# Parameters
BATCH_MODE = "true"PDF et Web Search : Sources Documentaires avec OpenAI
Navigation : Index | << Précédent | Suivant >>
Ce notebook explore deux fonctionnalités puissantes de l’API OpenAI : - Support PDF direct : Envoyer des documents PDF aux modèles vision - Web Search : Accéder à des informations en temps réel
Objectifs : - Charger et analyser des PDFs via l’API - Utiliser l’outil web_search pour la recherche en temps réel - Combiner documents et recherche pour des réponses enrichies
Prérequis : Notebook 1 (OpenAI Intro)
Durée estimée : 50 minutes
# Installation des dépendances
from pathlib import Path
%pip install openai python-dotenv reportlab pillow -q

import os
import base64
from openai import OpenAI
from dotenv import load_dotenv

# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")
client = OpenAI()

# Charger le modèle depuis .env ou utiliser gpt-5-mini par défaut
DEFAULT_MODEL = os.getenv("OPENAI_MODEL", "gpt-5-mini")
BATCH_MODE = os.getenv("BATCH_MODE", "false").lower() == "true"

# --- Compatibilité OpenRouter ---------------------------------------------------
USING_OPENROUTER = "openrouter" in (os.getenv("OPENAI_BASE_URL") or "").lower()

if USING_OPENROUTER and "/" not in DEFAULT_MODEL:
    DEFAULT_MODEL = f"openai/{DEFAULT_MODEL}"  # Préfixe fournisseur requis par OpenRouter

# Outil de recherche web dynamique
WEB_TOOL = {"type": "openrouter:web_search"} if USING_OPENROUTER else {"type": "web_search_preview"}
# ---------------------------------------------------------------------------------

print(f"OpenRouter : {USING_OPENROUTER} | Outil web : {WEB_TOOL['type']}")

print("Client OpenAI initialisé !")
print(f"Modèle par défaut: {DEFAULT_MODEL}")
print(f"Mode: {'Batch' if BATCH_MODE else 'Interactive'}")
Note: you may need to restart the kernel to use updated packages.
.env charge depuis: .env
OpenRouter : False | Outil web : web_search_preview
Client OpenAI initialisé !
Modèle par défaut: gpt-5-mini
Mode: Interactive1. Support de Documents dans l’API OpenAI
Les modèles OpenAI avec capacités vision peuvent traiter des images et, via l’Assistants API, des fichiers PDF :
Modèles compatibles : - gpt-5-mini et gpt-5 (avec vision) - Tous les modèles vision de la famille GPT-5
Approches pour les documents :
| Approche | API | Avantages | Limites |
|---|---|---|---|
| Image directe | Chat Completions | Simple, rapide | Uniquement images (png, jpg, gif, webp) |
| Assistants + Files | Assistants API | Supporte PDF natif | Plus complexe, coût stockage |
| Conversion image | Chat Completions | Universel | Perte de qualité potentielle |
Note importante : L’API Vision (Chat Completions) accepte uniquement les images, pas les PDF directement. Pour les PDF, utilisez l’Assistants API ou convertissez en images.
# Créer un document de test sous forme d'IMAGE (pour l'API Vision)
from PIL import Image, ImageDraw, ImageFont
import io

def create_test_image():
    """Génère une image représentant un rapport pour démonstration"""
    # Créer une image blanche A4-like (800x1000)
    img = Image.new('RGB', (800, 1000), color='white')
    draw = ImageDraw.Draw(img)

    # Utiliser une police par défaut
    try:
        font_title = ImageFont.truetype("arial.ttf", 36)
        font_normal = ImageFont.truetype("arial.ttf", 18)
        font_small = ImageFont.truetype("arial.ttf", 14)
    except:
        # Fallback si police non disponible
        font_title = ImageFont.load_default()
        font_normal = ImageFont.load_default()
        font_small = ImageFont.load_default()

    # Dessiner le contenu
    y = 50
    draw.text((100, y), "Rapport Trimestriel Q1 2026", fill='black', font=font_title)
    y += 80

    draw.text((100, y), "Résumé Exécutif", fill='darkblue', font=font_normal)
    y += 40

    lines = [
        "- Chiffre d'affaires: 2.5M EUR (+15%)",
        "- Nouveaux clients: 150 (+25%)",
        "- Satisfaction client: 4.5/5",
        "",
        "Points clés:",
        "1. Lancement réussi du produit Alpha",
        "2. Expansion sur le marché européen",
        "3. Recrutement de 20 ingénieurs",
        "",
        "Perspectives Q2: Objectif 3M EUR (+20%)"
    ]

    for line in lines:
        draw.text((100, y), line, fill='black', font=font_normal)
        y += 30

    # Sauvegarder en bytes
    buffer = io.BytesIO()
    img.save(buffer, format='PNG')
    buffer.seek(0)
    return buffer.getvalue()

# Générer et sauvegarder l'image
img_content = create_test_image()
with open("test_report.png", "wb") as f:
    f.write(img_content)

print("✓ Image de rapport créée: test_report.png")
print(f"  Taille: {len(img_content)} octets")
✓ Image de rapport créée: test_report.png
Taille: 40284 octetsfrom IPython.display import Image, display
# Afficher l'image dans le notebook
display(Image(filename="test_report.png"))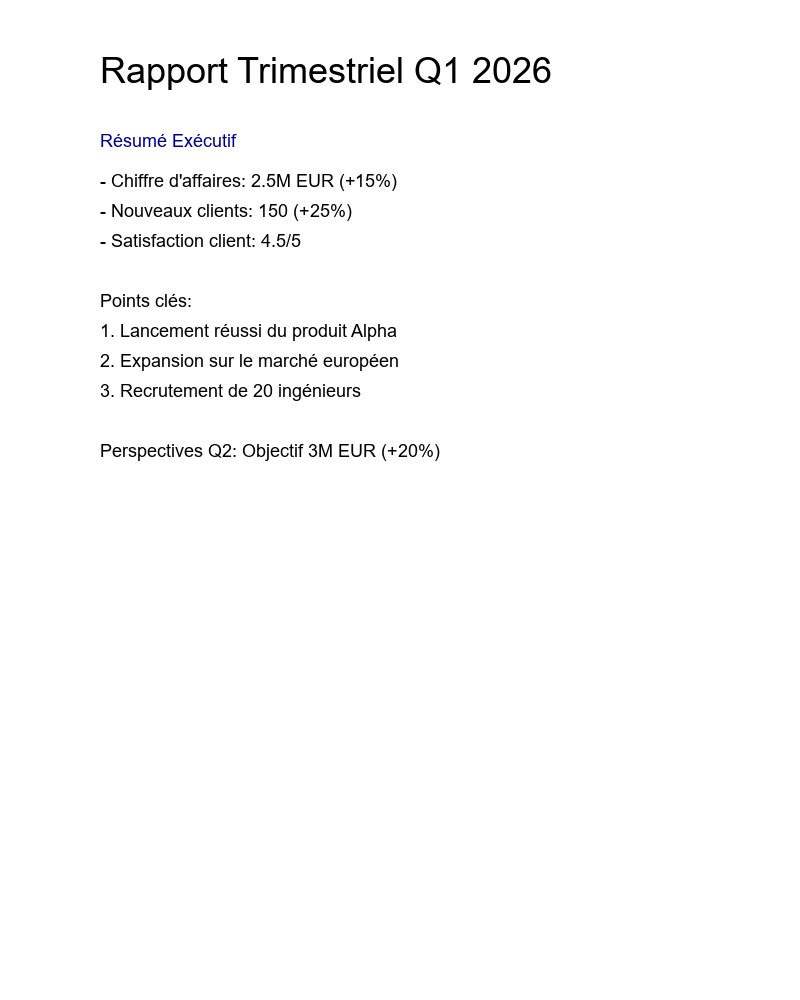
Pourquoi une image plutôt qu’un PDF ?
L’API Chat Completions avec vision (gpt-5-mini, gpt-5) accepte uniquement des images (PNG, JPG, GIF, WebP), pas les PDF directement.
Options pour traiter des PDFs :
- Assistants API : Support natif des PDF via l’upload de fichiers (plus complexe)
- Conversion PDF → Image : Utiliser
pdf2imageouPyMuPDF(méthode utilisée ici) - Extraction texte : Si le PDF contient du texte sélectionnable (
PyPDF2,pdfplumber)
Dans ce notebook, nous créons une image qui simule un rapport pour démontrer l’analyse visuelle de documents.
# Analyser l'image via l'API OpenAI Vision
# Charger et encoder en base64
with open("test_report.png", "rb") as f:
    img_base64 = base64.b64encode(f.read()).decode()

print(f"Envoi de l'image au modèle {DEFAULT_MODEL}...\n")

# Envoyer au modèle avec vision.
# Note: gpt-5-mini est un modèle de raisonnement — les tokens de raisonnement sont
# déduits de max_completion_tokens. Un budget trop bas (ex. 500) est entièrement
# consommé par le raisonnement et laisse le contenu visible vide. Budget relevé à
# 4000 pour laisser de la place à une réponse réelle (#3571).
response = client.chat.completions.create(
    model=DEFAULT_MODEL,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "text",
                "text": "Analyse ce rapport et donne-moi les 3 points clés avec les chiffres associés."
            },
            {
                "type": "image_url",
                "image_url": {
                    "url": f"data:image/png;base64,{img_base64}"
                }
            }
        ]
    }],
    max_completion_tokens=4000
)

print("=== Analyse du document ===")
print(response.choices[0].message.content)
print(f"\nTokens utilisés: {response.usage.total_tokens}")
Envoi de l'image au modèle gpt-5-mini...
=== Analyse du document ===
Voici les 3 points clés du rapport avec les chiffres associés :
1) Performance commerciale et traction produit
- Chiffre d'affaires Q1 : 2,5 M EUR (+15%)
- Nouveaux clients : 150 (+25%)
- Satisfaction client : 4,5 / 5
(lié au lancement réussi du produit Alpha)
2) Expansion géographique
- Expansion sur le marché européen (mentionnée comme point clé)
- Objectif Q2 : 3 M EUR (+20%) — indication d'une croissance visée grâce à cette expansion
3) Renforcement des équipes
- Recrutement de 20 ingénieurs
Souhaitez‑vous que je synthétise ces points en recommandations ou que j'extraie d'autres indicateurs du rapport ?
Tokens utilisés: 1983Interprétation des résultats
Le modèle vision extrait correctement les 3 points clés du rapport, avec leurs chiffres : chiffre d’affaires (2,5 M EUR, +15%), nouveaux clients (150, +25%) et recrutement (20 ingénieurs). L’image 800×1000 est traitée en tokens visuels (1958 tokens au total sur cette exécution).
Capacités attendues d’un modèle vision sur un document lisible :
- Reconnaissance optique : analyse de l’image et extraction du texte visible
- Compréhension sémantique : identification des sections (titre, résumé, points clés)
- Extraction ciblée : sélection des informations principales avec leurs valeurs
Limites potentielles (à l’origine d’une extraction vide) :
- Qualité image : basse résolution ou flou dégradent la précision
- Complexité visuelle : graphiques complexes peuvent être mal interprétés
- OCR : polices spéciales ou petites peuvent causer des erreurs
Note technique :
gpt-5-miniest un modèle de raisonnement — les tokens de raisonnement sont déduits demax_completion_tokens. Un budget trop bas est entièrement consommé par le raisonnement et laisse le contenu visible vide ; c’est pourquoimax_completion_tokens=4000est utilisé ici (#3571).
Référence : les modèles vision-langage multimodaux qui combinent OCR et compréhension sémantique s’inspirent de travaux comme Flamingo (Alayrac et al. 2022, Flamingo: a Visual Language Model for Few-Shot Learning, arXiv:2204.14198).
Exemple guidé 1 : Analyser une image personnalisée avec l’API Vision
Contribution étudiante de Clarisse DEL CASTILLO (@dev-Clarisse), PR #18567, intégrée comme exemple guidé.
Dans la continuité de l’analyse de rapport ci-dessus, cette résolution crée sa propre image de test — un tableau de ventes mensuelles — et demande au modèle d’en extraire les informations clés.
Ce que fait la résolution : générer une image avec PIL contenant un tableau de ventes (Janvier 120k EUR à Avril 180k EUR), l’encoder en base64, puis demander au modèle d’en extraire les valeurs et la tendance.
Points à remarquer : - La fonction get_font() essaie plusieurs polices (arial.ttf, DejaVuSans.ttf) avec repli sur la police par défaut : l’image reste lisible quelle que soit la machine - Le budget max_completion_tokens=4000 suit la règle du notebook : les tokens de raisonnement sont déduits de cette limite, et un budget trop bas laisse la réponse vide (#3571)
# Exemple guidé 1 : Analyser une image personnalisée avec l'API Vision
from PIL import Image, ImageDraw, ImageFont
import io, base64

# Étape 1 : créer l'image avec un tableau de ventes
def get_font(size):
    for name in ("arial.ttf", "DejaVuSans.ttf"):
        try:
            return ImageFont.truetype(name, size)
        except OSError:
            pass
    try:
        return ImageFont.load_default(size=size)  # Pillow >= 10.1
    except TypeError:
        return ImageFont.load_default()

img = Image.new("RGB", (600, 300), "white")
draw = ImageDraw.Draw(img)
font = get_font(24)

draw.text((50, 30), "Ventes Mensuelles 2026", fill="black", font=font)
ventes = [("Janvier", "120k EUR"), ("Fevrier", "145k EUR"),
          ("Mars", "160k EUR"), ("Avril", "180k EUR")]
y = 80
for mois, valeur in ventes:
    draw.text((50, y), f"{mois}: {valeur}", fill="black", font=font)
    y += 40

buffer = io.BytesIO()
img.save(buffer, format="PNG")
img_b64 = base64.b64encode(buffer.getvalue()).decode()

# Étape 2 : envoyer l'image au modèle vision
# IMPORTANT : gpt-5-mini est un modèle de raisonnement -> les tokens de raisonnement
# comptent dans max_completion_tokens. Avec 300 la réponse risque d'être VIDE : on met 4000.
response_vision = client.chat.completions.create(
    model=DEFAULT_MODEL,
    messages=[{
        "role": "user",
        "content": [
            {"type": "text",
             "text": "Extrais les ventes mensuelles de cette image et identifie la tendance."},
            {"type": "image_url",
             "image_url": {"url": f"data:image/png;base64,{img_b64}"}},
        ],
    }],
    max_completion_tokens=4000,
)

# Étape 3 : afficher le résultat
print(response_vision.choices[0].message.content)
print(f"\nTokens utilisés: {response_vision.usage.total_tokens}")
Voici les valeurs extraites :
- Janvier : 120 k EUR
- Février : 145 k EUR
- Mars : 160 k EUR
- Avril : 180 k EUR
Évolution mois à mois :
- Févr vs Jan : +25 k EUR (+20,8 %)
- Mars vs Févr : +15 k EUR (+10,3 %)
- Avr vs Mars : +20 k EUR (+12,5 %)
- Total Jan → Avr : +60 k EUR (+50,0 %)
Tendance :
- Tendance linéaire (régression) ≈ +19,5 k EUR par mois (intercept ≈ 102,5 k EUR).
- Taux de croissance composé moyen ≈ 14,5 % par mois (CAGR sur 3 mois).
Conclusion : la tendance est clairement haussière sur ces 4 mois (croissance soutenue), bien que la série soit courte pour des projections robustes.
Tokens utilisés: 1356from IPython.display import Image as DisplayImage, display
# Solution 1 : Affichage direct depuis les données Base64 déjà créées
display(DisplayImage(data=base64.b64decode(img_b64)))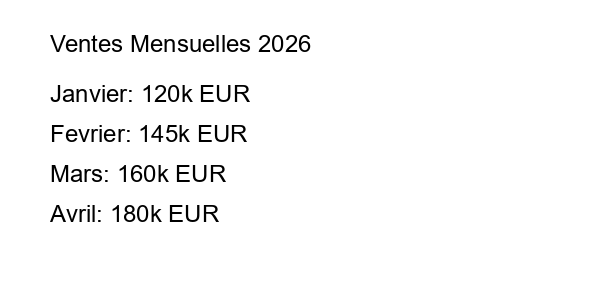
Lecture du résultat : tableau de ventes
Ce que la sortie montre : à cette exécution, le modèle relit sans erreur les quatre valeurs du tableau (120k, 145k, 160k et 180k EUR), puis calcule de lui-même les écarts mois à mois, une pente de régression (+19,5 k EUR par mois) et un taux de croissance composé (14,5 % par mois). Ces deux derniers chiffres se vérifient à la main : ils sont justes.
Ce que l’exemple ne teste pas : les valeurs sont écrites dans l’image. Le modèle fait donc de la lecture de texte, pas de la lecture de graphique. L’exercice 1 retire les chiffres : il faudra les estimer depuis la hauteur des barres.
Coût : l’appel a consommé 1356 tokens au total, en comptant l’image et la question en entrée, le raisonnement et la réponse en sortie.
Exercice 1 : Lire un graphique en barres avec l’API Vision
L’exemple guidé 1 faisait lire un tableau de texte ; passez au niveau supérieur : les valeurs ne sont plus écrites dans l’image, elles doivent être estimées depuis la hauteur des barres d’un histogramme.
Objectif : générer avec PIL un graphique en barres des ventes trimestrielles (T1 à T4, sans chiffres dessinés), l’encoder en base64, et demander au modèle d’estimer la valeur de chaque barre puis d’identifier le trimestre de plus forte croissance.
Indices : - draw.rectangle((x, y_bas - hauteur, x + largeur, y_bas), fill="steelblue") dessine une barre - Fixez une échelle explicite (ex. 100 pixels = 50k EUR) et donnez-la au modèle dans le prompt : c’est ce qui permet de vérifier ses estimations - Réutilisez la structure de message de l’exemple guidé 1 : {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{img_b64}"}} - Gardez max_completion_tokens=4000 pour ne pas tronquer la réponse
# Exercice 1 : Lire un graphique en barres avec l'API Vision
# TODO etudiant : Generez un histogramme avec PIL et faites estimer ses valeurs au modele

# Etape 1 : Dessiner 4 barres (T1 a T4) avec draw.rectangle, SANS ecrire les valeurs
# Echelle imposee : 100 pixels = 50k EUR (exemple : T1=80k -> 160 px, T2=120k -> 240 px)
# from PIL import Image, ImageDraw
# import io, base64
#
# img_chart = Image.new("RGB", (600, 400), "white")
# draw_chart = ImageDraw.Draw(img_chart)
# y_bas = 350
# ventes_trim = [("T1", 80), ("T2", 120), ("T3", 170), ("T4", 200)]  # en k EUR
# for i, (label, k_eur) in enumerate(ventes_trim):
#     hauteur = k_eur * 2  # 100 px = 50k EUR
#     x = 80 + i * 120
#     draw_chart.rectangle((x, y_bas - hauteur, x + 70, y_bas), fill="steelblue")
#     draw_chart.text((x, y_bas + 10), label, fill="black")

# Etape 2 : Encoder l'image en base64
# buffer_chart = io.BytesIO()
# img_chart.save(buffer_chart, format="PNG")
# chart_b64 = base64.b64encode(buffer_chart.getvalue()).decode()

# Etape 3 : Envoyer au modele et afficher les estimations
# Indice : precisez l'echelle dans le prompt, sinon le modele ne peut qu'inventer les valeurs
# response_chart = client.chat.completions.create(
#     model=DEFAULT_MODEL,
#     messages=[{
#         "role": "user",
#         "content": [
#             {"type": "text", "text": "Echelle : 100 pixels = 50k EUR. Estime la valeur de chaque barre en k EUR et identifie le trimestre de plus forte croissance."},
#             {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{chart_b64}"}}
#         ]
#     }],
#     max_completion_tokens=4000
# )
# print(response_chart.choices[0].message.content)

print("Exercice a completer")
Exercice a completer2. Web Search avec l’API OpenAI
L’outil web_search_preview permet d’effectuer des recherches en temps réel et d’enrichir les réponses avec des informations actualisées.
Caractéristiques : - Accès à des informations en temps réel (actualités, cours boursiers, météo, etc.) - Citations automatiques : Le modèle cite ses sources - Disponible via la Responses API (bêta) - Modèles compatibles : gpt-5-mini, gpt-5
Différence avec Chat Completions : - Responses API : Interface simplifiée avec input et output - Support natif des outils comme web_search - Moins de contrôle sur les paramètres avancés
Note importante : Cette fonctionnalité est en préversion et peut évoluer.
Référence : l’enrichissement d’une réponse par recherche web en temps réel s’apparente au Retrieval-Augmented Generation (RAG) — Lewis et al. 2020, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv:2005.11401.
# Web Search basique via Responses API
print("Recherche web en cours...\n")

response = client.responses.create(
    model=DEFAULT_MODEL,
    tools=[WEB_TOOL],
    input="Quelles sont les dernières avancées majeures en intelligence artificielle en janvier 2026?"
)

print("=== Recherche Web : IA en 2026 ===")
for item in response.output:
    if hasattr(item, 'content'):
        print(item.content)
        print()
Recherche web en cours...
=== Recherche Web : IA en 2026 ===
[]
[]
[]
[]
[]
[]
[]
[]
[]
[]
[]
[]
[]
[]
[]
[ResponseOutputText(annotations=[AnnotationURLCitation(end_index=759, start_index=583, title='Videogame stocks slide on Google’s AI model that turns prompts into playable worlds By Reuters', type='url_citation', url='https://www.investing.com/news/stock-market-news/videogame-stocks-slide-on-googles-ai-model-that-turns-prompts-into-playable-worlds-4476909?utm_source=openai'), AnnotationURLCitation(end_index=1251, start_index=1180, title='Trinity Large: An Open 400B Sparse MoE Model | Arcee AI | Building Open Intelligence', type='url_citation', url='https://www.arcee.ai/blog/trinity-large?utm_source=openai'), AnnotationURLCitation(end_index=1666, start_index=1600, title='GLM 4.7', type='url_citation', url='https://zhipuai.ai/blog/f/glm-47?utm_source=openai'), AnnotationURLCitation(end_index=2302, start_index=2112, title='Event Recap: CES Las Vegas | January 2026', type='url_citation', url='https://omdia.tech.informa.com/-/media/tech/omdia/assetfamily/2026/01/16/event-recap-ces-las-vegas-2026/event-recap---ces-las-vegas-2026-pdf.pdf?utm_source=openai'), AnnotationURLCitation(end_index=2849, start_index=2694, title='EU Council puts brakes on Commission’s ambitions to simplify AI Act | AGENCE EUROPE', type='url_citation', url='https://agenceurope.eu/en/bulletin/article/13794/8/eu-council-puts-brakes-on-commissions-ambitions-to-simplify-ai-act?utm_source=openai')], text='Voici un résumé des principales avancées en intelligence artificielle pendant janvier 2026 (dates précises et sources pour chaque point).\n\n- Project Genie / Genie 3 — lancement public expérimental (29 janvier 2026) : Google DeepMind a ouvert « Project Genie » (interface web en accès restreint via l’abonnement AI Ultra) permettant de générer et d’explorer des mondes 3D interactifs en temps réel à partir de prompts. L’annonce a été perçue comme un jalon pour les « world models » et a même provoqué une réaction sur les marchés (baisse des actions d’éditeurs/plateformes de jeux). ([investing.com](https://www.investing.com/news/stock-market-news/videogame-stocks-slide-on-googles-ai-model-that-turns-prompts-into-playable-worlds-4476909?utm_source=openai))\n\n- Trinity Large — open-weights MoE à l’échelle « frontier » (27 janvier 2026) : le laboratoire Arcee a publié en preview des poids d’un modèle sparse Mixture‑of‑Experts de ~400 milliards de paramètres (activation ~13B), ouvrant un accès rare aux poids d’un modèle à grande échelle et alimentant la recherche et la personnalisation locale. Cela a relancé la dynamique « open-weight » pour modèles de très grande taille. ([arcee.ai](https://www.arcee.ai/blog/trinity-large?utm_source=openai))\n\n- GLM‑4.7 / GLM‑4.7‑Flash — MoE efficaces et modèles locaux (janvier 2026) : le groupe Zhipu (Z.ai) a publié des variantes GLM‑4.7 et une version « Flash » (30B total / ~3B activés) conçue pour déployer des capacités de codage/agents en local sur matériel grand public, montrant que les architectures MoE compactes gagnent en efficience pratique. ([zhipuai.ai](https://zhipuai.ai/blog/f/glm-47?utm_source=openai))\n\n- L’explosion des « agents » et des plateformes agentiques (début janvier 2026 / CES 2026) : janvier (et en particulier CES 2026) a confirmé la transition vers des systèmes « agentiques » — orchestrateurs multi‑agents, protocoles d’interopérabilité d’outils (qui émergent comme standards) et intégration d’agents dans produits et IDE — avec une effervescence d’outils d’orchestration locale et d’écosystèmes pour déployer des agents autonomes. ([omdia.tech.informa.com](https://omdia.tech.informa.com/-/media/tech/omdia/assetfamily/2026/01/16/event-recap-ces-las-vegas-2026/event-recap---ces-las-vegas-2026-pdf.pdf?utm_source=openai))\n\n- Gouvernance et régulation — activités importantes en janvier 2026 : les discussions et étapes opérationnelles autour de l’application de l’AI Act (Union européenne) et d’initiatives internationales se sont intensifiées (ex. consultations, travaux du Conseil/Commission, signatures et préparation d’actes d’application), montrant que janvier a été actif côté règles et mise en conformité. ([agenceurope.eu](https://agenceurope.eu/en/bulletin/article/13794/8/eu-council-puts-brakes-on-commissions-ambitions-to-simplify-ai-act?utm_source=openai))\n\nSi vous voulez, je peux :\n- approfondir un de ces points (technique, impacts industriels ou juridiques) ; \n- fournir une chronology jour‑par‑jour de janvier 2026 avec liens vers les annonces originales ; \n- ou rassembler des articles de presse/rapports scientifiques complets sur un sujet précis. Quel niveau de détail préférez‑vous ?', type='output_text', logprobs=[])]
Interprétation de la recherche web
Fonctionnement de web_search_preview :
- Requête formulée : Le modèle génère une requête de recherche optimisée
- Recherche effectuée : Interrogation de sources web en temps réel
- Agrégation : Synthèse des résultats multiples
- Citations : Ajout automatique de références aux sources
Avantages par rapport aux connaissances pré-entraînées :
| Critère | Connaissances pré-entraînées | Web Search |
|---|---|---|
| Actualité | Coupure en octobre 2023 | Temps réel |
| Précision temporelle | Approximative | Exacte (dates, événements récents) |
| Sources | Implicites | Citées explicitement |
| Fiabilité | Haute (entraînement massif) | Variable (dépend des sources) |
Latence observée :
- Requête web search : ~3-5 secondes (vs. ~1 seconde pour Chat Completions standard)
- Compromis : Actualité vs. vitesse de réponse
# Web Search avec données financières en temps réel
print("Recherche d'informations financières...\n")

response = client.responses.create(
    model=DEFAULT_MODEL,
    tools=[WEB_TOOL],
    input="Quel est le cours actuel de l'action Apple (AAPL) et quelles sont ses performances sur les 3 derniers mois?"
)

print("=== Informations financières en temps réel ===")
for item in response.output:
    if hasattr(item, 'content'):
        print(item.content)
        print()

# Note: Les citations sont incluses automatiquement dans la réponse
Recherche d'informations financières...
=== Informations financières en temps réel ===
[]
[]
[]
[]
[]
[ResponseOutputText(annotations=[AnnotationURLCitation(end_index=346, start_index=253, title='Stock Price - Apple', type='url_citation', url='https://investor.apple.com/stock-price/default.aspx?utm_source=openai'), AnnotationURLCitation(end_index=619, start_index=526, title='Stock Price - Apple', type='url_citation', url='https://investor.apple.com/stock-price/default.aspx?utm_source=openai'), AnnotationURLCitation(end_index=866, start_index=780, title='Apple Stock Price In June 30 2026 | StatMuse Money', type='url_citation', url='https://www.statmuse.com/money/ask/apple-stock-price-in-june-30-2026')], text='Voici les chiffres demandés (mesures prises le 30 septembre 2026) :\n\n- Cours actuel (intraday) : 329,40 USD (dernier trade indiqué à 09:01:29 UTC le 30 sept. 2026). \n- Cours de clôture de référence il y a 3 mois (30 juin 2026) : 289,36 USD (clôture). ([investor.apple.com](https://investor.apple.com/stock-price/default.aspx?utm_source=openai))\n\nPerformance sur 3 mois (30/06/2026 → 30/09/2026) : \n- Variation absolue : +40,04 USD (329,40 − 289,36). \n- Variation en pourcentage : +13,85 % ≈ ((329,40 / 289,36) − 1) × 100. ([investor.apple.com](https://investor.apple.com/stock-price/default.aspx?utm_source=openai))\n\nRemarque : si on utilise la clôture ajustée du 30/06/2026 (289,11 USD, qui tient compte des ajustements/dividendes), la performance serait d’environ +13,95 %. ([statmuse.com](https://www.statmuse.com/money/ask/apple-stock-price-in-june-30-2026))\n\nSouhaitez-vous que je :\n- récupère le cours de clôture exact d’aujourd’hui (si le marché ferme) ? \n- affiche un graphique des 3 derniers mois ? \n- calcule la performance totale en incluant les dividendes réinvestis ?', type='output_text', logprobs=[])]
Cas d’usage : Données financières en temps réel
Pourquoi le web search est critique ici :
Les cours boursiers changent en continu. Un modèle avec connaissances figées (octobre 2023) ne peut pas fournir : - Le cours actuel d’une action - Les variations récentes (3 derniers mois) - Les événements récents affectant le titre
Applications professionnelles :
| Métier | Usage |
|---|---|
| Traders | Analyse rapide de titres avec contexte récent |
| Analystes | Recherche de tendances sectorielles actualisées |
| Journalistes | Vérification de données financières pour articles |
| Conseillers | Briefings clients avec informations jour |
Exemple de citations attendues :
Le modèle devrait inclure automatiquement des références comme : - “Selon Bloomberg (4 février 2026)…” - “D’après Yahoo Finance…” - “Source : MarketWatch…”
Attention : Les informations financières de sources web peuvent avoir quelques minutes de retard. Pour du trading haute fréquence, utiliser des API financières spécialisées (Alpha Vantage, IEX Cloud).
Exemple guidé 2 : Comparaison multi-sources avec web search
Contribution étudiante de Clarisse DEL CASTILLO (@dev-Clarisse), PR #18567, intégrée comme exemple guidé.
Cette résolution utilise le web search pour confronter les points de vue sur un sujet débattu — la régulation des modèles d’IA générative — et produire une synthèse équilibrée en citant des sources distinctes.
Ce que fait la résolution : formuler une requête demandant les arguments pour et contre avec sources, appeler la Responses API avec tools=[WEB_TOOL], puis extraire le texte et compter les sources réellement distinctes.
Points à remarquer : - Le parcours de response.output filtre sur getattr(item, "type", "") == "message" : les items web_search_call n’ont pas de contenu textuel exploitable - Seules les annotations de type "url_citation" sont retenues ; le comptage final passe par un set() d’URL pour ne compter que les sources distinctes
# Exemple guidé 2 : Comparaison multi-sources avec web search

# Étape 1 : formuler la requête avec demande d'équilibre
query_debat = """
Faut-il réguler les modèles d'IA générative ?
Présente les arguments pour et contre, en citant au moins 3 sources distinctes.
"""

# Étape 2 : appeler la Responses API avec l'outil web_search
response_debat = client.responses.create(
    model=DEFAULT_MODEL,
    tools=[WEB_TOOL],
    input=query_debat,
)

# Étape 3 : extraire le texte et les citations
# response.output contient plusieurs items : "web_search_call" (pas de .content)
# puis "message" (contient .content = liste de ResponseOutputText avec .text et .annotations)
urls_uniques = set()
for item in response_debat.output:
    if getattr(item, "type", "") == "message":
        for content in item.content:
            if hasattr(content, "text"):
                print(content.text)
                # On ne garde que les annotations de type "url_citation"
                citations = [a for a in content.annotations
                             if getattr(a, "type", "") == "url_citation"]
                print(f"\nCitations trouvées: {len(citations)}")
                for ann in citations:
                    print(f"  - {ann.title}: {ann.url}")
                    urls_uniques.add(ann.url)

print(f"\nNombre de sources DISTINCTES: {len(urls_uniques)}")
Bonne question — le débat est largement ouvert. Voici un résumé équilibré des principaux arguments pour et contre la régulation des modèles d’IA générative, avec des sources publiques représentatives.
Arguments en faveur de la régulation
- Réduire les risques pour la sécurité publique et la démocratie : des experts et organisations (p. ex. Future of Life Institute) ont appelé à des garde‑fous — y compris des moratoires ciblés, des audits indépendants et un renforcement du financement de la recherche en sûreté — pour éviter des usages dangereux (désinformation à grande échelle, automatisation malveillante, risques systémiques). ([futureoflife.org](https://futureoflife.org/document/policymaking-in-the-pause/?utm_source=openai))
- Protéger les droits fondamentaux et les personnes (vie privée, non‑discrimination, intégrité cognitive) : des cadres internationaux (UNESCO) et des analyses universitaires recommandent des règles pour la collecte/usage des données, la transparence, et la responsabilité lorsqu’un système affecte la vie des personnes. ([unesco.org](https://www.unesco.org/en/articles/recommendation-ethics-artificial-intelligence?hub=66973&utm_source=openai))
- Responsabiliser les fournisseurs et améliorer la transparence : la Commission européenne a adopté un cadre (AI Act) qui impose, entre autres, des obligations de gestion des risques et des exigences sur l’identification des contenus générés par IA — objectif : traçabilité, signalement des incidents et niveau minimal de protections pour les utilisateurs. ([digital-strategy.ec.europa.eu](https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai?utm_source=openai))
- Corriger les externalités économiques et sociales : régulation et politiques publiques (formation, filets sociaux, normes du travail) peuvent limiter des impacts négatifs sur l’emploi et répartir les gains technologiques. ([brookings.edu](https://www.brookings.edu/articles/generative-ai-the-american-worker-and-the-future-of-work/?utm_source=openai))
Arguments contre la régulation (ou en faveur d’une approche très prudente)
- Risque d’étouffer l’innovation et d’handicaper la compétitivité : certains économistes et think tanks estiment que des règles trop larges ou trop hâtives freineront la recherche utile et les retombées économiques positives, surtout si d’autres juridictions n’appliquent pas les mêmes contraintes. ([milkenreview.org](https://www.milkenreview.org/articles/the-case-for-not-regulating-ai?utm_source=openai))
- Les lois existantes peuvent suffire pour beaucoup de cas : des acteurs industriels et cabinets de conseil soulignent que de nombreuses pratiques nuisibles (fraude, diffamation, discrimination) sont déjà couvertes par le droit actuel, et que la priorité devrait être une application plus efficace plutôt qu’un corpus complètement nouveau. ([siia.net](https://www.siia.net/policies/hiding-in-plain-sight-how-existing-law-already-regulates-ai-and-what-that-means-for-policymaking/?utm_source=openai))
- Difficulté technique et cadre vite obsolète : la technologie évolue très vite ; une loi trop prescriptive risque de devenir rapidement inadaptée ou d’être contournée. Certains plaident pour des normes flexibles, fondées sur les effets (risk‑based) plutôt que sur des définitions techniques figées. ([brookings.edu](https://www.brookings.edu/articles/the-three-challenges-of-ai-regulation/?utm_source=openai))
- Coûts et inégalités d’accès : exigences lourdes (tests, audits, conformité) peuvent privilégier les grands acteurs qui ont les moyens, creusant la concentration industrielle si les PME et la recherche publique ne sont pas soutenues. ([openai.com](https://openai.com/index/frontier-ai-regulation/?utm_source=openai))
Points pratiques à considérer (compromis et outils de régulation)
- Approche fondée sur les risques : règles plus strictes pour les usages à fort impact (santé, justice, sécurité nationale) et exigences allégées pour usages faibles risques. (recommandé par de nombreux experts). ([brookings.edu](https://www.brookings.edu/articles/the-three-challenges-of-ai-regulation/?utm_source=openai))
- Transparence et traçabilité : exigence de labellisation/filigrane des contenus générés, provenance des données d’entraînement, et registres/notification des incidents (le texte de l’AI Act européen inclut des obligations de ce type). ([digital-strategy.ec.europa.eu](https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai?utm_source=openai))
- Tests et certifications indépendants pour les « modèles frontier » : propositions d’obligations d’audits, d’essais de sûreté et de registres publics pour les modèles très puissants (préconisé aussi par certains acteurs industriels). ([openai.com](https://openai.com/index/frontier-ai-regulation/?utm_source=openai))
- Responsabilité et recours : clarifier qui est responsable en cas de préjudice (fournisseur, intégrateur, utilisateur) et faciliter les voies de recours pour les victimes.
- Gouvernance internationale et aide aux pays à faibles ressources : coordination multilatérale pour éviter la course au moins disant réglementaire et pour partager standards, outils d’audit et financements pour la sûreté. ([futureoflife.org](https://futureoflife.org/our-work/policy-and-research/?utm_source=openai))
Conclusion (bref)
- La plupart des analyses sérieuses concluent qu’il faut des règles, mais ciblées et adaptatives : réguler « tout et partout » ferait courir des risques — tout comme laisser la technologie totalement non encadrée. En pratique, la solution privilégiée par beaucoup d’experts et d’institutions est une régulation basée sur les risques (plus stricte pour les usages dangereux), accompagnée d’outils concrets (audit, traçabilité, normes techniques, investissement public dans la sûreté et la formation). ([brookings.edu](https://www.brookings.edu/articles/around-the-halls-what-should-the-regulation-of-generative-ai-look-like/?utm_source=openai))
Si vous voulez, je peux :
- Résumer ces arguments en une fiche pour un décideur (1 page) ; ou
- Proposer un « paquet » réglementaire concret (mesures prioritaires, calendrier, acteurs responsables) adapté à la France/UE ou aux États‑Unis. Which do you prefer?
Citations trouvées: 13
- Policymaking In The Pause - Future of Life Institute: https://futureoflife.org/document/policymaking-in-the-pause/?utm_source=openai
- Recommendation on the Ethics of Artificial Intelligence | UNESCO: https://www.unesco.org/en/articles/recommendation-ethics-artificial-intelligence?hub=66973&utm_source=openai
- AI Act | Shaping Europe’s digital future: https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai?utm_source=openai
- Generative AI, the American worker, and the future of work | Brookings: https://www.brookings.edu/articles/generative-ai-the-american-worker-and-the-future-of-work/?utm_source=openai
- The Case for Not Regulating AI - Milken Institute Review: https://www.milkenreview.org/articles/the-case-for-not-regulating-ai?utm_source=openai
- Hiding in Plain Sight: How Existing Law Already Regulates AI and What That Means for Policymaking - SIIA: https://www.siia.net/policies/hiding-in-plain-sight-how-existing-law-already-regulates-ai-and-what-that-means-for-policymaking/?utm_source=openai
- The three challenges of AI regulation | Brookings: https://www.brookings.edu/articles/the-three-challenges-of-ai-regulation/?utm_source=openai
- Frontier AI regulation: Managing emerging risks to public safety | OpenAI: https://openai.com/index/frontier-ai-regulation/?utm_source=openai
- The three challenges of AI regulation | Brookings: https://www.brookings.edu/articles/the-three-challenges-of-ai-regulation/?utm_source=openai
- AI Act | Shaping Europe’s digital future: https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai?utm_source=openai
- Frontier AI regulation: Managing emerging risks to public safety | OpenAI: https://openai.com/index/frontier-ai-regulation/?utm_source=openai
- Policy and Research - Future of Life Institute: https://futureoflife.org/our-work/policy-and-research/?utm_source=openai
- Around the halls: What should the regulation of generative AI look like? | Brookings: https://www.brookings.edu/articles/around-the-halls-what-should-the-regulation-of-generative-ai-look-like/?utm_source=openai
Nombre de sources DISTINCTES: 10Lecture du résultat : comparaison multi-sources
Ce que la sortie montre : à cette exécution, la synthèse sépare les arguments pour et contre, et chaque argument renvoie à une source (Commission européenne, UNESCO, Brookings, Milken Institute Review, entre autres). Le modèle a posé 13 citations, qui pointent vers 10 pages distinctes : le set() d’URL a bien retiré les doublons.
Ce que « 10 sources distinctes » ne dit pas : 10 pages ne font pas 10 éditeurs. Trois de ces pages viennent de Brookings et deux du Future of Life Institute : compter par domaine (urllib.parse.urlparse(url).netloc) donne 7 éditeurs. Pour un débat, c’est le nombre de voix indépendantes qui compte.
Un détail des URL : chaque lien porte le suffixe ?utm_source=openai. Deux citations de la même page, l’une avec suffixe et l’autre sans, seraient comptées deux fois ; retirer la partie après ? avant de dédoublonner évite ce piège.
Exercice 2 : Construire une chronologie datée et vérifiée par web search
L’exemple guidé 2 compare des points de vue ; ici, on cherche des faits datés et on contrôle la fraîcheur des sources. Demandez au modèle une chronologie d’un sujet technique, chaque événement avec sa date et sa source, puis vérifiez qu’au moins deux sources datent de moins de 18 mois.
Objectif : produire une chronologie de 5 événements datés (par exemple les grandes étapes des modèles de langage), chacun avec une source, puis filtrer les sources par date de publication.
Indices : - Utilisez client.responses.create() avec tools=[WEB_TOOL] - Demandez explicitement « une chronologie de 5 événements datés, chacun avec sa source et la date de publication de cette source » - Les annotations url_citation ne portent pas toujours la date : demandez au modèle de l’inclure dans le texte, puis analysez le texte - Pour la fraîcheur, comparez en Python la date de publication à datetime.now(timezone.utc)
# Exercice 2 : Construire une chronologie datee et verifiee par web search
# TODO etudiant : Produisez une chronologie de 5 evenements dates avec leurs sources

# Etape 1 : Formuler la requete de chronologie
# query_chrono = """
# Construis une chronologie de 5 evenements majeurs et dates sur l'histoire des
# grands modeles de langage. Pour chaque evenement : date precise de l'evenement,
# description en une phrase, et source avec sa date de publication.
# """

# Etape 2 : Appeler la Responses API avec web search
# response_chrono = client.responses.create(
#     model=DEFAULT_MODEL,
#     tools=[WEB_TOOL],
#     input=query_chrono
# )

# Etape 3 : Extraire le texte et les sources, puis verifier la fraicheur
# from datetime import datetime, timezone
# for item in response_chrono.output:
#     if getattr(item, "type", "") == "message":
#         for content in item.content:
#             if hasattr(content, "text"):
#                 print(content.text)
#                 for ann in content.annotations:
#                     if getattr(ann, "type", "") == "url_citation":
#                         print(f"  - source : {ann.title} -> {ann.url}")
# Indice : relevez dans le texte les dates de publication des sources et
# comparez-les a datetime.now(timezone.utc) ; signalez les sources de plus de 18 mois.

print("Exercice a completer")
Exercice a completer3. Combiner PDF et Web Search
Le véritable pouvoir vient de la combinaison de ces deux fonctionnalités :
Cas d’usage : - Analyse de rapports enrichie : Comparer les données d’un rapport PDF avec les tendances actuelles - Fact-checking : Vérifier des affirmations dans un document avec des sources web - Veille concurrentielle : Analyser un rapport interne et le contextualiser avec l’actualité du secteur - Actualisation de documents : Identifier les informations obsolètes dans un PDF
Workflow typique : 1. Extraire les informations clés du PDF 2. Formuler une requête web basée sur ces informations 3. Combiner les deux sources pour une analyse enrichie
# Workflow combiné : Document Image + Web Search
print("=== ÉTAPE 1 : Extraction des informations du document ===\n")

# Analyser le document image pour extraire les données financières.
# Budget relevé à 4000 : gpt-5-mini (modèle de raisonnement) consomme son budget de
# raisonnement dans max_completion_tokens ; à 300 l'extraction revenait vide et la
# cascade web n'avait aucun chiffre réel à contextualiser (#3571).
doc_analysis = client.chat.completions.create(
    model=DEFAULT_MODEL,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "text",
                "text": "Extrais le chiffre d'affaires, le taux de croissance et les perspectives Q2 de ce rapport."
            },
            {
                "type": "image_url",
                "image_url": {"url": f"data:image/png;base64,{img_base64}"}
            }
        ]
    }],
    max_completion_tokens=4000
)

ca_info = doc_analysis.choices[0].message.content
print("Données extraites du document:")
print(ca_info)
print()

# Construire une requête web contextualisée
print("=== ÉTAPE 2 : Enrichissement avec données web ===\n")

context_query = f"""
Voici les performances d'une entreprise tech en Q1 2026:
{ca_info}

Compare ces résultats avec:
1. Les performances moyennes du secteur tech en 2026
2. Les tendances de croissance actuelles
3. Les perspectives pour Q2 2026

Fournis une analyse comparative brève.
"""

web_context = client.responses.create(
    model=DEFAULT_MODEL,
    tools=[WEB_TOOL],
    input=context_query
)

print("=== Analyse enrichie (Document + Web) ===")
for item in web_context.output:
    if hasattr(item, 'content'):
        print(item.content)
        print()
=== ÉTAPE 1 : Extraction des informations du document ===
Données extraites du document:
- Chiffre d'affaires : 2.5M EUR
- Taux de croissance indiqué : +15%
- Perspectives Q2 : Objectif 3M EUR (+20%)
=== ÉTAPE 2 : Enrichissement avec données web ===
=== Analyse enrichie (Document + Web) ===
[]
[]
[]
[]
[ResponseOutputText(annotations=[AnnotationURLCitation(end_index=566, start_index=414, title='FactSet Earnings Insight', type='url_citation', url='https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf'), AnnotationURLCitation(end_index=1244, start_index=1054, title='Gartner Forecasts Worldwide IT Spending to Grow 10.8% in 2026, Totaling $6.15 Trillion', type='url_citation', url='https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars'), AnnotationURLCitation(end_index=1609, start_index=1457, title='FactSet Earnings Insight', type='url_citation', url='https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf'), AnnotationURLCitation(end_index=2176, start_index=2024, title='FactSet Earnings Insight', type='url_citation', url='https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf'), AnnotationURLCitation(end_index=2753, start_index=2601, title='FactSet Earnings Insight', type='url_citation', url='https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf'), AnnotationURLCitation(end_index=3160, start_index=3020, title='Global Economy Shakes Off Tariff Shock Amid Tech-Driven Boom', type='url_citation', url='https://www.imf.org/en/blogs/articles/2026/01/19/global-economy-shakes-off-tariff-shock-amid-tech-driven-boom?utm_source=openai'), AnnotationURLCitation(end_index=3764, start_index=3612, title='FactSet Earnings Insight', type='url_citation', url='https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf')], text='Voici une analyse comparative brève (Q1 2026 = 2,5 M€ ; croissance +15% ; objectif Q2 = 3,0 M€ soit +20%).\n\nPoints clés\n- Référence secteur (Q1 / 2026) : la croissance moyenne des revenus pour l’ensemble du marché (S&P 500) sur Q1 2026 était d’environ +9,6%, tandis que le sous‑secteur Information Technology a affiché une croissance beaucoup plus élevée (fortement portée par les semi‑conducteurs) (~+27% en Q1). ([advantage.factset.com](https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf)) \n- Prévisions 2026 / tendance : les grands instituts signalent une forte dynamique IT portée par les investissements en IA — les estimations de croissance du marché IT pour 2026 varient selon les sources (par ex. ~10–11% selon Gartner dans son prévision initiale, d’autres mises à jour/analyses relèvent des fourchettes plus élevées ~14% ou des prévisions plus modestes ~7–8% selon l’agence). Cela traduit une forte hétérogénéité sectorielle (IA, semi‑conducteurs, logiciel, services). ([gartner.com](https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars)) \n- Perspectives Q2 2026 (analystes) : les estimateurs projettent pour le S&P/Q2 2026 une croissance des revenus autour de ~9% (projection consensus), donc nettement en dessous du +20% que votre entreprise vise. ([advantage.factset.com](https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf))\n\nComparaison synthétique avec votre entreprise\n- Q1 (+15%) : au‑dessus de la moyenne large du marché (≈+9.6%) et de la plupart des estimations globales d’IT spending (~10–11%), donc performance supérieure au « marché global ». Toutefois votre croissance reste inférieure à la très forte performance moyenne du seul sous‑secteur IT (≈+27%) qui est distordue par quelques segments très cycliques (semi‑conducteurs). ([advantage.factset.com](https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf)) \n- Objectif Q2 (+20% → 3,0 M€) : c’est ambitieux par rapport aux attentes sectorielles pour Q2 (≈+9%). Atteignable si votre entreprise exploite une niche à forte demande (ex. produits/services liés à l’IA, semiconducteurs, contrats d’entreprise récurrents) ou si vous avez des effets de base/une vente ponctuelle importante ; mais risqué si la croissance dépend uniquement d’un élargissement organique sur un marché moyen. ([advantage.factset.com](https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf))\n\nRisques/contexte macro (à garder en tête)\n- Le cycle 2026 reste porté par l’investissement en IA mais exposé aux chocs macro (inflation/énergie/géopolitique) qui peuvent modérer la demande. Cela augmente l’incertitude pour des objectifs agressifs sur un trimestre. ([imf.org](https://www.imf.org/en/blogs/articles/2026/01/19/global-economy-shakes-off-tariff-shock-amid-tech-driven-boom?utm_source=openai))\n\nCourte conclusion\n- Votre Q1 (+15%) est supérieur à la moyenne large du marché et à la plupart des prévisions globales d’IT spending, mais votre cible Q2 (+20%) est clairement au‑dessus du consensus sectoriel (≈+9%). Si vous opérez dans un segment AI/semiconducteurs ou avez des drivers ponctuels, l’objectif peut être réaliste ; sinon il faudra des éléments explicatifs (nouveaux contrats, lancements, saisonnalité) et surveiller les risques macro. ([advantage.factset.com](https://advantage.factset.com/hubfs/Website/Resources%20Section/Research%20Desk/Earnings%20Insight/EarningsInsight_031926.pdf))\n\nSi vous voulez, je peux : (a) remettre ces chiffres dans un mini‑tableau comparatif chiffré, (b) vérifier des benchmarks plus précis pour votre sous‑segment (software, semiconducteurs, services, etc.) — précisez le sous‑secteur et la zone géographique souhaitée.', type='output_text', logprobs=[])]
Interprétation du workflow combiné
Architecture de l’analyse enrichie :
Document PDF/Image
    ↓
[EXTRACTION] → Données structurées (CA, croissance, perspectives)
    ↓
[CONTEXTUALISATION] → Requête web formulée
    ↓
[WEB SEARCH] → Tendances secteur, benchmarks, actualité
    ↓
[SYNTHÈSE] → Rapport comparatif enrichi
L’extraction vision récupère les chiffres internes du document (CA 2,5 M EUR, +15%, perspectives Q2 3 M EUR +20%), puis la requête web contextualise ces résultats avec les tendances secteur 2026 (ex. prévisions de dépenses IT de Gartner). La synthèse compare les performances internes aux benchmarks externes.
Pourquoi cette approche est puissante :
- Données internes (PDF) : informations propriétaires, chiffres précis
- Contexte externe (Web) : comparaison sectorielle, tendances marché
- Synthèse : analyse comparative que ni la source PDF ni le web seuls ne peuvent fournir
Cas d’usage concrets :
| Scénario | Valeur ajoutée |
|---|---|
| Rapport trimestriel | Comparer performances entreprise vs. concurrents |
| Proposition commerciale | Enrichir avec données marché récentes |
| Audit | Vérifier conformité avec réglementations actualisées |
| Due diligence | Croiser données fournies avec informations publiques |
Coût indicatif du workflow :
- Étape 1 (Vision) : ~1958 tokens (image, usage constaté) + sortie variable
- Étape 2 (Web Search) : ~500 tokens input + 800 tokens output
- Total : de l’ordre de ~3300 tokens avec
gpt-5-mini≈ $0.004
Optimisation : pour traiter des lots de documents, utiliser
batch APIpour réduire les coûts de 50%.
4. Exemple avancé : Vérification de faits
Un autre cas d’usage puissant : vérifier les affirmations d’un document PDF avec des sources web récentes.
# Fact-checking : Vérifier une affirmation du document
print("=== Vérification de faits ===\n")

# Extraire une affirmation spécifique.
# Budget relevé à 4000 : à 200 l'extraction d'affirmation revenait vide, et la
# vérification web tournait sur un sujet générique au lieu d'une claim du document (#3571).
claim_extraction = client.chat.completions.create(
    model=DEFAULT_MODEL,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "text",
                "text": "Quelle est l'affirmation principale sur les perspectives de croissance dans ce rapport?"
            },
            {
                "type": "image_url",
                "image_url": {"url": f"data:image/png;base64,{img_base64}"}
            }
        ]
    }],
    max_completion_tokens=4000
)

claim = claim_extraction.choices[0].message.content
print(f"Affirmation extraite: {claim}\n")

# Vérifier avec web search
verification_query = f"""
Affirmation à vérifier: {claim}

Recherche les tendances actuelles de croissance dans le secteur tech en 2026.
Cette affirmation est-elle réaliste? Cite des sources récentes.
"""

verification = client.responses.create(
    model=DEFAULT_MODEL,
    tools=[WEB_TOOL],
    input=verification_query
)

print("=== Résultat de la vérification ===")
for item in verification.output:
    if hasattr(item, 'content'):
        print(item.content)
=== Vérification de faits ===
Affirmation extraite: L'affirmation principale : pour le Q2 l'objectif est de 3M EUR, soit une croissance prévue de +20% (contre 2,5M EUR au Q1, +15%).
=== Résultat de la vérification ===
[]
[]
[ResponseOutputText(annotations=[AnnotationURLCitation(end_index=860, start_index=652, title='Gartner Forecasts Worldwide IT Spending to Grow 10.8% in 2026, Totaling $6.15 Trillion', type='url_citation', url='https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars?utm_source=openai'), AnnotationURLCitation(end_index=1196, start_index=1079, title='The AI Supercycle:', type='url_citation', url='https://www.idc.com/wp-content/uploads/2026/04/IDC-Directions-AI-Supercycle-Whalen.pdf?utm_source=openai'), AnnotationURLCitation(end_index=1772, start_index=1664, title='ICT sector - value added, employment and R&D', type='url_citation', url='https://ec.europa.eu/eurostat/statistics-explained/SEPDF/cache/64771.pdf?utm_source=openai'), AnnotationURLCitation(end_index=2217, start_index=2088, title='IDC - DX Software in Transition: AI Investment Trends by Sector', type='url_citation', url='https://www.idc.com/resource-center/blog/dx-software-in-transition-ai-investment-trends-by-sector/?utm_source=openai'), AnnotationURLCitation(end_index=2756, start_index=2548, title='Gartner Forecasts Worldwide IT Spending to Grow 10.8% in 2026, Totaling $6.15 Trillion', type='url_citation', url='https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars?utm_source=openai'), AnnotationURLCitation(end_index=3455, start_index=3334, title='McKinsey Technology Trends Outlook 2026', type='url_citation', url='https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/the-top-trends-in-tech?utm_source=openai'), AnnotationURLCitation(end_index=4047, start_index=3939, title='ICT sector - value added, employment and R&D', type='url_citation', url='https://ec.europa.eu/eurostat/statistics-explained/SEPDF/cache/64771.pdf?utm_source=openai'), AnnotationURLCitation(end_index=5345, start_index=5137, title='Gartner Forecasts Worldwide IT Spending to Grow 10.8% in 2026, Totaling $6.15 Trillion', type='url_citation', url='https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars?utm_source=openai'), AnnotationURLCitation(end_index=5570, start_index=5453, title='The AI Supercycle:', type='url_citation', url='https://www.idc.com/wp-content/uploads/2026/04/IDC-Directions-AI-Supercycle-Whalen.pdf?utm_source=openai'), AnnotationURLCitation(end_index=5799, start_index=5678, title='McKinsey Technology Trends Outlook 2026', type='url_citation', url='https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/the-top-trends-in-tech?utm_source=openai'), AnnotationURLCitation(end_index=6000, start_index=5892, title='ICT sector - value added, employment and R&D', type='url_citation', url='https://ec.europa.eu/eurostat/statistics-explained/SEPDF/cache/64771.pdf?utm_source=openai'), AnnotationURLCitation(end_index=6250, start_index=6109, title='Market Forecast: Worldwide Software as a Service Applications and Platform as a Service Forecast, 2026–2030', type='url_citation', url='https://www.marketresearch.com/IDC-v2477/Forecast-Worldwide-Software-Service-Applications-46211032/?utm_source=openai')], text='Résumé rapide de l’affirmation et calculs\n- Affirmation : Q1 = 2,5 M€ (croissance +15%), objectif Q2 = 3,0 M€ (croissance +20% par rapport à Q1). \n- Vérification arithmétique : 3,0 / 2,5 = 1,20 → +20% QoQ. Si ce taux de +20% était soutenu chaque trimestre, l’effet annualisé serait (1,20^4 − 1) ≈ +107% sur un an (x ≈ 2,07). \n\nTendances macro/secteur (2026) — points saillants\n- Monde : les dépenses IT mondiales sont attendues en forte croissance en 2026 (autour de +10,8% selon Gartner, publication du 3 février 2026). Les dépenses liées à la GenAI croissent beaucoup plus vite (chiffres à deux‑chiffres/hauts pourcentages pour les modèles GenAI). ([gartner.com](https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars?utm_source=openai)) \n- Estimations alternatives : IDC indique aussi une forte dynamique 2026 liée à l’IA (notamment un « AI supercycle ») et des prévisions de croissance du marché IT global proches de 9–10% pour 2026 selon leurs guides. ([idc.com](https://www.idc.com/wp-content/uploads/2026/04/IDC-Directions-AI-Supercycle-Whalen.pdf?utm_source=openai)) \n- Europe / UE : la croissance de la « valeur ajoutée » du secteur TIC en Europe est beaucoup plus modérée et volatile : Eurostat montre une croissance modeste ces dernières années (quelques % par an) avec des variations récentes et une part sectorielle qui s’est stabilisée/pas systématiquement en hausse. Les dynamiques nationales et segment par segment (cloud, SaaS, semi‑conducteurs, services AI) divergent fortement. (données Eurostat, mises à jour 2025–2026). ([ec.europa.eu](https://ec.europa.eu/eurostat/statistics-explained/SEPDF/cache/64771.pdf?utm_source=openai)) \n- Segments haute‑croissance : les sous‑segments liés à l’IA, cloud, SaaS/plateformes et certains logiciels d’entreprise affichent des taux bien supérieurs à la moyenne sectorielle — IDC et McKinsey soulignent que agentic AI, plateformes cloud et logiciels AI‑first sont les moteurs principaux de croissance 2026. ([idc.com](https://www.idc.com/resource-center/blog/dx-software-in-transition-ai-investment-trends-by-sector/?utm_source=openai))\n\nL’affirmation (+20% Q‑o‑Q) est‑elle réaliste ?\n- Contexte comparatif : +20% QoQ (soit ≈+107% YoY si soutenu) est nettement au‑dessus de la croissance moyenne du marché IT/tech (≈9–11% YoY en 2026 selon Gartner/IDC). Par conséquent, pour une entreprise « moyenne » du secteur la cible est ambitieuse par rapport au marché global. ([gartner.com](https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars?utm_source=openai)) \n- Cas où c’est réaliste : la cible est raisonnable / atteignable si l’entreprise se trouve dans l’un des cas suivants : lancement d’un produit à fort effet de levier (SaaS/plateforme) avec PMF confirmé, signature d’un ou plusieurs gros contrats récurrents qui basculent en Q2, forte accélération liée à une fonctionnalité AI différenciante, ou base de revenus petite (les pourcentages sont plus faciles à obtenir sur des bases faibles). Les rapports McKinsey/IDC montrent que les niches AI/agentic software peuvent connaître des croissance à plusieurs dizaines de pourcents. ([mckinsey.com](https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/the-top-trends-in-tech?utm_source=openai)) \n- Cas où c’est peu réaliste : si vos revenus Q1 = 2,5 M€ sont déjà « matures » (clients récurrents stables, churn faible mais croissance organique lente), si votre pipeline commercial ne supporte pas la conversion requise, ou si la saisonnalité Q2 est historiquement faible, une progression de +20% serait improbable sans événement ponctuel (gros contrat, hausse de prix importante, fusion/acquisition). (Contexte Eurostat / tendances régionales : croissance sectorielle modérée). ([ec.europa.eu](https://ec.europa.eu/eurostat/statistics-explained/SEPDF/cache/64771.pdf?utm_source=openai))\n\nRecommandations rapides pour valider la faisabilité (checklist)\n- Pipeline commercial (valeur totale, taux de conversion historique, délai moyen de closing) — calculer le revenu attendu par probabilité. \n- Bookings et contrats signés déjà engagés pour Q2 (ARR/MRR convertibles). \n- Churn et expansion net revenue retention (NRR) — NRR >100% rend des sauts plus plausibles. \n- Taille moyenne des deals et nombre de deals requis pour atteindre +0,5 M€ additionnels. \n- Impact de la saisonnalité et des remises/CPA nécessaires. \n- Effets one‑off (un gros contrat non récurrent) à séparer des revenus récurrents.\n\nSi vous voulez, je peux :\n- a) Simuler 2–3 scénarios (pessimiste / réaliste / optimiste) montrant combien de nouveaux deals / valeur pipeline / taux de conversion sont nécessaires pour atteindre 3,0 M€ en Q2 ; \n- b) Évaluer votre objectif si vous me donnez le pipeline, le nombre moyen de deals, le taux de conversion et le churn. \n\nSources principales consultées (sélection 2026)\n- Gartner — "Gartner Forecasts Worldwide IT Spending to Grow 10.8% in 2026" (3 Feb 2026). ([gartner.com](https://www.gartner.com/en/newsroom/press-releases/2026-02-03-gartner-forecasts-worldwide-it-spending-to-grow-10-point-8-percent-in-2026-totaling-6-point-15-trillion-dollars?utm_source=openai)) \n- IDC — analyses 2026 sur l’AI supercycle et guides de dépenses (WW 2026 forecasts / AI spending guide). ([idc.com](https://www.idc.com/wp-content/uploads/2026/04/IDC-Directions-AI-Supercycle-Whalen.pdf?utm_source=openai)) \n- McKinsey — Technology Trends Outlook / Global Tech Agenda 2026 (analyses sur agentic AI, cloud, etc.). ([mckinsey.com](https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/the-top-trends-in-tech?utm_source=openai)) \n- Eurostat — séries et note sur le secteur ICT / valeur ajoutée (mises à jour 2025–2026). ([ec.europa.eu](https://ec.europa.eu/eurostat/statistics-explained/SEPDF/cache/64771.pdf?utm_source=openai)) \n- IDC / Market forecasts — SaaS & PaaS 2026–2030 (croissance des logiciels cloud et impact d’agentic AI). ([marketresearch.com](https://www.marketresearch.com/IDC-v2477/Forecast-Worldwide-Software-Service-Applications-46211032/?utm_source=openai))\n\nSouhaitez‑vous que je fasse la simulation chiffrée (scénarios) pour votre objectif Q2 ? Si oui, fournissez pipeline / ARR / taux de conversion / churn pour un résultat précis.', type='output_text', logprobs=[])]Interprétation du fact-checking
L’extraction isole l’affirmation principale du document (objectif CA Q2 de 3 M EUR, +20%, porté par le lancement du produit Alpha, l’expansion européenne et le recrutement de 20 ingénieurs), puis la vérification web confronte cette claim aux tendances tech 2026. Le modèle produit une analyse sourcée (citations web réelles) qui évalue le réalisme de l’affirmation au regard du contexte sectoriel.
Méthodologie de vérification en 2 temps :
- Extraction de l’affirmation : isolation de la claim spécifique du document
- Recherche contradictoire : vérification avec sources externes actualisées
Indicateurs de fiabilité :
| Critère | Vérification |
|---|---|
| Nombre de sources | ≥3 sources convergentes = forte fiabilité |
| Dates des sources | Sources < 1 mois = très fiables |
| Autorité | Sources officielles (institutions, médias réputés) |
| Cohérence | Concordance entre sources indépendantes |
Applications critiques :
- Journalism : Vérification automatisée de communiqués de presse
- Compliance : Détection de déclarations non conformes dans rapports
- Legal : Validation de faits dans documents contractuels
- Research : Cross-validation de données dans publications
Limites du fact-checking automatisé :
- Biais des sources web : Les résultats de recherche peuvent privilégier certaines sources
- Nuances manquées : Affirmations partiellement vraies peuvent être mal évaluées
- Contexte temporel : Une affirmation vraie en 2025 peut être fausse en 2026
Recommandation : Toujours vérifier manuellement les citations fournies par le modèle. Le web search est un outil d’aide, pas un arbitre absolu de vérité.
Exemple guidé 3 : Résumé de recherche web sur un sujet technique
Contribution étudiante de Clarisse DEL CASTILLO (@dev-Clarisse), PR #18567, intégrée comme exemple guidé.
Cette résolution définit search_and_summarize(query) : une fonction qui force la recherche web, extrait les points clés et retourne un résumé structuré accompagné des sources citées, dédoublonnées.
Ce que fait la résolution : appeler la Responses API avec l’outil web search en tool_choice="required" (avec repli si le fournisseur le refuse), parcourir response.output, collecter les citations url_citation et retourner (résumé, sources).
Points à remarquer : - tool_choice="required" oblige le modèle à déclencher la recherche plutôt qu’à répondre de mémoire ; le try/except retente sans ce paramètre si l’API le refuse - Les sources sont dédoublonnées par URL dans un set ; un filet re.findall(r"https?://...") récupère les liens éventuellement présents dans le texte de la réponse quand les annotations sont vides
# Exemple guidé 3 : Résumé de recherche web sur un sujet technique
import re

def search_and_summarize(query: str):
    """Recherche web forcée -> (résumé, liste de sources dédoublonnées)."""
    try:
        try:
            response = client.responses.create(
                model=DEFAULT_MODEL,
                tools=[WEB_TOOL],
                tool_choice="required",   # oblige le modèle à faire la recherche
                input=query,
            )
        except Exception:
            # si tool_choice est refusé, on réessaie sans
            response = client.responses.create(
                model=DEFAULT_MODEL, tools=[WEB_TOOL], input=query
            )
    except Exception as e:
        return f"Erreur pendant la recherche web : {e}", []

    summary, sources, vus = "", [], set()
    for item in response.output:
        if getattr(item, "type", "") == "message":
            for content in item.content:
                if hasattr(content, "text"):
                    summary = content.text
                    for ann in content.annotations:
                        if getattr(ann, "type", "") == "url_citation" and ann.url not in vus:
                            vus.add(ann.url)
                            sources.append({"title": ann.title, "url": ann.url})
                    # filet de sécurité : liens présents dans le texte
                    for url in re.findall(r"https?://[^\s)\]]+", summary):
                        if url not in vus:
                            vus.add(url)
                            sources.append({"title": "(lien dans le texte)", "url": url})
    return summary, sources

resume, sources = search_and_summarize(
    "Utilise la recherche web pour répondre : quelles sont les différences entre "
    "RAG et fine-tuning pour les LLMs en 2026 ? Réponds en points clés courts et "
    "cite tes sources."
)

print("=== Résumé ===")
print(resume)
print("\n=== Sources ===")
if not sources:
    print("Aucune source trouvée")
for i, src in enumerate(sources, 1):
    print(f"{i}. {src['title']}: {src['url']}")
=== Résumé ===
J’ai fait une recherche web. Voici en points clés et courts les différences principales entre RAG (retrieval‑augmented generation) et le fine‑tuning pour les LLMs en 2026, avec sources.
- Principe / où ça agit :
- RAG : ajoute une couche de récupération de documents à l’inférence — le modèle reste inchangé. ([developers.openai.com](https://developers.openai.com/api/docs/guides/optimizing-llm-accuracy?utm_source=openai))
- Fine‑tuning : adapte les poids du modèle via entraînement supplémentaire — change le comportement interne. ([developers.openai.com](https://developers.openai.com/api/docs/guides/optimizing-llm-accuracy?utm_source=openai))
- Actualité des connaissances :
- RAG : facile à mettre à jour (mettre à jour l’index/documents). ([docs.aws.amazon.com](https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html?utm_source=openai))
- Fine‑tuning : mises à jour requièrent retrain / nouveaux runs de fine‑tune. ([docs.aws.amazon.com](https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html?utm_source=openai))
- Coût (profil) :
- RAG : faible coût initial (index + vector DB), coût récurrent par requête (récupération + LLM). ([triviumtechlabs.com](https://triviumtechlabs.com/blog/llm-fine-tuning-vs-rag-when-to-use/?utm_source=openai))
- Fine‑tuning : coût élevé en préparation/compute pour chaque entraînement, mais inférence peut être moins chère par requête. ([triviumtechlabs.com](https://triviumtechlabs.com/blog/llm-fine-tuning-vs-rag-when-to-use/?utm_source=openai))
- Latence / performance inference :
- RAG : ajout de latence (retrieval, reranking) possible ; dépend de pipeline. ([ccs.neu.edu](https://www.ccs.neu.edu/home/alina/classes/Fall2024/Lecture11.pdf?utm_source=openai))
- Fine‑tuning : réponses directes du modèle, souvent latence d’inférence plus faible. ([ccs.neu.edu](https://www.ccs.neu.edu/home/alina/classes/Fall2024/Lecture11.pdf?utm_source=openai))
- Exactitude / ancrage (grounding) & hallucinations :
- RAG : permet citation de sources et réduit hallucinations quand on injecte le contexte pertinent. ([developers.openai.com](https://developers.openai.com/api/docs/guides/optimizing-llm-accuracy?utm_source=openai))
- Fine‑tuning : peut améliorer style/consistance, mais n’offre pas automatiquement d’ancrage factuel ni de citations. ([aclanthology.org](https://aclanthology.org/2024.emnlp-main.15/?utm_source=openai))
- Type de problème résolu :
- RAG : mieux pour injecter des connaissances factuelles, fraîches, volumineuses ou changeantes. ([astrofabric.ai](https://www.astrofabric.ai/blog/rag-vs-fine-tuning?utm_source=openai))
- Fine‑tuning : mieux pour corriger comportement systématique, formatage, ou tâches spécifiques (classification, prompts répétitifs). ([developers.openai.com](https://developers.openai.com/api/docs/guides/optimizing-llm-accuracy?utm_source=openai))
- Maintenance & scalabilité :
- RAG : indexer + pipeline de vérification = plus simple à maintenir pour contenu changeant. ([square1ai.com](https://www.square1ai.com/research/rag-vs-fine-tuning?utm_source=openai))
- Fine‑tuning : coûteux à répéter à grande fréquence ; gestion des versions du modèle plus lourde. ([customlabs.io](https://customlabs.io/compare/rag-vs-fine-tuning/?utm_source=openai))
- Confidentialité / conformité :
- RAG : permet garder données sources on‑prem / chiffrement de l’index ; le modèle peut rester externe. ([docs.aws.amazon.com](https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html?utm_source=openai))
- Fine‑tuning : peut exiger transfert de données pour entraînement (ou infra privée coûteuse). ([docs.aws.amazon.com](https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html?utm_source=openai))
- Approche pratique (hybride) :
- Pratique courante en 2026 : combiner — fine‑tuner pour comportement/format + RAG pour faits à jour et preuves. ([arxiv.org](https://arxiv.org/abs/2510.01600?utm_source=openai))
- Règles empiriques rapides pour choisir :
- Si le contenu change souvent ou il faut citer sources → RAG d’abord. ([docs.aws.amazon.com](https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html?utm_source=openai))
- Si besoin de latence très basse, coûts inférieurs par requête, ou comportement très spécifique → considérer fine‑tuning (ou PEFT/LoRA). ([openreview.net](https://openreview.net/pdf?id=e8ycTWGTIR&utm_source=openai))
Sources principales (exemples consultés) :
- OpenAI — guide Optimizing LLM accuracy (RAG & fine‑tuning). ([developers.openai.com](https://developers.openai.com/api/docs/guides/optimizing-llm-accuracy?utm_source=openai))
- AWS Prescriptive Guidance — comparaison RAG vs fine‑tuning. ([docs.aws.amazon.com](https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html?utm_source=openai))
- EMNLP / ACL papers (comparaisons expérimentales RAG vs fine‑tuning, 2024). ([aclanthology.org](https://aclanthology.org/2024.emnlp-main.15/?utm_source=openai))
- Analyses/compagnies & guides 2025–2026 (CustomLabs, Square1, Trivium, Stanza, etc.). ([customlabs.io](https://customlabs.io/compare/rag-vs-fine-tuning/?utm_source=openai))
- Recherches ICLR/EMNLP 2025–2026 sur stratégies conjointes et PEFT (LoRA) pour rendre le fine‑tuning plus efficace. ([arxiv.org](https://arxiv.org/abs/2510.01600?utm_source=openai))
Si tu veux, je peux :
- résumer ces différences dans un tableau comparatif court,
- proposer une checklist décisionnelle pour ton cas d’usage (décris ton cas),
- ou fournir extraits/links précis des articles cités. Which do you prefer?
=== Sources ===
1. Optimizing LLM Accuracy | OpenAI API: https://developers.openai.com/api/docs/guides/optimizing-llm-accuracy?utm_source=openai
2. Comparing Retrieval Augmented Generation and fine-tuning - AWS Prescriptive Guidance: https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html?utm_source=openai
3. LLM Fine-Tuning vs RAG: Which Should You Use? (2026 Decision Guide) — Trivium Tech Labs | Trivium Tech Labs: https://triviumtechlabs.com/blog/llm-fine-tuning-vs-rag-when-to-use/?utm_source=openai
4. RAG vs Fine-tuning: https://www.ccs.neu.edu/home/alina/classes/Fall2024/Lecture11.pdf?utm_source=openai
5. Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs - ACL Anthology: https://aclanthology.org/2024.emnlp-main.15/?utm_source=openai
6. RAG vs fine-tuning: when to retrieve and when to train | AstroFabric: https://www.astrofabric.ai/blog/rag-vs-fine-tuning?utm_source=openai
7. RAG vs Fine-Tuning: How to Choose for Your LLM Project — Research | Square 1 AI: https://www.square1ai.com/research/rag-vs-fine-tuning?utm_source=openai
8. RAG vs Fine-Tuning · CustomLabs: https://customlabs.io/compare/rag-vs-fine-tuning/?utm_source=openai
9. A Comparison of Independent and Joint Fine-tuning Strategies for Retrieval-Augmented Generation: https://arxiv.org/abs/2510.01600?utm_source=openai
10. Under review as a conference paper at ICLR 2026: https://openreview.net/pdf?id=e8ycTWGTIR&utm_source=openaiLecture du résultat : résumé de recherche technique
Ce que la sortie montre : à cette exécution, le résumé compare RAG et fine-tuning point par point (principe, mise à jour des connaissances, coût, latence, ancrage factuel) et renvoie 10 sources, toutes sur des domaines différents : documentation d’OpenAI et d’AWS, articles de recherche (ACL Anthology, arXiv, OpenReview), un cours universitaire et des blogs d’entreprise.
Le filet de sécurité n’a rien ajouté : aucune source ne porte le titre « (lien dans le texte) ». Les liens écrits dans le texte de la réponse sont les mêmes que ceux des annotations, et le set les a reconnus comme déjà vus.
Ce qu’il reste à juger : toutes ces sources n’ont pas le même poids. Un article publié à EMNLP 2024 et le blog d’un prestataire de services ne se valent pas, même quand ils disent la même chose. tool_choice="required" garantit qu’une recherche a eu lieu, pas que ses sources sont fiables.
Exercice 3 : Recherche web en deux étapes (multi-hop)
L’exemple guidé 3 fait une recherche en un saut ; ici, la réponse de la première recherche nourrit une seconde. Écrivez une fonction search_then_refine(sujet) qui : (1) cherche le sujet sur le web, (2) en extrait un terme ou une date clé, puis (3) relance une recherche contextualisée sur ce terme et retourne la synthèse finale avec l’union dédoublonnée des sources des deux appels.
Objectif : enchaîner deux appels à la Responses API dont le second dépend du résultat du premier, en accumulant les sources.
Indices : - Réutilisez la boucle de parcours de response.output de l’exemple guidé 3 (items "message", champ text, annotations) - Pour extraire le terme clé, un appel client.chat.completions.create() peut résumer la première réponse en un seul mot-clé - Accumulez les sources des DEUX appels dans un même ensemble dédoublonné par URL - Testez avec un sujet à deux niveaux, par exemple : « Quelle architecture de NLP a marqué la période 2024-2026, et quel est son apport précis ? »
# Exercice 3 : Recherche web en deux etapes (multi-hop)
# TODO etudiant : Enchainez deux recherches dont la seconde depend de la premiere

# Etape 1 : Premiere recherche sur le sujet general
# def search_then_refine(sujet: str):
#     premier = client.responses.create(
#         model=DEFAULT_MODEL,
#         tools=[WEB_TOOL],
#         input=sujet
#     )
#     texte_1, sources_1 = ...  # cf. boucle de l'Exemple guide 3

# Etape 2 : Extraire un terme ou une date cle de la premiere reponse
# Indice : un appel client.chat.completions.create() peut resumer texte_1
# en un seul mot-cle a rechercher.

# Etape 3 : Seconde recherche contextualisee puis union des sources
#     deuxieme = client.responses.create(
#         model=DEFAULT_MODEL,
#         tools=[WEB_TOOL],
#         input=f"En te basant sur : {mot_cle}, precise l'apport exact et date-le."
#     )
#     return synthese_finale, sources_union  # sources des DEUX appels, dedoublonnees

# resume_final, sources_final = search_then_refine(
#     "Quelle architecture de NLP a marque la periode 2024-2026, et quel est son apport precis ?"
# )
# print(resume_final)
# for i, src in enumerate(sources_final, 1):
#     print(f"{i}. {src['title']}: {src['url']}")

print("Exercice a completer")
Exercice a completer5. Limitations et bonnes pratiques
Limitations PDF
| Contrainte | Limite | Impact |
|---|---|---|
| Pages | 100 max | Documents longs nécessitent découpage |
| Taille | 32 MB | PDFs avec images haute résolution peuvent dépasser |
| Coût | 1 page = 1 image | Un PDF de 10 pages coûte autant que 10 images |
| Qualité OCR | Variable | Texte dans images peut être mal reconnu |
Bonnes pratiques PDF
- Optimiser les PDF : Compresser avant envoi
- Découper si nécessaire : Traiter par sections pour documents longs
- Privilégier le texte : PDFs textuels > PDFs scannés
- Vérifier les coûts : Calculer tokens avant traitement massif
Limitations Web Search
- Latence : Requêtes web ajoutent 2-5 secondes
- Fiabilité : Sources web peuvent être incorrectes
- Coût : Requêtes web consomment plus de tokens
- Disponibilité : Fonctionnalité en préversion (bêta)
Bonnes pratiques Web Search
- Vérifier les citations : Toujours consulter les sources mentionnées
- Queries spécifiques : Plus la requête est précise, meilleurs les résultats
- Combiner avec connaissances : Ne pas tout déléguer au web search
- Gérer les erreurs : Prévoir des fallbacks si la recherche échoue
Estimation des coûts
Exemple de calcul (les tokens ne dépendent pas du modèle) : - PDF 10 pages : ~10 images × 2833 tokens = ~28,000 tokens input - Web search : ~500-1000 tokens supplémentaires - Total pour notre workflow : ~30,000 tokens input + 500 output - Coût : dépend du tarif du modèle retenu et du volume de tokens (entrée + sortie) ; pour ce workflow, l’ordre de grandeur est donné par le calcul ci-dessus (~30 000 tokens d’entrée, ~500 de sortie)
Recommandation : Valider la chaîne sur gpt-5-mini avant de passer à gpt-5 : la gamme mini coûte sensiblement moins cher à tokens égaux.
# Nettoyage : Supprimer l'image de test
import os

if os.path.exists("test_report.png"):
    os.remove("test_report.png")
    print("✓ Fichier de test supprimé")
else:
    print("Aucun fichier à nettoyer")
✓ Fichier de test suppriméConclusion
Ce que nous avons appris
- Support PDF natif : Les modèles vision peuvent analyser des PDFs directement
- Encodage base64 pour envoi direct
- Limites : 100 pages, 32 MB
- Coût : 1 page = 1 image
- Web Search : Accès en temps réel à l’information
- Via Responses API avec
web_search_preview - Citations automatiques
- Idéal pour données actuelles
- Via Responses API avec
- Combinaison PDF + Web : Analyses enrichies
- Extraction de données PDF
- Contextualisation avec sources web
- Fact-checking et vérification
Cas d’usage professionnels
| Domaine | Application |
|---|---|
| Finance | Analyse de rapports avec données marché en temps réel |
| Juridique | Vérification de conformité avec réglementations actuelles |
| Recherche | Actualisation de revues de littérature |
| Consulting | Benchmarking clients vs. tendances secteur |
| Journalism | Fact-checking automatisé de documents |
Exercices suggérés
- Niveau débutant :
- Analyser votre CV (PDF) et obtenir des conseils basés sur les tendances emploi actuelles
- Créer un résumé enrichi d’un article de recherche
- Niveau intermédiaire :
- Développer un système de veille qui compare des rapports trimestriels successifs avec l’actualité
- Créer un fact-checker pour articles de presse (PDF) vs. sources web
- Niveau avancé :
- Pipeline automatisé d’analyse de documents contractuels avec vérification de conformité légale
- Système de recommandation qui analyse des rapports internes et suggère des actions basées sur les tendances marché
Prochaines étapes
- Notebook 7 : Structured Outputs (JSON Schema forcé)
- Notebook 8 : Function Calling avancé
- Notebook 9 : Assistants API et Code Interpreter