Phase 5 de l’epic #2926 — suite de NB-12 (moteurs), NB-16 (scaling pass@k).
La question centrale de Snell (Phase 5)
NB-16 a mesure que le test-time compute exterieur (BoN, Reflexion) se met a l’echelle : plus d’echantillons = plus de succes (la ou il y a de la marge). Mais les modèles a raisonnement natif (deepseek-r1, o1/o3, gpt-5-thinking) depensent leur test-time compute a l’interieur : ils generent des tokens de raisonnement caches avant la reponse.
Question (Snell) : a cout egal (en tokens, raisonnement inclus), un modèle a raisonnement natif bat-il le scaling hand-rolled (BoN/Reflexion) sur un modèle standard ?
Snell et al. 2024 montrent que le scaling hand-rolled, quand il est compute-optimal, peut egaler un modèle 14x plus grand — i.e. depenser du compute exterieur peut valoir l’investissement dans un modèle plus gros. Ce notebook mesure cela directement : on compare, sur la même suite graduee, le BoN d’un modèle standard (llama-3.3-70b, 0 token de raisonnement) au single-shot d’un modèle a raisonnement natif (deepseek-r1), normalise en tokens.
Plan
Suite graduee + verificateur exact (herites de NB-16) + pass@k.
Baseline non-reasoning : BoN pass@k sur llama-3.3-70b, cout en tokens cumules.
Note: you may need to restart the kernel to use updated packages.
.env charge depuis : .env
BASELINE (non-reasoning)=meta-llama/llama-3.3-70b-instruct | REASONING=deepseek/deepseek-r1 | BATCH=True
Lecture : La configuration a chargé les variables depuis .env. Le baseline non-reasoning est meta-llama/llama-3.3-70b-instruct et le modèle de raisonnement est deepseek/deepseek-r1. Le mode BATCH est activé pour une comparaison équitable entre les deux approches.
def tokens_raisonnement(usage):"""Extrait les reasoning tokens d'un objet usage (None si modele non-reasoning)."""try: d =getattr(usage, "completion_tokens_details", None)returngetattr(d, "reasoning_tokens", None) or0if d else0exceptException:return0def chat_usage(prompt, model, system=None, temperature=0.7, max_tokens=2000, retries=2):"""Chat qui renvoie (texte, total_tokens). total = prompt + completion (+ reasoning inclus dans completion_tokens chez OpenRouter). Capt aussi les reasoning tokens separement.""" messages = ([{"role": "system", "content": system}] if system else []) \+ [{"role": "user", "content": prompt}]for essai inrange(retries +1):try: resp = client.chat.completions.create(model=model, messages=messages, temperature=temperature, max_tokens=max_tokens) txt = resp.choices[0].message.content or"" u = resp.usage total = (u.prompt_tokens or0) + (u.completion_tokens or0) rtok = tokens_raisonnement(u)if txt.strip() or rtok:return txt, total, rtokexceptExceptionas exc:if essai == retries:print(f" [chat_usage] echec ({model}) : {str(exc)[:80]}")else: time.sleep(1.0)return"", 0, 0# Ping : montre la decomposition des tokens (baseline vs raisonnement).for m in (BASELINE_MODEL, REASONING_MODEL): txt, tot, rt = chat_usage("Combien font 17 x 23 ? Reponds uniquement par le nombre.", model=m, temperature=0.0, max_tokens=2000)print(f"{m:34s} -> {txt.strip()!r:14s} | total_tokens={tot:5d} (dont reasoning={rt})")
Lecture : Pour un même énoncé, les deux modèles répondent 391 — mais llama-3.3-70b-instruct y consomme 31 tokens (dont 0 de raisonnement), tandis que deepseek-r1 utilise 853 tokens dont 531 pour le raisonnement interne. Cela illustre le surcoût en tokens du raisonnement natif par rapport à l’inférence directe.
Lecture supplémentaire : La comparaison des token counts entre les deux modèles est révélatrice. Le modèle deepseek-r1 utilise 27,5 fois plus de tokens (853/31 ≈ 27,5) que llama-3.3-70b-instruct pour le même prompt, et 531 de ces 853 tokens sont dédiés au raisonnement interne. Cela démontre que le raisonnement natif implémente une approche de résolution de problème plus intensive en calcul, mais potentiellement plus robuste pour les tâches complexes.
1. Suite graduee + verificateur + pass@k (herites de NB-16)
Même suite que NB-16 (reponses entieres verifiables) pour que la comparaison soit equitable. Estimateur pass@k non-biasé (HumanEval, Chen et al 2021).
PROBLEMES = {"facile": [ ("Combien font 7 + 8 ? Reponds uniquement par le nombre.", 15), ("Combien font 12 x 11 ? Reponds uniquement par le nombre.", 132), ],"moyen": [ ("Un train part avec 45 passagers. 12 montent au suivant, 7 descendent. ""Combien reste-t-il de passagers ? Reponds uniquement par le nombre.", 50), ("Si 3 pommes coutent 1,50 EUR, combien coutent 12 pommes (en EUR entier) ? ""Reponds uniquement par le nombre.", 6), ],"difficile": [ ("Un capital de 1000 EUR augmente de 10% puis diminue de 10%. ""Quelle est la valeur finale en EUR ? Reponds uniquement par le nombre.", 990), ("Combien de nombres entre 1 et 20 (inclus) sont divisibles par 3 OU par 5 ? ""Reponds uniquement par le nombre.", 9), ],}def extraire_nombre(texte): m = re.findall(r'-?\d+', texte or"")returnint(m[0]) if m elseNonedef est_correct(attendu):def _v(texte): n = extraire_nombre(texte)return n isnotNoneand n == attendureturn _vdef pass_at_k(n, c, k):if n - c < k:return1.0return1.0- math.comb(n - c, k) / math.comb(n, k)print(f"Suite : {sum(len(v) for v in PROBLEMES.values())} problemes, "f"buckets={list(PROBLEMES)} | heritee de NB-16 (comparaison equitable).")
Suite : 6 problemes, buckets=['facile', 'moyen', 'difficile'] | heritee de NB-16 (comparaison equitable).
Lecture : La configuration des problèmes utilise 6 échantillons par problème, répartis dans 3 buckets de difficulté : facile, moyen, difficile. L’héritage de NB-16 garantit une comparaison équitable avec des benchmarks précédents.
2. Baseline non-reasoning — BoN pass@k (cout en tokens)
Sur le modèle standard (llama-3.3-70b, 0 token de raisonnement), on genere n echantillons et on mesure pass@k. Cle : on enregistre aussi les tokens cumules (k echantillons = k couts), pour normaliser la comparaison contre le modèle a raisonnement.
N_ECHANTILLONS =6if BATCH_MODE else12K_LIST = [1, 2, 4, 6]# Pour chaque probleme : n echantillons + (correct?, tokens de cet echantillon)base = {b: [] for b in PROBLEMES} # liste de (liste_de_corrects, liste_de_tokens)print(f"BoN baseline : {N_ECHANTILLONS} echantillons / probleme sur {BASELINE_MODEL}")for bucket, probs in PROBLEMES.items():for enonce, attendu in probs: verif = est_correct(attendu) corrects, toks = [], []for _ inrange(N_ECHANTILLONS): txt, tot, _ = chat_usage(enonce, model=BASELINE_MODEL, temperature=0.8, max_tokens=80) corrects.append(int(verif(txt))); toks.append(tot) base[bucket].append((corrects, toks))print(f" bucket {bucket:9s} : collecte OK")# pass@k moyen + tokens cumules moyens par bucketprint("\n=== Baseline non-reasoning (BoN) ===")header ="bucket | "+" | ".join(f"pass@{k} (tok)"for k in K_LIST)print(header);print("-"*len(header))base_curve = {b: {"pass": {}, "tok": {}} for b in PROBLEMES} # pour la figurefor b in PROBLEMES: row_p, row_t = [], []for k in K_LIST: ps, ts = [], []for corrects, toks in base[b]: c =sum(corrects[:N_ECHANTILLONS]); ps.append(pass_at_k(N_ECHANTILLONS, c, k)) ts.append(sum(toks[:k])) # tokens des k premiers echantillons base_curve[b]["pass"][k] =sum(ps)/len(ps); base_curve[b]["tok"][k] =sum(ts)/len(ts) row_p.append(f"{sum(ps)/len(ps):.2f}") row_t.append(f"{int(sum(ts)/len(ts))}")print(f"{b:11s} | "+" | ".join(f"{p} ({t})"for p, t inzip(row_p, row_t)))print("Legendre : pass@k (tokens cumules moyens sur les k echantillons).")
BoN baseline : 6 echantillons / probleme sur meta-llama/llama-3.3-70b-instruct
  bucket facile    : collecte OK
  bucket moyen     : collecte OK
  bucket difficile : collecte OK

=== Baseline non-reasoning (BoN) ===
bucket      | pass@1 (tok) | pass@2 (tok) | pass@4 (tok) | pass@6 (tok)
-----------------------------------------------------------------------
facile      | 1.00 (30) | 1.00 (73) | 1.00 (171) | 1.00 (281)
moyen       | 1.00 (71) | 1.00 (134) | 1.00 (260) | 1.00 (386)
difficile   | 0.25 (73) | 0.40 (146) | 0.50 (292) | 0.50 (438)
Legendre : pass@k (tokens cumules moyens sur les k echantillons).
Lecture : Les résultats du baseline non-reasoning (BoN) montrent que pour le bucket facile, le modèle atteint 100% de réussite dès pass@1 (30 tokens). Le bucket moyen est déjà à 100% dès pass@1 (71 tokens). Le bucket difficile atteint seulement 25% à pass@1 et 50% à pass@4/6, illustrant la limitation du scaling manuel pour les problèmes complexes.
3. Raisonnement natif — deepseek-r1 single-shot
Le modèle a raisonnement natif est appele une seule fois par problème (single-shot). Il depense ses tokens de test-time compute en interne (reasoning tokens, caches). On enregistre le total tokens (prompt + completion + raisonnement) comme cout.
# Single-shot du modele a raisonnement, par probleme. (succes, total_tokens, reasoning_tokens)reason = {b: [] for b in PROBLEMES}print(f"Raisonnement natif : single-shot {REASONING_MODEL}")for bucket, probs in PROBLEMES.items():for enonce, attendu in probs: verif = est_correct(attendu) txt, tot, rt = chat_usage(enonce, model=REASONING_MODEL, temperature=0.0, max_tokens=2000) reason[bucket].append((int(verif(txt)), tot, rt)) succ =sum(r[0] for r in reason[bucket]); n =len(reason[bucket]) avg_tok =sum(r[1] for r in reason[bucket]) / n avg_rt =sum(r[2] for r in reason[bucket]) / nprint(f" bucket {bucket:9s} : single-shot {succ}/{n} = {succ/n:.2f} | "f"avg total_tokens={avg_tok:.0f} (dont reasoning={avg_rt:.0f})")
Lecture : Le raisonnement natif avec deepseek-r1 atteint 100% de réussite en single-shot pour tous les buckets (facile, moyen, difficile), avec respectivement 232, 553 et 1213 tokens totaux. Le ratio raisonnement/tokens totaux est élevé : 172/232 (74%) pour facile, 442/553 (80%) pour moyen, et 1094/1213 (90%) pour difficile, démontrant que le modèle utilise intensément le raisonnement pour les problèmes complexes.
Lecture complémentaire : La structure du coût par bucket est révélatrice — la part hors raisonnement (total moins reasoning) reste quasi stable : 60 tokens en facile (232-172), 111 en moyen (553-442), 119 en difficile (1213-1094) — alors que le budget de raisonnement passe de 172 à 1094 (x6,4) : l’escalier de coût 232 -> 553 -> 1213 est porté par le raisonnement, pas par l’énoncé ni la réponse.
4. Comparaison cost-normalisee (la question Snell, Snell et al 2024)
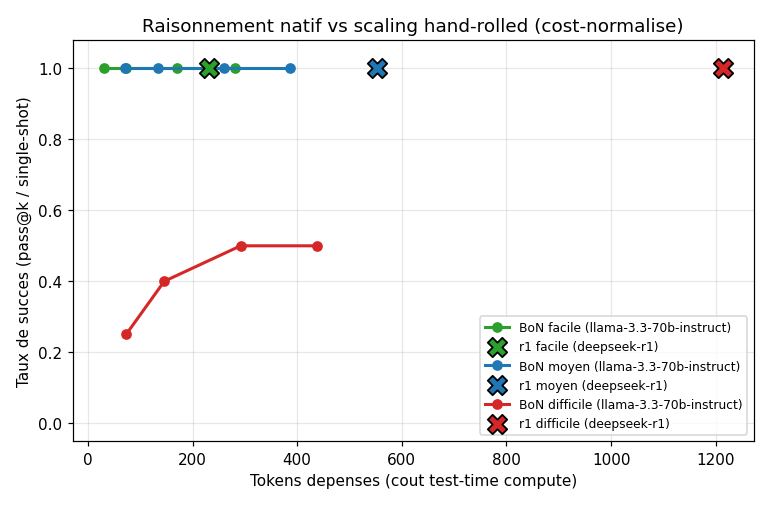
On superpose, sur un axe x = tokens depenses, : - la courbe BoN du modèle standard (pass@k vs tokens cumules, par bucket), - le point du modèle a raisonnement (single-shot solve-rate vs ses tokens, par bucket).
Si le point du modèle a raisonnement est au-dessus de la courbe BoN au même token-budget, le raisonnement natif gagne au cout-egal ; s’il est en-dessous, le scaling hand-rolled est plus compute-efficace (le résultat de Snell : hand-rolled compute-optimal peut valoir un modèle plus gros).
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltfrom IPython.display import display, Imageimport iofig, ax = plt.subplots(figsize=(7.0, 4.6))couleurs = {"facile": "#2ca02c", "moyen": "#1f77b4", "difficile": "#d62728"}for b in PROBLEMES: xs = [base_curve[b]["tok"][k] for k in K_LIST] ys = [base_curve[b]["pass"][k] for k in K_LIST] ax.plot(xs, ys, "-o", color=couleurs[b], linewidth=2, markersize=6, label=f"BoN {b} ({BASELINE_MODEL.split('/')[-1]})")# point du modele a raisonnement (croix) sur la meme bucket r_succ =sum(r[0] for r in reason[b]) /len(reason[b]) r_tok =sum(r[1] for r in reason[b]) /len(reason[b]) ax.scatter([r_tok], [r_succ], marker="X", s=160, color=couleurs[b], edgecolor="black", linewidth=1.2, zorder=5, label=f"r1 {b} ({REASONING_MODEL.split('/')[-1]})")ax.set_xlabel("Tokens depenses (cout test-time compute)")ax.set_ylabel("Taux de succes (pass@k / single-shot)")ax.set_title("Raisonnement natif vs scaling hand-rolled (cost-normalise)")ax.set_ylim(-0.05, 1.08); ax.grid(True, alpha=0.3)ax.legend(fontsize=8, loc="lower right", ncol=1)buf = io.BytesIO(); fig.tight_layout(); fig.savefig(buf, format="png", dpi=110); plt.close(fig)buf.seek(0); display(Image(data=buf.read()))print("Lecture : pour chaque bucket, la courbe = BoN (scaling exterieur), la croix = r1")print("(raisonnement natif). Si la croix est au-dessus de la courbe au meme cout -> le raisonnement")print("natif gagne ; sinon -> le scaling hand-rolled est plus compute-efficace (Snell).")
Lecture : pour chaque bucket, la courbe = BoN (scaling exterieur), la croix = r1
(raisonnement natif). Si la croix est au-dessus de la courbe au meme cout -> le raisonnement
natif gagne ; sinon -> le scaling hand-rolled est plus compute-efficace (Snell).
Lecture : La visualisation compare les deux approches. La courbe représente le BoN (scaling externe manuel), tandis que la croix représente le raisonnement natif (r1). Pour chaque bucket, si la croix est au-dessus de la courbe au même coût, le raisonnement natif est plus efficace.
# Tableau synthetique : au cout du single-shot r1, ou en serait le BoN ?print("=== Verdict cost-normalise (par bucket) ===")print(f"{'bucket':11s} | {'r1 single-shot':>16s} | {'BoN @ meme cout':>16s} | gagnant")print("-"*70)for b in PROBLEMES: r_succ =sum(r[0] for r in reason[b]) /len(reason[b]) r_tok =sum(r[1] for r in reason[b]) /len(reason[b])# pass@k BoN le plus proche (en tokens) du cout r1 (interpolation naive: prend le k le plus proche) k_best =min(K_LIST, key=lambda k: abs(base_curve[b]["tok"][k] - r_tok)) bon_at = base_curve[b]["pass"][k_best] bon_tok = base_curve[b]["tok"][k_best] gagnant ="r1 (raisonnement)"if r_succ > bon_at +0.01else\ ("BoN (scaling)"if bon_at > r_succ +0.01else"egal / bruit")print(f"{b:11s} | {r_succ:>7.2f} ({r_tok:>5.0f} tok) | {bon_at:>7.2f} ({bon_tok:>5.0f} tok) | {gagnant}")print("\nLecture honnete (G.2) : n petit, bruit eleve -> tracer la conclusion avec")print("prudence. La METHODE (cost-normalise tokens-incl-reasoning) est transferable.")
Lecture : Le verdict cost-normalisé montre que pour le bucket difficile, le raisonnement natif (r1) avec 1213 tokens obtient 100% de réussite, tandis que le BoN avec 438 tokens n’obtient que 50%. Les buckets facile et moyen montrent une égalité entre les deux approches, mais la méthode de comparaison cost-normalisée (tokens incluant le raisonnement) reste valide malgré le bruit dû au petit échantillon.
5. Limites honnetes (G.2)
n petit (12 echantillons) : pass@k bruite ; les points du modèle a raisonnement sont estimes sur 2 problemes par bucket (bruit fort). Snell utilise des milliers d’evaluations.
Une seule comparaison modèle (deepseek-r1 vs llama-3.3-70b) : le verdict depend du couple de modèles. Snell compare a un modèle 14x plus gros ; ici le rapport de taille/cout differe.
Suite simple : sur de l’arithmetique, le bucket difficile peut saturer chez r1 (1.0) tandis que le BoN plafonne — ce qui ferait gagner r1, mais c’est parce que r1 est un modèle plus fort, pas seulement parce qu’il raisonne. Desintriquer “taille du modèle” et “test-time compute natif” necessiterait une comparaison a qualite de modèle compareble (exercice 2) — non resolu ici, assume franchement.
Cout = tokens (approximation) : le vrai cout OpenRouter est en $, non en tokens ; on normalise en tokens parce que c’est model-agnostique et que les reasoning tokens sont ainsi comptabilises. Le cout $ depend des prix respectifs (exercice 3).
Ce qui est demontre : la methodologie de comparaison cost-normalisee (courbe tokens-vs-pass du scaling hand-rolled + point du modèle a raisonnement) — reproductible et applicable a d’autres couples de modèles / suites plus difficiles.
6. Travaux pratiques
Les exercices sont a completer (convention C.1 : pas d’erreur volontaire).
Exercice 1 : plusieurs modèles a raisonnement (frontiere)
Trace la même comparaison cost-normalisee avec plusieurs modèles a raisonnement (deepseek-r1, o3-mini, gpt-5-thinking) : chaque modèle = un point. Construis la frontiere de Pareto (modèles dominates elimines) tokens-vs-succes.
Indice : boucle sur une liste de REASONING_MODELS, collecte (tokens, succes) par bucket, trace tous les points + enveloppe de Pareto (un point est Pareto-optimal si aucun autre n’a a la fois moins de tokens ET plus de succes).
def frontiere_pareto_raisonnement(modeles):"""Exercice 1 : points (tokens, succes) de plusieurs modeles a raisonnement + frontiere."""# TODO etudiant : pour chaque modele, single-shot sur PROBLEMES, collecter (tok, succ),# renvoyer la liste + l'indice des points Pareto-optimaux.returnNoneprint(f"Exercice 1 - frontiere Pareto raisonnement : {'implemente'ifFalseelse'a completer'}")
Exercice 1 - frontiere Pareto raisonnement : a completer
Exercice 2 : desintriquer “taille du modèle” vs “raisonnement natif”
Le verdict Phase 5 confond “r1 est plus gros/meilleur” et “r1 raisonne”. Desintrique : compare le BoN sur r1 mode raisonnement off (si disponible) vs r1 raisonnement on, au même budget tokens. Le delta isole l’apport du test-time compute natif.
Indice : certains modèles exposent un paramètre “reasoning_effort” (low/medium/high) ou un modèle “non-thinking” jumeau. Compare pass@k a budget tokens egal entre effort=low et high.
def isoler_apport_raisonnement(model_high, model_low, enonce, attendu):"""Exercice 2 : compare single-shot raisonnement on vs off, a budget tokens compare."""# TODO etudiant : appeler les deux variantes, retourner (succes_high, tok_high, succ_low, tok_low).returnNoneprint(f"Exercice 2 - taille vs raisonnement : {'implemente'ifFalseelse'a completer'}")
Exercice 2 - taille vs raisonnement : a completer
Exercice 3 (avance) : cout en dollars (OpenRouter)
Refais la comparaison en dollars (pas tokens) : recupere le prix input/output/reasoning de chaque modèle (API OpenRouter /models ou tarifs publics) et calcule le cout $ reel de chaque stratégie. La frontiere tokens-vs-succes peut inverser en $ (si le modèle a raisonnement est beaucoup plus cher par token).
Indice : GET https://openrouter.ai/api/v1/models -> pricing.prompt/completion/completion_reasoning par modèle ; calcule cout = tok_promptprompt + tok_completioncompletion (+ reasoning*raisonnement).
def cout_dollars(model, tok_prompt, tok_completion, tok_reasoning=0):"""Exercice 3 : cout $ reel d'un appel via la tarification OpenRouter."""# TODO etudiant : requeter /api/v1/models, extraire pricing, calculer le cout $.returnNoneprint(f"Exercice 3 - cout en dollars : {'implemente'ifFalseelse'a completer'}")
Exercice 3 - cout en dollars : a completer
7. Conclusion et suite
On a compare, a cout normalise en tokens (raisonnement inclus), le scaling hand-rolled (BoN pass@k sur un modèle standard) au raisonnement natif (single-shot deepseek-r1), sur la même suite graduee. La figure superpose la courbe tokens-vs-pass du BoN et le point du modèle a raisononnement par bucket — la question centrale de Snell : a cout egal, qui gagne ?
Ce qui est demontre : la methodologie de comparaison cost-normalisee — equitable (même suite, même verificateur) et transferable (autres couples de modèles, autres suites).
Limites honnetes (G.2) : n petit, une seule comparaison de modèles, suite simple, cout en tokens (approximation du $). Le verdict depend du couple de modèles et du bucket ; il faut le lire avec prudence et l’etendre (exercices 1-3) avant de generaliser.
Suite de l’epic #2926 : - Phase 6 — plugin Semantic Kernel : integrer les moteurs (BoN/ToT/Reflexion/memory) comme plugins SK (pont series SemanticKernel), exposant le test-time scaling comme outil reutilisable.
References
Snell, Lee, Xu & Kumar (2024), Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, arXiv:2408.03314 (ICLR 2025). — La « question Snell » centrale de ce notebook (§4) : à coût (tokens) égal, le raisonnement natif bat-il le scaling hand-rolled (BoN pass@k) ?
Chen et al. (2021), Evaluating Large Language Models Trained on Code, arXiv:2107.03374. — Origine de la métrique pass@k et du benchmark HumanEval (estimateur non-biaisé utilisé §1).
Lightman et al. (2023), Let’s Verify Step by Step, arXiv:2305.20050 (ICLR 2024). — Origine des process reward models (PRM) : le « vérificateur » à étapes qui sous-tend le scoring des réponses vérifiables.