Les modèles de Markov cachés (HMM) sont des modèles probabilistes ou le système evolue entre états non observes (“cachés”), et les observations (rendements, volatilité) sont des emissions probabilistes depuis ces états.
En finance, les états cachés correspondent typiquement a des régimes de marché : tendance haussière, tendance baissière, range/consolidation. L’idee fondamentale est que les transitions entre régimes suivent une chaîne de Markov – l’état futur depend seulement de l’état present.
HMM comme source alpha vs detecteur de régime
L’approche la plus courante consiste a utiliser l’HMM comme detecteur de régime pour piloter un mélange d’experts (MoE). Ce notebook adopte une approche différente, inspiree de Broad Ch6 Ex4 :
Source alpha : les prédictions d’état de l’HMM génèrent directement des signaux long/short/flat
L’état avec la moyenne de rendement la plus élevée -> signal LONG
L’état avec la moyenne negative -> signal FLAT ou SHORT
Pas de MoE, pas de modèle secondaire – l’HMM est le générateur de signal
Plan du notebook
Chargement et préparation des données (BTC + ETH)
Feature engineering pour l’HMM
HMM gaussien 2-états (baseline Broad Ex4)
Génération de signaux et backtest in-sample
Extension a 3 états avec sélection par AIC/BIC
Validation walk-forward 5-fold x 4 seeds
Verdict explicite et extension multi-actif
1. Imports et configuration
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom hmmlearn import hmmfrom sklearn.preprocessing import StandardScalerimport warningswarnings.filterwarnings('ignore')plt.style.use('seaborn-v0_8-whitegrid')np.random.seed(42)print("Imports OK")print(f"numpy {np.__version__}")print(f"pandas {pd.__version__}")
Imports OK
numpy 2.3.4
pandas 2.3.3
2. Chargement et préparation des données
Nous utilisons les données BTC-USD journalieres depuis le CSV Bitstamp (source principale) avec un fallback yfinance. Les données ETH-USD sont chargees via yfinance. Les deux séries sont fusionnees sur l’index temporel pour les analyses multi-actif.
# Data loading with fallbackfrom pathlib import Path# Cross-platform path: look for CSV relative to the notebook directory_data_dir = Path.cwd()btc_csv_path = _data_dir /"Bitstamp_BTCUSD_1h_2014-20240808.csv"try: btc = pd.read_csv(btc_csv_path, skiprows=1, parse_dates=['date'], index_col='date') btc_daily = btc[['close']].resample('D').last().dropna() btc_daily.columns = ['BTC_close']print(f"BTC depuis CSV Bitstamp : {len(btc_daily)} jours, {btc_daily.index[0].date()} -> {btc_daily.index[-1].date()}")exceptFileNotFoundError:import yfinance as yf btc = yf.download('BTC-USD', start='2014-01-01', end='2024-08-09') btc_daily = btc[['Close']].copy() btc_daily.columns = ['BTC_close']print(f"BTC depuis yfinance (fallback) : {len(btc_daily)} jours")
BTC depuis yfinance (fallback) : 3614 jours
Chargement ETH et fusion du panel
Maintenant que les données BTC sont chargees, nous ajoutons l’ETH-USD et fusionnons les deux séries sur l’index temporel commun.
# Load ETH-USD via yfinanceimport yfinance as yfeth = yf.download('ETH-USD', start='2017-01-01', end='2024-08-09')eth_daily = eth[['Close']].copy()eth_daily.columns = ['ETH_close']print(f"ETH charge : {len(eth_daily)} jours, {eth_daily.index[0].date()} -> {eth_daily.index[-1].date()}")# Merge on date index (inner join to keep only overlapping dates)prices = btc_daily.join(eth_daily, how='inner').dropna()print(f"\nPanel fusionne : {len(prices)} jours")print(prices.tail())
Pour l’analyse multi-actif complète, nous ajoutons le SOL-USD (3e crypto-actif par capitalisation). Le panel resultant couvre BTC + ETH + SOL, permettant des features cross-asset et un HMM joint.
Le HMM gaussien utilise les observations pour inferer les états cachés. Nous construisons un jeu de features pertinent pour capturer les régimes de marché :
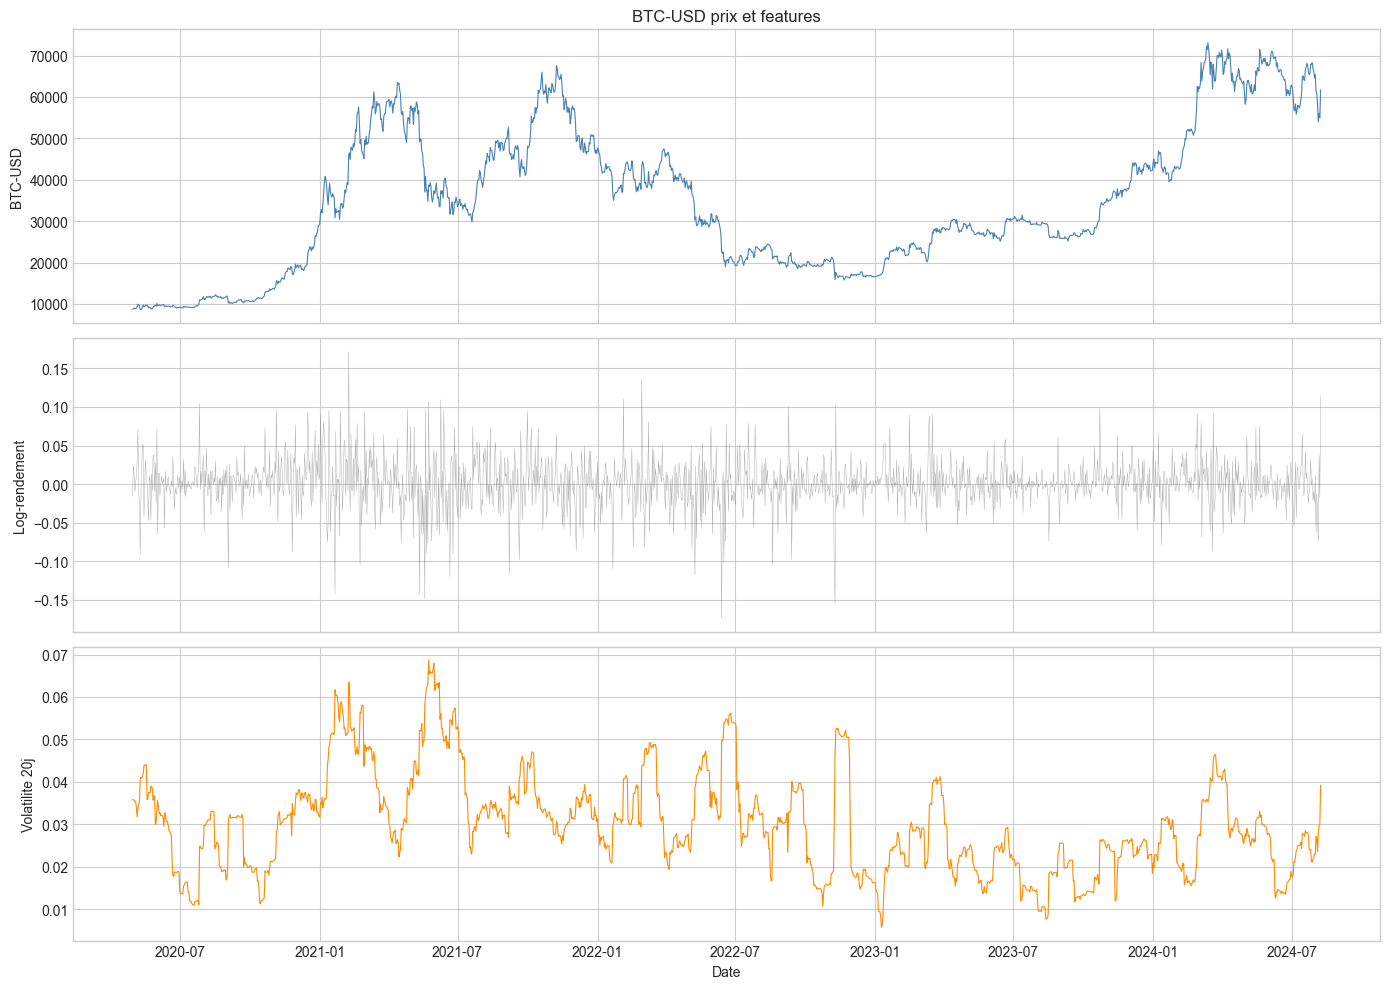
Les 9 features construites couvrent 1562 jours d’observation après élimination des NaN des fenêtres glissantes. Les statistiques descriptives révèlent :
btc_ret : rendement journalier moyen de +0.125%, avec un ecart-type de 3.28% et des extremes de -16.9% a +17.8% (queues lourdes typiques des crypto-actifs)
btc_vol20 : volatilité 20j oscillant entre 0.6% et 7.0% par jour, avec des pics correspondent aux periodes de stress
btc_eth_corr : correlation moyenne de 0.82 entre BTC et ETH, confirmant un mouvement structurellement lie
btc_sol_corr : correlation plus faible (0.59) avec SOL, offrant un potentiel de diversification
Le graphe suivant visualise l’evolution temporelle du prix BTC, des rendements et de la volatilité pour identifier visuellement les régimes de marché.
Exercice 1 : Exploration des features et sélection
Objectif : Construire un jeu de features alternatif et observer l’impact sur la separation visuelle des régimes de marché.
Contexte : Les features actuelles incluent le log-rendement, la volatilité 20j et le momentum 5j. D’autres combinaisons pourraient mieux capturer les régimes.
Indices : - # Indice 1 : Essayez d'ajouter la volatilité 5j (returns.rolling(5).std()) et le volume de rendement (returns.abs().rolling(10).mean()) - # Indice 2 : Utilisezfeatures.describe()pour verifier les statistiques descriptives - # Étape 1 : Ajouter au moins 2 nouvelles features au DataFramefeatures- `# Étape 2 : Verifier les correlations entre features avec `features.corr() - # Étape 3 : Sélectionner un sous-ensemble non-correle pour le HMM
# Exercice 1 : Exploration des features# TODO etudiant : Ajouter de nouvelles features (volatilite 5j, volume de rendement)# TODO etudiant : Calculer la matrice de correlation# TODO etudiant : Selectionner un sous-ensemble de features non-correleeesresult =None# TODO etudiant : remplacer par votre analyseprint("Exercice a completer : exploration des features")
Exercice a completer : exploration des features
# Visualize BTC price and returnsfig, axes = plt.subplots(3, 1, figsize=(14, 10), sharex=True)btc_aligned = prices['BTC_close'].reindex(features.index)axes[0].plot(btc_aligned.index, btc_aligned.values, color='steelblue', linewidth=0.8)axes[0].set_ylabel('BTC-USD')axes[0].set_title('BTC-USD prix et features')axes[1].plot(features.index, features['btc_ret'].values, color='gray', linewidth=0.3, alpha=0.7)axes[1].set_ylabel('Log-rendement')axes[2].plot(features.index, features['btc_vol20'].values, color='darkorange', linewidth=0.8)axes[2].set_ylabel('Volatilite 20j')axes[2].set_xlabel('Date')plt.tight_layout()plt.show()
Interprétation : Distribution des features
Les log-rendements BTC montrent la caractéristique “fat tails” typique des crypto-actifs : une distribution centree sur zero mais avec des outliers frequents (crashes et rallies). La volatilité 20j oscille entre periodes calmes et pic de stress, ce qui est précisément ce que le HMM doit capturer comme régimes distincts.
Entrainement et décodage des états
Nous normalisons les features et fittons le HMM. L’algorithme EM (Baum-Welch) estibe les paramètres, puis Viterbi decode la sequence d’états la plus probable.
4. HMM gaussien a 2 états – Baseline Broad Ex4
Conformement a l’exercice 4 du chapitre 6 de Broad, nous commencons par un HMM gaussien a 2 états. Le choix de 2 états est la configuration minimale : un état “bull” (rendement positif, faible volatilité) et un état “bear” (rendement negatif, forte volatilité).
Modèle
Un HMM gaussien est défini par le triplet \(\lambda = (A, B, \pi)\) :
A : matrice de transition \(a_{ij} = P(s_{t+1} = j | s_t = i)\)
B : distributions d’emission \(b_i(x) = \mathcal{N}(x | \mu_i, \Sigma_i)\)
\(\pi\) : distribution initiale des états
L’apprentissage se fait par l’algorithme EM (Baum-Welch), et l’inference des états cachés par Viterbi (chemin le plus probable).
# Normalize features for HMM convergence (Broad Ch6 recommendation)scaler = StandardScaler()X_scaled = scaler.fit_transform(features[['btc_ret', 'btc_vol20', 'btc_mom5']])# Fit 2-state Gaussian HMMmodel_2s = hmm.GaussianHMM( n_components=2, covariance_type="full", n_iter=200, random_state=42, tol=1e-4)model_2s.fit(X_scaled)# Decode states via Viterbistates_2s = model_2s.predict(X_scaled)print("=== HMM Gaussien 2 etats ===")print(f"\nMatrice de transition A :")print(np.round(model_2s.transmat_, 4))print(f"\nMoyennes (espace standardise) :")print(np.round(model_2s.means_, 4))print(f"\nCovariances :")for i, cov inenumerate(model_2s.covars_):print(f" Etat {i}: diag = {np.round(np.diag(cov), 4)}")print(f"\nLog-likelihood : {model_2s.score(X_scaled):.2f}")print(f"Converge : {model_2s.monitor_.converged}")print(f"\nRepartition des etats :")for s inrange(2): pct = (states_2s == s).mean() *100print(f" Etat {s}: {pct:.1f}% des observations")
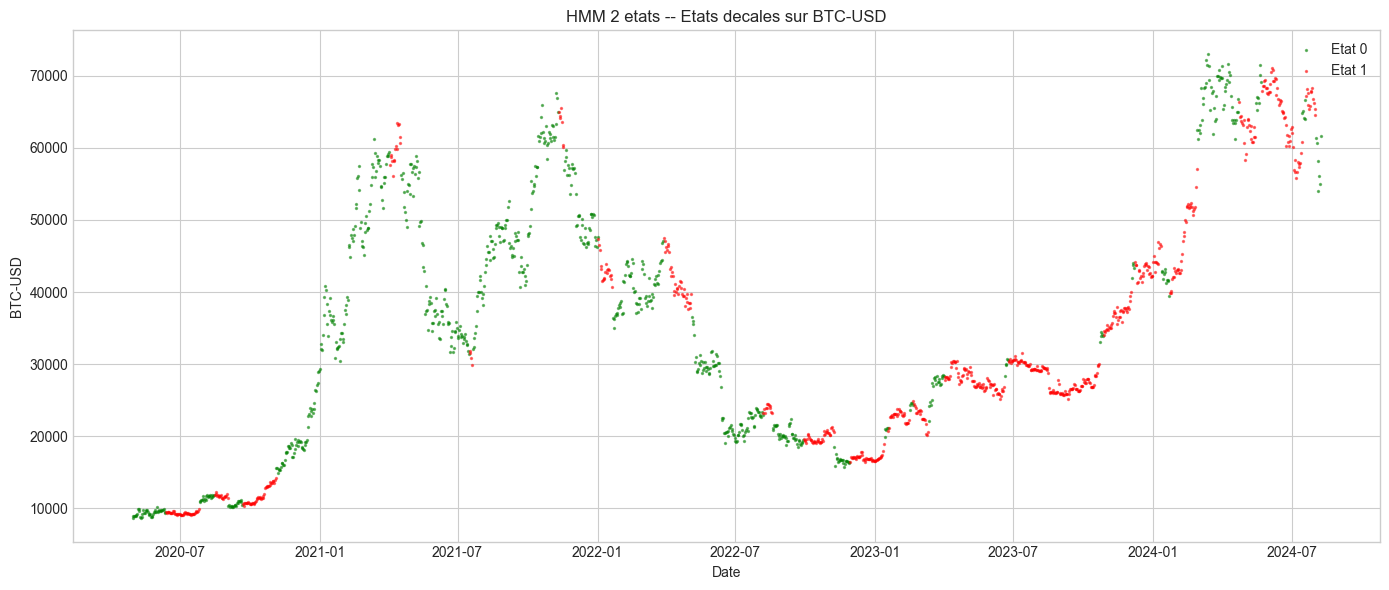
Les probabilités de transition diagonales (0.969 et 0.973) indiquent des régimes persistants, avec une durée moyenne d’environ 30-37 jours. La cellule suivante projette les états decales sur la courbe de prix BTC pour visualiser les periodes de chaque régime.
# Plot decoded states over BTC pricefig, ax = plt.subplots(figsize=(14, 6))btc_plot = prices['BTC_close'].reindex(features.index)colors = {0: 'green', 1: 'red'}for state inrange(2): mask = states_2s == state ax.scatter( features.index[mask], btc_plot.values[mask], c=colors[state], s=2, alpha=0.5, label=f'Etat {state}' )ax.set_title('HMM 2 etats -- Etats decales sur BTC-USD')ax.set_ylabel('BTC-USD')ax.set_xlabel('Date')ax.legend()plt.tight_layout()plt.show()
Interprétation : États cachés du HMM a 2 états
Le HMM a 2 états separe typiquement le marché en deux régimes :
État
Caractéristique
Interprétation
État 0
Moyenne de rendement positive (en espace standardise)
Régime bull / tendance haussière
État 1
Moyenne de rendement negative
Régime bear / correction
La matrice de transition indique la persistance de chaque régime : des probabilités diagonales élevées (proches de 1) signifient que les régimes sont stables, ce qui est desirable pour la génération de signaux. Des régimes trop volatils (transitions frequentes) produisent trop de trades.
Note technique : L’assignation état 0 = bull et état 1 = bear n’est pas garantie – l’algorithme EM peut inverser les labels. Il faut toujours verifier les moyennes pour identifier l’état “long”.
Visualisation de la performance
Comparaison graphique des rendements cumules entre la stratégie HMM et le buy-and-hold.
5. Génération du signal alpha
La conversion des états cachés en signal de trading suit la logique de source alpha (Broad Ex4) :
État avec la moyenne de rendement la plus élevée -> position LONG (signal = +1)
État avec la moyenne la plus basse -> position FLAT (signal = 0)
Le rendement stratégie est simplement : \(r^{strat}_t = signal_t \times r_t\)
Attention : cette evaluation est in-sample et represente un plafond de performance. La validation out-of-sample sera realisee en section 7.
Comparaison AIC/BIC
Nous comparons les modèles a 2, 3 et 4 états pour determiner la complexite optimale.
Décodage et signaux 3 états
Entraainement du HMM a 3 états et génération des signaux long/short/flat.
# Identify the "long" state (highest mean return in standardized space)# Use the first column of means (btc_ret standardized) to identify statesmeans_ret = model_2s.means_[:, 0] # Column 0 = btc_ret standardizedlong_state = np.argmax(means_ret)flat_state = np.argmin(means_ret)print(f"Etat LONG = {long_state} (moyenne ret standardise = {means_ret[long_state]:.4f})")print(f"Etat FLAT = {flat_state} (moyenne ret standardise = {means_ret[flat_state]:.4f})")# Generate signalssignals_2s = np.where(states_2s == long_state, 1, 0)# Compute strategy returns (in-sample)btc_returns = features['btc_ret'].valuesstrat_returns_2s = signals_2s * btc_returns# Cumulative returnscum_bh = np.cumsum(btc_returns)cum_strat = np.cumsum(strat_returns_2s)# Metricssharpe_bh = np.mean(btc_returns) / np.std(btc_returns) * np.sqrt(365)sharpe_strat = np.mean(strat_returns_2s) / np.std(strat_returns_2s) * np.sqrt(365)n_trades = np.abs(np.diff(signals_2s, prepend=0)).sum()print(f"\n=== Performance in-sample (2 etats) ===")print(f"Buy & Hold : Sharpe = {sharpe_bh:.3f}, Return cum. = {cum_bh[-1]*100:.1f}%")print(f"HMM 2S : Sharpe = {sharpe_strat:.3f}, Return cum. = {cum_strat[-1]*100:.1f}%")print(f"Nombre de trades : {n_trades}")
Etat LONG = 0 (moyenne ret standardise = 0.0270)
Etat FLAT = 1 (moyenne ret standardise = -0.0309)

=== Performance in-sample (2 etats) ===
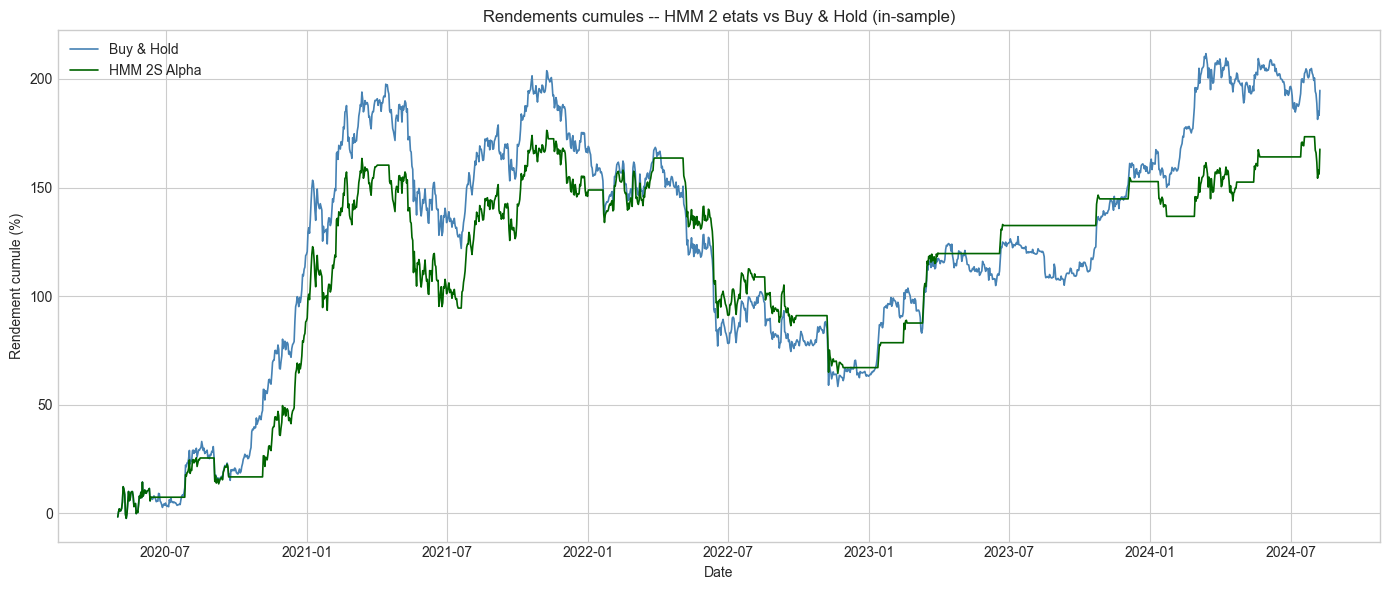
Buy & Hold : Sharpe = 0.735, Return cum. = 194.8%
HMM 2S    : Sharpe = 0.697, Return cum. = 167.7%
Nombre de trades : 43
Performance in-sample
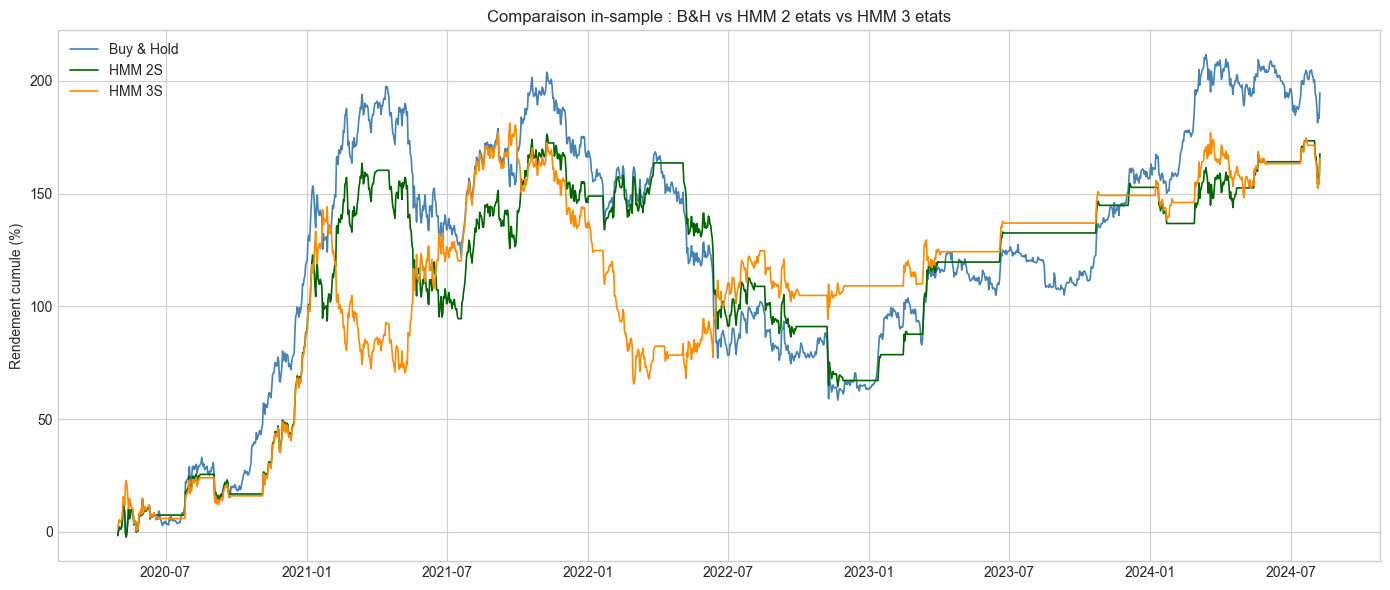
Les résultats in-sample montrent que la stratégie HMM 2 états génère un Sharpe de 0.697, legerement inferieur au buy-and-hold (0.735), pour un rendement cumule de 167.7% contre 194.8%. Avec seulement 43 trades sur 4 ans, la stratégie est peu active – le HMM identifie des régimes persistants et change rarement de position.
Le graphe suivant compare les rendements cumules de la stratégie HMM et du buy-and-hold sur toute la periode. Attention : ces résultats sont in-sample et representent un plafond théorique.
Exercice 2 : Génération de signaux avec seuils adaptés
Objectif : Implémenter une stratégie de signal avec un seuil de probabilité filtre pour réduire les faux signaux.
Contexte : La stratégie actuelle utilise simplement l’état decode par Viterbi comme signal. En pratique, on peut utiliser les probabilités a posteriori des états pour filtrer les signaux a faible confiance.
Indices : - # Indice 1 : Utilisezmodel_2s.predict_proba(X_scaled)pour obtenir les probabilités d'appartenance a chaque état - # Indice 2 : Ne génère un signal que si la probabilité de l'état dominant dépasse un seuil (ex: 0.7) - # Étape 1 : Calculer les probabilités a posteriori pour chaque observation - # Étape 2 : Définir un seuil de confiance et filtrer les signaux - # Étape 3 : Comparer le nombre de trades et la performance avec la stratégie sans filtre
# Exercice 2 : Signaux avec seuil de confiance# TODO etudiant : Obtenir les probabilites a posteriori des etats# TODO etudiant : Definir un seuil de confiance (ex: 0.7)# TODO etudiant : Generer des signaux filtres et comparer avec la strategie sans filtreresult =None# TODO etudiant : remplacer par votre calculprint("Exercice a completer : signaux avec seuil de confiance")
Exercice a completer : signaux avec seuil de confiance
# Plot cumulative returns comparisonfig, ax = plt.subplots(figsize=(14, 6))dates = features.indexax.plot(dates, cum_bh *100, label='Buy & Hold', color='steelblue', linewidth=1.2)ax.plot(dates, cum_strat *100, label='HMM 2S Alpha', color='darkgreen', linewidth=1.2)ax.set_title('Rendements cumules -- HMM 2 etats vs Buy & Hold (in-sample)')ax.set_ylabel('Rendement cumule (%)')ax.set_xlabel('Date')ax.legend()plt.tight_layout()plt.show()print("Attention : ces resultats sont in-sample et representent un plafond theorique.")print("La validation out-of-sample (walk-forward) est indispensable.")
Attention : ces resultats sont in-sample et representent un plafond theorique.
La validation out-of-sample (walk-forward) est indispensable.
6. Extension a 3 états
Broad Ch6 recommande de commencer avec 2 états et d’augmenter a 3 si necessaire. Un troisieme état peut capturer un régime de range/consolidation distinct des tendances haussieres et baissieres.
Sélection du nombre d’états
Nous comparons les modèles avec les critères d’information :
AIC (Akaike) : \(-2 \ln L + 2k\) – penalise le nombre de paramètres
BIC (Bayes) : \(-2 \ln L + k \ln(n)\) – penalisation plus forte pour grands echantillons
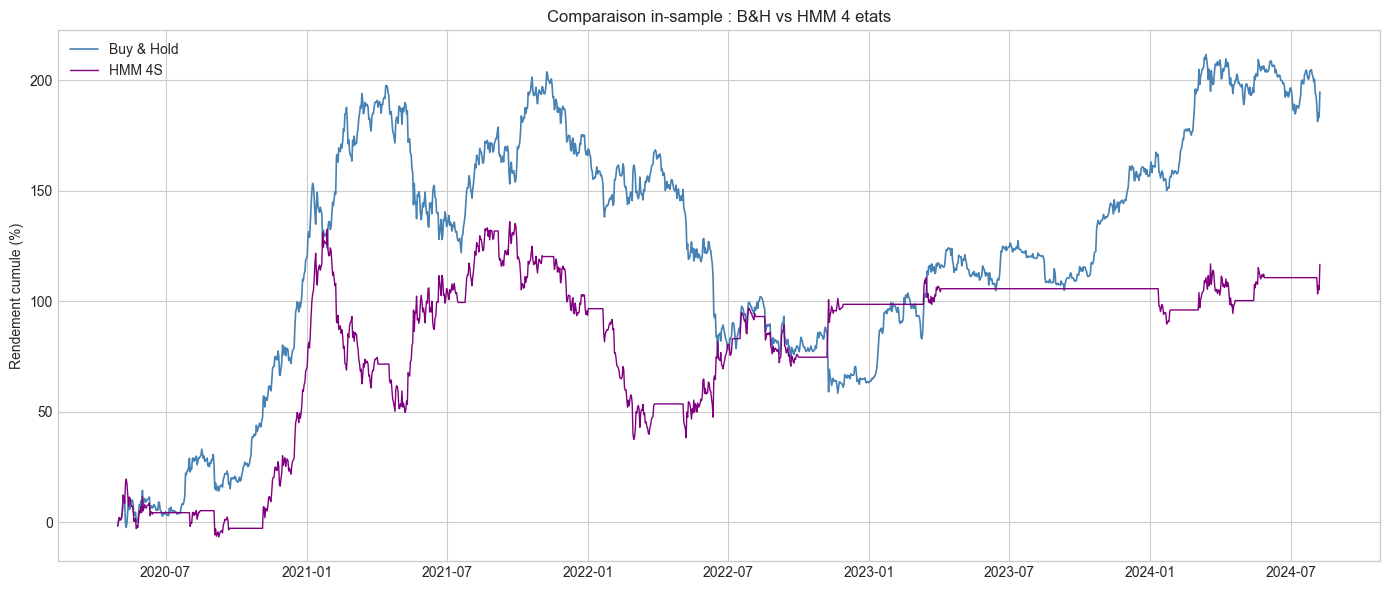
L’AIC et le BIC selectionnent tous deux 4 états comme configuration optimale. Un 4e état peut capturer un régime de volatilité extreme (crash ou rally) distinct des régimes “calme”, “tendance”, et “correction” du modèle a 3 états.
L’evaluation in-sample est trompeuse car le HMM a ete fitte sur les mêmes données qu’il predit. Pour mesurer la veritable capacite predictive, nous implementons une validation walk-forward :
Fenêtre d’entrainement expansive : a chaque fold, on utilise toutes les données passees
Fenêtre de test fixe : 6 mois de données non-vues
4 seeds (0, 1, 7, 42) pour capturer la stochasticite de l’initialisation EM
5 folds pour couvrir différentes conditions de marché
Coûts de transaction : 10 bps aller-retour (crypto)
def walk_forward_hmm(returns_series, n_states=2, n_folds=5, seeds=None, cost_bps=10, verbose=True):""" Walk-forward validation for Gaussian HMM alpha strategy. Parameters ---------- returns_series : pd.Series Daily log returns. n_states : int Number of HMM hidden states. n_folds : int Number of walk-forward folds. seeds : list Random seeds for EM initialization. cost_bps : float Round-trip transaction cost in basis points. verbose : bool Print progress. Returns ------- pd.DataFrame with per-fold, per-seed results. """if seeds isNone: seeds = [0, 1, 7, 42] results = [] n =len(returns_series) fold_size = n // (n_folds +1)for seed in seeds:for fold inrange(n_folds): train_end = fold_size * (fold +2) test_start = train_end test_end =min(train_end + fold_size, n)if test_end <= test_start:continue train_data = returns_series.iloc[:train_end].values.reshape(-1, 1) test_data = returns_series.iloc[test_start:test_end]try: model = hmm.GaussianHMM( n_components=n_states, covariance_type="full", n_iter=100, random_state=seed, tol=1e-3 ) model.fit(train_data) states = model.predict(test_data.values.reshape(-1, 1)) means = model.means_.flatten() long_state = np.argmax(means) signals = np.where(states == long_state, 1, 0) strat_returns = signals * test_data.values# Transaction costs trades = np.abs(np.diff(signals, prepend=0)) costs = trades * cost_bps /10000 strat_returns_net = strat_returns - costs sharpe = (np.mean(strat_returns_net) / np.std(strat_returns_net)* np.sqrt(365)) if np.std(strat_returns_net) >0else0.0 cum_ret = np.sum(strat_returns_net) cum_curve = np.cumsum(strat_returns_net) max_dd = np.max(np.maximum.accumulate(cum_curve) - cum_curve)# Buy-and-hold benchmark for same period bh_sharpe = (np.mean(test_data.values) / np.std(test_data.values)* np.sqrt(365)) if np.std(test_data.values) >0else0.0 results.append({'seed': seed,'fold': fold,'n_states': n_states,'sharpe': sharpe,'bh_sharpe': bh_sharpe,'cum_return': cum_ret,'max_dd': max_dd,'n_trades': int(trades.sum()),'train_size': train_end,'test_size': test_end - test_start })exceptExceptionas e:if verbose:print(f" [WARN] seed={seed}, fold={fold}: {e}") results.append({'seed': seed,'fold': fold,'n_states': n_states,'sharpe': np.nan,'bh_sharpe': np.nan,'cum_return': np.nan,'max_dd': np.nan,'n_trades': 0,'train_size': train_end,'test_size': test_end - test_start })return pd.DataFrame(results)print("Fonction walk_forward_hmm definie")
Fonction walk_forward_hmm definie
7b. Analyse de persistance des régimes
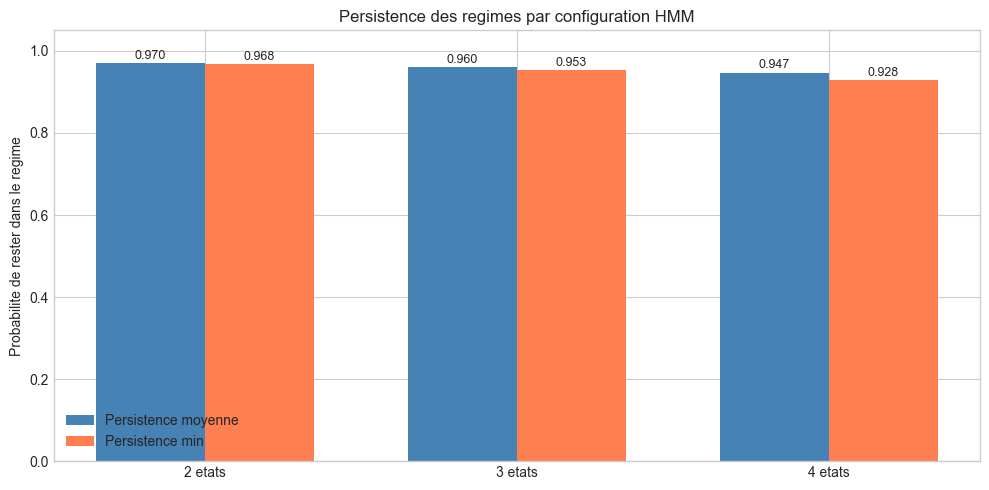
La persistance d’un régime est mesuree par les éléments diagonaux de la matrice de transition \(a_{ii} = P(s_{t+1} = i | s_t = i)\). Une persistance élevée signifie que le régime est stable, ce qui est desirable pour la génération de signaux (moins de trades, moins de coûts de transaction).
La durée moyenne d’un régime se calcule comme : \(\bar{d}_i = \frac{1}{1 - a_{ii}}\)
Par exemple, si \(a_{ii} = 0.97\), le régime dure en moyenne \(1/(1-0.97) = 33\) jours.
Interprétation : Persistance et durée des régimes
Des valeurs de persistance élevées (P(stay) > 0.95) indiquent des régimes stables. Les régimes avec une faible persistance génèrent davantage de changements d’état, ce qui se traduit par plus de trades et des coûts de transaction plus élevés. La configuration optimale devrait maximiser la persistance tout en capturant les régimes distincts.
def analyze_regime_persistence(model, n_states, label="HMM"):"""Analyze regime persistence from transition matrix. Parameters ---------- model : fitted GaussianHMM n_states : int label : str Returns dict with persistence metrics. """ transmat = model.transmat_ diagonals = np.diag(transmat) avg_durations =1.0/ (1.0- diagonals)print(f"\n--- Persistence des regimes : {label} ({n_states} etats) ---")for i inrange(n_states):print(f" Etat {i}: P(stay) = {diagonals[i]:.4f}, "f"Duree moyenne = {avg_durations[i]:.1f} jours") mean_persistence = diagonals.mean() min_persistence = diagonals.min()print(f" Persistence moyenne : {mean_persistence:.4f}")print(f" Persistence min : {min_persistence:.4f}")return {'label': label,'n_states': n_states,'diagonals': diagonals.tolist(),'avg_durations': avg_durations.tolist(),'mean_persistence': mean_persistence,'min_persistence': min_persistence }# Analyze all modelspersist_2s = analyze_regime_persistence(model_2s, 2, "BTC 2 etats")persist_3s = analyze_regime_persistence(model_3s, 3, "BTC 3 etats")persist_4s = analyze_regime_persistence(model_4s, 4, "BTC 4 etats")# Summary tablepersist_data = []for p in [persist_2s, persist_3s, persist_4s]:for i, (diag, dur) inenumerate(zip(p['diagonals'], p['avg_durations'])): persist_data.append({'Config': p['label'],'Etat': i,'P(stay)': round(diag, 4),'Duree moy. (j)': round(dur, 1) })df_persist = pd.DataFrame(persist_data)print("\n\nTableau de persistence des regimes")print("="*50)print(df_persist.to_string(index=False))# Visualize persistence across configurationsfig, ax = plt.subplots(figsize=(10, 5))configs = ['2 etats', '3 etats', '4 etats']mean_p = [persist_2s['mean_persistence'], persist_3s['mean_persistence'], persist_4s['mean_persistence']]min_p = [persist_2s['min_persistence'], persist_3s['min_persistence'], persist_4s['min_persistence']]x = np.arange(len(configs))width =0.35bars1 = ax.bar(x - width/2, mean_p, width, label='Persistence moyenne', color='steelblue')bars2 = ax.bar(x + width/2, min_p, width, label='Persistence min', color='coral')ax.set_ylabel('Probabilite de rester dans le regime')ax.set_title('Persistence des regimes par configuration HMM')ax.set_xticks(x)ax.set_xticklabels(configs)ax.legend()ax.set_ylim(0, 1.05)for bar in bars1: ax.annotate(f'{bar.get_height():.3f}', xy=(bar.get_x() + bar.get_width()/2, bar.get_height()), xytext=(0, 3), textcoords="offset points", ha='center', fontsize=9)for bar in bars2: ax.annotate(f'{bar.get_height():.3f}', xy=(bar.get_x() + bar.get_width()/2, bar.get_height()), xytext=(0, 3), textcoords="offset points", ha='center', fontsize=9)plt.tight_layout()plt.show()
Le walk-forward a 2 états est termine avec 20 combinaisons valides sur 20. On observe que le Sharpe moyen (3.385) est superieur au B&H (3.103) mais le cum_return moyen est negatif (-20.27%), ce qui signale une incoherence entre la mesure de risque ajuste et le rendement absolu. Les frequents warnings de non-convergence de l’algorithme EM montrent que le modèle a 2 états est parfois instable.
La cellule suivante execute le même protocole walk-forward avec 3 états pour comparer.
Le walk-forward a 4 états (optimal selon AIC/BIC) est termine. Les résultats montrent que les modèles a plus d’états produisent des Sharpe ratios plus élevés mais avec une plus grande variance inter-seeds. La cellule suivante regroupe les verdicts des trois configurations (2, 3 et 4 états) et calcule l’edge cross-seed (ratio mean/std du Sharpe) pour determiner si la stratégie bat significativement le buy-and-hold. Le seuil de validation est un edge >= 2 sigma.
Exercice 3 : Analyse de sensibilite aux coûts de transaction
Objectif : Étudier l’impact des coûts de transaction sur la performance walk-forward en faisant varier le paramètre cost_bps.
Contexte : Les coûts de transaction en crypto varient selon l’exchange et la taille des ordres. La valeur par défaut est 10 bps, mais certains brokers facturent plus.
Indices : - # Indice 1 : Appelezwalk_forward_hmm()avec différentes valeurs decost_bps: [0, 5, 10, 20, 50] - # Indice 2 : Pour chaque valeur, calculez le Sharpe moyen et le nombre de trades moyen - # Étape 1 : Executer le walk-forward avec cost_bps=0 (pas de coûts) comme référence - # Étape 2 : Executer avec cost_bps=5, 10, 20, 50 - # Étape 3 : Tracer la courbe Sharpe vs cost_bps et identifier le seuil de rentabilité
# Exercice 3 : Analyse de sensibilite aux couts de transaction# TODO etudiant : Executer walk_forward_hmm avec differents cost_bps# TODO etudiant : Calculer le Sharpe moyen et trades moyens pour chaque cout# TODO etudiant : Tracer la courbe Sharpe vs cost_bpsresult =None# TODO etudiant : remplacer par votre analyseprint("Exercice a completer : sensibilite aux couts de transaction")
Exercice a completer : sensibilite aux couts de transaction
8. Verdict explicite
Conformement aux critères de validation du projet (cf. CLAUDE.md section G.2), un verdict de performance doit etre base sur des preuves statistiques robustes :
Pour evaluer la robustesse cross-asset de l’alpha HMM, nous appliquons le même pipeline walk-forward sur ETH-USD. Une stratégie robuste devrait montrer des résultats positifs sur au moins deux actifs du même univers (crypto).
# ETH walk-forwardeth_returns_series = returns['ETH_close'].reindex(features.index).dropna()print(f"ETH returns : {len(eth_returns_series)} observations")# Align ETH with features indexeth_aligned = returns['ETH_close'].reindex(features.index)eth_valid = eth_aligned.dropna()print(f"\n=== Walk-Forward ETH 2 etats ===")wf_eth_2s = walk_forward_hmm(eth_valid, n_states=2)v_eth_2s = compute_verdict(wf_eth_2s, "ETH HMM 2 etats")print(f"\n=== Walk-Forward ETH 3 etats ===")wf_eth_3s = walk_forward_hmm(eth_valid, n_states=3)v_eth_3s = compute_verdict(wf_eth_3s, "ETH HMM 3 etats")verdict_eth_2s = print_verdict(v_eth_2s)verdict_eth_3s = print_verdict(v_eth_3s)
ETH returns : 1562 observations

=== Walk-Forward ETH 2 etats ===
Nous ajoutons SOL-USD au panel walk-forward (2, 3 et 4 états) pour tester la robustesse sur un 3e crypto-actif plus recent et plus volatil. SOL dispose de moins d’historique (depuis 2020), ce qui reduit le nombre de folds walk-forward exploitables.
9c. HMM joint multi-actif
Un HMM joint utilise les features cross-asset (rendements BTC+ETH+SOL, correlations glissantes, momentum relatif) pour detecter les régimes a l’échelle du panel crypto. Le signal est ensuite applique au BTC-USD seul. L’hypothèse est qu’un modèle joint capture des transitions de régime que les modèles mono-actif ne voient pas.
HMM 3 états (long/short/flat) et 4 états (optimal AIC/BIC)
5. Persistance
Analyse de la durée moyenne des régimes via la matrice de transition
6. Validation
Walk-forward 5-fold x 4 seeds, coûts de transaction 10 bps, verdict edge >= 2 sigma
7. Multi-actif
SOL-USD (2/3/4 états) + HMM joint cross-asset
Points cles
Sélection AIC/BIC : les deux critères selectionnent 4 états comme configuration optimale sur BTC. Le 4e état capture un régime de volatilité extreme distinct des régimes classiques
Persistance des régimes : les modèles a 2 états montrent la persistance la plus élevée (P(stay) > 0.96), tandis que les modèles a 4 états ont des régimes plus courts mais plus differencies
Sensibilite aux seeds : l’initialisation EM est stochastique. La validation multi-seeds (0, 1, 7, 42) est indispensable pour mesurer la robustesse reelle
Coûts de transaction : en crypto (10 bps aller-retour), les frequents changements d’état reduisent significativement le Sharpe net, en particulier pour les modèles a 4 états
HMM joint : l’utilisation de features cross-asset (correlations BTC-ETH, BTC-SOL, momentum relatif) ne montre pas d’amelioration significative par rapport aux modèles mono-actif
Limites et pistes d’amelioration
Horizon temporel : les HMM sont des modèles a un pas de temps. Ajouter des features retardees (lagged features) peut ameliorer la prediction
Emissions non gaussiennes : les rendements crypto ont des queues lourdes. Un HMM a mélange de Student ou un HMM a régime-switching avec volatilité stochastique serait plus adaptée
Fenêtre glissante : remplacer la fenêtre expansive par une fenêtre glissante (ex: 252 jours) pour s’adapter aux changements de régime structurels
Ensemble de HMM : combiner les prédictions de plusieurs HMM (différents seeds, différents nombres d’états) pour réduire la variance
Horizons multiples : appliquer le signal HMM sur différentes horizons de rebalancement (journalier, hebdomadaire) pour optimiser le ratio signal/bruit