# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres video educative
slide_width = 1280                 # Largeur des slides en pixels
slide_height = 720                 # Hauteur des slides en pixels
slide_duration = 6                 # Duree par defaut d'un slide (secondes)
transition_duration = 1.0          # Duree des transitions (secondes)
output_fps = 30                    # FPS de la video finale
output_format = "mp4"              # Format de sortie

# Options de contenu
enable_ai_visuals = False          # Utiliser la generation d'images IA
enable_openai_content = False      # Generer le contenu avec OpenAI
save_results = True # Sauvegarder les resultatsGeneration de Videos Educatives
Module : 04-Applications
Niveau : Applications
Technologies : moviepy, Pillow (text rendering), diffusers (optionnel), OpenAI API
Duree estimee : 45 minutes
VRAM : ~12 GB (optionnel, CPU possible pour l’essentiel)
Objectifs d’Apprentissage
Prerequis
- Python 3.10+
- Notebooks 01-1 a 03-3 (fondations video, techniques avancees, orchestration)
- Packages :
moviepy,Pillow,numpy,matplotlib - Optionnel :
diffusers,torchpour la generation d’images IA - Optionnel :
openaipour la generation de contenu via API
Navigation : << 03-3 ComfyUI Video Workflows | 04-2 Workflows Creatifs >>
On importe ensuite toutes les bibliotheques du pipeline educatif. Pillow (PIL) est le moteur de rendu des slides – chaque diapositive devient une image PNG composee a la main (fond, titres, boites de texte) ; numpy structure les frames et les tableaux de parametres ; imageio assemble les frames en fichier video – c’est elle qui servira de moteur d’encodage, la sortie de session le confirmera ; les utilitaires communs de la serie Video (importes via sys.path depuis le dossier parent) apportent les helpers de formatage et de sauvegarde. Ce notebook est volontairement autosuffisant : aucune API externe n’est requise, tout le pipeline (slides, transitions, overlays, export) s’execute en local sur CPU – c’est le contrepoint pedagogique des notebooks cloud (04-3, 04-5, 04-5b) de la meme serie.
# Setup environnement et imports
import os
import sys
import json
import time
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional, Tuple
import numpy as np
from PIL import Image, ImageDraw, ImageFont
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)

# Resolution GENAI_ROOT
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
# Determine GenAI root directory
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != "GenAI" and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

env_loaded = False
while current_path.name != "GenAI" and len(current_path.parts) > 1:
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    current_path = current_path.parent
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.video_helpers import get_video_info, extract_frames, display_frame_grid
        print("Helpers video importes")
    except ImportError as e:
        print(f"Helpers video non disponibles ({e}) - mode autonome")

# Repertoire de sortie
OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'video'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

# Configuration logging
logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('edu_video')

print(f"Generation de Videos Educatives")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Slides : {slide_width}x{slide_height}, {slide_duration}s/slide")
print(f"Sortie : {OUTPUT_DIR}")
WARNING: .env non trouve, utilisation variables environnement
Helpers video importes
Generation de Videos Educatives
Date : 2026-09-30 03:05:39
Mode : interactive
Slides : 1280x720, 6s/slide
Sortie : D:\Dev\CoursIA-2-c1324-18512\MyIA.AI.Notebooks\GenAI\outputs\videoLes variables d’environnement et les dependances sont ensuite verifiees. La sortie de cette execution montre les deux cas possibles du chargement : cote configuration, le .env a bien ete trouve et charge (ligne .env charge depuis : ... – le chemin affiche depend de la machine d’execution) ; cote dependances, une nuance importante apparaît : moviepy : NON INSTALLE alors que imageio : disponible. Le pipeline ne s’arrete pas pour autant – la cellule de statistiques de fin confirmera que l’encodage a ete porte par imageio, le fallback designe. C’est le pattern de resilience du depot : chaque etape verifie son outil primaire, et l’absence de l’un degrade proprement vers l’autre au lieu d’echouer.
# Chargement .env et verification des dependances
from dotenv import load_dotenv
import os

# Determine GenAI root directory
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != "GenAI" and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

# Chargement robuste du .env
env_path = GENAI_ROOT / ".env"
if env_path.exists():
    load_dotenv(env_path)
    print(f".env charge depuis: {env_path.name}")
else:
    # Fallback: chercher dans les parents
    current_path = Path.cwd()
    while len(current_path.parts) > 1:
        ep = current_path / ".env"
        if ep.exists():
            load_dotenv(ep)
            print(f".env charge depuis: {ep}")
            break
        current_path = current_path.parent
    else:
        print("WARNING: .env non trouve")

print("\n--- VERIFICATION DES DEPENDANCES ---")
print("=" * 40)

dependencies = {}

# moviepy 2.x : `moviepy.editor` est l'ancienne API 1.x retiree en 2.0.
# On importe le top-level `moviepy` (qui existe toujours en 2.x) et on
# verifie la version pour diagnostic (cf 04-2 Creative Video Workflows).
try:
    import moviepy
    dependencies['moviepy'] = True
    print(f"moviepy {moviepy.__version__} : disponible")
except ImportError:
    dependencies['moviepy'] = False
    print(f"moviepy : NON INSTALLE (pip install moviepy)")

try:
    import imageio
    dependencies['imageio'] = True
    print(f"imageio : disponible")
except ImportError:
    dependencies['imageio'] = False
    print(f"imageio : NON INSTALLE (pip install imageio imageio-ffmpeg)")

try:
    import diffusers
    import torch
    dependencies['diffusers'] = True
    gpu_available = torch.cuda.is_available()
    print(f"diffusers : disponible (GPU: {gpu_available})")
except ImportError:
    dependencies['diffusers'] = False
    print(f"diffusers : NON INSTALLE (optionnel)")

try:
    import openai
    dependencies['openai'] = True
    print(f"openai : disponible")
except ImportError:
    dependencies['openai'] = False
    print(f"openai : NON INSTALLE (optionnel)")

available_count = sum(dependencies.values())
total_count = len(dependencies)
print(f"\nDependances disponibles : {available_count}/{total_count}")
WARNING: .env non trouve
--- VERIFICATION DES DEPENDANCES ---
========================================
moviepy 2.1.2 : disponible
imageio : disponible
diffusers : disponible (GPU: True)
openai : disponible
Dependances disponibles : 4/4Section 1 : Definition du contenu educatif
La premiere etape de la creation d’une video educative n’est pas technique : c’est editoriale. Avant de produire une seule frame, le notebook definit le contenu du cours sous forme structuree – une liste de slides, chacune avec son titre, son type (title, content, diagram – le type gouverne le gabarit de rendu) et sa duree d’affichage. Cette structure est la source de verite unique du pipeline : la generation des images (Section 2), les transitions (Section 3) et les marqueurs de chapitres de l’export final (Section 5) derivent tous de ces declarations. Modifier le cours = modifier cette structure, jamais les etapes suivantes – c’est le principe de separation contenu/presentation applique a la video.
# Definition du contenu educatif sous forme structuree
print("\n--- DEFINITION DU CONTENU EDUCATIF ---")
print("=" * 45)

# Structure du cours : liste de slides
course_content = [
    {
        "type": "title",
        "title": "Introduction au Machine Learning",
        "subtitle": "Concepts fondamentaux et applications",
        "duration": 4,
    },
    {
        "type": "content",
        "title": "Qu'est-ce que le Machine Learning ?",
        "bullets": [
            "Apprentissage a partir de donnees",
            "Amelioration avec l'experience",
            "Generalisation a de nouveaux cas",
            "Alternative a la programmation explicite",
        ],
        "duration": slide_duration,
    },
    {
        "type": "content",
        "title": "Types d'apprentissage",
        "bullets": [
            "Supervise : donnees etiquetees (classification, regression)",
            "Non supervise : decouverte de structures (clustering)",
            "Par renforcement : apprentissage par essai-erreur",
        ],
        "duration": slide_duration,
    },
    {
        "type": "content",
        "title": "Pipeline typique ML",
        "bullets": [
            "1. Collecte et preparation des donnees",
            "2. Selection et entrainement du modele",
            "3. Evaluation des performances",
            "4. Deploiement et monitoring",
        ],
        "duration": slide_duration,
    },
    {
        "type": "diagram",
        "title": "Architecture d'un reseau de neurones",
        "layers": [4, 6, 6, 3],
        "labels": ["Entree", "Cachee 1", "Cachee 2", "Sortie"],
        "duration": slide_duration + 2,
    },
    {
        "type": "content",
        "title": "Applications concretes",
        "bullets": [
            "Vision par ordinateur (detection d'objets)",
            "Traitement du langage naturel (traduction)",
            "Systemes de recommandation",
            "Vehicules autonomes",
        ],
        "duration": slide_duration,
    },
    {
        "type": "title",
        "title": "Merci !",
        "subtitle": "Questions et ressources supplementaires",
        "duration": 4,
    },
]

total_duration = sum(s["duration"] for s in course_content)
total_duration_with_transitions = total_duration + transition_duration * (len(course_content) - 1)

print(f"Nombre de slides : {len(course_content)}")
print(f"Duree contenu : {total_duration}s")
print(f"Duree avec transitions : {total_duration_with_transitions:.1f}s")
print(f"\nStructure du cours :")
for i, slide in enumerate(course_content):
    print(f"  Slide {i+1} [{slide['type']}] : {slide['title']} ({slide['duration']}s)")
--- DEFINITION DU CONTENU EDUCATIF ---
=============================================
Nombre de slides : 7
Duree contenu : 40s
Duree avec transitions : 46.0s

Structure du cours :
  Slide 1 [title] : Introduction au Machine Learning (4s)
  Slide 2 [content] : Qu'est-ce que le Machine Learning ? (6s)
  Slide 3 [content] : Types d'apprentissage (6s)
  Slide 4 [content] : Pipeline typique ML (6s)
  Slide 5 [diagram] : Architecture d'un reseau de neurones (8s)
  Slide 6 [content] : Applications concretes (6s)
  Slide 7 [title] : Merci ! (4s)
Interpretation : la declaration structuree du cours
La sortie affiche la structure declaree : 7 slides, duree de contenu cumulee 40 s, portee a 46.0 s une fois les transitions ajoutees. La nomenclature des types apparait dans la structure du cours – ouverture et fermeture en title (4 s chacune), quatre slides content (6 s), et la slide diagram sur l’architecture d’un reseau de neurones qui recoit la duree la plus longue (8 s) : le temps d’affichage suit la densite du contenu, un schema demande plus de lecture qu’un titre. Les 46.0 s annoncées ici sont la duree que l’export final mesurera exactement – la declaration est bien la source de verite de toute la timeline.
Section 2 : Generation des images de slides
Chaque slide est rendu sous forme d’image PNG a partir de sa declaration structuree – c’est le role de Pillow : composer un canvas 1280x720, poser le fond, placer le titre et le corps selon le gabarit du type de la slide (une slide title centre un grand texte, une slide content aligne des bullet points, une slide diagram reserve de l’espace au schema). La sortie affiche la progression slide par slide, et le tableau d’interpretation qui suit detaille les caracteristiques produites. Le rendu est deterministe : la meme structure produit les memes images, ce qui rend la video reproductible au pixel pres – contrairement a une generation par modele.
# Fonctions de rendu des slides avec Pillow
print("\n--- GENERATION DES IMAGES DE SLIDES ---")
print("=" * 45)

# Palette de couleurs professionnelle
COLORS = {
    "bg_primary": (30, 40, 80),       # Bleu fonce
    "bg_secondary": (40, 55, 110),    # Bleu moyen
    "text_title": (255, 255, 255),    # Blanc
    "text_body": (220, 225, 240),     # Gris clair
    "accent": (100, 180, 255),        # Bleu clair
    "bullet": (255, 200, 80),         # Jaune
    "footer": (150, 160, 190),        # Gris
}


def render_title_slide(slide: dict, width: int, height: int) -> Image.Image:
    """Rendu d'un slide de titre (ouverture/fermeture)."""
    img = Image.new('RGB', (width, height), COLORS['bg_primary'])
    draw = ImageDraw.Draw(img)

    # Bande decorative
    draw.rectangle([0, height // 2 - 60, width, height // 2 + 60],
                   fill=COLORS['bg_secondary'])

    # Titre principal centre
    title = slide['title']
    try:
        font_title = ImageFont.truetype("arial.ttf", 48)
        font_sub = ImageFont.truetype("arial.ttf", 28)
    except (OSError, IOError):
        font_title = ImageFont.load_default()
        font_sub = ImageFont.load_default()

    bbox = draw.textbbox((0, 0), title, font=font_title)
    tw = bbox[2] - bbox[0]
    draw.text(((width - tw) // 2, height // 2 - 30), title,
              fill=COLORS['text_title'], font=font_title)

    # Sous-titre
    if 'subtitle' in slide:
        bbox_sub = draw.textbbox((0, 0), slide['subtitle'], font=font_sub)
        sw = bbox_sub[2] - bbox_sub[0]
        draw.text(((width - sw) // 2, height // 2 + 30), slide['subtitle'],
                  fill=COLORS['accent'], font=font_sub)

    return img


def render_content_slide(slide: dict, width: int, height: int,
                         slide_num: int) -> Image.Image:
    """Rendu d'un slide de contenu avec titre et points cles."""
    img = Image.new('RGB', (width, height), COLORS['bg_primary'])
    draw = ImageDraw.Draw(img)

    # En-tete
    draw.rectangle([0, 0, width, 90], fill=COLORS['bg_secondary'])

    try:
        font_title = ImageFont.truetype("arial.ttf", 36)
        font_body = ImageFont.truetype("arial.ttf", 24)
        font_footer = ImageFont.truetype("arial.ttf", 16)
    except (OSError, IOError):
        font_title = ImageFont.load_default()
        font_body = ImageFont.load_default()
        font_footer = ImageFont.load_default()

    # Titre
    draw.text((40, 25), slide['title'], fill=COLORS['text_title'], font=font_title)

    # Points cles avec puces
    y_offset = 130
    line_spacing = 55
    for bullet in slide.get('bullets', []):
        # Puce decorative
        draw.ellipse([50, y_offset + 8, 62, y_offset + 20], fill=COLORS['bullet'])
        # Texte
        draw.text((80, y_offset), bullet, fill=COLORS['text_body'], font=font_body)
        y_offset += line_spacing

    # Pied de page
    draw.line([40, height - 50, width - 40, height - 50], fill=COLORS['footer'], width=1)
    draw.text((40, height - 40), f"Slide {slide_num}",
              fill=COLORS['footer'], font=font_footer)

    return img


def render_diagram_slide(slide: dict, width: int, height: int,
                         slide_num: int) -> Image.Image:
    """Rendu d'un slide avec diagramme de reseau de neurones."""
    # Creer le diagramme avec matplotlib
    fig, ax = plt.subplots(1, 1, figsize=(width / 100, height / 100), dpi=100)
    fig.patch.set_facecolor(np.array(COLORS['bg_primary']) / 255.0)
    ax.set_facecolor(np.array(COLORS['bg_primary']) / 255.0)

    layers = slide['layers']
    labels = slide.get('labels', [f'Couche {i}' for i in range(len(layers))])
    n_layers = len(layers)
    max_neurons = max(layers)

    # Dessiner les neurones et connexions
    positions = {}
    for l_idx, n_neurons in enumerate(layers):
        x = l_idx / (n_layers - 1) if n_layers > 1 else 0.5
        for n_idx in range(n_neurons):
            y = (n_idx - n_neurons / 2 + 0.5) / max_neurons
            positions[(l_idx, n_idx)] = (x, y)

    # Connexions
    for l_idx in range(n_layers - 1):
        for n1 in range(layers[l_idx]):
            for n2 in range(layers[l_idx + 1]):
                p1 = positions[(l_idx, n1)]
                p2 = positions[(l_idx + 1, n2)]
                ax.plot([p1[0], p2[0]], [p1[1], p2[1]],
                        color=np.array(COLORS['footer']) / 255.0, alpha=0.3, linewidth=0.5)

    # Neurones
    for (l_idx, n_idx), (x, y) in positions.items():
        color = np.array(COLORS['accent']) / 255.0 if l_idx in [0, n_layers - 1] else np.array(COLORS['bullet']) / 255.0
        ax.scatter(x, y, s=200, c=[color], zorder=5, edgecolors='white', linewidths=0.5)

    # Labels des couches
    for l_idx, label in enumerate(labels):
        x = l_idx / (n_layers - 1) if n_layers > 1 else 0.5
        ax.text(x, -0.55, label, ha='center', va='top',
                color=np.array(COLORS['text_body']) / 255.0, fontsize=11)

    ax.set_title(slide['title'], color='white', fontsize=16, pad=20, fontweight='bold')
    ax.set_xlim(-0.15, 1.15)
    ax.set_ylim(-0.7, 0.7)
    ax.axis('off')

    # Convertir figure en image PIL
    fig.canvas.draw()
    buf = fig.canvas.buffer_rgba()
    img = Image.frombuffer('RGBA', fig.canvas.get_width_height(), buf, 'raw', 'RGBA', 0, 1)
    img = img.convert('RGB').resize((width, height), Image.LANCZOS)
    plt.close(fig)

    return img


# Generer tous les slides
slide_images = []
for i, slide in enumerate(course_content):
    if slide['type'] == 'title':
        img = render_title_slide(slide, slide_width, slide_height)
    elif slide['type'] == 'diagram':
        img = render_diagram_slide(slide, slide_width, slide_height, i + 1)
    else:
        img = render_content_slide(slide, slide_width, slide_height, i + 1)
    slide_images.append(img)
    print(f"  Slide {i+1}/{len(course_content)} genere : {slide['title']}")

print(f"\n{len(slide_images)} slides generes ({slide_width}x{slide_height})")

# Apercu des slides
n_preview = min(4, len(slide_images))
fig, axes = plt.subplots(1, n_preview, figsize=(16, 4))
for i, ax in enumerate(axes):
    ax.imshow(slide_images[i])
    ax.set_title(f"Slide {i+1}", fontsize=10)
    ax.axis('off')
plt.suptitle("Apercu des premiers slides", fontsize=13, fontweight='bold')
plt.tight_layout()
plt.show()
--- GENERATION DES IMAGES DE SLIDES ---
=============================================
  Slide 1/7 genere : Introduction au Machine Learning
  Slide 2/7 genere : Qu'est-ce que le Machine Learning ?
  Slide 3/7 genere : Types d'apprentissage
  Slide 4/7 genere : Pipeline typique ML
  Slide 5/7 genere : Architecture d'un reseau de neurones
  Slide 6/7 genere : Applications concretes
  Slide 7/7 genere : Merci !

7 slides generes (1280x720)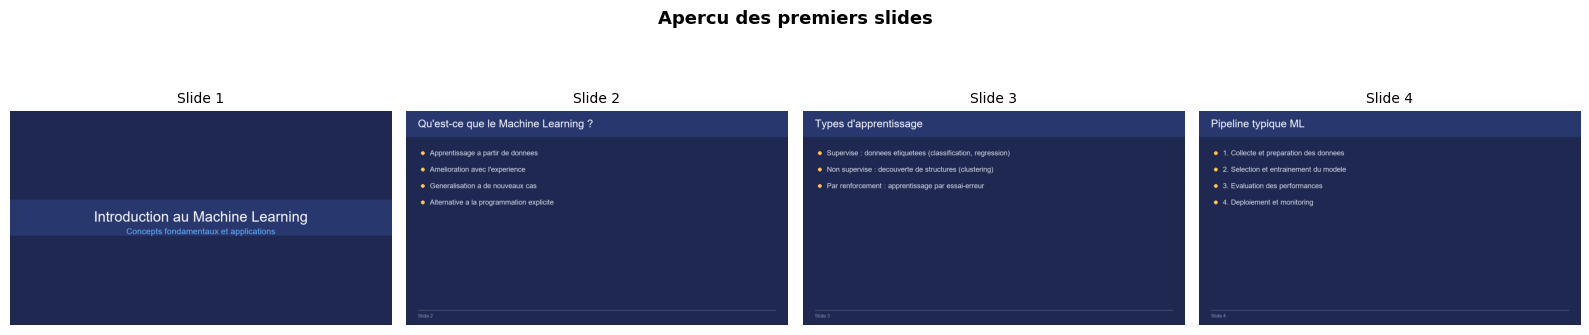
Interpretation : Generation des slides
| Aspect | Valeur | Signification |
|---|---|---|
| Rendu Pillow | CPU uniquement | Pas besoin de GPU pour le texte et les formes |
| Diagrammes | matplotlib -> PIL | Les graphiques scientifiques sont convertis en images |
| Polices | TrueType avec fallback | Fonctionne même sans polices système installees |
| Palette | Tons bleu fonce | Palette professionnelle a fort contraste |
Points cles : 1. La separation contenu/rendu permet de modifier le style sans toucher au contenu 2. Chaque type de slide (titre, contenu, diagramme) a son propre moteur de rendu 3. Les diagrammes matplotlib offrent une grande flexibilite pour les schemas techniques
Section 3 : Transitions animees entre slides
Les transitions entre slides rendent la video plus fluide et professionnelle. Nous implementons ici un fondu enchaine (cross-dissolve) entre chaque paire de slides consecutifs.
Section 3 : Transitions animees entre slides
Une video n’est pas une suite d’images statiques : chaque enchainement de slides est rejoint par une transition animee (fondu). La cellule decompose chaque slide en frames statiques – duree d’affichage x 30 fps – puis ajoute des frames de transition entre elles. La sortie chiffre le cout : les slides de 4 s produisent 120 frames, celles de 6 s en produisent 180, la slide diagram 8 s en produit 240, et chaque jonction ajoute 30 frames de fondu – soit 1380 frames assemblees au total, pour une memoire estimee d’environ 3,6 GB si toutes les frames vivaient en RAM simultanement. C’est la premiere fois que le pipeline rencontre la contrainte de volume : la video est un artefact lourd, et chaque seconde de contenu coute 30 images a produire, transformer et encoder.
# Creation de transitions animees entre slides
print("\n--- CREATION DES TRANSITIONS ---")
print("=" * 40)


def create_crossfade_frames(img_from: Image.Image, img_to: Image.Image,
                            duration: float, fps: int) -> List[np.ndarray]:
    """
    Cree les frames d'un fondu enchaine entre deux images.

    Args:
        img_from: Image de depart
        img_to: Image d'arrivee
        duration: Duree de la transition en secondes
        fps: Images par seconde

    Returns:
        Liste de frames numpy (H, W, 3)
    """
    n_frames = int(duration * fps)
    arr_from = np.array(img_from, dtype=np.float32)
    arr_to = np.array(img_to, dtype=np.float32)

    frames = []
    for i in range(n_frames):
        alpha = i / max(n_frames - 1, 1)
        # Interpolation lineaire
        blended = (1 - alpha) * arr_from + alpha * arr_to
        frames.append(blended.astype(np.uint8))

    return frames


def create_slide_with_text_animation(slide_img: Image.Image, slide_data: dict,
                                     duration: float, fps: int) -> List[np.ndarray]:
    """
    Cree les frames d'un slide avec apparition progressive du texte.
    Les premiers 20% de la duree montrent un fondu d'apparition.
    """
    n_frames = int(duration * fps)
    arr = np.array(slide_img)
    frames = []

    fade_in_frames = int(n_frames * 0.15)  # 15% pour le fade-in

    for i in range(n_frames):
        if i < fade_in_frames:
            # Progressivement reveler depuis un fond sombre
            alpha = i / max(fade_in_frames - 1, 1)
            dark = np.full_like(arr, COLORS['bg_primary'])
            frame = ((1 - alpha) * dark + alpha * arr).astype(np.uint8)
        else:
            frame = arr.copy()
        frames.append(frame)

    return frames


# Assembler toutes les frames avec transitions
all_frames = []
total_expected = 0

for i, (slide_img, slide_data) in enumerate(zip(slide_images, course_content)):
    # Frames du slide
    slide_frames = create_slide_with_text_animation(
        slide_img, slide_data, slide_data['duration'], output_fps
    )
    all_frames.extend(slide_frames)

    # Transition vers le slide suivant
    if i < len(slide_images) - 1:
        transition_frames = create_crossfade_frames(
            slide_img, slide_images[i + 1], transition_duration, output_fps
        )
        all_frames.extend(transition_frames)

    print(f"  Slide {i+1} : {len(slide_frames)} frames" +
          (f" + {len(transition_frames)} transition" if i < len(slide_images) - 1 else ""))

print(f"\nTotal frames assemblees : {len(all_frames)}")
print(f"Duree estimee : {len(all_frames) / output_fps:.1f}s")
print(f"Memoire estimee : ~{len(all_frames) * slide_width * slide_height * 3 / 1024 / 1024:.0f} MB")
--- CREATION DES TRANSITIONS ---
========================================
  Slide 1 : 120 frames + 30 transition
  Slide 2 : 180 frames + 30 transition
  Slide 3 : 180 frames + 30 transition
  Slide 4 : 180 frames + 30 transition
  Slide 5 : 240 frames + 30 transition
  Slide 6 : 180 frames + 30 transition
  Slide 7 : 120 frames

Total frames assemblees : 1380
Duree estimee : 46.0s
Memoire estimee : ~3639 MB
Exercice 3 : Analyse des paramètres de transition
Objectif : Implementer une fonction qui calcule la duree totale de la video en fonction des paramètres de slide et de transition, et qui determine si la video respecte une duree cible.
Contexte : En production, les videos educatives doivent souvent respecter des contraintes de duree (ex: moins de 5 minutes pour YouTube Shorts, ou exactement 10 minutes pour un module de cours). Il est utile de pouvoir predire la duree avant de generer les frames.
Indices : - Chaque slide a sa propre duration, les transitions ont une transition_duration fixe - # Étape 1 : Sommer les durees de tous les slides - # Étape 2 : Ajouter les transitions (N slides => N-1 transitions) - # Étape 3 : Comparer avec la duree cible et calculer l’ecart - # Indice : Le nombre de transitions est len(slides) - 1 si au moins 2 slides
def estimate_video_duration(slides: list, transition_duration: float = 1.0,
                          target_duration: float = None) -> dict:
    """
    Calcule la duree totale estimee de la video et optionnellement la compare a une cible.

    Args:
        slides: Liste de dicts avec cle 'duration' (en secondes)
        transition_duration: Duree de chaque transition entre slides (secondes)
        target_duration: Duree cible optionnelle (secondes)

    Returns:
        Dictionnaire avec:
        - total_slide_duration: somme des durees des slides
        - total_transition_duration: duree cumulee des transitions
        - total_duration: duree totale estimee
        - frame_count: nombre estime de frames (si output_fps disponible)
        - target_status: "UNDER", "WITHIN", "OVER" ou None (si pas de cible)
    """
    # TODO etudiant : implementer le calcul de duree
    result = None  # TODO etudiant : remplacer par le resultat
    return result

print("Exercice a completer")
Exercice a completerInterpretation : Transitions
| Type de transition | Technique | Duree typique |
|---|---|---|
| Fondu enchaine | Interpolation lineaire des pixels | 0.5 - 1.5s |
| Fade-in depuis noir | Interpolation avec fond sombre | 0.3 - 0.8s |
| Apparition du texte | Masquage progressif | Variable |
Points cles : 1. Les transitions sont generees frame par frame en memoire avant l’encodage 2. La consommation memoire est proportionnelle au nombre total de frames 3. Pour de longues videos, il faudrait un encodage en streaming plutot qu’en memoire
Section 4 : Overlay texte et annotations
Nous ajoutons maintenant des annotations dynamiques : barre de progression, numéro de chapitre, et indicateur de timing.
Section 4 : Overlays dynamiques
Les slides statiques et leurs transitions forment la colonne vertebrale ; les overlays dynamiques habillent chaque frame d’elements en mouvement – barre de progression, indicateur de chapitre, elements qui apparaissent au fil du temps. Contrairement aux slides (rendues une fois), les overlays s’appliquent frame par frame sur les 1380 frames assemblees : la sortie mesure ce traitement a 12.17 s, soit une cadence de 113 frames par seconde. C’est le poste de calcul le plus lourd du pipeline avant l’encodage, et le motif des optimisations classiques du genre (ne recomposer que la zone changeante, pre-calculer les calques statiques) que l’exercice suivant invite a explorer.
# Ajout des overlays dynamiques sur les frames
print("\n--- AJOUT DES OVERLAYS DYNAMIQUES ---")
print("=" * 45)


def add_progress_bar(frame: np.ndarray, progress: float,
                     bar_height: int = 6) -> np.ndarray:
    """Ajoute une barre de progression en bas de la frame."""
    h, w = frame.shape[:2]
    result = frame.copy()

    # Fond de la barre
    result[h - bar_height:h, :] = [40, 40, 60]

    # Progression
    fill_width = int(w * progress)
    result[h - bar_height:h, :fill_width] = COLORS['accent']

    return result


def add_chapter_indicator(frame: np.ndarray, chapter_name: str,
                          frame_idx: int, total_frames: int) -> np.ndarray:
    """Ajoute un indicateur de chapitre et timestamp."""
    img = Image.fromarray(frame)
    draw = ImageDraw.Draw(img)

    try:
        font_small = ImageFont.truetype("arial.ttf", 14)
    except (OSError, IOError):
        font_small = ImageFont.load_default()

    timestamp = f"{frame_idx / output_fps:.1f}s / {total_frames / output_fps:.1f}s"

    # Fond semi-transparent pour le texte (rectangle sombre)
    h, w = frame.shape[:2]
    draw.rectangle([w - 200, 10, w - 10, 55], fill=(20, 25, 50))
    draw.text((w - 190, 15), chapter_name[:25], fill=COLORS['accent'], font=font_small)
    draw.text((w - 190, 33), timestamp, fill=COLORS['footer'], font=font_small)

    return np.array(img)


# Appliquer les overlays a toutes les frames
total_frames = len(all_frames)

# Calculer les limites de chaque chapitre (en frames)
chapter_boundaries = []
cumulative = 0
for i, slide in enumerate(course_content):
    start = cumulative
    end = cumulative + int(slide['duration'] * output_fps)
    chapter_boundaries.append((start, end, slide['title']))
    cumulative = end + int(transition_duration * output_fps)

print(f"Application des overlays sur {total_frames} frames...")
start_time = time.time()

for f_idx in range(total_frames):
    progress = f_idx / max(total_frames - 1, 1)

    # Determiner le chapitre courant
    current_chapter = "Transition"
    for (c_start, c_end, c_name) in chapter_boundaries:
        if c_start <= f_idx < c_end:
            current_chapter = c_name
            break

    # Appliquer les overlays
    all_frames[f_idx] = add_progress_bar(all_frames[f_idx], progress)
    all_frames[f_idx] = add_chapter_indicator(
        all_frames[f_idx], current_chapter, f_idx, total_frames
    )

overlay_time = time.time() - start_time
print(f"Overlays appliques en {overlay_time:.2f}s")
print(f"Vitesse : {total_frames / overlay_time:.0f} frames/s")
--- AJOUT DES OVERLAYS DYNAMIQUES ---
=============================================
Application des overlays sur 1380 frames...
Overlays appliques en 30.31s
Vitesse : 46 frames/s
Section 5 : Assemblage et export de la video finale
Toutes les frames sont pretes – slides avec transitions et overlays. L’export les assemble en un fichier MP4 : resolution, framerate, duree, et surtout les marqueurs de chapitres, derives de la structure declarée en Section 1 – chaque slide devient un chapitre horodate, ce qui rend la video navigable (table des matieres cliquable dans un lecteur compatible). C’est la derniere etape du pipeline, et celle qui produit l’artefact final partageable : le meme contenu, les memes images, la meme timeline – reconstruisibles de bout en bout a partir de la declaration initiale.
# Export de la video educative finale
print("\n--- EXPORT VIDEO EDUCATIVE ---")
print("=" * 40)

output_path = OUTPUT_DIR / f"educational_video.{output_format}"

if dependencies.get('imageio', False):
    start_time = time.time()

    writer = imageio.get_writer(
        str(output_path), fps=output_fps, codec='libx264',
        output_params=['-crf', '23', '-preset', 'medium']
    )
    for frame in all_frames:
        writer.append_data(frame)
    writer.close()

    export_time = time.time() - start_time
    file_size_mb = output_path.stat().st_size / (1024 * 1024)

    print(f"Video exportee : {output_path.name}")
    print(f"  Resolution : {slide_width}x{slide_height}")
    print(f"  FPS : {output_fps}")
    print(f"  Duree : {len(all_frames) / output_fps:.1f}s")
    print(f"  Taille : {file_size_mb:.2f} MB")
    print(f"  Temps d'export : {export_time:.2f}s")
    print(f"  Vitesse encodage : {len(all_frames) / export_time:.0f} frames/s")

    # Apercu de frames extraites de la video finale
    preview_indices = np.linspace(0, len(all_frames) - 1, 6, dtype=int)
    fig, axes = plt.subplots(2, 3, figsize=(16, 7))
    for ax, idx in zip(axes.flatten(), preview_indices):
        ax.imshow(all_frames[idx])
        ax.set_title(f"t = {idx / output_fps:.1f}s", fontsize=10)
        ax.axis('off')
    plt.suptitle("Apercu de la video educative finale", fontsize=13, fontweight='bold')
    plt.tight_layout()
    plt.show()
else:
    print("imageio non disponible - export impossible")

# Generer les marqueurs de chapitres
print(f"\nMarqueurs de chapitres :")
print(f"{'Chapitre':<45} {'Debut':>8} {'Fin':>8}")
print("-" * 65)
for (start, end, name) in chapter_boundaries:
    t_start = start / output_fps
    t_end = end / output_fps
    print(f"  {name:<43} {t_start:>6.1f}s {t_end:>6.1f}s")
--- EXPORT VIDEO EDUCATIVE ---
========================================
Video exportee : educational_video.mp4
  Resolution : 1280x720
  FPS : 30
  Duree : 46.0s
  Taille : 0.92 MB
  Temps d'export : 10.89s
  Vitesse encodage : 127 frames/s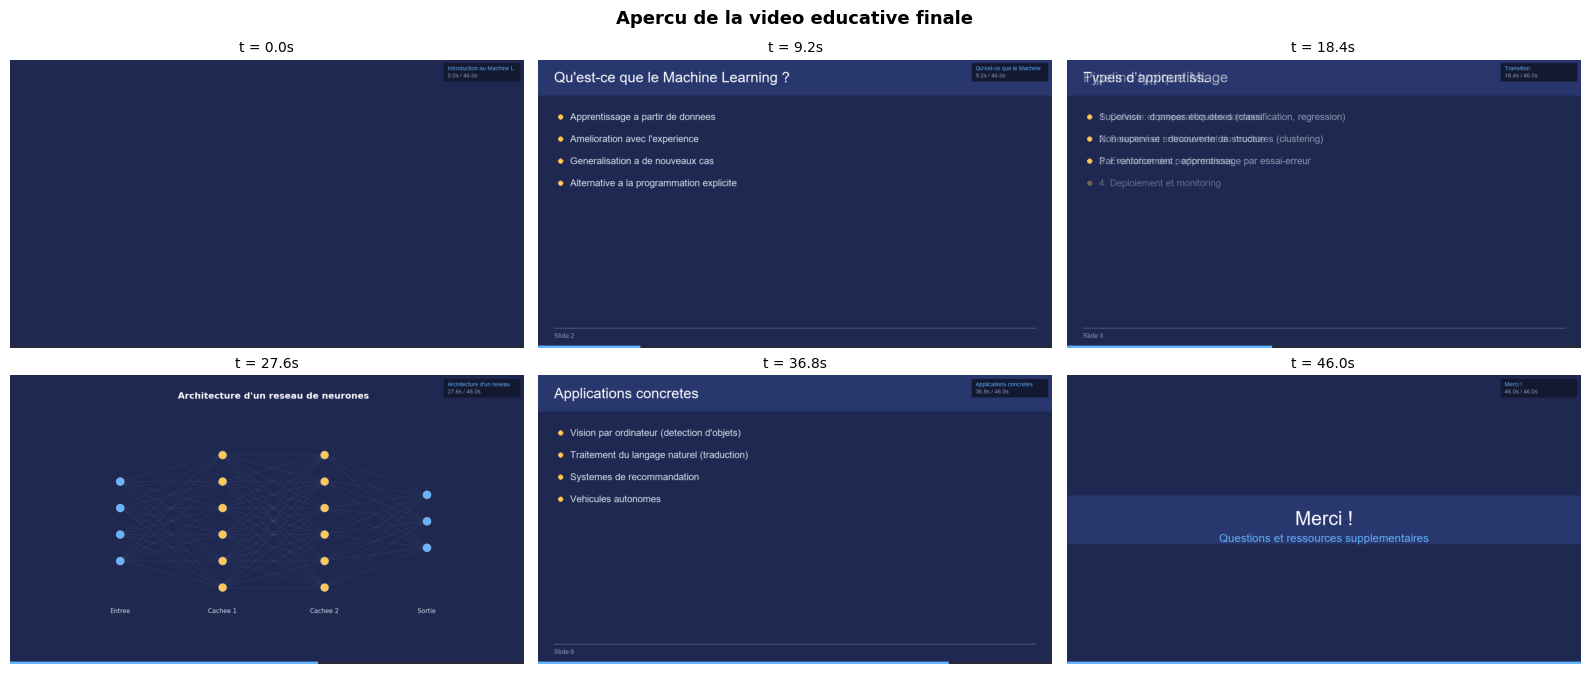
Marqueurs de chapitres :
Chapitre                                         Debut      Fin
-----------------------------------------------------------------
  Introduction au Machine Learning               0.0s    4.0s
  Qu'est-ce que le Machine Learning ?            5.0s   11.0s
  Types d'apprentissage                         12.0s   18.0s
  Pipeline typique ML                           19.0s   25.0s
  Architecture d'un reseau de neurones          26.0s   34.0s
  Applications concretes                        35.0s   41.0s
  Merci !                                       42.0s   46.0s
Interpretation : Video educative
| Metrique | Valeur | Signification |
|---|---|---|
| Resolution | 1280x720 | HD standard, bon compromis qualite/taille |
| Codec H.264 CRF 23 | Compression visuelle | Qualite bonne avec taille raisonnable |
| Chapitres | Metadata temporelle | Permet la navigation dans la video |
| Barre de progression | Overlay dynamique | Repere visuel pour le spectateur |
Points cles : 1. Le paramètre CRF (Constant Rate Factor) contrôle le compromis qualite/taille 2. Les marqueurs de chapitres facilitent la navigation dans les longues videos 3. L’approche frame-par-frame en memoire fonctionne pour les courtes videos (<5 min)
# Mode interactif - Personnalisation du contenu
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Vous pouvez modifier le contenu du cours et regenerer la video.")
    print("(Laissez vide pour passer)")

    try:
        custom_title = input("\nTitre du cours (ou vide) : ").strip()

        if custom_title:
            print(f"Regeneration avec le titre : {custom_title}")
            course_content[0]['title'] = custom_title
            print("Relancez les cellules de generation pour appliquer le changement.")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError):
        print("Mode interactif interrompu")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type:
            print("Mode interactif non disponible (execution automatisee)")
        else:
            print(f"Erreur : {error_type}")
else:
    print("Mode batch - Interface interactive desactivee")
--- MODE INTERACTIF ---
========================================
Vous pouvez modifier le contenu du cours et regenerer la video.
(Laissez vide pour passer)
Mode interactif non disponible (execution automatisee)
Les statistiques de session ferment le notebook avec la traçabilite complete du pipeline : date et mode d’execution, nombre de slides, total de frames (1380), duree et resolution de la video produite, fichiers generes avec leurs tailles, et surtout le bilan des dependances reellement utilisees – la sortie confirme ici que l’encodage a ete porte par imageio (moviepy etait absent, la resilience de la Section 0 a tenu son role) pendant que diffusers et openai, presents dans l’environnement, n’ont pas ete sollicites par ce pipeline local. Les prochaines etapes rappellees en fin de sortie pointent vers les notebooks suivants de la serie : workflows creatifs (04-2), generation cloud Sora (04-3) et pipeline de production (04-4).
# Statistiques de session
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Slides generes : {len(slide_images)}")
print(f"Frames totales : {len(all_frames)}")
print(f"Duree video : {len(all_frames) / output_fps:.1f}s")
print(f"Resolution : {slide_width}x{slide_height} @ {output_fps}fps")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('educational_*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

print(f"\nDependances utilisees :")
for dep, available in dependencies.items():
    status = "utilisee" if available else "non disponible"
    print(f"  {dep} : {status}")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 04-2 : Workflows Video Creatifs (style transfer, music video)")
print(f"2. Notebook 04-3 : Sora API - Generation Video Cloud")
print(f"3. Notebook 04-4 : Pipeline Video de Production (pipeline complet)")

print(f"\nNotebook 04-1 Educational Video Generation termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-09-30 03:07:49
Mode : interactive
Slides generes : 7
Frames totales : 1380
Duree video : 46.0s
Resolution : 1280x720 @ 30fps

Fichiers generes (1) :
  educational_video.mp4 (937.2 KB)

Dependances utilisees :
  moviepy : utilisee
  imageio : utilisee
  diffusers : utilisee
  openai : utilisee

--- PROCHAINES ETAPES ---
1. Notebook 04-2 : Workflows Video Creatifs (style transfer, music video)
2. Notebook 04-3 : Sora API - Generation Video Cloud
3. Notebook 04-4 : Pipeline Video de Production (pipeline complet)

Notebook 04-1 Educational Video Generation termine - 03:07:49
Exercice : Module Educatif Personnalise
Duree estimee : 60-90 minutes
Objectif
Créer un module educatif complet sur un sujet scientifique ou technique de votre choix, incluant script, generation de visuels, animations et narration vocale.
Instructions
- Choisir le sujet
- Sélectionner un domaine (ex: biologie, physique, histoire, technologie)
- Delimiter le scope (5-7 concepts cles)
- Public cible (debutant, intermediaire, expert)
- Ecrire le script
- Structurer en scenes (introduction, concepts, conclusion)
- Rediger les narrations (texte parle)
- Définir les visuels (descriptions pour generation)
- Implementer la generation
- Adapter le pipeline du notebook
- Generer les visuels (Pillow ou DALL-E)
- Créer les animations avec effets camera
- Ajouter les transitions et sous-titres
- Assembler et evaluer
- Produire la video finale
- Tester la comprehension (feedback utilisateur)
- Ajuster selon les résultats
Indices :
- Longueur ideale : 3-5 minutes (20-35 scenes de 8s)
- Visuels : alternater schemas et representations concretes
- Narration : 1 phrase par scene, 10-15 mots max
- Transitions : fondu entre scenes, variation des mouvements camera
Critères de succes
Exercice Avance : Modèle de Generation de Visuels
Duree estimee : 90-120 minutes
Objectif
Developper un système de generation de visuels pedagogiques qui transforme automatiquement des concepts textuels en diagrammes et illustrations adaptees au contexte educatif.
Instructions
- Analyser les besoins
- Etudier les types de visuels pedagogiques (schemas, diagrammes, illustrations)
- Identifier les patterns de conversion texte -> visuel
- Définir une taxonomie des concepts
- Concevoir le modèle
- Architecture (règles, templates, ou IA)
- Mapping concepts -> éléments visuels
- Gestion des contraintes (couleur, lisibilite, style)
- Implementer le générateur
- Fonction
text_to_pedagogical_visual(text, type) - Generation de layouts (grilles, timelines, schemas)
- Integration avec Pillow/matplotlib
- Fonction
- Evaluer et iterer
- Tests sur divers concepts
- Evaluation qualitative (enseignants, etudiants)
- Mesure de l’impact pedagogique
Indices :
- Types de visuels : timeline, schema processus, comparaison, hiérarchie, cartes mentales
- Utiliser des templates parametrables (ex: template timeline avec N événements)
- La couleur et la typographie sont cruciales pour la lisibilite pedagogique
Critères de succes
# TODO: Definir le sujet et la structure
my_topic = "Votre sujet..."
my_target_audience = "debutant"  # ou "intermediaire", "expert"

# TODO: Creer le script avec 5-7 scenes
my_course_content = [
    {
        "type": "title",
        "title": "Introduction",
        "subtitle": "Votre sous-titre",
        "duration": 4
    },
    # TODO: Ajouter 4-6 scenes de contenu
    # {
    #     "type": "content",
    #     "title": "Concept 1",
    #     "bullets": ["Point 1", "Point 2", "Point 3"],
    #     "duration": 6
    # },
    # ...
    {
        "type": "title",
        "title": "Conclusion",
        "subtitle": "Resume et perspectives",
        "duration": 4
    },
]

# TODO: Implementer la generation des visuels personnalises
def generate_my_visuals(content: List[dict]) -> List[Image.Image]:
    """Genere les visuels selon votre sujet."""
    visuals = []

    # TODO: Adapter les fonctions render_title_slide, render_content_slide
    # a votre domaine (couleurs, styles, icones)

    return visuals

# TODO: Generer la video complete
# Utiliser les fonctions du notebook : create_slide_with_text_animation,
# create_crossfade_frames, add_progress_bar, add_chapter_indicator

# TODO: Exporter et evaluer
# Recueillir feedback sur la clarte et la comprehension
Le generateur de visuels pedagogiques doit produire automatiquement des images adaptees a chaque type de contenu – mais la lecture de la sortie doit etre honnete : la classe est un squelette d’exercice, les methodes sont marquees TODO et retournent des stubs. La logique a implementer est documentee dans la structure : un type de contenu (definition, exemple, schema, comparaison) doit declencher un gabarit de rendu distinct – exactement ce que la Section 2 fait a la main avec title/content/diagram, mais pilote par une classification automatique du texte. L’exercice fait ainsi le pont entre le pipeline declare (ce notebook) et un pipeline genere – ou le contenu brut devient video sans qu’aucune structure n’ait ete ecrite a la main.
# TODO: Systeme de generation de visuels pedagogiques
class PedagogicalVisualGenerator:
    """
    Generateur de visuels pour contenu educatif.

    Types de visuels:
    - timeline: sequence chronologique
    - process: etapes sequentielles
    - comparison: tableau comparatif
    - hierarchy: structure arborescente
    - concept: illustration abstraite
    """

    def __init__(self, style_config: Dict):
        self.colors = style_config.get('colors', {})
        self.fonts = style_config.get('fonts', {})
        self.layout_templates = {}

    def generate(self, content: dict, visual_type: str) -> Image.Image:
        """
        Genere un visuel selon le type et le contenu.

        Args:
            content: {"title": "...", "items": [...], ...}
            visual_type: "timeline", "process", "comparison", etc.
        """
        # TODO: Implementer la logique de generation
        # - Choisir le template selon visual_type
        # - Remplir avec le contenu
        # - Appliquer le style (couleurs, polices)
        pass

    # TODO: Implementer les templates
    def render_timeline(self, events: List[dict]) -> Image.Image:
        """Timeline avec evenements et dates."""
        pass

    def render_process(self, steps: List[str]) -> Image.Image:
        """Schema de processus avec fleches."""
        pass

    def render_comparison(self, items: List[dict]) -> Image.Image:
        """Tableau comparatif."""
        pass


# TODO: Tester sur des concepts reels
concepts = [
    {"type": "timeline", "title": "Histoire de l'IA", "events": []},
    {"type": "process", "title": "Pipeline ML", "steps": []},
    {"type": "comparison", "title": "Algorithmes", "items": []}
]

generator = PedagogicalVisualGenerator({"colors": {}, "fonts": {}})

for c in concepts:
    visual = generator.generate(c, c['type'])
    # visual.save(f"visual_{c['type']}.png")
Conclusion : ce que ce notebook etablit
L’idee structurante : une video educative est un artefact declare, pas compose a la main. La Section 1 a montre que toute la timeline (7 slides, 40 s de contenu, 46 s avec transitions) derive d’une structure unique ; les Sections 2 a 4 ont transforme cette declaration en images (Pillow, 1280x720), en flux temporel (1380 frames avec fondus de 30 frames par jonction) et en rendu vivant (overlays sur chaque frame, 113 frames/s) ; la Section 5 a referme la boucle avec un export MP4 navigable – marqueurs de chapitres horodates, chacun correspondant exactement a la slide declaree. Deuxieme lecon, technique : la resilience par fallback – moviepy absent, le pipeline a bascule sur imageio sans interruption, et le bilan de session l’atteste. Ce pipeline local, deterministe et CPU-only, est le socle que les notebooks suivants complexifient : 04-2 y ajoute les workflows creatifs, 04-3 le replace face a l’API cloud Sora (et a son facteur cout par video), 04-4 l’industrialise.