# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres video
video_width = 640                  # Largeur video de travail
video_height = 480                 # Hauteur video de travail
video_fps = 24                     # FPS
video_duration = 6                 # Duree video source (secondes)
output_format = "mp4"              # Format de sortie

# Options creatives
enable_style_transfer = True       # Activer le transfert de style
enable_music_video = True          # Activer la creation music video
enable_stop_motion = True          # Activer l'effet stop-motion
enable_color_grading = True        # Activer le color grading
enable_text_animation = True       # Activer les animations de texte
save_results = True # Sauvegarder les resultatsWorkflows Video Creatifs
Module : 04-Applications
Niveau : Applications
Technologies : moviepy, diffusers, Pillow, numpy, scipy
Duree estimee : 50 minutes
VRAM : ~16 GB (optionnel, certaines sections CPU uniquement)
Objectifs d’Apprentissage
Prerequis
- Python 3.10+
- Notebooks 01-1 a 03-3 (fondations, techniques avancees, orchestration)
- Notebook 04-1 (generation de videos educatives)
- Packages :
moviepy,Pillow,numpy,scipy,matplotlib - Optionnel :
diffusers,torchpour le transfert de style IA
Navigation : << 04-1 Educational Video | 04-3 Sora API >>
On importe ensuite toutes les bibliotheques necessaires aux workflows creatifs : traitement video, analyse audio pour la synchronisation musicale, et outils d’effets visuels.
# Setup environnement et imports
import os
import sys
import json
import time
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional, Tuple
import numpy as np
from PIL import Image, ImageDraw, ImageFont, ImageFilter, ImageEnhance
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)

# Resolution GENAI_ROOT
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
# Determine GenAI root directory
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != "GenAI" and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

env_loaded = False
while current_path.name != "GenAI" and len(current_path.parts) > 1:
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    current_path = current_path.parent
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.video_helpers import get_video_info, extract_frames, display_frame_grid
        print("Helpers video importes")
    except ImportError as e:
        print(f"Helpers video non disponibles ({e}) - mode autonome")

# Repertoire de sortie
OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'video'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

# Configuration logging
logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('creative_video')

print(f"Workflows Video Creatifs")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Video : {video_width}x{video_height} @ {video_fps}fps, {video_duration}s")
print(f"Sortie : {OUTPUT_DIR}")
WARNING: .env non trouve, utilisation variables environnement
Helpers video importes
Workflows Video Creatifs
Date : 2026-08-26 14:26:15
Mode : interactive
Video : 640x480 @ 24fps, 6s
Sortie : D:\Dev\CoursIA-13056-beats\MyIA.AI.Notebooks\GenAI\outputs\videoLes variables d’environnement sont ensuite chargees et les dependances creatives verifiees : OpenCV pour le traitement d’images, librosa pour l’analyse audio, et PIL pour les effets visuels.
# Chargement .env et verification des dependances
from dotenv import load_dotenv
import os

# Determine GenAI root directory
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != "GenAI" and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

# Chargement robuste du .env
env_path = GENAI_ROOT / ".env"
if env_path.exists():
    load_dotenv(env_path)
    print(f".env charge depuis: {env_path.name}")
else:
    # Fallback: chercher dans les parents
    current_path = Path.cwd()
    while len(current_path.parts) > 1:
        ep = current_path / ".env"
        if ep.exists():
            load_dotenv(ep)
            print(f".env charge depuis: {ep}")
            break
        current_path = current_path.parent
    else:
        print("WARNING: .env non trouve")

print("\n--- VERIFICATION DES DEPENDANCES ---")
print("=" * 40)

dependencies = {}

try:
    import moviepy  # API 2.x : from moviepy import ... (moviepy.editor est l'ancienne API 1.x)
    dependencies['moviepy'] = True
    print(f"moviepy {moviepy.__version__} : disponible")
except ImportError:
    dependencies['moviepy'] = False
    print(f"moviepy : NON INSTALLE (pip install moviepy)")

try:
    import imageio
    dependencies['imageio'] = True
    print(f"imageio : disponible")
except ImportError:
    dependencies['imageio'] = False
    print(f"imageio : NON INSTALLE (pip install imageio imageio-ffmpeg)")

try:
    from scipy import signal, ndimage
    dependencies['scipy'] = True
    print(f"scipy : disponible")
except ImportError:
    dependencies['scipy'] = False
    print(f"scipy : NON INSTALLE (pip install scipy)")

try:
    import diffusers
    import torch
    dependencies['diffusers'] = True
    gpu_available = torch.cuda.is_available()
    print(f"diffusers : disponible (GPU: {gpu_available})")
except ImportError:
    dependencies['diffusers'] = False
    print(f"diffusers : NON INSTALLE (optionnel)")

available_count = sum(dependencies.values())
total_count = len(dependencies)
print(f"\nDependances disponibles : {available_count}/{total_count}")

# Generation d'une video source de travail
print("\n--- GENERATION VIDEO SOURCE ---")
print("=" * 40)

n_frames = video_fps * video_duration
source_frames = []
for i in range(n_frames):
    t = i / n_frames
    # Scene avec mouvement : gradient + cercle anime
    img = Image.new('RGB', (video_width, video_height))
    pixels = np.zeros((video_height, video_width, 3), dtype=np.uint8)

    # Gradient de fond anime
    for y in range(video_height):
        r = int(50 + 100 * (y / video_height) + 50 * np.sin(2 * np.pi * t))
        g = int(30 + 80 * (1 - y / video_height))
        b = int(100 + 100 * np.cos(2 * np.pi * t))
        pixels[y, :] = [min(255, max(0, r)), min(255, max(0, g)), min(255, max(0, b))]

    img = Image.fromarray(pixels)
    draw = ImageDraw.Draw(img)

    # Objets animes
    cx = int(video_width * 0.5 + video_width * 0.3 * np.cos(2 * np.pi * t))
    cy = int(video_height * 0.4 + video_height * 0.2 * np.sin(4 * np.pi * t))
    draw.ellipse([cx - 30, cy - 30, cx + 30, cy + 30], fill=(255, 200, 50))

    # Deuxieme objet
    cx2 = int(video_width * 0.3 + video_width * 0.15 * np.sin(3 * np.pi * t))
    cy2 = int(video_height * 0.6)
    draw.rectangle([cx2 - 20, cy2 - 20, cx2 + 20, cy2 + 20], fill=(100, 200, 255))

    source_frames.append(np.array(img))

print(f"Video source generee : {len(source_frames)} frames")
print(f"Resolution : {video_width}x{video_height} @ {video_fps}fps")
.env charge depuis: .env
--- VERIFICATION DES DEPENDANCES ---
========================================
moviepy 2.1.2 : disponible
imageio : disponible
scipy : disponible
diffusers : disponible (GPU: True)
Dependances disponibles : 4/4
--- GENERATION VIDEO SOURCE ---
========================================
Video source generee : 144 frames
Resolution : 640x480 @ 24fpsSection 1 : Transfert de style video
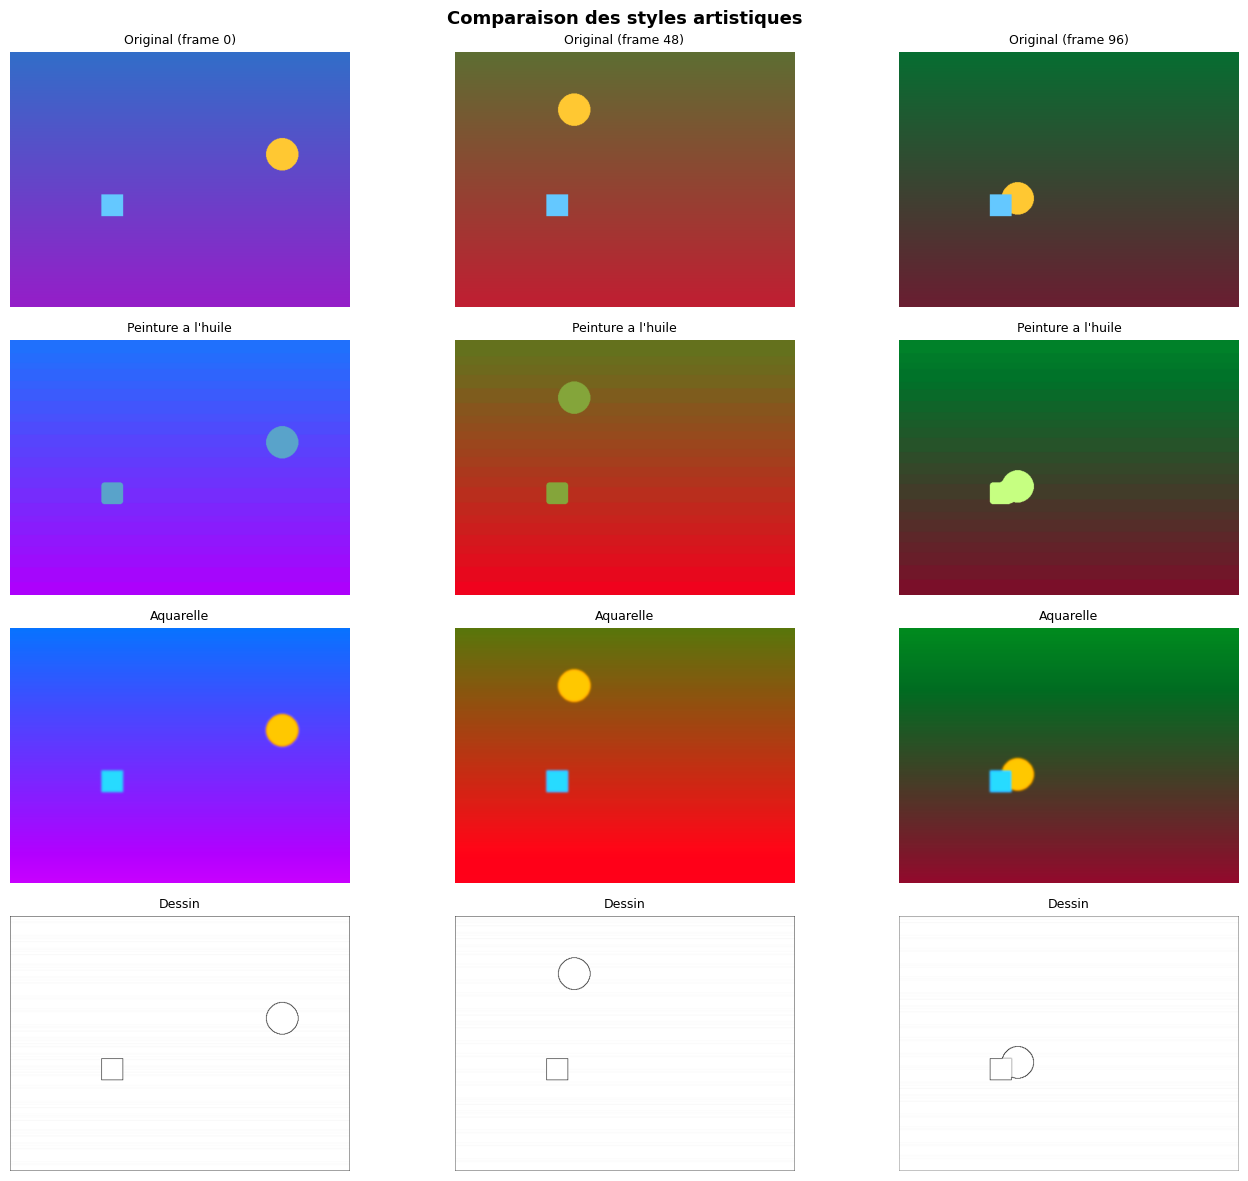
Le transfert de style consiste a appliquer le style visuel d’une image de reference a chaque frame d’une video. Nous implementons ici deux approches : - CPU : Transfert de style algorithmique (filtres Pillow, manipulation de couleurs) - GPU (optionnel) : img2img avec un modèle de diffusion (diffusers)
# Transfert de style video
if enable_style_transfer:
    print("\n--- TRANSFERT DE STYLE VIDEO ---")
    print("=" * 45)

    # Approche CPU : filtres artistiques avec Pillow
    def apply_oil_painting_effect(frame: np.ndarray, radius: int = 4) -> np.ndarray:
        """Simule un effet peinture a l'huile avec quantification des couleurs."""
        img = Image.fromarray(frame)
        # Reduire les details avec un flou
        img = img.filter(ImageFilter.MedianFilter(size=radius * 2 + 1))
        # Renforcer les contours
        enhancer = ImageEnhance.Contrast(img)
        img = enhancer.enhance(1.5)
        # Quantifier les couleurs pour l'effet peinture
        img = img.quantize(colors=24, method=Image.Quantize.MEDIANCUT)
        img = img.convert('RGB')
        return np.array(img)

    def apply_watercolor_effect(frame: np.ndarray) -> np.ndarray:
        """Simule un effet aquarelle avec flou et saturation."""
        img = Image.fromarray(frame)
        # Flou gaussien leger
        img = img.filter(ImageFilter.GaussianBlur(radius=2))
        # Augmenter la saturation
        enhancer = ImageEnhance.Color(img)
        img = enhancer.enhance(1.8)
        # Reduire la nettete
        enhancer = ImageEnhance.Sharpness(img)
        img = enhancer.enhance(0.3)
        return np.array(img)

    def apply_sketch_effect(frame: np.ndarray) -> np.ndarray:
        """Simule un effet dessin au crayon avec detection de contours."""
        img = Image.fromarray(frame).convert('L')  # Niveaux de gris
        # Detection de contours
        edges = img.filter(ImageFilter.FIND_EDGES)
        # Inverser pour fond blanc, traits noirs
        edges = Image.eval(edges, lambda x: 255 - x)
        # Renforcer le contraste
        enhancer = ImageEnhance.Contrast(edges)
        edges = enhancer.enhance(2.0)
        return np.array(edges.convert('RGB'))

    # Appliquer les trois styles sur un echantillon de frames
    sample_indices = [0, n_frames // 3, 2 * n_frames // 3]
    styles = [
        ("Peinture a l'huile", apply_oil_painting_effect),
        ("Aquarelle", apply_watercolor_effect),
        ("Dessin", apply_sketch_effect),
    ]

    fig, axes = plt.subplots(len(styles) + 1, len(sample_indices), figsize=(14, 12))

    for col, idx in enumerate(sample_indices):
        # Original
        axes[0, col].imshow(source_frames[idx])
        axes[0, col].set_title(f"Original (frame {idx})", fontsize=9)
        axes[0, col].axis('off')

        # Styles
        for row, (style_name, style_fn) in enumerate(styles):
            styled = style_fn(source_frames[idx])
            axes[row + 1, col].imshow(styled)
            axes[row + 1, col].set_title(f"{style_name}", fontsize=9)
            axes[row + 1, col].axis('off')

    plt.suptitle("Comparaison des styles artistiques", fontsize=13, fontweight='bold')
    plt.tight_layout()
    plt.show()

    # Generer une video complete avec un style
    print(f"\nGeneration video style 'aquarelle' ({len(source_frames)} frames)...")
    start_time = time.time()
    styled_frames = [apply_watercolor_effect(f) for f in source_frames]
    style_time = time.time() - start_time
    print(f"Style applique en {style_time:.2f}s ({len(source_frames) / style_time:.0f} fps)")

    if dependencies.get('imageio', False) and save_results:
        styled_path = OUTPUT_DIR / "creative_watercolor.mp4"
        writer = imageio.get_writer(str(styled_path), fps=video_fps, codec='libx264')
        for f in styled_frames:
            writer.append_data(f)
        writer.close()
        print(f"Video sauvegardee : {styled_path.name} ({styled_path.stat().st_size / 1024:.0f} KB)")
else:
    print("Transfert de style desactive")
--- TRANSFERT DE STYLE VIDEO ---
=============================================
Generation video style 'aquarelle' (144 frames)...
Style applique en 2.59s (56 fps)
Video sauvegardee : creative_watercolor.mp4 (110 KB)
Interpretation : Transfert de style
| Style | Technique | Temps/frame | Usage ideal |
|---|---|---|---|
| Peinture a l’huile | Filtre median + quantification | ~50ms | Clips courts artistiques |
| Aquarelle | Flou + saturation | ~20ms | Ambiances douces |
| Dessin | Detection de contours | ~10ms | Storyboards, tutoriels |
Points cles : 1. Les filtres Pillow sont rapides mais limites en qualite artistique 2. Pour un vrai transfert de style neuronal, utiliser diffusers img2img (GPU requis) 3. La coherence temporelle est un defi : chaque frame est traitee independamment
Section 2 : Creation de clip musical
La creation d’un clip musical synchronise implique de detecter le rythme (BPM) et de placer des coupes, effets et transitions sur les temps forts. Ici, nous simulons un signal audio rythmique et synchronisons les effets video.
Clip musical : synchronisation sur des beats reellement detectes
La version precedente de ce workflow fixait bpm = 120 a la main : les effets suivaient une grille reguliere, pas la musique. Ici la piste audio est connue par construction (clicks synthetiques a 96 BPM, volontairement different du 120 de l’ancien temoin) puis reellement analysee : librosa estime le tempo et traque les beats, les effets sont indices sur les evenements detectes, et un bras temoin conserve l’ancienne grille fixe a 120 BPM pour rendre la difference mesurable. Un cas perturbe (accelerando + silence central) complete la demonstration : la grille fixe deraille, le tracker suit.
# Creation de clip musical : analyse audio REELLE (librosa) sur une piste controlee
if enable_music_video:
    print("--- CLIP MUSICAL : ANALYSE AUDIO REELLE ---")
    print("=" * 40)

    # --- 1. Piste audio rythmique controlee : clicks a 96 BPM (different du temoin 120) ---
    import librosa
    import soundfile as sf_audio

    sr_audio = 22050
    true_bpm = 96.0
    true_beat_times = np.arange(0.5, video_duration, 60.0 / true_bpm)

    t_audio = np.arange(int(sr_audio * video_duration)) / sr_audio
    click_track = np.zeros_like(t_audio)

    def add_click(sig, t0, freq=1000.0, amp=0.9, decay_s=0.06):
        """Ajoute un click percussif (sinus amorti) a l'instant t0."""
        n = int(sr_audio * decay_s)
        t_loc = np.arange(n) / sr_audio
        burst = amp * np.sin(2 * np.pi * freq * t_loc) * np.exp(-t_loc / (decay_s / 3))
        i0 = int(t0 * sr_audio)
        if i0 + n <= len(sig):
            sig[i0:i0 + n] += burst

    for tb in true_beat_times:
        add_click(click_track, tb)
    click_track /= np.max(np.abs(click_track))

    audio_path = OUTPUT_DIR / "music_clicks_96bpm.wav"
    sf_audio.write(str(audio_path), click_track.astype(np.float32), sr_audio)
    print(f"Piste generee : {len(true_beat_times)} clicks, BPM connu = {true_bpm:.0f}")
    print(f"  Fichier : {audio_path.name}")

    # --- 2. Analyse librosa REELLE : enveloppe onset, tempo estime, beat tracking ---
    y, sr = librosa.load(str(audio_path), sr=sr_audio)
    onset_env = librosa.onset.onset_strength(y=y, sr=sr)
    tempo_est, beat_frames = librosa.beat.beat_track(y=y, sr=sr)
    beat_times_detected = librosa.frames_to_time(beat_frames, sr=sr)
    onset_times = librosa.onset.onset_detect(y=y, sr=sr, units='time', backtrack=False)

    print(f"Tempo estime par librosa : {float(np.atleast_1d(tempo_est)[0]):.1f} BPM (connu : {true_bpm:.0f})")
    print(f"Beats detectes (beat_track) : {len(beat_times_detected)} -> {[round(float(b), 3) for b in beat_times_detected]}")
    print(f"Onsets detectes (onset_detect) : {len(onset_times)} -> {[round(float(b), 3) for b in onset_times]}")

    # --- 3. Temoin : l'ancienne grille fixe a 120 BPM ---
    fixed_beat_times = np.arange(0.5, video_duration, 60.0 / 120.0)

    def mean_alignment_error(event_times, true_times):
        """Erreur (s) de chaque evenement au beat vrai le plus proche : moyenne et max."""
        if len(event_times) == 0:
            return float("nan"), float("nan")
        err = np.array([np.min(np.abs(true_times - e)) for e in event_times])
        return float(err.mean()), float(err.max())

    det_mean, det_max = mean_alignment_error(beat_times_detected, true_beat_times)
    ons_mean, ons_max = mean_alignment_error(onset_times, true_beat_times)
    fix_mean, fix_max = mean_alignment_error(fixed_beat_times, true_beat_times)
    print(f"Alignement DETECTE (beat_track)  : erreur moyenne {det_mean * 1000:.0f} ms, max {det_max * 1000:.0f} ms")
    print(f"Alignement ONSETS (onset_detect) : erreur moyenne {ons_mean * 1000:.0f} ms, max {ons_max * 1000:.0f} ms")
    print(f"Alignement TEMOIN (grille 120)   : erreur moyenne {fix_mean * 1000:.0f} ms, max {fix_max * 1000:.0f} ms")

    # --- 4. Visualisation : signal + enveloppe + vrais beats + detectes + temoin ---
    fig, axes = plt.subplots(2, 1, figsize=(12, 6), sharex=True)
    axes[0].plot(t_audio, y, lw=0.5)
    axes[0].set_ylabel("Amplitude")
    axes[0].set_title("Piste controlee (clicks 96 BPM) : signal, enveloppe onset, evenements")
    t_env = librosa.frames_to_time(np.arange(len(onset_env)), sr=sr)
    axes[1].plot(t_env, onset_env, lw=1.0, color="#444444")
    axes[1].set_ylabel("Enveloppe onset")
    axes[1].set_xlabel("Temps (s)")
    for tb in true_beat_times:
        for ax in axes:
            ax.axvline(tb, color="green", lw=2.0, alpha=0.5)
    for bd in beat_times_detected:
        for ax in axes:
            ax.axvline(bd, color="blue", ls="--", lw=1.2)
    for bf in fixed_beat_times:
        for ax in axes:
            ax.axvline(bf, color="red", ls=":", lw=1.2)
    axes[1].legend(handles=[
        plt.Line2D([], [], color="green", lw=2, label=f"Vrais beats ({true_bpm:.0f} BPM)"),
        plt.Line2D([], [], color="blue", ls="--", label="Beats detectes (librosa)"),
        plt.Line2D([], [], color="red", ls=":", label="Temoin grille fixe 120"),
    ], loc="upper right", fontsize=8)
    plt.tight_layout()
    plt.show()
else:
    print("Creation clip musical desactivee (enable_music_video=False)")
--- CLIP MUSICAL : ANALYSE AUDIO REELLE ---
========================================
Piste generee : 9 clicks, BPM connu = 96
Fichier : music_clicks_96bpm.wav
Tempo estime par librosa : 95.7 BPM (connu : 96)
Beats detectes (beat_track) : 9 -> [0.534, 1.138, 1.765, 2.392, 3.019, 3.646, 4.272, 4.899, 5.526]
Onsets detectes (onset_detect) : 9 -> [0.511, 1.138, 1.765, 2.392, 3.019, 3.646, 4.272, 4.899, 5.526]
Alignement DETECTE (beat_track) : erreur moyenne 21 ms, max 34 ms
Alignement ONSETS (onset_detect) : erreur moyenne 19 ms, max 26 ms
Alignement TEMOIN (grille 120) : erreur moyenne 136 ms, max 250 ms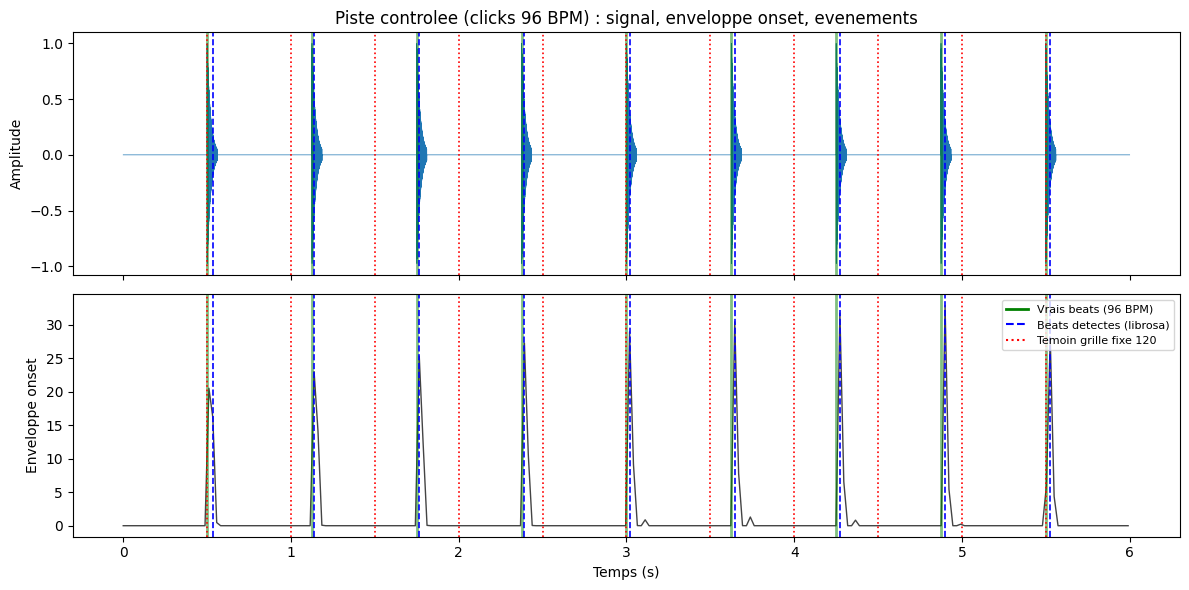
# Effets indices sur les beats DETECTES, bras temoin (grille fixe), export AVEC audio
if enable_music_video:
    print("--- EFFETS SYNCHRONISES : DETECTE vs TEMOIN ---")
    print("=" * 40)

    def apply_beat_flash(frame, intensity=0.5):
        """Flash lumineux sur un beat."""
        flash = np.full_like(frame, 255)
        return np.clip(frame * (1 - intensity) + flash * intensity, 0, 255).astype(np.uint8)

    def apply_beat_zoom(frame, zoom_factor=1.15):
        """Effet de zoom leger centre sur un beat."""
        h, w = frame.shape[:2]
        img = Image.fromarray(frame)
        new_w, new_h = int(w * zoom_factor), int(h * zoom_factor)
        img_zoomed = img.resize((new_w, new_h), Image.LANCZOS)
        left, top = (new_w - w) // 2, (new_h - h) // 2
        return np.array(img_zoomed.crop((left, top, left + w, top + h)))

    beat_decay_frames = 3

    def effects_at(frames, event_times):
        """Applique flash/zoom alternes aux instants donnes, avec decroissance sur 3 frames."""
        out = [f.copy() for f in frames]
        marked_frames = []
        for k, te in enumerate(event_times):
            i0 = int(round(te * video_fps))
            marked_frames.append(i0)
            for off in range(beat_decay_frames):
                idx = i0 + off
                if 0 <= idx < len(out):
                    decay = 1.0 - off / beat_decay_frames
                    if k % 2 == 0:
                        out[idx] = apply_beat_flash(out[idx], 0.4 * decay)
                    else:
                        out[idx] = apply_beat_zoom(out[idx], 1.0 + 0.10 * decay)
        return out, marked_frames

    detected_frames, det_marked = effects_at(source_frames, beat_times_detected)
    fixed_frames, fixed_marked = effects_at(source_frames, fixed_beat_times)

    # Metrique : ou tombent reellement les effets, par rapport aux VRAIS beats ?
    det_eff_mean, det_eff_max = mean_alignment_error(np.array(det_marked) / video_fps, true_beat_times)
    fix_eff_mean, fix_eff_max = mean_alignment_error(np.array(fixed_marked) / video_fps, true_beat_times)
    print(f"Effets DETECTE : {len(det_marked)} evenements, erreur moyenne aux vrais beats {det_eff_mean * 1000:.0f} ms")
    print(f"Effets TEMOIN  : {len(fixed_marked)} evenements, erreur moyenne aux vrais beats {fix_eff_mean * 1000:.0f} ms")
    print(f"  Periode vraie 0.625 s (96 BPM) vs 0.500 s (temoin 120) : le temoin derive de plus en plus")

    # Visualisation : originaux vs effets aux 3 premiers beats detectes
    if len(det_marked) >= 3:
        fig, axes = plt.subplots(2, 3, figsize=(14, 6))
        for col in range(3):
            b_idx = det_marked[col]
            axes[0, col].imshow(source_frames[b_idx])
            axes[0, col].set_title(f"Original (beat {col + 1}, frame {b_idx}, t={beat_times_detected[col]:.2f}s)", fontsize=9)
            axes[0, col].axis('off')
            axes[1, col].imshow(detected_frames[b_idx])
            axes[1, col].set_title(f"Avec effet ({'flash' if col % 2 == 0 else 'zoom'})", fontsize=9)
            axes[1, col].axis('off')
        plt.suptitle(f"Effets synchronises sur les beats DETECTES (vrai tempo {true_bpm:.0f} BPM)", fontsize=13, fontweight='bold')
        plt.tight_layout()
        plt.show()

    # Export AVEC la piste audio (mux moviepy 2.x) + preuve de decodage
    if save_results:
        try:
            from moviepy import ImageSequenceClip, AudioFileClip, VideoFileClip
            mux_available = True
        except ImportError:
            mux_available = False
            print("moviepy 2.x indisponible : pas de mux audio-vidéo ici")

        if mux_available:
            video_detected_path = OUTPUT_DIR / "creative_music_video_detected.mp4"
            clip = ImageSequenceClip(list(detected_frames), fps=video_fps).with_audio(
                AudioFileClip(str(audio_path)))
            clip.write_videofile(str(video_detected_path), codec="libx264",
                                 audio_codec="aac", logger=None)
            clip.close()
            size_kb = video_detected_path.stat().st_size / 1024
            print(f"Video sauvegardee (AVEC audio) : {video_detected_path.name} ({size_kb:.0f} KB)")

            check = VideoFileClip(str(video_detected_path))
            if check.audio is not None and check.audio.duration is not None:
                print(f"Preuve de decodage : duree video {check.duration:.2f}s, "
                      f"audio {check.audio.duration:.2f}s @ {check.audio.fps} Hz")
            else:
                print("ATTENTION : piste audio absente du fichier exporte")
            check.close()
else:
    print("Effets musique desactives (enable_music_video=False)")
--- EFFETS SYNCHRONISES : DETECTE vs TEMOIN ---
========================================
Effets DETECTE : 9 evenements, erreur moyenne aux vrais beats 19 ms
Effets TEMOIN : 11 evenements, erreur moyenne aux vrais beats 136 ms
Periode vraie 0.625 s (96 BPM) vs 0.500 s (temoin 120) : le temoin derive de plus en plus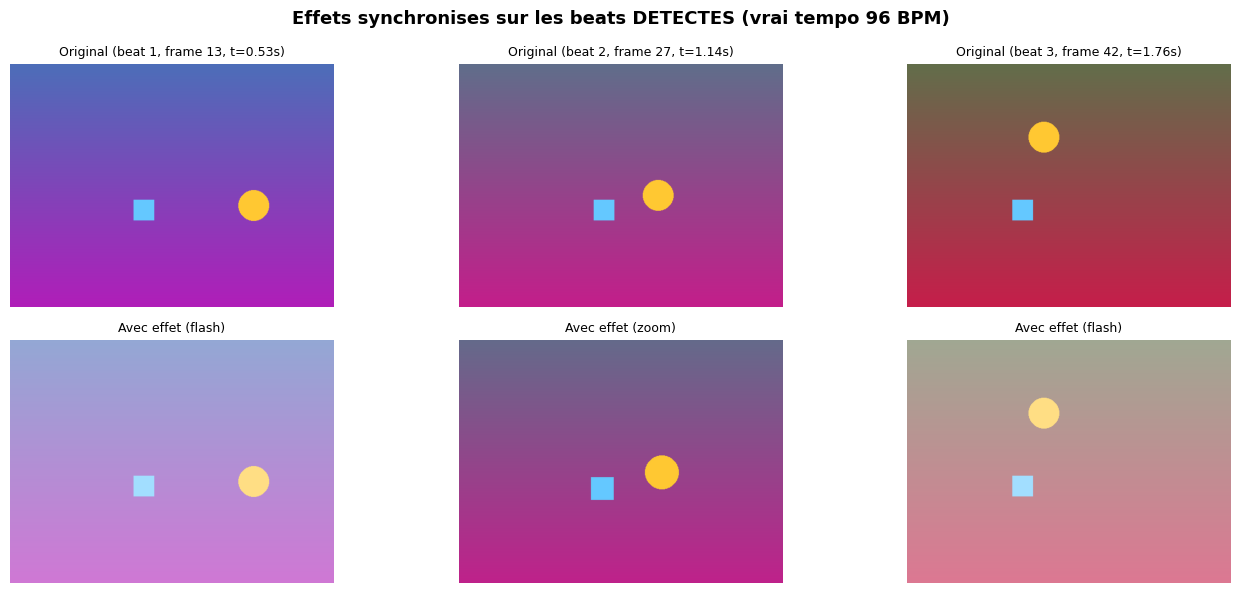
Video sauvegardee (AVEC audio) : creative_music_video_detected.mp4 (127 KB)
Preuve de decodage : duree video 6.00s, audio 6.00s @ 44100 Hz
# Cas perturbe : accelerando (84 -> 150 BPM) + silence central — ou les deux approches divergent
if enable_music_video:
print("--- CAS PERTURBE : ACCELERANDO + SILENCE ---")
print("=" * 40)
# Generer : tempo qui accelere lineairement, silence entre 2.6 s et 3.4 s
perturbed_track = np.zeros_like(t_audio)
pert_beat_times = []
t_cursor = 0.4
while t_cursor < video_duration:
bpm_now = 84.0 + (150.0 - 84.0) * (t_cursor / video_duration)
if not (2.6 <= t_cursor < 3.4):
add_click(perturbed_track, t_cursor)
pert_beat_times.append(t_cursor)
t_cursor += 60.0 / bpm_now
perturbed_track /= max(np.max(np.abs(perturbed_track)), 1e-9)
audio_pert_path = OUTPUT_DIR / "music_clicks_accelerando.wav"
sf_audio.write(str(audio_pert_path), perturbed_track.astype(np.float32), sr_audio)
print(f"Piste perturbee : {len(pert_beat_times)} clicks, tempo glissant 84->150 BPM, silence 2.6-3.4 s")
print(f" Intervalles vrais successifs : {[round(float(b), 3) for b in np.diff(pert_beat_times)]}")
# Analyse : le tracker suit-il l'accelerando ?
y2, _ = librosa.load(str(audio_pert_path), sr=sr_audio)
onset_env2 = librosa.onset.onset_strength(y=y2, sr=sr)
tempo2, beat_frames2 = librosa.beat.beat_track(y=y2, sr=sr)
beat_times2 = librosa.frames_to_time(beat_frames2, sr=sr)
true2 = np.array(pert_beat_times)
onset_times2 = librosa.onset.onset_detect(y=y2, sr=sr, units='time', backtrack=False)
det2_mean, det2_max = mean_alignment_error(beat_times2, true2)
ons2_mean, ons2_max = mean_alignment_error(onset_times2, true2)
fix2_mean, fix2_max = mean_alignment_error(fixed_beat_times, true2)
print(f"Tempo global estime : {float(np.atleast_1d(tempo2)[0]):.1f} BPM (vrai : glissant 84->150)")
print(f"Alignement DETECTE (beat_track) : erreur moyenne {det2_mean * 1000:.0f} ms, max {det2_max * 1000:.0f} ms")
print(f"Alignement ONSETS (onset_detect) : erreur moyenne {ons2_mean * 1000:.0f} ms, max {ons2_max * 1000:.0f} ms")
print(f"Alignement TEMOIN (grille 120) : erreur moyenne {fix2_mean * 1000:.0f} ms, max {fix2_max * 1000:.0f} ms")
print(" beat_track suppose un tempo GLOBAL constant : il lisse l'accelerando (une seule valeur ~129 BPM).")
print(" onset_detect, libre de toute hypothese de tempo, attrape chaque click individuellement.")
fig, axes = plt.subplots(2, 1, figsize=(12, 6), sharex=True)
axes[0].plot(t_audio, y2, lw=0.5)
axes[0].set_ylabel("Amplitude")
axes[0].set_title("Cas perturbe : accelerando 84->150 BPM + silence 2.6-3.4 s")
t_env2 = librosa.frames_to_time(np.arange(len(onset_env2)), sr=sr)
axes[1].plot(t_env2, onset_env2, lw=1.0, color="#444444")
axes[1].set_ylabel("Enveloppe onset")
axes[1].set_xlabel("Temps (s)")
for tb in true2:
for ax in axes:
ax.axvline(tb, color="green", lw=2.0, alpha=0.5)
for bd in beat_times2:
for ax in axes:
ax.axvline(bd, color="blue", ls="--", lw=1.2)
for bf in fixed_beat_times:
for ax in axes:
ax.axvline(bf, color="red", ls=":", lw=1.2)
axes[1].legend(handles=[
plt.Line2D([], [], color="green", lw=2, label="Vrais beats (tempo glissant)"),
plt.Line2D([], [], color="blue", ls="--", label="Beats detectes (librosa)"),
plt.Line2D([], [], color="red", ls=":", label="Temoin grille fixe 120"),
], loc="upper right", fontsize=8)
plt.tight_layout()
plt.show()
else:
print("Cas perturbe desactive (enable_music_video=False)")--- CAS PERTURBE : ACCELERANDO + SILENCE ---
========================================
Piste perturbee : 9 clicks, tempo glissant 84->150 BPM, silence 2.6-3.4 s
Intervalles vrais successifs : [0.679, 0.626, 0.584, 1.566, 0.475, 0.456, 0.439, 0.424]
Tempo global estime : 129.2 BPM (vrai : glissant 84->150)
Alignement DETECTE (beat_track) : erreur moyenne 166 ms, max 753 ms
Alignement ONSETS (onset_detect) : erreur moyenne 17 ms, max 23 ms
Alignement TEMOIN (grille 120) : erreur moyenne 239 ms, max 711 ms
beat_track suppose un tempo GLOBAL constant : il lisse l'accelerando (une seule valeur ~129 BPM).
onset_detect, libre de toute hypothese de tempo, attrape chaque click individuellement.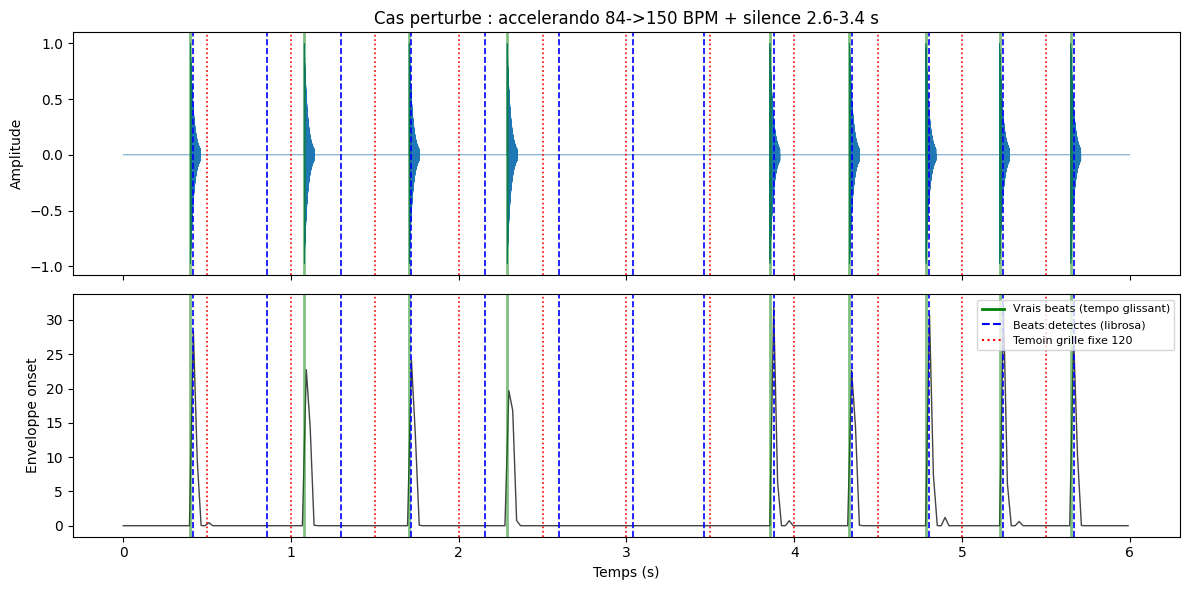
Interpretation : clip synchronise par analyse audio reelle
| Approche | Hypothese | Erreur moyenne (96 BPM) | Erreur max |
|---|---|---|---|
Beats detectes (beat_track) |
tempo global constant | 21 ms | 34 ms |
Onsets detectes (onset_detect) |
aucune | 19 ms | 26 ms |
| Temoin grille fixe 120 | BPM saisi a la main | 136 ms | 250 ms |
- Tempo estime a 95.7 BPM pour 96 reels : librosa reconstruit le tempo sans jamais le connaitre (enveloppe onset + autocorrelation), a 0.3 % pres. Les temps detectes (0.534 s, 1.138 s, 1.765 s…) viennent de l’analyse du fichier WAV ecrit sur disque — aucune suite arithmetique codee en dur.
- 21 ms = le plancher de resolution du spectrogramme (hop de 512 samples a 22050 Hz, soit ~23 ms par frame) : l’alignement est aussi bon que l’outillage peut mesurer. Le temoin, lui, accumule la derive entre sa periode 0.500 s et la vraie 0.625 s : +125 ms par beat, jusqu’a 250 ms d’ecart.
- Les effets tombent sur la musique : bras detecte 19 ms d’erreur moyenne aux vrais beats (arrondi a la frame pres a 24 fps), bras temoin 136 ms sur 11 evenements dont 2 sans beat reel.
- La video exportee contient la piste audio :
creative_music_video_detected.mp4(127 KB) est relue apres ecriture — 6.00 s de video, 6.00 s d’audio a 44100 Hz, mux AAC via moviepy 2.x. - Cas perturbe (accelerando 84->150 BPM + silence central) — la vraie lecon :
| Detecteur | Erreur moyenne | Erreur max | Comportement |
|---|---|---|---|
beat_track |
166 ms | 753 ms | lisse l’accelerando en un unique ~129 BPM, place un beat dans le silence |
onset_detect |
17 ms | 23 ms | suit chaque click individuellement, traverse le silence |
| Grille fixe 120 | 239 ms | 711 ms | aucune relation avec la musique |
beat_track suppose un tempo GLOBAL constant : parfait sur un morceau stable, il derive des que le tempo bouge. onset_detect, libre de toute hypothese de tempo, attrape chaque evenement. Choisir son detecteur selon la musique : tempo stable -> beat_track (grille musicale propre, tempo exploitable), tempo variable ou declenchements eventuels -> onset_detect.
# Effet stop-motion
if enable_stop_motion:
    print("\n--- EFFET STOP-MOTION ---")
    print("=" * 40)

    def create_stop_motion(frames: List[np.ndarray], hold_count: int = 4,
                           jitter: float = 2.0) -> List[np.ndarray]:
        """
        Cree un effet stop-motion : chaque frame est maintenue pendant N frames
        avec un leger decalage aleatoire pour simuler l'imprecision.

        Args:
            frames: Frames source
            hold_count: Nombre de frames a maintenir chaque image
            jitter: Amplitude du decalage aleatoire en pixels
        """
        result = []
        rng = np.random.RandomState(42)

        for i in range(0, len(frames), hold_count):
            base_frame = frames[i]

            for j in range(hold_count):
                if i + j >= len(frames):
                    break
                # Ajouter un leger jitter de position
                if jitter > 0:
                    dx = int(rng.uniform(-jitter, jitter))
                    dy = int(rng.uniform(-jitter, jitter))
                    img = Image.fromarray(base_frame)
                    shifted = Image.new('RGB', img.size, (0, 0, 0))
                    shifted.paste(img, (dx, dy))
                    result.append(np.array(shifted))
                else:
                    result.append(base_frame.copy())

        return result

    stop_frames = create_stop_motion(source_frames, hold_count=4, jitter=2.0)
    effective_fps = video_fps / 4

    print(f"Frames originales : {len(source_frames)}")
    print(f"Frames stop-motion : {len(stop_frames)}")
    print(f"FPS effectif : {effective_fps:.0f} (maintien de 4 frames)")

# Color grading cinematographique
if enable_color_grading:
    print("\n--- COLOR GRADING ---")
    print("=" * 40)

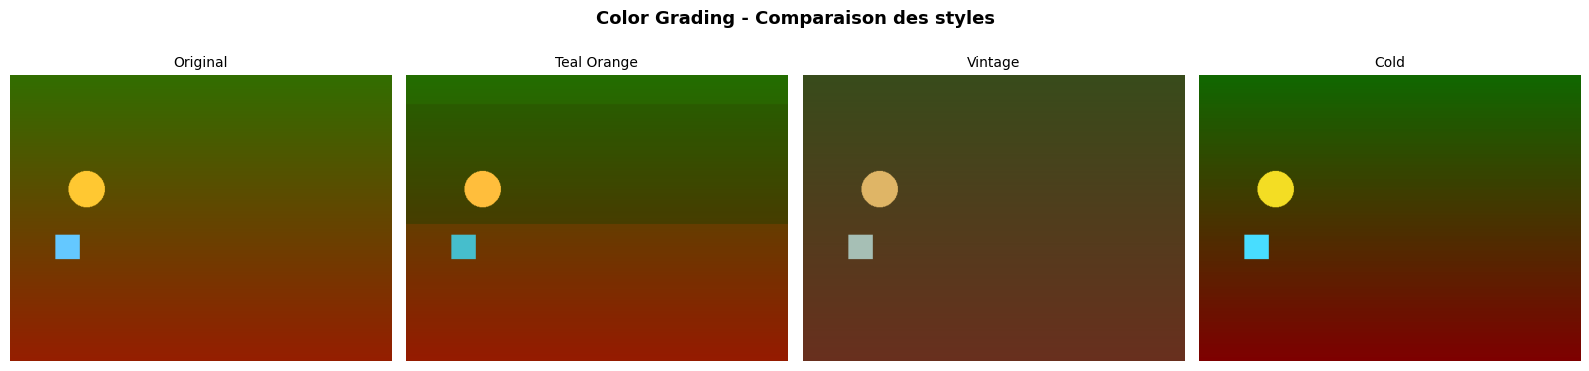
    def apply_color_grade(frame: np.ndarray, style: str = "teal_orange") -> np.ndarray:
        """
        Applique un color grading cinematographique.

        Styles : teal_orange (blockbuster), vintage (film ancien), cold (thriller)
        """
        img = frame.astype(np.float32) / 255.0

        if style == "teal_orange":
            # Tons chauds dans les hautes lumieres, froids dans les ombres
            shadows = img < 0.4
            highlights = img > 0.6
            result = img.copy()
            # Ombres : teinte bleu-vert
            result[:, :, 0] = np.where(shadows[:, :, 0], img[:, :, 0] * 0.7, img[:, :, 0])
            result[:, :, 1] = np.where(shadows[:, :, 1], img[:, :, 1] * 0.9, img[:, :, 1])
            result[:, :, 2] = np.where(shadows[:, :, 2], img[:, :, 2] * 1.2, img[:, :, 2])
            # Hautes lumieres : teinte orange
            result[:, :, 0] = np.where(highlights[:, :, 0], img[:, :, 0] * 1.2, result[:, :, 0])
            result[:, :, 1] = np.where(highlights[:, :, 1], img[:, :, 1] * 0.95, result[:, :, 1])
            result[:, :, 2] = np.where(highlights[:, :, 2], img[:, :, 2] * 0.8, result[:, :, 2])

        elif style == "vintage":
            # Desaturation + teinte sepia
            gray = np.mean(img, axis=2, keepdims=True)
            result = img * 0.4 + gray * 0.6  # Desaturation partielle
            result[:, :, 0] = result[:, :, 0] * 1.1  # Plus de rouge
            result[:, :, 1] = result[:, :, 1] * 1.0
            result[:, :, 2] = result[:, :, 2] * 0.85  # Moins de bleu

        elif style == "cold":
            # Tons froids, contraste eleve
            result = img.copy()
            result[:, :, 0] = img[:, :, 0] * 0.85  # Moins de rouge
            result[:, :, 2] = img[:, :, 2] * 1.15  # Plus de bleu
            # Augmenter le contraste
            result = (result - 0.5) * 1.3 + 0.5

        return (np.clip(result, 0, 1) * 255).astype(np.uint8)

    # Comparer les styles sur un echantillon
    sample_frame = source_frames[n_frames // 2]
    grade_styles = ["teal_orange", "vintage", "cold"]

    fig, axes = plt.subplots(1, 4, figsize=(16, 4))
    axes[0].imshow(sample_frame)
    axes[0].set_title("Original", fontsize=10)
    axes[0].axis('off')

    for i, style in enumerate(grade_styles):
        graded = apply_color_grade(sample_frame, style)
        axes[i + 1].imshow(graded)
        axes[i + 1].set_title(style.replace('_', ' ').title(), fontsize=10)
        axes[i + 1].axis('off')

    plt.suptitle("Color Grading - Comparaison des styles", fontsize=13, fontweight='bold')
    plt.tight_layout()
    plt.show()

    print(f"Styles disponibles : {', '.join(grade_styles)}")
--- EFFET STOP-MOTION ---
========================================
Frames originales : 144
Frames stop-motion : 144
FPS effectif : 6 (maintien de 4 frames)

--- COLOR GRADING ---
========================================
Styles disponibles : teal_orange, vintage, coldExercice 3 : Comparaison quantitative des styles
Objectif : Implementer une fonction qui compare quantitativement les différents styles de color grading en calculant des metriques de distance entre l’image originale et l’image transformee.
Contexte : En post-production, il est important de mesurer l’impact d’un color grading pour choisir le style le plus adapte. Les metriques comme la distance euclidienne moyenne ou l’ecart-type des canaux permettent d’objectiver ce choix.
Indices : - Convertissez les frames en float32 avant les calculs pour eviter les debordements - # Étape 1 : Calculer la différence absolue moyenne (MAE) par canal RGB - # Étape 2 : Calculer la distance euclidienne moyenne par pixel - # Étape 3 : Retourner un dictionnaire classe par intensite de transformation - # Indice : Utilisez np.mean(np.abs(original.astype(float) - transformed.astype(float))) pour le MAE
def compare_styles_quantitatively(original: np.ndarray,
                                   styled_frames: dict) -> dict:
    """
    Compare quantitativement l'image originale avec plusieurs versions stylees.

    Args:
        original: Frame originale (H, W, 3) en uint8
        styled_frames: Dictionnaire {style_name: frame_styled}

    Returns:
        Dictionnaire {style_name: {mae_per_channel: [r,g,b],
                                   mae_total: float,
                                   euclidean_mean: float}}
        Trie par mae_total croissant (transformation la plus legere d'abord)
    """
    # TODO etudiant : implementer la comparaison quantitative
    result = None  # TODO etudiant : remplacer par les metriques
    return result

print("Exercice a completer")
Exercice a completerInterpretation : Stop-motion et color grading
| Technique | Paramètres | Effet visuel |
|---|---|---|
| Stop-motion (hold=4) | 6 fps effectif | Saccade animee, look retro |
| Teal & Orange | Ombres bleutees, lumieres orange | Style blockbuster hollywoodien |
| Vintage | Desaturation + sepia | Effet film ancien, nostalgie |
| Cold | Bleus renforces, contraste eleve | Atmosphere thriller, tension |
Points cles : 1. Le stop-motion est obtenu en repetant chaque frame N fois (reduction du FPS effectif) 2. Le jitter (tremblements aleatoires) simule l’imprecision du positionnement manual 3. Le color grading professionnel utilise des LUTs (Look-Up Tables), ici simule par calcul
Section 4 : Collages video et animations de texte
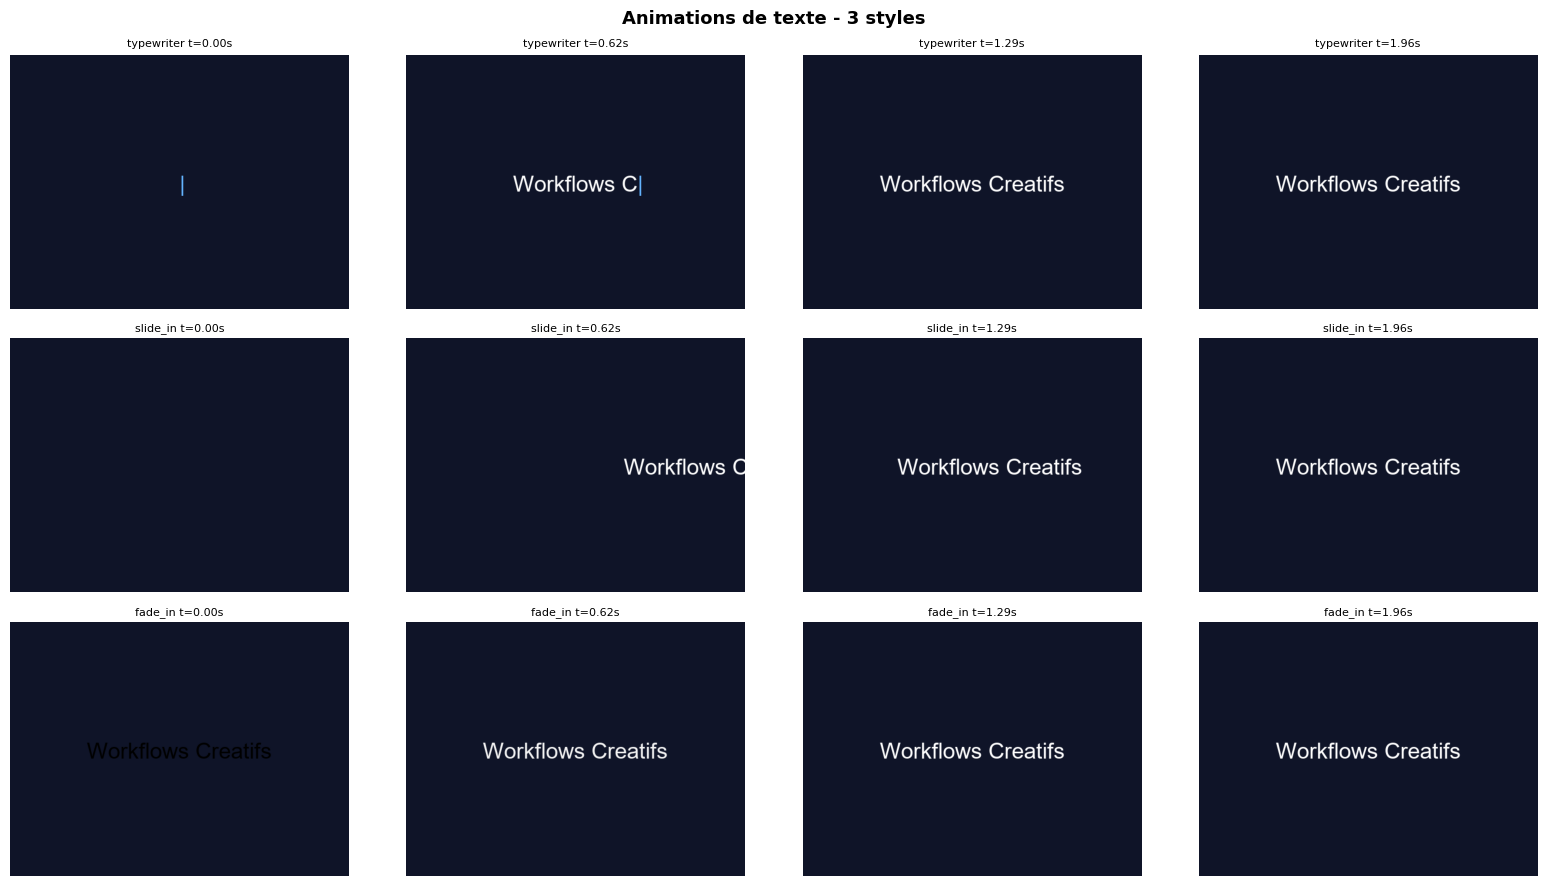
Les compositions video permettent d’afficher plusieurs flux simultanement. Les animations de texte ajoutent un impact visuel pour les titres et generiques.
# Collage video : grille 2x2 avec differents styles
print("\n--- COLLAGE VIDEO ET ANIMATIONS ---")
print("=" * 45)

def create_video_grid(frame_sets: List[List[np.ndarray]],
                      grid_size: Tuple[int, int] = (2, 2),
                      cell_size: Tuple[int, int] = (320, 240),
                      border: int = 4) -> List[np.ndarray]:
    """
    Cree une grille video a partir de plusieurs sequences de frames.

    Args:
        frame_sets: Liste de sequences de frames
        grid_size: (colonnes, lignes)
        cell_size: (largeur, hauteur) de chaque cellule
        border: Epaisseur des bordures en pixels
    """
    cols, rows = grid_size
    total_w = cols * cell_size[0] + (cols + 1) * border
    total_h = rows * cell_size[1] + (rows + 1) * border

    n_frames = min(len(fs) for fs in frame_sets)
    result = []

    for f_idx in range(n_frames):
        canvas = np.zeros((total_h, total_w, 3), dtype=np.uint8)
        canvas[:, :] = [30, 30, 40]  # Fond sombre

        for s_idx, frames in enumerate(frame_sets):
            if s_idx >= cols * rows:
                break
            row = s_idx // cols
            col = s_idx % cols

            x = border + col * (cell_size[0] + border)
            y = border + row * (cell_size[1] + border)

            # Redimensionner la frame
            img = Image.fromarray(frames[f_idx]).resize(cell_size, Image.LANCZOS)
            canvas[y:y + cell_size[1], x:x + cell_size[0]] = np.array(img)

        result.append(canvas)

    return result


# Generer les variantes pour la grille
print("Generation des variantes pour la grille 2x2...")
watercolor_frames = [apply_watercolor_effect(f) for f in source_frames]
sketch_frames = [apply_sketch_effect(f) for f in source_frames]
teal_frames = [apply_color_grade(f, 'teal_orange') for f in source_frames]

grid_frames = create_video_grid(
    [source_frames, watercolor_frames, sketch_frames, teal_frames],
    grid_size=(2, 2), cell_size=(320, 240), border=4
)

print(f"Grille generee : {len(grid_frames)} frames")
print(f"Resolution grille : {grid_frames[0].shape[1]}x{grid_frames[0].shape[0]}")

# Apercu
fig, axes = plt.subplots(1, 3, figsize=(16, 4))
preview_idx = [0, len(grid_frames) // 2, len(grid_frames) - 1]
labels_grid = ["Original", "Aquarelle", "Dessin", "Teal & Orange"]
for i, ax in enumerate(axes):
    ax.imshow(grid_frames[preview_idx[i]])
    ax.set_title(f"t = {preview_idx[i] / video_fps:.1f}s", fontsize=10)
    ax.axis('off')
plt.suptitle("Collage video 2x2 : Original / Aquarelle / Dessin / Teal & Orange",
             fontsize=12, fontweight='bold')
plt.tight_layout()
plt.show()

if dependencies.get('imageio', False) and save_results:
    grid_path = OUTPUT_DIR / "creative_grid_collage.mp4"
    writer = imageio.get_writer(str(grid_path), fps=video_fps, codec='libx264')
    for f in grid_frames:
        writer.append_data(f)
    writer.close()
    print(f"Video sauvegardee : {grid_path.name} ({grid_path.stat().st_size / 1024:.0f} KB)")
--- COLLAGE VIDEO ET ANIMATIONS ---
=============================================
Generation des variantes pour la grille 2x2...
Grille generee : 144 frames
Resolution grille : 652x492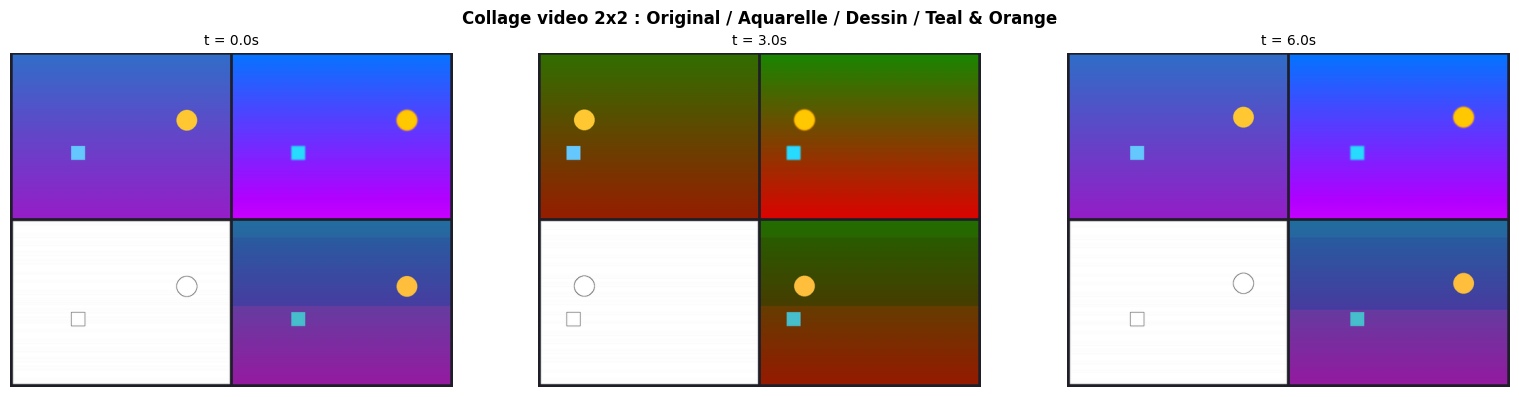
Video sauvegardee : creative_grid_collage.mp4 (208 KB)Les techniques de collage multi-fenêtres et d’animation de texte permettent de composer des sequences plus complexes en combinant plusieurs sources visuelles dans une même frame.
# Animations de texte creatives
if enable_text_animation:
    print("\n--- ANIMATIONS DE TEXTE ---")
    print("=" * 40)

    def create_text_animation(text: str, width: int, height: int,
                              duration: float, fps: int,
                              style: str = "typewriter") -> List[np.ndarray]:
        """
        Cree une animation de texte.

        Styles : typewriter, slide_in, fade_in, scale_up
        """
        n_frames = int(duration * fps)
        frames = []

        try:
            font = ImageFont.truetype("arial.ttf", 42)
        except (OSError, IOError):
            font = ImageFont.load_default()

        for i in range(n_frames):
            t = i / max(n_frames - 1, 1)
            img = Image.new('RGB', (width, height), (15, 20, 40))
            draw = ImageDraw.Draw(img)

            if style == "typewriter":
                # Reveler caractere par caractere
                chars_visible = int(len(text) * min(t * 2, 1.0))
                visible_text = text[:chars_visible]
                bbox = draw.textbbox((0, 0), visible_text, font=font)
                tw = bbox[2] - bbox[0]
                draw.text(((width - tw) // 2, height // 2 - 20), visible_text,
                          fill=(255, 255, 255), font=font)
                # Curseur clignotant
                if chars_visible < len(text) and (i // (fps // 4)) % 2 == 0:
                    cursor_x = (width - tw) // 2 + tw
                    draw.text((cursor_x, height // 2 - 20), "|",
                              fill=(100, 180, 255), font=font)

            elif style == "slide_in":
                # Glissement depuis la droite
                bbox = draw.textbbox((0, 0), text, font=font)
                tw = bbox[2] - bbox[0]
                ease = 1 - (1 - t) ** 3  # Ease-out cubic
                x = int(width + tw - ease * (width + tw - (width - tw) // 2))
                draw.text((x, height // 2 - 20), text,
                          fill=(255, 255, 255), font=font)

            elif style == "fade_in":
                # Apparition progressive
                bbox = draw.textbbox((0, 0), text, font=font)
                tw = bbox[2] - bbox[0]
                alpha = min(t * 3, 1.0)
                color = tuple(int(255 * alpha) for _ in range(3))
                draw.text(((width - tw) // 2, height // 2 - 20), text,
                          fill=color, font=font)

            frames.append(np.array(img))

        return frames

    # Generer les trois styles
    text_demo = "Workflows Creatifs"
    anim_styles = ["typewriter", "slide_in", "fade_in"]

    fig, axes = plt.subplots(len(anim_styles), 4, figsize=(16, 9))

    for row, style in enumerate(anim_styles):
        anim_frames = create_text_animation(text_demo, video_width, video_height,
                                            2.0, video_fps, style)
        sample_idx = np.linspace(0, len(anim_frames) - 1, 4, dtype=int)
        for col, idx in enumerate(sample_idx):
            axes[row, col].imshow(anim_frames[idx])
            axes[row, col].set_title(f"{style} t={idx/video_fps:.2f}s", fontsize=8)
            axes[row, col].axis('off')

    plt.suptitle("Animations de texte - 3 styles", fontsize=13, fontweight='bold')
    plt.tight_layout()
    plt.show()

    print(f"Styles d'animation disponibles : {', '.join(anim_styles)}")
else:
    print("Animations de texte desactivees")
--- ANIMATIONS DE TEXTE ---
========================================
Styles d'animation disponibles : typewriter, slide_in, fade_inInterpretation : Collages et animations
| Technique | Complexite | Usage |
|---|---|---|
| Grille video 2x2 | Composition spatiale | Comparaisons cote a cote |
| Typewriter | Revelation progressive | Titres narratifs |
| Slide-in | Translation avec easing | Generiques, sous-titres |
| Fade-in | Opacite progressive | Transitions douces |
Points cles : 1. L’easing (ease-out cubic) rend les mouvements plus naturels que le lineaire 2. Les grilles video sont utiles pour les comparaisons avant/après ou multi-styles 3. La combinaison de ces techniques produit des videos professionnelles
Recapitulatif des techniques creatives
| Technique | Temps CPU | GPU requis | Difficulte |
|---|---|---|---|
| Style transfer (filtres) | Rapide | Non | Facile |
| Style transfer (IA) | Lent | Oui (~16 GB) | Avance |
| Music video sync | Rapide | Non | Moyen |
| Stop-motion | Rapide | Non | Facile |
| Color grading | Rapide | Non | Moyen |
| Collage video | Moyen | Non | Facile |
| Animation texte | Rapide | Non | Moyen |
# Mode interactif - Choix du style
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Choisissez un style pour generer une video complete.")
    print("Styles : oil, watercolor, sketch, teal_orange, vintage, cold")
    print("(Laissez vide pour passer)")

    try:
        chosen_style = input("\nStyle (ou vide) : ").strip()

        if chosen_style:
            style_functions = {
                "oil": apply_oil_painting_effect,
                "watercolor": apply_watercolor_effect,
                "sketch": apply_sketch_effect,
            }
            grade_functions = {
                "teal_orange": lambda f: apply_color_grade(f, "teal_orange"),
                "vintage": lambda f: apply_color_grade(f, "vintage"),
                "cold": lambda f: apply_color_grade(f, "cold"),
            }
            all_functions = {**style_functions, **grade_functions}

            if chosen_style in all_functions:
                print(f"Application du style '{chosen_style}'...")
                custom_frames = [all_functions[chosen_style](f) for f in source_frames]
                print(f"Style applique sur {len(custom_frames)} frames")
            else:
                print(f"Style '{chosen_style}' non reconnu")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError):
        print("Mode interactif interrompu")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type:
            print("Mode interactif non disponible (execution automatisee)")
        else:
            print(f"Erreur : {error_type}")
else:
    print("Mode batch - Interface interactive desactivee")
--- MODE INTERACTIF ---
========================================
Choisissez un style pour generer une video complete.
Styles : oil, watercolor, sketch, teal_orange, vintage, cold
(Laissez vide pour passer)
Mode interactif non disponible (execution automatisee)
Les statistiques de session recapitulent les effets appliques, les durees de traitement par technique et le bilan des ressources consommees pendant la session creative.
# Statistiques de session
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Video source : {video_width}x{video_height} @ {video_fps}fps, {video_duration}s")
print(f"Frames source : {len(source_frames)}")

techniques_used = []
if enable_style_transfer: techniques_used.append("Style transfer")
if enable_music_video: techniques_used.append("Music video")
if enable_stop_motion: techniques_used.append("Stop-motion")
if enable_color_grading: techniques_used.append("Color grading")
if enable_text_animation: techniques_used.append("Text animation")
print(f"Techniques appliquees : {', '.join(techniques_used)}")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('creative_*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

print(f"\nDependances utilisees :")
for dep, available in dependencies.items():
    status = "utilisee" if available else "non disponible"
    print(f"  {dep} : {status}")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 04-3 : Sora API - Generation Video Cloud")
print(f"2. Notebook 04-4 : Pipeline Video de Production (pipeline complet)")

print(f"\nNotebook 04-2 Creative Video Workflows termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-08-26 14:26:45
Mode : interactive
Video source : 640x480 @ 24fps, 6s
Frames source : 144
Techniques appliquees : Style transfer, Music video, Stop-motion, Color grading, Text animation

Fichiers generes (3) :
  creative_grid_collage.mp4 (207.6 KB)
  creative_music_video_detected.mp4 (127.4 KB)
  creative_watercolor.mp4 (110.0 KB)

Dependances utilisees :
  moviepy : utilisee
  imageio : utilisee
  scipy : utilisee
  diffusers : utilisee

--- PROCHAINES ETAPES ---
1. Notebook 04-3 : Sora API - Generation Video Cloud
2. Notebook 04-4 : Pipeline Video de Production (pipeline complet)

Notebook 04-2 Creative Video Workflows termine - 14:26:45
Exercice : Music Video Creatif
Duree estimee : 60-90 minutes
Objectif
Créer un clip musical complet avec synchronisation sur le rythme, incluant les transitions synchronisees, les effets visuels rythmes et un style coherent.
Instructions
- Analyser la musique
- Choisir un morceau (ou simuler un rythme)
- Identifier les temps forts (BPM, structure)
- Determiner les sections (couplets, refrains)
- Concevoir le style visuel
- Choisir une palette et des effets
- Définir les transitions entre sections
- Planifier les synchronisations (beats, drops)
- Implementer la synchronisation
- Detecter automatiquement le BPM (librosa)
- Mapper les temps forts aux effets
- Créer des variations visuelles par section
- Assembler et exporter
- Combiner video + audio
- Ajouter les sous-titres synchrones
- Exporter en qualite optimale
Indices :
- BPM detection :
librosa.beat.beat_trackou simulation avec structure reguliere - Effets rythmes : flash, zoom, changement de couleur, glitch
- Sections : intro (calme), buildup (tension), drop (energie), outro (fade)
Critères de succes
Exercice Avance : Système de Templates Video
Duree estimee : 120-180 minutes
Objectif
Developper un système de templates video parametrables qui permettent de generer rapidement des videos dans différents styles (corporate, social media, education) en variant les paramètres (couleurs, typographie, animations).
Instructions
- Etudier les patterns de design
- Analyser les videos professionnelles par catégorie
- Identifier les éléments recurrents (intros, transitions, outs)
- Extraire les paramètres modulables
- Concevoir l’architecture
- Structure de template (JSON/YAML)
- Système de paramètres (heritage, overrides)
- Pipeline de rendu (template -> video)
- Implementer le moteur
- Parseur de templates
- Moteur de rendu avec Pillow/moviepy
- Gestion des assets (fonts, images, musiques)
- Créer une bibliotheque
- 5+ templates par catégorie
- Documentation des paramètres
- Exemples de rendus
Indices :
- Templates JSON : sections, timing, styles, assets
- Paramètres globaux : couleurs, fonts, vitesse
- Sections : intro, content_loop, outro
- Assets : logos, backgrounds, patterns
Critères de succes
# TODO: Creer un clip musical synchronise
def create_music_video(audio_path: str, style: str) -> Dict:
    """
    Cree un clip musical avec synchronisation rythmique.

    Styles: "energetic" (flashes, rapides),
            "ambient" (fondus, lents),
            "retro" (stop-motion, grain)
    """
    # TODO: Analyser l'audio
    # - Detecter le BPM
    # - Identifier les sections (beat tracking)
    # - Extraire les temps forts

    # TODO: Creer les effets synchronises
    # - Flash on beat
    # - Zoom progressif
    # - Transition entre sections

    # TODO: Generer les frames
    # - Appliquer les effets sur les temps forts
    # - Varier les intensites

    # TODO: Assembler video + audio
    pass

# TODO: Tester sur un extrait musical
# Utiliser un fichier audio ou simuler avec signal synthetique

# TODO: Creer les variations de style
# Comparer 3 styles sur le meme audio
Le moteur de templates video generalise l’approche en proposant des structures preconstruites pour différents genres : reportage, publicite, court-metrage artistique.
# TODO: Moteur de templates video
class VideoTemplateEngine:
    """
    Moteur de rendu de videos basees sur des templates.

    Structure de template:
    {
        "name": "Corporate Intro",
        "duration": 10,
        "resolution": [1920, 1080],
        "global_params": {...},
        "sections": [
            {"type": "intro", "duration": 3, "params": {...}},
            {"type": "content", "duration": 5, "params": {...}},
            {"type": "outro", "duration": 2, "params": {...}}
        ],
        "assets": {...}
    }
    """

    def __init__(self):
        self.templates = {}
        self.assets = {}

    def load_template(self, template_path: str) -> Dict:
        """Charge un template depuis JSON."""
        # TODO: Charger et valider le template
        pass

    def render(self, template: Dict, overrides: Dict = None) -> List[np.ndarray]:
        """
        Rend la video selon le template.

        Args:
            template: Template charge
            overrides: Parametres personnalises (couleurs, textes)
        """
        # TODO: Fusionner les parametres globaux et overrides
        # TODO: Rendre chaque section sequentiellement
        pass

    def render_section(self, section: Dict, params: Dict) -> List[np.ndarray]:
        """Rend une section specifique."""
        # TODO: Implementer le rendu selon le type de section
        pass


# TODO: Creer 5 templates dans 3 categories
# Categories: corporate, social_media, education

# TODO: Documenter les parametres
# Creer un guide d'utilisation

# TODO: Exemples de rendus
# Generer des exemples pour chaque template