ComfyUI - Workflows Video via API

Module : 03-Video-Orchestration
Niveau : Avance
Technologies : ComfyUI API, AnimateDiff nodes, VideoHelperSuite
Duree estimee : 60 minutes
VRAM : ~20 GB (depends on workflow)

Objectifs d’Apprentissage

Prerequis

  • Instance ComfyUI accessible (locale ou distante)
  • Notebooks 03-1 et 03-2 completes
  • Custom nodes : AnimateDiff-Evolved, VideoHelperSuite
  • Packages : requests, websocket-client, torch, Pillow, imageio

Navigation : << 03-2 | Index | Suivant >>

import os

# Parametres Papermill - JAMAIS modifier ce commentaire
# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"
# Parametres ComfyUI
comfyui_url = os.getenv("COMFYUI_VIDEO_URL", "https://qwen-image-edit.myia.io")  # URL du serveur ComfyUI
workflow_type = "animatediff"         # Type de workflow : "animatediff"
enable_video_helper = True           # Utiliser VideoHelperSuite
# Parametres generation
prompt_text = "a serene lake at sunset, soft ripples on water, golden light, cinematic"  # Prompt
negative_prompt = "low quality, blurry, distorted, watermark"  # Prompt negatif
num_frames = 16                      # Nombre de frames
width = 512                          # Largeur
height = 512                         # Hauteur
steps = 25                           # Etapes de debruitage
cfg_scale = 7.5                      # CFG scale
seed_value = 42                      # Graine
fps_output = 8                       # FPS de sortie
# Configuration
run_workflow = True                   # Executer le workflow
save_as_mp4 = True                   # Sauvegarder en MP4
save_results = True

print(f"Config ComfyUI: mode={notebook_mode}, debug={debug_level}")
Config ComfyUI: mode=interactive, debug=INFO
# Parameters
BATCH_MODE = "true"

On importe ensuite les bibliotheques necessaires pour interagir avec l’API ComfyUI : requests pour les appels REST, websockets pour le suivi en temps reel, et json pour la construction des workflows.

# Setup environnement et imports
import os
import sys
import json
import time
import uuid
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import numpy as np
from PIL import Image
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)
warnings.filterwarnings('ignore', category=FutureWarning)

# Import helpers GenAI
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent

# Definir GENAI_ROOT a partir de current_path (apres la boucle de recherche)
GENAI_ROOT = current_path if current_path.name == "GenAI" else current_path / "GenAI"
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging
        print("Helpers GenAI importes")
    except ImportError:
        print("Helpers GenAI non disponibles - mode autonome")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'comfyui_video'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('comfyui_video')

print(f"ComfyUI - Workflows Video via API")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"ComfyUI URL : {comfyui_url}")
print(f"Workflow : {workflow_type}")
print(f"VideoHelperSuite : {enable_video_helper}")
.env charge depuis: .env
Helpers GenAI importes
ComfyUI - Workflows Video via API
Date : 2026-09-21 15:45:04
Mode : interactive
ComfyUI URL : http://localhost:8189
Workflow : animatediff
VideoHelperSuite : True

Les variables d’environnement et le token d’authentification ComfyUI sont charges depuis le fichier .env. On verifie ensuite la connectivite au service avant de soumettre des workflows.

# Chargement .env et verification de la connexion ComfyUI
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

# Token d'authentification ComfyUI
# COMFYUI_VIDEO_TOKEN d'abord : l'instance video a son propre jeton, les
# noms generiques portent celui du stack qwen (mesure : 200 vs 401 sur :8189).
comfyui_token = os.environ.get('COMFYUI_VIDEO_TOKEN', os.environ.get('COMFYUI_API_TOKEN', os.environ.get('COMFYUI_AUTH_TOKEN', '')))
if comfyui_token:
    print(f"Token ComfyUI : configure")
else:
    print("Token ComfyUI : non configure (connexion sans authentification)")

# Verification de la connexion
print("\n--- VERIFICATION COMFYUI ---")
print("=" * 40)

import requests

comfyui_available = False
comfyui_info = {}

headers = {}
if comfyui_token:
    headers['Authorization'] = f'Bearer {comfyui_token}'

try:
    # Health check
    response = requests.get(f"{comfyui_url}/system_stats", headers=headers, timeout=10)
    if response.status_code == 200:
        stats = response.json()
        comfyui_available = True
        comfyui_info = stats
        
        print(f"ComfyUI accessible : {comfyui_url}")
        
        # GPU info
        devices = stats.get('devices', [])
        for dev in devices:
            name = dev.get('name', 'Inconnu')
            vram_total = dev.get('vram_total', 0) / 1024**3
            vram_free = dev.get('vram_free', 0) / 1024**3
            print(f"  GPU : {name}")
            print(f"  VRAM : {vram_free:.1f} / {vram_total:.1f} GB libre")
        
        # Verifier les custom nodes
        try:
            obj_info = requests.get(f"{comfyui_url}/object_info", headers=headers, timeout=30)
            if obj_info.status_code == 200:
                nodes = obj_info.json()
                animatediff_nodes = [n for n in nodes.keys() if 'animatediff' in n.lower()]
                vhs_nodes = [n for n in nodes.keys() if 'video' in n.lower() and 'helper' in n.lower()]
                
                print(f"\n  AnimateDiff nodes : {len(animatediff_nodes)}")
                for n in animatediff_nodes[:5]:
                    print(f"    - {n}")
                if len(animatediff_nodes) > 5:
                    print(f"    ... et {len(animatediff_nodes) - 5} autres")
                
                print(f"  VideoHelperSuite nodes : {len(vhs_nodes)}")
                for n in vhs_nodes[:5]:
                    print(f"    - {n}")
                
                if not animatediff_nodes:
                    print("\n  AnimateDiff-Evolved non installe dans ComfyUI")
                    print("  Le notebook montrera les workflows sans les executer")
        except Exception:
            print("  Impossible de lister les nodes")
    else:
        print(f"ComfyUI repond avec status {response.status_code}")
        run_workflow = False

except requests.ConnectionError:
    print(f"ComfyUI non accessible a {comfyui_url}")
    print("Le notebook montrera les workflows sans les executer.")
    run_workflow = False

except Exception as e:
    print(f"Erreur connexion : {type(e).__name__}: {str(e)[:100]}")
    run_workflow = False

print(f"\nComfyUI disponible : {comfyui_available}")
print(f"Workflow active : {run_workflow}")
.env charge depuis: .env
Token ComfyUI : configure

--- VERIFICATION COMFYUI ---
========================================
ComfyUI accessible : http://localhost:8189
  GPU : cuda:0 NVIDIA GeForce RTX 3090 : cudaMallocAsync
  VRAM : 19.9 / 24.0 GB libre

  AnimateDiff nodes : 25
    - ADE_AnimateDiffLoRALoader
    - ADE_AnimateDiffSamplingSettings
    - ADE_AnimateDiffKeyframe
    - ADE_AnimateDiffUniformContextOptions
    - ADE_AnimateDiffSettings
    ... et 20 autres
  VideoHelperSuite nodes : 0

ComfyUI disponible : True
Workflow active : True

Section 1 : API ComfyUI et soumission de workflows

ComfyUI expose une API REST et WebSocket pour piloter la generation. Contrairement a l’approche diffusers (Python direct), ComfyUI utilise des workflows JSON (graphes de nodes) que l’on soumet a un serveur.

Endpoint Méthode Description
/system_stats GET Etat du serveur (GPU, queue)
/object_info GET Liste des nodes disponibles
/prompt POST Soumettre un workflow
/history/{id} GET Résultats d’un workflow execute
/view GET Telecharger une image/video generee
/ws WebSocket Suivi en temps reel de la progression

Architecture ComfyUI vs diffusers

Aspect diffusers (Python) ComfyUI (API)
Flexibilite Code personnalise Workflow visuel/JSON
Reproductibilite Script Python Fichier JSON exportable
GPU requis localement Oui Non (serveur distant possible)
Custom nodes Non applicable Ecosysteme riche
Monitoring Manuel WebSocket integre
# Definition du workflow AnimateDiff via l'API ComfyUI
print("\n--- WORKFLOW ANIMATEDIFF ---")
print("=" * 45)


def build_animatediff_workflow(
    prompt: str,
    negative: str,
    width: int,
    height: int,
    frames: int,
    steps: int,
    cfg: float,
    seed: int
) -> Dict[str, Any]:
    """
    Construit un workflow AnimateDiff au format ComfyUI API.
    
    Le workflow suit la chaine :
    CheckpointLoader -> CLIPTextEncode (pos/neg) -> AnimateDiffLoader
    -> ApplyAnimateDiff -> UseEvolvedSampling -> KSampler
    -> VAEDecode -> VHS_VideoCombine (ou SaveImage)
    
    Args:
        prompt: Description textuelle positive
        negative: Prompt negatif
        width, height: Resolution video
        frames: Nombre de frames
        steps: Etapes de debruitage
        cfg: CFG scale
        seed: Graine de generation
    
    Returns:
        Dict au format ComfyUI prompt API
    """
    workflow = {
        # Node 1 : Charger le modele SD 1.5
        "1": {
            "class_type": "CheckpointLoaderSimple",
            "inputs": {
                "ckpt_name": "sd-v1-5-pruned-emaonly.ckpt"
            }
        },
        # Node 2 : Encodage du prompt positif
        "2": {
            "class_type": "CLIPTextEncode",
            "inputs": {
                "text": prompt,
                "clip": ["1", 1]  # Sortie CLIP du checkpoint
            }
        },
        # Node 3 : Encodage du prompt negatif
        "3": {
            "class_type": "CLIPTextEncode",
            "inputs": {
                "text": negative,
                "clip": ["1", 1]
            }
        },
        # Node 4 : Charger le motion module AnimateDiff
        "4": {
            "class_type": "ADE_LoadAnimateDiffModel",
            "inputs": {
                "model_name": "v3_sd15_mm.ckpt"
            }
        },
        # Node 5 : Appliquer le motion module (sortie M_MODELS)
        "5": {
            "class_type": "ADE_ApplyAnimateDiffModelSimple",
            "inputs": {
                "motion_model": ["4", 0]
            }
        },
        # Node 10 : Injecter le motion model dans le modele de base
        # (M_MODELS + MODEL -> MODEL exploitable par le KSampler)
        "10": {
            "class_type": "ADE_UseEvolvedSampling",
            "inputs": {
                "model": ["1", 0],  # Sortie MODEL du checkpoint
                "m_models": ["5", 0],  # Sortie M_MODELS de l'ApplyAnimateDiff
                "beta_schedule": "autoselect"
            }
        },
        # Node 6 : Latent vide (batch de frames)
        "6": {
            "class_type": "EmptyLatentImage",
            "inputs": {
                "width": width,
                "height": height,
                "batch_size": frames
            }
        },
        # Node 7 : KSampler
        "7": {
            "class_type": "KSampler",
            "inputs": {
                "model": ["10", 0],  # Modele avec AnimateDiff (via UseEvolvedSampling)
                "positive": ["2", 0],
                "negative": ["3", 0],
                "latent_image": ["6", 0],
                "seed": seed,
                "steps": steps,
                "cfg": cfg,
                "sampler_name": "euler",
                "scheduler": "normal",
                "denoise": 1.0
            }
        },
        # Node 8 : Decodage VAE
        "8": {
            "class_type": "VAEDecode",
            "inputs": {
                "samples": ["7", 0],
                "vae": ["1", 2]  # Sortie VAE du checkpoint
            }
        }
    }
    
    # Node 9 : Sortie video (VideoHelperSuite ou SaveImage)
    if enable_video_helper:
        workflow["9"] = {
            "class_type": "VHS_VideoCombine",
            "inputs": {
                "images": ["8", 0],
                "frame_rate": fps_output,
                "loop_count": 0,
                "filename_prefix": "animatediff",
                "format": "video/h264-mp4",
                "pingpong": False,
                "save_output": True
            }
        }
    else:
        workflow["9"] = {
            "class_type": "SaveImage",
            "inputs": {
                "images": ["8", 0],
                "filename_prefix": "animatediff_frame"
            }
        }
    
    return workflow


# Construire le workflow
workflow = build_animatediff_workflow(
    prompt=prompt_text,
    negative=negative_prompt,
    width=width,
    height=height,
    frames=num_frames,
    steps=steps,
    cfg=cfg_scale,
    seed=seed_value
)

print(f"Workflow construit : {len(workflow)} nodes")
print(f"\nNodes du workflow :")
for node_id, node_data in workflow.items():
    print(f"  [{node_id}] {node_data['class_type']}")

# Sauvegarder le workflow JSON
workflow_path = OUTPUT_DIR / "animatediff_workflow.json"
with open(workflow_path, 'w', encoding='utf-8') as f:
    json.dump({"prompt": workflow}, f, indent=2)
print(f"\nWorkflow sauvegarde : {workflow_path.name}")
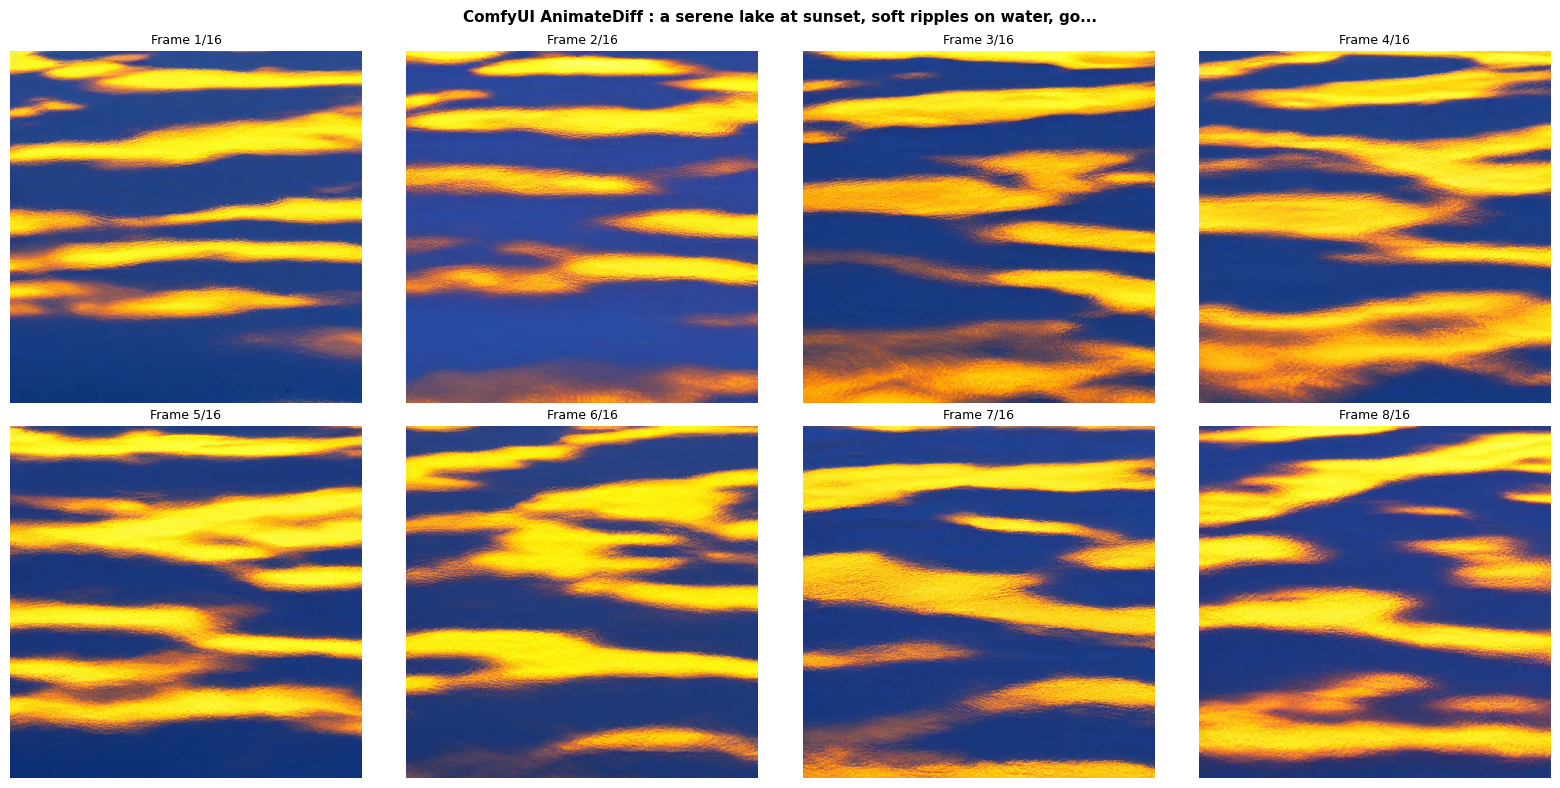
--- WORKFLOW ANIMATEDIFF ---
=============================================
Workflow construit : 10 nodes

Nodes du workflow :
  [1] CheckpointLoaderSimple
  [2] CLIPTextEncode
  [3] CLIPTextEncode
  [4] ADE_LoadAnimateDiffModel
  [5] ADE_ApplyAnimateDiffModelSimple
  [10] ADE_UseEvolvedSampling
  [6] EmptyLatentImage
  [7] KSampler
  [8] VAEDecode
  [9] VHS_VideoCombine

Workflow sauvegarde : animatediff_workflow.json

Interpretation : Structure du workflow

Node Classe Rôle
1 CheckpointLoaderSimple Charge le modèle SD 1.5 (MODEL + CLIP + VAE)
2-3 CLIPTextEncode Encode les prompts positif et negatif
4 ADE_LoadAnimateDiffModel Charge le motion module v3
5 ADE_ApplyAnimateDiffModelSimple Applique le motion module au modèle
6 EmptyLatentImage Créé un batch de latents (1 par frame)
7 KSampler Debruite les latents
8 VAEDecode Decode les latents en images
9 VHS_VideoCombine Assemble les frames en video MP4

Points cles : 1. Chaque node est identifie par un ID unique (string) et a un class_type 2. Les connexions sont exprimees par ["node_id", output_index] 3. Le workflow est un DAG (graphe acyclique dirige) - pas de boucles

Section 2 : Soumission et monitoring du workflow

# Soumission du workflow et monitoring
print("\n--- SOUMISSION DU WORKFLOW ---")
print("=" * 45)

client_id = str(uuid.uuid4())
prompt_id = None
generation_result = {"success": False}


def submit_workflow(workflow: Dict, server_url: str, auth_headers: Dict) -> Optional[str]:
    """Soumet un workflow a ComfyUI et retourne le prompt_id."""
    payload = {
        "prompt": workflow,
        "client_id": client_id
    }
    
    try:
        response = requests.post(
            f"{server_url}/prompt",
            json=payload,
            headers=auth_headers,
            timeout=30
        )
        
        if response.status_code == 200:
            result = response.json()
            return result.get('prompt_id')
        else:
            print(f"  Erreur HTTP {response.status_code} : {response.text[:200]}")
            return None
    except Exception as e:
        print(f"  Erreur soumission : {type(e).__name__}: {str(e)[:100]}")
        return None


def poll_progress(prompt_id: str, server_url: str, auth_headers: Dict,
                  timeout: int = 300, poll_interval: float = 2.0) -> Dict:
    """
    Attend la fin d'un workflow en interrogeant periodiquement l'historique.
    
    Retourne le resultat du workflow ou un dict d'erreur.
    """
    start_time = time.time()
    
    while time.time() - start_time < timeout:
        try:
            response = requests.get(
                f"{server_url}/history/{prompt_id}",
                headers=auth_headers,
                timeout=10
            )
            
            if response.status_code == 200:
                history = response.json()
                if prompt_id in history:
                    entry = history[prompt_id]
                    status = entry.get('status', {})
                    
                    if status.get('completed', False):
                        elapsed = time.time() - start_time
                        return {
                            "success": True,
                            "outputs": entry.get('outputs', {}),
                            "elapsed": elapsed
                        }
                    
                    if status.get('status_str') == 'error':
                        return {
                            "success": False,
                            "error": "Workflow en erreur",
                            "details": status
                        }
        except Exception:
            pass
        
        elapsed = time.time() - start_time
        print(f"  En cours... {elapsed:.0f}s", end='\r')
        time.sleep(poll_interval)
    
    return {"success": False, "error": f"Timeout apres {timeout}s"}


def download_outputs(outputs: Dict, server_url: str, auth_headers: Dict) -> List[Image.Image]:
    """
    Telecharge les images/videos generees depuis les outputs du workflow.
    """
    images = []
    
    for node_id, node_output in outputs.items():
        # Images standard (SaveImage node)
        if 'images' in node_output:
            for img_info in node_output['images']:
                filename = img_info.get('filename', '')
                subfolder = img_info.get('subfolder', '')
                img_type = img_info.get('type', 'output')
                
                params = {
                    'filename': filename,
                    'subfolder': subfolder,
                    'type': img_type
                }
                
                try:
                    resp = requests.get(
                        f"{server_url}/view",
                        params=params,
                        headers=auth_headers,
                        timeout=30
                    )
                    if resp.status_code == 200:
                        from io import BytesIO
                        img = Image.open(BytesIO(resp.content)).convert('RGB')
                        images.append(img)
                except Exception as e:
                    print(f"  Erreur telechargement {filename}: {e}")
        
        # Videos (VHS_VideoCombine node)
        if 'gifs' in node_output:
            for vid_info in node_output['gifs']:
                filename = vid_info.get('filename', '')
                subfolder = vid_info.get('subfolder', '')
                vid_type = vid_info.get('type', 'output')
                print(f"  Video generee : {filename}")
                # Telecharger la video generee et en extraire les frames pour affichage
                try:
                    resp = requests.get(
                        f"{server_url}/view",
                        params={'filename': filename, 'subfolder': subfolder, 'type': vid_type},
                        headers=auth_headers,
                        timeout=60
                    )
                    if resp.status_code == 200:
                        vid_path = OUTPUT_DIR / filename
                        vid_path.write_bytes(resp.content)
                        print(f"  Video telechargee : {vid_path.name} ({len(resp.content) / 1024:.1f} KB)")
                        try:
                            import imageio.v3 as iio
                            vframes = iio.imread(str(vid_path), index=None)
                            for fr in vframes:
                                images.append(Image.fromarray(fr).convert('RGB'))
                            print(f"  Frames extraites pour affichage : {len(vframes)}")
                        except Exception as e:
                            print(f"  Frames non extraites ({type(e).__name__}) - video sur disque")
                except Exception as e:
                    print(f"  Erreur telechargement video {filename}: {type(e).__name__}")
    
    return images


# Soumettre le workflow
if run_workflow and comfyui_available:
    print(f"Client ID : {client_id[:8]}...")
    print(f"Prompt : {prompt_text[:50]}...")
    print(f"Parametres : {num_frames} frames, {steps} steps, CFG={cfg_scale}")
    
    prompt_id = submit_workflow(workflow, comfyui_url, headers)
    
    if prompt_id:
        print(f"Workflow soumis : {prompt_id[:12]}...")
        print(f"\nAttente de la completion...")
        
        generation_result = poll_progress(prompt_id, comfyui_url, headers, timeout=300)
        
        if generation_result['success']:
            print(f"\nWorkflow termine en {generation_result['elapsed']:.1f}s")
            
            # Telecharger les resultats
            output_images = download_outputs(
                generation_result['outputs'], comfyui_url, headers
            )
            generation_result['images'] = output_images
            
            if output_images:
                print(f"Images telechargees : {len(output_images)}")
                
                # Affichage
                n_display = min(8, len(output_images))
                fig, axes = plt.subplots(2, 4, figsize=(16, 8))
                axes_flat = axes.flatten()
                for i in range(n_display):
                    axes_flat[i].imshow(output_images[i])
                    axes_flat[i].set_title(f"Frame {i+1}/{len(output_images)}", fontsize=9)
                    axes_flat[i].axis('off')
                for i in range(n_display, len(axes_flat)):
                    axes_flat[i].axis('off')
                plt.suptitle(f"ComfyUI AnimateDiff : {prompt_text[:50]}...", fontsize=11, fontweight='bold')
                plt.tight_layout()
                plt.show()
                
                # Sauvegarder en MP4 local
                if save_as_mp4 and output_images:
                    import imageio
                    mp4_path = OUTPUT_DIR / "comfyui_animatediff.mp4"
                    frames_array = [np.array(img) for img in output_images]
                    imageio.mimsave(str(mp4_path), frames_array, fps=fps_output)
                    print(f"MP4 sauvegarde : {mp4_path.name}")
            else:
                print("Aucune image telechargee (la sortie est peut-etre une video)")
        else:
            print(f"\nErreur : {generation_result.get('error', 'inconnue')}")
    else:
        print("Soumission echouee")
else:
    print("Workflow non execute (ComfyUI non disponible ou desactive)")
    print("\nSchema d'execution :")
    print("  1. POST /prompt avec le workflow JSON")
    print("  2. Poll /history/{prompt_id} pour attendre la completion")
    print("  3. GET /view pour telecharger les images/videos")

--- SOUMISSION DU WORKFLOW ---
=============================================
Client ID : f65a6c18...
Prompt : a serene lake at sunset, soft ripples on water, go...
Parametres : 16 frames, 25 steps, CFG=7.5
Workflow soumis : 267318af-593...

Attente de la completion...

Workflow termine en 6.6s
  Video generee : animatediff_00003.mp4
  Video telechargee : animatediff_00003.mp4 (795.0 KB)
  Frames extraites pour affichage : 16
Images telechargees : 16

MP4 sauvegarde : comfyui_animatediff.mp4

Interpretation : Exécution du workflow

Étape Endpoint Description
Soumission POST /prompt Envoie le workflow, retourne prompt_id
Monitoring GET /history/{id} Interroge periodiquement l’etat
Telechargement GET /view Recupere les images/videos generees

Points cles : 1. ComfyUI traite les workflows de facon asynchrone (queue) 2. Le monitoring par polling est simple mais moins reactif que WebSocket 3. Les images sont stockees sur le serveur et telechargees a la demande

Section 3 : Comparaison diffusers vs ComfyUI

Nous avons explore les deux approches de generation video. Comparons-les objectivement.

# Comparaison diffusers vs ComfyUI
print("\n--- COMPARAISON DIFFUSERS VS COMFYUI ---")
print("=" * 50)

comparison_data = {
    "Critere": [
        "Installation",
        "Flexibilite code",
        "Interface visuelle",
        "Custom nodes",
        "Reproductibilite",
        "GPU distant",
        "Debugging",
        "Integration Python",
        "Community",
        "Production batch"
    ],
    "diffusers": [
        "pip install",
        "Totale (Python)",
        "Non",
        "Non applicable",
        "Script Python",
        "Non (local only)",
        "pdb / print",
        "Native",
        "HuggingFace",
        "Scripts Python"
    ],
    "ComfyUI": [
        "Git clone + setup",
        "Via nodes JSON",
        "Oui (navigateur)",
        "Ecosysteme riche",
        "Workflow JSON",
        "Oui (API REST)",
        "Logs serveur",
        "Via API REST",
        "ComfyUI Manager",
        "API programmable"
    ]
}

# Affichage du tableau
print(f"{'Critere':<22} {'diffusers':<22} {'ComfyUI':<22}")
print("-" * 66)
for i in range(len(comparison_data['Critere'])):
    print(f"  {comparison_data['Critere'][i]:<22} {comparison_data['diffusers'][i]:<22} {comparison_data['ComfyUI'][i]:<22}")

# Recapitulatif du notebook
print(f"\n\n--- RECAPITULATIF DU MODULE 03 ---")
print("=" * 50)

print(f"\n{'Notebook':<45} {'Contenu principal':<40}")
print("-" * 85)
print(f"  {'03-1 Multi-Model Comparison':<45} {'Benchmark HunyuanVideo/LTX/Wan/SVD':<40}")
print(f"  {'03-2 Workflow Orchestration':<45} {'Pipelines multi-modeles, batch, upscale':<40}")
print(f"  {'03-3 ComfyUI Video Workflows':<45} {'API ComfyUI, AnimateDiff, monitoring':<40}")

print(f"\nRecommandation selon le profil :")
print(f"  Chercheur/Dev Python : diffusers (controle total, scripts personnalises)")
print(f"  Artiste/Designer : ComfyUI (interface visuelle, workflows partageables)")
print(f"  Production : ComfyUI API (GPU distant, file d'attente, monitoring)")

--- COMPARAISON DIFFUSERS VS COMFYUI ---
==================================================
Critere                diffusers              ComfyUI               
------------------------------------------------------------------
  Installation           pip install            Git clone + setup     
  Flexibilite code       Totale (Python)        Via nodes JSON        
  Interface visuelle     Non                    Oui (navigateur)      
  Custom nodes           Non applicable         Ecosysteme riche      
  Reproductibilite       Script Python          Workflow JSON         
  GPU distant            Non (local only)       Oui (API REST)        
  Debugging              pdb / print            Logs serveur          
  Integration Python     Native                 Via API REST          
  Community              HuggingFace            ComfyUI Manager       
  Production batch       Scripts Python         API programmable      


--- RECAPITULATIF DU MODULE 03 ---
==================================================

Notebook                                      Contenu principal                       
-------------------------------------------------------------------------------------
  03-1 Multi-Model Comparison                   Benchmark HunyuanVideo/LTX/Wan/SVD      
  03-2 Workflow Orchestration                   Pipelines multi-modeles, batch, upscale 
  03-3 ComfyUI Video Workflows                  API ComfyUI, AnimateDiff, monitoring    

Recommandation selon le profil :
  Chercheur/Dev Python : diffusers (controle total, scripts personnalises)
  Artiste/Designer : ComfyUI (interface visuelle, workflows partageables)
  Production : ComfyUI API (GPU distant, file d'attente, monitoring)

En mode interactif, l’utilisateur peut modifier les paramètres du workflow (prompt, pas de diffusion, resolution) et soumettre une nouvelle generation sans relancer tout le notebook.

# Mode interactif : modifier les parametres du workflow
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Entrez un prompt pour generer via ComfyUI AnimateDiff.")
    print("(Laissez vide pour passer a la suite)")
    
    try:
        user_prompt = input("\nVotre prompt : ").strip()
        
        if user_prompt and run_workflow and comfyui_available:
            print(f"\nGeneration : {user_prompt}")
            
            user_workflow = build_animatediff_workflow(
                prompt=user_prompt,
                negative=negative_prompt,
                width=width,
                height=height,
                frames=num_frames,
                steps=steps,
                cfg=cfg_scale,
                seed=seed_value + 100
            )
            
            user_prompt_id = submit_workflow(user_workflow, comfyui_url, headers)
            if user_prompt_id:
                print(f"Workflow soumis. Attente...")
                user_result = poll_progress(user_prompt_id, comfyui_url, headers)
                
                if user_result['success']:
                    user_images = download_outputs(user_result['outputs'], comfyui_url, headers)
                    if user_images:
                        n_display = min(8, len(user_images))
                        fig, axes = plt.subplots(1, n_display, figsize=(2.5 * n_display, 3))
                        if n_display == 1:
                            axes = [axes]
                        for i in range(n_display):
                            axes[i].imshow(user_images[i])
                            axes[i].set_title(f"Frame {i+1}", fontsize=8)
                            axes[i].axis('off')
                        plt.suptitle(f"ComfyUI : {user_prompt[:50]}...", fontweight='bold')
                        plt.tight_layout()
                        plt.show()
                    print(f"Generation terminee en {user_result['elapsed']:.1f}s")
                else:
                    print(f"Erreur : {user_result.get('error', 'inconnue')}")
        elif user_prompt:
            print("ComfyUI non disponible")
        else:
            print("Mode interactif ignore")
    
    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif ignore en execution automatisee (mode batch)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")

--- MODE INTERACTIF ---
========================================
Entrez un prompt pour generer via ComfyUI AnimateDiff.
(Laissez vide pour passer a la suite)

Mode interactif ignore en execution automatisee (mode batch)

La conclusion recapitule les différences entre l’approche ComfyUI (workflow graph JSON) et l’approche diffusers (code Python direct), pour guider le choix selon le contexte.

Bonnes pratiques ComfyUI pour la video

Workflow AnimateDiff - conseils

Conseil Details
Modèle de base SD 1.5 (recommande pour AnimateDiff v3)
Motion module v3_sd15_mm.ckpt (meilleure coherence)
Sampler euler ou euler_ancestral
CFG 6.0-8.0 (eviter > 10 pour la coherence temporelle)
Frames 16-24 (au-dela, la coherence diminue)
Resolution 512x512 (limitation SD 1.5)

VideoHelperSuite - nodes essentiels

Node Usage
VHS_VideoCombine Assembler les frames en video MP4/GIF
VHS_LoadVideo Charger une video existante comme input
VHS_SplitVideo Decomposer une video en frames
VHS_MergeImages Combiner des sequences de frames

Securite et authentification

Aspect Recommandation
Token Bearer Toujours utiliser en production
HTTPS Obligatoire pour les connexions distantes
Timeouts Configurer des timeouts raisonnables (5 min max)
Validation Verifier les outputs avant traitement

Exercice : Workflow ComfyUI Personnalise

Duree estimee : 45-60 minutes

Objectif

Créer un workflow ComfyUI complet pour un cas d’usage spécifique (ex: video promotionnelle, clip musical), incluant la soumission API et le monitoring de progression.

Instructions

  1. Définir le cas d’usage
    • Choisir un type de contenu (ex: teaser produit, animation loop, background video)
    • Specifics requirements (duree, style, fps)
    • Contraintes (temps de generation, VRAM)
  2. Construire le workflow JSON
    • Designer la chaîne de nodes ComfyUI
    • Configurer les paramètres (modèle, motion, sampler)
    • Inclure les nodes de sortie (VideoHelperSuite)
  3. Implementer le client API
    • Fonction de soumission du workflow
    • Monitoring avec WebSocket (ou polling)
    • Gestion des erreurs et timeouts
  4. Tester et iterer
    • Executer sur plusieurs prompts
    • Ajuster les paramètres selon les résultats
    • Documenter les meilleures pratiques

Indices :

  • Workflows ComfyUI visuels : utiliser l’interface pour designer, exporter en JSON
  • Nodes essentiels : CheckpointLoader, CLIPTextEncode, KSampler, VAEDecode, VHS_VideoCombine
  • Le monitoring WebSocket est plus reactif que le polling : ws_client.connect()

Code de depart

# TODO: Construire un workflow ComfyUI pour votre cas d'usage
def build_my_workflow(prompt: str, negative: str, 
                      width: int, height: int, 
                      frames: int, fps: int) -> Dict:
    """
    Workflow ComfyUI personnalisé.
    
    Nodes à inclure:
    1. CheckpointLoader (chargement modèle)
    2. CLIPTextEncode (prompt positif et négatif)
    3. KSampler (génération)
    4. VAEDecode (décodage)
    5. VHS_VideoCombine (assemblage vidéo)
    
    Choisir:
    - Modèle SD: v1-5, SDXL, ou custom
    - Motion module AnimateDiff: v2 ou v3
    - Sampler: euler, euler_ancestral, ddim
    """
    workflow = {}
    
    # TODO: Construire les nodes du workflow
    # workflow["1"] = {...}
    
    return workflow

# TODO: Implémenter la soumission et le monitoring
def submit_and_monitor(workflow: Dict, server_url: str, 
                      headers: Dict, timeout: int = 300) -> Dict:
    """
    Soumet le workflow et attend la completion.
    
    Retourne: {"success": bool, "outputs": ..., "elapsed": ...}
    """
    # TODO: Soumission POST /prompt
    # TODO: Monitoring GET /history/{id} ou WebSocket
    # TODO: Téléchargement GET /view
    pass

# TODO: Tester sur 3 prompts de votre cas d'usage
my_prompts = [
    "Votre prompt 1...",
    "Votre prompt 2...",
    "Votre prompt 3..."
]

for p in my_prompts:
    wf = build_my_workflow(p, "low quality", 512, 512, 16, 8)
    result = submit_and_monitor(wf, comfyui_url, headers)
    print(f"Résultat: {result['success']}, Temps: {result.get('elapsed', 0):.1f}s")

Critères de succès


Exercice Avance : Integration Diffusers + ComfyUI

Duree estimee : 90-120 minutes

Objectif

Créer un pipeline hybride combinant la flexibilite de code diffusers avec l’ecosysteme ComfyUI, en implémentant un “proxy” qui permet d’appeler des pipelines diffusers via ComfyUI custom nodes.

Instructions

  1. Etudier les approches
    • Analyser l’architecture ComfyUI (nodes, exécution)
    • Comprendre l’API custom nodes de ComfyUI
    • Identifier les points d’integration possibles
  2. Concevoir l’architecture hybride
    • Schema de communication (ComfyUI <-> Python)
    • Definition des custom nodes (wrappers diffusers)
    • Gestion de la VRAM et des ressources
  3. Implementer un prototype
    • Custom node ComfyUI qui appelle un pipeline diffusers
    • Serialization des outputs (images, latents)
    • Gestion des erreurs
  4. Evaluer l’approche
    • Comparaison perf (diffusers pur vs hybride)
    • Avantages/inconvenients
    • Cas d’usage ou cela a du sens

Indices :

  • Custom nodes ComfyUI : dossier custom_nodes/ avec __init__.py et classe Node
  • Communication possible via : HTTP API, WebSocket, ou appels Python directs
  • Les latents diffusers peuvent etre serialises en numpy arrays pour ComfyUI

Code de depart

# TODO: Créer un custom node ComfyUI pour diffusers
class DiffusersProxyNode:
    """
    Custom node ComfyUI qui proxy vers diffusers.
    
    Architecture:
    ComfyUI -> Custom Node -> Pipeline Diffusers -> Output ComfyUI
    """
    
    @classmethod
    def INPUT_TYPES(cls):
        return {
            "required": {
                "model_id": ("STRING", {"default": "stabilityai/sd-turbo"}),
                "prompt": ("STRING", {"default": ""}),
                "steps": ("INT", {"default": 20}),
                "width": ("INT", {"default": 512}),
                "height": ("INT", {"default": 512}),
            }
        }
    
    RETURN_TYPES = ("IMAGE",)
    FUNCTION = "generate"
    
    def generate(self, model_id, prompt, steps, width, height):
        # TODO: Appeler le pipeline diffusers
        # from diffusers import StableDiffusionPipeline
        # pipe = StableDiffusionPipeline.from_pretrained(model_id)
        # image = pipe(prompt, num_inference_steps=steps).images[0]
        # Retourner au format ComfyUI (numpy tensor)
        pass

# TODO: Intégrer dans un workflow ComfyUI
# Le workflow utilise ce node comme n'importe quel autre node ComfyUI

# TODO: Benchmark comparatif
# Diffusers pur vs ComfyUI proxy
# Mesurer: temps, VRAM, flexibilité

Critères de succès


# TODO: Construire un workflow ComfyUI pour votre cas d'usage
def build_my_workflow(prompt: str, negative: str, 
                      width: int, height: int, 
                      frames: int, fps: int) -> Dict:
    """
    Workflow ComfyUI personnalisé.
    
    Nodes à inclure:
    1. CheckpointLoader (chargement modèle)
    2. CLIPTextEncode (prompt positif et négatif)
    3. KSampler (génération)
    4. VAEDecode (décodage)
    5. VHS_VideoCombine (assemblage vidéo)
    
    Choisir:
    - Modèle SD: v1-5, SDXL, ou custom
    - Motion module AnimateDiff: v2 ou v3
    - Sampler: euler, euler_ancestral, ddim
    """
    workflow = {}
    
    # TODO: Construire les nodes du workflow
    # workflow["1"] = {...}
    
    return workflow

# TODO: Implémenter la soumission et le monitoring
def submit_and_monitor(workflow: Dict, server_url: str, 
                      headers: Dict, timeout: int = 300) -> Dict:
    """
    Soumet le workflow et attend la completion.
    
    Retourne: {"success": bool, "outputs": ..., "elapsed": ...}
    """
    # TODO: Soumission POST /prompt
    # TODO: Monitoring GET /history/{id} ou WebSocket
    # TODO: Téléchargement GET /view
    pass

# TODO: Tester sur 3 prompts de votre cas d'usage
my_prompts = [
    "Votre prompt 1...",
    "Votre prompt 2...",
    "Votre prompt 3..."
]

for p in my_prompts:
    wf = build_my_workflow(p, "low quality", 512, 512, 16, 8)
    result = submit_and_monitor(wf, comfyui_url, headers)
    if result is None:
        print(f"ComfyUI non disponible pour: {p[:50]}...")
    else:
        print(f"Résultat: {result['success']}, Temps: {result.get('elapsed', 0):.1f}s")
ComfyUI non disponible pour: Votre prompt 1......
ComfyUI non disponible pour: Votre prompt 2......
ComfyUI non disponible pour: Votre prompt 3......

La construction d’un second workflow alternatif permet de tester différentes architectures de nodes et de comparer les performances sur le même prompt.

# Second workflow alternatif : meme prompt, architecture de nodes differente.
# Cette cellule ne redefinit ni build_my_workflow ni submit_and_monitor
# (exercice precedent) : seule la construction varie, la soumission reutilise
# la meme fonction.
def build_alternate_workflow(prompt: str, negative: str,
                             width: int, height: int,
                             frames: int, fps: int) -> Dict:
    """
    Variante d'architecture pour comparer les performances sur le meme prompt.

    Differences volontaires par rapport a build_my_workflow :
    - Sampler : ddim au lieu d'euler (convergence differente)
    - Motion module : v2_sd15_mm.ckpt au lieu de v3_sd15_mm.ckpt
    - CFG legerement plus bas (6.0) pour la coherence temporelle

    Nodes a inclure : CheckpointLoader, CLIPTextEncode x2, KSampler,
    VAEDecode, VHS_VideoCombine -- la topologie reste libre.
    """
    workflow = {}

    # TODO: Construire les nodes de la variante
    # workflow["1"] = {...}

    return workflow

# Comparaison : le meme prompt soumis a la variante (la soumission reutilise
# submit_and_monitor de l'exercice precedent).
for p in my_prompts:
    wf_alt = build_alternate_workflow(p, "low quality", 512, 512, 16, 8)
    result_alt = submit_and_monitor(wf_alt, comfyui_url, headers)
    if result_alt is None:
        print(f"Variante non soumise (submit_and_monitor non complete ou ComfyUI non disponible): {p[:50]}...")
    else:
        print(f"Variante - Resultat: {result_alt['success']}, Temps: {result_alt.get('elapsed', 0):.1f}s")
Variante non soumise (submit_and_monitor non complete ou ComfyUI non disponible): Votre prompt 1......
Variante non soumise (submit_and_monitor non complete ou ComfyUI non disponible): Votre prompt 2......
Variante non soumise (submit_and_monitor non complete ou ComfyUI non disponible): Votre prompt 3......

Pour exposer diffusers comme un node ComfyUI, on créé un proxy qui traduit les paramètres du workflow JSON vers les appels Python correspondants.

# TODO: Créer un custom node ComfyUI pour diffusers
class DiffusersProxyNode:
    """
    Custom node ComfyUI qui proxy vers diffusers.
    
    Architecture:
    ComfyUI -> Custom Node -> Pipeline Diffusers -> Output ComfyUI
    """
    
    @classmethod
    def INPUT_TYPES(cls):
        return {
            "required": {
                "model_id": ("STRING", {"default": "stabilityai/sd-turbo"}),
                "prompt": ("STRING", {"default": ""}),
                "steps": ("INT", {"default": 20}),
                "width": ("INT", {"default": 512}),
                "height": ("INT", {"default": 512}),
            }
        }
    
    RETURN_TYPES = ("IMAGE",)
    FUNCTION = "generate"
    
    def generate(self, model_id, prompt, steps, width, height):
        # TODO: Appeler le pipeline diffusers
        # from diffusers import StableDiffusionPipeline
        # pipe = StableDiffusionPipeline.from_pretrained(model_id)
        # image = pipe(prompt, num_inference_steps=steps).images[0]
        # Retourner au format ComfyUI (numpy tensor)
        pass

# TODO: Intégrer dans un workflow ComfyUI
# Le workflow utilise ce node comme n'importe quel autre node ComfyUI

# TODO: Benchmark comparatif
# Diffusers pur vs ComfyUI proxy
# Mesurer: temps, VRAM, flexibilité

Exercice : Exploration et Comparaison de Paramètres Workflow

Duree estimee : 30-45 minutes

Objectif

Implementer une fonction de balayage systématique des paramètres du workflow AnimateDiff (CFG scale, steps, sampler) pour etudier leur impact sur la qualite visuelle de la video generee.

Contexte

Les paramètres du KSampler (node “7”) ont un impact direct sur la qualite de la video : - CFG scale : contrôle l’adherence au prompt (trop bas = flou, trop haut = artefacts) - Steps : nombre d’itérations de debruitage (plus = meilleure qualite mais plus lent) - Sampler : algorithme de debruitage (euler, euler_ancestral, ddim, dpmpp_2m…)

Un balayage systématique permet de trouver les paramètres optimaux sans tatonnement manuel.

Instructions

  1. Définir la grille de paramètres
    • CFG : [4.0, 7.5, 12.0]
    • Steps : [15, 25, 40]
    • Samplers : [“euler”, “euler_ancestral”, “dpmpp_2m”]
  2. Implementer la fonction de sweep
    • run_parameter_sweep(base_workflow, param_grid) : modifie les champs du KSampler
    • Sauvegarder chaque résultat avec les paramètres utilises
    • Mesurer le temps de generation pour chaque combinaison
  3. Analyser les résultats
    • Comparer visuellement les frames pour chaque paramètre
    • Identifier les combinaisons optimales (qualite vs temps)
    • Documenter les observations dans un tableau recapitulatif

Indices :

  • Le KSampler est le node “7” dans le workflow de base : workflow["7"]["inputs"]["cfg"]
  • Pour modifier le sampler : workflow["7"]["inputs"]["sampler_name"]
  • Limiter le sweep a 9 combinaisons pour rester dans un temps raisonnable
  • Sauvegarder les images de chaque run avec un nom encode les paramètres
# TODO: Implementer le balayage systematique des parametres

import copy  # Pour copier le workflow de base sans le modifier

def run_parameter_sweep(base_workflow: Dict, param_grid: Dict) -> List[Dict]:
    """
    Execute un balayage des parametres du KSampler.
    
    Args:
        base_workflow: Workflow AnimateDiff de base (dict JSON ComfyUI)
        param_grid: Dictionnaire avec les parametres a tester
            {
                "cfg": [4.0, 7.5, 12.0],
                "steps": [15, 25, 40],
                "sampler_name": ["euler", "euler_ancestral", "dpmpp_2m"]
            }
    
    Returns:
        Liste de resultats, chacun contenant:
        - 'params': parametres utilises
        - 'success': bool
        - 'elapsed': temps en secondes
        - 'images': liste d'images PIL (ou None)
    """
    results = []
    
    # TODO: Iterer sur chaque combinaison de parametres
    # for cfg in param_grid.get("cfg", [7.5]):
    #     for steps in param_grid.get("steps", [25]):
    #         for sampler in param_grid.get("sampler_name", ["euler"]):
    #             # 1. Copier le workflow de base
    #             wf = copy.deepcopy(base_workflow)
    #             
    #             # 2. Modifier le node KSampler (node "7")
    #             wf["7"]["inputs"]["cfg"] = cfg
    #             wf["7"]["inputs"]["steps"] = steps
    #             wf["7"]["inputs"]["sampler_name"] = sampler
    #             
    #             # 3. Soumettre le workflow
    #             start_time = time.time()
    #             # prompt_id = submit_workflow(wf, comfyui_url, headers)
    #             elapsed = time.time() - start_time
    #             
    #             # 4. Collecter les resultats
    #             results.append({
    #                 "params": {"cfg": cfg, "steps": steps, "sampler": sampler},
    #                 "success": False,
    #                 "elapsed": elapsed,
    #                 "images": None
    #             })
    
    return results


# Grille de parametres pour le sweep
param_grid = {
    "cfg": [4.0, 7.5, 12.0],
    "steps": [15, 25, 40],
    "sampler_name": ["euler", "euler_ancestral", "dpmpp_2m"]
}

# TODO: Executer le sweep (decommenter quand ComfyUI est disponible)
# sweep_results = run_parameter_sweep(workflow, param_grid)
# print(f"Sweep termine : {len(sweep_results)} combinaisons testees")

# TODO: Afficher un tableau recapitulatif des resultats
# for r in sweep_results:
#     p = r["params"]
#     print(f"  CFG={p['cfg']}, Steps={p['steps']}, Sampler={p['sampler']}: "
#           f"{'OK' if r['success'] else 'FAIL'} en {r['elapsed']:.1f}s")

# TODO: Visualiser les meilleures frames cote a cote
# Identifier les 4 meilleures combinaisons et afficher leurs frames

print("Exercice a completer : exploration et comparaison de parametres workflow")
Exercice a completer : exploration et comparaison de parametres workflow

Les statistiques de session recapitulent les workflows soumis, les temps d’exécution et les ressources utilisees pour evaluer l’efficacite de l’integration ComfyUI.

# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"ComfyUI URL : {comfyui_url}")
print(f"ComfyUI disponible : {comfyui_available}")
print(f"Workflow type : {workflow_type}")
print(f"VideoHelperSuite : {enable_video_helper}")
print(f"Parametres : {num_frames} frames, {steps} steps, CFG={cfg_scale}")
print(f"Resolution : {width}x{height}")

if generation_result.get('success'):
    print(f"\nGeneration : OK en {generation_result.get('elapsed', 0):.1f}s")
    n_images = len(generation_result.get('images', []))
    print(f"Images telechargees : {n_images}")
else:
    print(f"\nGeneration : non executee ou echouee")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Module 04-1 : Generation video educative (applications production)")
print(f"2. Explorer les workflows ComfyUI avances (ControlNet video, IP-Adapter)")
print(f"3. Combiner ComfyUI + diffusers dans un pipeline hybride")
print(f"4. Deployer un serveur ComfyUI pour la generation a la demande")

print(f"\nNotebook 03-3 ComfyUI Video Workflows termine - {datetime.now().strftime('%H:%M:%S')}")

--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-09-21 15:45:24
Mode : interactive
ComfyUI URL : http://localhost:8189
ComfyUI disponible : True
Workflow type : animatediff
VideoHelperSuite : True
Parametres : 16 frames, 25 steps, CFG=7.5
Resolution : 512x512

Generation : OK en 6.6s
Images telechargees : 16

Fichiers generes (3) :
  animatediff_00003.mp4 (795.0 KB)
  animatediff_workflow.json (2.3 KB)
  comfyui_animatediff.mp4 (465.2 KB)

--- PROCHAINES ETAPES ---
1. Module 04-1 : Generation video educative (applications production)
2. Explorer les workflows ComfyUI avances (ControlNet video, IP-Adapter)
3. Combiner ComfyUI + diffusers dans un pipeline hybride
4. Deployer un serveur ComfyUI pour la generation a la demande

Notebook 03-3 ComfyUI Video Workflows termine - 15:45:24
Retour au sommet