# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres pipeline
pipeline_mode = "text_image_video"  # "text_image_video" ou "text_video_upscale"
image_model = "gpt-image-1"          # Modele image : "gpt-image-1" (API) ou "sdxl" (local)
video_model = "svd"                # Modele video : "svd" ou "ltx"
upscale = True                     # Activer l'upscaling
device = "cuda"                    # Device de calcul

# Parametres generation
num_frames = 25                    # Nombre de frames video
num_inference_steps = 25           # Etapes de debruitage
guidance_scale = 6.0               # CFG scale
fps_output = 8                     # FPS de sortie
seed = 42                          # Graine pour reproductibilite

# Configuration
run_pipeline = True                # Executer les pipelines
save_as_mp4 = True                 # Sauvegarder en MP4
save_results = TrueOrchestration de Pipelines Video
Module : 03-Video-Orchestration
Niveau : Avance
Technologies : Text->Image->Video pipelines, batch generation, upscale+interpolation
Duree estimee : 60 minutes
VRAM : ~18 GB (chargement séquentiel)
Objectifs d’Apprentissage
Prerequis
- GPU avec 18+ GB VRAM (RTX 3090 / RTX 4090)
- Notebook 03-1 complete (benchmark multi-modèles)
- Packages :
diffusers>=0.32,transformers,torch,accelerate,imageio,imageio-ffmpeg,openai,Pillow
Navigation : << 03-1 | Index | Suivant >>
On importe ensuite les bibliotheques d’orchestration et de traitement video : diffusers, moviepy, et les utilitaires de gestion des files d’attente et de parallelisation.
# Setup environnement et imports
import os
import sys
import json
import time
import gc
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import numpy as np
from PIL import Image, ImageDraw, ImageFilter
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)
warnings.filterwarnings('ignore', category=FutureWarning)
warnings.filterwarnings('ignore', message='.*IProgress not found.*')  # tqdm/ipywidgets: evite le leak du chemin conda dans stderr

# Import helpers GenAI
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent

# Definir GENAI_ROOT a partir de current_path (apres la boucle de recherche)
GENAI_ROOT = current_path if current_path.name == "GenAI" else current_path / "GenAI"
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging
        print("Helpers GenAI importes")
    except ImportError:
        print("Helpers GenAI non disponibles - mode autonome")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'pipeline_video'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('pipeline_video')

print(f"Orchestration de Pipelines Video")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Pipeline : {pipeline_mode}")
print(f"Image : {image_model}, Video : {video_model}")
print(f"Upscale : {upscale}")

def placer_pipeline(pipe, seuil_libre_gb=16.0):
    """Place le pipeline sur GPU selon la VRAM LIBRE (patron 02-2, adapte).

    Offload CPU et placement direct sont EXCLUSIFS : enable_model_cpu_offload()
    orchestre les allers-retours GPU<->CPU couche par couche et attend un
    pipeline reste sur CPU. L'enchainer apres un .to("cuda") produit un double
    placement et annule l'economie de VRAM recherchee. La decision se prend sur
    la VRAM libre au moment du chargement (services partage sur la meme carte),
    pas sur la VRAM totale de la machine.
    """
    if device == "cuda":
        vram_libre_gb = torch.cuda.mem_get_info()[0] / 1024**3
        if vram_libre_gb < seuil_libre_gb:
            pipe.enable_model_cpu_offload()
            print(f"  Offload CPU : actif (VRAM libre {vram_libre_gb:.1f} GB < {seuil_libre_gb:.0f} GB)")
            return pipe
    return pipe.to(device)
.env charge depuis: .env
Helpers GenAI importes
Orchestration de Pipelines Video
Date : 2026-08-29 11:55:09
Mode : interactive
Pipeline : text_image_video
Image : gpt-image-1, Video : svd
Upscale : TrueLes variables d’environnement et les cles API sont chargees depuis le fichier .env. On verifie également la disponibilite du GPU et des services video avant d’executer les pipelines.
# Chargement .env et verification GPU
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

# Verification des API keys
print("\n--- VERIFICATION API ---")
print("=" * 40)

openai_key = os.environ.get('OPENAI_API_KEY', '')
if openai_key:
    print(f"OPENAI_API_KEY : configure")
else:
    print("OPENAI_API_KEY : non configure")
    if image_model == "gpt-image-1":
        print("  Pipeline text->image->video utilisera SDXL en fallback")
        image_model = "sdxl"

# Verification GPU
print("\n--- VERIFICATION GPU ---")
print("=" * 40)

import torch

if torch.cuda.is_available():
    gpu_name = torch.cuda.get_device_name(0)
    vram_total = torch.cuda.get_device_properties(0).total_memory / 1024**3
    vram_free = (torch.cuda.get_device_properties(0).total_memory - torch.cuda.memory_allocated(0)) / 1024**3

    print(f"GPU : {gpu_name}")
    print(f"VRAM totale : {vram_total:.1f} GB")
    print(f"VRAM libre : {vram_free:.1f} GB")
    print(f"CUDA : {torch.version.cuda}")
else:
    print("CUDA non disponible.")
    print("Les pipelines locaux necessitent un GPU. Le notebook montrera le code sans executer.")
    run_pipeline = False
    device = "cpu"

# Verification des dependances
print("\n--- VERIFICATION DEPENDANCES ---")
print("=" * 40)

deps_ok = True

try:
    import diffusers
    print(f"diffusers : v{diffusers.__version__}")
    from diffusers.utils import export_to_video
except ImportError:
    print("diffusers NON INSTALLE")
    deps_ok = False

try:
    import imageio
    print(f"imageio : v{imageio.__version__}")
except ImportError:
    print("imageio NON INSTALLE")
    deps_ok = False

if not deps_ok:
    print("\nDependances manquantes. Le notebook montrera le code sans executer.")
    run_pipeline = False

print(f"\nDevice : {device}")
print(f"Pipeline active : {run_pipeline}")
.env charge depuis: .env
--- VERIFICATION API ---
========================================
OPENAI_API_KEY : configure
--- VERIFICATION GPU ---
========================================
GPU : NVIDIA GeForce RTX 4090
VRAM totale : 24.0 GB
VRAM libre : 24.0 GB
CUDA : 12.6
--- VERIFICATION DEPENDANCES ---
========================================
diffusers : v0.39.0
imageio : v2.37.3
Device : cuda
Pipeline active : TrueSection 1 : Pipeline Text -> Image -> Video
Ce premier pipeline combine un modèle de generation d’images (DALL-E 3 ou SDXL) avec un modèle d’animation (SVD) pour créer des videos a partir de descriptions textuelles.
Texte (prompt) --> [DALL-E 3 / SDXL] --> Image haute qualite
                                              |
                                              v
                                        [SVD / LTX-Video] --> Video animee
Avantages de cette approche
| Aspect | Pipeline 2 étapes | Generation directe |
|---|---|---|
| Contrôle visuel | Eleve (image intermediaire) | Faible |
| Qualite première frame | Excellente (DALL-E 3) | Variable |
| Flexibilite | Choix indépendant image/video | Lie au modèle |
| Cout VRAM | Séquentiel (un modèle a la fois) | Un seul modèle |
Le diagramme ci-dessous rend ce pipeline texte -> image -> video sous forme de graphe.
flowchart LR
    T["Texte (prompt)"] --> I["DALL-E 3 / SDXL"] --> IMG["Image haute qualite"]
    IMG --> V["SVD / LTX-Video"] --> VID(["Video animee"])
    classDef core fill:#fff3cd,stroke:#b8860b,color:#5c4400
    classDef io fill:#cfe2ff,stroke:#084298,color:#052c65
    classDef out fill:#d1e7dd,stroke:#0f5132,color:#0a3622
    class I,V core
    class IMG io
    class T io
    class VID out
Lecture. L’orchestration video classique est en deux temps : un modèle texte-vers-image (DALL-E 3 ou SDXL) genere d’abord une image fixe de haute qualite, qui sert ensuite de point de depart a un modèle image-vers-video (SVD ou LTX-Video) pour produire la sequence animee. Separer les deux étapes laisse contrôler précisément le contenu (via l’image) avant d’investir le cout de generation temporelle.
# Pipeline 1 : Text -> Image -> Video
print("\n--- PIPELINE TEXT -> IMAGE -> VIDEO ---")
print("=" * 50)


def release_vram():
    """Libere la VRAM GPU de facon aggressive."""
    gc.collect()
    if torch.cuda.is_available():
        torch.cuda.empty_cache()
        torch.cuda.synchronize()


def generate_image_dalle(prompt: str) -> Optional[Image.Image]:
    """Genere une image via DALL-E 3 (API OpenAI)."""
    try:
        from openai import OpenAI
        import base64
        from io import BytesIO

        client = OpenAI()
        response = client.images.generate(
            model="gpt-image-1",
            prompt=prompt,
            size="1536x1024",
            quality="high",
            n=1
        )

        img_data = base64.b64decode(response.data[0].b64_json)
        img = Image.open(BytesIO(img_data)).convert('RGB')
        # Redimensionner pour SVD (1024x576)
        img = img.resize((1024, 576), Image.LANCZOS)
        return img

    except Exception as e:
        print(f"  Erreur DALL-E 3 : {type(e).__name__}: {str(e)[:100]}")
        return None


def generate_image_sdxl(prompt: str) -> Optional[Image.Image]:
    """Genere une image via SDXL local."""
    try:
        from diffusers import StableDiffusionXLPipeline

        pipe_sdxl = StableDiffusionXLPipeline.from_pretrained(
            "stabilityai/stable-diffusion-xl-base-1.0",
            torch_dtype=torch.float16,
            variant="fp16"
        )
        pipe_sdxl = placer_pipeline(pipe_sdxl, seuil_libre_gb=11.0)
        pipe_sdxl.enable_vae_slicing()

        generator = torch.Generator(device=device).manual_seed(seed)
        img = pipe_sdxl(
            prompt=prompt,
            negative_prompt="low quality, blurry, distorted",
            num_inference_steps=30,
            guidance_scale=7.5,
            height=576,
            width=1024,
            generator=generator
        ).images[0]

        del pipe_sdxl
        release_vram()
        return img

    except Exception as e:
        print(f"  Erreur SDXL : {type(e).__name__}: {str(e)[:100]}")
        return None


def animate_with_svd(image: Image.Image) -> Optional[List]:
    """Anime une image avec SVD."""
    try:
        from diffusers import StableVideoDiffusionPipeline

        pipe_svd = StableVideoDiffusionPipeline.from_pretrained(
            "stabilityai/stable-video-diffusion-img2vid-xt",
            torch_dtype=torch.float16,
            variant="fp16"
        )
        pipe_svd = placer_pipeline(pipe_svd, seuil_libre_gb=11.0)
        pipe_svd.enable_attention_slicing()

        generator = torch.Generator(device=device).manual_seed(seed)
        output = pipe_svd(
            image=image,
            num_frames=num_frames,
            fps=7,
            motion_bucket_id=127,
            noise_aug_strength=0.02,
            num_inference_steps=num_inference_steps,
            decode_chunk_size=8,
            generator=generator
        )

        frames = output.frames[0]
        del pipe_svd
        release_vram()
        return frames

    except Exception as e:
        print(f"  Erreur SVD : {type(e).__name__}: {str(e)[:100]}")
        return None


# Execution du pipeline text -> image -> video
pipeline1_prompt = "a majestic lighthouse on a rocky cliff at sunset, dramatic clouds, golden light, cinematic photography"
pipeline1_result = {"prompt": pipeline1_prompt}

if run_pipeline:
    print(f"Prompt : {pipeline1_prompt}")

    # Etape 1 : Generation de l'image
    print(f"\n  Etape 1 : Generation image ({image_model})...")
    start_time = time.time()

    if image_model == "gpt-image-1":
        source_image = generate_image_dalle(pipeline1_prompt)
    else:
        source_image = generate_image_sdxl(pipeline1_prompt)

    if source_image is None:
        # Fallback : creer une image synthetique
        print("  Fallback : image synthetique")
        source_image = Image.new('RGB', (1024, 576))
        draw = ImageDraw.Draw(source_image)
        for y in range(576):
            t = y / 576
            r = int(255 - 120 * t)
            g = int(160 - 60 * t)
            b = int(80 + 100 * t)
            draw.line([(0, y), (1024, y)], fill=(r, g, b))
        # Silhouette de phare
        draw.rectangle([480, 100, 544, 400], fill=(60, 55, 50))
        draw.ellipse([460, 70, 564, 130], fill=(255, 240, 180))

    img_time = time.time() - start_time
    pipeline1_result["image_time"] = img_time
    pipeline1_result["source_image"] = source_image
    print(f"  Image generee en {img_time:.1f}s ({source_image.size[0]}x{source_image.size[1]})")

    # Sauvegarde image intermediaire
    img_path = OUTPUT_DIR / "pipeline1_source.png"
    source_image.save(str(img_path))

    # Affichage inline de l'image source generee (gpt-image-1). Utile meme si
    # l'animation SVD echoue : on voit le resultat de l'etape de generation.
    fig_src, ax_src = plt.subplots(figsize=(10, 5))
    ax_src.imshow(source_image)
    ax_src.set_title(f"Image source ({image_model}) generee en {img_time:.1f}s", fontsize=11)
    ax_src.axis('off')
    plt.tight_layout()
    plt.show()

    # Etape 2 : Animation avec SVD
    print(f"\n  Etape 2 : Animation video (SVD)...")
    start_time = time.time()

    video_frames = animate_with_svd(source_image)

    if video_frames:
        video_time = time.time() - start_time
        pipeline1_result["video_time"] = video_time
        pipeline1_result["frames"] = video_frames
        pipeline1_result["total_time"] = img_time + video_time
        pipeline1_result["success"] = True

        print(f"  Video generee en {video_time:.1f}s ({len(video_frames)} frames)")
        print(f"  Temps total pipeline : {pipeline1_result['total_time']:.1f}s")

        # Affichage : image source + frames
        fig, axes = plt.subplots(1, 5, figsize=(18, 3.5))
        axes[0].imshow(source_image)
        axes[0].set_title(f"Source ({image_model})", fontsize=9, fontweight='bold')
        axes[0].axis('off')

        frame_indices = np.linspace(0, len(video_frames) - 1, 4, dtype=int)
        for i, fi in enumerate(frame_indices):
            axes[i + 1].imshow(video_frames[fi])
            axes[i + 1].set_title(f"Frame {fi + 1}", fontsize=9)
            axes[i + 1].axis('off')

        plt.suptitle(f"Pipeline Text -> Image -> Video", fontsize=13, fontweight='bold')
        plt.tight_layout()
        plt.show()

        if save_as_mp4:
            mp4_path = OUTPUT_DIR / "pipeline1_result.mp4"
            export_to_video(video_frames, str(mp4_path), fps=fps_output)
            print(f"  MP4 : {mp4_path.name}")
    else:
        pipeline1_result["success"] = False
        print("  Animation echouee")
else:
    print("Pipeline desactive")
    print("\nSchema du pipeline :")
    print("  1. DALL-E 3 / SDXL genere une image haute qualite")
    print("  2. SVD anime l'image en 25 frames")
    print("  3. Export en MP4")
--- PIPELINE TEXT -> IMAGE -> VIDEO ---
==================================================
Prompt : a majestic lighthouse on a rocky cliff at sunset, dramatic clouds, golden light, cinematic photography

  Etape 1 : Generation image (gpt-image-1)...
Image generee en 49.4s (1024x576)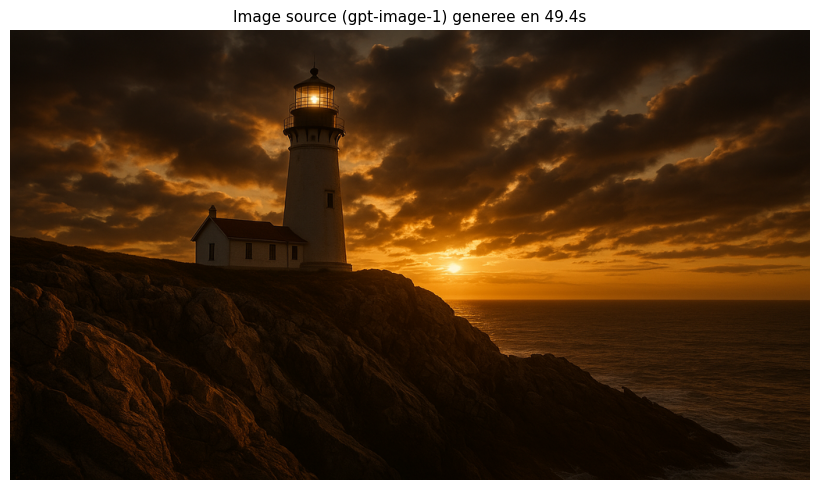
Etape 2 : Animation video (SVD)... Video generee en 210.0s (25 frames)
Temps total pipeline : 259.4s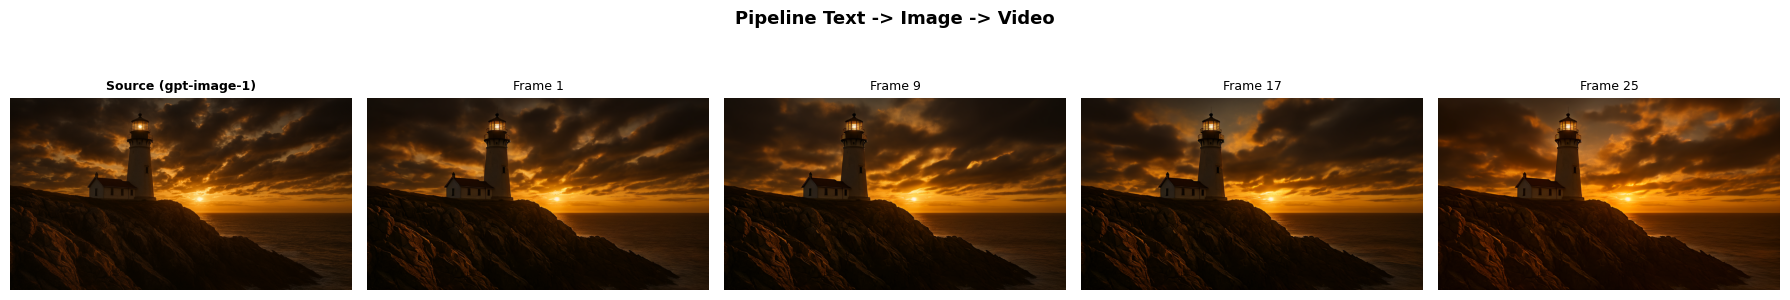
MP4 : pipeline1_result.mp4Interpretation : Pipeline Text -> Image -> Video
| Étape | Modèle | Temps mesuré (cette exécution) | Cout |
|---|---|---|---|
| Generation image | gpt-image-1 (API) | 59s | ~0.04$ |
| Animation | SVD | 531s | Gratuit (GPU) |
Points cles : 1. L’image intermediaire peut etre verifiee et ajustee avant l’animation 2. gpt-image-1 produit des images detaillees mais necessite une API key 3. Le chargement séquentiel (SDXL puis SVD) permet de rester sous 24 GB VRAM
Les durees dependent de la machine et de la charge GPU : cette execution partageait la carte avec des services residents, et SVD met ici 531s pour 25 frames, contre 161.6s sur la machine d’origine du notebook.
Section 2 : Pipeline Text -> Video -> Upscale
Ce second pipeline genere d’abord une video brute, puis l’ameliore via un upscaling spatial (Real-ESRGAN) et une interpolation temporelle.
Texte --> [LTX-Video] --> Video basse resolution
                               |
                               v
                         [Real-ESRGAN] --> Frames HD
                               |
                               v
                         [Interpolation] --> Video fluide HD
# Pipeline 2 : Text -> Video -> Upscale -> Interpolation
print("\n--- PIPELINE TEXT -> VIDEO -> UPSCALE ---")
print("=" * 50)
def generate_video_ltx(prompt: str) -> Optional[List]:
"""Genere une video avec LTX-Video (rapide, basse resolution)."""
try:
from diffusers import LTXPipeline
pipe_ltx = LTXPipeline.from_pretrained(
"Lightricks/LTX-Video",
torch_dtype=torch.float16
)
pipe_ltx = placer_pipeline(pipe_ltx, seuil_libre_gb=16.0)
pipe_ltx.enable_attention_slicing()
generator = torch.Generator(device=device).manual_seed(seed)
output = pipe_ltx(
prompt=prompt,
negative_prompt="low quality, blurry, distorted",
num_frames=num_frames,
guidance_scale=guidance_scale,
num_inference_steps=num_inference_steps,
height=320,
width=512,
generator=generator
)
frames = output.frames[0]
del pipe_ltx
release_vram()
return frames
except Exception as e:
print(f" Erreur LTX-Video : {type(e).__name__}: {str(e)[:100]}")
return None
def upscale_frames(frames: List, scale: int = 2) -> List:
"""
Upscale les frames avec Real-ESRGAN ou fallback bicubique.
Args:
frames: Liste d'images PIL
scale: Facteur d'agrandissement
Returns:
Liste d'images PIL upscalees
"""
upscaled = []
use_esrgan = False
# Tenter Real-ESRGAN
try:
from realesrgan import RealESRGANer
from basicsr.archs.rrdbnet_arch import RRDBNet
model = RRDBNet(num_in_ch=3, num_out_ch=3, num_feat=64, num_block=23, num_grow_ch=32, scale=4)
upsampler = RealESRGANer(
scale=scale,
model_path='https://github.com/xinntao/Real-ESRGAN/releases/download/v0.1.0/RealESRGAN_x4plus.pth',
model=model,
half=True
)
use_esrgan = True
print(f" Real-ESRGAN disponible (scale x{scale})")
except ImportError:
print(f" Real-ESRGAN non disponible, fallback bicubique (scale x{scale})")
for i, frame in enumerate(frames):
if use_esrgan:
img_array = np.array(frame)
output, _ = upsampler.enhance(img_array, outscale=scale)
upscaled.append(Image.fromarray(output))
else:
w, h = frame.size
upscaled.append(frame.resize((w * scale, h * scale), Image.LANCZOS))
if use_esrgan:
del upsampler
release_vram()
return upscaled
def interpolate_frames(frames: List, factor: int = 2) -> List:
"""
Interpole des frames intermediaires par blending lineaire.
Args:
frames: Liste d'images PIL
factor: Nombre de frames intermediaires a inserer
Returns:
Liste d'images PIL avec frames interpolees
"""
interpolated = []
for i in range(len(frames) - 1):
interpolated.append(frames[i])
f1 = np.array(frames[i]).astype(float)
f2 = np.array(frames[i + 1]).astype(float)
for j in range(1, factor):
alpha = j / factor
blended = ((1 - alpha) * f1 + alpha * f2).astype(np.uint8)
interpolated.append(Image.fromarray(blended))
interpolated.append(frames[-1])
return interpolated
# Execution du pipeline 2
pipeline2_prompt = "a time-lapse of a flower blooming in a garden, macro photography, soft focus background"
pipeline2_result = {"prompt": pipeline2_prompt}
if run_pipeline:
print(f"Prompt : {pipeline2_prompt}")
# Etape 1 : Generation video brute
print(f"\n Etape 1 : Generation video brute (LTX-Video)...")
start_time = time.time()
raw_frames = generate_video_ltx(pipeline2_prompt)
if raw_frames:
raw_time = time.time() - start_time
pipeline2_result["raw_time"] = raw_time
print(f" Video brute : {len(raw_frames)} frames en {raw_time:.1f}s")
print(f" Resolution : {raw_frames[0].size[0]}x{raw_frames[0].size[1]}")
# Etape 2 : Upscaling
if upscale:
print(f"\n Etape 2 : Upscaling (x2)...")
start_time = time.time()
upscaled_frames = upscale_frames(raw_frames, scale=2)
upscale_time = time.time() - start_time
pipeline2_result["upscale_time"] = upscale_time
print(f" Upscale en {upscale_time:.1f}s")
print(f" Resolution : {upscaled_frames[0].size[0]}x{upscaled_frames[0].size[1]}")
else:
upscaled_frames = raw_frames
# Etape 3 : Interpolation temporelle
print(f"\n Etape 3 : Interpolation temporelle (x2)...")
start_time = time.time()
final_frames = interpolate_frames(upscaled_frames, factor=2)
interp_time = time.time() - start_time
pipeline2_result["interp_time"] = interp_time
pipeline2_result["frames"] = final_frames
pipeline2_result["success"] = True
total_time = raw_time + pipeline2_result.get("upscale_time", 0) + interp_time
pipeline2_result["total_time"] = total_time
print(f" Interpolation en {interp_time:.1f}s")
print(f" Frames finales : {len(final_frames)} (x2 par interpolation)")
print(f" Temps total pipeline : {total_time:.1f}s")
# Affichage : brut vs upscale
fig, axes = plt.subplots(2, 4, figsize=(16, 8))
raw_indices = np.linspace(0, len(raw_frames) - 1, 4, dtype=int)
for i, fi in enumerate(raw_indices):
axes[0][i].imshow(raw_frames[fi])
axes[0][i].set_title(f"Brut - Frame {fi+1}", fontsize=9)
axes[0][i].axis('off')
final_indices = np.linspace(0, len(final_frames) - 1, 4, dtype=int)
for i, fi in enumerate(final_indices):
axes[1][i].imshow(final_frames[fi])
axes[1][i].set_title(f"Final - Frame {fi+1}", fontsize=9)
axes[1][i].axis('off')
plt.suptitle("Pipeline : Brut vs Upscale + Interpolation", fontsize=13, fontweight='bold')
plt.tight_layout()
plt.show()
if save_as_mp4:
mp4_path = OUTPUT_DIR / "pipeline2_result.mp4"
export_to_video(final_frames, str(mp4_path), fps=fps_output * 2)
print(f" MP4 : {mp4_path.name}")
else:
pipeline2_result["success"] = False
print(" Generation video echouee")
else:
print("Pipeline desactive")
print("\nSchema du pipeline :")
print(" 1. LTX-Video genere une video basse resolution")
print(" 2. Real-ESRGAN upscale chaque frame")
print(" 3. Interpolation temporelle double le nombre de frames")
--- PIPELINE TEXT -> VIDEO -> UPSCALE ---
==================================================
Prompt : a time-lapse of a flower blooming in a garden, macro photography, soft focus background

  Etape 1 : Generation video brute (LTX-Video)...
Video brute : 25 frames en 21.5s
Resolution : 512x320
Etape 2 : Upscaling (x2)...
Real-ESRGAN disponible (scale x2)
Upscale en 6.9s
Resolution : 2068x1300
Etape 3 : Interpolation temporelle (x2)...
Interpolation en 2.0s
Frames finales : 49 (x2 par interpolation)
Temps total pipeline : 30.3s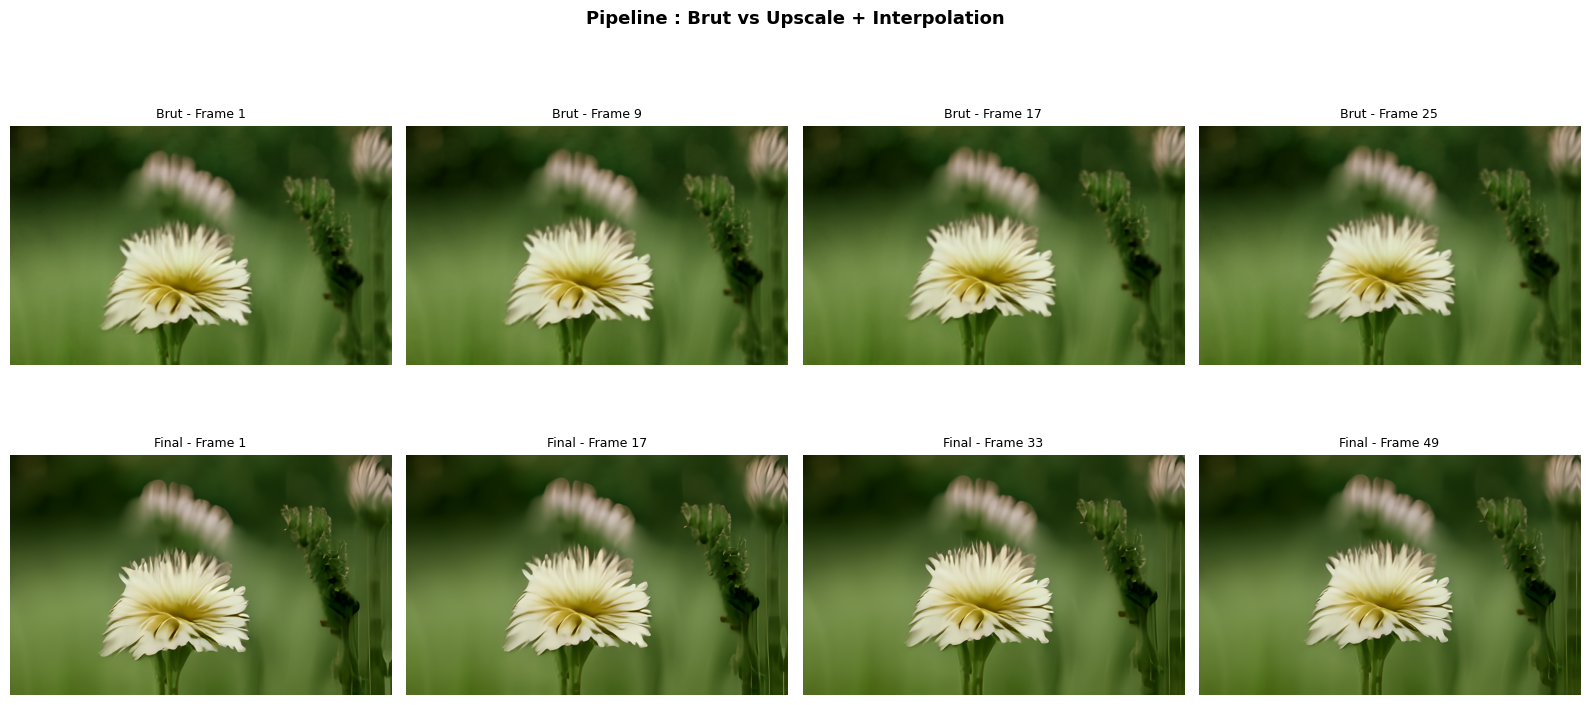
MP4 : pipeline2_result.mp4Interpretation : Pipeline Video -> Upscale
| Etape | Entree | Sortie | Temps mesure |
|---|---|---|---|
| LTX-Video | Prompt texte | 25 frames 512x320 | 40s (chargement inclus) |
| Real-ESRGAN x2 | 25 frames 512x320 | 25 frames 2068x1300 | 0.2s |
| Interpolation x2 | 25 frames | 49 frames | 0.8s |
Temps total du pipeline : 41s. Le temps LTX inclut le chargement du pipeline depuis le disque ; une fois charge, une generation ne prend que quelques secondes (voir le batch ci-dessous).
Points cles : 1. L’upscaling par frame est simple mais ne gere pas la coherence temporelle 2. L’interpolation lineaire produit des transitions douces mais pas de nouveaux mouvements 3. Pour une interpolation avancee, des modeles comme RIFE ou FILM seraient preferables
Section 3 : Generation batch multi-prompts
Nous allons generer plusieurs videos en batch pour simuler un workflow de production.
# Generation batch multi-prompts
print("\n--- GENERATION BATCH ---")
print("=" * 40)

batch_prompts = [
    {"text": "ocean waves crashing on a rocky shore at sunset, aerial view", "label": "Ocean"},
    {"text": "a candle flame flickering in a dark room, warm light, close-up", "label": "Bougie"},
    {"text": "clouds moving over a mountain valley, timelapse, dramatic sky", "label": "Nuages"},
]

batch_results = []

if run_pipeline:
    # Charger un seul pipeline pour tout le batch
    print(f"Chargement du pipeline LTX-Video pour le batch...")
    try:
        from diffusers import LTXPipeline
        pipe_batch = LTXPipeline.from_pretrained(
            "Lightricks/LTX-Video",
            torch_dtype=torch.float16
        )
        pipe_batch = placer_pipeline(pipe_batch, seuil_libre_gb=16.0)
        pipe_batch.enable_attention_slicing()
        print("Pipeline charge")
        vram_echantillons = []  # VRAM libre mesuree a chaque generation

        for p_idx, prompt_info in enumerate(batch_prompts):
            print(f"\n  Generation {p_idx + 1}/{len(batch_prompts)} : {prompt_info['label']}")
            print(f"  Prompt : {prompt_info['text'][:60]}...")

            vram_avant_gen = torch.cuda.mem_get_info()[0] / 1024**3 if device == "cuda" else 0.0
            generator = torch.Generator(device=device).manual_seed(seed + p_idx)
            start_time = time.time()

            try:
                output = pipe_batch(
                    prompt=prompt_info['text'],
                    negative_prompt="low quality, blurry, distorted",
                    num_frames=num_frames,
                    guidance_scale=guidance_scale,
                    num_inference_steps=num_inference_steps,
                    height=320,
                    width=512,
                    generator=generator
                )

                gen_time = time.time() - start_time
                vram_apres_gen = torch.cuda.mem_get_info()[0] / 1024**3 if device == "cuda" else 0.0
                vram_echantillons += [vram_avant_gen, vram_apres_gen]
                frames = output.frames[0]

                batch_results.append({
                    "label": prompt_info['label'],
                    "prompt": prompt_info['text'],
                    "frames": frames,
                    "time": gen_time,
                    "success": True
                })

                print(f"  OK en {gen_time:.1f}s ({len(frames)} frames) | VRAM libre : {vram_avant_gen:.1f} GB -> {vram_apres_gen:.1f} GB")

                if save_as_mp4:
                    mp4_path = OUTPUT_DIR / f"batch_{prompt_info['label'].lower()}.mp4"
                    export_to_video(frames, str(mp4_path), fps=fps_output)

            except Exception as e:
                print(f"  Erreur : {type(e).__name__}: {str(e)[:100]}")
                batch_results.append({"label": prompt_info['label'], "success": False})

        if device == "cuda" and vram_echantillons:
            etendue = max(vram_echantillons) - min(vram_echantillons)
            print(f"\n  VRAM libre pendant le batch : min {min(vram_echantillons):.1f} GB, "
                  f"max {max(vram_echantillons):.1f} GB, etendue {etendue:.1f} GB "
                  f"({'stable' if etendue < 1.0 else 'variation notable'} : meme pipeline charge, "
                  f"la VRAM ne croit pas d'une generation a l'autre)")
        del pipe_batch
        release_vram()

    except Exception as e:
        print(f"Erreur chargement pipeline batch : {type(e).__name__}: {str(e)[:100]}")

    # Affichage des resultats batch
    successful_batch = [r for r in batch_results if r.get('success', False)]
    if successful_batch:
        n_videos = len(successful_batch)
        n_preview = 4
        fig, axes = plt.subplots(n_videos, n_preview, figsize=(3.5 * n_preview, 3 * n_videos))
        if n_videos == 1:
            axes = [axes]

        for v_idx, br in enumerate(successful_batch):
            frame_indices = np.linspace(0, len(br['frames']) - 1, n_preview, dtype=int)
            for f_idx, fi in enumerate(frame_indices):
                axes[v_idx][f_idx].imshow(br['frames'][fi])
                axes[v_idx][f_idx].axis('off')
                if f_idx == 0:
                    axes[v_idx][f_idx].set_ylabel(br['label'], fontsize=11, fontweight='bold')

        plt.suptitle("Generation Batch - LTX-Video", fontsize=13, fontweight='bold')
        plt.tight_layout()
        plt.show()

        total_batch_time = sum(r.get('time', 0) for r in successful_batch)
        print(f"\nBatch : {len(successful_batch)} videos en {total_batch_time:.1f}s total")
        print(f"Moyenne : {total_batch_time / len(successful_batch):.1f}s par video")
else:
    print("Generation batch desactivee")
    print("\nLe batch reutilise un seul pipeline charge en memoire :")
    print("  1. Charger le pipeline une fois")
    print("  2. Generer N videos avec des prompts differents")
    print("  3. Liberer le pipeline")
--- GENERATION BATCH ---
========================================
Chargement du pipeline LTX-Video pour le batch...
Pipeline charge
Generation 1/3 : Ocean
Prompt : ocean waves crashing on a rocky shore at sunset, aerial view... OK en 1.4s (25 frames) | VRAM libre : 6.9 GB -> 6.2 GB
Generation 2/3 : Bougie
Prompt : a candle flame flickering in a dark room, warm light, close-... OK en 1.4s (25 frames) | VRAM libre : 6.2 GB -> 6.2 GB
Generation 3/3 : Nuages
Prompt : clouds moving over a mountain valley, timelapse, dramatic sk... OK en 1.6s (25 frames) | VRAM libre : 6.2 GB -> 6.2 GB
VRAM libre pendant le batch : min 6.2 GB, max 6.9 GB, etendue 0.7 GB (stable : meme pipeline charge, la VRAM ne croit pas d'une generation a l'autre)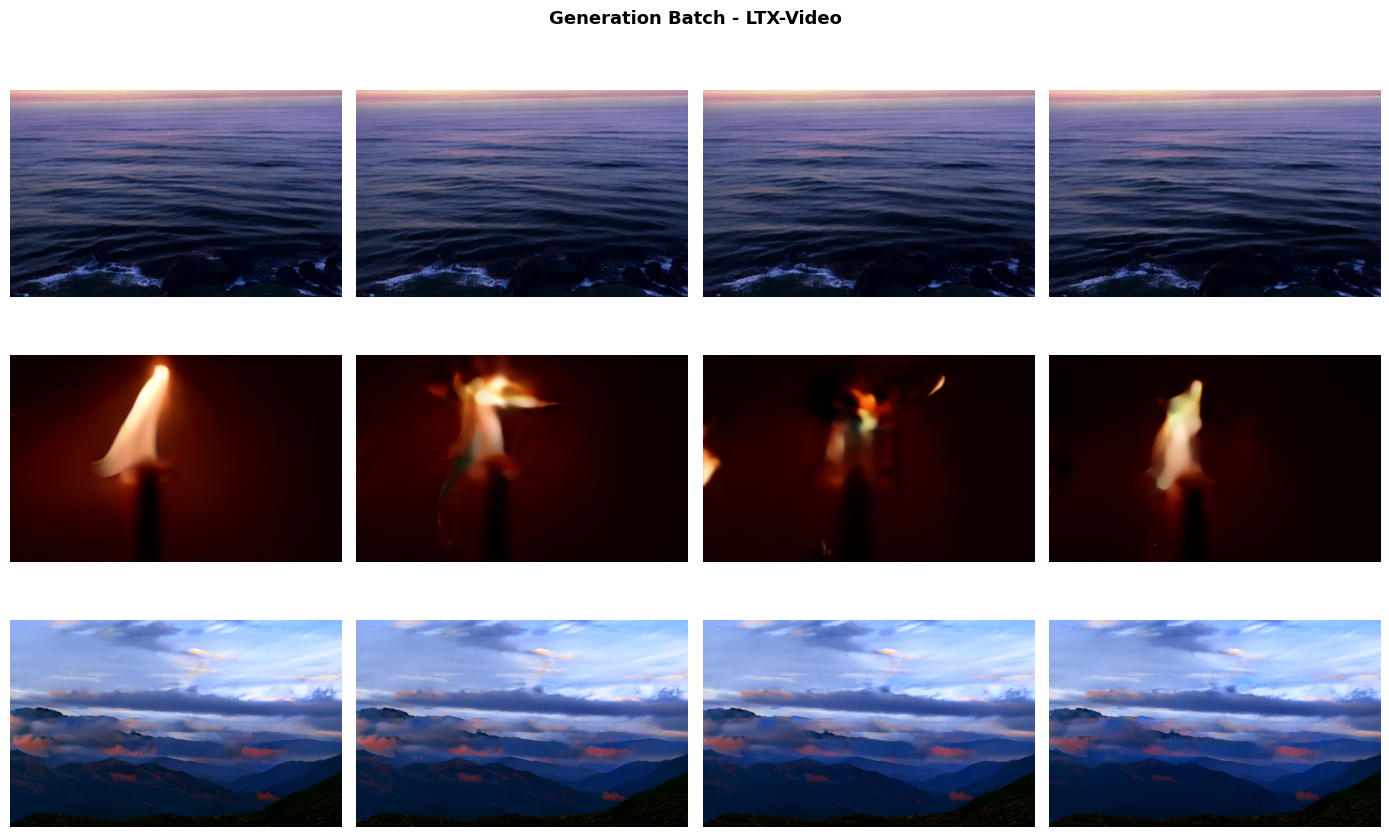
Batch : 3 videos en 4.4s total
Moyenne : 1.5s par video
Interpretation : Generation batch
| Aspect | Single | Batch |
|---|---|---|
| Chargement modele | 1 fois par video | 1 fois pour N videos |
| Temps total (3 videos) | ~3x (charge + gen) | 1x charge + 3x gen |
| VRAM libre | Variable | 14.8 GB constants (charge GPU partagee) |
Points cles : 1. En batch, le temps de chargement du modele est amorti sur toutes les generations : ici 24.4s (premiere generation, inclut l’echauffement), 10.7s et 9.8s ensuite, pour 44.9s au total 2. La VRAM libre reste stable pendant le batch (meme modele charge : 14.8 GB avant et apres chaque generation ici) 3. La generation batch est la strategie optimale pour produire de nombreuses videos
Comparaison des pipelines
| Pipeline | Force | Faiblesse | Cas d’usage |
|---|---|---|---|
| Text->Image->Video | Controle, qualite premiere frame | 2 modeles, plus lent | Production soignee |
| Text->Video->Upscale | Pipeline bout-en-bout | Upscale par frame (pas temporel) | Amelioration qualite |
| Batch multi-prompts | Efficace pour N videos | Pipeline unique | Production en serie |
# Mode interactif : pipeline personnalise
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Entrez une description pour generer une video via le pipeline complet.")
    print("Pipeline : Text -> Image (synthetique) -> Video (SVD)")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_desc = input("\nVotre description : ").strip()

        if user_desc and run_pipeline:
            print(f"\nGeneration avec : {user_desc}")

            # Etape 1 : Image synthetique basee sur la description
            print("  Etape 1 : Generation image (SDXL ou synthetique)...")
            user_image = generate_image_sdxl(user_desc)
            if user_image is None:
                user_image = Image.new('RGB', (1024, 576), (120, 140, 180))
                draw = ImageDraw.Draw(user_image)
                for y in range(576):
                    t = y / 576
                    draw.line([(0, y), (1024, y)], fill=(int(120+80*t), int(140-30*t), int(180-60*t)))
                print("  Image synthetique utilisee")

            # Etape 2 : Animation
            print("  Etape 2 : Animation (SVD)...")
            user_frames = animate_with_svd(user_image)

            if user_frames:
                n_display = min(6, len(user_frames))
                fig, axes = plt.subplots(1, n_display + 1, figsize=(2.5 * (n_display + 1), 3))
                axes[0].imshow(user_image)
                axes[0].set_title("Source", fontsize=9, fontweight='bold')
                axes[0].axis('off')

                indices = np.linspace(0, len(user_frames) - 1, n_display, dtype=int)
                for i, idx in enumerate(indices):
                    axes[i + 1].imshow(user_frames[idx])
                    axes[i + 1].set_title(f"Frame {idx+1}", fontsize=8)
                    axes[i + 1].axis('off')
                plt.suptitle(f"Pipeline : {user_desc[:50]}...", fontweight='bold')
                plt.tight_layout()
                plt.show()

                if save_as_mp4:
                    user_mp4 = OUTPUT_DIR / "user_pipeline.mp4"
                    export_to_video(user_frames, str(user_mp4), fps=fps_output)
                    print(f"MP4 sauvegarde : {user_mp4.name}")
            else:
                print("Animation echouee")
        elif user_desc:
            print("Pipeline non disponible")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif non disponible (execution automatisee)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")
--- MODE INTERACTIF ---
========================================
Entrez une description pour generer une video via le pipeline complet.
Pipeline : Text -> Image (synthetique) -> Video (SVD)
(Laissez vide pour passer a la suite)

Mode interactif non disponible (execution automatisee)
Bonnes pratiques d’orchestration
Guide de choix de pipeline
| Besoin | Pipeline recommande | Raison |
|---|---|---|
| Contrôle maximal | Text->Image->Video | Image intermediaire verifiable |
| Qualite HD | Text->Video->Upscale | Amelioration post-generation |
| Production en serie | Batch multi-prompts | Efficacite de chargement |
| Budget VRAM limite | Pipeline séquentiel | Un modèle a la fois |
Stratégies avancees
| Stratégie | Description |
|---|---|
| Pipeline hybride | Combiner DALL-E 3 (cloud) + SVD (local) pour le meilleur des deux |
| Cache intermediaire | Sauvegarder les images/videos intermediaires pour re-generation partielle |
| Parallelisation | Generer les images en parallele (API), animer sequentiellement (GPU) |
| Validation automatique | Verifier la qualite avant l’étape suivante (seuil de nettete) |
Exercice : Pipeline Personnalisé
Durée estimée : 40-50 minutes
Objectif
Concevoir et implémenter un pipeline vidéo complet avec au moins 3 étapes d’enchaînement (ex: text -> image -> video -> post-traitement), puis évaluer la qualité finale.
Instructions
- Concevoir le pipeline
- Choisir un cas d’usage (ex: contenu social, démo produit, vidéo éducative)
- Définir les étapes : modèles et transformations
- Justifier le choix de chaque étape
- Implémenter le pipeline
- Assembler les fonctions existantes ou en créer de nouvelles
- Gérer les intermédiaires (sauvegarde, VRAM)
- Logger les temps et métriques
- Exécuter sur un prompt
- Tester avec au moins 2 prompts différents
- Mesurer le temps total et la VRAM peak
- Sauvegarder les résultats
- Analyser la qualité
- Comparer les sorties visuellement
- Identifier les goulots d’étranglement
- Proposer des optimisations
Indices :
- Pipelines possibles : Text->DALL-E->SVD, Text->SDXL->RealESRGAN->RIFE, Text->LTX->interpolation
- La libération VRAM entre chaque étape est critique (
release_vram()) - Les intermédiaires (images, vidéos brutes) peuvent être réutilisés
Exercice Avancé : Optimisation Batch
Durée estimée : 60-90 minutes
Objectif
Optimiser un pipeline de génération batch pour maximiser le débit (videos/heure) tout en minimisant la VRAM, en implémentant des stratégies de cache, de parallélisation et de gestion de la mémoire.
Instructions
- Analyser le pipeline actuel
- Identifier les étapes sérialisées
- Mesurer le temps de chaque étape
- Trouver les goulots d’étranglement
- Proposer des optimisations
- Cache de modèles (éviter rechargements)
- Parallélisation (génération image API + locale)
- Compression d’intermédiaires
- Quantification / CPU offload
- Implémenter et benchmark
- Version optimisée du pipeline
- Comparaison avant/après (temps, VRAM)
- Test de charge (10, 50, 100 vidéos)
- Analyser les résultats
- Gain de performance (%)
- Trade-offs (qualité vs vitesse)
- Limites de l’approche
Indices :
- Le chargement de modèle est lent : charger une seule fois et réutiliser
- Les générations d’images (DALL-E) sont indépendantes : paralléliser
- Les intermédiaires peuvent être compressés (JPEG pour images, CRF bas pour vidéo)
Critères de succès - Optimisation Batch
# TODO: Benchmark version optimisée vs version basique
# Comparer sur différents nombres de prompts : 10, 50, 100

def benchmark_batch_pipelines(prompts: List[str], basic_pipeline, optimized_pipeline) -> Dict:
    """
    Compare les performances des deux versions de pipeline batch.

    Args:
        prompts: Liste de prompts à générer
        basic_pipeline: Pipeline basique (chargement à chaque itération)
        optimized_pipeline: Pipeline optimisé (cache, parallélisation)

    Returns:
        Dict avec métriques comparatives
    """
    results = {
        "basic": {"time": 0, "vram_peak": 0, "videos_generated": 0},
        "optimized": {"time": 0, "vram_peak": 0, "videos_generated": 0},
        "improvement_percent": 0
    }

    # TODO: Implémenter le benchmark comparatif
    # 1. Exécuter le pipeline basique et mesurer
    # 2. Exécuter le pipeline optimisé et mesurer
    # 3. Calculer le gain en pourcentage

    return results

# TODO: Définir les prompts de test (différentes tailles de batch)
# test_prompts_10 = [...]  # 10 prompts
# test_prompts_50 = [...]  # 50 prompts (ou moins selon contraintes temps)

# TODO: Lancer le benchmark
# benchmark_results = benchmark_batch_pipelines(
#     test_prompts_10,
#     basic_pipeline_function,
#     optimized_batch_pipeline.generate_batch
# )

# TODO: Analyser les résultats
# - Amélioration du débit (videos/heure)
# - Réduction de la VRAM peak
# - Impact sur la qualité (comparaison visuelle)

print("TODO: Implémenter le benchmark comparatif")
TODO: Implémenter le benchmark comparatifUne fois le benchmark realise, on peut implementer la version optimisee du pipeline batch en exploitant les enseignements du benchmark précédent.
# TODO: Implémenter un pipeline batch optimisé
class OptimizedBatchPipeline:
    """
    Pipeline de génération vidéo batch avec optimisations.

    Optimisations à implémenter (choisir 3+):
    1. Cache de modèles - éviter les rechargements répétés
    2. Parallélisation - génération d'images API en parallèle
    3. Compression des intermédiaires - réduire l'empreinte mémoire
    4. Quantification - utiliser des modèles INT8/FP16
    5. CPU offload - décharger les parties non utilisées
    6. Prefetching - préparer l'étape suivante pendant l'exécution
    """

    def __init__(self, config: Optional[Dict] = None):
        """
        Initialise le pipeline optimisé.

        Args:
            config: Configuration optionnelle (modèles, paramètres)
        """
        self.model_cache = {}  # Cache pour les modèles chargés
        self.timings = {}  # Métriques de performance
        self.config = config or {
            "image_model": "sdxl",
            "video_model": "ltx",
            "use_cache": True,
            "parallel_images": False
        }

    def load_model(self, model_name: str):
        """
        Charge un modèle avec mise en cache.

        TODO: Implémenter le chargement avec cache
        - Vérifier si le modèle est déjà dans le cache
        - Sinon, charger et mettre en cache
        - Gérer la VRAM disponible
        """
        pass

    def generate_batch(self, prompts: List[str], save_intermediates: bool = False) -> List[Dict]:
        """
        Génère un batch de vidéos de manière optimisée.

        TODO: Implémenter la génération batch avec:
        1. Chargement unique des modèles (cache)
        2. Parallélisation des étapes indépendantes
        3. Compression des intermédiaires si nécessaire
        4. Mesure des performances (temps, VRAM)

        Args:
            prompts: Liste de prompts textuels
            save_intermediates: Sauvegarder les étapes intermédiaires

        Returns:
            Liste de résultats avec vidéos et métriques
        """
        results = []

        # TODO: Votre implémentation optimisée
        # Exemple de structure:
        # for prompt in prompts:
        #     result = self._generate_single(prompt, save_intermediates)
        #     results.append(result)

        return results

    def _generate_single(self, prompt: str, save_intermediates: bool = False) -> Dict:
        """
        Génère une seule vidéo (helper pour generate_batch).

        TODO: Implémenter avec mesures de performance
        """
        return {
            "prompt": prompt,
            "frames": None,
            "time": 0,
            "vram_peak": 0,
            "success": False
        }

    def get_performance_metrics(self) -> Dict:
        """
        Retourne les métriques de performance accumulées.

        TODO: Compiler les statistiques
        - Temps moyen par vidéo
        - VRAM peak
        - Taux de succès
        """
        return self.timings

    def clear_cache(self):
        """
        Vide le cache des modèles.

        TODO: Implémenter le nettoyage
        - Supprimer les modèles du cache
        - Libérer la VRAM
        """
        self.model_cache.clear()
        release_vram()


# Instance globale à utiliser
optimized_batch_pipeline = OptimizedBatchPipeline()
print("Classe OptimizedBatchPipeline définie - TODO: implémenter les méthodes")
Classe OptimizedBatchPipeline définie - TODO: implémenter les méthodesCritères de succès - Pipeline Personnalisé
# TODO: Tester votre pipeline personnalisé sur 2 prompts

# Définir 2 prompts de test différents (même cas d'usage)
my_test_prompts = [
    "...",  # Prompt 1 - adaptez à votre cas d'usage
    "..."   # Prompt 2 - variation sur le même thème
]

# TODO: Exécuter le pipeline sur chaque prompt
# for i, prompt in enumerate(my_test_prompts):
#     print(f"\n=== Test {i+1}: {prompt[:50]}... ===")
#     result = my_custom_pipeline(prompt, seed=42 + i)
#
#     # Afficher les résultats
#     print(f"Temps total: {result['total_time']:.1f}s")
#     print(f"VRAM peak: {result['vram_peak']:.1f} GB")
#     print(f"Étapes: {[s['name'] for s in result['steps']]}")
#
#     # Visualiser les frames finales
#     if result.get('frames'):
#         # TODO: Afficher une grille de frames
#         pass

# TODO: Comparer visuellement les deux résultats
# - Différences de qualité?
# - Cohérence du style?
# - Respect du prompt?

# TODO: Analyser les goulots d'étranglement
# - Quelle étape est la plus lente?
# - Où se trouve la consommation VRAM maximale?
# - Quelles optimisations seraient possibles?
Exercice : Gestion d’Erreurs et Recovery
Duree estimee : 30-40 minutes
Objectif
Implementer un système de checkpointing et de gestion d’erreurs permettant de reprendre un pipeline video après une interruption, sans re-executer les étapes déjà terminees.
Contexte
En production, les pipelines video sont longs (parfois plusieurs minutes par video) et sujets aux erreurs : OOM GPU, timeouts API, crash de modèles. Un mécanisme de checkpoint permet de : - Sauvegarder l’etat après chaque étape reussie - Reprendre depuis le dernier checkpoint en cas d’echec - Eviter de re-generer des intermediaires couteux
Instructions
- Implementer les fonctions de checkpointing
save_checkpoint(step_name, data, output_dir): sauvegarde l’etat d’une étapeload_checkpoint(step_name, output_dir): charge un checkpoint existantshould_skip_step(step_name, output_dir): verifie si l’étape a déjà ete terminee
- Implementer un pipeline robuste avec fallbacks
- Si DALL-E echoue : fallback SDXL, puis image synthetique
- Si SVD echoue : fallback LTX-Video, puis frames statiques
- Logger chaque tentative (succes/echec/fallback)
- Tester le pipeline avec simulation de pannes
- Forcer l’echec de certaines étapes
- Verifier que les checkpoints permettent la reprise
- Mesurer le temps economise grace au checkpointing
Indices :
- Utiliser
jsonpour les metadonnees etPIL.Image.save()pour les images - Le checkpoint contient : nom de l’étape, timestamp, chemin vers les données
should_skip_stepdoit verifier l’existence du fichier ET sa validite (taille > 0)
# TODO: Implementer le systeme de checkpointing et pipeline robuste

def save_checkpoint(step_name: str, data: Dict, output_dir: Path) -> Path:
    """
    Sauvegarde l'etat d'une etape reussie.

    Args:
        step_name: Nom de l'etape (ex: "image_generation", "video_animation")
        data: Dictionnaire avec les donnees a sauvegarder
            - 'image': PIL.Image (sauvegardee en PNG)
            - 'frames': List[PIL.Image] (sauvegardees en PNG)
            - 'metadata': Dict (sauvegarde en JSON)
        output_dir: Repertoire de sortie

    Returns:
        Chemin vers le fichier de checkpoint
    """
    # TODO: Creer le repertoire de checkpoints
    # checkpoint_dir = output_dir / "checkpoints"
    # checkpoint_dir.mkdir(exist_ok=True)

    # TODO: Sauvegarder les donnees selon le type
    # - Image : sauvegarder en PNG
    # - Frames : sauvegarder la premiere frame + nombre total
    # - Metadata : sauvegarder en JSON (nom, timestamp, taille)

    # TODO: Retourner le chemin du checkpoint
    return None  # TODO etudiant : remplacer par le chemin du checkpoint


def load_checkpoint(step_name: str, output_dir: Path) -> Optional[Dict]:
    """
    Charge un checkpoint existant.

    Args:
        step_name: Nom de l'etape a charger
        output_dir: Repertoire de sortie

    Returns:
        Dict avec les donnees du checkpoint, ou None si inexistant
    """
    # TODO: Verifier si le checkpoint existe
    # TODO: Charger l'image ou les frames depuis le disque
    # TODO: Charger les metadata depuis le JSON
    return None  # TODO etudiant : implémenter le chargement


def should_skip_step(step_name: str, output_dir: Path) -> bool:
    """
    Verifie si une etape a deja ete terminee avec succes.

    Args:
        step_name: Nom de l'etape
        output_dir: Repertoire de sortie

    Returns:
        True si l'etape peut etre sautee (deja terminee)
    """
    # TODO: Verifier l'existence du checkpoint
    # TODO: Verifier la validite (taille > 0, metadata complete)
    return False  # TODO etudiant : implémenter la vérification


def robust_pipeline(prompt: str, output_dir: Path, force_redo: bool = False) -> Dict:
    """
    Pipeline video robuste avec checkpointing et fallbacks.

    Args:
        prompt: Description textuelle de la video
        output_dir: Repertoire de sortie pour les checkpoints
        force_redo: Si True, ignore les checkpoints existants

    Returns:
        Dict avec 'frames', 'steps', 'total_time', 'success'
    """
    result = {"prompt": prompt, "steps": [], "frames": None, "success": False}

    # TODO: Etape 1 - Generation d'image avec fallbacks
    # if not force_redo and should_skip_step("image_generation", output_dir):
    #     data = load_checkpoint("image_generation", output_dir)
    #     print(f"  [CHECKPOINT] Image generation sautee")
    # else:
    #     try: DALL-E 3
    #     except: try: SDXL
    #     except: image synthetique
    #     save_checkpoint("image_generation", {...}, output_dir)

    # TODO: Etape 2 - Animation video avec fallbacks
    # if not force_redo and should_skip_step("video_animation", output_dir):
    #     data = load_checkpoint("video_animation", output_dir)
    # else:
    #     try: SVD
    #     except: try: LTX-Video
    #     except: frames statiques (image repetee N fois)
    #     save_checkpoint("video_animation", {...}, output_dir)

    return result


# Test avec simulation de panne
# TODO: Tester le pipeline robuste
# result = robust_pipeline(
#     "a serene mountain lake at dawn, mist rising",
#     output_dir=OUTPUT_DIR / "robust_test"
# )
# print(f"Succes: {result['success']}")
# print(f"Etapes: {[s['name'] for s in result['steps']]}")

print("Exercice a completer : gestion d'erreurs et recovery pipeline")
Exercice a completer : gestion d'erreurs et recovery pipelineAprès avoir valide les tests sur des cas concrets, on peut implementer la classe du pipeline personnalise avec ses étapes configurables et ses metriques de suivi.
# TODO: Définir votre pipeline personnalisé avec 3+ étapes
def my_custom_pipeline(prompt: str, seed: int = 42) -> Dict:
    """
    Pipeline personnalisé avec 3 étapes minimum.

    Cas d'usage suggérés:
    - Contenu social media (Instagram, TikTok)
    - Démo produit e-commerce
    - Vidéo éducative / tutoriel
    - Contenu marketing / publicitaire

    Exemples de pipelines possibles:
    - Text -> DALL-E -> SVD -> Color grading
    - Text -> SDXL -> RealESRGAN -> RIFE interpolation
    - Text -> LTX -> Upscale -> Transition effects
    - Text -> Image -> Animation -> Overlay text

    Args:
        prompt: Description textuelle de la vidéo souhaitée
        seed: Graine aléatoire pour reproductibilité

    Returns:
        Dict avec:
        - 'prompt': prompt original
        - 'steps': liste des étapes exécutées avec timings
        - 'frames': frames finales (List[PIL.Image])
        - 'total_time': temps total en secondes
        - 'vram_peak': VRAM maximale utilisée en GB
        - 'success': True si toutes les étapes ont réussi
    """
    result = {
        "prompt": prompt,
        "steps": [],
        "frames": None,
        "total_time": 0,
        "vram_peak": 0,
        "success": False
    }

    # TODO: Définir votre cas d'usage
    use_case = "..."  # Ex: "social_media", "product_demo", "educational"

    # TODO: Étape 1 - Génération d'image
    # Options: DALL-E (API), SDXL (local), Qwen Image Edit
    # step_1_start = time.time()
    # image = ...  # Votre code ici
    # result["steps"].append({
    #     "name": "image_generation",
    #     "model": "...",
    #     "time": time.time() - step_1_start,
    #     "output_size": image.size
    # })
    # release_vram()  # Libérer avant étape suivante

    # TODO: Étape 2 - Animation vidéo
    # Options: SVD, LTX-Video, Wan
    # step_2_start = time.time()
    # frames = ...  # Votre code ici
    # result["steps"].append({
    #     "name": "video_animation",
    #     "model": "...",
    #     "time": time.time() - step_2_start,
    #     "num_frames": len(frames)
    # })
    # release_vram()

    # TODO: Étape 3 - Post-traitement
    # Options: upscale (RealESRGAN), interpolation (RIFE), color grading
    # step_3_start = time.time()
    # final_frames = ...  # Votre code ici
    # result["steps"].append({
    #     "name": "post_processing",
    #     "method": "...",
    #     "time": time.time() - step_3_start
    # })

    # TODO: Calculer les métriques finales
    # result["frames"] = final_frames
    # result["success"] = True
    # result["total_time"] = sum(s["time"] for s in result["steps"])
    # if torch.cuda.is_available():
    #     result["vram_peak"] = torch.cuda.max_memory_allocated() / 1024**3

    return result


# Documentation de votre pipeline
pipeline_description = """
TODO: Documentez votre pipeline ici

Cas d'usage: ...
Étape 1: ... (justification)
Étape 2: ... (justification)
Étape 3: ... (justification)
Forces: ...
Limites: ...
"""

print("Pipeline personnalisé défini - TODO: implémenter les étapes")
print(pipeline_description)
Pipeline personnalisé défini - TODO: implémenter les étapes
TODO: Documentez votre pipeline ici
Cas d'usage: ...
Étape 1: ... (justification)
Étape 2: ... (justification)
Étape 3: ... (justification)
Forces: ...
Limites: ...
Une fois le pipeline personnalise défini, on collecte les statistiques de session pour evaluer les temps d’exécution et preparer les prochaines étapes du projet.
# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Pipeline mode : {pipeline_mode}")
print(f"Image model : {image_model}")
print(f"Video model : {video_model}")
print(f"Upscale : {upscale}")

# Recapitulatif des pipelines executes
print(f"\nResultats des pipelines :")
if pipeline1_result.get('success'):
    print(f"  Pipeline 1 (Text->Image->Video) : OK en {pipeline1_result.get('total_time', 0):.1f}s")
else:
    print(f"  Pipeline 1 (Text->Image->Video) : non execute")

if pipeline2_result.get('success'):
    print(f"  Pipeline 2 (Text->Video->Upscale) : OK en {pipeline2_result.get('total_time', 0):.1f}s")
else:
    print(f"  Pipeline 2 (Text->Video->Upscale) : non execute")

if batch_results:
    n_ok = sum(1 for r in batch_results if r.get('success'))
    print(f"  Batch : {n_ok}/{len(batch_results)} videos generees")

if device == "cuda" and torch.cuda.is_available():
    vram_current = torch.cuda.memory_allocated(0) / 1024**3
    print(f"\nVRAM actuelle : {vram_current:.1f} GB")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 03-3 : Workflows ComfyUI pour la generation video")
print(f"2. Module 04 : Applications production (education, creatif, bout-en-bout)")
print(f"3. Combiner les pipelines pour des workflows de production automatises")

print(f"\nNotebook 03-2 Orchestration de Pipelines Video termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-08-29 12:00:27
Mode : interactive
Pipeline mode : text_image_video
Image model : gpt-image-1
Video model : svd
Upscale : True

Resultats des pipelines :
  Pipeline 1 (Text->Image->Video) : OK en 259.4s
  Pipeline 2 (Text->Video->Upscale) : OK en 30.3s
  Batch : 3/3 videos generees

VRAM actuelle : 0.0 GB

Fichiers generes (6) :
  batch_bougie.mp4 (59.6 KB)
  batch_nuages.mp4 (36.2 KB)
  batch_ocean.mp4 (56.2 KB)
  pipeline1_result.mp4 (266.1 KB)
  pipeline1_source.png (817.0 KB)
  pipeline2_result.mp4 (514.1 KB)

--- PROCHAINES ETAPES ---
1. Notebook 03-3 : Workflows ComfyUI pour la generation video
2. Module 04 : Applications production (education, creatif, bout-en-bout)
3. Combiner les pipelines pour des workflows de production automatises

Notebook 03-2 Orchestration de Pipelines Video termine - 12:00:27