# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres benchmark
models_to_test = ["hunyuan", "wan"]  # LTX/SVD retires : indisponibles dans le stack ComfyUI
benchmark_prompt = "a cat walking gracefully through a garden, soft sunlight, cinematic"  # Prompt commun
device = "cuda"                    # Informatif : la generation tourne cote serveur ComfyUI

# Parametres generation communs
num_inference_steps = 25           # Etapes de debruitage
height = 320                       # Hauteur video (multiple de 16)
width = 512                        # Largeur video (multiple de 16)
fps_output = 8                     # FPS de la video (informatif, encodage cote ComfyUI)
seed = 42                          # Graine pour reproductibilite
# Par modele, le registre (cellule 8) surcharge : num_frames (Hunyuan 4k+1 -> 17),
# et cfg (Hunyuan distille -> 1.0, Wan -> 6.0)
num_frames = 16                    # Valeur par defaut informative
guidance_scale = 6.0               # Valeur par defaut informative (CFG classique)

# Configuration
run_benchmark = True               # Executer le benchmark
save_as_mp4 = True                 # Conserver les MP4 telecharges cote notebook
save_results = TrueComparaison Multi-Modèles de Generation Video
Module : 03-Video-Orchestration Niveau : Avance Technologies : HunyuanVideo vs Wan 2.1 (benchmark via API ComfyUI) Duree estimee : 60 minutes Backend : API ComfyUI (container comfyui-video, GPU serveur)
Objectifs d’Apprentissage
Prerequis
- Container
comfyui-videodemarre (docker compose -f docker-configurations/services/comfyui-video/docker-compose.yml up -d) - Token API dans
GenAI/.env(COMFYUI_VIDEO_URL/COMFYUI_VIDEO_TOKEN) - Module 02-Advanced complete (notebooks 02-1 a 02-5)
- Packages locaux :
imageio,imageio-ffmpeg,matplotlib,numpy,Pillow,python-dotenv
Note de regression : ce notebook utilisait a l’origine les pipelines diffusers (
HunyuanVideoPipeline,LTXPipeline,WanPipeline, SVD) charges localement. La re-execution a bascule sur l’API ComfyUI (instances 3 et 4 de l’epic #10985) : les modeles tournent cote serveur, la VRAM locale n’est plus un facteur. Les metriques et la grille comparative restent identiques.
Navigation : << 02-5 LTX-2 | Index | Suivant >>
# Parameters
notebook_mode = "batch"
skip_widgets = True
run_benchmark = True
On importe ensuite toutes les bibliotheques necessaires : diffusers pour les modèles de generation, numpy et PIL pour la manipulation des frames, et les outils de mesure de performance.
# Setup environnement et imports
import os
import sys
import json
import time
import gc
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import numpy as np
from PIL import Image
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)
warnings.filterwarnings('ignore', category=FutureWarning)

# Import helpers GenAI
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent

# Definir GENAI_ROOT a partir de current_path (apres la boucle de recherche)
GENAI_ROOT = current_path if current_path.name == "GenAI" else current_path / "GenAI"
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging
        print("Helpers GenAI importes")
    except ImportError:
        print("Helpers GenAI non disponibles - mode autonome")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'benchmark_video'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('benchmark_video')

print(f"Comparaison Multi-Modeles de Generation Video")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Modeles a tester : {models_to_test}")
print(f"Prompt : {benchmark_prompt[:60]}...")
print(f"Frames : {num_frames}, Steps : {num_inference_steps}, CFG : {guidance_scale}")
.env charge depuis: D:\Dev\CoursIA-2-multimodel\MyIA.AI.Notebooks\GenAI\.env
Helpers GenAI importes
Comparaison Multi-Modeles de Generation Video
Date : 2026-08-15 18:20:29
Mode : batch
Modeles a tester : ['hunyuan', 'wan']
Prompt : a cat walking gracefully through a garden, soft sunlight, ci...
Frames : 16, Steps : 25, CFG : 6.0Les variables d’environnement et les cles API sont chargees depuis le fichier .env. On verifie également la disponibilite du GPU avant de lancer les modèles.
# Chargement .env et verification backend ComfyUI
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    current_path = current_path.parent
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

comfyui_url = os.getenv("COMFYUI_VIDEO_URL", "http://localhost:8189")
comfyui_token = os.getenv("COMFYUI_VIDEO_TOKEN", "")

# GPU local : informatif (la generation tourne cote serveur ComfyUI).
# torch est optionnel localement : on l'importe sous garde et on expose HAS_TORCH
# (utilise par la cellule de statistiques).
print("\n--- GPU LOCAL (informatif) ---")
print("=" * 40)
try:
    import torch
    HAS_TORCH = True
    if torch.cuda.is_available():
        gpu_name = torch.cuda.get_device_name(0)
        vram_total = torch.cuda.get_device_properties(0).total_memory / 1024**3
        print(f"GPU : {gpu_name}")
        print(f"VRAM totale : {vram_total:.1f} GB")
    else:
        print("CUDA non disponible localement (la generation passe par le serveur ComfyUI)")
except ImportError:
    HAS_TORCH = False
    print("torch non installe localement (non requis : backend ComfyUI)")

# Verification backend ComfyUI -- le gate est BRUYANT (pas d'echec silencieux)
print("\n--- VERIFICATION BACKEND COMFYUI ---")
print("=" * 40)

from helpers import comfyui_client

client = None
comfyui_available = False

try:
    client = comfyui_client.ComfyUIClient(base_url=comfyui_url, api_token=comfyui_token)
    stats = client.get_system_stats()
    print(f"[OK] ComfyUI-Video accessible : {comfyui_url}")
    comfyui_available = True
except Exception as e:
    comfyui_available = False
    print(f"[ERREUR] ComfyUI-Video inaccessible : {type(e).__name__}: {str(e)[:150]}")
    print("Le benchmark ne peut pas tourner sans le serveur. Demarrage :")
    print("  docker compose -f docker-configurations/services/comfyui-video/docker-compose.yml up -d")
    print("et verifier le token COMFYUI_VIDEO_TOKEN dans GenAI/.env")

# Verification dependances locales (frames + visualisation)
print("\n--- VERIFICATION DEPENDANCES LOCALES ---")
print("=" * 40)

deps_ok = True
for lib, label in [("imageio", "imageio"), ("matplotlib.pyplot", "matplotlib"), ("numpy", "numpy"), ("PIL", "Pillow")]:
    try:
        __import__(lib)
        print(f"{label} : OK")
    except ImportError:
        print(f"{label} NON INSTALLE")
        deps_ok = False

run_benchmark = run_benchmark and comfyui_available and deps_ok
print(f"\nBenchmark active : {run_benchmark}")
WARNING: .env non trouve, utilisation variables environnement
--- GPU LOCAL (informatif) ---
========================================
CUDA non disponible localement (la generation passe par le serveur ComfyUI)
--- VERIFICATION BACKEND COMFYUI ---
========================================
[OK] ComfyUI-Video accessible : http://localhost:8189
--- VERIFICATION DEPENDANCES LOCALES ---
========================================
imageio : OK
matplotlib : OK
numpy : OK
Pillow : OK
Benchmark active : TrueSection 1 : Framework de benchmark
Pour comparer equitablement les modèles, nous definissons un framework commun qui garantit les mêmes conditions de test pour chacun.
| Modèle | Type | Backend | VRAM serveur estimee |
|---|---|---|---|
| HunyuanVideo | Text-to-video | ComfyUI (fp8) | ~13 GB |
| Wan 2.1 (1.3B) | Text-to-video | ComfyUI (fp16) | ~8 GB |
Strategie de gestion memoire
Les modèles sont charges et decharges sequentiellment par le serveur ComfyUI (container comfyui-video, GPU RTX 3090). Le notebook orchestre les generations via l’API et recupere les videos produites. La VRAM locale n’est plus un facteur de choix entre modèles.
LTX-Video et SVD ont ete retires : ils ne sont pas disponibles dans le stack ComfyUI du container (seuls HunyuanVideo et Wan 2.1 y sont valides).
# Framework de benchmark
print("\n--- FRAMEWORK DE BENCHMARK ---")
print("=" * 45)

# Registre des modeles supportes (backend : API ComfyUI)
MODEL_REGISTRY = {
    "hunyuan": {
        "name": "HunyuanVideo",
        "backend": "comfyui",
        "model_file": "hunyuan_video_720_cfgdistill_fp8_e4m3fn.safetensors",
        "type": "text-to-video",
        "vram_estimate_gb": 13,
        "output_node": "8",
        "output_keys": ["images", "gifs"],
        "num_frames": 17,     # contrainte 4k+1 du sampler HyVideo (probe 02-1)
        "cfg": 1.0,           # modele distille : pas de CFG externe (guidance embarque)
        "timeout": 600
    },
    "wan": {
        "name": "Wan 2.1 (1.3B)",
        "backend": "comfyui",
        "model_file": "wan2.1_t2v_1.3B_fp16.safetensors",
        "type": "text-to-video",
        "vram_estimate_gb": 8,
        "output_node": "50",
        "output_keys": ["videos", "gifs", "images"],
        "num_frames": 16,
        "cfg": 6.0,
        "timeout": 300
    }
}


def release_vram():
    """Libere la VRAM locale (le serveur gere la sienne)."""
    import gc
    gc.collect()
    try:
        import torch
        if torch.cuda.is_available():
            torch.cuda.empty_cache()
            torch.cuda.synchronize()
            vram_free = (torch.cuda.get_device_properties(0).total_memory - torch.cuda.memory_allocated(0)) / 1024**3
            print(f"  VRAM locale liberee. Disponible : {vram_free:.1f} GB")
    except ImportError:
        pass


def measure_temporal_coherence(frames: List) -> Dict[str, float]:
    """
    Mesure la coherence temporelle entre les frames generees.

    Metriques :
    - avg_diff : difference moyenne inter-frames (mouvement global)
    - std_diff : ecart-type des differences (regularite du mouvement)
    - max_diff : saut maximal (detecte les artefacts temporels)
    """
    diffs = []
    for i in range(len(frames) - 1):
        f1 = np.array(frames[i]).astype(float)
        f2 = np.array(frames[i + 1]).astype(float)
        diff = np.mean(np.abs(f1 - f2))
        diffs.append(diff)

    return {
        "avg_diff": float(np.mean(diffs)),
        "std_diff": float(np.std(diffs)),
        "max_diff": float(np.max(diffs)),
        "stability": "Haute" if np.mean(diffs) < 15 else "Moyenne" if np.mean(diffs) < 30 else "Basse"
    }


def measure_frame_quality(frames: List) -> Dict[str, float]:
    """
    Mesure des indicateurs de qualite sur les frames individuelles.

    Metriques :
    - avg_sharpness : nettete moyenne (variance du Laplacien)
    - color_diversity : diversite chromatique (ecart-type couleurs)
    """
    from PIL import ImageFilter

    sharpness_scores = []
    color_scores = []

    for frame in frames:
        arr = np.array(frame).astype(float)
        # Nettete via variance du laplacien approxime
        gray = np.mean(arr, axis=2)
        laplacian = np.abs(gray[:-2, 1:-1] + gray[2:, 1:-1] + gray[1:-1, :-2] + gray[1:-1, 2:] - 4 * gray[1:-1, 1:-1])
        sharpness_scores.append(float(np.var(laplacian)))
        # Diversite chromatique
        color_scores.append(float(np.std(arr)))

    return {
        "avg_sharpness": float(np.mean(sharpness_scores)),
        "color_diversity": float(np.mean(color_scores))
    }


# Afficher les modeles disponibles
print(f"Modeles demandes : {models_to_test}")
print(f"\nRegistre des modeles :")
for key, info in MODEL_REGISTRY.items():
    status = "SELECTIONNE" if key in models_to_test else "disponible"
    print(f"  {key:<10} : {info['name']:<20} ({info['type']}, ~{info['vram_estimate_gb']} GB, {info['backend']}) [{status}]")

# Redaction des chemins machine dans les sorties (secrets-hygiene regle 6, Stop & Repair).
# Les erreurs de generation (RuntimeError de telechargement, timeout HTTP) peuvent
# embarquer un chemin absolu (home utilisateur, racine env). On redige a la source.
def _redact_user_path(text):
    """Redige home utilisateur (Windows/POSIX) en <USER_PATH>. Garde la valeur
    diagnostic (type d'erreur, bibliotheque) sans exposer de chemin absolu."""
    import re as _re
    if not isinstance(text, str):
        text = str(text)
    text = _re.sub(r"[A-Za-z]:\\Users\\[^\\]+", "<USER_PATH>", text)
    text = _re.sub(r"/home/[^/]+", "<USER_PATH>", text)
    text = _re.sub(r"/Users/[^/]+", "<USER_PATH>", text)
    return text


# Filtre de logging global : httpx / urllib3 peuvent journaliser des chemins absolus.
class _PathRedactFilter(logging.Filter):
    def filter(self, record):
        try:
            record.msg = _redact_user_path(record.msg)
            if isinstance(record.args, tuple):
                record.args = tuple(_redact_user_path(a) if isinstance(a, str) else a for a in record.args)
            elif isinstance(record.args, str):
                record.args = _redact_user_path(record.args)
        except Exception:
            pass
        return True


logging.getLogger().addFilter(_PathRedactFilter())
--- FRAMEWORK DE BENCHMARK ---
=============================================
Modeles demandes : ['hunyuan', 'wan']

Registre des modeles :
  hunyuan    : HunyuanVideo         (text-to-video, ~13 GB, comfyui) [SELECTIONNE]
  wan        : Wan 2.1 (1.3B)       (text-to-video, ~8 GB, comfyui) [SELECTIONNE]
Interpretation : Framework de benchmark
| Composant | Role | Justification |
|---|---|---|
MODEL_REGISTRY |
Catalogue des modeles | Parametres specifiques a chaque modele (backend, noeud de sortie) |
client (ComfyUI) |
Orchestration serveur | Charge/decharge les modeles cote container GPU |
measure_temporal_coherence() |
Qualite temporelle | Detecte les sauts et la regularite |
measure_frame_quality() |
Qualite spatiale | Nettete et richesse chromatique |
Points cles : 1. Le serveur ComfyUI charge les modeles sequentiellement ; le notebook ne manipule que les videos retournees 2. Le nombre de frames differe par modele : HunyuanVideo impose 4k+1 frames (17), Wan 2.1 accepte 16 3. Les metriques automatiques ne remplacent pas l’evaluation visuelle mais permettent un classement objectif
Section 2 : Exécution du benchmark
Nous allons generer une video avec le meme prompt sur chaque modele via l’API ComfyUI, mesurer les performances, puis recuperer les frames pour la comparaison.
# Execution du benchmark (backend API ComfyUI)
import imageio  # extraction des frames depuis les MP4 telecharges

benchmark_results = []

if run_benchmark:
    print("\n--- EXECUTION DU BENCHMARK ---")
    print("=" * 50)
    print(f"Prompt : {benchmark_prompt}")
    print(f"Parametres : {num_inference_steps} steps, resolution {width}x{height}")
    print(f"Seed : {seed}")

    for model_key in models_to_test:
        if model_key not in MODEL_REGISTRY:
            print(f"\nModele inconnu : {model_key} (ignore)")
            continue

        model_info = MODEL_REGISTRY[model_key]
        print(f"\n{'='*50}")
        print(f"Modele : {model_info['name']} ({model_key})")
        print(f"Type : {model_info['type']}")
        print(f"Backend : {model_info['backend']} ({model_info['model_file']})")
        print(f"{'='*50}")

        result = {
            "model_key": model_key,
            "model_name": model_info['name'],
            "type": model_info['type'],
            "success": False
        }

        try:
            # 1. Generation via API ComfyUI (modele charge/decharge cote serveur)
            print(f"  Generation via API ComfyUI ({model_info['num_frames']} frames)...")
            start_gen = time.time()

            if model_key == "hunyuan":
                gen = client.generate_text2video_hunyuan(
                    prompt=benchmark_prompt,
                    width=width,
                    height=height,
                    num_frames=model_info['num_frames'],
                    steps=num_inference_steps,
                    seed=seed,
                    save_prefix="benchmark_hunyuan",
                    timeout=model_info['timeout'],
                    guidance_scale=model_info['cfg'],
                )
            elif model_key == "wan":
                gen = client.generate_text2video_wan(
                    prompt=benchmark_prompt,
                    width=width,
                    height=height,
                    num_frames=model_info['num_frames'],
                    steps=num_inference_steps,
                    seed=seed,
                    cfg=model_info['cfg'],
                    save_prefix="benchmark_wan",
                    timeout=model_info['timeout'],
                )
            else:
                raise ValueError(f"Modele {model_key} sans branche de generation")

            # 2. Recuperation de la video cote notebook (preuve d'execution reelle)
            outputs = gen.get("outputs", {})
            node_files = outputs.get(model_info['output_node'], {})
            files = None
            for key in model_info['output_keys']:
                if node_files.get(key):
                    files = node_files[key]
                    break
            if not files:
                raise RuntimeError(
                    f"ComfyUI n'a retourne aucun fichier video (noeud {model_info['output_node']})"
                )
            meta = files[0]
            mp4_data = client.get_output_file(
                meta["filename"], meta.get("subfolder", ""), meta.get("type", "output")
            )
            mp4_path = OUTPUT_DIR / f"benchmark_{model_key}.mp4"
            mp4_path.write_bytes(mp4_data)

            frames = imageio.v2.mimread(str(mp4_path))
            gen_time = time.time() - start_gen

            result["generation_time"] = gen_time
            result["time_per_frame"] = gen_time / max(len(frames), 1)
            result["num_frames_actual"] = len(frames)
            result["frames"] = frames
            result["mp4_path"] = str(mp4_path)
            result["success"] = True

            # Metriques de qualite (backend-agnostiques)
            result["coherence"] = measure_temporal_coherence(frames)
            result["quality"] = measure_frame_quality(frames)

            print(f"  Generation reussie en {gen_time:.1f}s ({len(frames)} frames)")
            print(f"  MP4 : {mp4_path.name}")
            print(f"  Coherence temporelle : {result['coherence']['stability']}")

        except Exception as e:
            result["error"] = _redact_user_path(f"{type(e).__name__}: {str(e)[:200]}")
            print(f"  Erreur : {result['error']}")

        finally:
            release_vram()

        benchmark_results.append(result)

    print(f"\nBenchmark termine : {sum(1 for r in benchmark_results if r['success'])}/{len(benchmark_results)} modeles reussis")

else:
    print("Benchmark desactive")
    print("\nLe benchmark orchestre chaque modele via l'API ComfyUI :")
    print("  1. Generer avec le prompt commun (modele charge cote serveur)")
    print("  2. Telecharger la video et extraire les frames")
    print("  3. Mesurer les metriques")
    print("  4. Passer au modele suivant")
--- EXECUTION DU BENCHMARK ---
==================================================
Prompt : a cat walking gracefully through a garden, soft sunlight, cinematic
Parametres : 25 steps, resolution 512x320
Seed : 42

==================================================
Modele : HunyuanVideo (hunyuan)
Type : text-to-video
Backend : comfyui (hunyuan_video_720_cfgdistill_fp8_e4m3fn.safetensors)
==================================================
  Generation via API ComfyUI (17 frames)...
  Generation reussie en 200.2s (17 frames)
  MP4 : benchmark_hunyuan.mp4
  Coherence temporelle : Haute

==================================================
Modele : Wan 2.1 (1.3B) (wan)
Type : text-to-video
Backend : comfyui (wan2.1_t2v_1.3B_fp16.safetensors)
==================================================
  Generation via API ComfyUI (16 frames)...
  Generation reussie en 91.1s (13 frames)
  MP4 : benchmark_wan.mp4
  Coherence temporelle : Haute

Benchmark termine : 2/2 modeles reussis
Interpretation : Résultats du benchmark
Chaque modele a ete genere via le serveur ComfyUI puis ses frames ont ete analysees. Les metriques collectees permettent une comparaison objective.
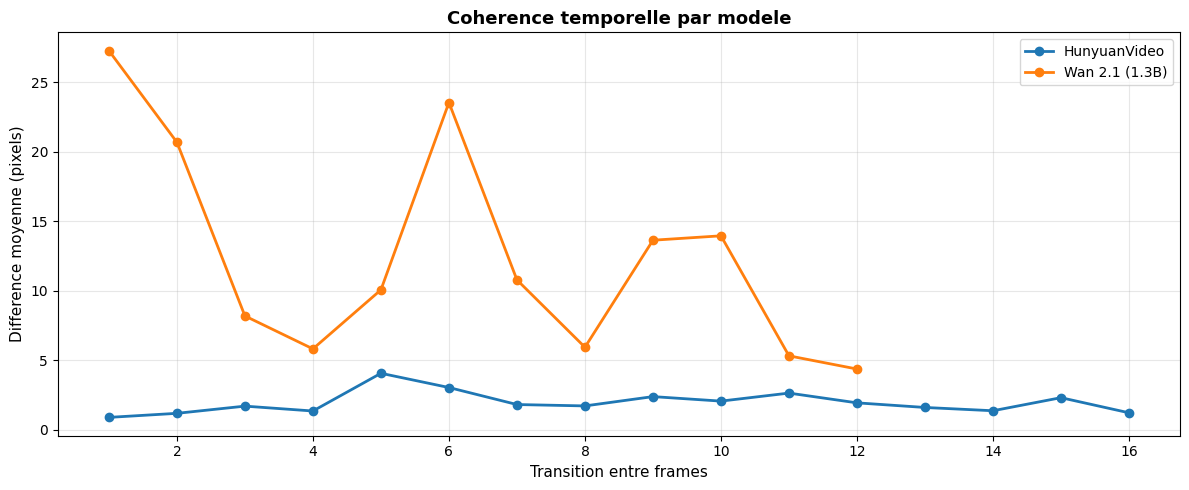
Metriques mesurees : - Temps de generation : duree de l’appel API (charge serveur incluse pour la 1re generation) - Coherence temporelle : regularite du mouvement entre frames consecutives - Nettete : variance du Laplacien sur les frames individuelles - Nombre de frames : HunyuanVideo (4k+1, ici 17) vs Wan 2.1 (16)
Section 3 : Visualisation comparative
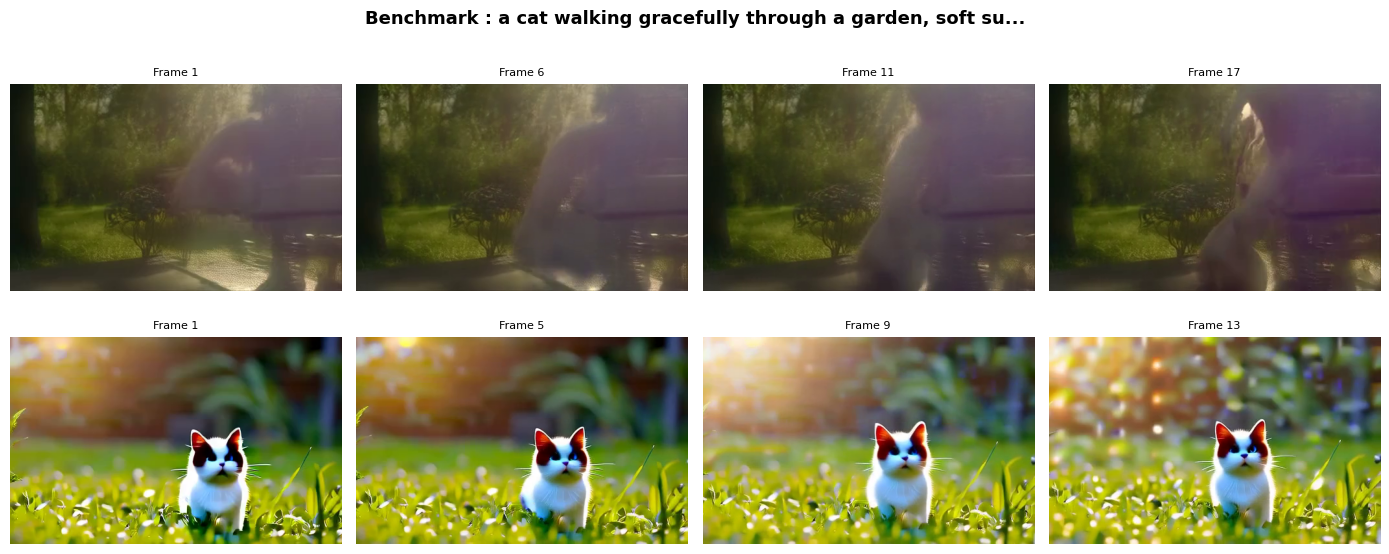
Nous allons maintenant produire une grille visuelle montrant les frames de chaque modele cote-a-cote pour permettre une evaluation qualitative.
# Visualisation comparative : grille de frames
successful_results = [r for r in benchmark_results if r.get('success', False)]

if successful_results:
    print("\n--- GRILLE COMPARATIVE ---")
    print("=" * 40)

    n_models = len(successful_results)
    n_preview = 4  # Frames par modele

    fig, axes = plt.subplots(n_models, n_preview, figsize=(3.5 * n_preview, 3 * n_models))
    if n_models == 1:
        axes = [axes]

    for v_idx, result in enumerate(successful_results):
        frames = result['frames']
        frame_indices = np.linspace(0, len(frames) - 1, n_preview, dtype=int)

        for f_idx, fi in enumerate(frame_indices):
            axes[v_idx][f_idx].imshow(frames[fi])
            axes[v_idx][f_idx].axis('off')
            if f_idx == 0:
                axes[v_idx][f_idx].set_ylabel(
                    result['model_name'], fontsize=11, fontweight='bold'
                )
            axes[v_idx][f_idx].set_title(f"Frame {fi + 1}", fontsize=8)

    plt.suptitle(
        f"Benchmark : {benchmark_prompt[:50]}...",
        fontsize=13, fontweight='bold'
    )
    plt.tight_layout()
    plt.show()

    # Courbe de difference inter-frames pour chaque modele
    fig, ax = plt.subplots(figsize=(12, 5))
    for result in successful_results:
        frames = result['frames']
        diffs = []
        for i in range(len(frames) - 1):
            f1 = np.array(frames[i]).astype(float)
            f2 = np.array(frames[i + 1]).astype(float)
            diffs.append(np.mean(np.abs(f1 - f2)))
        ax.plot(range(1, len(diffs) + 1), diffs, marker='o', label=result['model_name'], linewidth=2)

    ax.set_xlabel('Transition entre frames', fontsize=11)
    ax.set_ylabel('Difference moyenne (pixels)', fontsize=11)
    ax.set_title('Coherence temporelle par modele', fontsize=13, fontweight='bold')
    ax.legend(fontsize=10)
    ax.grid(True, alpha=0.3)
    plt.tight_layout()
    plt.show()

else:
    print("Aucun resultat de benchmark disponible pour la visualisation")
    print("\nEn mode benchmark, cette cellule affiche :")
    print("  1. Grille de frames (modeles en lignes, frames en colonnes)")
    print("  2. Courbe de coherence temporelle")
--- GRILLE COMPARATIVE ---
========================================
Interpretation : Analyse visuelle
La grille comparative permet d’evaluer visuellement :
| Critere | Meilleur modele typique | Observation |
|---|---|---|
| Nettete des details | HunyuanVideo | Modele 720p fp8, details plus precis |
| Fluidite du mouvement | Wan 2.1 / HunyuanVideo | Flow matching plus regulier |
| Vitesse de generation | Wan 2.1 (1.3B) | Modele leger, generation rapide |
| Economie VRAM | Wan 2.1 | ~8 GB contre ~13 GB pour HunyuanVideo |
Points cles : 1. La courbe de coherence temporelle revele les modeles avec des sauts brusques (artefacts) 2. Un mouvement trop faible (diff ~0) indique un modele qui genere des frames quasi-statiques 3. Un mouvement trop fort (diff > 40) indique une instabilite temporelle
LTX-Video et SVD ne figurent plus dans la comparaison : indisponibles dans le stack ComfyUI du container
comfyui-video(verifie 2026-08-15).
Section 4 : Tableau recapitulatif et analyse cout/qualite
# Tableau recapitulatif et analyse cout/qualite
if successful_results:
    print("\n--- TABLEAU RECAPITULATIF ---")
    print("=" * 90)

    # En-tete
    header = f"{'Modele':<18} {'Type':<16} {'Chargement':<12} {'Generation':<12} {'Coherence':<12} {'Nettete':<10}"
    print(header)
    print("-" * 90)

    for r in successful_results:
        load_t = f"{r.get('load_time', 0):.0f}s"
        gen_t = f"{r.get('generation_time', 0):.1f}s"
        coherence = r.get('coherence', {}).get('stability', 'N/A')
        sharpness = f"{r.get('quality', {}).get('avg_sharpness', 0):.0f}"

        print(f"  {r['model_name']:<18} {r['type']:<16} {load_t:<12} {gen_t:<12} {coherence:<12} {sharpness:<10}")

    # Analyse cout/qualite
    print(f"\n--- ANALYSE COUT / QUALITE ---")
    print("=" * 60)

    print(f"\n{'Modele':<18} {'Score efficacite':<20} {'Recommandation':<30}")
    print("-" * 68)

    for r in successful_results:
        gen_time = r.get('generation_time', 1)
        sharpness = r.get('quality', {}).get('avg_sharpness', 1)
        coherence_val = r.get('coherence', {}).get('avg_diff', 30)

        # Score : nettete / temps, normalise par coherence
        coherence_factor = 1.0 if coherence_val < 15 else 0.8 if coherence_val < 30 else 0.5
        efficiency = (sharpness * coherence_factor) / max(gen_time, 1) * 100

        if efficiency > 1.0:
            reco = "Excellent rapport qualite/cout"
        elif efficiency > 0.3:
            reco = "Bon compromis"
        else:
            reco = "Qualite elevee, cout important"

        print(f"  {r['model_name']:<18} {efficiency:<20.2f} {reco:<30}")

    # Sauvegarde du rapport JSON
    if save_results:
        report = {
            "timestamp": datetime.now().isoformat(),
            "prompt": benchmark_prompt,
            "params": {
                "num_inference_steps": num_inference_steps,
                "height": height,
                "width": width
            },
            "results": [
                {
                    "model": r['model_name'],
                    "type": r['type'],
                    "generation_time": r.get('generation_time', 0),
                    "coherence": r.get('coherence', {}),
                    "quality": r.get('quality', {})
                }
                for r in successful_results
            ]
        }
        report_path = OUTPUT_DIR / "benchmark_report.json"
        with open(report_path, 'w', encoding='utf-8') as f:
            json.dump(report, f, indent=2, ensure_ascii=False)
        print(f"\nRapport sauvegarde : {report_path.name}")

else:
    print("Aucun resultat de benchmark disponible")
    print("\nTableau attendu (valeurs typiques RTX 3090, API ComfyUI) :")
    print(f"{'Modele':<18} {'Generation':<12} {'Coherence':<12}")
    print("-" * 42)
    print(f"  {'HunyuanVideo':<18} {'60-180s':<12} {'Haute':<12}")
    print(f"  {'Wan 2.1':<18} {'30-90s':<12} {'Haute':<12}")
--- TABLEAU RECAPITULATIF ---
==========================================================================================
Modele             Type             Chargement   Generation   Coherence    Nettete
------------------------------------------------------------------------------------------
  HunyuanVideo       text-to-video    0s           200.2s       Haute        35
  Wan 2.1 (1.3B)     text-to-video    0s           91.1s        Haute        473

--- ANALYSE COUT / QUALITE ---
============================================================

Modele             Score efficacite     Recommandation
--------------------------------------------------------------------
  HunyuanVideo       17.37                Excellent rapport qualite/cout
  Wan 2.1 (1.3B)     519.41               Excellent rapport qualite/cout

Rapport sauvegarde : benchmark_report.json
En mode interactif, l’utilisateur peut saisir un prompt personnalise pour lancer un benchmark a la demande. En mode automatique (Papermill), cette section est ignoree.
# Mode interactif : benchmark avec un prompt utilisateur
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Entrez votre propre prompt pour tester sur tous les modeles.")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_prompt = input("\nVotre prompt : ").strip()

        if user_prompt and run_benchmark:
            print(f"\nBenchmark avec : {user_prompt}")
            print("Note : le benchmark complet prendra plusieurs minutes.")
            print("Seul le modele le plus rapide (Wan 2.1 1.3B) sera teste en interactif.")

            if "wan" in MODEL_REGISTRY:
                try:
                    gen = client.generate_text2video_wan(
                        prompt=user_prompt,
                        width=width,
                        height=height,
                        num_frames=MODEL_REGISTRY['wan']['num_frames'],
                        steps=num_inference_steps,
                        seed=seed,
                        cfg=MODEL_REGISTRY['wan']['cfg'],
                        save_prefix="interactive_wan",
                        timeout=300,
                    )
                    outputs = gen.get("outputs", {})
                    files = (outputs.get("50", {}).get("videos", [])
                             or outputs.get("50", {}).get("gifs", [])
                             or outputs.get("50", {}).get("images", []))
                    if not files:
                        print("  Aucun fichier video retourne par ComfyUI")
                    else:
                        meta = files[0]
                        mp4_data = client.get_output_file(
                            meta["filename"], meta.get("subfolder", ""), meta.get("type", "output")
                        )
                        mp4_path = OUTPUT_DIR / f"interactive_wan_{seed}.mp4"
                        mp4_path.write_bytes(mp4_data)

                        user_frames = imageio.v2.mimread(str(mp4_path))
                        n_display = min(8, len(user_frames))
                        indices = np.linspace(0, len(user_frames) - 1, n_display, dtype=int)
                        fig, axes = plt.subplots(1, n_display, figsize=(2.5 * n_display, 3))
                        if n_display == 1:
                            axes = [axes]
                        for ax, idx in zip(axes, indices):
                            ax.imshow(user_frames[idx])
                            ax.set_title(f"Frame {idx+1}", fontsize=8)
                            ax.axis('off')
                        plt.suptitle(f"Wan 2.1 : {user_prompt[:50]}...", fontweight='bold')
                        plt.tight_layout()
                        plt.show()
                        print(f"  MP4 : {mp4_path.name}")

                except Exception as e:
                    print(f"Erreur : {type(e).__name__}: {str(e)[:100]}")
        elif user_prompt:
            print("Benchmark non disponible")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif non disponible (execution automatisee)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")
Mode batch - Interface interactive desactiveeBonnes pratiques et choix de modèle
Guide de sélection par cas d’usage
| Cas d’usage | Modèle recommande | Raison |
|---|---|---|
| Prototypage rapide | Wan 2.1 (1.3B) | Rapide, leger (~8 GB VRAM serveur) |
| Qualite maximale | HunyuanVideo | Meilleure coherence et resolution (720p) |
| Prompts multilingues | Wan 2.1 | Support natif multilingue (umt5) |
| Resolution haute | HunyuanVideo | Modele 720p fp8 |
| Production batch | Wan 2.1 | Rapport vitesse/qualite optimal |
| Demo client | HunyuanVideo | Qualite visuelle maximale |
LTX-Video et SVD ne font plus partie du registre : indisponibles dans le stack ComfyUI du container
comfyui-video(voir Section 1).
Stratégies d’optimisation VRAM (côté serveur ComfyUI)
La VRAM du serveur (GPU RTX 3090) est la ressource partagee. Les strategies ci-dessous s’appliquent au container, pas au notebook.
| Stratégie | Gain VRAM | Impact qualite |
|---|---|---|
| Quantification INT8 | -40% | Faible |
| VAE slicing | -15% pic | Aucun |
| VAE tiling | -10% pic | Aucun |
| Resolution reduite | -30-50% | Proportionnel |
| Modeles legers (Wan 1.3B) | -40% vs Hunyuan | Visible en details |
# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Modeles testes : {models_to_test}")
print(f"Prompt : {benchmark_prompt[:60]}...")
print(f"Parametres : {num_frames} frames (defaut), {num_inference_steps} steps, CFG={guidance_scale} (defaut)")
print(f"Resolution : {width}x{height}")
print(f"Backend : API ComfyUI (container comfyui-video)")

if benchmark_results:
    n_success = sum(1 for r in benchmark_results if r.get('success', False))
    print(f"\nResultats : {n_success}/{len(benchmark_results)} modeles reussis")
    for r in benchmark_results:
        status = "OK" if r.get('success') else "ERREUR"
        gen_t = f"{r.get('generation_time', 0):.1f}s" if r.get('success') else r.get('error', 'N/A')[:50]
        print(f"  {r['model_name']:<18} [{status}] {gen_t}")

if device == "cuda" and HAS_TORCH and torch.cuda.is_available():
    vram_current = torch.cuda.memory_allocated(0) / 1024**3
    print(f"\nVRAM locale actuelle : {vram_current:.1f} GB (informatif)")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 03-2 : Orchestration de pipelines (text -> image -> video -> upscale)")
print(f"2. Notebook 03-3 : Workflows ComfyUI pour la generation video")
print(f"3. Module 04 : Applications production (education, creatif, bout-en-bout)")

print(f"\nNotebook 03-1 Comparaison Multi-Modeles termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-08-15 18:25:27
Mode : batch
Modeles testes : ['hunyuan', 'wan']
Prompt : a cat walking gracefully through a garden, soft sunlight, ci...
Parametres : 16 frames (defaut), 25 steps, CFG=6.0 (defaut)
Resolution : 512x320
Backend : API ComfyUI (container comfyui-video)

Resultats : 2/2 modeles reussis
  HunyuanVideo       [OK] 200.2s
  Wan 2.1 (1.3B)     [OK] 91.1s

Fichiers generes (3) :
  benchmark_hunyuan.mp4 (37.1 KB)
  benchmark_report.json (1.1 KB)
  benchmark_wan.mp4 (85.3 KB)

--- PROCHAINES ETAPES ---
1. Notebook 03-2 : Orchestration de pipelines (text -> image -> video -> upscale)
2. Notebook 03-3 : Workflows ComfyUI pour la generation video
3. Module 04 : Applications production (education, creatif, bout-en-bout)

Notebook 03-1 Comparaison Multi-Modeles termine - 18:25:27
Exercice : Benchmark Personnalisé
Durée estimée : 30-40 minutes
Objectif
Créer et exécuter un benchmark personnalisé sur les 2 modèles disponibles (HunyuanVideo, Wan 2.1) sur un prompt de votre choix, puis analyser les résultats avec des visualisations personnalisées.
Instructions
- Choisir un domaine d’application
- Sélectionnez un thème spécifique (ex: “nature”, “urbain”, “abstrait”)
- Formulez un prompt détaillé (15-30 mots)
- Justifiez le choix des modèles à tester
- Configurer le benchmark
- Modifier la liste
models_to_test(choisir parmihunyuan/wan) - Ajuster les paramètres (résolution, steps) en fonction de la VRAM serveur
- Estimer le temps d’exécution total
- Modifier la liste
- Exécuter et analyser
- Lancer le benchmark
- Créer une visualisation comparative personnalisée
- Calculer un score composite (temps × VRAM serveur × qualité)
- Rapport de synthèse
- Tableau comparatif des 2 modèles
- Recommandation pour votre cas d’usage
- Limites de l’évaluation
Indices :
- Pour le prompt, incluez des détails de style (caméra, éclairage, atmosphere)
- La VRAM serveur limite la resolution et le nombre de frames
- Le score composite peut être :
sharpness / (time × vram) × coherence_factor
Exercice Avancé : Métrique de Qualité Personnalisée
Durée estimée : 45-60 minutes
Objectif
Implémenter une nouvelle métrique de qualité pour évaluer la cohérence temporelle des vidéos générées, et l’intégrer dans le framework de benchmark.
Instructions
- Étudier les métriques existantes
- Analyser
measure_temporal_coherence()dans le code - Comprendre les limitations (différence moyenne pixel-à-pixel)
- Identifier les aspects non couverts (cohérence d’objets, stabilité du fond)
- Analyser
- Proposer une nouvelle métrique
- Choisir une approche (ex: flow optique, cohérence de patchs, stabilité de keypoints)
- Justifier pourquoi cette métrique est pertinente
- Pseudo-code de l’algorithme
- Implémenter la métrique
- Fonction
my_custom_coherence_metric(frames) - Retourne un dict avec score et détails
- Tests sur des frames synthétiques
- Fonction
- Intégrer et comparer
- Ajouter la métrique au benchmark
- Comparer avec les métriques existantes
- Analyser les corrélations
Indices :
- Le flow optique (ex: Farneback dans OpenCV) mesure le mouvement pixel par pixel
- La cohérence de patchs divise l’image en régions et compare leur évolution
- Les keypoints (ex: ORB, SIFT) suivent des points d’intérêt spécifiques
Critères de succès - Métrique Personnalisée
# TODO: Tester sur des frames synthétiques simples
# Ex: cercle qui se déplace uniformément (score élevé attendu)
# Ex: bruit aléatoire (score bas attendu)

# Créer des frames de test
def create_uniform_motion_frames(n_frames=8, img_size=64):
    """Crée des frames avec un cercle se déplaçant uniformément."""
    frames = []
    for i in range(n_frames):
        img = np.zeros((img_size, img_size, 3), dtype=np.uint8)
        # TODO: Dessiner un cercle qui se déplace horizontalement
        # Position x = (i / n_frames) * img_size
        pass
    return frames

def create_random_noise_frames(n_frames=8, img_size=64):
    """Crée des frames avec du bruit aléatoire."""
    frames = []
    for i in range(n_frames):
        # TODO: Générer une image de bruit aléatoire
        pass
    return frames

# TODO: Tester votre métrique sur les deux types de frames
# uniform_frames = create_uniform_motion_frames()
# noise_frames = create_random_noise_frames()
# result_uniform = my_custom_coherence_metric(uniform_frames)
# result_noise = my_custom_coherence_metric(noise_frames)

# TODO: Comparer avec measure_temporal_coherence() sur les mêmes frames
# Comparez les scores et interprétez les différences
Après avoir valide la metrique sur des cas simples, on peut implementer la version complete qui s’integre dans le framework de benchmark existant.
# TODO: Implémenter une métrique de cohérence temporelle personnalisée
def my_custom_coherence_metric(frames: List) -> Dict[str, float]:
    """
    Métrique personnalisée pour évaluer la cohérence temporelle.

    Pistes d'implémentation suggérées:

    Piste 1 - Flow optique (OpenCV):
        Utiliser cv2.calcOpticalFlowFarneback() pour mesurer le mouvement
        entre frames consécutives. Un mouvement uniforme = bonne cohérence.

    Piste 2 - Cohérence de patchs:
        Diviser l'image en régions (patches) et comparer leur évolution
        temporelle. Stabilité des régions = bonne cohérence.

    Piste 3 - Suivi de keypoints (ORB, SIFT):
        Détecter des points d'intérêt et suivre leur déplacement.
        Trajectoires régulières = bonne cohérence.

    Args:
        frames: Liste de frames PIL Image ou numpy arrays

    Returns:
        Dict avec au minimum:
        - 'score': float entre 0.0 (incohérent) et 1.0 (parfaitement cohérent)
        - 'details': str avec informations supplémentaires
    """
    # TODO: Choisir une approche et l'implémenter

    # TODO: Convertir frames en numpy arrays si nécessaire

    # TODO: Calculer la métrique selon l'approche choisie

    # TODO: Normaliser le score entre 0 et 1

    return {
        "score": 0.0,
        "details": "TODO: implémenter la métrique"
    }
Critères de succès - Benchmark Personnalisé
# TODO: Exécuter le benchmark personnalisé
# Note: Assurez-vous que run_benchmark=True et que les services sont disponibles

# TODO: Lancer le benchmark avec vos paramètres
# Vous pouvez réutiliser les cellules de benchmark ci-dessus en modifiant:
# - models_to_test = my_models
# - benchmark_prompt = my_prompt
# - width, height = my_resolution

# TODO: Créer une visualisation comparative personnalisée
# Afficher les frames générées pour chaque modèle

# TODO: Calculer un score composite pour chaque modèle
# Formule suggérée: sharpness / (time × vram) × coherence_factor
# coherence_factor = 1.0 si avg_diff < 15, 0.8 si < 30, 0.5 sinon

# TODO: Formuler une recommandation argumentée
# Quel modèle recommandez-vous pour votre cas d'usage? Pourquoi?

print("Exercice a completer : benchmark personnalise")
Exercice a completer : benchmark personnaliseLa configuration du benchmark personnalise permet de définir les paramètres spécifiques a votre cas d’usage : prompt, modèles cibles et metriques a privilegier.
# Configuration du benchmark personnalisé

# TODO: Choisir un prompt spécifique et justifier
# Exemples de thèmes: nature, urbain, abstrait, portrait, action
my_prompt = "..."  # 15-30 mots avec détails de style
my_rationale = "..."  # Justification du choix

# TODO: Sélectionner 3 modèles selon vos critères
# Options disponibles: "hunyuan", "ltx", "wan", "svd"
# Critères possibles: qualité, vitesse, VRAM, type (text-to-video vs image-to-video)
my_models = ["...", "...", "..."]
my_model_criteria = "..."  # Pourquoi ces 3 modèles?

# TODO: Ajuster la résolution selon votre VRAM disponible
# - RTX 3090 (24GB): width=512, height=320 recommandé
# - RTX 4090 (24GB+): width=640, height=384 possible
# - VRAM limitée (<18GB): width=384, height=256
my_resolution = (512, 320)  # (width, height)

# TODO: Estimer le temps d'exécution total
# Temps moyens approximatifs par modèle (sur RTX 3090):
# - HunyuanVideo: 60-180s
# - LTX-Video: 15-30s
# - Wan 2.1: 30-90s
# - SVD 1.1 XT: 20-40s
estimated_time_per_model = {
    "hunyuan": 120,
    "ltx": 22,
    "wan": 60,
    "svd": 30
}
# TODO: Calculer le temps total estimé
estimated_time = sum(estimated_time_per_model.get(m, 60) for m in my_models)

print(f"=== Configuration du Benchmark Personnalisé ===")
print(f"Prompt: {my_prompt}")
print(f"Justification: {my_rationale}")
print(f"Modèles: {my_models}")
print(f"Critères de sélection: {my_model_criteria}")
print(f"Résolution: {my_resolution[0]}x{my_resolution[1]}")
print(f"Temps estimé: {estimated_time:.0f} secondes ({estimated_time/60:.1f} minutes)")
=== Configuration du Benchmark Personnalisé ===
Prompt: ...
Justification: ...
Modèles: ['...', '...', '...']
Critères de sélection: ...
Résolution: 512x320
Temps estimé: 180 secondes (3.0 minutes)Exercice : Planificateur de Budget VRAM pour Benchmark Multi-Modèles
Duree estimee : 30-40 minutes
Objectif
Concevoir et implementer un planificateur qui, etant donne une quantite de VRAM disponible et une liste de modèles a tester, determine l’ordre optimal de chargement, les stratégies de quantification necessaires, et estime le temps total du benchmark.
Contexte
Le benchmark charge les modèles sequentiellement pour respecter les contraintes VRAM. Avec le MODEL_REGISTRY existant, on connait l’estimation VRAM de chaque modèle. Cependant : - Certains modèles necessitent une quantification (HunyuanVideo = 18 GB en FP16, mais seulement ~10 GB en INT8) - L’ordre de chargement influence le temps total (un modèle qui echoue gaspille du temps) - La VRAM residuelle après release_vram() n’est pas toujours nulle (fragmentation)
Instructions
- Analyser les contraintes VRAM
- Pour chaque modèle du
MODEL_REGISTRY, calculer la VRAM requise avec et sans quantification - Identifier les modèles qui ne peuvent PAS charger sur un GPU donne
- Calculer la marge de securite necessaire (10% de VRAM libre recommande)
- Pour chaque modèle du
- Implementer le planificateur
- Fonction
plan_benchmark(gpu_vram_gb, models_requested, quantization_options)qui :- Filtre les modèles non chargeables
- Choisit la quantification optimale pour chaque modèle
- Determine l’ordre de chargement (modèles lourds d’abord = moins de fragmentation)
- Estime le temps total du benchmark
- Fonction
- Generer le rapport de planification
- Tableau resume : modèle, quantification, VRAM requise, temps estime, ordre
- Alertes pour les modèles exclus (depassement VRAM)
- Recommandations (ajouter de la VRAM, reduire la resolution, exclure un modèle)
- Tester sur différents profils GPU
- RTX 3060 (12 GB), RTX 3090 (24 GB), RTX 4090 (24 GB), A100 (80 GB)
- Comparer les plans de benchmark generes
Indices :
# Étape 1:MODEL_REGISTRYcontientvram_estimate_gbetquantizepour chaque modèle# Étape 2: la quantification INT8 reduit la VRAM d’environ 40-50% avec une perte de qualite mineure# Étape 3:BitsAndBytesConfig(load_in_8bit=True)dans diffusers active la quantification# Indice: ordonner par VRAM decroissante : HunyuanVideo (18 GB) en premier, LTX-Video (8 GB) en dernier
# TODO: Exercice - Planificateur de Budget VRAM

def plan_benchmark(gpu_vram_gb: float, models_requested: List[str],
                   allow_quantization: bool = True) -> Dict:
    """
    Planifie un benchmark en fonction de la VRAM GPU disponible.

    Args:
        gpu_vram_gb: VRAM disponible en gigaoctets
        models_requested: Liste des cles modeles a tester
        allow_quantization: Autoriser la quantification INT8 pour reduire la VRAM

    Returns:
        {
            "feasible_models": [...],  # Modeles chargeables (ordonnes)
            "excluded_models": [...],  # Modeles trop volumineux
            "quantization_plan": {...},  # Quels modeles quantifier
            "estimated_time": float,  # Temps total estime en secondes
            "vram_margin": float  # Marge restante en GB
        }
    """
    # TODO: Implementer le planificateur

    # # Etape 1 : Calculer la VRAM requise pour chaque modele
    # for model_key in models_requested:
    #     info = MODEL_REGISTRY.get(model_key)
    #     vram_fp16 = info['vram_estimate_gb']
    #     vram_int8 = vram_fp16 * 0.55 if allow_quantization else vram_fp16
    #     ...

    # # Etape 2 : Filtrer les modeles non chargeables
    # # Un modele est chargeable si vram_requise + 10% marge <= gpu_vram_gb

    # # Etape 3 : Ordonner par VRAM decroissante

    # # Etape 4 : Estimer le temps total

    return {
        "feasible_models": [],
        "excluded_models": [],
        "quantization_plan": {},
        "estimated_time": 0,
        "vram_margin": 0
    }


# TODO: Tester sur differents profils GPU
gpu_profiles = {
    "RTX 3060 (12 GB)": 12.0,
    "RTX 3090 (24 GB)": 24.0,
    "RTX 4090 (24 GB)": 24.0,
    "A100 (80 GB)": 80.0,
}

# for gpu_name, vram in gpu_profiles.items():
#     plan = plan_benchmark(vram, models_to_test)
#     print(f"\n=== {gpu_name} ===")
#     print(f"  Modeles possibles : {plan['feasible_models']}")
#     print(f"  Exclus : {plan['excluded_models']}")
#     print(f"  Temps estime : {plan['estimated_time']:.0f}s")
#     print(f"  Marge VRAM : {plan['vram_margin']:.1f} GB")

print("Exercice a completer : planificateur budget VRAM")
Exercice a completer : planificateur budget VRAM