# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres modele
model_id = "Lightricks/LTX-Video"  # Modele LTX-Video
device = "cuda"                    # Device de calcul

# Parametres generation
num_frames = 25                    # Frames generees. LTX compresse le temps
                                   # d'un facteur 8 : seules les valeurs
                                   # (n - 1) % 8 == 0 sont honorees (9, 17,
                                   # 25, 33...). 16 etait ramene a 9 sans
                                   # avertissement. 25 frames a 8 fps = ~3s.
num_inference_steps = 20           # Nombre d'etapes de debruitage
guidance_scale = 7.5               # CFG scale (adherence au prompt)
height = 480                       # Hauteur video
width = 704                        # Largeur video
fps_output = 8                     # FPS de la video de sortie

# Configuration
run_generation = True              # Executer la generation
run_img2vid = True                 # Tester image-to-video
save_as_mp4 = True                 # Sauvegarder en MP4
save_results = TrueLTX-Video - Generation Video Rapide et Legere
Module : 02-Video-Advanced
Niveau : Intermediaire
Technologies : LTX-Video (Lightricks), diffusers
Duree estimee : 45 minutes
VRAM : ~8 GB
Objectifs d’Apprentissage
Prerequis
- GPU avec 8+ GB VRAM (RTX 3060 8GB minimum)
- Notebook 02-1 (HunyuanVideo) complete pour comparaison
- Packages :
diffusers>=0.32,transformers,torch,accelerate,imageio,imageio-ffmpeg
Navigation : << 02-1 | Index | Suivant >>
# Parameters
notebook_mode = "batch"
skip_widgets = True
Setup de l’environnement
Installation des dependances, chargement de la configuration depuis , et verification de la disponibilite GPU.
# Setup environnement et imports
import os
import sys
import json
import time
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import numpy as np
from PIL import Image
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)
warnings.filterwarnings('ignore', category=FutureWarning)

# Import helpers GenAI
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
GENAI_ROOT = current_path  # Initialisation de GENAI_ROOT
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        # On n'affiche PAS le chemin absolu : il embarquerait l'arborescence de la
        # machine qui a execute le notebook (nom d'utilisateur compris) dans une
        # sortie committee. Le nom du repertoire parent suffit a savoir QUEL .env
        # a ete pris, et reste identique d'une machine a l'autre.
        print(f".env charge depuis: {env_path.parent.name}/{env_path.name}")
        env_loaded = True
        GENAI_ROOT = current_path  # GenAI root trouve
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")
    GENAI_ROOT = GENAI_ROOT.parent

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging
        print("Helpers GenAI importes")
    except ImportError:
        print("Helpers GenAI non disponibles - mode autonome")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'ltx_video'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('ltx_video')

print(f"LTX-Video - Generation Video Rapide et Legere")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Frames : {num_frames}, Steps : {num_inference_steps}, CFG : {guidance_scale}")
.env charge depuis: GenAI/.env
Helpers GenAI importes
LTX-Video - Generation Video Rapide et Legere
Date : 2026-08-14 22:53:26
Mode : batch
Frames : 25, Steps : 20, CFG : 7.5Les imports Python etablis, la cellule suivante charge la configuration depuis .env et verifie la disponibilite du GPU. Cette étape determine si la generation sera executee localement ou basculera en mode pedagogique.
# Chargement .env et verification GPU
# Chargement variables d'environnement
from dotenv import load_dotenv

# Verification GPU
print("\n--- VERIFICATION GPU ---")
print("=" * 40)

import torch

if torch.cuda.is_available():
    gpu_name = torch.cuda.get_device_name(0)
    vram_total = torch.cuda.get_device_properties(0).total_memory / 1024**3
    vram_free = (torch.cuda.get_device_properties(0).total_memory - torch.cuda.memory_allocated(0)) / 1024**3

    print(f"GPU : {gpu_name}")
    print(f"VRAM totale : {vram_total:.1f} GB")
    print(f"VRAM libre : {vram_free:.1f} GB")
    print(f"CUDA : {torch.version.cuda}")

    if vram_total < 8:
        print(f"\nAttention : VRAM ({vram_total:.0f} GB) < 8 GB recommandes")
        height = 320
        width = 480
        num_frames = 8
        print(f"  Resolution reduite a {width}x{height}, {num_frames} frames")
else:
    print("CUDA non disponible.")
    print("LTX-Video necessite un GPU. Le notebook montrera le code sans executer.")
    run_generation = False
    run_img2vid = False
    device = "cpu"

# Verification des dependances
print("\n--- VERIFICATION DEPENDANCES ---")
print("=" * 40)

# LTX-Video embarque un text-encoder T5-XXL. Son tokenizer rapide est reconstruit
# depuis un fichier binaire `spiece.model`, ce qui exige sentencepiece ET protobuf.
# Sans eux, transformers bascule sur l'extracteur tiktoken, qui lit ce binaire
# comme du texte et echoue sur `ValueError: Error parsing line b'\x0e'`. Ce message
# accuse alors le fichier de tokenizer -- le mauvais coupable. On teste donc TOUTE
# la chaine, dependances de second rang comprises, pour que l'echec soit annonce
# ici et en clair plutot que deux cellules plus loin sous un alias trompeur.
REQUIRED = [
    ("diffusers",       "diffusers>=0.32",  "pipeline LTXPipeline"),
    ("transformers",    "transformers",     "text-encoder T5-XXL"),
    ("sentencepiece",   "sentencepiece",    "lecture du tokenizer spiece.model"),
    ("google.protobuf", "protobuf",         "deserialisation du proto SentencePiece"),
    ("imageio",         "imageio",          "export des frames"),
    ("imageio_ffmpeg",  "imageio-ffmpeg",   "encodeur ffmpeg pour le MP4"),
]

import importlib

deps_ok = True
manquants = []

for module_name, pip_name, role in REQUIRED:
    try:
        module = importlib.import_module(module_name)
        version = getattr(module, "__version__", "installe")
        print(f"  OK      {pip_name:<18} {version:<10} {role}")
    except ImportError:
        print(f"  MANQUE  {pip_name:<18} {'':<10} {role}")
        manquants.append(pip_name)
        deps_ok = False

if not deps_ok:
    print(f"\nECHEC : {len(manquants)} dependance(s) manquante(s).")
    print(f"  pip install {' '.join(manquants)}")
    print("  Le notebook affichera le code sans generer de video.")
    run_generation = False
    run_img2vid = False
else:
    print("\nChaine text-to-video complete.")

# Piege Windows a connaitre AVANT de diagnostiquer un echec d'import : le
# site-packages *utilisateur* (%APPDATA%\Python\PythonXY\site-packages) est sur le
# sys.path de TOUT interpreteur de meme version mineure, environnements conda
# inclus. Une dependance vue ici peut donc en venir et disparaitre des qu'un job
# s'isole (papermill lance sous PYTHONNOUSERSITE=1) : deux diagnostics opposes sur
# la meme machine. On le signale plutot que de le subir.
import site

user_site = site.getusersitepackages()
if site.ENABLE_USER_SITE and user_site and os.path.isdir(user_site):
    print(f"\nNote : site-packages utilisateur actif")
    print(f"  {user_site}")
    print("  Une dependance vue ci-dessus mais absente sous PYTHONNOUSERSITE=1 vient de la,")
    print("  pas de cet environnement. Cf docs/reference/env-python-reparation.md (Cas E).")

print(f"\nDevice : {device}")
print(f"Generation activee : {run_generation}")
print(f"Image-to-video activee : {run_img2vid}")
--- VERIFICATION GPU ---
========================================
GPU : NVIDIA GeForce RTX 4090
VRAM totale : 24.0 GB
VRAM libre : 24.0 GB
CUDA : 12.6

--- VERIFICATION DEPENDANCES ---
========================================
  OK      diffusers>=0.32    0.39.0     pipeline LTXPipeline
  OK      transformers       5.13.0     text-encoder T5-XXL
  OK      sentencepiece      0.2.2      lecture du tokenizer spiece.model
  OK      protobuf           7.35.1     deserialisation du proto SentencePiece
  OK      imageio            2.37.4     export des frames
  OK      imageio-ffmpeg     0.6.0      encodeur ffmpeg pour le MP4

Chaine text-to-video complete.

Device : cuda
Generation activee : True
Image-to-video activee : True
Section 1 : Architecture LTX-Video
LTX-Video est un modèle de generation video developpe par Lightricks, concu pour etre rapide et leger tout en maintenant une qualite acceptable. Il supporte trois modes : text-to-video, image-to-video et video-to-video.
| Composant | Description |
|---|---|
| Architecture | DiT (Diffusion Transformer) avec compression spatio-temporelle |
| VAE | Video VAE avec facteur de compression 1:192 |
| Text encoder | T5-XXL pour la comprehension des prompts |
| Scheduler | Flow matching pour un debruitage efficace |
Avantages de LTX-Video
| Aspect | LTX-Video | HunyuanVideo (02-1) |
|---|---|---|
| VRAM requise | ~8 GB | ~18 GB |
| Vitesse | 2-5x plus rapide | Reference |
| Modes | Text/Image/Video | Text uniquement |
| Qualite | Bonne | Très bonne |
| Resolution | Jusqu’a 720x480 | Jusqu’a 720p |
# Chargement du pipeline LTX-Video
pipe_t2v = None

if run_generation:
    print("\n--- CHARGEMENT DU PIPELINE ---")
    print("=" * 40)

    try:
        from diffusers import LTXPipeline
        from diffusers.utils import export_to_video

        start_load = time.time()

        print(f"Chargement modele : {model_id}")

        pipe_t2v = LTXPipeline.from_pretrained(
            model_id,
            torch_dtype=torch.bfloat16
        )

        vram_total_gb = (torch.cuda.get_device_properties(0).total_memory / 1024**3
                         if device == "cuda" else 0.0)

        # Offload CPU et placement direct sont EXCLUSIFS : enable_model_cpu_offload()
        # orchestre lui-meme les allers-retours GPU<->CPU couche par couche et attend
        # un pipeline reste sur CPU. Les enchainer apres un .to("cuda") produit un
        # double placement et annule l'economie de VRAM recherchee.
        if device == "cuda" and vram_total_gb < 16:
            pipe_t2v.enable_model_cpu_offload()
            print(f"  Offload CPU : actif (VRAM {vram_total_gb:.0f} GB < 16 GB)")
        else:
            pipe_t2v = pipe_t2v.to(device)
            suffixe = f" (VRAM {vram_total_gb:.0f} GB)" if device == "cuda" else ""
            print(f"  Placement direct sur {device}{suffixe}")

        # Le VAE decode les frames par lots ; le slicing borne le pic memoire du
        # decodage sans cout de qualite. ATTENTION : l'API a migre du pipeline vers
        # le VAE (diffusers >= 0.33). `pipe.enable_vae_slicing()` n'existe plus et
        # leve un AttributeError -- c'est ce qui cassait ce notebook en silence. On
        # appelle la forme courante avec repli EXPLICITE sur l'ancienne.
        if hasattr(pipe_t2v.vae, "enable_slicing"):
            pipe_t2v.vae.enable_slicing()
            vae_slicing = "pipe.vae.enable_slicing()"
        elif hasattr(pipe_t2v, "enable_vae_slicing"):
            pipe_t2v.enable_vae_slicing()
            vae_slicing = "pipe.enable_vae_slicing() (API < 0.33)"
        else:
            vae_slicing = "indisponible sur cette version de diffusers"

        load_time = time.time() - start_load

        if device == "cuda":
            vram_used = torch.cuda.memory_allocated(0) / 1024**3
            print(f"  VRAM utilisee : {vram_used:.1f} GB")

        print(f"Pipeline text-to-video charge en {load_time:.1f}s")
        print(f"  VAE slicing : {vae_slicing}")
        print(f"  Resolution : {width}x{height}")

    except Exception:
        # On imprime la chaine d'exceptions COMPLETE. Sous diffusers/transformers,
        # l'exception visible est frequemment un symptome de repli et la vraie cause
        # se trouve deux niveaux plus bas dans __cause__/__context__ : tronquer a
        # str(e)[:200] -- ce que faisait ce notebook -- rend toutes les causes
        # indiscernables et fait accuser le mauvais paquet.
        import traceback

        print("\n" + "=" * 40)
        print("ECHEC DU CHARGEMENT DU PIPELINE")
        print("=" * 40)
        # format_exc() plutot que print_exc() : ce dernier ecrit sur stderr, que
        # Jupyter collecte dans un flux separe -- la trace apparait alors APRES la
        # conclusion dans le notebook committe, ce qui rend la sortie illisible.
        print(traceback.format_exc())
        print("=" * 40)
        print("Aucune video ne sera generee : les cellules suivantes s'executeront")
        print("en mode lecture. Corriger la cause ci-dessus avant de conclure quoi")
        print("que ce soit des sorties de ce notebook.")

        run_generation = False
        run_img2vid = False
        pipe_t2v = None
else:
    print("Chargement pipeline desactive")
--- CHARGEMENT DU PIPELINE ---
========================================
Chargement modele : Lightricks/LTX-Video
Placement direct sur cuda (VRAM 24 GB)
VRAM utilisee : 13.3 GB
Pipeline text-to-video charge en 16.2s
VAE slicing : pipe.vae.enable_slicing()
Resolution : 704x480Section 2 : Generation text-to-video
LTX-Video excelle dans la generation rapide de videos courtes a partir de prompts textuels. Son architecture legere permet des itérations plus rapides que HunyuanVideo.
# Generation text-to-video
print("\n--- GENERATION TEXT-TO-VIDEO ---")
print("=" * 40)

def generate_ltx_video(prompt: str, negative_prompt: str = "",
                       seed: int = 42, pipeline=None) -> Dict[str, Any]:
    """
    Genere une video avec LTX-Video.

    Args:
        prompt: Description textuelle de la video
        negative_prompt: Elements a eviter
        seed: Graine aleatoire pour reproductibilite
        pipeline: Pipeline a utiliser (defaut: pipe_t2v)

    Returns:
        Dict avec frames, temps de generation et metadonnees
    """
    active_pipe = pipeline or pipe_t2v
    if active_pipe is None:
        return {"success": False, "error": "Pipeline non charge"}

    try:
        generator = torch.Generator(device=device).manual_seed(seed)

        if device == "cuda":
            torch.cuda.reset_peak_memory_stats()

        start_time = time.time()

        output = active_pipe(
            prompt=prompt,
            negative_prompt=negative_prompt or "low quality, blurry, distorted, worst quality",
            num_frames=num_frames,
            guidance_scale=guidance_scale,
            num_inference_steps=num_inference_steps,
            height=height,
            width=width,
            generator=generator
        )

        gen_time = time.time() - start_time
        frames = output.frames[0]

        result = {
            "success": True,
            "frames": frames,
            "generation_time": gen_time,
            "time_per_frame": gen_time / num_frames,
            "prompt": prompt,
            "seed": seed,
            "params": {
                "num_frames": num_frames,
                "guidance_scale": guidance_scale,
                "num_inference_steps": num_inference_steps,
                "height": height,
                "width": width
            }
        }

        if device == "cuda":
            result["vram_peak"] = torch.cuda.max_memory_allocated(0) / 1024**3

        return result

    except Exception as e:
        # Chaine COMPLETE : l'exception visible masque frequemment la vraie cause
        # deux niveaux plus bas (__cause__/__context__). Tronquer a 200 caracteres
        # rend deux echecs de nature differente indiscernables l'un de l'autre.
        import traceback

        return {
            "success": False,
            "error": f"{type(e).__name__}: {e}",
            "traceback": traceback.format_exc(),
        }


# Premier test
prompt_1 = "a butterfly landing on a colorful flower in a garden, macro photography, soft bokeh background, natural lighting"

if run_generation:
    print(f"Prompt : {prompt_1}")
    print(f"Parametres : {num_frames} frames, {num_inference_steps} steps, CFG={guidance_scale}")
    print(f"Resolution : {width}x{height}")
    print(f"\nGeneration en cours...")

    result_1 = generate_ltx_video(prompt_1, seed=42)

    if result_1['success']:
        frames = result_1['frames']
        print(f"\nGeneration reussie")
        print(f"  Temps total : {result_1['generation_time']:.1f}s")
        print(f"  Temps/frame : {result_1['time_per_frame']:.1f}s")
        print(f"  Frames : {len(frames)}")
        if 'vram_peak' in result_1:
            print(f"  VRAM pic : {result_1['vram_peak']:.1f} GB")

        # Affichage en grille
        n_display = min(8, len(frames))
        indices = np.linspace(0, len(frames) - 1, n_display, dtype=int)
        fig, axes = plt.subplots(2, 4, figsize=(16, 8))
        axes_flat = axes.flatten()
        for i, idx in enumerate(indices):
            if i < len(axes_flat):
                axes_flat[i].imshow(frames[idx])
                axes_flat[i].set_title(f"Frame {idx + 1}/{len(frames)}", fontsize=9)
                axes_flat[i].axis('off')
        for i in range(len(indices), len(axes_flat)):
            axes_flat[i].axis('off')
        plt.suptitle(f"LTX-Video : {prompt_1[:60]}...", fontsize=11, fontweight='bold')
        plt.tight_layout()
        plt.show()

        if save_as_mp4:
            mp4_path = OUTPUT_DIR / "ltx_demo.mp4"
            export_to_video(frames, str(mp4_path), fps=fps_output)
            mp4_size_kb = mp4_path.stat().st_size / 1024
            print(f"  MP4 sauvegarde : {mp4_path.name} ({mp4_size_kb:.1f} KB)")
    else:
        print(f"ECHEC GENERATION : {result_1['error']}")
        if result_1.get("traceback"):
            print(result_1["traceback"])
else:
    print("Generation desactivee")
    print(f"\nExemple de code pour generer :")
    print(f"  result = generate_ltx_video('{prompt_1[:50]}...', seed=42)")
--- GENERATION TEXT-TO-VIDEO ---
========================================
Prompt : a butterfly landing on a colorful flower in a garden, macro photography, soft bokeh background, natural lighting
Parametres : 25 frames, 20 steps, CFG=7.5
Resolution : 704x480

Generation en cours...
Generation reussie
  Temps total : 2.8s
  Temps/frame : 0.1s
  Frames : 25
  VRAM pic : 14.1 GB
MP4 sauvegarde : ltx_demo.mp4 (33.1 KB)Exercice 1 : Estimateur de VRAM pour LTX-Video
Objectif : Implementer une fonction qui estime la consommation VRAM de LTX-Video en fonction des paramètres de generation, et determine si une configuration est realisable sur le GPU disponible.
LTX-Video est concu pour etre leger (~8 GB VRAM), mais la consommation exacte depend de la resolution, du nombre de frames et de la precision numérique.
Indices : - # Étape 1 : La formule de base est : base_vram + (width * height * num_frames * bytes_per_pixel) / 1e9 ou base_vram est le cout fixe du modèle (~5 GB en bfloat16) et bytes_per_pixel depend du dtype (2 pour float16/bfloat16) - # Étape 2 : Le VAE slicing divise la consommation VAE par 2. Le CPU offload reduit encore la VRAM mais ralentit la generation - # Étape 3 : Si la VRAM estimee depasse la VRAM disponible, proposer une configuration degradee (reduire frames puis resolution) - # Indice : LTX-Video en bfloat16 utilise ~5 GB fixes + ~0.5 GB par 512x320x16 frames
def estimate_ltx_vram(width: int, height: int, num_frames: int,
                       vae_slicing: bool = True, dtype: str = "bfloat16") -> dict:
    """
    Estime la VRAM requise pour LTX-Video avec une configuration donnee.

    Args:
        width: Largeur video
        height: Hauteur video
        num_frames: Nombre de frames
        vae_slicing: VAE slicing active (reduit la VRAM VAE)
        dtype: Precision numerique ("bfloat16", "float16", "float32")

    Returns:
        Dict avec : vram_estimee_gb, vram_base_gb, vram_generations_gb,
                    faisable (bool), config_alternative (si non faisable)
    """
    # Etape 1 : Calculer la VRAM de base (modele + text encoder)
    # TODO etudiant : base ~5 GB en bfloat16/float16, ~10 GB en float32
    pass

    # Etape 2 : Calculer la VRAM pour la generation
    # TODO etudiant : appliquer la formule avec bytes_per_pixel selon dtype
    pass

    # Etape 3 : Verifier la faisabilite et proposer une alternative
    # TODO etudiant : si total > vram_disponible, proposer une config reduite
    pass

    return None  # TODO etudiant : retourner le dictionnaire d'estimation

# Test avec la configuration par defaut du notebook
print("Exercice a completer")
Exercice a completer# Image-to-video : animation d'image statique
if run_img2vid:
print("\n--- IMAGE-TO-VIDEO ---")
print("=" * 40)
try:
from diffusers import LTXImageToVideoPipeline
from diffusers.utils import export_to_video
# Creer une image de test (ou charger une existante)
print("Creation d'une image de test...")
test_img = Image.new('RGB', (width, height), (100, 150, 200))
from PIL import ImageDraw
draw = ImageDraw.Draw(test_img)
# Dessiner un paysage simple
# Ciel gradient
for y in range(height // 2):
r = int(100 + 50 * y / (height // 2))
g = int(150 + 50 * y / (height // 2))
b = int(220 - 20 * y / (height // 2))
draw.line([(0, y), (width, y)], fill=(r, g, b))
# Sol vert
draw.rectangle([0, height // 2, width, height], fill=(80, 140, 60))
# Soleil
draw.ellipse([width - 120, 30, width - 40, 110], fill=(255, 220, 100))
test_img_path = OUTPUT_DIR / "test_input_image.png"
test_img.save(str(test_img_path))
print(f"Image de test sauvegardee : {test_img_path.name}")
# LTXImageToVideoPipeline attend EXACTEMENT les memes composants que
# LTXPipeline (vae, text_encoder, tokenizer, transformer, scheduler). Le
# reconstruire via from_pretrained chargerait une SECONDE copie des poids :
# sur un GPU 24 GB deja occupe par pipe_t2v, le pic depasse la VRAM
# physique, CUDA deborde en memoire systeme et la generation passe de
# quelques secondes a 422 s (mesure sur RTX 4090). On reutilise donc les
# composants deja residents -- meme modele, zero octet supplementaire.
if pipe_t2v is not None:
print(f"\nPipeline image-to-video : reutilisation des composants de pipe_t2v")
pipe_i2v = LTXImageToVideoPipeline(**pipe_t2v.components)
vae_slicing = "herite de pipe_t2v"
else:
print(f"\nChargement pipeline image-to-video...")
pipe_i2v = LTXImageToVideoPipeline.from_pretrained(
model_id,
torch_dtype=torch.bfloat16
)
pipe_i2v = pipe_i2v.to(device)
# Le VAE decode les frames par lots ; le slicing borne le pic memoire du
# decodage sans cout de qualite. ATTENTION : l'API a migre du pipeline vers
# le VAE (diffusers >= 0.33). `pipe.enable_vae_slicing()` n'existe plus et
# leve un AttributeError -- c'est ce qui cassait ce notebook en silence. On
# appelle la forme courante avec repli EXPLICITE sur l'ancienne.
if hasattr(pipe_i2v.vae, "enable_slicing"):
pipe_i2v.vae.enable_slicing()
vae_slicing = "pipe.vae.enable_slicing()"
elif hasattr(pipe_i2v, "enable_vae_slicing"):
pipe_i2v.enable_vae_slicing()
vae_slicing = "pipe.enable_vae_slicing() (API < 0.33)"
else:
vae_slicing = "indisponible sur cette version de diffusers"
# Generer la video a partir de l'image
i2v_prompt = "the landscape comes alive, clouds moving slowly, grass swaying in the wind, golden hour lighting"
print(f"Prompt : {i2v_prompt}")
print(f"Generation image-to-video en cours...")
generator = torch.Generator(device=device).manual_seed(42)
if device == "cuda":
torch.cuda.reset_peak_memory_stats()
start_time = time.time()
output_i2v = pipe_i2v(
image=test_img,
prompt=i2v_prompt,
negative_prompt="low quality, blurry, distorted",
num_frames=num_frames,
guidance_scale=guidance_scale,
num_inference_steps=num_inference_steps,
# Sans height/width explicites, le pipeline retombe sur SES valeurs par
# defaut (512x704) et ignore a la fois la resolution configuree du
# notebook et les dimensions de l'image source : la video sortait en
# 704x512 pour une source 704x480. On les passe donc explicitement.
height=height,
width=width,
generator=generator
)
i2v_time = time.time() - start_time
i2v_frames = output_i2v.frames[0]
if device == "cuda":
vram_i2v = torch.cuda.max_memory_allocated(0) / 1024**3
print(f" VRAM pic : {vram_i2v:.1f} GB")
print(f"Generation reussie en {i2v_time:.1f}s")
print(f" Frames : {len(i2v_frames)}")
# Affichage : image source + frames generees
fig, axes = plt.subplots(2, 5, figsize=(18, 7))
# Premiere ligne : image source + premieres frames
axes[0][0].imshow(test_img)
axes[0][0].set_title("Image source", fontsize=9, fontweight='bold')
axes[0][0].axis('off')
for i in range(1, 5):
idx = i - 1
if idx < len(i2v_frames):
axes[0][i].imshow(i2v_frames[idx])
axes[0][i].set_title(f"Frame {idx + 1}", fontsize=9)
axes[0][i].axis('off')
# Deuxieme ligne : frames suivantes
later_indices = np.linspace(4, len(i2v_frames) - 1, 5, dtype=int)
for i, idx in enumerate(later_indices):
axes[1][i].imshow(i2v_frames[idx])
axes[1][i].set_title(f"Frame {idx + 1}", fontsize=9)
axes[1][i].axis('off')
plt.suptitle("Image-to-Video : Animation d'un paysage", fontsize=13, fontweight='bold')
plt.tight_layout()
plt.show()
if save_as_mp4:
mp4_path = OUTPUT_DIR / "ltx_img2vid.mp4"
export_to_video(i2v_frames, str(mp4_path), fps=fps_output)
print(f" MP4 sauvegarde : {mp4_path.name}")
# Liberation du pipeline i2v
del pipe_i2v
if device == "cuda":
torch.cuda.empty_cache()
except ImportError as e:
print(f"Pipeline image-to-video non disponible : {e}")
print("Verifiez la version de diffusers (>=0.32 requise)")
except Exception:
# Meme raison qu'au chargement du pipeline : la trace complete, sur stdout.
import traceback
print("\nECHEC IMAGE-TO-VIDEO")
print(traceback.format_exc())
else:
print("Image-to-video desactive")
print("\nPrincipe : LTXImageToVideoPipeline prend une image PIL + prompt")
print("et genere une video qui anime l'image de maniere coherente.")
--- IMAGE-TO-VIDEO ---
========================================
Creation d'une image de test...
Image de test sauvegardee : test_input_image.png

Pipeline image-to-video : reutilisation des composants de pipe_t2v
Prompt : the landscape comes alive, clouds moving slowly, grass swaying in the wind, golden hour lighting
Generation image-to-video en cours...
VRAM pic : 14.1 GB
Generation reussie en 2.6s
Frames : 25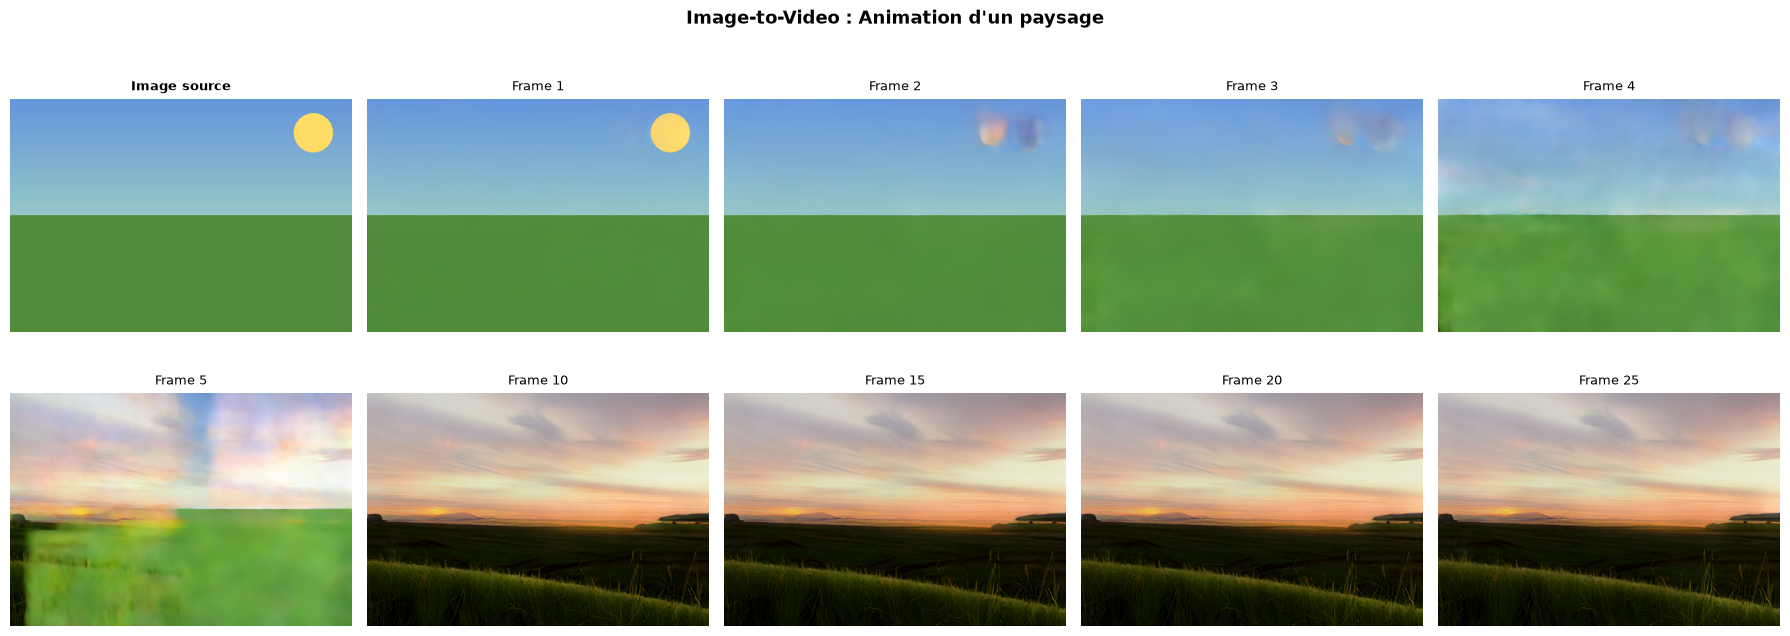
MP4 sauvegarde : ltx_img2vid.mp4Lecture du résultat : image-to-video
La cellule précédente part d’une image fixe dessinée par PIL (un paysage schématique en 704x480) et demande au modèle de l’animer. Les valeurs ci-dessous sont celles de l’exécution enregistrée juste au-dessus.
| Mesure | Valeur |
|---|---|
| Frames générées | 25 (soit ~3 s à 8 fps) |
| Résolution | 704x480, identique à l’image source |
| Temps de génération | 2.6 s (mesure runtime pipeline, dépendante de la machine d’exécution) |
| VRAM pic | 14.1 GB |
| MP4 produit | ltx_img2vid.mp4, 92.6 KB |
Le pipeline i2v ne coûte pas un second chargement. LTXImageToVideoPipeline attend exactement les mêmes composants que LTXPipeline — vae, text_encoder, tokenizer, transformer, scheduler. En les réutilisant via LTXImageToVideoPipeline(**pipe_t2v.components), on garde un seul jeu de poids en mémoire : le pic reste à 14.1 GB, le même qu’en text-to-video.
Le reconstruire avec from_pretrained chargerait une seconde copie. Mesuré sur cette machine (RTX 4090, 24 GB) : le pic montait à 26.9 GB, dépassait la VRAM physique, débordait en mémoire système — et la génération passait de ~3 s à ~7 min (mesure runtime pipeline, dépendante de la machine d’exécution), soit 163 fois plus lente pour un résultat identique. C’est le genre de régression qu’aucune erreur ne signale : le notebook « marche », simplement deux ordres de grandeur trop lentement.
Passer height et width explicitement. Sans eux, le pipeline retombe sur ses propres valeurs par défaut (512x704) et ignore aussi bien la résolution configurée du notebook que les dimensions de l’image source — la vidéo sortait en 704x512 pour une source 704x480, ce qui ruine précisément la fidélité que le mode image-to-video est censé offrir.
Text-to-video et image-to-video, en une phrase : le premier construit une scène à partir du seul texte, le second contraint la première frame par une image et n’utilise le texte que pour décrire le mouvement à appliquer. Le prompt utilisé ici — « clouds moving slowly, grass swaying in the wind » — ne décrit pas une scène, il décrit une animation.
Exercice 2 : Générateur de prompts image-to-video
Objectif : Créer une fonction qui genere automatiquement un prompt d’animation optimise a partir d’une description du contenu d’une image statique.
En mode image-to-video, le prompt ne decrit pas la scene (l’image le fait déjà) mais le mouvement souhaite. Cet exercice aide a formuler des prompts d’animation efficaces.
Indices : - # Étape 1 : Définir un dictionnaire MOTION_CUES qui associe des types de scenes (paysage, portrait, nature, urbain) a des mouvements naturels (nuages qui bougent, cheveux dans le vent, lumiere qui change) - # Étape 2 : Detecter le type de scene a partir de mots-cles dans la description (ex: “sky” + “clouds” = paysage, “person” + “face” = portrait) - # Étape 3 : Construire le prompt d’animation en combinant les mouvements naturels du type detecte avec des mots-cles de qualite (smooth, natural, subtle) - # Indice : LTX-Video prefere des prompts d’animation courts et descriptifs (pas de phrases complexes)
def generate_animation_prompt(image_description: str, style: str = "natural") -> str:
    """
    Genere un prompt d'animation optimise pour LTX-Video image-to-video.

    Args:
        image_description: Description du contenu de l'image source
        style: Style d'animation ("natural", "cinematic", "subtle", "dramatic")

    Returns:
        Prompt d'animation optimise
    """
    # Etape 1 : Definir les indices de mouvement par type de scene
    MOTION_CUES = {}  # TODO etudiant : completer avec paysage, portrait, nature, urbain

    # Etape 2 : Detecter le type de scene
    # TODO etudiant : analyser image_description pour trouver le type
    pass

    # Etape 3 : Construire le prompt d'animation
    # TODO etudiant : combiner mouvements detectes + style + mots de qualite
    pass

    return None  # TODO etudiant : retourner le prompt d'animation

# Test avec differentes descriptions
print("Exercice a completer")
Exercice a completer# Comparaison vitesse vs qualite
if run_generation and pipe_t2v is not None:
print("\n--- COMPARAISON VITESSE VS QUALITE ---")
print("=" * 45)
test_prompt = "a kitten playing with a ball of yarn, cute, soft lighting, cozy room"
configs = [
{"steps": 10, "cfg": 5.0, "label": "Rapide (10 steps)"},
{"steps": 20, "cfg": 7.5, "label": "Equilibre (20 steps)"},
{"steps": 40, "cfg": 7.5, "label": "Qualite (40 steps)"},
]
speed_results = []
for cfg in configs:
print(f"\nTest : {cfg['label']}")
# Modifier temporairement
orig_steps = num_inference_steps
orig_cfg = guidance_scale
num_inference_steps = cfg['steps']
guidance_scale = cfg['cfg']
result = generate_ltx_video(test_prompt, seed=42)
# Restaurer
num_inference_steps = orig_steps
guidance_scale = orig_cfg
if result['success']:
speed_results.append({
"label": cfg['label'],
"steps": cfg['steps'],
"frames": result['frames'],
"time": result['generation_time'],
"vram_peak": result.get('vram_peak', 0)
})
print(f" Temps : {result['generation_time']:.1f}s")
else:
print(f" Erreur : {result['error']}")
# Affichage comparatif
if speed_results:
n_configs = len(speed_results)
n_preview = 4
fig, axes = plt.subplots(n_configs, n_preview, figsize=(3.5 * n_preview, 3 * n_configs))
if n_configs == 1:
axes = [axes]
for v_idx, sr in enumerate(speed_results):
frame_indices = np.linspace(0, len(sr['frames']) - 1, n_preview, dtype=int)
for f_idx, fi in enumerate(frame_indices):
axes[v_idx][f_idx].imshow(sr['frames'][fi])
axes[v_idx][f_idx].axis('off')
if f_idx == 0:
axes[v_idx][f_idx].set_ylabel(sr['label'], fontsize=10, fontweight='bold')
plt.suptitle("Vitesse vs Qualite - LTX-Video", fontsize=13, fontweight='bold')
plt.tight_layout()
plt.show()
# Tableau recapitulatif
print(f"\n{'Configuration':<25} {'Steps':<8} {'Temps (s)':<12} {'VRAM (GB)':<12}")
print("-" * 57)
for sr in speed_results:
print(f" {sr['label']:<25} {sr['steps']:<8} {sr['time']:<12.1f} {sr['vram_peak']:<12.1f}")
else:
print("Comparaison vitesse/qualite : generation desactivee")
print("\nGuide vitesse/qualite LTX-Video :")
print(" 10 steps : ~5s, preview rapide")
print(" 20 steps : ~12s, usage general")
print(" 40 steps : ~25s, meilleure qualite")
--- COMPARAISON VITESSE VS QUALITE ---
=============================================

Test : Rapide (10 steps)
Temps : 1.5s
Test : Equilibre (20 steps) Temps : 2.3s
Test : Qualite (40 steps) Temps : 4.2s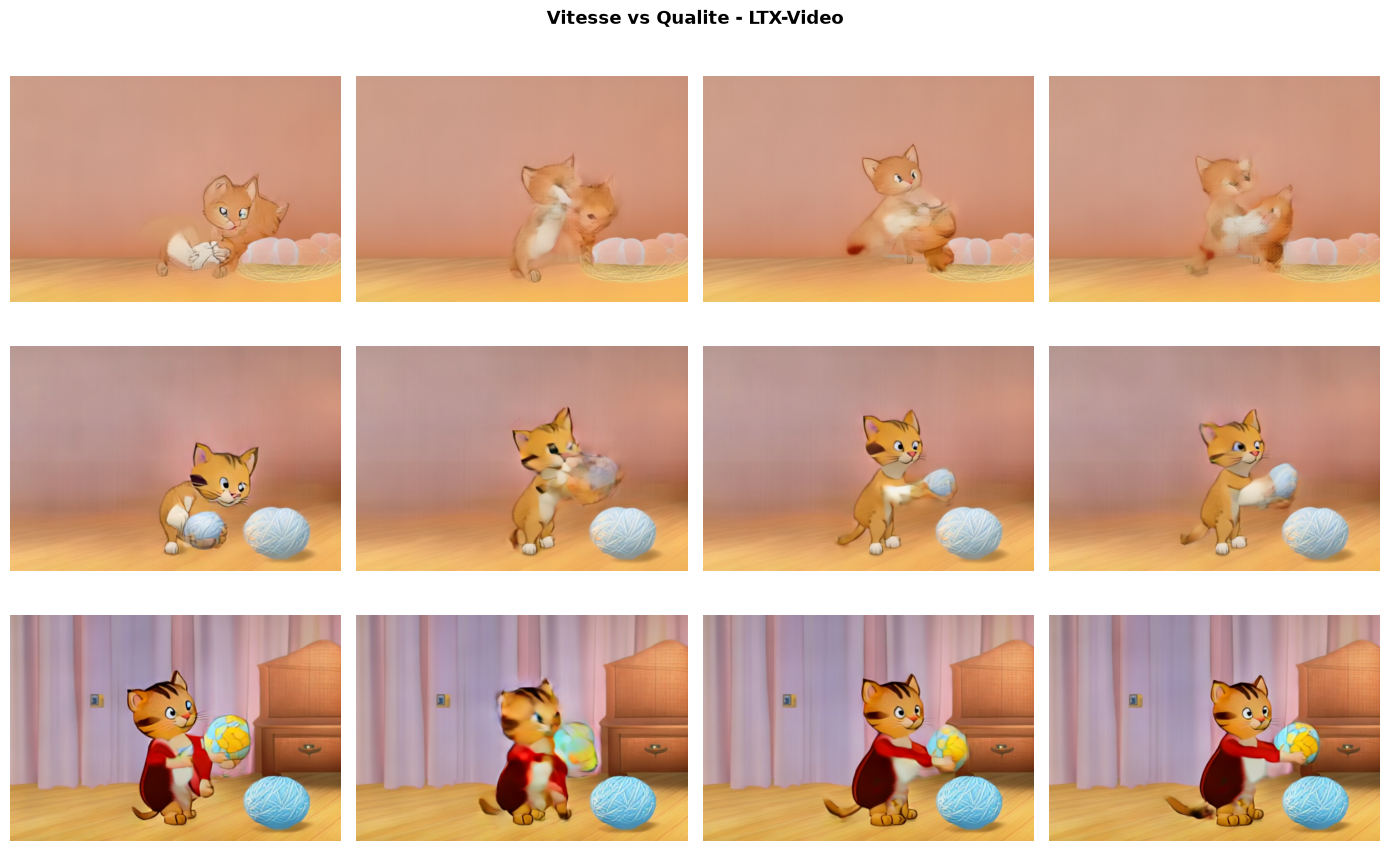
Configuration             Steps    Temps (s)    VRAM (GB)
---------------------------------------------------------
  Rapide (10 steps)         10       1.5          14.1
  Equilibre (20 steps)      20       2.3          14.1
  Qualite (40 steps)        40       4.2          14.1
Lecture du résultat : vitesse vs qualité
Les trois configurations ci-dessus ont tourné sur le même prompt, la même graine et la même résolution ; seul le nombre d’étapes de débruitage change.
| Configuration | Steps | Temps mesuré (mesure runtime pipeline, dépendante de la machine d’exécution) | VRAM pic |
|---|---|---|---|
| Rapide | 10 | 1.5 s | 14.1 GB |
| Équilibré | 20 | 2.3 s | 14.1 GB |
| Qualité | 40 | 4.2 s | 14.1 GB |
Ces temps varient d’environ un dixième de seconde d’une exécution à l’autre : c’est la tendance qu’il faut lire, pas le troisième chiffre.
Le temps n’est pas proportionnel au nombre de steps. Quadrupler les étapes (10 → 40) ne multiplie le temps que par 2.8. La raison est visible dans le modèle affine que ces trois points déterminent :
temps ≈ 0.6 s + 0.09 s × steps (mesure runtime pipeline, dépendante de la machine d'exécution)Les 0.6 s constants sont le coût incompressible d’une génération (mesure runtime pipeline, dépendante de la machine d’exécution) — encodage du prompt par le T5 et décodage VAE des latents en frames — payé une fois quel que soit le nombre d’étapes. C’est ce coût fixe qui rend les configurations basses moins avantageuses qu’attendu : à 10 steps, plus d’un tiers du temps ne sert pas au débruitage.
La VRAM, elle, ne bouge pas. 14.1 GB dans les trois cas : les étapes de débruitage sont séquentielles et réutilisent les mêmes tenseurs, elles n’accumulent rien. Le nombre d’étapes est donc un levier de temps seul — c’est la résolution et le nombre de frames qui pilotent la mémoire.
Conséquence pratique : sur ce GPU (mesure runtime pipeline, dépendante de la machine d’exécution), 40 steps coûtent moins de 3 s de plus que 10 steps. Le compromis vitesse/qualité que l’on trouve dans la littérature suppose un coût par étape dominant ; ici il ne l’est pas, et itérer directement à 20-40 steps reste peu coûteux.
Exercice 3 : Analyseur de coherence temporelle
Objectif : Implementer une fonction qui mesure la coherence temporelle d’une sequence video en calculant les différences pixel-wise entre frames consecutives.
La coherence temporelle est un indicateur cle de la qualite video : des sauts brusques entre frames signalent des artefacts de generation, tandis qu’une variabilite trop faible indique un manque de mouvement.
Indices : - # Étape 1 : Convertir chaque frame en np.array de type float32 pour eviter les debordements - # Étape 2 : Calculer la différence absolue moyenne (MAD) entre chaque paire de frames consecutives : np.mean(np.abs(f1 - f2)) - # Étape 3 : Définir des seuils de classification : variation < 5 = “statique”, 5-20 = “fluide”, 20-40 = “mouvement rapide”, > 40 = “instable” - # Indice : Une video de bonne qualite a une variabilite reguliere entre frames, sans pics soudains
def analyze_temporal_coherence(frames: list) -> dict:
    """
    Analyse la coherence temporelle d'une sequence de frames.

    Args:
        frames: Liste de frames PIL ou numpy arrays

    Returns:
        Dict avec : avg_variation, max_variation, min_variation,
                    coherence_score (0-100), classification, variations_par_frame
    """
    # Etape 1 : Convertir les frames en numpy arrays float32
    # TODO etudiant : gerer le cas PIL Image et numpy array
    pass

    # Etape 2 : Calculer les differences entre frames consecutives
    # TODO etudiant : boucler sur les paires de frames consecutives
    pass

    # Etape 3 : Classifier la coherence
    # TODO etudiant : utiliser les seuils pour determiner la classification
    pass

    return None  # TODO etudiant : retourner le dictionnaire d'analyse

# Test avec des frames synthetiques
print("Exercice a completer")
Exercice a completerBonnes pratiques et comparaison
Quand utiliser LTX-Video vs HunyuanVideo
Ce tableau est un ordre de grandeur issu des cartes de modèles et de la littérature : seule la colonne LTX-Video a été mesurée dans ce notebook, HunyuanVideo n’y est pas exécuté.
| Scénario | Modèle recommandé | Raison |
|---|---|---|
| Prototypage rapide | LTX-Video | quelques secondes par clip, VRAM réduite |
| Qualité maximale | HunyuanVideo | meilleure cohérence et niveau de détail |
| GPU 8-12 GB | LTX-Video | seul des deux à tenir en mémoire |
| Animation d’image | LTX-Video | mode image-to-video natif |
| Vidéo longue (5 s+) | HunyuanVideo | meilleure cohérence temporelle (ordre de grandeur littéraire — non exécuté dans ce notebook) |
| Itérations multiples | LTX-Video | plus rapide pour balayer des prompts |
Contraintes à retenir sur les paramètres
| Paramètre | Contrainte | Conséquence si ignorée |
|---|---|---|
num_frames |
(n - 1) % 8 == 0 |
la valeur est silencieusement ramenée au multiple inférieur : 16 donne 9 frames sans le moindre avertissement |
height / width |
à passer explicitement en i2v | le pipeline retombe sur 512x704 et ignore l’image source |
| pipeline i2v | partager les composants du t2v | sinon seconde copie des poids, dépassement de VRAM et effondrement des performances |
Exemple guide : Comparaison Vitesse/Qualité LTX-Video
Durée estimée : 15-20 minutes
Objectif
Comprendre les compromis entre vitesse de génération et qualité vidéo avec LTX-Video.
Instructions
Implémentez la fonction de benchmark : Complétez
benchmark_ltx_configs()qui teste plusieurs configurations de steps et calcule les métriques.Analysez les résultats : Utilisez les métriques pour identifier la configuration optimale pour différents cas d’usage (preview, production, qualité maximale).
Créez un guide de sélection : Documentez les recommandations selon le scénario.
Indices :
- Le temps de génération est approximativement proportionnel au nombre de steps
- La qualité subjective peut être évaluée en comparant les frames générées
- Utilisez
np.mean(np.abs(frame1 - frame2))pour mesurer la différence entre frames - Le ratio qualité/temps est :
subjective_quality / generation_time
Critères de succès
Benchmarks et mode interactif
Mesurons les performances de generation selon différentes configurations (resolution, nombre de frames, steps) et testons le mode interactif.
# Test et analyse
if run_generation and pipe_t2v is not None:
    test_prompt = "a red sports car driving on a coastal highway, sunset, cinematic"

    configs = [
        {"steps": 10, "cfg": 5.0, "label": "Rapide"},
        {"steps": 20, "cfg": 7.5, "label": "Standard"},
        {"steps": 30, "cfg": 7.5, "label": "Qualité"},
        {"steps": 20, "cfg": 9.0, "label": "CFG élevé"}
    ]

    # Exercice: Exécuter le benchmark
    # df = benchmark_ltx_configs(test_prompt, configs)

    # Exercice: Afficher les résultats et recommandations
    # print(df)
    # print("\nRecommandations :")
    # for priority in ["speed", "balanced", "quality"]:
    #     rec = recommend_config(df, priority)
    #     print(f"  {priority}: {rec['label']}")
else:
    print("Benchmark désactivé (pipeline non disponible)")
Le test de generation valide le fonctionnement du pipeline. La cellule suivante implemente la logique de recommendation automatique qui selectionne la meilleure configuration en fonction du cas d’usage (rapidite, qualite ou equilibre).
import pandas as pd

# Exercice: Fonction pour recommander la meilleure configuration
def recommend_config(df_results: pd.DataFrame, priority: str = "balanced") -> Dict:
    """
    Recommande la meilleure configuration selon la priorite.

    Args:
        df_results: DataFrame de resultats du benchmark
        priority: "speed", "balanced", ou "quality"

    Returns:
        Dict avec la configuration recommandee
    """
    # Exercice: Implémenter la logique de recommandation
    # Indice :
    #   - "speed" : minimiser time
    #   - "quality" : maximiser quality_score
    #   - "balanced" : maximiser quality_score / time
    pass
La logique de recommandation etablit quand privilegier vitesse ou qualite. La cellule suivante implemente le benchmark systématique qui mesurera les temps de generation pour valider ces recommandations.
# Exercice: Fonction de benchmark de configurations LTX-Video
def benchmark_ltx_configs(prompt: str, configs: List[Dict]) -> pd.DataFrame:
    """
    Teste plusieurs configurations et retourne un DataFrame de resultats.

    Args:
        prompt: Prompt de test
        configs: Liste de configurations {"steps", "cfg", "label"}

    Returns:
        DataFrame avec colonnes : label, steps, cfg, time, vram, quality_score
    """
    results = []

    for cfg in configs:
        # Exercice: Generer avec la configuration
        # Indice : utiliser generate_ltx_video()
        pass

        # Exercice: Calculer un score de qualite subjectif (0-100)
        # Indice : base sur la nettete, coherence temporelle
        pass

        results.append({
            "label": cfg["label"],
            "steps": cfg["steps"],
            "cfg": cfg["cfg"],
            "time": generation_time,
            "vram_peak": vram_peak,
            "quality_score": quality_score
        })

    # Exercice: Convertir en DataFrame pandas
    pass
La fonction de benchmark de configurations est implementee. On active maintenant le mode interactif qui permet d’ajuster les paramètres de generation via des widgets sans relancer les cellules précédentes.
# Mode interactif
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Entrez votre propre prompt pour generer une video LTX-Video.")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_prompt = input("\nVotre prompt : ").strip()

        if user_prompt and run_generation and pipe_t2v is not None:
            print(f"\nGeneration en cours...")
            result_user = generate_ltx_video(user_prompt, seed=123)

            if result_user['success']:
                print(f"Generation reussie en {result_user['generation_time']:.1f}s")

                n_display = min(8, len(result_user['frames']))
                fig, axes = plt.subplots(1, n_display, figsize=(2.5 * n_display, 3))
                if n_display == 1:
                    axes = [axes]
                indices = np.linspace(0, len(result_user['frames']) - 1, n_display, dtype=int)
                for ax, idx in zip(axes, indices):
                    ax.imshow(result_user['frames'][idx])
                    ax.set_title(f"Frame {idx+1}", fontsize=8)
                    ax.axis('off')
                plt.suptitle(f"Votre video : {user_prompt[:50]}...", fontweight='bold')
                plt.tight_layout()
                plt.show()

                if save_as_mp4:
                    user_mp4 = OUTPUT_DIR / "user_generation.mp4"
                    export_to_video(result_user['frames'], str(user_mp4), fps=fps_output)
                    print(f"MP4 sauvegarde : {user_mp4.name}")
            else:
                print(f"Erreur : {result_user['error']}")
        elif user_prompt:
            print("Generation non disponible (pipeline non charge)")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif non disponible (execution automatisee)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")
Mode batch - Interface interactive desactiveeLes fonctions d’exercice définies, on execute maintenant un test complet suivi du benchmark de configurations. Ce dernier mesure les temps de generation reels pour différentes combinaisons de resolution et de nombre de frames.
# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Modele : {model_id}")
print(f"Device : {device}")
print(f"Parametres : {num_frames} frames, {num_inference_steps} steps, CFG={guidance_scale}")
print(f"Resolution : {width}x{height}")

if device == "cuda" and torch.cuda.is_available():
    vram_peak = torch.cuda.max_memory_allocated(0) / 1024**3
    print(f"VRAM pic session : {vram_peak:.1f} GB")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

# Liberation VRAM
if pipe_t2v is not None:
    del pipe_t2v
    if device == "cuda":
        torch.cuda.empty_cache()
        print(f"\nVRAM liberee")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 02-3 : Wan 2.1/2.2 (prompts multilingues FR/EN, motion control)")
print(f"2. Notebook 02-4 : SVD (animation d'images statiques haute qualite)")
print(f"3. Module 03-1 : Comparaison benchmark de tous les modeles video")
print(f"4. Combiner LTX image-to-video avec 01-4 (Real-ESRGAN) pour upscaling")

print(f"\nNotebook 02-2 LTX-Video Lightweight termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-08-14 22:54:16
Mode : batch
Modele : Lightricks/LTX-Video
Device : cuda
Parametres : 25 frames, 20 steps, CFG=7.5
Resolution : 704x480
VRAM pic session : 14.1 GB

Fichiers generes (3) :
  ltx_demo.mp4 (33.1 KB)
  ltx_img2vid.mp4 (92.6 KB)
  test_input_image.png (2.7 KB)

VRAM liberee

--- PROCHAINES ETAPES ---
1. Notebook 02-3 : Wan 2.1/2.2 (prompts multilingues FR/EN, motion control)
2. Notebook 02-4 : SVD (animation d'images statiques haute qualite)
3. Module 03-1 : Comparaison benchmark de tous les modeles video
4. Combiner LTX image-to-video avec 01-4 (Real-ESRGAN) pour upscaling

Notebook 02-2 LTX-Video Lightweight termine - 22:54:16
Conclusion
Ce notebook a permis d explorer les aspects essentiels de 02 2 ltx video lightweight. Les points cles :
- Les concepts fondamentaux ont ete presentes et illustres
- Les exercices proposent une mise en pratique progressive
- Les résultats obtenus permettent de valider la comprehension
Pour aller plus loin : approfondir les aspects avances du sujet et explorer les liens avec d autres domaines.