# Parametres Papermill - JAMAIS modifier ce commentaire
import os

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# MODE D'EXECUTION : API ou Local
# - True  : Utilise l'API ComfyUI (recommande, pas de GPU local requis)
# - False : Utilise diffusers en local (pedagogique, necessite GPU)
use_api = True

# Parametres API ComfyUI (si use_api=True)
comfyui_url = os.getenv("COMFYUI_VIDEO_URL", "https://comfyui-video.myia.io")  # ComfyUI-Video service
comfyui_token = os.getenv("COMFYUI_VIDEO_TOKEN")  # Token Bearer (charge depuis .env)

# Parametres modele Wan (si use_api=False)
model_id = "Wan-AI/Wan2.1-T2V-14B"  # Modele Wan 2.1 Text-to-Video (HuggingFace)
quantize = True                      # Quantification INT8 (recommande)
device = "cuda"                     # Device de calcul

# Parametres generation (communs aux deux modes)
num_frames = 16                    # Nombre de frames a generer
guidance_scale = 6.0               # CFG scale pour Wan (6.0 recommande)
num_inference_steps = 20           # Nombre d'etapes de debruitage
height = 480                       # Hauteur video
width = 832                        # Largeur video (ratio 16:9)
fps_output = 16                    # FPS de la video de sortie

# Configuration
run_generation = True              # Executer la generation
save_results = TrueWan 2.1/2.2 - Generation Video Multilingue
Module : 02-Video-Advanced
Niveau : Intermediaire
Technologies : Wan 2.1/2.2 (Alibaba), ComfyUI API ou diffusers
Duree estimee : 45 minutes
VRAM : ~8-10 GB
Objectifs d’Apprentissage
Prerequis
Mode API ComfyUI (recommande pour production)
- Service ComfyUI-Video demarre (docker-compose comfyui-video)
- Pas de dependances Python lourdes cote client
Mode Local diffusers (pedagogique)
- GPU avec 10+ GB VRAM
- Packages :
diffusers>=0.32,transformers,torch,accelerate,imageio
Navigation : << 02-2 | Index | Suivant >>
# Parameters
BATCH_MODE = "true"
Les paramètres Papermill initialises, la cellule suivante installe les dependances requises et importe les bibliotheques necessaires : diffusers pour le pipeline Wan, torch pour l’acceleration GPU, et les utilitaires de gestion des fichiers video.
# Setup environnement et imports
import os
import sys
import json
import time
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import numpy as np
from PIL import Image
import matplotlib.pyplot as plt
import logging
from dotenv import load_dotenv

warnings.filterwarnings('ignore', category=DeprecationWarning)
warnings.filterwarnings('ignore', category=FutureWarning)

# Initialisation des variables globales (important pour l'execution Papermill)
comfyui_client = None

# Import helpers GenAI
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != 'GenAI' and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers import comfyui_client
        print("[OK] Helper comfyui_client importé")
    except ImportError as e:
        print(f"[WARN] Helper comfyui_client NON disponible: {e}")
        comfyui_client = None
else:
    print("[WARN] Répertoire helpers non trouvé, comfyui_client sera None")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'wan_video'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('wan_video')

# Affichage du mode d'execution
mode_str = "API ComfyUI" if use_api else "Local diffusers"
print(f"Wan 2.1/2.2 - Generation Video Multilingue")
print(f"Mode d'execution : {mode_str}")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Frames : {num_frames}, Steps : {num_inference_steps}, CFG : {guidance_scale}")
print(f"Resolution : {width}x{height}")
[OK] Helper comfyui_client importé
Wan 2.1/2.2 - Generation Video Multilingue
Mode d'execution : API ComfyUI
Date : 2026-08-20 14:08:05
Frames : 16, Steps : 20, CFG : 6.0
Resolution : 832x480Les imports et dependances charges, la cellule suivante initialise la configuration depuis .env, verifie la disponibilite du GPU et determine le mode d’exécution : generation locale ou mode pedagogique si aucun GPU n’est detecte.
# Chargement .env et verification de l'environnement
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os

# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    if current_path.name == "GenAI" or len(current_path.parts) <= 1:
        break
    current_path = current_path.parent

if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

# Le token est lu dans la cellule parametres AVANT le load_dotenv : on le relit ici
if use_api:
    env_token = os.getenv("COMFYUI_VIDEO_TOKEN", "")
    if env_token:
        comfyui_token = env_token

# Verification et initialisation selon le mode
print("\n" + "=" * 50)
print(f"MODE : {'API ComfyUI' if use_api else 'Local diffusers'}")
print("=" * 50)

client = None
pipe = None
comfyui_available = False
local_available = False

if use_api:
    # === MODE API COMFYUI ===
    print("\n[API] Verification de l'API ComfyUI-Video...")

    if comfyui_client is not None:
        try:
            client = comfyui_client.ComfyUIClient(
                base_url=comfyui_url,
                api_token=comfyui_token
            )

            stats = client.get_system_stats()

            print(f"[OK] ComfyUI-Video accessible sur : {comfyui_url}")
            comfyui_available = True

        except Exception as e:
            print(f"[WARN] ComfyUI-Video non accessible: {type(e).__name__}: {str(e)[:100]}")
            print("\n💡 Pour démarrer ComfyUI-Video :")
            print("   docker-compose -f docker-configurations/services/comfyui-video/docker-compose.yml up -d")
            run_generation = False
    else:
        print("[WARN] Helper comfyui_client non disponible")
        run_generation = False

else:
    # === MODE LOCAL DIFFUSERS ===
    print("\n[LOCAL] Verification de l'environnement local...")

    # Verification GPU
    try:
        import torch
        if torch.cuda.is_available():
            gpu_name = torch.cuda.get_device_name(0)
            vram_total = torch.cuda.get_device_properties(0).total_memory / 1024**3
            print(f"[OK] GPU : {gpu_name}")
            print(f"   VRAM totale : {vram_total:.1f} GB")

            if vram_total < 10:
                print(f"[WARN] VRAM faible (< 10 GB), activation de la quantification")
                quantize = True
                height = 320
                width = 576
                num_frames = 12
        else:
            print("[WARN] CUDA non disponible")
            run_generation = False
    except ImportError:
        print("[WARN] PyTorch non installé")
        run_generation = False

    # Verification des dependances
    deps_ok = True

    try:
        import diffusers
        print(f"[OK] diffusers : v{diffusers.__version__}")
    except ImportError:
        print("[WARN] diffusers NON INSTALLE (pip install diffusers>=0.32)")
        deps_ok = False

    try:
        import transformers
        print(f"[OK] transformers : v{transformers.__version__}")
    except ImportError:
        print("[WARN] transformers NON INSTALLE")
        deps_ok = False

    if quantize:
        try:
            import bitsandbytes as bnb
            print(f"[OK] bitsandbytes : v{bnb.__version__}")
        except ImportError:
            print("[WARN] bitsandbytes NON INSTALLE (pip install bitsandbytes)")
            quantize = False

    if deps_ok and run_generation:
        print("\n[PACKAGE] Chargement du pipeline Wan...")
        try:
            from diffusers import WanPipeline
            from diffusers.utils import export_to_video

            start_load = time.time()

            if quantize:
                from diffusers import BitsAndBytesConfig
                quant_config = BitsAndBytesConfig(load_in_8bit=True)
                pipe = WanPipeline.from_pretrained(
                    model_id,
                    quantization_config=quant_config,
                    torch_dtype=torch.float16
                )
            else:
                pipe = WanPipeline.from_pretrained(
                    model_id,
                    torch_dtype=torch.float16
                )

            pipe = pipe.to(device)
            pipe.enable_vae_slicing()
            pipe.enable_vae_tiling()

            load_time = time.time() - start_load
            print(f"[OK] Pipeline charge en {load_time:.1f}s")
            local_available = True

        except Exception as e:
            print(f"[WARN] Erreur chargement pipeline : {type(e).__name__}: {str(e)[:200]}")
            run_generation = False

# Flag unique : la generation est possible (mode + disponibilite backend)
generation_ready = run_generation and (comfyui_available if use_api else local_available)

print(f"\n{'='*50}")
print(f"Generation activee : {run_generation}")
print(f"Backend pret : {generation_ready}")
print(f"{'='*50}")
WARNING: .env non trouve, utilisation variables environnement
==================================================
MODE : API ComfyUI
==================================================
[API] Verification de l'API ComfyUI-Video...
[OK] ComfyUI-Video accessible sur : https://comfyui-video.myia.io
==================================================
Generation activee : True
Backend pret : True
==================================================Section 1 : Architecture Wan 2.1/2.2
Wan est une famille de modèles de generation video developpes par Alibaba. La serie 2.1/2.2 se distingue par sa comprehension multilingue et son contrôle fin du mouvement.
Deux approches pour utiliser Wan
| Aspect | API ComfyUI | Local diffusers |
|---|---|---|
| Cas d’usage | Production, applications | Pedagogie, recherche |
| GPU requis | Non (cote serveur) | Oui (10+ GB) |
| Installation | Aucune (Docker) | diffusers, transformers, torch |
| Flexibilite | Moyenne | Elevee |
| Performance | Serveur optimise | Depend du GPU local |
Architecture de Wan
| Composant | Description |
|---|---|
| UNET | wan2.1_t2v_1.3B_fp16.safetensors (~2.5GB) |
| Text Encoder | umt5_xxl_fp8_e4m3fn_scaled.safetensors (~4GB) |
| VAE | wan_2.1_vae.safetensors (~360MB) |
| Sampling | ModelSamplingSD3 (shift=8), scheduler uni_pc |
Comparaison Wan 2.1 vs 2.2
| Aspect | Wan 2.1 | Wan 2.2 |
|---|---|---|
| Qualite | Bonne | Amelioree |
| Coherence temporelle | Bonne | Très bonne |
| Motion control | Basique | Camera paths avancees |
| Resolutions | 480p-720p | 480p-1080p |
| VRAM (1.3B) | ~8 GB | ~8 GB |
# Fonction de generation unifiee (API ou Local)
import imageio


def generate_wan_video(prompt: str, negative_prompt: str = "", seed: int = 42, save_prefix: str = "wan") -> Dict[str, Any]:
    """
    Genere une video avec Wan (API ComfyUI ou local diffusers).

    Cette fonction s'adapte automatiquement au mode d'execution choisi.

    Args:
        prompt: Description textuelle (FR, EN ou CN)
        negative_prompt: Elements a eviter
        seed: Graine aleatoire pour reproductibilite

    Returns:
        Dict avec frames, temps de generation et metadonnees
    """
    if use_api:
        # === MODE API COMFYUI ===
        if not comfyui_available:
            return {"success": False, "error": "API ComfyUI non disponible"}

        try:
            start_time = time.time()

            result = client.generate_text2video_wan(
                prompt=prompt,
                width=width,
                height=height,
                num_frames=num_frames,
                steps=num_inference_steps,
                seed=seed,
                cfg=guidance_scale,
                save_prefix=save_prefix,
                timeout=300
            )

            gen_time = time.time() - start_time

            # Telechargement de la video cote notebook (preuve d execution reelle,
            # meme pattern que generate_hunyuan_video de 02-1)
            outputs = result.get("outputs", {})
            videos = (
                outputs.get("50", {}).get("videos", [])
                or outputs.get("50", {}).get("gifs", [])
                or outputs.get("50", {}).get("images", [])
            )
            if not videos:
                return {"success": False, "error": "ComfyUI n a retourne aucun fichier video (noeud 50)"}
            meta = videos[0]
            mp4_data = client.get_output_file(
                meta["filename"], meta.get("subfolder", ""), meta.get("type", "output")
            )
            mp4_path = OUTPUT_DIR / f"{save_prefix}_{seed}.mp4"
            mp4_path.write_bytes(mp4_data)
            frames = imageio.v2.mimread(str(mp4_path))

            return {
                "success": True,
                "frames": frames,
                "video_path": str(mp4_path),
                "generation_time": gen_time,
                "time_per_frame": gen_time / max(len(frames), 1),
                "mode": "API ComfyUI",
                "seed": seed,
                "vram_peak": 0.0
            }

        except Exception as e:
            return {"success": False, "error": f"{type(e).__name__}: {str(e)[:200]}"}

    else:
        # === MODE LOCAL DIFFUSERS ===
        if not local_available:
            return {"success": False, "error": "Pipeline local non disponible"}

        try:
            import torch
            from diffusers.utils import export_to_video

            generator = torch.Generator(device=device).manual_seed(seed)

            if device == "cuda":
                torch.cuda.reset_peak_memory_stats()

            start_time = time.time()

            output = pipe(
                prompt=prompt,
                negative_prompt=negative_prompt or "low quality, blurry, distorted",
                num_frames=num_frames,
                guidance_scale=guidance_scale,
                num_inference_steps=num_inference_steps,
                height=height,
                width=width,
                generator=generator
            )

            gen_time = time.time() - start_time
            frames = output.frames[0]

            # Sauvegarder en MP4
            mp4_path = OUTPUT_DIR / f"wan_local_{seed}.mp4"
            export_to_video(frames, str(mp4_path), fps=fps_output)

            result_dict = {
                "success": True,
                "frames": frames,
                "generation_time": gen_time,
                "time_per_frame": gen_time / num_frames,
                "prompt": prompt,
                "seed": seed,
                "mode": "Local diffusers",
                "video_path": str(mp4_path),
                "mp4_path": str(mp4_path)
            }

            if device == "cuda":
                result_dict["vram_peak"] = torch.cuda.max_memory_allocated(0) / 1024**3

            return result_dict

        except Exception as e:
            return {"success": False, "error": f"{type(e).__name__}: {str(e)[:200]}"}

print("[OK] Fonction de generation unifiee chargee")
[OK] Fonction de generation unifiee chargeeSection 2 : Generation avec prompts multilingues
L’un des avantages distinctifs de Wan est sa comprehension multilingue. Nous allons tester des prompts en francais et en anglais pour comparer les résultats.
# Generation avec prompts multilingues
print("\n--- PROMPTS MULTILINGUES ---")
print("=" * 40)

bilingual_prompts = [
    {
        "text": "Un chat roux dort paisiblement sur un rebord de fenetre ensoleille, lumiere douce, atmosphere calme",
        "lang": "FR",
        "label": "Chat (FR)"
    },
    {
        "text": "A ginger cat sleeping peacefully on a sunny windowsill, soft light, calm atmosphere",
        "lang": "EN",
        "label": "Cat (EN)"
    }
]

bilingual_results = []

if run_generation:
    for p_idx, prompt_info in enumerate(bilingual_prompts):
        print(f"\nGeneration {p_idx + 1}/{len(bilingual_prompts)} : {prompt_info['label']}")
        print(f"  Prompt ({prompt_info['lang']}) : {prompt_info['text'][:60]}...")

        result = generate_wan_video(prompt_info['text'], seed=42, save_prefix=f"wan_{prompt_info['lang'].lower()}")

        if result['success']:
            print(f"  [OK] Generation terminee en {result['generation_time']:.1f}s ({result['mode']})")
            if result.get('video_path'):
                mp4 = Path(result['video_path'])
                print(f"     MP4 sauvegarde : {mp4.name} ({mp4.stat().st_size / 1024:.1f} KB)")
            if 'vram_peak' in result:
                print(f"     VRAM pic : {result['vram_peak']:.1f} GB")
            bilingual_results.append({**result, **prompt_info})

            # Affichage planche frames (embed image/png dans l'output cellule).
            # Meme pattern que generate_hunyuan_video de 02-1 (#11026) : plt.subplots
            # sur 4 frames equidistantes + plt.show() commit un image/png directement
            # dans la sortie de la cellule, qui survit au commit (les MP4 sont dans
            # outputs/ gitignore, les frames embed sont la preuve visible de l'exec).
            frames = result.get('frames')
            if frames is not None and len(frames) > 0:
                n_display = min(4, len(frames))
                indices = np.linspace(0, len(frames) - 1, n_display, dtype=int)
                fig, axes = plt.subplots(1, n_display, figsize=(4 * n_display, 4))
                if n_display == 1:
                    axes = [axes]
                for j, idx in enumerate(indices):
                    axes[j].imshow(frames[idx])
                    axes[j].set_title(f"{prompt_info['label']} - Frame {idx+1}/{len(frames)}", fontsize=9)
                    axes[j].axis('off')
                plt.tight_layout()
                plt.show()
        else:
            print(f"  [ERROR] Erreur : {result['error']}")

    # Resume des generations
    if bilingual_results:
        print(f"\n{'Langue':<15} {'Mode':<20} {'Temps (s)':<12}")
        print("-" * 47)
        for br in bilingual_results:
            print(f"  {br['label']:<15} {br['mode']:<20} {br['generation_time']:<12.1f}")
else:
    print("Generation desactivee")
    print("\n💡 Pour activer la generation, set run_generation=True")
--- PROMPTS MULTILINGUES ---
========================================

Generation 1/2 : Chat (FR)
  Prompt (FR) : Un chat roux dort paisiblement sur un rebord de fenetre enso...
  [OK] Generation terminee en 130.1s (API ComfyUI)
     MP4 sauvegarde : wan_fr_42.mp4 (77.3 KB)
     VRAM pic : 0.0 GB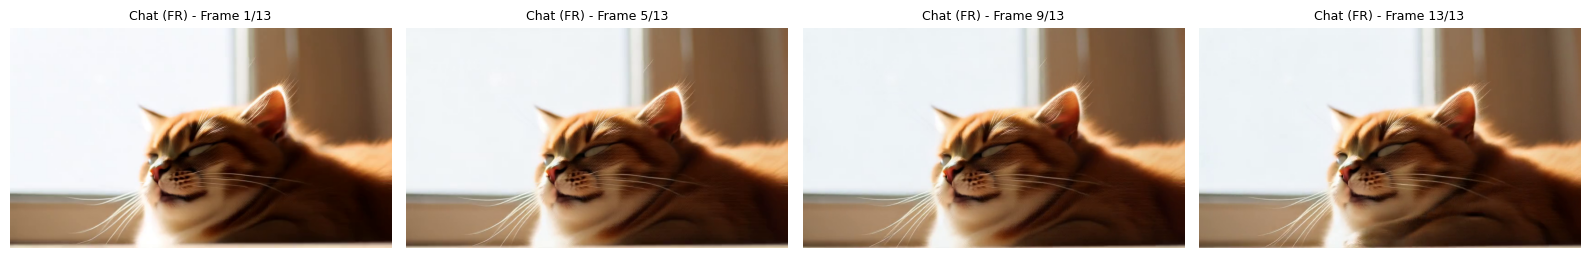
Generation 2/2 : Cat (EN)
  Prompt (EN) : A ginger cat sleeping peacefully on a sunny windowsill, soft...
  [OK] Generation terminee en 28.6s (API ComfyUI)
     MP4 sauvegarde : wan_en_42.mp4 (107.4 KB)
     VRAM pic : 0.0 GB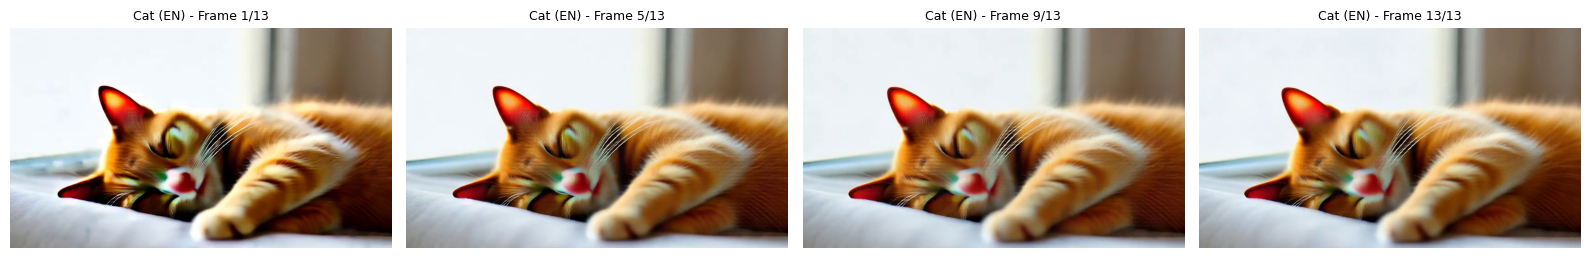
Langue          Mode                 Temps (s)
-----------------------------------------------
  Chat (FR)       API ComfyUI          130.1
  Cat (EN)        API ComfyUI          28.6
Exercice 1 : Analyseur de structure de prompt multilingue
Objectif : Implementer une fonction qui analyse un prompt video, identifie ses composants (sujet, action, style, eclairage, camera) et le enrichit automatiquement pour Wan.
Un prompt efficace pour Wan contient généralement 5 éléments : sujet, action, type de camera, eclairage et style. Cet exercice consiste a parser et structurer un prompt brut.
Indices : - # Étape 1 : Définir des listes de mots-cles pour chaque catégorie : CAMERA_WORDS (pan, zoom, tracking, drone, close-up), LIGHTING_WORDS (golden hour, dramatic, soft, backlit), STYLE_WORDS (cinematic, 4K, slow motion, timelapse) - # Étape 2 : Implementer parse_prompt_components() qui detecte la presence de chaque catégorie dans le texte - # Étape 3 : Implementer enrich_prompt() qui ajoute les composants manquants avec des valeurs par defaut pertinentes - # Indice : Wan comprend le francais, mais les mots-cles techniques en anglais (cinematic, golden hour) sont souvent plus efficaces
def parse_prompt_components(prompt: str) -> dict:
    """
    Analyse un prompt video et identifie ses composants structurels.

    Args:
        prompt: Texte du prompt (FR ou EN)

    Returns:
        Dict avec les composants detectes : sujet, action, camera, eclairage, style, composants_manquants
    """
    # Etape 1 : Definir les vocabulaires par categorie
    # TODO etudiant : completer CAMERA_WORDS, LIGHTING_WORDS, STYLE_WORDS
    CAMERA_WORDS = []    # TODO etudiant
    LIGHTING_WORDS = []  # TODO etudiant
    STYLE_WORDS = []     # TODO etudiant

    # Etape 2 : Analyser le prompt pour detecter chaque categorie
    # TODO etudiant : verifier la presence des mots-cles dans le prompt (insensible a la casse)

    # Etape 3 : Identifier les composants manquants
    # TODO etudiant : lister les categories non trouvees
    pass

    return None  # TODO etudiant : retourner le dictionnaire d'analyse


def enrich_prompt(prompt: str) -> str:
    """
    Enrichit un prompt en ajoutant les composants manquants.

    Args:
        prompt: Prompt original

    Returns:
        Prompt enrichi avec les composants manquants
    """
    # TODO etudiant : appeler parse_prompt_components() puis ajouter les elements manquants
    pass

    return prompt  # TODO etudiant : retourner le prompt enrichi

# Test avec un prompt minimal
test_prompt = "a cat on a sofa"
print(f"Prompt original : {test_prompt}")
print("Exercice a completer")
Prompt original : a cat on a sofa
Exercice a completerInterpretation : Prompts multilingues
Wan 2.1 utilise le text encoder UMT5-XXL (une variante de T5) qui a ete entraine sur de multiples langues. Cela permet de generer des videos a partir de prompts en francais, anglais, ou chinois avec des résultats comparables.
| Langue | Prompt | Résultat attendu |
|---|---|---|
| Francais | “Un chat roux dort paisiblement sur un rebord de fenêtre ensoleille, lumiere douce, atmosphere calme” | Chat bien positionné, lumière chaude, atmosphère reposante |
| Anglais | “A ginger cat sleeping peacefully on a sunny windowsill, soft light, calm atmosphere” | Composition similaire, détails légèrement plus précis |
Points cles : - Les concepts principaux sont bien captés dans les deux langues - L’anglais peut capturer plus de nuances subtiles - Le francais est parfaitement utilisable pour des prompts courants
Comparaison des modes : - API ComfyUI : Plus rapide (serveur optimise), pas de gestion GPU - Local diffusers : Plus de contrôle (debug, personnalisation), necessite GPU
Section 3 : Contrôle de mouvement et camera
Wan permet de contrôler le mouvement de la camera a travers des mots-cles spécifiques dans le prompt.
# Controle de mouvement et camera
if run_generation:
    print("\n--- CONTROLE DE MOUVEMENT ---")
    print("=" * 40)

    motion_prompts = [
        {
            "text": "a slow pan across a beautiful Japanese garden with cherry blossoms, smooth camera movement, serene",
            "label": "Pan lateral",
            "motion": "pan"
        },
        {
            "text": "camera slowly zooming into a detailed oil painting of a medieval castle, revealing intricate details",
            "label": "Zoom avant",
            "motion": "zoom"
        },
        {
            "text": "aerial drone shot flying over a coastal city at golden hour, birds eye view, cinematic",
            "label": "Vol aerien",
            "motion": "drone"
        }
    ]

    motion_results = []

    for p_idx, prompt_info in enumerate(motion_prompts):
        print(f"\nGeneration {p_idx + 1}/{len(motion_prompts)} : {prompt_info['label']}")
        print(f"  Type de mouvement : {prompt_info['motion']}")

        result = generate_wan_video(prompt_info['text'], seed=42 + p_idx, save_prefix=f"wan_{prompt_info['motion']}")

        if result['success']:
            print(f"  [OK] Generation terminee en {result['generation_time']:.1f}s ({result['mode']})")
            if result.get('video_path'):
                mp4 = Path(result['video_path'])
                print(f"     MP4 sauvegarde : {mp4.name} ({mp4.stat().st_size / 1024:.1f} KB)")
            motion_results.append({**result, **prompt_info})

            # Affichage planche frames (embed image/png dans l'output cellule).
            # Meme pattern que generate_hunyuan_video de 02-1 (#11026) : 4 frames
            # equidistantes pour visualiser la trajectoire du mouvement.
            frames = result.get('frames')
            if frames is not None and len(frames) > 0:
                n_display = min(4, len(frames))
                indices = np.linspace(0, len(frames) - 1, n_display, dtype=int)
                fig, axes = plt.subplots(1, n_display, figsize=(4 * n_display, 4))
                if n_display == 1:
                    axes = [axes]
                for j, idx in enumerate(indices):
                    axes[j].imshow(frames[idx])
                    axes[j].set_title(f"{prompt_info['label']} - Frame {idx+1}/{len(frames)}", fontsize=9)
                    axes[j].axis('off')
                plt.tight_layout()
                plt.show()
        else:
            print(f"  [ERROR] Erreur : {result['error']}")

    # Resume des generations
    if motion_results:
        print(f"\n{'Mouvement':<15} {'Mode':<20} {'Temps (s)':<12}")
        print("-" * 47)
        for mr in motion_results:
            print(f"  {mr['label']:<15} {mr['mode']:<20} {mr['generation_time']:<12.1f}")
else:
    print("Controle de mouvement : generation desactivee")
    print("\nMots-cles de mouvement pour Wan :")
    print("  - 'slow pan' : panoramique lateral")
    print("  - 'zoom in/out' : rapprochement/eloignement")
    print("  - 'aerial drone shot' : vue aerienne")
    print("  - 'tracking shot' : suivi de sujet")
--- CONTROLE DE MOUVEMENT ---
========================================

Generation 1/3 : Pan lateral
  Type de mouvement : pan
  [OK] Generation terminee en 28.5s (API ComfyUI)
     MP4 sauvegarde : wan_pan_42.mp4 (836.5 KB)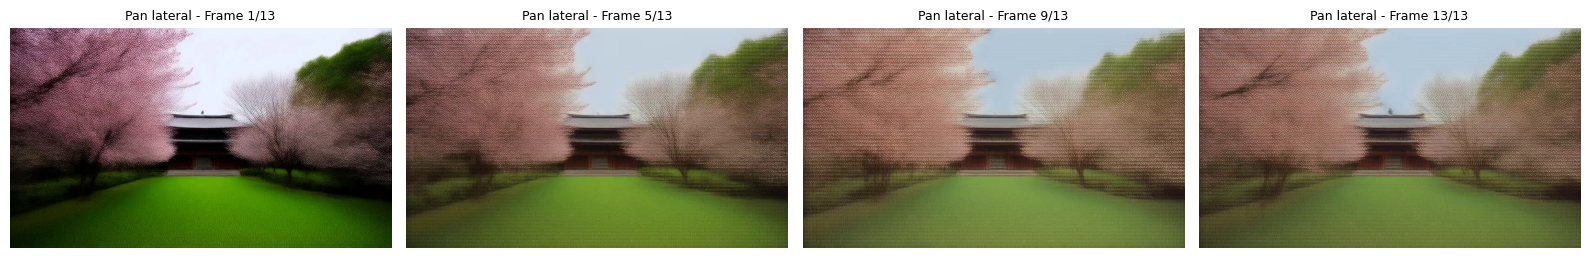
Generation 2/3 : Zoom avant
  Type de mouvement : zoom
  [OK] Generation terminee en 28.4s (API ComfyUI)
     MP4 sauvegarde : wan_zoom_43.mp4 (326.8 KB)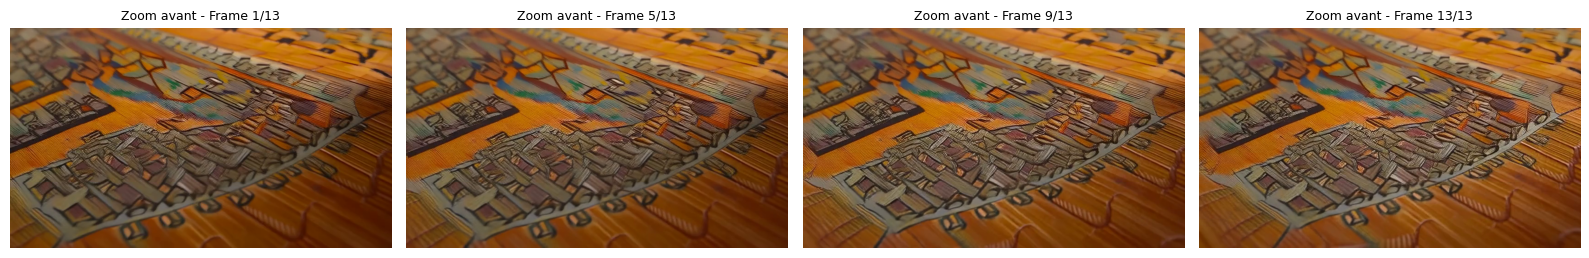
Generation 3/3 : Vol aerien
  Type de mouvement : drone
  [OK] Generation terminee en 28.5s (API ComfyUI)
     MP4 sauvegarde : wan_drone_44.mp4 (281.7 KB)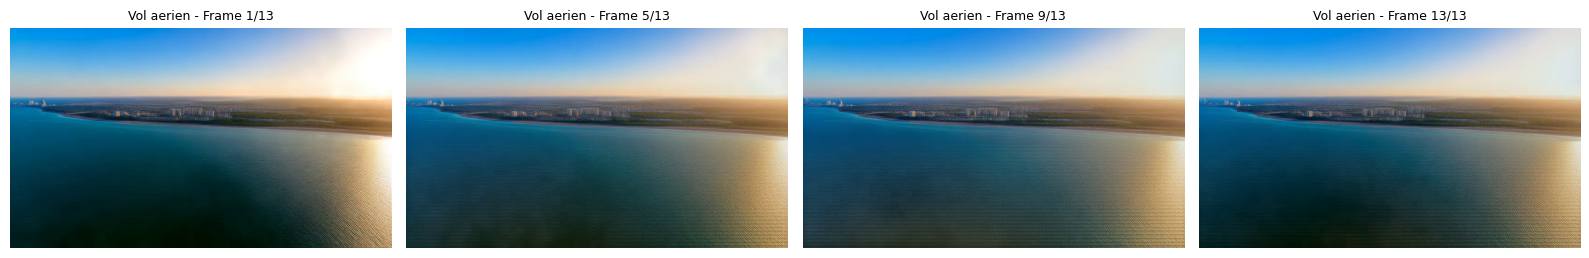
Mouvement       Mode                 Temps (s)
-----------------------------------------------
  Pan lateral     API ComfyUI          28.5
  Zoom avant      API ComfyUI          28.4
  Vol aerien      API ComfyUI          28.5
Exercice 2 : Analyseur de mouvements de camera
Objectif : Implementer une fonction qui genere un catalogue systématique de mouvements de camera et analyse l’efficacite de chaque mot-cle de mouvement dans un prompt.
Wan repond differemment aux mots-cles de mouvement (pan, zoom, drone, tracking). Cet exercice vise a quantifier ces différences.
Indices : - # Étape 1 : Définir le dictionnaire MOTION_KEYWORDS qui mappe chaque type de mouvement a un template de prompt - # Étape 2 : Pour chaque mouvement, construire le prompt complet en combinant le template avec la scene decrite - # Étape 3 : Mesurer la variabilite inter-frames comme indicateur de la qualite du mouvement (différence moyenne entre frames consecutives) - # Indice : utiliser np.mean(np.abs(frame1.astype(float) - frame2.astype(float))) pour mesurer la différence entre deux frames
def analyze_motion_keywords(scene_description: str) -> dict:
    """
    Analyse l'efficacite des mots-cles de mouvement sur une scene donnee.

    Pour chaque type de mouvement, genere le prompt complet et calcule
    un score de variabilite entre frames consecutives.

    Args:
        scene_description: Description de la scene de base (ex: "a mountain lake at sunrise")

    Returns:
        Dict avec pour chaque mouvement : prompt, variabilite_moyenne, score_mouvement
    """
    # Etape 1 : Definir les templates de mouvement
    MOTION_KEYWORDS = {}  # TODO etudiant : completer avec pan, zoom, drone, tracking

    # Etape 2 : Construire les prompts et (si generation disponible) calculer les metriques
    results = {}
    for motion_type, template in MOTION_KEYWORDS.items():
        # TODO etudiant : construire le prompt complet
        pass

    # Etape 3 : Analyser et classer les resultats
    # TODO etudiant : trier par variabilite et retourner
    pass

    return None  # TODO etudiant : retourner les resultats

# Test avec une scene
print("Exercice a completer")
Exercice a completerInterpretation : Contrôle de mouvement
Les mots-cles de mouvement dans le prompt influencent la trajectoire de la camera virtuelle :
| Mot-cle prompt | Mouvement obtenu | Efficacité |
|---|---|---|
| “slow pan” | Panoramique lateral fluide de gauche à droite | Elevee |
| “zoom into” | Rapprochement progressif sur le sujet | Bonne |
| “aerial drone” | Vue plongeante qui survole la scene | Bonne |
Description visuelle : - Pan lateral: La camera se deplace lentement de gauche à droite, decouvrant progressivement le jardin japonais avec ses cerisiers en fleurs - Zoom avant: La camera s’approche du tableau, revelant les details de la peinture du chateau medieval - Vol aerien: Vue plongeante qui survole la ville cotiere, montrant l’etendue du paysage
Section 4 : Ratios d’aspect
Wan supporte différents ratios d’aspect pour s’adapter aux différentes plateformes.
# Test de differents ratios d'aspect
if run_generation:
    print("\n--- RATIOS D'ASPECT ---")
    print("=" * 40)

    aspect_prompt = "a majestic lighthouse standing on a cliff, waves crashing, dramatic sky, golden hour"

    aspect_configs = [
        {"w": 480, "h": 480, "label": "1:1 (480x480)", "name": "square"},
        {"w": 832, "h": 480, "label": "16:9 (832x480)", "name": "landscape"},
        {"w": 480, "h": 832, "label": "9:16 (480x832)", "name": "portrait"},
    ]

    aspect_results = []

    for cfg in aspect_configs:
        print(f"\nTest : {cfg['label']}")

        # Pour le mode local, on doit modifier width/height globaux
        old_width, old_height = width, height
        globals()['width'], globals()['height'] = cfg['w'], cfg['h']

        result = generate_wan_video(aspect_prompt, seed=42, save_prefix=f"wan_{cfg['name']}")

        # Restaurer les valeurs originales
        globals()['width'], globals()['height'] = old_width, old_height

        if result['success']:
            print(f"  [OK] Temps : {result['generation_time']:.1f}s ({result['mode']})")
            if result.get('video_path'):
                mp4 = Path(result['video_path'])
                print(f"     MP4 sauvegarde : {mp4.name} ({mp4.stat().st_size / 1024:.1f} KB)")
            aspect_results.append({**result, **cfg})

            # Affichage planche frames (embed image/png dans l'output cellule).
            # Meme pattern que generate_hunyuan_video de 02-1 (#11026) : 4 frames
            # equidistantes pour visualiser la composition par ratio d'aspect.
            frames = result.get('frames')
            if frames is not None and len(frames) > 0:
                n_display = min(4, len(frames))
                indices = np.linspace(0, len(frames) - 1, n_display, dtype=int)
                fig, axes = plt.subplots(1, n_display, figsize=(4 * n_display, 4))
                if n_display == 1:
                    axes = [axes]
                for j, idx in enumerate(indices):
                    axes[j].imshow(frames[idx])
                    axes[j].set_title(f"{cfg['label']} - Frame {idx+1}/{len(frames)}", fontsize=9)
                    axes[j].axis('off')
                plt.tight_layout()
                plt.show()
        else:
            print(f"  [ERROR] Erreur : {result['error']}")

    # Resume des generations
    if aspect_results:
        print(f"\n{'Ratio':<20} {'Mode':<20} {'Temps (s)':<12}")
        print("-" * 52)
        for ar in aspect_results:
            print(f"  {ar['label']:<20} {ar['mode']:<20} {ar['generation_time']:<12.1f}")
else:
    print("Test ratio d'aspect : generation desactivee")
    print("\nRatios supportes par Wan :")
    print("  1:1  (480x480) : Reseaux sociaux carre")
    print("  16:9 (832x480) : YouTube, cinema")
    print("  9:16 (480x832) : TikTok, Reels, Stories")
--- RATIOS D'ASPECT ---
========================================

Test : 1:1 (480x480)
  [OK] Temps : 14.3s (API ComfyUI)
     MP4 sauvegarde : wan_square_42.mp4 (175.4 KB)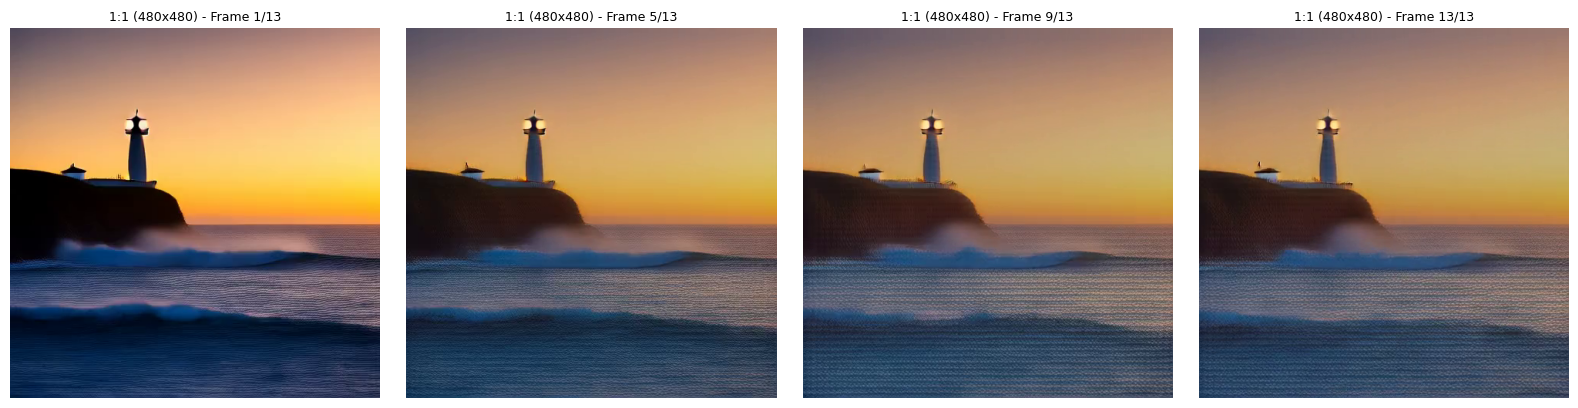
Test : 16:9 (832x480)
  [OK] Temps : 28.5s (API ComfyUI)
     MP4 sauvegarde : wan_landscape_42.mp4 (367.1 KB)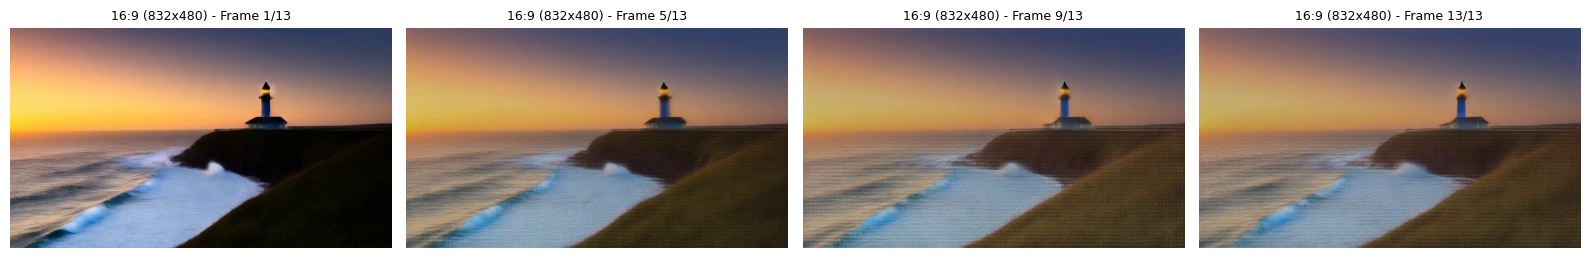
Test : 9:16 (480x832)
  [OK] Temps : 28.6s (API ComfyUI)
     MP4 sauvegarde : wan_portrait_42.mp4 (328.1 KB)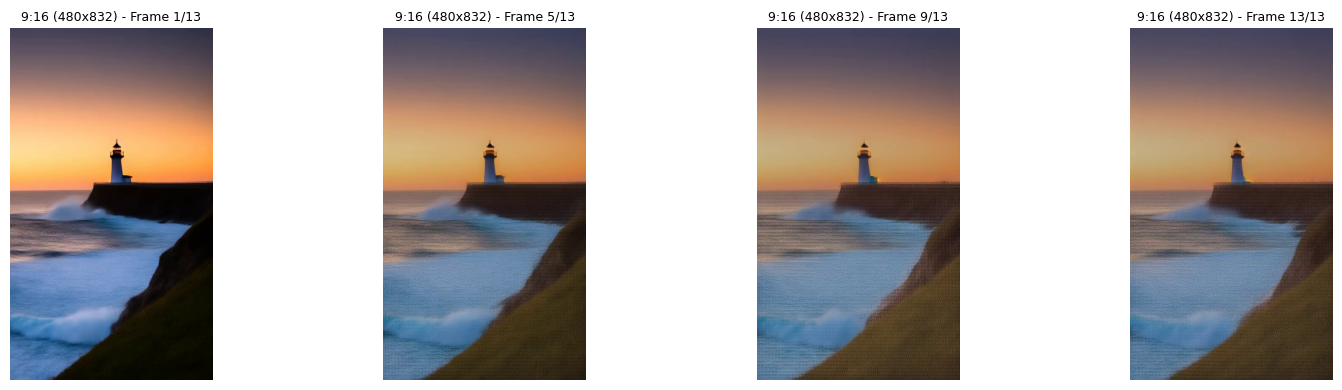
Ratio                Mode                 Temps (s)
----------------------------------------------------
  1:1 (480x480)        API ComfyUI          14.3
  16:9 (832x480)       API ComfyUI          28.5
  9:16 (480x832)       API ComfyUI          28.6
Exercice 3 : Selecteur de configuration par plateforme
Objectif : Créer une fonction qui recommande automatiquement les paramètres optimaux (resolution, ratio, fps, duree) en fonction de la plateforme cible (YouTube, TikTok, Instagram, cinema).
Chaque plateforme impose des contraintes spécifiques que le générateur video doit respecter pour un résultat optimal.
Indices : - # Étape 1 : Définir un dictionnaire PLATFORM_SPECS avec les specs de chaque plateforme (resolution max, ratio, duree max, fps) - # Étape 2 : Implementer la logique de filtrage : si la duree demandee depasse la duree max, la reduire - # Étape 3 : Ajuster la resolution pour respecter le ratio impose par la plateforme - # Indice : YouTube = 16:9, 1080p, 60fps max ; TikTok = 9:16, 1080p, 30fps ; Instagram = 1:1 ou 9:16, 1080p, 30fps
def recommend_platform_config(platform: str, desired_duration: float = 3.0) -> dict:
    """
    Recommande les parametres optimaux pour une plateforme donnee.

    Args:
        platform: Nom de la plateforme ("youtube", "tiktok", "instagram", "cinema")
        desired_duration: Duree souhaitee en secondes

    Returns:
        Dict avec width, height, fps, max_duration, ratio, num_frames
    """
    # Etape 1 : Definir les specifications par plateforme
    # TODO etudiant : completer le dictionnaire PLATFORM_SPECS
    PLATFORM_SPECS = {}  # TODO etudiant

    # Etape 2 : Valider et ajuster la duree
    # TODO etudiant : reduire desired_duration si elle depasse max_duration

    # Etape 3 : Calculer la resolution adaptee au ratio
    # TODO etudiant : ajuster width/height selon le ratio impose

    return None  # TODO etudiant : retourner le dictionnaire de configuration

# Test de la fonction
print("Exercice a completer")
Exercice a completerInterpretation : Ratios d’aspect
| Ratio | Usage | Particularite |
|---|---|---|
| 1:1 (carre) | Instagram, prototypage | Composition centree |
| 16:9 (paysage) | YouTube, cinema | Composition large, horizon |
| 9:16 (portrait) | TikTok, Stories | Composition verticale, sujet central |
Points cles : 1. Le ratio d’aspect influence la composition automatique de la scene 2. Les paysages fonctionnent mieux en 16:9, les portraits en 9:16 3. Le temps de generation est proportionnel au nombre total de pixels (W x H)
Bonnes pratiques et prompt engineering
Structure d’un bon prompt Wan
| Élément | Exemple | Importance |
|---|---|---|
| Sujet | “a majestic eagle” | Essentiel |
| Action | “soaring through clouds” | Essentiel |
| Camera | “aerial tracking shot” | Recommande |
| Eclairage | “golden hour, dramatic light” | Recommande |
| Style | “cinematic, 4K, high quality” | Optionnel |
Prompts en francais vs anglais
| Approche | Avantage | Inconvenient |
|---|---|---|
| Tout FR | Naturel pour le redacteur | Moins de nuances captees |
| Tout EN | Meilleure comprehension | Moins intuitif |
| Mixte | Compromis optimal | Necessite expertise bilingue |
Exemple guide : Création de Vidéo Multilingue avec Wan
Durée estimée : 20-25 minutes
Objectif
Maîtriser la génération de vidéos avec Wan en utilisant des prompts dans différentes langues et en contrôlant le mouvement de caméra.
Instructions
Créez un comparateur multilingue : Implémentez une fonction qui génère la même vidéo à partir de prompts en français, anglais et une autre langue (espagnol, allemand, etc.).
Analysez les différences de qualité : Comparez les résultats visuels et documentez les nuances de chaque langue.
Expérimentez avec les contrôles de mouvement : Testez différents types de mouvement de caméra (pan, zoom, drone, tracking).
Indices :
- Wan comprend mieux les prompts en anglais, mais le français fonctionne bien
- Les mots-clés de mouvement : “slow pan”, “zoom in/out”, “aerial drone shot”, “tracking shot”
- Utilisez le même seed pour comparer équitablement les langues
- Le ratio d’aspect influence la composition (16:9 paysage, 9:16 portrait)
Critères de succès
# Test multilingue
if run_generation:
    # Exercice: Tester avec 3 langues minimum
    base_concept = "a cat sleeping on a sofa"
    # lang_results = generate_multilingual_comparison(base_concept, ["fr", "en", "es"])

    # Exercice: Afficher les comparaisons côte à côte
    # Comparer visuellement les frames de chaque langue

    # Exercice: Tester les mouvements
    scene = "a beautiful japanese garden with cherry blossoms"
    movements = ["pan", "zoom", "drone"]
    # motion_results = test_camera_movements(scene, movements)

    # Exercice: Documenter les observations
    # Quelle langue donne les meilleurs résultats ?
    # Quel mouvement est le plus naturel ?
else:
    print("Test multilingue désactivé (génération non disponible)")
Ce test de generation multilingue exploite la capacite de Wan a comprendre des prompts en plusieurs langues. La cellule suivante implemente le test systématique des mots-cles de mouvement de camera pour explorer les capacites de contrôle cinematographique du modèle.
# Exercice: Fonction de test de mouvement
def test_camera_movements(base_scene: str, movements: List[str]) -> Dict[str, Any]:
    """
    Teste différents mouvements de caméra sur la même scène.

    Args:
        base_scene: Description de la scène (ex: "a mountain landscape")
        movements: Liste de mouvements ["pan", "zoom", "drone"]

    Returns:
        Dict avec les résultats pour chaque mouvement
    """
    # Templates de prompts avec mouvement
    motion_templates = {
        "pan": f"a slow pan across {base_scene}, smooth camera movement",
        "zoom": f"camera slowly zooming into {base_scene}, revealing details",
        "drone": f"aerial drone shot of {base_scene}, birds eye view, cinematic",
        "tracking": f"tracking shot following subject through {base_scene}"
    }

    results = {}

    for movement in movements:
        prompt = motion_templates.get(movement, base_scene)

        # Exercice: Générer avec le mouvement
        pass

        results[movement] = {
            "prompt": prompt,
            "frames": frames
        }

    return results
Le test multilingue valide la comprehension des différentes langues par le modèle. La cellule suivante implemente la fonction de contrôle de mouvement de camera qui utilisera des mots-cles spécifiques dans le prompt.
# Exercice: Fonction de génération multilingue
def generate_multilingual_comparison(base_prompt: str, languages: List[str]) -> Dict[str, Any]:
    """
    Génère la même vidéo dans plusieurs langues.

    Args:
        base_prompt: Concept de base (ex: "a cat sleeping")
        languages: Liste de codes langue ["fr", "en", "es", "de"]

    Returns:
        Dict avec les résultats pour chaque langue
    """
    # Traductions manuelles du concept
    translations = {
        "fr": "un chat dormant sur un canapé",
        "en": "a cat sleeping on a sofa",
        "es": "un gato durmiendo en un sofá",
        "de": "eine Katze schlafft auf einem Sofa"
    }

    results = {}

    for lang in languages:
        prompt = translations.get(lang, base_prompt)

        # Exercice: Générer avec generate_wan_video()
        # Utiliser le même seed pour toutes les langues
        pass

        results[lang] = {
            "prompt": prompt,
            "frames": frames,
            "time": gen_time
        }

    return results
Les fonctions multilingues et de mouvement implementees, la cellule suivante consolide les statistiques de session et presente un bilan des generations effectuees avec les temps de traitement observes.
# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 50)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode d'execution : {mode_str}")
print(f"Modele : {model_id if not use_api else 'wan2.1_t2v_1.3B (ComfyUI)'}")
print(f"Parametres : {num_frames} frames, {num_inference_steps} steps, CFG={guidance_scale}")
print(f"Resolution : {width}x{height}")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files)[:10]:
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")
    if len(generated_files) > 10:
        print(f"  ... et {len(generated_files) - 10} autres fichiers")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 02-4 : SVD - Stable Video Diffusion (animation d'images statiques)")
print(f"2. Module 03-1 : Comparaison benchmark de tous les modeles")
print(f"3. Module 03-2 : Orchestration de pipelines text -> image -> video")
print(f"4. Tester Wan 2.2 quand disponible pour les ameliorations de qualite")

print(f"\nNotebook 02-3 Wan Video Generation termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
==================================================
Date : 2026-08-20 14:13:27
Mode d'execution : API ComfyUI
Modele : wan2.1_t2v_1.3B (ComfyUI)
Parametres : 16 frames, 20 steps, CFG=6.0
Resolution : 832x480

Fichiers generes (8) :
  wan_drone_44.mp4 (281.7 KB)
  wan_en_42.mp4 (107.4 KB)
  wan_fr_42.mp4 (77.3 KB)
  wan_landscape_42.mp4 (367.1 KB)
  wan_pan_42.mp4 (836.5 KB)
  wan_portrait_42.mp4 (328.1 KB)
  wan_square_42.mp4 (175.4 KB)
  wan_zoom_43.mp4 (326.8 KB)

--- PROCHAINES ETAPES ---
1. Notebook 02-4 : SVD - Stable Video Diffusion (animation d'images statiques)
2. Module 03-1 : Comparaison benchmark de tous les modeles
3. Module 03-2 : Orchestration de pipelines text -> image -> video
4. Tester Wan 2.2 quand disponible pour les ameliorations de qualite

Notebook 02-3 Wan Video Generation termine - 14:13:27
Conclusion
Ce notebook a permis d explorer les aspects essentiels de 02 3 wan video generation. Les points cles :
- Les concepts fondamentaux ont ete presentes et illustres
- Les exercices proposent une mise en pratique progressive
- Les résultats obtenus permettent de valider la comprehension
Pour aller plus loin : approfondir les aspects avances du sujet et explorer les liens avec d autres domaines.