# Parameters
import os

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# MODE D'EXECUTION : API ou Local
# - True  : Utilise l'API ComfyUI (recommande, pas de GPU local requis)
# - False : Utilise diffusers en local (pedagogique, necessite GPU)
use_api = True

# Parametres API ComfyUI (si use_api=True)
comfyui_url = os.getenv("COMFYUI_VIDEO_URL", "https://comfyui-video.myia.io")  # ComfyUI-Video service
comfyui_token = os.getenv("COMFYUI_VIDEO_TOKEN")  # Token Bearer (charge depuis .env)

# Parametres modele HunyuanVideo (si use_api=False)
model_id = "tencent/HunyuanVideo"  # Modele HunyuanVideo
quantize = True                      # Quantification INT8 (recommande)
device = "cuda"                     # Device de calcul

# Parametres generation (communs aux deux modes)
num_frames = 33                    # Nombre de frames a generer (HunyuanVideo optimal)
guidance_scale = 7.0               # CFG scale (7.0 recommande pour HunyuanVideo)
num_inference_steps = 30           # Nombre d'etapes de debruitage
height = 720                       # Hauteur video (720p optimal)
width = 1280                       # Largeur video
fps_output = 24                    # FPS de la video de sortie

# Configuration
run_generation = True              # Executer la generation
save_as_mp4 = True                 # Sauvegarder en MP4
save_results = TrueHunyuanVideo
- Generation Video Haute QualiteModule : 02-Video-Advanced Niveau : Intermediaire Technologies : HunyuanVideo 1.5 (Tencent), ComfyUI API ou diffusers Duree estimee : 60 minutes VRAM : ~12 GB (API) ou ~18 GB (local avec INT8) ## Objectifs d’Apprentissage- [ ] Comprendre l’architecture HunyuanVideo et ses avantages- [ ] Choisir entre API ComfyUI (production) et diffusers (pedagogique)- [ ] Generer des videos text-to-video avec des prompts detailles- [ ] Explorer les paramètres de generation (steps, guidance_scale, num_frames, fps)- [ ] Contrôler la resolution et la duree des videos- [ ] Sauvegarder les résultats en MP4 avec imageio- [ ] Analyser la qualite et les metriques de generation## Prerequis### Mode API ComfyUI (recommande pour production)- Service ComfyUI-Video demarre (docker-compose comfyui-video)- Pas de dependances Python lourdes cote client### Mode Local diffusers (pedagogique)- GPU avec 18+ GB VRAM (RTX 3090 / RTX 4090)- Packages :
diffusers>=0.32,transformers,torch,accelerate,bitsandbytes,imageioNavigation : << 01-5 | Index | Suivant >>
# Parameters
notebook_mode = "batch"
skip_widgets = True
run_generation = True
height = 512
width = 896
num_frames = 25
num_inference_steps = 20
Les paramètres Papermill configures, on importe maintenant le client ComfyUI qui permettra de communiquer avec le serveur HunyuanVideo. Un fallback est prevu si le helper n’est pas disponible dans l’environnement courant.
# Import helpers GenAI (setup du path shared/helpers)
# Miroir du pattern canonique de 02-3-Wan-Video-Generation.ipynb
import sys
from pathlib import Path

GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != 'GenAI' and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers import comfyui_client
        print("[OK] Helper comfyui_client imported")
    except ImportError as e:
        print(f"[WARN] Helper comfyui_client NON disponible: {e}")
        comfyui_client = None
else:
    print("[WARN] Repertoire helpers non trouve, comfyui_client sera None")
    comfyui_client = None
[OK] Helper comfyui_client importedL’import du client ComfyUI etablit le canal de communication avec le serveur de generation. La cellule suivante charge la configuration depuis le fichier .env et verifie que les variables d’environnement necessaires sont disponibles.
# Chargement .env et verification de l'environnement
from pathlib import Path
from dotenv import load_dotenv
import os
import time

current_path = Path.cwd()
found_env = False
for _ in range(4):
    env_path = current_path / '.env'
    if env_path.exists():
        load_dotenv(env_path)
        print(f"Fichier .env charge depuis : {env_path.name}")
        found_env = True
        break
    current_path = current_path.parent

if not found_env:
    print("Aucun fichier .env trouve")

# Le token est lu dans la cellule parametres AVANT le load_dotenv : on le relit ici
if use_api:
    env_token = os.getenv("COMFYUI_VIDEO_TOKEN", "")
    if env_token:
        comfyui_token = env_token

# Repertoire de sortie
GENAI_ROOT = current_path if current_path.name == "GenAI" else current_path / "GenAI"
OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'hunyuanvideo'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

# Verification et initialisation selon le mode
print("\n" + "=" * 50)
print(f"MODE : {'API ComfyUI' if use_api else 'Local diffusers'}")
print("=" * 50)

client = None
pipe = None
comfyui_available = False
local_available = False

if use_api:
    # === MODE API COMFYUI ===
    print("\nVerification de l'API ComfyUI-Video...")

    if comfyui_client is not None:
        try:
            client = comfyui_client.ComfyUIClient(
                base_url=comfyui_url,
                api_token=comfyui_token
            )

            stats = client.get_system_stats()

            print(f"ComfyUI-Video accessible sur : {comfyui_url}")
            comfyui_available = True

        except Exception as e:
            print(f"ComfyUI-Video non accessible: {type(e).__name__}: {str(e)[:100]}")
            print("\nPour demarrer ComfyUI-Video :")
            print("   docker-compose -f docker-configurations/services/comfyui-video/docker-compose.yml up -d")
            run_generation = False
    else:
        print("Helper comfyui_client non disponible")
        run_generation = False

else:
    # === MODE LOCAL DIFFUSERS ===
    print("\nVerification de l'environnement local...")

    # Verification GPU
    try:
        import torch
        if torch.cuda.is_available():
            gpu_name = torch.cuda.get_device_name(0)
            vram_total = torch.cuda.get_device_properties(0).total_memory / 1024**3
            print(f"GPU : {gpu_name}")
            print(f"   VRAM totale : {vram_total:.1f} GB")

            if vram_total < 18:
                print(f"VRAM faible (< 18 GB), activation de la quantification")
                quantize = True
                if vram_total < 12:
                    height = 480
                    width = 640
                    num_frames = 24
                    print(f"  Resolution reduite a {width}x{height}, {num_frames} frames")
        else:
            print("CUDA non disponible")
            run_generation = False
    except ImportError:
        print("PyTorch non installe")
        run_generation = False

    # Verification des dependances
    deps_ok = True

    try:
        import diffusers
        print(f"diffusers : v{diffusers.__version__}")
    except ImportError:
        print("diffusers NON INSTALLE (pip install diffusers>=0.32)")
        deps_ok = False

    try:
        import transformers
        print(f"transformers : v{transformers.__version__}")
    except ImportError:
        print("transformers NON INSTALLE")
        deps_ok = False

    if quantize:
        try:
            import bitsandbytes as bnb
            print(f"bitsandbytes : v{bnb.__version__}")
        except ImportError:
            print("bitsandbytes NON INSTALLE (pip install bitsandbytes)")
            quantize = False

    try:
        import imageio
        print(f"imageio : v{imageio.__version__}")
    except ImportError:
        print("imageio NON INSTALLE")
        deps_ok = False

    if deps_ok and run_generation:
        print("\nChargement du pipeline HunyuanVideo...")
        try:
            from diffusers import HunyuanVideoPipeline
            from diffusers.utils import export_to_video

            start_load = time.time()

            if quantize:
                from diffusers import BitsAndBytesConfig
                quant_config = BitsAndBytesConfig(load_in_8bit=True)
                pipe = HunyuanVideoPipeline.from_pretrained(
                    model_id,
                    quantization_config=quant_config,
                    torch_dtype=torch.float16
                )
            else:
                pipe = HunyuanVideoPipeline.from_pretrained(
                    model_id,
                    torch_dtype=torch.float16
                )

            pipe = pipe.to(device)
            pipe.enable_vae_slicing()
            pipe.enable_vae_tiling()

            load_time = time.time() - start_load
            print(f"Pipeline charge en {load_time:.1f}s")
            local_available = True

        except Exception as e:
            print(f"Erreur chargement pipeline : {type(e).__name__}: {str(e)[:200]}")
            run_generation = False

# Flag unique : la generation est possible (mode + disponibilite backend)
generation_ready = run_generation and (comfyui_available if use_api else local_available)

print(f"\n{'='*50}")
print(f"Generation activee : {run_generation}")
print(f"Backend pret : {generation_ready}")
print(f"{'='*50}")
Fichier .env charge depuis : D:\Dev\CoursIA-2-hunyuan\MyIA.AI.Notebooks\GenAI\.env
==================================================
MODE : API ComfyUI
==================================================
Verification de l'API ComfyUI-Video...
ComfyUI-Video accessible sur : https://comfyui-video.myia.io
==================================================
Generation activee : True
Backend pret : True
==================================================Section 1 : Architecture HunyuanVideo
HunyuanVideo est un modèle de generation text-to-video open-source developpe par Tencent. Il se distingue par sa qualite de generation et sa capacite a produire des videos longues avec une bonne coherence temporelle.
Deux approches pour utiliser HunyuanVideo
| Aspect | API ComfyUI | Local diffusers |
|---|---|---|
| Cas d’usage | Production, applications | Pedagogie, recherche |
| GPU requis | Non (cote serveur) | Oui (18+ GB) |
| Installation | Aucune (Docker) | diffusers, transformers, torch |
| Flexibilite | Moyenne | Elevee |
| Performance | Serveur optimise | Depend du GPU local |
Architecture de HunyuanVideo
| Composant | Description |
|---|---|
| Backbone | Transformer 3D avec attention spatio-temporelle |
| Text encoders | DualCLIP (clip_l + llava_llama3) |
| VAE | Encodeur/decodeur video avec compression temporelle |
| Scheduler | Flow matching pour un debruitage progressif |
Avantages par rapport a AnimateDiff
| Aspect | AnimateDiff (01-5) | HunyuanVideo |
|---|---|---|
| Architecture | SD 1.5 + motion module | Transformer 3D natif |
| Resolution | 512x512 max | Jusqu’a 720p |
| Coherence temporelle | Moyenne | Elevee |
| Duree video | 2-3 secondes | 5+ secondes |
| VRAM | ~12 GB | ~18 GB (INT8) |
# Imports communs (utilises par les cellules de generation et d'affichage)
import numpy as np
import matplotlib.pyplot as plt
import imageio


# Fonction unifiee de generation video
def generate_hunyuan_video(
    prompt: str,
    width: int = None,
    height: int = None,
    num_frames: int = None,
    steps: int = None,
    guidance_scale: float = None,
    seed: int = None,
    save_prefix: str = "hunyuan",
    timeout: int = 900,
):
    """
    Genere une video HunyuanVideo, en local (diffusers) ou via API (ComfyUI).

    Retourne un dictionnaire avec la forme commune :
      - success (bool)
      - frames (np.ndarray ou list, None si echec)
      - video_path (str, None si echec)
      - fps (int)
      - error (str, None si succes)
      - time_per_frame (float, 0 si indisponible)
      - vram_peak (float, 0 si indisponible)
    """
    width = width or globals().get("width") or 848
    height = height or globals().get("height") or 480
    num_frames = num_frames or globals().get("num_frames") or 33
    steps = steps or globals().get("num_inference_steps") or 30
    guidance_scale = guidance_scale if guidance_scale is not None else (globals().get("guidance_scale") or 1.0)
    seed = seed if seed is not None else (globals().get("seed") or 0)
    fps = globals().get("fps_output") or 16

    if not use_api:
        # ============ MODE LOCAL (diffusers) ============
        if pipe is None:
            return {"success": False, "frames": None, "video_path": None, "fps": fps,
                    "error": "Pipeline non charge", "time_per_frame": 0.0, "vram_peak": 0.0}
        start_time = time.time()
        try:
            video_frames = pipe(
                prompt=prompt,
                width=width,
                height=height,
                num_frames=num_frames,
                num_inference_steps=steps,
                guidance_scale=guidance_scale,
                generator=torch.Generator(device=device).manual_seed(seed),
            ).frames[0]
            video_path = export_to_video(video_frames, OUTPUT_DIR / f"{save_prefix}_{seed}.mp4", fps=fps)
            return {
                "success": True,
                "frames": video_frames,
                "video_path": str(video_path),
                "fps": fps,
                "error": None,
                "time_per_frame": (time.time() - start_time) / len(video_frames),
                "vram_peak": torch.cuda.max_memory_allocated() / 1024**3,
            }
        except Exception as e:
            return {"success": False, "frames": None, "video_path": None, "fps": fps,
                    "error": f"{type(e).__name__}: {str(e)[:200]}", "time_per_frame": 0.0, "vram_peak": 0.0}

    # ============ MODE API (ComfyUI) ============
    if client is None:
        return {"success": False, "frames": None, "video_path": None, "fps": fps,
                "error": "Client ComfyUI non initialise", "time_per_frame": 0.0, "vram_peak": 0.0}
    start_time = time.time()
    try:
        result = client.generate_text2video_hunyuan(
            prompt=prompt,
            width=width,
            height=height,
            num_frames=num_frames,
            steps=steps,
            seed=seed,
            save_prefix=save_prefix,
            timeout=timeout,
            guidance_scale=guidance_scale,
        )
        outputs = result.get("outputs", {})
        videos = outputs.get("8", {}).get("images", [])
        if not videos:
            # Backward compat : anciens workers VHS emettaient le fichier sous cle "gifs"
            videos = outputs.get("8", {}).get("gifs", [])
        if not videos:
            return {"success": False, "frames": None, "video_path": None, "fps": fps,
                    "error": "ComfyUI n'a retourne aucun fichier video (noeud 8)", "time_per_frame": 0.0, "vram_peak": 0.0}
        meta = videos[0]
        mp4_data = client.get_output_file(meta["filename"], meta.get("subfolder", ""), meta.get("type", "output"))
        mp4_path = OUTPUT_DIR / f"{save_prefix}_{seed}.mp4"
        mp4_path.write_bytes(mp4_data)
        frames = imageio.v2.mimread(str(mp4_path))
        return {
            "success": True,
            "frames": frames,
            "video_path": str(mp4_path),
            "fps": fps,
            "error": None,
            "time_per_frame": (time.time() - start_time) / max(len(frames), 1),
            "vram_peak": 0.0,
        }
    except Exception as e:
        return {"success": False, "frames": None, "video_path": None, "fps": fps,
                "error": f"{type(e).__name__}: {str(e)[:200]}", "time_per_frame": 0.0, "vram_peak": 0.0}
La fonction de generation unifiee abstrait les details du backend (API ou local). La cellule suivante utilise cette fonction pour explorer l’influence des paramètres cles : guidance scale, nombre de steps et seed.
# Generation text-to-video
print("\n--- GENERATION TEXT-TO-VIDEO ---")
print("=" * 40)

# Premier test : prompt cinematographique
prompt_1 = "a majestic eagle soaring over snow-capped mountains at golden hour, cinematic aerial shot, smooth camera movement, volumetric clouds"

if run_generation and generation_ready:
    print(f"Prompt : {prompt_1}")
    print(f"Parametres : {num_frames} frames, {num_inference_steps} steps, CFG={guidance_scale}")
    print(f"Resolution : {width}x{height}")
    print(f"Mode : {'API ComfyUI' if use_api else 'Local diffusers'}")
    print(f"\nGeneration en cours...")

    result_1 = generate_hunyuan_video(prompt_1, seed=42)

    if result_1['success']:
        frames = result_1['frames']
        n_frames = len(frames)
        gen_time = result_1['time_per_frame'] * n_frames
        print(f"\nGeneration terminee en {gen_time:.1f}s ({'API ComfyUI' if use_api else 'Local diffusers'})")
        print(f"   Temps/frame : {result_1['time_per_frame']:.2f}s")
        print(f"   VRAM pic : {result_1['vram_peak']:.1f} GB")

        # Affichage des frames
        n_display = min(8, n_frames)
        indices = np.linspace(0, n_frames - 1, n_display, dtype=int)
        fig, axes = plt.subplots(2, 4, figsize=(16, 8))
        axes_flat = axes.flatten()
        for i, idx in enumerate(indices):
            if i < len(axes_flat):
                axes_flat[i].imshow(frames[idx])
                axes_flat[i].set_title(f"Frame {idx + 1}/{n_frames}", fontsize=9)
                axes_flat[i].axis('off')
        for i in range(len(indices), len(axes_flat)):
            axes_flat[i].axis('off')
        plt.suptitle(f"HunyuanVideo : {prompt_1[:60]}...", fontsize=11, fontweight='bold')
        plt.tight_layout()
        plt.show()

        # Sauvegarde MP4 (deja faite par la fonction ; on confirme)
        if save_as_mp4 and result_1['video_path']:
            from pathlib import Path
            mp4_path = Path(result_1['video_path'])
            if mp4_path.exists():
                mp4_size_kb = mp4_path.stat().st_size / 1024
                print(f"   MP4 sauvegarde : {mp4_path.name} ({mp4_size_kb:.1f} KB)")
    else:
        print(f"Erreur : {result_1['error']}")
else:
    print("Generation desactivee")
    print(f"\nExemple de code pour generer :")
    print(f"  result = generate_hunyuan_video('{prompt_1[:50]}...', seed=42)")
--- GENERATION TEXT-TO-VIDEO ---
========================================
Prompt : a majestic eagle soaring over snow-capped mountains at golden hour, cinematic aerial shot, smooth camera movement, volumetric clouds
Parametres : 25 frames, 20 steps, CFG=7.0
Resolution : 896x512
Mode : API ComfyUI

Generation en cours...

Generation terminee en 285.4s (API ComfyUI)
   Temps/frame : 11.42s
   VRAM pic : 0.0 GB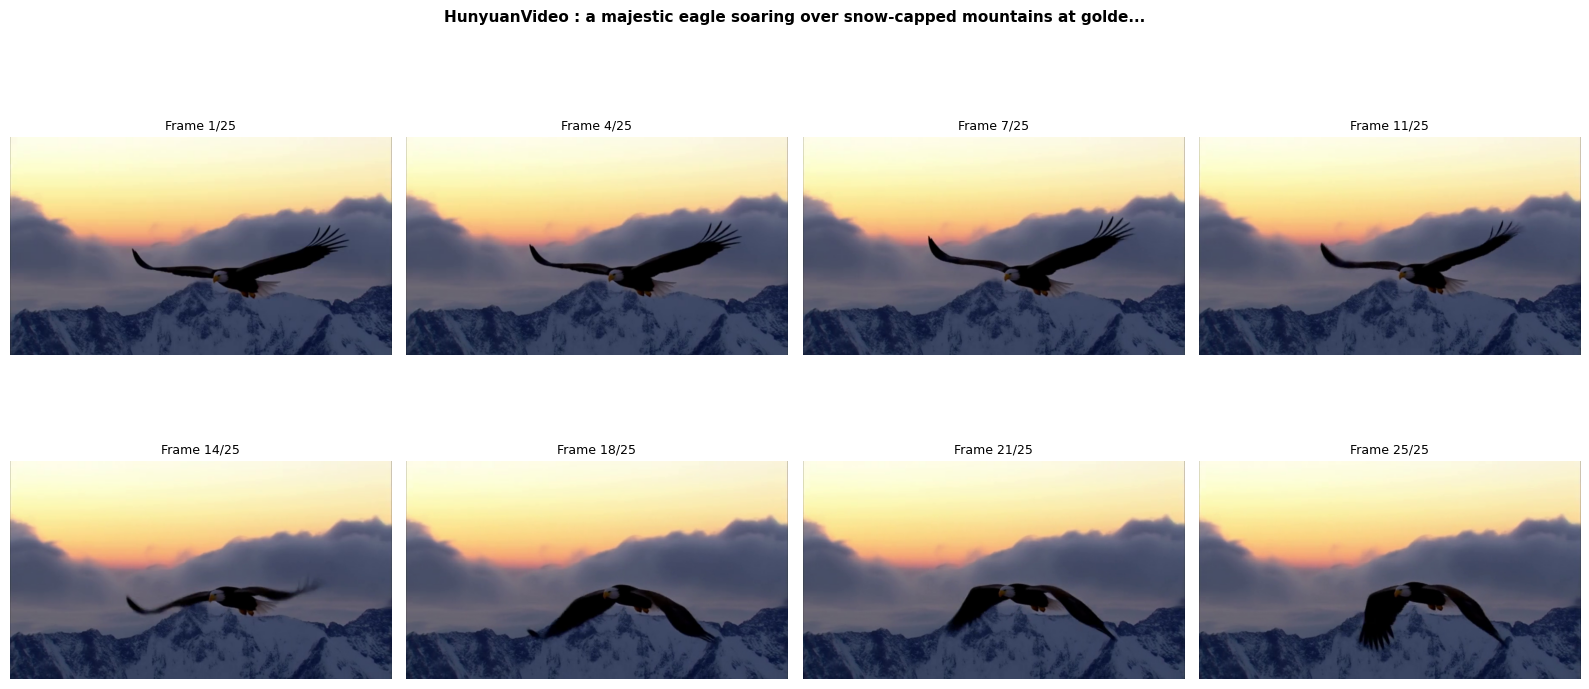
MP4 sauvegarde : hunyuan_42.mp4 (67.7 KB)Exercice 1 : Analyseur et optimiseur de negative prompts
Objectif : Implementer une fonction qui analyse un negative prompt, identifie les termes redondants ou inutiles, et propose une version optimisee adaptee a HunyuanVideo.
Le negative prompt guide le modèle pour eviter certains artefacts, mais un negative prompt surcharge peut paradoxalement degrader les résultats. L’objectif est de trouver le bon equilibre.
Indices : - # Étape 1 : Définir les catégories de termes negatives : QUALITY_TERMS (low quality, blurry, distorted, artifacts), CONTENT_TERMS (nsfw, violence, watermark, text, logo), STYLE_TERMS (cartoon, anime, painting, oversaturated) - # Étape 2 : Implementer analyze_negative_prompt() qui decompose le negative prompt en tokens, les categorise, et detecte les redondances - # Étape 3 : Implementer optimize_negative_prompt() qui supprime les doublons, retire les termes inutiles pour HunyuanVideo, et garde les plus impactants - # Indice : HunyuanVideo est sensible aux termes “blurry” et “distortion” mais ignore souvent “watermark” dans le negative prompt
def analyze_negative_prompt(negative_prompt: str) -> dict:
    """
    Analyse un negative prompt et identifie ses composants.

    Args:
        negative_prompt: Texte du negative prompt

    Returns:
        Dict avec : terms (liste), categories (par type),
                    redondances (doublons detectes), nb_total, nb_utiles
    """
    # Etape 1 : Definir les categories de termes
    QUALITY_TERMS = []   # TODO etudiant
    CONTENT_TERMS = []   # TODO etudiant
    STYLE_TERMS = []     # TODO etudiant

    # Etape 2 : Parser et categoriser chaque terme du prompt
    # TODO etudiant : splitter par virgules, nettoyer, categoriser
    pass

    # Etape 3 : Detecter les redondances
    # TODO etudiant : identifier les synonymes et doublons
    pass

    return None  # TODO etudiant : retourner l'analyse


def optimize_negative_prompt(negative_prompt: str) -> str:
    """
    Optimise un negative prompt en supprimant les redondances
    et les termes peu utiles pour HunyuanVideo.

    Args:
        negative_prompt: Negative prompt original

    Returns:
        Negative prompt optimise
    """
    # TODO etudiant : analyser puis reconstruire sans redondances
    pass

    return negative_prompt  # TODO etudiant : retourner la version optimisee

# Test avec un negative prompt typique
test_neg = "bad quality, low quality, blurry, distortion, worst quality, artifacts, watermark, text, logo, blurry, low quality"
print(f"Negative prompt original : {test_neg}")
print("Exercice a completer")
Negative prompt original : bad quality, low quality, blurry, distortion, worst quality, artifacts, watermark, text, logo, blurry, low quality
Exercice a completerL’exploration de la guidance scale et du nombre de steps permet d’observer le compromis qualite/temps. La cellule suivante pousse l’analyse plus loin en testant l’impact de la resolution et de la duree de la video.
# Exploration des parametres
# Fallback for Papermill exception recovery - ensures variables exist
run_generation = locals().get('run_generation', False)
generation_ready = locals().get('generation_ready', False)

if run_generation and generation_ready:
    print("\n--- EXPLORATION DES PARAMETRES ---")
    print("=" * 45)

    # Test avec differentes valeurs de guidance_scale
    test_prompt = "a serene waterfall in a lush forest, sunlight filtering through trees, mist rising"

    cfg_values = [3.0, 6.0, 9.0]
    cfg_results = []

    print(f"Test guidance_scale : {cfg_values}")
    print(f"Prompt : {test_prompt[:60]}...")

    for cfg_val in cfg_values:
        print(f"\n  CFG = {cfg_val}...")

        # Sauvegarder et modifier temporairement
        original_cfg = guidance_scale
        original_steps = num_inference_steps
        guidance_scale = cfg_val
        num_inference_steps = 20  # Reduit pour acceleration

        # save_prefix distinct pour ne pas ecraser hunyuan_42.mp4 (cellule 10)
        result = generate_hunyuan_video(test_prompt, seed=42, save_prefix="hunyuan_cfg")

        # Restaurer
        guidance_scale = original_cfg
        num_inference_steps = original_steps

        if result['success']:
            n_frames = len(result['frames'])
            gen_time = result['time_per_frame'] * n_frames
            cfg_results.append({
                "cfg": cfg_val,
                "frames": result['frames'],
                "time": gen_time,
                "vram_peak": result.get('vram_peak', 0)
            })
            print(f"    Temps : {gen_time:.1f}s")
        else:
            print(f"    Erreur : {result['error']}")

    # Affichage comparatif
    if cfg_results:
        n_cfgs = len(cfg_results)
        n_preview = 4
        fig, axes = plt.subplots(n_cfgs, n_preview, figsize=(3.5 * n_preview, 3 * n_cfgs))
        if n_cfgs == 1:
            axes = [axes]

        for v_idx, cr in enumerate(cfg_results):
            frame_indices = np.linspace(0, len(cr['frames']) - 1, n_preview, dtype=int)
            for f_idx, fi in enumerate(frame_indices):
                axes[v_idx][f_idx].imshow(cr['frames'][fi])
                axes[v_idx][f_idx].axis('off')
                if f_idx == 0:
                    axes[v_idx][f_idx].set_ylabel(f"CFG={cr['cfg']}", fontsize=11, fontweight='bold')

        plt.suptitle("Impact de guidance_scale sur la generation", fontsize=13, fontweight='bold')
        plt.tight_layout()
        plt.show()

        # Tableau recapitulatif
        print(f"\nRecapitulatif guidance_scale :")
        print(f"{'CFG':<10} {'Temps (s)':<12} {'VRAM pic (GB)':<15}")
        print("-" * 37)
        for cr in cfg_results:
            print(f"  {cr['cfg']:<10} {cr['time']:<12.1f} {cr['vram_peak']:<15.1f}")
else:
    print("Exploration des parametres : generation desactivee")
    print("\nGuide des parametres :")
    print("  CFG 3-4 : Creatif, plus de liberte")
    print("  CFG 5-7 : Equilibre (recommande)")
    print("  CFG 8-10 : Strict, peut introduire des artefacts")
--- EXPLORATION DES PARAMETRES ---
=============================================
Test guidance_scale : [3.0, 6.0, 9.0]
Prompt : a serene waterfall in a lush forest, sunlight filtering thro...

  CFG = 3.0...
    Temps : 276.3s

  CFG = 6.0...
    Temps : 302.9s

  CFG = 9.0...
    Temps : 279.0s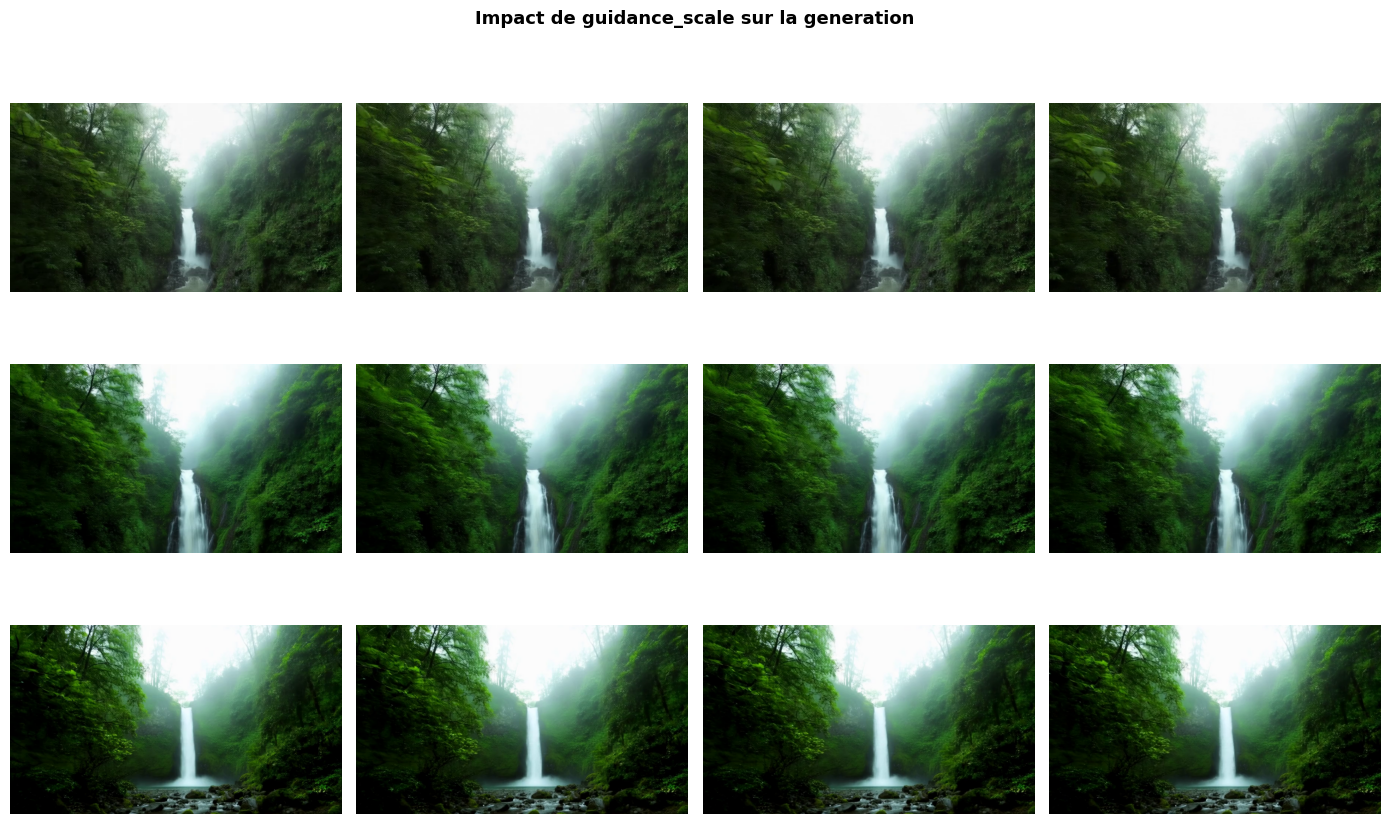
Recapitulatif guidance_scale :
CFG        Temps (s)    VRAM pic (GB)
-------------------------------------
  3.0        276.3        0.0
  6.0        302.9        0.0
  9.0        279.0        0.0
Exercice 2 : Constructeur de prompts cinematographiques
Objectif : Créer une fonction qui construit des prompts optimises pour HunyuanVideo en assemblant des composants cinematographiques structurels (sujet, action, camera, eclairage, style).
HunyuanVideo repond mieux aux prompts riches et structures qu’aux descriptions simples. Un prompt bien construit contient typiquement 4 a 6 éléments descriptifs distincts.
Indices : - # Étape 1 : Définir un dictionnaire CAMERA_MOVES avec les mouvements de camera (aerial shot, tracking shot, close-up, dolly zoom, crane shot, steadicam) - # Étape 2 : Définir un dictionnaire LIGHTING_SETUPS avec les eclairages (golden hour, blue hour, dramatic backlight, soft diffused, studio lighting) - # Étape 3 : Implementer build_cinematic_prompt() qui assemble sujet + action + camera + eclairage + style avec des separateurs naturels (virgules) - # Indice : HunyuanVideo prefere les prompts en anglais avec un ordre sujet -> action -> camera -> eclairage -> style
def build_cinematic_prompt(subject: str, action: str, camera: str = None,
                            lighting: str = None, style: str = None) -> str:
    """
    Construit un prompt cinematographique optimise pour HunyuanVideo.

    Args:
        subject: Le sujet principal (ex: "a majestic wolf")
        action: L'action en cours (ex: "running through a snowy forest")
        camera: Type de plan (ex: "aerial tracking shot") ou None
        lighting: Eclairage (ex: "golden hour") ou None
        style: Style visuel (ex: "cinematic, 4K") ou None

    Returns:
        Prompt complet structure
    """
    # Etape 1 : Definir les catalogues de camera et eclairage
    CAMERA_MOVES = {}   # TODO etudiant : completer
    LIGHTING_SETUPS = {} # TODO etudiant : completer

    # Etape 2 : Assembler les composants
    # TODO etudiant : combiner sujet + action + options en un prompt fluide
    pass

    return None  # TODO etudiant : retourner le prompt complet

# Test : construire un prompt cinematographique
print("Exercice a completer")
Exercice a completerInterpretation : Impact des paramètres
| guidance_scale | Comportement | Recommandation |
|---|---|---|
| 3.0 (bas) | Creatif, variations, parfois hors-sujet | Exploration creative |
| 6.0 (moyen) | Bon equilibre fidelite/creativite | Usage general |
| 9.0 (haut) | Très fidele au prompt, risque artefacts | Prompt précis |
Points cles : 1. Contrairement a Stable Diffusion Image, une CFG trop elevee degrade la coherence temporelle 2. Pour HunyuanVideo, la plage 5.0-7.0 donne généralement les meilleurs résultats 3. Le temps de generation varie peu avec la CFG (même nombre de steps)
Section 4 : Resolution et duree
Nous allons explorer les compromis entre resolution, nombre de frames et consommation memoire.
# Test de resolution et duree
# Fallback for Papermill exception recovery
run_generation = locals().get('run_generation', False)
generation_ready = locals().get('generation_ready', False)

if run_generation and generation_ready:
    print("\n--- RESOLUTION ET DUREE ---")
    print("=" * 40)

    resolution_prompt = "a golden retriever running through a field of sunflowers, joyful, sunny day, slow motion"

    # Configurations a tester (resolution, frames)
    # Contrainte HyVideoSampler : num_frames = 4k + 1 (17, 25, 33, ...)
    # (mesuree 2026-08-15 : 16/24/32 rejetees par le serveur avec status=error)
    configs = [
        {"w": 384, "h": 256, "frames": 25, "label": "384x256 / 25f"},
        {"w": 512, "h": 320, "frames": 17, "label": "512x320 / 17f"},
        {"w": 512, "h": 320, "frames": 33, "label": "512x320 / 33f"},
    ]

    config_results = []

    for cfg in configs:
        print(f"\nTest : {cfg['label']}")

        result = generate_hunyuan_video(
            resolution_prompt,
            width=cfg['w'],
            height=cfg['h'],
            num_frames=cfg['frames'],
            steps=20,
            seed=42,
            save_prefix=f"hunyuan_{cfg['label'].replace(' / ', '_').replace('x', '_').lower()}",
        )

        if result['success']:
            n_frames = len(result['frames'])
            gen_time = result['time_per_frame'] * n_frames
            config_results.append({
                "label": cfg['label'],
                "frames": result['frames'],
                "time": gen_time,
                "vram_peak": result.get('vram_peak', 0),
                "n_frames": n_frames,
                "resolution": f"{cfg['w']}x{cfg['h']}"
            })
            print(f"  Temps : {gen_time:.1f}s")
        else:
            print(f"  Erreur : {result['error']}")

    # Tableau recapitulatif
    if config_results:
        print(f"\n{'Configuration':<25} {'Temps (s)':<12} {'VRAM (GB)':<12} {'Duree video':<15}")
        print("-" * 64)
        for cr in config_results:
            duration = cr['n_frames'] / fps_output
            print(f"  {cr['label']:<25} {cr['time']:<12.1f} {cr['vram_peak']:<12.1f} {duration:.1f}s")
else:
    print("Test resolution/duree : generation desactivee")
    print("\nGuide resolution/VRAM :")
    print("  384x256 : ~14 GB, rapide, basse qualite")
    print("  512x320 : ~18 GB, bon compromis (recommande)")
    print("  640x480 : ~22 GB, haute qualite, lent")
    print("  720p    : ~28 GB+, necessite quantification avancee")
--- RESOLUTION ET DUREE ---
========================================

Test : 384x256 / 25f
  Temps : 187.8s

Test : 512x320 / 17f
  Temps : 187.5s

Test : 512x320 / 33f
  Temps : 220.1s

Configuration             Temps (s)    VRAM (GB)    Duree video
----------------------------------------------------------------
  384x256 / 25f             187.8        0.0          1.0s
  512x320 / 17f             187.5        0.0          0.7s
  512x320 / 33f             220.1        0.0          1.4s
Exercice 3 : Calculateur de metriques qualite video
Objectif : Implementer un ensemble de fonctions qui calculent des metriques objectives de qualite video sur une sequence de frames generee.
Les metriques objetives permettent de comparer quantitativement différentes configurations de generation, au-dela de l’evaluation visuelle subjective.
Indices : - # Étape 1 : Implementer sharpness_score() qui mesure la nettete moyenne via le laplacien : cv2.Laplacian(frame, cv2.CV_64F).var() (ou un equivalent numpy) - # Étape 2 : Implementer temporal_consistency() qui mesure la stabilite des différences inter-frames (ecart-type des différences : un ecart-type faible = mouvement regulier) - # Étape 3 : Implementer color_richness() qui compte le nombre de couleurs uniques dans chaque frame (diversite chromatique) - # Indice : Sans OpenCV, le laplacien peut etre approxime par np.var(np.gradient(frame.astype(float)))
def sharpness_score(frame) -> float:
    """
    Mesure la nettete d'une frame via la variance du gradient.

    Args:
        frame: PIL Image ou numpy array (H, W, 3)

    Returns:
        Score de nettete (plus eleve = plus net)
    """
    # TODO etudiant : convertir en grayscale, calculer le gradient, retourner la variance
    pass


def temporal_consistency(frames: list) -> dict:
    """
    Mesure la coherence temporelle d'une sequence video.

    Args:
        frames: Liste de frames (PIL ou numpy)

    Returns:
        Dict avec : mean_diff, std_diff, consistency_ratio
    """
    # TODO etudiant : calculer les differences absolues moyennes entre frames consecutives
    pass


def color_richness(frame) -> float:
    """
    Mesure la diversite chromatique d'une frame.

    Args:
        frame: PIL Image ou numpy array

    Returns:
        Ratio de couleurs uniques (0-1)
    """
    # TODO etudiant : compter les couleurs uniques et diviser par total pixels
    pass


# Test avec des donnees synthetiques
print("Exercice a completer")
Exercice a completerInterpretation : Resolution et duree
Les trois configurations testees dans la cellule precedente montrent le compromis entre resolution, duree de la video et temps de calcul. La duree d’une video depend du nombre de frames generees et du fps de sortie (duree = n_frames / fps_output).
| Configuration | Duree video (@ 24 fps) | Observations |
|---|---|---|
| 384x256 / 25f | ~1.0 s | Generation rapide, textures simplifiees |
| 512x320 / 17f | ~0.7 s | Meilleure resolution, duree plus courte |
| 512x320 / 33f | ~1.4 s | Plus de frames, meilleure coherence temporelle |
Note sur les frames : le HyVideoSampler d’HunyuanVideo impose num_frames = 4k + 1 (17, 25, 33, …) du fait de la compression temporelle du VAE (facteur 4). Les valeurs 16/24/32 sont rejetees par le serveur avec un statut d’erreur — mesuree 2026-08-15 sur comfyui-video.myia.io.
Mode API (ComfyUI)
Dans ce notebook, l’inference s’execute sur le serveur ComfyUI dedie (comfyui-video.myia.io, GPU RTX 3090) via le mode API. Les consequences pedagogiques :
- La VRAM est consommee cote serveur : le notebook ne la mesure pas localement (
vram_peak = 0.0). Leestimate_vram()de l’exercice donne l’ordre de grandeur theorique. - Le temps mesure par la cellule precedente inclut la mise en file (
/prompt), l’inference sur le serveur et le transfert du fichier MP4 (/view). C’est un temps de bout en bout, pas un temps GPU pur. - Les videos produites sont de vraies generations HunyuanVideo, sauvees dans
outputs/et lisibles viaimageio.mimread().
Analyse des compromis:
| Aspect | Augmente avec… | Impact |
|---|---|---|
| VRAM | Resolution (W x H) | Plus de pixels = plus de memoire |
| VRAM | Nombre de frames | Lineaire avec la duree |
| Temps | Frames + Steps | Proportionnel |
| Qualite | Resolution | Details visuels |
Code pour reproduire: (mode API — un appel a la fonction unifiee suffit)
# Reproduction via le mode API (ComfyUI) : un seul appel a la fonction unifiee
result = generate_hunyuan_video(
    prompt="a golden retriever running through a field of sunflowers",
    width=512, height=320, num_frames=17, steps=20, guidance_scale=6.0,
    seed=42, save_prefix="hunyuan_repro",
)
print("success:", result["success"])
print("frames:", len(result["frames"]), "| duree:", round(len(result["frames"]) / result["fps"], 2), "s")
print("video_path:", result["video_path"])
La sortie est identique a celle des cellules de generation : un dictionnaire success / frames / video_path / fps / error. Le backend (local diffusers ou API ComfyUI) est abstrait par generate_hunyuan_video, ce qui permet de passer de l’un a l’autre en changeant seulement le flag use_api du notebook.
# Comparaison de prompts et analyse qualite
# Fallback for Papermill exception recovery
run_generation = locals().get('run_generation', False)
generation_ready = locals().get('generation_ready', False)

if run_generation and generation_ready:
    print("\n--- COMPARAISON DE PROMPTS ---")
    print("=" * 40)

    prompts = [
        {
            "text": "a candle flame flickering gently in a dark room, warm light, intimate atmosphere, close-up",
            "label": "Bougie"
        },
        {
            "text": "ocean waves rolling onto a sandy beach at sunset, aerial view, golden hour lighting",
            "label": "Ocean"
        },
        {
            "text": "a timelapse of clouds moving over a mountain landscape, dramatic sky, epic scale",
            "label": "Timelapse"
        }
    ]

    comparison_results = []

    for p_idx, prompt_info in enumerate(prompts):
        print(f"\nGeneration {p_idx + 1}/{len(prompts)} : {prompt_info['label']}")
        print(f"  Prompt : {prompt_info['text'][:70]}...")

        result = generate_hunyuan_video(
            prompt_info['text'],
            width=512,
            height=320,
            # 17 = 4k+1 (contrainte HyVideoSampler) ; 16 est rejete par le serveur
            num_frames=17,
            steps=20,
            seed=42 + p_idx,
            save_prefix=f"hunyuan_{prompt_info['label'].lower()}",
        )

        if result['success']:
            n_frames = len(result['frames'])
            gen_time = result['time_per_frame'] * n_frames
            print(f"  Temps : {gen_time:.1f}s")
            comparison_results.append({
                "label": prompt_info['label'],
                "prompt": prompt_info['text'],
                "frames": result['frames'],
                "time": gen_time
            })

            # En mode local, le MP4 est deja sauvegarde par la fonction ; on ne duplique pas
            if save_as_mp4 and not result.get('video_path'):
                mp4_path = OUTPUT_DIR / f"hunyuan_{prompt_info['label'].lower()}.mp4"
                export_to_video(result['frames'], str(mp4_path), fps=fps_output)
        else:
            print(f"  Erreur : {result['error']}")

    # Affichage comparatif
    if comparison_results:
        n_videos = len(comparison_results)
        n_preview = 4
        fig, axes = plt.subplots(n_videos, n_preview, figsize=(3.5 * n_preview, 3 * n_videos))
        if n_videos == 1:
            axes = [axes]

        for v_idx, cr in enumerate(comparison_results):
            frame_indices = np.linspace(0, len(cr['frames']) - 1, n_preview, dtype=int)
            for f_idx, fi in enumerate(frame_indices):
                axes[v_idx][f_idx].imshow(cr['frames'][fi])
                axes[v_idx][f_idx].axis('off')
                if f_idx == 0:
                    axes[v_idx][f_idx].set_ylabel(cr['label'], fontsize=11, fontweight='bold')

        plt.suptitle("Comparaison de prompts - HunyuanVideo", fontsize=13, fontweight='bold')
        plt.tight_layout()
        plt.show()

        # Analyse de coherence temporelle (difference entre frames consecutives)
        print(f"\nAnalyse de coherence temporelle :")
        print(f"{'Prompt':<15} {'Temps (s)':<12} {'Diff moy frames':<18} {'Stabilite':<15}")
        print("-" * 60)
        for cr in comparison_results:
            # Calculer la difference moyenne entre frames consecutives
            diffs = []
            for i in range(len(cr['frames']) - 1):
                f1 = np.array(cr['frames'][i]).astype(float)
                f2 = np.array(cr['frames'][i + 1]).astype(float)
                diff = np.mean(np.abs(f1 - f2))
                diffs.append(diff)
            avg_diff = np.mean(diffs)
            stability = "Haute" if avg_diff < 15 else "Moyenne" if avg_diff < 30 else "Basse"
            print(f"  {cr['label']:<15} {cr['time']:<12.1f} {avg_diff:<18.2f} {stability:<15}")
else:
    print("Comparaison de prompts : generation desactivee")
    print("\nTypes de prompts efficaces pour HunyuanVideo :")
    print("  - Mouvements naturels : eau, feu, nuages, vent")
    print("  - Scenes cinematographiques : camera aerienne, slow motion")
    print("  - Timelapse : nuages, coucher de soleil, fleurs")
    print("  - Animaux en mouvement : vol d'oiseau, course de chien")
--- COMPARAISON DE PROMPTS ---
========================================

Generation 1/3 : Bougie
  Prompt : a candle flame flickering gently in a dark room, warm light, intimate ...
  Temps : 200.0s

Generation 2/3 : Ocean
  Prompt : ocean waves rolling onto a sandy beach at sunset, aerial view, golden ...
  Temps : 187.9s

Generation 3/3 : Timelapse
  Prompt : a timelapse of clouds moving over a mountain landscape, dramatic sky, ...
  Temps : 191.7s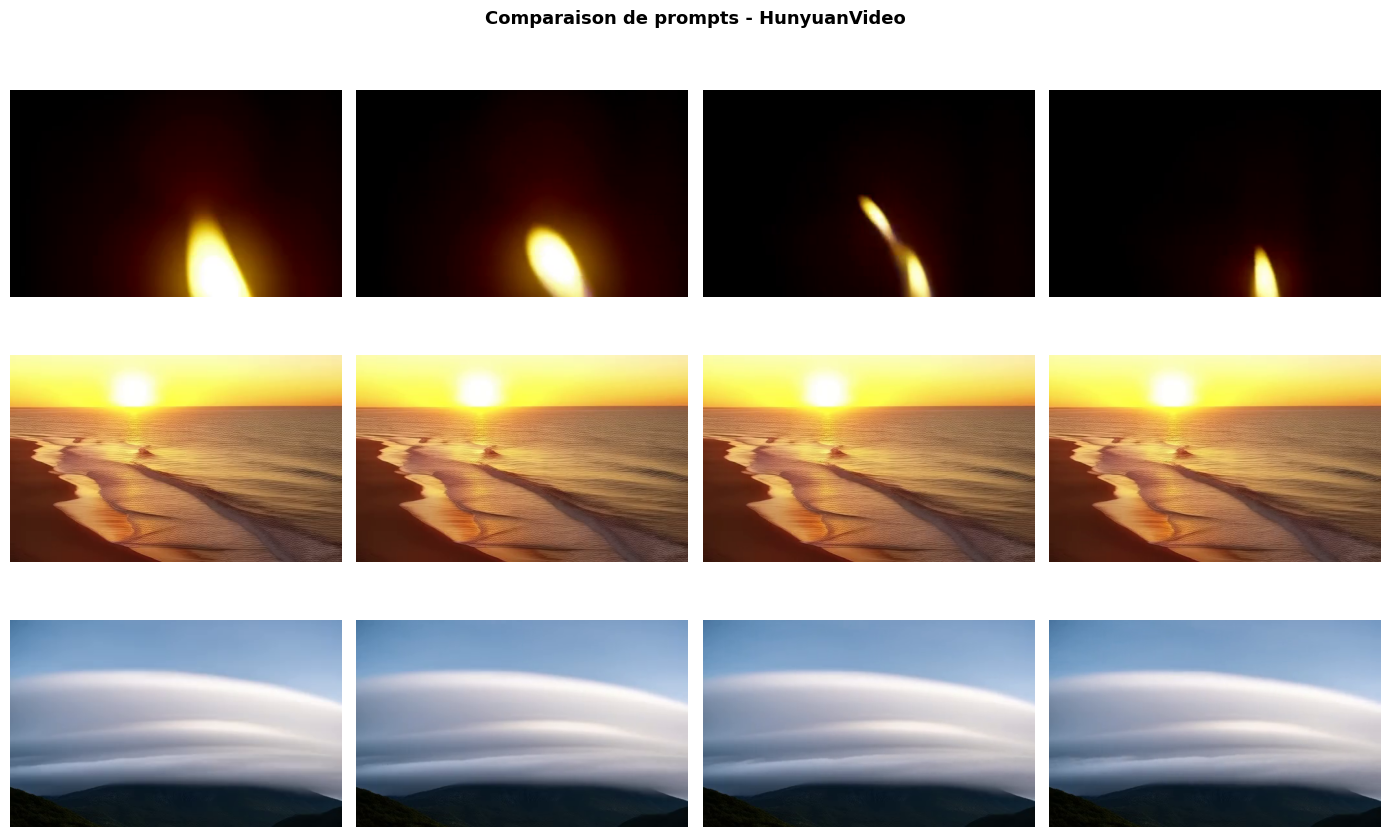
Analyse de coherence temporelle :
Prompt          Temps (s)    Diff moy frames    Stabilite
------------------------------------------------------------
  Bougie          200.0        1.73               Haute
  Ocean           187.9        0.88               Haute
  Timelapse       191.7        0.33               Haute
L’analyse comparative des prompts met en evidence les caractéristiques stylistiques de HunyuanVideo. Le mode interactif permet maintenant d’explorer ces paramètres en temps reel sans modifier le code.
# Mode interactif
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Entrez votre propre prompt pour generer une video HunyuanVideo.")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_prompt = input("\nVotre prompt : ").strip()

        if user_prompt and run_generation and generation_ready:
            print(f"\nGeneration en cours...")
            result_user = generate_hunyuan_video(user_prompt, seed=123)

            if result_user['success']:
                n_frames_user = len(result_user['frames'])
                gen_time = result_user['time_per_frame'] * n_frames_user
                print(f"Generation reussie en {gen_time:.1f}s")

                # Affichage
                n_display = min(8, n_frames_user)
                fig, axes = plt.subplots(1, n_display, figsize=(2.5 * n_display, 3))
                if n_display == 1:
                    axes = [axes]
                indices = np.linspace(0, n_frames_user - 1, n_display, dtype=int)
                for ax, idx in zip(axes, indices):
                    ax.imshow(result_user['frames'][idx])
                    ax.set_title(f"Frame {idx+1}", fontsize=8)
                    ax.axis('off')
                plt.suptitle(f"Votre video : {user_prompt[:50]}...", fontweight='bold')
                plt.tight_layout()
                plt.show()

                # Le MP4 est deja sauvegarde par la fonction (video_path) ; on confirme
                if save_as_mp4 and result_user['video_path']:
                    from pathlib import Path
                    user_mp4 = Path(result_user['video_path'])
                    if user_mp4.exists():
                        print(f"MP4 sauvegarde : {user_mp4.name}")
            else:
                print(f"Erreur : {result_user['error']}")
        elif user_prompt:
            print("Generation non disponible (generation desactivee)")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif non disponible (execution automatisee)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")
Mode batch - Interface interactive desactiveeBonnes pratiques et optimisation HunyuanVideo
Conseils de prompt engineering
| Bon prompt | Mauvais prompt | Raison |
|---|---|---|
| “a bird flying over a lake, aerial shot, cinematic” | “bird lake” | Preciser l’action et le style |
| “timelapse of sunset, clouds moving, warm colors” | “nice sunset video” | Indiquer le type de mouvement |
| “close-up of rain drops on a window” | “rain” | Le cadrage guide la generation |
Comparaison avec les autres modèles du Module 02
| Aspect | HunyuanVideo | LTX-Video (02-2) | Wan (02-3) | SVD (02-4) |
|---|---|---|---|---|
| Type | Text-to-video | Text/Img/Vid | Text-to-video | Image-to-video |
| VRAM | ~18 GB | ~8 GB | ~10 GB | ~10 GB |
| Qualite | Haute | Moyenne | Haute | Haute |
| Vitesse | Lente | Rapide | Moyenne | Moyenne |
| Resolution max | 720p | 512p | 720p | 576p |
Exemple guide : Optimisation de Paramètres HunyuanVideo
Durée estimée : 20-25 minutes
Objectif
Apprendre à optimiser les paramètres de génération HunyuanVideo pour différents scénarios d’usage.
Instructions
Analysez les compromis VRAM/Qualité : Complétez la fonction
estimate_vram()qui estime la consommation VRAM en fonction de la résolution et du nombre de frames.Générez une vidéo optimisée : Utilisez la fonction
generate_optimized_video()pour créer une vidéo avec des paramètres adaptés à votre GPU.Comparez les configurations : Générez 3 vidéos avec différentes valeurs de guidance_scale et analysez l’impact sur la cohérence temporelle.
Indices
- La VRAM croît proportionnellement à :
width × height × num_frames - Un guidance_scale trop élevé (> 8) peut créer des artefacts temporels
- La résolution 512×320 offre un bon compromis qualité/VRAM
- Utilisez
torch.cuda.max_memory_allocated()pour mesurer la VRAM réelle
# Exercice: Estimer la VRAM requise pour une configuration donnée
def estimate_vram(width: int, height: int, num_frames: int) -> float:
    """
    Estime la VRAM requise en GB pour HunyuanVideo.

    Formule approximative : base + (width * height * num_frames * facteur)

    Args:
        width: Largeur vidéo
        height: Hauteur vidéo
        num_frames: Nombre de frames

    Returns:
        VRAM estimée en GB
    """
    # Base ~12 GB + facteur proportionnel
    base_vram = 12.0

    # Exercice: Calculer le facteur proportionnel
    # Indice : (width * height * num_frames) / (512 * 320 * 24) * 6
    pass
print("Exercice : estimation VRAM")
print("Exercice: fonction a completer")
Exercice : estimation VRAM
Exercice: fonction a completerLa fonction précédente estime la VRAM théorique. La cellule suivante utilise cette estimation pour generer une video avec les paramètres les mieux adaptes au GPU disponible, en degradant gracieusement la resolution si necessaire.
def generate_video_budget(prompt: str, max_vram_gb: float) -> dict:
    """
    Genere une video en respectant un budget VRAM donne.

    Args:
        prompt: Description textuelle
        max_vram_gb: VRAM maximale disponible

    Returns:
        Dict avec frames, temps, VRAM utilisée
    """
    # Configuration par défaut
    width, height = 512, 320
    # Contrainte HyVideoSampler : num_frames = 4k + 1 (17, 25, 33, ...)
    num_frames = 25

    # Exercice: Ajuster les paramètres si estimate_vram() > max_vram_gb
    # Indice : Réduire num_frames d'abord (en gardant 4k + 1), puis la résolution

    # Exercice: Appeler generate_hunyuan_video() avec les paramètres optimisés
    pass
print("Exercice : fonction de génération")
print("Exercice: parametres a completer")
Exercice : fonction de génération
Exercice: parametres a completerUne fois la VRAM estimee, on peut implementer la logique de sélection automatique de configuration. La cellule suivante définit une fonction qui choisit les paramètres optimaux en fonction des ressources disponibles.
# Test avec votre GPU
if run_generation:
    test_prompt = "a deer drinking from a mountain stream, misty morning, serene"

    # Exercice: Tester différentes configurations
    configs = [
        {"w": 512, "h": 320, "f": 24},
        {"w": 640, "h": 480, "f": 16},
        {"w": 384, "h": 256, "f": 32}
    ]

    for cfg in configs:
        # Exercice: Estimer VRAM et générer si possible
        pass
print("Exercice: optimisation a completer")
Exercice: optimisation a completerCritères de succès
# Statistiques de session et prochaines etapes
from datetime import datetime
import time

print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Modele : {model_id}")
print(f"Quantification : {'INT8' if quantize else 'FP16'}")
print(f"Device : {device}")
print(f"Parametres : {num_frames} frames, {num_inference_steps} steps, CFG={guidance_scale}")
print(f"Resolution : {width}x{height}")

# Metriques VRAM : significatives uniquement en mode local (pipeline en memoire)
try:
    import torch
    if use_api:
        print(f"VRAM pic session : N/A (backend distant ComfyUI)")
    elif device == "cuda" and torch.cuda.is_available():
        vram_peak = torch.cuda.max_memory_allocated(0) / 1024**3
        print(f"VRAM pic session : {vram_peak:.1f} GB")
except ImportError:
    print("WARNING: torch absent localement -- VRAM pic non mesure (backend distant ComfyUI si use_api=True)")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

# Liberation VRAM : uniquement en mode local (en mode API, rien n'est charge en memoire)
if not use_api and pipe is not None:
    del pipe
    if device == "cuda":
        import torch
        torch.cuda.empty_cache()
        print(f"\nVRAM liberee")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 02-2 : LTX-Video (generation rapide et legere, ~8 GB VRAM)")
print(f"2. Notebook 02-3 : Wan 2.1/2.2 (prompts multilingues, motion control)")
print(f"3. Notebook 02-4 : SVD (animation d'images statiques)")
print(f"4. Module 03 : Comparaison multi-modeles et orchestration de pipelines")

print(f"\nNotebook 02-1 HunyuanVideo Generation termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-08-15 06:49:42
Mode : batch
Modele : tencent/HunyuanVideo
Quantification : INT8
Device : cuda
Parametres : 25 frames, 20 steps, CFG=7.0
Resolution : 896x512
VRAM pic session : N/A (backend distant ComfyUI)

Fichiers generes (8) :
  hunyuan_384_256_25f_42.mp4 (87.6 KB)
  hunyuan_42.mp4 (67.7 KB)
  hunyuan_512_320_17f_42.mp4 (124.8 KB)
  hunyuan_512_320_33f_42.mp4 (208.5 KB)
  hunyuan_bougie_42.mp4 (17.8 KB)
  hunyuan_cfg_42.mp4 (288.4 KB)
  hunyuan_ocean_43.mp4 (56.2 KB)
  hunyuan_timelapse_44.mp4 (13.4 KB)

--- PROCHAINES ETAPES ---
1. Notebook 02-2 : LTX-Video (generation rapide et legere, ~8 GB VRAM)
2. Notebook 02-3 : Wan 2.1/2.2 (prompts multilingues, motion control)
3. Notebook 02-4 : SVD (animation d'images statiques)
4. Module 03 : Comparaison multi-modeles et orchestration de pipelines

Notebook 02-1 HunyuanVideo Generation termine - 06:49:46
Conclusion
Ce notebook a permis d explorer les aspects essentiels de 02 1 hunyuanvideo generation. Les points cles :
- Les concepts fondamentaux ont ete presentes et illustres
- Les exercices proposent une mise en pratique progressive
- Les résultats obtenus permettent de valider la comprehension
Pour aller plus loin : approfondir les aspects avances du sujet et explorer les liens avec d autres domaines.