# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres modele
base_model = "stable-diffusion-v1-5/stable-diffusion-v1-5"  # Modele de base SD
motion_adapter = "guoyww/animatediff-motion-adapter-v1-5-3"  # Motion module

# Parametres generation
num_frames = 16                    # Nombre de frames a generer
guidance_scale = 7.5               # CFG scale (adherence au prompt)
num_inference_steps = 25           # Nombre d'etapes de debruitage
height = 512                       # Hauteur video
width = 512                        # Largeur video
fps_output = 8                     # FPS de la video de sortie

# Configuration
run_generation = True              # Executer la generation
save_as_gif = True                 # Sauvegarder en GIF
save_as_mp4 = True                 # Sauvegarder en MP4
save_results = TrueAnimateDiff - Introduction a la Generation Text-to-Video
Navigation : Index | << Précédent
Module : 01-Video-Foundation
Niveau : Intermediaire
Technologies : AnimateDiff, diffusers, Stable Diffusion v1.5
Duree estimee : 45 minutes
VRAM : ~12 GB
Objectifs d’Apprentissage
Prerequis
- GPU avec 12+ GB VRAM (RTX 3060 12GB minimum)
- Notebooks 01-1 a 01-4 completes
- Packages :
diffusers>=0.30,transformers,torch,accelerate,imageio,imageio-ffmpeg
Principe d’AnimateDiff
AnimateDiff ajoute un motion module (attention temporelle) a un modèle Stable Diffusion existant pour generer des sequences de frames coherentes temporellement.
| Composant | Rôle |
|---|---|
| Base model | Stable Diffusion v1.5 (generation d’images) |
| Motion adapter | Module d’attention temporelle (coherence entre frames) |
| Scheduler | Contrôle du processus de debruitage (DDIM, Euler, etc.) |
# Parameters
BATCH_MODE = True
Les paramètres AnimateDiff sont définis. La cellule suivante initialise l’environnement Python : imports, chargement du .env et configuration du repertoire de sortie pour les videos generees.
# Import guards - verification des dependances
try:
    import openai
    OPENAI_AVAILABLE = True
except ImportError:
    OPENAI_AVAILABLE = False

try:
    import anthropic
    ANTHROPIC_AVAILABLE = True
except ImportError:
    ANTHROPIC_AVAILABLE = False

try:
    import requests
    REQUESTS_AVAILABLE = True
except ImportError:
    REQUESTS_AVAILABLE = False

try:
    import matplotlib
    MATPLOTLIB_AVAILABLE = True
except ImportError:
    MATPLOTLIB_AVAILABLE = False

try:
    import numpy
    NUMPY_AVAILABLE = True
except ImportError:
    NUMPY_AVAILABLE = False

try:
    import pandas
    PANDAS_AVAILABLE = True
except ImportError:
    PANDAS_AVAILABLE = False

try:
    from PIL import Image
    PIL_AVAILABLE = True
except ImportError:
    PIL_AVAILABLE = False

try:
    import IPython
    IPYTHON_AVAILABLE = True
except ImportError:
    IPYTHON_AVAILABLE = False

try:
    from dotenv import load_dotenv
    DOTENV_AVAILABLE = True
except ImportError:
    DOTENV_AVAILABLE = False

try:
    import torch
    TORCH_AVAILABLE = True
except ImportError:
    TORCH_AVAILABLE = False

try:
    import transformers
    TRANSFORMERS_AVAILABLE = True
except ImportError:
    TRANSFORMERS_AVAILABLE = False

try:
    import cv2
    CV2_AVAILABLE = True
except ImportError:
    CV2_AVAILABLE = False

try:
    import pydantic
    PYDANTIC_AVAILABLE = True
except ImportError:
    PYDANTIC_AVAILABLE = False

# Resume des dependances disponibles
_DEPS = {
    'openai': OPENAI_AVAILABLE,
    'anthropic': ANTHROPIC_AVAILABLE,
    'requests': REQUESTS_AVAILABLE,
    'matplotlib': MATPLOTLIB_AVAILABLE,
    'numpy': NUMPY_AVAILABLE,
    'pandas': PANDAS_AVAILABLE,
    'PIL': PIL_AVAILABLE,
    'IPython': IPYTHON_AVAILABLE,
    'dotenv': DOTENV_AVAILABLE,
    'torch': TORCH_AVAILABLE,
    'transformers': TRANSFORMERS_AVAILABLE,
    'cv2': CV2_AVAILABLE,
    'pydantic': PYDANTIC_AVAILABLE,
}
available = [k for k, v in _DEPS.items() if v]
missing = [k for k, v in _DEPS.items() if not v]
print(f"Dependances: {len(available)}/{len(_DEPS)} disponibles"
      + (f" | Manquantes: {missing}" if missing else ""))

# Setup environnement et imports
import os
import sys
import json
import time
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import numpy as np
from PIL import Image
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)
warnings.filterwarnings('ignore', category=FutureWarning)

# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)
from dotenv import load_dotenv

current_path = Path.cwd()
genai_path = None

while len(current_path.parts) > 1:
    if current_path.name == "GenAI":
        genai_path = current_path
        break
    current_path = current_path.parent

if genai_path:
    env_path = genai_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
    GENAI_ROOT = genai_path
else:
    print("WARNING: GenAI directory not found")
    GENAI_ROOT = Path.cwd()

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging
        print("Helpers GenAI importes")
    except ImportError:
        print("Helpers GenAI non disponibles - mode autonome")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'animatediff'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('animatediff')

print(f"AnimateDiff - Generation Text-to-Video")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Frames : {num_frames}, Steps : {num_inference_steps}, CFG : {guidance_scale}")
Dependances: 13/13 disponibles
Helpers GenAI importes
AnimateDiff - Generation Text-to-Video
Date : 2026-09-03 00:56:54
Mode : interactive
Frames : 16, Steps : 25, CFG : 7.5L’environnement est configure. La cellule suivante verifie le GPU disponible et les dependances critiques : huggingface-hub, diffusers et torch, en signalant les incompatibilites de version qui empecharaient le chargement d’AnimateDiff.
# Verification GPU et dependances
print("\n--- VERIFICATION GPU ---")
print("=" * 40)
import torch
import pandas as pd
device = "cuda" if torch.cuda.is_available() else "cpu"
if torch.cuda.is_available():
    gpu_name = torch.cuda.get_device_name(0)
    vram_total = torch.cuda.get_device_properties(0).total_memory / 1024**3
    vram_free = (torch.cuda.get_device_properties(0).total_memory - torch.cuda.memory_allocated(0)) / 1024**3
    print(f"GPU : {gpu_name}")
    print(f"VRAM totale : {vram_total:.1f} GB")
    print(f"VRAM libre : {vram_free:.1f} GB")
    print(f"CUDA : {torch.version.cuda}")

    if vram_total < 12:
        print(f"\nAttention : VRAM ({vram_total:.0f} GB) < 12 GB recommandes")
        print("Reduction de la resolution et du nombre de frames")
        if vram_total < 8:
            height = 256
            width = 256
            num_frames = 8
            print(f"  Resolution reduite a {width}x{height}, {num_frames} frames")
else:
    print("CUDA non disponible.")
    print("AnimateDiff necessite un GPU. Le notebook montrera le code sans executer.")
    run_generation = False

# Verification des dependances
print("\n--- VERIFICATION DEPENDANCES ---")
print("=" * 40)
# Diagnostic empirique : on teste le VRAI import AnimateDiff plutot qu'une
# heuristique de version (hf-hub >= 1.0 etait incompatible avec d'anciennes
# versions de diffusers, mais les versions recentes des deux librairies
# fonctionnent ensemble). Le verdict de compatibilite vient de l'import reel.
animatediff_available = False
try:
    import huggingface_hub
    print(f"huggingface-hub : v{huggingface_hub.__version__}")
except ImportError:
    print("huggingface-hub NON INSTALLE")

try:
    import diffusers
    print(f"diffusers : v{diffusers.__version__}")
except ImportError:
    print("diffusers NON INSTALLE")

# Test empirique : l'import reel est la source de verite (pas la version)
try:
    from diffusers import AnimateDiffPipeline, MotionAdapter, DDIMScheduler
    from diffusers.utils import export_to_gif, export_to_video
    print("AnimateDiff pipeline : disponible (import reussi)")
    animatediff_available = True
except ImportError as e:
    error_str = str(e)
    if "huggingface-hub" in error_str:
        print(f"AnimateDiff pipeline : NON DISPONIBLE (conflit de version huggingface-hub)")
        print(f"  Solution: pip install --upgrade huggingface-hub diffusers")
    else:
        print(f"AnimateDiff pipeline : NON DISPONIBLE - {error_str[:100]}")
    animatediff_available = False
    run_generation = False

print(f"\nDevice : {device}")
print(f"Generation activee : {run_generation}")
--- VERIFICATION GPU ---
========================================
GPU : NVIDIA GeForce RTX 3090
VRAM totale : 24.0 GB
VRAM libre : 24.0 GB
CUDA : 12.6

--- VERIFICATION DEPENDANCES ---
========================================
huggingface-hub : v1.20.1
diffusers : v0.38.0
AnimateDiff pipeline : disponible (import reussi)

Device : cuda
Generation activee : True
Section 1 : Chargement du pipeline AnimateDiff
Le pipeline AnimateDiff combine : 1. Un motion adapter (module d’attention temporelle entraine separement) 2. Un modèle Stable Diffusion de base (genere les frames individuelles) 3. Un scheduler (contrôle le processus de debruitage)
Le motion adapter s’insere dans les couches d’attention du U-Net de Stable Diffusion pour ajouter une dimension temporelle au traitement.
# Chargement du pipeline AnimateDiff
import warnings

# Règle 6 secrets-hygiene : le warning de deprecation hf_hub inclut le chemin
# local du module dans son en-tete (site-packages\...\huggingface_hub\utils
# \_validators.py:205) — chemin machine interdit dans une sortie commitée.
# Cause filtering cible par message (non-actionnable : local_dir_use_symlinks
# est ignore depuis hf_hub_download) — jamais d'edition a la main de l'output.
warnings.filterwarnings(
    "ignore",
    message=".*local_dir_use_symlinks.*",
    category=UserWarning,
)

pipe = None

if run_generation:
    print("\n--- CHARGEMENT DU PIPELINE ---")
    print("=" * 40)

    try:
        # 1. Charger le motion adapter
        print(f"Chargement motion adapter : {motion_adapter}")
        adapter = MotionAdapter.from_pretrained(
            motion_adapter,
            torch_dtype=torch.float16
        )
        print(f"  Motion adapter charge")

        # 2. Charger le pipeline complet
        print(f"Chargement base model : {base_model}")
        start_load = time.time()

        pipe = AnimateDiffPipeline.from_pretrained(
            base_model,
            motion_adapter=adapter,
            torch_dtype=torch.float16
        )

        # 3. Configurer le scheduler
        pipe.scheduler = DDIMScheduler.from_pretrained(
            base_model,
            subfolder="scheduler",
            clip_sample=False,
            timestep_spacing="linspace",
            beta_schedule="linear",
            steps_offset=1
        )

        # 4. Transferer sur GPU
        pipe = pipe.to(device)

        # 5. Optimisations memoire
        pipe.enable_vae_slicing()  # Reduit la VRAM pour le decodage VAE
        try:
            pipe.enable_model_cpu_offload()  # Offload intelligent CPU<->GPU
        except Exception:
            pass  # Pas critique si indisponible

        load_time = time.time() - start_load

        if device == "cuda":
            vram_used = torch.cuda.memory_allocated(0) / 1024**3
            print(f"  VRAM utilisee : {vram_used:.1f} GB")

        print(f"Pipeline charge en {load_time:.1f}s")
        print(f"  Scheduler : DDIMScheduler")
        print(f"  VAE slicing : active")
        print(f"  Resolution : {width}x{height}")

    except Exception as e:
        print(f"Erreur chargement pipeline : {type(e).__name__}: {str(e)[:200]}")
        print("Le notebook continuera sans generation.")
        run_generation = False
        pipe = None
else:
    print("Chargement pipeline desactive")
--- CHARGEMENT DU PIPELINE ---
========================================
Chargement motion adapter : guoyww/animatediff-motion-adapter-v1-5-3
Motion adapter charge
Chargement base model : stable-diffusion-v1-5/stable-diffusion-v1-5 VRAM utilisee : 0.0 GB
Pipeline charge en 15.5s
Scheduler : DDIMScheduler
VAE slicing : active
Resolution : 512x512Section 2 : Generation text-to-video
Nous allons generer une première video a partir d’un prompt textuel. Les paramètres principaux sont :
| Paramètre | Impact | Valeur typique |
|---|---|---|
num_frames |
Duree de la video | 8-24 |
guidance_scale |
Adherence au prompt (trop haut = artefacts) | 5.0-10.0 |
num_inference_steps |
Qualite (plus = mieux mais plus lent) | 20-50 |
height/width |
Resolution (carree recommandee) | 256-512 |
# Generation text-to-video
print("\n--- GENERATION TEXT-TO-VIDEO ---")
print("=" * 40)

def generate_video(prompt: str, negative_prompt: str = "",
                   seed: int = 42) -> Dict[str, Any]:
    """
    Genere une video a partir d'un prompt textuel.

    Args:
        prompt: Description textuelle de la video
        negative_prompt: Elements a eviter
        seed: Graine aleatoire pour reproductibilite

    Returns:
        Dict avec frames, temps de generation et metadonnees
    """
    if pipe is None:
        return {"success": False, "error": "Pipeline non charge"}

    try:
        generator = torch.Generator(device=device).manual_seed(seed)

        if device == "cuda":
            torch.cuda.reset_peak_memory_stats()
            vram_before = torch.cuda.memory_allocated(0) / 1024**3

        start_time = time.time()

        output = pipe(
            prompt=prompt,
            negative_prompt=negative_prompt or "low quality, blurry, distorted",
            num_frames=num_frames,
            guidance_scale=guidance_scale,
            num_inference_steps=num_inference_steps,
            height=height,
            width=width,
            generator=generator
        )

        gen_time = time.time() - start_time
        frames = output.frames[0]  # Liste d'images PIL

        result = {
            "success": True,
            "frames": frames,
            "generation_time": gen_time,
            "time_per_frame": gen_time / num_frames,
            "prompt": prompt,
            "seed": seed,
            "params": {
                "num_frames": num_frames,
                "guidance_scale": guidance_scale,
                "num_inference_steps": num_inference_steps,
                "height": height,
                "width": width
            }
        }

        if device == "cuda":
            result["vram_peak"] = torch.cuda.max_memory_allocated(0) / 1024**3

        return result

    except Exception as e:
        return {"success": False, "error": f"{type(e).__name__}: {str(e)[:200]}"}


# Premier test : generation simple
prompt_1 = "a serene lake at sunset with mountains in the background, golden light reflecting on water, cinematic"

if run_generation:
    print(f"Prompt : {prompt_1}")
    print(f"Parametres : {num_frames} frames, {num_inference_steps} steps, CFG={guidance_scale}")
    print(f"Resolution : {width}x{height}")
    print(f"\nGeneration en cours...")

    result_1 = generate_video(prompt_1, seed=42)

    if result_1['success']:
        frames = result_1['frames']
        print(f"\nGeneration reussie")
        print(f"  Temps total : {result_1['generation_time']:.1f}s")
        print(f"  Temps/frame : {result_1['time_per_frame']:.1f}s")
        print(f"  Frames : {len(frames)}")
        if 'vram_peak' in result_1:
            print(f"  VRAM pic : {result_1['vram_peak']:.1f} GB")

        # Affichage en grille
        n_display = min(8, len(frames))
        indices = np.linspace(0, len(frames) - 1, n_display, dtype=int)
        fig, axes = plt.subplots(2, 4, figsize=(16, 8))
        axes_flat = axes.flatten()
        for i, idx in enumerate(indices):
            if i < len(axes_flat):
                axes_flat[i].imshow(frames[idx])
                axes_flat[i].set_title(f"Frame {idx + 1}/{len(frames)}", fontsize=9)
                axes_flat[i].axis('off')
        for i in range(len(indices), len(axes_flat)):
            axes_flat[i].axis('off')
        plt.suptitle(f"AnimateDiff : {prompt_1[:60]}...", fontsize=11, fontweight='bold')
        plt.tight_layout()
        plt.show()

        # Sauvegarde GIF
        if save_as_gif:
            gif_path = OUTPUT_DIR / "animatediff_demo.gif"
            export_to_gif(frames, str(gif_path))
            gif_size_kb = gif_path.stat().st_size / 1024
            print(f"  GIF sauvegarde : {gif_path.name} ({gif_size_kb:.1f} KB)")

        # Sauvegarde MP4
        if save_as_mp4:
            mp4_path = OUTPUT_DIR / "animatediff_demo.mp4"
            export_to_video(frames, str(mp4_path), fps=fps_output)
            mp4_size_kb = mp4_path.stat().st_size / 1024
            print(f"  MP4 sauvegarde : {mp4_path.name} ({mp4_size_kb:.1f} KB)")
    else:
        print(f"Erreur : {result_1['error']}")
else:
    # Mode pedagogique : afficher ce qui serait genere
    print("**MODE PEDAGOGIQUE**")
    print(f"\nSur un environnement GPU (RTX 3090, 24GB VRAM), ce code genererait :")
    print(f"")
    print(f"| Parametre | Valeur |")
    print(f"|-----------|--------|")
    print(f"| Prompt | {prompt_1[:50]}... |")
    print(f"| Frames | {num_frames} |")
    print(f"| Resolution | {width}x{height} |")
    print(f"| Steps | {num_inference_steps} |")
    print(f"| CFG Scale | {guidance_scale} |")
    print(f"| Temps estime | ~45s |")
    print(f"| VRAM | ~10 GB |")
    print(f"")
    print(f"**Resultat attendu :**")
    print(f"Une video de 2 secondes (16 frames @ 8 fps) montrant un lac paisible")
    print(f"au coucher du soleil avec des montagnes en arriere-plan et des")
    print(f"reflets dorees sur l'eau. Le mouvement sera subtil : ondulations de")
    print(f"l'eau, nuages se deplacant lentement, lumiere changeante.")
    print(f"")
    print(f"**Code pour reproduire :**")
    print(f"```python")
    print(f"result = generate_video('{prompt_1[:40]}...', seed=42)")
    print(f"```")
--- GENERATION TEXT-TO-VIDEO ---
========================================
Prompt : a serene lake at sunset with mountains in the background, golden light reflecting on water, cinematic
Parametres : 16 frames, 25 steps, CFG=7.5
Resolution : 512x512

Generation en cours...
Generation reussie
  Temps total : 26.3s
  Temps/frame : 1.6s
  Frames : 16
  VRAM pic : 4.5 GB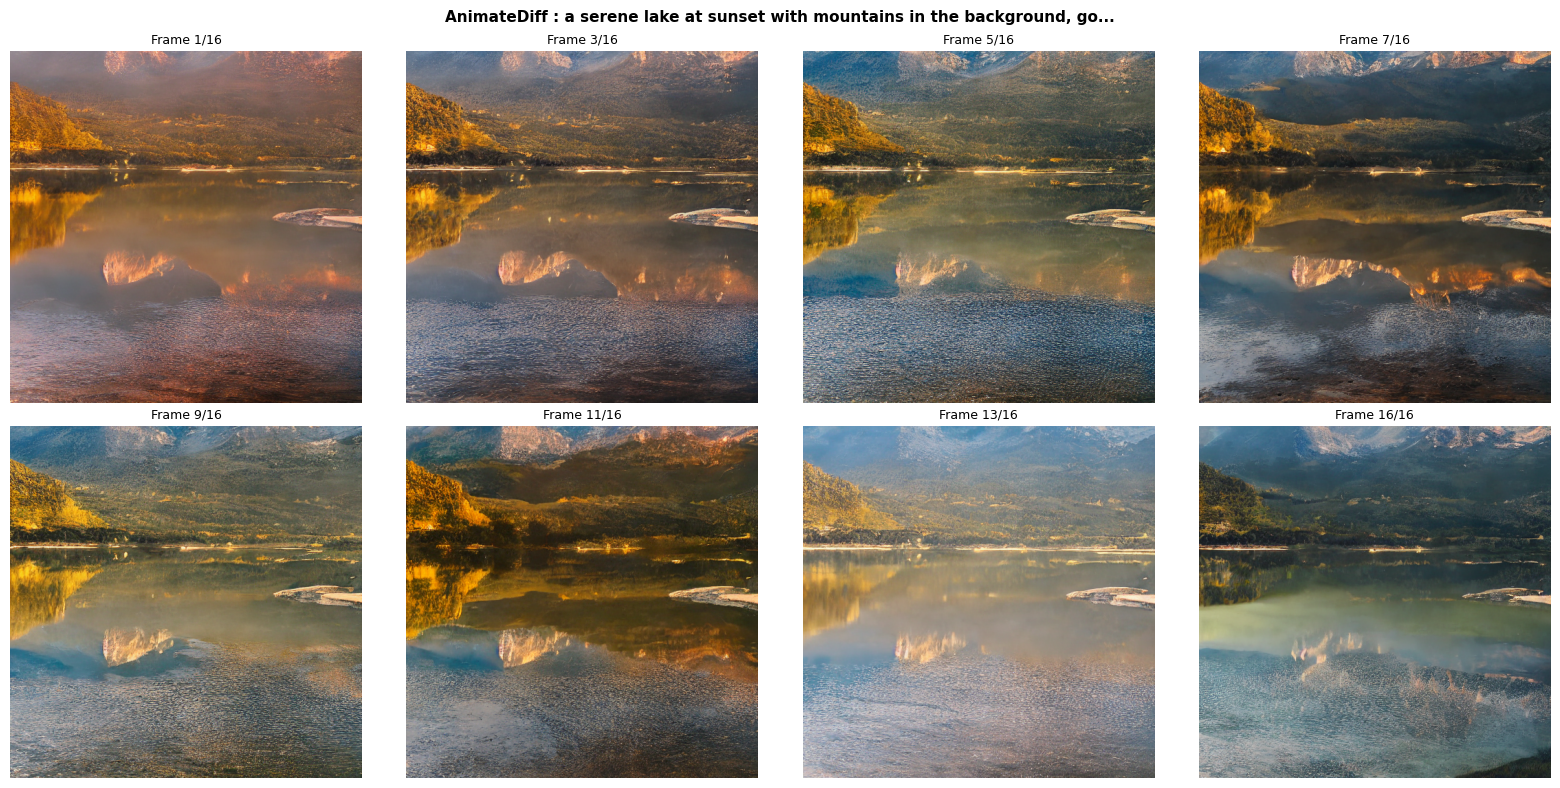
  GIF sauvegarde : animatediff_demo.gif (3123.8 KB)
  MP4 sauvegarde : animatediff_demo.mp4 (660.3 KB)
Exercice 1 : Engineering de negative prompts
La Section 2 genere des videos avec un negative prompt generique ("low quality, blurry, distorted"). L’objectif est d’implementer un système qui construit automatiquement un negative prompt adapte au type de contenu genere.
Contexte : Le negative prompt est aussi important que le prompt positif. Un bon negative prompt adapte au sujet (paysage vs personnage vs objet) ameliore significativement la qualite.
Étapes : 1. Categoriser le prompt positif (paysage, personnage, mouvement, abstrait) 2. Associer une liste de termes negatifs spécifiques a chaque catégorie 3. Ajouter des termes generiques de qualite 4. Tester et comparer avec le negative prompt generique
Indices : - Catégorie “paysage” : negatifs = “people, text, watermark, oversaturated” - Catégorie “personnage” : negatifs = “extra limbs, deformed hands, blurry face” - Catégorie “mouvement” : negatifs = “static, frozen, jittery” - Utilisez des mots-cles dans le prompt pour detecter la catégorie (ex: “lake” -> paysage)
# Exercice 1 : Engineering de negative prompts adaptes

def build_adaptive_negative_prompt(positive_prompt: str) -> str:
    """
    Construit un negative prompt adapte au contenu du prompt positif.

    Args:
        positive_prompt: Description textuelle de la video desiree

    Returns:
        Negative prompt adapte
    """
    # Etape 1 : Definir les categories et leurs mots-cles
    categories = {
        "paysage": {
            "keywords": ["lake", "mountain", "ocean", "sunset", "forest", "sky",
                         "mer", "montagne", "lac", "foret", "ciel"],
            "negatives": ["people", "text", "watermark", "oversaturated",
                          "buildings", "urban"]
        },
        "personnage": {
            "keywords": ["person", "man", "woman", "cat", "dog", "walking",
                         "personne", "chat", "marche"],
            "negatives": ["extra limbs", "deformed hands", "blurry face",
                          "mutated", "disfigured"]
        },
        "mouvement": {
            "keywords": ["running", "flying", "dancing", "crashing", "launching",
                         "courant", "volant", "lancement"],
            "negatives": ["static", "frozen", "jittery", "stuttering",
                          "repeating motion"]
        }
    }

    # Etape 2 : Detecter la categorie dominante
    # TODO etudiant : verifier la presence des mots-cles dans le prompt
    detected = "generic"  # TODO etudiant

    # Etape 3 : Construire le negative prompt
    # TODO etudiant : combiner les negatifs specifiques + negatifs generiques
    generic_negatives = ["low quality", "blurry", "distorted", "artifact",
                         "noise", "compression"]

    negative = ""  # TODO etudiant : concatener les termes

    return negative


# TODO etudiant : Tester avec differents prompts
# test_prompts = [
#     "a serene lake at sunset with mountains",
#     "a cat walking gracefully on a windowsill",
#     "a rocket launching into space"
# ]
# for p in test_prompts:
#     neg = build_adaptive_negative_prompt(p)
#     print(f"Prompt: {p}")
#     print(f"Negative: {neg}\n")
print("Exercice a completer")
Exercice a completerSection 3 : Exploration des paramètres
Nous allons tester différentes combinaisons de paramètres pour comprendre leur impact sur la qualite et le temps de generation.
# Comparaison de prompts
if run_generation and pipe is not None:
    print("\n--- COMPARAISON DE PROMPTS ---")
    print("=" * 40)

    prompts = [
        {
            "text": "a cat walking gracefully on a windowsill, soft morning light, cozy atmosphere",
            "label": "Chat"
        },
        {
            "text": "ocean waves crashing on a rocky shore, dramatic clouds, powerful nature",
            "label": "Ocean"
        },
        {
            "text": "a rocket launching into space with fire and smoke, cinematic epic shot",
            "label": "Fusee"
        }
    ]

    comparison_results = []

    for p_idx, prompt_info in enumerate(prompts):
        print(f"\nGeneration {p_idx + 1}/{len(prompts)} : {prompt_info['label']}")
        print(f"  Prompt : {prompt_info['text'][:70]}...")

        result = generate_video(prompt_info['text'], seed=42 + p_idx)

        if result['success']:
            print(f"  Temps : {result['generation_time']:.1f}s")
            comparison_results.append({
                "label": prompt_info['label'],
                "prompt": prompt_info['text'],
                "frames": result['frames'],
                "time": result['generation_time']
            })

            # Sauvegarder chaque video
            if save_as_gif:
                gif_path = OUTPUT_DIR / f"comparison_{prompt_info['label'].lower()}.gif"
                export_to_gif(result['frames'], str(gif_path))
        else:
            print(f"  Erreur : {result['error']}")

    # Affichage comparatif
    if comparison_results:
        n_videos = len(comparison_results)
        n_preview = 4
        fig, axes = plt.subplots(n_videos, n_preview, figsize=(3.5 * n_preview, 3 * n_videos))
        if n_videos == 1:
            axes = [axes]

        for v_idx, cr in enumerate(comparison_results):
            frame_indices = np.linspace(0, len(cr['frames']) - 1, n_preview, dtype=int)
            for f_idx, fi in enumerate(frame_indices):
                axes[v_idx][f_idx].imshow(cr['frames'][fi])
                axes[v_idx][f_idx].axis('off')
                if f_idx == 0:
                    axes[v_idx][f_idx].set_ylabel(cr['label'], fontsize=11, fontweight='bold')

        plt.suptitle("Comparaison de prompts - AnimateDiff", fontsize=13, fontweight='bold')
        plt.tight_layout()
        plt.show()

        # Tableau recapitulatif
        print(f"\nRecapitulatif :")
        print(f"{'Label':<15} {'Temps (s)':<12} {'Prompt':<60}")
        print("-" * 85)
        for cr in comparison_results:
            prompt_short = cr['prompt'][:55] + '...' if len(cr['prompt']) > 55 else cr['prompt']
            print(f"  {cr['label']:<15} {cr['time']:<12.1f} {prompt_short:<60}")
else:
    print("Comparaison de prompts : generation desactivee")
    print("\nExemples de prompts efficaces pour AnimateDiff :")
    print("  - Mouvements naturels : eau, vent, nuages")
    print("  - Animaux en mouvement : chat marchant, oiseau volant")
    print("  - Paysages dynamiques : coucher de soleil, aurores boreales")
    print("  - Actions simples : fusee decollant, fleur eclosant")
--- COMPARAISON DE PROMPTS ---
========================================

Generation 1/3 : Chat
  Prompt : a cat walking gracefully on a windowsill, soft morning light, cozy atm...
Temps : 26.6s
Generation 2/3 : Ocean
Prompt : ocean waves crashing on a rocky shore, dramatic clouds, powerful natur... Temps : 25.0s
Generation 3/3 : Fusee
Prompt : a rocket launching into space with fire and smoke, cinematic epic shot... Temps : 26.7s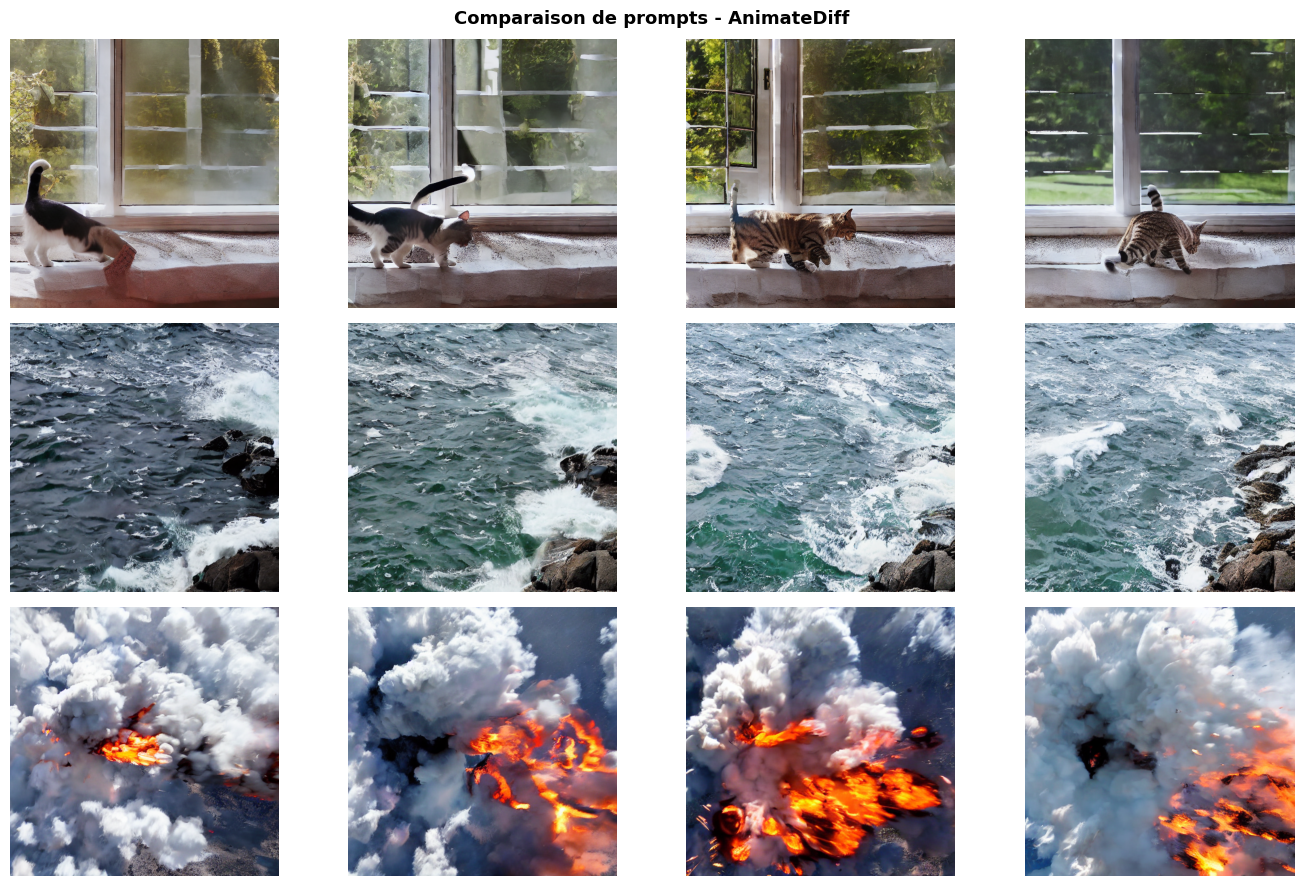
Recapitulatif :
Label           Temps (s)    Prompt
-------------------------------------------------------------------------------------
  Chat            26.6         a cat walking gracefully on a windowsill, soft morning ...
  Ocean           25.0         ocean waves crashing on a rocky shore, dramatic clouds,...
  Fusee           26.7         a rocket launching into space with fire and smoke, cine...
Exercice 2 : Analyse de coherence temporelle entre seeds
La Section 3 compare différents prompts avec le même seed (42). L’objectif est d’implementer une fonction qui mesure la coherence temporelle d’une video generee en analysant la variance entre frames consecutives.
Contexte : Une video generee par AnimateDiff peut presenter des sauts temporels (flickering) ou une evolution non fluide. Mesurer la différence entre frames consecutives permet de quantifier ce problème.
Étapes : 1. Pour une liste de frames, calculer la différence absolue moyenne entre chaque paire consecutive 2. Detecter les sauts importants (différence > 2x la mediane) 3. Calculer un score de fluidite : ratio de transitions fluides / total 4. Visualiser l’evolution des différences dans un graphique
Indices : - La différence entre deux frames consecutives : np.mean(np.abs(frame[i].astype(float) - frame[i+1].astype(float))) - Un “saut” est une différence significativement plus elevee que la moyenne - Un score de fluidite proche de 1.0 indique une video fluide sans artefacts temporels
# Exercice 2 : Analyse de coherence temporelle

def analyze_temporal_coherence(frames: List[np.ndarray],
                                jump_threshold: float = 2.0) -> Dict[str, Any]:
    """
    Analyse la coherence temporelle d'une sequence de frames.

    Args:
        frames: Liste de frames numpy (H, W, 3) uint8
        jump_threshold: Facteur multiplicateur de la mediane pour detecter les sauts

    Returns:
        Dict avec differences, n_jumps, fluidity_score, mean_diff, std_diff
    """
    if len(frames) < 2:
        return {'differences': [], 'n_jumps': 0, 'fluidity_score': 0.0,
                'mean_diff': 0.0, 'std_diff': 0.0}

    # Etape 1 : Calculer les differences entre frames consecutives
    differences = []  # TODO etudiant : boucler et calculer np.mean(np.abs(diff))

    # Etape 2 : Calculer la mediane et detecter les sauts
    median_diff = 0.0  # TODO etudiant
    threshold = median_diff * jump_threshold
    n_jumps = 0  # TODO etudiant : compter les differences > threshold

    # Etape 3 : Score de fluidite
    fluidity_score = 0.0  # TODO etudiant : 1 - (n_jumps / len(differences))

    # Etape 4 : Statistiques globales
    mean_diff = 0.0  # TODO etudiant
    std_diff = 0.0   # TODO etudiant

    return {
        'differences': differences,
        'n_jumps': n_jumps,
        'fluidity_score': fluidity_score,
        'mean_diff': mean_diff,
        'std_diff': std_diff
    }


def plot_temporal_coherence(differences: List[float], title: str = "") -> None:
    """
    Affiche l'evolution des differences entre frames consecutives.
    """
    # TODO etudiant : tracer les differences avec matplotlib
    # TODO etudiant : ajouter la ligne horizontale du seuil de saut
    pass


# TODO etudiant : Analyser une video generee
# if result_1.get('success') and result_1.get('frames'):
#     coherence = analyze_temporal_coherence(
#         [np.array(f) for f in result_1['frames']]
#     )
#     print(f"Fluidite : {coherence['fluidity_score']:.3f}")
#     print(f"Sauts detectes : {coherence['n_jumps']}")
#     plot_temporal_coherence(coherence['differences'], "Video 1")
print("Exercice a completer")
Exercice a completerExercice 3 : Impact des paramètres de generation sur la qualite video
Les paramètres guidance_scale, num_inference_steps et num_frames influencent fortement la qualite d’une video AnimateDiff. L’objectif est d’implementer un sweep de paramètres qui genere des videos avec différentes configurations et mesure leur impact.
Contexte : Le guidance_scale contrôle l’adherence au prompt (trop bas = flou, trop haut = artefacts). Le num_inference_steps affecte la qualite du debruitage. Le nombre de frames impacte la coherence temporelle.
Étapes : 1. Définir une grille de paramètres avec au moins 2 valeurs par paramètre 2. Pour chaque combinaison, simuler (ou executer si GPU disponible) une generation 3. Mesurer le temps de generation et la coherence temporelle (si frames disponibles) 4. Presenter les résultats dans un DataFrame et un graphique comparatif
Indices : - Grille suggeree : guidance_scale in [5.0, 7.5, 10.0], num_inference_steps in [15, 25] - Pour mesurer la coherence sans GPU, vous pouvez comparer les prompts et paramètres theoriquement - Le temps de generation est approximativement proportionnel a num_frames * num_inference_steps - Un DataFrame avec colonnes guidance, steps, frames, temps_estime, qualite_estimee
# Exercice 3 : Sweep de parametres AnimateDiff

def parameter_sweep(prompt: str,
                    guidance_values: List[float] = [5.0, 7.5, 10.0],
                    steps_values: List[int] = [15, 25],
                    num_frames_fixed: int = 16) -> pd.DataFrame:
    """
    Teste differentes combinaisons de parametres AnimateDiff.

    Args:
        prompt: Texte de prompt pour la generation
        guidance_values: Liste de guidance_scale a tester
        steps_values: Liste de num_inference_steps a tester
        num_frames_fixed: Nombre de frames fixe pour le sweep

    Returns:
        DataFrame avec resultats par combinaison
    """
    results = []

    for guidance in guidance_values:
        for steps in steps_values:
            # TODO etudiant : estimer le temps de generation
            # Le temps est approximativement : steps * num_frames * 0.1s (sur RTX 3090)
            estimated_time = 0.0  # TODO etudiant

            # TODO etudiant : estimer la qualite theorique
            # guidance trop haut (>10) = artefacts, trop bas (<5) = flou
            # steps trop bas (<15) = sous-debruite, trop haut (>50) = rendement decroissant
            estimated_quality = "medium"  # TODO etudiant : logique de classification

            # TODO etudiant : si pipe est disponible, lancer la vraie generation
            # result = generate_video(prompt, seed=42)
            # et mesurer le temps reel et la coherence temporelle

            results.append({
                'guidance_scale': guidance,
                'num_inference_steps': steps,
                'num_frames': num_frames_fixed,
                'temps_estime': estimated_time,
                'qualite_estimee': estimated_quality,
                'generation_reussie': False  # TODO etudiant
            })

    return pd.DataFrame(results)


# TODO etudiant : Executer le sweep et analyser les resultats
# df_sweep = parameter_sweep("a cat walking on a windowsill")
# print(df_sweep)
#
# TODO etudiant : Visualiser avec un graphique
# fig, ax = plt.subplots(figsize=(10, 6))
# for guidance in [5.0, 7.5, 10.0]:
#     subset = df_sweep[df_sweep['guidance_scale'] == guidance]
#     ax.plot(subset['num_inference_steps'], subset['temps_estime'],
#             marker='o', label=f'CFG={guidance}')
# ax.set_xlabel('Steps')
# ax.set_ylabel('Temps estime (s)')
# ax.legend()
# ax.set_title('Impact des parametres sur le temps de generation')
# plt.show()
print("Exercice a completer")
Exercice a completerLes différents prompts ont ete compares. La cellule suivante active le mode interactif pour generer une video a partir d’un prompt personnalise saisi par l’utilisateur.
# Mode interactif
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Entrez votre propre prompt pour generer une video.")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_prompt = input("\nVotre prompt : ").strip()

        if user_prompt and run_generation and pipe is not None:
            print(f"\nGeneration en cours...")
            result_user = generate_video(user_prompt, seed=123)

            if result_user['success']:
                print(f"Generation reussie en {result_user['generation_time']:.1f}s")

                # Affichage
                n_display = min(8, len(result_user['frames']))
                fig, axes = plt.subplots(1, n_display, figsize=(2.5 * n_display, 3))
                if n_display == 1:
                    axes = [axes]
                indices = np.linspace(0, len(result_user['frames']) - 1, n_display, dtype=int)
                for ax, idx in zip(axes, indices):
                    ax.imshow(result_user['frames'][idx])
                    ax.set_title(f"Frame {idx+1}", fontsize=8)
                    ax.axis('off')
                plt.suptitle(f"Votre video : {user_prompt[:50]}...", fontweight='bold')
                plt.tight_layout()
                plt.show()

                if save_as_gif:
                    user_gif = OUTPUT_DIR / "user_generation.gif"
                    export_to_gif(result_user['frames'], str(user_gif))
                    print(f"GIF sauvegarde : {user_gif.name}")
            else:
                print(f"Erreur : {result_user['error']}")
        elif user_prompt:
            print("Generation non disponible (pipeline non charge)")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif non disponible (execution automatisee)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")
--- MODE INTERACTIF ---
========================================
Entrez votre propre prompt pour generer une video.
(Laissez vide pour passer a la suite)

Mode interactif non disponible (execution automatisee)
Bonnes pratiques et optimisation
Conseils pour les prompts AnimateDiff
| Bon prompt | Mauvais prompt | Raison |
|---|---|---|
| “a cat walking slowly” | “a cat” | Preciser le mouvement |
| “ocean waves, cinematic” | “nice ocean” | Termes de qualite |
| “single subject, simple motion” | “crowd scene, complex action” | Mouvement simple = meilleur |
Paramètres optimaux
| Paramètre | Rapide | Equilibre | Haute qualite |
|---|---|---|---|
num_frames |
8 | 16 | 24 |
num_inference_steps |
15 | 25 | 50 |
guidance_scale |
5.0 | 7.5 | 7.5 |
height/width |
256 | 512 | 512 |
| Temps estime (RTX 3090) | ~15s | ~45s | ~120s |
| VRAM estimee | ~6 GB | ~10 GB | ~14 GB |
Limitations d’AnimateDiff
- Resolution maximale limitee (512x512 pour SD 1.5)
- Mouvements complexes souvent mal geres
- Coherence temporelle imparfaite sur les longues sequences
- Base model SD 1.5 (qualite inferieure a SDXL ou Flux)
Alternatives (voir Module 02)
| Modèle | Avantage | VRAM |
|---|---|---|
| HunyuanVideo | Haute qualite, longues sequences | ~18 GB |
| LTX-Video | Rapide, leger | ~8 GB |
| Wan 2.1/2.2 | Prompts multilingues | ~10 GB |
| SVD | Image-to-video | ~10 GB |
# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"Base model : {base_model}")
print(f"Motion adapter : {motion_adapter}")
print(f"Device : {device}")
print(f"Parametres : {num_frames} frames, {num_inference_steps} steps, CFG={guidance_scale}")
print(f"Resolution : {width}x{height}")

if device == "cuda" and torch.cuda.is_available():
    vram_peak = torch.cuda.max_memory_allocated(0) / 1024**3
    print(f"VRAM pic session : {vram_peak:.1f} GB")

if save_results and OUTPUT_DIR.exists():
    generated_files = list(OUTPUT_DIR.glob('*'))
    print(f"\nFichiers generes ({len(generated_files)}) :")
    for f in sorted(generated_files):
        size_kb = f.stat().st_size / 1024
        print(f"  {f.name} ({size_kb:.1f} KB)")

# Liberation VRAM
if pipe is not None:
    del pipe
    if device == "cuda":
        torch.cuda.empty_cache()
        print(f"\nVRAM liberee")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Module 02-1 : HunyuanVideo (generation video haute qualite)")
print(f"2. Module 02-2 : LTX-Video (generation rapide et legere)")
print(f"3. Module 02-3 : Wan 2.1/2.2 (prompts multilingues)")
print(f"4. Module 02-4 : SVD - Stable Video Diffusion (image-to-video)")
print(f"5. Combiner 01-4 (upscaling) avec la generation pour des videos HD")

print(f"\nNotebook 01-5 AnimateDiff Introduction termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-09-03 00:59:21
Mode : interactive
Base model : stable-diffusion-v1-5/stable-diffusion-v1-5
Motion adapter : guoyww/animatediff-motion-adapter-v1-5-3
Device : cuda
Parametres : 16 frames, 25 steps, CFG=7.5
Resolution : 512x512
VRAM pic session : 4.5 GB

Fichiers generes (5) :
  animatediff_demo.gif (3123.8 KB)
  animatediff_demo.mp4 (660.3 KB)
  comparison_chat.gif (2997.3 KB)
  comparison_fusee.gif (2570.6 KB)
  comparison_ocean.gif (4283.5 KB)

VRAM liberee

--- PROCHAINES ETAPES ---
1. Module 02-1 : HunyuanVideo (generation video haute qualite)
2. Module 02-2 : LTX-Video (generation rapide et legere)
3. Module 02-3 : Wan 2.1/2.2 (prompts multilingues)
4. Module 02-4 : SVD - Stable Video Diffusion (image-to-video)
5. Combiner 01-4 (upscaling) avec la generation pour des videos HD

Notebook 01-5 AnimateDiff Introduction termine - 00:59:21
Exemple guide : Exploration des Paramètres AnimateDiff
Duree estimee : 25-30 minutes
Objectif
Explorer systematiquement l’impact des paramètres AnimateDiff sur la qualite et le style des videos generees.
Instructions
Grille de paramètres : Completez la fonction ci-dessous pour tester différentes combinaisons de guidance_scale, num_inference_steps et num_frames.
Analyse qualitative : Pour chaque combinaison, enregistrez la video et notez la qualite (coherence temporelle, nettete, presence d’artefacts).
Visualisation des résultats : Créez une grille visuelle comparant les résultats pour identifier les paramètres optimaux.
Indices
- Indice 1 : Utilisez des seeds fixes pour assurer la reproductibilite entre les tests.
- Indice 2 : Le guidance_scale trop eleve (>10) genere souvent des artefacts, trop bas (<3) donne des results flous.
- Indice 3 : Le nombre de frames affecte la coherence temporelle (plus de frames = plus difficile a maintenir).
- Indice 4 :
num_inference_stepsimpacte la qualite mais a un rendement decroissant (>30 steps = peu d’amelioration).
Critères de succès
# Exercice: Exploration systematique des parametres AnimateDiff

def explore_params(grid: Dict[str, List[Any]],
                   prompt: str,
                   pipe) -> pd.DataFrame:
    """
    Explore une grille de parametres et enregistre les resultats.

    Args:
        grid: Dictionnaire {"param_name": [values]}
        prompt: Prompt texte pour la generation
        pipe: Pipeline AnimateDiff charge

    Returns:
        DataFrame avec resultats et metriques
    """
    results = []

    # Exercice: Generer toutes les combinaisons de parametres
    # Exercice: Pour chaque combinaison :
    #   - Generer la video
    #   - Sauvegarder le GIF
    #   - Noter la qualite (manuelle ou automatique)
    # Exercice: Retourner un DataFrame resume

    return pd.DataFrame(results)

# Exercice: Fonction d'evaluation automatique (optionnel)

def evaluate_video_quality(frames: List[np.ndarray]) -> Dict[str, float]:
    """
    Evalue la qualite d'une video generee.

    Args:
        frames: Liste des frames de la video

    Returns:
        Dict avec metriques (coherence, nettete, etc.)
    """
    # Exercice: Calculer la difference moyenne entre frames consecutives
    # Exercice: Mesurer la nettete (variance du Laplacian)
    # Exercice: Detecter les artefacts (pixels satures, etc.)
    pass

# Exercice: Creer la grille de parametres et tester
param_grid = {
    "guidance_scale": [5.0, 7.5, 10.0],
    "num_inference_steps": [15, 25, 35],
    "num_frames": [8, 16, 24]
}

# Exercice: Analyser les resultats et identifier les parametres optimaux
# df_results = explore_params(param_grid, "a cat walking", pipe)