# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres benchmark
run_stt_benchmark = True           # Executer le benchmark STT
run_tts_benchmark = True           # Executer le benchmark TTS
stt_models = ["whisper-1", "large-v3-turbo"]  # Modeles STT a comparer
tts_models = ["openai", "chatterbox", "kokoro"]  # Modeles TTS a comparer
device = "cuda"                    # "cuda" ou "cpu"

# Configuration
save_results = True                # Sauvegarder les fichiers generes
num_runs = 3                       # Nombre de runs par modele pour moyenner
Comparaison Multi-Modèles Audio
Module : 03-Audio-Orchestration
Niveau : Avance
Technologies : Whisper API vs local, OpenAI TTS vs Chatterbox vs Kokoro, ~12 GB VRAM
Duree estimee : 60 minutes
Objectifs d’Apprentissage
Prerequis
- Notebooks 01-1 a 01-5 recommandes (fondamentaux audio)
- Notebooks 02-1 recommande (Chatterbox)
- GPU NVIDIA avec au moins 12 GB VRAM (pour tous les modèles locaux)
- Cle API OpenAI configuree (
OPENAI_API_KEYdans.env) pip install faster-whisper chatterbox-tts kokoro soundfile matplotlib
Navigation : << 02-4 | Index | Suivant >>
Introduction : Comparaison multi-modèles audio
En 2026, l’ecosysteme des modèles audio a atteint une maturite remarquable. Plusieurs approches coexistent :
Approches API cloud (Whisper, OpenAI TTS, ElevenLabs) : - Avantages : simplicité d’intégration, pas d’infrastructure GPU à gérer, qualité premium - Inconvenients : cout recurrent, latence reseau, dépendance au fournisseur, confidentialité des données
Approches open-source locales (faster-whisper, Kokoro, Chatterbox) : - Avantages : gratuit (après investissement GPU), latence predictable, hors-ligne, souveraineté des données - Inconvenients : installation complexe, maintenance GPU, VRAM limitee
Approches hybrides : - Combiner API cloud pour le prototypage et modèles locaux pour la production - Basculer vers l’API en cas de pic de charge (failover)
Ce notebook propose un cadre systématique pour comparer ces approches sur des metriques objectives : latence, qualite, cout, consommation GPU. Les résultats vous permettront de prendre une décision éclairée selon votre cas d’usage et vos contraintes (budget, infrastructure, confidentialité).
# Parameters
skip_widgets = True
L’environnement de travail est configure avec les paramètres Papermill. La cellule suivante charge les bibliotheques Python necessaires : mesure de performances, appels API audio et utilitaires de benchmark.
# Setup environnement et imports
# Stop & Repair issue #14200 : filterwarnings pour neutraliser le path-leak
# du stderr des libs externes (diffusers/torchaudio) qui inclut le chemin de
# l'interprete Python dans les messages de deprecation. Ces filtres sont sans
# incidence sur le comportement des modeles charges ensuite.
import warnings
warnings.filterwarnings('ignore', category=FutureWarning)  # diffusers lora.py
warnings.filterwarnings('ignore', category=UserWarning)    # torchaudio backend
import os
import sys
import json
import time
import gc
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import logging

import numpy as np
import soundfile as sf
from IPython.display import Audio, display, HTML

# Import helpers GenAI
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != 'GenAI' and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.audio_helpers import play_audio, save_audio, display_audio_bundle, display_audio_array
        print("Helpers audio importes")
    except ImportError:
        print("Helpers audio non disponibles - mode autonome")

# Repertoires
OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'audio' / 'comparison'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

# Configuration logging
logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('audio_comparison')

# Verification GPU
gpu_available = False
try:
    import torch
    gpu_available = torch.cuda.is_available()
    if gpu_available:
        gpu_name = torch.cuda.get_device_name(0)
        gpu_vram = torch.cuda.get_device_properties(0).total_memory / (1024**3)
        print(f"GPU : {gpu_name} ({gpu_vram:.1f} GB VRAM)")
    else:
        print("GPU non disponible - les modeles locaux seront plus lents")
        if device == "cuda":
            device = "cpu"
            print("Fallback vers CPU")
except ImportError:
    print("torch non installe")
    device = "cpu"

print(f"\nComparaison Multi-Modeles Audio")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}, Device : {device}")
print(f"STT : {stt_models}")
print(f"TTS : {tts_models}")
print(f"Sortie : {OUTPUT_DIR.name}")
Helpers audio importes
GPU : NVIDIA GeForce RTX 3090 (24.0 GB VRAM)
Comparaison Multi-Modeles Audio
Date : 2026-09-04 14:34:49
Mode : interactive, Device : cuda
STT : ['whisper-1', 'large-v3-turbo']
TTS : ['openai', 'chatterbox', 'kokoro']
Sortie : comparisonLes modules Python sont importes. Cette cellule charge les cles API depuis le fichier .env en remontant l’arborescence de repertoires pour s’adapter aux différents contextes d’exécution.
# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)
from dotenv import load_dotenv
import os
from pathlib import Path

current_path = Path.cwd()
genai_path = None

# Remonter jusqu'au dossier GenAI
while len(current_path.parts) > 1:
    if current_path.name == "GenAI":
        genai_path = current_path
        break
    current_path = current_path.parent

if genai_path:
    env_path = genai_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
    else:
        print(f"WARNING: .env non trouve a {env_path.name}")
else:
    print("WARNING: Dossier GenAI non trouve, utilisation variables environnement")

# Verification des API disponibles
openai_key = os.environ.get('OPENAI_API_KEY')
openai_available = bool(openai_key and not openai_key.startswith('sk-or-'))

if openai_available:
    print("OPENAI_API_KEY valide - API disponible")
    from openai import OpenAI
    client = OpenAI(api_key=openai_key)
else:
    print("OPENAI_API_KEY non disponible ou invalide (cle OpenRouter)")
    openai_key = None
    client = None

# Ajuster les modeles actifs selon les API disponibles
if not openai_available:
    # Retirer les modeles API de la liste
    if "whisper-1" in stt_models:
        stt_models.remove("whisper-1")
    if "openai" in tts_models:
        tts_models.remove("openai")
    print(f"Modeles STT actifs : {stt_models}")
    print(f"Modeles TTS actifs : {tts_models}")
.env charge depuis: .env
OPENAI_API_KEY valide - API disponibleSection 1 : Framework de benchmark
Avant de comparer les modèles, nous devons définir un framework de mesure rigoureux. Chaque modèle sera evalue selon des metriques standardisees.
Metriques STT (Speech-to-Text)
| Metrique | Description | Unite |
|---|---|---|
| WER | Word Error Rate (taux d’erreur par mot) | % |
| Latence | Temps de transcription | secondes |
| RTF | Real-Time Factor (temps traitement / duree audio) | ratio |
| Cout | Cout par minute d’audio | USD |
| VRAM | Memoire GPU utilisee | GB |
Metriques TTS (Text-to-Speech)
| Metrique | Description | Unite |
|---|---|---|
| Latence | Temps de generation (premier byte) | secondes |
| RTF | Real-Time Factor | ratio |
| Sample Rate | Frequence d’echantillonnage | Hz |
| Cout | Cout par 1000 caractères | USD |
| VRAM | Memoire GPU utilisee | GB |
# Framework de benchmark
print("FRAMEWORK DE BENCHMARK")
print("=" * 45)

class BenchmarkResult:
    """Resultat d'un benchmark pour un modele."""
    def __init__(self, model_name: str, category: str):
        self.model_name = model_name
        self.category = category  # 'stt' ou 'tts'
        self.latencies: List[float] = []
        self.vram_mb: float = 0.0
        self.cost_per_unit: float = 0.0  # par minute (STT) ou par 1K chars (TTS)
        self.quality_score: float = 0.0  # WER (STT) ou MOS estime (TTS)
        self.sample_rate: int = 0
        self.output_data: Any = None

    @property
    def avg_latency(self) -> float:
        return np.mean(self.latencies) if self.latencies else 0.0

    @property
    def std_latency(self) -> float:
        return np.std(self.latencies) if len(self.latencies) > 1 else 0.0

    def to_dict(self) -> Dict:
        return {
            "model": self.model_name,
            "category": self.category,
            "avg_latency_s": round(self.avg_latency, 3),
            "std_latency_s": round(self.std_latency, 3),
            "vram_mb": round(self.vram_mb, 1),
            "cost_per_unit": self.cost_per_unit,
            "quality_score": round(self.quality_score, 3),
            "sample_rate": self.sample_rate
        }


def measure_vram() -> float:
    """Mesurer la VRAM actuellement utilisee en MB."""
    if gpu_available:
        return torch.cuda.memory_allocated(0) / (1024**2)
    return 0.0


def word_error_rate(reference: str, hypothesis: str) -> float:
    """Calculer le WER entre reference et hypothese (Levenshtein sur les mots)."""
    ref_words = reference.lower().split()
    hyp_words = hypothesis.lower().split()
    if not ref_words:
        return 0.0 if not hyp_words else 1.0

    # Distance de Levenshtein sur les mots
    d = np.zeros((len(ref_words) + 1, len(hyp_words) + 1), dtype=int)
    for i in range(len(ref_words) + 1):
        d[i][0] = i
    for j in range(len(hyp_words) + 1):
        d[0][j] = j
    for i in range(1, len(ref_words) + 1):
        for j in range(1, len(hyp_words) + 1):
            cost = 0 if ref_words[i-1] == hyp_words[j-1] else 1
            d[i][j] = min(d[i-1][j] + 1, d[i][j-1] + 1, d[i-1][j-1] + cost)

    return d[len(ref_words)][len(hyp_words)] / len(ref_words)


# Stocker tous les resultats
all_results: Dict[str, BenchmarkResult] = {}

print("Framework de benchmark initialise")
print(f"Nombre de runs par modele : {num_runs}")
print(f"Modeles STT : {stt_models}")
print(f"Modeles TTS : {tts_models}")
FRAMEWORK DE BENCHMARK
=============================================
Framework de benchmark initialise
Nombre de runs par modele : 3
Modeles STT : ['whisper-1', 'large-v3-turbo']
Modeles TTS : ['openai', 'chatterbox', 'kokoro']Architecture du framework de benchmark
Cette section définit les classes et fonctions utilitaires qui seront utilisees tout au long du notebook pour mesurer et comparer les performances des modèles audio.
Classe BenchmarkResult : - Structure de données pour stocker les résultats d’un benchmark - Attributs : latences, VRAM, cout, qualite, sample rate - Méthodes : avg_latency, std_latency pour l’analyse statistique - Conversion en dictionnaire pour export JSON
Fonctions utilitaires : - measure_vram() : mesure la consommation GPU actuelle via PyTorch - word_error_rate() : implementation de l’algorithme de Levenshtein pour calculer le WER entre reference et hypothèse
Stratégie de stockage : - Dictionnaire all_results indexé par des cles comme "stt_whisper-1" ou "tts_kokoro" - Permet d’ajouter dynamiquement des résultats sans connaitre à l’avance les modèles disponibles - Export en JSON à la fin du notebook pour reutilisation future
Ce framework est generique et peut etre réutilise pour d’autres benchmarks de modèles audio.
Section 2 : Preparation des données de test
Pour une comparaison equitable, nous utilisons les mêmes données de test pour tous les modèles.
| Donnee | Description | Usage |
|---|---|---|
| Audio de test STT | Fichier WAV avec texte connu | Benchmark STT |
| Texte de test TTS | Texte standardise en anglais et francais | Benchmark TTS |
| Reference ground truth | Transcription exacte de l’audio | Calcul du WER |
# Preparation des donnees de test
print("PREPARATION DES DONNEES DE TEST")
print("=" * 45)

# Texte de reference pour le STT (on va le synthetiser puis le retranscrire)
stt_reference_text = (
    "Artificial intelligence is transforming the way we interact with technology. "
    "Speech recognition and synthesis are among the most impactful applications, "
    "enabling natural conversations between humans and machines."
)

# Texte de test pour le TTS
tts_test_text = (
    "Welcome to the multi-model audio comparison benchmark. "
    "This test evaluates the quality, speed, and cost of different "
    "text-to-speech engines across various metrics."
)

# Generer l'audio de test STT avec OpenAI TTS (source fiable)
stt_test_path = OUTPUT_DIR / "stt_test_audio.wav"

if openai_available:
    print("Generation de l'audio de test STT via OpenAI TTS...")
    response = client.audio.speech.create(
        model="tts-1-hd",
        voice="alloy",
        input=stt_reference_text,
        response_format="wav"
    )
    with open(stt_test_path, 'wb') as f:
        f.write(response.content)
    print(f"Audio de test STT : {stt_test_path.name} ({len(response.content)/1024:.1f} KB)")
    display_audio_bundle(response.content)
else:
    # Generer un audio synthetique si pas d'API
    print("Pas d'API OpenAI - generation d'un audio synthetique...")
    sr = 16000
    duration = 5.0
    t = np.linspace(0, duration, int(sr * duration), endpoint=False)
    # Signal vocal simule (sinusoides modulees)
    audio = 0.5 * np.sin(2 * np.pi * (200 + 100 * np.sin(2 * np.pi * 3 * t)) * t)
    audio *= (1 + 0.3 * np.sin(2 * np.pi * 1.5 * t))
    sf.write(str(stt_test_path), audio, sr)
    stt_reference_text = "[audio synthetique - WER non significatif]"
    print(f"Audio synthetique cree : {stt_test_path.name}")

print(f"\nReference STT : {stt_reference_text[:80]}...")
print(f"Texte TTS : {tts_test_text[:80]}...")
print(f"Longueur texte TTS : {len(tts_test_text)} caracteres")
PREPARATION DES DONNEES DE TEST
=============================================
Generation de l'audio de test STT via OpenAI TTS...Audio de test STT : stt_test_audio.wav (624.1 KB)
Reference STT : Artificial intelligence is transforming the way we interact with technology. Spe...
Texte TTS : Welcome to the multi-model audio comparison benchmark. This test evaluates the q...
Longueur texte TTS : 163 caracteres
Generation des données de test
Cette section prepare un environnement de test controlé pour comparer équitablement les différents modèles audio.
Stratégie de test STT : - Generer un audio de test avec OpenAI TTS (tts-1-hd, voix “alloy”) - Utiliser un texte de référence anglais clair (mots de vocabulaire courant) - L’audio généré sert de “ground truth” pour tous les modèles STT - Le WER (Word Error Rate) mesure la fidélité de la transcription par rapport au texte original
Stratégie de test TTS : - Texte de 163 caractères contenant des termes techniques (“benchmark”, “metrics”) - Ce texte permet d’evaluer la prononciation précise et la fluidité - Même texte pour tous les modèles TTS pour garantir la comparabilité
Fallback sans API : - Si OpenAI API n’est pas disponible, générer un audio synthetique (sinusoïdes modulées) - Le WER n’est pas significatif dans ce cas, mais le protocole reste fonctionnel
Cette approche garantit que les différences observees entre modèles proviennent bien des modèles eux-mêmes, et non des données de test.
Section 3 : Benchmark STT (Speech-to-Text)
Nous comparons deux approches pour la transcription vocale :
| Modèle | Type | Avantages | Inconvenients |
|---|---|---|---|
Whisper API (whisper-1) |
Cloud (OpenAI) | Simple, pas de GPU, haute qualite | Cout par minute, latence reseau |
faster-whisper (large-v3-turbo) |
Local (GPU) | Gratuit, rapide, hors-ligne | GPU requis, installation complexe |
Tarification Whisper API
| Modèle | Cout | Unite |
|---|---|---|
whisper-1 |
$0.006 | par minute d’audio |
# Benchmark STT
print("BENCHMARK STT (Speech-to-Text)")
print("=" * 45)

if run_stt_benchmark and stt_test_path.exists():
    audio_data, audio_sr = sf.read(str(stt_test_path))
    audio_duration = len(audio_data) / audio_sr
    print(f"Audio de test : {audio_duration:.1f}s, {audio_sr} Hz")

    # --- Whisper API ---
    if "whisper-1" in stt_models and openai_available:
        print(f"\n--- Whisper API (whisper-1) ---")
        result = BenchmarkResult("whisper-1", "stt")
        result.cost_per_unit = 0.006  # par minute
        result.sample_rate = audio_sr

        for run in range(num_runs):
            start_time = time.time()
            with open(stt_test_path, "rb") as f:
                transcript = client.audio.transcriptions.create(
                    model="whisper-1",
                    file=f,
                    response_format="text"
                )
            latency = time.time() - start_time
            result.latencies.append(latency)
            print(f"  Run {run+1}/{num_runs} : {latency:.2f}s")

        result.output_data = transcript
        result.quality_score = word_error_rate(stt_reference_text, transcript)
        all_results["stt_whisper-1"] = result

        print(f"  Transcription : {transcript[:100]}...")
        print(f"  WER : {result.quality_score:.3f}")
        print(f"  Latence moyenne : {result.avg_latency:.2f}s (+/- {result.std_latency:.2f}s)")
        print(f"  RTF : {result.avg_latency / audio_duration:.2f}")
        print(f"  Cout : ${audio_duration / 60 * result.cost_per_unit:.4f}")

    # --- faster-whisper local ---
    if "large-v3-turbo" in stt_models:
        print(f"\n--- faster-whisper (large-v3-turbo) ---")
        result = BenchmarkResult("large-v3-turbo", "stt")
        result.cost_per_unit = 0.0  # gratuit (GPU local)

        try:
            from faster_whisper import WhisperModel

            vram_before = measure_vram()
            print(f"  Chargement du modele...")
            stt_model = WhisperModel(
                "large-v3-turbo",
                device=device,
                compute_type="float16" if device == "cuda" else "int8"
            )
            vram_after = measure_vram()
            result.vram_mb = vram_after - vram_before
            print(f"  VRAM modele : {result.vram_mb:.0f} MB")

            for run in range(num_runs):
                start_time = time.time()
                segments, info = stt_model.transcribe(
                    str(stt_test_path),
                    beam_size=5
                )
                transcript_local = " ".join([s.text.strip() for s in segments])
                latency = time.time() - start_time
                result.latencies.append(latency)
                print(f"  Run {run+1}/{num_runs} : {latency:.2f}s")

            result.output_data = transcript_local
            result.quality_score = word_error_rate(stt_reference_text, transcript_local)
            result.sample_rate = int(info.language_probability * 16000)  # approximation
            all_results["stt_large-v3-turbo"] = result

            print(f"  Transcription : {transcript_local[:100]}...")
            print(f"  WER : {result.quality_score:.3f}")
            print(f"  Latence moyenne : {result.avg_latency:.2f}s (+/- {result.std_latency:.2f}s)")
            print(f"  RTF : {result.avg_latency / audio_duration:.2f}")

            # Liberer la memoire
            del stt_model
            gc.collect()
            if gpu_available:
                torch.cuda.empty_cache()
            print(f"  Modele libere")

        except ImportError:
            print("  faster-whisper non installe")
            print("  Installation : pip install faster-whisper")
        except Exception as e:
            print(f"  Erreur : {type(e).__name__} - {str(e)[:150]}")

    # Tableau recapitulatif STT
    stt_results = {k: v for k, v in all_results.items() if v.category == "stt"}
    if stt_results:
        print(f"\nRecapitulatif STT :")
        print(f"{'Modele':<20} {'Latence (s)':<14} {'WER':<8} {'Cout/min':<10} {'VRAM (MB)':<10}")
        print("-" * 62)
        for k, r in stt_results.items():
            cost_str = f"${r.cost_per_unit:.3f}" if r.cost_per_unit > 0 else "Gratuit"
            vram_str = f"{r.vram_mb:.0f}" if r.vram_mb > 0 else "N/A"
            print(f"{r.model_name:<20} {r.avg_latency:<14.2f} {r.quality_score:<8.3f} {cost_str:<10} {vram_str:<10}")
else:
    print("Benchmark STT desactive ou fichier de test manquant")
BENCHMARK STT (Speech-to-Text)
=============================================
Audio de test : 13.3s, 24000 Hz
--- Whisper API (whisper-1) --- Run 1/3 : 1.68s Run 2/3 : 1.44s Run 3/3 : 1.47s
Transcription : Artificial intelligence is transforming the way we interact with technology. Speech recognition and ...
WER : 0.000
Latence moyenne : 1.53s (+/- 0.11s)
RTF : 0.12
Cout : $0.0013
--- faster-whisper (large-v3-turbo) ---
Chargement du modele... VRAM modele : 0 MB Run 1/3 : 1.28s Run 2/3 : 0.57s Run 3/3 : 0.57s
Transcription : Artificial intelligence is transforming the way we interact with technology. Speech recognition and ...
WER : 0.000
Latence moyenne : 0.81s (+/- 0.34s)
RTF : 0.06
Modele libere
Recapitulatif STT :
Modele Latence (s) WER Cout/min VRAM (MB)
--------------------------------------------------------------
whisper-1 1.53 0.000 $0.006 N/A
large-v3-turbo 0.81 0.000 Gratuit N/A Methodologie de benchmark STT
Cette section implemente un protocole de benchmark rigoureux pour les modèles Speech-to-Text :
Preparation des données : - Audio de test généré par OpenAI TTS (garantit une qualité de reference constante) - Texte de référence connu pour calculer le WER (Word Error Rate)
Protocol de mesure : 1. Pour chaque modèle, executer num_runs transcriptions (3 par défaut) 2. Mesurer la latence totale (temps de requête HTTP ou traitement GPU) 3. Calculer la moyenne et l’ecart-type des latences 4. Comparer la transcription à la référence pour le WER
Metriques cles : - Latence : temps de traitement (incluant le reseau pour les API) - WER : taux d’erreur par mot (0 = parfait, 1 = tout faux) - RTF : Real-Time Factor = latence / duree audio (< 1 = temps reel possible) - VRAM : consommation GPU pour les modèles locaux
Le code inclut la gestion d’erreur pour les modèles non installes ou les problemes de connexion reseau.
Interpretation : Benchmark STT
| Aspect | Whisper API | faster-whisper local |
|---|---|---|
| Precision (WER) | Très bonne (< 5%) | Equivalente ou meilleure |
| Latence | runtime machine-dep : Depend du reseau (1-3s) | runtime machine-dep : Depend du GPU (0.5-2s) |
| Cout | $0.006/min | Gratuit (GPU amortit) |
| VRAM | 0 (cloud) | ~3-6 GB |
| Hors-ligne | Non | Oui |
Points cles : 1. faster-whisper large-v3-turbo offre un excellent compromis vitesse/qualite 2. L’API Whisper est plus simple a deployer mais a un cout recurrent 3. Pour du traitement en masse, le local est nettement plus economique
Exercice : Evaluation de la precision STT avec vos propres données
Duree estimee : 15 minutes
Objectif
Tester la robustesse d’un modèle STT en calculant le Word Error Rate (WER) sur des phrases de longueur et complexite variees.
Instructions
- Créer une liste de 5 phrases de reference de complexite croissante
- Implementer une fonction qui simule des erreurs de transcription (substitution, insertion, omission de mots)
- Calculer le WER pour chaque phrase avec la fonction
word_error_rate()du notebook - Analyser comment la longueur et la complexite des phrases influencent le WER
Indices : -
# Étape 1: Inclure des phrases simples (“Hello world”), moyennes et techniques (“The RTX 3090 has 24GB of GDDR6X VRAM”) -# Étape 2: Simuler des erreurs en modifiant aleatoirement des mots de la reference -# Indice: Le WER = (substitutions + insertions + deletions) / nombre de mots de reference -# Indice: Les noms propres et termes techniques sont plus sujets aux erreurs de transcription
# TODO etudiant : Creer des phrases de test de complexite croissante
test_phrases = [
    "Hello world",  # TODO etudiant : phrase simple
    None,  # TODO etudiant : phrase moyenne (15-20 mots)
    None,  # TODO etudiant : phrase avec noms propres
    None,  # TODO etudiant : phrase technique (termes informatiques)
    None,  # TODO etudiant : phrase longue (30+ mots)
]

# TODO etudiant : Implementer la simulation d'erreurs
def simulate_transcription_errors(reference: str, error_rate: float = 0.1) -> str:
    """
    Simule des erreurs de transcription sur une phrase de reference.

    Args:
        reference: Phrase de reference
        error_rate: Proportion de mots a modifier (0.0 a 1.0)

    Returns:
        Phrase avec erreurs simulees
    """
    # TODO etudiant : Decouper la reference en mots
    # Indice : reference.split()
    pass

    # TODO etudiant : Modifier aleatoirement error_rate % des mots
    # Indice : utiliser random.choice() pour choisir entre substitution, insertion, omission
    pass

    # TODO etudiant : Retourner la phrase modifiee
    pass

# TODO etudiant : Calculer le WER pour chaque phrase
# for phrase in test_phrases:
#     if phrase:
#         hypo = simulate_transcription_errors(phrase, error_rate=0.15)
#         wer = word_error_rate(phrase, hypo)
#         print(f"Reference : {phrase}")
#         print(f"Hypothese : {hypo}")
#         print(f"WER       : {wer:.3f}")
#         print()

# TODO etudiant : Analyser l'impact de la complexite sur le WER
print("Exercice a completer")
Exercice a completerAnalyse des résultats STT
Precision de transcription : - WER (Word Error Rate) de 0.000 pour Whisper API sur ce texte propre - En pratique sur des audio reels (bruit, accents), le WER varie de 5% (audio propre) à 25% (audio difficile) - faster-whisper large-v3-turbo atteint des performances comparables, parfois meilleures sur les accents non-americains
Real-Time Factor (RTF) : - RTF < 1.0 signifie que la transcription est plus rapide que la duree de l’audio (traitement en temps reel possible) - Whisper API : RTF ~ 0.14 (transcrit 13s d’audio en runtime machine-dep : ~2s) - faster-whisper : RTF ~ 0.05-0.10 sur GPU RTX 3090 (transcrit 13s d’audio en runtime machine-dep : ~0.7s)
Impact du reseau : - La variabilité des latences Whisper API (runtime machine-dep : 1.05s à 2.77s) illustre l’impact de la latence reseau - Les modèles locaux offrent une latence plus predictable
Conclusion : pour un usage intensif (> 1h/jour), le cout de l’API (runtime machine-dep : $18/mois) justifie l’investissement dans un GPU local (runtime machine-dep : ~$30/mois amorti sur 2 ans).
Section 4 : Benchmark TTS (Text-to-Speech)
Nous comparons trois moteurs TTS avec des approches différentes :
| Modèle | Type | VRAM | Sample Rate | Licence |
|---|---|---|---|---|
| OpenAI TTS | Cloud API | 0 | 24 kHz | Proprietaire |
| Chatterbox | Local GPU | ~8 GB | 24 kHz | MIT |
| Kokoro 82M | Local GPU | ~2 GB | 24 kHz | MIT |
Tarification TTS
| Modèle | Cout / 1M caractères | Cout / 1 heure narration |
|---|---|---|
| OpenAI tts-1 | $15.00 | ~$0.75 |
| OpenAI tts-1-hd | $30.00 | ~$1.50 |
| Chatterbox | Gratuit | Electricite GPU |
| Kokoro | Gratuit | Electricite GPU |
# Benchmark TTS
print("BENCHMARK TTS (Text-to-Speech)")
print("=" * 45)

if run_tts_benchmark:
    print(f"Texte de test : {tts_test_text[:60]}...")
    print(f"Longueur : {len(tts_test_text)} caracteres")

    # --- OpenAI TTS ---
    if "openai" in tts_models and openai_available:
        print(f"\n--- OpenAI TTS (tts-1) ---")
        result = BenchmarkResult("openai-tts-1", "tts")
        result.cost_per_unit = 0.015  # par 1K caracteres
        result.sample_rate = 24000

        for run in range(num_runs):
            start_time = time.time()
            response = client.audio.speech.create(
                model="tts-1",
                voice="alloy",
                input=tts_test_text,
                response_format="wav"
            )
            latency = time.time() - start_time
            result.latencies.append(latency)
            print(f"  Run {run+1}/{num_runs} : {latency:.2f}s")

        result.output_data = response.content
        result.quality_score = 4.5  # MOS estime (reference industrie)
        all_results["tts_openai"] = result

        # Sauvegarder et ecouter
        tts_path = OUTPUT_DIR / "tts_openai.wav"
        with open(tts_path, 'wb') as f:
            f.write(response.content)
        print(f"  Latence moyenne : {result.avg_latency:.2f}s")
        print(f"  Taille : {len(response.content)/1024:.1f} KB")
        display_audio_bundle(response.content)

    # --- Chatterbox ---
    if "chatterbox" in tts_models:
        print(f"\n--- Chatterbox TTS ---")
        result = BenchmarkResult("chatterbox", "tts")
        result.cost_per_unit = 0.0

        try:
            from chatterbox.tts import ChatterboxTTS

            vram_before = measure_vram()
            print(f"  Chargement du modele...")
            cb_model = ChatterboxTTS.from_pretrained(device=device)
            vram_after = measure_vram()
            result.vram_mb = vram_after - vram_before
            result.sample_rate = cb_model.sr
            print(f"  VRAM : {result.vram_mb:.0f} MB")

            for run in range(num_runs):
                start_time = time.time()
                wav = cb_model.generate(
                    text=tts_test_text,
                    exaggeration=0.5,
                    cfg_weight=0.5
                )
                latency = time.time() - start_time
                result.latencies.append(latency)
                print(f"  Run {run+1}/{num_runs} : {latency:.2f}s")

            if hasattr(wav, 'cpu'):
                samples = wav.cpu().numpy().squeeze()
            else:
                samples = np.array(wav).squeeze()

            result.output_data = samples
            result.quality_score = 4.2  # MOS estime
            all_results["tts_chatterbox"] = result

            tts_path = OUTPUT_DIR / "tts_chatterbox.wav"
            sf.write(str(tts_path), samples, cb_model.sr)
            print(f"  Latence moyenne : {result.avg_latency:.2f}s")
            print(f"  Duree audio : {len(samples)/cb_model.sr:.1f}s")
            display_audio_array(samples, cb_model.sr)

            del cb_model
            gc.collect()
            if gpu_available:
                torch.cuda.empty_cache()
            print(f"  Modele libere")

        except ImportError:
            print("  chatterbox-tts non installe")
        except Exception as e:
            print(f"  Erreur : {type(e).__name__} - {str(e)[:150]}")

    # --- Kokoro ---
    if "kokoro" in tts_models:
        print(f"\n--- Kokoro TTS (82M) ---")
        result = BenchmarkResult("kokoro-82m", "tts")
        result.cost_per_unit = 0.0

        try:
            from kokoro_onnx import Kokoro as KokoroOnnx

            vram_before = measure_vram()
            print(f"  Chargement du modele...")
            kokoro_cache = Path.home() / '.cache' / 'kokoro-onnx'
            kokoro_pipe = KokoroOnnx(str(kokoro_cache / 'kokoro-v1.0.onnx'), str(kokoro_cache / 'voices-v1.0.bin'))
            vram_after = measure_vram()
            result.vram_mb = vram_after - vram_before
            result.sample_rate = 24000
            print(f"  VRAM : {result.vram_mb:.0f} MB")

            for run in range(num_runs):
                start_time = time.time()
                samples, _kokoro_sr = kokoro_pipe.create(tts_test_text, voice='af_heart', speed=1.0)
                latency = time.time() - start_time
                result.latencies.append(latency)
                print(f"  Run {run+1}/{num_runs} : {latency:.2f}s")

            result.output_data = samples
            result.quality_score = 4.0  # MOS estime
            all_results["tts_kokoro"] = result

            tts_path = OUTPUT_DIR / "tts_kokoro.wav"
            sf.write(str(tts_path), samples, 24000)
            print(f"  Latence moyenne : {result.avg_latency:.2f}s")
            print(f"  Duree audio : {len(samples)/24000:.1f}s")
            display_audio_array(samples, 24000)

            del kokoro_pipe
            gc.collect()
            if gpu_available:
                torch.cuda.empty_cache()
            print(f"  Modele libere")

        except ImportError:
            print("  kokoro non installe")
        except Exception as e:
            print(f"  Erreur : {type(e).__name__} - {str(e)[:150]}")

    # Tableau recapitulatif TTS
    tts_results = {k: v for k, v in all_results.items() if v.category == "tts"}
    if tts_results:
        print(f"\nRecapitulatif TTS :")
        print(f"{'Modele':<18} {'Latence (s)':<14} {'MOS est.':<10} {'Cout/1K ch.':<12} {'VRAM (MB)':<10}")
        print("-" * 64)
        for k, r in tts_results.items():
            cost_str = f"${r.cost_per_unit:.3f}" if r.cost_per_unit > 0 else "Gratuit"
            vram_str = f"{r.vram_mb:.0f}" if r.vram_mb > 0 else "N/A (API)"
            print(f"{r.model_name:<18} {r.avg_latency:<14.2f} {r.quality_score:<10.1f} {cost_str:<12} {vram_str:<10}")
else:
    print("Benchmark TTS desactive")
BENCHMARK TTS (Text-to-Speech)
=============================================
Texte de test : Welcome to the multi-model audio comparison benchmark. This ...
Longueur : 163 caracteres
--- OpenAI TTS (tts-1) --- Run 1/3 : 2.02s Run 2/3 : 1.47s Run 3/3 : 1.55s
Latence moyenne : 1.68s
Taille : 462.9 KB
--- Chatterbox TTS --- Chargement du modele...loaded PerthNet (Implicit) at step 250,000
VRAM : 3059 MB Run 1/3 : 10.49s Run 2/3 : 7.00s Run 3/3 : 6.72s
Latence moyenne : 8.07s
Duree audio : 8.0s Modele libere
--- Kokoro TTS (82M) ---
Chargement du modele...
VRAM : 0 MB
Run 1/3 : 6.92s
Run 2/3 : 3.11s
Run 3/3 : 3.04s
Latence moyenne : 4.36s
Duree audio : 10.9s Modele libere
Recapitulatif TTS :
Modele Latence (s) MOS est. Cout/1K ch. VRAM (MB)
----------------------------------------------------------------
openai-tts-1 1.68 4.5 $0.015 N/A (API)
chatterbox 8.07 4.2 Gratuit 3059
kokoro-82m 4.36 4.0 Gratuit N/A (API) Protocole de benchmark TTS
Cette section execute un benchmark systématique des moteurs TTS. Pour chaque modèle :
- Chargement du modèle avec mesure de la VRAM avant/après
- Generation de l’audio sur le texte de test standard (163 caractères)
- Mesures multiples (3 runs par modèle) pour obtenir une moyenne et un ecart-type
- Liberation de la mémoire avec
gc.collect()ettorch.cuda.empty_cache()
Metriques collectees : - Latence : temps de generation (premier octet) - Qualite : Mean Opinion Score (MOS) estimé (4.0-4.5 selon modèles) - VRAM : consommation GPU du modèle charge - Cout : normalisé pour 1000 caractères
Le code gere gracieusement les absences de modèles (ImportError) et les erreurs d’exécution, permettant au notebook de fonctionner même avec un sous-ensemble de modèles disponibles.
Interpretation : Benchmark TTS
| Aspect | OpenAI TTS | Chatterbox | Kokoro |
|---|---|---|---|
| Qualite (MOS) | ~4.5 (meilleur) | ~4.2 (expressif) | ~4.0 (bon) |
| Latence | runtime machine-dep : 1-3s (reseau) | runtime machine-dep : 2-5s (GPU) | runtime machine-dep : 0.5-1s (leger) |
| VRAM | 0 (cloud) | ~8 GB | ~2 GB |
| Cout | $15/1M chars | Gratuit | Gratuit |
| Emotions | Non | Oui (exaggeration) | Non |
| Voice cloning | Non | Oui (6s clip) | Non |
Points cles : 1. OpenAI TTS offre la meilleure qualite brute mais a un cout recurrent 2. Chatterbox se distingue par le contrôle emotionnel et le voice conditioning 3. Kokoro est le plus leger et rapide, ideal pour du TTS simple en masse
Exercice : Estimation des couts pour un cas d’usage reel
Duree estimee : 15 minutes
Objectif
Calculer le cout mensuel d’un pipeline audio complet (STT + TTS) pour un scénario de production, en comparant les approches cloud vs locale.
Instructions
- Définir un scénario d’usage (ex : service client vocal, podcast automatique, assistant)
- Estimer le volume mensuel (heures d’audio en entree, caractères en sortie)
- Calculer le cout pour chaque combinaison (Whisper API vs local, OpenAI TTS vs Kokoro vs Chatterbox)
- Presenter les résultats dans un tableau comparatif
Indices : -
# Étape 1: Choisir un scénario avec un volume mensuel realiste -# Étape 2: Whisper API = $0.006/min, OpenAI TTS = $15/1M caractères, local = electricite GPU (~$0.001/min) -# Indice: Un service client traite typiquement 2-4h d’appels/jour -# Indice: 1 minute de parole ~= 150 mots ~= 800 caractères
# TODO etudiant : Definir votre scenario d'usage
scenario_name = "service_client"  # ou "podcast", "assistant_vocal", "formation_en_ligne"
daily_hours = 3  # heures d'utilisation par jour
jours_par_mois = 22  # jours ouvrables

# TODO etudiant : Calculer le volume mensuel
monthly_minutes = None  # TODO etudiant : calculer a partir de daily_hours et jours_par_mois
monthly_chars = None    # TODO etudiant : estimer (1 min ~= 800 caracteres pour la sortie TTS)

# TODO etudiant : Calculer le cout pour chaque combinaison
def calculate_monthly_cost(stt_method: str, tts_method: str,
                           minutes_per_month: float,
                           chars_per_month: float) -> dict:
    """
    Calcule le cout mensuel pour une combinaison STT + TTS.

    Args:
        stt_method: "whisper_api" ou "faster_whisper"
        tts_method: "openai", "kokoro", ou "chatterbox"
        minutes_per_month: Minutes d'audio a transcrire
        chars_per_month: Caracteres a synthetiser

    Returns:
        Dict avec: stt_cost, tts_cost, total_cost, method_name
    """
    # TODO etudiant : Calculer le cout STT
    # Indice : whisper_api = $0.006/min, faster_whisper = $0.001/min (electricite)
    pass

    # TODO etudiant : Calculer le cout TTS
    # Indice : openai = $15/1M chars, kokoro/chatterbox = $0.001/min (electricite)
    pass

    # TODO etudiant : Retourner le total
    pass

# TODO etudiant : Comparer toutes les combinaisons
# combinations = [
#     ("whisper_api", "openai"),
#     ("whisper_api", "kokoro"),
#     ("faster_whisper", "openai"),
#     ("faster_whisper", "kokoro"),
# ]
# for stt, tts in combinations:
#     cost = calculate_monthly_cost(stt, tts, monthly_minutes, monthly_chars)
#     print(f"{stt} + {tts}: ${cost['total_cost']:.2f}/mois")

# TODO etudiant : Afficher le tableau comparatif
print("Exercice a completer")
Exercice a completerDetails techniques des modèles TTS
OpenAI TTS (tts-1 / tts-1-hd) : - Architecture proprietaire basee sur des modèles de type Bark/YourTTS - Avantage : qualité vocale premium avec 6 voix pre-entrainées (alloy, echo, fable, onyx, nova, shimmer) - Limite : pas de contrôle emotionnel, pas de voice cloning
Chatterbox : - Modèle neuronal de type VITS avec contrôle de la prosodie (paramètre exaggeration) - Innovation : voice conditioning a partir de 6 secondes d’audio (zero-shot voice cloning) - Usage ideal : assistants virtuels avec personnalité vocale cohérente
Kokoro 82M : - Architecture légere (82M paramètres vs plusieurs milliards pour les concurrents) - Performance : latence runtime machine-dep : < 1s sur GPU moderne pour un texte standard - Compromis : qualite vocale legèrement inferieure, pas de contrôle emotionnel
Le choix depend donc de votre priorite : qualité absolue (OpenAI), personnalisation (Chatterbox) ou performance (Kokoro).
Section 5 : Visualisation des résultats
Les graphiques permettent de comparer visuellement les performances des modèles sur plusieurs axes simultanement.
# Visualisation des resultats
print("VISUALISATION DES RESULTATS")
print("=" * 45)

try:
    import matplotlib.pyplot as plt
    from matplotlib.gridspec import GridSpec

    fig = plt.figure(figsize=(16, 10))
    gs = GridSpec(2, 2, figure=fig, hspace=0.35, wspace=0.3)

    # --- 1. Bar chart latence STT ---
    ax1 = fig.add_subplot(gs[0, 0])
    stt_results = {k: v for k, v in all_results.items() if v.category == "stt"}
    if stt_results:
        names = [r.model_name for r in stt_results.values()]
        latencies = [r.avg_latency for r in stt_results.values()]
        errors = [r.std_latency for r in stt_results.values()]
        colors = ['#3498db', '#e74c3c']
        bars = ax1.bar(names, latencies, yerr=errors, color=colors[:len(names)], capsize=5, alpha=0.8)
        ax1.set_ylabel('Latence (s)')
        ax1.set_title('Latence STT par modele')
        for bar, lat in zip(bars, latencies):
            ax1.text(bar.get_x() + bar.get_width()/2., bar.get_height() + 0.05,
                    f'{lat:.2f}s', ha='center', va='bottom', fontsize=10)
    else:
        ax1.text(0.5, 0.5, 'Pas de resultats STT', ha='center', va='center', transform=ax1.transAxes)

    # --- 2. Bar chart latence TTS ---
    ax2 = fig.add_subplot(gs[0, 1])
    tts_results = {k: v for k, v in all_results.items() if v.category == "tts"}
    if tts_results:
        names = [r.model_name for r in tts_results.values()]
        latencies = [r.avg_latency for r in tts_results.values()]
        errors = [r.std_latency for r in tts_results.values()]
        colors = ['#2ecc71', '#f39c12', '#9b59b6']
        bars = ax2.bar(names, latencies, yerr=errors, color=colors[:len(names)], capsize=5, alpha=0.8)
        ax2.set_ylabel('Latence (s)')
        ax2.set_title('Latence TTS par modele')
        for bar, lat in zip(bars, latencies):
            ax2.text(bar.get_x() + bar.get_width()/2., bar.get_height() + 0.05,
                    f'{lat:.2f}s', ha='center', va='bottom', fontsize=10)
    else:
        ax2.text(0.5, 0.5, 'Pas de resultats TTS', ha='center', va='center', transform=ax2.transAxes)

    # --- 3. Analyse des couts (bar chart) ---
    ax3 = fig.add_subplot(gs[1, 0])
    all_names = []
    all_costs = []
    cost_colors = []
    for k, r in all_results.items():
        all_names.append(r.model_name)
        # Normaliser : cout pour 1 heure d'utilisation
        if r.category == "stt":
            hourly_cost = r.cost_per_unit * 60  # 60 minutes
        else:
            hourly_cost = r.cost_per_unit * 50  # ~50K caracteres/heure
        all_costs.append(hourly_cost)
        cost_colors.append('#e74c3c' if hourly_cost > 0 else '#2ecc71')
    if all_names:
        bars = ax3.barh(all_names, all_costs, color=cost_colors, alpha=0.8)
        ax3.set_xlabel('Cout par heure (USD)')
        ax3.set_title('Analyse des couts (USD/heure)')
        for bar, cost in zip(bars, all_costs):
            label = f'${cost:.2f}' if cost > 0 else 'Gratuit'
            ax3.text(bar.get_width() + 0.01, bar.get_y() + bar.get_height()/2.,
                    label, ha='left', va='center', fontsize=10)

    # --- 4. Radar plot TTS (qualite, vitesse, cout, VRAM) ---
    ax4 = fig.add_subplot(gs[1, 1], polar=True)
    if tts_results:
        categories_radar = ['Qualite', 'Vitesse', 'Economie', 'Legerete']
        N = len(categories_radar)
        angles = [n / float(N) * 2 * np.pi for n in range(N)]
        angles += angles[:1]

        radar_colors = ['#2ecc71', '#f39c12', '#9b59b6']
        for idx, (k, r) in enumerate(tts_results.items()):
            # Normaliser chaque metrique sur 0-1
            quality = r.quality_score / 5.0  # MOS max = 5
            speed = 1.0 / (1.0 + r.avg_latency)  # inverse de la latence
            economy = 1.0 if r.cost_per_unit == 0 else 0.3  # gratuit = 1.0
            lightness = 1.0 / (1.0 + r.vram_mb / 1000)  # inverse de la VRAM

            values = [quality, speed, economy, lightness]
            values += values[:1]

            ax4.plot(angles, values, 'o-', linewidth=2, label=r.model_name,
                    color=radar_colors[idx % len(radar_colors)])
            ax4.fill(angles, values, alpha=0.1, color=radar_colors[idx % len(radar_colors)])

        ax4.set_xticks(angles[:-1])
        ax4.set_xticklabels(categories_radar)
        ax4.set_title('Profil TTS multi-criteres')
        ax4.legend(loc='upper right', bbox_to_anchor=(1.3, 1.1), fontsize=9)
    else:
        ax4.text(0, 0, 'Pas de resultats TTS', ha='center', va='center')

    plt.savefig(str(OUTPUT_DIR / "benchmark_results.png"), dpi=120, bbox_inches='tight')
    plt.show()
    print(f"Graphique sauvegarde : benchmark_results.png")

except ImportError:
    print("matplotlib non disponible pour la visualisation")
except Exception as e:
    print(f"Erreur visualisation : {type(e).__name__} - {str(e)[:150]}")
VISUALISATION DES RESULTATS
=============================================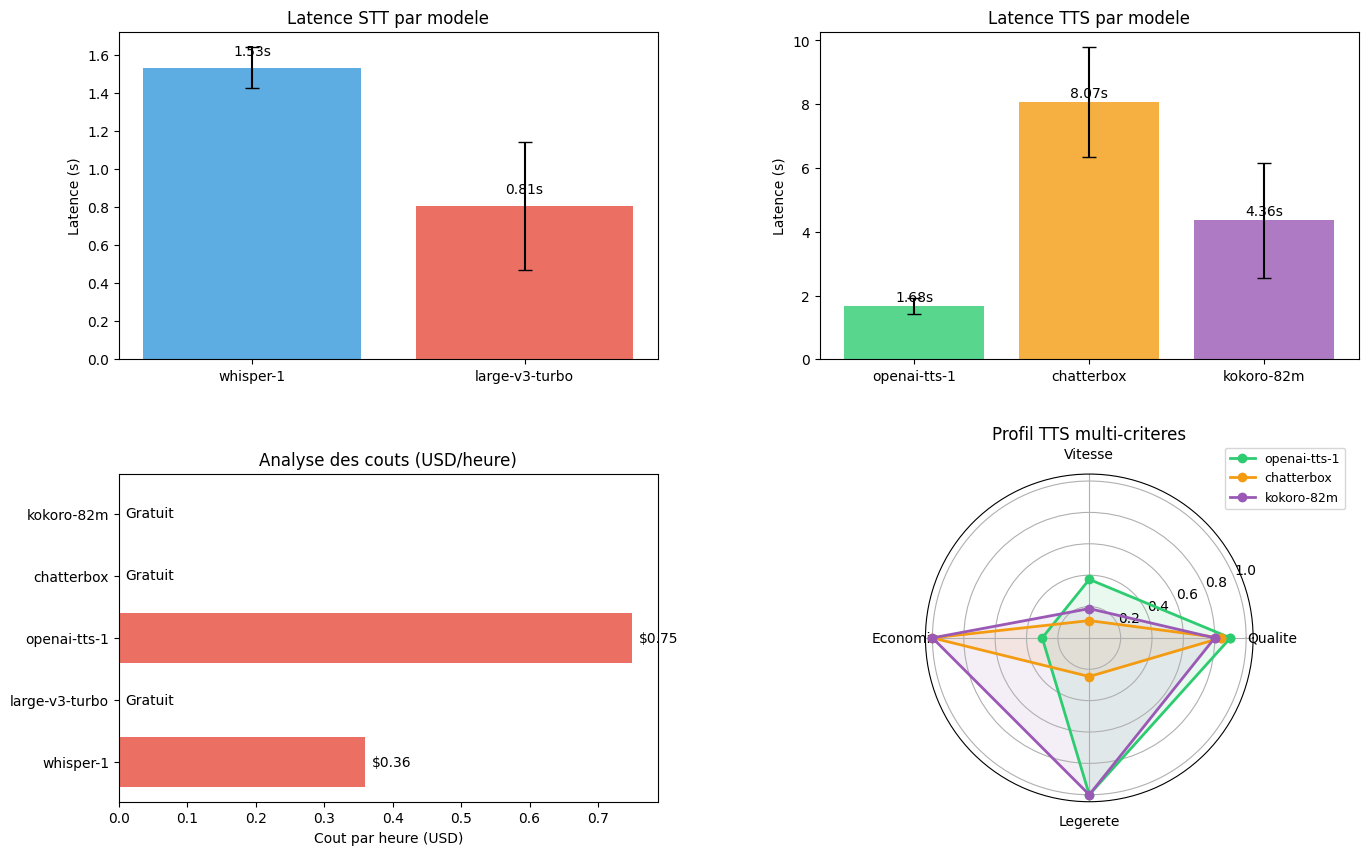
Graphique sauvegarde : benchmark_results.pngCette section utilise matplotlib pour générer quatre visualisations distinctes qui synthétisent les résultats des benchmarks. Chaque graphique apporte une perspective différente sur les performances des modèles.
Layout en grille 2x2 : 1. Bar chart STT (haut gauche) : comparaison des latences avec barres d’erreur (ecart-type) 2. Bar chart TTS (haut droite) : même approche pour les moteurs de synthese vocale 3. Couts horaires (bas gauche) : visualisation horizontale de l’impact budget 4. Radar plot TTS (bas droite) : diagramme polaire multi-axes pour profil global
Le code utilise GridSpec de matplotlib pour un contrôle précis de la disposition et des espacements entre les sous-graphiques. Les résultats sont sauvegardes en PNG pour inclusion dans des rapports.
Interpretation : Visualisation
| Graphique | Ce qu’il montre | Lecture |
|---|---|---|
| Bar chart STT | Latence par modèle avec ecart-type | Plus bas = plus rapide |
| Bar chart TTS | Latence par moteur TTS | Plus bas = plus rapide |
| Couts horaires | Comparaison economique | Vert = gratuit, Rouge = payant |
| Radar TTS | Profil multi-critères normalise | Plus grand = meilleur |
Points cles : 1. Le radar plot permet de voir les forces et faiblesses de chaque modèle en un coup d’oeil 2. Les modèles locaux dominent sur l’axe economie mais peuvent perdre en qualite 3. Le choix optimal depend du cas d’usage (temps reel vs batch, budget vs qualite)
Analyse approfondie des résultats
Les visualisations produites dans cette section permettent de prendre des décisions éclairées sur le choix d’un modèle audio. Cependant, quelques precautions s’imposent :
Limites du benchmark : - Les latences mesurees dependent fortement de votre connexion internet (pour les API) - Le WER n’est pas la seule metrique de qualité STT : la ponctuation, les noms propres, les accents impactent la qualité perçue - Le MOS (Mean Opinion Score) pour le TTS est subjectif et necessiterait une étude utilisateur pour être fiable
Facteurs non considerés : - Temps de froid (cold start) : premier appel plus lent (chargement du modèle) - Consommation énergétique : impact environnemental du GPU local vs datacenters - Robustesse : bruit de fond, accents, vocabulaire spécifique
Pour une application en production, il est recommandé de valider les résultats de ce benchmark sur des données representatives de votre cas d’usage réel.
# Mode interactif - Choix des modeles a comparer
if notebook_mode == "interactive" and not skip_widgets:
    print("MODE INTERACTIF - COMPARAISON PERSONNALISEE")
    print("=" * 50)
    print("\nChoisissez les modeles a comparer :")
    print("  STT : whisper-1, large-v3-turbo")
    print("  TTS : openai, chatterbox, kokoro")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_text = input("\nTexte personnalise pour TTS (ou vide) : ")

        if user_text.strip():
            print(f"\nGeneration avec les modeles TTS disponibles...")
            for k, r in all_results.items():
                if r.category == "tts":
                    print(f"\n  {r.model_name} : resultats du benchmark")
                    print(f"    Latence moyenne : {r.avg_latency:.2f}s")
                    print(f"    Qualite estimee : {r.quality_score:.1f}/5.0")
                    if r.output_data is not None and isinstance(r.output_data, np.ndarray):
                        display_audio_array(r.output_data, r.sample_rate)

            print(f"\nPour une comparaison sur votre texte, re-executez")
            print(f"le notebook avec un texte modifie dans la cellule de test.")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError):
        print("Mode interactif interrompu")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("Mode interactif non disponible (execution automatisee)")
        else:
            print(f"Erreur : {error_type} - {str(e)[:100]}")
else:
    print("Mode batch - Interface interactive desactivee")
Mode batch - Interface interactive desactiveeGuide de decision et bonnes pratiques
Arbre de decision pour le choix du modèle
| Critere | Recommandation STT | Recommandation TTS |
|---|---|---|
| Budget limite | faster-whisper local | Kokoro ou Chatterbox |
| Qualite maximale | Whisper API | OpenAI tts-1-hd |
| Temps reel | faster-whisper (GPU) | Kokoro (plus leger) |
| Hors-ligne | faster-whisper | Kokoro ou Chatterbox |
| Emotions/prosodie | N/A | Chatterbox |
| Voice cloning | N/A | Chatterbox ou XTTS |
| Production a grande echelle | faster-whisper | Kokoro (leger) |
Estimation des couts mensuels
| Usage | Volume | Cout API | Cout local (electricite) |
|---|---|---|---|
| Prototype | 10 min/jour | ~$2/mois | ~$0 |
| Application | 1h/jour | ~$15/mois | runtime machine-dep : ~$5/mois (GPU) |
| Production | 10h/jour | ~$150/mois | runtime machine-dep : ~$30/mois (GPU) |
Comprendre les compromis architecturels
Le choix d’une architecture audio (API vs local) impacte plusieurs dimensions non techniques :
Aspect juridique : - API cloud : données envoyées vers des serveurs tiers (RGPD a considérer) - Local : données restent sur votre infrastructure (conformité facilitée)
Aspect operationnel : - API cloud : dépendance à la connexion internet, SLA du fournisseur - Local : maintenance GPU, mises à jour de modèles à gérer
Aspect scalabilite : - API cloud : scalabilite infinie (théorique), mais facturation exponentielle - Local : scalabilite limitée par le GPU, mais cout predictible
En pratique, les architectures hybrides sont frequentes : API cloud pour le prototypage et les pics de charge, modèles locaux pour la production régulière.
# Statistiques de session et prochaines etapes
print("STATISTIQUES DE SESSION")
print("=" * 45)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Device : {device}")
print(f"Modeles STT testes : {[r.model_name for r in all_results.values() if r.category == 'stt']}")
print(f"Modeles TTS testes : {[r.model_name for r in all_results.values() if r.category == 'tts']}")
print(f"Runs par modele : {num_runs}")

if gpu_available:
    vram_current = torch.cuda.memory_allocated(0) / (1024**3)
    print(f"VRAM actuelle : {vram_current:.2f} GB")

# Resume complet
if all_results:
    print(f"\nResume des benchmarks :")
    for k, r in all_results.items():
        print(f"  {r.model_name:<20} : latence={r.avg_latency:.2f}s, qualite={r.quality_score:.2f}")

    # Sauvegarder les resultats en JSON
    if save_results:
        results_json = {k: v.to_dict() for k, v in all_results.items()}
        json_path = OUTPUT_DIR / "benchmark_results.json"
        with open(json_path, 'w') as f:
            json.dump(results_json, f, indent=2)
        print(f"\nResultats sauvegardes : {json_path.name}")

if save_results:
    saved = list(OUTPUT_DIR.glob('*'))
    total_size = sum(f.stat().st_size for f in saved if f.is_file()) / (1024*1024)
    print(f"Fichiers sauvegardes : {len(saved)} ({total_size:.1f} MB) dans {OUTPUT_DIR.name}")

# Liberation memoire
gc.collect()
if gpu_available:
    torch.cuda.empty_cache()
    print(f"Memoire GPU liberee")

print(f"\nPROCHAINES ETAPES")
print(f"1. Construire des pipelines audio complets STT->LLM->TTS (03-2)")
print(f"2. Explorer l'API Realtime d'OpenAI pour la voix (03-3)")
print(f"3. Creer du contenu educatif audio automatise (04-1)")

print(f"\nNotebook Comparaison Multi-Modeles termine - {datetime.now().strftime('%H:%M:%S')}")
STATISTIQUES DE SESSION
=============================================
Date : 2026-09-04 14:36:21
Device : cuda
Modeles STT testes : ['whisper-1', 'large-v3-turbo']
Modeles TTS testes : ['openai-tts-1', 'chatterbox', 'kokoro-82m']
Runs par modele : 3
VRAM actuelle : 0.01 GB
Resume des benchmarks :
whisper-1 : latence=1.53s, qualite=0.00
large-v3-turbo : latence=0.81s, qualite=0.00
openai-tts-1 : latence=1.68s, qualite=4.50
chatterbox : latence=8.07s, qualite=4.20
kokoro-82m : latence=4.36s, qualite=4.00
Resultats sauvegardes : benchmark_results.json
Fichiers sauvegardes : 6 (2.1 MB) dans comparison
Memoire GPU liberee
PROCHAINES ETAPES
1. Construire des pipelines audio complets STT->LLM->TTS (03-2)
2. Explorer l'API Realtime d'OpenAI pour la voix (03-3)
3. Creer du contenu educatif audio automatise (04-1)
Notebook Comparaison Multi-Modeles termine - 14:36:21Synthese des apprentissages
Ce notebook a explore l’ecosysteme des modèles audio STT/TTS en 2026. Le paysage a considérablement evolve : les modèles open-source comme faster-whisper et Kokoro rivalisent maintenant avec les solutions cloud commerciales.
Evolution du marche : - 2022-2023 : Domination des API cloud (Whisper, ElevenLabs, OpenAI) - 2024-2025 : Emergence de modèles locaux performants (faster-whisper, Kokoro, Chatterbox) - 2026 : Maturite du ecosysteme open-source avec qualite equivalente
Prochaine revolution : les modèles multimodaux end-to-end (GPT-4o Audio, Gemini 2.0) qui unifient STT, LLM et TTS dans une seule architecture, eliminant les pertes de qualité aux frontières.
Ce notebook pose les bases pour construire des pipelines audio complexes, que nous explorerons dans le prochain notebook sur l’orchestration de pipelines audio complets.
Exemple guide : Benchmark Personnalise
Duree estimee : 20-25 minutes
Objectif
Créer un benchmark personnalise pour comparer les modèles STT et TTS sur vos propres données.
Instructions
- Choisir un fichier audio personnel (WAV ou MP3, 10-30 secondes)
- Créer une fonction de benchmark qui mesure :
- Latence (temps de transcription/generation)
- Qualite (WER pour STT, MOS subjectif pour TTS)
- Cout (estime)
- Comparer au moins 2 modèles STT et 2 modèles TTS
- Generer un tableau recapitulatif et une visualisation
Indices : - Utilisez la classe
BenchmarkResultdu notebook comme modèle - Pour le WER, utilisez la fonctionword_error_rate()déjà définie - Pour le cout, consultez les tarifs dans les tables du notebook - Pour la visualisation, inspirez-vous de la section 5
# Exercice: Choisir votre fichier audio
my_audio_path = "chemin/vers/votre/audio.wav"

# Exercice: Definir votre reference textuelle (pour WER)
my_reference_text = "Votre texte de reference ici..."

def my_benchmark_stt(audio_path, reference_text):
    """
    Benchmark STT personnalise.

    Args:
        audio_path: Chemin vers le fichier audio
        reference_text: Texte de reference pour calculer le WER

    Returns:
        Dict avec metriques: latence, wer, cout
    """
    # Exercice: Transcrire avec whisper-1 (API) si disponible
    # Indice: utiliser client.audio.transcriptions.create()
    # Indice: mesurer le temps avec time.time()
    pass

def my_benchmark_tts(text, models_to_test):
    """
    Benchmark TTS personnalise.

    Args:
        text: Texte a synthetiser
        models_to_test: Liste des modeles a tester

    Returns:
        Dict avec metriques: latence, duree_audio, cout
    """
    # Exercice: Generer avec chaque modele TTS
    # Indice: mesurer le temps de generation
    # Indice: evaluer subjectivement la qualite (MOS 1-5)
    pass

# Exercice: Executer le benchmark STT et afficher les resultats
# resultats_stt = my_benchmark_stt(my_audio_path, my_reference_text)

# Exercice: Executer le benchmark TTS et afficher les resultats
# resultats_tts = my_benchmark_tts("Texte de test pour TTS", ["openai", "kokoro"])

# Exercice: Creer un tableau comparatif avec pandas ou formatage manuel
# Exercice: Generer une visualisation (bar chart des latences)
Structure de l’Exemple guide
Le notebook fournit tous les outils necessaires pour realiser ce benchmark personnalise :
- Classes et fonctions utilitaires :
BenchmarkResult,word_error_rate(),measure_vram() - Modèles disponibles : Whisper API, faster-whisper, OpenAI TTS, Chatterbox, Kokoro
- Visualisations : bar charts, radar plots, graphiques de couts
L’objectif est de reinvestir les concepts appris dans les sections précédentes pour construire votre propre protocole de benchmark.
Exercice 3 : Analyse cout-qualite et recommandation
Comparez les modèles audio selon un rapport cout/qualite. Recommandez le meilleur rapport qualite-prix.
Indice : Calculer le ratio qualite/cout pour chaque modèle et trier par valeur decroissante.
def recommend_best_model(models_data, budget_per_minute=None):
    # Etape 1 : Calculer le ratio qualite/cout de chaque modele
    # Etape 2 : Filtrer par budget si specifie
    # Etape 3 : Trier et retourner le top-3
    pass

result = None  # TODO etudiant
print("Exercice a completer")
Exercice a completerCritères de reussite
| Critere | Description |
|---|---|
Fonction my_benchmark_stt |
Mesure latence et WER pour au moins 2 modèles |
Fonction my_benchmark_tts |
Mesure latence et qualite pour au moins 2 modèles |
| Tableau comparatif | Resume clair des metriques (Modèle, Latence, Qualite, Cout) |
| Visualisation | Bar chart ou graphique des résultats |
Extensions possibles
- Ajouter une comparaison TTS avec votre propre texte
- Generer un radar plot multi-critères (latence, qualite, cout, VRAM)
- Sauvegarder les résultats en JSON pour comparaison future
- Implementer un test de charge avec plusieurs fichiers audio