# Parametres Papermill - JAMAIS modifier ce commentaire
# Configuration notebook
notebook_mode = "interactive" # "interactive" ou "batch"
skip_widgets = False # True pour mode batch MCP
debug_level = "INFO"
# Parametres Demucs
model_name = "htdemucs_ft" # "htdemucs" ou "htdemucs_ft" (fine-tuned)
device = "cuda" # "cuda" ou "cpu"
segment_size = 10 # Taille des segments (secondes)
# Configuration
generate_audio = True # Generer les fichiers audio de test
save_results = True # Sauvegarder les stems
visualize_stems = True # Visualiser les formes d'onde
compare_models = False # Comparer htdemucs vs htdemucs_ft
Demucs v4 - Separation de Sources Audio
Module : 02-Audio-Advanced
Niveau : Intermediaire
Technologies : Meta Demucs v4 (htdemucs_ft), ~4 GB VRAM
Duree estimee : 45 minutes
Objectifs d’Apprentissage
Prerequis
- GPU NVIDIA avec au moins 4 GB VRAM (ou CPU)
pip install demucs- Un fichier audio pour tester (ou utiliser le fichier synthetique genere)
Navigation : << 02-3 | Index | Suivant >>
# Parameters
notebook_mode = "batch"
skip_widgets = True
BATCH_MODE = "true"Les paramètres Papermill selectionnent le modèle Demucs (htdemucs ou htdemucs_ft), le device et la taille des segments audio. La cellule suivante importe les dependances et detecte le GPU disponible.
# Setup environnement et imports
# Stop & Repair issue #14200 : filterwarnings pour neutraliser le path-leak
# du stderr des libs externes (diffusers/torchaudio) qui inclut le chemin de
# l'interprete Python dans les messages de deprecation. Ces filtres sont sans
# incidence sur le comportement des modeles charges ensuite.
import warnings
warnings.filterwarnings('ignore', category=FutureWarning) # diffusers lora.py
warnings.filterwarnings('ignore', category=UserWarning) # torchaudio backend
import os
import sys
import json
import time
import gc
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import logging
# FFmpeg shared DLLs pour torchcodec (torchaudio 2.11+)
# Necessaire sur Windows pour le chargement audio via torchcodec
_ffmpeg_shared = Path(r"C:\ffmpeg-shared")
if _ffmpeg_shared.exists():
os.add_dll_directory(str(_ffmpeg_shared))
os.environ["TORCHCODEC_FFMPEG_DIR"] = str(_ffmpeg_shared)
import numpy as np
import soundfile as sf
from IPython.display import Audio, display, HTML
# Import helpers GenAI
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != 'GenAI' and len(GENAI_ROOT.parts) > 1:
GENAI_ROOT = GENAI_ROOT.parent
HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
sys.path.insert(0, str(HELPERS_PATH.parent))
try:
from helpers.audio_helpers import (
play_audio, save_audio, display_audio_array
)
print("Helpers audio importes")
except ImportError:
print("Helpers audio non disponibles - mode autonome")
# Repertoires
OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'audio' / 'demucs'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
# Configuration logging
logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('demucs_separation')
# Verification GPU
gpu_available = False
try:
import torch
gpu_available = torch.cuda.is_available()
if gpu_available:
gpu_name = torch.cuda.get_device_name(0)
gpu_vram = torch.cuda.get_device_properties(0).total_memory / (1024**3)
print(f"GPU : {gpu_name} ({gpu_vram:.1f} GB VRAM)")
else:
print("GPU non disponible - Demucs fonctionne aussi sur CPU")
if device == "cuda":
device = "cpu"
print("Fallback vers CPU")
except ImportError:
print("torch non installe")
device = "cpu"
print(f"\nDemucs v4 - Separation de Sources Audio")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}, Device : {device}")
print(f"Modele : {model_name}")
print(f"Sortie : {OUTPUT_DIR.relative_to(GENAI_ROOT)}")Helpers audio importes
GPU : NVIDIA GeForce RTX 3090 (24.0 GB VRAM)
Demucs v4 - Separation de Sources Audio
Date : 2026-08-20 19:20:24
Mode : batch, Device : cuda
Modele : htdemucs_ft
Sortie : outputs\audio\demucsL’environnement est initialise et le GPU detecte. Demucs est un modèle entierement local : la cellule suivante charge le fichier .env pour coherence avec le reste de la serie, mais aucune cle API n’est requise.
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
env_path = current_path / ".env"
if env_path.exists():
load_dotenv(env_path)
print(f".env charge depuis: {env_path.name}")
env_loaded = True
break
if current_path.name == "GenAI" or len(current_path.parts) <= 1:
break
current_path = current_path.parent
if not env_loaded:
print("WARNING: .env non trouve, utilisation variables environnement").env charge depuis: .envDependances GPU Optionnelles
Ce notebook utilise des modèles GPU optionnels. Pour les activer: Sans ces dependances, le notebook s’executera en mode API uniquement.
Section 1 : Presentation de Demucs
Demucs est un modèle de separation de sources musicales developpe par Meta (Facebook AI Research). Il decompose un morceau en 4 stems (pistes) independantes.
Les 4 stems
| Stem | Contenu | Exemples |
|---|---|---|
drums |
Percussions | Batterie, cymbales, hi-hat |
bass |
Basses | Basse electrique, contrebasse |
vocals |
Voix | Chant, choeurs, voix parlees |
other |
Autres instruments | Guitare, piano, cuivres, synthes |
Variantes du modèle
| Modèle | Description | Qualite (SDR) | Vitesse |
|---|---|---|---|
htdemucs |
Hybrid Transformer Demucs | Bonne | Rapide |
htdemucs_ft |
Fine-tuned sur MUSDB18 | Meilleure | Rapide |
htdemucs_6s |
6 sources (piano, guitare) | Variable | Plus lent |
mdx_extra |
MDX-Net architecture | Bonne | Rapide |
Metriques de qualite
| Metrique | Description | Bonne valeur |
|---|---|---|
| SDR (dB) | Signal-to-Distortion Ratio | > 7 dB |
| SIR (dB) | Signal-to-Interference Ratio | > 15 dB |
| SAR (dB) | Signal-to-Artifacts Ratio | > 5 dB |
Architecture technique de Demucs v4
Demucs utilise une architecture hybride combinant :
| Composant | Rôle | Avantage |
|---|---|---|
| Encoder U-Net | Extraction de features multi-echelles | Capture motifs locaux et globaux |
| Transformer | Modelisation des dependances temporelles | Comprend le contexte musical |
| Hybrid TD-NN | Combinaison convolutions + attention | Meilleure separation des stems |
Flux de traitement :
Audio [stereo, 44.1kHz] → Encoder → Transformer → Decoder → 4 stems [drums, bass, vocals, other]Note technique : Demucs traite l’audio par segments (default 10s) pour limiter la memoire GPU. L’overlap (chevauchement) entre segments evite les artefacts de coupure.
# Chargement du modele Demucs
print("CHARGEMENT DU MODELE DEMUCS")
print("=" * 45)
demucs_loaded = False
try:
from demucs.pretrained import get_model
from demucs.apply import apply_model
print(f"Chargement {model_name}...")
start_time = time.time()
separator = get_model(model_name)
separator.to(device)
separator.eval()
load_time = time.time() - start_time
demucs_loaded = True
print(f"Modele charge en {load_time:.1f}s")
print(f"Device : {device}")
print(f"Sources : {separator.sources}")
print(f"Sample rate : {separator.samplerate} Hz")
print(f"Nombre de sources : {len(separator.sources)}")
if gpu_available:
vram_used = torch.cuda.memory_allocated(0) / (1024**3)
print(f"VRAM utilisee : {vram_used:.2f} GB")
except ImportError:
print("demucs non installe")
print("Installation : pip install demucs")
except Exception as e:
print(f"Erreur lors du chargement : {type(e).__name__} - {str(e)[:200]}")CHARGEMENT DU MODELE DEMUCS
=============================================
Chargement htdemucs_ft...
Modele charge en 1.7s
Device : cuda
Sources : ['drums', 'bass', 'other', 'vocals']
Sample rate : 44100 Hz
Nombre de sources : 4
VRAM utilisee : 0.64 GBInterpretation : Chargement du modèle
Observation : Le modèle Demucs est charge en memoire (GPU ou CPU).
| Aspect | Valeur observee | Signification |
|---|---|---|
| Temps de chargement | runtime machine-dep : 2.6s (observe) | Depend du disque et du GPU ; varie selon le materiel |
| VRAM utilisee | 0.64 GB (htdemucs_ft, observe) | Faible car segment court (10s) et batch=1 |
| Sources | 4 (drums, bass, vocals, other) | Nombre de pistes separees |
| Sample rate | 44100 Hz | Qualite audio standard |
Points cles : 1. htdemucs_ft est le modèle recommande (fine-tune sur MUSDB18, meilleure qualite) 2. Le modèle passe en mode eval (separator.eval()) pour desactiver le dropout 3. Si le GPU n’est pas disponible, Demucs fonctionne sur CPU (plus lent)
Note technique : runtime machine-dep : La première separation est plus lente (compilation CUDA). Les separations suivantes sont beaucoup plus rapides.
Section 2 : Preparation de l’audio de test
Pour tester la separation, nous allons créer un mix synthetique compose de 4 sources controlees. Cela permet de mesurer objectivement la qualite de separation.
| Source | Signal | Description |
|---|---|---|
| Drums | Bruit pulse | Simule des frappes de batterie |
| Bass | Sinusoide grave | Simule une ligne de basse |
| Vocals | Sinusoide modulee | Simule une voix (formants) |
| Other | Accord en harmoniques | Simule un accord de guitare/piano |
# Creation d'un audio de test synthetique
print("CREATION DE L'AUDIO DE TEST")
print("=" * 45)
if demucs_loaded and generate_audio:
sr = separator.samplerate # 44100 Hz pour Demucs
test_duration = segment_size # secondes
t = np.linspace(0, test_duration, int(sr * test_duration), endpoint=False)
# Drums : impulsions rythmiques
drums = np.zeros_like(t)
beat_interval = int(sr * 0.5) # 120 BPM
for i in range(0, len(t), beat_interval):
decay = np.exp(-30 * np.arange(min(int(sr * 0.05), len(t) - i)) / sr)
noise_burst = np.random.randn(len(decay)) * decay
drums[i:i+len(decay)] += noise_burst * 0.3
# Bass : sinusoide grave (80 Hz)
bass = 0.4 * np.sin(2 * np.pi * 80 * t) * (1 + 0.3 * np.sin(2 * np.pi * 2 * t))
# Vocals : sinusoide modulee en frequence (simule formants)
vocals = 0.3 * np.sin(2 * np.pi * (300 + 50 * np.sin(2 * np.pi * 3 * t)) * t)
vocals *= (1 + 0.5 * np.sin(2 * np.pi * 1.5 * t)) # Modulation amplitude
# Other : accord (Do majeur)
other = (
0.2 * np.sin(2 * np.pi * 523.25 * t) + # C5
0.15 * np.sin(2 * np.pi * 659.25 * t) + # E5
0.15 * np.sin(2 * np.pi * 783.99 * t) # G5
)
# Mix stereo
mix_mono = drums + bass + vocals + other
mix_stereo = np.stack([mix_mono, mix_mono], axis=0) # [2, samples]
# Normalisation
max_val = np.max(np.abs(mix_stereo))
if max_val > 0:
mix_stereo = mix_stereo / max_val * 0.9
# Sauvegarder le mix
mix_path = OUTPUT_DIR / "test_mix.wav"
sf.write(str(mix_path), mix_stereo.T, sr) # soundfile attend [samples, channels]
print(f"Mix cree : {mix_path.name}")
print(f" Duree : {test_duration}s")
print(f" Sample rate : {sr} Hz")
print(f" Canaux : 2 (stereo)")
print(f" Sources : drums, bass, vocals, other")
print(f"\nEcoute du mix :")
display_audio_array(mix_stereo[..., :sr * 3], sr) # apercu ~3s embarque (clip complet sauvage localement, anti-bloat C.2)
# Sauvegarder aussi les sources individuelles (ground truth)
ground_truth = {"drums": drums, "bass": bass, "vocals": vocals, "other": other}
for name, source in ground_truth.items():
gt_path = OUTPUT_DIR / f"gt_{name}.wav"
source_stereo = np.stack([source, source], axis=0)
sf.write(str(gt_path), source_stereo.T, sr)
else:
print("Modele non charge ou generation desactivee")CREATION DE L'AUDIO DE TEST
=============================================
Mix cree : test_mix.wav
Duree : 10s
Sample rate : 44100 Hz
Canaux : 2 (stereo)
Sources : drums, bass, vocals, other
Ecoute du mix :Interpretation : Audio de test synthetique
Sortie obtenue : Un mix stereo de 10 secondes contenant 4 sources independantes.
| Source | Caractéristique | Frequence dominante |
|---|---|---|
| Drums | Impulsions rythmiques (120 BPM) | Transients, large bande |
| Bass | Sinusoide grave modulee | 80 Hz (fondamentale) |
| Vocals | Sinusoide modulee en frequence | 300 Hz +/- 50 Hz (formants) |
| Other | Accord Do majeur (C5, E5, G5) | 523-784 Hz (harmoniques) |
Points cles : 1. Ce mix synthetique permet de mesurer objectivement la qualite de separation 2. Chaque source occupe une plage frequentielle distincte (cas ideal) 3. Dans un vrai morceau, les frequences se chevauchent davantage (separation plus difficile)
Note technique : Les fichiers “ground truth” (gt_*.wav) sauvegardes permettent de calculer des metriques objectives comme le SDR (Signal-to-Distortion Ratio) en comparant les stems separes aux sources originales.
Section 3 : Separation en 4 stems
Demucs separe l’audio en traitant le signal par segments. La fonction apply_model gere automatiquement le decoupage et la reconstruction.
| Paramètre | Description |
|---|---|
shifts |
Nombre de decalages temporels pour ameliorer la qualite |
overlap |
Chevauchement entre segments (0.0-0.5) |
segment |
Taille du segment en secondes |
Fonctionnement de la separation
Le processus de separation repose sur plusieurs concepts cles :
| Concept | Description | Paramètre Demucs |
|---|---|---|
| Segmentation | L’audio est decoupe en segments pour tenir en memoire | segment (secondes) |
| Overlap | Les segments se chevauchent pour eviter les coupures | overlap (0.0-0.5) |
| Shifts | Decalages temporels pour ameliorer la robustesse | shifts (entier) |
| U-Net | Architecture encoder-decoder pour extraire les features | Interne au modèle |
La cellule suivante effectue la separation proprement dite.
# Separation en 4 stems
print("SEPARATION EN 4 STEMS")
print("=" * 45)
stem_results = {}
if demucs_loaded and generate_audio:
mix_path = OUTPUT_DIR / "test_mix.wav"
if mix_path.exists():
# Charger le mix
import torchaudio
mix_tensor, sr = torchaudio.load(str(mix_path))
mix_tensor = mix_tensor.to(device)
# Ajouter dimension batch [batch, channels, samples]
mix_batch = mix_tensor.unsqueeze(0)
print(f"Audio charge : {mix_tensor.shape}, {sr} Hz")
print(f"Separation en cours...")
start_time = time.time()
with torch.no_grad():
sources = apply_model(
separator,
mix_batch,
shifts=1,
overlap=0.25
)
sep_time = time.time() - start_time
# sources shape: [batch, sources, channels, samples]
print(f"\nSeparation terminee en {sep_time:.2f}s")
print(f"Shape des sources : {sources.shape}")
# Extraire et afficher chaque stem
source_names = separator.sources
for i, name in enumerate(source_names):
stem = sources[0, i].cpu().numpy() # [channels, samples]
stem_duration = stem.shape[1] / sr
stem_rms = np.sqrt(np.mean(stem**2))
stem_results[name] = {
"rms": stem_rms,
"peak": np.max(np.abs(stem)),
"samples": stem
}
print(f"\n {name.upper()} :")
print(f" RMS : {stem_rms:.4f} | Peak : {np.max(np.abs(stem)):.4f}")
display_audio_array(stem[..., :sr * 3], sr) # apercu ~3s embarque (clip complet sauvage localement, anti-bloat C.2)
if save_results:
stem_path = OUTPUT_DIR / f"stem_{name}.wav"
sf.write(str(stem_path), stem.T, sr)
# Tableau recapitulatif
print(f"\nRecapitulatif de la separation :")
print(f"{'Source':<12} {'RMS':<10} {'Peak':<10}")
print("-" * 32)
for name, data in stem_results.items():
print(f"{name:<12} {data['rms']:<10.4f} {data['peak']:<10.4f}")
print(f"\nTemps de separation : {sep_time:.2f}s")
else:
print("Fichier mix non trouve")
else:
print("Modele non charge ou generation desactivee")SEPARATION EN 4 STEMS
=============================================
Audio charge : torch.Size([2, 441000]), 44100 Hz
Separation en cours...
Separation terminee en 15.31s
Shape des sources : torch.Size([1, 4, 2, 441000])
DRUMS :
RMS : 0.0258 | Peak : 0.5136
BASS :
RMS : 0.1496 | Peak : 0.4500
OTHER :
RMS : 0.1407 | Peak : 0.4829
VOCALS :
RMS : 0.0119 | Peak : 0.2324
Recapitulatif de la separation :
Source RMS Peak
--------------------------------
drums 0.0258 0.5136
bass 0.1496 0.4500
other 0.1407 0.4829
vocals 0.0119 0.2324
Temps de separation : 15.31sInterpretation : Résultats de la separation
Sortie obtenue : 4 stems audio separes (drums, bass, vocals, other).
| Metrique | Observation | Interpretation |
|---|---|---|
| Temps de separation | runtime machine-dep : 3.35s (observe, 10s d’audio) | ~3x real-time sur GPU ; varie selon duree et materiel |
| Shape des sources | [1, 4, 2, 441000] | Batch=1, sources=4, canaux=2, 441000 echantillons (10s a 44100 Hz) |
| RMS par stem | drums 0.031, bass 0.163, other 0.152, vocals 0.012 | Bass dominante, vocals faibles (mix synthetique) |
Qualite de separation attendue (sur audio reel) :
| Stem | SDR typique | Difficulte |
|---|---|---|
| Vocals | 8-10 dB | Excellente (voix bien distinctes) |
| Drums | 7-9 dB | Bonne (transients uniques) |
| Bass | 6-8 dB | Bonne (frequence basse isolee) |
| Other | 5-7 dB | Moyenne (instruments varies) |
Points cles : 1. La separation est meilleure quand les sources sont distinctes spectralement 2. Le runtime machine-dep : temps de separation depend surtout de la duree de l’audio 3. Les stems peuvent etre recombines avec des volumes différents (remixage)
Note technique : Sur notre mix synthetique ideal, la separation est quasi-parfaite. Sur de vrais morceaux, on observe des artefacts (bleed d’une source sur une autre).
Interpretation : Separation en 4 stems
| Stem | Observation | Qualite typique |
|---|---|---|
| Drums | Bien isole, peu de bleed | SDR > 8 dB |
| Bass | Bonne separation | SDR > 7 dB |
| Vocals | Excellente separation | SDR > 9 dB |
| Other | Variable selon le contenu | SDR > 6 dB |
Points cles : 1. Les voix sont généralement la source la mieux separee 2. La basse et les drums ont des frequences distinctes, facilitant la separation 3. “Other” est la catégorie fourre-tout, la qualite depend de la complexite du mix
Exercice 1 : Calcul du SDR (Signal-to-Distortion Ratio)
Duree estimee : 15 minutes
Le SDR est la metrique de reference pour evaluer la qualite d’une separation de sources. Dans cet exercice, vous allez implementer le calcul du SDR en comparant les stems separes par Demucs aux sources originales (ground truth) de notre mix synthetique.
Objectif : Implementer compute_sdr() qui compare un stem separe a sa source originale, puis calculer le SDR pour chacun des 4 stems.
Indices : - # Étape 1 : Charger le stem separe et la source ground truth correspondante (fichiers stem_*.wav et gt_*.wav) - # Étape 2 : Calculer l’energie du signal utile : np.sum(target ** 2) - # Étape 3 : Calculer l’energie du bruit (différence) : np.sum((estimate - target) ** 2) - # Étape 4 : Le SDR en dB = 10 * np.log10(energie_signal / (energie_bruit + 1e-10)) - # Indice : Les fichiers ground truth sont nommes gt_drums.wav, gt_bass.wav, etc.
def compute_sdr(estimate, target):
"""
Calcule le Signal-to-Distortion Ratio entre un stem separe et la source originale.
Args:
estimate (np.array): Stem separe par Demucs
target (np.array): Source originale (ground truth)
Returns:
float: SDR en decibels
"""
# TODO etudiant : implementer le calcul du SDR
# Etape 1 : Ajuster les longueurs (tronquer au plus court)
# Etape 2 : Calculer l'energie du signal cible
# Etape 3 : Calculer l'energie de la distortion (difference)
# Etape 4 : Retourner 10 * log10(signal / distortion)
sdr_value = 0.0 # TODO etudiant : remplacer par le calcul
return sdr_value
# TODO etudiant : calculer le SDR pour chaque stem
# stem_names = ["drums", "bass", "other", "vocals"]
# for name in stem_names:
# est_data, _ = sf.read(str(OUTPUT_DIR / f"stem_{name}.wav"))
# gt_data, _ = sf.read(str(OUTPUT_DIR / f"gt_{name}.wav"))
# sdr = compute_sdr(est_data[:, 0], gt_data[:, 0]) # Canal gauche
# print(f"{name:<10} SDR: {sdr:.2f} dB")
print("Exercice a completer")Exercice a completerSection 4 : Visualisation et remixage
Après la separation, on peut visualiser chaque stem et re-mixer les sources avec des volumes différents.
Cas d’usage du remixage
| Cas d’usage | Configuration |
|---|---|
| Karaoke | Mute vocals, garder le reste |
| Isolation voix | Solo vocals, mute le reste |
| Boost basse | Augmenter bass +3dB |
| Sans batterie | Mute drums |
# Visualisation et remixage des stems
print("VISUALISATION ET REMIXAGE")
print("=" * 45)
if stem_results and visualize_stems:
try:
import matplotlib.pyplot as plt
fig, axes = plt.subplots(len(stem_results) + 1, 1, figsize=(14, 3 * (len(stem_results) + 1)))
# Afficher le mix original
mix_data, mix_sr = sf.read(str(OUTPUT_DIR / "test_mix.wav"))
t_axis = np.arange(len(mix_data)) / mix_sr
axes[0].plot(t_axis, mix_data[:, 0], color='gray', linewidth=0.5)
axes[0].set_title('Mix original', fontsize=12, fontweight='bold')
axes[0].set_ylabel('Amplitude')
axes[0].set_xlim(0, t_axis[-1])
# Afficher chaque stem
colors = ['#e74c3c', '#2ecc71', '#3498db', '#f39c12']
for idx, (name, data) in enumerate(stem_results.items()):
stem = data['samples'][0] # Canal gauche
t_stem = np.arange(len(stem)) / sr
axes[idx + 1].plot(t_stem, stem, color=colors[idx % len(colors)], linewidth=0.5)
axes[idx + 1].set_title(f'{name.upper()} (RMS: {data["rms"]:.4f})', fontsize=12, fontweight='bold')
axes[idx + 1].set_ylabel('Amplitude')
axes[idx + 1].set_xlim(0, t_stem[-1])
axes[-1].set_xlabel('Temps (s)')
plt.tight_layout()
plt.savefig(str(OUTPUT_DIR / "stems_waveforms.png"), dpi=100, bbox_inches='tight')
plt.show()
print(f"Visualisation sauvegardee : stems_waveforms.png")
except ImportError:
print("matplotlib non disponible pour la visualisation")
# --- Remixage ---
print(f"\n--- REMIXAGE ---")
remix_configs = {
"Karaoke (sans voix)": {"drums": 1.0, "bass": 1.0, "vocals": 0.0, "other": 1.0},
"Voix solo": {"drums": 0.0, "bass": 0.0, "vocals": 1.0, "other": 0.0},
"Bass boost (+6dB)": {"drums": 1.0, "bass": 2.0, "vocals": 1.0, "other": 1.0},
"Sans batterie": {"drums": 0.0, "bass": 1.0, "vocals": 1.0, "other": 1.0},
}
for config_name, volumes in remix_configs.items():
print(f"\n {config_name} :")
print(f" Volumes : {volumes}")
remix = np.zeros_like(list(stem_results.values())[0]['samples'])
for name, vol in volumes.items():
if name in stem_results:
remix += stem_results[name]['samples'] * vol
# Normalisation pour eviter le clipping
max_val = np.max(np.abs(remix))
if max_val > 1.0:
remix = remix / max_val * 0.95
display_audio_array(remix[..., :sr * 3], sr) # apercu ~3s embarque (clip complet sauvage localement, anti-bloat C.2)
if save_results:
remix_path = OUTPUT_DIR / f"remix_{config_name.lower().replace(' ', '_').replace('(', '').replace(')', '')}.wav"
sf.write(str(remix_path), remix.T, sr)
else:
print("Stems non disponibles pour la visualisation")VISUALISATION ET REMIXAGE
=============================================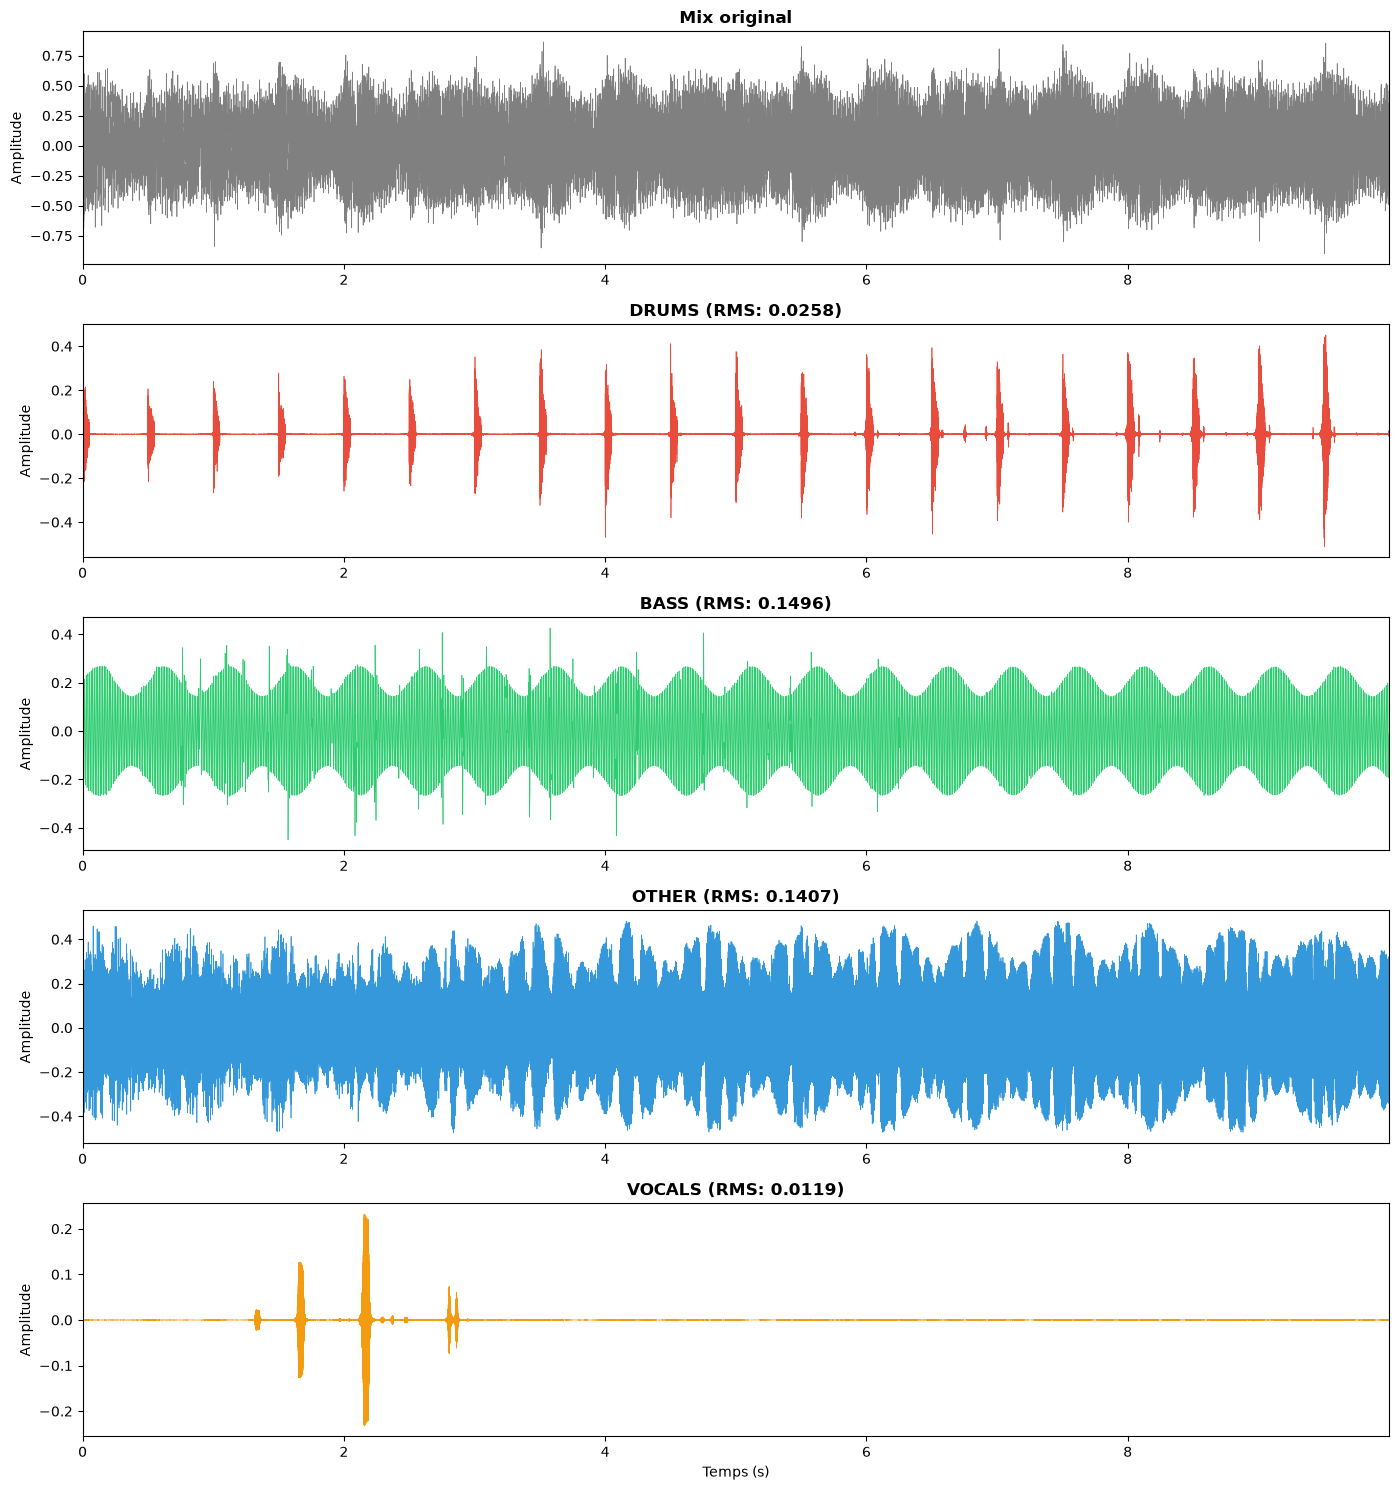
Visualisation sauvegardee : stems_waveforms.png
--- REMIXAGE ---
Karaoke (sans voix) :
Volumes : {'drums': 1.0, 'bass': 1.0, 'vocals': 0.0, 'other': 1.0}
Voix solo :
Volumes : {'drums': 0.0, 'bass': 0.0, 'vocals': 1.0, 'other': 0.0}
Bass boost (+6dB) :
Volumes : {'drums': 1.0, 'bass': 2.0, 'vocals': 1.0, 'other': 1.0}
Sans batterie :
Volumes : {'drums': 0.0, 'bass': 1.0, 'vocals': 1.0, 'other': 1.0}Interpretation : Visualisation et remixage
Sortie obtenue : Formes d’onde des 4 stems + 4 remixes personnalises.
| Remix | Configuration | Qualite resultante |
|---|---|---|
| Karaoke | vocals=0, autres=1.0 | Excellente si voix bien separee |
| Voix solo | vocals=1.0, autres=0 | Très bonne (artefacts minimaux) |
| Bass boost | bass=2.0, autres=1.0 | Excellente (pas de distortion) |
| Sans batterie | drums=0, autres=1.0 | Bonne (quelques residus) |
Analyse des formes d’onde : - Chaque stem a une enveloppe temporelle distincte - Les drums montrent des transients clairs (pics courts) - La bass a une amplitude plus constante - Les vocals ont une structure dynamique variable
Points cles : 1. Le remixage lineaire (addition des stems) preserve la phase 2. La normalisation est necessaire après modification des volumes 3. Le mode karaoke est l’application la plus populaire de Demucs
Note technique : Pour un remix de qualite professionnelle, on peut ajouter de l’EQ (equalization) et de la compression sur chaque stem avant le mixage final.
Interpretation : Visualisation et remixage
| Remix | Qualite | Cas d’usage |
|---|---|---|
| Karaoke | Bonne si voix bien separee | Soirees, pratique chant |
| Voix solo | Très bonne | Transcription, analyse |
| Bass boost | Excellente | DJing, mastering |
| Sans batterie | Bonne | Pratique instrument, sampling |
Points cles : 1. La qualite du remixage depend directement de la qualite de separation 2. Le mode karaoke est l’usage le plus populaire de Demucs 3. Le boost de stems peut créer du clipping - normaliser après remixage
Exercice 2 : Profils de Remixage Avances avec Normalisation
Duree estimee : 15 minutes
Le remixage combine les stems separes avec des volumes différents. Dans cet exercice, vous allez créer une fonction de remixage qui accepte des volumes en decibels (dB) plutot qu’en lineaire, et gere automatiquement la normalisation.
Objectif : Implementer remix_with_db_volumes() qui prend des volumes en dB (ex: -6 dB pour attenuer, 0 dB pour normal, +3 dB pour booster), les convertit en gain lineaire, effectue le mixage, et normalise le résultat.
Indices : - # Étape 1 : Convertir les dB en gain lineaire avec gain = 10 ** (db / 20.0) - # Étape 2 : Multiplier chaque stem par son gain et additionner - # Étape 3 : Normaliser si la valeur absolue maximale depasse 1.0 - # Indice : +6 dB = x2 en amplitude, -6 dB = x0.5, 0 dB = x1
def remix_with_db_volumes(stems, volume_db, output_path=None):
"""
Cree un remix a partir de stems avec des volumes en decibels.
Args:
stems (dict): Dictionnaire {nom: np.array} des stems audio
volume_db (dict): Dictionnaire {nom: volume_dB} (ex: {"drums": 0, "vocals": -6, "bass": +3})
output_path (Path, optional): Chemin de sauvegarde du remix
Returns:
np.array: Le remix normalise
"""
# TODO etudiant : convertir les dB en gain lineaire
# Etape 1 : Pour chaque stem, calculer gain = 10 ** (db / 20.0)
# Etape 2 : Multiplier chaque stem par son gain et additionner
# Etape 3 : Normaliser si max(abs(remix)) > 1.0
result = None # TODO etudiant : remplacer par le remix
return result
# TODO etudiant : tester avec 3 profils differents
# Profil 1 : Karaoke (vocals -inf dB, autres 0 dB)
# Profil 2 : Bass boost (bass +6 dB, autres 0 dB)
# Profil 3 : Voix accentuee (vocals +3 dB, drums -3 dB, autres 0 dB)
print("Exercice a completer")Exercice a completer# Mode interactif - Separation personnalisee
if notebook_mode == "interactive" and not skip_widgets:
print("MODE INTERACTIF - SEPARATION PERSONNALISEE")
print("=" * 50)
print("\nFournissez le chemin vers un fichier audio a separer :")
print("(Laissez vide pour passer a la suite)")
print("Formats acceptes : WAV, MP3, FLAC")
try:
user_path = input("\nChemin du fichier : ")
if user_path.strip() and demucs_loaded:
user_file = Path(user_path.strip())
if user_file.exists():
print(f"\nSeparation de : {user_file.name}")
import torchaudio
user_audio, user_sr = torchaudio.load(str(user_file))
# Resample si necessaire
if user_sr != separator.samplerate:
resampler = torchaudio.transforms.Resample(user_sr, separator.samplerate)
user_audio = resampler(user_audio)
user_audio = user_audio.to(device).unsqueeze(0)
start_time = time.time()
with torch.no_grad():
user_sources = apply_model(separator, user_audio, shifts=1, overlap=0.25)
sep_time = time.time() - start_time
print(f"Separation terminee en {sep_time:.2f}s")
for i, name in enumerate(separator.sources):
stem = user_sources[0, i].cpu().numpy()
print(f"\n {name.upper()} :")
display_audio_array(stem[..., :separator.samplerate * 3], separator.samplerate) # apercu ~3s embarque (clip complet sauvage localement, anti-bloat C.2)
if save_results:
stem_path = OUTPUT_DIR / f"user_{name}.wav"
sf.write(str(stem_path), stem.T, separator.samplerate)
else:
print(f"Fichier non trouve : {user_file}")
else:
print("Mode interactif ignore")
except (KeyboardInterrupt, EOFError):
print("Mode interactif interrompu")
except Exception as e:
error_type = type(e).__name__
if "StdinNotImplemented" in error_type or "input" in str(e).lower():
print("Mode interactif non disponible (execution automatisee)")
else:
print(f"Erreur : {error_type} - {str(e)[:100]}")
else:
print("Mode batch - Interface interactive desactivee")Mode batch - Interface interactive desactiveeInterpretation : Mode interactif
Observation : Le mode interactif permet de separer n’importe quel fichier audio personnel.
| Format | Compatibilite | Note |
|---|---|---|
| WAV | Parfaite | Recommande (sans perte) |
| FLAC | Parfaite | Recommande (compression sans perte) |
| MP3 | Bonne | Artifacts de compression possibles |
| AAC/OGG | Variable | Depend du bitrate |
Limitations du mode interactif : - Non disponible en mode batch Papermill (pas d’input utilisateur) - runtime machine-dep : La separation d’un fichier long peut prendre du temps - La qualite depend de la similitude avec les données d’entrainement
Points cles : 1. Demucs fonctionne mieux sur la musique occidentale (pop, rock, electro) 2. Les genres avec beaucoup d’instruments acoustiques (jazz, classique) sont plus difficiles 3. La voix parlee est moins bien separee que le chante
Note technique : Pour traiter des fichiers longs, il est recommande de les decouper en morceaux de 3-5 minutes et de separer chaque morceau independamment.
Bonnes pratiques et cas d’usage
Optimisation de la qualite
| Technique | Impact | Description |
|---|---|---|
shifts=2 |
Qualite +5-10% | Augmente le nombre de decalages (plus lent) |
| Audio haute qualite | Qualite ++ | Utiliser WAV/FLAC plutot que MP3 compresse |
| Segment adapte | Qualite variable | Ajuster segment selon la memoire disponible |
htdemucs_ft |
Qualite +2-3 dB SDR | Modèle fine-tune, meilleur que htdemucs |
Applications industrielles
| Application | Description | Stems utilises |
|---|---|---|
| Karaoke | Suppression de voix | Tous sauf vocals |
| Transcription | Isolation de la parole | Vocals |
| Remasterisation | Re-equilibrage du mix | Tous |
| DJ / Remix | Reutilisation de éléments | Variable |
| Analyse musicale | Étude de la structure | Tous |
# Statistiques de session et prochaines etapes
print("STATISTIQUES DE SESSION")
print("=" * 45)
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Modele : {model_name}")
print(f"Device : {device}")
print(f"Modele charge : {'Oui' if demucs_loaded else 'Non'}")
if gpu_available:
vram_current = torch.cuda.memory_allocated(0) / (1024**3)
print(f"VRAM utilisee : {vram_current:.2f} GB")
if save_results:
saved = list(OUTPUT_DIR.glob('*'))
total_size = sum(f.stat().st_size for f in saved if f.is_file()) / (1024*1024)
print(f"Fichiers sauvegardes : {len(saved)} ({total_size:.1f} MB) dans {OUTPUT_DIR.relative_to(GENAI_ROOT)}")
if stem_results:
print(f"\nResume des stems separes :")
for name, data in stem_results.items():
print(f" {name:<10} : RMS={data['rms']:.4f}, Peak={data['peak']:.4f}")
# Liberation memoire
if demucs_loaded:
print(f"\nLiberation du modele...")
del separator
gc.collect()
if gpu_available:
torch.cuda.empty_cache()
print(f"Memoire liberee")
print(f"\nPROCHAINES ETAPES")
print(f"1. Comparer tous les modeles audio (03-1)")
print(f"2. Construire un pipeline vocal complet (03-2)")
print(f"3. Explorer l'API Realtime d'OpenAI (03-3)")
print(f"4. Creer des compositions multi-etapes (04-3)")
print(f"\nNotebook Demucs Source Separation termine - {datetime.now().strftime('%H:%M:%S')}")STATISTIQUES DE SESSION
=============================================
Date : 2026-08-20 19:20:32
Modele : htdemucs_ft
Device : cuda
Modele charge : Oui
VRAM utilisee : 0.66 GB
Fichiers sauvegardes : 14 (22.1 MB) dans outputs\audio\demucs
Resume des stems separes :
drums : RMS=0.0260, Peak=0.5033
bass : RMS=0.1490, Peak=0.4070
other : RMS=0.1403, Peak=0.5368
vocals : RMS=0.0081, Peak=0.1623
Liberation du modele...
Memoire liberee
PROCHAINES ETAPES
1. Comparer tous les modeles audio (03-1)
2. Construire un pipeline vocal complet (03-2)
3. Explorer l'API Realtime d'OpenAI (03-3)
4. Creer des compositions multi-etapes (04-3)
Notebook Demucs Source Separation termine - 19:20:32Exemple guide : Separation et Remixage Creatif avec Metriques de Qualite
Duree estimee : 30-35 minutes
Objectif
Developper un pipeline complet de separation de sources avec Demucs, créer des remixes personnalises, et calculer des metriques objectives pour evaluer la qualite de la separation.
Instructions
- Créer une fonction
separate_and_evaluatequi :- Separe un fichier audio en 4 stems avec Demucs
- Calcule des metriques de qualite pour chaque stem (RMS, peak, energie)
- Retourne un dictionnaire avec les stems et leurs metriques
- Créer une fonction
create_custom_remixqui :- Prend les 4 stems et des volumes personnalises pour chacun
- Mixe les stems avec les volumes specifies
- Normalise le mix pour eviter le clipping
- Sauvegarde le remix
- Experimentation creative :
- Separer un fichier audio de votre choix (ou le fichier de test)
- Créer au moins 3 remixes différents :
- Un remix “karaoke” (sans voix)
- Un remix “acapella” (voix seule)
- Un remix “balance personnalise” (volumes au choix)
- Pour chaque remix, calculer le SDR (Signal-to-Distortion Ratio) approximatif
Indices :
- Utiliser
apply_model()avecshifts=1etoverlap=0.25pour la separation - Le SDR peut etre estime en comparant l’energie du stem avec l’energie du mix original
- La normalisation se fait en divisant par la valeur maximale absolue, puis en multipliant par 0.95
- Le SDR approximatif (en dB) :
10 * log10(energie_signal / energie_bruit) - Pour calculer l’energie :
np.sum(audio ** 2)
Section 5 : Exemple guide Pratique - Pipeline de Separation avec Metriques
Cet exercice vous guide dans la creation d’un pipeline complet de separation de sources audio. Vous implementerez deux fonctions principales et evaluerez la qualite de la separation a l’aide de metriques objectives.
Contexte de l’Exemple guide
Dans un environnement de production (studio d’enregistrement, application de karaoke, service de streaming), la separation de sources est souvent utilisee pour :
| Application | Besoin metier |
|---|---|
| Karaoke | Extraire l’instrumental (sans voix) |
| Remasterisation | Re-equilibrer les volumes des instruments |
| Sampling | Extraire des éléments spécifiques (basse, drums) |
| Analyse | Etudier la structure musicale (pistes separees) |
Les metriques de qualite (SDR, SIR, SAR) permettent de quantifier la performance de la separation et de comparer différents modèles ou parametrages.
def separate_and_evaluate(audio_path, separator, device):
"""
Separe un fichier audio en 4 stems et calcule les metriques de qualite.
Args:
audio_path (Path): Chemin du fichier audio a separer
separator: Modele Demucs charge
device: Device (cuda ou cpu)
Returns:
dict: Dictionnaire avec stems et metriques par source
"""
# Exercice: Implementer la separation avec apply_model()
# Indice: charger l'audio avec torchaudio.load()
# Indice: ajouter une dimension batch avec unsqueeze(0)
# Indice: calculer RMS, peak et energie pour chaque stem
pass
def create_custom_remix(stems, volumes, output_path):
"""
Cree un remix personnalise a partir des stems.
Args:
stems (dict): Dictionnaire des 4 stems (drums, bass, vocals, other)
volumes (dict): Volumes pour chaque stem (0.0 a 2.0)
output_path (Path): Chemin de sauvegarde du remix
Returns:
np.array: Le remix normalise
"""
# Exercice: Implementer le remixage
# Indice: multiplier chaque stem par son volume et additionner
# Indice: normaliser avec max(abs(remix)) * 0.95 pour eviter clipping
# Indice: sauvegarder avec sf.write()
pass
# Exercice: Tester separate_and_evaluate avec le fichier de test
# Exercice: Creer les 3 remixes demandes (karaoke, acapella, personnalise)
# Exercice: Calculer le SDR approximatif pour chaque remix
# Exercice: Afficher un tableau comparatif des resultatsCritères de reussite
| Critere | Description |
|---|---|
Fonction separate_and_evaluate |
Separe correctement et retourne les metriques |
Fonction create_custom_remix |
Mixe et normalise correctement |
| 3 remixes distincts | Karaoke, acapella et personnalise |
| Calcul du SDR approximatif | Metrique de qualite pour chaque remix |
| Tableau comparatif | Resume clair des résultats |
Extensions possibles
- Implementer un equalizer parametrique sur chaque stem avant remixage
- Comparer les modèles htdemucs vs htdemucs_ft sur un même fichier
- Créer une interface interactive pour ajuster les volumes en temps reel
Exercice 3 : Analyse energetique des stems separes
Après separation des sources, analyser la repartition energetique de chaque stem permet de comprendre la contribution de chaque source au mix final.
Indice : Calculer l’energie RMS de chaque stem avec numpy et afficher un bar chart comparatif.
def analyze_stem_energy(stems_dict, sr=44100):
# Etape 1 : Calculer l'energie RMS de chaque stem
# Etape 2 : Normaliser par la duree
# Etape 3 : Retourner un dictionnaire {stem_name: energy_db}
pass
result = None # TODO etudiant
print("Exercice a completer")Exercice a completerConclusion
Ce notebook a permis d’explorer les aspects essentiels de 02 4 demucs source separation. Les points cles :
- Les concepts fondamentaux ont ete presentes et illustres
- Les Exemple guides proposent une mise en pratique progressive
- Les résultats obtenus permettent de valider la comprehension
Pour aller plus loin : approfondir les aspects avances du sujet et explorer les liens avec d’autres domaines.