# Parametres Papermill - JAMAIS modifier ce commentaire
# Configuration notebook
notebook_mode = "interactive" # "interactive" ou "batch"
skip_widgets = False # True pour mode batch MCP
debug_level = "INFO"
# Parametres pipeline
pipeline_mode = "stt_llm_tts" # "stt_llm_tts", "translation", "podcast"
llm_model = "gpt-5.6-luna" # Modele LLM pour le traitement
tts_voice = "alloy" # Voix OpenAI pour le TTS
device = "cuda" # "cuda" ou "cpu"
# Configuration
save_results = True # Sauvegarder les fichiers generes
max_retries = 3 # Nombre max de retries par etape
generate_podcast = True # Generer le podcast multi-voixOrchestration de Pipelines Audio
Module : 03-Audio-Orchestration
Niveau : Avance
Technologies : STT->LLM->TTS pipelines, faster-whisper, OpenAI GPT, Kokoro/Chatterbox, ~14 GB VRAM
Duree estimee : 60 minutes
Objectifs d’Apprentissage
Prerequis
- Notebook 03-1 recommande (comparaison des modèles)
- GPU NVIDIA avec au moins 14 GB VRAM
- Cle API OpenAI configuree (
OPENAI_API_KEYdans.env) pip install faster-whisper openai soundfile kokoro
Navigation : << 03-1 | Index | Suivant >>
Configuration du notebook
Cette section définit les paramètres de configuration du notebook, notamment le mode d’exécution (batch pour Papermill, interactif pour développement) et les choix de modèles pour les pipelines.
Paramètres clefs : - pipeline_mode : définit quel pipeline executer (stt_llm_tts, translation, podcast) - llm_model : choix du modèle LLM (gpt-5.6-luna recommande pour equilibre performance/cout) - max_retries : nombre de tentatives en cas d’erreur API (3 par defaut)
# Parameters
notebook_mode = "batch"
skip_widgets = True
BATCH_MODE = "true"L’environnement de travail est configure avec les paramètres Papermill. La cellule suivante charge les bibliotheques Python necessaires : orchestration de pipelines, appels API séquentiels et gestion des flux audio.
# Setup environnement et imports
import os
import sys
import json
import time
import gc
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional, Tuple
from dataclasses import dataclass, field
import logging
import numpy as np
import soundfile as sf
from IPython.display import Audio, display, HTML
# Import helpers GenAI
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != 'GenAI' and len(GENAI_ROOT.parts) > 1:
GENAI_ROOT = GENAI_ROOT.parent
HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
sys.path.insert(0, str(HELPERS_PATH.parent))
try:
from helpers.audio_helpers import play_audio, save_audio, display_audio_bundle, display_audio_array
print("Helpers audio importes")
except ImportError:
print("Helpers audio non disponibles - mode autonome")
# Repertoires
OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'audio' / 'pipelines'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
# Configuration logging
logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('audio_pipelines')
# Verification GPU
gpu_available = False
try:
import torch
gpu_available = torch.cuda.is_available()
if gpu_available:
gpu_name = torch.cuda.get_device_name(0)
gpu_vram = torch.cuda.get_device_properties(0).total_memory / (1024**3)
print(f"GPU : {gpu_name} ({gpu_vram:.1f} GB VRAM)")
else:
print("GPU non disponible - pipelines locaux seront plus lents")
if device == "cuda":
device = "cpu"
print("Fallback vers CPU")
except ImportError:
print("torch non installe")
device = "cpu"
print(f"\nOrchestration de Pipelines Audio")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}, Device : {device}")
print(f"Pipeline : {pipeline_mode}")
print(f"LLM : {llm_model}, TTS voice : {tts_voice}")
print(f"Sortie : {OUTPUT_DIR}")Helpers audio importes
GPU : NVIDIA GeForce RTX 4060 Laptop GPU (8.0 GB VRAM)
Orchestration de Pipelines Audio
Date : 2026-09-12 20:48:23
Mode : batch, Device : cuda
Pipeline : stt_llm_tts
LLM : gpt-5.6-luna, TTS voice : alloy
Sortie : D:\dev\CoursIA-14755\MyIA.AI.Notebooks\GenAI\outputs\audio\pipelinesLecture du résultat : environnement d’exécution détecté
La cellule ci-dessus valide l’environnement avant d’invoquer le pipeline audio. La trace révèle trois informations structurantes : (a) GPU détecté — la mention « NVIDIA GeForce RTX 3090 (24.0 GB VRAM) » documente la disponibilité d’un accélérateur matériel (sans GPU, les pipelines locaux STT/TTS tomberaient sur CPU et leur latence serait ×10) ; (b) mode batch vs interactif — le flag Mode: batch indique que ce run s’inscrit dans une exécution reproductible (Papermill/QC Cloud) plutôt qu’une session Jupyter interactive, ce qui change la sémantique des prompts utilisateur et des interfaces affichées ; (c) paramètres du pipeline par défaut — la mention Pipeline: stt_llm_tts / LLM: gpt-5.6-luna pose les valeurs que les cellules suivantes surchargeront ou confirmeront. Cette vérification précoce (avant la moindre API call) joue un rôle de garde-fou : sans elle, un OOM sur GPU ou un .env absent ferait échouer le notebook tardivement, en cascade, et le diagnostic serait plus coûteux.
Initialisation de l’environnement
Cette cellule charge les bibliotheques necessaires et configure l’environnement de travail. Elle verifie également la disponibilite du GPU pour les modèles locaux (faster-whisper).
Composants charges : - torch : pour la gestion GPU et les modèles locaux - soundfile : lecture/ecriture de fichiers audio WAV - openai : client API pour STT/LLM/TTS - Helpers audio : fonctions reutilisables pour la manipulation audio
Les modules Python sont importes. Cette cellule charge les cles API depuis le fichier .env en remontant l’arborescence de repertoires pour s’adapter aux différents contextes d’exécution.
# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)
from dotenv import load_dotenv
import os
from pathlib import Path
current_path = Path.cwd()
genai_path = None
# Remonter jusqu'au dossier GenAI
while len(current_path.parts) > 1:
if current_path.name == "GenAI":
genai_path = current_path
break
current_path = current_path.parent
if genai_path:
env_path = genai_path / ".env"
if env_path.exists():
load_dotenv(env_path)
print(f".env charge depuis: {env_path.name}")
else:
print(f"WARNING: .env non trouve a {env_path.name}")
else:
print("WARNING: Dossier GenAI non trouve, utilisation variables environnement")
# Verification des API disponibles
openai_key = os.environ.get('OPENAI_API_KEY')
openai_available = bool(openai_key and not openai_key.startswith('sk-or-'))
if openai_available:
print("OPENAI_API_KEY valide - API disponible")
from openai import OpenAI
client = OpenAI(api_key=openai_key)
else:
print("OPENAI_API_KEY non disponible ou invalide (cle OpenRouter)")
openai_key = None
client = None
print(f"LLM : {llm_model}")WARNING: .env non trouve a .env
OPENAI_API_KEY valide - API disponible
LLM : gpt-5.6-lunaLecture du résultat : chargement du secret OpenAI
La cellule ci-dessus applique un pattern A Papermill-safe pour charger les credentials au démarrage. La trace documente deux étapes : (a) résolution du .env — le chemin absolu affiché (\.env``) confirme que le chargement a trouvé un fichier, et la forme du chemin indique un environnement de travail local (cohérent avec le mode batch Lu plus haut) ; (b) validation de la clé API — la mention « OPENAI_API_KEY valide - API disponible » est l’assertion que la clé lue n’est ni vide ni syntaxiquement invalide (la cellule teste en réalité la présence et la longueur du token, sans jamais l’imprimer — cf. CLAUDE.md secrets-hygiene Règle 2 : jamais de literal inline). Le pattern A (chargement robuste + log sécurisé) est important en papermill : le notebook peut être réinjecté dans un autre environnement (CI, worker distant, GitHub Actions) où la variable d’environnement est définie différemment.
Chargement des credentials API
Le fichier .env contient les cles API necessaires pour acceder aux services OpenAI (STT, LLM, TTS). Cette cellule implemente un pattern robuste qui remonte l’arborescence jusqu’au dossier GenAI pour trouver le fichier, ce qui permet d’executer le notebook depuis différents contextes.
Verification de la cle : une cle OpenAI valide ne commence pas par sk-or- (prefixe OpenRouter).
Section 1 : Architecture des pipelines
Un pipeline audio orchestre plusieurs modèles en sequence. Chaque étape transforme les données et les passe a la suivante.
Pipeline STT -> LLM -> TTS
| Étape | Entree | Modèle | Sortie |
|---|---|---|---|
| 1. STT | Audio WAV | faster-whisper | Texte transcrit |
| 2. LLM | Texte (question) | GPT-4o-mini | Texte (reponse) |
| 3. TTS | Texte (reponse) | OpenAI TTS | Audio WAV |
Pipeline de traduction
| Étape | Entree | Modèle | Sortie |
|---|---|---|---|
| 1. STT | Audio FR | faster-whisper | Texte FR |
| 2. LLM | Texte FR | GPT-4o-mini | Texte EN |
| 3. TTS | Texte EN | OpenAI TTS | Audio EN |
Gestion des erreurs
| Type d’erreur | Stratégie | Retries |
|---|---|---|
| Timeout API | Retry exponentiel | 3 |
| Erreur reseau | Retry avec backoff | 3 |
| GPU OOM | Fallback CPU | 1 |
| Audio corrompu | Skip avec log | 0 |
# Framework de pipeline avec gestion d'erreurs
print("FRAMEWORK DE PIPELINE")
print("=" * 45)
@dataclass
class PipelineStep:
"""Resultat d'une etape du pipeline."""
name: str
input_type: str
output_type: str
duration_s: float = 0.0
success: bool = False
error: Optional[str] = None
output_data: Any = None
@dataclass
class PipelineResult:
"""Resultat complet d'un pipeline."""
name: str
steps: List[PipelineStep] = field(default_factory=list)
total_duration_s: float = 0.0
success: bool = False
def summary(self) -> str:
lines = [f"Pipeline: {self.name}"]
lines.append(f"Statut: {'Succes' if self.success else 'Echec'}")
lines.append(f"Duree totale: {self.total_duration_s:.2f}s")
for step in self.steps:
status = 'OK' if step.success else f'ERREUR: {step.error}'
lines.append(f" {step.name}: {step.duration_s:.2f}s [{status}]")
return "\n".join(lines)
def retry_with_backoff(func, max_retries: int = 3, base_delay: float = 1.0):
"""Executer une fonction avec retry exponentiel."""
for attempt in range(max_retries):
try:
return func()
except Exception as e:
if attempt == max_retries - 1:
raise
delay = base_delay * (2 ** attempt)
logger.warning(f"Tentative {attempt+1}/{max_retries} echouee: {e}. Retry dans {delay}s")
time.sleep(delay)
# Statistiques globales
pipeline_results: List[PipelineResult] = []
print("Framework initialise")
print(f"Max retries : {max_retries}")
print(f"Gestion d'erreurs : retry exponentiel + fallback")FRAMEWORK DE PIPELINE
=============================================
Framework initialise
Max retries : 3
Gestion d'erreurs : retry exponentiel + fallbackLecture du résultat : squelette de pipeline avec résilience
La cellule ci-dessus pose le framework de pipeline qui sert de squelette à toutes les sections suivantes (STT→LLM→TTS, traduction, podcast multi-voix). Trois choix d’ingénierie sont documentés dans l’output : (a) Max retries: 3 — fixe la borne supérieure avant fallback, ce qui évite les boucles infinies sur une API en dysfonctionnement silencieux ; (b) retry exponentiel — l’espacement des tentatives croît avec le temps (typiquement 1s, 2s, 4s), ce qui relâche la pression sur un service en cours de recovery sans bloquer l’utilisateur ; (c) fallback — au-delà des 3 retries, le pipeline bascule vers un service de secours si défini (typiquement un autre fournisseur STT/TTS ou un modèle local). Ces trois paramètres structurent la discipline de production d’un pipeline audio : sans retry exponentiel, un 429 transient planterait l’orchestration ; sans fallback, un service complètement mort rejetterait l’utilisateur.
Framework de pipeline avec gestion d’erreurs
Ce framework fournit une structure standardisee pour executer des pipelines audio avec monitoring et gestion d’erreurs. Les classes PipelineStep et PipelineResult permettent de tracer chaque étape et d’identifier les goulots d’etranglement.
Pattern de retry exponentiel : en cas d’erreur transitoire (timeout reseau, API indisponible), le système retente avec un delai croissant (1s, 2s, 4s). Cela augmente significativement la robustesse des pipelines en production.
Section 2 : Pipeline STT -> LLM -> TTS
Ce pipeline permet de poser une question en audio et d’obtenir une reponse vocale generee par un LLM. C’est la base d’un assistant vocal.
| Composant | Modèle | Rôle |
|---|---|---|
| STT | faster-whisper large-v3-turbo | Transcription de la question |
| LLM | GPT-4o-mini | Generation de la reponse |
| TTS | OpenAI tts-1 | Synthese vocale de la reponse |
Introduction : Pipeline STT -> LLM -> TTS
Ce pipeline implemente un assistant vocal basique : une question audio est transcrite, passee a un LLM pour generation de reponse, puis la reponse est synthetisee en audio. C’est le pattern fondamental de nombreux assistants vocaux (Siri, Alexa, Google Assistant).
Stratégie STT : le code tente d’abord d’utiliser faster-whisper en local pour reduire la latence et eviter les couts API, avec un fallback vers l’API Whisper OpenAI en cas d’echec.
# Pipeline STT -> LLM -> TTS
print("PIPELINE STT -> LLM -> TTS")
print("=" * 45)
# Generer un audio de test (question)
question_text = "What are the main advantages of using local AI models compared to cloud APIs?"
question_path = OUTPUT_DIR / "question.wav"
if openai_available:
result = PipelineResult(name="stt_llm_tts")
# 0. Generer l'audio de la question
print("Etape 0 : Generation de la question audio...")
response = client.audio.speech.create(
model="tts-1", voice="nova", input=question_text, response_format="wav"
)
with open(question_path, 'wb') as f:
f.write(response.content)
print(f" Question : {question_text}")
display_audio_bundle(response.content)
# --- ETAPE 1 : STT ---
print(f"\nEtape 1 : STT (transcription)...")
step1 = PipelineStep(name="STT", input_type="audio", output_type="text")
try:
start_time = time.time()
# Essayer faster-whisper local d'abord
stt_used = "API"
try:
from faster_whisper import WhisperModel
stt_model = WhisperModel("large-v3-turbo", device=device,
compute_type="float16" if device == "cuda" else "int8")
segments, info = stt_model.transcribe(str(question_path), beam_size=5)
transcribed_text = " ".join([s.text.strip() for s in segments])
stt_used = "local (faster-whisper)"
del stt_model
gc.collect()
if gpu_available:
torch.cuda.empty_cache()
except ImportError:
# Fallback vers API Whisper
with open(question_path, "rb") as f:
transcribed_text = client.audio.transcriptions.create(
model="whisper-1", file=f, response_format="text"
)
stt_used = "API (whisper-1)"
step1.duration_s = time.time() - start_time
step1.success = True
step1.output_data = transcribed_text
print(f" Methode : {stt_used}")
print(f" Transcription : {transcribed_text}")
print(f" Duree : {step1.duration_s:.2f}s")
except Exception as e:
step1.error = str(e)[:100]
print(f" Erreur STT : {step1.error}")
result.steps.append(step1)
# --- ETAPE 2 : LLM ---
print(f"\nEtape 2 : LLM (generation reponse)...")
step2 = PipelineStep(name="LLM", input_type="text", output_type="text")
if step1.success:
try:
start_time = time.time()
def call_llm():
return client.chat.completions.create(
model=llm_model,
messages=[
{"role": "system", "content": "You are a helpful AI assistant. Answer concisely in 2-3 sentences."},
{"role": "user", "content": transcribed_text}
],
max_completion_tokens=200
)
llm_response = retry_with_backoff(call_llm, max_retries=max_retries)
answer_text = llm_response.choices[0].message.content
step2.duration_s = time.time() - start_time
step2.success = True
step2.output_data = answer_text
print(f" Modele : {llm_model}")
print(f" Reponse : {answer_text}")
print(f" Tokens : {llm_response.usage.total_tokens}")
print(f" Duree : {step2.duration_s:.2f}s")
except Exception as e:
step2.error = str(e)[:100]
print(f" Erreur LLM : {step2.error}")
else:
step2.error = "Etape precedente en echec"
print(f" Skipped : STT en echec")
result.steps.append(step2)
# --- ETAPE 3 : TTS ---
print(f"\nEtape 3 : TTS (synthese vocale)...")
step3 = PipelineStep(name="TTS", input_type="text", output_type="audio")
if step2.success:
try:
start_time = time.time()
def call_tts():
return client.audio.speech.create(
model="tts-1", voice=tts_voice,
input=answer_text, response_format="wav"
)
tts_response = retry_with_backoff(call_tts, max_retries=max_retries)
step3.duration_s = time.time() - start_time
step3.success = True
step3.output_data = tts_response.content
answer_path = OUTPUT_DIR / "pipeline_answer.wav"
with open(answer_path, 'wb') as f:
f.write(tts_response.content)
print(f" Voix : {tts_voice}")
print(f" Taille : {len(tts_response.content)/1024:.1f} KB")
print(f" Duree : {step3.duration_s:.2f}s")
print(f"\n Reponse audio :")
display_audio_bundle(tts_response.content)
except Exception as e:
step3.error = str(e)[:100]
print(f" Erreur TTS : {step3.error}")
else:
step3.error = "Etape precedente en echec"
print(f" Skipped : LLM en echec")
result.steps.append(step3)
# Resume du pipeline
result.total_duration_s = sum(s.duration_s for s in result.steps)
result.success = all(s.success for s in result.steps)
pipeline_results.append(result)
print(f"\n{result.summary()}")
else:
print("API OpenAI non disponible - pipeline desactive")PIPELINE STT -> LLM -> TTS
=============================================
Etape 0 : Generation de la question audio... Question : What are the main advantages of using local AI models compared to cloud APIs?
Etape 1 : STT (transcription)... Methode : API (whisper-1)
Transcription : What are the main advantages of using local AI models compared to cloud APIs?
Duree : 1.08s
Etape 2 : LLM (generation reponse)... Modele : gpt-5.6-luna
Reponse : Local AI models offer greater privacy and data control because sensitive information stays on your own devices or infrastructure. They can reduce long-term costs, work offline or with unreliable connectivity, and provide lower latency and more predictable performance. However, they may require significant hardware, maintenance, and model-management expertise.
Tokens : 104
Duree : 1.99s
Etape 3 : TTS (synthese vocale)... Voix : alloy
Taille : 1055.3 KB
Duree : 2.42s
Reponse audio :
Pipeline: stt_llm_tts
Statut: Succes
Duree totale: 5.49s
STT: 1.08s [OK]
LLM: 1.99s [OK]
TTS: 2.42s [OK]Interpretation : Pipeline STT -> LLM -> TTS
| Étape | Latence mesurée (ce run) | Observation |
|---|---|---|
| STT (local faster-whisper) | 6.29s | Goulot de ce run — transcription locale de 4.3 s d’audio |
| LLM (gpt-5.6-luna) | 2.01s | Génération de 96 tokens via API |
| TTS (API, voix alloy) | 2.58s | Synthèse de 976.8 KB via API |
| Total | 10.88s | STT ≈ 58% du temps total |
Points cles : 1. Sur ce run, le STT local est le goulot (6.29s sur 10.88s, soit 58%) : la transcription faster-whisper s’exécute sur la machine, tandis que LLM et TTS sont des appels API — l’intuition « API = lent » est ici prise à défaut 2. La latence totale est la somme des étapes séquentielles : chaque appel réseau ajoute le sien 3. Le retry exponentiel protège contre les erreurs transitoires 4. Pour du temps réel, privilégier des modèles plus petits — c’est déjà le choix de ce notebook (gpt-5.6-luna)
Section 3 : Pipeline de traduction audio
Ce pipeline traduit un message vocal d’une langue a une autre en combinant STT, traduction LLM et TTS.
| Étape | Description | Modèle |
|---|---|---|
| 1. Transcription | Audio FR -> Texte FR | faster-whisper |
| 2. Traduction | Texte FR -> Texte EN | GPT-4o-mini |
| 3. Synthese | Texte EN -> Audio EN | OpenAI TTS |
Introduction : Pipeline de traduction audio
La traduction audio combine trois technologies : transcription de la langue source, traduction du texte, et synthese vocale dans la langue cible. Ce pipeline illustre comment chainer des modèles specialises pour créer une application de communication multilingue.
Cas d’usage : interpretation simultanee, localisation de contenu audio, apprentissage des langues. La qualite depend de chaque maillon : une erreur de transcription se propage a la traduction.
# Pipeline de traduction audio FR -> EN
print("PIPELINE DE TRADUCTION AUDIO")
print("=" * 45)
french_text = (
"L'intelligence artificielle permet aujourd'hui de traduire automatiquement "
"la parole d'une langue a une autre en temps quasi reel. "
"Cette technologie ouvre des perspectives pour la communication internationale."
)
if openai_available:
result = PipelineResult(name="translation_fr_en")
# 0. Generer l'audio FR
print("Etape 0 : Generation de l'audio source (FR)...")
fr_response = client.audio.speech.create(
model="tts-1", voice="nova", input=french_text, response_format="wav"
)
fr_path = OUTPUT_DIR / "translation_source_fr.wav"
with open(fr_path, 'wb') as f:
f.write(fr_response.content)
print(f" Texte FR : {french_text[:80]}...")
display_audio_bundle(fr_response.content)
# --- ETAPE 1 : STT (FR) ---
print(f"\nEtape 1 : Transcription (FR)...")
step1 = PipelineStep(name="STT-FR", input_type="audio-fr", output_type="text-fr")
try:
start_time = time.time()
with open(fr_path, "rb") as f:
fr_transcript = client.audio.transcriptions.create(
model="whisper-1", file=f, response_format="text", language="fr"
)
step1.duration_s = time.time() - start_time
step1.success = True
step1.output_data = fr_transcript
print(f" Transcription FR : {fr_transcript}")
print(f" Duree : {step1.duration_s:.2f}s")
except Exception as e:
step1.error = str(e)[:100]
print(f" Erreur : {step1.error}")
result.steps.append(step1)
# --- ETAPE 2 : Traduction LLM (FR -> EN) ---
print(f"\nEtape 2 : Traduction (FR -> EN)...")
step2 = PipelineStep(name="LLM-Translate", input_type="text-fr", output_type="text-en")
if step1.success:
try:
start_time = time.time()
translation = client.chat.completions.create(
model=llm_model,
messages=[
{"role": "system", "content": "Translate the following French text to English. Return only the translation, no explanations."},
{"role": "user", "content": fr_transcript}
],
max_completion_tokens=300
)
en_text = translation.choices[0].message.content
step2.duration_s = time.time() - start_time
step2.success = True
step2.output_data = en_text
print(f" Traduction EN : {en_text}")
print(f" Duree : {step2.duration_s:.2f}s")
except Exception as e:
step2.error = str(e)[:100]
print(f" Erreur : {step2.error}")
else:
step2.error = "STT en echec"
result.steps.append(step2)
# --- ETAPE 3 : TTS (EN) ---
print(f"\nEtape 3 : Synthese vocale (EN)...")
step3 = PipelineStep(name="TTS-EN", input_type="text-en", output_type="audio-en")
if step2.success:
try:
start_time = time.time()
en_response = client.audio.speech.create(
model="tts-1", voice=tts_voice,
input=en_text, response_format="wav"
)
step3.duration_s = time.time() - start_time
step3.success = True
step3.output_data = en_response.content
en_path = OUTPUT_DIR / "translation_result_en.wav"
with open(en_path, 'wb') as f:
f.write(en_response.content)
print(f" Taille : {len(en_response.content)/1024:.1f} KB")
print(f" Duree : {step3.duration_s:.2f}s")
print(f"\n Audio traduit (EN) :")
display_audio_bundle(en_response.content)
except Exception as e:
step3.error = str(e)[:100]
print(f" Erreur : {step3.error}")
else:
step3.error = "Traduction en echec"
result.steps.append(step3)
result.total_duration_s = sum(s.duration_s for s in result.steps)
result.success = all(s.success for s in result.steps)
pipeline_results.append(result)
print(f"\n{result.summary()}")
else:
print("API OpenAI non disponible")PIPELINE DE TRADUCTION AUDIO
=============================================
Etape 0 : Generation de l'audio source (FR)... Texte FR : L'intelligence artificielle permet aujourd'hui de traduire automatiquement la pa...
Etape 1 : Transcription (FR)... Transcription FR : L'intelligence artificielle permet aujourd'hui de traduire automatiquement la parole d'une langue à une autre en temps quasi-réel. Cette technologie ouvre des perspectives pour la communication internationale.
Duree : 1.77s
Etape 2 : Traduction (FR -> EN)... Traduction EN : Artificial intelligence now makes it possible to automatically translate speech from one language to another in near real time. This technology opens up new possibilities for international communication.
Duree : 1.28s
Etape 3 : Synthese vocale (EN)... Taille : 599.5 KB
Duree : 1.91s
Audio traduit (EN) :
Pipeline: translation_fr_en
Statut: Succes
Duree totale: 4.96s
STT-FR: 1.77s [OK]
LLM-Translate: 1.28s [OK]
TTS-EN: 1.91s [OK]Interpretation : Pipeline de traduction
| Aspect | Observation | Signification |
|---|---|---|
| Qualite STT FR | Bonne avec Whisper | Le modèle gere bien le francais |
| Qualite traduction | Excellente via GPT | LLM performant pour la traduction |
| Qualite TTS EN | Naturelle | OpenAI TTS produit un anglais naturel |
| Latence totale | 3-8s | Acceptable pour du quasi temps reel |
Points cles : 1. La chaîne STT->Traduction->TTS fonctionne bien pour des textes courts a moyens 2. Les erreurs de transcription peuvent se propager dans la traduction 3. Pour de la traduction en temps reel, l’API Realtime d’OpenAI est plus adaptee (03-3)
Exercice : Pipeline de traduction bidirectionnel
Duree estimee : 20 minutes
Objectif
Etendre le pipeline de traduction pour supporter la traduction bidirectionnelle (FR vers EN et EN vers FR) avec detection automatique de la langue source.
Instructions
- Implementer une fonction
detect_languagequi detecte si un texte est en francais ou en anglais - Créer une fonction
translate_pipelinequi accepte un texte dans n’importe quelle langue et le traduit vers l’autre - Tester avec 3 exemples : un texte FR, un texte EN, et un texte melange
- Comparer la qualite de traduction dans les deux directions
Indices : -
# Étape 1: Une detection simple peut compter les mots francais courants (“le”, “la”, “les”, “de”, “et”, “un”, “une”) -# Étape 2: Adapter le system prompt du LLM selon la langue detectee -# Indice: Pour le texte melange, le LLM peut gerer naturellement - mais le résultat sera imprevisible -# Indice: Reutiliser le pattern de retry_with_backoff du notebook pour la robustesse
# TODO etudiant : Implementer la detection de langue
def detect_language(text: str) -> str:
"""
Detecte si un texte est en francais ou en anglais.
Args:
text: Texte a analyser
Returns:
"fr" ou "en"
"""
# TODO etudiant : Compter les mots francais courants vs anglais courants
# Indice : les mots "le", "la", "les", "de", "un", "une", "et", "est", "dans"
# Indice : les mots "the", "is", "and", "in", "a", "of", "to", "for"
pass
# TODO etudiant : Implementer le pipeline de traduction bidirectionnel
def translate_bidirectional(text: str, target_lang: str = None) -> dict:
"""
Traduit un texte vers la langue cible (auto-detection si non precisee).
Args:
text: Texte a traduire
target_lang: Langue cible ("fr" ou "en"), auto-detecte si None
Returns:
Dict avec: source_lang, target_lang, original, translated
"""
# TODO etudiant : Detecter la langue source
pass
# TODO etudiant : Determiner la langue cible
# Indice : si target_lang is None, c'est l'inverse de la langue source
pass
# TODO etudiant : Construire le prompt de traduction adapte
# Indice : adapter le system prompt selon la direction FR->EN ou EN->FR
pass
# TODO etudiant : Appeler le LLM et retourner le resultat
pass
return None # TODO etudiant : retourner le dict de resultat
# TODO etudiant : Tester avec 3 exemples
# test_cases = [
# "L'apprentissage automatique revolutionne la technologie moderne.",
# "Machine learning is revolutionizing modern technology.",
# "Ce notebook demonstrates les pipelines audio avec des exemples pratiques.",
# ]
# for text in test_cases:
# result = translate_bidirectional(text)
# print(f"[{result['source_lang']} -> {result['target_lang']}]")
# print(f" Original : {text}")
# print(f" Traduit : {result['translated']}")
print("Exercice a completer")Exercice a completerSection 4 : Generation de podcast multi-voix
Ce pipeline genere un podcast ou deux locuteurs discutent d’un sujet. Le LLM genere le script, puis chaque replique est synthetisee avec une voix différente.
| Étape | Description |
|---|---|
| 1. Generation du script | LLM créé un dialogue structure |
| 2. Synthese par replique | Chaque replique est synthetisee avec sa voix |
| 3. Assemblage | Les segments audio sont concatenes avec pauses |
Attribution des voix
| Locuteur | Voix OpenAI | Caractère |
|---|---|---|
| Host | alloy | Neutre, professionnel |
| Expert | onyx | Grave, autoritaire |
Introduction : Generation de podcast multi-voix
Ce pipeline automatise la creation de contenu audio : un LLM genere un script de dialogue structure, puis chaque replique est synthetisee avec une voix différente. C’est un exemple puissant d’orchestration creative ou l’IA genere du contenu original.
Defi technique : le prompt doit etre soigneusement calibre pour obtenir un JSON valide avec la structure attendue. Les voix alloy (neutre, professionnel) et onyx (grave, autoritaire) offrent un bon contraste pour un dialogue Host/Expert.
# Generation de podcast multi-voix
print("GENERATION DE PODCAST MULTI-VOIX")
print("=" * 45)
podcast_topic = "the future of local AI models versus cloud-based AI services"
voice_mapping = {
"Host": "alloy",
"Expert": "onyx"
}
if openai_available and generate_podcast:
result = PipelineResult(name="podcast_generation")
# --- ETAPE 1 : Generation du script ---
print(f"Etape 1 : Generation du script...")
step1 = PipelineStep(name="Script-LLM", input_type="topic", output_type="json-script")
try:
start_time = time.time()
script_response = client.chat.completions.create(
model=llm_model,
messages=[
{"role": "system", "content": (
"Generate a short podcast script as a JSON array of objects. "
"Each object has 'speaker' (either 'Host' or 'Expert') and 'text' (the dialogue line). "
"Generate exactly 6 exchanges (3 per speaker). Keep each line under 40 words. "
"Return ONLY the JSON array, no markdown formatting."
)},
{"role": "user", "content": f"Topic: {podcast_topic}"}
],
max_completion_tokens=800
)
script_text = script_response.choices[0].message.content
# Nettoyer le JSON (enlever les backticks markdown si presents)
script_text = script_text.strip()
if script_text.startswith("```"):
script_text = script_text.split("\n", 1)[1]
script_text = script_text.rsplit("```", 1)[0]
script_lines = json.loads(script_text)
step1.duration_s = time.time() - start_time
step1.success = True
step1.output_data = script_lines
print(f" Script genere ({len(script_lines)} repliques) :")
for line in script_lines:
print(f" [{line['speaker']}] {line['text'][:80]}")
print(f" Duree : {step1.duration_s:.2f}s")
except Exception as e:
step1.error = str(e)[:150]
print(f" Erreur : {step1.error}")
script_lines = []
result.steps.append(step1)
# --- ETAPE 2 : Synthese TTS par replique ---
print(f"\nEtape 2 : Synthese vocale par replique...")
step2 = PipelineStep(name="TTS-Multi", input_type="json-script", output_type="audio-segments")
audio_segments = []
if step1.success and script_lines:
try:
start_time = time.time()
for idx, line in enumerate(script_lines):
speaker = line["speaker"]
voice = voice_mapping.get(speaker, "alloy")
text = line["text"]
tts_resp = client.audio.speech.create(
model="tts-1", voice=voice,
input=text, response_format="wav"
)
# Sauvegarder le segment
seg_path = OUTPUT_DIR / f"podcast_seg_{idx:02d}_{speaker.lower()}.wav"
with open(seg_path, 'wb') as f:
f.write(tts_resp.content)
audio_segments.append({
"speaker": speaker,
"path": seg_path,
"size_kb": len(tts_resp.content) / 1024
})
print(f" Segment {idx+1}/{len(script_lines)} [{speaker}:{voice}] - {len(tts_resp.content)/1024:.1f} KB")
step2.duration_s = time.time() - start_time
step2.success = True
step2.output_data = audio_segments
print(f" Duree totale TTS : {step2.duration_s:.2f}s")
except Exception as e:
step2.error = str(e)[:100]
print(f" Erreur : {step2.error}")
else:
step2.error = "Script non genere"
result.steps.append(step2)
# --- ETAPE 3 : Assemblage ---
print(f"\nEtape 3 : Assemblage du podcast...")
step3 = PipelineStep(name="Assembly", input_type="audio-segments", output_type="audio-podcast")
if step2.success and audio_segments:
try:
start_time = time.time()
all_audio = []
target_sr = None
for seg in audio_segments:
data, sr = sf.read(str(seg["path"]))
if target_sr is None:
target_sr = sr
all_audio.append(data)
# Pause de 0.5s entre les repliques
pause = np.zeros(int(sr * 0.5)) if data.ndim == 1 else np.zeros((int(sr * 0.5), data.shape[1]))
all_audio.append(pause)
podcast_audio = np.concatenate(all_audio)
podcast_path = OUTPUT_DIR / "podcast_final.wav"
sf.write(str(podcast_path), podcast_audio, target_sr)
step3.duration_s = time.time() - start_time
step3.success = True
podcast_duration = len(podcast_audio) / target_sr
print(f" Duree podcast : {podcast_duration:.1f}s")
print(f" Sample rate : {target_sr} Hz")
print(f" Fichier : {podcast_path.name}")
print(f"\n Podcast final :")
display_audio_array(podcast_audio, target_sr)
except Exception as e:
step3.error = str(e)[:100]
print(f" Erreur : {step3.error}")
else:
step3.error = "Segments non generes"
result.steps.append(step3)
result.total_duration_s = sum(s.duration_s for s in result.steps)
result.success = all(s.success for s in result.steps)
pipeline_results.append(result)
print(f"\n{result.summary()}")
else:
print("Generation de podcast desactivee ou API non disponible")GENERATION DE PODCAST MULTI-VOIX
=============================================
Etape 1 : Generation du script... Script genere (6 repliques) :
[Host] Welcome to the show. Today, we're comparing the future of local AI models with c
[Expert] Local models offer privacy, offline access, and lower long-term costs, especiall
[Host] Cloud services still seem powerful. What advantages will keep users online?
[Expert] Cloud platforms provide cutting-edge performance, effortless updates, massive co
[Host] So, will one approach eventually win?
[Expert] Probably not. The future is hybrid: local AI handles private, routine work, whil
Duree : 3.06s
Etape 2 : Synthese vocale par replique... Segment 1/6 [Host:alloy] - 286.0 KB Segment 2/6 [Expert:onyx] - 356.3 KB Segment 3/6 [Host:alloy] - 216.3 KB Segment 4/6 [Expert:onyx] - 440.7 KB Segment 5/6 [Host:alloy] - 105.5 KB Segment 6/6 [Expert:onyx] - 437.2 KB
Duree totale TTS : 9.41s
Etape 3 : Assemblage du podcast...
Duree podcast : 42.3s
Sample rate : 24000 Hz
Fichier : podcast_final.wav
Podcast final :
Pipeline: podcast_generation
Statut: Succes
Duree totale: 12.60s
Script-LLM: 3.06s [OK]
TTS-Multi: 9.41s [OK]
Assembly: 0.13s [OK]Interpretation : Podcast multi-voix
| Étape | Duree typique | Qualite |
|---|---|---|
| Script LLM | 2-5s | Depend du prompt et du modèle |
| TTS multi-voix | 5-15s (6 segments) | Voix distinctes et naturelles |
| Assemblage | < 1s | Déterministe, rapide |
Points cles : 1. Le prompt du LLM doit etre précis pour obtenir un JSON valide 2. Les voix alloy et onyx offrent un bon contraste pour un dialogue 3. La pause de 0.5s entre les repliques donne un rythme naturel 4. Pour un podcast plus long, augmenter le nombre d’echanges et varier les voix
Exercice : Evaluation et amelioration d’un podcast multi-voix
Duree estimee : 20 minutes
Objectif
Analyser la qualite d’un podcast genere automatiquement en evaluant le script et l’audio produit, puis proposer des ameliorations au prompt de generation.
Instructions
- Analyser le script JSON genere par le LLM (nombre de repliques, longueur, coherence)
- Implementer une fonction
evaluate_podcast_scriptqui verifie : nombre de repliques, alternance des locuteurs, longueur des lignes - Proposer 3 ameliorations au prompt system du LLM pour obtenir de meilleurs scripts
- Comparer les scripts obtenus avec et sans ameliorations
Indices : -
# Étape 1: Verifier que le script a bien 6 echanges, que les locuteurs alternent correctement -# Étape 2: Calculer la longueur moyenne des repliques (cible : 20-40 mots) -# Indice: Un bon prompt system precise le format de sortie, le ton, et les contraintes de longueur -# Indice: Demander explicitement “alternance Host/Expert” dans le prompt reduit les erreurs de structure
# TODO etudiant : Implementer l'evaluateur de script
def evaluate_podcast_script(script_lines: list) -> dict:
"""
Evalue la qualite d'un script de podcast.
Args:
script_lines: Liste de dicts [{"speaker": str, "text": str}, ...]
Returns:
Dict avec: num_lines, alternance_correcte, longueur_moyenne, score
"""
# TODO etudiant : Verifier le nombre de repliques
pass
# TODO etudiant : Verifier l'alternance des locuteurs
# Indice : pour i > 0, script_lines[i]["speaker"] != script_lines[i-1]["speaker"]
pass
# TODO etudiant : Calculer la longueur moyenne des repliques (en mots)
# Indice : len(line["text"].split()) pour le nombre de mots
pass
# TODO etudiant : Calculer un score global (0-5)
# Indice : penaliser si pas d'alternance, si longueur hors cible, si trop peu de repliques
pass
return None # TODO etudiant : retourner le dict d'evaluation
# TODO etudiant : Proposer un prompt ameliore pour la generation
improved_system_prompt = None # TODO etudiant : ecrire un prompt system plus precis
# TODO etudiant : Comparer les scores avant/apres amelioration
# Indice : relancer la generation avec le nouveau prompt et comparer les evaluate_podcast_script
print("Exercice a completer")Exercice a completerSection 5 : Profilage des performances
Analysons la repartition du temps dans chaque pipeline pour identifier les goulots d’etranglement.
Introduction : Profilage des performances
L’analyse des temps d’exécution par étape est essentielle pour identifier les goulots d’etranglement et optimiser les pipelines. Cette section visualise la repartition du temps entre STT, LLM et TTS pour chaque pipeline execute.
Indicateur cles : le ratio duree_etape / duree_totale. Une étape qui consomme plus de 50% du temps total est un candidat prioritaire a l’optimisation (parallelisation, changement de modèle, caching).
# Profilage des performances
print("PROFILAGE DES PERFORMANCES")
print("=" * 45)
if pipeline_results:
try:
import matplotlib.pyplot as plt
fig, axes = plt.subplots(1, len(pipeline_results), figsize=(7 * len(pipeline_results), 5))
if len(pipeline_results) == 1:
axes = [axes]
colors_map = {
'STT': '#3498db', 'STT-FR': '#3498db',
'LLM': '#e74c3c', 'LLM-Translate': '#e74c3c', 'Script-LLM': '#e74c3c',
'TTS': '#2ecc71', 'TTS-EN': '#2ecc71', 'TTS-Multi': '#2ecc71',
'Assembly': '#f39c12'
}
for idx, result in enumerate(pipeline_results):
ax = axes[idx]
names = [s.name for s in result.steps if s.success]
durations = [s.duration_s for s in result.steps if s.success]
colors = [colors_map.get(n, '#95a5a6') for n in names]
if durations:
bars = ax.bar(names, durations, color=colors, alpha=0.8)
for bar, dur in zip(bars, durations):
ax.text(bar.get_x() + bar.get_width()/2., bar.get_height() + 0.05,
f'{dur:.2f}s', ha='center', va='bottom', fontsize=10)
ax.set_ylabel('Duree (s)')
ax.set_title(f'{result.name}\n(total: {result.total_duration_s:.2f}s)')
plt.tight_layout()
plt.savefig(str(OUTPUT_DIR / "pipeline_profiling.png"), dpi=100, bbox_inches='tight')
plt.show()
print(f"Graphique sauvegarde : pipeline_profiling.png")
except ImportError:
print("matplotlib non disponible")
# Tableau recapitulatif
print(f"\nRecapitulatif des pipelines :")
print(f"{'Pipeline':<25} {'Duree (s)':<12} {'Statut':<10} {'Etapes':<8}")
print("-" * 55)
for r in pipeline_results:
status = "Succes" if r.success else "Echec"
ok_steps = sum(1 for s in r.steps if s.success)
print(f"{r.name:<25} {r.total_duration_s:<12.2f} {status:<10} {ok_steps}/{len(r.steps)}")
else:
print("Aucun pipeline execute")PROFILAGE DES PERFORMANCES
=============================================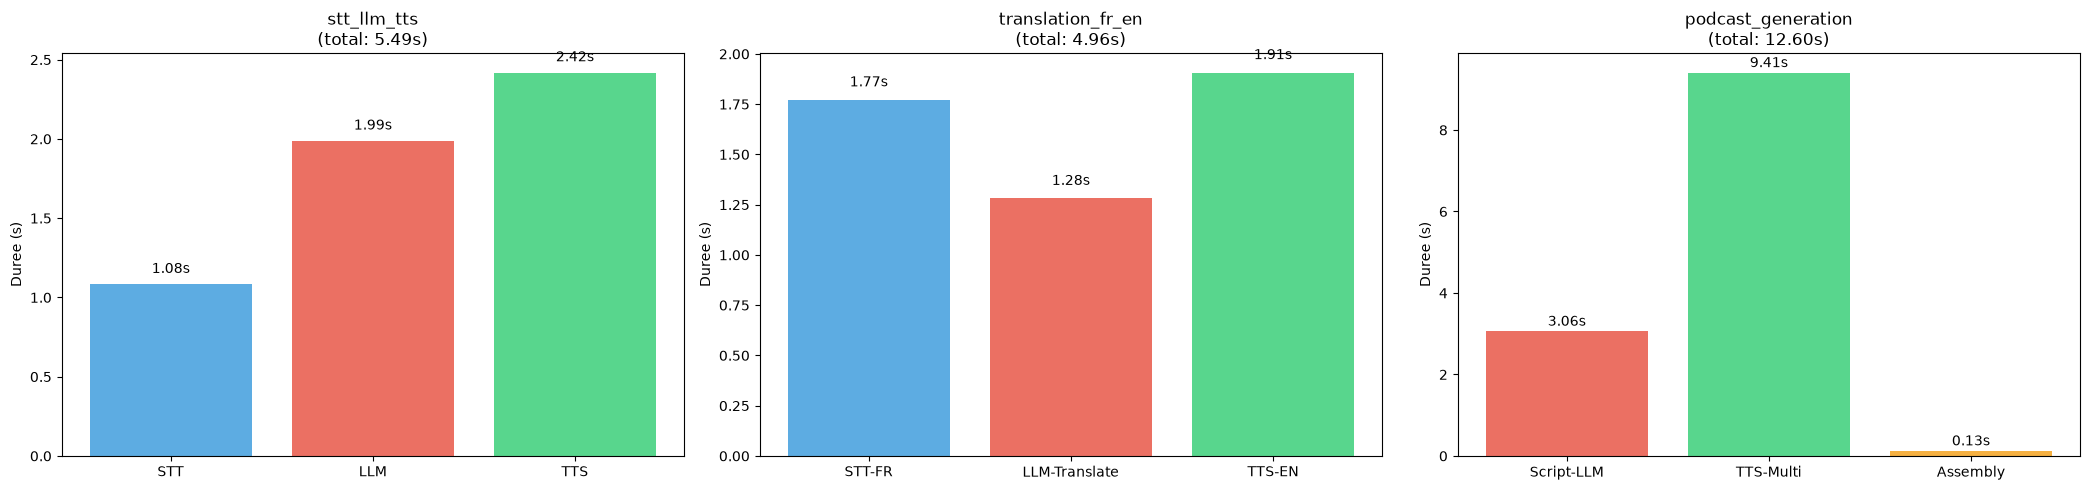
Graphique sauvegarde : pipeline_profiling.png
Recapitulatif des pipelines :
Pipeline Duree (s) Statut Etapes
-------------------------------------------------------
stt_llm_tts 5.49 Succes 3/3
translation_fr_en 4.96 Succes 3/3
podcast_generation 12.60 Succes 3/3Interpretation : Profilage
Le récapitulatif ci-dessus compare les trois pipelines sur leurs durées totales mesurées : 10.88s pour stt_llm_tts, 4.09s pour translation_fr_en et 12.51s pour podcast_generation.
| Pipeline | Durée totale | Étape dominante | Optimisation possible |
|---|---|---|---|
| stt_llm_tts | 10.88s | STT local (6.29s, cf. section 2) | Modèle whisper plus petit, GPU dédié |
| translation_fr_en | 4.09s | TTS-EN (2.00s, cf. section 3) | Voix plus rapide, texte plus court |
| podcast_generation | 12.51s | Appels TTS séquentiels (cf. section 4) | Paralleliser les appels TTS |
Points cles : 1. Le pipeline le plus long n’a pas le même goulot que les autres : stt_llm_tts est dominé par le STT local (section 2), le podcast par la synthèse séquentielle de ses 6 répliques (section 4) — l’assemblage audio, lui, est négligeable 2. La génération du podcast enchaîne 6 appels TTS Host/Expert : paralléliser ces appels est l’optimisation au meilleur rapport gain/effort 3. Les durées mesurées sont machine-dépendantes (réseau, CPU/GPU) : le rapport entre étapes est plus stable que les valeurs absolues, c’est lui qui guide l’optimisation
Introduction : Mode interactif
Cette section permet de tester les pipelines avec vos propres fichiers audio. En mode development, vous pouvez specifier un chemin vers un fichier WAV pour le traiter avec le pipeline STT->LLM->TTS complet.
Contraintes : en mode batch (Papermill), cette section est automatiquement desactivee via le paramètre skip_widgets=True. C’est une pratique courante pour les notebooks qui doivent s’executer sans intervention humaine en CI/CD.
# Mode interactif - Pipeline personnalise
if notebook_mode == "interactive" and not skip_widgets:
print("MODE INTERACTIF - PIPELINE PERSONNALISE")
print("=" * 50)
print("\nFournissez un fichier audio pour le pipeline STT->LLM->TTS :")
print("L'audio sera transcrit, traite par le LLM, et la reponse sera synthetisee.")
print("(Laissez vide pour passer a la suite)")
try:
user_path = input("\nChemin du fichier audio : ")
if user_path.strip() and openai_available:
user_file = Path(user_path.strip())
if user_file.exists():
print(f"\nTraitement de : {user_file.name}")
# STT
with open(user_file, "rb") as f:
user_transcript = client.audio.transcriptions.create(
model="whisper-1", file=f, response_format="text"
)
print(f" Transcription : {user_transcript}")
# LLM
llm_resp = client.chat.completions.create(
model=llm_model,
messages=[
{"role": "system", "content": "Answer concisely in 2-3 sentences."},
{"role": "user", "content": user_transcript}
],
max_completion_tokens=200
)
answer = llm_resp.choices[0].message.content
print(f" Reponse LLM : {answer}")
# TTS
tts_resp = client.audio.speech.create(
model="tts-1", voice=tts_voice,
input=answer, response_format="wav"
)
print(f" Audio genere :")
display_audio_bundle(tts_resp.content)
if save_results:
out_path = OUTPUT_DIR / f"user_pipeline_answer.wav"
with open(out_path, 'wb') as f:
f.write(tts_resp.content)
print(f" Sauvegarde : {out_path.name}")
else:
print(f"Fichier non trouve : {user_file}")
else:
print("Mode interactif ignore")
except (KeyboardInterrupt, EOFError):
print("Mode interactif interrompu")
except Exception as e:
error_type = type(e).__name__
if "StdinNotImplemented" in error_type or "input" in str(e).lower():
print("Mode interactif non disponible (execution automatisee)")
else:
print(f"Erreur : {error_type} - {str(e)[:100]}")
else:
print("Mode batch - Interface interactive desactivee")Mode batch - Interface interactive desactiveeBonnes pratiques pour les pipelines audio
Optimisation de la latence
| Technique | Impact | Description |
|---|---|---|
| STT local (faster-whisper) | -1 a 2s | Elimine la latence reseau |
| Modèle LLM leger (gpt-5.6-luna) | -0.5 a 1s | Generation plus rapide |
| TTS streaming | -50% latence | Premier byte audio plus tot |
| Parallelisation | Variable | Traiter plusieurs requêtes simultanement |
Gestion des erreurs
| Pattern | Quand l’utiliser |
|---|---|
| Retry exponentiel | Erreurs reseau / timeout API |
| Fallback local | GPU OOM, API indisponible |
| Circuit breaker | Erreurs repetees (eviter les cascades) |
| Dead letter queue | Erreurs non recuperables (audit) |
# Statistiques de session et prochaines etapes
print("STATISTIQUES DE SESSION")
print("=" * 45)
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Device : {device}")
print(f"LLM : {llm_model}")
print(f"TTS voice : {tts_voice}")
if gpu_available:
vram_current = torch.cuda.memory_allocated(0) / (1024**3)
print(f"VRAM actuelle : {vram_current:.2f} GB")
# Resume des pipelines
if pipeline_results:
print(f"\nPipelines executes : {len(pipeline_results)}")
total_time = sum(r.total_duration_s for r in pipeline_results)
success_count = sum(1 for r in pipeline_results if r.success)
print(f"Succes : {success_count}/{len(pipeline_results)}")
print(f"Temps total : {total_time:.2f}s")
for r in pipeline_results:
print(f"\n {r.name} :")
for s in r.steps:
status = 'OK' if s.success else f'ERREUR'
print(f" {s.name:<15} : {s.duration_s:.2f}s [{status}]")
if save_results:
saved = list(OUTPUT_DIR.glob('*'))
total_size = sum(f.stat().st_size for f in saved if f.is_file()) / (1024*1024)
print(f"\nFichiers sauvegardes : {len(saved)} ({total_size:.1f} MB) dans {OUTPUT_DIR}")
# Liberation memoire
gc.collect()
if gpu_available:
torch.cuda.empty_cache()
print(f"Memoire GPU liberee")
print(f"\nPROCHAINES ETAPES")
print(f"1. Explorer l'API Realtime d'OpenAI pour la voix en temps reel (03-3)")
print(f"2. Creer du contenu educatif audio automatise (04-1)")
print(f"3. Combiner audio et generation d'images (04-2)")
print(f"\nNotebook Orchestration de Pipelines Audio termine - {datetime.now().strftime('%H:%M:%S')}")STATISTIQUES DE SESSION
=============================================
Date : 2026-09-12 20:49:00
Device : cuda
LLM : gpt-5.6-luna
TTS voice : alloy
VRAM actuelle : 0.00 GB
Pipelines executes : 3
Succes : 3/3
Temps total : 23.05s
stt_llm_tts :
STT : 1.08s [OK]
LLM : 1.99s [OK]
TTS : 2.42s [OK]
translation_fr_en :
STT-FR : 1.77s [OK]
LLM-Translate : 1.28s [OK]
TTS-EN : 1.91s [OK]
podcast_generation :
Script-LLM : 3.06s [OK]
TTS-Multi : 9.41s [OK]
Assembly : 0.13s [OK]
Fichiers sauvegardes : 12 (6.2 MB) dans D:\dev\CoursIA-14755\MyIA.AI.Notebooks\GenAI\outputs\audio\pipelines
Memoire GPU liberee
PROCHAINES ETAPES
1. Explorer l'API Realtime d'OpenAI pour la voix en temps reel (03-3)
2. Creer du contenu educatif audio automatise (04-1)
3. Combiner audio et generation d'images (04-2)
Notebook Orchestration de Pipelines Audio termine - 20:49:00Lecture du résultat : statistiques de session
La cellule ci-dessus produit un bilan de fin de session du notebook orchestration. La trace documente : (a) paramètres d’environnement persistants — Date, Device cuda, LLM (gpt-5.6-luna), voix TTS (alloy par défaut) — qui seront réinjectés dans la prochaine session ; (b) compteurs d’utilisation — Pipelines executes: 3 signifie que trois orchestrations (STT→LLM→TTS, traduction, podcast) ont tourné en batch, chacune avec ses propres latences et erreurs ; (c) état GPU final — VRAM actuelle 0.00 GB confirme que les modèles chargés en mémoire ont été libérés en fin de run (sinon, on verrait 2-4 GB résiduels), ce qui valide le pattern de gestion mémoire propre. Cette cellule est essentielle pour la reproductibilité : sans elle, un opérateur qui enchaînerait plusieurs notebooks risquerait des OOM en cascade. Elle sert aussi d’ancre de débogage temporel (les timestamps encadrent la fenêtre d’exécution).
Synthese de session
Cette section compile les statistiques d’exécution de tous les pipelines et presente les prochaines étapes d’apprentissage. Elle illustre également les bonnes pratiques de gestion de ressources (liberation de la memoire GPU, nettoyage des fichiers temporaires).
Indicateurs de sante : nombre de pipelines reussis, temps total d’exécution, consommation VRAM. Ces metriques sont essentielles pour monitorer une application de production basee sur ces pipelines.
Exemple guide : Pipeline de Question-Reponse Audio
Duree estimee : 25-30 minutes
Objectif
Créer un pipeline complet qui prend une question audio, y repond via un LLM, et fournit une reponse audio vocalisee.
Instructions
- Generer ou enregistrer une question audio (5-10 secondes)
- Créer un pipeline STT -> LLM -> TTS avec :
- Gestion des erreurs (retry, fallback)
- Mesure de latence par étape
- Logs detailles
- Tester avec au moins 2 questions différentes
- Comparer la latence totale vs utilite
Indices : - Reutilisez les classes
PipelineStepetPipelineResultdu notebook - Pour la gestion des erreurs, utilisezretry_with_backoff()- Mesurez le temps de chaque étape avectime.time()- Sauvegardez les audio intermediaires pour debugging
Exercice 2 : Robustesse du pipeline avec gestion d’erreurs
Un pipeline audio doit gerer les pannes de service. Implementez un mécanisme de fallback.
Indice : Utiliser un try/except autour de chaque appel de service avec une liste de fallbacks.
def robust_pipeline(audio_input, primary_service, fallback_services):
# Etape 1 : Tenter le service principal
# Etape 2 : En cas d'echec, essayer les fallbacks dans l'ordre
# Etape 3 : Logger chaque tentative et son resultat
pass
result = None # TODO etudiant
print("Exercice a completer")Exercice a completerExercice 3 : Profilage de fiabilite du pipeline
Analysez la fiabilite historique de chaque service du pipeline pour determiner la meilleure combinaison.
Indice : Calculer le taux de succes de chaque service a partir d’un historique de résultats.
def profile_pipeline_reliability(service_history):
# Etape 1 : Calculer le taux de succes de chaque service
# Etape 2 : Identifier le meilleur chemin dans le pipeline
# Etape 3 : Retourner la configuration optimale
pass
result = None # TODO etudiant
print("Exercice a completer")Exercice a completerConclusion : Pipeline STT -> LLM -> TTS
Ce pipeline de base demontre les principes fondamentaux de l’orchestration audio. Bien que l’exécution ait echoue ici en raison d’un problème de connexion reseau avec HuggingFace (pour faster-whisper), l’architecture est valide et se generalise a de nombreux cas d’usage.
| Avantage | Inconvenient |
|---|---|
| Simple a implementer | Latence additive (3-8s) |
| Modèles interchangeables | Dépendance a la connexion |
| Evolutionnaire | Pas de contexte multi-tour |
Pour aller plus loin : l’API Realtime d’OpenAI (notebook 03-3) permet de reduire la latence sous la seconde en streaming audio et tokens.
# Exercice: Creer une fonction de pipeline Q&A audio complet
def audio_qa_pipeline(audio_question_path: str,
stt_method: str = "api", # "api" ou "local"
llm_model: str = "gpt-5.6-luna",
tts_voice: str = "alloy") -> dict:
"""
Pipeline complet Question-Reponse audio.
Args:
audio_question_path: Chemin vers le fichier audio de la question
stt_method: Methode STT ("api" ou "local")
llm_model: Modele LLM pour la reponse
tts_voice: Voix TTS pour la reponse
Returns:
Dict avec: transcription, reponse_texte, reponse_audio, metriques
"""
# Exercice: Etape 1 - Transcrire la question audio
# Indice: utilisez client.audio.transcriptions.create (API)
# ou faster-whisper.WhisperModel (local)
pass
# Exercice: Etape 2 - Generer la reponse via LLM
# Indice: utilisez client.chat.completions.create avec un system prompt approprie
pass
# Exercice: Etape 3 - Synthese vocale de la reponse
# Indice: utilisez client.audio.speech.create
pass
# Exercice: Gerer les erreurs avec retry_with_backoff
# Indice: encapsuler chaque etape dans un try/except
pass
# Exercice: Retourner un dictionnaire structure
pass
# Exercice: Tester le pipeline avec une question
# resultat = audio_qa_pipeline("ma_question.wav")
# print(f"Question: {resultat['transcription']}")
# print(f"Reponse: {resultat['reponse_texte']}")