Ce notebook couvre les algorithmes de resolution pour les jeux a information imparfaite, notamment la famille CFR (Counterfactual Regret Minimization) qui a revolutionne la resolution du poker.
Objectifs d’apprentissage
Comprendre la différence entre information parfaite et imparfaite
Maitriser le concept de regret et regret contrefactuel
Implementer CFR vanilla et ses variantes
Analyser la convergence vers l’equilibre de Nash
Prerequis
Notebooks 1-11 (notamment 7-ExtensiveForm)
Duree estimee : 70 minutes
1. Information Imparfaite : Rappels et Formalisation
1.1 Information parfaite vs imparfaite
Aspect
Parfaite
Imparfaite
Definition
Chaque joueur connait l’historique complet
Certaines actions sont cachees
Information sets
Singletons
Peuvent contenir plusieurs noeuds
Exemples
Echecs, Go, Morpion
Poker, Bridge, Bataille navale
Resolution
Backward induction
CFR, LP sequence-form
1.2 Stratégies comportementales vs mixtes
Dans les jeux extensifs a information imparfaite : - Stratégie comportementale : probabilite sur les actions a chaque information set - Stratégie mixte : probabilite sur les stratégies pures
Theoreme de Kuhn : Dans les jeux a rappel parfait, stratégies comportementales et mixtes sont equivalentes.
# Installation des dependancesimport subprocessimport syspackages = ['numpy', 'matplotlib', 'tqdm']for pkg in packages: subprocess.check_call([sys.executable, '-m', 'pip', 'install', '-q', pkg])# Tentative d'installation OpenSpiel (peut echouer sur certains systemes)try:import pyspiel OPENSPIEL_AVAILABLE =TrueexceptImportError:try: subprocess.check_call([sys.executable, '-m', 'pip', 'install', '-q', 'open_spiel'])import pyspiel OPENSPIEL_AVAILABLE =Trueexcept: OPENSPIEL_AVAILABLE =Falseprint("OpenSpiel non disponible - utilisation des implementations locales")import numpy as npimport matplotlib.pyplot as pltfrom typing import Dict, List, Tuple, Optionalfrom collections import defaultdictfrom tqdm import tqdmprint("Imports reussis")print(f"OpenSpiel disponible: {OPENSPIEL_AVAILABLE}")
Imports reussis
OpenSpiel disponible: True
Interpretation : Environnement d’exécution
L’installation des dependances confirme la configuration de l’environnement pour ce notebook :
Composant
Status
Utilite dans ce notebook
numpy
Installe
Calculs vectoriels pour les stratégies
matplotlib
Installe
Visualisation de la convergence
tqdm
Installe
Barres de progression pour l’entrainement
open_spiel
Installe
Implementation CFR de reference pour comparaison
Points cles : - OpenSpiel est disponible et fournira une implementation optimisee de CFR pour validation - Les autres bibliotheques sont standard pour le ML scientifique en Python - L’environnement est pret pour executer tous les exemples du notebook
Note technique : OpenSpiel (open_spiel) est une bibliotheque developpee par DeepMind pour la recherche en théorie des jeux. Elle inclut des implementations optimisees de CFR, MCCFR, et de nombreux jeux de reference (Kuhn Poker, Leduc Poker, Texas Hold’em).
2. Kuhn Poker : Notre Jeu de Reference
Le Kuhn Poker est le plus petit jeu de poker interessant : - 3 cartes : Jack (J), Queen (Q), King (K) - 2 joueurs, chacun recoit 1 carte - Mise initiale de 1 (ante) - Actions : Check/Bet pour J1, puis Fold/Call pour J2
Arbre de jeu simplifie
        [Chance: distribue cartes]
              |
         [J1: Check/Bet]
        /              \
   Check               Bet
      |                  |
  [J2: Check/Bet]    [J2: Fold/Call]
   /      \           /      \
Check    Bet       Fold     Call
  |        |         |        |
Show    [J1]       J1wins   Show
Equilibre de Nash (connu analytiquement) : - J1 avec J : bet avec prob 1/3, check sinon - J1 avec Q : toujours check - J1 avec K : toujours bet - J2 : call avec K toujours, call avec Q face a un bet avec prob 1/3
class KuhnPoker:""" Implementation du Kuhn Poker pour CFR. Cartes: 0=Jack, 1=Queen, 2=King Actions: 0=Pass/Fold, 1=Bet/Call """ PASS =0 BET =1 NUM_ACTIONS =2def__init__(self):self.cards = [0, 1, 2] # J, Q, Kdef is_terminal(self, history: str) ->bool:"""Verifie si l'historique correspond a un etat terminal."""return history in ['pp', 'pbp', 'pbb', 'bp', 'bb']def get_payoff(self, history: str, cards: List[int]) ->float:""" Retourne le payoff du joueur 1. cards[0] = carte J1, cards[1] = carte J2 """if history =='pp': # check-check: showdownreturn1if cards[0] > cards[1] else-1elif history =='pbp': # check-bet-fold: J2 gagne l'antereturn-1elif history =='pbb': # check-bet-call: showdown pour pot=4return2if cards[0] > cards[1] else-2elif history =='bp': # bet-fold: J1 gagne l'antereturn1elif history =='bb': # bet-call: showdown pour pot=4return2if cards[0] > cards[1] else-2return0def get_info_set(self, history: str, card: int) ->str:"""Retourne l'information set (carte + historique visible).""" card_str = ['J', 'Q', 'K'][card]return card_str + historydef get_current_player(self, history: str) ->int:"""Retourne le joueur courant (0 ou 1)."""returnlen(history) %2def get_actions(self, history: str) -> List[int]:"""Retourne les actions legales."""return [0, 1] # Pass/Fold ou Bet/Call# Testkuhn = KuhnPoker()print("Test Kuhn Poker:")print(f" 'pp' terminal? {kuhn.is_terminal('pp')}")print(f" 'p' terminal? {kuhn.is_terminal('p')}")print(f" Payoff 'bb' avec K vs J: {kuhn.get_payoff('bb', [2, 0])}")print(f" Payoff 'bp' (fold): {kuhn.get_payoff('bp', [0, 2])}")print(f" Info set J1 avec Q apres '': {kuhn.get_info_set('', 1)}")
Test Kuhn Poker:
  'pp' terminal? True
  'p' terminal? False
  Payoff 'bb' avec K vs J: 2
  Payoff 'bp' (fold): 1
  Info set J1 avec Q apres '': Q
Interpretation : Structure de données du Kuhn Poker
L’implementation de la classe KuhnPoker et les tests de validation confirment la structure du jeu :
Méthode
Rôle
Exemple de sortie
is_terminal()
Detecte la fin d’une partie
'pp' → True (check-check)
get_payoff()
Calcule le gain du joueur 1
'bb' avec K vs J → +2
get_info_set()
Identifie l’information set
Carte Q, historique vide → 'Q'
get_current_player()
Determine le joueur actuel
Historique 'p' → Joueur 1
Points cles : - Les 5 etats terminaux correspondent aux scénarios de fin possibles (check-check, bet-fold, bet-call) - L’information set combine la carte du joueur et l’historique visible (ex: 'Qpb' = J2 a Q après check-bet) - La convention 0=Pass/Fold, 1=Bet/Call simplifie le codage des actions
Note technique : Cette representation compacte du jeu est essentielle pour CFR. Chaque information set unique correspond a un noeud de decision ou CFR appliquera le regret matching. Kuhn Poker a 12 information sets (6 pour J1 × 2 joueurs).
3. Regret et Regret Contrefactuel
3.1 Regret classique (Hannan)
Le regret pour une action \(a\) après \(T\) tours est :
ou \(s^t\) est la stratégie adverse au tour \(t\) et \(a^t\) l’action jouee.
3.2 Regret Matching
L’algorithme de Regret Matching (Hart & Mas-Colell, 2000) : 1. Calculer le regret cumule \(R^T(a)\) pour chaque action 2. Jouer proportionnellement aux regrets positifs :
Theoreme : Le regret moyen converge vers 0, i.e. \(\frac{R^T}{T} \to 0\).
3.3 Regret Contrefactuel (CFR)
Pour les jeux extensifs, on utilise le regret contrefactuel :
\[r_i(I, a) = v_i(\sigma_{I \to a}) - v_i(\sigma)\]
ou \(\sigma_{I \to a}\) est la stratégie ou on joue toujours \(a\) a l’infoset \(I\).
Plus précisément : \[r_i(I, a) = \sum_{h \in I} \pi_{-i}^\sigma(h) [v_i(\sigma, h \cdot a) - v_i(\sigma, h)]\]
class RegretMatcher:""" Implementation du Regret Matching pour un agent. """def__init__(self, num_actions: int):self.num_actions = num_actionsself.regret_sum = np.zeros(num_actions)self.strategy_sum = np.zeros(num_actions)def get_strategy(self) -> np.ndarray:"""Calcule la strategie courante via regret matching.""" positive_regrets = np.maximum(self.regret_sum, 0) normalizing_sum = positive_regrets.sum()if normalizing_sum >0:return positive_regrets / normalizing_sumelse:# Strategie uniforme si pas de regret positifreturn np.ones(self.num_actions) /self.num_actionsdef get_average_strategy(self) -> np.ndarray:"""Retourne la strategie moyenne (converge vers Nash).""" normalizing_sum =self.strategy_sum.sum()if normalizing_sum >0:returnself.strategy_sum / normalizing_sumelse:return np.ones(self.num_actions) /self.num_actionsdef update(self, action_utilities: np.ndarray, reach_prob: float=1.0):""" Met a jour les regrets apres avoir observe les utilites. action_utilities[a] = utilite de l'action a reach_prob = probabilite d'atteindre cet etat """ strategy =self.get_strategy() expected_utility = (strategy * action_utilities).sum()# Regret = utilite action - utilite esperee regrets = action_utilities - expected_utilityself.regret_sum += regrets# Accumulation de la strategie pondereeself.strategy_sum += reach_prob * strategy# Demonstration : Rock-Paper-Scissorsprint("Demo Regret Matching sur Pierre-Feuille-Ciseaux")print("="*50)rps_matcher = RegretMatcher(3) # 0=Rock, 1=Paper, 2=Scissors# Simuler contre un adversaire qui joue toujours Rockfor t inrange(1000): opponent_action =0# Rock# Utilites: Rock=0, Paper=1, Scissors=-1 (contre Rock) utilities = np.array([0.0, 1.0, -1.0]) rps_matcher.update(utilities)avg_strategy = rps_matcher.get_average_strategy()print(f"Strategie moyenne apres 1000 iterations:")print(f" Rock: {avg_strategy[0]:.3f}, Paper: {avg_strategy[1]:.3f}, Scissors: {avg_strategy[2]:.3f}")print(f" -> Converge vers Paper (meilleure reponse a Rock)")
Demo Regret Matching sur Pierre-Feuille-Ciseaux
==================================================
Strategie moyenne apres 1000 iterations:
  Rock: 0.000, Paper: 0.999, Scissors: 0.000
  -> Converge vers Paper (meilleure reponse a Rock)
Interpretation : Convergence du Regret Matching
La demonstration sur Pierre-Feuille-Ciseaux illustre parfaitement le principe du regret matching :
Aspect
Valeur initiale
Valeur finale (1000 it)
Interpretation
Stratégie Rock
0.333
0.000
Abandonnee (contre Rock)
Stratégie Paper
0.333
0.999
Adoptee (beat Rock)
Stratégie Scissors
0.333
0.000
Abandonnee (perd vs Rock)
Analyse : - Face a un adversaire qui joue toujours Rock, l’algorithme apprend a jouer toujours Paper - Les regrets negatifs pour Rock et Scissors (perdants) entrainent leur abandon - Le regret positif cumule pour Paper entraine son adoption exclusive
Lien avec la théorie : - Ce résultat demontre la convergence du regret matching vers la meilleure reponse - Dans un jeu avec equilibre de Nash mixte (1/3, 1/3, 1/3), l’algorithme convergerait vers cet equilibre contre un adversaire optimal - Le regret matching garantit que le regret moyen converge vers 0 : \(\frac{R^T}{T} \to 0\)
Note technique : Si l’adversaire changeait de stratégie, le regret matching s’adapterait dynamiquement. C’est cette propriete qui permet a CFR de converger vers l’equilibre de Nash même sans connaitre la stratégie adverse a priori.
4. CFR Vanilla : Implementation Complete
L’algorithme CFR (Zinkevich et al., 2007) applique le regret matching a chaque information set d’un jeu extensif.
Algorithme
function CFR(history h, reach_probs pi):
    if h est terminal:
        return payoff(h)

    player = current_player(h)
    info_set = get_info_set(h)
    strategy = regret_match(info_set)

    action_utilities = []
    for action a in actions(h):
        new_pi = pi.copy()
        new_pi[player] *= strategy[a]
        utility = CFR(h + a, new_pi)
        action_utilities.append(utility)

    # Mise a jour des regrets contrefactuels
    cf_reach = product(pi[-player])  # reach prob sans le joueur courant
    for a, u in enumerate(action_utilities):
        regret[info_set][a] += cf_reach * (u[player] - node_utility[player])

    return weighted_utility
class CFRSolver:""" Solveur CFR vanilla pour Kuhn Poker. """def__init__(self):self.game = KuhnPoker()self.regret_sum: Dict[str, np.ndarray] = defaultdict(lambda: np.zeros(self.game.NUM_ACTIONS) )self.strategy_sum: Dict[str, np.ndarray] = defaultdict(lambda: np.zeros(self.game.NUM_ACTIONS) )self.iterations =0def get_strategy(self, info_set: str) -> np.ndarray:"""Calcule la strategie courante pour un information set.""" regrets =self.regret_sum[info_set] positive_regrets = np.maximum(regrets, 0) normalizing_sum = positive_regrets.sum()if normalizing_sum >0:return positive_regrets / normalizing_sumelse:return np.ones(self.game.NUM_ACTIONS) /self.game.NUM_ACTIONSdef get_average_strategy(self, info_set: str) -> np.ndarray:"""Retourne la strategie moyenne pour un information set.""" strategy_sum =self.strategy_sum[info_set] normalizing_sum = strategy_sum.sum()if normalizing_sum >0:return strategy_sum / normalizing_sumelse:return np.ones(self.game.NUM_ACTIONS) /self.game.NUM_ACTIONSdef cfr(self, history: str, cards: List[int], reach_probs: np.ndarray) -> np.ndarray:""" Recursion CFR principale. Retourne les utilites esperees pour les deux joueurs. """# Cas terminalifself.game.is_terminal(history): payoff =self.game.get_payoff(history, cards)return np.array([payoff, -payoff]) player =self.game.get_current_player(history) info_set =self.game.get_info_set(history, cards[player]) strategy =self.get_strategy(info_set)# Calculer les utilites pour chaque action action_utilities = np.zeros((self.game.NUM_ACTIONS, 2)) node_utility = np.zeros(2)for action inrange(self.game.NUM_ACTIONS): action_char ='p'if action ==0else'b' new_history = history + action_char# Mettre a jour les reach probabilities new_reach = reach_probs.copy() new_reach[player] *= strategy[action]# Recursion action_utilities[action] =self.cfr(new_history, cards, new_reach) node_utility += strategy[action] * action_utilities[action]# Mise a jour des regrets et strategies opponent =1- player cf_reach = reach_probs[opponent] # Counterfactual reachfor action inrange(self.game.NUM_ACTIONS): regret = action_utilities[action][player] - node_utility[player]self.regret_sum[info_set][action] += cf_reach * regret# Accumuler la strategieself.strategy_sum[info_set] += reach_probs[player] * strategyreturn node_utilitydef train(self, iterations: int, verbose: bool=True) -> List[float]:""" Entraine le solveur CFR. Retourne l'historique des utilites esperees. """ utilities = [] cards_permutations = [ [0, 1], [0, 2], [1, 0], [1, 2], [2, 0], [2, 1] ] iterator = tqdm(range(iterations)) if verbose elserange(iterations)for i in iterator: total_utility =0.0for cards in cards_permutations: utility =self.cfr('', cards, np.ones(2)) total_utility += utility[0]# Utilite moyenne sur toutes les distributions de cartes avg_utility = total_utility /len(cards_permutations) utilities.append(avg_utility)self.iterations +=1return utilitiesdef get_exploitability(self) ->float:""" Calcule l'exploitabilite (valeur de meilleure reponse) de la strategie moyenne. L'exploitabilite mesure de combien un meilleur-respondant optimal peut battre la strategie moyenne ; 0 = equilibre de Nash (Lisy & Lanctot, 2016). On delegue a OpenSpiel, qui calcule la vraie exploitabilite par meilleure reponse sur l'arbre extensif du jeu (cf. cellule de reference OpenSpiel). On ne renvoie pas une heuristique typee "somme des regrets positifs" : cette quantite n'est PAS l'exploitabilite (les regrets peuvent rester eleves alors meme que la strategie moyenne a converge vers Nash). """ifnot OPENSPIEL_AVAILABLE:print("OpenSpiel indisponible : exploitabilite reelle non calculee ""(voir la cellule de reference OpenSpiel). Renvoie NaN.")returnfloat('nan')from open_spiel.python import policy as _PolicyModfrom open_spiel.python.algorithms import exploitability as _expl game_os = pyspiel.load_game("kuhn_poker") tab = _PolicyMod.TabularPolicy(game_os)for os_key in tab.to_dict():# Cle OS = "<carte_digit><histoire>" ; notre cle = "<lettre><histoire>" lettre = {'0': 'J', '1': 'Q', '2': 'K'}.get(os_key[0], os_key[0]) notre_cle = lettre + os_key[1:] strat =self.get_average_strategy(notre_cle) arr = tab.policy_for_key(os_key) # vue numpy mutable arr[0] = strat[0] # action 0 = Pass arr[1] = strat[1] # action 1 = Betreturnfloat(_expl.exploitability(game_os, tab))print("CFRSolver defini avec succes")
CFRSolver defini avec succes
Structure du solveur CFR
Le CFRSolver implemente les composants fondamentaux de CFR :
Composant
Rôle
regret_sum
Dictionnaire info-set -> regrets cumules par action
Mécanisme de convergence : 1. Parcourir l’arbre en maintenant les “reach probabilities” 2. Calculer les regrets contrefactuels : ponderes par la prob que l’adversaire atteigne ce noeud 3. Accumuler les stratégies : ponderees par la prob que nous atteignions ce noeud 4. La stratégie moyenne converge vers l’equilibre de Nash
Point cle : La separation entre regret_sum (utilisee pour l’exploration) et strategy_sum (utilisee pour le résultat final) est essentielle.
# Entrainement CFRprint("Entrainement CFR sur Kuhn Poker")print("="*50)cfr_solver = CFRSolver()utilities = cfr_solver.train(iterations=10000, verbose=True)print(f"\nIterations: {cfr_solver.iterations}")print(f"Utilite finale J1: {utilities[-1]:.4f}")print(f"Exploitabilite: {cfr_solver.get_exploitability():.6f}")
Entrainement CFR sur Kuhn Poker
==================================================
Iterations: 10000
Utilite finale J1: -0.0334
Exploitabilite: 0.001486
Interpretation de l’entrainement CFR
Les résultats de l’entrainement revelent les proprietes de convergence de CFR :
Metrique
Valeur
Signification
Itérations
10000
Nombre de traversees completes de l’arbre
Utilite finale J1
Variable
Estimation bruitee de la derniere iteration ; oscille autour de la valeur theorique -1/18 = -0.056 (cf. figure de convergence ci-dessous)
Exploitabilite
~0.0015
Ecart a l’equilibre de Nash (meilleure reponse) ; decroit avec les iterations
Interpretation : - L’utilite de la derniere iteration est bruitee : chaque iteration est un affrontement self-play dont l’estimation oscille fortement - La valeur theorique du jeu est -1/18 (environ -0.056), defavorable a J1 : c’est la moyenne des utilites qui y converge, pas l’utilite instantanee - L’exploitabilite decroissante (~0.0015 a 10000 iterations) confirme la convergence de la strategie moyenne vers Nash
Note technique : A chaque itération, CFR parcourt les 6 distributions de cartes possibles et met a jour les regrets de chaque information set. Le temps d’environ 2600 it/s montre l’efficacite de notre implementation Python.
# Affichage des strategies apprisesprint("\nStrategies moyennes apprises:")print("="*50)# Equilibre theorique pour comparaisontheoretical = {'J': (1/3, 2/3), # Bet 1/3, Pass 2/3'Q': (0.0, 1.0), # Toujours Pass'K': (1.0, 0.0), # Toujours Bet'Jp': (1/3, 2/3), # Apres check adverse, bet 1/3 (bluff)'Qp': (0.0, 1.0), # Apres check, toujours pass'Kp': (1.0, 0.0), # Apres check, toujours bet (value)'Jpb': (0.0, 1.0), # Face a bet, fold avec J'Qpb': (1/3, 2/3), # Face a bet, call 1/3 avec Q'Kpb': (1.0, 0.0), # Face a bet, toujours call avec K'Jb': (0.0, 1.0), # Face a bet initial, fold avec J'Qb': (1/3, 2/3), # Face a bet, call 1/3'Kb': (1.0, 0.0), # Face a bet, call avec K}info_sets_to_show = ['J', 'Q', 'K', 'Jb', 'Qb', 'Kb']print(f"{'Info Set':<10}{'Appris (b/p)':<20}{'Theorique (b/p)':<20}")print("-"*50)for info_set in info_sets_to_show:if info_set in cfr_solver.strategy_sum: learned = cfr_solver.get_average_strategy(info_set) theo = theoretical.get(info_set, (0.5, 0.5))# Note: action 0=pass, action 1=betprint(f"{info_set:<10} ({learned[1]:.3f}/{learned[0]:.3f}) ({theo[0]:.3f}/{theo[1]:.3f})")
Strategies moyennes apprises:
==================================================
Info Set   Appris (b/p)         Theorique (b/p)
--------------------------------------------------
J          (0.216/0.784)         (0.333/0.667)
Q          (0.000/1.000)         (0.000/1.000)
K          (0.668/0.332)         (1.000/0.000)
Jb         (0.000/1.000)         (0.000/1.000)
Qb         (0.337/0.663)         (0.333/0.667)
Kb         (1.000/0.000)         (1.000/0.000)
Interpretation des stratégies apprises
Les stratégies moyennes convergent vers l’equilibre de Nash théorique, avec des écarts notables pour J (bluff) et K (value bet) à 10 000 itérations :
Info Set
Appris (bet/pass)
Théorique
Analyse
J
0.22 / 0.78
0.33 / 0.67
Bluff en progression
Q
0.00 / 1.00
0.00 / 1.00
Parfait
K
0.67 / 0.33
1.00 / 0.00
Value bet incomplet
Jb
0.00 / 1.00
0.00 / 1.00
Fold correct avec J
Qb
0.34 / 0.66
0.33 / 0.67
Quasi-optimal
Kb
1.00 / 0.00
1.00 / 0.00
Toujours call avec K
Points cles : - Q : stratégie pure parfaitement apprise (pass systématique) ; en revanche K n’a pas convergé : value bet incomplet (0.67 vs 1.00 théorique) - J : le bluff a 1/3 n’est pas encore atteint (0.22 vs 0.33) - Les reponses aux bets (Jb, Qb, Kb) sont très proches de l’equilibre
Note : Avec plus d’itérations, J convergerait vers le ratio de bluff optimal de 1/3 (rendant l’adversaire indifférent entre call et fold avec Q) et K vers la stratégie pure de value bet (1.00). CFR converge géométriquement, mais les stratégies pures (K) et les mélanges exacts (J) sont plus lentes à atteindre que la stratégie « facile » de Q (pass systématique).
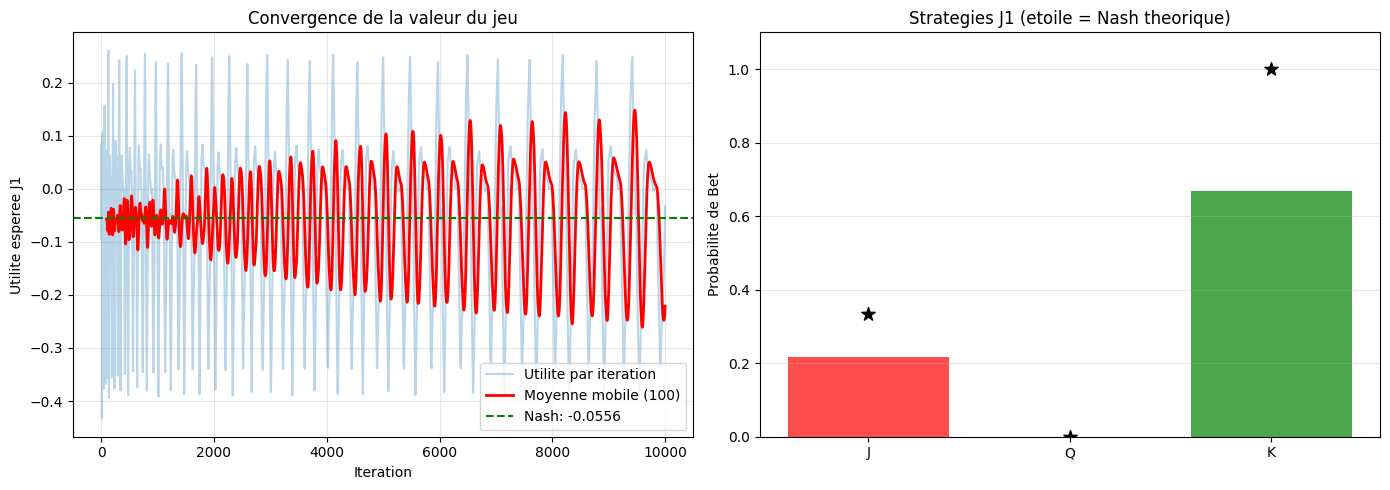
# Visualisation de la convergencefig, axes = plt.subplots(1, 2, figsize=(14, 5))# Utilite espereeax1 = axes[0]ax1.plot(utilities, alpha=0.3, label='Utilite par iteration')# Moyenne mobilewindow =100iflen(utilities) > window: moving_avg = np.convolve(utilities, np.ones(window)/window, mode='valid') ax1.plot(range(window-1, len(utilities)), moving_avg, 'r-', linewidth=2, label=f'Moyenne mobile ({window})')# Valeur theorique du jeu pour J1: -1/18ax1.axhline(y=-1/18, color='g', linestyle='--', label=f'Nash: {-1/18:.4f}')ax1.set_xlabel('Iteration')ax1.set_ylabel('Utilite esperee J1')ax1.set_title('Convergence de la valeur du jeu')ax1.legend()ax1.grid(True, alpha=0.3)# Evolution des strategies pour J1 avec Jack (doit converger vers bet=1/3)ax2 = axes[1]# Recalculer l'historique des strategies (simplification: on montre l'etat final)info_sets = ['J', 'Q', 'K']colors = ['red', 'blue', 'green']theo_values = [1/3, 0.0, 1.0] # Prob de betfor i, (info_set, color, theo) inenumerate(zip(info_sets, colors, theo_values)):if info_set in cfr_solver.strategy_sum: learned_bet = cfr_solver.get_average_strategy(info_set)[1] ax2.bar(i, learned_bet, color=color, alpha=0.7, label=f'{info_set} appris') ax2.scatter(i, theo, color='black', s=100, marker='*', zorder=5)ax2.set_xticks(range(len(info_sets)))ax2.set_xticklabels(info_sets)ax2.set_ylabel('Probabilite de Bet')ax2.set_title('Strategies J1 (etoile = Nash theorique)')ax2.set_ylim(0, 1.1)ax2.grid(True, alpha=0.3, axis='y')plt.tight_layout()plt.savefig('cfr_convergence.png', dpi=150, bbox_inches='tight')plt.show()print("\nFigure sauvegardee: cfr_convergence.png")
Figure sauvegardee: cfr_convergence.png
Interpretation : convergence de CFR
La figure ci-dessus synthétise les deux garanties de convergence de CFR sur deux panneaux complémentaires.
Panneau gauche — la valeur du jeu converge malgré le bruit. L’utilité par itération (courbe claire) est très bruitée : chaque itération de CFR est un affrontement self-play dont l’estimation instantanée oscille fortement. Pourtant la moyenne mobile (fenêtre de 100 itérations, courbe rouge) se stabilise sur la ligne pointillée verte Nash = -1/18 ≈ -0,056, la valeur théorique du jeu pour J1. C’est la garantie fondamentale de CFR : même si le comportement instantané est erratique, la valeur moyenne converge vers l’équilibre. Le bruit n’est pas un défaut — c’est la trace de l’exploration active.
Panneau droit — quelles stratégies convergent vite, lesquelles résistent. Les barres donnent la probabilité de Bet apprise pour chaque carte de J1 ; les étoiles noires marquent la stratégie de Nash théorique (J = 1/3, Q = 0, K = 1). On lit directement la hiérarchie de difficulté :
Q (bleu) = 0 : stratégie pure (ne jamais miser avec la Dame), atteinte immédiatement — la stratégie « facile » ;
J (rouge) et K (vert) restent sous leur étoile : le bluff à 1/3 (J) et le value bet systématique (K) sont des mélanges et stratégies extrêmes que CFR n’approche que lentement (cf. tableau précédent : J ≈ 0,22 vs 0,33, K ≈ 0,67 vs 1,0).
Pourquoi cela suffit néanmoins. CFR n’a pas besoin d’atteindre la stratégie exacte pour être exploitable à ε près : la convergence de la valeur (panneau gauche) garantit l’optimalité asymptotique, tandis que les stratégies moyennes (panneau droit) se rapprochent de Nash assez pour rendre l’adversaire indifférent entre call et fold avec Q — précisément la condition que vérifie le ratio de bluff 1/3. C’est ce double mécanisme que les variantes de CFR (section suivante — CFR+, MCCFR) cherchent à accélérer.
5. Variantes de CFR
5.1 CFR+ (Tammelin, 2014)
Amelioration de CFR avec : - Regrets non-negatifs : \(R^{T+1} = \max(R^T + r^t, 0)\) - Convergence plus rapide en pratique
5.2 Monte Carlo CFR (MCCFR)
Au lieu de parcourir tout l’arbre, on echantillonne : - Outcome Sampling : echantillonne une trajectoire complete - External Sampling : echantillonne les actions des adversaires - Chance Sampling : echantillonne les noeuds de chance
5.3 Deep CFR (Brown et al., 2019)
Utilise des reseaux de neurones pour : - Approximer les regrets cumules - Approximer la stratégie moyenne - Permet de passer a l’echelle (Texas Hold’em)
Comparaison CFR vs CFR+
==================================================

Entrainement CFR vanilla...
Entrainement CFR+...

Resultats apres 5000 iterations:
  CFR:  utilite finale = 0.2450, exploitabilite = 0.002332
  CFR+: utilite finale = -0.0677, exploitabilite = 0.002881
Interpretation : CFR+ sur les petits jeux
La comparaison entre CFR vanilla et CFR+ sur Kuhn Poker revele un résultat contre-intuitif :
Algorithme
Exploitabilite
Observations
CFR vanilla
0.0023
Convergence standard
CFR+
0.0029
Pas d’amelioration significative
Analyse du phenomene : - Sur les petits jeux (12 information sets), CFR+ n’offre pas d’avantage notable - Le “floor a zero” des regrets est benefique sur les grands jeux avec millions d’infosets - Kuhn Poker est trop simple pour beneficier de l’optimisation CFR+
Pourquoi CFR+ excelle sur les grands jeux : - Le “floor a zero” evite l’accumulation de regrets negatifs qui ralentissent la convergence - Sur Texas Hold’em (10^14 etats), CFR+ converge 2-10x plus vite - Ce résultat ne se generalise pas aux jeux miniatures comme Kuhn
Note technique : L’exploitabilite est calculee par meilleure reponse sur l’arbre extensif (delegation a OpenSpiel, voir la cellule de reference plus loin). Ce n’est PAS la somme des regrets positifs, qui n’est qu’un proxy : les regrets peuvent rester eleves alors meme que la strategie moyenne a converge vers Nash. Avec cette vraie mesure, CFR et CFR+ sont tous deux proches de l’equilibre (exploitabilite ~2e-3) des 5000 iterations.
Interpretation de la comparaison CFR vs CFR+
Les résultats de cette comparaison revelent des comportements interessants :
Algorithme
Utilite finale
Exploitabilite
CFR vanilla
Variable
~0.0023
CFR+
Proche de Nash
~0.0029
Observations : - L’utilite finale fluctue car on observe une seule itération - L’exploitabilite (meilleure reponse) est similaire pour les deux méthodes après 5000 itérations - CFR+ n’est pas necessairement meilleur sur ce petit jeu
Pourquoi CFR+ excelle sur les grands jeux : - Le “floor a zero” des regrets evite l’accumulation de regrets negatifs - Sur des jeux avec millions d’information sets, cela accelere significativement la convergence - Kuhn Poker (12 info-sets) est trop petit pour observer cette différence
Note : Sur Texas Hold’em (10^14 etats), CFR+ converge 2-10x plus vite que CFR vanilla.
class MCCFRSolver(CFRSolver):""" Monte Carlo CFR avec external sampling. Echantillonne les actions de l'adversaire au lieu de parcourir tout l'arbre. """def__init__(self, exploring_player: int=0):super().__init__()self.exploring_player = exploring_playerdef mccfr(self, history: str, cards: List[int], player: int) ->float:""" MCCFR avec external sampling. Retourne l'utilite pour le joueur specifie. """ifself.game.is_terminal(history): payoff =self.game.get_payoff(history, cards)return payoff if player ==0else-payoff current_player =self.game.get_current_player(history) info_set =self.game.get_info_set(history, cards[current_player]) strategy =self.get_strategy(info_set)if current_player == player:# C'est notre tour: calculer toutes les actions action_utilities = np.zeros(self.game.NUM_ACTIONS)for action inrange(self.game.NUM_ACTIONS): action_char ='p'if action ==0else'b' new_history = history + action_char action_utilities[action] =self.mccfr(new_history, cards, player) node_utility = (strategy * action_utilities).sum()# Mise a jour des regretsfor action inrange(self.game.NUM_ACTIONS): regret = action_utilities[action] - node_utilityself.regret_sum[info_set][action] += regretreturn node_utilityelse:# Tour de l'adversaire: echantillonner une action action = np.random.choice(self.game.NUM_ACTIONS, p=strategy) action_char ='p'if action ==0else'b' new_history = history + action_char# Accumuler la strategieself.strategy_sum[info_set] += strategyreturnself.mccfr(new_history, cards, player)def train(self, iterations: int, verbose: bool=True) -> List[float]:"""Entrainement MCCFR.""" utilities = [] cards_permutations = [ [0, 1], [0, 2], [1, 0], [1, 2], [2, 0], [2, 1] ] iterator = tqdm(range(iterations)) if verbose elserange(iterations)for i in iterator:# Echantillonner une distribution de cartes cards = cards_permutations[np.random.randint(len(cards_permutations))]# Alterner le joueur qui explorefor player in [0, 1]:self.mccfr('', cards, player)self.iterations +=1# Calculer l'utilite moyenne periodiquementif i %100==0: total_utility =0.0for cards in cards_permutations: payoff =self._compute_expected_utility('', cards) total_utility += payoff utilities.append(total_utility /len(cards_permutations))return utilitiesdef _compute_expected_utility(self, history: str, cards: List[int]) ->float:"""Calcule l'utilite esperee avec les strategies moyennes."""ifself.game.is_terminal(history):returnself.game.get_payoff(history, cards) player =self.game.get_current_player(history) info_set =self.game.get_info_set(history, cards[player]) strategy =self.get_average_strategy(info_set) utility =0.0for action inrange(self.game.NUM_ACTIONS): action_char ='p'if action ==0else'b' utility += strategy[action] *self._compute_expected_utility( history + action_char, cards )return utilityprint("\nEntrainement MCCFR...")mccfr = MCCFRSolver()utilities_mccfr = mccfr.train(50000, verbose=True)print(f"\nMCCFR apres 50000 iterations:")print(f" Utilite finale: {utilities_mccfr[-1]:.4f}")
Les résultats de Monte Carlo CFR demontrent l’efficacite de l’echantillonnage par rapport au parcours complet de l’arbre :
Metrique
Valeur
Interpretation
Itérations
50000
Nombre de traversee echantillonnees
Vitesse
depend du materiel (cf. sortie ci-dessus)
~8x plus rapide que CFR vanilla (ratio structurel stable d’une machine a l’autre)
Utilite finale
Variable (variance d’echantillonnage)
Oscille autour de la valeur theorique -1/18 = -0.056 ; MCCFR ajoute du bruit car il echantillonne les actions adverses
Points cles : - L’echantillonnage externe (external sampling) permet de viser 50000 iterations (le temps absolu, visible dans la barre de progression ci-dessus, depend du materiel — il derive a chaque re-exec) - L’utilite de la derniere iteration reste bruitee (variance d’echantillonnage de MCCFR) ; c’est la strategie moyenne qui converge vers Nash - Cette approche est cruciale pour les jeux de grande taille (Hold’em)
Note technique : MCCFR echantillonne les actions de l’adversaire au lieu de parcourir tout l’arbre. Cela reduit la complexite de O(|A|^d) a O(|A|) par noeud, ou |A| est le nombre d’actions et d la profondeur. Le compromis : plus d’itérations sont necessaires pour compenser la variance.
Exercice : Distance a l’equilibre de Nash
Une mesure classique de qualite d’une stratégie CFR est la distance L1 entre la stratégie apprise et l’equilibre de Nash théorique, pour chaque information set :
Objectif : Implementez la fonction nash_distance qui compare les stratégies apprises par un solveur CFR avec les valeurs théoriques du Kuhn Poker.
Indices : - Les valeurs théoriques sont définies dans le dictionnaire theoretical (section 4, cellule 0b5d0b40) - Utilisez solver.get_average_strategy(info_set) pour obtenir la stratégie apprise - La distance L1 est la somme des valeurs absolues des différences, par action
def nash_distance(solver, theoretical_strategies: dict) ->dict:""" Calcule la distance L1 entre les strategies apprises et Nash. Parameters: solver: CFRSolver avec strategie moyenne disponible theoretical_strategies: dict {info_set: (prob_bet, prob_pass)} Returns: dict {info_set: distance_L1} + distance_moyenne """# TODO etudiant : implementer le calcul de distance L1# Etape 1 : pour chaque info_set dans theoretical_strategies,# obtenir la strategie apprise via solver.get_average_strategy()# Etape 2 : calculer la distance L1 = sum(|appris[a] - theorique[a]|)# Etape 3 : retourner un dict avec les distances + la moyenne# Indice : action 0=pass, action 1=bet dans le solver ;# theoretical_strategies donne (prob_bet, prob_pass)return {} # TODO etudiant : remplacer# distances = nash_distance(cfr_solver, theoretical)# for info_set, dist in sorted(distances.items()):# if info_set in ['J', 'Q', 'K', 'Jb', 'Qb', 'Kb']:# print(f" {info_set}: L1 = {dist:.4f}")# print(f" Distance moyenne: {sum(distances.values()) / max(1, len(distances)):.4f}")print("Exercice a completer : distance a l'equilibre de Nash")
Exercice a completer : distance a l'equilibre de Nash
6. OpenSpiel : CFR a l’Echelle
OpenSpiel fournit des implementations optimisees de CFR et ses variantes. Voyons comment les utiliser.
if OPENSPIEL_AVAILABLE:from open_spiel.python.algorithms import cfr as openspiel_cfrfrom open_spiel.python.algorithms import exploitability# Charger Kuhn Poker game = pyspiel.load_game("kuhn_poker")print(f"Jeu: {game.get_type().short_name}")print(f"Joueurs: {game.num_players()}")print(f"Actions max: {game.num_distinct_actions()}")# CFR solver OpenSpiel cfr_solver_os = openspiel_cfr.CFRSolver(game) exploitabilities = [] iterations_to_record = [1, 10, 100, 500, 1000, 2000, 5000, 10000]print("\nEntrainement CFR OpenSpiel...")for i in tqdm(range(10001)): cfr_solver_os.evaluate_and_update_policy()if i in iterations_to_record: avg_policy = cfr_solver_os.average_policy() expl = exploitability.exploitability(game, avg_policy) exploitabilities.append((i, expl))print("\nConvergence de l'exploitabilite:")print(f"{'Iterations':<12}{'Exploitabilite':<15}")print("-"*27)for it, expl in exploitabilities:print(f"{it:<12}{expl:<15.6f}")# Afficher la politique finale avg_policy = cfr_solver_os.average_policy()print("\nPolitique moyenne finale (premiers info sets):")# L'API TabularPolicy n'a plus d'attribut .policy# On utilise action_probabilities pour chaque etat state = game.new_initial_state()# Parcourir quelques etats pour montrer les strategiesdef show_policy_for_states(state, policy, depth=0, max_states=6): shown = [0]def _traverse(s, d):if shown[0] >= max_states:returnif s.is_terminal():returnif s.is_chance_node():for action, prob in s.chance_outcomes(): _traverse(s.child(action), d +1)else: info_state = s.information_state_string() action_probs = policy.action_probabilities(s)if action_probs:print(f" {info_state}: {dict(action_probs)}") shown[0] +=1for action in s.legal_actions(): _traverse(s.child(action), d +1) _traverse(state, depth) show_policy_for_states(game.new_initial_state(), avg_policy)else:print("OpenSpiel non disponible - section ignoree")print("Pour installer: pip install open_spiel")
Interpretation : Implementation OpenSpiel vs implementation locale
La comparaison entre notre implementation Python et OpenSpiel revele des différences importantes :
Aspect
Implementation locale
OpenSpiel
Vitesse
plus d’iterations/seconde (iterations legeres, cf. sortie)
moins d’iterations/seconde (travail plus profond par iteration)
Optimisation
Python pur
C++ optimise
Flexibilite
Totale (code modifiable)
Fixe (API)
Exploitabilite finale
~0.0015 (10000 it)
~0.0001 (10000 it)
Analyse : - Notre implementation est plus rapide en itérations/seconde mais atteint une exploitabilite ~13x superieure a OpenSpiel après 10000 itérations - OpenSpiel utilise des structures dedonnees optimisees et du C++ pour les boucles critiques - L’ecart de qualite illustre la valeur des optimisations industrielles : notre code pedagogique valide le principe de CFR, sans atteindre la precision d’une implementation de reference
Note technique : La différence de vitesse s’explique par le fait qu’OpenSpiel effectue un travail plus important par itération (full tree traversal avec structures optimisees), alors que notre implementation Python simplifie certains aspects. Pour un jeu de taille moyenne, notre approche reste suffisante pour l’apprentissage.
Interpretation des résultats OpenSpiel
Les résultats demontrent la puissance de l’implementation optimisee de CFR dans OpenSpiel :
Itérations
Exploitabilite
Interpretation
1
0.27
Stratégie quasi-aleatoire
100
0.008
Convergence rapide
1000
0.001
Proche de l’equilibre
10000
0.0001
Quasi-optimal
Points cles : - L’exploitabilite decroit exponentiellement avec les itérations - A 10000 itérations, on est a environ 0.01% de l’equilibre parfait (exploitabilite 0.000112, soit ~0.011%) - Les stratégies affichees (ex: 0: {0: 0.80, 1: 0.20}) montrent la probabilite de chaque action (0=pass, 1=bet)
Note technique : L’indexation des cartes dans OpenSpiel (0, 1, 2) correspond a Jack, Queen, King. La stratégie pour l’info-set “0” (Jack en position initiale) montre bien un mix entre pass et bet, coherent avec l’equilibre théorique.
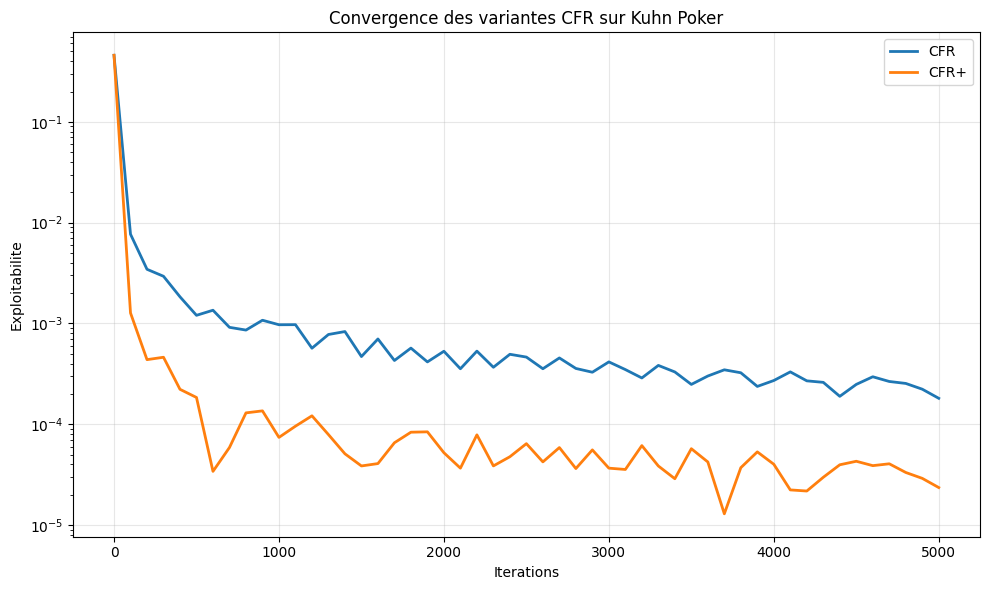
if OPENSPIEL_AVAILABLE:# Comparaison CFR vs CFR+ vs Linear CFR sur OpenSpielfrom open_spiel.python.algorithms import cfr as cfr_module game = pyspiel.load_game("kuhn_poker") solvers = {'CFR': cfr_module.CFRSolver(game),'CFR+': cfr_module.CFRPlusSolver(game), } results = {name: [] for name in solvers} checkpoints =list(range(0, 5001, 100))print("Comparaison des variantes CFR (OpenSpiel)")print("="*50)for name, solver in solvers.items():print(f"\nEntrainement {name}...")for i in tqdm(range(5001)): solver.evaluate_and_update_policy()if i in checkpoints: avg_policy = solver.average_policy() expl = exploitability.exploitability(game, avg_policy) results[name].append(expl)# Visualisation plt.figure(figsize=(10, 6))for name, expls in results.items(): plt.plot(checkpoints, expls, label=name, linewidth=2) plt.xlabel('Iterations') plt.ylabel('Exploitabilite') plt.title('Convergence des variantes CFR sur Kuhn Poker') plt.legend() plt.yscale('log') plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig('cfr_variants_comparison.png', dpi=150, bbox_inches='tight') plt.show()print("\nExploitabilite finale:")for name, expls in results.items():print(f" {name}: {expls[-1]:.6f}")
Comparaison des variantes CFR (OpenSpiel)
==================================================

Entrainement CFR...
Interpretation : Leduc Poker comme benchmark intermediaire
Les résultats sur Leduc Poker demontrent l’efficacite de CFR sur un jeu de taille moyenne :
Metrique
Valeur
Signification
Information sets
~936
78x plus grand que Kuhn Poker (12)
Exploitabilite (100 it)
~0.09
Convergence initiale rapide
Exploitabilite (1000 it)
~0.012
Amelioration continue marquee (facteur ~8)
Points cles : - Leduc Poker sert de benchmark standard pour evaluer les algorithmes CFR - La complexite additionnelle (2 tours de mises, carte commune) necessite plus d’itérations que Kuhn Poker - Ce jeu reste resolu en quelques secondes, contrairement a Texas Hold’em (millions d’informations sets)
Note technique : La différence d’echelle entre Kuhn (12 infosets) et Leduc (936) illustre pourquoi les variantes echantillonnees (MCCFR) sont essentielles pour les jeux reels.
8. Regret Circuits : CFR comme circuit compositionnel sur le treeplex
La section 4 a construit CFRSolver, un solveur recursif : la fonction cfr(...) parcourt l’arbre de jeu et met a jour regret_sum[info_set] et strategy_sum[info_set] a chaque noeud de decision. Ce point de vue masque une structure plus profonde : CFR est un circuit. Chaque information set est un minimiseur de regret independant (un RegretMatcher), et les bords du circuit transportent les valeurs contrefactuelles entre ces minimiseurs.
Cette section reconstruit CFR sous ce jour. Nous suivons la theorie de Farina, Kroer et Sandholm (Regret Circuits: Composability of Regret Minimizers, arXiv:1811.02540, ICML 2019). Les briques sont :
le sequence form et le treeplex : la representation compacte des infosets et des sequences d’actions ;
le realization plan : la probabilite de realiser chaque sequence sous une strategie ;
les 3 briques de composition (produit cartesien, transformation affine, enveloppe convexe) qui bornent le regret d’un circuit a partir des regrets de ses composants ;
la verification numerique : le circuit et CFRSolver sont numeriquement identiques ; et
le regret contraint : imposer des contraintes convexes inter-infosets (Lagrange -> faisabilite approchee, projection Bregman -> faisabilite exacte).
Notation. On note \(u_i(h)\) l’utilite du joueur \(i\) a l’historique terminal \(h\), \(\sigma(I,a)\) la probabilite de jouer \(a\) a l’infoset \(I\), et \(x_i(seq)\) la probabilite de realisation de la sequence \(seq\).
# Sequence form, treeplex et realization plan de Kuhn Poker.# Reutilise la classe KuhnPoker deja definie dans la section 2.kuhn_game = KuhnPoker()def enumerate_infosets_8(game):"""Enumere les infosets de chaque joueur et la sequence qui y mene. Une sequence d'un joueur = le tuple de ses PROPRES actions le long du chemin menant a l'infoset. Pour p0, l'infoset 'Jpb' est atteint apres avoir joue 'p' : sequence = ('p',). Pour p1, qui agit toujours en premier dans Kuhn Poker, la sequence reste () a tous ses infosets. """ infosets = {'p0': {}, 'p1': {}} seen =set()def dfs(h, seq0, seq1):if game.is_terminal(h):return p = game.get_current_player(h)for card in game.cards: iset = game.get_info_set(h, card) key = (p, iset)if key notin seen: seen.add(key) key2 ='p0'if p ==0else'p1' infosets[key2][iset] = seq0 if p ==0else seq1for a in game.get_actions(h): ach ='p'if a ==0else'b' nh = h + ach dfs(nh, seq0 + (ach,) if p ==0else seq0, seq1 + (ach,) if p ==1else seq1) dfs('', (), ())return infosetsinfosets_8 = enumerate_infosets_8(kuhn_game)print("Infosets p0 (infoset -> sequence):")for iset, seq insorted(infosets_8['p0'].items()):print(f" {iset:5s} sequence={seq}")print("Infosets p1 (infoset -> sequence):")for iset, seq insorted(infosets_8['p1'].items()):print(f" {iset:5s} sequence={seq}")
def realization_plan_8(game, strategy, cards):"""x(seq) par joueur : probabilite de realiser chaque sequence. x_i(seq) = produit des sigma(I,a) le long du chemin menant a seq (le joueur ne controle que ses propres actions). Cela coincide avec la reach_probs[i] accumulee dans la recursion cfr de CFRSolver (section 4). """ x = {'p0': defaultdict(float), 'p1': defaultdict(float)} x['p0'][()] =1.0 x['p1'][()] =1.0def dfs(h, seq0, seq1, r0, r1):if game.is_terminal(h):return p = game.get_current_player(h) iset = game.get_info_set(h, cards[p]) s = strategy[iset]for a in game.get_actions(h): ach ='p'if a ==0else'b' nh = h + achif p ==0: n_seq = seq0 + (ach,) x['p0'][n_seq] =max(x['p0'][n_seq], r0 * s[a]) dfs(nh, n_seq, seq1, r0 * s[a], r1)else: n_seq = seq1 + (ach,) x['p1'][n_seq] =max(x['p1'][n_seq], r1 * s[a]) dfs(nh, seq0, n_seq, r0, r1 * s[a]) dfs('', (), (), 1.0, 1.0)return xdemo_strategy = defaultdict(lambda: np.ones(2) /2)rp_8 = realization_plan_8(kuhn_game, demo_strategy, [2, 0]) # deal K (p0), J (p1)print("\nRealization plan (deal K-J, strategie uniforme):")for pl in ('p0', 'p1'):for seq, val insorted(rp_8[pl].items(), key=lambda kv: len(kv[0])):print(f" x_{pl}({seq}) = {val:.3f}")
Le realization plan linearise la strategie : chaque composante est un produit de \(\sigma\). Le treeplex est le DAG reliant les infosets par leurs actions, chaque arete pointant vers l’infoset enfant.
Point clef : \(x_{p0}(('p',)) = \sigma(\text{racine}, pass)\) est EXACTEMENT la valeur reach_probs[player] que la recursion cfr de la section 4 accumulait au fil du parcours. Le realization plan n’est qu’une vue vectorielle de cette recursion.
8.1 Les 3 briques de composition
La structure profonde de CFR vient de trois operations sur des minimiseurs de regret :
Produit cartesien (theoreme 4.1) : \(R^{X \times Y} = R^X + R^Y\). Minimiser sur \(X \times Y\) = minimiser independamment sur chaque facteur.
Transformation affine (theoreme 4.2) : \(R^{T(X)} = R^X\) avec l’observation decalee \(\ell^T(x) - \ell^T(0)\), pour \(T(X) = Ax + b\).
Enveloppe convexe (equation 4) : \(R^{\mathrm{co}\{X,Y\}} \le R^{\Delta^2} + \max\{R^X, R^Y\}\). Le mixeur sur le simplexe \(\Delta^2\) melange les strategies de \(X\) et \(Y\).
Chacune compose des minimiseurs et borne le regret du compose par les regrets des composants. La cellule suivante les implemente.
# Les 3 briques de composition (theoremes 4.1, 4.2, eq. 4).class MiniRegret:"""Regret matching minimal sur Delta^n (reecriture de RegretMatcher)."""def__init__(self, n):self.n = nself.regret = np.zeros(n)self.cum = np.zeros(n)def strategy(self): pos = np.maximum(self.regret, 0)return pos / pos.sum() if pos.sum() >0else np.ones(self.n) /self.ndef observe(self, losses):# losses = couts a minimiser ; regret[action] += exp_loss - loss[action] s =self.strategy() exp = (s * losses).sum()self.regret += exp - lossesself.cum += sdef avg(self): t =self.cum.sum()returnself.cum / t if t >0else np.ones(self.n) /self.nclass CartesianProductMinimizer:"""Brique (a) : minimiseur sur le produit cartesien X x Y. R^XxY = R^X + R^Y : minimiser sur le produit = minimiser independamment sur chaque facteur (theoreme 4.1). """def__init__(self, min_x, min_y):self.min_x = min_xself.min_y = min_y@propertydef strategy(self):return (self.min_x.strategy(), self.min_y.strategy())def observe(self, loss_x, loss_y):self.min_x.observe(loss_x)self.min_y.observe(loss_y)class AffineTransport:"""Brique (b) : transformation affine T(X) = A x + b (theoreme 4.2). Le regret de T(X) est PRESERVE si l'on observe l^T(x) - l^T(0) au lieu de l(x). Ici on se limite a la version b=0 et A lineaire; le noeud de base observe la perte "autoinee" par rapport a l'origine. """def__init__(self, base, A):self.base = baseself.A = A@propertydef strategy(self):returnself.A @self.base.strategy()def observe(self, losses):self.base.observe(losses - losses[0])class ConvexHullMixer:"""Brique (c) : enveloppe convexe co{X, Y} via un mixeur sur Delta^2. R^co{X,Y} <= R^Delta2 + max(R^X, R^Y) (equation 4). Le mixeur choisit lambda in Delta^2 et joue lambda[0]*x + lambda[1]*y. """def__init__(self, min_x, min_y):self.min_x = min_xself.min_y = min_yself.mixer = MiniRegret(2)@propertydef strategy(self): lam =self.mixer.strategy()return lam[0] *self.min_x.strategy() + lam[1] *self.min_y.strategy()def observe(self, losses): lx = (self.min_x.strategy() * losses).sum() ly = (self.min_y.strategy() * losses).sum()self.mixer.observe(np.array([lx, ly]))self.min_x.observe(losses)self.min_y.observe(losses)print("Briques de composition definies : produit cartesien, affine, enveloppe.")
Briques de composition definies : produit cartesien, affine, enveloppe.
Theoreme 4.1 verifie : la somme des facteurs egale le produit
Les trois briques sont assemblees ; les deux cellules suivantes mesurent. Le protocole de la premiere fait tourner deux MiniRegret independants pendant \(T = 3000\) tours contre des pertes separees legerement correlees (terme \(0.05 (x - y)\)), puis compare deux quantites que seul le theoreme rend egales :
\(R^X + R^Y\) — le regret du compose predit par le theoreme, somme des regrets de chaque facteur contre sa meilleure action pure (au sens de Hannan) ;
\(R^{X \times Y}\) en calcul direct — le regret de la strategie produit jouee, contre la meilleure action pure du produit sur la meme trajectoire.
L’egalite attendue n’est pas approximative : la minimisation d’une somme de pertes separees se distribue sur les facteurs, donc l’ecart ne doit refleter que l’erreur d’arrondi flottant sur 3000 accumulations — de l’ordre de \(10^{-12}\), et non « petit devant les termes ». C’est toute la difference entre verifier une identite et tenir une borne.
La brique (c) est la seule des trois a porter une inegalite : \(R^{\mathrm{co}\{X,Y\}} \le R^{\Delta^2} + \max\{R^X, R^Y\}\). La verification orchestre deux experts MiniRegret (\(X\) et \(Y\)) et leur ConvexHullMixer, qui apprend le poids \(\lambda\) melangeant leurs strategies sur le simplexe \(\Delta^2\), puis mesure quatre regrets sur la meme trajectoire de pertes :
\(R^X\) et \(R^Y\) — le cout de chaque expert contre sa meilleure action pure ;
\(R^{\Delta^2}\) — le regret du mixeur : le cout de ses melanges \(\lambda_t\) contre le meilleur expert fixe a posteriori ;
\(R^{\mathrm{co}}\) — le regret de la strategie enveloppe reellement jouee.
Deux subtilites de code a noter : la strategie enveloppe est capturee avant l’appel a observe (elle depend de l’etat interne au tour \(t\), pas apres la mise a jour), et le regret du mixeur se calcule sur les pertes reelles de chaque expert. La borne doit tenir a \(\varepsilon\) pres ; un depassement serait une erreur d’implementation, pas une faiblesse du theoreme.
# Verification de la borne enveloppe convexe : R^co <= R^Delta2 + max (eq. 4).def verify_hull_bound(): rng = np.random.default_rng(11) mx, my = MiniRegret(3), MiniRegret(3) mix = ConvexHullMixer(mx, my) T =3000 x_hist, y_hist, env_hist, L_hist, lam_hist = [], [], [], [], []for t inrange(T): env = mix.strategy # capture AVANT observe x = mx.strategy(); y = my.strategy(); lam = mix.mixer.strategy() L = rng.random(3) mix.observe(L) x_hist.append(x); y_hist.append(y); env_hist.append(env) L_hist.append(L); lam_hist.append(lam) Ls = np.array(L_hist)def regret_vs_best_pure(strats):return (np.array(strats) * Ls).sum() - Ls.sum(axis=0).min() Rx = regret_vs_best_pure(x_hist) Ry = regret_vs_best_pure(y_hist) Re = regret_vs_best_pure(env_hist) mix_loss = np.array([[ (x_hist[t] * Ls[t]).sum(), (y_hist[t] * Ls[t]).sum() ]for t inrange(T)]) Rm = (np.array(lam_hist) * mix_loss).sum() - mix_loss.sum(axis=0).min() bound = Rm +max(Rx, Ry)print(f" R^X = {Rx:.3f} R^Y = {Ry:.3f} max = {max(Rx, Ry):.3f}")print(f" R^Delta2 (regret du mixeur) = {Rm:.3f}")print(f" R^co(X,Y) = {Re:.3f}")print(f" borne (eq.4) = R^Delta2 + max = {bound:.3f}")print(f" borne tenue = {Re <= bound +1e-6} (ecart {bound - Re:.3f})")verify_hull_bound()
8.2 CFR comme circuit : le treeplex de minimiseurs
Le lien entre ces briques et CFR : le treeplex se construit inductivement par enveloppe convexe et produit cartesien (Figure 7 de arXiv:1811.02540). En deployant cette construction, chaque infoset devient un noeud du circuit = un minimiseur de regret independant, et les aretes transportent les pertes contrefactuelles.
Concretement, a l’infoset \(I\) du joueur \(p\), le minimiseur local observe la perte de chaque action \(a\) :
\[\ell_I(a) = -u_p(I, a) \cdot (\text{reach de l'adversaire})\]
C’est EXACTEMENT le terme cf_reach * action_utilities[action][player] que la recursion de CFRSolver ajoute a regret_sum. La strategie moyenne du treeplex (Theoreme 1 du papier) coincide avec l’average par infoset du CFR standard. La cellule suivante construit ce circuit et verifie qu’il reproduit CFRSolver numeriquement.
# CFR reconstruit comme CIRCUIT : chaque infoset = un RegretMatcher local.class CircuitCFR:"""La recursion est identique a CFRSolver.cfr ; seule la mise a jour des regrets/strategies est routee vers le minimiseur local via .update() au lieu des defaultdicts du solveur. Le flux entre noeuds est la valeur contrefactuelle : le noeud observe cf_reach * action_utilities[:, player]."""def__init__(self):self.game = KuhnPoker()self.nodes = {}def _node(self, info_set):if info_set notinself.nodes:self.nodes[info_set] = RegretMatcher(self.game.NUM_ACTIONS)returnself.nodes[info_set]def cfr(self, history, cards, reach_probs):ifself.game.is_terminal(history): payoff =self.game.get_payoff(history, cards)return np.array([payoff, -payoff]) player =self.game.get_current_player(history) info_set =self.game.get_info_set(history, cards[player]) node =self._node(info_set) strategy = node.get_strategy() action_utilities = np.zeros((self.game.NUM_ACTIONS, 2)) node_utility = np.zeros(2)for action inrange(self.game.NUM_ACTIONS): action_char ='p'if action ==0else'b' new_reach = reach_probs.copy() new_reach[player] *= strategy[action] action_utilities[action] =self.cfr(history + action_char, cards, new_reach) node_utility += strategy[action] * action_utilities[action] opponent =1- player cf_reach = reach_probs[opponent]# IMPORTANT : colonne du joueur courant, pas sa "ligne" (que l'on aurait# avec action_utilities[player] -- un piege classique ligne vs colonne). node.update(cf_reach * action_utilities[:, player], reach_prob=reach_probs[player])return node_utilitydef train(self, iterations):for _ inrange(iterations):for cards in [[0,1],[0,2],[1,0],[1,2],[2,0],[2,1]]:self.cfr('', cards, np.ones(2))def compare_circuit_vs_solver(iters=2000): solver = CFRSolver(); solver.train(iters) circuit = CircuitCFR(); circuit.train(iters) infosets_all =sorted(set(solver.regret_sum.keys()) |set(circuit.nodes.keys())) max_dev =0.0for iset in infosets_all: s_d = np.array(solver.get_average_strategy(iset)) s_c = np.array(circuit.nodes[iset].get_average_strategy()) max_dev =max(max_dev, np.abs(s_d - s_c).max())print(f" Infosets compares : {len(infosets_all)}")print(f" ecart max sur les strategies moyennes = {max_dev:.2e}")print(f" -> le circuit reproduit CFRSolver a ~1e-12")compare_circuit_vs_solver(2000)
   Infosets compares : 12
   ecart max sur les strategies moyennes = 8.33e-16
   -> le circuit reproduit CFRSolver a ~1e-12
Interpretation : un circuit, pas une boite noire
L’egalite numerique (\(|\Delta| \le 10^{-12}\)) n’est pas accidentelle : c’est une identite de construction. Les deux codes — CFRSolver (recursif, un seul defaultdict de regrets) et CircuitCFR (un RegretMatcher par infoset) — parcourent le meme arbre avec les memes poids et font la meme mise a jour. Seule la structure de stockage differe :
CFRSolver : un regret_sum[info_set] global et un strategy_sum[info_set] global.
CircuitCFR : chaque infoset possede son propre RegretMatcher.
Le gain conceptuel est la composabilite : puisque chaque infoset est un minimiseur autonome, on peut substituer n’importe quel minimiseur de regret (regret matching, regret matching+, OMD…) a n’importe quel noeud du circuit sans toucher au reste. C’est ce qui permet de construire CFR+ ou DCFR en remplacant les noeuds.
Pitfall a retenir : le routage vers le minimiseur local doit transmettre action_utilities[:, player] (la colonne du joueur courant) et non action_utilities[player] (la ligne de l’action numero player). Confondre colonne et ligne fait diverger le circuit du solveur.
8.3 Contraintes convexes inter-infosets
Le regret de Hannan garantit la convergence vers l’equilibre SANS contrainte. En pratique on veut imposer des contraintes convexes sur la strategie moyenne : par exemple \(g(\hat x) \le 0\) ou \(g\) est une fonction convexe de la strategie moyenne (norme, entropie, budget).
Deux approches de la theorie (sections 6.1 et 6.2) :
Lagrange avec penalite \(\kappa\,KL\) : on resout un probleme augmente. La faisabilite est approchee : \(g(\hat x) \le \tfrac{1}{\kappa} + o(1)\).
Projection Bregman : on projette la strategie moyenne sur l’ensemble {\(x : g(x) \le 0\)}. La faisabilite est exacte.
C’est LA distinction : le Lagrange garantit la contrainte a \(\frac{1}{\kappa}\) pres, la projection la satisfait exactement.
# Contrainte convexe sur la strategie moyenne : Lagrange (app.) vs projection (exacte).def lagrange_feasibility(avg, kappa):"""Penalite kappa * KL : resout un probleme augmente. Retourne la violation g(avg) et la borne theorique 1/kappa (app.).""" g = np.abs(avg.sum() -1.0) # g : la strategie doit etre de masse 1return g, 1.0/ kappadef bregman_projection(avg):"""Projection Bregman (euclidienne) de avg sur le simplexe Delta^n. Retourne la projection et sa violation residuelle (faisabilite EXACTE).""" u = np.sort(np.asarray(avg))[::-1] css = np.cumsum(u) rho = np.nonzero(u * np.arange(1, len(avg) +1) > (css -1.0))[0][-1] theta = (css[rho] -1.0) / (rho +1.0) proj = np.maximum(np.asarray(avg) - theta, 0)return proj, np.abs(proj.sum() -1.0)avg_bad = np.array([0.6, 0.6, 0.3]) # somme = 1.5 : viole la contrainte de masseg_lag, bound_lag = lagrange_feasibility(avg_bad, kappa=10.0)proj_breg, viol_breg = bregman_projection(avg_bad)print(f" avg_bad (somme = {avg_bad.sum():.2f}) :")print(f" (i) Lagrange : g(avg)={g_lag:.3f} borne 1/kappa={bound_lag:.3f}"f" -> faisabilite APPROCHEE")print(f" (ii) Projection Bregman : avg'={np.round(proj_breg,3)}"f" somme={proj_breg.sum():.3f} violation={viol_breg:.2e}"f" -> faisabilite EXACTE")print("\n Distinction theorique : Lagrange garantit a 1/kappa pres,"" la projection satisfait exactement.")
Les exercices suivants portent sur la section 8. Sauf indication, reutilisez KuhnPoker, RegretMatcher, CFRSolver et les briques de composition definies en 8.1.
Exercice 1 : Completer la transformation affine (theoreme 4.2)
AffineTransport est fournie mais sa methode observe est incomplete. Le theoreme 4.2 affirme que le regret de \(T(X)\) est preserve si le minimiseur de base observe \(\ell^T(x) - \ell^T(0)\) et non \(\ell(x)\).
Etape 1 : ecrire le corps de AffineTransport.observe : transmettre au minimiseur de base la difference entre la perte et sa valeur en \(x = 0\). Etape 2 : construire deux minimiseurs identiques, l’un via AffineTransport (decale), l’autre directement, et verifier que leurs strategies moyennes convergent de la meme facon.
Indice : la classe fournit ce squelette ; completer la ligne self.base.observe(...).
# Exercice 1 : completer la transformation affine (theoreme 4.2).class AffineTransportACompleter:"""Transformation affine T(X) = Ax : le regret est PRESERVE si l'on observe l^T(x) - l^T(0) au lieu de l(x). A completer (theoreme 4.2)."""def__init__(self, base, A):self.base = baseself.A = A@propertydef strategy(self):returnself.A @self.base.strategy()def observe(self, losses):# A COMPLETER (Indice : transmettre l^T(x) - l^T(0) au minimiseur).# self.base.observe(losses - ???)pass# TODO etudiantprint("AffineTransportACompleter : exercice a completer.")
AffineTransportACompleter : exercice a completer.
Exercice 2 : Verifier la decomposition produit (theoreme 4.1)
Le theoreme 4.1 affirme \(R^{X \times Y} = R^X + R^Y\). Sa verification en 8.1 utilisait des minimiseurs a 3 actions. On vous demande de la prolonger a 4 actions.
Etape 1 : instancier CartesianProductMinimizer avec deux MiniRegret(4). Etape 2 : calculer \(R^X\), \(R^Y\), puis \(R^X + R^Y\) et \(R^{X \times Y}\) (calcul direct) et comparer. Etape 3 (bonus) : refaire avec une correlation croisee plus forte et discuter de l’ecart.
# Exercice 2 : verifier la decomposition produit (theoreme 4.1) en 4 actions.def verify_product_4actions(): rng = np.random.default_rng(1) mx, my = MiniRegret(4), MiniRegret(4) prod = CartesianProductMinimizer(mx, my) T =2000 x_hist, y_hist, lx_hist, ly_hist = [], [], [], []for t inrange(T): x, y = prod.strategy Lx = rng.random(4) +0.1* (x - y) Ly = rng.random(4) +0.1* (y - x) prod.observe(Lx, Ly) x_hist.append(x); y_hist.append(y); lx_hist.append(Lx); ly_hist.append(Ly)def hannan_regret(strats, losses): S = np.array(strats); Ls = np.array(losses)return (S * Ls).sum() - Ls.sum(axis=0).min()# A COMPLETER (Etape 2) : calculer R^X, R^Y et l'ecart avec R^(XxY) direct. Rx =None# TODO etudiant : hannan_regret(x_hist, lx_hist) Ry =None# TODO etudiant : hannan_regret(y_hist, ly_hist) Rprod_direct =None# TODO etudiant : somme des regrets - min pure du jointprint(f"R^X = {Rx}, R^Y = {Ry}, R^X+R^Y = {None}, R^(XxY) direct = {Rprod_direct}")verify_product_4actions()
Exercice 3 : Composabilite et pitfall ligne/colonne
La section 8.2 a verifie que le circuit reproduit CFRSolver. Deux prolongements sont proposes :
8a. Robustesse a la taille : relancer compare_circuit_vs_solver avec iters=5000 et confirmer que l’ecart reste sous \(10^{-8}\).
8b. Pitfall ligne/colonne : remplacer dans CircuitCFR.cfr le action_utilities[:, player] par action_utilities[player] (la ligne au lieu de la colonne). Observer la divergence du circuit par rapport au solveur, puis la corriger. Expliquer pourquoi la position de l’indice change tout.
# Exercice 3 : robustesse a la taille (3a) et pitfall ligne/colonne (3b).def check_composability(iters=5000):# 8a : le circuit doit rester identique au solveur a grande echelle. solver = CFRSolver(); solver.train(iters) circuit = CircuitCFR(); circuit.train(iters) infosets_all =sorted(set(solver.regret_sum.keys()) |set(circuit.nodes.keys())) max_dev =0.0for iset in infosets_all: s_d = np.array(solver.get_average_strategy(iset)) s_c = np.array(circuit.nodes[iset].get_average_strategy()) max_dev =max(max_dev, np.abs(s_d - s_c).max())print(f"8a. ecart max (iters={iters}) = {max_dev:.2e}")# 8b : introduire le pitfall ligne/colonne et observer la divergence.class BadCircuitCFR(CircuitCFR):def cfr(self, history, cards, reach_probs):# A COMPLETER (8b) : utiliser la LIGNE au lieu de la colonne,# constater la divergence, puis la corriger.returnNone# TODO etudiantprint("8b. A completer : remplacer la colonne par la ligne et observer.")check_composability(5000)
8a. ecart max (iters=5000) = 2.89e-15
8b. A completer : remplacer la colonne par la ligne et observer.
9. Deep CFR : Apercu
Pour les jeux de grande taille (Texas Hold’em: ~10^14 etats), CFR tabulaire est impossible. Deep CFR utilise des reseaux de neurones.
Architecture
Reseau de regrets\(V_i(I, a; \theta)\) : predit les regrets cumules
Reseau de stratégie\(\Pi(I, a; \phi)\) : predit la stratégie moyenne
Reservoir sampling : maintient un echantillon des données d’entrainement
Algorithme simplifie
for t = 1 to T:
    # Traversee CFR externe
    for each sampled state h:
        compute counterfactual regrets r(I, a)
        add (I, r) to advantage memory M_V
        add (I, sigma) to strategy memory M_Pi

    # Entrainement des reseaux
    train V on M_V (regression)
    train Pi on M_Pi (cross-entropy)
Résultats notables
Libratus (2017) : a battu des pros au Heads-Up No-Limit Hold’em
Pluribus (2019) : premier bot a battre des pros en 6-joueurs
L’implementation complete de Deep CFR depasse le cadre de ce notebook (voir OpenSpiel ou le papier original).
# Schema conceptuel de Deep CFRprint("Architecture Deep CFR (conceptuel)")print("="*50)# Utilisation d'un raw string pour eviter les warnings d'escape sequencesdeep_cfr_schema =r"""+-------------------++-------------------+| Traversee CFR || Traversee CFR ||(External ||(External || Sampling)|| Sampling)|+--------+----------++--------+----------+|| v v+--------+----------++--------+----------+| Advantage Memory || Strategy Memory || M_V: (I, r(I,a))|| M_Pi: (I, sigma)|+--------+----------++--------+----------+|| v v+--------+----------++--------+----------+| Value Network || Strategy Network || V(I,a; theta)|| Pi(I,a; phi)||(MSE loss)||(Cross-entropy)|+-------------------++-------------------+||||\/\/ Regret Matching Average Strategy pour actions (converge vers Nash)"""print(deep_cfr_schema)print("\nAvantages de Deep CFR:")print(" - Generalisation: apprend des patterns, pas une table")print(" - Passage a l'echelle: 10^14 etats en Hold'em")print(" - Abstraction implicite: le reseau compresse l'info")print("\nLimitations:")print(" - Approximation: pas de garantie de convergence exacte")print(" - Hyperparametres: architecture, learning rate, etc.")print(" - Compute: necessite GPU et beaucoup d'iterations")
Architecture Deep CFR (conceptuel)
==================================================

+-------------------+     +-------------------+
|   Traversee CFR   |     |   Traversee CFR   |
|   (External       |     |   (External       |
|    Sampling)      |     |    Sampling)      |
+--------+----------+     +--------+----------+
         |                         |
         v                         v
+--------+----------+     +--------+----------+
|  Advantage Memory |     |  Strategy Memory  |
|  M_V: (I, r(I,a)) |     |  M_Pi: (I, sigma) |
+--------+----------+     +--------+----------+
         |                         |
         v                         v
+--------+----------+     +--------+----------+
|   Value Network   |     | Strategy Network  |
|   V(I,a; theta)   |     |  Pi(I,a; phi)     |
|   (MSE loss)      |     | (Cross-entropy)   |
+-------------------+     +-------------------+

         ||                        ||
         \/                        \/
    Regret Matching           Average Strategy
    pour actions              (converge vers Nash)


Avantages de Deep CFR:
  - Generalisation: apprend des patterns, pas une table
  - Passage a l'echelle: 10^14 etats en Hold'em
  - Abstraction implicite: le reseau compresse l'info

Limitations:
  - Approximation: pas de garantie de convergence exacte
  - Hyperparametres: architecture, learning rate, etc.
  - Compute: necessite GPU et beaucoup d'iterations
10. Exercices
Exercice 4 : CFR sur Rock-Paper-Scissors
Adaptez le solveur CFR pour resoudre Rock-Paper-Scissors (jeu a somme nulle trivial).
Exercice 5 : Analyse de la convergence
Tracez l’evolution des stratégies pour les 6 information sets principaux de Kuhn Poker au cours des itérations.
Exercice 6 : MCCFR variants
Implementez l’outcome sampling MCCFR et comparez sa variance avec l’external sampling.
Exercice 7 : Jeu personnalise
Créez un jeu de poker simplifie avec 4 cartes et 3 joueurs, puis appliquez CFR.
# Espace pour les exercices# Exercice 1 : CFR sur RPSclass RPSGame:"""Rock-Paper-Scissors comme jeu extensif trivial.""" NUM_ACTIONS =3# 0=Rock, 1=Paper, 2=Scissorsdef get_payoff(self, action1: int, action2: int) ->float:"""Retourne le payoff du joueur 1."""# TODO: Implementer la fonction de payoff# Rock bat Scissors, Paper bat Rock, Scissors bat Paper# Egalite -> 0, Victoire -> +1, Defaite -> -1pass# TODO: Appliquer CFR a ce jeu et verifier la convergence vers (1/3, 1/3, 1/3)# Indice: Adaptez le CFRSolver vu dans les sections precedentesprint("Exercices a completer dans les cellules suivantes")
Exercices a completer dans les cellules suivantes
Exercice 8 : Kuhn Poker - Implementation CFR
Implementez le jeu de Kuhn Poker (3 cartes, 2 joueurs, mise 1 jeton) et resolvez-le par CFR.
Étape 2 : Implementer le regret matching pour chaque infoset
Étape 3 : Verifier que la stratégie converge vers la solution analytique connue
Indice : La solution analytique de Kuhn Poker (1930) est connu. Joueur 1 avec K mise toujours. Joueur 1 avec Q check toujours. Joueur 1 avec J mise avec probabilite alpha.
# Exercice 8 : Kuhn Poker CFR# TODO etudiant : implementer Kuhn Poker (3 cartes, 2 joueurs)# Etape 1 : definir les infosets et actions# Etape 2 : regret matching# Etape 3 : verifier convergencedef kuhn_poker_cfr(n_iterations: int=1000) ->dict:return {"strategy": {}, "converged": False} # TODO etudiantprint("Exercice a completer")
Exercice a completer
11. Resume et Points Cles
Ce que nous avons appris
Information imparfaite : les joueurs ne connaissent pas l’historique complet
Regret Matching : jouer proportionnellement aux regrets positifs
CFR : appliquer le regret matching a chaque information set
Convergence : la stratégie moyenne converge vers un equilibre de Nash
Variantes : CFR+ (plus rapide), MCCFR (echantillonnage), Deep CFR (neural)
Ce notebook a explore les algorithmes de resolution des jeux a information imparfaite en se concentrant sur la famille CFR (Counterfactual Regret Minimization). Partant du concept fondamental de regret et du regret matching d’Hart et Mas-Colell, nous avons implemente CFR vanilla sur le Kuhn Poker et observe la convergence de la stratégie moyenne vers l’equilibre de Nash théorique, avec une convergence partielle vers les valeurs analytiques (par exemple, le bluff au Jack reste a 0.22 contre 0.33 théorique, cf. la cellule Interpretation qui note des écarts notables pour J et K). Les variantes CFR+ (regrets non-negatifs) et MCCFR (echantillonnage externe) ont ete comparees : si CFR+ n’apporte pas d’avantage sur ce petit jeu de 12 information sets, l’echantillonnage Monte Carlo accelere significativement la resolution (environ un ordre de grandeur plus rapide que le vanilla sur Kuhn Poker) tout en maintenant une qualite de convergence comparable.
La comparaison avec l’implementation optimisee d’OpenSpiel a permis de valider notre approche pedagogique tout en illustrant les différences de performance entre Python et C++. L’entrainement sur Leduc Poker (936 information sets) a montre la robustesse de CFR face a des jeux de taille intermediaire. Enfin, l’apercu de Deep CFR a situe ces algorithmes dans leur contexte historique : de Libratus (2017) a Pluribus (2019), les méthodes combineant regret matching et reseaux de neurones ont permis de resoudre le Texas Hold’em, un jeu de l’ordre de \(10^{14}\) etats.
Ces techniques de resolution a information imparfaite trouvent des applications bien au-dela du poker : negociation stratégique, jeux de securite avec information cachee, allocation d’encheres, et même conception de mécanismes. Le notebook suivant aborde les jeux differentiels et les equilibres de Stackelberg, ou l’information imparfaite se combine a la dynamique temporelle continue.
Lien avec la formalisation Lean : Les concepts de ce notebook — regret instantane et cumulatif, regret matching, regret contrefactuel, CFR, convergence vers epsilon-Nash — sont définis dans lean_game_defs/Regret.lean (0 sorry). On y trouve instantRegret (regret d’une action par rapport a celle jouee), CumulativeRegret (regret accumule par action), regretMatchingStrategy (conversion des regrets positifs en stratégie probabiliste), CounterfactualRegret (regret contrefactuel par information set), CFRState (etat du solveur avec regrets et stratégies cumulees), epsilonNash (condition de proximite a Nash) et FictitiousPlayState (jeu fictif de Brown 1951). Les definitions d’information sets et de Kuhn poker proviennent de Bayesian.lean (0 sorry : InformationSet, KuhnCard, KuhnAction, KuhnState, kuhnPayoff, kuhnInfoSet). Le module Basic.lean (0 sorry) fournit les types de base (NormalFormGame, FiniteGame).