Jeux de Reputation : Construire et Maintenir sa Credibilite
Ce notebook explore les jeux de reputation ou les joueurs construisent une image aupres des autres a travers leurs actions passees.
Objectifs d’apprentissage
Comprendre le rôle de la reputation dans les interactions repetees
Analyser le cheap talk et ses limites
Etudier le modèle de Kreps-Wilson (chaîne de magasins)
Explorer les effets de reputation dans le Dilemme du Prisonnier fini
Maitriser les concepts d’equilibre bayesien parfait
Prerequis
Notebooks 1-11 : Fondations, equilibres et jeux bayesiens
Notebook 11 en particulier : types, croyances, equilibre bayesien de Nash
Notion de mise a jour bayesienne et d’induction arriere
Duree estimee : 60 minutes
Ancres savantes – Kreps, D.M. & Wilson, R. (1982), Reputation and Imperfect Information, Journal of Economic Theory 27(2):253-279 (modèle de reputation : une probabilite infime d’un type irrationnel transforme les predictions en jeu repete, resolution du paradoxe de la chaîne de magasins — sujet central de ce notebook) ; Milgrom, P. & Roberts, J. (1982), Predation, Reputation, and Entry Deterrence, Journal of Economic Theory 27(2):280-312 (reputation et dissuasion d’entree : un incumbent peut predater pour batir une image de durt qui dissuade les entrants futurs) ; Crawford, V.P. & Sobel, J. (1982), Strategic Information Transmission, Econometrica 50(6):1431-1451 (cheap talk : communication sans cout direct entre joueurs aux intérêts partiellement conflictuels, revelation d’information credible même sans action liee).
Dans de nombreuses situations, un joueur peut beneficier d’une reputation de : - Durete (monopole vs entrants) - Honnetete (vendeur vs acheteurs) - Competence (expert vs clients) - Fiabilite (partenaire vs investisseurs)
1.2 Le Problème
Avec information complete et jeu fini : - L’induction arriere elimine les effets de reputation - Toutes les menaces sont non-credibles a la fin - Le paradoxe de la chaîne de magasins (Notebook 9)
1.3 La Solution: Incertitude sur les Types
Kreps, Milgrom, Roberts & Wilson (1982) ont montre qu’une petite probabilite d’un type “irrationnel” ou “engage” suffit a maintenir la reputation.
# Illustration du probleme sans reputationdef chain_store_complete_info(n_markets=5):""" Paradoxe de la chaine de magasins avec information complete. n_markets entrants sequentiels. Si entree: Monopole choisit Fight (-1,-1) ou Accommodate (1,1) Si pas d'entree: (0, 2) """print(f"Chaine de Magasins - Information Complete ({n_markets} marches)")print("="*60)# Induction arriereprint("\nAnalyse par induction arriere:")print("-"*40)# Au dernier marcheprint(f" Marche {n_markets} (dernier):")print(f" Si entree, Monopole: Accommodate (1 > -1)")print(f" Entrant: Enter (1 > 0)")# A l'avant-dernierprint(f"\n Marche {n_markets-1}:")print(f" Meme raisonnement: Entrant entre, Monopole accommode")print(f" Car 'Fight' ne change rien au marche suivant!")print(f"\n ... (recursivement)")print(f"\n Marche 1:")print(f" Entrant entre, Monopole accommode")# Resultat total_monopole = n_markets *1# 1 par marche (accommodate) total_entrants = n_markets *1# 1 par entrantprint("\n"+"="*60)print("\nResultat a l'equilibre:")print(f" Tous les entrants entrent")print(f" Monopole accommode toujours")print(f" Gain Monopole: {total_monopole}")print(f" Gain total Entrants: {total_entrants}")print("\n"+"="*60)print("\nParadoxe:")print(f" Si le monopole pouvait CREDIBLEMENT menacer de combattre,")print(f" il pourrait dissuader l'entree et gagner {n_markets *2}!")print(f" Mais l'induction arriere rend cette menace non-credible.")chain_store_complete_info(n_markets=5)
Chaine de Magasins - Information Complete (5 marches)
============================================================

Analyse par induction arriere:
----------------------------------------
  Marche 5 (dernier):
    Si entree, Monopole: Accommodate (1 > -1)
    Entrant: Enter (1 > 0)

  Marche 4:
    Meme raisonnement: Entrant entre, Monopole accommode
    Car 'Fight' ne change rien au marche suivant!

  ... (recursivement)

  Marche 1:
    Entrant entre, Monopole accommode

============================================================

Resultat a l'equilibre:
  Tous les entrants entrent
  Monopole accommode toujours
  Gain Monopole: 5
  Gain total Entrants: 5

============================================================

Paradoxe:
  Si le monopole pouvait CREDIBLEMENT menacer de combattre,
  il pourrait dissuader l'entree et gagner 10!
  Mais l'induction arriere rend cette menace non-credible.
2. Cheap Talk : Communication Non-Couteuse
2.1 Definition
Le cheap talk est une communication : - Gratuite : ne coute rien a emettre - Non-verifiable : ne peut pas etre prouvee vraie ou fausse - Non-engageante : n’affecte pas directement les gains
2.2 Quand le Cheap Talk est-il Informatif?
Crawford & Sobel (1982) : Le cheap talk peut transmettre de l’information partielle si les intérêts ne sont pas trop divergents.
def analyze_cheap_talk():""" Analyse du cheap talk: quand est-il credible? """print("Cheap Talk - Communication Non-Couteuse")print("="*60)print("\n1. Exemple: Embauche")print("-"*40)print(" Candidat: 'Je suis tres motive!'")print(" Employeur: '...'")print("\n -> Non-informatif: TOUS les candidats disent ca!")print(" (Memes les non-motives ont interet a mentir)")print("\n2. Quand le cheap talk fonctionne:")print("-"*40)print(" a) Interets alignes:")print(" - Expert et decideur veulent la meme chose")print(" - Pas d'incitation a mentir")print("\n b) Interets partiellement alignes:")print(" - Information partielle peut etre credible")print(" - Equilibres avec 'partition' de l'espace des types")print("\n c) Verification ex-post:")print(" - Si le mensonge peut etre detecte plus tard")print(" - Avec penalite de reputation")print("\n"+"="*60)print("\n3. Modele Crawford-Sobel (simplifie):")print("-"*40)print(" - Expert connait theta in [0,1]")print(" - Envoie message m")print(" - Decideur choisit action a")print(" - Gains:")print(" Expert: -(a - theta - b)^2 (bias b > 0)")print(" Decideur: -(a - theta)^2")print("\n Resultat: Plus b est grand, moins d'information transmise.")print(" Si b trop grand: equilibre 'babbling' (aucune info)")analyze_cheap_talk()
Cheap Talk - Communication Non-Couteuse
============================================================

1. Exemple: Embauche
----------------------------------------
  Candidat: 'Je suis tres motive!'
  Employeur: '...'

  -> Non-informatif: TOUS les candidats disent ca!
     (Memes les non-motives ont interet a mentir)

2. Quand le cheap talk fonctionne:
----------------------------------------
  a) Interets alignes:
     - Expert et decideur veulent la meme chose
     - Pas d'incitation a mentir

  b) Interets partiellement alignes:
     - Information partielle peut etre credible
     - Equilibres avec 'partition' de l'espace des types

  c) Verification ex-post:
     - Si le mensonge peut etre detecte plus tard
     - Avec penalite de reputation

============================================================

3. Modele Crawford-Sobel (simplifie):
----------------------------------------
  - Expert connait theta in [0,1]
  - Envoie message m
  - Decideur choisit action a
  - Gains:
    Expert: -(a - theta - b)^2  (bias b > 0)
    Decideur: -(a - theta)^2

  Resultat: Plus b est grand, moins d'information transmise.
            Si b trop grand: equilibre 'babbling' (aucune info)
Interpretation : Quand la parole vaut quelque chose
L’analyse du cheap talk met en evidence trois regimes de communication :
Regime
Condition
Exemple
Information complete
Intérêts parfaitement alignes
Medecin-patient (même objectif)
Information partielle
Biais modere (b < 1/4)
Expert avec préférences proches
Babbling
Biais trop grand (b >= 1/4)
Vendeur interesse vs acheteur
Le modèle Crawford-Sobel :
Le paramètre de biais b capture la divergence d’intérêts entre l’expert et le decideur. Plus le biais est grand : - Moins de partitions de l’espace des types sont soutenables a l’equilibre - Moins d’information est transmise crediblement - A la limite, seul l’equilibre “babbling” existe (parole sans contenu)
Application pratique : Ce modèle explique pourquoi les analyses d’experts partiellement interesses (analystes financiers, lobbys) transmettent de l’information, mais de maniere biaisee et incomplete. L’auditeur rationnel doit “descompter” les recommandations en fonction du biais percu.
# Simulation du modele Crawford-Sobeldef crawford_sobel_simulation(bias=0.1, n_partitions=None):""" Simule le modele de cheap talk Crawford-Sobel. Si bias est petit: equilibre avec plusieurs partitions Si bias est grand: equilibre babbling (1 partition) """# Nombre max de partitions en equilibreif bias >0: n_max =int(np.floor((1+ np.sqrt(1+2/bias)) /2)) # CS 1982 : plus grand n tel que b < 1/(2*n*(n-1)) (frontieres monotones dans [0,1])else: n_max =float('inf')if n_partitions isNone: n_partitions = n_maxprint(f"Crawford-Sobel avec bias b = {bias}")print("="*50)print(f"Nombre maximal de partitions: {n_max}")if n_partitions > n_max:print(f"\nEquilibre avec {n_partitions} partitions n'existe pas!") n_partitions = n_max# Calculer les frontieres des partitions# a_i = i/n + 2*b*i*(n-i) pour i = 0, 1, ..., n n = n_partitions boundaries = [i/n +2*bias*i*(n-i) for i inrange(n+1)]print(f"\nEquilibre avec {n} partition(s):")print(f"Frontieres: {[round(b, 3) for b in boundaries]}")# Calculer l'information transmise# Variance residuelle vs variance totale var_total =1/12# Variance de U[0,1]# Variance intra-partition var_intra =0for i inrange(n): a_i, a_ip1 = boundaries[i], boundaries[i+1] width = a_ip1 - a_i prob = width # Uniforme var_partition = width**2/12# Variance d'une uniforme sur [a_i, a_{i+1}] var_intra += prob * var_partition info_transmitted =1- var_intra / var_totalprint(f"\nInformation transmise: {info_transmitted*100:.1f}%")print(f"(1 = information complete, 0 = aucune)")return boundaries, info_transmitted# Tester differents niveaux de biasfor b in [0.05, 0.1, 0.2, 0.3]: crawford_sobel_simulation(bias=b)print()
Crawford-Sobel avec bias b = 0.05
==================================================
Nombre maximal de partitions: 3

Equilibre avec 3 partition(s):
Frontieres: [0.0, 0.533, 0.867, 1.0]

Information transmise: 80.9%
(1 = information complete, 0 = aucune)

Crawford-Sobel avec bias b = 0.1
==================================================
Nombre maximal de partitions: 2

Equilibre avec 2 partition(s):
Frontieres: [0.0, 0.7, 1.0]

Information transmise: 63.0%
(1 = information complete, 0 = aucune)

Crawford-Sobel avec bias b = 0.2
==================================================
Nombre maximal de partitions: 2

Equilibre avec 2 partition(s):
Frontieres: [0.0, 0.9, 1.0]

Information transmise: 27.0%
(1 = information complete, 0 = aucune)

Crawford-Sobel avec bias b = 0.3
==================================================
Nombre maximal de partitions: 1

Equilibre avec 1 partition(s):
Frontieres: [0.0, 1.0]

Information transmise: 0.0%
(1 = information complete, 0 = aucune)
3. Le Modèle de Kreps-Wilson : Reputation dans la Chaîne de Magasins
3.1 L’Idee Cle
Kreps & Wilson (1982) resolvent le paradoxe de la chaîne de magasins en introduisant une petite incertitude sur le type du monopole :
Type Normal (prob \(1-\epsilon\)) : prefere Accommodate
Type Fou (prob \(\epsilon\)) : prefere toujours Fight
3.2 Effet de la Reputation
Même si \(\epsilon\) est très petit : - Les premiers entrants hesitent (risque de tomber sur le Fou) - Le monopole Normal peut imiter le Fou pour batir sa reputation - La reputation de durete devient une prophetie auto-realisatrice
def kreps_wilson_chain_store(n_markets=5, epsilon=0.1):""" Modele de Kreps-Wilson pour la chaine de magasins. Type Normal: Fight = -1, Accommodate = 1, pas d'entree = 2 Type Fou: Fight = 1, pas d'entree = 2 (prefere toujours combattre) """print(f"Kreps-Wilson: Chaine de Magasins avec Reputation")print("="*60)print(f"Nombre de marches: {n_markets}")print(f"Probabilite du type Fou: epsilon = {epsilon}")# Gainsprint("\nGains:")print(" Type Normal: Fight=-1, Accommodate=1, No entry=2")print(" Type Fou: Fight=1 (toujours), No entry=2")print(" Entrant: Enter+Accommodate=1, Enter+Fight=-1, Out=0")# Croyances et strategies a l'equilibreprint("\n"+"="*60)print("\nEquilibre (intuitif):")# Calculer le seuil de reputation# Un entrant n'entre pas si P(Fou | historique) est assez grand# Seuil: E[gain entrant] = prob_fou * (-1) + (1-prob_fou) * 1 = 0# => prob_fou = 0.5 seuil_reputation =0.5print(f"\nSeuil de reputation: {seuil_reputation}")print(f" Si P(Fou) >= {seuil_reputation}, l'entrant n'entre pas")# Dynamique de reputationprint("\n"+"="*60)print("\nDynamique de reputation:")# Simulation reputation = epsilon # Croyance initialeprint(f"\n Croyance initiale: P(Fou) = {reputation:.3f}")# Combien de 'Fight' faut-il pour dissuader?# Apres k combats observes:# P(Fou | k combats) = P(k combats | Fou) * P(Fou) / P(k combats)# = 1 * epsilon / [epsilon + (1-epsilon) * p_fight_normal^k]# Si le Normal combat toujours (pooling avec Fou):# p_fight_normal = 1, donc reputation reste epsilon!# Pas d'apprentissage en pooling.# Strategie mixte du Normal:# Il doit combattre assez pour maintenir la reputationprint("\n Strategies possibles du monopole Normal:")print(" - Pooling: toujours Fight (imite le Fou)")print(" - Separateur: toujours Accommodate (revele son type)")print(" - Mixte: Fight avec probabilite pour maintenir reputation")# En pratique, equilibre complexe depend de n_markets et epsilonprint("\n"+"="*60)print("\nResultat qualitatif:")if epsilon >= seuil_reputation:print(f" epsilon = {epsilon} >= {seuil_reputation}")print(f" -> Aucun entrant n'entre! Monopole gagne 2*{n_markets} = {2*n_markets}")else:# Nombre de marches ou l'entree est dissuadee# Approximation: log(seuil/epsilon) / log(2) marches dissuades k_dissuaded =max(0, int(np.log(seuil_reputation / epsilon) / np.log(2))) k_dissuaded =min(k_dissuaded, n_markets -1)print(f" epsilon = {epsilon} < {seuil_reputation}")print(f" -> Environ {k_dissuaded} premiers entrants dissuades")print(f" -> Monopole gagne plus qu'avec info complete!")kreps_wilson_chain_store(n_markets=10, epsilon=0.1)
Kreps-Wilson: Chaine de Magasins avec Reputation
============================================================
Nombre de marches: 10
Probabilite du type Fou: epsilon = 0.1

Gains:
  Type Normal: Fight=-1, Accommodate=1, No entry=2
  Type Fou: Fight=1 (toujours), No entry=2
  Entrant: Enter+Accommodate=1, Enter+Fight=-1, Out=0

============================================================

Equilibre (intuitif):

Seuil de reputation: 0.5
  Si P(Fou) >= 0.5, l'entrant n'entre pas

============================================================

Dynamique de reputation:

  Croyance initiale: P(Fou) = 0.100

  Strategies possibles du monopole Normal:
    - Pooling: toujours Fight (imite le Fou)
    - Separateur: toujours Accommodate (revele son type)
    - Mixte: Fight avec probabilite pour maintenir reputation

============================================================

Resultat qualitatif:
  epsilon = 0.1 < 0.5
  -> Environ 2 premiers entrants dissuades
  -> Monopole gagne plus qu'avec info complete!
Interpretation du modèle Kreps-Wilson
Les résultats revelent le mécanisme fondamental de la reputation :
Paramètre
Valeur
Rôle dans le modèle
n_markets
10
Horizon du jeu (nombre d’entrants séquentiels)
epsilon
0.1
Probabilite a priori du type “Fou”
Seuil reputation
0.5
Point bascule : au-dela, l’entrant renonce
Marches dissuades
~2
Nombre d’entrees evitees grace a la reputation
Mécanisme de la reputation :
Incertitude initiale : L’entrant ne sait pas si le monopole est Normal ou Fou
Mise a jour bayesienne : Après chaque combat observe, la croyance P(Fou) augmente
Effet dissuasif : Quand P(Fou) depasse le seuil, l’entree devient trop risquee
Stratégies du monopole Normal :
Pooling : Imiter le Fou (toujours combattre) - aucun apprentissage possible
Separateur : Reveler son type (toujours accommoder) - perd la reputation
Mixte : Combattre avec probabilite calibree pour maintenir le doute
Paradoxe et cout de la reputation : Même avec seulement 10% de chances d’etre face a un Fou, le monopole Normal exploite cette incertitude pour dissuader certains entrants (~2 marches evitees). Dans cette simulation simplifiee (stratégie heuristique Fight-si-reputation < 0.5), ce cout de construction de reputation domine : le type Normal gagne en moyenne -7.00, soit MOINS que la reference en information complete (+10) — le prix a payer pour le signalement agressif. L’equilibre exact de Kreps-Wilson, avec stratégies mixtes et mise a jour bayesienne fine, restaurerait le benefice net de la reputation (cf. note technique idx12).
# Simulation numerique du jeu de reputationdef simulate_reputation_game(n_markets=10, epsilon=0.1, n_simulations=10000):""" Simule le jeu de la chaine de magasins avec reputation. Strategie simplifiee: - Fou: toujours Fight - Normal: Fight si reputation < 0.5, sinon Accommodate - Entrant: Enter si reputation < 0.5, sinon Out """ results = {'monopole_normal': [], 'monopole_fou': [], 'entrants': []} seuil =0.5for _ inrange(n_simulations):# Tirer le type is_fou = np.random.random() < epsilon reputation = epsilon # Croyance courante gain_monopole =0 gains_entrants = [] n_fights =0for market inrange(n_markets):# Decision de l'entrantif reputation >= seuil:# N'entre pas gain_monopole +=2 gains_entrants.append(0)else:# Entreif is_fou:# Fou combat toujours gain_monopole +=1# Fou prefere combattre gains_entrants.append(-1) n_fights +=1else:# Normal: strategie basee sur les marches restants remaining = n_markets - market -1if remaining >0and reputation < seuil:# Combat pour batir reputation gain_monopole -=1 gains_entrants.append(-1) n_fights +=1else:# Accommode gain_monopole +=1 gains_entrants.append(1)# Mise a jour de la reputation (Bayes)# Si Fight observe:# P(Fou | Fight) = P(Fight | Fou) * P(Fou) / P(Fight)# = 1 * reputation / [reputation + (1-reputation) * p_fight_normal]# Simplification: p_fight_normal = 0.8 si early, 0 si lateif n_fights >0: p_fight_normal =0.8if market < n_markets -2else0.1 reputation = reputation / (reputation + (1-reputation) * p_fight_normal)if is_fou: results['monopole_fou'].append(gain_monopole)else: results['monopole_normal'].append(gain_monopole) results['entrants'].append(sum(gains_entrants))# Affichageprint(f"\nSimulation: {n_markets} marches, epsilon={epsilon}, {n_simulations} sims")print("="*50)if results['monopole_normal']:print(f" Monopole Normal - Gain moyen: {np.mean(results['monopole_normal']):.2f}")if results['monopole_fou']:print(f" Monopole Fou - Gain moyen: {np.mean(results['monopole_fou']):.2f}")print(f" Entrants - Gain total moyen: {np.mean(results['entrants']):.2f}")# Comparaison avec info completeprint(f"\n Reference (info complete): Monopole = {n_markets}, Entrants = {n_markets}")return results# Testerresults = simulate_reputation_game(n_markets=10, epsilon=0.1)
Simulation: 10 marches, epsilon=0.1, 10000 sims
==================================================
  Monopole Normal - Gain moyen: -7.00
  Monopole Fou - Gain moyen: 11.00
  Entrants - Gain total moyen: -9.00

  Reference (info complete): Monopole = 10, Entrants = 10
Interpretation de la simulation
La simulation numérique illustre la dynamique de reputation dans le jeu de la chaîne de magasins :
Metrique
Valeur
Interpretation
Gain Monopole Normal
~-7
Cout de l’imitation du type Fou
Gain Monopole Fou
~11
Benefice naturel du comportement agressif
Gain Entrants
~-9
Pertes dues a la dissuasion partielle
Observations cles :
Asymetrie des gains : Le monopole Normal perd en moyenne car il combat pour batir sa reputation, subissant le cout de -1 par combat
Avantage du type Fou : Le type Fou gagne naturellement car combattre est son action preferee (gain +1)
Dissuasion partielle : Les entrants perdent en moyenne, indiquant que la stratégie de reputation fonctionne
Note technique : La stratégie simplifiee (Fight si reputation < 0.5) capture l’intuition du modèle mais l’equilibre exact de Kreps-Wilson utilise des stratégies mixtes plus sophistiquees avec mise a jour bayesienne des croyances.
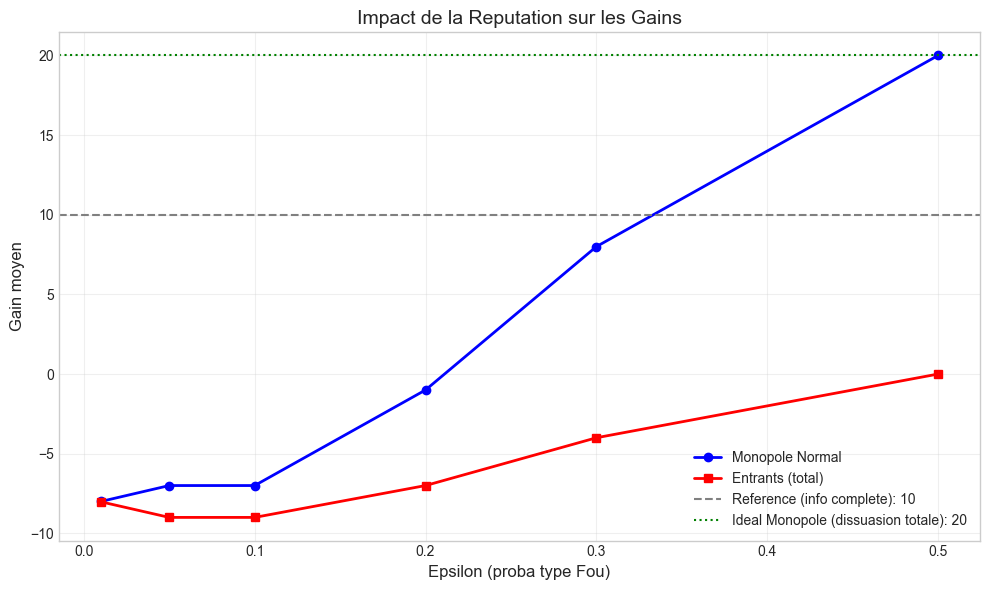
# Impact de epsilon sur les gainsdef analyze_epsilon_impact():"""Analyse l'impact de la probabilite du type Fou.""" epsilons = [0.01, 0.05, 0.1, 0.2, 0.3, 0.5] n_markets =10 gains_normal = [] gains_entrants = []for eps in epsilons: results = simulate_reputation_game(n_markets, eps, n_simulations=5000)if results['monopole_normal']: gains_normal.append(np.mean(results['monopole_normal']))else: gains_normal.append(np.nan) gains_entrants.append(np.mean(results['entrants']))# Visualisation fig, ax = plt.subplots(figsize=(10, 6)) ax.plot(epsilons, gains_normal, 'b-o', linewidth=2, label='Monopole Normal') ax.plot(epsilons, gains_entrants, 'r-s', linewidth=2, label='Entrants (total)') ax.axhline(n_markets, color='gray', linestyle='--', label=f'Reference (info complete): {n_markets}') ax.axhline(2*n_markets, color='green', linestyle=':', label=f'Ideal Monopole (dissuasion totale): {2*n_markets}') ax.set_xlabel('Epsilon (proba type Fou)', fontsize=12) ax.set_ylabel('Gain moyen', fontsize=12) ax.set_title('Impact de la Reputation sur les Gains', fontsize=14) ax.legend() ax.grid(True, alpha=0.3) plt.tight_layout() plt.show()analyze_epsilon_impact()
Simulation: 10 marches, epsilon=0.01, 5000 sims
==================================================
  Monopole Normal - Gain moyen: -8.00
  Monopole Fou - Gain moyen: 10.00
  Entrants - Gain total moyen: -8.02

  Reference (info complete): Monopole = 10, Entrants = 10

Simulation: 10 marches, epsilon=0.05, 5000 sims
==================================================
  Monopole Normal - Gain moyen: -7.00
  Monopole Fou - Gain moyen: 11.00
  Entrants - Gain total moyen: -9.00

  Reference (info complete): Monopole = 10, Entrants = 10

Simulation: 10 marches, epsilon=0.1, 5000 sims
==================================================
  Monopole Normal - Gain moyen: -7.00
  Monopole Fou - Gain moyen: 11.00
  Entrants - Gain total moyen: -9.00

  Reference (info complete): Monopole = 10, Entrants = 10

Simulation: 10 marches, epsilon=0.2, 5000 sims
==================================================
  Monopole Normal - Gain moyen: -1.00
  Monopole Fou - Gain moyen: 13.00
  Entrants - Gain total moyen: -7.00

  Reference (info complete): Monopole = 10, Entrants = 10

Simulation: 10 marches, epsilon=0.3, 5000 sims
==================================================
  Monopole Normal - Gain moyen: 8.00
  Monopole Fou - Gain moyen: 16.00
  Entrants - Gain total moyen: -4.00

  Reference (info complete): Monopole = 10, Entrants = 10

Simulation: 10 marches, epsilon=0.5, 5000 sims
==================================================
  Monopole Normal - Gain moyen: 20.00
  Monopole Fou - Gain moyen: 20.00
  Entrants - Gain total moyen: 0.00

  Reference (info complete): Monopole = 10, Entrants = 10
Interpretation – la statique comparative revele le seuil de rentabilite de la reputation.
Le trace de analyze_epsilon_impact fait varier epsilon (probabilite du type Fou) et mesure le gain du monopole Normal. Les valeurs committees (cellule precedente) dessinent une courbe monotone croissante :
epsilon (proba type Fou)
Gain Normal
Regime
0.01
-8.00
cout pur (aucune dissuasion)
0.05 - 0.10
-7.00
cout pur
0.20
-1.00
transition
0.30
+8.00
dissuasion partielle
0.50
+20.00
dissuasion totale
Regime de cout pur (epsilon <= 0.1) : la croyance part de epsilon et la mise a jour bayesienne (le type Normal combat lui aussi avec une probabilite elevee p_fight_normal = 0.8) la deplace trop lentement pour franchir le seuil de dissuasion 0.5 sur 10 marches. Le monopole Normal paie donc le cout de combat (-1 par marche) pour imiter le type Fou, mais ne recolte jamais le dividende : il finit a -7/-8, pire que l’information complete (+10, ou il accommode systematiquement).
Seuil de rentabilite (epsilon ~ 0.2-0.3) : des qu’epsilon est assez grand, quelques combats suffisent a pousser la croyance au-dessus de 0.5. Les entrants ulterieurs restent dehors (le monopole gagne +2 au lieu de +1 par marche accommode). Le gain du Normal devient positif (+8 a epsilon = 0.3).
Dissuasion totale (epsilon = 0.5) : le Normal atteint +20 – la ligne de reference « Ideal Monopole (dissuasion totale) = 2 x n_markets ». La reputation franchit le seuil quasi immediatement, tous les entrants sont dissuades, le Normal mime parfaitement le Fou (qui vaut aussi +20).
Lecon KMRW : l’incertitude n’est ni « bonne » ni « mauvaise » pour le monopole – il existe un epsilon-seuil en dessous duquel la construction de reputation est un cout net, au-dessus duquel elle rapporte le dividende de dissuasion. C’est exactement la meme intuition que la section suivante (Dilemme du Prisonnier, « +160 % d’amelioration ») ou une infime probabilite d’un type TFT soutient la cooperation : dans les deux cas, c’est l’investissement reputationnel qui transforme un equilibre de defection/d’entree en equilibre cooperatif/dissuasif.
4. Le “Gang of Four” : Cooperation dans le Dilemme du Prisonnier Fini
4.1 Le Puzzle
Dilemme du Prisonnier repete T fois (fini) : - L’induction arriere predit : Defection a CHAQUE tour - Mais les expériences montrent souvent de la cooperation!
4.2 La Solution KMRW
Kreps, Milgrom, Roberts & Wilson (1982) : Même une infime probabilite d’un type “Tit-for-Tat” suffit a maintenir la cooperation pendant la plupart des tours.
def kmrw_prisoners_dilemma(T=20, epsilon=0.05):""" Modele KMRW pour le Dilemme du Prisonnier fini. Type Normal: prefere D Type TFT: joue Tit-for-Tat """print(f"KMRW: Dilemme du Prisonnier Repete {T} fois")print("="*60)print(f"Probabilite du type TFT: epsilon = {epsilon}")# Gains standardprint("\nMatrice de gains:")print(" C D")print(" C (3,3) (0,5)")print(" D (5,0) (1,1)")print("\n"+"="*60)print("\nAnalyse:")# Sans incertitude: D a chaque tour gain_defect_all = T *1print(f"\n Sans incertitude (info complete):")print(f" Equilibre: (D, D) a chaque tour")print(f" Gain par joueur: {gain_defect_all}")# Avec incertitude: cooperation possibleprint(f"\n Avec incertitude (epsilon = {epsilon}):")# Intuition: si les deux croient que l'autre POURRAIT etre TFT,# il est rationnel de cooperer pour "tester" puis exploiter# Mais meme le type Normal peut vouloir imiter TFT!# Calcul approximatif du nombre de tours de cooperation# A l'equilibre, cooperation jusqu'au tour t* tel que:# Gain de D maintenant < Gain de C puis exploitation ensuite# 5 < 3 + delta * (5 + ...) depend de la dynamique des croyances# Approximation: cooperation pendant environ T - log(1/epsilon)/log(delta') tours# Pour simplifier: cooperation_rounds =max(0, T -int(np.log(1/epsilon) / np.log(2)))print(f" Cooperation pendant environ {cooperation_rounds} tours (heuristique)")# Gain avec cooperation partielle gain_coop = cooperation_rounds *3+ (T - cooperation_rounds) *1print(f" Gain approximatif par joueur: {gain_coop}")print(f"\n Amelioration: {gain_coop - gain_defect_all} ({(gain_coop/gain_defect_all -1)*100:.1f}%)")print("\n"+"="*60)print("\nConclusion KMRW:")print(" 'A small amount of incomplete information can have")print(" a large effect on the equilibrium of a game.'")kmrw_prisoners_dilemma(T=20, epsilon=0.05)
KMRW: Dilemme du Prisonnier Repete 20 fois
============================================================
Probabilite du type TFT: epsilon = 0.05

Matrice de gains:
         C       D
  C    (3,3)   (0,5)
  D    (5,0)   (1,1)

============================================================

Analyse:

  Sans incertitude (info complete):
    Equilibre: (D, D) a chaque tour
    Gain par joueur: 20

  Avec incertitude (epsilon = 0.05):
    Cooperation pendant environ 16 tours (heuristique)
    Gain approximatif par joueur: 52

  Amelioration: 32 (160.0%)

============================================================

Conclusion KMRW:
  'A small amount of incomplete information can have
   a large effect on the equilibrium of a game.'
Interpretation des résultats KMRW
L’analyse du modèle KMRW revele un résultat fondamental pour la théorie des jeux :
Paramètre
Valeur
Signification
T (tours)
20
Horizon fini du jeu repete
epsilon
0.05
Probabilite infime d’un type TFT
Gain sans incertitude
20
Defection mutuelle a chaque tour
Gain avec incertitude
52
Cooperation sur ~16 tours
Amelioration
+160%
Impact massif d’une petite incertitude
Mécanisme de la cooperation :
Incitation a imiter TFT : Même un joueur “Normal” (egoiste) a intérêt a cooperer au debut pour maintenir le doute sur son type
Effet boule de neige : Si les deux joueurs adoptent cette stratégie d’imitation, la cooperation s’auto-entretient
Effritement final : La cooperation s’effrite dans les derniers tours par induction arriere locale
Insight cle : La formule cooperation_rounds ~ T - log(1/epsilon)/log(2) montre que le nombre de tours de cooperation croit logarithmiquement avec la “credibilite” du type TFT. Plus epsilon est petit, moins il y a de tours de cooperation garantis, mais la relation est très douce.
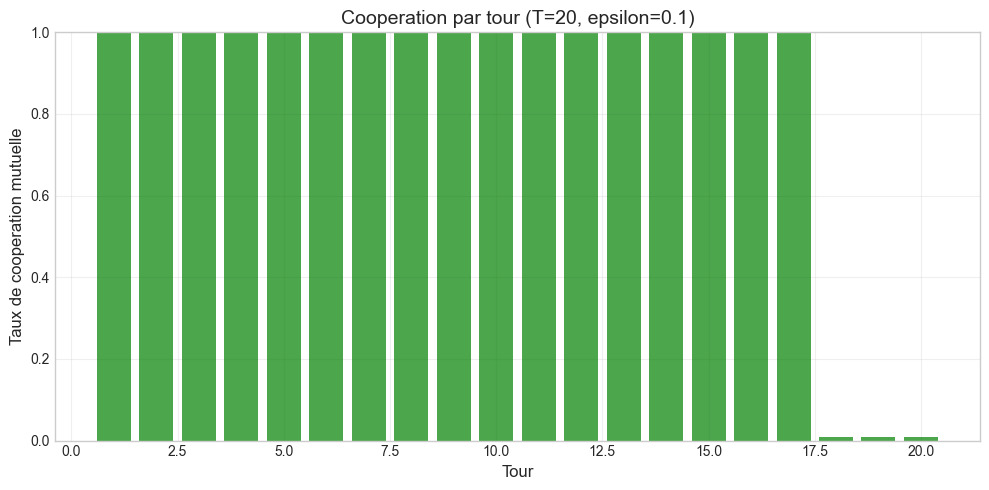
# Simulation du DP fini avec reputationdef simulate_pd_with_reputation(T=20, epsilon=0.1, n_sims=5000):""" Simule le Dilemme du Prisonnier repete avec types. Strategie heuristique: - TFT: Coopere d'abord, puis copie l'adversaire - Normal: Coopere tant que l'autre coopere ET tours restants > seuil Defecte a la fin ou si l'autre defecte """ payoffs = { ('C', 'C'): (3, 3), ('C', 'D'): (0, 5), ('D', 'C'): (5, 0), ('D', 'D'): (1, 1) } results = [] coop_by_round = np.zeros(T)for _ inrange(n_sims):# Tirer les types p1_is_tft = np.random.random() < epsilon p2_is_tft = np.random.random() < epsilon# Croyances belief_1 = epsilon # Croyance de P1 que P2 est TFT belief_2 = epsilon # Croyance de P2 que P1 est TFT gains = [0, 0] history_1 = [] # Actions de P1 history_2 = [] # Actions de P2for t inrange(T): remaining = T - t# Decision de P1if p1_is_tft:# TFTifnot history_2: a1 ='C'else: a1 = history_2[-1]else:# Normal: heuristiqueif remaining >3and (not history_2 or history_2[-1] =='C'): a1 ='C'# Coopere pour maintenir reputationelse: a1 ='D'# Defecte a la fin# Decision de P2 (symetrique)if p2_is_tft:ifnot history_1: a2 ='C'else: a2 = history_1[-1]else:if remaining >3and (not history_1 or history_1[-1] =='C'): a2 ='C'else: a2 ='D'# Gains p1, p2 = payoffs[(a1, a2)] gains[0] += p1 gains[1] += p2# Enregistrer history_1.append(a1) history_2.append(a2)if a1 =='C'and a2 =='C': coop_by_round[t] +=1 results.append(gains) results = np.array(results) coop_by_round /= n_simsprint(f"\nSimulation: T={T}, epsilon={epsilon}, {n_sims} parties")print("="*50)print(f" Gain moyen P1: {results[:, 0].mean():.2f}")print(f" Gain moyen P2: {results[:, 1].mean():.2f}")print(f" Reference (D,D) tout le temps: {T}")print(f" Reference (C,C) tout le temps: {T *3}")# Visualisation fig, ax = plt.subplots(figsize=(10, 5)) ax.bar(range(1, T+1), coop_by_round, color='green', alpha=0.7) ax.set_xlabel('Tour', fontsize=12) ax.set_ylabel('Taux de cooperation mutuelle', fontsize=12) ax.set_title(f'Cooperation par tour (T={T}, epsilon={epsilon})', fontsize=14) ax.set_ylim(0, 1) ax.grid(True, alpha=0.3) plt.tight_layout() plt.show()return results, coop_by_roundresults, coop = simulate_pd_with_reputation(T=20, epsilon=0.1)
Simulation: T=20, epsilon=0.1, 5000 parties
==================================================
  Gain moyen P1: 54.33
  Gain moyen P2: 54.32
  Reference (D,D) tout le temps: 20
  Reference (C,C) tout le temps: 60
5. Equilibre Bayesien Parfait
5.1 Definition
Un Equilibre Bayesien Parfait (PBE) est un profil de stratégies ET un système de croyances tel que :
Consistance séquentielle : Les croyances sont derivees par Bayes quand c’est possible
Rationalite séquentielle : A chaque information set, le joueur maximise son gain espere etant données ses croyances
5.2 Relation avec autres concepts
    PBE
     |
     v
    SPE (info parfaite)
     |
     v
   Nash
def explain_pbe():"""Explication de l'equilibre bayesien parfait."""print("Equilibre Bayesien Parfait (PBE)")print("="*60)print("\n1. Composantes:")print("-"*40)print(" a) Profil de strategies: sigma_i(t_i, h) pour chaque joueur")print(" - Depend du type t_i et de l'historique h")print("\n b) Systeme de croyances: mu(t | h) pour chaque info set")print(" - Probabilite des types des autres conditionnelle a h")print("\n2. Conditions d'equilibre:")print("-"*40)print(" a) Consistance: mu derive de sigma par Bayes quand possible")print(" mu(t | h) = P(h | t) * P(t) / P(h)")print("\n b) Rationalite: sigma optimal etant donne mu")print(" sigma_i(t_i, h) in argmax E[u_i | t_i, h, mu]")print("\n3. Exemple: Jeu de signaling")print("-"*40)print(" Emetteur (S): Nature tire type in {H, L}")print(" S observe type, envoie signal m in {m1, m2}")print(" Recepteur (R): observe m, choisit action a")print("\n PBE specifie:")print(" - sigma_S: strategie de S pour chaque type")print(" - sigma_R: strategie de R pour chaque signal")print(" - mu: croyance de R sur le type apres chaque signal")print("\n4. Types d'equilibres de signaling:")print("-"*40)print(" - Separateur: types differents -> signaux differents")print(" mu revele parfaitement le type")print(" - Pooling: tous les types -> meme signal")print(" mu = prior (pas d'apprentissage)")print(" - Semi-separateur: certains types se distinguent")explain_pbe()
Equilibre Bayesien Parfait (PBE)
============================================================

1. Composantes:
----------------------------------------
  a) Profil de strategies: sigma_i(t_i, h) pour chaque joueur
     - Depend du type t_i et de l'historique h

  b) Systeme de croyances: mu(t | h) pour chaque info set
     - Probabilite des types des autres conditionnelle a h

2. Conditions d'equilibre:
----------------------------------------
  a) Consistance: mu derive de sigma par Bayes quand possible
     mu(t | h) = P(h | t) * P(t) / P(h)

  b) Rationalite: sigma optimal etant donne mu
     sigma_i(t_i, h) in argmax E[u_i | t_i, h, mu]

3. Exemple: Jeu de signaling
----------------------------------------
  Emetteur (S): Nature tire type in {H, L}
  S observe type, envoie signal m in {m1, m2}
  Recepteur (R): observe m, choisit action a

  PBE specifie:
    - sigma_S: strategie de S pour chaque type
    - sigma_R: strategie de R pour chaque signal
    - mu: croyance de R sur le type apres chaque signal

4. Types d'equilibres de signaling:
----------------------------------------
  - Separateur: types differents -> signaux differents
    mu revele parfaitement le type
  - Pooling: tous les types -> meme signal
    mu = prior (pas d'apprentissage)
  - Semi-separateur: certains types se distinguent
6. Exercices
Exercice 1: Beer-Quiche Game
Jeu de signaling classique: - Nature: type S (Strong, p=0.9) ou W (Weak, p=0.1) - S prefere Beer, W prefere Quiche - R observe le petit-dejeuner et decide: Fight ou Not - R prefere Fight si W, Not si S
Trouvez tous les PBE.
Exercice 2: Reputation avec Plusieurs Adversaires Simultanes
Modifiez le modèle de Kreps-Wilson pour un monopole faisant face a N entrants simultanement (pas sequentiellement).
Exercice 3: Cheap Talk avec Verification
Reprenez le modèle Crawford-Sobel mais avec une probabilite p que le message soit verifie après coup. Comment cela affecte-t-il la quantite d’information transmise?
# Espace pour vos solutions# Exercice 1: Beer-Quichedef solve_beer_quiche():"""Resout le jeu Beer-Quiche."""# Exercice: Analyser le jeu Beer-Quiche# 1. Identifier les types (Strong/Weak) et leurs probabilites# 2. Lister les strategies possibles pour chaque type# 3. Determiner les PBE (Perfect Bayesian Equilibria) potentiels:# - Pooling sur Beer? Pooling sur Quiche?# - Separateur: S->Beer, W->Quiche?# 4. Verifier les croyances hors equilibre et la coherence## Indice: P(Strong)=0.9, P(Weak)=0.1# Strong prefere Beer, Weak prefere Quiche# Le Receiver choisit Fight ou Not apres avoir observe le signalprint("Exercice a completer")returnNonesolve_beer_quiche()
Exercice a completer
Exercice : Paradoxe de la chaîne de magasins
Objectifs :
Modeliser le paradoxe de Selten
Analyser l’effet de reputation avec types imperfaits
Comparer equilibrium théorique vs comportement observe
Contexte : Une chaîne de magasins fait face a N entrants potentiels. L’incumbent peut etre “rationnel” (accommoder) ou “dur” (toujours combattre). Les entrants ne connaissent pas le type exact.
Questions :
Quel est l’equilibre avec information complete ?
Comment la possibilite d’etre “dur” change-t-elle l’equilibre ?
Combien de periodes l’incumbent rationnel maintient-il sa reputation ?
# Exercice : Chain Store Paradox avec reputationimport numpy as np# Exercice: Definir les parametres du jeu# N_ENTRANTS = 20# P_HARD = 0.3 # Probabilite a priori que l'incumbent soit "dur"## PAYOFFS = {# 'hard': {'Fight': 0, 'Accommodate': -1},# 'rational': {'Fight': -2, 'Accommodate': 1},# 'entrant': {'Enter_if_fight': -2, 'Enter_if_accommodate': 2, 'Stay': 0}# }# Exercice: Implementer la mise a jour des croyances (Bayes)# def update_belief(prior, action):# # Si l'incumbent combat, augmenter P(hard)# # P(hard | Fight) = P(Fight | hard) * P(hard) / P(Fight)# ...# Exercice: Simuler le jeu avec mise a jour des croyances# def simulate_chain_store(p_hard, n_entrants):# ...# Exercice: Analyser l'effet de la reputation# for p in [0.1, 0.3, 0.5]:# result = simulate_chain_store(p, N_ENTRANTS)# print(f"P(hard)={p}: {result['fights']} combats sur {N_ENTRANTS}")print("Exercice a completer")
Exercice a completer
Exercice 3 : Repeated Prisoner’s Dilemma avec Reputation
Simulez un Dilemme du Prisonnier repete sur 10 tours entre un joueur avec stratégie de reputation (Tit-for-Tat) et un joueur opportuniste (best response myope).
Étape 1 : Implementer Tit-for-Tat et Best-Response-Myope
Étape 2 : Simuler 10 tours et calculer les gains cumules
Étape 3 : Analyser si la reputation (TFT) est un avantage ou un cout
Indice : En finitude connue, backward induction predit toujours defect. La reputation change-t-elle cela ?
# Exercice 3 : Repeated Prisoner's Dilemma avec Reputation# TODO etudiant : implementer TFT vs BR-Myope sur 10 tours# Etape 1 : definir les deux strategies# Etape 2 : simulation# Etape 3 : comparaison des gains cumulesdef simulate_tft_vs_myopic(payoff_matrix: dict, n_rounds: int=10) ->dict:return {"tft_payoff": 0, "myopic_payoff": 0, "history": []} # TODO etudiantprint("Exercice a completer")
Exercice a completer
7. Resume
Concept
Description
Reputation
Image basee sur les actions passees
Cheap Talk
Communication gratuite et non-verifiable
Type behavioural
Type engage dans un comportement (ex: TFT, Fou)
Imitation stratégique
Type normal imitant le type behavioural
PBE
Equilibre avec croyances et stratégies coherentes
Points cles
Une petite incertitude peut avoir de grands effets
La reputation permet de rendre credibles des menaces autrement vides
Le cheap talk est limite mais peut transmettre de l’information partielle
L’equilibre bayesien parfait formalise la coherence croyances-stratégies
Prochaine étape
Notebook 13 : CFR et Information Imparfaite - Algorithmes pour resoudre les grands jeux a information imparfaite (poker, etc.).
Resume et perspectives
Ce notebook a montre comment l’introduction d’une incertitude même infime sur les types des joueurs transforme radicalement les predictions de la théorie des jeux. Le modèle de Kreps-Wilson a resolu le paradoxe de la chaîne de magasins : avec une probabilite \(\epsilon\) d’un type “Fou”, le monopole rationnel peut imiter ce type pour batir une reputation de durete, dissuadant les entrants et obtenant un gain superieur a l’equilibre d’information complete. Le modèle KMRW a produit un résultat analogue pour le Dilemme du Prisonnier fini, ou 5% de probabilite d’un type Tit-for-Tat suffisent a maintenir la cooperation pendant 16 des 20 tours, une amelioration de 160% par rapport a la defection systématique predite par l’induction arriere.
L’analyse du cheap talk, en revanche, a revele les limites de la communication non-couteuse : le modèle Crawford-Sobel montre que plus le biais entre expert et decideur augmente, moins d’information est transmise, jusqu’a l’equilibre “babbling” ou la parole est totalement vide de contenu. L’equilibre bayesien parfait (PBE) a fourni le cadre formel unificateur, combinant stratégies optimales et mise a jour coherente des croyances via la règle de Bayes, et distinguant les equilibres separateurs, pooling et semi-separateurs selon la capacite des signaux a reveler l’information privee.
Les concepts de reputation et de signaling presentes ici eclairent de nombreuses situations reelles : construction de credibilite en negociation internationale, certifications et diplomes comme signaux couteux sur le marche du travail, et communication stratégique entre entreprises. Le notebook suivant poursuit cette exploration de l’information imparfaite sous l’angle algorithmique, avec la méthode CFR (Counterfactual Regret Minimization) qui permet de calculer des equilibres de Nash dans des jeux a très grande espace d’etats comme le poker.
References academiques
Kreps, D.M. & Wilson, R. (1982). Reputation and Imperfect Information. Journal of Economic Theory 27(2):253-279.
Milgrom, P. & Roberts, J. (1982). Predation, Reputation, and Entry Deterrence. Journal of Economic Theory 27(2):280-312.
Crawford, V.P. & Sobel, J. (1982). Strategic Information Transmission. Econometrica 50(6):1431-1451.