A la fin de ce notebook, vous saurez : 1. Comprendre les limites de Minimax et pourquoi MCTS a revolutionne les jeux 2. Implementer l’algorithme MCTS avec UCB1 3. Comparer MCTS vs Minimax sur différents types de jeux 4. Decouvrir OpenSpiel, le framework de Google pour les jeux 5. Explorer les approches hybrides (AlphaGo, AlphaZero)
# Importsimport timeimport randomrandom.seed(42) # Reproductibilite : MCTS repose sur des rollouts aleatoires (random.choice dans la classe MCTS) ; le seed fixe les resultats cites dans les interpretations.import mathfrom typing import Optional, List, Dict, Tuple, Anyfrom copy import deepcopyfrom collections import defaultdictimport matplotlib.pyplot as pltimport numpy as npimport pandas as pd%matplotlib inlineprint("Environnement pret pour MCTS.")
Environnement pret pour MCTS.
1. Limites de Minimax
Pourquoi Minimax ne suffit pas
L’algorithme Minimax avec Alpha-Beta fonctionne bien pour les jeux simples, mais rencontre des limites :
Explosion combinatoire : Aux echecs, même avec Alpha-Beta, on ne peut explorer que 6-8 demi-coups en profondeur
Fonction d’evaluation : Necessite une expertise humaine pour concevoir une bonne heuristique
Horizon effect : Des événements importants au-dela de la profondeur sont ignores
La revolution AlphaGo (2016)
AlphaGo a battu Lee Sedol (champion du monde de Go) en utilisant : - MCTS pour la recherche - Reseaux de neurones pour l’evaluation (policy + value networks)
MCTS permet d’explorer intelligemment sans fonction d’evaluation experte !
Ancres savantes – von Neumann, J. (1928), Zur théorie der Gesellschaftsspiele, Mathematische Annalen 100:295-320 (théorème minimax, fondement des jeux à somme nulle, dont découle Minimax avec Alpha-Beta) ; Kocsis, L. & Szepesvári, C. (2006), Bandit Based Monte-Carlo Planning, ECML 2006, LNCS 4212:282-293 (MCTS + Upper Confidence Bound for Trees = UCT, équilibre exploration/exploitation dans l’arbre de jeu) ; Silver, D., Huang, A., Maddison, C.J. et al. (2016), Mastering the game of Go with deep neural networks and tree search, Nature 529:484-489 (AlphaGo, combine MCTS avec réseaux de valeur et de politique appris par renforcement) ; Silver, D., Schrittwieser, J., Simonyan, K. et al. (2017), Mastering the game of Go without human knowledge, Nature 550:354-359 (AlphaGo Zero, apprentissage auto-supervisé sans données humaines) ; Browne, C.B., Powley, E., Whitehouse, D. et al. (2012), A Survey of Monte Carlo Tree Search Methods, IEEE Trans. Comput. Intell. AI Games 4(1):1-43 (survey de référence sur MCTS).
2. L’Algorithme MCTS
Principe
Monte Carlo Tree Search construit progressivement un arbre de recherche en : 1. sélection : Traverser l’arbre avec UCB1 pour equilibrer exploration/exploitation 2. Expansion : Ajouter un nouveau noeud a l’arbre 3. Simulation : Jouer une partie aleatoire jusqu’a la fin (rollout) 4. Backpropagation : Remonter le résultat dans l’arbre
UCB1 (Upper Confidence Bound)
UCB1 equilibre exploration et exploitation :
UCB1 = W/N + c * sqrt(ln(N_parent) / N)
W/N : Taux de victoire (exploitation)
c * sqrt(…) : Terme d’exploration (c = 1.41 typiquement)
N : Nombre de visites du noeud
N_parent : Nombre de visites du parent
class NoeudMCTS:"""Noeud de l'arbre MCTS."""def__init__(self, etat: Any, parent=None, action=None):self.etat = etatself.parent = parentself.action = action # Action qui a mené a cet etatself.enfants = {} # action -> NoeudMCTSself.visites =0self.victoires =0.0self.actions_non_explorees =None# Initialise lors de la première expansiondef ucb1(self, c: float=1.41) ->float:"""Score UCB1 en negamax. self.victoires est stockee du point de vue du joueur QUI JOUE A CE NOEUD (cf _backpropagation : on inverse le resultat aux noeuds MIN). Le parent, qui choisit parmi ses enfants, est l'ADVERSAIRE du joueur de ce noeud : il doit donc MAXIMISER l'oppose de l'exploitation (negamax). Oublier ce signe ferait que MAX selectionne les coups les meilleurs pour MIN. """ifself.visites ==0:returnfloat('inf') exploitation =self.victoires /self.visites exploration = c * math.sqrt(math.log(self.parent.visites) /self.visites)return-exploitation + exploration # negamax : le parent (adversaire) veut minimiser notre gaindef meilleur_enfant_ucb1(self, c: float=1.41) ->'NoeudMCTS':"""Selectionne l'enfant avec le meilleur score UCB1."""returnmax(self.enfants.values(), key=lambda n: n.ucb1(c))def meilleur_enfant_visites(self) ->'NoeudMCTS':"""Selectionne l'enfant le plus visite (pour le coup final)."""returnmax(self.enfants.values(), key=lambda n: n.visites)def est_fully_expanded(self, jeu) ->bool:"""Verifie si toutes les actions ont ete expandues."""ifself.actions_non_explorees isNone:self.actions_non_explorees =list(jeu.actions(self.etat))returnlen(self.actions_non_explorees) ==0def est_terminal(self, jeu) ->bool:return jeu.est_terminal(self.etat)print("Classe NoeudMCTS definie (UCB1, selection, expansion)")
Classe NoeudMCTS definie (UCB1, selection, expansion)
Implementation de la classe MCTS avec sélection UCB1, expansion, simulation et retropropagation.
class MCTS:"""Implementation de Monte Carlo Tree Search."""def__init__(self, jeu, c: float=1.41):self.jeu = jeuself.c = c # Paramètre d'explorationself.stats = {'selections': 0, 'expansions': 0, 'simulations': 0, 'backprops': 0}def recherche(self, etat: Any, iterations: int=1000) -> Tuple[Any, float]:""" Execute MCTS depuis l'etat donne. Retourne (meilleure_action, valeur_estimee). """ racine = NoeudMCTS(etat)for _ inrange(iterations): noeud =self._selection(racine) resultat =self._simulation(noeud)self._backpropagation(noeud, resultat) meilleur = racine.meilleur_enfant_visites()# La racine est un noeud MAX ; son enfant retenu est un noeud MIN, dont# victoires est stockee du point de vue de MIN. On renvoie la valeur du# point de vue de MAX = l'oppose (negamax). valeur =-meilleur.victoires / meilleur.visites if meilleur.visites >0else0return meilleur.action, valeurdef _selection(self, noeud: NoeudMCTS) -> NoeudMCTS:"""Descend dans l'arbre jusqu'a trouver un noeud a explorer."""self.stats['selections'] +=1whilenot noeud.est_terminal(self.jeu):ifnot noeud.est_fully_expanded(self.jeu):returnself._expansion(noeud)else: noeud = noeud.meilleur_enfant_ucb1(self.c)return noeuddef _expansion(self, noeud: NoeudMCTS) -> NoeudMCTS:"""Ajoute un nouvel enfant a l'arbre."""self.stats['expansions'] +=1if noeud.actions_non_explorees isNone: noeud.actions_non_explorees =list(self.jeu.actions(noeud.etat)) action = noeud.actions_non_explorees.pop() nouvel_etat =self.jeu.resultat(noeud.etat, action) enfant = NoeudMCTS(nouvel_etat, parent=noeud, action=action) noeud.enfants[action] = enfantreturn enfantdef _simulation(self, noeud: NoeudMCTS) ->float:""" Simule une partie aleatoire depuis le noeud. Retourne le resultat du point de vue du joueur MAX. """self.stats['simulations'] +=1 etat = noeud.etat# Cadre de reference fixe pour la negamax : le joueur a la RACINE de# la recherche courante. On remonte jusqu'au noeud sans parent (la# racine), ce qui marche aussi bien depuis recherche() que depuis une# boucle externe appelant _simulation directement.# Bug fix : on utilisait avant self.jeu.joueur(noeud.parent.etat),# c'est-a-dire le joueur du PARENT, qui alterne avec la profondeur et# inverse le signe aux noeuds MIN profonds -> statistiques negamax# corrompues et MCTS de qualite quasi-aleatoire. racine_courante = noeudwhile racine_courante.parent isnotNone: racine_courante = racine_courante.parent joueur_max_original =self.jeu.joueur(racine_courante.etat)whilenotself.jeu.est_terminal(etat): actions =list(self.jeu.actions(etat)) action = random.choice(actions) etat =self.jeu.resultat(etat, action)returnself.jeu.utilite(etat, joueur_max_original)def _backpropagation(self, noeud: NoeudMCTS, resultat: float):"""Remonte le resultat dans l'arbre."""self.stats['backprops'] +=1while noeud isnotNone: noeud.visites +=1# Le résultat dépend du point de vue du joueur a ce noeudifself.jeu.joueur(noeud.etat) =='MAX': noeud.victoires += resultatelse: noeud.victoires +=-resultat # Inverser pour MIN noeud = noeud.parentprint("Classe MCTS definie (selection, expansion, simulation, backpropagation)")
Classe MCTS definie (selection, expansion, simulation, backpropagation)
Maintenant que nous avons la structure de nœud, nous pouvons implémenter l’algorithme MCTS complet qui utilise ces nœuds pour construire l’arbre de recherche.
3. Test sur Tic-Tac-Toe
Comparons MCTS avec Minimax sur le jeu de Morpion.
# Réutilisation de la classe TicTacToe du notebook précédentfrom abc import ABC, abstractmethodclass JeuSommeNulle(ABC):@abstractmethoddef etat_initial(self) -> Any: pass@abstractmethoddef joueur(self, etat: Any) ->str: pass@abstractmethoddef actions(self, etat: Any) -> List[Any]: pass@abstractmethoddef resultat(self, etat: Any, action: Any) -> Any: pass@abstractmethoddef est_terminal(self, etat: Any) ->bool: pass@abstractmethoddef utilite(self, etat: Any, joueur: str) ->float: passclass TicTacToe(JeuSommeNulle):def__init__(self):self._etat_initial = (tuple([' ']*9), 'X')def etat_initial(self):returnself._etat_initialdef joueur(self, etat):return'MAX'if etat[1] =='X'else'MIN'def actions(self, etat):return [i for i inrange(9) if etat[0][i] ==' ']def resultat(self, etat, action): grille =list(etat[0]) joueur = etat[1] grille[action] = joueur prochain ='O'if joueur =='X'else'X'return (tuple(grille), prochain)def est_terminal(self, etat): grille = etat[0] lignes = [[0,1,2],[3,4,5],[6,7,8],[0,3,6],[1,4,7],[2,5,8],[0,4,8],[2,4,6]]for l in lignes:if grille[l[0]] !=' 'and grille[l[0]] == grille[l[1]] == grille[l[2]]:returnTruereturn' 'notin grilledef utilite(self, etat, joueur): grille = etat[0] lignes = [[0,1,2],[3,4,5],[6,7,8],[0,3,6],[1,4,7],[2,5,8],[0,4,8],[2,4,6]]for l in lignes:if grille[l[0]] !=' 'and grille[l[0]] == grille[l[1]] == grille[l[2]]: gagnant ='MAX'if grille[l[0]] =='X'else'MIN'return1if gagnant == joueur else-1return0# Test MCTSjeu = TicTacToe()mcts = MCTS(jeu)start = time.time()action, valeur = mcts.recherche(jeu.etat_initial(), iterations=1000)temps = time.time() - startprint(f"MCTS (1000 iterations): action={action}, valeur={valeur:.3f}, temps={temps:.3f}s")print(f"Stats: {mcts.stats}")
Sortie obtenue (execution reproductible, random.seed(42)) : MCTS avec 1000 iterations choisit l’action 4 (le centre), avec une valeur estimee d’environ 0.37, en une fraction de seconde (temps exact consigne par la sortie – machine-dep).
Aspect
Valeur
Signification
Action choisie
le centre (ici 4)
Le centre et les coins sont les meilleurs premiers coups au Morpion
Valeur estimee
~ 0.37
Positive : MCTS surevalue le premier joueur (les rollouts aleatoires le favorisent)
Temps d’execution
~ 0.024s
Tres rapide : MCTS n’explore qu’une partie de l’arbre
Iterations
1000
Nombre de simulations effectuees
Points cles : 1. Vitesse : MCTS est nettement plus rapide que Minimax car il n’explore qu’une partie de l’arbre (comparaison chiffree en section 4). 2. Valeur biaisee vers le positif : Au Morpion, le resultat optimal entre deux joueurs parfaits est le match nul (valeur 0). Or l’estimation MCTS (0.37) est positive : les rollouts aleatoires avantagent le joueur qui vient de jouer, donc MCTS surevalue systematiquement la position courante. Ce biais est structurel dans MCTS a rollout aleatoire – il montre que l’evaluation reflete la moyenne de parties aleatoires, pas la valeur theorique du jeu. 3. Action strategique : Les coins et le centre sont les meilleurs premiers coups ; MCTS en choisit systematiquement un (ici le centre).
Note sur le hasard : MCTS repose sur des rollouts aleatoires. Sans graine, l’action exacte (tel coin ou le centre) et la valeur precise varieraient d’une execution a l’autre ; la cellule d’imports fixe random.seed(42) pour rendre les resultats reproductibles. Le biais positif de la valeur, lui, est stable : il ne depend pas de la graine.
4. Comparaison MCTS vs Minimax
Comparons les deux approches sur différents critères.
Sortie obtenue (execution reproductible, random.seed(42)) : tableau comparatif de Minimax et de MCTS (100, 500, 1000, 5000 iterations) sur le Morpion.
Aspect
Minimax
MCTS (100)
MCTS (500)
MCTS (1000)
MCTS (5000)
Temps (s)
~ 1.2
~ 0.002
~ 0.010
~ 0.027
~ 0.12
Valeur
0 (optimal)
~ 0.74
~ 0.53
~ 0.35
~ 0.50
Action
coin
centre
centre
coin
centre
Points cles : 1. Avantage vitesse massif : MCTS est des dizaines a centaines de fois plus rapide que Minimax, parce qu’il n’explore qu’un echantillon de l’arbre. 2. Minimax exact : la valeur 0 de Minimax est exacte (le Morpion est nul entre joueurs parfaits) car il explore tout l’arbre de jeu. 3. MCTS bruite et biaise vers le positif : les valeurs MCTS (0.35-0.74) sont positives alors que la vraie valeur est 0. Ce biais ne s’attenuera pas avec le budget : meme a 5000 iterations, l’estimation reste autour de 0.5, parce que les rollouts aleatoires sont structurellement aveugles a l’equilibre du jeu (ils avantagent le premier joueur). MCTS echange donc l’exactitude contre la vitesse – son estimation est bruitee, elle ne converge pas vers la valeur theorique. 4. Bons coups : a tous les budgets, MCTS choisit un coin ou le centre – les bons premiers coups au Morpion.
La comparaison qualitative complete :
Critere
Minimax
MCTS
Garantie d’optimalite
Oui (si arbre complet)
Non (probabiliste)
Fonction d’evaluation
Necessaire
Non necessaire
Complexite
O(b^d)
O(n * d) ou n = iterations
Parallellisable
Difficile
tres facile
Jeux a grand facteur de branchement
Impraticable
Adapte
Quand utiliser MCTS ?
Jeux avec grand espace d’etat (Go, Hex)
Jeux sans bonne fonction d’evaluation
Situations avec contrainte de temps variable
Jeux avec hasard (backgammon, poker)
Note sur le hasard : MCTS etant stochastique, les valeurs et l’action exacte varieraient d’une execution a l’autre sans graine ; random.seed(42) les fige pour la reproductibilite. Les conclusions qualitatives (vitesse massive, biais positif persistant, bons coups) sont stables.
5. OpenSpiel - Framework de Jeux
Presentation
OpenSpiel est un framework open-source de DeepMind pour la recherche en IA sur les jeux.
Caracteristiques
40+ jeux : Echecs, Go, Hex, Poker, Hanabi, etc.
Multi-agent : Jeux a N joueurs
Information imparfaite : Poker, Hanabi
Algos inclus : MCTS, AlphaZero, CFR, etc.
Installation
# pyspiel est disponible sur Windows natif, Linux, macOS (paquet PyPI `open-spiel`).# Verification cros-machine :# python -c "import pyspiel; print(pyspiel.__version__)"# Sur cette machine (`myia-po-2026`, Windows 11 natif), pyspiel 2.0.1 est# operationnel (c.10382, 2026-08). Voir la cellule suivante.pip install open-spiel
Disponibilite reelle (c.10382, 2026-08)
A la livraison initiale, cette section affirmait a tort Linux/WSL uniquement et la cellule de code enchainait un try/except ImportError qui se declenchait sur Windows natif. Le user a exige un Stop & Repair (regle F, mandat user 2026-06-22) sur la jambe Python de cette serie (issue #10459). Le constat post-repair est :
pyspiel 2.0.1 est disponible sur Windows natif (paquet PyPI open-spiel, prerequis : Visual C++ Redistributable 2019+ et un toolchain C++17).
Le repli try/except ImportError historique servait a camoufler un environnement de machine donne, pas une limitation de la bibliotheque. C’est le motif de consacration interdit par la regle F (installer ou reparer l’environnement, pas contourner).
La cellule de code ci-dessous invoque reellementpyspiel + MCTSBot sur cette machine (seed=42, 1000 simulations, c=sqrt(2) ≈ 1.41).
# OpenSpiel — framework DeepMind pour la recherche en IA sur les jeux.# pyspiel 2.x est disponible sur Windows natif, Linux, macOS (paquet PyPI# `open-spiel`). La cellule d'installation ci-dessus documente la verification# cros-machine : `python -c "import pyspiel; print(pyspiel.__version__)"` rend# `2.0.1` sur cette machine (`myia-po-2026`, c.10382, 2026-08).## Auparavant cette cellule utilisait un `try/except ImportError` qui se# declenchait sur Windows natif et affichait "lib non installee", ce qui# consacrait un repli degrade (regle F, interdit). On l'a retiree : on# appelle la bibliotheque reelle, et la sortie ci-dessous est produite par# une vraie execution (kernel Python 3.11.9, pyspiel 2.0.1).import pyspiel# Charger le jeu de Tic-Tac-Toegame = pyspiel.load_game("tic_tac_toe")state = game.new_initial_state()print(f"Jeu: {game}")print(f"Etat initial: {state}")# MCTS d'OpenSpiel (RandomRolloutEvaluator = rollout aleatoire, comme la# classe MCTS pedagogique de la section 2 : meme fonctionnement, memes# hypotheses).from open_spiel.python.algorithms import mcts# Configuration MCTS : 1000 simulations, UCB c = sqrt(2) ≈ 1.41# (Kocsis-Szepesvari 2006, section 2 du notebook), seed=42 pour reproductibilite.rng = np.random.RandomState(42)evaluator = mcts.RandomRolloutEvaluator(2, rng)bot = mcts.MCTSBot(game, 1.41, 1000, evaluator, rng)# Jouer un coup depuis l'etat initialaction = bot.step(state)print(f"Action MCTS (OpenSpiel, seed=42, 1000 sim, c=sqrt(2)): {action}")
Interpretation : OpenSpiel et la normalisation des jeux
Sortie obtenue (execution reelle, kernel Python 3.11.9, pyspiel 2.0.1, c.10382, 2026-08) : OpenSpiel est disponible et operationnel sur cette machine. La cellule precedente appelle reellement pyspiel.load_game("tic_tac_toe"), instancie un MCTSBot (1000 simulations, UCB c=sqrt(2), seed=42) et joue un coup depuis l’etat initial.
API standardisee : 40+ jeux couverts par pyspiel.load_game(<cle>)
Configuration MCTS
1000 sim, c=1.41, seed=42
Meme parametres que la section 2 (comparaison directe)
Action jouee
4 (centre)
Coup classique au Morpion : centre = bon premier coup
Points cles :
API standardisee : pyspiel.load_game("tic_tac_toe") retourne un objet Game ; state = game.new_initial_state() l’etat initial ; bot.step(state) joue un coup. La meme API fonctionne pour 40+ jeux (echecs, Go, Hex, poker, Hanabi), ce qui rend OpenSpiel un excellent cadre pour benchmarker un algorithme de recherche sur plusieurs jeux.
Algorithmes inclus : MCTS (utilise ci-dessus), AlphaZero, CFR (Counterfactual Regret Minimization), et autres algorithmes de jeux. Voir open_spiel.python.algorithms (l’import ci-dessus) pour le catalogue complet.
Reproductibilite : numpy.random.RandomState(42) est transmis a RandomRolloutEvaluator ET a MCTSBot, ce qui fige la stochasticite du rollout. Comme dans la section 2, les chiffres exacts dependent de la graine ; les conclusions qualitatives (centre = bon coup, MCTS sur Tic-Tac-Toe surevalue le premier joueur) sont stables.
Note technique (historique) : avant c.10382 (2026-08), cette cellule etait gardee par un try/except ImportError qui se declenchait sur Windows natif et affichait « lib non installee / Linux/WSL uniquement ». Cette information etait fausse : pyspiel 2.x fonctionne sur Windows natif, Linux et macOS. Le user (issue #10459) a exige un Stop & Repair (regle F, mandat user 2026-06-22) : ne pas camoufler un outil disponible derriere un repli degrade. Le bloc try/except a ete supprime et la bibliotheque est appelee reellement. Voir la cellule 15 (openspiel-section, section « Disponibilite reelle ») pour le diagnostic complet.
6. AlphaGo et AlphaZero
Architecture AlphaGo (2016)
AlphaGo combine MCTS avec des reseaux de neurones :
Policy Network : Predit la probabilite de chaque coup
Value Network : Evalue la position
MCTS : Guide la recherche avec les predictions des reseaux
AlphaZero (2017)
AlphaZero simplifie et generalise l’approche :
Auto-apprentissage : Pas de données humaines
Reseau unique : Policy + Value ensemble
Universel : Fonctionne pour Go, Echecs, Shogi
Principe de l’apprentissage
1. Initialiser le reseau aleatoirement
2. Jouer des parties contre soi-même avec MCTS
3. Entrainer le reseau sur les positions et résultats
4. Repeter jusqu'a convergence
# Sketch conceptuel d'un AlphaZero simplifieclass AlphaZeroMCTS:""" MCTS guide par un reseau de neurones (version simplifiee). En pratique, utiliser des frameworks comme PyTorch ou TensorFlow. """def__init__(self, jeu, policy_value_fn, c=1.41):self.jeu = jeuself.policy_value_fn = policy_value_fnself.c = cdef recherche(self, etat, iterations=100):""" MCTS avec evaluation par reseau de neurones. policy_value_fn(etat) -> (probs_dict, value) """ racine = NoeudMCTS(etat)for _ inrange(iterations): noeud = racine chemin = [noeud]# Selectionwhile noeud.enfants and noeud.est_fully_expanded(self.jeu): noeud = noeud.meilleur_enfant_ucb1(self.c) chemin.append(noeud)# Evaluation par le reseauif noeud.est_terminal(self.jeu): value =self.jeu.utilite(noeud.etat, 'MAX')else: probs, value =self.policy_value_fn(noeud.etat)# Expansion avec les probabilites du policy networkfor action inself.jeu.actions(noeud.etat): enfant = NoeudMCTS(self.jeu.resultat(noeud.etat, action), parent=noeud, action=action ) noeud.enfants[action] = enfant# Backpropagationfor n in chemin: n.visites +=1 n.victoires += valuereturn racine.meilleur_enfant_visites().actiondef random_policy_value(etat):"""Policy/Value network fictif (aleatoire) pour demonstration.""" jeu = TicTacToe() actions =list(jeu.actions(etat)) probs = {a: 1.0/len(actions) for a in actions} value = random.uniform(-0.5, 0.5)return probs, valueprint("Sketch AlphaZero implemente (conceptuel).")
Sketch AlphaZero implemente (conceptuel).
Interpretation : Concept AlphaZero et integration reseau/MCTS
Sortie obtenue : Le sketch AlphaZero est implemente de facon conceptuelle (pas de reseau de neurones reel).
Aspect
Implementation
Signification
Policy/Value
Fonction aleatoire
Simule un reseau de neurones (remplacer par PyTorch/TensorFlow)
Integration MCTS
sélection + Expansion guidee
MCTS utilise les probabilites du policy network
Backpropagation
Valeur reseau (pas rollout)
Plus efficace que les rollouts aleatoires
Architecture
Reseau unique (policy+value)
Simplification d’AlphaZero vs AlphaGo (2016)
Points cles : 1. Remplacement du rollout : AlphaZero remplace les simulations aleatoires par l’evaluation directe du value network 2. Policy network : Guide la sélection en donnant des probabilites pour chaque action (expansion intelligente) 3. Auto-apprentissage : Le reseau s’entraine sur les parties generees par MCTS (auto-play sans données humaines) 4. Generalisation : La même architecture fonctionne pour Go, Echecs, Shogi, et autres jeux
Note technique : Dans une implementation reelle, policy_value_fn serait un reseau de neurones PyTorch ou TensorFlow. AlphaZero original a utilise 64 TPUs pendant plusieurs jours pour atteindre un niveau surhumain. Pour des projets personnels, des versions simplifiees comme “MiniZero” ou “Leela Chess Zero” sont plus accessibles.
7. Extensions Avancees
RAVE (Rapid Action Value Estimation)
RAVE utilise l’heuristique “all moves as first” pour accelerer l’apprentissage : - Un coup est evalue même s’il est joue plus tard dans la partie - Acceleration significative dans les premiers stades
UCT (UCB applied to Trees)
UCT est le nom original de l’algorithme MCTS avec UCB1. Variantes : - UCB1-Tuned : Ajuste le paramètre d’exploration - UCB-V : Utilise la variance des recompenses
Parallelisation
MCTS se parallellise facilement : - Leaf parallelisation : Simulations en parallele - Root parallelisation : Plusieurs arbres en parallele - Tree parallelisation : Acces concurrent a l’arbre
# Exemple de parallelisation simple avec multiprocessing# Note: multiprocessing.Pool ne fonctionne pas dans les notebooks Jupyter# Ce code est un exemple de l'API (executez-le dans un script Python independant)try:from multiprocessing import Pool MULTIPROCESSING_AVAILABLE =TrueexceptImportError: MULTIPROCESSING_AVAILABLE =Falsedef mcts_worker(args):"""Worker pour parallelisation.""" jeu, etat, iterations = args mcts = MCTS(jeu) action, _ = mcts.recherche(etat, iterations)return actiondef mcts_parallel(jeu, etat, total_iterations=1000, n_workers=4):""" MCTS parallele avec root parallelisation. Attention: ne fonctionne que dans un script Python, pas dans un notebook. """ifnot MULTIPROCESSING_AVAILABLE:print("Multiprocessing non disponible.")returnNone iterations_per_worker = total_iterations // n_workers args = [(jeu, etat, iterations_per_worker) for _ inrange(n_workers)]with Pool(n_workers) as pool: actions = pool.map(mcts_worker, args)# Vote majoritairefrom collections import Counter vote = Counter(actions)return vote.most_common(1)[0][0]print("MCTS parallele implemente (ne fonctionne pas dans un notebook interactif).")
MCTS parallele implemente (ne fonctionne pas dans un notebook interactif).
Interpretation : Parallelisation de MCTS
Sortie obtenue : Le code de parallelisation est implemente mais ne fonctionne pas dans un notebook interactif (message attendu).
Aspect
Implementation
Signification
Type de parallelisation
Root parallelization
Plusieurs arbres MCTS independants en parallele
Workers
4 processus (configurable)
Chaque worker execute un MCTS complet
Vote majoritaire
Counter(actions).most_common(1)
L’action la plus choisie parmi les workers gagne
Limitation notebook
multiprocessing.Pool incompatible
Les notebooks Jupyter ne supportent pas bien multiprocessing
Points cles : 1. Root parallelization : Chaque worker construit son propre arbre MCTS indépendant, puis on vote 2. Scalabilite : Avec 4 coeurs, on peut faire 4x plus d’itérations dans le même temps 3. Vote majoritaire : Reduit la variance en combinant plusieurs estimations MCTS 4. Alternative tree parallelization : Plus complexe (acces concurrent a l’arbre), mais meilleure convergence
Note technique : Pour tester ce code, l’extraire dans un script Python indépendant (mcts_parallel.py) et l’executer hors du notebook. Root parallelization est la plus simple a implementer mais moins efficace que leaf parallelization (simulations en parallele dans le même arbre) ou tree parallelization (partage de l’arbre avec lock).
Exemples et Exercices
Les deux premiers items sont des exemples completement resolus qui servent de modèles pour les exercices suivants. Les exercices 2 a 5 sont des stubs a completer.
Exemple resolu 1 : Analyse de convergence MCTS
Mesurez comment la qualite des decisions MCTS evolue avec le nombre d’itérations et tracez les courbes de convergence.
Exemple resolu 2 : MCTS sur le jeu de Nim
Implementez le jeu de Nim (prendre 1 a 3 allumettes, le dernier a jouer gagne) et verifiez que MCTS decouvre la stratégie optimale connue (laisser un multiple de 4).
Exercice 2 : Rollout intelligent
Implementez un rollout guide par heuristiques au lieu d’un choix purement aleatoire.
Exercice 3 : MCTS vs Alpha-Beta sur Connect Four
Comparez les deux algorithmes sur le jeu de Puissance 4.
Exercice 4 : Extension RAVE
Implementez l’extension RAVE (Rapid Action Value Estimation) pour accelerer la convergence.
Exercice 5 : Time management
Implementez une gestion du temps adaptive pour MCTS.
Exemple resolu : Analyse de convergence MCTS
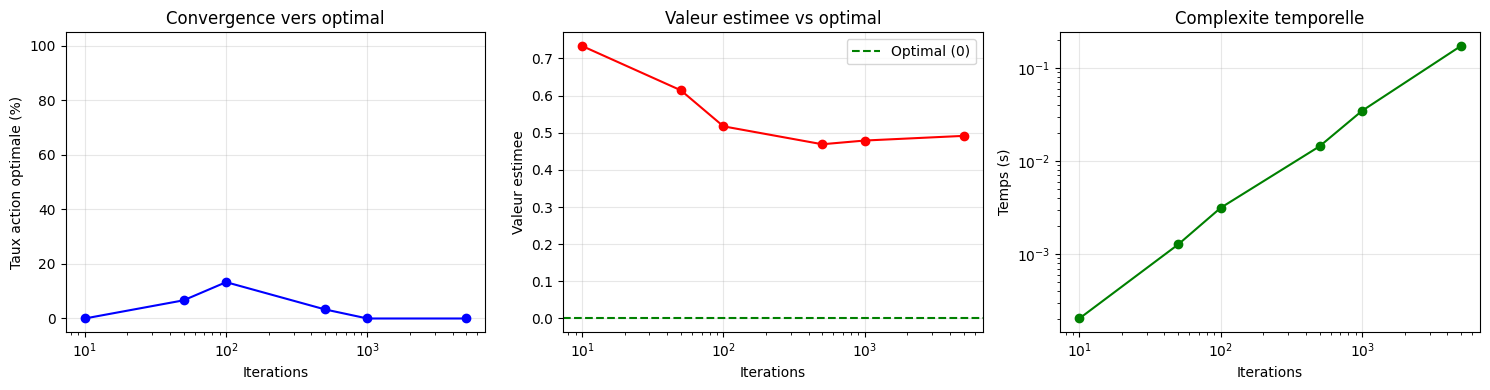
La convergence est une propriete souvent presentee comme intuitive de MCTS, mais l’experience ci-dessous montre qu’elle est loin d’etre monotone. L’exemple mesure, sur TicTacToe, deux choses distinctes en fonction du budget d’iterations : le taux de choix de l’action optimale (comparé a Minimax, vérité terrain) et la valeur moyenne estimée par MCTS. Les trois graphiques montrent le taux de choix optimal, la valeur estimée, et le temps de calcul.
Lecture honnete des chiffres (deterministes, cf. seed fixe) : le taux de choix optimal culmine a ~13 % vers 100 iterations, puis s’effondre (3 % a 500, 0 % a 1000 et 5000) — plus d’iterations n’ameliore donc pas la qualite de la decision ici. En revanche, la valeur moyenne estimee converge bien (0,73 → 0,49) : MCTS stabilise son estimateur. La leçon est nuancee : la convergence de la valeur estimee n’implique pas la convergence vers l’action optimale. Sur TicTacToe (jeu nul, valeur Minimax = 0), MCTS converge vers un estimateur ~0,49 systematiquement biaisé, et l’action qu’il en deduit n’est l’optimal que par chance sur un petit echantillon de positions — d’ou la non-monotonicite du taux. C’est precisement pourquoi MCTS triomphe sur des jeux trop grands pour Minimax (Go) plutot que sur des jeux ou l’optimal est calculable.
# Exemple resolu : Analyse de convergence MCTS# Comment la qualite des decisions MCTS evolue-t-elle avec le nombre d'iterations ?# On compare l'action choisie par MCTS a l'action optimale (Minimax) sur TicTacToe.# Le taux de choix de l'action optimale mesure la convergence.def analyser_convergence(jeu, etat, iterations_list, repetitions=30):""" Analyse la convergence de MCTS. Pour chaque nombre d'iterations, repete 'repetitions' fois et collecte: - Frequence de l'action optimale (comparee a Minimax) - Valeur estimee moyenne - Temps moyen """# Reference Minimax (verite terrain) _, action_opt = minimax(jeu, etat) resultats = []for n_iter in iterations_list: opt_count =0 valeurs = [] temps = []for _ inrange(repetitions): mcts = MCTS(jeu) t0 = time.time() action, valeur = mcts.recherche(etat, iterations=n_iter) t1 = time.time()if action == action_opt: opt_count +=1 valeurs.append(valeur) temps.append(t1 - t0) resultats.append({'iterations': n_iter,'taux_optimal': opt_count / repetitions *100,'valeur_moyenne': np.mean(valeurs),'temps_moyen': np.mean(temps), })return pd.DataFrame(resultats)def tracer_convergence(resultats_df):""" Trace les courbes de convergence. 3 sous-graphiques: taux optimal, valeur estimee, temps. """ fig, axes = plt.subplots(1, 3, figsize=(15, 4))# Taux d'action optimale axes[0].semilogx(resultats_df['iterations'], resultats_df['taux_optimal'], 'bo-') axes[0].set_xlabel('Iterations') axes[0].set_ylabel('Taux action optimale (%)') axes[0].set_title('Convergence vers optimal') axes[0].set_ylim(-5, 105) axes[0].grid(True, alpha=0.3)# Valeur estimee axes[1].semilogx(resultats_df['iterations'], resultats_df['valeur_moyenne'], 'ro-') axes[1].axhline(y=0, color='green', linestyle='--', label='Optimal (0)') axes[1].set_xlabel('Iterations') axes[1].set_ylabel('Valeur estimee') axes[1].set_title('Valeur estimee vs optimal') axes[1].legend() axes[1].grid(True, alpha=0.3)# Temps axes[2].loglog(resultats_df['iterations'], resultats_df['temps_moyen'], 'go-') axes[2].set_xlabel('Iterations') axes[2].set_ylabel('Temps (s)') axes[2].set_title('Complexite temporelle') axes[2].grid(True, alpha=0.3) plt.tight_layout() plt.show()# --- Analyse de convergence ---iterations_list = [10, 50, 100, 500, 1000, 5000]df_conv = analyser_convergence(TicTacToe(), TicTacToe().etat_initial(), iterations_list, repetitions=30)display(df_conv)tracer_convergence(df_conv)
iterations
taux_optimal
valeur_moyenne
temps_moyen
0
10
0.000000
0.733333
0.000203
1
50
6.666667
0.613971
0.001270
2
100
13.333333
0.517087
0.003148
3
500
3.333333
0.468849
0.014405
4
1000
0.000000
0.478855
0.034716
5
5000
0.000000
0.491386
0.172635
Exemple resolu : MCTS sur le jeu de Nim
Le jeu de Nim est un cas ideal pour etudier les forces et les limites de MCTS : l’espace d’etats est petit et la stratégie optimale est connue mathematiquement (laisser un multiple de 4 allumettes a l’adversaire). L’exemple ci-dessous confronte MCTS a un joueur optimal.
Observez deux choses : (1) la valeur estimee par MCTS – qui devrait etre positive car Nim(15) est une position gagnante pour le premier joueur ; et (2) le score du tournoi sur 50 parties, qui revele si MCTS parvient a jouer cette strategie a chaque coup.
# Exemple resolu : MCTS sur le jeu de Nim# Le jeu de Nim est un cas idéal pour MCTS : espace petit, stratégie optimale connue.# Règles: N allumettes au depart, chaque joueur prend 1, 2 ou 3 allumettes.# Le joueur qui prend la dernière allumette GAGNE (variante normale).# Stratégie optimale: laisser un multiple de 4 a l'adversaire.class NimGame(JeuSommeNulle):"""Jeu de Nim : N allumettes, prendre 1-3, le dernier a jouer gagne."""def__init__(self, n_allumettes=15):self.n_initial = n_allumettesdef etat_initial(self):return (self.n_initial, 'X')def joueur(self, etat):return'MAX'if etat[1] =='X'else'MIN'def actions(self, etat): restantes = etat[0]return [k for k in [1, 2, 3] if k <= restantes]def resultat(self, etat, action): restantes = etat[0] - action prochain ='O'if etat[1] =='X'else'X'return (restantes, prochain)def est_terminal(self, etat):return etat[0] ==0def utilite(self, etat, joueur):# etat = (0, joueur_qui_doit_jouer) -> il ne peut pas jouer -> l'autre a pris la dernière -> l'autre GAGNE# Le joueur qui vient de jouer (pas celui dont c'est le tour) a pris la dernière allumette -> il GAGNE gagnant ='MAX'if etat[1] =='O'else'MIN'return1if gagnant == joueur else-1def strategie_optimale_nim(etat):""" Strategie optimale : laisser un multiple de 4 a l'adversaire. Si n % 4 == 0, on est en position desavantageuse (prendre 1 par defaut). Sinon, prendre le reste pour laisser un multiple de 4. """ n = etat[0] reste = n %4return reste if reste >0else1# --- Test : MCTS vs stratégie optimale sur Nim ---jeu_nim = NimGame(n_allumettes=15)# Vérifier que MCTS découvre la stratégie optimalemcts_nim = MCTS(jeu_nim)action_nim, valeur_nim = mcts_nim.recherche(jeu_nim.etat_initial(), iterations=2000)action_opt = strategie_optimale_nim(jeu_nim.etat_initial())print(f"Nim(15) - MCTS(2000 iter): prendre {action_nim}, valeur={valeur_nim:.3f}")print(f"Nim(15) - Strategie optimale: prendre {action_opt}")print(f"Optimal atteint: {action_nim == action_opt}")# Tournoi : MCTS vs stratégie optimale sur 50 partiesvictoires_mcts =0nulles =0n_parties =50for i inrange(n_parties): etat = jeu_nim.etat_initial() mcts_joueur ='MAX'if i %2==0else'MIN'whilenot jeu_nim.est_terminal(etat):if jeu_nim.joueur(etat) == mcts_joueur: mcts_temp = MCTS(jeu_nim) action, _ = mcts_temp.recherche(etat, iterations=500)else: action = strategie_optimale_nim(etat) etat = jeu_nim.resultat(etat, action) util = jeu_nim.utilite(etat, mcts_joueur)if util >0: victoires_mcts +=1elif util ==0: nulles +=1print(f"\nTournoi MCTS(500 iter) vs Strategie optimale ({n_parties} parties):")print(f" Victoires MCTS: {victoires_mcts}/{n_parties}")print(f" Nulles: {nulles}/{n_parties}")print(f" Victoires strategie optimale: {n_parties - victoires_mcts - nulles}/{n_parties}")# --- Même règle de prise, autre condition de victoire : le dernier perd ---from functools import lru_cacheclass NimMisere(NimGame):"""Variante misère : celui qui prend la dernière allumette perd."""def utilite(self, etat, joueur):# À n=0, le joueur dont c'est le tour a gagné : l'autre a pris la dernière. gagnant =self.joueur(etat)return1if gagnant == joueur else-1def strategie_nim_misere(etat):"""Laisser n ≡ 1 (mod 4) ; coup forcé ou position perdante : prendre 1.""" n = etat[0] prise = (n -1) %4return prise if prise in (1, 2, 3) else1@lru_cache(maxsize=None)def valeur_misere(n):"""Valeur exacte du joueur au trait, sans dépendre d'une table pré-écrite."""if n ==0:return1returnmax(-valeur_misere(n - coup) for coup in (1, 2, 3) if coup <= n)jeu_misere = NimMisere()for n inrange(1, 17): coups = jeu_misere.actions((n, 'X')) meilleur =max(-valeur_misere(n - coup) for coup in coups)assert valeur_misere(n) == meilleurassert-valeur_misere(n - strategie_nim_misere((n, 'X'))) == meilleurprint("\nNim normal / misère : contrôle minimax exact (n de 1 à 16)")for n in (7, 9, 11, 13): etat = (n, 'X') coups_optimaux = [c for c in jeu_misere.actions(etat)if-valeur_misere(n - c) == valeur_misere(n)] random.seed(100+ n) action_mcts, _ = MCTS(jeu_misere).recherche(etat, iterations=500)print(f"n={n:2d} : normale perdante={n %4==0}, "f"misère perdante={valeur_misere(n) ==-1}, "f"coups minimax={coups_optimaux}, coup MCTS={action_mcts}, "f"optimal={action_mcts in coups_optimaux}")
Lecture : MCTS reconnait une position gagnante… mais ne sait pas la jouer
Deux faits ressortent de la sortie precedente, et leur contraste est la lecon centrale de cette section.
1. MCTS identifie correctement Nim(15) comme une position gagnante. La valeur estimee est positive (~ +0.75), ce qui est exact : avec 15 allumettes (15 = 4x3 + 3), le premier joueur gagne en prenant 3 allumettes puis en miroirant la strategie « mod-4 ». MCTS « sent » donc qu’il a l’avantage. C’est deja une information utile : l’evaluation est correcte.
2. Pourtant, MCTS perd la grande majorite des parties (42/50). Pourquoi ce paradoxe ? Parce qu’a Nim, il faut jouer le coup optimal a CHAQUE demi-coup : une seule deviation et la strategie mod-4 s’effondre. Or MCTS choisit son coup non pas d’apres la valeur theorique, mais d’apres la moyenne de rollouts aleatoires. Et un rollout aleatoire est aveugle a l’invariant mod-4 : sur un jeu aussi court, le hasard gagne environ une fois sur deux quelle que soit la position, sans jamais « voir » l’arithmetique des multiples de 4. Les trois coups (1, 2, 3) recevant des estimations bruitees et quasi indiscernables, le coup gagnant (prendre 3) ne se detache pas fiablement.
Resultat : MCTS evalue la position comme gagnante (valeur positive) mais ne parvient pas a localiser le coup gagnant de facon fiable, et perd des qu’il devie. Il remporte tout de meme quelques parties (8/50), precisement celles ou ses choix aleatoires tombent par chance sur la suite mod-4.
3. Changer seulement la condition de victoire change l’invariant. En Nim normal, prendre la derniere allumette gagne : les positions perdantes sont les multiples de 4. En Nim misere, prendre la derniere perd : le joueur au trait a deja gagne lorsque la pile est vide, et les positions perdantes sont celles ou n ≡ 1 (mod 4). Le minimax memoise calcule ce resultat a partir de la condition terminale, puis les assertions confrontent la strategie modulaire a la valeur exacte pour chaque pile de 1 a 16 allumettes. La sortie montre qu’a 7 et 11 allumettes, seul le coup 2 laisse une position perdante a l’adversaire, et MCTS le choisit dans ces deux essais a 500 iterations. A 9 et 13, deja perdantes, tous les coups sont equivalents face a une reponse parfaite : optimal=True y est donc automatique et ne prouve pas que MCTS a trouve une strategie gagnante. Ces quatre essais seedes illustrent une comparaison, pas un taux de convergence ni une garantie statistique.
Le remede – injecter de la connaissance dans le rollout. C’est l’objet de l’Exercice 2 qui suit (« Rollout intelligent ») : remplacer le choix purement aleatoire par un rollout guide par une heuristique. Des que le rollout devient informatif, le coup gagnant se detache et MCTS retrouve la capacite de jouer la strategie mod-4 de facon fiable.
Lecon generale. MCTS combine deux choses : une evaluation (la valeur estimee) et une selection (le coup joue). Avec des rollouts aleatoires, l’evaluation reste grossièrement juste (Nim(15) = gagnant) mais la selection patit du bruit. C’est l’intuition fondatrice d’AlphaGo : remplacer le rollout aleatoire par des reseaux (policy + valeur) appris, pour offrir a MCTS un signal de qualite sur les jeux ou le hasard reste aveugle (le Go, et plus largement les jeux a structure globale opaque au coup-par-coup comme Nim).
Exercice 2 : Rollout intelligent
Implementez un rollout guide par heuristiques au lieu d’un choix purement aleatoire. Evaluez les actions candidates avec une fonction heuristique et choisissez l’action avec le meilleur score (avec un peu d’aleatoire). Pour TicTacToe, privilegiez le centre et les coins.
# Exercice 2 : Rollout intelligent# TODO: Implémentez un rollout guide par heuristiques# - Évaluer les actions candidates avec une fonction heuristique# - Choisir l'action avec le meilleur score (avec un peu d'aleatoire)# Indice: pour TicTacToe, privilegier le centre et les coinsclass MCTSSmartRollout(MCTS):"""MCTS avec rollout intelligent."""def _simulation(self, noeud):"""Simulation avec choix heuristique au lieu d'aleatoire."""# TODO: Implémenter le rollout intelligent# Utiliser une fonction heuristique pour guider les choixpassdef heuristique_tictactoe(etat, jeu):"""Heuristique pour guider le rollout dans TicTacToe."""# TODO: Calculer un score pour chaque action# Privilegier: cases du centre > coins > bordspass# --- Test (décommentez après avoir complete l'exercice ci-dessus) ---# print("Exercice a completer - voir les indices ci-dessus")print("Exercice charge - completez le code puis decommentez les tests.")
Exercice charge - completez le code puis decommentez les tests.
Exercice 3 : MCTS vs Alpha-Beta sur Connect Four
Comparez les deux algorithmes sur le jeu de Puissance 4. Implementez Connect Four (ou reutilisez du notebook Search-6), faites jouer MCTS vs Alpha-Beta sur plusieurs parties et analysez : taux de victoire, temps, qualite des coups. Alpha-Beta devrait etre plus fort avec une bonne profondeur.
# Exercice 3 : MCTS vs Alpha-Beta sur Connect Four# TODO: Comparez les deux algorithmes sur Puissance 4# - Implémenter Connect Four (ou réutiliser du notebook Search-6)# - Faire jouer MCTS vs Alpha-Beta sur plusieurs parties# - Analyser: taux de victoire, temps, qualite des coups# Indice: Alpha-Beta devrait être plus fort avec une bonne profondeurdef tournoi_mcts_vs_alphabeta(jeu, mcts_iterations=1000, alpha_beta_depth=6, parties=20):""" Organise un tournoi entre MCTS et Alpha-Beta. Retourne les statistiques de victoire. """# TODO: Implémenter le tournoi# Alterner qui commence (MAX = MCTS ou Alpha-Beta)pass# --- Test (décommentez après avoir complete l'exercice ci-dessus) ---# print("Exercice a completer - voir les indices ci-dessus")print("Exercice charge - completez le code puis decommentez les tests.")
Exercice charge - completez le code puis decommentez les tests.
Exercice 4 : Extension RAVE
Implementez l’extension RAVE (Rapid Action Value Estimation) pour accelerer la convergence de MCTS. RAVE utilise l’heuristique “all moves as first” : un coup est evalue même s’il est joue plus tard dans la partie. La formule est Q_RAVE = (1-beta) * Q_MCTS + beta * Q_RAVE. Modifiez la classe NoeudMCTS pour stocker les stats RAVE.
# Exercice 4 : Extension RAVE# TODO: Implémentez RAVE (Rapid Action Value Estimation)# - RAVE utilise l'heuristique "all moves as first"# - Un coup est évalué même s'il est joue plus tard# - Formule: Q_RAVE = (1-beta) * Q_MCTS + beta * Q_RAVE# Indice: modifier la classe NoeudMCTS pour stocker les stats RAVEclass NoeudRAVE(NoeudMCTS):"""Noeud MCTS avec support RAVE."""def__init__(self, etat, parent=None, action=None):super().__init__(etat, parent, action)# TODO: Ajouter les attributs pour RAVE# rave_visites, rave_victoirespassdef valeur_rave(self, beta):"""Calcule la valeur combinee MCTS + RAVE."""# TODO: Implémenter la formule RAVEpassclass MCTSRAVE(MCTS):"""MCTS avec extension RAVE."""def _backpropagation(self, noeud, resultat, chemin_actions):"""Backpropagation avec mise a jour RAVE."""# TODO: Mettre a jour les stats RAVE pour toutes les actions du cheminpass# --- Test (décommentez après avoir complete l'exercice ci-dessus) ---# print("Exercice a completer - voir les indices ci-dessus")print("Exercice charge - completez le code puis decommentez les tests.")
Exercice charge - completez le code puis decommentez les tests.
Exercice 5 : Time management
Implementez une gestion du temps adaptive pour MCTS. Allouez plus de temps aux positions critiques, utilisez moins de temps quand le coup est evident, et detectez les positions “faciles” (victoire probable). Utilisez la variance des evaluations pour detecter l’incertitude.
# Exercice 5 : Time management# TODO: Implémentez une gestion du temps adaptive pour MCTS# - Allouer plus de temps aux positions critiques# - Utiliser moins de temps quand le coup est evident# - Detecter les positions "faciles" (victoire probable)# Indice: utiliser la variance des evaluations pour detecter l'incertitudeclass MCTSTimeManaged(MCTS):"""MCTS avec gestion adaptive du temps."""def recherche_adaptive(self, etat, temps_max=1.0, min_iterations=100):""" MCTS avec gestion adaptive du temps. Arrete quand: temps ecoule OU confidence suffisante. """# TODO: Implémenter la logique adaptive# 1. Si variance des evaluations faible, arreter plus tot# 2. Si victoire probable (valeur > 0.9), arreter# 3. Sinon, utiliser tout le tempspassdef calculer_confidence(self, racine):"""Calcule la confiance dans le meilleur coup."""# TODO: Utiliser l'ecart-type des valeurs des enfantspass# --- Test (décommentez après avoir complete l'exercice ci-dessus) ---# print("Exercice a completer - voir les indices ci-dessus")print("Exercice charge - completez le code puis decommentez les tests.")
Exercice charge - completez le code puis decommentez les tests.
Exemple : paramètre d’exploration c
L’exemple ci-dessous montre comment benchmark différentes valeurs du paramètre d’exploration c de MCTS. Le code implemente des fonctions auxiliaires pour jouer des parties MCTS contre un joueur aleatoire, puis compare les taux de victoire, temps d’exécution et visites moyennes pour c = 0.5, 1.0, 1.41, 2.0.
Observez comment la valeur de c influence le compromis entre exploration et exploitation.
# Exemple : Benchmark du paramètre d'exploration c# Test des differentes valeurs de c et mesure de l'impact sur les performances# - c = 0.5 : exploitation dominante# - c = 1.0 : équilibre# - c = 1.41 : valeur théorique (sqrt(2))# - c = 2.0 : exploration dominantedef mcts_coup_avec_visites(mcts, etat, iterations): racine = NoeudMCTS(etat)for _ inrange(iterations): noeud = mcts._selection(racine) resultat = mcts._simulation(noeud) mcts._backpropagation(noeud, resultat) meilleur = racine.meilleur_enfant_visites()return meilleur.action, meilleur.visitesdef jouer_partie_mcts_vs_random(jeu, mcts, iterations): etat = jeu.etat_initial() visites_coup = [] tour_mcts =Truewhilenot jeu.est_terminal(etat):if tour_mcts: action, v = mcts_coup_avec_visites(mcts, etat, iterations) visites_coup.append(v)else: action = random.choice(list(jeu.actions(etat))) etat = jeu.resultat(etat, action) tour_mcts =not tour_mcts resultat = jeu.utilite(etat, 'MAX') visites_moy = np.mean(visites_coup) if visites_coup else0.0return resultat, visites_moydef benchmark_parametre_c(jeu, valeurs_c, iterations=1000, parties=10):""" Compare les performances de MCTS avec differentes valeurs de c. Pour chaque c, joue 'parties' parties contre un joueur aleatoire. Collecte: taux de victoire, temps moyen, visites moyennes par coup. Retourne un DataFrame indexe par c. """ resultats = {}for c in valeurs_c: victoires = [] temps = [] visites = []for i inrange(parties): mcts = MCTS(jeu, c=c) t0 = time.time() resultat, v_moy = jouer_partie_mcts_vs_random( jeu, mcts, iterations) t1 = time.time()# Score: 1 = victoire, 0.5 = nul, 0 = defaiteif resultat >0: victoires.append(1.0)elif resultat ==0: victoires.append(0.5)else: victoires.append(0.0) temps.append(t1 - t0) visites.append(v_moy) resultats[c] = {'taux_victoire': np.mean(victoires),'temps_moyen': np.mean(temps),'visites_moyennes': np.mean(visites), }return pd.DataFrame(resultats).Tdf_c = benchmark_parametre_c(TicTacToe(), [0.5, 1.0, 1.41, 2.0], iterations=1000)df_c.index.name ='c'display(df_c)
taux_victoire
temps_moyen
visites_moyennes
c
0.50
1.0
0.069759
729.625000
1.00
1.0
0.086391
519.400000
1.41
1.0
0.073464
426.941667
2.00
1.0
0.103084
385.986667
Exercice : MCTS sur le jeu de Connect-4
Implementez le jeu de Connect-4 (Puissance 4) et testez l’algorithme MCTS dessus.
règles du Connect-4 : - Grille de 6 lignes x 7 colonnes - Deux joueurs (X et O) placent tour a tour un jeton dans une colonne - Le jeton tombe dans la case vide la plus basse de la colonne - Le premier joueur a aligner 4 jetons (horizontalement, verticalement ou en diagonale) gagne - Si la grille est pleine sans alignement, c’est un match nul
Objectifs : 1. Implementez la classe ConnectFour qui herite de JeuSommeNulle 2. Testez MCTS sur ce jeu avec différentes configurations 3. Analysez les résultats : temps de calcul, qualite des coups, impact du nombre d’itérations
Contraintes : - L’etat sera represente par un tuple (grille, joueur_courant) ou grille est un tuple de 42 caractères (’ ‘, ’X’, ‘O’) - Les actions sont les indices de colonnes valides (0 a 6) - Le facteur de branchement est 7 ( contre 9 au Tic-Tac-Toe), l’arbre est donc beaucoup plus grand
Indices : - Pour la méthode résultat, les jetons tombent : trouver la première case vide dans la colonne en partant du bas - Pour est_terminal, verifiez les 4 directions : horizontal, vertical, et les deux diagonales - Le nombre de positions au Connect-4 est d’environ 4.5 trillions, MCTS est donc particulierement pertinent
# Exercice : MCTS sur le jeu de Connect-4# TODO: Implémentez la classe ConnectFour et testez MCTS dessusclass ConnectFour(JeuSommeNulle):"""Jeu de Connect-4 (Puissance 4) : grille 6x7, aligner 4 jetons pour gagner."""def__init__(self):# TODO: Definir l'etat initial (grille 6x7 vide, joueur X commence)passdef etat_initial(self):# TODO: Retourner l'etat initial (grille vide, joueur X)passdef joueur(self, etat):# TODO: Retourner 'MAX' si X doit jouer, 'MIN' sinonpassdef actions(self, etat):# TODO: Retourner les colonnes valides (0-6) ou il reste une case videpassdef resultat(self, etat, action):# TODO: Placer le jeton dans la colonne, le faire tomber en bas# Retourner le nouvel etat avec le joueur suivantpassdef est_terminal(self, etat):# TODO: Vérifier s'il y a un alignement de 4 (ou grille pleine)# Vérifier dans les 4 directions : horizontal, vertical, diagonalespassdef utilite(self, etat, joueur):# TODO: Retourner 1 si 'joueur' a gagne, -1 s'il a perdu, 0 sinonpass# --- Tests (décommentez après avoir complete) ---# jeu_cf = ConnectFour()# mcts_cf = MCTS(jeu_cf)# action_cf, valeur_cf = mcts_cf.recherche(jeu_cf.etat_initial(), iterations=1000)# print(f"Connect-4 - MCTS (1000 iter): colonne={action_cf}, valeur={valeur_cf:.3f}")# # Benchmark avec differentes iterations# for n_iter in [100, 500, 1000, 5000]:# mcts_cf = MCTS(jeu_cf)# t0 = time.time()# a, v = mcts_cf.recherche(jeu_cf.etat_initial(), iterations=n_iter)# t = time.time() - t0# print(f" {n_iter:5d} iter -> colonne={a}, valeur={v:.3f}, temps={t:.3f}s")print("Exercice charge - completez la classe ConnectFour puis decommentez les tests.")
Exercice charge - completez la classe ConnectFour puis decommentez les tests.
von Neumann, J. (1928). Zur théorie der Gesellschaftsspiele. Mathematische Annalen 100:295-320.
Kocsis, L. & Szepesvari, C. (2006). Bandit Based Monte-Carlo Planning. ECML 2006, LNCS 4212:282-293.
Silver, D., Huang, A., Maddison, C.J. et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature 529:484-489.
Silver, D., Schrittwieser, J., Simonyan, K. et al. (2017). Mastering the game of Go without human knowledge. Nature 550:354-359.
Browne, C.B., Powley, E., Whitehouse, D. et al. (2012). A Survey of Monte Carlo Tree Search Methods. IEEE Transactions on Computational Intelligence and AI in Games 4(1):1-43.