Search-02-Uninformed : Algorithmes de Recherche Non Informee

Navigation : << Espaces d’etats | Index | Recherche informee >>

Algorithmes de Recherche Non Informee (BFS, DFS, UCS, IDDFS)

Ce notebook explore les algorithmes de recherche non informee (ou aveugle) : des stratégies d’exploration systématique qui n’utilisent aucune connaissance du domaine au-dela de la definition du problème.

Objectifs d’apprentissage

A la fin de ce notebook, vous saurez : 1. Implementer l’algorithme de recherche generique (tree-search et graph-search) 2. Distinguer BFS, DFS, UCS et IDDFS par leur gestion de la frontiere 3. Analyser la completude, l’optimalite et la complexite de chaque algorithme 4. Comparer experimentalement les performances sur des problemes concrets

Prerequis

  • Notebook Search-01-StateSpace complete (definition de problemes, etats, actions)
  • Bases de Python : classes, collections (deque, heapq)

Duree estimee : 50 minutes

# Imports
import sys
import time
from collections import deque
import heapq
from typing import Optional, List, Dict, Tuple, Any, Callable

import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
import networkx as nx
import numpy as np

%matplotlib inline

import warnings
warnings.filterwarnings('ignore')
print("Imports OK : sys, time, deque, heapq, math")
Imports OK : sys, time, deque, heapq, math

1. Introduction

Un algorithme de recherche non informee (uninformed search) explore l’espace d’etats sans aucune indication sur la “direction” du but. Il ne dispose que de : - L’etat initial - La fonction de test de but - La fonction successeur (actions et etats resultants) - Le cout des actions (pour UCS)

Les stratégies différent par l’ordre d’exploration des noeuds, ce qui determine la structure de données utilisee pour la frontiere (open list).

critères d’evaluation

Nous evaluerons chaque algorithme selon quatre critères :

Critere Question
Completude L’algorithme trouve-t-il toujours une solution si elle existe ?
Optimalite La solution trouvee est-elle de cout minimal ?
Complexite temporelle Combien de noeuds sont explores au pire cas ?
Complexite spatiale Combien de noeuds sont stockes en memoire ?

Notations : \(b\) = facteur de branchement, \(d\) = profondeur de la solution la moins profonde, \(m\) = profondeur maximale de l’arbre, \(C^*\) = cout de la solution optimale, \(\epsilon\) = cout minimal d’une action.

Ancres savantes – Moore, E.F. (1959), The shortest path through a maze, Proc. Int. Symp. Switching Theory (BFS, parcours en largeur optimal en nombre d’aretes sur graphe non pondere) ; Tarjan, R. (1972), Depth-first search and linear graph algorithms, SIAM Journal on Computing 1(2):146-160 (DFS, parcours en profondeur, structure lineaire en temps) ; Dijkstra, E.W. (1959), A note on two problems in connexion with graphs, Numerische Mathematik 1:269-271 (UCS / cout uniforme, plus court chemin sur graphe pondere a poids positifs) ; Korf, R.E. (1985), Depth-first iterative-deepening: an optimal admissible tree search, Artificial Intelligence 27(1):97-109 (IDDFS, combine la complexite memoire de DFS avec l’optimalite de BFS) ; Russell, S. & Norvig, P. (2020), Artificial Intelligence: A Modern Approach (4th ed.), Pearson (cadre des quatre algorithmes de recherche non informee).

2. Cadre generique de recherche

Avant d’implementer chaque algorithme, definissons les structures de base communes a tous : le noeud de recherche, la definition du problème et la boucle de recherche generique.

Classe Problem

La classe abstraite Problem définit l’interface que tout problème de recherche doit implementer.

# --- Définition abstraite d'un problème de recherche ---

class Problem:
    """Classe abstraite definissant un probleme de recherche."""

    def __init__(self, initial, goal=None):
        self.initial = initial
        self.goal = goal

    def actions(self, state):
        """Actions possibles depuis cet etat."""
        pass  # Exercice: implementer pour chaque sous-classe

    def result(self, state, action):
        """Etat resultant de l'application de l'action."""
        pass  # Exercice: implementer pour chaque sous-classe

    def goal_test(self, state):
        """Teste si l'etat est un etat but."""
        return state == self.goal

    def step_cost(self, state, action, next_state):
        """Cout d'une action. Par defaut, cout uniforme de 1."""
        return 1
print("Classe Problem definie : probleme de recherche abstrait")
Classe Problem definie : probleme de recherche abstrait

problème concret : villes francaises

Definissons un problème de recherche d’itineraire sur un graphe de villes francaises avec des distances reelles.

# --- Probleme de recherche sur un graphe (villes et routes) ---

class GraphProblem(Problem):
    """Probleme de cheminement sur un graphe pondere."""

    def __init__(self, initial, goal, graph):
        """
        Args:
            initial: noeud de depart
            goal: noeud d'arrivee
            graph: dict de dict {noeud: {voisin: distance, ...}, ...}
        """
        super().__init__(initial, goal)
        self.graph = graph

    def actions(self, state):
        return list(self.graph.get(state, {}).keys())

    def result(self, state, action):
        return action

    def step_cost(self, state, action, next_state):
        return self.graph[state].get(next_state, float('inf'))


# --- Carte des villes francaises (graphe pondere) ---

france_graph = {
    'Paris':      {'Lyon': 465, 'Lille': 225, 'Strasbourg': 490, 'Nantes': 385, 'Bordeaux': 585},
    'Lyon':       {'Paris': 465, 'Marseille': 315, 'Grenoble': 110, 'Strasbourg': 490},
    'Marseille':  {'Lyon': 315, 'Toulouse': 405, 'Nice': 200, 'Montpellier': 170},
    'Toulouse':   {'Marseille': 405, 'Bordeaux': 245, 'Montpellier': 245},
    'Bordeaux':   {'Paris': 585, 'Toulouse': 245, 'Nantes': 340},
    'Nantes':     {'Paris': 385, 'Bordeaux': 340, 'Rennes': 110},
    'Rennes':     {'Nantes': 110, 'Lille': 600},
    'Lille':      {'Paris': 225, 'Rennes': 600, 'Strasbourg': 530},
    'Strasbourg': {'Paris': 490, 'Lyon': 490, 'Lille': 530},
    'Nice':       {'Marseille': 200, 'Grenoble': 330},
    'Grenoble':   {'Lyon': 110, 'Nice': 330},
    'Montpellier': {'Marseille': 170, 'Toulouse': 245},
}

# Coordonnees approximatives pour la visualisation
france_coords = {
    'Paris': (2.35, 48.86), 'Lyon': (4.83, 45.76), 'Marseille': (5.37, 43.30),
    'Toulouse': (1.44, 43.60), 'Bordeaux': (-0.57, 44.84), 'Nantes': (-1.55, 47.22),
    'Rennes': (-1.68, 48.11), 'Lille': (3.06, 50.63), 'Strasbourg': (7.75, 48.57),
    'Nice': (7.26, 43.70), 'Grenoble': (5.72, 45.19), 'Montpellier': (3.88, 43.61),
}

print("Graphe des villes francaises charge.")
print(f"  {len(france_graph)} villes, {sum(len(v) for v in france_graph.values()) // 2} routes")
print(f"  Exemple: Paris -> {list(france_graph['Paris'].keys())}")
Graphe des villes francaises charge.
  12 villes, 18 routes
  Exemple: Paris -> ['Lyon', 'Lille', 'Strasbourg', 'Nantes', 'Bordeaux']

Visualisation du graphe

Implementons une fonction de visualisation pour afficher le graphe avec les chemins trouves et les noeuds explores.

# --- Visualisation du graphe des villes ---

def draw_france_graph(graph, coords, path=None, explored=None,
                      frontier=None, title="Carte des villes"):
    """Dessine le graphe des villes avec un chemin optionnel."""
    G = nx.Graph()
    for city, neighbors in graph.items():
        for neighbor, dist in neighbors.items():
            G.add_edge(city, neighbor, weight=dist)

    fig, ax = plt.subplots(1, 1, figsize=(12, 9))

    # Positions basees sur les coordonnees
    pos = {city: (lon, lat) for city, (lon, lat) in coords.items()}

    # Couleurs des noeuds
    node_colors = []
    for node in G.nodes():
        if path and node in path:
            node_colors.append('#FF6B6B')  # Rouge pour le chemin
        elif explored and node in explored:
            node_colors.append('#ADD8E6')  # Bleu clair pour explores
        elif frontier and node in frontier:
            node_colors.append('#FFD700')  # Jaune pour la frontiere
        else:
            node_colors.append('#E8E8E8')  # Gris pour non visites

    # Dessiner le graphe
    nx.draw_networkx_nodes(G, pos, ax=ax, node_color=node_colors,
                           node_size=800, edgecolors='black', linewidths=1.5)
    nx.draw_networkx_labels(G, pos, ax=ax, font_size=8, font_weight='bold')

    # Aretes normales
    nx.draw_networkx_edges(G, pos, ax=ax, edge_color='gray',
                           width=1.0, alpha=0.6)

    # Distances sur les aretes
    edge_labels = nx.get_edge_attributes(G, 'weight')
    nx.draw_networkx_edge_labels(G, pos, edge_labels=edge_labels,
                                 ax=ax, font_size=7, font_color='navy')

    # Chemin en surbrillance
    if path and len(path) > 1:
        path_edges = [(path[i], path[i+1]) for i in range(len(path)-1)]
        nx.draw_networkx_edges(G, pos, edgelist=path_edges, ax=ax,
                               edge_color='red', width=3.0, alpha=0.8)

    # Legende
    legend_items = [
        mpatches.Patch(facecolor='#FF6B6B', edgecolor='black', label='Chemin solution'),
        mpatches.Patch(facecolor='#ADD8E6', edgecolor='black', label='Explore'),
        mpatches.Patch(facecolor='#FFD700', edgecolor='black', label='Frontiere'),
        mpatches.Patch(facecolor='#E8E8E8', edgecolor='black', label='Non visite'),
    ]
    ax.legend(handles=legend_items, loc='lower left', fontsize=9)
    ax.set_title(title, fontsize=14, fontweight='bold')
    ax.axis('off')
    plt.tight_layout()
    plt.show()

# Afficher le graphe de base
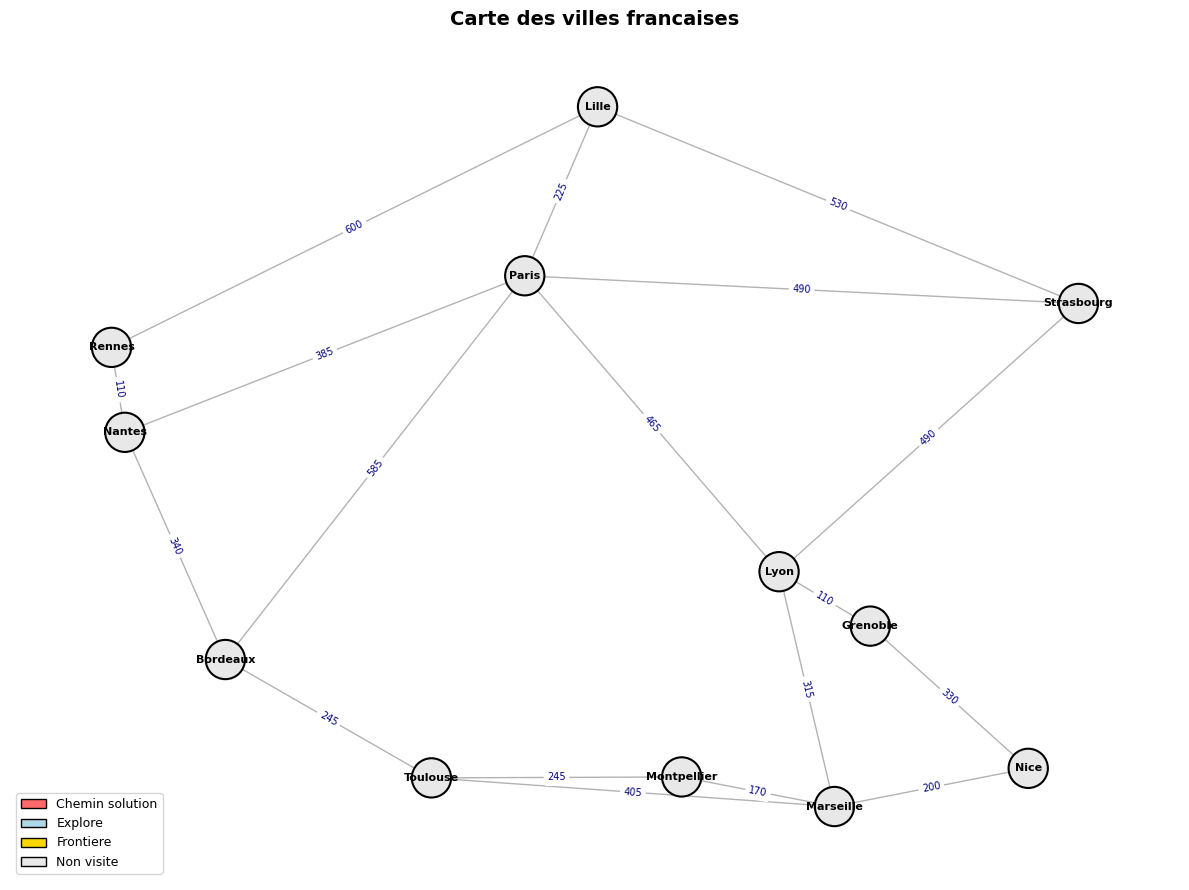
draw_france_graph(france_graph, france_coords, title="Carte des villes francaises")

Interpretation - Graphe des villes

Le graphe represente 12 villes francaises reliees par des routes ponderes par la distance en km. Nous utiliserons ce graphe comme fil conducteur pour comparer les différents algorithmes.

problème de reference : trouver un chemin de Bordeaux a Strasbourg.

Ce problème est interessant car : - Plusieurs chemins existent (via Paris, via Lyon, via Toulouse-Marseille-Lyon, etc.) - Les couts sont non uniformes (les distances varient beaucoup) - Selon le trajet, BFS (le moins d etapes) et UCS (le moins cher) peuvent donner des chemins differents – nous le verrons sur le cas Paris -> Rennes

# --- Fonction utilitaire pour tracer une recherche ---

class SearchResult:
    """Resultat d'une recherche, avec statistiques."""

    def __init__(self, algorithm, solution_node=None, nodes_expanded=0,
                 nodes_generated=0, max_frontier_size=0, elapsed_ms=0,
                 explored_order=None):
        self.algorithm = algorithm
        self.solution_node = solution_node
        self.nodes_expanded = nodes_expanded
        self.nodes_generated = nodes_generated
        self.max_frontier_size = max_frontier_size
        self.elapsed_ms = elapsed_ms
        self.explored_order = explored_order or []

    @property
    def found(self):
        return self.solution_node is not None

    @property
    def path(self):
        if self.solution_node:
            return [n.state for n in self.solution_node.path()]
        return []

    @property
    def cost(self):
        if self.solution_node:
            return self.solution_node.path_cost
        return float('inf')

    def display(self):
        print(f"\n--- {self.algorithm} ---")
        if self.found:
            print(f"  Chemin     : {' -> '.join(self.path)}")
            print(f"  Cout total : {self.cost}")
            print(f"  Longueur   : {len(self.path) - 1} étapes")
        else:
            print(f"  Aucune solution trouvee.")
        print(f"  Noeuds explorés  : {self.nodes_expanded}")
        print(f"  Noeuds generes   : {self.nodes_generated}")
        print(f"  Frontiere max    : {self.max_frontier_size}")
        print(f"  Temps            : {self.elapsed_ms:.2f} ms")

print("Framework de recherche pret.")
Framework de recherche pret.

6. Recherche en Profondeur Iteree (IDDFS - Iterative Deepening DFS)

IDDFS combine les avantages de BFS (completude, optimalite avec couts uniformes) et de DFS (faible consommation memoire).

Principe

IDDFS execute une serie de recherches en profondeur limitee (Depth-Limited Search) avec des limites croissantes : 0, 1, 2, 3, …

A chaque itération : 1. DFS avec limite de profondeur \(\ell\) 2. Si solution trouvee : retourner 3. Sinon : incrementer \(\ell\) et recommencer depuis la racine

Proprietes théoriques

Propriete Valeur Condition
Completude Oui Si \(b\) est fini
Optimalite Oui Si les couts sont uniformes
Complexite temporelle \(O(b^d)\) même ordre que BFS
Complexite spatiale \(O(bd)\) Lineaire (même que DFS)

L’overhead est negligeable

On pourrait penser que re-explorer les niveaux superieurs est couteux. En realite, le nombre total de noeuds generes est :

\[N(IDDFS) = (d)b + (d-1)b^2 + ... + (1)b^d\]

Pour \(b=10, d=5\) : \(N(IDDFS) = 123\,456\) vs \(N(BFS) = 111\,111\). L’overhead n’est que d’environ 11%.

def depth_limited_search(problem, limit, verbose=False):
    """
    Recherche en profondeur limitee.
    Retourne (result_node, cutoff_occurred)
    """
    nodes_expanded = 0
    nodes_generated = 0
    explored_order = []

    def recursive_dls(node, limit_remaining):
        nonlocal nodes_expanded, nodes_generated

        if problem.goal_test(node.state):
            explored_order.append(node.state)
            return node, False  # Trouve, pas de coupure

        if limit_remaining == 0:
            return None, True   # Coupure : limite atteinte

        explored_order.append(node.state)
        nodes_expanded += 1
        cutoff_occurred = False

        for child in node.expand(problem):
            nodes_generated += 1
            result, cutoff = recursive_dls(child, limit_remaining - 1)
            if cutoff:
                cutoff_occurred = True
            elif result is not None:
                return result, False

        return None, cutoff_occurred

    root = Node(problem.initial)
    result, cutoff = recursive_dls(root, limit)
    return result, cutoff, nodes_expanded, nodes_generated, explored_order


def iterative_deepening_search(problem, max_depth=50, verbose=False):
    """
    Recherche en profondeur iteree (IDDFS).
    Enchaine des DFS limitees avec des profondeurs croissantes.
    """
    start_time = time.perf_counter()
    total_expanded = 0
    total_generated = 0
    all_explored = []

    for depth_limit in range(max_depth + 1):
        result, cutoff, expanded, generated, explored = \
            depth_limited_search(problem, depth_limit)

        total_expanded += expanded
        total_generated += generated

        if verbose:
            status = "Solution!" if result else ("Coupure" if cutoff else "Echec")
            print(f"  Limite={depth_limit:2d} | Explores={expanded:4d} | "
                  f"Generes={generated:4d} | {status}")

        if result is not None:
            elapsed = (time.perf_counter() - start_time) * 1000
            # Fusionner les noeuds explorés de la dernière itération
            all_explored = explored
            return SearchResult('IDDFS', result, total_expanded,
                                total_generated, depth_limit,
                                elapsed, all_explored)

        if not cutoff:
            break  # Espace entier explore, pas de solution

    elapsed = (time.perf_counter() - start_time) * 1000
    return SearchResult('IDDFS', None, total_expanded, total_generated,
                        0, elapsed, all_explored)
print("Fonction depth_limited_search definie (DLS)")
Fonction depth_limited_search definie (DLS)

Appliquons maintenant IDDFS a notre problème de reference et observons le comportement iteratif.

# --- Application de IDDFS au problème Bordeaux -> Strasbourg ---

print("IDDFS : Bordeaux -> Strasbourg")
print("=" * 60)
result_iddfs = iterative_deepening_search(problem_bs, verbose=True)
result_iddfs.display()
IDDFS : Bordeaux -> Strasbourg
============================================================
  Limite= 0 | Explores=   0 | Generes=   0 | Coupure
  Limite= 1 | Explores=   1 | Generes=   3 | Coupure
  Limite= 2 | Explores=   2 | Generes=   4 | Solution!

--- IDDFS ---
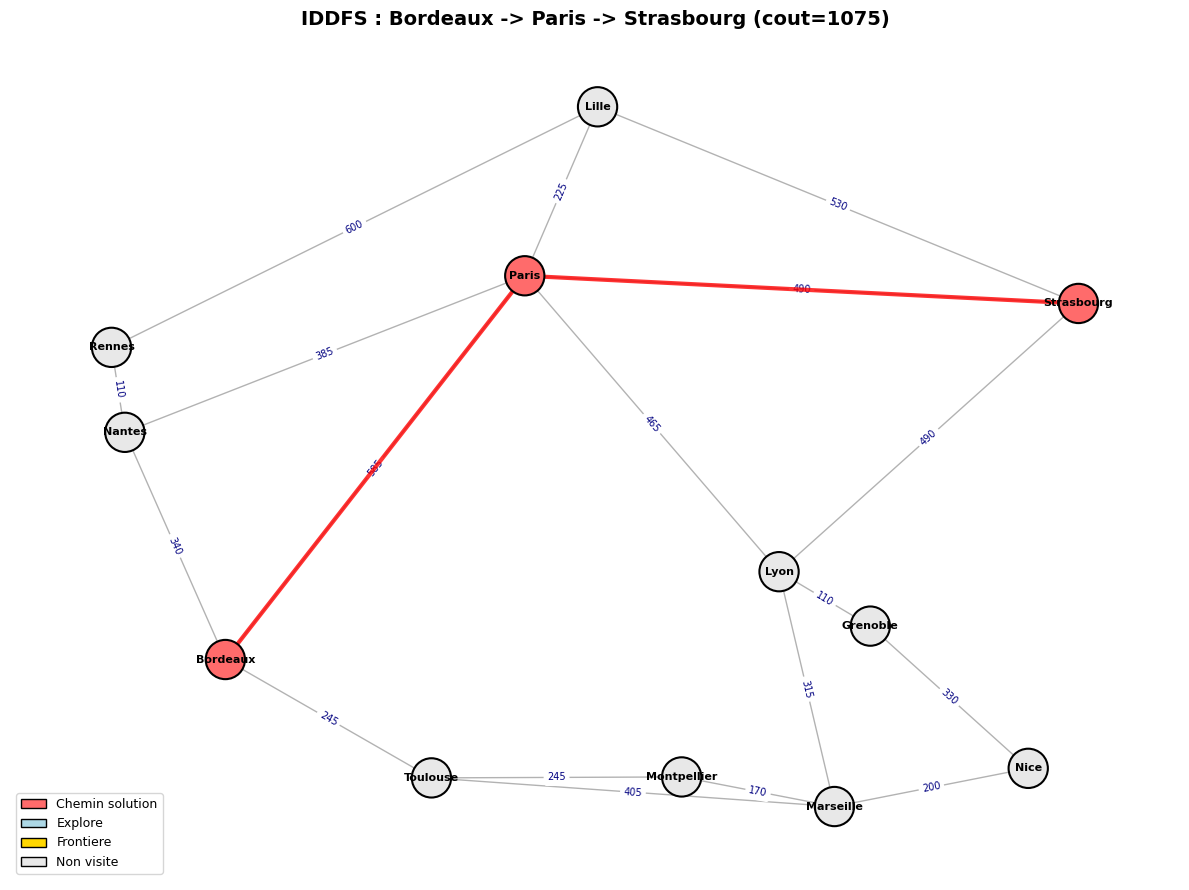
  Chemin     : Bordeaux -> Paris -> Strasbourg
  Cout total : 1075
  Longueur   : 2 etapes
  Noeuds explores  : 3
  Noeuds generes   : 7
  Frontiere max    : 2
  Temps            : 0.05 ms

Interpretation - IDDFS et l’overhead de re-exploration

Sortie obtenue : IDDFS teste successivement les limites de profondeur 0, 1, 2, … jusqu’a trouver une solution.

itération Limite Noeuds explores résultat
1 0 0 Coupure (profondeur insuffisante)
2 1 quelques Coupure
… … … …
dernière \(d\) tous les niveaux \(\leq d\) Solution trouvee

Points cles : 1. IDDFS trouve le même chemin que BFS (même profondeur minimale) 2. L’overhead de re-exploration est modeste : les niveaux superieurs contiennent peu de noeuds 3. La memoire utilisee est lineaire en \(O(bd)\), pas exponentielle comme BFS 4. C’est l’algorithme recommande quand on ne connait pas la profondeur de la solution

Recommandation AIMA : IDDFS est généralement la méthode de recherche non informee preferee quand l’espace de recherche est grand et la profondeur de la solution inconnue.

# Visualisation du résultat IDDFS
draw_france_graph(france_graph, france_coords,
                  path=result_iddfs.path,
                  explored=set(result_iddfs.explored_order),
                  title=f"IDDFS : {' -> '.join(result_iddfs.path)} (cout={result_iddfs.cost})")

Analyse de l’overhead de IDDFS

Calculons l’overhead théorique de IDDFS par rapport a BFS sur un arbre regulier.

# --- Analyse de l'overhead de IDDFS ---

def compute_overhead(b, d):
    """Calcule le ratio noeuds generes IDDFS / BFS pour un arbre regulier."""
    # BFS genere b + b^2 + ... + b^d = b*(b^d - 1)/(b-1)
    bfs_nodes = sum(b**i for i in range(1, d+1))

    # IDDFS genere d*b + (d-1)*b^2 + ... + 1*b^d
    iddfs_nodes = sum((d - i + 1) * b**i for i in range(1, d+1))

    return bfs_nodes, iddfs_nodes, iddfs_nodes / bfs_nodes

print("Overhead de IDDFS par rapport a BFS")
print("=" * 60)
print(f"{'b':>3} {'d':>3} {'BFS noeuds':>15} {'IDDFS noeuds':>15} {'Ratio':>10}")
print("-" * 60)

for b in [2, 5, 10]:
    for d in [3, 5, 10]:
        bfs_n, iddfs_n, ratio = compute_overhead(b, d)
        print(f"{b:>3} {d:>3} {bfs_n:>15,} {iddfs_n:>15,} {ratio:>10.3f}")
Overhead de IDDFS par rapport a BFS
============================================================
  b   d      BFS noeuds    IDDFS noeuds      Ratio
------------------------------------------------------------
  2   3              14              22      1.571
  2   5              62             114      1.839
  2  10           2,046           4,072      1.990
  5   3             155             190      1.226
  5   5           3,905           4,875      1.248
  5  10      12,207,030      15,258,775      1.250
 10   3           1,110           1,230      1.108
 10   5         111,110         123,450      1.111
 10  10  11,111,111,110  12,345,679,000      1.111

Interpretation - Overhead de IDDFS

Sortie obtenue : le tableau montre que l’overhead de IDDFS diminue quand le facteur de branchement \(b\) augmente.

Branchement \(b\) Overhead approximatif
\(b = 2\) ~2x plus de noeuds
\(b = 5\) ~1.25x plus de noeuds
\(b = 10\) ~1.11x plus de noeuds

Explication : quand \(b\) est grand, le dernier niveau contient \(b^d\) noeuds, ce qui domine largement les niveaux précédents. Les re-explorations des niveaux superieurs deviennent negligeables.

Conclusion : pour \(b \geq 5\) (très courant en pratique), l’overhead est inferieur a 25%. Le gain en memoire (\(O(bd)\) vs \(O(b^d)\)) justifie largement ce surcout.

7. Comparaison des algorithmes

Comparons les quatre algorithmes sur le même problème pour observer leurs différences en pratique.

# --- Comparaison complète sur plusieurs problèmes ---

test_cases = [
    ('Bordeaux', 'Strasbourg'),
    ('Rennes', 'Nice'),
    ('Lille', 'Toulouse'),
    ('Nantes', 'Marseille'),
]

all_results = []

print("Comparaison des algorithmes sur plusieurs problemes")
print("=" * 80)

for start, goal in test_cases:
    problem = GraphProblem(start, goal, france_graph)

    results = {
        'BFS': breadth_first_search(problem),
        'DFS': depth_first_search(problem),
        'UCS': uniform_cost_search(problem),
        'IDDFS': iterative_deepening_search(problem),
    }

    print(f"\n{start} -> {goal}")
    print("-" * 80)
    print(f"{'Algo':<8} {'Chemin':<40} {'Cout':>8} {'Explores':>10} {'Generes':>10}")
    print("-" * 80)

    for name, result in results.items():
        path_str = ' -> '.join(result.path) if result.found else 'NON TROUVE'
        if len(path_str) > 38:
            path_str = path_str[:35] + '...'
        print(f"{name:<8} {path_str:<40} {result.cost:>8.0f} "
              f"{result.nodes_expanded:>10} {result.nodes_generated:>10}")

    all_results.append((start, goal, results))
Comparaison des algorithmes sur plusieurs problemes
================================================================================

Bordeaux -> Strasbourg
--------------------------------------------------------------------------------
Algo     Chemin                                       Cout   Explores    Generes
--------------------------------------------------------------------------------
BFS      Bordeaux -> Paris -> Strasbourg              1075          2          6
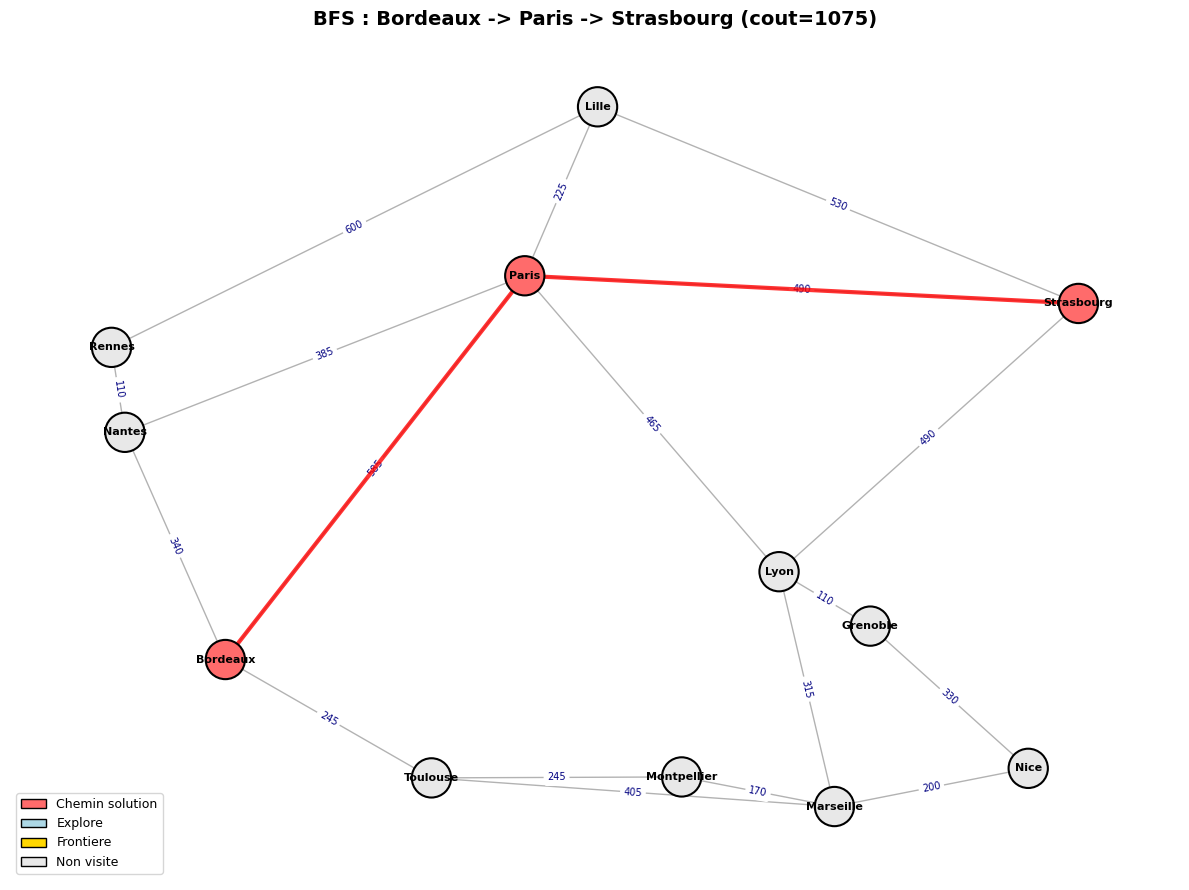
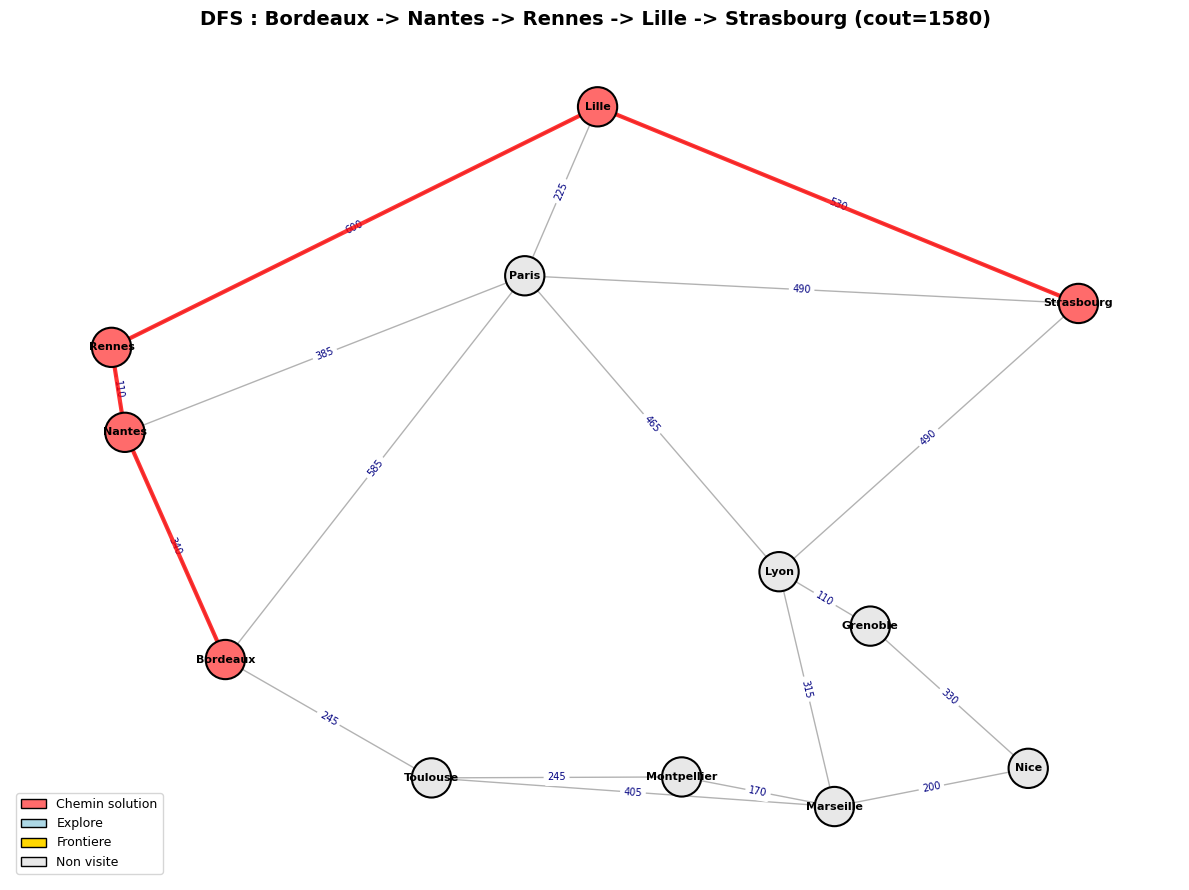
DFS      Bordeaux -> Nantes -> Rennes -> Lil...       1580          4         11
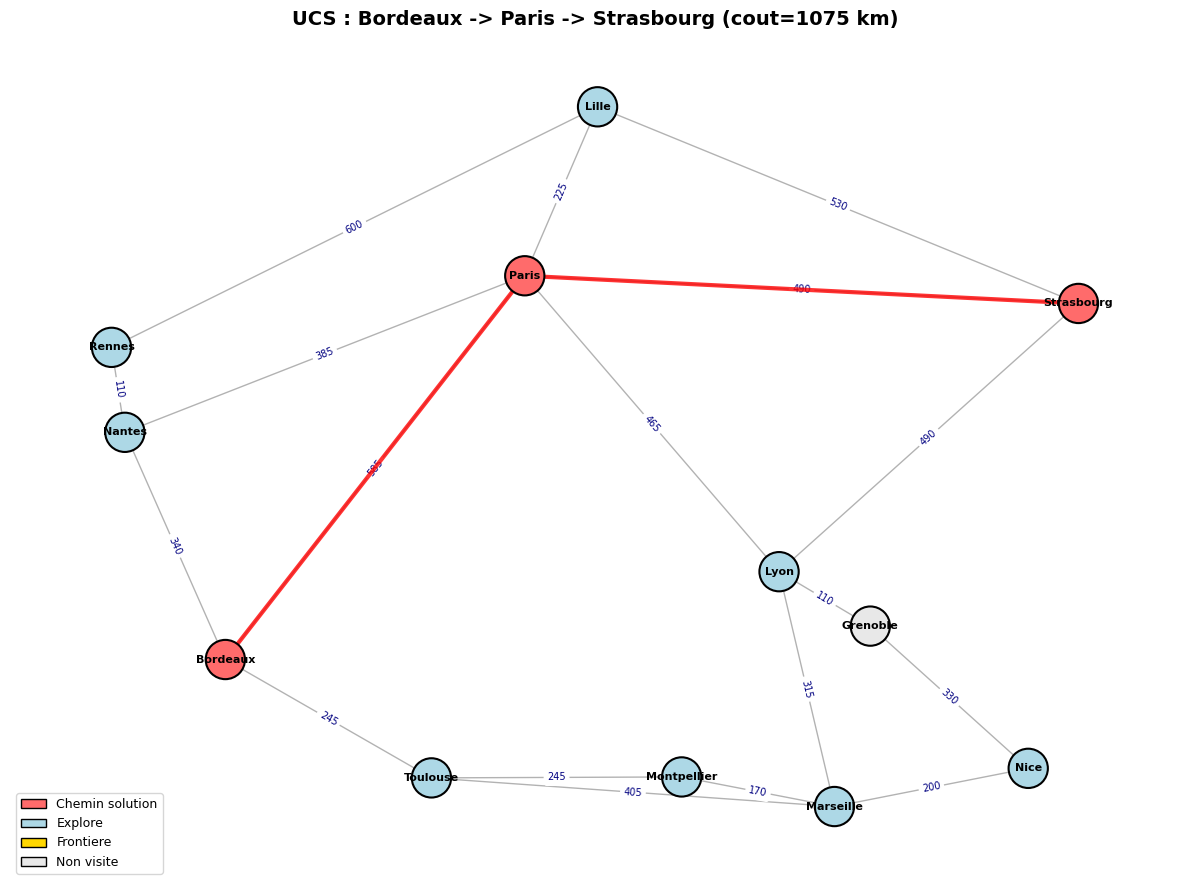
UCS      Bordeaux -> Paris -> Strasbourg              1075         10         31
IDDFS    Bordeaux -> Paris -> Strasbourg              1075          3          7

Rennes -> Nice
--------------------------------------------------------------------------------
Algo     Chemin                                       Cout   Explores    Generes
--------------------------------------------------------------------------------
BFS      Rennes -> Nantes -> Paris -> Lyon -...       1475          9         29
DFS      Rennes -> Lille -> Strasbourg -> Ly...       2060          5         14
UCS      Rennes -> Nantes -> Bordeaux -> Tou...       1300         11         34
IDDFS    Rennes -> Nantes -> Paris -> Lyon -...       1475         48        146

Lille -> Toulouse
--------------------------------------------------------------------------------
Algo     Chemin                                       Cout   Explores    Generes
--------------------------------------------------------------------------------
BFS      Lille -> Paris -> Bordeaux -> Toulouse       1055          7         22
DFS      Lille -> Strasbourg -> Lyon -> Gren...       2075          7         20
UCS      Lille -> Paris -> Bordeaux -> Toulouse       1055          9         29
IDDFS    Lille -> Paris -> Bordeaux -> Toulouse       1055         12         37

Nantes -> Marseille
--------------------------------------------------------------------------------
Algo     Chemin                                       Cout   Explores    Generes
--------------------------------------------------------------------------------
BFS      Nantes -> Paris -> Lyon -> Marseille         1165          5         15
DFS      Nantes -> Rennes -> Lille -> Strasb...       2370          7         19
UCS      Nantes -> Bordeaux -> Toulouse -> M...        990         10         30
IDDFS    Nantes -> Paris -> Lyon -> Marseille         1165          8         20

Interpretation - Comparaison experimentale

Observations :

Algorithme Trouve le chemin… Cout du chemin Memoire
BFS Le moins profond (min d’étapes) Pas forcement minimal en distance Elevee
DFS Le premier en profondeur Souvent sous-optimal Faible
UCS De cout minimal (distance minimale) Optimal Elevee
IDDFS Le moins profond (comme BFS) Optimal si couts uniformes Faible

Points cles : 1. UCS donne toujours le meilleur cout quand les distances varient 2. BFS et IDDFS donnent le même chemin (même profondeur), mais des couts différents de UCS 3. DFS peut trouver des chemins très longs et couteux 4. IDDFS explore plus de noeuds au total (overhead), mais utilise peu de memoire

# --- Tableau récapitulatif et graphique ---

# Tableau récapitulatif théorique
print("\nTableau récapitulatif des propriétés")
print("=" * 85)
print(f"{'Algorithme':<12} {'Complet?':<12} {'Optimal?':<15} "
      f"{'Temps':<18} {'Espace':<15} {'Frontiere':<10}")
print("-" * 85)
rows = [
    ('BFS',   'Oui',  'Oui*',  'O(b^d)',        'O(b^d)',        'FIFO'),
    ('DFS',   'Non',  'Non',   'O(b^m)',        'O(bm)',         'LIFO'),
    ('UCS',   'Oui',  'Oui',   'O(b^(1+C*/e))', 'O(b^(1+C*/e))', 'Priorite'),
    ('IDDFS', 'Oui',  'Oui*',  'O(b^d)',        'O(bd)',         'LIFO'),
]
for row in rows:
    print(f"{row[0]:<12} {row[1]:<12} {row[2]:<15} {row[3]:<18} {row[4]:<15} {row[5]:<10}")

print("\n* Optimal uniquement si tous les couts d'action sont identiques.")

Tableau récapitulatif des propriétés
=====================================================================================
Algorithme   Complet?     Optimal?        Temps              Espace          Frontiere 
-------------------------------------------------------------------------------------
BFS          Oui          Oui*            O(b^d)             O(b^d)          FIFO      
DFS          Non          Non             O(b^m)             O(bm)           LIFO      
UCS          Oui          Oui             O(b^(1+C*/e))      O(b^(1+C*/e))   Priorite  
IDDFS        Oui          Oui*            O(b^d)             O(bd)           LIFO      

* Optimal uniquement si tous les couts d'action sont identiques.

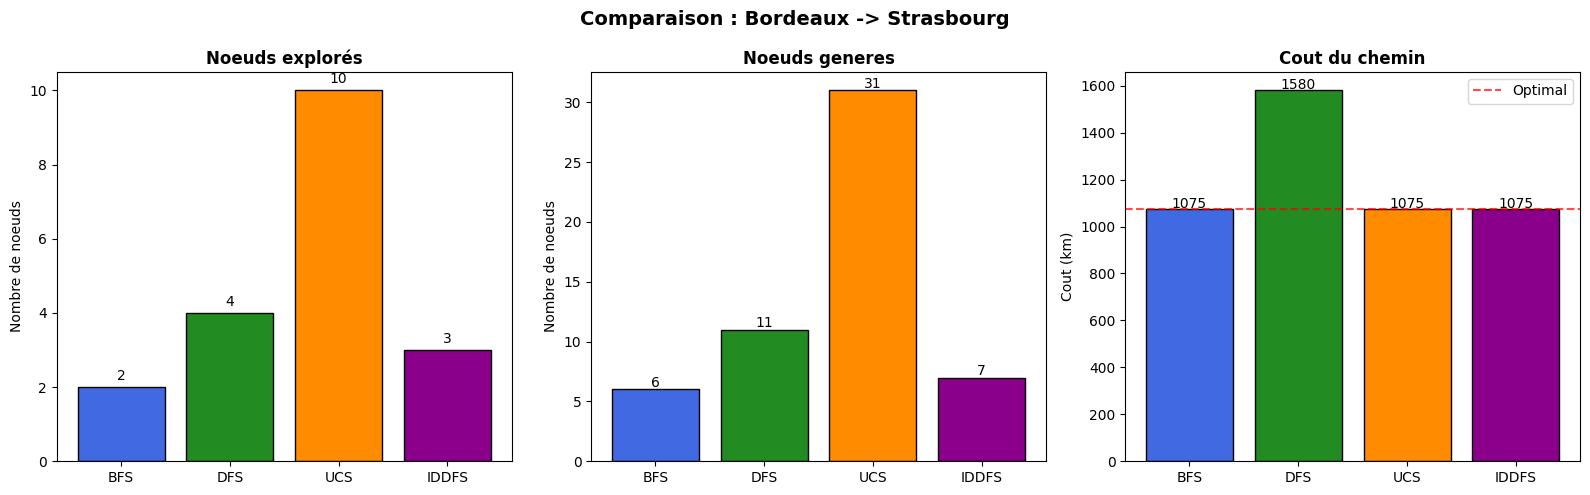
Visualisons maintenant ces résultats sous forme de graphiques en barres pour mieux comparer les performances.

# --- Graphique comparatif ---

# Utiliser le premier problème (Bordeaux -> Strasbourg) pour le graphique
_, _, results_bs = all_results[0]

algos = ['BFS', 'DFS', 'UCS', 'IDDFS']
expanded = [results_bs[a].nodes_expanded for a in algos]
generated = [results_bs[a].nodes_generated for a in algos]
costs = [results_bs[a].cost for a in algos]

fig, axes = plt.subplots(1, 3, figsize=(16, 5))

# Noeuds explorés
colors = ['#4169E1', '#228B22', '#FF8C00', '#8B008B']
axes[0].bar(algos, expanded, color=colors, edgecolor='black')
axes[0].set_ylabel('Nombre de noeuds')
axes[0].set_title('Noeuds explorés', fontweight='bold')
for i, v in enumerate(expanded):
    axes[0].text(i, v + 0.2, str(v), ha='center', fontsize=10)

# Noeuds generes
axes[1].bar(algos, generated, color=colors, edgecolor='black')
axes[1].set_ylabel('Nombre de noeuds')
axes[1].set_title('Noeuds generes', fontweight='bold')
for i, v in enumerate(generated):
    axes[1].text(i, v + 0.2, str(v), ha='center', fontsize=10)

# Cout de la solution
axes[2].bar(algos, costs, color=colors, edgecolor='black')
axes[2].set_ylabel('Cout (km)')
axes[2].set_title('Cout du chemin', fontweight='bold')
for i, v in enumerate(costs):
    axes[2].text(i, v + 5, f"{v:.0f}", ha='center', fontsize=10)

# Marquer le cout optimal
optimal_cost = min(costs)
axes[2].axhline(y=optimal_cost, color='red', linestyle='--', alpha=0.7, label='Optimal')
axes[2].legend()

plt.suptitle('Comparaison : Bordeaux -> Strasbourg', fontsize=14, fontweight='bold')
plt.tight_layout()
plt.show()

Interpretation - Graphiques comparatifs

Les trois graphiques montrent les compromis entre les algorithmes :

Critere Meilleur algorithme Explication
Noeuds explores DFS ou BFS (selon le graphe) DFS peut trouver vite si le but est “en profondeur”
Cout du chemin UCS Seul algorithme garantissant l’optimalite avec couts variables
Memoire DFS / IDDFS Complexite spatiale lineaire vs exponentielle

Synthese : - Si les couts sont uniformes et la memoire est limitee : utiliser IDDFS - Si les couts sont variables : utiliser UCS - Si on a assez de memoire et les couts sont uniformes : BFS est le plus simple - DFS est rarement le meilleur choix seul, mais il est utile comme sous-routine (dans IDDFS)

Exercice 3 : Comparaison experimentale personnalisee

Objectif : Comparez les 4 algorithmes sur un trajet de votre choix et analysez les résultats.

Choisissez un trajet dans le graphe france_graph qui met en evidence une différence notable entre les algorithmes (par exemple un trajet ou UCS trouve un chemin nettement moins couteux que BFS).

Consignes : 1. Choisissez un depart et une arrivee dans france_graph 2. Executez les 4 algorithmes (BFS, DFS, UCS, IDDFS) sur ce trajet 3. Affichez un tableau comparatif : chemin, cout, noeuds explores 4. Identifiez quel algorithme trouve le chemin optimal et pourquoi

Indices : - Un trajet long (4+ étapes) montrera mieux les différences - Comparez le cout BFS vs UCS pour voir l’impact des couts non uniformes - Utilisez SearchResult.display() pour afficher chaque résultat

# --- Exercice 3 : Comparaison experimentale personnalisee ---

# TODO étudiant : choisissez un depart et une arrivee
depart = None    # TODO etudiant : remplacer par une ville (ex: 'Grenoble')
arrivee = None   # TODO etudiant : remplacer par une ville (ex: 'Lille')

# TODO étudiant : instanciez le problème
# problem_custom = GraphProblem(depart, arrivee, france_graph)

# TODO étudiant : exécutez les 4 algorithmes
# Etape 1 : res_bfs = breadth_first_search(problem_custom)
# Etape 2 : res_dfs = depth_first_search(problem_custom)
# Etape 3 : res_ucs = uniform_cost_search(problem_custom)
# Etape 4 : res_iddfs = iterative_deepening_search(problem_custom)

# TODO étudiant : affichez un tableau comparatif
# Indice : utilisez result.display() pour chaque résultat

print("Exercice a completer")
Exercice a completer

8. Exemple guide

Exemple guide 1 : Trace manuelle de BFS

Considerez le graphe suivant (couts uniformes) :

        A
       / \
      B   C
     / \   \
    D   E   F
   /       / \
  G       H   I (but)

Question : Tracez l’exécution de BFS depuis A vers I. A chaque étape, indiquez le contenu de la frontiere et l’ensemble des etats explores.

Indice : Utilisez le code ci-dessous pour verifier votre reponse.

Initialisation

  • Frontière : [A]
  • Explorés : Aucun

étape 1 : Expansion de A A génère B et C - Frontière : [B,C] - Explorés : {A} étape 2 : Expansion de B B génère D et E (A est ignoré car déjà exploré) - Frontière : [C, D, E] - Explorés : {A,B} étape 3 : Expansion de C C génère F (A ignoré) - Frontière [D, E, F] - Explorés : {A,B,C} étape 4 : Expansion de D D génère G - Frontière : [E, F, G] - Explorés : {A,B,C,D} étape 5 : Expansion de E E ne génère aucun nouvel état - Frontière : [F, G] - Explorés : {A,B,C,D,E} étape 6 : Expansion de F F génère H et I, I est l’objectif donc arrêt de la recherche. - Frontière : [G, H, I] - Explorés : {A,B,C,D,E,F}

Le BFS trouve le but I via le chemin A -> C -> F -> I La solution est optimale car BFS explore par niveaux (coûts uniformes)

# --- Exemple guide 1 : Trace BFS sur un petit graphe ---

exercise_graph = {
    'A': {'B': 1, 'C': 1},
    'B': {'A': 1, 'D': 1, 'E': 1},
    'C': {'A': 1, 'F': 1},
    'D': {'B': 1, 'G': 1},
    'E': {'B': 1},
    'F': {'C': 1, 'H': 1, 'I': 1},
    'G': {'D': 1},
    'H': {'F': 1},
    'I': {'F': 1},
}

ex1_problem = GraphProblem('A', 'I', exercise_graph)

print("Exemple guide 1 - Trace BFS de A a I")
print("=" * 50)
ex1_result = breadth_first_search(ex1_problem, verbose=True)
ex1_result.display()
Exemple guide 1 - Trace BFS de A a I
==================================================
  Explore: A               | Frontiere: []
  Explore: B               | Frontiere: ['C']
  Explore: C               | Frontiere: ['D', 'E']
  Explore: D               | Frontiere: ['E', 'F']
  Explore: E               | Frontiere: ['F', 'G']
  Explore: F               | Frontiere: ['G']

--- BFS ---
  Chemin     : A -> C -> F -> I
  Cout total : 3
  Longueur   : 3 etapes
  Noeuds explores  : 6
  Noeuds generes   : 13
  Frontiere max    : 3
  Temps            : 0.07 ms

Exemple guide 2 : Quand DFS est meilleur que BFS

Question : Donnez un exemple de problème ou DFS explore strictement moins de noeuds que BFS pour trouver la solution. Expliquez pourquoi.

Indice : Pensez a un arbre ou la solution est a grande profondeur mais accessible par la première branche.

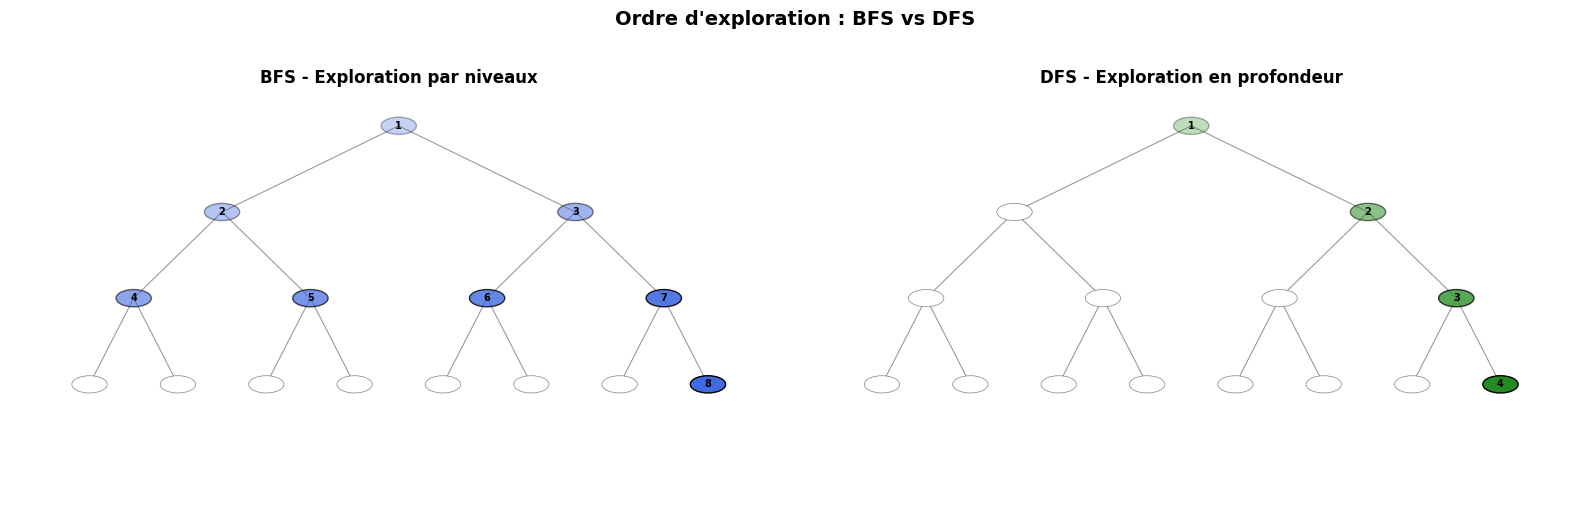
DFS peut être meilleur que BFS dans un arbre très profond et peu large, où la solution se trouve très profondément dans la première branche explorée. Par exemple : profondeur de 8, facteur de branchement de 3, avec un objectif placé sur la première branche gauche.

Le BFS explore tous les noeuds par niveau, donc on explore toutes les branches proches du niveau 0, 1, 2 etc. L’exploration devient exponentielle en largeur et beaucoup de noeuds sont visités avant d’atteindre la profondeur 8.

Le DFS, quant à lui, va explorer une branche complète avant de revenir en arrière et ici il choisi directement la branche gauche. Il descend directement jusqu’à la solution, ce qui implique que très peu de noeuds sont explorés.

DFS est meilleur quand la solution est profonde et bien orentiée dans l’ordre d’exploration, tandis que BFS souffre de l’explosion combinatoire en largeur.

# --- Exemple guide 2 : Construction d'un cas favorable a DFS ---
#
# Objectif : construire un problème de graphe ou DFS explore
# strictement moins de noeuds que BFS.
#
# Indices :
#   1. Creez un arbre regulier avec `depth` et `branching` eleves
#      (ex : depth=8, branching=3).
#   2. Placez le but sur la PREMIERE branche exploree par DFS
#      (la branche "la plus a gauche").
#   3. Comparez le nombre de noeuds explorés par breadth_first_search
#      et depth_first_search sur ce problème.
#
# A completer :

# deep_graph = {}
# depth = ?
# branching = ?

deep_graph = {}
depth = 8
branching = 3

# Exemple guide: construire l'arbre dans deep_graph
for i in range(depth):
    for j in range(branching**i):
        node = f"L{i}_{j}"
        deep_graph[node] = {}
        if i < depth - 1:
            for k in reversed(range(branching)):
                fils = f"L{i+1}_{j*branching + k}"
                deep_graph[node][fils] = 1


# Exemple guide: définir goal_dfs (la feuille atteinte par la première branche)
# goal_dfs = ...
goal_dfs = f"L{depth - 1}_0"

# Exemple guide: instancier GraphProblem('L0_0', goal_dfs, deep_graph)
# problem_deep = ...
problem_deep = GraphProblem('L0_0', goal_dfs, deep_graph)

# Exemple guide: executer breadth_first_search et depth_first_search
# result_bfs_deep = ...
# result_dfs_deep = ...
result_bfs_deep = breadth_first_search(problem_deep)
result_dfs_deep = depth_first_search(problem_deep)


# Exemple guide: comparer les compteurs de noeuds explorés (attribut .counts
# ou count de result.display() selon l'implémentation utilisée).
print("\nComparaison BFS vs DFS sur le cas profond")
print("-" * 50)
print(f"BFS : {result_bfs_deep.nodes_expanded} noeuds explorés, "
      f"chemin de longueur {len(result_bfs_deep.path)-1}")
print(f"DFS : {result_dfs_deep.nodes_expanded} noeuds explorés, "
        f"chemin de longueur {len(result_dfs_deep.path)-1}")

print("Exemple guide 2 : construction et comparaison terminees.")

Comparaison BFS vs DFS sur le cas profond
--------------------------------------------------
BFS : 1093 noeuds explorés, chemin de longueur 7
DFS : 7 noeuds explorés, chemin de longueur 7
Exemple guide 2 : construction et comparaison terminees.

Exemple 3 : Recherche bidirectionnelle (BFS)

Principe : lancez simultanement un BFS depuis l’etat initial et un BFS depuis l’etat but. Les deux recherches s’arretent quand leurs frontieres se rencontrent.

Avantage théorique : complexite en \(O(b^{d/2})\) au lieu de \(O(b^d)\).

# --- Exemple 3 : BFS bidirectionnel ---

def bidirectional_bfs(problem, graph, verbose=False):
    """
    Recherche bidirectionnelle BFS.
    Lance un BFS depuis initial et un BFS depuis goal,
    et s'arrete quand les frontieres se rencontrent.
    """
    start_time = time.perf_counter()

    # Initialiser les structures pour BFS avant et arrière
    frontier_fwd = deque([problem.initial])
    parent_fwd = {problem.initial: None}
    frontier_bwd = deque([problem.goal])
    parent_bwd = {problem.goal: None}
    expanded_nodes = 0
    central_point = None

    # Boucle principale : alterner expansion avant/arrière
    # Detecter le point de rencontre (noeud present dans les deux parent dicts)
    while frontier_fwd and frontier_bwd:
        if frontier_fwd:
            current_fwd = frontier_fwd.popleft()
            expanded_nodes += 1

            for i in graph.get(current_fwd, {}):
                if i not in parent_fwd:
                    parent_fwd[i] = current_fwd
                    frontier_fwd.append(i)
                    if i in parent_bwd:
                        central_point = i
                        break
            if central_point:
                break

        if frontier_bwd:
            current_bwd = frontier_bwd.popleft()
            expanded_nodes += 1

            for j in graph.get(current_bwd, {}):
                if j not in parent_bwd:
                    parent_bwd[j] = current_bwd
                    frontier_bwd.append(j)
                    if j in parent_fwd:
                        central_point = j
                        break
            if central_point:
                break
    elapsed = (time.perf_counter() - start_time) * 1000
    if central_point is None:
        return None

    # Reconstruire le chemin complet via les deux parent dicts
    path = []
    node = central_point
    while node is not None:
        path.append(node)
        node = parent_fwd[node]
    path.reverse()

    path2 = []
    node = parent_bwd[central_point]
    while node is not None:
        path2.append(node)
        node = parent_bwd[node]
    global_path = path + path2

    total_cost = sum(graph[global_path[i]][global_path[i+1]] for i in range(len(global_path)-1))
    if verbose:
        print(f"point de rencontre: {central_point}")
        print(f"chemin trouve: {' -> '.join(global_path)} (cout={total_cost})")
        print(f"noeuds explorés: {expanded_nodes} en {elapsed:.2f} ms")
    return global_path, total_cost, expanded_nodes

print("BFS bidirectionnel : Bordeaux -> Strasbourg")
print("=" * 50)
bi_result = bidirectional_bfs(problem_bs, france_graph, verbose=True)

# Comparer avec BFS classique
print("\nComparaison :")
print(f"  BFS classique     : {result_bfs.nodes_expanded} noeuds explorés")
if bi_result:
    print(f"  BFS bidirectionnel: {bi_result[2]} noeuds explorés")
BFS bidirectionnel : Bordeaux -> Strasbourg
==================================================
point de rencontre: Paris
chemin trouve: Bordeaux -> Paris -> Strasbourg (cout=1075)
noeuds explorés: 2 en 0.02 ms

Comparaison :
  BFS classique     : 2 noeuds explorés
  BFS bidirectionnel: 2 noeuds explorés

Exemple guide 3 : IDS avec suivi de memoire

Question : Implementez une variante de la recherche en profondeur iteree (IDS) qui suit en detail la consommation memoire a chaque itération.

Objectifs : 1. Ecrire une fonction ids_with_memory() qui enregistre a chaque profondeur : le nombre de noeuds explores, generes, et la taille maximale de la pile d’appels 2. Comparer l’evolution de la memoire de IDS avec celle de BFS sur le problème Rennes -> Nice (le plus profond du notebook)

Contexte : IDS est reconnu pour sa faible empreinte memoire (\(O(bd)\)) contre \(O(b^d)\) pour BFS. Cet exercice vous demande de le verifier experimentalement.

# --- Exemple guide 3 : IDS avec suivi de mémoire ---
#
# Objectif : implémentez iterative_deepening_search avec un suivi détaillé
# de la mémoire utilisée a chaque itération.
#
# 1. Completez la fonction ids_with_memory() qui : 
#    - Execute des DLS avec des profondeurs croissantes (0, 1, 2, ...)
#    - A chaque itération, enregistre :
#      * La profondeur limite
#      * Le nombre de noeuds explorés
#      * Le nombre de noeuds generes
#      * La taille maximale de la pile (mémoire)
#    - Retourne un objet SearchResult et un dictionnaire memory_log
#
# 2. Comparez la consommation mémoire de IDS avec celle de BFS
#    sur le problème Rennes -> Nice (le plus profond du notebook).
#
# Indices :
#   - Utilisez depth_limited_search comme sous-routine
#   - Pour mesurer la mémoire, comptez le nombre d'éléments dans la pile
#     récursive (profondeur d'appel = mémoire utilisée)
#   - Un dictionnaire memory_log peut contenir : {"depth": [...], "memory": [...]}
#

def ids_with_memory(problem, max_depth=50, verbose=False):
    """
    IDS avec suivi detaille de la memoire.
    
    Retourne: (SearchResult, memory_log)
        memory_log = {"depth": [...], "expanded": [...], "memory": [...]}
    """
    # Exemple guide: implémentation de cette fonction
    memory_log = {
        "depth": [],
        "expanded": [],
        "generated": [],
        "memory": []
    }

    total_expanded = 0
    total_generated = 0

    def dls(node, depth, limit, visited):
        nonlocal expanded, generated, max_memory

        max_memory = max(max_memory, depth)

        if problem.goal_test(node):
            return [node]

        if depth == limit:
            return None

        expanded += 1

        for child in problem.actions(node):
            generated += 1
            if child not in visited:
                visited.add(child)
                path = dls(child, depth + 1, limit, visited)
                if path:
                    return [node] + path

        return None

    for limit in range(max_depth + 1):
        expanded = 0
        generated = 0
        max_memory = 0

        visited = set([problem.initial])

        path = dls(problem.initial, 0, limit, visited)

        memory_log["depth"].append(limit)
        memory_log["expanded"].append(expanded)
        memory_log["generated"].append(generated)
        memory_log["memory"].append(max_memory)

        total_expanded += expanded
        total_generated += generated

        if verbose:
            print(f"Profondeur {limit} | expanded={expanded} | memory={max_memory}")

        if path:
            # Création d'un résultat simple compatible
            class Result:
                def __init__(self, path, expanded):
                    self.path = path
                    self.nodes_expanded = expanded

            return Result(path, total_expanded), memory_log

    return None, memory_log
# Exemple guide: exécutez ids_with_memory sur le problème Rennes -> Nice
# problem_rn = GraphProblem('Rennes', 'Nice', france_graph)
# result_ids, mem_log = ids_with_memory(problem_rn, verbose=True)

# Exemple guide: affichez un graphique comparant la mémoire de IDS vs BFS
# avec plt.plot(mem_log["depth"], mem_log["memory"], label="IDS")

print("Exemple guide 3 a completer")
Exemple guide 3 a completer

Algorithme supplementaire

Implementation complementaire des méthodes de recherche non informee.

problem_rn = GraphProblem('Rennes', 'Nice', france_graph)

result_ids, mem_log = ids_with_memory(problem_rn, verbose=True)

print("\nIDS terminé")
print(f"Chemin : {result_ids.path}")
print(f"Noeuds explorés : {result_ids.nodes_expanded}")
Profondeur 0 | expanded=0 | memory=0
Profondeur 1 | expanded=1 | memory=1
Profondeur 2 | expanded=3 | memory=2
Profondeur 3 | expanded=3 | memory=3
Profondeur 4 | expanded=6 | memory=4
Profondeur 5 | expanded=5 | memory=5

IDS terminé
Chemin : ['Rennes', 'Nantes', 'Paris', 'Lyon', 'Marseille', 'Nice']
Noeuds explorés : 18

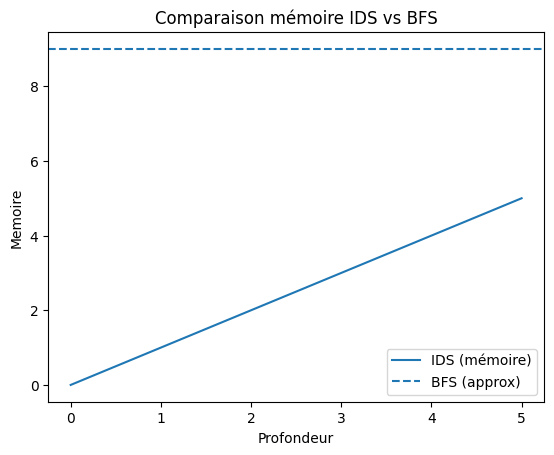
IDS explore en profondeur limitée croissante, la mémoire utilisée est équivalente à la profondeur courante, avec une faible empreinte mémoire. Ici, on a une mémoire max = 5 et une croissance linéaire.

Pour le BFS, on stocke tous les noeuds d’un niveau et la mémoire grandit exponentiellement en fonction de la profondeur.

import matplotlib.pyplot as plt

# BFS pour comparaison
result_bfs = breadth_first_search(problem_rn)

# Courbe IDS
plt.plot(mem_log["depth"], mem_log["memory"], label="IDS (mémoire)")

# Ligne BFS (constante)
plt.axhline(y=result_bfs.nodes_expanded, linestyle='--', label="BFS (approx)")

plt.xlabel("Profondeur")
plt.ylabel("Memoire")
plt.title("Comparaison mémoire IDS vs BFS")
plt.legend()
plt.show()

Exercice 4 (capstone) : implementer la recherche bidirectionnelle

La recherche bidirectionnelle est le seul grand algorithme de recherche non informee demontre plus haut (Exemple 3) sans que vous l’ayez implemente vous-meme. L’idee : lancer deux BFS en parallele, l’une depuis la source, l’autre depuis le but (en parcourant les aretes a l’envers), et s’arreter des que leurs frontieres se rencontrent.

L’interet est asymptotique : si b est le facteur de branchement et d la profondeur de la solution, une BFS classique developpe de l’ordre de O(b^d) noeuds, alors que la version bidirectionnelle n’en developpe que O(2 * b^(d/2)) — un gain quadratique qui devient decisif sur les graphes profonds.

Objectif. Re-implementer la BFS bidirectionnelle from scratch sur le graphe des villes, choisir un couple (source, but) eloigne, et mesurer le nombre de noeuds expandus par rapport a la BFS classique pour quantifier le gain.

  • Indice 1 : ecrire une fonction bfs_depuis(problem, depart, max_expansions) qui renvoie un dict explores : noeud -> parent apres max_expansions developpements.
  • Indice 2 : inverser le graphe pour la BFS partant du but (construire un dict predecesseurs : noeud -> liste de predecesseurs a partir de problem.graph).
  • Indice 3 : a chaque etape, verifier l’intersection entre les deux ensembles explores ; quand un noeud appartient aux deux, reconstruire le chemin en remontant les parents des deux cotes. Comparer le compte total d’expansions (somme des deux moities) au compte d’une BFS classique sur le meme couple.
# Exercice 4 (capstone) : implementer la recherche bidirectionnelle (BFS)
# L'Exemple 3 ci-dessus MONTRE une recherche bidirectionnelle ; a votre tour
# de l'implementer from scratch sur un nouveau couple (source, but).
# Etape 1 : ecrire bfs_depuis(problem, depart) qui renvoie la frontiere
#           exploree (un dict noeud -> parent) apres K expansions.
# Etape 2 : lancer deux BFS simultanees, l'une depuis la source, l'autre
#           depuis le but (en inversant les aretes), jusqu'a intersection.
# Etape 3 : comparer le nombre de noeuds expands par la BFS bidirectionnelle
#           vs la BFS classique sur le meme couple ; commenter le gain.
# Indice : si b est le facteur de branchement et d la profondeur de la
#          solution, la BFS classique developpe ~O(b^d) noeuds ; la
#          bidirectionnelle ~O(2*b^(d/2)), soit un gain quadratique.
resultat = None  # TODO etudiant
print("Exercice a completer : implementer la BFS bidirectionnelle.")
Exercice a completer : implementer la BFS bidirectionnelle.

9. Resume

Concepts cles

Concept Definition
Recherche non informee Exploration sans connaissance du domaine (pas d’heuristique)
Frontiere Ensemble des noeuds generes mais pas encore explores
Ensemble explore Noeuds déjà etendus (graph-search)
Completude Garantie de trouver une solution si elle existe
Optimalite Garantie de trouver la solution de cout minimal

Tableau recapitulatif

Algorithme Complet? Optimal? Temps Espace Frontiere
BFS Oui Oui* \(O(b^d)\) \(O(b^d)\) FIFO
DFS Non Non \(O(b^m)\) \(O(bm)\) LIFO
UCS Oui Oui \(O(b^{1+\lfloor C^*/\epsilon \rfloor})\) \(O(b^{1+\lfloor C^*/\epsilon \rfloor})\) Priorite
IDDFS Oui Oui* \(O(b^d)\) \(O(bd)\) LIFO

* Optimal uniquement si tous les couts d’action sont identiques.

Guide de choix

Situation Algorithme recommande
Couts uniformes, memoire limitee IDDFS
Couts uniformes, memoire abondante BFS
Couts variables UCS
Memoire très limitee, pas besoin d’optimalite DFS
Heuristique disponible Voir Search-3 (A*, Greedy)

Pour aller plus loin

Le prochain notebook Search-03-Informed introduit les algorithmes de recherche informee qui exploitent une heuristique \(h(n)\) pour guider la recherche vers le but. Ces algorithmes (Greedy Best-First, A*) sont généralement beaucoup plus efficaces que les approches non informees.

Reference : Russell & Norvig, Artificial Intelligence: A Modern Approach, Chapitre 3.4 - Uninformed Search stratégies.


Navigation : << Espaces d’etats | Index | Recherche informee >>

Resume et perspectives

Ce notebook a couvert les quatre algorithmes fondamentaux de recherche non informee – BFS, DFS, UCS et IDDFS – en mettant en evidence le rôle central de la structure de la frontiere (FIFO, LIFO ou file de priorite) dans la definition de chaque stratégie. Vous avez pu observer experimentalement que seul UCS garantit l’optimalite en presence de couts variables, tandis que IDDFS offre le meilleur compromis completite-optimalite-memoire quand les couts sont uniformes.

Ces méthodes aveugles posent les bases necessaires pour aborder la recherche informee (notebook Search-03-Informed), ou une heuristique \(h(n)\) permettra de guider l’exploration et de reduire drastiquement le nombre de noeuds explores. Le passage de UCS a A* sera alors naturel : il s’agit simplement d’ajouter l’heuristique au cout déjà accumule.

References academiques

  • Moore, E.F. (1959). The shortest path through a maze. Proc. Int. Symp. Theory of Switching.
  • Tarjan, R. (1972). Depth-first search and linear graph algorithms. SIAM Journal on Computing 1(2):146-160.
  • Dijkstra, E.W. (1959). A note on two problems in connexion with graphs. Numerische Mathematik 1:269-271.
  • Korf, R.E. (1985). Depth-first iterative-deepening: an optimal admissible tree search. Artificial Intelligence 27(1):97-109.
  • Russell, S. & Norvig, P. (2020). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
Retour au sommet