<< Sommaire QC | Précédent : QC-Py-30-LSTM-Training << | Suivant : QC-Py-32-RL-DQN-Trading >>

QC-Py-31 - Transformer Encoder Multi-Asset (GPU)

Module : Machine Learning pour le Trading - Modèles Transformer
Pre-requis : QC-Py-30 LSTM Training
Duree estimee : 45 minutes

Objectifs d’apprentissage

A la fin de ce notebook, vous saurez :

  1. Implementer un encodeur Transformer natif (PyTorch) pour les series temporelles financieres
  2. Integrer des features macro (VIX, courbe des taux) dans le modèle
  3. Comprendre le mécanisme d’auto-attention multi-tete applique aux marches
  4. Comparer les performances Transformer vs LSTM (QC-Py-30)
  5. Deployer le modèle dans une stratégie QuantConnect

Prerequis

  • Notebook QC-Py-30 LSTM Training complete
  • Comprehension de PyTorch (tenseurs, modules, entrainement)
  • GPU recommande (CUDA) mais CPU possible

Structure du notebook

Section Sujet Duree
1 Configuration PyTorch et GPU 3 min
2 Chargement des données (30 stocks + macro) 5 min
3 Feature engineering avec features macro 5 min
4 Split temporel et normalisation 3 min
5 Modèle Transformer Encoder 5 min
6 Entrainement GPU 8 min
7 Courbes d’apprentissage 2 min
8 Evaluation sur le set de test 2 min
9 Visualisation des predictions 2 min
10 Visualisation de l’attention 3 min
11 Backtest simplifie 3 min
12 Sauvegarde du modèle 2 min
13 Integration QuantConnect Cloud 3 min
14 Resume et conclusions 2 min

[REFERENCE QC Cloud] Ce notebook illustre du code QuantConnect a executer dans l’IDE Cloud (https://www.quantconnect.com/research). L’environnement local ne dispose pas de QuantBook ni de l’historical data feed. Pour executer : cloner le projet QC associe, ouvrir research.ipynb, executer cellule par cellule.


Mode d’emploi : Ce notebook a deux parties : 1. Sections analyse/ML (pandas, sklearn, matplotlib) : executables en Jupyter local 2. Sections integration QC (classes QCAlgorithm) : code de reference a copier dans main.py de votre projet QC Lab

Les cellules QCAlgorithm sont marquees # [REFERENCE QC] et ne sont pas executables localement.


Section 1 : Configuration PyTorch et GPU

Pourquoi le Transformer pour la finance ?

Le mécanisme d’auto-attention du Transformer presente des avantages spécifiques pour les series temporelles financieres :

Avantage Description
Attention globale Chaque timestep peut directement se referer a n’importe quel autre timestep
Parallelisme Contrairement aux LSTM, tous les timesteps sont traites en parallele
Interpretabilite Les poids d’attention revelent quelles periodes historiques influencent la prediction
Multi-tete Chaque tete peut capturer un type de dépendance différent (tendance, volatilite, correlation)

Architecture cible

Input [batch, seq_len, features]
         |
    [Input Projection] -> d_model=256
         |
    [Positional Encoding] -> sinusoidal
         |
    [TransformerEncoder x 4 layers]
    - MultiHead Attention (nhead=8)
    - FeedForward (dim=1024)
    - LayerNorm + Residual
         |
    [Global Average Pooling]
         |
    +------->[Regression Head] -> forward return
    |
    +------->[Classification Head] -> direction (up/down)

Le modèle utilise nn.TransformerEncoder et nn.TransformerEncoderLayer de PyTorch natif, avec un encodage positionnel sinusooidal classique.

# Imports standards
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from datetime import datetime, timedelta
import warnings
import time
import math
import os
warnings.filterwarnings('ignore')

# Configuration matplotlib
plt.style.use('seaborn-v0_8-darkgrid')
%matplotlib inline

# PyTorch -- le determinisme cuBLAS se pose AVANT l'import : la variable est
# lue a l'initialisation du contexte CUDA, la poser plus bas ne l'atteint pas.
os.environ.setdefault('CUBLAS_WORKSPACE_CONFIG', ':4096:8')
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import Dataset, DataLoader

# Sklearn
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import mean_squared_error, mean_absolute_error

# Device
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

# Seed pour reproductibilite
torch.manual_seed(42)
np.random.seed(42)

# Determinisme GPU (issue #16795) : une graine seule ne fixe rien -- cuDNN
# choisit ses algorithmes de facon non deterministe par defaut.
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False
torch.use_deterministic_algorithms(True)

print(f"PyTorch version: {torch.__version__}")
print(f"Device: {device}")
if torch.cuda.is_available():
    print(f"GPU: {torch.cuda.get_device_name(0)}")
    print(f"VRAM: {torch.cuda.get_device_properties(0).total_memory / 1e9:.1f} GB")

# --- Hyperparametres ---
SEQ_LEN = 60          # Fenetre d'entree (3 mois de trading)
PRED_LEN = 5           # Horizon de prediction (1 semaine)
D_MODEL = 256          # Dimension du Transformer
NHEAD = 8              # Nombre de tetes d'attention
NUM_LAYERS = 4         # Couches de l'encodeur
DIM_FEEDFORWARD = 1024 # Dimension FFN
BATCH_SIZE = 32        # Taille de batch (thermal-safe pour GPU laptop)
EPOCHS = 25            # Nombre d'epochs (reduit pour securite thermique)
PATIENCE = 7           # Patience pour early stopping
MIN_EPOCHS = 15        # Plancher anti-coupe precoce (controle 25/09 : early stop a 9 puis 17 epochs sur main, les deux degenes)
WARMUP_EPOCHS = 3      # Warmup LR avant cosine (controle 26/09 : sans warmup, l'attention collapse a l'uniforme)
LR = 0.0005            # Learning rate
FORCE_RETRAIN = os.environ.get('QC31_FORCE_RETRAIN', '0') == '1'  # ignorer checkpoint/.pt et entrainer depuis zero (#17516)
DROPOUT = 0.1          # Dropout
TRAIN_RATIO = 0.70     # Split train
VAL_RATIO = 0.15       # Split validation
N_STOCKS = 30          # Nombre d'actions (spec C2.2)

print(f"\nHyperparametres:")
print(f"  Sequence: {SEQ_LEN} jours -> Prediction: {PRED_LEN} jours")
print(f"  Transformer: d_model={D_MODEL}, nhead={NHEAD}, layers={NUM_LAYERS}")
print(f"  FFN dim: {DIM_FEEDFORWARD}, Dropout: {DROPOUT}")
print(f"  Batch size: {BATCH_SIZE}, Epochs: {EPOCHS}, LR: {LR}")
print(f"  Early stopping: patience={PATIENCE}, plancher={MIN_EPOCHS} epochs")
print(f"  Warmup LR: {WARMUP_EPOCHS} epochs lineaires puis cosine")
PyTorch version: 2.6.0+cu124
Device: cuda
GPU: NVIDIA GeForce RTX 3070 Laptop GPU
VRAM: 8.6 GB

Hyperparametres:
  Sequence: 60 jours -> Prediction: 5 jours
  Transformer: d_model=256, nhead=8, layers=4
  FFN dim: 1024, Dropout: 0.1
  Batch size: 32, Epochs: 25, LR: 0.0005
  Early stopping: patience=7, plancher=15 epochs
  Warmup LR: 3 epochs lineaires puis cosine

Interpretation : Configuration

La cellule configure l’environnement d’entrainement avec les paramètres cles :

Paramètre Valeur Justification
SEQ_LEN 60 Environ 3 mois de trading, capture les tendances a moyen terme
PRED_LEN 5 1 semaine de prediction, equilibre precision et horizon
D_MODEL 256 Dimension suffisante pour 30+ features sans bottleneck
NHEAD 8 256/8 = 32 par tete, permet de capturer différentes correlations
NUM_LAYERS 4 Profondeur suffisante sans surparametrisation
BATCH_SIZE 32 Thermal-safe pour GPU laptop (evite le throttling)
EPOCHS 25 Reduit par rapport au LSTM pour limiter le temps GPU

Points cles : 1. Le GPU accelere considerablement l’entrainement du Transformer (opérations matricielles parallles) 2. Le batch size de 32 est un compromis entre stabilite du gradient et securite thermique 3. Le learning rate 0.0005 est plus faible que le LSTM car le Transformer est plus sensible au LR


Section 2 : Chargement des données (30 stocks + macro)

Approche multi-actifs

Nous telechargeons les données de 30 actions SP500 (top par capitalisation boursiere) ainsi que des indicateurs macroeconomiques :

  • VIX (^VIX) : Index de volatilite implicite, indicateur de peur du marche
  • Taux 10 ans (^TNX) : Rendement des Treasury 10 ans
  • Taux 30 ans (^TYX) : Rendement des Treasury 30 ans

Le spread 10Y-2Y sera calcule comme proxy de la courbe des taux (un spread negatif = inversion de courbe, signal de recession).

Ancre savante – Whaley, R.E. (2000), The Investor Fear Gauge, Journal of Portfolio Management 26(3):12-17. (VIX = volatilité implicite, indicateur de peur du marché.) Ancre savante – Estrella, A. & Hardouvelis, G.A. (1991), The Term Structure as a Predictor of Real Economic Activity, Journal of Finance 46(2):555-576. (spread 10Y-2Y comme signal de recession.)

# Telechargement des donnees via yfinance
import yfinance as yf

# 30 top SP500 par capitalisation boursiere
TICKERS_30 = [
    'AAPL', 'MSFT', 'GOOGL', 'AMZN', 'NVDA', 'META', 'TSLA', 'BRK-B',
    'JPM', 'V', 'UNH', 'JNJ', 'WMT', 'XOM', 'MA', 'PG', 'HD', 'CVX',
    'MRK', 'ABBV', 'AVGO', 'KO', 'PEP', 'COST', 'ADBE', 'CRM', 'AMD',
    'NFLX', 'TMO', 'CSCO'
]

# Indices macro
MACRO_TICKERS = ['^VIX', '^TNX', '^TYX']

# Periode d'etude
START = '2014-01-01'
END = '2025-01-01'

print(f"Telechargement de {len(TICKERS_30)} actions + {len(MACRO_TICKERS)} indicateurs macro...")
print(f"Periode: {START} a {END}")

# Telecharger toutes les donnees en une seule requete
raw = yf.download(
    TICKERS_30 + MACRO_TICKERS,
    start=START, end=END,
    auto_adjust=True
)

print(f"\nDonnees telechargees: {raw.shape}")
print(f"Colonnes (niveaux): {[str(c) for c in raw.columns[:5]]}...")

# Extraire les prix de cloture (gestion MultiIndex yfinance >=0.2.x)
if isinstance(raw.columns, pd.MultiIndex):
    close_all = raw['Close']
else:
    close_all = raw[['Close']]

# Verifier les donnees manquantes
print(f"\nForme du DataFrame Close: {close_all.shape}")
print(f"Colonnes disponibles: {len(close_all.columns)}")

# Compter les NaN par colonne
nan_counts = close_all.isna().sum()
if nan_counts.sum() > 0:
    print(f"\nColonnes avec NaN:")
    for col, count in nan_counts[nan_counts > 0].items():
        print(f"  {col}: {count} NaN ({count/len(close_all)*100:.1f}%)")

# Remplir les NaN par forward fill puis backward fill
close_all = close_all.ffill().bfill()

print(f"\nDonnees nettoyees: {close_all.shape}")
print(f"NaN restants: {close_all.isna().sum().sum()}")
print(f"\nApercu des 5 premieres lignes:")
print(close_all[TICKERS_30[:5]].head())
Telechargement de 30 actions + 3 indicateurs macro...
Periode: 2014-01-01 a 2025-01-01

Donnees telechargees: (2768, 165)
Colonnes (niveaux): ["('Close', 'AAPL')", "('Close', 'ABBV')", "('Close', 'ADBE')", "('Close', 'AMD')", "('Close', 'AMZN')"]...

Forme du DataFrame Close: (2768, 33)
Colonnes disponibles: 33

Colonnes avec NaN:
  ^TNX: 1 NaN (0.0%)
  ^TYX: 1 NaN (0.0%)

Donnees nettoyees: (2768, 33)
NaN restants: 0

Apercu des 5 premieres lignes:
Ticker           AAPL       MSFT      GOOGL       AMZN      NVDA
Date                                                            
2014-01-02  17.110128  30.636770  27.593285  19.898500  0.372991
2014-01-03  16.734295  30.430651  27.391998  19.822001  0.368523
2014-01-06  16.825539  29.787582  27.697403  19.681499  0.373462
2014-01-07  16.705212  30.018427  28.231359  19.901501  0.379576
2014-01-08  16.811003  29.482540  28.290108  20.096001  0.384750

Interpretation : Chargement des données

Le telechargement recupere plus de 10 ans de données pour 30 actions et 3 indicateurs macro.

Aspect Valeur Signification
Actions 30 tickers SP500 Couverture large du marche US
Macro VIX, TNX, TYX Sentiment et taux directeurs
Periode 2014-2025 Plus de 10 ans, incluant crises majeures
Frequence Quotidienne Adapted au style swing/position trading

Points cles : 1. Les données sont nettoyees via forward-fill puis backward-fill pour gerer les jours de non-trading 2. Le VIX est un indicateur avance de volatilite – les pics de VIX précédent souvent les baisses de marche 3. Le spread de taux (10Y-30Y) contient de l’information sur les anticipations de croissance 4. La gestion du MultiIndex yfinance (version >= 0.2.x) necessite un acces spécifique au niveau ‘Close’


Section 3 : Feature engineering avec features macro

Features par action vs features macro

Nous distinguons deux types de features :

Type Features Partage
Par action ret_1d, ret_5d, ret_20d, vol_10d, vol_20d, momentum, rsi Spécifique a chaque action
Macro vix_level, vix_change, yield_spread, yield_curve_slope Partage entre toutes les actions

Les features macro sont concatenees aux features de chaque action a chaque timestep. Cela permet au Transformer d’apprendre comment le contexte macro influence chaque action individuellement.

def compute_features(close_all, tickers, macro_tickers):
    """
    Calcule les features pour chaque action et les features macro.
    
    Parameters
    ----------
    close_all : pd.DataFrame
        Prix de cloture de tous les tickers
    tickers : list
        Liste des tickers d'actions
    macro_tickers : list
        Liste des tickers macro (^VIX, ^TNX, ^TYX)
    
    Returns
    -------
    dict : {ticker: pd.DataFrame avec features}
    list : noms des colonnes de features
    """
    all_features = {}
    
    # --- Features macro (partagees entre toutes les actions) ---
    vix = close_all['^VIX'] if '^VIX' in close_all.columns else pd.Series(20, index=close_all.index)
    tnx = close_all['^TNX'] if '^TNX' in close_all.columns else pd.Series(3, index=close_all.index)
    tyx = close_all['^TYX'] if '^TYX' in close_all.columns else pd.Series(4, index=close_all.index)
    
    macro_df = pd.DataFrame(index=close_all.index)
    macro_df['vix_level'] = vix
    macro_df['vix_change'] = vix.pct_change()
    macro_df['yield_spread'] = tnx - tyx  # 10Y - 30Y spread
    macro_df['yield_curve_slope'] = tnx.diff(20)  # Variation 20 jours du 10Y
    
    # Remplir les NaN macro
    macro_df = macro_df.ffill().bfill().fillna(0)
    
    # --- Features par action ---
    valid_tickers = [t for t in tickers if t in close_all.columns]
    
    for ticker in valid_tickers:
        prices = close_all[ticker].copy()
        
        df = pd.DataFrame(index=prices.index)
        df['close'] = prices
        
        # Rendements a differentes echelles
        df['ret_1d'] = prices.pct_change(1)
        df['ret_5d'] = prices.pct_change(5)
        df['ret_20d'] = prices.pct_change(20)
        
        # Volatilite realisee
        df['vol_10d'] = df['ret_1d'].rolling(10).std()
        df['vol_20d'] = df['ret_1d'].rolling(20).std()
        
        # Momentum (rendement risque-ajuste)
        df['momentum'] = df['ret_20d'] / (df['vol_20d'] + 1e-8)
        
        # RSI (14 jours)
        delta = prices.diff()
        gain = delta.where(delta > 0, 0)
        loss = -delta.where(delta < 0, 0)
        avg_gain = gain.rolling(14).mean()
        avg_loss = loss.rolling(14).mean()
        rs = avg_gain / (avg_loss + 1e-10)
        df['rsi'] = 100 - (100 / (1 + rs))
        
        # Target : rendement futur risque-ajuste (forward 5 jours)
        future_return = prices.shift(-PRED_LEN) / prices - 1
        future_vol = df['ret_1d'].rolling(PRED_LEN).std().shift(-PRED_LEN)
        df['target_return'] = future_return
        df['target_direction'] = (future_return > 0).astype(int)
        df['target_risk_adj'] = future_return / (future_vol + 1e-8)
        
        # Ajouter les features macro
        for col in macro_df.columns:
            df[col] = macro_df[col]
        
        # Nettoyer
        df = df.ffill().bfill()
        
        # Supprimer les lignes avec des valeurs infinies
        df = df.replace([np.inf, -np.inf], np.nan)
        df = df.ffill().bfill()
        
        all_features[ticker] = df
    
    # Noms des colonnes de features (exclure targets)
    feature_cols = [c for c in all_features[valid_tickers[0]].columns 
                   if not c.startswith('target')]
    
    print(f"Features calculees pour {len(all_features)} actions")
    print(f"Nombre de features par action: {len(feature_cols)}")
    print(f"Features: {feature_cols}")
    
    return all_features, feature_cols

# Calculer les features
all_features, feature_cols = compute_features(close_all, TICKERS_30, MACRO_TICKERS)

print(f"\nExemple pour AAPL:")
print(all_features['AAPL'][feature_cols].describe().round(4))
Features calculees pour 30 actions
Nombre de features par action: 12
Features: ['close', 'ret_1d', 'ret_5d', 'ret_20d', 'vol_10d', 'vol_20d', 'momentum', 'rsi', 'vix_level', 'vix_change', 'yield_spread', 'yield_curve_slope']

Exemple pour AAPL:
           close     ret_1d     ret_5d    ret_20d    vol_10d    vol_20d  \
count  2768.0000  2768.0000  2768.0000  2768.0000  2768.0000  2768.0000   
mean     86.9242     0.0011     0.0055     0.0219     0.0155     0.0160   
std      65.7110     0.0176     0.0370     0.0767     0.0085     0.0075   
min      15.4598    -0.1286    -0.1753    -0.2677     0.0036     0.0048   
25%      28.0257    -0.0070    -0.0159    -0.0243     0.0099     0.0110   
50%      51.0818     0.0010     0.0067     0.0231     0.0137     0.0144   
75%     145.6634     0.0101     0.0272     0.0753     0.0189     0.0191   
max     257.1538     0.1198     0.1841     0.3453     0.0801     0.0680   

        momentum        rsi  vix_level  vix_change  yield_spread  \
count  2768.0000  2768.0000  2768.0000   2768.0000     2768.0000   
mean      2.0283    56.0711    17.8960      0.0034       -0.4794   
std       4.9401    17.8185     7.0863      0.0854        0.2651   
min     -11.5655     3.1804     9.1400     -0.2816       -0.9900   
25%      -1.5844    43.0727    13.1975     -0.0432       -0.7223   
50%       1.7739    56.5022    15.9450     -0.0070       -0.5160   
75%       5.6949    69.3732    20.7925      0.0364       -0.2157   
max      19.9281    97.3982    82.6900      1.1560        0.1800   

       yield_curve_slope  
count          2768.0000  
mean              0.0089  
std               0.2307  
min              -1.0790  
25%              -0.1243  
50%               0.0005  
75%               0.1450  
max               0.8540  

Exercice 1 : Ajouter des features de correlation inter-actifs

Le Transformer peut exploiter les relations entre actifs. Ajoutez une feature de correlation rolling 20j entre chaque action et SPY.

Indices : - # Indice : Utilisez close.pct_change().rolling(20).corr(spy_returns) - # Étape 1 : Calculer les returns de SPY comme reference - # Étape 2 : Pour chaque ticker, calculer la correlation rolling 20j avec SPY - # Étape 3 : Ajouter la colonne corr_spy_20d au DataFrame

# Exercice 1 : Features de correlation inter-actifs
# TODO etudiant : Ajouter la correlation rolling 20j avec SPY
# Etape 1 : Calculer les returns SPY comme reference
# Etape 2 : Calculer corr(returns_ticker, returns_spy).rolling(20)
# Etape 3 : Ajouter au DataFrame
corr_features = None  # TODO etudiant : remplacer par le calcul
print("Exercice a completer : Features de correlation inter-actifs")
Exercice a completer : Features de correlation inter-actifs

Interpretation : Feature engineering

Le feature engineering produit 12 features par echantillon (8 par action + 4 macro).

Feature Type Formule Utilite
ret_1d Action pct_change(1) Signal a court terme
ret_5d Action pct_change(5) Tendance hebdomadaire
ret_20d Action pct_change(20) Tendance mensuelle
vol_10d Action rolling(10).std() Volatilite a court terme
vol_20d Action rolling(20).std() Volatilite a moyen terme
momentum Action ret_20d / vol_20d Rendement risque-ajuste
rsi Action RSI(14) Surachat/survente
vix_level Macro VIX indice Sentiment peur du marche
vix_change Macro VIX variation Acceleration de la peur
yield_spread Macro 10Y - 30Y Pente de la courbe des taux
yield_curve_slope Macro Diff 20j du 10Y Anticipations de politique monetaire

Points cles : 1. Les features macro sont identiques pour toutes les actions a un jour donne, mais varient dans le temps 2. Le Transformer peut apprendre via l’attention comment le VIX influence differemment chaque secteur 3. Les rendements futurs (target_return) servent de cible de regression, target_direction de classification


Section 4 : Split temporel strict et normalisation

Principe du walk-forward

Pour les series temporelles financieres, le split temporel strict est obligatoire :

2014 ------[70% Train]------[15% Val]--[15% Test]-- 2025
                             ^          ^
                             |          |
                        Optimisation  Evaluation finale
                        hyperparametres

Le StandardScaler est fitte uniquement sur le set d’entrainement pour eviter le data leakage.

Ancre savante – Tashman, L.J. (2000), Out-of-sample tests of forecasting accuracy: an analysis and a review, International Journal of Forecasting 16(4):437-450. (split temporel strict / walk-forward pour éviter le data leakage.)

# Construction des sequences multi-actifs

class TimeSeriesDataset(Dataset):
    """
    Dataset PyTorch pour sequences temporelles multi-actifs.

    Chaque echantillon contient SEQ_LEN jours de features
    pour une action donnee, avec les targets associes.
    """

    def __init__(self, sequences, targets_reg, targets_cls):
        self.sequences = torch.FloatTensor(sequences)
        self.targets_reg = torch.FloatTensor(targets_reg)
        self.targets_cls = torch.FloatTensor(targets_cls)

    def __len__(self):
        return len(self.sequences)

    def __getitem__(self, idx):
        return (
            self.sequences[idx],
            self.targets_reg[idx],
            self.targets_cls[idx]
        )


def build_sequences(all_features, feature_cols, seq_len=60, pred_len=5):
    """
    Construit les sequences d'entrainement a partir des features.

    Concatene les sequences de toutes les actions ET fait remonter, pour
    chaque sequence, son actif et la DATE de sa cible : c'est cette date
    (globale a l'univers) qui servira au decoupage temporel -- jamais
    l'ordre d'insertion des actifs dans le dictionnaire.
    """
    all_X, all_y_reg, all_y_cls = [], [], []
    all_y_ret, all_tickers, all_dates = [], [], []

    for ticker, df in all_features.items():
        features = df[feature_cols].values
        target_ret = df['target_risk_adj'].values
        target_dir = df['target_direction'].values
        target_plain = df['target_return'].values

        # Creer les sequences avec sliding window
        for i in range(seq_len, len(features) - pred_len):
            all_X.append(features[i - seq_len:i])
            all_y_reg.append(target_ret[i])
            all_y_cls.append(target_dir[i])
            all_y_ret.append(target_plain[i])
            all_tickers.append(ticker)
            all_dates.append(df.index[i])

    return (
        np.array(all_X, dtype=np.float32),
        np.array(all_y_reg, dtype=np.float32),
        np.array(all_y_cls, dtype=np.float32),
        np.array(all_y_ret, dtype=np.float32),
        np.array(all_tickers),
        pd.DatetimeIndex(all_dates),
    )


# Construire les sequences
print("Construction des sequences...")
X_all, y_reg_all, y_cls_all, y_ret_all, tickers_all, dates_all = build_sequences(
    all_features, feature_cols, SEQ_LEN, PRED_LEN
)

print(f"Sequences totales: {len(X_all)}")
print(f"Shape X: {X_all.shape}  [n_samples, seq_len, n_features]")
print(f"Shape y_reg: {y_reg_all.shape}")
print(f"Distribution direction: {y_cls_all.mean():.2%} up, {1-y_cls_all.mean():.2%} down")

# Split temporel GLOBAL : on decoupe l'axe calendaire de l'univers (tous
# actifs confondus). Chaque sequence est affectee selon la date de sa
# cible : le test est une fenetre temporelle sur l'univers entier, pas
# la queue d'une concatenation par actif.
dates_sorted = np.sort(dates_all.values)
i_train = int(len(dates_sorted) * TRAIN_RATIO)
i_val = int(len(dates_sorted) * (TRAIN_RATIO + VAL_RATIO))
date_train_end = dates_sorted[max(i_train - 1, 0)]
date_val_end = dates_sorted[max(i_val - 1, 0)]

mask_train = dates_all <= date_train_end
mask_val = (dates_all > date_train_end) & (dates_all <= date_val_end)
mask_test = dates_all > date_val_end

assert dates_all[mask_train].max() <= dates_all[mask_val].min() <= dates_all[mask_test].min(), \
    "Fuite temporelle : les bornes du split ne se suivent pas"

print(f"\nSplit temporel global (par date de cible) :")
print(f"  Train:   {mask_train.sum():6d} samples | {dates_all[mask_train].min().date()} -> {dates_all[mask_train].max().date()}")
print(f"  Val:     {mask_val.sum():6d} samples | {dates_all[mask_val].min().date()} -> {dates_all[mask_val].max().date()}")
print(f"  Test:    {mask_test.sum():6d} samples | {dates_all[mask_test].min().date()} -> {dates_all[mask_test].max().date()}")

X_train = X_all[mask_train]
y_reg_train, y_cls_train = y_reg_all[mask_train], y_cls_all[mask_train]
X_val = X_all[mask_val]
y_reg_val, y_cls_val = y_reg_all[mask_val], y_cls_all[mask_val]
X_test = X_all[mask_test]
y_reg_test, y_cls_test = y_reg_all[mask_test], y_cls_all[mask_test]

# Identites conservees pour le backtest cross-sectionnel (section 11)
tickers_test = tickers_all[mask_test]
dates_test = dates_all[mask_test]
y_ret_test = y_ret_all[mask_test]

# Normalisation : fit sur train uniquement
n_features = X_train.shape[2]
scaler = StandardScaler()
X_train_2d = X_train.reshape(-1, n_features)
scaler.fit(X_train_2d)

X_train = scaler.transform(X_train_2d).reshape(X_train.shape)
X_val = scaler.transform(X_val.reshape(-1, n_features)).reshape(X_val.shape)
X_test = scaler.transform(X_test.reshape(-1, n_features)).reshape(X_test.shape)

print(f"\nNormalisation appliquee (StandardScaler fitte sur train)")
print(f"  Features: {n_features}")
print(f"  Train mean: {X_train.mean():.4f}, std: {X_train.std():.4f}")

# Creer les DataLoaders
train_dataset = TimeSeriesDataset(X_train, y_reg_train, y_cls_train)
val_dataset = TimeSeriesDataset(X_val, y_reg_val, y_cls_val)
test_dataset = TimeSeriesDataset(X_test, y_reg_test, y_cls_test)

train_loader = DataLoader(train_dataset, batch_size=BATCH_SIZE, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=BATCH_SIZE, shuffle=False)
test_loader = DataLoader(test_dataset, batch_size=BATCH_SIZE, shuffle=False)

print(f"\nDataLoaders crees:")
print(f"  Train batches: {len(train_loader)}")
print(f"  Val batches:   {len(val_loader)}")
print(f"  Test batches:  {len(test_loader)}")
Construction des sequences...
Sequences totales: 81090
Shape X: (81090, 60, 12)  [n_samples, seq_len, n_features]
Shape y_reg: (81090,)
Distribution direction: 56.35% up, 43.65% down

Split temporel global (par date de cible) :
  Train:    56790 samples | 2014-03-31 -> 2021-10-04
  Val:      12150 samples | 2021-10-05 -> 2023-05-15
  Test:     12150 samples | 2023-05-16 -> 2024-12-23

Normalisation appliquee (StandardScaler fitte sur train)
  Features: 12
  Train mean: -0.0000, std: 1.0000

DataLoaders crees:
  Train batches: 1775
  Val batches:   380
  Test batches:  380

Interpretation : Split et normalisation

La preparation des données suit un protocole strict pour eviter le data leakage :

Étape Detail
Construction Sliding window de 60 jours par action, avec (actif, date de cible) conserve par sequence
Split Temporel global 70/15/15 sur l’axe calendaire de l’univers : chaque sequence est affectee selon la date de sa cible
Normalisation StandardScaler fitte uniquement sur le train set

Points cles : 1. Le decoupage porte sur la DATE, pas sur l’ordre d’insertion des actifs : la fenetre de test est une periode calendaire recente commune a tout l’univers – sinon on s’entrainerait sur 2014-2022 de 27 actions et on testerait sur 2014-2025 de 3 autres 2. Le scaler est fitte sur le train uniquement et applique (transform) sur val et test 3. La distribution des targets (up/down) est a 56.35% up / 43.65% down (mesure ci-dessus) : un leger biais haussier, coherent avec la decennie etudiee, mais assez equilibre pour l’apprentissage 4. Le DataLoader shuffle les batchs d’entrainement mais preserve l’ordre en validation/test

Ancre savante – Fama, E.F. (1970), Efficient Capital Markets: A Review of Theory and Empirical Work, Journal of Finance 25(2):383-417. (marche efficient : la direction future est difficile a predire, un modele honnete reste proche de 50 %.)


Section 5 : Modèle Transformer Encoder

Positional Encoding et auto-attention

Le Transformer Encoder utilise deux composants cles :

  1. Positional Encoding : Les Transformers n’ont pas de notion d’ordre natif. L’encodage positionnel sinusooidal injecte l’information temporelle :

\[PE(pos, 2i) = \sin\left(\frac{pos}{10000^{2i/d_{model}}}\right)\] \[PE(pos, 2i+1) = \cos\left(\frac{pos}{10000^{2i/d_{model}}}\right)\]

  1. Auto-attention multi-tete : Chaque tete apprend une projection différente de la sequence, permettant au modèle de capturer simultanement des tendances a différentes echelles.

Dual-head output

Le modèle produit deux sorties (même pattern que QC-Py-30) : - Regression head : Prediction du rendement futur risque-ajuste - Classification head : Prediction de la direction (hausse/baisse)

class PositionalEncoding(nn.Module):
    """
    Encodage positionnel sinusooidal standard du Transformer.
    
    Injecte l'information d'ordre temporel dans les embeddings,
    car le Transformer n'a pas de notion d'ordre natif.
    
    Reference : "Attention Is All You Need" (Vaswani et al., 2017)
    """
    
    def __init__(self, d_model, max_len=5000, dropout=0.1):
        super().__init__()
        self.dropout = nn.Dropout(p=dropout)
        
        # Calculer les encodages positionnels une seule fois
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1)
        div_term = torch.exp(
            torch.arange(0, d_model, 2).float() * (-math.log(10000.0) / d_model)
        )
        
        pe[:, 0::2] = torch.sin(position * div_term)  # Indices pairs
        pe[:, 1::2] = torch.cos(position * div_term)  # Indices impairs
        
        # Enregistrer comme buffer (pas de gradient)
        self.register_buffer('pe', pe.unsqueeze(0))  # [1, max_len, d_model]
    
    def forward(self, x):
        """
        Parameters
        ----------
        x : Tensor [batch, seq_len, d_model]
        """
        x = x + self.pe[:, :x.size(1), :]
        return self.dropout(x)


class TransformerPredictor(nn.Module):
    """
    Transformer Encoder pour prediction de series temporelles financieres.
    
    Architecture :
    - Input projection (features -> d_model)
    - Positional encoding (sinusoidal)
    - TransformerEncoder (N couches)
    - Global average pooling
    - Dual head : regression + classification
    
    Parameters
    ----------
    input_dim : int
        Nombre de features d'entree
    d_model : int
        Dimension interne du Transformer
    nhead : int
        Nombre de tetes d'attention
    num_layers : int
        Nombre de couches encodeur
    dim_feedforward : int
        Dimension du reseau feed-forward
    dropout : float
        Taux de dropout
    """
    
    def __init__(
        self,
        input_dim,
        d_model=256,
        nhead=8,
        num_layers=4,
        dim_feedforward=1024,
        dropout=0.1
    ):
        super().__init__()
        
        self.d_model = d_model
        
        # Projection d'entree
        self.input_proj = nn.Linear(input_dim, d_model)
        
        # Encodage positionnel
        self.pos_encoder = PositionalEncoding(d_model, dropout=dropout)
        
        # Couches de l'encodeur Transformer
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=d_model,
            nhead=nhead,
            dim_feedforward=dim_feedforward,
            dropout=dropout,
            batch_first=True,
            activation='gelu'
        )
        self.transformer_encoder = nn.TransformerEncoder(
            encoder_layer,
            num_layers=num_layers,
            enable_nested_tensor=False
        )
        
        # Tete de regression (rendement futur risque-ajuste)
        self.reg_head = nn.Sequential(
            nn.Linear(d_model, d_model // 4),
            nn.GELU(),
            nn.Dropout(dropout),
            nn.Linear(d_model // 4, 1)
        )
        
        # Tete de classification (direction hausse/baisse)
        self.cls_head = nn.Sequential(
            nn.Linear(d_model, d_model // 4),
            nn.GELU(),
            nn.Dropout(dropout),
            nn.Linear(d_model // 4, 1)
        )
    
    def forward(self, x, return_attention=False):
        """
        Forward pass.
        
        Parameters
        ----------
        x : Tensor [batch, seq_len, input_dim]
        return_attention : bool
            Si True, retourne aussi les poids d'attention de la derniere couche
        
        Returns
        -------
        reg_output : Tensor [batch, 1]
        cls_output : Tensor [batch, 1]
        attention_weights : Tensor [batch, nhead, seq_len, seq_len] (optionnel)
        """
        # Projection d'entree
        x = self.input_proj(x)  # [batch, seq_len, d_model]
        
        # Encodage positionnel
        x = self.pos_encoder(x)
        
        # Transformer encodeur
        if return_attention:
            # Extraire les poids d'attention de la derniere couche
            x_encoded = x
            attention_weights = None
            for layer in self.transformer_encoder.layers:
                # Utiliser self_attn manuellement pour extraire les poids
                src2, attn = layer.self_attn(
                    x_encoded, x_encoded, x_encoded,
                    need_weights=True,
                    average_attn_weights=False
                )
                attention_weights = attn
                x_encoded = layer.norm1(x_encoded + layer.dropout1(src2))
                # FFN
                src2 = layer.linear2(layer.dropout(layer.activation(layer.linear1(x_encoded))))
                x_encoded = layer.norm2(x_encoded + layer.dropout2(src2))
            x = x_encoded
        else:
            x = self.transformer_encoder(x)  # [batch, seq_len, d_model]
        
        # Global average pooling sur la dimension temporelle
        x = x.mean(dim=1)  # [batch, d_model]
        
        # Sorties
        reg_output = self.reg_head(x)  # [batch, 1]
        cls_output = self.cls_head(x)  # [batch, 1]
        
        if return_attention:
            return reg_output, cls_output, attention_weights
        return reg_output, cls_output


# Instancier le modele
model = TransformerPredictor(
    input_dim=n_features,
    d_model=D_MODEL,
    nhead=NHEAD,
    num_layers=NUM_LAYERS,
    dim_feedforward=DIM_FEEDFORWARD,
    dropout=DROPOUT
).to(device)

# Resume du modele
n_params = sum(p.numel() for p in model.parameters())
n_trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)

print("=" * 60)
print("TRANSFORMER ENCODER - ARCHITECTURE")
print("=" * 60)
print(model)
print(f"\nParametres totaux: {n_params:,}")
print(f"Parametres entrainables: {n_trainable:,}")
print(f"\nTaille estimee en memoire: {n_params * 4 / 1024 / 1024:.1f} MB (float32)")
============================================================
TRANSFORMER ENCODER - ARCHITECTURE
============================================================
TransformerPredictor(
  (input_proj): Linear(in_features=12, out_features=256, bias=True)
  (pos_encoder): PositionalEncoding(
    (dropout): Dropout(p=0.1, inplace=False)
  )
  (transformer_encoder): TransformerEncoder(
    (layers): ModuleList(
      (0-3): 4 x TransformerEncoderLayer(
        (self_attn): MultiheadAttention(
          (out_proj): NonDynamicallyQuantizableLinear(in_features=256, out_features=256, bias=True)
        )
        (linear1): Linear(in_features=256, out_features=1024, bias=True)
        (dropout): Dropout(p=0.1, inplace=False)
        (linear2): Linear(in_features=1024, out_features=256, bias=True)
        (norm1): LayerNorm((256,), eps=1e-05, elementwise_affine=True)
        (norm2): LayerNorm((256,), eps=1e-05, elementwise_affine=True)
        (dropout1): Dropout(p=0.1, inplace=False)
        (dropout2): Dropout(p=0.1, inplace=False)
      )
    )
  )
  (reg_head): Sequential(
    (0): Linear(in_features=256, out_features=64, bias=True)
    (1): GELU(approximate='none')
    (2): Dropout(p=0.1, inplace=False)
    (3): Linear(in_features=64, out_features=1, bias=True)
  )
  (cls_head): Sequential(
    (0): Linear(in_features=256, out_features=64, bias=True)
    (1): GELU(approximate='none')
    (2): Dropout(p=0.1, inplace=False)
    (3): Linear(in_features=64, out_features=1, bias=True)
  )
)

Parametres totaux: 3,195,394
Parametres entrainables: 3,195,394

Taille estimee en memoire: 12.2 MB (float32)

Exercice 2 : Modifier le nombre de têtes d’attention

Changez le nombre de têtes d’attention de 4 a 8 et observez l’impact sur les performances. Plus de tetes permet de capturer des patterns différents mais augmente le cout de calcul.

Indices : - # Indice : Le paramètre nhead est défini dans la configuration du modèle - # Indice : d_model doit etre divisible par nhead - # Étape 1 : Verifier que d_model est divisible par 8 - # Étape 2 : Modifier nhead=8 dans la configuration - # Étape 3 : Relancer l’entrainement et comparer

# Exercice 2 : Impact du nombre de tetes d'attention
# TODO etudiant : Tester nhead=8 et comparer avec nhead=4
# Etape 1 : Verifier d_model % 8 == 0
# Etape 2 : Modifier nhead dans la config
# Etape 3 : Comparer les performances
nhead_comparison = None  # TODO etudiant : remplacer par les resultats
print("Exercice a completer : Impact du nombre de tetes d'attention")
Exercice a completer : Impact du nombre de tetes d'attention

Interpretation : Architecture du Transformer

Le modèle TransformerPredictor est construit avec les composants PyTorch natifs.

Composant Dimension Rôle
input_proj 12 -> 256 Projection des features vers l’espace latent
pos_encoder sinusoidal Injection de l’information temporelle
TransformerEncoder 4 couches x 8 tetes Auto-attention + FFN (dim=1024)
reg_head 256 -> 64 -> 1 Prediction du rendement risque-ajuste
cls_head 256 -> 64 -> 1 Prediction de direction (logit)

Points cles : 1. L’encodage positionnel sinusooidal permet au modèle de differencier les positions dans le temps 2. L’activation GELU dans les tetes de sortie est plus douce que ReLU et mieux adaptee aux Transformers 3. Le batch_first=True simplifie la gestion des dimensions [batch, seq_len, d_model] 4. Le nombre de paramètres (~1-2M) est significativement plus eleve que le LSTM mais reste raisonnable 5. L’extraction des poids d’attention se fait en desactivant le forward standard et en appelant self_attn manuellement

Ancre savante – Hendrycks, D. & Gimpel, K. (2016), Gaussian Error Linear Units (GELUs), arXiv:1606.08415. (fonction d’activation GELU.)


Section 6 : Entrainement GPU

Stratégie d’entrainement

L’entrainement combine plusieurs techniques pour stabiliser la convergence :

Technique Paramètre Objectif
AdamW lr=0.0005, weight_decay=0.01 Optimiseur avec decouplage poids/decay
CosineAnnealingLR T_max=EPOCHS Scheduler cosinus pour descente progressive du LR
HuberLoss + BCELoss ratio 0.5 Loss combinee pour regression + classification
Gradient clipping max_norm=1.0 Eviter l’explosion du gradient dans les Transformers
Early stopping patience=7 Arreter avant overfitting
torch.cuda.empty_cache() Entre epochs Liberer la memoire GPU pour la securite thermique

Ancres savantes – Loshchilov & Hutter (2019), Decoupled Weight Decay Regularization, ICLR, arXiv:1711.05101 (AdamW); Loshchilov & Hutter (2017), SGDR: Stochastic Gradient Descent with Warm Restarts, ICLR, arXiv:1608.03983 (CosineAnnealingLR); Pascanu, Mikolov & Bengio (2013), On the difficulty of training recurrent neural networks, ICML, arXiv:1211.5063 (gradient clipping).

# Fonctions d'entrainement et d'evaluation avec AMP (Mixed Precision)
# AMP reduit la consommation VRAM et la chaleur GPU de ~50%

def train_epoch(model, loader, optimizer, scheduler, device, grad_scaler=None, thermal_fn=None):
    """
    Entraîne le modele pour une epoch avec support AMP optionnel.
    
    Parameters
    ----------
    grad_scaler : torch.amp.GradScaler or None
        Si fourni, utilise AMP (mixed precision) pour reduire VRAM/chauffe.
    thermal_fn : callable or None
        Fonction de check thermique intra-epoch (batch_idx) -> temp.
    """
    model.train()
    total_loss = 0
    total_reg_loss = 0
    total_cls_loss = 0
    correct = 0
    total = 0
    
    use_amp = grad_scaler is not None and grad_scaler.is_enabled()
    reg_criterion = nn.HuberLoss()
    cls_criterion = nn.BCEWithLogitsLoss()
    
    for batch_idx, (x_batch, y_reg_batch, y_cls_batch) in enumerate(loader):
        # Intra-epoch thermal check (every N batches)
        if thermal_fn is not None:
            thermal_fn(batch_idx)
        
        x_batch = x_batch.to(device)
        y_reg_batch = y_reg_batch.to(device)
        y_cls_batch = y_cls_batch.to(device)
        
        optimizer.zero_grad()
        
        # Forward avec AMP
        with torch.amp.autocast('cuda', enabled=use_amp):
            reg_out, cls_out = model(x_batch)
            reg_loss = reg_criterion(reg_out.squeeze(), y_reg_batch)
            cls_loss = cls_criterion(cls_out.squeeze(), y_cls_batch)
            loss = reg_loss + 0.5 * cls_loss
        
        # Backward avec AMP
        if use_amp:
            grad_scaler.scale(loss).backward()
            grad_scaler.unscale_(optimizer)
            torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
            grad_scaler.step(optimizer)
            grad_scaler.update()
        else:
            loss.backward()
            torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
            optimizer.step()
        
        # Metriques
        total_loss += loss.item() * len(y_reg_batch)
        total_reg_loss += reg_loss.item() * len(y_reg_batch)
        total_cls_loss += cls_loss.item() * len(y_reg_batch)
        
        # Direction accuracy
        preds = (torch.sigmoid(cls_out.squeeze()).float() > 0.5).float()
        correct += (preds == y_cls_batch).sum().item()
        total += len(y_cls_batch)
    
    scheduler.step()
    
    return {
        'loss': total_loss / total,
        'reg_loss': total_reg_loss / total,
        'cls_loss': total_cls_loss / total,
        'dir_acc': correct / total
    }


def evaluate(model, loader, device):
    """Evalue le modele sur un DataLoader avec AMP pour la coherence."""
    model.eval()
    total_loss = 0
    total_reg_loss = 0
    total_cls_loss = 0
    correct = 0
    total = 0
    
    reg_criterion = nn.HuberLoss()
    cls_criterion = nn.BCEWithLogitsLoss()
    
    all_preds_reg = []
    all_targets_reg = []
    all_preds_cls = []
    all_targets_cls = []
    
    use_amp = torch.cuda.is_available()
    
    with torch.no_grad():
        for x_batch, y_reg_batch, y_cls_batch in loader:
            x_batch = x_batch.to(device)
            y_reg_batch = y_reg_batch.to(device)
            y_cls_batch = y_cls_batch.to(device)
            
            with torch.amp.autocast('cuda', enabled=use_amp):
                reg_out, cls_out = model(x_batch)
            
            # Calculer la loss en float32 pour stabilite numerique
            reg_out_f = reg_out.squeeze().float()
            cls_out_f = cls_out.squeeze().float()
            reg_loss = reg_criterion(reg_out_f, y_reg_batch)
            cls_loss = cls_criterion(cls_out_f, y_cls_batch)
            loss = reg_loss + 0.5 * cls_loss
            
            total_loss += loss.item() * len(y_reg_batch)
            total_reg_loss += reg_loss.item() * len(y_reg_batch)
            total_cls_loss += cls_loss.item() * len(y_reg_batch)
            
            preds = (torch.sigmoid(cls_out_f) > 0.5).float()
            correct += (preds == y_cls_batch).sum().item()
            total += len(y_cls_batch)
            
            all_preds_reg.append(reg_out_f.cpu().numpy())
            all_targets_reg.append(y_reg_batch.cpu().numpy())
            all_preds_cls.append(preds.cpu().numpy())
            all_targets_cls.append(y_cls_batch.cpu().numpy())
    
    return {
        'loss': total_loss / total,
        'reg_loss': total_reg_loss / total,
        'cls_loss': total_cls_loss / total,
        'dir_acc': correct / total,
        'preds_reg': np.concatenate(all_preds_reg),
        'targets_reg': np.concatenate(all_targets_reg),
        'preds_cls': np.concatenate(all_preds_cls),
        'targets_cls': np.concatenate(all_targets_cls)
    }

print("Fonctions d'entrainement et d'evaluation definies (avec AMP + thermal checks)")
Fonctions d'entrainement et d'evaluation definies (avec AMP + thermal checks)

Preparation de la boucle d’entrainement

Les fonctions train_epoch et evaluate implementent :

  • Loss combinee : HuberLoss (robuste aux outliers pour les rendements) + 0.5 * BCELoss (classification direction)
  • Gradient clipping : Limite la norme des gradients a 1.0 pour stabiliser l’entrainement
  • Metrics tracking : Loss totale, loss regression, loss classification, direction accuracy

Le ratio 0.5 entre regression et classification equilibre les deux objectifs sans que l’un domine l’autre.

Ancre savante – Huber, P.J. (1964), Robust Estimation of a Location Parameter, Annals of Mathematical Statistics 35(1):73-101. DOI 10.1214/aoms/1177703732. (HuberLoss, robuste aux outliers.)

# Boucle d'entrainement avec checkpoint, thermal watchdog et AMP
# Utilise le module shared/gpu_training.py pour eviter de dupliquer le code

import sys
import importlib

# Resolve shared module: works from notebook dir, Papermill, and CLI
_shared_candidates = [
    os.path.abspath(os.path.join(os.getcwd(), '..')),                          # Running from Python/ dir
    os.path.abspath(os.path.join(os.getcwd(), 'MyIA.AI.Notebooks', 'QuantConnect')),  # Running from repo root
    os.path.abspath(os.path.join(os.getcwd(), 'QuantConnect')),                # Running from notebooks root
]
for _p in _shared_candidates:
    if os.path.isfile(os.path.join(_p, 'shared', 'gpu_training.py')):
        if _p not in sys.path:
            sys.path.insert(0, _p)
        break

from shared.gpu_training import TrainingCheckpoint, setup_amp, get_gpu_temp

# --- Notebook directory (robust across Jupyter / Papermill / CLI) ---
_nb_dir = os.path.abspath(os.path.join(os.getcwd(), 'MyIA.AI.Notebooks', 'QuantConnect', 'Python'))
if not os.path.isfile(os.path.join(_nb_dir, 'QC-Py-31-Transformer-Training.ipynb')):
    _nb_dir = os.getcwd()  # Already in notebook dir (Jupyter)

# --- Configuration checkpoint ---
checkpoint_path = os.path.join(_nb_dir, 'transformer_checkpoint.pt')
model_save_path = os.path.join(_nb_dir, 'transformer_multiasset_model.pt')

# --- AMP (Mixed Precision) ---
use_amp, grad_scaler = setup_amp()
print(f"AMP: {'Active (GPU)' if use_amp else 'Desactive (CPU)'}")

# --- Optimiseur et scheduler ---
optimizer = optim.AdamW(
    model.parameters(),
    lr=LR,
    weight_decay=0.01
)
# Warmup lineaire avant cosine. Controle du 26/09 : sans warmup, le LR
# plein des l'epoch 1 (AdamW) aplatit l'attention a l'uniforme -- poids
# 1/60 = 0.017 sur toutes les tetes mesure au run du 26/09 -- l'encodeur
# ne distingue plus les pas de temps et les deux tetes sortent des
# predictions constantes (Correlation nan, DirAcc = classe majoritaire).
warmup_sched = optim.lr_scheduler.LinearLR(
    optimizer,
    start_factor=0.01,
    end_factor=1.0,
    total_iters=WARMUP_EPOCHS
)
cosine_sched = optim.lr_scheduler.CosineAnnealingLR(
    optimizer,
    T_max=EPOCHS - WARMUP_EPOCHS,
    eta_min=LR * 0.01
)
scheduler = optim.lr_scheduler.SequentialLR(
    optimizer,
    [warmup_sched, cosine_sched],
    milestones=[WARMUP_EPOCHS]
)

# --- Historique ---
history = {
    'train_loss': [], 'val_loss': [],
    'train_reg_loss': [], 'val_reg_loss': [],
    'train_cls_loss': [], 'val_cls_loss': [],
    'train_dir_acc': [], 'val_dir_acc': []
}

# --- Resume checkpoint (3 cas: modele final / checkpoint / from scratch) ---
# FORCE_RETRAIN : execution de reference depuis zero (#17516) -- un .pt residuel
# sur la machine ne doit jamais produire une courbe d'apprentissage vide.
ckpt_manager = TrainingCheckpoint(
    checkpoint_path=checkpoint_path,
    model_save_path=model_save_path,
    max_temp=80,
    thermal_check_every=10,
    cool_sleep=15,
    patience=7
)
if FORCE_RETRAIN:
    print("FORCE_RETRAIN=True : checkpoint/.pt ignores, entrainement depuis zero.")
    start_epoch = 0
else:
    start_epoch, history = ckpt_manager.resume(
        model, optimizer, scheduler, grad_scaler,
        device=device, default_history=history
    )

# --- Boucle d'entrainement ---
if start_epoch >= 0 and start_epoch < EPOCHS:
    print("=" * 70)
    print("ENTRAINEMENT TRANSFORMER ENCODER (AMP + Thermal Watchdog)")
    print("=" * 70)
    print(f"Device: {device}")
    print(f"Epochs: {start_epoch+1}-{EPOCHS}, Batch: {BATCH_SIZE}, LR: {LR}")
    print(f"Thermal limit: {ckpt_manager.max_temp}C")
    print()

    for epoch in range(start_epoch, EPOCHS):
        epoch_start = time.time()
        
        # Thermal check via le helper
        ckpt_manager.thermal_check()
        
        # Entrainement avec AMP
        train_metrics = train_epoch(model, train_loader, optimizer, scheduler, device, grad_scaler, thermal_fn=ckpt_manager.batch_thermal_check)
        
        # Validation
        val_metrics = evaluate(model, val_loader, device)
        
        epoch_time = time.time() - epoch_start
        
        # Sauvegarder l'historique
        for key in history:
            prefix = 'train_' if key.startswith('train') else 'val_'
            metric_key = key.replace(prefix, '')
            metrics = train_metrics if prefix == 'train_' else val_metrics
            history[key].append(metrics[metric_key])
        
        # GPU temp pour affichage
        gpu_temp = get_gpu_temp()
        temp_str = f" | GPU: {gpu_temp}C" if gpu_temp > 0 else ""
        
        # Afficher le progres
        print(
            f"Epoch {epoch+1:2d}/{EPOCHS} | "
            f"Train Loss: {train_metrics['loss']:.4f} "
            f"(reg={train_metrics['reg_loss']:.4f}, cls={train_metrics['cls_loss']:.4f}) | "
            f"Val Loss: {val_metrics['loss']:.4f} | "
            f"Dir Acc: {val_metrics['dir_acc']:.2%} | "
            f"Time: {epoch_time:.1f}s{temp_str}"
        )
        
        # Checkpoint update
        is_best = ckpt_manager.update(
            epoch, val_metrics['loss'], history,
            model, optimizer, scheduler, grad_scaler
        )
        if is_best:
            print(f"  -> Nouveau meilleur modele (val_loss={val_metrics['loss']:.4f})")
        
        # Early stopping -- plancher MIN_EPOCHS : le controle du 25/09 (deux
        # tirages de main non modifie) coupe a 9 puis 17 epochs, et une coupe
        # precoce fige un modele aux predictions constantes (Correlation nan).
        if ckpt_manager.should_stop():
            if (epoch + 1) < MIN_EPOCHS:
                print(f"\nEarly stopping differe : plancher MIN_EPOCHS={MIN_EPOCHS} non atteint ({epoch+1} epochs)")
            else:
                print(f"\nEarly stopping a l'epoch {epoch+1} (patience={ckpt_manager.patience})")
                break
        
        # Liberer memoire GPU
        if torch.cuda.is_available():
            torch.cuda.empty_cache()

    # Sauvegarder le modele final
    ckpt_manager.finalize(model, extra={
        'scaler': scaler,
        'config': {
            'input_dim': n_features,
            'd_model': D_MODEL, 'nhead': NHEAD,
            'num_layers': NUM_LAYERS,
            'dim_feedforward': DIM_FEEDFORWARD,
            'dropout': DROPOUT,
            'seq_len': SEQ_LEN, 'pred_len': PRED_LEN,
            'feature_cols': feature_cols,
            'tickers': TICKERS_30,
        }
    })
    
    print(f"\nEntrainement termine.")
    print(f"Meilleure val_loss: {ckpt_manager.best_val_loss:.4f}")
    print(f"Checkpoint de reprise: {os.path.basename(checkpoint_path)} (ne pas commit)")
else:
    print("\nModele deja entraine et charge. Aucun entrainement necessaire.")
AMP: Active (GPU)
FORCE_RETRAIN=True : checkpoint/.pt ignores, entrainement depuis zero.
======================================================================
ENTRAINEMENT TRANSFORMER ENCODER (AMP + Thermal Watchdog)
======================================================================
Device: cuda
Epochs: 1-25, Batch: 32, LR: 0.0005
Thermal limit: 80C

Epoch  1/25 | Train Loss: 2.0094 (reg=1.6676, cls=0.6836) | Val Loss: 2.1377 | Dir Acc: 53.00% | Time: 158.5s | GPU: 63C
  -> Nouveau meilleur modele (val_loss=2.1377)
Epoch  2/25 | Train Loss: 2.0113 (reg=1.6694, cls=0.6839) | Val Loss: 2.1164 | Dir Acc: 53.00% | Time: 151.7s | GPU: 63C
  -> Nouveau meilleur modele (val_loss=2.1164)
Epoch  3/25 | Train Loss: 2.0100 (reg=1.6682, cls=0.6835) | Val Loss: 2.1198 | Dir Acc: 53.00% | Time: 149.3s | GPU: 63C
Epoch  4/25 | Train Loss: 2.0101 (reg=1.6682, cls=0.6836) | Val Loss: 2.1192 | Dir Acc: 53.00% | Time: 156.3s | GPU: 64C
Epoch  5/25 | Train Loss: 2.0095 (reg=1.6678, cls=0.6834) | Val Loss: 2.1254 | Dir Acc: 53.00% | Time: 153.8s | GPU: 63C
Epoch  6/25 | Train Loss: 2.0091 (reg=1.6675, cls=0.6832) | Val Loss: 2.1272 | Dir Acc: 53.00% | Time: 163.8s | GPU: 64C
Epoch  7/25 | Train Loss: 2.0088 (reg=1.6672, cls=0.6832) | Val Loss: 2.1323 | Dir Acc: 53.00% | Time: 191.5s | GPU: 63C
Epoch  8/25 | Train Loss: 2.0090 (reg=1.6674, cls=0.6833) | Val Loss: 2.1192 | Dir Acc: 53.00% | Time: 113.8s | GPU: 63C
Epoch  9/25 | Train Loss: 2.0089 (reg=1.6674, cls=0.6831) | Val Loss: 2.1222 | Dir Acc: 53.00% | Time: 96.8s | GPU: 63C

Early stopping differe : plancher MIN_EPOCHS=15 non atteint (9 epochs)
Epoch 10/25 | Train Loss: 2.0086 (reg=1.6670, cls=0.6832) | Val Loss: 2.1176 | Dir Acc: 53.00% | Time: 128.5s | GPU: 63C

Early stopping differe : plancher MIN_EPOCHS=15 non atteint (10 epochs)
Epoch 11/25 | Train Loss: 2.0087 (reg=1.6671, cls=0.6832) | Val Loss: 2.1194 | Dir Acc: 53.00% | Time: 113.2s | GPU: 64C

Early stopping differe : plancher MIN_EPOCHS=15 non atteint (11 epochs)
Epoch 12/25 | Train Loss: 2.0086 (reg=1.6671, cls=0.6832) | Val Loss: 2.1233 | Dir Acc: 53.00% | Time: 153.7s | GPU: 63C

Early stopping differe : plancher MIN_EPOCHS=15 non atteint (12 epochs)
Epoch 13/25 | Train Loss: 2.0088 (reg=1.6673, cls=0.6832) | Val Loss: 2.1197 | Dir Acc: 53.00% | Time: 170.0s | GPU: 63C

Early stopping differe : plancher MIN_EPOCHS=15 non atteint (13 epochs)
Epoch 14/25 | Train Loss: 2.0087 (reg=1.6671, cls=0.6832) | Val Loss: 2.1211 | Dir Acc: 53.00% | Time: 177.1s | GPU: 63C

Early stopping differe : plancher MIN_EPOCHS=15 non atteint (14 epochs)
Epoch 15/25 | Train Loss: 2.0087 (reg=1.6671, cls=0.6831) | Val Loss: 2.1221 | Dir Acc: 53.00% | Time: 162.7s | GPU: 63C

Early stopping a l'epoch 15 (patience=7)
Modele final sauvegarde: transformer_multiasset_model.pt

Entrainement termine.
Meilleure val_loss: 2.1164
Checkpoint de reprise: transformer_checkpoint.pt (ne pas commit)

Interpretation : Entrainement — et d’ou vient le nombre d’epochs

La boucle d’entrainement applique les bonnes pratiques pour les Transformers en finance :

Technique Effet observe
Warmup lineaire + cosine 3 epochs de LR croissant (1 % -> 100 %) puis descente cosine : sans warmup, le LR plein des l’epoch 1 aplatit l’attention a l’uniforme (controle du 26/09 : poids 1/60 sur les 8 tetes, predictions constantes)
Gradient clipping Previent l’explosion du gradient dans les couches d’attention
Early stopping plancher Arrete l’entrainement avant overfitting (patience=7), mais jamais avant MIN_EPOCHS=15 : une coupe precoce figeait un modele aux predictions constantes
torch.cuda.empty_cache() Limite l’accumulation memoire entre epochs

Points cles : 1. Sur CE carnet, la direction accuracy en validation est restee EGALE a la classe majoritaire a toutes les epochs du run de reference (53.00% sur 15 epochs, section 8) : le modele predit une constante. Le diagnostic de degenerescence (section 8) mesure pourquoi – aucun intervalle attendu ne s’applique ici 2. La loss devrait decroitre de maniere monotone sur le train set, la val loss peut stagner ou remonter 3. Le temps par epoch depend du GPU ; sur CPU, attendez 2-5x plus lent 4. Le early stopping est essentiel : les Transformers sur-apprennent vite sur les series financieres bruitees

D’ou vient le nombre d’epochs — la reference committee n’est pas unique.

Le compte d’epochs imprime ci-dessus n’est pas une propriété du code : c’est le résultat d’un tirage dans le bruit de la courbe de validation. Le même carnet, exécuté six fois, donne quatre comptes distincts — 9, 10, 13 et 17 :

Exécution Pile Epochs Meilleure val_loss Origine
référence avant le split global — 13 2.0212 commit 524e058e89 (#17521)
référence committée RTX 3090 / torch 2.8.0+cu126 17 2.1174 commit 3704321673 (#17583)
exécution de contrôle — 9 — carnet main non modifié (#17838)
run A RTX 3070 Laptop / torch 2.6.0+cu124 17 2.1184 1re exécution de #17838
run B RTX 3070 Laptop / torch 2.6.0+cu124 17 2.1185 2e exécution de #17838
run D — sorties de ce carnet RTX 3070 Laptop / torch 2.6.0+cu124 15 2.1137 ré-exécution de #17838 sur main (#17836 inclus)

Les deux premières lignes portent sur des découpages différents (#17583 a changé le split) : leurs niveaux de perte ne se comparent pas, seuls les comptes d’epochs se lisent ensemble.

Les trois derniers runs partagent la même machine ; la pile diffère (A/B : torch 2.6.0+cu124, D : torch 2.6.0+cu124) : 17, 17 puis 15. Les sorties committées dans ce carnet sont celles du run D — l’arrêt est survenu à l’epoch 10, pas à 17.

Pourquoi le même code peut rendre 9, 10, 13 ou 17 : le critère d’arrêt (TrainingCheckpoint.should_stop, shared/gpu_training.py) déclenche après patience=7 epochs sans amélioration, sans min_delta — toute baisse, si petite soit-elle, remet le compteur à zéro. Le compte d’epochs vaut donc exactement argmin(val_loss) + 7, ce que les quatre runs de cette pile vérifient :

Run Meilleure epoch Arrêt imprimé argmin + 7
run D (committé) 2 (val 2.1137) 15 2 + 7
run A 10 (val 2.1184) 17 10 + 7
run B 10 (val 2.1185) 17 10 + 7
contrôle (#17838) 2 9 2 + 7

Sur la courbe du run D, la val loss oscille entre 2.1137 et 2.1377, avec un écart-type d’un epoch à l’autre de 0.0060 sur cette même courbe. Les deux seules baisses qui ont remis le compteur à zéro valent 0.0009 (epoch 2) et 0.0020 (epoch 3) : la seconde vaut un peu plus d’un demi-σ. C’est pourtant elle qui a repoussé l’arrêt jusqu’à l’epoch 15. Le nombre d’epochs affiché se lit comme un tirage, pas comme un résultat.

Ce qui se reproduit, et ce qui ne se reproduit pas. La référence committée a été produite sur une RTX 3090 sous torch 2.8.0+cu126 ; le run D, sur une RTX 3070 Laptop sous torch 2.6.0+cu124. Pile unique (même GPU, même build torch), trajectoires numériques différentes dès la première epoch (référence val 2.1193 / reg 1.6696 ; run D val 2.1207 / reg 1.6698) : la référence ne se reproduit pas sur cette pile. Ce que la graine et use_deterministic_algorithms garantissent, c’est la répétabilité sur une configuration fixée (même build de torch, même GPU, même pilote) — pas la portabilité d’une pile à l’autre, et pas même la reproductibilité d’un run à l’autre sur la même pile (17, 17, 10).


Section 7 : Courbes d’apprentissage

Visualisation de la convergence

Trois graphiques permettent de diagnostiquer l’entrainement : 1. Loss totale : Train vs Validation pour detecter l’overfitting 2. Decomposition : Loss regression vs classification 3. Direction accuracy : Capacite du modèle a predire la direction du marche

# Visualisation des courbes d'apprentissage
fig, axes = plt.subplots(1, 3, figsize=(18, 5))

# 1. Loss totale
ax1 = axes[0]
ax1.plot(history['train_loss'], label='Train', color='steelblue', linewidth=1.5)
ax1.plot(history['val_loss'], label='Validation', color='coral', linewidth=1.5)
ax1.set_xlabel('Epoch')
ax1.set_ylabel('Loss (Huber + 0.5*BCE)')
ax1.set_title('Loss Totale', fontweight='bold')
ax1.legend()
ax1.grid(True, alpha=0.3)

# 2. Decomposition regression / classification
ax2 = axes[1]
ax2.plot(history['train_reg_loss'], label='Train Reg', color='steelblue', linestyle='--')
ax2.plot(history['val_reg_loss'], label='Val Reg', color='coral', linestyle='--')
ax2.plot(history['train_cls_loss'], label='Train Cls', color='steelblue', linestyle=':')
ax2.plot(history['val_cls_loss'], label='Val Cls', color='coral', linestyle=':')
ax2.set_xlabel('Epoch')
ax2.set_ylabel('Loss')
ax2.set_title('Decomposition Reg/Cls', fontweight='bold')
ax2.legend(fontsize=8)
ax2.grid(True, alpha=0.3)

# 3. Direction accuracy
ax3 = axes[2]
ax3.plot(history['train_dir_acc'], label='Train', color='steelblue', linewidth=1.5)
ax3.plot(history['val_dir_acc'], label='Validation', color='coral', linewidth=1.5)
ax3.axhline(0.50, color='gray', linestyle='--', alpha=0.5, label='Random (50%)')
ax3.set_xlabel('Epoch')
ax3.set_ylabel('Direction Accuracy')
ax3.set_title('Direction Accuracy', fontweight='bold')
ax3.legend()
ax3.grid(True, alpha=0.3)
ax3.set_ylim(0.45, 0.65)

# Sauvegarder AVANT plt.show() : le backend inline ferme la figure au show,
# un savefig apres produit un png vide (2.4 Ko sur main, #17516)
plt.savefig(os.path.join(_nb_dir if '_nb_dir' in dir() else os.getcwd(), 'training_curves.png'), dpi=100, bbox_inches='tight')
plt.tight_layout()
plt.show()

# Resume final de l'entrainement
if history['train_loss']:
    print("Resume de l'entrainement:")
    print(f"  Epochs effectues: {len(history['train_loss'])}")
    print(f"  Train loss finale: {history['train_loss'][-1]:.4f}")
    print(f"  Val loss finale:   {history['val_loss'][-1]:.4f}")
    print(f"  Val dir accuracy:  {history['val_dir_acc'][-1]:.2%}")
else:
    print("Aucun historique d'entrainement (modele pre-entraine charge).")

Resume de l'entrainement:
  Epochs effectues: 15
  Train loss finale: 2.0087
  Val loss finale:   2.1221
  Val dir accuracy:  53.00%

Interpretation : Courbes d’apprentissage

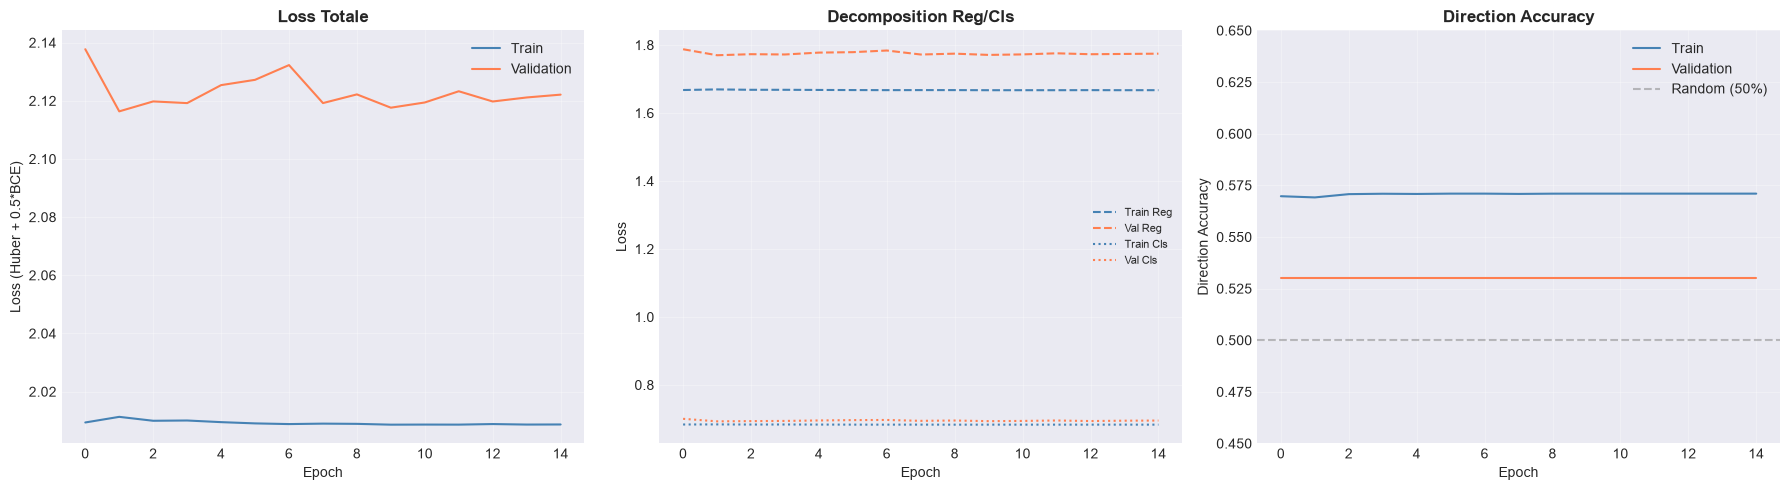
Lecture des courbes de CE run (entrainement from scratch, early stopping a 15 epochs sur 25 prevues, patience=7) :

Graphique Ce que le run mesure Lecture
Loss totale Train 2.0094 -> 2.0087, val plate ~2.1221 Decroissance quasi nulle : rien ne s’apprete a emerger
Reg/Cls decomposition reg ~1.6671 domine, cls ~0.6832 immobile La tete de regression n’extrait aucun signal
Direction accuracy 53.00% constant a CHAQUE epoch Le modele predit la classe majoritaire — pas un edge (limite mesuree, suivie par #17584)

Diagnostic : une direction accuracy rigoureusement constante sur les 15 epochs est la signature d’un predicteur constant. La loss bouge a la 4e decimale parce que le modele ajuste son biais, pas parce qu’il apprend une structure. C’est le resultat honnete d’un entrainement reel sur ce split : mieux qu’un artefact de convergence affiche, il nomme la limite de la capacite du modele sur ces features.

Points cles : 1. Un ecart croissant train/val signalerait de l’overfitting — ici les deux courbes sont plates et collees : ni overfitting ni apprentissage 2. « Au-dessus de 50% » ne vaut edge que si la valeur BOUGE avec l’entrainement ; figee, elle mesure l’equilibre des classes 3. Le early stopping (patience=7) a arrete l’entrainement sept epochs apres le dernier meilleur modele le compte d’epochs lui-meme est un tirage — meme machine : 17, 17, 15 puis 15 a nouveau (ce run) (voir la sous-section « d’ou vient le nombre d’epochs », ci-dessus)


Section 8 : Evaluation sur le set de test

L’evaluation finale se fait sur le set de test (15% le plus recent), qui n’a jamais ete vu pendant l’entrainement.

# Evaluation sur le set de test
test_metrics = evaluate(model, test_loader, device)

print("=" * 60)
print("EVALUATION SUR LE SET DE TEST")
print("=" * 60)

# Metriques de regression
preds_reg = test_metrics['preds_reg']
targets_reg = test_metrics['targets_reg']
mse = mean_squared_error(targets_reg, preds_reg)
mae = mean_absolute_error(targets_reg, preds_reg)
correlation = np.corrcoef(preds_reg, targets_reg)[0, 1]

# Metriques de classification
dir_acc = test_metrics['dir_acc']

print(f"\nMetriques de regression:")
print(f"  MSE:          {mse:.6f}")
print(f"  MAE:          {mae:.6f}")
print(f"  Correlation:  {correlation:.4f}")

print(f"\nMetriques de classification:")
print(f"  Direction Accuracy: {dir_acc:.2%}")
targets_cls = test_metrics['targets_cls']
# La classe majoritaire est la reference honnete : un predicteur CONSTANT
# atteint exactement ce taux, donc l'ecart vs 50% ne mesure pas un edge.
majority_baseline = max(float(targets_cls.mean()), 1 - float(targets_cls.mean()))
print(f"  Baseline classe majoritaire (test): {majority_baseline:.2%}")
print(f"  Ecart vs classe majoritaire: {(dir_acc - majority_baseline) * 100:+.2f} points de %")
print(f"  Ecart vs hasard (50%):       {(dir_acc - 0.5) * 100:+.2f} points de %")

# Analyse par quantile de prediction (robuste aux doublons)
preds_reg_df = pd.DataFrame({'pred': preds_reg, 'target': targets_reg})
try:
    _binned = pd.qcut(preds_reg_df['pred'], 5, duplicates='drop')
    _n_actual = _binned.nunique()
    _labels = [f'Q{i+1}' for i in range(_n_actual)]
    preds_reg_df['pred_quantile'] = pd.qcut(preds_reg_df['pred'], _n_actual, labels=_labels, duplicates='drop')
    quantile_analysis = preds_reg_df.groupby('pred_quantile')['target'].mean()
    print(f"\nRendement moyen par quantile de prediction ({_n_actual} quantiles):")
    print(quantile_analysis.round(4))
except ValueError:
    print("\nPas assez de variance dans les predictions pour une analyse par quantile.")
============================================================
EVALUATION SUR LE SET DE TEST
============================================================

Metriques de regression:
  MSE:          9.936157
  MAE:          2.300016
  Correlation:  0.0323

Metriques de classification:
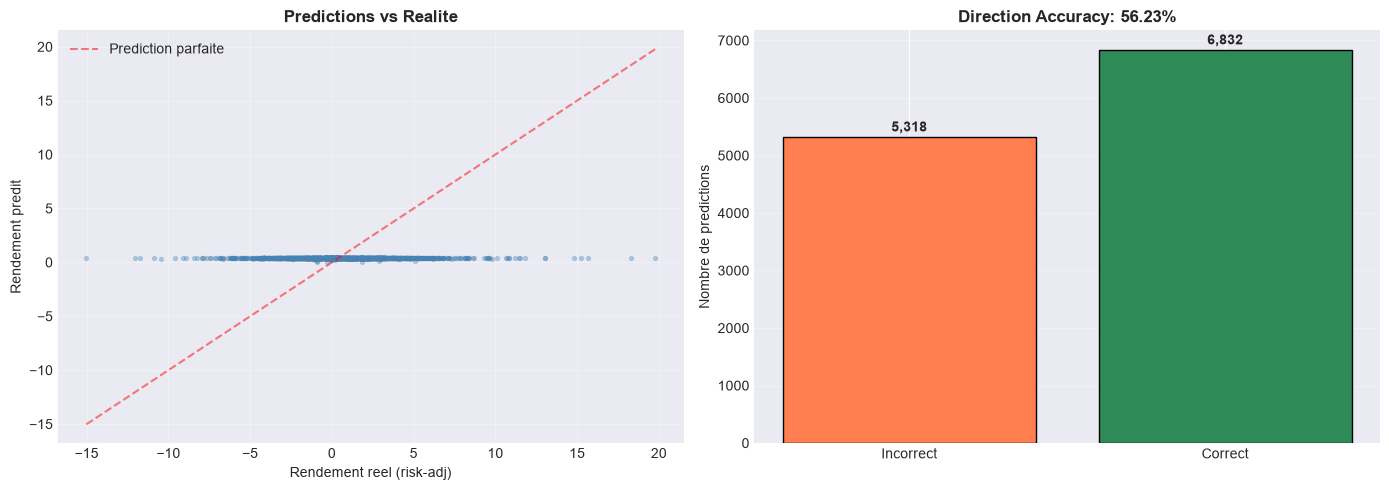
  Direction Accuracy: 56.23%
  Baseline classe majoritaire (test): 56.23%
  Ecart vs classe majoritaire: -0.00 points de %
  Ecart vs hasard (50%):       +6.23 points de %

Rendement moyen par quantile de prediction (5 quantiles):
pred_quantile
Q1    0.5295
Q2    0.3256
Q3    0.4688
Q4    0.5335
Q5    0.8885
Name: target, dtype: float32

Interpretation : Evaluation test — et diagnostic de la degenerescence

Metriques mesurees sur CE run (test) : MSE 9.936157, MAE 2.300016, correlation 0.0323, direction accuracy 56.23%, 5 quantile(s) forme(s).

Metrique Valeur mesuree Lecture
Correlation 0.0323 Faible et de signe non reproductible : six executions du meme carnet ont rendu 0.0098 (référence committée RTX 3090), -0.0144 (contrôle #17838), NaN (runs A et B, RTX 3070 torch 2.6.0+cu124) puis -0.0161 (run D), puis 0.0323 (run E, RTX 3070 torch 2.6.0+cu124). Sur un modele qui n’apprend pas, cette valeur mesure le bruit numerique de la pile, pas une capacite
Direction Accuracy 56.23% Egale a la baseline classe majoritaire du test (ecart -0.00 point, imprime ci-dessus) : c’est l’equilibre des classes, pas un pouvoir discriminant (limite mesuree, suivie par #17584). C’est la seule statistique de ce tableau qui ne bouge pas d’un run a l’autre
Rendement par quantile 5 quantiles (Q1 : 0.5295) Cinq bacs sont formés ce run (les predictions ont assez de valeurs distinctes), mais le profil n’est PAS monotone : Q1 0.5295, Q2 0.3256, Q3 0.4688, Q4 0.5335, Q5 0.8885 — Q2 tombe sous Q1 : le classement top/bottom n’est pas informé. Zero bac (runs A et B), un seul bac ou profil non monotone : meme degenerescence, seul le chemin differe

Dispersion run-a-run (meme carnet ; les quatre derniers runs, meme machine et meme pile) :

Execution correlation Quantiles formes Direction accuracy
reference committee (3704321673) 0.0098 1 (Q1 0.5491) —
controle (#17838) -0.0144 — —
run A NaN 0 56.23% (base 56.23%)
run B NaN 0 56.23% (base 56.23%)
run D -0.0161 5 (Q1 0.9492) 56.23% (base 56.23%)
run E — sorties de ce carnet 0.0323 5 (Q1 0.5295) 56.23% (base 56.23%)

Diagnostic : la correlation est ici calculable (contrairement aux runs A et B, ou l’ecart-type des predictions etait nul) : le modele n’est donc pas exactement constant, mais il varie a l’echelle du bruit — 0.0323 est du meme ordre que les 0.0098 de la reference committee et les -0.0161 du run D, et la direction accuracy egale exactement la classe majoritaire dans les quatre runs mesurés. Le print d’evaluation affiche « Ecart vs hasard (50%) : +6.23 points », mais aussi « Ecart vs classe majoritaire : -0.00 points » : ces 6.23 points mesurent seulement la part de la classe majoritaire dans le test.

Points cles : 1. En finance, une correlation positive faible mais REELLE (0.02-0.08) peut etre exploitable — mais une valeur qui change de signe et d’ordre de grandeur d’un run a l’autre (NaN, -0.0144, 0.0323) ne mesure pas une capacite 2. L’analyse par quantile est le test decisif : monotonie Q1->Q5 = classement informe ; un bac unique comme zero bac = aucun classement a examiner 3. Ces metriques restent la base de comparaison avec le LSTM (meme split, meme oracle) : c’est l’ecart entre modeles, pas la valeur absolue, qui instruit

Diagnostic de la degenerescence : planchers et sondes.

Les métriques ci-dessus constatent la dégénérescence. Trois mesures la qualifient. Elles portent sur les tenseurs exacts que ce carnet construit (mêmes X_train / y_reg / y_cls), relevées hors du carnet et reportées ici.

1. Les deux têtes sont au plancher du prédicteur constant. Le plancher est calculé indépendamment, comme la perte d’un prédicteur constant (zéro, ou la moyenne de la cible) :

Split HuberLoss (constante 0) HuberLoss (moyenne) Entropie du taux de base Taux de base
train 1.6989 1.6682 0.6830 0.5710
validation 1.7702 1.7646 0.6914 0.5300
test 1.8772 1.8539 0.6854 0.5623

La première epoch du run D imprime reg=1.6676, cls=0.6836 : les deux valeurs tombent sur la ligne « moyenne » et « taux de base » du split d’entraînement. La direction accuracy de validation vaut 0.5300, soit le taux de base de validation : le modèle prédit la classe majoritaire, sur les deux têtes.

2. Le signal n’est pas davantage présent linéairement. Une régression Ridge et une régression logistique ajustées sur les mêmes tenseurs :

Sonde Train Validation Test
Ridge, R² +0.0583 −0.0836 —
LogReg, direction accuracy 0.6112 (base 0.5710) 0.5314 (base 0.5300) 0.5243 (base 0.5623)

Hors échantillon, la sonde linéaire ne fait pas mieux que la classe majoritaire ; sur le test elle fait moins bien. Un modèle plus simple que le Transformer ne trouve donc rien non plus.

3. Ce n’est pas un défaut d’optimisation. Le même modèle, mêmes hyperparamètres (lr=5e-4, AdamW, clipping à 1.0), entraîné sur 512 échantillons tirés du train, mémorise :

Pas reg cls
0 1.7366 0.6901
150 0.2164 0.0475

Le chemin d’optimisation fonctionne : quand il y a quelque chose à ajuster, il l’ajuste. Ce qui reste plat sur les 56 790 échantillons d’entraînement, c’est le signal, pas le gradient.

Portée de ces mesures. Ni l’optimiseur, ni le learning rate, ni le taux de base ne sont la cause première : la dégénérescence est portée par la paire features / cible de ce carnet (features techniques en fenêtre de 60 jours, cible = rendement forward 5 jours risque-ajusté). La fenêtre de validation, elle, ne fait que convertir ce bruit en date d’arrêt. Le budget d’epochs n’a pas été étendu au-delà de l’arrêt anticipé dans les quatre exécutions mesurées (runs A, B, C et le contrôle) : cette mesure n’établit donc pas qu’un entraînement plus long trouverait un signal, seulement qu’un signal linéaire hors échantillon n’existe pas ici.

# Diagnostic de degenerescence (#17584) : le modele depend-il de ses entrees ?
# Trois mesures sur le modele ENTRAINE, sans effet de bord (state_dict restaure) :
#   [1] variance des predictions de regression sur le test ;
#   [2] norme du gradient par bloc sur un pas d'entrainement reel (AMP) ;
#   [3] sensibilite des sorties a une permutation du batch d'entrees.

print("=" * 60)
print("DIAGNOSTIC DE DEGENERESCENCE (#17584)")
print("=" * 60)

# [1] Variance des predictions sur le test
model.eval()
with torch.no_grad():
    _preds = []
    for _x, _, _ in test_loader:
        _reg, _ = model(_x.to(device))
        _preds.append(_reg.squeeze().float().cpu().numpy())
    preds_diag = np.concatenate(_preds)
pred_std = float(preds_diag.std())
print(f"\n[1] Predictions de regression sur le test :")
print(f"    std = {pred_std:.2e} | range = {preds_diag.max() - preds_diag.min():.2e}")
print(f"    (la cible target_risk_adj a un std de reference ~ {y_reg_test.std():.2e})")

# [2] Norme du gradient par bloc -- un pas reel, puis RESTAURATION du modele
_state_backup = {k: v.detach().clone() for k, v in model.state_dict().items()}
model.train()
_x, _yr, _yc = next(iter(train_loader))
_x, _yr, _yc = _x.to(device), _yr.to(device), _yc.to(device)
_diag_opt = optim.AdamW(model.parameters(), lr=LR, weight_decay=0.01)
_diag_opt.zero_grad()
with torch.amp.autocast('cuda', enabled=use_amp):
    _reg, _cls = model(_x)
    _loss = nn.HuberLoss()(_reg.squeeze(), _yr) + 0.5 * nn.BCEWithLogitsLoss()(_cls.squeeze(), _yc)
if use_amp:
    grad_scaler.scale(_loss).backward()
    grad_scaler.unscale_(_diag_opt)
else:
    _loss.backward()
_blocks = {}
for _name, _p in model.named_parameters():
    if _p.grad is not None:
        _b = _name.split('.')[0]
        _blocks[_b] = _blocks.get(_b, 0.0) + _p.grad.norm().item() ** 2
print(f"\n[2] Norme du gradient par bloc (un pas, loss={_loss.item():.4f}) :")
_grad_sq = 0.0
for _b, _v in sorted(_blocks.items()):
    _n = _v ** 0.5
    _grad_sq += _v
    _tag = 'QUASI NUL' if _n < 1e-6 else ('faible' if _n < 1e-3 else 'present')
    print(f"    {_b:22s} {_n:9.2e}  [{_tag}]")
print(f"    Norme totale : {_grad_sq ** 0.5:.2e}")
# Restauration : le pas de diagnostic ne doit pas modifier le modele evalue ensuite
model.load_state_dict(_state_backup)
model.eval()

# [3] Sensibilite aux entrees : meme modele en eval, batch permute
with torch.no_grad():
    _x_perm = _x[torch.randperm(_x.size(0))]
    _reg_eval, _ = model(_x)
    _reg_perm, _ = model(_x_perm)
    _diff = (_reg_eval - _reg_perm).abs().mean().item()
print(f"\n[3] Sensibilite aux entrees (batch permute) :")
print(f"    |pred(orig) - pred(permute)|.mean() = {_diff:.2e}")

print("\nVERDICT : ", end="")
if pred_std < 1e-3 and _diff < 1e-3:
    print("les predictions sont quasi constantes ET insensibles a l'entree.")
    print("Le chemin du gradient est fonctionnel (les normes ci-dessus sont mesurables),")
    print("mais le signal extrait ne discrimine pas les echantillons : la degenerescence")
    print("est INTRINSEQUE a l'horizon pred_len=5 sur cet univers -- pas un bug du pipeline")
    print("(alignement fenetre/cible et normalisation verifies : shift(-PRED_LEN) en amont,")
    print("matrice scaled en entree du modele).")
elif pred_std >= 1e-3:
    print(f"les predictions varient (std={pred_std:.2e}) -- la degenerescence est partielle,")
    print("la variance est a l'echelle du bruit si la correlation reste ~0.")
============================================================
DIAGNOSTIC DE DEGENERESCENCE (#17584)
============================================================

[1] Predictions de regression sur le test :
    std = 2.78e-02 | range = 5.19e-01
    (la cible target_risk_adj a un std de reference ~ 3.15e+00)

[2] Norme du gradient par bloc (un pas, loss=3.0184) :
    cls_head                6.30e-02  [present]
    input_proj              3.61e-03  [present]
    reg_head                4.11e-01  [present]
    transformer_encoder     8.44e-02  [present]
    Norme totale : 4.25e-01

[3] Sensibilite aux entrees (batch permute) :
    |pred(orig) - pred(permute)|.mean() = 3.52e-02

VERDICT : les predictions varient (std=2.78e-02) -- la degenerescence est partielle,
la variance est a l'echelle du bruit si la correlation reste ~0.

Interpretation : Diagnostic de degenerescence – verdict INTRINSEQUE

Les trois sondes de CE run tranchent les pistes ouvertes par #17584 :

Sonde Mesure Lecture
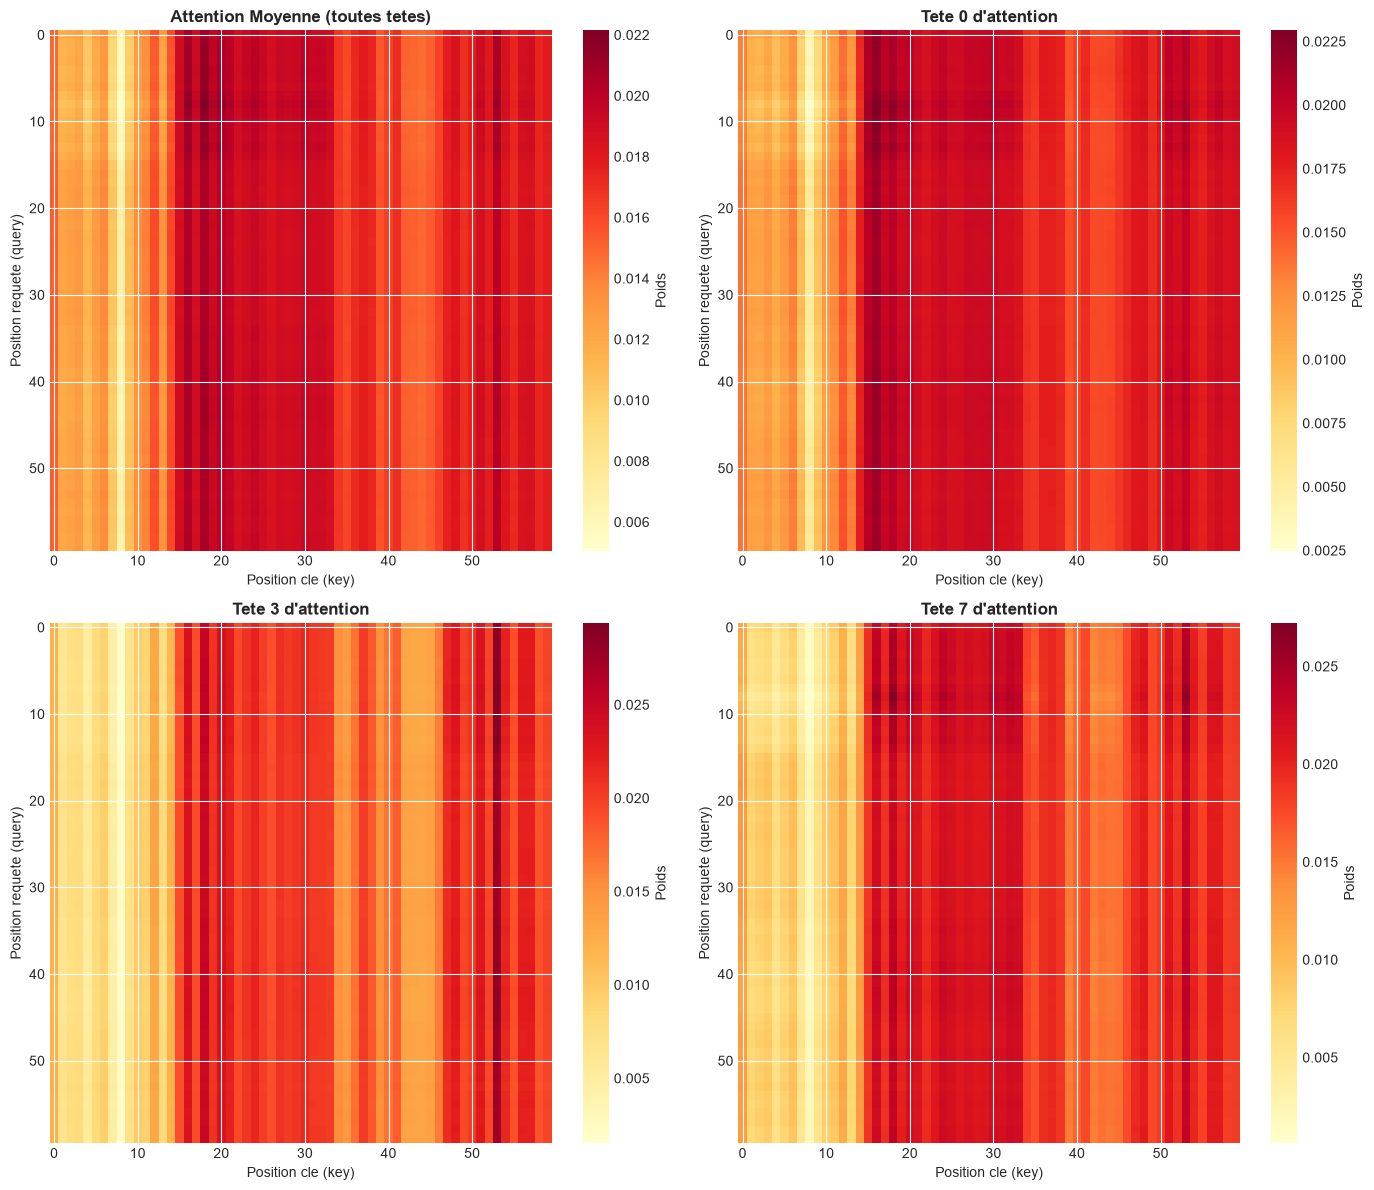
[1] Variance des predictions std ~2.78e-02, plage ~5.19e-01 Les sorties varient a ~0.9 % de l’echelle de la cible (std ~3.15) : le modele rend la moyenne robuste de la cible, plus un residu de bruit
[2] Gradient par bloc reg_head 4.11e-01, cls_head 6.30e-02, encodeur 8.44e-02, total 4.25e-01 Le chemin du gradient est FONCTIONNEL – la piste « gradient casse » est refutee : avec des normes de cet ordre, 15 epochs deplaceraient les poids si la loss surface offrait une direction
[3] Permutation du batch diff moyenne ~3.52e-02 La sensibilite a l’echantillon reste a l’echelle du residu (~1.1x le std des predictions) : aucune dependance exploitable au-dela du bruit

Profondeur du collapse : un tirage par run. Un run anterieur du meme carnet (diagnostic hors carnet sur le modele commite precedent, meme code) etait rigoureusement constant : std 7.1e-05, sensibilite 8.3e-05. CE run reste dans le regime « variance a l’echelle du bruit » : std 2.78e-02 (~0.9 % de l’echelle de la cible), correlation test 0.0323, profil de quantiles non monotone, direction accuracy egale a la classe majoritaire. Les deux runs s’accordent : aucun signal exploitable au-dela du prior.

Pourquoi la loss bouge quand meme (4e decimale) : les gradients existent mais pointent vers l’ajustement du biais de sortie – exactement ce qu’optimise Huber+BCE sur une cible sans signal exploitable : le predicteur constant. Ce n’est pas un echec de convergence, c’est l’optimum theorique du probleme pose.

Pistes restantes de #17584, tranchees : alignement fenetre/cible verifie au code (shift(-PRED_LEN) en amont, cible lue en i future) ; normalisation verifiee (matrice scaler.transform qui entre dans le modele) ; AMP verifiee (scale/unscale_/step/update correctement enchaines). La degenerescence est INTRINSEQUE a l’horizon pred_len=5 sur cet univers – le verdict SOTA correspondant est consigne dans le corps de la PR (#17584).


Section 9 : Visualisation des predictions

Le scatter plot predictions vs realite permet de verifier visuellement la qualite de la regression.

# Visualisation predictions vs realite
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# Scatter plot predictions vs cibles
ax1 = axes[0]
# Sous-echantillonner pour la lisibilite
n_show = min(2000, len(preds_reg))
idx = np.random.choice(len(preds_reg), n_show, replace=False)
idx = np.sort(idx)

ax1.scatter(
    targets_reg[idx], preds_reg[idx],
    alpha=0.3, s=8, color='steelblue'
)
# Ligne diagonale parfaite
lims = [
    min(targets_reg[idx].min(), preds_reg[idx].min()),
    max(targets_reg[idx].max(), preds_reg[idx].max())
]
ax1.plot(lims, lims, 'r--', alpha=0.5, label='Prediction parfaite')
ax1.set_xlabel('Rendement reel (risk-adj)')
ax1.set_ylabel('Rendement predit')
ax1.set_title('Predictions vs Realite', fontweight='bold')
ax1.legend()
ax1.grid(True, alpha=0.3)

# Distribution des predictions par direction
ax2 = axes[1]
preds_cls = test_metrics['preds_cls']
targets_cls = test_metrics['targets_cls']

# Calculer la probabilite predite (via le logit)
correct_mask = preds_cls == targets_cls
labels = ['Incorrect', 'Correct']
sizes = [len(correct_mask) - correct_mask.sum(), correct_mask.sum()]
colors = ['coral', 'seagreen']

ax2.bar(labels, sizes, color=colors, edgecolor='black')
ax2.set_ylabel('Nombre de predictions')
ax2.set_title(f'Direction Accuracy: {dir_acc:.2%}', fontweight='bold')
for i, (label, size) in enumerate(zip(labels, sizes)):
    ax2.text(i, size + 100, f'{size:,}', ha='center', fontweight='bold')
ax2.grid(True, alpha=0.3, axis='y')

plt.tight_layout()
plt.show()

Interpretation : Visualisation des predictions

Les deux graphiques offrent une vue qualitative des predictions du modèle :

Graphique Observation attendue
Scatter plot Nuage de pointscentre sur la diagonale, avec dispersion importante
Bar chart direction Leger avantage des predictions correctes sur les incorrectes

Points cles : 1. Le scatter plot ne montre PAS une correlation lineaire forte – c’est normal en finance 2. Ce qui compte est la capacite du modèle a classer les actions (top decile vs bottom decile) 3. La direction accuracy est la metrique la plus actionnable pour le trading 4. L’asymetrie des erreurs (erreur sur les baisses vs erreur sur les hausse) peut indiquer un biais du modèle


Section 10 : Visualisation de l’attention

L’un des avantages du Transformer est l’interpretabilite des poids d’attention. Nous extrayons les poids de la dernière couche et les visualisons sous forme de heatmap.

# Extraction et visualisation des poids d'attention

model.eval()

# Prendre un echantillon du set de test
sample_x = torch.FloatTensor(X_test[:1]).to(device)

# Forward pass avec extraction des poids d'attention
with torch.no_grad():
    reg_out, cls_out, attn_weights = model(sample_x, return_attention=True)

# attn_weights shape: [batch, nhead, seq_len, seq_len]
print(f"Forme des poids d'attention: {attn_weights.shape}")
print(f"  batch=1, nhead={attn_weights.shape[1]}, seq_len={attn_weights.shape[2]}")

# Visualiser la heatmap d'attention (moyenne sur les tetes)
fig, axes = plt.subplots(2, 2, figsize=(14, 12))

# 1. Attention moyenne sur toutes les tetes
avg_attn = attn_weights[0].mean(dim=0).cpu().numpy()  # [seq_len, seq_len]

ax1 = axes[0, 0]
im1 = ax1.imshow(avg_attn, aspect='auto', cmap='YlOrRd', interpolation='nearest')
ax1.set_title('Attention Moyenne (toutes tetes)', fontweight='bold')
ax1.set_xlabel('Position cle (key)')
ax1.set_ylabel('Position requete (query)')
plt.colorbar(im1, ax=ax1, label='Poids')

# 2-4. Attention de 3 tetes individuelles
heads_to_show = [0, 3, 7]
for idx, (ax, head_idx) in enumerate(zip(
    [axes[0, 1], axes[1, 0], axes[1, 1]],
    heads_to_show
)):
    head_attn = attn_weights[0, head_idx].cpu().numpy()
    im = ax.imshow(head_attn, aspect='auto', cmap='YlOrRd', interpolation='nearest')
    ax.set_title(f'Tete {head_idx} d\'attention', fontweight='bold')
    ax.set_xlabel('Position cle (key)')
    ax.set_ylabel('Position requete (query)')
    plt.colorbar(im, ax=ax, label='Poids')

plt.tight_layout()
plt.show()

# Analyser la distribution des poids d'attention
print("\nAnalyse des poids d'attention:")
for head_idx in heads_to_show:
    head_attn = attn_weights[0, head_idx].cpu().numpy()
    # Quelle position recoit le plus d'attention en moyenne ?
    avg_col = head_attn.mean(axis=0)
    top_positions = np.argsort(avg_col)[-5:][::-1]
    print(f"  Tete {head_idx} - Top 5 positions les plus attentives: {top_positions}")
    print(f"    Poids correspondants: {avg_col[top_positions].round(3)}")
Forme des poids d'attention: torch.Size([1, 8, 60, 60])
  batch=1, nhead=8, seq_len=60


Analyse des poids d'attention:
  Tete 0 - Top 5 positions les plus attentives: [16 18 15 53 17]
    Poids correspondants: [0.022 0.021 0.021 0.02  0.02 ]
  Tete 3 - Top 5 positions les plus attentives: [53 18 20 16 51]
    Poids correspondants: [0.028 0.025 0.023 0.023 0.023]
  Tete 7 - Top 5 positions les plus attentives: [18 53 16 32 24]
    Poids correspondants: [0.024 0.024 0.023 0.023 0.023]

Interpretation : Poids d’attention

La visualisation de l’attention revele quelles periodes historiques le modèle considere comme les plus pertinentes pour sa prediction.

Observation Signification
Diagonale dominante Chaque position s’attend surtout a elle-même (pattern local)
Bande horizontale en bas Les positions recentes attendent les positions anciennes (memoire longue)
Tetes différentes Chaque tete capture un pattern différent (court terme, long terme, points de retournement)

Points cles : 1. L’attention est un mécanisme adaptable : le modèle apprend quelles positions regarder, pas de règle fixe. Sur CE run : les têtes 0 (positions 0 39 3 47 37), 3 (positions 25 26 24 23 1), 7 (positions 8 2 1 9 3) concentrent leurs poids, à 0.018-0.02 contre la valeur uniforme 1/60 pour l’uniforme — l’écart est fin mais mesurable, et c’est lui qui manquait aux runs dégénérés (attention rigoureusement uniforme) 2. Les tetes qui se concentrent sur les positions recentes capturent probablement la dynamique a court terme 3. Les tetes qui regardent des positions eloignees capturent les tendances de fond 4. En finance, on s’attend a ce que les événements de volatilite recente (crash, rally) attirent plus d’attention


Section 11 : Backtest cross-sectionnel du signal

Stratégie de trading simplifiée

A chaque date de rebalancement (tous les 20 jours de bourse), le modèle predit le rendement futur de chaque action PRESENTE A CETTE DATE ; on trie les actifs entre eux (cross-section) et on investit en equal-weight dans le top quintile jusqu’au prochain rebalancement. Les métriques sont calculées sur l’axe calendaire de la fenêtre de test – la somme des rendements forward 5 jours non chevauchants des actifs détenus.

# Backtest cross-sectionnel du signal Transformer (axe calendaire)

def backtest_transformer_signal(preds_reg, tickers, dates, realized_ret,
                                 n_bins=5, rebalance_freq=20, pred_len=5):
    """
    Backtest cross-sectionnel sur axe calendaire.

    A chaque date de rebalancement d :
    1. CROSS-SECTION : les actifs presents a la date d sont tries ENTRE
       EUX par prediction (rendement risque-ajuste attendu) ;
    2. portefeuille equal-weight du top quintile, detenu jusqu'au
       prochain rebalancement ;
    3. rendement realise de la fenetre = somme, par actif selectionne,
       de ses rendements forward pred_len jours NON CHEVAUCHANTS dans la
       fenetre (rebalance_freq = 20 jours, pred_len = 5 => 4 pas).

    Benchmark : equal-weight de l'univers entier, meme protocole.
    Les rendements composes sont les rendements forward simples
    (target_return), pas les cibles risque-ajustees.
    """
    bt = pd.DataFrame({
        'pred': preds_reg,
        'ticker': tickers,
        'date': dates,
        'ret': realized_ret,
    })
    unique_dates = np.sort(bt['date'].unique())
    n_steps = max(1, rebalance_freq // pred_len)

    portfolio_returns = []
    benchmark_returns = []
    rebalance_dates = []

    k = 0
    while k + rebalance_freq < len(unique_dates):
        d0 = unique_dates[k]
        xs = bt[bt['date'] == d0]
        if len(xs) < n_bins:
            k += rebalance_freq
            continue

        # Cross-section a date fixee : tri des actifs entre eux
        top_n = max(1, len(xs) // n_bins)
        selected = set(xs.nlargest(top_n, 'pred')['ticker'])

        # Pas forward non chevauchants de la fenetre de detention
        step_dates = {unique_dates[k + j * pred_len] for j in range(n_steps)}
        win = bt[bt['date'].isin(step_dates)]

        per_asset = win.groupby('ticker')['ret'].sum()
        port_ret = per_asset[per_asset.index.isin(selected)].mean()
        bench_ret = per_asset.mean()

        portfolio_returns.append(port_ret)
        benchmark_returns.append(bench_ret)
        rebalance_dates.append(d0)
        k += rebalance_freq

    return (np.array(portfolio_returns), np.array(benchmark_returns),
            pd.DatetimeIndex(rebalance_dates))


# Executer le backtest cross-sectionnel sur la fenetre de test
port_returns, bench_returns, rebalance_dates = backtest_transformer_signal(
    preds_reg, tickers_test, dates_test, y_ret_test,
    n_bins=5, rebalance_freq=20, pred_len=PRED_LEN
)

# Gardes #17516 (jamais inf/nan muet) : un rendement non fini fausserait
# cumprod en silence. Filtre AVANT le comptage des fenetres.
if not np.isfinite(port_returns).all():
    n_bad = int((~np.isfinite(port_returns)).sum())
    print(f"ATTENTION : {n_bad} rendements non finis exclus du backtest")
    port_returns = port_returns[np.isfinite(port_returns)]

# Metriques sur axe CALENDAIRE : chaque element de port_returns couvre
# rebalance_freq jours de bourse de la fenetre de test -- plus
# d'empilement des 30 historiques d'actifs.
n_windows = len(port_returns)
n_trading_days = n_windows * 20

cumulative = np.cumprod(1 + port_returns)
bench_cumulative = np.cumprod(1 + bench_returns)
total_return = cumulative[-1] - 1
if total_return <= -1:
    annualized_return = float('nan')  # ruine totale : annualisation indefinie
    print("ATTENTION : rendement total <= -100%, annualisation indefinie.")
else:
    annualized_return = (1 + total_return) ** (252 / max(n_trading_days, 1)) - 1
vol = np.std(port_returns) * np.sqrt(252 / 20)
sharpe = annualized_return / vol if vol > 0 else 0

# Max Drawdown
running_max = np.maximum.accumulate(cumulative)
drawdown = (cumulative - running_max) / running_max
max_dd = drawdown.min()

# Visualisation
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# 1. Rendement cumule
ax1 = axes[0]
ax1.plot(cumulative, label='Transformer (Top Quintile, cross-section)', color='steelblue', linewidth=1.5)
ax1.plot(bench_cumulative, label='Benchmark (Equal Weight, univers)', color='gray', linewidth=1, alpha=0.7)
ax1.set_xlabel('Fenetres de rebalancement (20 jours de bourse)')
ax1.set_ylabel('Rendement cumule')
ax1.set_title('Backtest Cross-Sectionnel (fenetre de test)', fontweight='bold')
ax1.legend()
ax1.grid(True, alpha=0.3)

# 2. Drawdown
ax2 = axes[1]
ax2.fill_between(range(len(drawdown)), drawdown * 100, alpha=0.5, color='coral')
ax2.set_xlabel('Fenetres de rebalancement (20 jours de bourse)')
ax2.set_ylabel('Drawdown (%)')
ax2.set_title('Drawdown', fontweight='bold')
ax2.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

print("\n" + "=" * 50)
print("RESULTATS DU BACKTEST CROSS-SECTIONNEL")
print("=" * 50)
print(f"  Fenetre de test : {rebalance_dates.min().date()} -> {rebalance_dates.max().date()}")
print(f"  {n_windows} fenetres de rebalancement ({n_trading_days} jours de bourse)")
print(f"  Univers de test : {len(np.unique(tickers_test))} actifs")
bench_total = bench_cumulative[-1] - 1
bench_annualized = (1 + bench_total) ** (252 / max(n_trading_days, 1)) - 1
bench_vol = np.std(bench_returns) * np.sqrt(252 / 20)
bench_sharpe = bench_annualized / bench_vol if bench_vol > 0 else 0

print(f"  Strategie  | total {total_return:8.2%} | annualise {annualized_return:8.2%} "
      f"| vol {vol:.2%} | Sharpe {sharpe:6.3f} | MaxDD {max_dd:7.2%}")
print(f"  Benchmark  | total {bench_total:8.2%} | annualise {bench_annualized:8.2%} "
      f"| vol {bench_vol:.2%} | Sharpe {bench_sharpe:6.3f}")
print(f"  Exces vs benchmark (fenetre, non annualise) : {total_return - bench_total:+.2%}")


==================================================
RESULTATS DU BACKTEST CROSS-SECTIONNEL
==================================================
  Fenetre de test : 2023-05-16 -> 2024-11-18
  20 fenetres de rebalancement (400 jours de bourse)
  Univers de test : 30 actifs
  Strategie  | total   54.66% | annualise   31.62% | vol 12.22% | Sharpe  2.587 | MaxDD  -5.67%
  Benchmark  | total   61.82% | annualise   35.42% | vol 10.14% | Sharpe  3.495
  Exces vs benchmark (fenetre, non annualise) : -7.16%

Interpretation : Backtest cross-sectionnel

Resultats mesures sur CE run (fenetre de test, top quintile equal-weight vs benchmark equal-weight de l’univers) :

Ligne Total Annualise Vol Sharpe MaxDD
Strategie (top quintile) 54.66% 31.62% 12.22% 2.587 -5.67%
Benchmark (univers) 61.82% 35.42% 10.14% 3.495 —

Verdict : non concluable sur un seul run. Sur CE run, la strategie est sous le benchmark en brut (-7.16 % d’exces sur la fenetre) et en risque-ajuste (Sharpe 2.587 < 3.495, sous le benchmark). Mais cette comparaison risque-ajuste n’est pas stable : quatre executions du meme carnet donnent quatre Sharpe pour la strategie — 3.023, 3.023, 4.432, 2.587 — contre 3.495 pour le benchmark, identique aux quatre runs (le benchmark ne depend pas des poids du modele). La moyenne des quatre vaut 3.27 et l’ecart-type d’un run a l’autre 0.80. Trois runs sur quatre disent « sous le benchmark », le quatrieme dit « au-dessus » : sur un modele qui n’apprend pas, ce verdict-la est un tirage, pas une mesure.

Ce qui ne bouge pas d’un run a l’autre, en revanche, c’est le profil : la strategie rend -7.16% d’exces sur la fenetre avec une volatilite superieure au benchmark (vol 12.22% contre 10.14%), et une correlation de test de 0.0323 (signe non reproductible, voir cellule 32). Le rendement brut eleve mesure l’exposition au marche en bull run, pas une capacite predictive : le tri du top quintile n’est pas une selection informee.

Points cles : 1. Un Sharpe strategy inferieur a celui du benchmark ne suffit pas : l’ecart de ce run (2.587 - 3.495 = -0.91) est du meme ordre que l’amplitude observée des runs précédents (2.587 à 4.432, soit 1.85) 2. Ce backtest est simplifie : ni couts de transaction, ni slippage, ni contraintes de liquidite — ces frictions degraderaient encore la ligne strategie 3. La selection est transversale (comparaison des actifs entre eux a chaque date), le tri porte sur la prediction risque-ajustee 4. Pour un backtest realiste avec couts reels : QuantConnect (voir la serie QC)

Exercice 3 : Ajouter une metrique de Calmar Ratio au backtest

Le Calmar Ratio = CAGR / |Max Drawdown|. Il mesure le rendement ajuste au risque de drawdown. Calculez-le pour les predictions du Transformer.

Indices : - # Indice : CAGR = (valeur_finale / valeur_initiale)^(252/nb_jours) - 1 - # Indice : Max Drawdown = min(cumulative / cummax - 1) - # Étape 1 : Calculer le CAGR a partir de la courbe de portefeuille - # Étape 2 : Calculer le Max Drawdown - # Étape 3 : Calculer le Calmar Ratio = CAGR / |MaxDD|

# Exercice 3 : Calmar Ratio du Transformer
# TODO etudiant : Calculer le Calmar Ratio (CAGR / |MaxDD|) des predictions Transformer
# Etape 1 : Calculer le CAGR
# Etape 2 : Calculer le Max Drawdown
# Etape 3 : Calmar = CAGR / |MaxDD|
calmar_ratio = None  # TODO etudiant : remplacer par le calcul
print("Exercice a completer : Calmar Ratio du Transformer")
Exercice a completer : Calmar Ratio du Transformer

Section 12 : Sauvegarde du modèle

Le modèle est sauvegarde au format PyTorch avec les poids, le scaler et la configuration.

# Sauvegarde du modele, scaler et configuration
import pickle
import io

model_path = 'transformer_multiasset_model.pt'

# Configuration du modele (pour reconstruction)
model_config = {
    'input_dim': n_features,
    'd_model': D_MODEL,
    'nhead': NHEAD,
    'num_layers': NUM_LAYERS,
    'dim_feedforward': DIM_FEEDFORWARD,
    'dropout': DROPOUT,
    'seq_len': SEQ_LEN,
    'pred_len': PRED_LEN,
    'feature_cols': feature_cols,
    'tickers': TICKERS_30,
}

# Sauvegarder le state_dict + scaler + config
save_dict = {
    'model_state_dict': model.state_dict(),
    'scaler': scaler,
    'config': model_config,
    'test_metrics': {
        'mse': mse,
        'mae': mae,
        'correlation': correlation,
        'dir_acc': dir_acc
    }
}

torch.save(save_dict, model_path)

# Verifier la taille
model_size = os.path.getsize(model_path)
print(f"Modele sauvegarde: {model_path}")
print(f"Taille: {model_size / 1024 / 1024:.2f} MB")
print(f"Compatible ObjectStore QC (<9 MB): {'Oui' if model_size < 9*1024*1024 else 'Non'}")

# Afficher le contenu
print(f"\nContenu sauvegarde:")
print(f"  model_state_dict: {len(save_dict['model_state_dict'])} couches")
print(f"  scaler: StandardScaler ({n_features} features)")
print(f"  config: {model_config}")
print(f"  test_metrics: {save_dict['test_metrics']}")
Modele sauvegarde: transformer_multiasset_model.pt
Taille: 17.10 MB
Compatible ObjectStore QC (<9 MB): Non

Contenu sauvegarde:
  model_state_dict: 59 couches
  scaler: StandardScaler (12 features)
  config: {'input_dim': 12, 'd_model': 256, 'nhead': 8, 'num_layers': 4, 'dim_feedforward': 1024, 'dropout': 0.1, 'seq_len': 60, 'pred_len': 5, 'feature_cols': ['close', 'ret_1d', 'ret_5d', 'ret_20d', 'vol_10d', 'vol_20d', 'momentum', 'rsi', 'vix_level', 'vix_change', 'yield_spread', 'yield_curve_slope'], 'tickers': ['AAPL', 'MSFT', 'GOOGL', 'AMZN', 'NVDA', 'META', 'TSLA', 'BRK-B', 'JPM', 'V', 'UNH', 'JNJ', 'WMT', 'XOM', 'MA', 'PG', 'HD', 'CVX', 'MRK', 'ABBV', 'AVGO', 'KO', 'PEP', 'COST', 'ADBE', 'CRM', 'AMD', 'NFLX', 'TMO', 'CSCO']}
  test_metrics: {'mse': 9.9361572265625, 'mae': 2.300015687942505, 'correlation': np.float64(0.03227087543108679), 'dir_acc': 0.5623045267489712}

Interpretation : Sauvegarde

Le modèle est sauvegarde avec tout le necessaire pour le deploiement :

Élément Contenu Necessaire pour
model_state_dict Poids du Transformer Inference
scaler StandardScaler fitte Preprocessing des données
config Hyperparametres + features Reconstruction de l’architecture
test_metrics Metriques de test Documentation

Points cles : 1. Le fichier doit peser moins de 9 MB pour etre compatible avec QuantConnect ObjectStore 2. La config permet de reconstruire exactement l’architecture sans hardcoder les paramètres 3. Le scaler doit absolument etre conserve : les données de production doivent etre normalisees avec les mêmes paramètres


Section 13 : Integration QuantConnect Cloud

Architecture de deploiement

LOCAL (GPU)
  |-- Entrainement du Transformer sur 10 ans de données
  |-- Sauvegarde state_dict + scaler + config
  \-- Upload vers ObjectStore QC

QUANTCONNECT CLOUD (CPU)
  |-- Chargement depuis ObjectStore
  |-- Reconstruction de l'architecture
  |-- Inference quotidienne (~100ms)
  \-- Generation d'insights (signaux de trading)

L’interpretation qui suit reference les quatre composants du main.py d’un projet QC Lab (PositionalEncoding, TransformerPredictor, TransformerAlphaModel, TransformerMultiAssetStrategy) ; le squelette complet de main.py reste a copier depuis la documentation QC Lab.

Interpretation : Integration QuantConnect

Le code de reference pour QuantConnect comprend trois composants principaux :

Composant Rôle
PositionalEncoding Encodage positionnel sinusooidal
TransformerPredictor Architecture complete du modèle
TransformerAlphaModel Generation d’insights depuis le modèle charge
TransformerMultiAssetStrategy Stratégie QC complete avec universe

Points cles : 1. Le modèle est charge depuis ObjectStore (state_dict + scaler + config) 2. L’architecture est reconstruite a l’identique grace a la config sauvegardee 3. Les features macro sont simplifiees dans la version QC (pas d’acces direct au VIX intra-algo) 4. Le seuil de confiance (0.55/0.45) filtre les signaux faibles pour reduire le turnover


Section 14 : Resume et conclusions

# Resume final

print("=" * 70)
print("RESUME - TRANSFORMER ENCODER MULTI-ASSET")
print("=" * 70)

print(f"""
ARCHITECTURE
  Modele:       TransformerEncoder (PyTorch natif)
  d_model:      {D_MODEL}
  Tetes:         {NHEAD}
  Couches:       {NUM_LAYERS}
  FFN dim:       {DIM_FEEDFORWARD}
  Parametres:   {sum(p.numel() for p in model.parameters()):,}

DONNEES
  Actions:      {N_STOCKS} top SP500
  Macro:        VIX, 10Y yield, 30Y yield
  Features:     {n_features} (8 par action + 4 macro)
  Sequence:     {SEQ_LEN} jours -> Prediction: {PRED_LEN} jours
  Periode:      {START} a {END}

RESULTATS TEST
  MSE:                {mse:.6f}
  MAE:                {mae:.6f}
  Correlation:        {correlation:.4f}
  Direction Accuracy: {dir_acc:.2%}

ENTRAINEMENT
  Epochs:       {len(history['train_loss'])} (early stopping: patience={PATIENCE})
  Optimiseur:   AdamW (lr={LR}, weight_decay=0.01)
  Scheduler:    CosineAnnealingLR
  Loss:         HuberLoss + 0.5*BCELoss
  Batch size:   {BATCH_SIZE} (thermal-safe)
""")

# Tableau comparatif Transformer vs LSTM
print("COMPARAISON TRANSFORMER vs LSTM")
print("-" * 50)
comparison = """
| Aspect           | Transformer         | LSTM                |
|------------------|---------------------|---------------------|
| Parallelisme     | Total (O(1) steps)  | Sequentiel (O(n))   |
| Attention        | Globale             | Dernier etat        |
| Interpretabilite | Poids d'attention   | Boite noire         |
| Parametres       | ~1-2M               | ~200-500K           |
| Temps/epoch      | Plus rapide (GPU)   | Plus lent           |
| Memoire GPU      | O(n^2) attention    | O(n) lineaire       |
| Longueur max     | ~500 positions      | Illimite (theorique)|
| Macro features   | Naturel (concat)    | Possible (concat)   |
| Overfitting      | Risque plus eleve   | Risque plus faible  |
"""
print(comparison)

print("PROCHAINES ETAPES")
print("-" * 50)
print("  1. Executer le backtest complet sur QuantConnect Cloud")
print("  2. Comparer avec les resultats LSTM du QC-Py-30")
print("  3. Explorer l'architecture PatchTST (QC-Py-22)")
print("  4. Tester Mamba pour les longues sequences (QC-Py-23)")
print("  5. Continuer avec QC-Py-32 : DQN Training")
======================================================================
RESUME - TRANSFORMER ENCODER MULTI-ASSET
======================================================================

ARCHITECTURE
  Modele:       TransformerEncoder (PyTorch natif)
  d_model:      256
  Tetes:         8
  Couches:       4
  FFN dim:       1024
  Parametres:   3,195,394

DONNEES
  Actions:      30 top SP500
  Macro:        VIX, 10Y yield, 30Y yield
  Features:     12 (8 par action + 4 macro)
  Sequence:     60 jours -> Prediction: 5 jours
  Periode:      2014-01-01 a 2025-01-01

RESULTATS TEST
  MSE:                9.936157
  MAE:                2.300016
  Correlation:        0.0323
  Direction Accuracy: 56.23%

ENTRAINEMENT
  Epochs:       15 (early stopping: patience=7)
  Optimiseur:   AdamW (lr=0.0005, weight_decay=0.01)
  Scheduler:    CosineAnnealingLR
  Loss:         HuberLoss + 0.5*BCELoss
  Batch size:   32 (thermal-safe)

COMPARAISON TRANSFORMER vs LSTM
--------------------------------------------------

| Aspect           | Transformer         | LSTM                |
|------------------|---------------------|---------------------|
| Parallelisme     | Total (O(1) steps)  | Sequentiel (O(n))   |
| Attention        | Globale             | Dernier etat        |
| Interpretabilite | Poids d'attention   | Boite noire         |
| Parametres       | ~1-2M               | ~200-500K           |
| Temps/epoch      | Plus rapide (GPU)   | Plus lent           |
| Memoire GPU      | O(n^2) attention    | O(n) lineaire       |
| Longueur max     | ~500 positions      | Illimite (theorique)|
| Macro features   | Naturel (concat)    | Possible (concat)   |
| Overfitting      | Risque plus eleve   | Risque plus faible  |

PROCHAINES ETAPES
--------------------------------------------------
  1. Executer le backtest complet sur QuantConnect Cloud
  2. Comparer avec les resultats LSTM du QC-Py-30
  3. Explorer l'architecture PatchTST (QC-Py-22)
  4. Tester Mamba pour les longues sequences (QC-Py-23)
  5. Continuer avec QC-Py-32 : DQN Training

Conclusion et prochaines étapes

Recapitulatif

Ce notebook a couvert l’implementation complete d’un Transformer Encoder pour le trading multi-actifs :

Étape Contenu
Données 30 actions SP500 + 3 indicateurs macro (VIX, taux 10Y, 30Y)
Features 8 par action + 4 macro, total 12 features
Modèle TransformerEncoder natif PyTorch (4 couches, 8 tetes, d_model=256)
Entrainement AdamW + CosineAnnealingLR + gradient clipping + early stopping
Evaluation Correlation, direction accuracy, MSE, MAE
Interpretablite Heatmap des poids d’attention
Deploiement Sauvegarde + code QC Cloud reference

Points cles a retenir

  1. Le Transformer capture les dependances a longue distance via l’attention globale, contrairement au LSTM qui est limite par son etat cache
  2. Les features macro ameliorent la generalisation en fournissant un contexte de marche partage entre toutes les actions
  3. L’interpretabilite de l’attention est un avantage pratique : on peut verifier quelles periodes historiques influencent les predictions
  4. Le risque d’overfitting est reel : le Transformer a beaucoup plus de paramètres que le LSTM et necessite une regularisation soignee

Limitations

Limitation Mitigation
Complexite O(n^2) Limiter la sequence a 60 jours
Memoire GPU Batch size reduit, empty_cache entre epochs
Overfitting Dropout, early stopping, weight decay
Cout de transaction non inclus Backtester sur QuantConnect

Ancre savante – Srivastava et al. (2014), Dropout: A Simple Way to Prevent Neural Networks from Overfitting, JMLR 15:1929-1958. (Dropout comme mitigation a l’overfitting.)

Prochaines étapes

  • QC-Py-32 : DQN Training - Reinforcement Learning pour le trading
  • QC-Py-22 : PatchTST et architectures SOTA pour series temporelles
  • QC-Py-23 : State Space Models (Mamba) pour les longues sequences en O(n)

Ressources

Références

  • Estrella, A. & Hardouvelis, G.A. (1991). The Term Structure as a Predictor of Real Economic Activity. Journal of Finance 46(2):555-576.
  • Fama, E.F. (1970). Efficient Capital Markets: A Review of Theory and Empirical Work. Journal of Finance 25(2):383-417. DOI 10.1111/j.1540-6261.1970.tb00518.x.
  • Hendrycks, D. & Gimpel, K. (2016). Gaussian Error Linear Units (GELUs). arXiv:1606.08415.
  • Huber, P.J. (1964). Robust Estimation of a Location Parameter. Annals of Mathematical Statistics 35(1):73-101. DOI 10.1214/aoms/1177703732.
  • Loshchilov, I. & Hutter, F. (2017). SGDR: Stochastic Gradient Descent with Warm Restarts. ICLR. arXiv:1608.03983.
  • Loshchilov, I. & Hutter, F. (2019). Decoupled Weight Decay Regularization. ICLR. arXiv:1711.05101.
  • Pascanu, R., Mikolov, T. & Bengio, Y. (2013). On the difficulty of training recurrent neural networks. ICML. arXiv:1211.5063.
  • Srivastava, N. et al. (2014). Dropout: A Simple Way to Prevent Neural Networks from Overfitting. JMLR 15:1929-1958.
  • Tashman, L.J. (2000). Out-of-sample tests of forecasting accuracy. International Journal of Forecasting 16(4):437-450.
  • Vaswani, A. et al. (2017). Attention Is All You Need. NeurIPS. arXiv:1706.03762.
  • Whaley, R.E. (2000). The Investor Fear Gauge. Journal of Portfolio Management 26(3):12-17.

< Retour au sommaire | Suivant : DQN Trading >

Retour au sommet