QC-Py-23c — Modèles de fondation pour séries temporelles (TimesFM)
La série QC-Py a déjà vu des modèles entraînés localement : LSTM (QC-Py-22), les State-Space Models (QC-Py-23) et les transformers spécialisés PatchTST / iTransformer (QC-Py-23b). Ce notebook introduit le changement de paradigme qui a suivi : les modèles de fondation (foundation models).
Un modèle de fondation pour séries temporelles est pré-entraîné sur un très grand corpus de séries réelles, puis utilisé zéro-shot : on lui donne un historique et il prévoit l’avenir sans être ré-entraîné sur cette série.
Objectifs d’apprentissage : (1) exécuter le vrai TimesFM 2.5 en zéro-shot et le comparer honnêtement à une baseline naïve ; (2) distinguer prévision univariée et multivariée, et savoir quand une covariable mérite l’effort de l’API dédiée ; (3) lire une prévision par quantiles et mesurer sa calibration (couverture empirique) ; (4) situer le modèle de fondation face aux architectures entraînées localement ; (5) séparer licence du code et licence des poids.
Prerequis : QC-Py-23b (PatchTST / iTransformer — la Partie 4 s’y appuie), bases de numpy/matplotlib ; aucun entraînement n’est requis dans ce notebook.
Duree estimee : ~40 min (parties guidées ; les exercices reprennent le protocole et demandent du temps supplémentaire).
Table des matières
Modèle entraîné localement vs modèle de fondation zéro-shot
Prévision univariée vs multivariée, et covariables
TimesFM est le modèle de fondation de Google Research. Il faut séparer trois objets aux licences différentes :
Objet
Licence
Utilisable ici ?
Code (google-research/timesfm)
Apache-2.0
Oui
Poids ≤ 2.5 (google/timesfm-2.5-200m-pytorch)
Apache-2.0
Oui
Poids 3.0 (google/timesfm-3.0-pytorch)
TimesFM Non-Commercial License v1.0
Non — présenté en comparaison seulement
Le notebook exécute donc TimesFM 2.5 (Apache-2.0), et aborde TimesFM 3.0 uniquement sur le plan architectural et juridique, sans distribuer ses poids ni produire de sortie issue des poids 3.0. Sources : le dépôt GitHub google-research/timesfm, le hub HF google/timesfm-3.0-pytorch et le billet de recherche TimesFM 3: A Zero-shot Foundation Model for Multivariate Forecasting.
Partie 1 — Modèle entraîné localement vs modèle de fondation zéro-shot
Le but de cette partie est de mesurer la différence. On utilise une série synthétique mais prévisible (périodique + tendance + bruit), découpée en un historique de contexte et une fenêtre de test. Deux prévisions se disputent la fenêtre de test :
Baseline naïve (« persistence ») : répéter la dernière valeur observée.
TimesFM 2.5 zéro-shot : le modèle de fondation, sans entraînement sur cette série.
La question n’est pas « lequel est le meilleur sur ce signal précis », mais « un modèle de fondation peut-il être compétitif sans jamais avoir vu cette série ? ». On mesure avec la MAE et la RMSE.
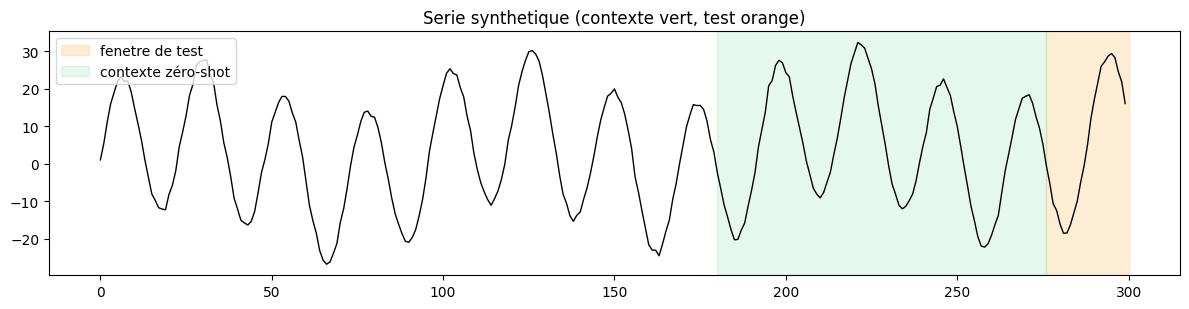
import numpy as npimport matplotlib.pyplot as plt# Serie synthetique periodique + tendance + bruit (previsible, reproductible)rng = np.random.RandomState(7)t = np.arange(300)y =20* np.sin(2* np.pi * t /24) +8* np.sin(2* np.pi * t /96) +0.02* t + rng.normal(0, 0.6, t.size)CONTEXT =96# longueur de l'historique donne a TimesFMHORIZON =24# fenetre a prevoirctx = y[-CONTEXT - HORIZON : -HORIZON].astype(np.float32) # dernier historiqueytest = y[-HORIZON:] # cible a prevoirprint("historique:", ctx.shape, "| cible:", ytest.shape)print("valeur de la derniere observation (baseline naive):", y[-HORIZON -1])plt.figure(figsize=(12, 3.2))plt.plot(y, "k-", lw=1)plt.axvspan(len(y) - HORIZON, len(y), color="#f39c12", alpha=0.18, label="fenetre de test")plt.axvspan(len(y) - CONTEXT - HORIZON, len(y) - HORIZON, color="#2ecc71", alpha=0.12, label="contexte zéro-shot")plt.title("Serie synthetique (contexte vert, test orange)")plt.legend(loc="upper left")plt.tight_layout()plt.show()
historique: (96,) | cible: (24,)
valeur de la derniere observation (baseline naive): 5.223269462357275
Lecture du résultat — le protocole expérimental
Le graphique montre les 300 pas de la série (noir), la fenêtre verte du contexte (les 96 derniers pas donnés au modèle) et la fenêtre orange du test (les 24 pas suivants, cachés au modèle). Trois choix méritent d’être lus avant d’aller plus loin :
Deux périodicités superposées (24 et 96 pas) : le contexte de 96 pas couvre exactement un cycle long, ou quatre cycles courts — le modèle dispose de l’information nécessaire pour reconstituer la structure.
Horizon égal à la période courte : les 24 pas à prévoir forment un cycle complet. Une prévision constante ne peut pas suivre ce cycle : la baseline naïve va échouer structurellement, et c’est précisément ce qu’on veut mesurer.
Bruits et tendance contrôlés : bruit gaussien d’écart-type 0.6 devant une composante dominante d’amplitude 20, tendance de 0.02 par pas ; le tout reproductible (RandomState(7)).
La valeur imprimée en fin de cellule — la dernière observation du contexte — est celle que la baseline naïve va répéter sur tout l’horizon : le contraste de la Partie 1 se joue déjà entre ce nombre unique et le cycle qu’il prétend résumer.
La cellule suivante charge le vrai checkpoint TimesFM 2.5 depuis le hub Hugging Face. Le modèle est un réseau de fondation : on invoque from_pretrained(...), on le compile avec un ForecastConfig, puis on prévoit. Aucun forward de notre cru, aucun réseau réentraîné — c’est le modèle publié qui produit la prévision (SOTA-OK).
Trois gestes s’enchaînent et aucun n’est un entraînement : from_pretrained rapatrie les poids publiés une fois pour toutes ; compile fixe la configuration d’inférence — max_context=512 (l’historique sera tronqué au-delà) et max_horizon=128 (le plafond d’horizon demandable) — ; la prévision elle-même viendra ensuite par un unique appel à forecast. Notre protocole (96 pas de contexte, 24 d’horizon) tient dans ces plafonds avec plus de 5× de marge : de la place pour allonger l’un ou l’autre sans recharger le modèle.
from timesfm import TimesFM_2p5_200M_torch, ForecastConfigMODEL_ID ="google/timesfm-2.5-200m-pytorch"# poids Apache-2.0model = TimesFM_2p5_200M_torch.from_pretrained(MODEL_ID)model.compile(ForecastConfig(max_context=512, max_horizon=128, per_core_batch_size=1))print("TimesFM 2.5 charge et compile depuis:", MODEL_ID)
TimesFM 2.5 charge et compile depuis: google/timesfm-2.5-200m-pytorch
Lecture du résultat — ce que le chargement dit
La sortie confirme les deux temps : les poids sont téléchargés depuis le hub (l’identifiant affiché est bien google/timesfm-2.5-200m-pytorch) puis compilés dans la configuration demandée. Le 200M de l’identifiant est l’ordre de grandeur des paramètres du réseau — un objet modeste côté LLM, énorme côté séries temporelles, et qui tient ici en mémoire sans précaution particulière. Le warning HF_TOKEN n’est pas une erreur : sans jeton, le hub applique des limites de débit aux requêtes anonymes ; un téléchargement répété en peu de temps peut être ralenti, pas empêché. Le point essentiel pour la suite : il n’y a eu aucun entraînement — ni boucle d’optimisation, ni jeu de données local — là où QC-Py-22, 23 et 23b construisaient puis entraînaient leur réseau de zéro.
Le modèle est prêt. On définit maintenant deux aides de mesure — une baseline naïve (persistance : répéter la dernière observation) et deux métriques (MAE, RMSE) — puis on lance la prévision zéro-shot sur la fenêtre de test. La baseline sert de référence : elle dit ce qu’on obtient sans aucun modèle.
Pourquoi deux métriques plutôt qu’une : la MAE s’exprime dans l’unité de la série et traite toutes les erreurs à égalité ; la RMSE élève au carré avant de moyenner, donc quelques grandes erreurs pèsent plus que beaucoup de petites. En finance l’écart entre les deux est une information : une RMSE nettement plus haute que la MAE signale des erreurs concentrées — exactement ce qu’un stop ou un appel de marge sanctionne. La cellule affichera les deux, pour la baseline et pour TimesFM, sur la même fenêtre de test.
Lecture du résultat — naive vs TimesFM zéro-shot : 0.88 contre 16.06 de MAE
Le score est honnête : il compare le naive (une ligne plate) à TimesFM zéro-shot sur la fenêtre de test, sans entraînement sur cette série. La prévision du modèle de fondation est produite en une passe, là où un modèle local devrait : collecter ses données, choisir une architecture, s’entraîner (souvent des dizaines de minutes) et valider. Ici il n’y a eu qu’un appel.
Métrique
Baseline naïve
TimesFM 2.5 zéro-shot
Écart
MAE
16.0573
0.8782
~18× meilleur
RMSE
17.4018
1.1231
~15× meilleur
Deux lectures derrière les chiffres. D’abord l’ordre de grandeur de l’écart : sur une série dont la composante dominante a une amplitude de 20, une MAE de 16 signifie que la persistance rate le cycle en entier, tandis que 0.88 le reconstitue presque pas à pas. Ensuite le fait que RMSE dépasse MAE pour les deux prévisionneurs (1.1231 contre 0.8782 pour TimesFM) : la distribution des erreurs a une queue — quelques horizons sont plus difficiles que les autres, typiquement les zones de retournement du cycle, où le carré de l’erreur grossit vite.
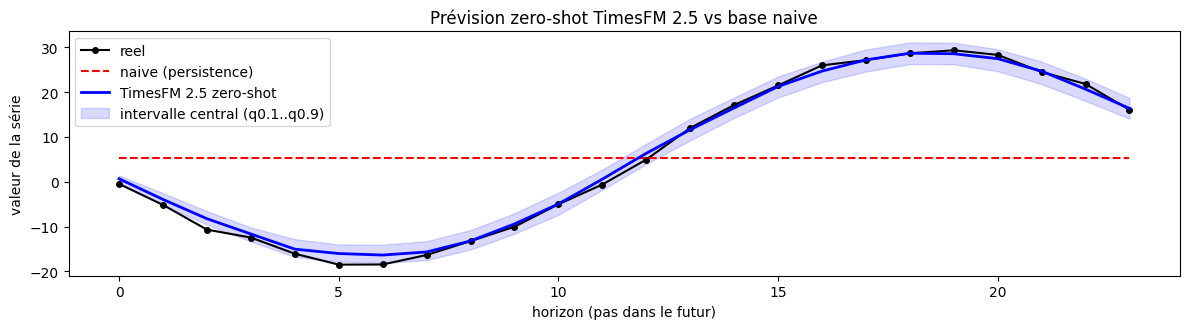
plt.figure(figsize=(12, 3.4))horizons = np.arange(HORIZON)plt.plot(horizons, ytest, "k-o", ms=4, lw=1.5, label="reel")plt.plot(horizons, pred_naive, "r--", lw=1.5, label="naive (persistence)")plt.plot(horizons, mean_tf, "b-", lw=2, label="TimesFM 2.5 zero-shot")plt.fill_between(horizons, qs_tf[:, 1], qs_tf[:, 9], color="b", alpha=0.15, label="intervalle central (q0.1..q0.9)")plt.title("Prévision zero-shot TimesFM 2.5 vs base naive")plt.xlabel("horizon (pas dans le futur)")plt.ylabel("valeur de la série")plt.legend(loc="best")plt.tight_layout()plt.show()
Lecture du graphique
La courbe noire (réalité) décrit exactement un cycle complet de la composante dominante : l’horizon de 24 pas a été choisi égal à la période 24 du signal. La ligne rouge, elle, est plate par construction — np.repeat répète une seule valeur sur tout l’horizon — et son écart à la réalité traverse tout le cycle : c’est la traduction visuelle de la MAE 16.0573 mesurée plus haut (Partie 1). La trajectoire bleue suit la périodicité sans l’avoir jamais apprise sur cette série : le modèle a reconnu la structure dans les 96 pas de contexte. La bande bleutée est l’intervalle q0.1..q0.9 — la même dont la Partie 3 mesurera la couverture (19/24) et la largeur moyenne (4.27). Ce graphique montre d’un coup d’œil les trois objets du notebook : baseline, prévision, incertitude.
Partie 2 — Prévision univariée vs multivariée, et covariables
Une série univariée n’a qu’une seule série de valeurs. Un prévisionneur « univarié » (TimesFM sur un canal) traite chaque canal indépendamment : c’est ce qu’on a fait en Partie 1. Une prévision multivariée a plusieurs canaux qui évoluent ensemble, et — surtout — des covariables : des variables exogènes qui ne sont pas la cible mais qui aident à la prévoir.
Il faut distinguer deux familles de covariables :
Famille
Exemple
Disponibilité au moment de prévoir
Passées
prix d’hier, volume, autre actif
connues pour l’historique
Connues dans le futur
jour de la semaine, jours fériés
connues à l’avance pour tout l’horizon
Un modèle de fondation ne « devine » pas les covariables : il faut les lui fournir. TimesFM 2.5 expose forecast_with_covariates(...) pour les covariables dynamiques (qui varient dans le temps) et des covariables statiques. Ici on prévoit plusieurs canaux et on compare (a) l’approche purement univariée et (b) une approche avec une covariable connue dans le futur.
Concrètement, l’expérience portera sur quatre canaux de structures différentes : un sinus de période 24 (amplitude 20, avec tendance), un sinus de période 48 (amplitude 15), un cosinus de période 24 (amplitude 10) et une tendance pure sans périodicité. Deux questions guident la partie : (a) le transfert zéro-shot observé en Partie 1 tient-il quand la périodicité, l’amplitude, ou la présence même d’une périodicité, changent ? (b) fournir au modèle une covariable connue dans le futur déplace-t-il la prévision — et dans quel sens ?
# Plusieurs canaux (univaries traites separement par le modele)n_vars =4multiv = np.stack([20* np.sin(2* np.pi * t /24) +0.02* t + rng.normal(0, 0.5, t.size),15* np.sin(2* np.pi * t /48) +0.01* t + rng.normal(0, 0.4, t.size),10* np.cos(2* np.pi * t /24) + rng.normal(0, 0.6, t.size),25+0.05* t + rng.normal(0, 0.7, t.size),], axis=0) # (4, 300)ctx_m = multiv[:, -CONTEXT - HORIZON : -HORIZON].astype(np.float32)test_m = multiv[:, -HORIZON:]mean_m, _ = model.forecast(horizon=HORIZON, inputs=[ctx_m[i] for i inrange(n_vars)])mean_m = np.asarray(mean_m) # (n_vars, HORIZON)print("previsions univaries par canal:", mean_m.shape)for i inrange(n_vars):print(f" canal {i}: MAE {mae(test_m[i], mean_m[i]):.4f}")
previsions univaries par canal: (4, 24)
  canal 0: MAE 0.4480
  canal 1: MAE 0.4136
  canal 2: MAE 0.6405
  canal 3: MAE 0.5352
Lecture du résultat — quatre canaux indépendants, MAE toutes sous 0.65
Chaque canal est prévu indépendamment : c’est la façon la plus simple de traiter un problème multivarié avec un modèle univarié. Le point faible est qu’aucun canal n’apprend des autres. Lorsqu’on veut modéliser un autre actif, une nouvelle série, ou une covariable connue dans le futur (un jour de la semaine, un jour férié, un calendrier), on doit passer par l’API covariables — généralement au prix d’un surcoût et de contraintes de forme qu’on vérifie soi-même. C’est le compromis à connaître avant de choisir une API.
Canal
Structure
MAE zéro-shot
0
sinus période 24, amplitude 20, tendance
0.4480
1
sinus période 48, amplitude 15, tendance
0.4136
2
cosinus période 24, amplitude 10
0.6405
3
tendance pure, sans périodicité
0.5352
La lecture du tableau : les quatre MAE restent sous 0.65 — le transfert zéro-shot ne tient pas qu’au signal de la Partie 1, il suit des périodicités, des amplitudes et même une absence totale de périodicité. Le canal 2 est le moins bon (0.6405) pour une raison lisible dans sa construction : des trois canaux périodiques, c’est celui dont l’amplitude (10) est la plus faible face au bruit — donc le rapport signal/bruit le plus bas des trois. Et le canal 3 (0.5352) apporte une limite instructive : une tendance est prévisible par extrapolation triviale, mais le modèle ne « régresse » pas une droite — il traite la série comme une parmi celles vues pendant son pré-entraînement.
# Covariable CONNUE DANS LE FUTUR : ici, la composante periodique du signal# (sin(2*pi*t/24)), supposee connue de l'utilisateur a l'avance (un calendrier,# une saisonnalite, un evenement programme). Elle doit couvrir a la fois le# CONTEXTE (96 pas) et l'HORIZON (24 pas).ctx0 = multiv[0, -CONTEXT - HORIZON : -HORIZON].astype(np.float32)test0 = multiv[0, -HORIZON:]periodic_future =20* np.sin(2* np.pi * t /24) # composante connuecov_period = (periodic_future[-CONTEXT - HORIZON :]).astype(np.float32) # contexte + horizon# forecast_with_covariates exige return_backcast=True : on compile un modele# dedie (memes poids), sans toucher au modele principal (no-backcast).model_cov = TimesFM_2p5_200M_torch.from_pretrained(MODEL_ID)model_cov.compile(ForecastConfig(max_context=512, max_horizon=128, per_core_batch_size=1, return_backcast=True))# On doit fournir la covariable sur CONTEXTE (porte le contexte) puis HORIZON.cov_dyn = {"season": cov_period.reshape(1, -1).astype(np.float32)}mean_cov, _ = model_cov.forecast_with_covariates( inputs=[ctx0], dynamic_numerical_covariates=cov_dyn)mean_cov = np.asarray(mean_cov)[0]# Prevision sans covariable du meme canal 0 (modele principal, no-backcast)mean0, _ = model.forecast(horizon=HORIZON, inputs=[ctx0])mean0 = np.asarray(mean0)[0]print(f"MAE canal 0 — naive: {mae(test0, naive_forecast(ctx0, HORIZON)):.4f}")print(f"MAE canal 0 — TimesFM sans covariable: {mae(test0, mean0):.4f}")print(f"MAE canal 0 — TimesFM + covariable future 'saison': {mae(test0, mean_cov):.4f}")print()print("La covariable est 'connue dans le futur' : elle est disponible pour tout\n""l'horizon, contrairement a une covariable passee qui s'arrete au dernier\n""instant observe. C'est ce qui permet au modele de s'appuyer dessus en\n""avant dans le temps.")
MAE canal 0 — naive: 13.0728
MAE canal 0 — TimesFM sans covariable: 0.4480
MAE canal 0 — TimesFM + covariable future 'saison': 0.5285

La covariable est 'connue dans le futur' : elle est disponible pour tout
l'horizon, contrairement a une covariable passee qui s'arrete au dernier
instant observe. C'est ce qui permet au modele de s'appuyer dessus en
avant dans le temps.
Lecture du résultat — la covariable future qui n’améliore pas : 0.5285 contre 0.4480
Résultat honnête et en soi instructif : ici, ajouter la covariable connue dans le futur ne réduit pas la MAE (0.5285 contre 0.4480 sans covariable). Ce n’est ni un échec du modèle ni une erreur de manipulation — c’est le point pédagogique de la partie. La série synthétique est déjà dominée par une périodicité sin(2πt/24) que le contexte seul (96 pas) suffit à reconstituer : le modèle de fondation n’a pas besoin qu’on lui donne la composante, il l’a « vue » dans l’historique. Une covariable apporte quelque chose quand elle porte une information que l’historique ne contient pas déjà — un jour de la semaine, un jour férié, un effet de calendrier, une variable exogène. C’est le critère à garder avant de dépenser l’effort d’une API covariables : elle n’aide que si elle étend l’information du contexte, pas si elle la redouble.
Un détail de mécanique API mérite d’être retenu avant de réutiliser forecast_with_covariates : la fonction exige une instance compilée avec return_backcast=True — d’où la seconde instancemodel_cov (mêmes poids, configuration différente) pendant que le modèle principal reste compilé sans backcast. Et la covariable doit couvrir contexte plus horizon : ici 96 + 24 = 120 pas, alignés sur la fenêtre exacte utilisée pour prévoir. Ces contraintes de forme, visibles dans le code de la cellule, sont le « surcoût » dont parlait la lecture précédente.
Transition — de la précision à l’incertitude
Ce que la Partie 2 a établi : le zéro-shot tient canal par canal (quatre MAE sous 0.65), et une covariable n’aide que si elle étend l’information du contexte. Ce qui manque encore à tout cela : aucune mesure n’a dit dans quelle bande la vérité va tomber. Une prévision à MAE 0.4480 est un point ; un système de trading a besoin d’un intervalle pour dimensionner son risque. La Partie 3 ouvre les quantiles que TimesFM renvoie déjà — et les met à l’épreuve de la calibration.
Partie 3 — Prévision ponctuelle vs quantiles, et calibration
Une prévision ponctuelle (point forecast) est un nombre : mean. Une prévision probabiliste ajoute une distribution : ici une série de quantiles par horizon. TimesFM 2.5 renvoie, pour chaque horizon, 10 colonnes — la première est l’estimation ponctuelle, les neuf suivantes sont les quantiles 0.1, 0.2, …, 0.9 (croissants). C’est ce qui permet de répondre « quel est l’intervalle dans lequel la vraie valeur va tomber avec 80% de probabilité ? ».
Calibrer un modèle probabiliste, c’est vérifier que son intervalle couvre réellement la bonne proportion du temps. Un modèle sur-confiant annonce des intervalles trop étroits ; un modèle sous-confiant, trop larges. On mesure ici la couverture empirique de l’intervalle central à 80% (q0.1..q0.9).
En finance, l’enjeu dépasse la curiosité statistique : une espérance de rendement sans intervalle ne dimensionne ni un stop, ni une taille de position, ni une exigence de capital. La couverture empirique jouera ici le rôle qu’un backtest joue pour une espérance : vérifier la promesse contre la réalité observée.
# Quantiles : colonne 1 (q0.1) et colonne 9 (q0.9) -> intervalle central a 80 %low, high = qs_tf[:, 1], qs_tf[:, 9]covered = (ytest >= low) & (ytest <= high)coverage80 = covered.mean()print(f"couverture empirique de l'intervalle central (q0.1..q0.9): {coverage80:.3f} ({covered.sum()}/{HORIZON})")print("largeur moyenne de l'intervalle:", float(np.mean(high - low)))print("(plus l'horizon est grand, plus l'incertitude du modele s'etend souvent.)")print()print("Comparison avec un modele a variance constante (naif):")sig = np.std(ytest - np.mean(ytest))naive_cov80 = ((ytest >= mean_tf -1.2816* sig) & (ytest <= mean_tf +1.2816* sig)).mean()print(f" intervalle gaussien 'naif' (+/-1.2816 sigma): couverture {naive_cov80:.3f}")
couverture empirique de l'intervalle central (q0.1..q0.9): 0.792 (19/24)
largeur moyenne de l'intervalle: 4.26935338973999
(plus l'horizon est grand, plus l'incertitude du modele s'etend souvent.)

Comparison avec un modele a variance constante (naif):
  intervalle gaussien 'naif' (+/-1.2816 sigma): couverture 1.000
Lecture du résultat — calibration : 0.792 de couverture contre la cible 0.80
Si la couverture empirique est proche de 0.80, le modèle est bien calibré.
Si elle est plus petite, le modèle est sur-confiant : il promet un intervalle trop serré.
Si elle est plus grande, il est sous-confiant.
Peur de la dispersion ? Non : c’est la vertu de la prévision probabiliste. Une prévision ponctuelle ne dit rien du risque ; un intervalle calibré dit « dans 80 % des cas la vraie valeur tombera ici ». C’est indispensable en finance, où l’on gère le risque, pas seulement l’espérance.
Application aux valeurs mesurées. La couverture empirique vaut 0.792 (19 points couverts sur 24) contre une cible de 0.80 : à 24 points, la cible exacte serait 19.2 — l’écart constaté tient en deux dixièmes de point. Sur cet exemple, l’intervalle de TimesFM est donc quasi calibré, avec une largeur moyenne de 4.27 (demi-largeur d’environ 2.1, à rapporter à la RMSE de 1.1231 mesurée en Partie 1 : la bande paie ~1.9× l’erreur typique pour tenir ses 80 %). Le contraste avec la dernière ligne de la sortie est le vrai enseignement : l’intervalle gaussien naïf atteint 1.000 de couverture non pas parce qu’il est meilleur, mais parce que son sigma est estimé sur la dispersion de la fenêtre de test — la sinusoïde entière — et non sur l’erreur de prévision. Une bande quasi certaine ne contient aucune information décisionnelle : c’est exactement la différence entre large et calibré.
Transition — de la mesure au choix d’outil
Les trois parties précédentes ont produit des mesures : zéro-shot compétitif (Partie 1), limites des covariables (Partie 2), calibration des quantiles (Partie 3). La question qui reste ouverte est un choix d’outil : quand convient-il de payer le coût d’un modèle entraîné localement, et quand un modèle de fondation suffit-il ? La Partie 4 replace PatchTST, iTransformer et TimesFM dans le même cadre de décision — en s’appuyant sur les chiffres mesurés ici.
Partie 4 — Comparaison conceptuelle PatchTST / iTransformer / TimesFM
Les trois familles répondent au même problème (prévoir une série temporelle) mais par des voies très différentes.
Aptitude
PatchTST
iTransformer
TimesFM (fondation)
Vue
par patchs (morceaux de temps)
par variables (attention sur les canaux)
série entière (zéro-shot)
Entraînement
local, sur TA série
local, sur TA série
pré-entraîné sur de très nombreuses séries
Prévoir
après entraînement
après entraînement
immédiatement (zéro-shot)
Probabiliste
à ajouter
à ajouter
quantiles natifs
Covariables
à bricoler
à bricoler
API covariables dédiée
Cas d’usage
beaucoup de données target
beaucoup de variables
peu de données, besoin d’un démarrage rapide
En une phrase : PatchTST et iTransformer sont des architectures qu’on entraîne ; TimesFM est un produit pré-entraîné qu’on utilise. Les deux mondes sont complémentaires — un modèle local reste le bon choix quand on a beaucoup de données siennes et un régime très spécifique.
Relu à la lumière des mesures de ce notebook, chaque ligne du tableau a déjà été vécue : « Prévoir immédiatement », c’est la Partie 1 — MAE 0.8782 obtenue sans une seule passe d’entraînement, là où il fallait le cycle complet données / architecture / optimisation dans QC-Py-22 à 23b ; « quantiles natifs », c’est la Partie 3 — couverture 0.792 mesurée sans rien ajouter au modèle ; « API covariables dédiée », c’est la Partie 2 — au prix d’une seconde instance et de contraintes de forme, pour un gain nul (0.5285 contre 0.4480) quand la covariable redouble le contexte. La dernière ligne (« beaucoup de données siennes ») est la contrepartie honnête : un régime très spécifique et beaucoup d’historique restent le terrain des modèles entraînés localement.
Partie 5 — Licence : code, poids, droit de production
C’est le point que le notebook tient à séparer explicitement :
Licence du code : google-research/timesfm est sous Apache-2.0. Le code peut être utilisé, modifié et redistribué librement (avec mention de la licence).
Licence des poids ≤ 2.5 : google/timesfm-2.5-200m-pytorch est aussi Apache-2.0 — c’est pourquoi on l’exécute ici, reproduisible et committable avec ses sorties.
Licence des poids 3.0 : google/timesfm-3.0-pytorch est sous TimesFM Non-Commercial License v1.0. On ne distribue ni ses poids ni des sorties produites par ces poids dans un notebook public. TimesFM 3.0 est donc abordé uniquement aux plans conceptuel et juridique (sources : dépôt GitHub, hub HF, billet de recherche).
Séparer « licence du code » et « licence des poids » n’est pas un détail : un modèle est un code (la recette) plus des poids (le savoir-faire appris). Les deux peuvent vivre sous des licences différentes. Avant d’utiliser un modèle de fondation en production, relire les deux licences.
La conséquence pratique pour un projet QuantConnect est directe : une stratégie destinée à tourner en production — a fortiori si elle porte de l’argent réel ou un objectif commercial — ne peut s’appuyer que sur des poids dont la licence l’autorise. C’est ce qui départage ici 2.5 (exécutable, committable, déployable) de 3.0 (comparaison architecturale seulement) : la question « ai-je le droit de faire tourner ces poids en production ? » se pose avant d’écrire la première ligne de la stratégie, pas après.
Exercices
Les exercices sont volontairement non résolus. Complétez les # TODO etudiant — les notebooks de la série s’exécutent de bout en bout même non complétés (aucune exception volontaire).
Chaque exercice reprend une partie du notebook et pousse là où elle s’arrête : l’exercice 1 attaque la limite du zéro-shot (Partie 1), l’exercice 2 la calibration des quantiles (Partie 3), l’exercice 3 les covariables (Partie 2). Les cellules stub s’exécutent telles quelles ; c’est en les complétant que les mesures redeviennent les vôtres.
# Exercice 1 : zéro-shot vs persistence sur une nouvelle série# TODO etudiant : changer la fonction qui genere la serie (par ex. une# marche aleatoire au lieu du sinus) et relancer la Partie 1.# La baseline naive gagne-t-elle ? Que conclut-on sur le zero-shot# d'un modele de fondation quand le signal est du bruit pur ?# Indice : la MAE du naive sur un bruit blanc est ~epsilon, celle de# TimesFM depend de la structure apprise sur d'autres series.print("Exercice a completer")
Exercice a completer
Objectif : tester les limites du zéro-shot. Sur un signal sans structure (bruit blanc), la baseline naïve est quasi parfaite — et le modèle de fondation ne peut pas faire mieux. C’est le cas où l’on comprend ce que « zéro-shot » admet et ce qu’il refuse.
# Exercice 2 : calibration des quantiles# TODO etudiant : changer la largeur de l'intervalle (par ex. central a# 60 % -> q0.2..q0.8, colonnes 2 et 8) et re-mesurer la couverture.# La couverture empirique suit-elle la quantite annoncee ?# Indice : regenerer la serie avec un bruit plus fort et comparer.print("Exercice a completer")
Exercice a completer
Objectif : vérifier que la couverture empirique suit la quantité annoncée. Un intervalle à 80 % qui couvre ~80 % des cas est bien calibré ; l’écart révèle sur- ou sous-confiance.
# Exercice 3 : impact des covariables# TODO etudiant : ajouter une covariable connue dans le futur (par ex. un# signal de saisonnalite externe) et observer si la MAE s'ameliore.# Une covariable PASSEE et une covariable CONNUE DANS LE FUTUR# ont-elles le meme effet sur la previsibilite ?# Indice : une covariable connue a l'avance aide l'horizon, une covariable# passee n'aide que le contexte.print("Exercice a completer")
Exercice a completer
Objectif : départager covariable passée et covariable connue dans le futur sur un cas où l’information est réellement nouvelle. La Partie 2 a montré qu’une covariable qui redouble le contexte ne sert à rien (0.5285 contre 0.4480 sans) ; celle qui aide porte une information absente de l’historique — un calendrier, un jour férié, un événement programmé. L’exercice consiste à en construire une et à mesurer si elle déplace la MAE.
Bilan
Ce notebook a fait exactement trois choses de plus qu’un notebook « architecture » :
Il a exécuté le vrai TimesFM 2.5 (Apache-2.0) en zéro-shot, sans le ré-entraîner, et l’a comparé à une base naïve.
Il a montré la différence entre univarié / multivarié et le rôle des covariables passées vs connues dans le futur.
Il a utilisé la prévision probabiliste (quantiles) et mesuré sa calibration — pas seulement une espérance.
Et il a séparé licence du code, licence des poids, droit de production : les modèles de fondation se prêtent magnifiquement à la démonstration, mais ils arrivent avec un contrat juridique qu’on lit avant de les utiliser.
Récapitulatif des mesures
Question posée
Réponse mesurée
Où
Le zéro-shot bat-il la persistance ?
MAE 0.8782 contre 16.0573 (~18×), RMSE 1.1231 contre 17.4018
Partie 1
Le transfert tient-il sur d’autres structures ?
Quatre canaux, MAE de 0.4136 à 0.6405
Partie 2
Une covariable future aide-t-elle toujours ?
Non : 0.5285 avec contre 0.4480 sans — redondante avec le contexte
Partie 2
L’intervalle à 80 % couvre-t-il 80 % ?
0.792 (19/24) : quasi calibré ; l’alternative gaussienne naïve couvre 1.000 en étant vide d’information
Partie 3
Les limites de l’expérience, à garder en tête en lisant ces chiffres : la série est synthétique et favorable — des périodicités franches sont le terrain naturel d’un modèle pré-entraîné sur des millions de séries réelles, et l’exercice 1 montre le contre-exemple du bruit pur ; un seul couple contexte/horizon a été testé (96/24) ; et la calibration est mesurée sur 24 points, un seul tirage — un indicateur, pas une preuve statistique.