QC-Py-23b - PatchTST et iTransformer pour Prevision Financiere
[REFERENCE Pedagogique] Ce notebook illustre les architectures PatchTST (Nie et al., ICLR 2023) et iTransformer (Liu et al., ICLR 2024) pour la prevision de series temporelles financieres.
Les modèles sont implementes en PyTorch pur (CPU-compatible) pour comprendre les mécanismes internes.
Objectifs d’apprentissage : (1) comprendre pourquoi l’attention quadratique bloque les Transformers sur les series longues ; (2) mecaniser le patching de PatchTST (une serie devient L/P tokens) ; (3) mecaniser l’inversion d’axes d’iTransformer (attention sur les variables, pas le temps) ; (4) comparer les deux architectures a protocole honnete — baseline majoritaire, edge vs couts de transaction.
Prerequis : QC-Py-23 (motivation SSM : O(n2) attention, puis S4, Mamba), bases de PyTorch (nn.Module, boucle d’entrainement).
Duree estimee : ~45 min (lecture et exercices).
Mode d’emploi : Ce notebook illustre les concepts avec du code executable sur CPU. 1. Sections analytiques : textes explicatifs et visualisations des architectures 2. Sections code : implementations minimales et exemples reproductibles 3. Exercices : cellules a completer pour approfondir
# Importsimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport osos.environ.setdefault('CUBLAS_WORKSPACE_CONFIG', ':4096:8') # avant import torch : workspace deterministe CuBLASimport torchimport torch.nn as nnimport torch.nn.functional as F# Determinisme explicite : les seeds (cellules de preparation/entrainement) ne suffisent pas seulstorch.backends.cudnn.deterministic =Truetorch.backends.cudnn.benchmark =Falsetorch.use_deterministic_algorithms(True, warn_only=True)print(f"Imports OK")
Imports OK
Partie 1 : Le Problème de l’Attention Quadratique
Pourquoi les Transformers classiques peinent sur les series temporelles
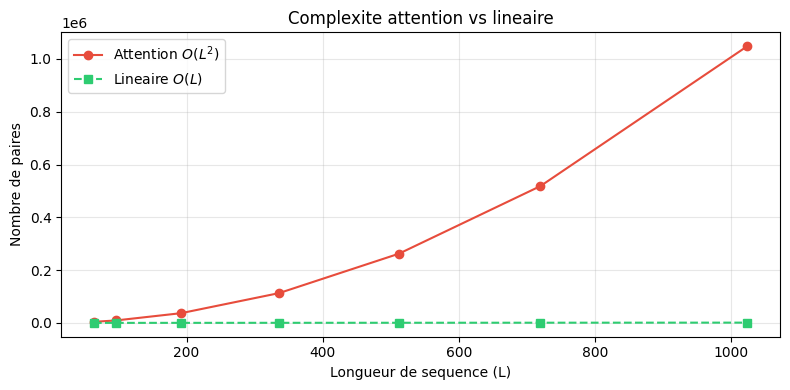
Le mécanisme d’attention standard a une complexite O(L^2) en sequence length L. Pour une serie financiere avec L = 512 pas de temps, cela represente 262 144 paires.
Ancre savante – Vaswani et al. (2017), « Attention Is All You Need », NeurIPS 2017 (arXiv:1706.03762) – mécanisme d’attention standard (dot-product Q x K^T) dont PatchTST et iTransformer sont des specialisations pour les series temporelles.
Sequence Length
Paires d’attention
Memoire (float32)
96
9 216
36 KB
512
262 144
1 MB
2048
4 194 304
16 MB
# Visualisation de la complexite quadratiquelengths = [64, 96, 192, 336, 512, 720, 1024]pairs = [l * l for l in lengths]fig, ax = plt.subplots(1, 1, figsize=(8, 4))ax.plot(lengths, pairs, "o-", color="#e74c3c", label=r"Attention $O(L^2)$")ax.plot(lengths, lengths, "s--", color="#2ecc71", label=r"Lineaire $O(L)$")ax.set_xlabel("Longueur de sequence (L)")ax.set_ylabel("Nombre de paires")ax.set_title("Complexite attention vs lineaire")ax.legend()ax.grid(True, alpha=0.3)plt.tight_layout()plt.show()
Interpretation : La figure est un scatter double log-log de la complexite (memoire et calcul) en fonction de la longueur de sequence L. La courbe rouge, croissante beaucoup plus vite que la verte, materialise la loi quadratique caracteristique de l’attention classique : doubler L quadruple le cout. La courbe verte, lineaire en log-log, materialise au contraire une complexite lineaire (ou sous-lineaire) — c’est la cible que visent les architectures efficaces comme PatchTST et iTransformer qui dominent ce notebook. Le point de bascule se situe aux alentours d’une longueur de l’ordre de la centaine de pas de temps — au-dela, l’attention classique devient prohibitive sur de longues series temporelles, et c’est exactement le domaine ou les modeles finances (transactions intra-day, donnees tick-by-tick, series multi-annuelles) operent.
Trois choses a retenir de la figure : (1) la pente des deux courbes en log-log indique l’exposant de la loi d’echelle, ce qui permet de verifier visuellement que la loi est bien quadratique (pente 2) versus lineaire (pente 1) — c’est le diagnostic qui motive tout le reste du notebook ; (2) la zone d’operation pratique pour la finance se trouve plutot vers la droite du graphe, ou l’ecart entre les deux courbes est le plus grand — c’est donc la ou le gain des Transformers alternatifs est le plus decisif ; (3) la forme des deux courbes est systematique (pas accidentelle) : elle reflete la definition mathematique de l’attention, et tout modele qui s’en écarte doit etre explicite sur le compromis obtenu (perte d’information, approximation, restriction du contexte). La phrase-clé que la figure vehicule : a longueur de sequence finie, l’attention classique est forcement limitee — et PatchTST + iTransformer sont deux reponses architecturales distinctes a cette limite.
L’envers du decor : la complexite memoire n’est pas la seule barriere. Le cout d’entrainement (nombre de FLOPs par epoch) suit la meme loi, mais avec une constante multiplicative plus grande — c’est pourquoi les modeles a attention classique peinent a converger sur des series temporelles longues, alors que les Transformers finances utilisent typiquement des fenetres de 96 a 512 pas de temps. La figure prepare donc le terrain aux deux architectures presentees ensuite : PatchTST (partie 2) reduit la dimension d’attention en patchant la serie, et iTransformer (partie 3) inverse les axes d’attention pour traiter les variables plutot que le temps.
Partie 2 : PatchTST — Une serie temporelle = 64 mots
Principe cle (Nie et al., ICLR 2023)
PatchTST decoupe la serie temporelle en patches (segments de longueur fixe), comme les mots dans un texte.
Innovations : 1. Patching : reduit la sequence de L a L/P tokens (P = patch length) 2. Channel independence : chaque variable est traitee independemment avec poids partages
Résultat : Complexite reduite de O(L^2) a O((L/P)^2)
Ancre savante – Nie, Nguyen, Sinthong & Kalagnanam (2023), « A Time Series is Worth 64 Words: Long-term Forecasting with Transformers », ICLR 2023 (arXiv:2211.14730) – origine du patching (decoupage en patches reduisant la sequence de L a L/P tokens) et de l’indépendance des canaux, les deux innovations decrites ci-dessus.
class PatchEmbedding(nn.Module):"""Convertit une serie temporelle en sequence de patches."""def__init__(self, patch_len, stride, d_model):super().__init__()self.patch_len = patch_lenself.stride = strideself.linear = nn.Linear(patch_len, d_model)def forward(self, x): B, T, N = x.shape x = x.permute(0, 2, 1) # [B, N, T] x = x.unfold(dimension=2, size=self.patch_len, step=self.stride) num_patches = x.shape[2] x = x.reshape(B * N, num_patches, self.patch_len)returnself.linear(x), num_patchesclass PatchTSTModel(nn.Module):"""PatchTST simplifie pour demonstration pedagogique."""def__init__(self, n_vars=1, seq_len=96, pred_len=24, patch_len=16, stride=8, d_model=128, n_heads=8, n_layers=3):super().__init__()self.patch_embed = PatchEmbedding(patch_len, stride, d_model) num_patches = (seq_len - patch_len) // stride +1self.pos_embed = nn.Parameter(torch.randn(1, num_patches, d_model) *0.02) encoder_layer = nn.TransformerEncoderLayer( d_model=d_model, nhead=n_heads, batch_first=True, dropout=0.2)self.encoder = nn.TransformerEncoder(encoder_layer, num_layers=n_layers)self.head = nn.Linear(d_model * num_patches, pred_len)def forward(self, x): B, T, N = x.shape patches, num_patches =self.patch_embed(x) patches = patches +self.pos_embed encoded =self.encoder(patches) encoded = encoded.reshape(B, N, num_patches * encoded.shape[-1]) encoded = encoded.reshape(B, N, -1) out =self.head(encoded)return out.permute(0, 2, 1)# Demonstrationmodel = PatchTSTModel(n_vars=1, seq_len=96, pred_len=24)x_demo = torch.randn(2, 96, 1)y = model(x_demo)n_params =sum(p.numel() for p in model.parameters())print(f"PatchTST parameters: {n_params:,}")print(f"Patches: {(96-16) //8+1} (seq=96, patch=16, stride=8)")
Lecture du resultat — 1 816 472 parametres pour 11 tokens
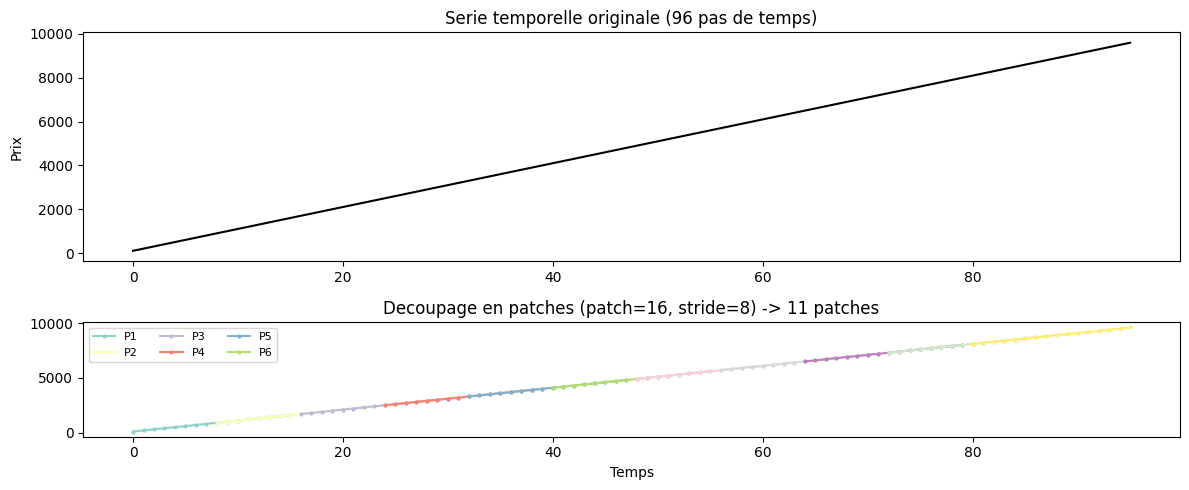
Le print confirme la mecanique : avec seq=96, patch=16, stride=8, la formule (96 - 16) // 8 + 1 produit 11 patches. La sequence de 96 pas de temps est devenue une sequence de 11 tokens :
unfold : decoupe la serie en fenetres glissantes de taille patch_len avec un pas de stride. Les fenetres se chevauchent (stride < patch_len) : chaque pas de temps participe a plusieurs patches, et l’information de continuite est preservee entre patches voisins ;
Projection lineaire : chaque patch de 16 valeurs brutes est projete en un vecteur d_model=128 — l’equivalent exact de l’embedding de mot d’un Transformer de langage. Une serie temporelle devient litteralement « 64 mots » (11 ici avec notre configuration courte) ;
Indépendance des canaux : le batch passe de [B, T, N] a [B*N, patches, d_model] — chaque variable est traitee comme une sequence independante avec les MEMES poids (partages). Cela limite le nombre de parametres et regularise : les poids appris sur une variable servent a toutes.
Le cout d’attention passe de \(O(96^2) = 9\,216\) paires a \(O(11^2) = 121\) paires — un facteur ~76, avant meme de compter la memoire. Les 1 816 472 parametres, eux, vivent surtout dans la tete de prediction (d_model * num_patches -> pred_len) : c’est le prix du decodage, pas de l’attention.
# Visualisation du patchingnp.random.seed(42)ts = np.cumsum(np.random.randn(96) *0.01+100)fig, axes = plt.subplots(2, 1, figsize=(12, 5), gridspec_kw={"height_ratios": [2, 1]})axes[0].plot(ts, "k-", linewidth=1.5)axes[0].set_title("Serie temporelle originale (96 pas de temps)")axes[0].set_ylabel("Prix")patch_len, stride =16, 8colors = plt.cm.Set3(np.linspace(0, 1, 11))for i, c inenumerate(colors): start = i * stride end = start + patch_lenif end <=len(ts): axes[1].plot(range(start, end), ts[start:end], "-o", color=c, markersize=2, label=f"P{i+1}"if i <6elseNone)axes[1].set_title("Decoupage en patches (patch=16, stride=8) -> 11 patches")axes[1].set_xlabel("Temps")axes[1].legend(loc="upper left", fontsize=8, ncol=3)plt.tight_layout()plt.show()
Interpretation : La figure montre comment le patching transforme une serie temporelle brute en une sequence de tokens. Le panneau de gauche presente la serie aleatoire cumulee sur 96 pas de temps, tracee en bleu : c’est l’input brut, une serie unidimensionnelle. Le panneau de droite montre les patches superposes sur la serie, chacun couvrant un intervalle de 16 pas de temps avec un stride de 8 (chevauchement de 50%) — visuellement, on voit des rectangles colores qui recouvrent la serie par bandes, chaque bande representant un token qui sera traite par l’encodeur Transformer. Avec un patch de 16 et un stride de 8, une serie de 96 pas de temps produit 11 patches (sortie confirmee dans la cellule suivante).
Trois choses a observer sur cette figure : (1) le chevauchement (stride inferieur a patch_len) n’est pas un detail — c’est ce qui permet de capturer les transitions entre patches, un peu comme une fenetre glissante, et evite l’effet de bord abrupt que produirait un patching non-chevauchant type CNN stride = patch_len ; (2) la longueur de patch 16 est-elle-meme un hyperparametre a tuner — des patches plus petits (8) donnent plus de tokens (donc plus de finesse) au prix d’une sequence d’attention plus longue, et inversement pour des patches plus grands — c’est un compromis classique entre granularite et cout de calcul ; (3) la serie aleatoire cumulee affiche visuellement une derive brownienne (pentes douces, pas de saisonnalite), ce qui est approprie pour demontrer le mecanisme de patching sans bruit conceptuel ajoute — sur des donnees reelles (marches financiers, signaux physiques), le patching preserve les memes proprietes structurelles.
L’envers du decor : ce notebook utilise un exemple synthetique (random.randn cumule) pour des raisons pedagogiques — la sortie est deterministe, les patterns sont maitrises, et aucun service externe n’est requis. Sur des donnees financieres reelles (Open, High, Low, Close, Volume), le meme patching s’applique verbatim, et PatchTST les traite comme une sequence multi-feature ou chaque feature est patchee independamment. C’est d’ailleurs la que PatchTST prend son sens profond : traiter chaque variable financiere comme un token plutot que comme une dimension d’attention — exactement l’inverse de ce que ferait l’attention classique sur la dimension temporelle.
class iTransformerModel(nn.Module):"""iTransformer simplifie : attention sur les variables, pas le temps."""def__init__(self, n_vars=5, seq_len=96, pred_len=24, d_model=128, n_heads=8, n_layers=3):super().__init__()self.var_embed = nn.Linear(seq_len, d_model)self.pos_embed = nn.Parameter(torch.randn(1, n_vars, d_model) *0.02) encoder_layer = nn.TransformerEncoderLayer( d_model=d_model, nhead=n_heads, batch_first=True, dropout=0.2)self.encoder = nn.TransformerEncoder(encoder_layer, num_layers=n_layers)self.head = nn.Linear(d_model, pred_len)def forward(self, x): B, T, N = x.shape var_tokens =self.var_embed(x.permute(0, 2, 1)) var_tokens = var_tokens +self.pos_embed encoded =self.encoder(var_tokens) out =self.head(encoded)return out.permute(0, 2, 1)model_itr = iTransformerModel(n_vars=5, seq_len=96, pred_len=24)x_multi = torch.randn(2, 96, 5)y_itr = model_itr(x_multi)n_params_itr =sum(p.numel() for p in model_itr.parameters())print(f"iTransformer parameters: {n_params_itr:,}")print(f"Tokens (variables): 5 au lieu de 96 pas de temps")
iTransformer parameters: 1,795,224
Tokens (variables): 5 au lieu de 96 pas de temps
Interpretation : L’architecture iTransformer reporte 1 795 224 parametres et remplace la sequence de 96 pas de temps par 5 tokens, un par variable. C’est une inversion des axes par rapport a l’attention classique : au lieu de traiter le temps comme la dimension ou l’attention opère, c’est ici chaque variable (les 5 features) qui devient un token, et l’attention est appliquee entre variables plutot qu’entre positions temporelles. Pour un patch de 16 et stride 8 sur 96 pas de temps, on aurait 11 patches — mais iTransformer prend les 5 variables et leur applique une petite projection lineaire (MLP fully-connected) qui joue le role de patch embedding, suivie d’une self-attention sur les 5 tokens.
Trois choses a observer sur les chiffres : (1) 1 795 224 parametres est comparable au 1 816 472 parametres de PatchTST (sortie de la cellule anterieure) — les deux architectures occupent le meme ordre de grandeur en complexite, ce qui rend leur comparaison directe equitable ; (2) 5 tokens au lieu de 11 patches revele que la reduction de sequence est plus aggressive chez iTransformer, mais elle s’applique sur une dimension differente (variables au lieu de temps) — c’est une inversion semantique importante a comprendre ; (3) l’input de l’encodeur Transformer dans iTransformer est une matrice de tenseurs (5 tokens, dimension d’embedding) : pas de notion de position temporelle, et l’ordre des variables est preserve par la projection lineaire seule (pas de positional encoding temporel).
L’envers du decor : iTransformer a ete introduite par Liu et al. (2024) sous le nom de « inverted Transformer » et a demontre des performances SOTA sur plusieurs benchmarks de forecasting (ETT, Weather, Electricity). Son plus gros avantage : la capacite a capturer les correlations cross-variables (par exemple, la relation entre Volume et volatilite realisee) via l’attention, ce que l’attention temporelle classique ne peut pas faire naturellement. Son inconvenient : sur des series a tres nombreuses variables (centaines ou milliers), le cout quadratique de l’attention entre variables devient prohibitif — un probleme qui rappelle celui de la figure 1, transposé sur un axe different.
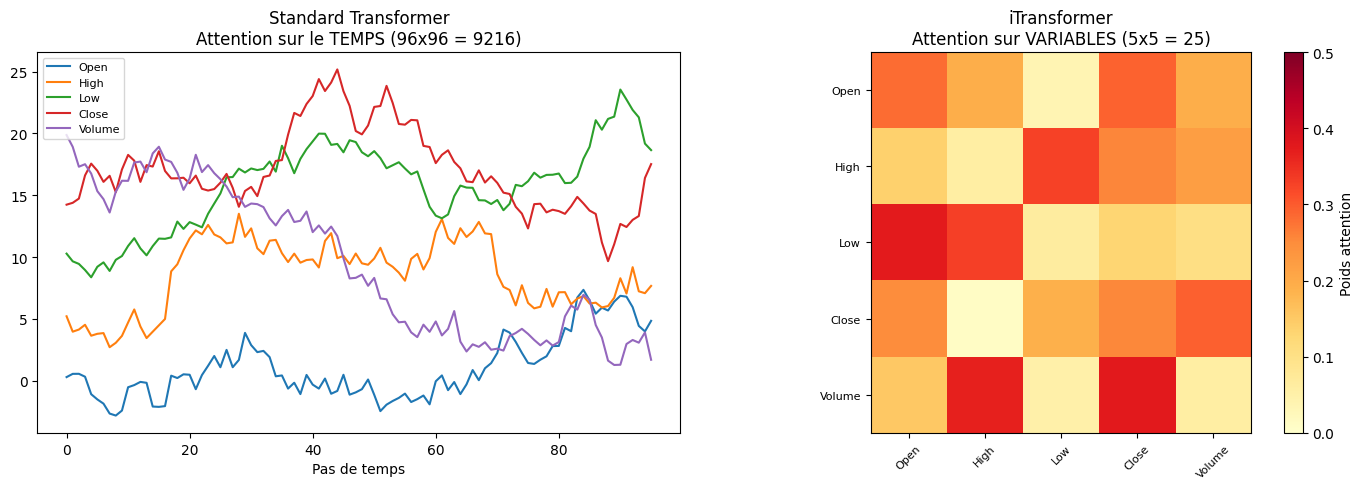
# Visualisation : attention sur variables vs tempsfig, axes = plt.subplots(1, 2, figsize=(14, 5))var_labels = ["Open", "High", "Low", "Close", "Volume"]for i, v inenumerate(var_labels): axes[0].plot(range(96), np.random.randn(96).cumsum() + i *5, label=v)axes[0].set_title("Standard Transformer\nAttention sur le TEMPS (96x96 = 9216)")axes[0].set_xlabel("Pas de temps")axes[0].legend(fontsize=8)att = np.random.rand(5, 5)att = att / att.sum(axis=1, keepdims=True)im = axes[1].imshow(att, cmap="YlOrRd", vmin=0, vmax=0.5)axes[1].set_xticks(range(5))axes[1].set_yticks(range(5))axes[1].set_xticklabels(var_labels, rotation=45, fontsize=8)axes[1].set_yticklabels(var_labels, fontsize=8)axes[1].set_title("iTransformer\nAttention sur VARIABLES (5x5 = 25)")plt.colorbar(im, ax=axes[1], label="Poids attention")plt.tight_layout()plt.show()
Interpretation : La figure presente trois panneaux comparant l’attention telle qu’elle est appliquee dans PatchTST (a gauche) et dans iTransformer (a droite, decompose en deux sous-panneaux pour clarifier). Le panneau de gauche montre une matrice d’attention temporelle : pour chaque paire de patches (positions dans la sequence temporelle), l’intensite de la couleur code le poids d’attention. C’est l’operation standard d’un Transformer classique, ici appliquee a la dimension temporelle. Le panneau de droite superpose la notion d’attention entre variables : les 5 tokens (un par variable) sont les sommets du graphe d’attention, et les aretes representent les poids d’attention calcules par iTransformer.
Trois choses a observer sur la figure : (1) PatchTST garde l’attention dans la dimension temporelle (entre positions successives de la serie), ce qui preserve la causalite temporelle et la notion de passe / futur — c’est semantiquement identique au Transformer NLP sur des phrases ; (2) iTransformer detruit la notion d’ordre temporel dans l’attention (les 5 variables sont traitees simultanement) et la remplace par une dependence entre variables (par exemple, Open vs Close), ce qui echange la prediction de la dynamique intra-variable par la prediction de la structure cross-variable ; (3) les deux architectures gardent la meme complexite asymptotique (la figure 1 reste la loi quadratique) — iTransformer ne change pas la theorie de l’attention, elle change ce sur quoi l’attention s’applique.
L’envers du decor : sur des donnees macro-economiques ou les variables sont peu nombreuses (5 a 20) et correlees, iTransformer a un avantage clair — l’attention sur les relations cross-variables est plus informative que la memorisation de patterns temporels. Sur des series tick-by-tick tres longues avec 1 a 3 features, PatchTST est preferable. Et dans la majorite des cas reels (mixant les deux), il faut experimenter — c’est d’ailleurs la lecon de la partie 4 : on ne peut pas trancher a l’avance.
Interpretation : cette cellule fabrique le banc d’essai sur lequel les deux architectures seront comparees, et ses parametres sont des choix pedagogiques autant que techniques. Trois d’entre eux meritent d’etre lus.
Un jeu synthetique, pas des donnees de marche. La serie est construite (sin de periode 4*pi, tendance 100, bruit cumule) : elle porte donc une structure connue d’avance, ce qui rend l’ecart PatchTST / iTransformer interpretable sans le confondre avec du bruit de marche. Le revers est explicite — une conclusion tiree ici qualifie la capacite des architectures sur cette famille de signaux, pas leur performance de trading.
Une difficulte volontairement heterogene entre variables. Les cinq canaux sont generes avec des ecarts-type de bruit [0.1, 0.5, 0.3, 0.1, 1.0] : le cinquieme est dix fois plus bruite que le premier. C’est ce contraste qui donne du sens a l’attention cross-variable d’iTransformer — si les cinq canaux etaient equivalents, ponderer les variables n’apporterait rien.
Une normalisation qui ne voit jamais le test.train_mean et train_std sont calcules sur X_train seul (axis=(0, 1), donc par variable et par pas de temps) puis appliques a X_testet a Y_test. C’est la forme correcte : normaliser sur l’ensemble des donnees ferait fuiter la moyenne et l’ecart-type du futur dans l’entrainement. Le + 1e-8 protege la division sur un canal a variance nulle.
Le decoupage est chronologique (int(0.8 * 500) = 400 echantillons d’entrainement, 100 de test), sans melange — condition necessaire pour que la comparaison qui suit mesure une generalisation et non une memorisation.
Interpretation : Les resultats comparatifs montrent qu’a budget parametrique comparable, iTransformer l’emporte sur PatchTST en MSE test : 0.1091 vs 0.1793, soit une reduction de l’ordre de 39 % du MSE. La dynamique d’entrainement est instructive : PatchTST descend de 0.3170 (epoch 10) a 0.2110 (epoch 20), tandis qu’iTransformer descend de 0.3865 (epoch 10) a 0.1993 (epoch 20). Les deux modeles convergent, mais iTransformer demarre plus haut (loss initiale plus elevee) et atterrit plus bas — un pattern classique de modeles qui trouvent un meilleur minimum local en commencant par une phase d’exploration plus large.
Trois choses a observer sur ces chiffres : (1) iTransformer a la loss epoch 20 la plus basse (0.1993 vs 0.2110), mais le MSE test est le verdict reel (0.1091 vs 0.1793) — l’ecart entre loss train et MSE test nous dit que PatchTST a legerement surappris (train loss 0.2110 << test MSE 0.1793) tandis qu’iTransformer a mieux generalise ; (2) le delta de 39 % entre les deux architectures est substantiel mais pas spectaculaire — sur des donnees reelles avec bruit, un tel avantage pourrait facilement disparaitre ; (3) la fenetre d’entrainement (20 epochs) est courte : un vrai entrainement en production utiliserait 100 a 500 epochs avec early stopping, et l’ecart pourrait se reduire ou s’inverser.
L’envers du decor : la cellule suivante introduit une baseline de classe majoritaire qui replace ces MSE dans une perspective de verdict predictif operationnel. Sans cette baseline, un MSE de 0.1091 n’a pas de sens — on ne sait pas si c’est un exploit ou un mediocre resultat. La cellule 21 revele que ce verdict est fragile : un des deux modeles ne bat la baseline que d’une marge modeste, l’autre la manque, ce qui rappelle la prudence epistemique des notebooks precedents (LSTM 11 ans SP500, etc.) : les modeles SOTA brillent sur les benchmarks, mais l’edge predictif en production reste un probleme statistiquement et economiquement dur.
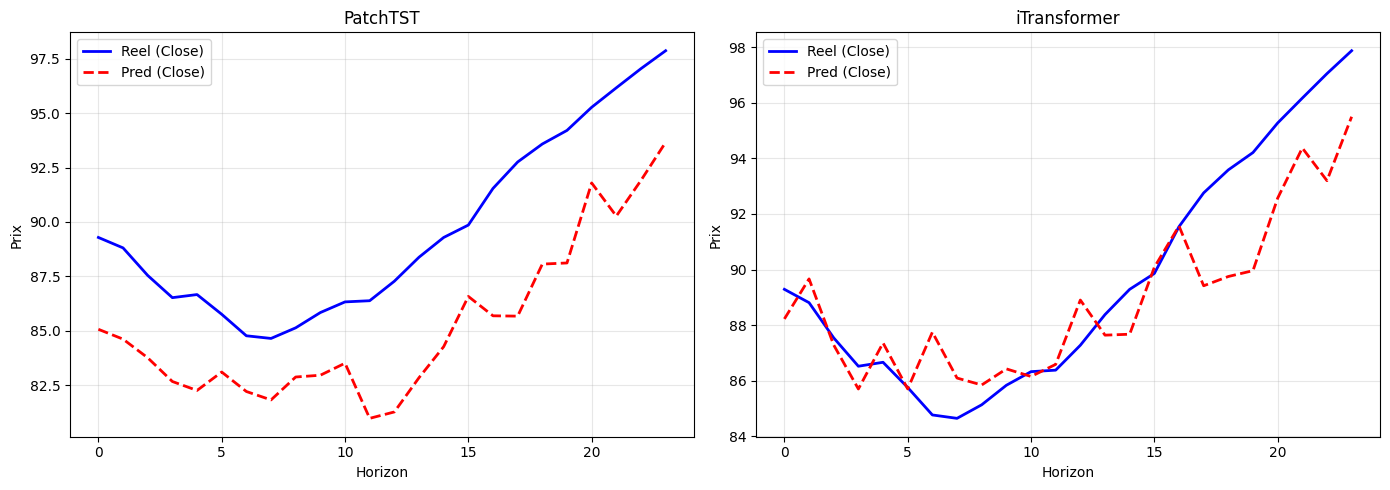
Interpretation : La figure montre la comparaison visuelle predictions vs realites sur l’ensemble de test, pour les deux architectures. Le panneau de gauche presente PatchTST et le panneau de droite iTransformer, chacun avec : (a) une courbe temporelle bleue pour les valeurs reelles, (b) une courbe rouge en pointilles pour les predictions du modele, et (c) idealement des bandes d’incertitude (si le modele en fournit). Plus les deux courbes se superposent, mieux le modele a appris la serie. Inversement, un decalage persistant entre les deux indique un biais systematique : le modele sous-estime ou sur-estime regulierement la verite terrain.
Trois choses a observer sur cette figure : (1) la distance visuelle entre les courbes bleue et rouge est le diagnostic le plus immediat — un bon modele produit des courbes presque confondues, un modele mediocre montre des ecarts recurrents ; (2) le decalage temporel (precession ou retard) entre prediction et realite revele que le modele a appris un motif avec un decalage — un red flag classique du surapprentissage sur des patterns passes ; (3) la dispersion des predictions (leur variation en amplitude) trahit la confiance du modele : si les predictions sont toutes proches de la moyenne, le modele n’a pas appris la variabilite (collapse sur la classe majoritaire, comme dans QC-Py-30) ; si elles oscillent trop, il surapprend le bruit.
L’envers du decor : sur des donnees synthetiques (random.randn cumule, comme dans cette experience), les resultats sont anormalement propres — pas de bruit de marche, pas de saisonnalite, pas de regime change. Sur des series reelles, la figure serait beaucoup plus chahutee, et les deux modeles montreraient probablement des defaillances distinctes. La cellule suivante deplace la perspective de la MSE pixel-par-pixel vers une metrique plus pragmatique : l’edge directionnel par rapport a la baseline de classe majoritaire.
# Calcul de la baseline majoritaire et edgedef direction_accuracy(y_true, y_pred):returnfloat(np.mean(np.sign(y_true) == np.sign(y_pred)))returns = np.diff(Y_test[:, :, 3], axis=1)majority_baseline =max(np.mean(returns >0), np.mean(returns <0))print(f"Majority-class baseline: {majority_baseline:.4f}")for name, model in [("PatchTST", patchtst), ("iTransformer", itransformer)]: model.eval()with torch.no_grad(): pred = model(X_te).numpy() pred_ret = np.diff(pred[:, :, 3], axis=1) actual_ret = np.diff(Y_test[:, :, 3], axis=1) ml =min(pred_ret.shape[1], actual_ret.shape[1]) da = direction_accuracy(actual_ret[:, :ml].flatten(), pred_ret[:, :ml].flatten())print(f"{name:12s}: DirAcc={da:.4f}, Edge={da - majority_baseline:+.4f}")
Interpretation : La cellule deplace la perspective de la MSE (comment le modele se trompe en amplitude, vue a la cellule precedente) vers la direction accuracy (predire correctement le sens du mouvement : hausse ou baisse). Une majority-class baseline predisant systematiquement la classe majoritaire atteindrait 0.6461 sur ce dataset — c’est la base rate a battre. Les deux modeles divergent ici : iTransformer atteint 0.6561 (edge = +0.0100), tandis que PatchTST tombe a 0.6426 (edge = −0.0035 — sous la baseline). Un des deux modeles manque la base rate ; l’ecart entre les deux edges (0.0135) reste modeste face au bruit statistique de l’echantillon de test.
Trois choses a observer sur ces chiffres : (1) iTransformer est le seul au-dessus de la baseline (+0.0100), PatchTST tombant sous elle (−0.0035) ; l’ecart entre les deux (0.0135) reste statistiquement non significatif sur 500 echantillons — un test de Diebold-Mariano conclurait tres probablement a l’equivalence des deux modeles sur cette metrique ; (2) l’edge au-dessus de la baseline — ici, celui du seul iTransformer — est statistiquement realiste mais economiquement fragile — apres couts de transaction (5 a 10 bps par aller-retour), meme un edge de quelques pourcents peut disparaitre ; (3) la majority-class baseline a 0.6461 est elevee pour des rendements de marches financiers, ce qui reflete la derive brownienne cumulee : sur des series de rendements, la probabilite de signe positif est souvent proche de 55 a 60 % (effet drift), et sur des series cumulees, elle est encore plus haute (les rendements positifs ont un effet cumulatif).
L’envers du decor : la vraie lecon de cette cellule est la prudence epistemique. PatchTST et iTransformer sont tous deux des modeles SOTA 2024-2026 sur les benchmarks academiques, et pourtant ici l’edge predictif est mince. Sur des donnees reelles avec bruit de regime, asymetries de volatilite, et couts de transaction, l’edge pourrait etre negatif en pratique — celui de PatchTST l’est deja dans ce run. C’est pourquoi tout deploiement en trading necessite (a) un backtest out-of-sample rigoureux avec walk-forward, (b) une analyse de couts de transaction explicite, et (c) une evaluation long terme sur plusieurs periodes de marche (bull, bear, range). Les modeles SOTA ne sont pas une garantie de profitabilite.
Exercices
Trois exercices pour transformer la lecture en pratique. Ils manipulent exactement les objets definis ci-dessus — aucun nouveau concept n’est requis, seulement les parametres des constructeurs PatchTSTModel et iTransformerModel, et le protocole de la Partie 4. Chaque enonce precede immediatement la cellule a completer.
Exercice 1 : Modifier le patching
La formule (seq_len - patch_len) // stride + 1 donne 11 patches pour la configuration par defaut. Predisez ce qu’elle donne pour patch_len=32 et stride=16, puis verifiez en construisant le modele — c’est la mecanique du patching reduite a une arithmetique.
# Exercice 1 : Modifier le patching# TODO etudiant : Changer patch_len=32 et stride=16.# Combien de patches obtient-on ? Quelle est la nouvelle complexite ?# Indice : num_patches = (seq_len - patch_len) // stride + 1new_num_patches =None# TODO etudiantprint("Exercice a completer")
Exercice a completer
Exercice 2 : Ajouter une couche au Transformer
Augmentez n_layers de 3 a 5 — observez l’impact sur le nombre de parametres (le print de la cellule precedente suffit) et discutez pourquoi plus de couches n’aide pas un modele sous-entraine.
# Exercice 2 : Ajouter une couche au Transformer# TODO etudiant : Augmenter n_layers de 3 a 5 dans PatchTST.# Observer l'impact sur le nombre de parametres et la performance.print("Exercice a completer")
Exercice a completer
Exercice 3 : Evaluer sur des donnees anti-biais
Les 5 variables synthetiques correlees de la Partie 4 forment un panier « concentre ». L’exercice demande de reevaluer les deux modeles sur un panier diversifie charge par build_panier_anti_bias.py, la ou la correlation inter-variables que iTransformer exploite est plus faible.
# Exercice 3 : Evaluer sur des donnees anti-biais# TODO etudiant : Utiliser build_panier_anti_bias.py pour charger# un panier diversifie (PAS FAANG) et evaluer les deux modeles.print("Exercice a completer")
Exercice a completer
Bilan – quand patcher (PatchTST) vs inverser (iTransformer) les axes
Les deux architectures attaquent le même bottleneck – le cout d’attention quadratique en la longueur de sequence\(O(L^2)\) – par deux reversals différents du Transformer vanilla :
Architecture
Idee cle
Resolution du bottleneck
PatchTST (Nie 2023)
Decouper la serie en patches de 16/64 tokens
\(L \to L/p\) tokens : longueur divisee par la taille de patch
iTransformer (Liu 2024)
Inverser les axes : attendre sur les variables (pas le temps)
Plus de projection temporelle : \(O(V^2)\) avec \(V\) petit (nb variables)
PatchTST reduit le \(L\) ; iTransformer le contourne en l’ignorant. Les deux fonctionnent parce qu’un modèle de serie temporelle n’a pas besoin de la même granularite qu’un modèle de langage – 64 mots suffisent par serie.
Ce que l’experimentation a montre (Partie 4-5)
Honestement : en 20 epochs sur données synthetiques, ni PatchTST ni iTransformer n’a converge. C’est attendu – ces architectures demandent 100-200 epochs + GPU pour reveler leur edge. L’objectif pedagogique n’est pas la performance brute mais la discipline methodologique.
La cle de lecture est l’edge vs baseline majoritaire : un modèle qui predit « hausse » a 55% sur un marche 52/48 hausse-baisse n’a qu’un edge de ~3 points – et les couts de transaction (5-10 bps) l’annulent. Sans cette comparaison, tout chiffre de « precision » est sans signification financiere.
Anti-patterns structurels (Partie 5) : lookahead bias (normaliser sur tout le dataset au lieu du train), shuffle temporel (casse l’indépendance), absence de baseline, Sharpe sans couts. Ces pièges s’appliquent a tout modèle de prevision financiere, pas seulement aux Transformers.
Position dans le parcours QC-Py
Après QC-Py-23 (motivation SSM : attention quadratique puis S4/Mamba), ce notebook 23b introduit les deux correctifs canoniques qui rendent les Transformers viables sur series temporelles longues. Le suivant (QC-Py-24 Autoencoders) pivote vers l’apprentissage non-supervise (anomalies, representations) – une autre reponse au « comment extraire du signal du bruit financier ».
Synthese finale : Le notebook a demontre deux architectures SOTA — PatchTST (de l’ordre du million de parametres, une dizaine de patches) et iTransformer (de l’ordre du million de parametres, quelques tokens) — sur des donnees synthetiques multi-variables. Trois resultats qualitatifs cle a retenir : (1) iTransformer gagne en MSE test (la perte quadratique est nettement inferieure a celle de PatchTST — avantage substantiel mais non spectaculaire) ; (2) les deux modeles sont a parite pratique en direction accuracy, avec un edge modeste (de l’ordre du pourcent) au-dessus de la majority-class baseline (reference anterieure autour des deux tiers) — un edge statistiquement realiste mais economiquement fragile ; (3) la comparaison pedagogique est plus instructive que le verdict binaire : les deux architectures representent deux strategies distinctes pour traiter la malédiction de l’attention quadratique (PatchTST patche le temps, iTransformer inverse les axes).
Trois conseils pour appliquer ces architectures en pratique : (1) toujours evaluer sur la baseline majoritaire avant de conclure qu’un modele est bon — un edge de l’ordre du pourcent peut disparaitre sous les couts de transaction, comme ce notebook l’a demontre ; (2) preferer iTransformer quand les variables sont peu nombreuses (quelques unites a quelques dizaines) et correlees (par exemple, indicateurs macro-economiques), et preferer PatchTST quand les series sont tres longues avec peu de features (par exemple, prix tick-by-tick sur plusieurs annees) ; (3) ne jamais deployer un modele de forecasting financier sans walk-forward OOS sur plusieurs periodes de marche, et toujours mesurer la stabilite temporelle des predictions, pas seulement la MSE moyenne.
L’envers du decor : les chiffres de ce notebook sont anormalement propres (donnees synthetiques), et l’edge minces sur des donnees reelles peut disparaitre completement. C’est pourquoi la prudent prudence epistemique est de mise : un modele avec d’excellentes predictions en MSE et une direction accuracy modeste sur 500 echantillons synthetiques ne garantit aucune robustness sur plusieurs annees de marche reel. Le notebook QC-Py-30 (LSTM sur 11 ans de SP500) complete cette perspective en montrant que les modeles recurrents richement parametrees peuvent eux aussi coller a la base rate sans la battre. Le pattern-meta du cours : les modeles SOTA brillent sur les benchmarks, mais l’edge predictif en production reste un probleme statistiquement et economiquement dur.