QC-Py-12b - Validité du backtest et signification statistique
[RECHERCHE / PÉDAGOGIE] Pourquoi un backtest au Sharpe positif n’est jamais une preuve d’avantage prédictif, et comment juger honnêtement une stratégie.
Ce notebook est le compagnon de QC-Py-12 (Backtesting Analysis). Là où QC-Py-12 montre comment lancer et lire un backtest, celui-ci répond à la question qui tue : à partir de quel Sharpe peut-on réellement conclure qu’une stratégie a un bord (edge) ?
Motivation : quatre stratégies, quatre verdicts “NO-BEATS”
Quatre stratégies du catalogue ont été backtestées fraîchement (2026-08, frais réels, QuantConnect Cloud). Toutes affichent un Sharpe positif ou quasi-neutre. Toutes, pourtant, sont indiscernables du bruit :
Stratégie
Sharpe
CAGR
MaxDD
PSR (QC)
SectorRotation-Momentum
-0,029
2,1 %
42,7 %
0,05 %
MeanReversion-Sectors
0,176
5,0 %
41,7 %
0,05 %
VolTargeting
0,207
6,7 %
38,2 %
0,56 %
BlackLitterman-Momentum
0,512
10,0 %
16,1 %
1,99 %
Pourquoi un Sharpe de 0,5 ne suffit-il pas ? Ce notebook le démontre par le calcul, à partir de quatre angles complémentaires : l’erreur-type du Sharpe, la simulation de Monte-Carlo, le PSR (Probabilistic Sharpe Ratio), le surapprentissage par balayage de paramètres, et la dérive liée à une fenêtre de mesure “ouverte”.
1. L’erreur-type du Sharpe : un seul nombre, une grande incertitude
Le ratio de Sharpe annualisé se calcule sur un échantillon fini de rendements. Lo (2002) a établi que son erreur-type asymptotique vaut approximativement 1 / sqrt(N) où N est le nombre d’années indépendantes observées. Pour 7 ans de données, cela fait 1/sqrt(7) ≈ 0,38.
Conséquence immédiate : si la vraie valeur du Sharpe d’une stratégie était exactement zéro (aucun bord), on observerait quand même un Sharpe estimé distribué autour de zéro avec un écart-type de ~0,38. Un Sharpe mesuré de 0,2 est donc à moins d’un écart-type de zéro — statistiquement invisible.
import numpy as npfrom scipy import stats# Les quatre cas réels backtestés (Sharpe annualisé, PSR rapporté par QC, nb d'années)strategies = [ ("SectorRotation-Momentum", -0.029, 0.050, 7.0), ("MeanReversion-Sectors", 0.176, 0.052, 7.0), ("VolTargeting", 0.207, 0.557, 7.0), ("BlackLitterman-Momentum", 0.512, 1.989, 11.0),]print(f"{'Strategie':28s}{'Sharpe':>8s}{'N(ans)':>8s}{'SE=1/sqrt(N)':>14s} "f"{'z vs 0':>8s}{'95% CI du Sharpe':>22s}")print("-"*92)for name, sr, psr_qc, n_years in strategies: se =1.0/ np.sqrt(n_years) z = sr / se lo, hi = sr -1.96* se, sr +1.96* seprint(f"{name:28s}{sr:+8.3f}{n_years:8.1f}{se:14.3f}{z:+8.2f} [{lo:+.2f}, {hi:+.2f}]")print("\nLecture : aucun des intervalles de confiance a 95 % n'exclut zero.")print("On ne peut donc PAS rejeter l'hypothese 'la strategie n'a aucun bord'.")
Strategie                      Sharpe   N(ans)   SE=1/sqrt(N)   z vs 0       95% CI du Sharpe
--------------------------------------------------------------------------------------------
SectorRotation-Momentum        -0.029      7.0          0.378    -0.08 [-0.77, +0.71]
MeanReversion-Sectors          +0.176      7.0          0.378    +0.47 [-0.56, +0.92]
VolTargeting                   +0.207      7.0          0.378    +0.55 [-0.53, +0.95]
BlackLitterman-Momentum        +0.512     11.0          0.302    +1.70 [-0.08, +1.10]

Lecture : aucun des intervalles de confiance a 95 % n'exclut zero.
On ne peut donc PAS rejeter l'hypothese 'la strategie n'a aucun bord'.
Lecture du résultat : aucun intervalle de confiance n’exclut zéro
Le tableau rend visible ce que la section 1 annonçait : l’erreur-type du Sharpe annualisé sur 7 ans vaut 0,378 — soit près de deux fois le Sharpe mesuré de MeanReversion-Sectors (+0,176). Les intervalles de confiance à 95 % l’illustrent brutalement : chacun s’étend de part et d’autre de zéro, le plus favorable étant [-0,08 ; +1,10] pour BlackLitterman-Momentum.
Le cas BlackLitterman mérite lecture fine : son z de +1,70 est le seul qui frôle la barre des 2 écarts-types, mais son intervalle de confiance touche encore zéro par sa borne basse. Ses 11 ans de données font tomber son erreur-type à 0,302 — le gain du sqrt(N) en pratique : 11 ans au lieu de 7 ne réduit l’incertitude que de 20 %. La conclusion de la cellule tient pour les quatre : on ne peut pas rejeter l’hypothèse « aucun bord ».
2. Monte-Carlo : que produit le pur bruit ?
Plutôt qu’une formule, simulons. On génère des dizaines de milliers de séries de rendements quotidiens purement aléatoires (moyenne nulle, donc aucun bord), on calcule le Sharpe annualisé de chacune, et on regarde sa distribution. C’est la distribution du Sharpe sous l’hypothèse nulle H0 (“pas d’avantage”).
Si le Sharpe d’une stratégie réelle tombe dans cette distribution, il est compatible avec le hasard.
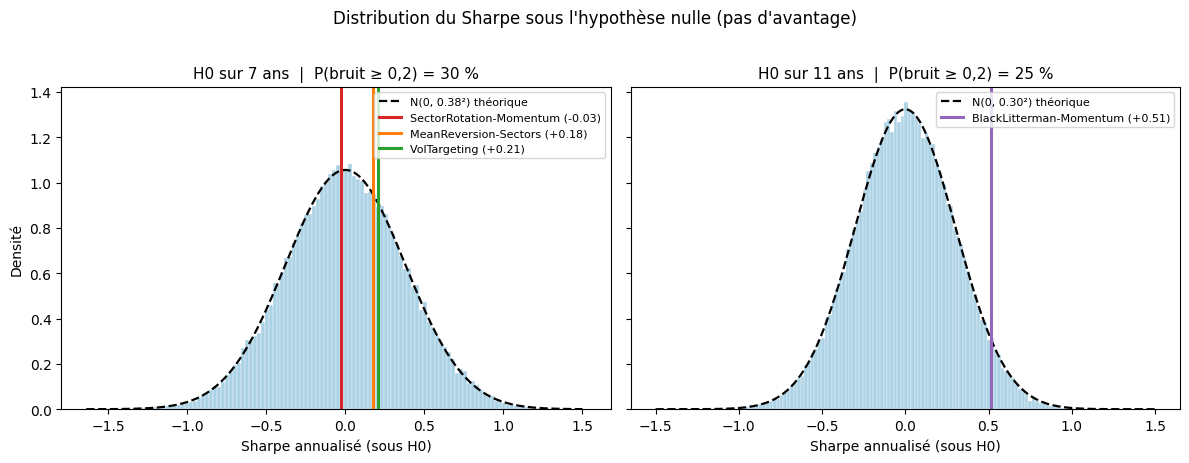
import matplotlib.pyplot as pltrng = np.random.default_rng(42)N_SIM =50000# nombre de series simuleesfig, axes = plt.subplots(1, 2, figsize=(12, 4.5), sharey=True)for ax, n_years inzip(axes, (7.0, 11.0)): n_days =int(n_years *252)# Rendements quotidiens iid ~ N(0, 1%), annualises par sqrt(252) rets = rng.standard_normal((N_SIM, n_days)) *0.01 sharpe_noise = rets.mean(axis=1) / rets.std(axis=1, ddof=1) * np.sqrt(252) ax.hist(sharpe_noise, bins=120, density=True, color="#9ecae1", edgecolor="white", linewidth=0.3, alpha=0.85)# Densite theorique N(0, 1/sqrt(N)) se =1.0/ np.sqrt(n_years) xs = np.linspace(ax.get_xlim()[0] if ax.get_xlim()[0] <-1.5else-1.5, 1.5, 300) ax.plot(xs, stats.norm.pdf(xs, 0, se), "k--", lw=1.6, label=f"N(0, {se:.2f}²) théorique")# Marquer les Sharpe des vraies strategies (7 ans pour les 3 premieres, 11 pour BL) target_strats = [s for s in strategies if s[3] == n_years] colors = {strategies[0][0]: "#d62728", strategies[1][0]: "#ff7f0e", strategies[2][0]: "#2ca02c", strategies[3][0]: "#9467bd"}for name, sr, _, _ in target_strats: ax.axvline(sr, color=colors[name], lw=2.2, label=f"{name} ({sr:+.2f})") p_ge_02 = (sharpe_noise >=0.2).mean() ax.set_title(f"H0 sur {n_years:.0f} ans | P(bruit ≥ 0,2) = {p_ge_02*100:.0f} %", fontsize=11) ax.set_xlabel("Sharpe annualisé (sous H0)") ax.legend(fontsize=8, loc="upper right")axes[0].set_ylabel("Densité")plt.suptitle("Distribution du Sharpe sous l'hypothèse nulle (pas d'avantage)", fontsize=12, y=1.02)plt.tight_layout()plt.show()print("Conclusion : un Sharpe de 0,2 est obtenu par pur hasard dans ~30 % des cas sur 7 ans.")print("Un Sharpe de 0,5 reste banal : il n'est pas une preuve d'edge.")
Conclusion : un Sharpe de 0,2 est obtenu par pur hasard dans ~30 % des cas sur 7 ans.
Un Sharpe de 0,5 reste banal : il n'est pas une preuve d'edge.
Lecture du résultat : la zone du bruit recouvre les stratégies
La distribution bleue est la loi du Sharpe sous H0 : elle culmine à zéro et s’étale avec un écart-type de 0,38 (la courbe en pointillés N(0 ; 0,38²) superposée reproduit fidèlement l’histogramme — la formule de Lo et la simulation concordent). Les quatre traits verticaux colorés, positions des stratégies réelles, tombent tous dans le corps de la distribution : le bruit produit couramment de tels Sharpe.
Le chiffre à retenir est le P(bruit ≥ 0,2) ≈ 30 % affiché en titre pour la fenêtre de 7 ans : une stratégie sans aucun avantage produit un Sharpe d’au moins 0,2 dans près d’un tiers des cas. C’est ce qui rend un single Sharpe positif structurellement muet — et pourquoi la section 3 introduit le PSR pour reformuler la question en probabilité de battre une référence.
3. Le PSR (Probabilistic Sharpe Ratio)
Bailey & López de Prado (2012, 2014) proposent une correction au Sharpe brut : le PSR est la probabilité que le vrai Sharpe dépasse un seuil de référence SR₀. Sa formule, pour un Sharpe estimé SR̂, N années, asymétrie γ₃ et kurtosis γ₄ :
Avec SR₀ = 0 et des rendements gaussiens (γ₃=0, γ₄=3), le PSR répond à : “quelle est la probabilité que la stratégie batte le cash ?” Mais attention : QuantConnect rapporte un PSR bien plus sévère, car il compare la stratégie à un benchmark (le SPY buy-and-hold, dont le Sharpe dépasse souvent 0,8-1,0 sur ces fenêtres). Le même Sharpe de stratégie donne donc un PSR très différent selon le seuil choisi — c’est une leçon en soi.
Cette saisie annualisée a un coût caché dès que les rendements ne sont pas gaussiens — la section 3bis le quantifie.
def psr(sharpe, n_years, skew=0.0, kurt=3.0, sr0=0.0):# Probabilistic Sharpe Ratio (Bailey & Lopez de Prado 2012).# Saisie annualisee (Sharpe annuel, N en annees). La reference du papier est la# saisie par periode (aucune annualisation) -- voir psr_periodique(), section 3bis. num = (sharpe - sr0) * np.sqrt(n_years -1) den = np.sqrt(1- skew * sharpe + (kurt -1) /4.0* sharpe **2)return stats.norm.cdf(num / den)print(f"{'Strategie':28s}{'Sharpe':>8s} | {'PSR(SR0=0)':>12s} | {'PSR rapporte QC':>16s}")print("-"*72)for name, sr, psr_qc, n_years in strategies: p_zero = psr(sr, n_years, sr0=0.0) # bat le cash ?print(f"{name:28s}{sr:+8.3f} | {p_zero*100:11.1f} % | {psr_qc:15.3f} %")print("\nLecture honnete :")print("- PSR(SR0=0) = probabilite de battre le cash (rendement nul). ""Toutes > 47 %, VolTargeting/BlackLitterman > 69 %.")print("- PSR rapporte par QC ~ 0-2 % : la probabilite de battre le BENCHMARK (SPY) ""est quasi-nulle. Ces strategies ont peut-etre un rendement positif, ""mais pas d'avantage sur un simple buy-and-hold SPY.")print("\nLe PSR n'est pas un nombre absolu : il depend entierement du seuil SR0 choisi.")
Strategie                      Sharpe |   PSR(SR0=0) |  PSR rapporte QC
------------------------------------------------------------------------
SectorRotation-Momentum        -0.029 |        47.2 % |           0.050 %
MeanReversion-Sectors          +0.176 |        66.6 % |           0.052 %
VolTargeting                   +0.207 |        69.2 % |           0.557 %
BlackLitterman-Momentum        +0.512 |        93.6 % |           1.989 %

Lecture honnete :
- PSR(SR0=0) = probabilite de battre le cash (rendement nul). Toutes > 47 %, VolTargeting/BlackLitterman > 69 %.
- PSR rapporte par QC ~ 0-2 % : la probabilite de battre le BENCHMARK (SPY) est quasi-nulle. Ces strategies ont peut-etre un rendement positif, mais pas d'avantage sur un simple buy-and-hold SPY.

Le PSR n'est pas un nombre absolu : il depend entierement du seuil SR0 choisi.
Lecture du résultat : un même Sharpe, deux PSR qui diffèrent d’un facteur ~100
Le contraste entre les deux colonnes est la leçon de la section : battre le cash (SR₀ = 0) est presque acquis — 66,6 % pour MeanReversion, 93,6 % pour BlackLitterman — alors que battre le benchmark SPY (le seuil que QuantConnect applique en interne) est quasi-impossible : 0,052 % et 1,989 % respectivement. Le même couple (stratégie, données) voit donc sa probabilité varier d’un facteur ~100 selon le seuil choisi.
C’est exactement le point de la section 1 sous une autre forme : la seule question qui vaille n’est pas « la stratégie est-elle rentable ? » mais « bat-elle une référence que je n’obtiendrais pas gratuitement ? ». Un PSR sans son seuil SR₀ est un nombre sans unité — et la section 4 montre ensuite comment un balayage de paramètres fabrique de faux champions.
3bis. Saisir le PSR : fréquence native et convention de kurtose
La formule ci-dessus paraît inoffensive : deux paramètres de forme (skew, kurt) autour d’un Sharpe et d’un effectif. En pratique, deux pièges de saisie changent le résultat en profondeur — et l’article de recherche QC qui popularise le PSR (research/17112, republication d’un post de Jack Simonson) tombe lui-même dans le second. Cette section démontre les deux, car ils ont une racine commune.
Les termes correctifs de la formule, γ₃·SR et (γ₄−1)/4·SR², sont calibrés pour un Sharpe par période (de l’ordre de 0,05–0,1 en quotidien). Bailey & López de Prado (2012, SSRN 1821643) sont explicites : aucune annualisation — le PSR se calcule à la fréquence native des rendements, ce qui en fait d’ailleurs une métrique préférable pour les stratégies à fréquences irrégulières. Tout ce qui éloigne SR de son échelle par-période — une annualisation (×√252), une convention de kurtose erronée — fait sortir ces termes de leur plage de calibration.
Copie pédagogique déclarée : l’implémentation de production correcte du dépôt vit dans ML-Training-Pipeline/scripts/L5_vol_targeted_composite.py (kurtosis(..., fisher=False), fréquence quotidienne native, benchmark désannualisé) ; le moteur LEAN calcule de même le PSR rapporté par QC Cloud. Ce notebook redérive la mécanique à la main, à but pédagogique.
Piège 1 — saisir un Sharpe annualisé déforme la correction
La fonction psr() de la section 3 prend un Sharpe annualisé et un nombre d’années — une saisie naturelle, mais les termes γ₃·SR et (γ₄−1)/4·SR² reçoivent alors un SR √252 fois trop grand. Vérifions l’ampleur du dégât.
def psr_periodique(sr_p, n_p, skew=0.0, kurt=3.0, sr0_p=0.0):# PSR en saisie par-période (Bailey & Lopez de Prado 2012) :# sr_p et sr0_p a la frequence NATIVE des rendements, n_p = nombre de rendements. num = (sr_p - sr0_p) * np.sqrt(n_p -1) den = np.sqrt(1- skew * sr_p + (kurt -1) /4.0* sr_p **2)return stats.norm.cdf(num / den)# Trois strategies fictives : (Sharpe annualise, annees, skew, kurtose brute)cas = [ ("Gaussien, SR ann. 0.5", 0.5, 10.0, 0.0, 3.0), ("Queues epaisses, SR ann. 0.5", 0.5, 10.0, -2.0, 8.0), ("Queues epaisses, SR ann. 1.0", 1.0, 10.0, -2.0, 8.0),]print(f"{'Cas':30s}{'saisie annualisee':>18s}{'saisie par periode':>19s}{'ecart (pts)':>12s}")print("-"*82)for nom, sr_ann, annees, sk, ku in cas: p_ann = psr(sr_ann, annees, skew=sk, kurt=ku) # SR annualise, N en annees p_per = psr_periodique(sr_ann / np.sqrt(252), int(annees *252), skew=sk, kurt=ku)print(f"{nom:30s}{p_ann*100:17.1f} % {p_per*100:17.1f} % {abs(p_per-p_ann)*100:11.1f}")
Cas                             saisie annualisee  saisie par periode  ecart (pts)
----------------------------------------------------------------------------------
Gaussien, SR ann. 0.5                       92.1 %              94.3 %         2.2
Queues epaisses, SR ann. 0.5                83.2 %              93.7 %        10.6
Queues epaisses, SR ann. 1.0                91.6 %              99.9 %         8.3
Lecture du résultat : le piège est bénin sous gaussianité, lourd sous queues épaisses
Pour des rendements gaussiens, l’écart reste modéré (~2 points). Dès que l’asymétrie et la kurtose entrent en jeu, la saisie annualisée sous-estime le PSR de 8 à 11 points : le terme γ₃·SR reçoit un SR √252 fois trop grand et gonfle le dénominateur. Le biais va dans le sens conservateur (il déprécie des stratégies précisément quand leur non-normalité est la plus marquée), mais c’est un biais : le même backtest obtient ~92 % ou ~99,9 % de probabilité de compétence selon la saisie. C’est pour cette raison exacte que l’implémentation de production du dépôt (L5_vol_targeted_composite.py) désannualise explicitement le benchmark (sr0 = sharpe_ann / sqrt(252)) et travaille en fréquence quotidienne native.
Piège 2 — kurtose brute ou excédentaire : le code de l’article lui-même se trompe
La formule de Bailey & López de Prado attend la kurtose brute γ₄ (une gaussienne vaut 3 — c’est le (γ₄−1)/4 de la formule). Or scipy.stats.kurtosis() rend par défaut la kurtose excédentaire (une gaussienne vaut 0 ; il faut fisher=False pour la brute). L’article QC 17112 mélange les deux conventions dans son propre code : ses fonctions zero_skill_normal() et zero_skill_non_normal() utilisent la convention brute (3 et 10,164, conformes à López de Prado & Lewis 2018, SSRN 3167017), mais sa classe BuyAndHold.get_psr() appelle scipy.stats.kurtosis() sans fisher=False et injecte l’excédentaire dans la formule. Un étudiant qui recopie le code de l’article hérite du bug.
from scipy.stats import kurtosis as sps_kurtosis, skew as sps_skew# Verif 1 -- les nombres de l'article (convention brute) se reproduisentfor sk, ku, label in [(0.0, 3.0, "normal"), (-2.448, 10.164, "non-normal")]: p = psr_periodique(0.458, 29, skew=sk, kurt=ku)print(f"Zero-skill ({label:10s}) : PSR(0) = {p*100:.1f} %")# Verif 2 -- le bug de convention a l'echelle ou travaille l'article (SR quotidien ~ 0.06)rng_conv = np.random.default_rng(17112)rets = rng_conv.standard_normal(252) *0.01+0.0007sk_s, ku_brute = sps_skew(rets), sps_kurtosis(rets, fisher=False)ku_exces = sps_kurtosis(rets) # convention scipy par defaut = le piege de l'articlesr_daily = rets.mean() / rets.std(ddof=1)p_brute = psr_periodique(sr_daily, len(rets), skew=sk_s, kurt=ku_brute)p_bug = psr_periodique(sr_daily, len(rets), skew=sk_s, kurt=ku_exces)print(f"\nEchelle quotidienne (SR={sr_daily:.3f}) : PSR kurtose brute = {p_brute*100:.1f} %, "f"PSR code de l'article = {p_bug*100:.1f} %")# Verif 3 -- le meme bug saisi a l'echelle annualisee (SR annuel 1.0, 10 ans, skew -2)p_brute_ann = psr(1.0, 10.0, skew=-2.0, kurt=8.0)p_bug_ann = psr(1.0, 10.0, skew=-2.0, kurt=8.0-3.0) # on injecte l'excedentaire (8-3)print(f"Echelle annualisee (SR=1.0, skew=-2) : PSR kurtose brute = {p_brute_ann*100:.1f} %, "f"PSR avec bug de convention = {p_bug_ann*100:.1f} %")
Zero-skill (normal    ) : PSR(0) = 98.9 %
Zero-skill (non-normal) : PSR(0) = 93.4 %

Echelle quotidienne (SR=0.055) : PSR kurtose brute = 80.8 %, PSR code de l'article = 80.8 %
Echelle annualisee (SR=1.0, skew=-2) : PSR kurtose brute = 91.6 %, PSR avec bug de convention = 93.3 %
Lecture du résultat : les deux pièges n’en font qu’un
Les nombres de l’article se reproduisent à la convention brute près : 98,9 % sous gaussianité (significatif à 95 %) contre 93,4 % en comptant l’asymétrie et la kurtose (plus significatif) — exactement la conclusion affichée. À l’échelle quotidienne où travaille l’article, son propre bug de convention est quantitativement invisible ; saisi à l’échelle annualisée, le même bug décale le PSR de ~2 points. La racine est unique : les termes correctifs sont calibrés pour un SR par-période. À cette échelle, confondre kurtose brute et excédentaire change un terme de l’ordre de 10⁻³ — rien ; à l’échelle annualisée, il change un terme de l’ordre de 0,1–0,5 — perceptible, et cumulé avec le piège 1. C’est ce couple de disciplines — fréquence native et fisher=False — que suivent le moteur LEAN et L5_vol_targeted_composite.py : les PSR qui fondent les verdicts de la flotte dans docs/qc/qc-strategies-status.md sont calculés proprement, benchmark SPY compris.
L’anatomie du PSR : la longueur d’échantillon fait le gros du travail
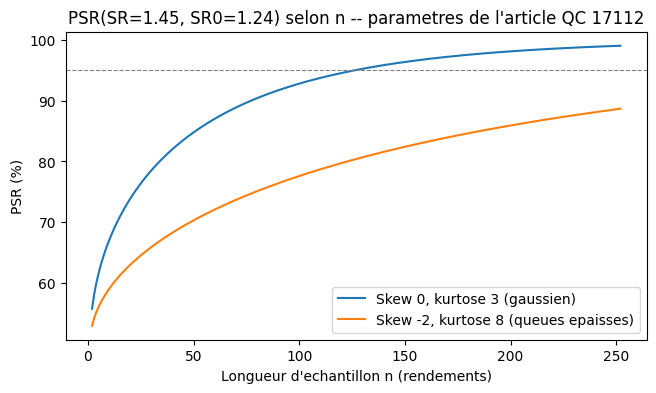
Seconde leçon durable de l’article : son étude de sensibilité. À écart Sharpe/benchmark constant, le PSR monte avec la longueur d’échantillon n et avec l’asymétrie positive, et descend avec la kurtose. Reproduisons la courbe PSR vs n avec les paramètres de l’article (SR observé 1,45, benchmark 1,24) — en notant que l’article les saisit à une échelle annualisée dans sa propre formule par-période, une troisième entorse à son principe de non-annualisation ; la forme de la courbe reste la leçon.
n_range = np.arange(2, 253)psr_norm = [psr_periodique(1.45, int(n), skew=0.0, kurt=3.0, sr0_p=1.24) for n in n_range]psr_gras = [psr_periodique(1.45, int(n), skew=-2.0, kurt=8.0, sr0_p=1.24) for n in n_range]fig, ax = plt.subplots(figsize=(7.5, 4))ax.plot(n_range, np.array(psr_norm) *100, label="Skew 0, kurtose 3 (gaussien)")ax.plot(n_range, np.array(psr_gras) *100, label="Skew -2, kurtose 8 (queues epaisses)")ax.axhline(95, color="gray", ls="--", lw=0.8)ax.set_xlabel("Longueur d'echantillon n (rendements)")ax.set_ylabel("PSR (%)")ax.set_title("PSR(SR=1.45, SR0=1.24) selon n -- parametres de l'article QC 17112")ax.legend()plt.show()for n in (25, 50, 100, 252):print(f"n={n:3d} : gaussien {psr_norm[n-2]*100:5.1f} % | queues epaisses {psr_gras[n-2]*100:5.1f} %")
Lecture du résultat : peu de données, peu de certitude — et la kurtose retarde tout
Avec un écart constant au benchmark, il faut plus d’une centaine de rendements pour que la version gaussienne dépasse 95 % ; la version à queues épaisses n’y arrive pas dans la fenêtre. La kurtose retarde la convergence autant que l’asymétrie la pénalise. Conclusion pratique : un PSR ne se lit jamais sans la profondeur d’échantillon qui l’a produit — un PSR de 90 % sur 30 rendements et un PSR de 90 % sur 2 000 rendements ne disent pas la même chose.
4. Le surapprentissage par balayage de paramètres
Un piège classique : on teste plusieurs variantes d’une stratégie, on garde la meilleure, et on publie son Sharpe. Mais le maximum de plusieurs tirages bruités est… encore du bruit, amplifié. Plus on balaye, plus on est quasi-certain de trouver un Sharpe élevé par hasard.
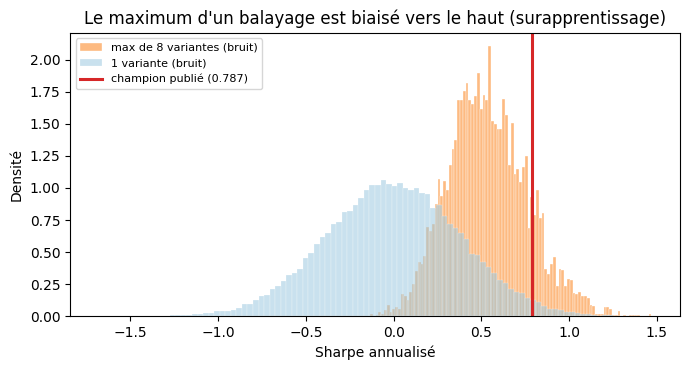
Cas réel (EPIC #9768) : la stratégie CSharp-BTC-MACD-ADX affichait un Sharpe catalogue de 0,787. Le forensic a révélé que ce nombre était le maximum d’un balayage à 8 variantes, dont les paramètres gagnants n’avaient jamais été réécrits dans le code (le code committé valait 0,225 le même jour). Simulons la probabilité d’observer un tel “champion” sous pur bruit.
best_reported =0.787n_variants =8n_years =7.0n_days =int(n_years *252)# Distribution du Sharpe sous H0 (meme simulation qu'avant, reutilisee conceptuellement)rets = rng.standard_normal((N_SIM, n_days)) *0.01sharpe_noise = rets.mean(axis=1) / rets.std(axis=1, ddof=1) * np.sqrt(252)# Pour chaque "experience", on tire n_variants Sharpe de bruit et on garde le maxn_experiences = N_SIM // n_variantssweeps = rng.choice(sharpe_noise, size=(n_experiences, n_variants), replace=True)max_per_sweep = sweeps.max(axis=1)p_champion = (max_per_sweep >= best_reported).mean()print(f"Balayage de {n_variants} variantes sous pur bruit, fenetre {n_years:.0f} ans.")print(f"P(max des {n_variants} variantes >= {best_reported}) = {p_champion*100:.1f} %")print(f"\nAutrement dit : '{p_champion*100:.0f} % du temps, un balayage de "f"{n_variants} variantes sans aucun bord produit un champion >= {best_reported}.'")print("\nLe Sharpe publie (0,787) n'etait PAS une preuve d'edge : ""c'etait le sommet attendu d'une chaine de tirages bruites.")fig, ax = plt.subplots(figsize=(7, 3.8))ax.hist(max_per_sweep, bins=100, density=True, color="#fdae6b", edgecolor="white", linewidth=0.3, alpha=0.85, label="max de 8 variantes (bruit)")ax.hist(sharpe_noise, bins=100, density=True, color="#9ecae1", edgecolor="white", linewidth=0.3, alpha=0.55, label="1 variante (bruit)")ax.axvline(best_reported, color="#d62728", lw=2.2, label=f"champion publié ({best_reported})")ax.set_xlabel("Sharpe annualisé")ax.set_ylabel("Densité")ax.set_title("Le maximum d'un balayage est biaisé vers le haut (surapprentissage)")ax.legend(fontsize=8)plt.tight_layout()plt.show()
Balayage de 8 variantes sous pur bruit, fenetre 7 ans.
P(max des 8 variantes >= 0.787) = 14.1 %

Autrement dit : '14 % du temps, un balayage de 8 variantes sans aucun bord produit un champion >= 0.787.'

Le Sharpe publie (0,787) n'etait PAS une preuve d'edge : c'etait le sommet attendu d'une chaine de tirages bruites.
Lecture du résultat : le champion publié est le sommet attendu d’un tirage bruité
L’histogramme orange — la distribution du maximum de 8 variantes sous pur bruit — est visiblement décalé vers la droite par rapport à la courbe bleue d’une variante unique : prendre le meilleur de plusieurs tirages biaise mécaniquement l’estimation vers le haut, sans qu’aucun avantage n’existe. Le trait rouge à 0,787 tombe dans la queue de cette distribution orange.
Le nombre en sortie le rend quantifié : P(max des 8 variantes ≥ 0,787) = 14,1 %. En clair, un balayage de 8 paramétrages sans le moindre bord produit un champion d’au moins 0,787 dans ~1 cas sur 7 — et le forensic de l’EPIC #9768 a établi que c’était précisément ce qui s’était passé (le code committé valait 0,225 le même jour). Un Sharpe publié sans preuve que c’est le code committé, et non le maximum d’un sweep, est un chiffre sans valeur de test.
5. La fenêtre ouverte : un nombre qui dérive chaque mois
Dernière source de dérive, identifiée par l’EPIC #9768 (axe D2) : beaucoup de backtests ne fixent pas de date de fin (SetEndDate). La fenêtre se termine donc “aujourd’hui” et s’allonge à chaque exécution. Le même code, rebactesté un mois plus tard, absorbe ~21 jours de bourse supplémentaires et rend un Sharpe différent — sans qu’aucune logique n’ait changé.
Ce n’est ni un bug ni une dégénérescence : c’est l’absorption passive de nouvelles données. Mais cela rend tout nombre publié périssable. Une lecture honnête doit toujours préciser la fenêtre.
Illustration : un Sharpe “stable” dans le code peut passer de 0,225 (avril) à 0,123 (août) simplement parce que 101 jours de marché se sont écoulés entre les deux mesures — MaxDD identique, ordres quasi identiques (50 → 52).
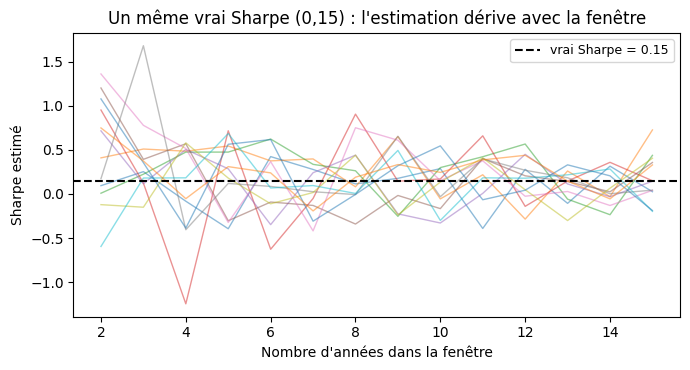
# Illustration : comment l'estimation du Sharpe "derive" quand la fenetre s'allonge,# meme pour une strategie dont le VRAI Sharpe est constant.true_sr =0.15# vrai Sharpe annuel (constant), supposehorizons = np.arange(2, 16) # anneesrng_demo = np.random.default_rng(7)fig, ax = plt.subplots(figsize=(7, 3.8))for trial inrange(12): srs = []for ny in horizons: nd =int(ny *252) r = rng_demo.standard_normal(nd) *0.01+ true_sr /252.0*0.01*252# moyenne ajustee# recalcule proprement: rendement moyen cible = true_sr/sqrt(252) * vol mu = true_sr / np.sqrt(252) *0.01 r = rng_demo.standard_normal(nd) *0.01+ mu srs.append(r.mean() / r.std(ddof=1) * np.sqrt(252)) ax.plot(horizons, srs, alpha=0.5, lw=1)ax.axhline(true_sr, color="k", ls="--", lw=1.5, label=f"vrai Sharpe = {true_sr}")ax.set_xlabel("Nombre d'années dans la fenêtre")ax.set_ylabel("Sharpe estimé")ax.set_title("Un même vrai Sharpe (0,15) : l'estimation dérive avec la fenêtre")ax.legend(fontsize=9)plt.tight_layout()plt.show()print("Sans SetEndDate, chaque execution re-measure sur une fenetre differente.")print("Le nombre change meme si la strategie, elle, est immuable.")
Sans SetEndDate, chaque execution re-measure sur une fenetre differente.
Le nombre change meme si la strategie, elle, est immuable.
Lecture du résultat : l’estimation converge, mais chaque fenêtre donne un nombre différent
Chacune des 12 courbes grises est une stratégie dont le vrai Sharpe est constant à 0,15 (la ligne en pointillés). Pourtant, aucune ne suit cette ligne : chacune dérive autour d’elle, et l’amplitude de la dérive se resserre à mesure que la fenêtre s’allonge (la précision croît en 1/sqrt(N)). Le même code, mesuré sur 2 ans puis sur 15 ans, produit des Sharpe estimés qui n’ont rien à voir — sans que la stratégie ait changé d’un iota.
C’est la mécanique derrière l’exemple de la section : un Sharpe « stable » qui passe de 0,225 (avril) à 0,123 (août) parce que 101 jours de marché se sont ajoutés entre les deux mesures. Deux lectures s’imposent : (1) toute publication de backtest doit préciser la fenêtre exacte (SetEndDate fixe ou fenêtre nommée) ; (2) un écart de mesure entre deux exécutions n’est pas un bug — c’est l’incertitude statistique de la section 1 qui s’exprime.
6. Synthèse — le cadre de verdict honnête
Un backtest n’est jamais une preuve d’avantage. Pour conclure honnêtement, croiser cinq questions :
Erreur-type : le Sharpe est-il à plus de ~2 écarts-types de zéro ? (Sinon : compatible avec le hasard.)
Distribution sous H0 : le Sharpe tombe-t-il dans la zone qu’occuperait le pur bruit ?
PSR : la probabilité de battre un vrai benchmark (pas le cash) est-elle > 95 % ?
Balayage : le Sharpe publié est-il celui du code committé, ou le maximum d’un sweep non reporté ?
Fenêtre : la date de fin est-elle fixée ? Le nombre est-il reproductible dans le temps ?
Les quatre stratégies de la motivation échouent à au moins trois de ces tests. D’où le verdict unanime NO-BEATS : rendre honnêtement un compte négatif est plus utile que de publier un Sharpe flatteur qui ne se reproduira pas en live.
La table ci-dessous récapitule les cinq tests appliqués aux quatre stratégies de la motivation (✓ = test satisfait, ✗ = test échoué, — = non évalué ici) :
Stratégie
CI exclut zéro ?
Hors bruit H0 ?
PSR benchmark > 95 % ?
Balayage vérifié ?
Fenêtre fixée ?
SectorRotation-Momentum
✗
✗
✗ (0,05 %)
—
—
MeanReversion-Sectors
✗
✗
✗ (0,05 %)
—
—
VolTargeting
✗
✗
✗ (0,56 %)
—
—
BlackLitterman-Momentum
✗
✗
✗ (1,99 %)
—
—
Les trois premières colonnes suffisent au verdict NO-BEATS : aucun intervalle ne sort de zéro, tous tombent dans la distribution du bruit, aucun PSR face au SPY n’approche 95 %. Les deux dernières colonnes (—) sont les conditions de reproductibilité à vérifier avant toute conclusion positive : une stratégie qui afficherait un bord devra prouver que son nombre vient du code committé et d’une fenêtre fixée.
Référence : Bailey, D. & López de Prado, M. (2012). The Sharpe Ratio Efficient Frontier. Journal of Risk, 15(2). — Lo, A. (2002). The Statistics of Sharpe Ratios. Financial Analysts Journal.
Exercices
Les quatre exercices suivants vous font manipuler les concepts ci-dessus. Complétez le code aux endroits marqués # TODO.
Exercice 1 — Seuil de signification
Combien d’années de données faut-il pour qu’un Sharpe mesuré de 0,5 soit significatif au seuil de 5 % (z > 1,96) ? Écrivez une fonction annees_pour_signification(sharpe, alpha=0.05) qui résout sharpe / (1/sqrt(N)) > z_{1-alpha/2} pour N.
# Indice : z_{1-alpha/2} = stats.norm.ppf(1 - alpha/2). On cherche N tel que# sharpe * sqrt(N) > z. Donc N > (z / sharpe)**2.def annees_pour_signification(sharpe, alpha=0.05):# TODO etudiant : retourner le nombre d'annees minimal (float) pour que le# Sharpe donne soit significatif au seuil alpha (test bilateral). result =None# TODO etudiantreturn result# Test : pour sharpe=0.5, alpha=0.05 -> environ 15.4 ansprint("Exercice a completer")
Exercice a completer
Exercice 2 — Effet du nombre de variantes balayées
Reprenez la simulation de la section 4. Pour un vrai Sharge de zéro et une fenêtre de 7 ans, tracez la probabilité que le champion d’un balayage dépasse 0,5, en fonction du nombre de variantes testées (de 1 à 50). Que conclure sur la pratique du “tester plein de paramètres et garder le meilleur” ?
# Indice : pour chaque k (nombre de variantes), tirer k Sharpe de bruit, prendre le max,# repeter sur N_SIM experiences, estimer P(max > 0.5). Tracer P vs k.def proba_champion_bruit(seuil, n_variants, n_years=7.0, n_sim=20000):# TODO etudiant : retourner P(max de n_variants tirages de bruit >= seuil). result =None# TODO etudiantreturn resultprint("Exercice a completer")
Exercice a completer
Exercice 3 — PSR et asymétrie des rendements
La formule du PSR dépend de l’asymétrie (skew) et du kurtosis des rendements. Une stratégie aux rendements très asymétriques (grosses pertes rares, petits gains fréquents — skew < 0) est-elle plus ou moins favorable au PSR qu’une stratégie gaussienne, à Sharpe égal ? Calculez le PSR(SR=0.5, N=10) pour skew valant 0, -1 et -2 (kurtosis croissant en conséquence), et interprétez.
# Indice : utiliser la fonction psr() definie plus haut. Pour une vraie distribution,# kurtosis augmente avec |skew| ; testez par exemple (skew=0, kurt=3),# (skew=-1, kurt=4), (skew=-2, kurt=7).def psr_vs_asymetrie(sharpe=0.5, n_years=10.0):# TODO etudiant : afficher le PSR pour les trois couples (skew, kurt) ci-dessus. result =None# TODO etudiantreturn resultprint("Exercice a completer")
Exercice a completer
Exercice 4 — Les quatre PSR d’un même backtest
Une stratégie backtestée sur 7 ans (1 764 rendements quotidiens) montre un Sharpe annualisé de 0,9, une asymétrie de −1,5 et une kurtose brute de 6. Calculez ses quatre PSR(SR₀ = 0) : saisie annualisée vs par-période, chacune en convention de kurtose brute puis excédentaire. Lesquels se ressemblent, lesquels s’écartent, et pourquoi ?
# Indice : SR par periode = 0.9 / sqrt(252) ; kurtose excedentaire = 6 - 3.# Utiliser psr() (saisie annualisee) et psr_periodique(), chacun avec kurt=6 puis kurt=3.def psr_quatre_variantes(sr_annuel=0.9, n_jours=1764, skew=-1.5, kurt_brute=6.0):# TODO etudiant : retourner le dict {'ann_brute': ..., 'ann_exces': ...,# 'per_brute': ..., 'per_exces': ...} (4 probabilites en 0-1). result =None# TODO etudiantreturn resultprint("Exercice a completer")