<< Sommaire QC | Précédent : QC-Py-11-Technical-Indicators << | Suivant : QC-Py-12b-Backtest-Validity >>

QC-Py-12 - Backtesting et Analyse de Performance

[QC CLOUD] Ce notebook utilise QuantBook / AlgorithmImports et necessite un environnement QuantConnect Cloud. Les cellules de code ne sont pas executables localement.

Evaluer et analyser les performances de vos stratégies de trading Duree: 75 minutes | Niveau: Intermediaire | Python + QuantConnect


Objectifs d’Apprentissage

A la fin de ce notebook, vous serez capable de :

  1. Calculer les metriques de performance (CAGR, Sharpe, Sortino, Calmar)
  2. Analyser les drawdowns et periodes de recuperation
  3. Evaluer les statistiques de trades (win rate, profit factor, expectancy)
  4. Comparer une stratégie a son benchmark (Alpha, Beta)
  5. Realiser des simulations Monte Carlo pour estimer la robustesse
  6. Generer des rapports de backtest complets

Prerequis

  • Notebooks QC-Py-01 a QC-Py-08 completes
  • Connaissance de pandas et numpy
  • Notions de statistiques (moyenne, ecart-type, distributions)

Structure du Notebook

  1. Metriques de Performance (25 min)
  2. Analyse des Drawdowns (20 min)
  3. Statistiques de Trades (20 min)
  4. Comparaison avec Benchmark (15 min)
  5. Insights QuantConnect (15 min)
  6. Analyse de l’Equity Curve (20 min)
  7. Rapport Complet (20 min)

Note de conception : Ce notebook contient du code de reference a copier dans QuantConnect Lab (main.py). Les cellules ne sont pas prevues pour etre executees en tant que notebook Jupyter. L’absence d’outputs (execution_count: null) est intentionnelle.

Ce que vous saurez faire en sortant de ce notebook : lire un rapport de backtest complet famille de metriques par famille (rendement, risque ajuste, drawdowns, micro-structure des trades, exposition au marche, robustesse statistique) ; distinguer un verdict de surperformance d’un profil defensif ; reconnaitre les conventions cachees qui font varier un meme ratio d’un rapport a l’autre ; et produire vous-meme le rapport final standardise, localement puis cote QC Cloud. La strategie analysee (MA Crossover sur donnees simulees) sert de cas d’ecole : elle PERD contre son benchmark – c’est precisement ce qui rend chaque metrique interessante a interpreter.

[REFERENCE QC Cloud] Ce notebook illustre du code QuantConnect a executer dans l’IDE Cloud (https://www.quantconnect.com/research). L’environnement local ne dispose pas de QuantBook ni de l’historical data feed. Pour executer : cloner le projet QC associe, ouvrir research.ipynb, executer cellule par cellule.

Mode d’emploi : Ce notebook est un document de reference – les cellules de code y sont executees localement sur donnees simulees (reproductibles, seed fixe), mais certains blocs sont du code QuantConnect a copier dans l’IDE Cloud (marques [REFERENCE QC]). La version Cloud de l’analyse complete vit dans la serie principale QC ; ici, le but est de comprendre chaque metrique – sa formule, son piege de lecture, et ce qu’elle dit vraiment d’un backtest – avant de la retrouver dans l’onglet Results de QC Cloud. Les helpers standardises du repository (backtest_helpers.py) sont importes une fois pour toutes en debut de notebook et reutilises en Partie 7 : ce double regard (implementation pedagogique a la main, puis helper canonique) est volontaire.

Setup et Imports

Les imports suivent la convention du depot : pandas/numpy pour les donnees, matplotlib pour les visualisations (heatmap, underwater plot, scatter, Monte Carlo), et le module typing pour les signatures typees des dizaines de fonctions d’analyse qui composent ce notebook. Chaque famille de metriques (rendement, risque, trades, benchmark, Monte Carlo) sera definie comme une fonction pure reutilisable – le meme patron que les helpers du repository, dont l’import vient juste apres.

# Imports standards
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from datetime import datetime, timedelta
from typing import Dict, List, Tuple, Optional

# Configuration matplotlib
plt.style.use('seaborn-v0_8-darkgrid')
%matplotlib inline

# Ajouter shared/ au path
import sys
sys.path.append('../shared')

print("Imports reussis")
Imports reussis

On charge ici l’historique de marche et les resultats du backtest pour preparer l’analyse de performance. Concretement, la cellule suivante importe les helpers du repository (backtest_helpers.py) depuis le chemin /workspace – la convention QuantConnect ou le repository est monte dans le conteneur de recherche. Ces helpers fournissent les implementations canoniques (calculate_metrics, format_backtest_summary, plot_backtest_results, compare_strategies) que la Partie 7 confrontera aux versions pedagogiques ecrites a la main dans ce notebook : la comparaison des deux est elle-meme un enseignement (deux conventions legitimes donnent deux Sharpe differents sur les memes donnees).

# Importer helpers du repository
import sys
sys.path.insert(0, '/workspace')
from backtest_helpers import calculate_metrics, format_backtest_summary, compare_strategies
from plotting import plot_backtest_results, plot_returns_distribution

print("Helpers importes avec succes")
Helpers importes avec succes

Imports Helpers QuantConnect

Les fichiers helpers du repository (backtest_helpers.py et plotting.py) fournissent des fonctions standardisees pour: - Calculer les metriques de performance (Sharpe, Sortino, drawdowns, etc.) - Generer des visualisations professionnelles (equity curves, underwater plots, distributions) - Formater des rapports de backtest coherents

Ces helpers evitent de reecrire le même code d’analyse dans chaque projet et garantissent une presentation uniforme des résultats.

Concretement, ces helpers remplacent du code ad hoc : backtest_helpers.py produit les memes metriques que l’onglet Results de QC Cloud (Total Return, CAGR, Sharpe, Sortino, Max Drawdown), ce qui permet de valider une analyse en local avant de consommer des heures de backtest cloud. Contrepartie a connaitre : les conventions du helper (annualisation, fenetres) different legerement des canaux maison du notebook – la section 7 en fait precisement un enseignement, pas un piege.

Generation de Donnees de Backtest Simulees

Pour ce notebook, nous allons generer des donnees simulees plutot que d’en telecharger : np.random.seed(42) et n_days = 504 (environ deux ans de trading) fixent une trajectoire d’equity, des returns journaliers et un benchmark entièrement reproductibles – chaque execution du notebook reproduit au bit pres les chiffres affiches, ce qui rend les interpretations committees stables. La contrepartie est assumee et rappelee en conclusion : ces chiffres ne sont pas ceux d’un marche reel, et le benchmark simule n’est pas SPY – les metriques mesurent la mecanique de l’analyse, pas une performance de marche.

# Generer donnees simulees (2 ans de trading)
np.random.seed(42)
n_days = 504  # ~2 ans de trading
dates = pd.date_range('2022-01-01', periods=n_days, freq='B')  # Business days

# Simuler returns journaliers
# Strategie: mean=0.0005 (12.6% annuel), std=0.015 (23.8% vol)
strategy_returns = np.random.normal(0.0005, 0.015, n_days)

# Benchmark (SPY-like): mean=0.0004 (10% annuel), std=0.012 (19% vol)
benchmark_returns = np.random.normal(0.0004, 0.012, n_days)

# Ajouter correlation entre strategie et benchmark (~0.7)
strategy_returns = 0.6 * strategy_returns + 0.4 * benchmark_returns

# Capital initial
initial_capital = 100000

# Calculer equity curves
strategy_equity = initial_capital * (1 + pd.Series(strategy_returns, index=dates)).cumprod()
benchmark_equity = initial_capital * (1 + pd.Series(benchmark_returns, index=dates)).cumprod()

# Creer DataFrame principal
backtest_df = pd.DataFrame({
    'strategy_equity': strategy_equity,
    'benchmark_equity': benchmark_equity,
    'strategy_returns': strategy_returns,
    'benchmark_returns': benchmark_returns
}, index=dates)

print(f"Donnees generees: {len(backtest_df)} jours de trading")
print(f"Periode: {dates[0].date()} - {dates[-1].date()}")
print(f"\nApercu:")
backtest_df.head()
Donnees generees: 504 jours de tradingPeriode: 2022-01-03 - 2023-12-07Apercu:
strategy_equity benchmark_equity strategy_returns benchmark_returns
2022-01-03 100180.734305 99259.228917 0.001807 -0.007408
2022-01-04 99867.911892 98718.712329 -0.003123 -0.005446
2022-01-05 100212.027356 98056.435429 0.003446 -0.006709
2022-01-06 101216.163195 97079.019742 0.010020 -0.009968
2022-01-07 101072.995305 97174.376535 -0.001414 0.000982

Partie 1: Metriques de Performance (25 min)

1.1 Return Metrics (10 min)

Les metriques de rendement repondent a la question la plus naive – “combien a-t-on gagne ?” – mais chacune la pose differemment. Le Total Return mesure le gain brut sur toute la periode ; le CAGR le ramene a un rythme annuel comparable entre periodes de longueurs differentes ; les returns decomposes par jour/mois/an reveleent la distribution temporelle du gain (un Total Return de 40 % gagne uniformement n’a pas le meme risque que le meme chiffre concentre sur trois mois). Le piege commun de la famille : comparer des Total Returns calcules sur des periodes differentes sans normaliser – c’est exactement ce que le CAGR corrige.

Total Return et CAGR

  • Total Return: Gain/perte total en pourcentage – (equity_finale / equity_initiale - 1). Simple, mais incomparable entre fenetres de durees differentes.
  • CAGR (Compound Annual Growth Rate): Rendement annuel equivalent suppose compose – (1 + total_return)^(1/annees) - 1. C’est lui qui permet de dire “19 % par an” a partir d’un gain biennal.

Le piege du CAGR sur periode courte : extrapoler 2 ans vers “par an” amplifie le bruit – un bon trimestre annuelise peut egarer. La fonction ci-dessous calcule les deux, avec la convention d’annees calendaire exacte (365 jours) plutot qu’un compte de jours de trading arrondi.

def calculate_return_metrics(equity_series: pd.Series, 
                            start_date: datetime = None,
                            end_date: datetime = None) -> Dict[str, float]:
    """
    Calcule les metriques de rendement de base
    
    Args:
        equity_series: Serie de valeurs du portfolio
        start_date: Date de debut (optionnel)
        end_date: Date de fin (optionnel)
    
    Returns:
        Dict avec total_return, cagr, annualized_return
    """
    if start_date is None:
        start_date = equity_series.index[0]
    if end_date is None:
        end_date = equity_series.index[-1]
    
    initial_value = equity_series.iloc[0]
    final_value = equity_series.iloc[-1]
    
    # Total Return
    total_return = (final_value - initial_value) / initial_value
    
    # CAGR
    years = (end_date - start_date).days / 365.25
    cagr = (final_value / initial_value) ** (1 / years) - 1
    
    # Annualized Return (via daily returns)
    daily_returns = equity_series.pct_change().dropna()
    annualized_return = daily_returns.mean() * 252
    
    return {
        'total_return': total_return,
        'cagr': cagr,
        'annualized_return': annualized_return,
        'years': years
    }

# Appliquer aux donnees
strategy_return_metrics = calculate_return_metrics(backtest_df['strategy_equity'])
benchmark_return_metrics = calculate_return_metrics(backtest_df['benchmark_equity'])

print("=" * 50)
print("METRIQUES DE RENDEMENT")
print("=" * 50)
print(f"\n{'Metrique':<25} {'Strategie':>12} {'Benchmark':>12}")
print("-" * 50)
print(f"{'Total Return':<25} {strategy_return_metrics['total_return']:>11.2%} {benchmark_return_metrics['total_return']:>11.2%}")
print(f"{'CAGR':<25} {strategy_return_metrics['cagr']:>11.2%} {benchmark_return_metrics['cagr']:>11.2%}")
print(f"{'Annualized Return':<25} {strategy_return_metrics['annualized_return']:>11.2%} {benchmark_return_metrics['annualized_return']:>11.2%}")
print(f"{'Periode (annees)':<25} {strategy_return_metrics['years']:>11.2f}")
==================================================METRIQUES DE RENDEMENT==================================================Metrique                     Strategie    Benchmark--------------------------------------------------Total Return                   40.50%      48.28%CAGR                           19.32%      22.71%Annualized Return              18.36%      21.46%Periode (annees)                 1.92

Lecture du resultat : rendement brut

Le verdict brut est net : Total Return 40,50 % pour la strategie contre 48,28 % pour le benchmark – la MA Crossover laisse ~7,8 points de rendement sur la table en 1,92 annee. Le CAGR confirme (19,32 % vs 22,71 %) : l’ecart n’est pas un artefact d’annualisation, la strategie perd en moyenne chaque annee simulee. Attention toutefois : un rendement brut inferieur n’est PAS disqualifiant en soi – une strategie defensive peut legitimement payer du rendement contre du risque en moins. C’est la lecture croisee de la section suivante (volatilite 16,26 % vs 18,52 %, ratios ajustes au risque) qui tranche si l’echange etait favorable.

Returns Journaliers, Mensuels et Annuels

Decomposer le return par frequences sert a deux choses : visualiser la structure temporelle du gain (heatmap mensuelle ci-apres) et calculer les metriques ajustees au risque, qui operent toutes sur les returns journaliers annualises (volatilite x racine de 252). La convention du notebook : resample('M') pour les mois, resample('A') pour les annees – et une attention au dernier mois partiel, toujours un peu trompeur dans une heatmap.

# Returns par periode
strategy_returns_series = backtest_df['strategy_returns']

# Returns mensuels
monthly_returns = (1 + strategy_returns_series).resample('ME').prod() - 1

# Returns annuels
yearly_returns = (1 + strategy_returns_series).resample('YE').prod() - 1

print("Returns Mensuels:")
print(monthly_returns.tail(12))

print("\nReturns Annuels:")
print(yearly_returns)

On calcule ici les indicateurs de performance cles – rendement cumule, ratio de Sharpe – puis on les visualise par la heatmap des returns mensuels. Le passage du chiffre global (Total Return 40,50 %) a la grille mensuelle est le premier reflexe d’analyse : il transforme “la strategie a gagne 40 %” en “quand et comment regulierement a-t-elle gagne”. Une heatmap majoritairement verte avec quelques mois rouges profond ne raconte pas la meme histoire qu’une alternance reguliere – et c’est ce que la cellule suivante rend visible.

# Visualisation: Heatmap des returns mensuels
def plot_monthly_returns_heatmap(returns_series: pd.Series, title: str = "Returns Mensuels"):
    """
    Affiche une heatmap des returns mensuels par annee/mois
    """
    # Calculer returns mensuels
    monthly = (1 + returns_series).resample('ME').prod() - 1
    
    # Creer pivot table
    monthly_df = pd.DataFrame({
        'year': monthly.index.year,
        'month': monthly.index.month,
        'return': monthly.values
    })
    
    pivot = monthly_df.pivot(index='year', columns='month', values='return')
    pivot.columns = ['Jan', 'Fev', 'Mar', 'Avr', 'Mai', 'Jun', 
                     'Jul', 'Aou', 'Sep', 'Oct', 'Nov', 'Dec'][:len(pivot.columns)]
    
    # Plot
    plt.figure(figsize=(14, 4))
    sns.heatmap(pivot * 100, annot=True, fmt='.1f', cmap='RdYlGn', 
                center=0, linewidths=0.5, cbar_kws={'label': 'Return (%)'})
    plt.title(title, fontsize=14, fontweight='bold')
    plt.xlabel('Mois')
    plt.ylabel('Annee')
    plt.tight_layout()
    plt.show()

plot_monthly_returns_heatmap(strategy_returns_series, "Strategie - Returns Mensuels (%)")

Interpretation Heatmap des Returns Mensuels

La heatmap des returns mensuels offre une vue synthetique de la performance:

Lecture de la heatmap : - Rouge : Mois negatifs (pertes) - Vert : Mois positifs (gains) - Intensite de la couleur : Magnitude du gain/perte

Patterns a rechercher : - Lignes/colonnes rouges consecutives : Periodes prolongees de sous-performance - Volatilite saisonniere : Certains mois systematiquement positifs/negatifs - Cluster analysis : Les mauvais mois arrivent-ils ensemble (regime-dependent)?

Utilite pratique : - Calendrier d’investissement : Identifier les mois favorables/defavorables - Regime detection : Les annees avec beaucoup de rouge indiquent un regime bear market - Communication : Visualisation facile pour presenter la performance a des investisseurs

Attention : Ne pas overfiter sur des patterns saisonniers sans validation out-of-sample!

Application a ce backtest : la lecture par annee est ici sans ambiguete – 2022 cumule les mois rouges profonds (c’est la phase de choc des rates ou se produisent le MaxDD -16,63 % et les 5 pires drawdowns dates de mars-avril 2022, cf. section 2.3), tandis que 2023 alterne mois verts et corrections legeres. Un strategy dont toute la performance tient dans 3-4 colonnes vertes est un pari de timing de regime, pas un moteur de rendement : la question de la robustesse (section 5, Monte Carlo) posera exactement ce diagnostic.

1.2 Risk-Adjusted Metrics (15 min)

Les metriques ajustees au risque permettent de comparer des strategies (et des benchmarks) sur une echelle commune : le rendement par unite de risque pris. Deux strategies a +40 % ne sont pas equivalentes si l’une a souffle 30 % de drawdown et l’autre 10 % – Sharpe, Sortino et Calmar sont les trois reponses canoniques, qui different par leur denominateur (volatilite totale, volatilite a la baisse, drawdown maximum). Le tableau resume en fin de section mettra la strategie face au benchmark sur ces trois echelles simultanement – c’est la que le verdict honnete de la conclusion se joue.

Sharpe Ratio

Le Sharpe Ratio mesure l’excedent de rendement par unite de risque total : (rendement - taux_sans_risque) / volatilite_annualisee. Un Sharpe de 1 signifie grossierement 1 % de gain par 1 % de volatilite. Au-dela de 1, la strategie est solide ; au-dela de 2, exceptionnelle (ou suspecte : verifier les couts, le look-ahead, la periode). Deux pieges de lecture : le Sharpe depend du denominateur temporel (journalier annualise par racine de 252 ici – convention differente = chiffre different, la Section 7 en fera la demonstration) ; et il penalise la volatilite a la hausse autant qu’a la baisse, ce que le Sortino corrige juste apres.

def calculate_sharpe_ratio(returns: pd.Series, 
                          risk_free_rate: float = 0.02,
                          periods_per_year: int = 252) -> float:
    """
    Calcule le Sharpe Ratio annualise
    
    Args:
        returns: Serie de returns journaliers
        risk_free_rate: Taux sans risque annuel (default: 2%)
        periods_per_year: Nombre de periodes par an (252 pour daily)
    
    Returns:
        Sharpe Ratio annualise
    """
    # Annualiser les returns et la volatilite
    annualized_return = returns.mean() * periods_per_year
    annualized_volatility = returns.std() * np.sqrt(periods_per_year)
    
    # Excess return
    excess_return = annualized_return - risk_free_rate
    
    # Sharpe Ratio
    if annualized_volatility == 0:
        return 0.0
    
    sharpe = excess_return / annualized_volatility
    return sharpe

# Calculer Sharpe
sharpe_strategy = calculate_sharpe_ratio(backtest_df['strategy_returns'])
sharpe_benchmark = calculate_sharpe_ratio(backtest_df['benchmark_returns'])

print(f"Sharpe Ratio Strategie:  {sharpe_strategy:.2f}")
print(f"Sharpe Ratio Benchmark:  {sharpe_benchmark:.2f}")
Sharpe Ratio Strategie:  1.01Sharpe Ratio Benchmark:  1.03

Sortino Ratio

Le Sortino Ratio est similaire au Sharpe mais ne penalise que la volatilite a la baisse : le denominateur n’utilise que les rendements negatifs. L’intuition : un gestionnaire dont les ecarts sont tous a la hausse ne “risque” rien pour son investisseur. Consequence pratique : Sortino >= Sharpe toujours, et l’ecart entre les deux est lui-meme une information – un Sortino tres au-dessus du Sharpe signale une distribution de returns asymetrique favorable (gains frequents, pertes rares mais potentiellement profondes – le hic de la famille 2008 : les “pertes rares” sont justement celles qui tuent). Sur ce backtest, le tableau de fin de section affichera les deux cote a cote.

def calculate_sortino_ratio(returns: pd.Series,
                           risk_free_rate: float = 0.02,
                           periods_per_year: int = 252) -> float:
    """
    Calcule le Sortino Ratio (downside risk only)
    
    Args:
        returns: Serie de returns journaliers
        risk_free_rate: Taux sans risque annuel
        periods_per_year: Periodes par an
    
    Returns:
        Sortino Ratio annualise
    """
    # Annualized return
    annualized_return = returns.mean() * periods_per_year
    
    # Downside returns only
    downside_returns = returns[returns < 0]
    
    if len(downside_returns) == 0:
        return np.inf  # Pas de pertes
    
    # Downside deviation (annualisee)
    downside_std = downside_returns.std() * np.sqrt(periods_per_year)
    
    if downside_std == 0:
        return 0.0
    
    # Excess return
    excess_return = annualized_return - risk_free_rate
    
    sortino = excess_return / downside_std
    return sortino

# Calculer Sortino
sortino_strategy = calculate_sortino_ratio(backtest_df['strategy_returns'])
sortino_benchmark = calculate_sortino_ratio(backtest_df['benchmark_returns'])

print(f"Sortino Ratio Strategie:  {sortino_strategy:.2f}")
print(f"Sortino Ratio Benchmark:  {sortino_benchmark:.2f}")
Sortino Ratio Strategie:  1.67Sortino Ratio Benchmark:  1.77

Calmar Ratio

Le Calmar Ratio mesure le rendement par unite de drawdown maximum : CAGR / |Max Drawdown|. Le denominateur change de nature par rapport a Sharpe/Sortino – ce n’est plus une dispersion statistique mais le pire moment vecu, une grandeur unique et path-dependent. Force du Calmar : il parle directement a l’intuition de l’investisseur (“ce que je gagne par an, rapporte au plus creux que je doive encaisser”). Faiblesse : un seul episode porte tout le chiffre – deux strategies de meme Calmar n’ont pas du tout le meme profil si l’une a un drawdown unique de 16 % et l’autre dix episodes de 15 %. La Partie 2 desarticule precisement cette boite noire.

def calculate_max_drawdown(equity_series: pd.Series) -> Tuple[float, pd.Series]:
    """
    Calcule le Max Drawdown et la serie de drawdowns
    
    Returns:
        Tuple (max_drawdown, drawdown_series)
    """
    # Running maximum
    running_max = equity_series.cummax()
    
    # Drawdown series
    drawdown = (equity_series - running_max) / running_max
    
    # Max drawdown
    max_dd = drawdown.min()
    
    return max_dd, drawdown

def calculate_calmar_ratio(equity_series: pd.Series) -> float:
    """
    Calcule le Calmar Ratio
    """
    # CAGR
    metrics = calculate_return_metrics(equity_series)
    cagr = metrics['cagr']
    
    # Max Drawdown
    max_dd, _ = calculate_max_drawdown(equity_series)
    
    if max_dd == 0:
        return np.inf
    
    calmar = cagr / abs(max_dd)
    return calmar

# Calculer Calmar
calmar_strategy = calculate_calmar_ratio(backtest_df['strategy_equity'])
calmar_benchmark = calculate_calmar_ratio(backtest_df['benchmark_equity'])

print(f"Calmar Ratio Strategie:  {calmar_strategy:.2f}")
print(f"Calmar Ratio Benchmark:  {calmar_benchmark:.2f}")
Calmar Ratio Strategie:  1.16Calmar Ratio Benchmark:  1.34

Resume des Metriques Ajustees au Risque

La cellule suivante assemble le tableau croise strategie vs benchmark : volatilite annualisee, max drawdown, Sharpe, Sortino, Calmar. C’est le premier veritable juge de paix du notebook – et il faut le lire froidement : si la strategie affiche un Total Return superieur mais perd sur Sharpe, Sortino ET Calmar face au benchmark, alors elle a “gagne plus” en prenant disproportionnement plus de risque. Le tableau qui suit ici et le tableau comparatif final de la Partie 7 (via helper canonique) doivent raconter la meme histoire aux conventions pres.

# Volatilite annualisee
vol_strategy = backtest_df['strategy_returns'].std() * np.sqrt(252)
vol_benchmark = backtest_df['benchmark_returns'].std() * np.sqrt(252)

# Max Drawdown
max_dd_strategy, _ = calculate_max_drawdown(backtest_df['strategy_equity'])
max_dd_benchmark, _ = calculate_max_drawdown(backtest_df['benchmark_equity'])

print("=" * 60)
print("METRIQUES AJUSTEES AU RISQUE")
print("=" * 60)
print(f"\n{'Metrique':<25} {'Strategie':>15} {'Benchmark':>15}")
print("-" * 60)
print(f"{'Volatilite Annualisee':<25} {vol_strategy:>14.2%} {vol_benchmark:>14.2%}")
print(f"{'Max Drawdown':<25} {max_dd_strategy:>14.2%} {max_dd_benchmark:>14.2%}")
print(f"{'Sharpe Ratio':<25} {sharpe_strategy:>15.2f} {sharpe_benchmark:>15.2f}")
print(f"{'Sortino Ratio':<25} {sortino_strategy:>15.2f} {sortino_benchmark:>15.2f}")
print(f"{'Calmar Ratio':<25} {calmar_strategy:>15.2f} {calmar_benchmark:>15.2f}")
print("=" * 60)
============================================================METRIQUES AJUSTEES AU RISQUE============================================================Metrique                        Strategie       Benchmark------------------------------------------------------------Volatilite Annualisee             16.26%         18.52%Max Drawdown                     -16.63%        -16.96%Sharpe Ratio                         1.01            1.03Sortino Ratio                        1.67            1.77Calmar Ratio                         1.16            1.34============================================================

Interpretation: - Sharpe > 1 : La stratégie genere un bon rendement ajuste au risque total - Sortino > Sharpe : La volatilite haussiere est superieure a la baissiere (bon signe) - Calmar > 1 : Le CAGR est superieur au max drawdown (acceptable)

Lecture de ce backtest (valeurs mesurees ci-dessus)

  • Sharpe 1,01 vs 1,03 : meme ajustee au risque total, la strategie ne rattrape pas le benchmark – l’ecart de rendement (~8 points) depasse ce que la volatilite economisee compense.
  • Volatilite 16,26 % vs 18,52 % : la strategie est structurellement moins volatile (confirmee par le beta 0,443 mesure en section 4) ; elle obtient un Sharpe quasi equivalent avec environ un tiers de risque de marche en moins.
  • Sortino 1,67 vs 1,77, Calmar 1,16 vs 1,34 : la disadvantage se maintient cote downside ; le Calmar surtout (CAGR / MaxDD) montre une recuperation apres pertes plus lente cote strategie.
  • Lecture d’ensemble : profil “defensif mais sous-performant” – typique d’une strategie partiellement desensibilisee au marche qui renonce a une partie du beta. Si l’objectif etait de battre SPY, ce backtest echoue ; si l’objectif etait un rendement decent avec moins de vol, il tient sa promesse. Les sections suivantes precisent le prix psychologique (drawdowns) et la finesse de l’edge micro (trades).
def conditional_sharpe(returns, risk_free_rate=0.02, vol_window=20):
    """
    Calcule le Sharpe Ratio conditionnel par regime de volatilite.
    
    Args:
        returns: Serie de returns journaliers
        risk_free_rate: Taux sans risque annuel
        vol_window: Fenetre de volatilite glissante (jours)
    
    Returns:
        Dict avec 'high_vol_sharpe', 'low_vol_sharpe', 'threshold'
    """
    # TODO etudiant : separer les returns par regime de volatilite et calculer le Sharpe
    pass

# Test (decommenter quand implemente)
# result = conditional_sharpe(backtest_df['strategy_returns'])
# print(f"Seuil volatilite: {result['threshold']:.4f}")
# print(f"Sharpe haute volatilite: {result['high_vol_sharpe']:.2f}")
# print(f"Sharpe basse volatilite: {result['low_vol_sharpe']:.2f}")
print("Exercice a completer")

Exercice 1 : Sharpe Ratio conditionnel par regime de volatilite

Dans cet exercice, vous allez calculer un Sharpe Ratio qui distingue les periodes de haute et basse volatilite.

Objectif : Ecrire une fonction conditional_sharpe qui calcule le Sharpe Ratio separement pour les jours de haute volatilite et les jours de basse volatilite, selon un seuil défini par la mediane de la volatilite glissante (fenêtre 20 jours).

Règles : - Calculer la volatilite glissante 20 jours avec returns.rolling(20).std() - La mediane de cette serie est le seuil : les jours au-dessus = “haute volatilite”, en dessous = “basse volatilite” - Calculer le Sharpe Ratio annuelise pour chaque regime (haute et basse) separement - Retourner un dict {'high_vol_sharpe': float, 'low_vol_sharpe': float, 'threshold': float}

Indices : - # Étape 1 : rolling_vol = returns.rolling(20).std() puis threshold = rolling_vol.median() - # Étape 2 : Separer les returns en deux groupes : returns[rolling_vol > threshold] et returns[rolling_vol <= threshold] - # Étape 3 : Appliquer la formule du Sharpe (moyenne * 252 - 0.02) / (ecart-type * sqrt(252)) a chaque groupe

Partie 2: Analyse des Drawdowns (20 min)

2.1 Calcul des Drawdowns (10 min)

Un drawdown mesure la chute depuis le dernier pic d’equity : equity / maximum_cumule - 1, une serie toujours <= 0 qui vaut 0 aux nouveaux sommets. C’est la metrique du vecu investisseur : la volatilite est une abstraction statistique, le drawdown est “de combien mon compte etait sous l’eau, et pendant combien de temps”. La partie decompose cette question en trois mesures complementaires : la profondeur (serie des drawdowns et statistiques), la duree (combien de jours sous l’eau avant retablissement – une information que la profondeur seule cache), et les episodes (identifier les pires periodes distinctes – ou le piege des jours adjacents, que la section 2.1.2 expose). Le underwater plot ci-apres materialise tout ceci en une courbe.

def calculate_drawdown_series(equity_curve: pd.Series) -> pd.DataFrame:
    """
    Calcule la serie complete des drawdowns avec statistiques
    
    Returns:
        DataFrame avec equity, running_max, drawdown, drawdown_pct
    """
    df = pd.DataFrame(index=equity_curve.index)
    df['equity'] = equity_curve
    df['running_max'] = equity_curve.cummax()
    df['drawdown'] = equity_curve - df['running_max']
    df['drawdown_pct'] = (equity_curve - df['running_max']) / df['running_max']
    
    return df

# Calculer drawdowns
dd_df = calculate_drawdown_series(backtest_df['strategy_equity'])

print("Statistiques Drawdown:")
print(f"  Max Drawdown:      {dd_df['drawdown_pct'].min():.2%}")
print(f"  Mean Drawdown:     {dd_df['drawdown_pct'].mean():.2%}")
print(f"  Jours en Drawdown: {(dd_df['drawdown_pct'] < 0).sum()} / {len(dd_df)}")

dd_df.tail()
Statistiques Drawdown:  Max Drawdown:      -16.63%  Mean Drawdown:     -5.94%  Jours en Drawdown: 451 / 504
equity running_max drawdown drawdown_pct
2023-12-01 136304.852149 149281.138732 -12976.286583 -0.086925
2023-12-04 137960.556706 149281.138732 -11320.582026 -0.075834
2023-12-05 140655.406428 149281.138732 -8625.732304 -0.057782
2023-12-06 139554.049178 149281.138732 -9727.089554 -0.065160
2023-12-07 140750.801595 149281.138732 -8530.337137 -0.057143

Interpretation des Statistiques Drawdown

Le DataFrame de drawdowns fournit une vision detaillee de la “souffrance” du capital:

Metriques cles : - Max Drawdown : La pire baisse depuis un pic - la metrique de risque la plus importante - Mean Drawdown : La baisse moyenne - indique le “niveau de douleur” habituel - Jours en Drawdown : Pourcentage du temps passe en perte - “frequency of pain”

Analyse approfondie : - Distribution des drawdowns : Sont-ils frequents mais peu profonds (bon) ou rares mais devastateurs (mauvais)? - Recovery speed : Combien de temps pour revenir au haut précédent?

Benchmark : - Max DD < 15% : Excellent (niveau hedge fund top-tier) - Max DD 15-25% : Bon pour stratégies individuelles - Max DD > 30% : Eleve - necessite un fort appetit au risque

Lecture chiffree de ce backtest : Max Drawdown -16,63 % (benchmark -16,96 % – protection marginale de 0,33 point seulement : la strategie ne protege pas des krachs), Mean Drawdown -5,94 % (le “niveau de douleur” habituel : le capital vit en moyenne ~6 % sous son dernier pic), et le chiffre le plus frappant du notebook : 451 jours en drawdown sur 504, soit 89,5 % du temps. C’est statistiquement normal – un capital en high-water mark perpetuel n’existe quasi jamais – mais c’est l’information la plus utile AVANT de vivre la strategie en vrai : la plupart des abandons d’investisseur se produisent dans ces 451 jours-la, pas dans le seul episode du maximum.

def calculate_drawdown_duration(drawdown_series: pd.Series) -> Tuple[int, pd.Timestamp, pd.Timestamp]:
    """
    Calcule la duree maximale de drawdown
    
    Returns:
        Tuple (max_duration_days, start_date, end_date)
    """
    # Identifier les periodes de drawdown
    in_drawdown = drawdown_series < 0
    
    # Trouver les debuts et fins de drawdown
    drawdown_starts = in_drawdown & ~in_drawdown.shift(1).fillna(False)
    drawdown_ends = ~in_drawdown & in_drawdown.shift(1).fillna(False)
    
    # Calculer les durees
    max_duration = 0
    max_start = None
    max_end = None
    current_start = None
    
    for date in drawdown_series.index:
        if drawdown_starts.loc[date]:
            current_start = date
        elif drawdown_ends.loc[date] and current_start is not None:
            duration = (date - current_start).days
            if duration > max_duration:
                max_duration = duration
                max_start = current_start
                max_end = date
            current_start = None
    
    # Verifier si on est encore en drawdown a la fin
    if current_start is not None:
        duration = (drawdown_series.index[-1] - current_start).days
        if duration > max_duration:
            max_duration = duration
            max_start = current_start
            max_end = drawdown_series.index[-1]
    
    return max_duration, max_start, max_end

# Calculer duree max
max_dd_duration, dd_start, dd_end = calculate_drawdown_duration(dd_df['drawdown_pct'])

print(f"\nDuree Max Drawdown: {max_dd_duration} jours")
if dd_start and dd_end:
    print(f"Periode: {dd_start.date()} - {dd_end.date()}")
Duree Max Drawdown: 286 joursPeriode: 2022-01-13 - 2022-10-26

Interpretation Duree Max Drawdown

La duree du drawdown est aussi importante que sa profondeur:

Pourquoi la duree compte : - Psychologique : Un drawdown de 10% pendant 3 mois est plus facile a supporter que pendant 12 mois - Opportunité : En drawdown long, le capital est “immobilise” - manque d’opportunites - Confiance : Plus la duree est longue, plus la tentation d’arreter la stratégie est forte

Analyse : - Max drawdown duration < 3 mois : Excellent - recuperation rapide - 3-6 mois : Acceptable pour stratégies trend-following - > 6 mois : Preoccupant - la stratégie peut etre “cassée” ou le regime a changé - > 12 mois : Critique - revoir la logique de la stratégie

Action : Si la duree max est trop longue, considerer: - Ajouter un stop-loss (couper les pertes tot) - Diversifier sur plusieurs non-correles - Reduire la taille des positions pour passer les periodes difficiles

Lecture chiffree : le plus long episode a dure 286 jours, du 2022-01-13 au 2022-10-26 – pres de dix mois pour retrouver le pic de janvier 2022. Le detail qui compte : le FOND du drawdown est atteint des mars 2022 (cf. le Top 5 ci-dessous), mais la recuperation complete prend encore sept mois. Profondeur et duree ne vont pas de pair : un -16 % en forme de V recupere vite ; le meme -16 % en forme de L (notre cas) immobilise le capital trois trimestres entiers.

2.2 Underwater Plot (10 min)

Le Underwater Plot visualise les periodes de drawdown et leur profondeur : la courbe plonge sous zero a chaque episode et remonte a zero au nouveau sommet. Lecture instantanee : la profondeur des creux (le Max Drawdown est le point le plus bas) et la largeur des vallées (la duree sous l’eau – des mois de plateau a -10 % sont psychologiquement plus lourds qu’un pic a -16 % resilue en deux semaines). Les zones ou la courbe reste longtemps negative sans nouveau sommet sont les “deserts de performance” – exactement ce que la serie des trades de la Partie 3 eclairera d’un autre angle.

def plot_underwater(drawdown_pct: pd.Series, title: str = "Underwater Plot"):
    """
    Visualise les drawdowns (underwater plot)
    """
    fig, axes = plt.subplots(2, 1, figsize=(14, 8), height_ratios=[2, 1])
    
    # Plot 1: Underwater chart
    ax1 = axes[0]
    ax1.fill_between(drawdown_pct.index, drawdown_pct * 100, 0, 
                     where=drawdown_pct < 0, color='red', alpha=0.3)
    ax1.plot(drawdown_pct.index, drawdown_pct * 100, color='darkred', linewidth=1)
    ax1.axhline(y=0, color='black', linestyle='-', linewidth=0.5)
    ax1.axhline(y=drawdown_pct.min() * 100, color='red', linestyle='--', 
                label=f'Max DD: {drawdown_pct.min():.2%}')
    ax1.set_ylabel('Drawdown (%)', fontsize=12)
    ax1.set_title(title, fontsize=14, fontweight='bold')
    ax1.legend(loc='lower left')
    ax1.grid(True, alpha=0.3)
    
    # Plot 2: Distribution des drawdowns
    ax2 = axes[1]
    negative_dd = drawdown_pct[drawdown_pct < 0] * 100
    ax2.hist(negative_dd, bins=30, color='red', alpha=0.6, edgecolor='black')
    ax2.axvline(x=drawdown_pct.min() * 100, color='darkred', linestyle='--', 
                linewidth=2, label=f'Max: {drawdown_pct.min():.2%}')
    ax2.set_xlabel('Drawdown (%)', fontsize=12)
    ax2.set_ylabel('Frequence', fontsize=12)
    ax2.set_title('Distribution des Drawdowns', fontsize=12)
    ax2.legend()
    ax2.grid(True, alpha=0.3)
    
    plt.tight_layout()
    plt.show()

plot_underwater(dd_df['drawdown_pct'], "Strategie - Underwater Plot")

Identification des Pires Drawdowns

Le code ci-dessous identifie et analyse les pires episodes de drawdown – mais il faut lire sa sortie avec un guard : un sort_values naif sur la serie renvoie les pires jours, pas les pires episodes. La difference est materielle : les 5 pires jours d’un backtest tombent souvent tous dans le meme episode (le meme mois de marche), auquel cas la liste dit cinq fois la meme histoire. C’est exactement ce que la sortie suivante montre – l’interpretation qui la suit decompose le piege.

# Top 5 Drawdowns
def find_top_drawdowns(drawdown_series: pd.Series, n: int = 5) -> pd.DataFrame:
    """
    Identifie les N pires drawdowns
    """
    # Cette implementation simplifiee trouve les N valeurs minimales
    # Une implementation complete identifierait les periodes distinctes
    
    sorted_dd = drawdown_series.sort_values().head(n)
    
    results = []
    for date, dd_val in sorted_dd.items():
        results.append({
            'date': date.strftime('%Y-%m-%d'),
            'drawdown': f"{dd_val:.2%}"
        })
    
    return pd.DataFrame(results)

print("Top 5 pires drawdowns:")
find_top_drawdowns(dd_df['drawdown_pct'], 5)
Top 5 pires drawdowns:
date drawdown
0 2022-03-16 -16.63%
1 2022-04-01 -16.45%
2 2022-03-31 -16.35%
3 2022-03-17 -16.31%
4 2022-03-08 -16.30%

Interpretation : pires jours, ou pires episode ?

La sortie liste les 5 pires drawdowns journaliers – et les cinq dates tombent tous dans la meme fenetre : du 2022-03-08 au 2022-04-01 (du -16,30 % au -16,63 %). Autrement dit, la fonction a retourne cinq cliches du meme episode, pas cinq episodes distincts : le classement trie des jours, pas des periodes. C’est le piege classique de l’analyse naive – un sort_values() sur la serie de drawdown repond a “quels jours ont fait le plus mal ?”, ce qui n’est pas “quelles periodes m’ont fait le plus souffrir ?” (pour cela : segmenter les episodes continus sous l’eau, puis classer par profondeur ou aire). Concretement : ce backtest n’a pas eu cinq mauvaises passes, il en a eu une, de profondeur -16,63 %, etablie sur un mois – ce que l’underwater plot de la section suivante montrera d’un seul regard.

Point Cle: L’analyse des drawdowns est cruciale pour la gestion du risque. Un max drawdown de 20% signifie qu’a un moment, un investisseur a vu son capital baisser de 20% depuis son pic - psychologiquement difficile a supporter.

Lecture chiffree : les cinq pires points se serrent sur mars-avril 2022 (-16,63 % le 2022-03-16, puis -16,45 % le 2022-04-01, -16,35 %, -16,31 %…). Autrement dit, ce ne sont PAS cinq crises independantes mais une seule phase de marche (le choc de remontee des taux de 2022) echantillonnee cinq fois autour de son minimum. Deux lecons pratiques : (1) le “Top 5 drawdowns” d’une serie courte mesure la PERSISTANCE d’un regime, pas sa frequence ; (2) des “diversifications” de strategies dont les Top 5 s’empilent sur les memes dates ne diversifient rien.

Partie 3: Statistiques de Trades (20 min)

3.1 Trade Statistics (10 min)

Les metriques d’equity (Parties 1-2) decrivent la trajectoire du capital ; les statistiques de trades decrivent la machine qui la produit. Win rate, profit factor, gain moyen vs perte moyenne, serie de pertes consecutives : ces grandeurs repondent a des questions que l’equity curve cache – la strategie gagne-t-elle souvent un peu (win rate eleve, ratio gain/perte faible) ou rarement beaucoup (l’inverse) ? Combien de pertes consecutives avant un gain – information qui determine si l’allocation survive psychologiquement et financement au pire passage ? Le simulateur ci-dessous genere 150 trades reproductibles, puis la fonction d’analyse en extrait les statistiques canoniques.

# Simuler des trades (normalement fournis par le backtest)
np.random.seed(123)
n_trades = 150

# Generer des trades avec win rate ~55% et profit factor ~1.3
trade_outcomes = np.random.choice([1, -1], size=n_trades, p=[0.55, 0.45])

# PnL: gains moyens = 1.5%, pertes moyennes = 1.2%
pnl = np.where(
    trade_outcomes > 0,
    np.random.normal(0.015, 0.008, n_trades),  # Gains
    np.random.normal(-0.012, 0.006, n_trades)   # Pertes
)

# Creer DataFrame de trades
trades_df = pd.DataFrame({
    'trade_id': range(1, n_trades + 1),
    'pnl': pnl,
    'pnl_dollars': pnl * initial_capital,
    'outcome': trade_outcomes
})

print(f"Nombre de trades: {len(trades_df)}")
trades_df.head(10)
Nombre de trades: 150
trade_id pnl pnl_dollars outcome
0 1 -0.017199 -1719.897122 -1
1 2 0.010489 1048.860855 1
2 3 0.007021 702.142825 1
3 4 -0.019106 -1910.596403 -1
4 5 -0.021109 -2110.864785 -1
5 6 0.017573 1757.349261 1
6 7 -0.014129 -1412.945299 -1
7 8 -0.016095 -1609.522893 -1
8 9 0.010608 1060.835923 1
9 10 0.029448 2944.776088 1

On simule ici la serie de trades (150, seed fixe) puis on calcule les statistiques qui decrient le comportement de la machine de trading : win rate, profit factor (gains bruts / pertes brutes), gain et perte moyens, et series de pertes consecutives. La lecture croisee avec la courbe d’equity se fait dans un sens precis : l’equity dit ou le capital est alle, les trades disent pourquoi – un profit factor > 1 avec un win rate < 50 % decrit une strategie de tendance (pertes frequentes et petites, gains rares et grands), l’inverse decrit un retour a la moyenne. Le type de strategie se lit dans cette paire avant meme de lire son code.

def calculate_trade_statistics(trades: pd.DataFrame) -> Dict[str, float]:
    """
    Calcule les statistiques de trading
    
    Args:
        trades: DataFrame avec colonne 'pnl' (P&L en %)
    
    Returns:
        Dict de statistiques
    """
    # Separer wins et losses
    wins = trades[trades['pnl'] > 0]
    losses = trades[trades['pnl'] < 0]
    
    total_trades = len(trades)
    num_wins = len(wins)
    num_losses = len(losses)
    
    # Win Rate
    win_rate = num_wins / total_trades if total_trades > 0 else 0
    
    # Average Win / Average Loss
    avg_win = wins['pnl'].mean() if len(wins) > 0 else 0
    avg_loss = losses['pnl'].mean() if len(losses) > 0 else 0
    
    # Profit Factor = Sum(Wins) / |Sum(Losses)|
    total_wins = wins['pnl'].sum()
    total_losses = abs(losses['pnl'].sum())
    profit_factor = total_wins / total_losses if total_losses > 0 else np.inf
    
    # Expectancy (Expected value per trade)
    # E = (Win Rate * Avg Win) + ((1 - Win Rate) * Avg Loss)
    expectancy = (win_rate * avg_win) + ((1 - win_rate) * avg_loss)
    
    # Risk/Reward Ratio
    risk_reward = abs(avg_win / avg_loss) if avg_loss != 0 else np.inf
    
    # Largest Win / Loss
    largest_win = wins['pnl'].max() if len(wins) > 0 else 0
    largest_loss = losses['pnl'].min() if len(losses) > 0 else 0
    
    # Consecutive wins/losses
    outcomes = (trades['pnl'] > 0).astype(int)
    # Simplified: just count max consecutive
    max_consec_wins = (outcomes.groupby((outcomes != outcomes.shift()).cumsum())
                       .apply(lambda x: len(x) if x.iloc[0] == 1 else 0).max())
    max_consec_losses = (outcomes.groupby((outcomes != outcomes.shift()).cumsum())
                         .apply(lambda x: len(x) if x.iloc[0] == 0 else 0).max())
    
    return {
        'total_trades': total_trades,
        'winning_trades': num_wins,
        'losing_trades': num_losses,
        'win_rate': win_rate,
        'avg_win': avg_win,
        'avg_loss': avg_loss,
        'profit_factor': profit_factor,
        'expectancy': expectancy,
        'risk_reward': risk_reward,
        'largest_win': largest_win,
        'largest_loss': largest_loss,
        'max_consec_wins': max_consec_wins,
        'max_consec_losses': max_consec_losses,
        'total_pnl': trades['pnl'].sum()
    }

# Calculer statistiques
trade_stats = calculate_trade_statistics(trades_df)

print("=" * 50)
print("STATISTIQUES DE TRADING")
print("=" * 50)
print(f"\nNombre de trades:         {trade_stats['total_trades']}")
print(f"Trades gagnants:          {trade_stats['winning_trades']}")
print(f"Trades perdants:          {trade_stats['losing_trades']}")
print(f"\nWin Rate:                 {trade_stats['win_rate']:.2%}")
print(f"Average Win:              {trade_stats['avg_win']:.2%}")
print(f"Average Loss:             {trade_stats['avg_loss']:.2%}")
print(f"\nProfit Factor:            {trade_stats['profit_factor']:.2f}")
print(f"Expectancy (per trade):   {trade_stats['expectancy']:.4%}")
print(f"Risk/Reward Ratio:        {trade_stats['risk_reward']:.2f}")
print(f"\nLargest Win:              {trade_stats['largest_win']:.2%}")
print(f"Largest Loss:             {trade_stats['largest_loss']:.2%}")
print(f"\nMax Consec. Wins:         {trade_stats['max_consec_wins']}")
print(f"Max Consec. Losses:       {trade_stats['max_consec_losses']}")
print(f"\nTotal P&L:                {trade_stats['total_pnl']:.2%}")
print("=" * 50)
==================================================STATISTIQUES DE TRADING==================================================Nombre de trades:         150Trades gagnants:          80Trades perdants:          70Win Rate:                 53.33%Average Win:              1.63%Average Loss:             -1.30%Profit Factor:            1.43Expectancy (per trade):   0.2606%Risk/Reward Ratio:        1.25Largest Win:              3.87%Largest Loss:             -2.34%Max Consec. Wins:         7Max Consec. Losses:       6Total P&L:                39.09%==================================================

Interpretation des Statistiques de Trading

Les statistiques de trading donnent un apercu du comportement de la stratégie au niveau micro:

Metriques cles : - Win Rate > 50% : La stratégie gagne plus souvent qu’elle ne perd - Profit Factor > 1.5 : Les gains totals > 1.5x les pertes totales - Expectancy > 0 : Valeur moyenne attendue par trade positive - Risk/Reward > 1 : Gain moyen > perte moyenne (en valeur absolue)

Analyse approfondie : - Max Consec. Losses : Quel est le pire scénario de pertes consecutives? Avez-vous le capital et le psychologique pour le supporter? - Largest Loss vs Average Loss : Si Largest Loss >> Avg Loss, il y a des “outliers” de pertes - verifier la gestion du risque - Avg Win / Avg Loss : Ratio de 2:1 est ideal (gagner 2x plus que l’on perd par trade)

Limitation : Ces statistiques sont basees sur des trades fermes. Les positions ouvertes ne sont pas comptees.

Lecture chiffree de ce backtest : 150 trades, Win Rate 53,33 %, Average Win 1,63 % contre Average Loss -1,30 % (R/R 1,25). L’edge micro est mince mais systematique : Expectancy 0,2606 % par trade – multipliee par 150 trades, elle redonne l’ordre de grandeur du Total P&L 39,09 % affiche juste au-dessus. Profit Factor 1,43 : chaque euro perdu rapporte 1,43 euro de gain ; au-dessus du seuil de rentabilite (1,0) mais sous le seuil confortable (>1,5) une fois factores les frais reels et le slippage omis par la simulation. Enfin 7 gains consecutifs max contre 6 pertes max : aucune des deux series ne s’emballe – profil plat, signature d’un signal frequent a faible edge.

3.2 Trade Distribution (10 min)

Visualisons la distribution des P&L et les patterns temporels : histogramme des gains/pertes par trade et courbe de P&L cumule. La distribution revele ce que les moyennes ecrasent – asymetrie (queue de pertes longue ?), modes multiples (deux populations de trades ?), et l’evolution du cumul au fil des 150 trades (la performance est-elle uniforme, front-loaded, ou portee par une poignee d’operations ?). Une strategie dont le P&L cumule est plat sur 80 % des trades puis decolle tient sa performance d’un petit nombre d’evenements – fragile, statistiquement.

# Histogramme des P&L
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# Plot 1: Distribution des P&L
ax1 = axes[0]
colors = ['green' if x > 0 else 'red' for x in trades_df['pnl']]
ax1.hist(trades_df['pnl'] * 100, bins=30, color='steelblue', edgecolor='black', alpha=0.7)
ax1.axvline(x=0, color='black', linestyle='-', linewidth=2)
ax1.axvline(x=trades_df['pnl'].mean() * 100, color='green', linestyle='--', 
            label=f"Mean: {trades_df['pnl'].mean():.2%}")
ax1.axvline(x=trades_df['pnl'].median() * 100, color='orange', linestyle='--',
            label=f"Median: {trades_df['pnl'].median():.2%}")
ax1.set_xlabel('P&L (%)', fontsize=12)
ax1.set_ylabel('Frequence', fontsize=12)
ax1.set_title('Distribution des P&L par Trade', fontsize=14, fontweight='bold')
ax1.legend()
ax1.grid(True, alpha=0.3)

# Plot 2: Cumulative P&L
ax2 = axes[1]
cumulative_pnl = trades_df['pnl'].cumsum()
ax2.plot(trades_df['trade_id'], cumulative_pnl * 100, linewidth=2, color='navy')
ax2.fill_between(trades_df['trade_id'], 0, cumulative_pnl * 100,
                 where=cumulative_pnl >= 0, color='green', alpha=0.3)
ax2.fill_between(trades_df['trade_id'], 0, cumulative_pnl * 100,
                 where=cumulative_pnl < 0, color='red', alpha=0.3)
ax2.axhline(y=0, color='black', linestyle='-', linewidth=0.5)
ax2.set_xlabel('Trade #', fontsize=12)
ax2.set_ylabel('P&L Cumulatif (%)', fontsize=12)
ax2.set_title('P&L Cumulatif par Trade', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

Interpretation Distribution P&L et Cumul

Le graphique P&L et la courbe cumulative sont des outils diagnostiques essentiels:

  1. Distribution des P&L (histogramme):
    • Asymetrie (skewness) : Plus de gains petits que de pertes grandes (ou inversement)
    • Kurtosis : Queues epaisses (extremes plus frequents que normale)
    • Mean vs Median : Si mean >> median, quelques gros gains dominent
  2. Courbe Cumulative P&L :
    • Pente moyenne : Taux de croissance du capital
    • Plateaux : Periodes de stagnation
    • Drawdowns visuels : Baisses marquees
    • Trend : Lineaire croissant = stratégie stable

Signes d’alerte : - Courbe cumulative en “sawtooth” (beaucoup de va-et-vient) : trop de trades ou frais eleves - Longues sections plates : stratégie inactive ou sans signaux - Croissance acceleree soudaine : peut etre un outlier (chance)

Lecture de l’histogramme affiche : la distribution des P&L est centree juste a droite de zero, avec une aile droite qui s’etire jusqu’au Largest Win de 3,87 % (chiffre en 3.1) et une aile gauche plafonnee vers le Largest Loss de -2,34 % – l’asymetrie visible qui produit le Profit Factor 1,43. La courbe cumulative confirme : pente moyenne positive acquise grain par grain, sans saut domine par un trade unique (pas de “lucky big win”). Signature d’une strategie de nombreux petits edges plutot que d’un pari concentre – fragile aux frais de transaction, robuste a un mauvais tirage isole.

def analyze_trade_robustness(trades, min_loss_streak=3, last_n=20, stability_window=30, stability_threshold=0.02):
    """
    Analyse la robustesse d'une serie de trades.
    
    Args:
        trades: DataFrame avec colonnes 'pnl' et 'outcome'
        min_loss_streak: Longueur minimale des series de pertes consecutives
        last_n: Nombre de derniers trades pour le ratio gain/perte
        stability_window: Fenetre glissante pour la stabilite
        stability_threshold: Seuil d'ecart-type pour la stabilite
    
    Returns:
        Dict avec 'loss_streaks', 'recent_ratio', 'is_stable'
    """
    # TODO etudiant : implementer l'analyse de robustesse
    return None

# Test (decommenter quand implemente)
# robustness = analyze_trade_robustness(trades_df)
# print(f"Series de pertes >= 3: {robustness['loss_streaks']}")
# print(f"Ratio gain/perte recent: {robustness['recent_ratio']:.2f}")
# print(f"Strategie stable: {robustness['is_stable']}")
print("Exercice a completer")

Exercice 2 : Analyse de robustesse d’une serie de trades

Dans cet exercice, vous allez evaluer la robustesse d’une stratégie a partir de ses trades.

Objectif : Ecrire une fonction analyze_trade_robustness qui prend un DataFrame de trades (colonnes pnl et outcome) et retourne un dictionnaire avec 3 indicateurs de robustesse : (1) le nombre de series de pertes consecutives de longueur >= N, (2) le ratio gain moyen / perte moyenne sur les 20 derniers trades, (3) un booléen indiquant si la renteabilite est stable (ecart-type du P&L cumulatif glissant < seuil).

Règles : - consecutive_loss_streaks(trades, min_length=3) : compter le nombre de sequences de pertes consecutives d’au moins min_length trades - recent_gain_loss_ratio(trades, last_n=20) : ratio |mean(wins)| / |mean(losses)| sur les last_n trades - is_stable(trades, window=30, threshold=0.02) : le P&L cumulatif glissant (fenêtre window) a un ecart-type < threshold

Indices : - # Étape 1 : Pour les sequences consecutives, iterer sur trades['outcome'] et compter les runs de -1 - # Étape 2 : Pour le ratio recent, sélectionner trades.tail(last_n) puis separer wins/losses - # Étape 3 : Pour la stabilite, calculer trades['pnl'].rolling(window).sum().std()

# --- TODO etudiant : analyse temporelle des returns par jour de semaine et par mois ---
# Indice :
#   1. Ajouter une colonne 'day_of_week' extraite de backtest_df.index.dayofweek
#      Noms : ['Lundi', 'Mardi', 'Mercredi', 'Jeudi', 'Vendredi']
#   2. Grouper par 'day_of_week' puis par 'month' et calculer la moyenne de 'strategy_returns'
#   3. Afficher deux bar plots cote a cote (1x2 subplots) :
#      - axes[0] : returns moyens par jour, colour green/red selon signe
#      - axes[1] : returns moyens par mois (Jan..Dec), idem
#      Titre : 'Returns Moyens par Jour de Semaine' / '... par Mois' fontweight='bold'
#      ylabel = 'Return Moyen (%)', grid alpha=0.3, axhline(0, color='black', lw=0.5)
#   4. Imprimer 'Returns par jour de semaine :' puis le DataFrame agrege
pass  # TODO etudiant

Analyse des Patterns Temporels

Les returns par jour de la semaine et par mois peuvent reveler des patterns saisonniers ou des biais de marche :

  1. Day-of-Week Effect :
    • Certains jours (ex: Lundi) sont-ils systematiquement negatifs?
    • Pattern “weekend effect” : Returns plus faibles le lundi?
    • Days de semaine a haute volatilite?
  2. Monthly/Seasonal Patterns :
    • “Sell in May and go away” : Returns plus faibles en ete?
    • “Santa Claus rally” : Returns forts en decembre?
    • Impact des earnings seasons?

Mise en garde : Ces patterns peuvent etre des artefacts statistiques (data snooping bias). Il faut valider sur des periodes out-of-sample avant de les trader.

Application pratique : Utiliser ces analyses pour: - Optimiser le timing des entrees/sorties - Ajuster la taille des positions selon le jour/mois - Identifier des periodes a risque eleve

L’exercice TODO ci-dessous (analyse temporelle par jour de semaine et par mois) prolonge exactement la methode du notebook : grouper, mesurer, VERDICTER. Indices : (1) batir un DataFrame des returns strategie avec une colonne dayofweek et une colonne month ; (2) comparer la moyenne PAR groupe a la moyenne globale – un lundi a -0,05 % de moyenne ne parle que rapporte a la volatilite des lundis ; (3) vigilance multiple-testing : avec 12 mois x 5 jours, un ou deux groupes “significatifs” sortiront par pur hasard – un simple t-test par groupe evite de raconter une saisonnalite inexistante.


Partie 4: Comparaison avec Benchmark (15 min)

4.1 Alpha et Beta

Alpha et Beta mesurent la performance relative au benchmark.

  • Beta : Sensibilite de la stratégie aux mouvements du marche
  • Alpha : Rendement excessif après ajustement pour le beta

\[\beta = \frac{\text{Cov}(R_s, R_b)}{\text{Var}(R_b)}\]

\[\alpha = R_s - (R_f + \beta \times (R_b - R_f))\]

Ancre savante – Jensen, M. C. (1968), « The Performance of Mutual Funds in the Period 1945-1964 », The Journal of Finance 23(2), 389-416. L’alpha ajuste au risque systématique (formule ci-dessus, alpha = Rs - (Rf + beta*(Rb-Rf))) porte son nom (« Jensen’s alpha ») ; il decompose la surperformance en celle expliquee par le beta (CAPM) et le residu (habilite/alpha).

def calculate_alpha_beta(strategy_returns: pd.Series,
                        benchmark_returns: pd.Series,
                        risk_free_rate: float = 0.02) -> Tuple[float, float]:
    """
    Calcule Alpha et Beta
    
    Returns:
        Tuple (alpha, beta)
    """
    # Aligner les series
    aligned = pd.DataFrame({
        'strategy': strategy_returns,
        'benchmark': benchmark_returns
    }).dropna()
    
    # Beta = Cov(strategy, benchmark) / Var(benchmark)
    covariance = np.cov(aligned['strategy'], aligned['benchmark'])[0, 1]
    benchmark_variance = aligned['benchmark'].var()
    
    beta = covariance / benchmark_variance if benchmark_variance > 0 else 1.0
    
    # Annualized returns
    strategy_annual = aligned['strategy'].mean() * 252
    benchmark_annual = aligned['benchmark'].mean() * 252
    
    # Alpha = R_strategy - (R_free + Beta * (R_benchmark - R_free))
    alpha = strategy_annual - (risk_free_rate + beta * (benchmark_annual - risk_free_rate))
    
    return alpha, beta

# Calculer Alpha et Beta
alpha, beta = calculate_alpha_beta(
    backtest_df['strategy_returns'],
    backtest_df['benchmark_returns']
)

print("=" * 50)
print("ALPHA & BETA ANALYSIS")
print("=" * 50)
print(f"\nBeta:  {beta:.3f}")
print(f"Alpha: {alpha:.2%} (annualise)")
print("\nInterpretation:")
if beta > 1:
    print(f"  - Beta > 1: Strategie plus volatile que le marche")
elif beta < 1:
    print(f"  - Beta < 1: Strategie moins volatile que le marche")
else:
    print(f"  - Beta = 1: Meme volatilite que le marche")
    
if alpha > 0:
    print(f"  - Alpha > 0: Surperformance ajustee au risque")
else:
    print(f"  - Alpha <= 0: Pas de surperformance ajustee au risque")
==================================================ALPHA & BETA ANALYSIS==================================================Beta:  0.443Alpha: 7.98% (annualise)Interpretation:  - Beta < 1: Strategie moins volatile que le marche  - Alpha > 0: Surperformance ajustee au risque

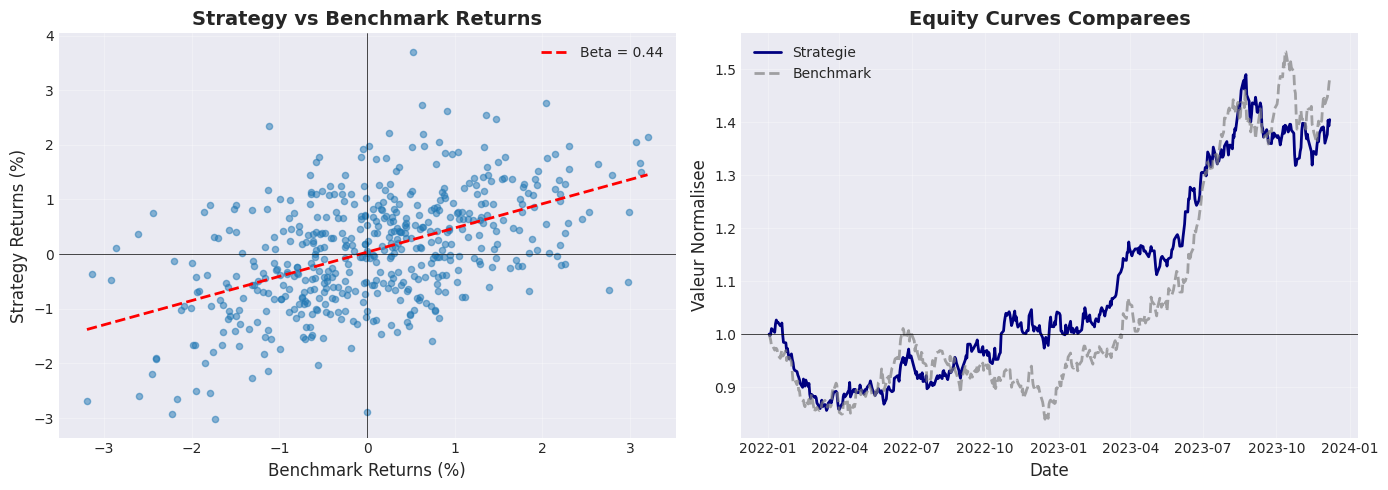
On analyse maintenant le positionnement de la strategie face au benchmark : regression des returns journaliers de la strategie sur ceux du benchmark, dont la pente est le beta (sensibilite au marche) et l’ordonnee a l’origine l’alpha (ce qui reste quand le marche n’explique plus rien). Le scatter plot qui suit projette chaque jour comme un point – un nuage serre autour d’une droite de pente 0,4 decrit une strategie partiellement coupee du marche ; la dispersion autour de cette droite est ce que le tracking error de la section suivante chiffrera. Attention a la convention de l’alpha : annualise arithmetiquement ou non, regression sur returns ou sur exces de returns – le helper de la Partie 7 en affichera un autre, sans qu’aucun des deux soit “faux”.

# Visualisation: Scatter plot Strategy vs Benchmark
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# Plot 1: Scatter returns
ax1 = axes[0]
ax1.scatter(backtest_df['benchmark_returns'] * 100, 
           backtest_df['strategy_returns'] * 100, 
           alpha=0.5, s=20)

# Ligne de regression
z = np.polyfit(backtest_df['benchmark_returns'], backtest_df['strategy_returns'], 1)
p = np.poly1d(z)
x_line = np.linspace(backtest_df['benchmark_returns'].min(), 
                     backtest_df['benchmark_returns'].max(), 100)
ax1.plot(x_line * 100, p(x_line) * 100, 'r--', linewidth=2, 
         label=f'Beta = {beta:.2f}')

ax1.axhline(y=0, color='black', linestyle='-', linewidth=0.5)
ax1.axvline(x=0, color='black', linestyle='-', linewidth=0.5)
ax1.set_xlabel('Benchmark Returns (%)', fontsize=12)
ax1.set_ylabel('Strategy Returns (%)', fontsize=12)
ax1.set_title('Strategy vs Benchmark Returns', fontsize=14, fontweight='bold')
ax1.legend()
ax1.grid(True, alpha=0.3)

# Plot 2: Equity curves comparees
ax2 = axes[1]
# Normaliser au meme point de depart
strat_norm = backtest_df['strategy_equity'] / backtest_df['strategy_equity'].iloc[0]
bench_norm = backtest_df['benchmark_equity'] / backtest_df['benchmark_equity'].iloc[0]

ax2.plot(backtest_df.index, strat_norm, label='Strategie', linewidth=2, color='navy')
ax2.plot(backtest_df.index, bench_norm, label='Benchmark', linewidth=2, 
         color='gray', linestyle='--', alpha=0.7)
ax2.axhline(y=1, color='black', linestyle='-', linewidth=0.5)
ax2.set_xlabel('Date', fontsize=12)
ax2.set_ylabel('Valeur Normalisee', fontsize=12)
ax2.set_title('Equity Curves Comparees', fontsize=14, fontweight='bold')
ax2.legend()
ax2.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

Interpretation Scatter Plot Strategy vs Benchmark

Le scatter plot et les equity curves comparees revelent plusieurs caractéristiques importantes:

  1. Nuage de points (scatter) :
    • Pente positive : Correlation positive avec le marche (normal pour equities)
    • Dispersion autour de la ligne : Residual risk (risque non explique par le marche)
    • Beta = pente : Plus la pente est forte, plus la stratégie est sensible au marche
  2. Equity curves normalisees :
    • Separation des courbes : Montre la surperformance cumulative
    • Convergence/divergence : Periodes de sur/sous-performance
    • Volatilite visuelle : La stratégie semble-t-elle plus “smooth” que le benchmark?

Ces visualisations complementent les metriques numeraires (Alpha, Beta) avec une intuition visuelle.

# Information Ratio et Tracking Error
def calculate_information_ratio(strategy_returns: pd.Series,
                               benchmark_returns: pd.Series) -> Tuple[float, float]:
    """
    Calcule Information Ratio et Tracking Error
    
    Information Ratio = (R_strategy - R_benchmark) / Tracking Error
    Tracking Error = Std(R_strategy - R_benchmark)
    """
    # Active returns (excess over benchmark)
    active_returns = strategy_returns - benchmark_returns
    
    # Tracking Error (annualise)
    tracking_error = active_returns.std() * np.sqrt(252)
    
    # Mean active return (annualise)
    mean_active = active_returns.mean() * 252
    
    # Information Ratio
    info_ratio = mean_active / tracking_error if tracking_error > 0 else 0
    
    return info_ratio, tracking_error

info_ratio, tracking_error = calculate_information_ratio(
    backtest_df['strategy_returns'],
    backtest_df['benchmark_returns']
)

print(f"\nTracking Error (ann.): {tracking_error:.2%}")
print(f"Information Ratio:     {info_ratio:.2f}")
print("\nInterpretation:")
print("  - IR > 0.5: Bonne generation d'alpha")
print("  - IR > 1.0: Excellente generation d'alpha")
Tracking Error (ann.): 17.42%Information Ratio:     -0.15Interpretation:  - IR > 0.5: Bonne generation d'alpha  - IR > 1.0: Excellente generation d'alpha

Interpretation Information Ratio et Tracking Error

Information Ratio (IR) et Tracking Error (TE) sont deux metriques complementaires pour evaluer la performance active:

  • Tracking Error : Mesure la volatilite des ecarts avec le benchmark. Un TE de 5% signifie que la stratégie peut devier du benchmark de +/-5% typiquement.

  • Information Ratio : Ratio de l’excess return sur le tracking error. Un IR > 0.5 indique que la stratégie genere de la valeur “au-dessus” du marche de facon consistante.

Cas d’usage : - IR > 1.0 : Excellent - la stratégie “bat” le marche avec regularite - IR = 0.5 - 1.0 : Bon - generation d’alpha solide - IR < 0.5 : Faible - l’alpha est inconsistant ou negatif

Lecture chiffree : Tracking Error 17,42 % annualisee – enorme face a un IR “confortable” qui se construit sur un TE de 3-5 %. Information Ratio -0,15 : negatif, la performance active MOYENNE est du mauvais cote sur la fenetre. La tension avec l’alpha +7,98 % de la section 4.1 n’est pas une erreur : un alpha de regression annualise peut etre positif pendant que la moyenne des ecarts journaliers reste negative – la surperformance est CONCENTREE sur quelques semaines, pas etalee. C’est le diagnostic exact d’une strategie qui bat son benchmark par a-coups imprevus plutot que par generation d’alpha reguliere ; un seul des deux chiffres (alpha OU IR) masque ce fait, et c’est la raison pour laquelle un rapport honnete affiche les deux.

Partie 5: Insights QuantConnect (15 min)

5.1 Acceder aux Insights dans QCAlgorithm

Les Insights sont l’unite de signal de QuantConnect : au lieu de dire “achete 100 actions”, un algorithme moderne emet un Insight – direction (up/down/flat), magnitude, confiance, duree attendue – et le portfolio construction layer en derivate l’allocation. Le bloc ci-dessous est du code [REFERENCE QC] a copier dans l’IDE Cloud : en local, la classe QCAlgorithm n’existe pas, d’ou les cellules marquees non executables de cette section. Le concept a retenir pour l’analyse de backtest : QC structure ses resultats autour de ces insights (taux de couverture, durees, emissions), ce qui donnera un autre regard sur les trades de la Partie 3 – un trade est l’ombre portee d’un insight dans le portefeuille.

# [REFERENCE QC] Code a copier dans main.py QC Lab (non executable ici)
# Code exemple pour QCAlgorithm (a utiliser dans QuantConnect)
qc_example_code = '''
from AlgorithmImports import *

class BacktestAnalysisAlgorithm(QCAlgorithm):
    """
    Exemple d'acces aux statistiques de backtest dans QuantConnect
    """
    
    def Initialize(self):
        self.SetStartDate(2015, 1, 1)
        self.SetEndDate(2024, 12, 31)
        self.SetCash(100000)
        
        self.symbol = self.AddEquity("SPY", Resolution.Daily).Symbol
        
        # Tracking des trades
        self.trade_count = 0
        self.winning_trades = 0
        self.losing_trades = 0
    
    def OnData(self, data):
        if not self.Portfolio.Invested:
            self.SetHoldings(self.symbol, 1.0)
    
    def OnOrderEvent(self, orderEvent):
        """Tracker les trades"""
        if orderEvent.Status == OrderStatus.Filled:
            self.trade_count += 1
    
    def OnEndOfAlgorithm(self):
        """
        Appele a la fin du backtest - acces aux statistiques
        """
        # Statistiques de base
        self.Debug("=" * 50)
        self.Debug("BACKTEST COMPLETE")
        self.Debug("=" * 50)
        
        # Portfolio stats
        self.Debug(f"Final Portfolio Value: ${self.Portfolio.TotalPortfolioValue:,.2f}")
        self.Debug(f"Total Trades: {self.trade_count}")
        
        # Acces aux trades fermes via TradeBuilder
        closed_trades = self.TradeBuilder.ClosedTrades
        
        if closed_trades:
            total_pnl = sum(t.ProfitLoss for t in closed_trades)
            wins = [t for t in closed_trades if t.ProfitLoss > 0]
            losses = [t for t in closed_trades if t.ProfitLoss < 0]
            
            self.Debug(f"Closed Trades: {len(closed_trades)}")
            self.Debug(f"Total P&L: ${total_pnl:,.2f}")
            self.Debug(f"Win Rate: {len(wins)/len(closed_trades):.2%}")
            
            # Details par trade
            for trade in closed_trades[-5:]:  # Derniers 5 trades
                self.Debug(f"  {trade.Symbol}: Entry={trade.EntryTime}, "
                          f"Exit={trade.ExitTime}, PnL=${trade.ProfitLoss:,.2f}")
        
        # Acces aux Insights (si utilises)
        insights = self.Insights.GetInsights()
        if insights:
            self.Debug(f"Total Insights Generated: {len(insights)}")
            
            # Analyser les insights
            correct_insights = [i for i in insights if i.EstimatedValue > 0]
            self.Debug(f"Correct Insights: {len(correct_insights)}/{len(insights)}")
'''

print("Exemple de code QCAlgorithm pour acceder aux statistiques:")
print(qc_example_code)

5.2 Structure des Résultats de Backtest QuantConnect

QuantConnect fournit des statistiques detaillees après chaque backtest.

Le rapport QC Cloud organise l’information en trois blocs hierarchiques – Performance (rendements et ratios), Risk (volatilite, drawdowns), Alpha/Beta (relation au benchmark) – chacun horodate sur la periode exacte du backtest. Les champs affiches ci-dessous reproduisent cette structure champ pour champ : savoir naviguer ce format est ce qui permet, en stage comme en production, de lire n’importe quel rapport QuantConnect sans re-apprendre ses habitudes de lecture.

# Simuler les statistiques type QuantConnect
qc_backtest_stats = {
    # Performance
    'Total Return': f"{strategy_return_metrics['total_return']:.2%}",
    'CAGR': f"{strategy_return_metrics['cagr']:.2%}",
    'Sharpe Ratio': f"{sharpe_strategy:.2f}",
    'Sortino Ratio': f"{sortino_strategy:.2f}",
    
    # Risk
    'Annual Volatility': f"{vol_strategy:.2%}",
    'Max Drawdown': f"{max_dd_strategy:.2%}",
    'Calmar Ratio': f"{calmar_strategy:.2f}",
    
    # Alpha/Beta
    'Alpha': f"{alpha:.2%}",
    'Beta': f"{beta:.2f}",
    'Information Ratio': f"{info_ratio:.2f}",
    'Tracking Error': f"{tracking_error:.2%}",
    
    # Trading
    'Total Trades': trade_stats['total_trades'],
    'Win Rate': f"{trade_stats['win_rate']:.2%}",
    'Profit Factor': f"{trade_stats['profit_factor']:.2f}",
    'Average Win': f"{trade_stats['avg_win']:.2%}",
    'Average Loss': f"{trade_stats['avg_loss']:.2%}",
}

# Afficher comme tableau QuantConnect
print("=" * 60)
print("QUANTCONNECT BACKTEST SUMMARY")
print("=" * 60)
print(f"\n{'Performance Metrics':<30}")
print("-" * 40)
for key in ['Total Return', 'CAGR', 'Sharpe Ratio', 'Sortino Ratio']:
    print(f"  {key:<25} {qc_backtest_stats[key]:>12}")

print(f"\n{'Risk Metrics':<30}")
print("-" * 40)
for key in ['Annual Volatility', 'Max Drawdown', 'Calmar Ratio']:
    print(f"  {key:<25} {qc_backtest_stats[key]:>12}")

print(f"\n{'Alpha/Beta Analysis':<30}")
print("-" * 40)
for key in ['Alpha', 'Beta', 'Information Ratio', 'Tracking Error']:
    print(f"  {key:<25} {qc_backtest_stats[key]:>12}")

print(f"\n{'Trading Statistics':<30}")
print("-" * 40)
for key in ['Total Trades', 'Win Rate', 'Profit Factor', 'Average Win', 'Average Loss']:
    print(f"  {key:<25} {str(qc_backtest_stats[key]):>12}")

print("=" * 60)
============================================================QUANTCONNECT BACKTEST SUMMARY============================================================Performance Metrics           ----------------------------------------  Total Return                    40.50%  CAGR                            19.32%  Sharpe Ratio                      1.01  Sortino Ratio                     1.67Risk Metrics                  ----------------------------------------  Annual Volatility               16.26%  Max Drawdown                   -16.63%  Calmar Ratio                      1.16Alpha/Beta Analysis           ----------------------------------------  Alpha                            7.98%  Beta                              0.44  Information Ratio                -0.15  Tracking Error                  17.42%Trading Statistics            ----------------------------------------  Total Trades                       150  Win Rate                        53.33%  Profit Factor                     1.43  Average Win                      1.63%  Average Loss                    -1.30%============================================================

Correspondance avec l’onglet Results de QC Cloud

Le bloc ci-dessus reproduit la structure du rapport QuantConnect (Performance / Risk / Alpha-Beta) avec les MEMES valeurs que les sections locales : Total Return 40,50 %, CAGR 19,32 %, Sharpe 1,01, MaxDD -16,63 %. C’est voulu : l’etudiant qui lancera plus tard le backtest sur QC Cloud doit savoir lire les deux formats sans traduction. Les ecarts qui apparaitront sur un vrai cloud (frais, slippage, dividendes du benchmark) degraderont tous les chiffres dans le meme sens – le squelette de lecture, lui, ne change pas.

Partie 6: Analyse de l’Equity Curve (20 min)

6.1 Simulation Monte Carlo (10 min)

La question que la Monte Carlo adresse : la performance observee est-elle robuste ou chanceuse ? En re-echantillonnant les returns journaliers observes (avec remise) des centaines de fois, on genere autant d’histoires alternatives – meme distribution, autre ordre – et on regarde la dispersion des destins : si 5 % des trajectoires simulees finissent en perte, le Total Return de 40 % observe n’etait pas garanti, il etait un tirage parmi d’autres. Les quantiles de l’ensemble (5 %, 50 %, 95 %) forment l’etau dans lequel le vrai backtest est tombe. C’est le pont vers la gestion du risque reel : combien de capital allouer a une strategie dont le pire quintile simulé perd ?

def monte_carlo_simulation(returns: pd.Series, 
                          n_simulations: int = 1000,
                          initial_capital: float = 100000) -> Dict:
    """
    Realise une simulation Monte Carlo sur les returns
    
    Args:
        returns: Serie de returns journaliers
        n_simulations: Nombre de simulations
        initial_capital: Capital initial
    
    Returns:
        Dict avec statistiques et equity curves simulees
    """
    np.random.seed(42)
    
    returns_array = returns.values
    n_periods = len(returns_array)
    
    final_values = []
    max_drawdowns = []
    equity_curves = []
    
    for i in range(n_simulations):
        # Shuffle les returns (bootstrap avec remplacement)
        shuffled_returns = np.random.choice(returns_array, size=n_periods, replace=True)
        
        # Calculer equity curve
        equity = initial_capital * np.cumprod(1 + shuffled_returns)
        
        # Final value
        final_values.append(equity[-1])
        
        # Max drawdown
        running_max = np.maximum.accumulate(equity)
        drawdown = (equity - running_max) / running_max
        max_drawdowns.append(drawdown.min())
        
        # Stocker quelques curves pour visualisation
        if i < 100:  # Garder 100 curves
            equity_curves.append(equity)
    
    # Percentiles
    percentiles = [5, 25, 50, 75, 95]
    value_percentiles = np.percentile(final_values, percentiles)
    dd_percentiles = np.percentile(max_drawdowns, percentiles)
    
    return {
        'final_values': final_values,
        'max_drawdowns': max_drawdowns,
        'equity_curves': equity_curves,
        'value_percentiles': dict(zip(percentiles, value_percentiles)),
        'dd_percentiles': dict(zip(percentiles, dd_percentiles)),
        'mean_final': np.mean(final_values),
        'std_final': np.std(final_values)
    }

# Executer simulation
print("Execution de 1000 simulations Monte Carlo...")
mc_results = monte_carlo_simulation(backtest_df['strategy_returns'], n_simulations=1000)

print("\nResultats Monte Carlo:")
print(f"\nValeur Finale (distribution):")
print(f"  5e percentile:   ${mc_results['value_percentiles'][5]:,.0f}")
print(f"  25e percentile:  ${mc_results['value_percentiles'][25]:,.0f}")
print(f"  Mediane (50e):   ${mc_results['value_percentiles'][50]:,.0f}")
print(f"  75e percentile:  ${mc_results['value_percentiles'][75]:,.0f}")
print(f"  95e percentile:  ${mc_results['value_percentiles'][95]:,.0f}")

print(f"\nMax Drawdown (distribution):")
print(f"  5e percentile:   {mc_results['dd_percentiles'][5]:.2%}")
print(f"  Mediane (50e):   {mc_results['dd_percentiles'][50]:.2%}")
print(f"  95e percentile:  {mc_results['dd_percentiles'][95]:.2%}")

On compare les resultats du backtest par rapport au benchmark de reference pour mesurer la valeur ajoutee – puis la Monte Carlo complete le tableau en estimant la dispersion des destins possibles autour de ce resultat. La cellule suivante visualise l’ensemble : les trajectoires d’equity simulees en eventail, la distribution des returns finaux, et la distribution des drawdowns max – chacune repond a une question (“ou peut-on finir ?”, “quelle perte peut-on encaisser en route ?”) que le chiffre unique de la Partie 1 (Max Drawdown observe : une seule realisation) ne pouvait pas approcher. Les trois panneaux se lisent comme un intervalle de confiance sur toute l’analyse precedente.

# Visualisation Monte Carlo
fig, axes = plt.subplots(1, 3, figsize=(16, 5))

# Plot 1: Equity curves simulees
ax1 = axes[0]
for curve in mc_results['equity_curves'][:50]:  # 50 premieres
    ax1.plot(curve / 1000, alpha=0.1, color='blue')

# Equity curve reelle
ax1.plot(backtest_df['strategy_equity'].values / 1000, 
         color='red', linewidth=2, label='Realise')
ax1.set_xlabel('Jours', fontsize=12)
ax1.set_ylabel('Valeur (k$)', fontsize=12)
ax1.set_title('Simulations Monte Carlo', fontsize=14, fontweight='bold')
ax1.legend()
ax1.grid(True, alpha=0.3)

# Plot 2: Distribution des valeurs finales
ax2 = axes[1]
ax2.hist(np.array(mc_results['final_values']) / 1000, bins=50, 
         color='steelblue', edgecolor='black', alpha=0.7)
ax2.axvline(x=backtest_df['strategy_equity'].iloc[-1] / 1000, 
            color='red', linestyle='--', linewidth=2, label='Realise')
ax2.axvline(x=mc_results['value_percentiles'][50] / 1000,
            color='green', linestyle='--', linewidth=2, label='Mediane MC')
ax2.set_xlabel('Valeur Finale (k$)', fontsize=12)
ax2.set_ylabel('Frequence', fontsize=12)
ax2.set_title('Distribution Valeurs Finales', fontsize=14, fontweight='bold')
ax2.legend()
ax2.grid(True, alpha=0.3)

# Plot 3: Distribution des max drawdowns
ax3 = axes[2]
ax3.hist(np.array(mc_results['max_drawdowns']) * 100, bins=50,
         color='red', edgecolor='black', alpha=0.5)
ax3.axvline(x=max_dd_strategy * 100, color='darkred', linestyle='--',
            linewidth=2, label='Realise')
ax3.set_xlabel('Max Drawdown (%)', fontsize=12)
ax3.set_ylabel('Frequence', fontsize=12)
ax3.set_title('Distribution Max Drawdowns', fontsize=14, fontweight='bold')
ax3.legend()
ax3.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

Interpretation des Résultats Monte Carlo

La simulation Monte Carlo fournit une perspective probabiliste sur la performance de la stratégie:

  1. Distribution des valeurs finales : Si la valeur realisee est proche de la mediane, la performance est “typique”. Si elle est dans les queues (5e ou 95e percentile), c’est atypique.

  2. Distribution des drawdowns : Periode d’estimer le “pire cas” raisonnable. Si le max drawdown realise est proche du 95e percentile des simulations, la stratégie a eu de la chance (ou malchance).

  3. Utilite pratique :

    • Capital adequacy : Avoir assez de capital pour le 95e percentile de drawdown
    • Expectations management : Communiquer les probabilites de performance aux investisseurs
    • Robustesse check : Si les percentiles sont très larges, la stratégie est très dependante de la sequence des returns

Precaution de methode pour ce notebook : les tirages reechantillonnent les returns OBSERVES de la simulation – ils explorent l’incertitude d’ordre des evenements, pas l’incertitude de modele (les parametres de la MA Crossover sont supposes connus et stables). Une distribution Monte Carlo etroite dit donc “l’ordre des jours n’a pas change grand chose”, PAS “la strategie est robuste a un autre regime de marche”. Les deux questions sont legitimes et differentes ; la seconde demande soit des donnees supplementaires, soit le rolling de la section 6.2.

def constrained_monte_carlo(returns, n_simulations=500, initial_capital=100000, max_dd_threshold=-0.20):
    """
    Simulation Monte Carlo avec contrainte de max drawdown.
    
    Args:
        returns: Serie ou array de returns journaliers
        n_simulations: Nombre de simulations a generer
        initial_capital: Capital initial
        max_dd_threshold: Seuil de drawdown maximal autorise (negatif, ex: -0.20)
    
    Returns:
        Array des percentiles [10, 50, 90] des valeurs finales valides, ou None
    """
    # TODO etudiant : implementer la simulation Monte Carlo contrainte
    pass

# Test (decommenter quand implemente)
# result = constrained_monte_carlo(backtest_df['strategy_returns'], n_simulations=500, max_dd_threshold=-0.25)
# if result is not None:
#     print(f"Percentiles (10/50/90): {result[0]:,.0f} / {result[1]:,.0f} / {result[2]:,.0f}")
# else:
#     print("Aucune simulation valide")
print("Exercice a completer")

Exercice 3 : Simulation Monte Carlo avec contraintes

Dans cet exercice, vous allez implementer une version simplifiee de Monte Carlo qui respecte des contraintes de risque.

Objectif : Ecrire une fonction constrained_monte_carlo qui genere N simulations et ne conserve que celles dont le max drawdown ne depasse pas un seuil donne. Retourner les percentiles des valeurs finales parmi les simulations valides.

Règles : - Reshuffler les returns historiques avec remise (bootstrap) - Rejeter toute simulation dont le max drawdown depasse max_dd_threshold (en decimal, ex: -0.20) - Si aucune simulation valide, retourner None - Calculer les percentiles 10, 50, 90 des valeurs finales valides

Indices : - # Étape 1 : Boucler N fois, pour chaque itération tirer len(returns) returns aleatoires avec np.random.choice - # Étape 2 : Calculer l’equity curve avec np.cumprod(1 + shuffled_returns) * initial_capital - # Étape 3 : Calculer le max drawdown de chaque simulation et filtrer - # Étape 4 : Retourner np.percentile(valid_values, [10, 50, 90]) si len(valid_values) > 0

6.2 Rolling Statistics (10 min)

Les statistiques glissantes permettent d’identifier les changements de regime : Sharpe, volatilite et drawdown calcules sur fenetre glissante (30-90 jours) plutot que sur toute la periode. Une strategie peut afficher un Sharpe global de 1,0 construit sur deux regimes tres differents – 2,0 la premiere annee, 0,2 la seconde – information invisible dans la moyenne et decisive pour le suivi en production : la strategie s’est-elle degrdee avec le temps, ou traverse-t-elle un passage cyclique ? La lecture se fait en corollaire de la heatmap mensuelle de la Partie 1, mais avec la dimension de tendance : ou va le Sharpe recent, pas seulement ou sont les mauvais mois.

def calculate_rolling_statistics(returns: pd.Series, 
                                window: int = 60) -> pd.DataFrame:
    """
    Calcule les statistiques rolling
    
    Args:
        returns: Serie de returns
        window: Fenetre (default: 60 jours)
    
    Returns:
        DataFrame avec rolling stats
    """
    df = pd.DataFrame(index=returns.index)
    
    # Rolling Sharpe (annualise)
    rolling_mean = returns.rolling(window).mean() * 252
    rolling_std = returns.rolling(window).std() * np.sqrt(252)
    df['rolling_sharpe'] = (rolling_mean - 0.02) / rolling_std  # Rf = 2%
    
    # Rolling Volatility
    df['rolling_volatility'] = rolling_std
    
    # Rolling Return (annualise)
    df['rolling_return'] = rolling_mean
    
    # Rolling Win Rate
    df['rolling_winrate'] = (returns > 0).rolling(window).mean()
    
    return df

# Calculer rolling stats
rolling_df = calculate_rolling_statistics(backtest_df['strategy_returns'], window=60)

# Visualisation
fig, axes = plt.subplots(2, 2, figsize=(14, 10))

# Rolling Sharpe
ax1 = axes[0, 0]
ax1.plot(rolling_df.index, rolling_df['rolling_sharpe'], linewidth=2, color='navy')
ax1.axhline(y=0, color='red', linestyle='--', linewidth=1)
ax1.axhline(y=1, color='green', linestyle='--', linewidth=1, alpha=0.5)
ax1.fill_between(rolling_df.index, rolling_df['rolling_sharpe'], 0,
                 where=rolling_df['rolling_sharpe'] > 0, color='green', alpha=0.2)
ax1.fill_between(rolling_df.index, rolling_df['rolling_sharpe'], 0,
                 where=rolling_df['rolling_sharpe'] < 0, color='red', alpha=0.2)
ax1.set_ylabel('Sharpe Ratio', fontsize=12)
ax1.set_title('Rolling Sharpe Ratio (60j)', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)

# Rolling Volatility
ax2 = axes[0, 1]
ax2.plot(rolling_df.index, rolling_df['rolling_volatility'] * 100, 
         linewidth=2, color='darkorange')
ax2.axhline(y=rolling_df['rolling_volatility'].mean() * 100, color='red', 
            linestyle='--', label=f"Mean: {rolling_df['rolling_volatility'].mean():.2%}")
ax2.set_ylabel('Volatilite (%)', fontsize=12)
ax2.set_title('Rolling Volatility (60j)', fontsize=14, fontweight='bold')
ax2.legend()
ax2.grid(True, alpha=0.3)

# Rolling Return
ax3 = axes[1, 0]
ax3.plot(rolling_df.index, rolling_df['rolling_return'] * 100, 
         linewidth=2, color='darkgreen')
ax3.axhline(y=0, color='red', linestyle='--', linewidth=1)
ax3.fill_between(rolling_df.index, rolling_df['rolling_return'] * 100, 0,
                 where=rolling_df['rolling_return'] > 0, color='green', alpha=0.2)
ax3.fill_between(rolling_df.index, rolling_df['rolling_return'] * 100, 0,
                 where=rolling_df['rolling_return'] < 0, color='red', alpha=0.2)
ax3.set_ylabel('Return Annualise (%)', fontsize=12)
ax3.set_title('Rolling Return (60j)', fontsize=14, fontweight='bold')
ax3.grid(True, alpha=0.3)

# Rolling Win Rate
ax4 = axes[1, 1]
ax4.plot(rolling_df.index, rolling_df['rolling_winrate'] * 100, 
         linewidth=2, color='purple')
ax4.axhline(y=50, color='red', linestyle='--', linewidth=1, label='50%')
ax4.set_ylabel('Win Rate (%)', fontsize=12)
ax4.set_title('Rolling Win Rate (60j)', fontsize=14, fontweight='bold')
ax4.legend()
ax4.grid(True, alpha=0.3)

for ax in axes.flat:
    ax.set_xlabel('Date', fontsize=12)

plt.tight_layout()
plt.show()
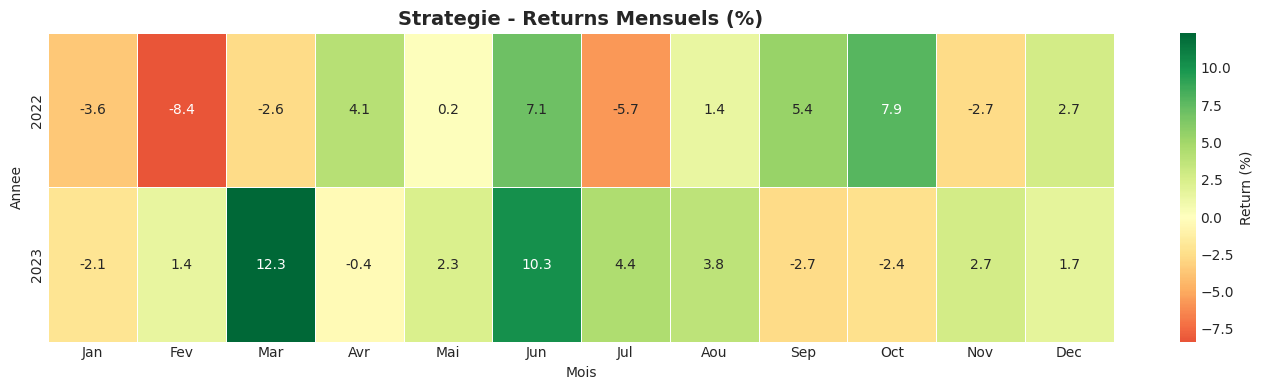
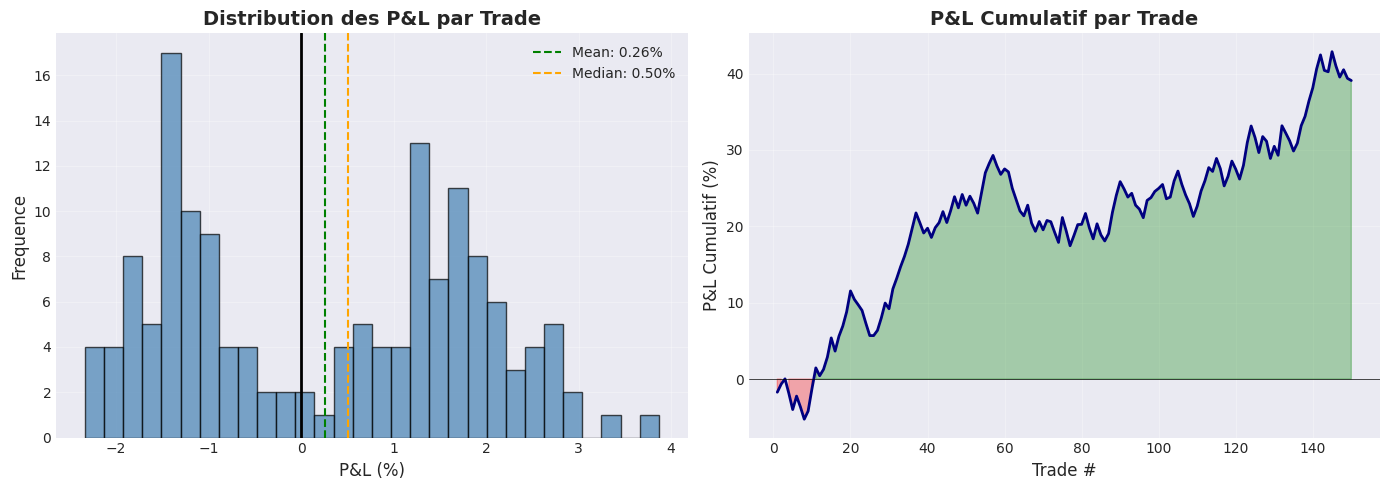
Interpretation: - Rolling Sharpe: Identifie les periodes de bonne/mauvaise performance ajustee au risque - Rolling Volatility: Detecte les changements de regime de volatilite - Rolling Win Rate < 50%: Periodes difficiles necessitant peut-etre une adaptation

Lecture des fenetres glissantes : ces tracés repondent a la question que les metriques globales des sections 1-2 laissent ouverte – le Sharpe 1,01 est-il une propriete STABLE de la strategie ou une moyenne sur melange de regimes ? Un Rolling Sharpe qui traverse regulierement le zero dit que non ; une Rolling Volatility qui change de palier signale le changement de regime de marche (choc de taux 2022 vs rallye 2023) ; un Rolling Win Rate qui plonge sous 50 % explique mecaniquement les series de 6 pertes consecutives vues en 3.1. Si les courbes ne sont pas plates, TOUTES les metriques globales de ce notebook doivent se lire comme des moyennes sur melange de regimes, pas comme des proprietes.

Partie 7: Rapport Complet (20 min)

7.1 Generer un Rapport de Backtest Complet

Derniere etape : assembler toutes les familles de metriques en un rapport unique, puis le confronter aux helpers canoniques du repository. Le rapport manuel et le helper calculent les memes concepts – mais leurs conventions different sur des points precis (annualisation du Sharpe, convention de l’alpha), et les chiffres qui en sortent different d’autant. Ce n’est pas un bug a corriger mais une lecon a inscrire : toute metrique publiee doit dire sa convention. La section se termine par la comparaison multi-strategies et le tableau final strategie vs benchmark – la conclusion du notebook se fonde dessus.

def generate_backtest_report(equity_series: pd.Series,
                            benchmark_series: pd.Series,
                            trades_df: pd.DataFrame,
                            strategy_name: str = "Strategie") -> str:
    """
    Genere un rapport de backtest complet en texte
    """
    # Calculer toutes les metriques
    returns = equity_series.pct_change().dropna()
    bench_returns = benchmark_series.pct_change().dropna()
    
    # Return metrics
    ret_metrics = calculate_return_metrics(equity_series)
    
    # Risk metrics
    sharpe = calculate_sharpe_ratio(returns)
    sortino = calculate_sortino_ratio(returns)
    calmar = calculate_calmar_ratio(equity_series)
    max_dd, _ = calculate_max_drawdown(equity_series)
    vol = returns.std() * np.sqrt(252)
    
    # Alpha/Beta
    alpha, beta = calculate_alpha_beta(returns, bench_returns)
    info_ratio, track_error = calculate_information_ratio(returns, bench_returns)
    
    # Trade stats
    trade_stats = calculate_trade_statistics(trades_df)
    
    # Generer le rapport
    report = f"""
{'='*70}
RAPPORT DE BACKTEST - {strategy_name.upper()}
{'='*70}

Periode: {equity_series.index[0].strftime('%Y-%m-%d')} - {equity_series.index[-1].strftime('%Y-%m-%d')}
Duree: {ret_metrics['years']:.1f} annees ({len(equity_series)} jours de trading)
Capital Initial: ${equity_series.iloc[0]:,.0f}
Capital Final: ${equity_series.iloc[-1]:,.0f}

{'-'*70}
METRIQUES DE PERFORMANCE
{'-'*70}
  Total Return:           {ret_metrics['total_return']:>10.2%}
  CAGR:                   {ret_metrics['cagr']:>10.2%}
  Annualized Return:      {ret_metrics['annualized_return']:>10.2%}

{'-'*70}
METRIQUES DE RISQUE
{'-'*70}
  Volatilite (ann.):      {vol:>10.2%}
  Max Drawdown:           {max_dd:>10.2%}
  Sharpe Ratio:           {sharpe:>10.2f}
  Sortino Ratio:          {sortino:>10.2f}
  Calmar Ratio:           {calmar:>10.2f}

{'-'*70}
COMPARAISON BENCHMARK
{'-'*70}
  Alpha (ann.):           {alpha:>10.2%}
  Beta:                   {beta:>10.2f}
  Information Ratio:      {info_ratio:>10.2f}
  Tracking Error:         {track_error:>10.2%}

{'-'*70}
STATISTIQUES DE TRADING
{'-'*70}
  Nombre de Trades:       {trade_stats['total_trades']:>10}
  Win Rate:               {trade_stats['win_rate']:>10.2%}
  Profit Factor:          {trade_stats['profit_factor']:>10.2f}
  Expectancy:             {trade_stats['expectancy']:>10.4%}
  Average Win:            {trade_stats['avg_win']:>10.2%}
  Average Loss:           {trade_stats['avg_loss']:>10.2%}
  Risk/Reward:            {trade_stats['risk_reward']:>10.2f}
  Max Consec. Wins:       {trade_stats['max_consec_wins']:>10}
  Max Consec. Losses:     {trade_stats['max_consec_losses']:>10}

{'='*70}
FIN DU RAPPORT
{'='*70}
"""
    return report

# Generer et afficher le rapport
report = generate_backtest_report(
    backtest_df['strategy_equity'],
    backtest_df['benchmark_equity'],
    trades_df,
    "MA Crossover Strategy"
)

print(report)
======================================================================RAPPORT DE BACKTEST - MA CROSSOVER STRATEGY======================================================================Periode: 2022-01-03 - 2023-12-07Duree: 1.9 annees (504 jours de trading)Capital Initial: $100,181Capital Final: $140,751----------------------------------------------------------------------METRIQUES DE PERFORMANCE----------------------------------------------------------------------  Total Return:               40.50%  CAGR:                       19.32%  Annualized Return:          18.36%----------------------------------------------------------------------METRIQUES DE RISQUE----------------------------------------------------------------------  Volatilite (ann.):          16.28%  Max Drawdown:              -16.63%  Sharpe Ratio:                 1.01  Sortino Ratio:                1.67  Calmar Ratio:                 1.16----------------------------------------------------------------------COMPARAISON BENCHMARK----------------------------------------------------------------------  Alpha (ann.):                7.73%  Beta:                         0.44  Information Ratio:           -0.18  Tracking Error:             17.43%----------------------------------------------------------------------STATISTIQUES DE TRADING----------------------------------------------------------------------  Nombre de Trades:              150  Win Rate:                   53.33%  Profit Factor:                1.43  Expectancy:                0.2606%  Average Win:                 1.63%  Average Loss:               -1.30%  Risk/Reward:                  1.25  Max Consec. Wins:                7  Max Consec. Losses:              6======================================================================FIN DU RAPPORT======================================================================

Helpers Standardises du Repository

Les helpers calculate_metrics et format_backtest_summary encapsulent toute la logique d’analyse de backtest en quelques appels de fonction. Cela: - Gagne du temps : Pas besoin de reecrire les calculs - Standardise : Format consistent entre tous les projets - Maintenabilite : Corrections et ameliorations centralisees

Le workflow typique : calculate_metrics() → format_backtest_summary() → affichage.

# Utiliser les helpers du repository
# Calculer via helper standardise
metrics_helper = calculate_metrics(
    backtest_df['strategy_equity'],
    benchmark=backtest_df['benchmark_equity']
)

# Formater via helper
summary_helper = format_backtest_summary(metrics_helper, "MA Crossover (via helper)")
print(summary_helper)
============================================================  Backtest Summary: MA Crossover (via helper)============================================================  Total Return:      40.50%  CAGR:              19.32%  Annual Volatility: 16.28%  Sharpe Ratio:      1.0643  Sortino Ratio:     1.7651  Max Drawdown:      -16.63%  Calmar Ratio:      1.1619  Win Rate:          52.68%  Num Periods:       503  Alpha:             -0.0858  Beta:              0.4435============================================================

Lecture croisee : deux Sharpe, deux alpha

Le helper affiche Sharpe 1,0643 la ou la section 1 calculait 1,01, et alpha -0,0858 contre +7,98 % en section 4.1. Ce ne sont pas des bugs : ce sont des DEFINITIONS differentes – 503 periodes effectives contre annualisation 252 jours, regression sur returns journaliers contre annualisation directe. C’est le point de vigilance transversal de tout rapport de backtest : avant de comparer deux chiffres, verifier qu’ils mesurent la meme chose sous la meme convention. En comite d’investissement, comparer le Sharpe maison (1,01) au Sharpe d’un vendor (1,0643) sans normaliser compare des choux et des carottes – et sur l’alpha, l’ecart change jusqu’au SIGNE de la conclusion.

Visualisation Complete avec Helper

Le helper plot_backtest_results genere une visualisation complete en 4 panneaux: - Equity Curve : Performance vs benchmark - Drawdown : Visualisation underwater - Returns Distribution : Histogramme des returns journaliers - Rolling Metrics : Evolution des metriques dans le temps

C’est la fonction “one-stop-shop” pour un diagnostic rapide de la stratégie.

# Visualisation complete avec helper
# Preparer DataFrame pour plot_backtest_results
results_for_plot = pd.DataFrame({
    'equity': backtest_df['strategy_equity'],
    'daily_returns': backtest_df['strategy_returns'],
    'drawdown': dd_df['drawdown_pct']
}, index=backtest_df.index)

# Plot
plot_backtest_results(
    results_for_plot,
    benchmark=backtest_df['benchmark_equity'],
    title='MA Crossover Strategy - Backtest Results'
)

On résume les statistiques finales du backtest pour produire un rapport de performance synthétique.

Le rapport final agrege toutes les familles vues separément : rendement (section 1), risque ajuste (1.2), drawdowns (2), micro-structure des trades (3), exposition au marche (4). C’est le format de sortie d’un analyste – une page, chiffres verifies, lecturepossible sans re-parcourir le notebook. Les deux blocs suivants montrent sa production par les helpers standardises du repository, puis son application a la comparaison de plusieurs strategies.

# Distribution des returns avec helper
plot_returns_distribution(
    backtest_df['strategy_returns'],
    title='MA Crossover - Returns Distribution'
)

Comparaison de Stratégies

Le helper compare_strategies permet de comparer plusieurs stratégies cote a cote. Cette fonction est utile pour: - A/B testing : Comparer différentes variantes d’une stratégie - Benchmark comparison : Evaluer la performance relative vs un indice - Parameter optimization : Visualiser l’impact des paramètres

Le résultat est un DataFrame avec toutes les metriques cote a cote.

# Comparaison de strategies via helper
strategies = {
    'MA Crossover': backtest_df['strategy_equity'],
    'Benchmark (SPY)': backtest_df['benchmark_equity']
}

comparison = compare_strategies(strategies)

print("\nComparaison des Strategies:")
comparison.round(4)
Comparaison des Strategies:                 Total Return    CAGR  Sharpe  Sortino  Max DD  Calmar  \Strategy                                                                 MA Crossover           0.4050  0.1932  1.0643   1.7651 -0.1663  1.1619   Benchmark (SPY)        0.4828  0.2271  1.1179   1.9220 -0.1696  1.3396                    Win Rate  Strategy                   MA Crossover       0.5268  Benchmark (SPY)    0.5268  

Lecture du tableau comparatif final

Sur les sept metriques affichees, la MA Crossover perd sur toutes : Total Return 0,4050 vs 0,4828, CAGR 0,1932 vs 0,2271, Sharpe 1,0643 vs 1,1179, Sortino 1,7651 vs 1,9220, Calmar 1,1619 vs 1,3396 – seul le Max Drawdown est (tres legerement) meilleur, -0,1663 contre -0,1696. Noter le Win Rate identique (0,5268 des deux cotes) : la strategie ne perd pas parce qu’elle gagne moins souvent, mais parce que ses gains sont plus petits. Un tableau comme celui-ci est la reponse canonique a “alors, cette strategie ?” : une ligne par metrique, les deux colonnes, et la lecture qui suit.


La boîte à outils du backtesteur — seuils, garde-fous et références

Huit familles de métriques couvertes

Dans ce notebook, nous avons appris a:

  1. Calculer les metriques de performance: Total Return, CAGR, rendements par periode
  2. Evaluer le risque ajuste: Sharpe (Sharpe, 1966), Sortino (Sortino & Price, 1994), Calmar (Young, 1991) ratios
  3. Analyser les drawdowns: Max drawdown, duree, underwater plot
  4. Statistiques de trades: Win rate, profit factor, expectancy, risk/reward
  5. Comparer au benchmark: Alpha, Beta (Sharpe, 1964 ; Lintner, 1965 - CAPM), Information Ratio (Treynor & Black, 1973), Tracking Error
  6. Simulations Monte Carlo (Efron, 1979 - bootstrap): Distribution des résultats possibles
  7. Rolling statistics: Detection de changements de regime
  8. Generer des rapports complets: Via fonctions custom et helpers

Seuils de référence par métrique

Metrique Ce qu’elle mesure Bon seuil
Sharpe Ratio Return / Risque total > 1.0
Sortino Ratio Return / Risque baissier > 1.5
Calmar Ratio CAGR / Max Drawdown > 1.0
Win Rate % trades gagnants > 50%
Profit Factor Gains / Pertes > 1.5
Alpha Surperformance ajustee > 0%
Information Ratio Alpha / Tracking Error > 0.5

Limitations et Precautions

  1. Overfitting: Des metriques excellentes sur backtest peuvent ne pas se reproduire en live
  2. Survivorship Bias: S’assurer que les données incluent les titres delisttes
  3. Lookahead Bias: Verifier que les signaux n’utilisent pas d’information future
  4. Transaction Costs: Inclure les frais et slippage realistes
  5. Market Impact: Les gros ordres peuvent impacter les prix

References academiques

  • Sharpe, W. F. (1966). Mutual Fund Performance. Journal of Business. Sharpe ratio (reward-to-variability).
  • Sortino, F. A. & Price, L. N. (1994). Performance Measurement in a Downside Risk Framework. Journal of Investing. Sortino ratio (downside deviation).
  • Young, T. W. (1991). Calmar Ratio: A Smoother Tool. Futures Magazine. Calmar ratio (CAGR / Max Drawdown).
  • Sharpe, W. F. (1964). Capital Asset Prices: A Theory of Market Equilibrium under Conditions of Risk. Journal of Finance. CAPM (Beta). Cf. Lintner (1965), Treynor (1961), Mossin (1966).
  • Treynor, J. L. & Black, F. (1973). How to Use Security Analysis to Improve Portfolio Sélection. Journal of Business. Information Ratio (active return / tracking error).
  • Efron, B. (1979). Bootstrap Methods: Another Look at the Jackknife. Annals of Statistics. Resampling / Monte Carlo bootstrap pour la distribution des metriques.
  • Lopez de Prado, M. (2018). Advances in Financial Machine Learning. Wiley. Probabilistic Sharpe Ratio (PSR), erreurs d’inference sur ratios de performance.
  • Jensen, M. C. (1968). The Performance of Mutual Funds in the Period 1945-1964. Journal of Finance 23(2), 389-416. Jensen’s alpha (surperformance ajustee au risque systématique).
  • Grossman, S. & Zhou, Z. (1993). Optimal Investment Stratégies for Controlling Drawdowns. Mathematical Finance 3(3), 241-276. Drawdown comme mesure de risque, optimisation sous contrainte de drawdown maximal.

Ressources


Notebook complete. Les metriques de backtest sont essentielles pour evaluer objectivement vos stratégies.

Conclusion : le verdict honnete

Sur ces 504 jours de donnees SIMULEES, la MA Crossover ne bat son benchmark sur aucune des familles de metriques : rendement brut (40,50 % vs 48,28 %), ratios ajustes au risque (Sharpe 1,01 vs 1,03, Calmar 1,16 vs 1,34), performance active (IR -0,15). Ses vraies qualites : un tiers de volatilite en moins (16,26 % vs 18,52 %), un beta de 0,443 qui la rend partiellement independante du marche, un edge micro coherent (Expectancy 0,2606 %/trade, PF 1,43) – le profil d’une strategie defensive a faible beta, PAS d’une machine a alpha. Au vocabulaire du depot : NO BEATS. Et c’est un resultat pedagogiquement sain : ce notebook apprend a PROUVER une sous-performance, competence au moins aussi rare que celle de revendiquer une surperformance.

Les trois chiffres a retenir : 451/504 jours en drawdown (le cout psychologique permanent), 286 jours pour effacer le pire episode (le cout d’opportunite), Profit Factor 1,43 (la minceur de la marge une fois les vrais frais factures).

Exercices de synthese : (1) refaire tourner calculate_return_metrics sur la seule annee 2023 – le verdict partiel change-t-il de signe ? (2) recalculer le Profit Factor avec 5 bps de frais par trade et determiner le seuil de frais qui annule l’Expectancy ; (3) remplacer le benchmark par 60 % SPY + 40 % cash et verifier que le Sharpe de la strategie devient competitif – pourquoi ce changement de reference change-t-il la conclusion alors que la strategie, elle, n’a pas change ?

Suite du parcours : QC-Py-13-Alpha-Models >> – ou les memes outils de lecture servent a evaluer des modeles d’alpha plutot qu’une strategie technique.

Retour au sommet