Jusqu’ici la série classe des images entières (4.2) ou détecte des contours (4.2b). La détection d’objets demande les deux à la fois : où sont les objets (localisation, une boîte par objet) et qu’y a-t-il (classification). Ce notebook construit la brique fondatrice de la famille one-stage anchor-based (SSD, YOLO, RetinaNet) entièrement à la main :
une grille d’anchors (tailles, ratios, échelles) posée sur une feature map ;
l’IoU vectorisée, l’assignation des anchors aux objets (seuils positif/négatif, zone d’ombre) et l’échantillonnage 1:3 ;
la loss from scratch : régression L1 lisse des décalages \((dx, dy, dw, dh)\) + entropie croisée binaire objet / fond ;
le décodage, la NMS gloutonne, et le mAP calculé à la main dans ses deux conventions (VOC07 11-point et VOC10 all-point) ;
une ablation qui mesure ce que la diversité des ratios d’anchors achète réellement.
Aucun torchvision.models.detection, aucun ultralytics — la parité industrielle arrive dans les notebooks SOTA de l’issue. Le terrain est synthétique et contrôlé : c’est ce qui permet de mesurer proprement l’effet de chaque choix (grille, seuils, ratios) sans le bruit d’un dataset réel.
1. Le problème : classifier n’est pas localiser
Un ConvNet de classification (4.2) produit un vecteur de logits par image. La détection produit, par objet, une boîte \((x, y, w, h)\) et un score. Trois familles historiques :
Famille
Idée
Représentants
Two-stage
proposer des régions, puis classifier chaque région
R-CNN, Fast/Faster R-CNN
One-stage anchor-based
prédire directement, pour chaque cellule d’une grille, des boîtes pré-formées décalées
SSD, YOLO, RetinaNet
One-stage anchor-free
prédire un centre/heatmap sans boîtes pré-formées
CenterNet, FCOS
L’anchor est la boîte pré-formée : pour chaque position de la feature map, on dépose \(k\) boîtes par défaut (ici \(k = 9\) : 3 tailles × 3 ratios). Le réseau n’apprend pas des boîtes depuis rien — il apprend des décalages\((dx, dy, dw, dh)\) par rapport à ces priors géométriques. Toute la question pédagogique est là : à quoi sert la diversité des priors ? La §11 y répond par la mesure.
import mathimport timeimport matplotlib.pyplot as pltimport numpy as npimport torchimport osos.environ.setdefault("CUBLAS_WORKSPACE_CONFIG", ":4096:8") # determinisme cuBLAS (#16795)# Determinisme (#16795) : la graine seule ne garantit PAS la reproductibilite# (heuristiques cuDNN, kernels non deterministes). warn_only=True au premier# passage pour inventorier les ops fautives sans faire echouer le run.torch.use_deterministic_algorithms(True, warn_only=True)torch.backends.cudnn.deterministic =Truetorch.backends.cudnn.benchmark =Falseimport torch.nn as nnimport torch.nn.functional as FSEED =0torch.manual_seed(SEED)np.random.seed(SEED)DEVICE = torch.device("cuda"if torch.cuda.is_available() else"cpu")print("device:", DEVICE.type)IMG =96# cote de l'imageSTRIDE =4# pas de la grille d'anchors (la feature map est IMG/STRIDE)FM = IMG // STRIDESIZES = [16.0, 24.0, 36.0] # tailles d'anchors (px)RATIOS = [0.5, 1.0, 2.0] # ratios largeur/hauteurN_ANC =len(SIZES) *len(RATIOS)print(f"feature map {FM}x{FM}, {N_ANC} anchors/cellule, {FM*FM*N_ANC} anchors au total")
device: cuda
feature map 24x24, 9 anchors/cellule, 5184 anchors au total
2. Le terrain : des objets synthétiques à échelles et ratios variés
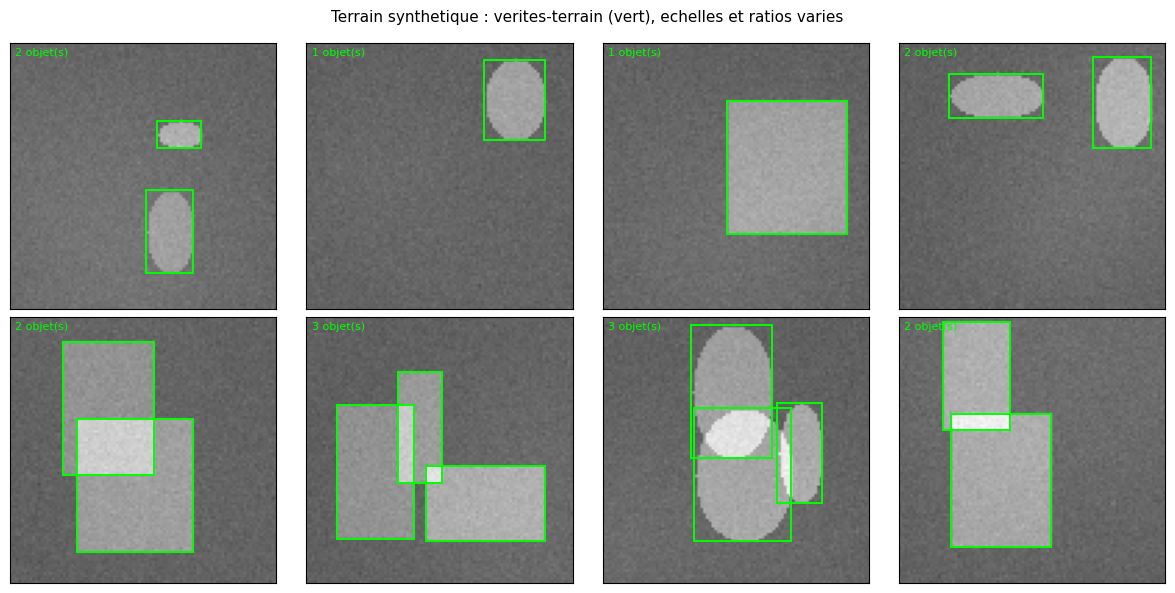
Le générateur produit des images 96×96 bruitées (gaussien + blobs lents de fond) contenant 1 à 3 objets — rectangles pleins ou ellipses — dont la largeur varie de 14 à 44 px et le ratio de 0,35 à 2,9. Les objets ne se recouvrent pas au-delà de IoU 0,25. Ce contrôle total du régime (échelles, ratios, densité) est ce qui rendra l’ablation de la §9 interprétable : on sait exactement quelles formes existent dans le terrain.
La boîte vérité-terrain (GT) d’un objet est le rectangle englobant \((x_0, y_0, w, h)\) en pixels — convention conservée partout dans ce notebook.
def iou_np(a, b):"""IoU de deux boites (x0, y0, w, h) en NumPy pur (scalaire).""" ix =max(0.0, min(a[0] + a[2], b[0] + b[2]) -max(a[0], b[0])) iy =max(0.0, min(a[1] + a[3], b[1] + b[3]) -max(a[1], b[1])) inter = ix * iy union = a[2] * a[3] + b[2] * b[3] - interreturn inter / union if union >0else0.0def make_image(rng): img = rng.normal(0, 0.08, (IMG, IMG)).astype(np.float32) yy, xx = np.mgrid[0:IMG, 0:IMG]for _ inrange(rng.integers(2, 5)): # fond : blobs lents cy, cx = rng.integers(0, IMG, 2) s = rng.uniform(18, 50) img +=0.10* rng.uniform(0.6, 1.3) * np.exp(-(((yy - cy) **2+ (xx - cx) **2) / (2* s * s))) boxes = []for _ inrange(rng.integers(1, 4)): # 1 a 3 objets kind = rng.choice(["rect", "ellipse"])for _try inrange(30): # placement sans recouvrement fort w =int(rng.uniform(14, 44)) h =int(max(10, min(48, w * rng.uniform(0.35, 2.9)))) x0 =int(rng.integers(2, IMG - w -2)) y0 =int(rng.integers(2, IMG - h -2)) cand = (x0, y0, w, h)ifall(iou_np(cand, b) <0.25for b in boxes): boxes.append(cand)breakfor (x0, y0, w, h) in boxes: amp = rng.uniform(0.7, 1.2)if kind =="rect": img[y0:y0 + h, x0:x0 + w] += ampelse: sub = img[y0:y0 + h, x0:x0 + w] ey, ex = np.mgrid[0:h, 0:w] mask = (((ex - w /2) / (w /2)) **2+ ((ey - h /2) / (h /2)) **2) <=1.0 img[y0:y0 + h, x0:x0 + w] = np.where(mask, sub + amp, sub)return np.clip(img, -1.5, 2.5), boxesdef make_split(n, seed): rng = np.random.default_rng(seed) xs, bs = [], []for _ inrange(n): img, boxes = make_image(rng) xs.append(img) bs.append(torch.tensor(boxes, dtype=torch.float32))return torch.tensor(np.stack(xs)).unsqueeze(1), bsXtr, Btr = make_split(2000, SEED +1)Xva, Bva = make_split(400, SEED +2)print("train:", tuple(Xtr.shape), "| val:", tuple(Xva.shape),"| objets GT val:", sum(len(b) for b in Bva))
def draw_boxes(ax, boxes, color, label):for (x0, y0, w, h) in boxes: ax.add_patch(plt.Rectangle((x0 -0.5, y0 -0.5), w, h, fill=False, edgecolor=color, linewidth=1.4)) ax.text(0.02, 0.98, label, transform=ax.transAxes, va="top", fontsize=8, color=color)fig, axes = plt.subplots(2, 4, figsize=(12, 6))for ax in axes.flat: ax.set_xticks([]); ax.set_yticks([])for i, ax inenumerate(axes.flat): img, boxes = Xva[i +40][0].numpy(), [tuple(b) for b in Bva[i +40].tolist()] ax.imshow(img, cmap="gray", vmin=-1.5, vmax=2.5) draw_boxes(ax, boxes, "lime", f"{len(boxes)} objet(s)")fig.suptitle("Terrain synthetique : verites-terrain (vert), echelles et ratios varies", fontsize=11)plt.tight_layout()plt.show()
3. La grille d’anchors : des priors géométriques
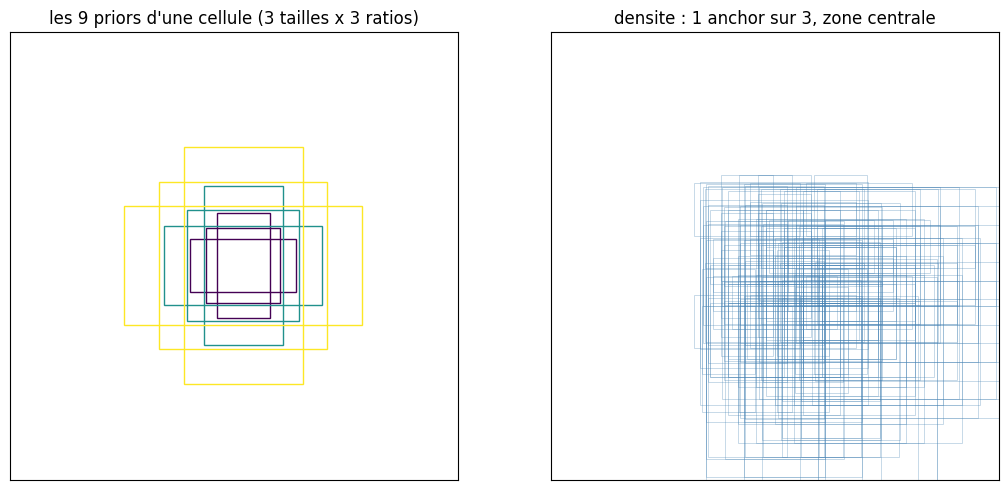
Sur chaque cellule \((g_x, g_y)\) de la feature map 24×24, le centre d’anchor est posé au milieu de la cellule : \(c = (g + 0{,}5) \cdot s\) avec \(s = 4\) px. Pour chaque taille \(a \in \{16, 24, 36\}\) et chaque ratio \(r \in \{0{,}5, 1, 2\}\), la boîte prior a pour dimensions \(w = a\sqrt{r}\), \(h = a/\sqrt{r}\) (conserver l’aire \(a^2\) en changeant le ratio). Neuf anchors par cellule, 5 184 au total.
Pourquoi des priors plutôt que rien ? Parce que régresser une boîte absolue depuis zéro est mal conditionné : les décalages à apprendre seraient de l’ordre de l’image entière. Avec un prior bien choisi, le réseau n’apprend que des petits corrections — c’est toute l’économie de l’anchor-based.
def build_anchors(sizes, ratios, device): anch = []for gy inrange(FM):for gx inrange(FM): cx = (gx +0.5) * STRIDE cy = (gy +0.5) * STRIDEfor s in sizes:for r in ratios: w = s * math.sqrt(r) h = s / math.sqrt(r) anch.append((cx - w /2, cy - h /2, w, h))return torch.tensor(anch, dtype=torch.float32, device=device)ANCH = build_anchors(SIZES, RATIOS, DEVICE)print("anchors:", tuple(ANCH.shape))# les 9 priors d'une cellule centralecx, cy =12.5* STRIDE, 12.5* STRIDEfig, axes = plt.subplots(1, 2, figsize=(11, 5))for ax in axes: ax.set_xlim(0, IMG); ax.set_ylim(IMG, 0) ax.set_aspect("equal"); ax.set_xticks([]); ax.set_yticks([])for s in SIZES:for r in RATIOS: w = s * math.sqrt(r); h = s / math.sqrt(r) axes[0].add_patch(plt.Rectangle((cx - w /2, cy - h /2), w, h, fill=False, edgecolor=plt.cm.viridis(SIZES.index(s) /2), linewidth=1.0))axes[0].set_title("les 9 priors d'une cellule (3 tailles x 3 ratios)")sub = ANCH[(ANCH[:, 0] >30) & (ANCH[:, 0] <60) & (ANCH[:, 1] >30) & (ANCH[:, 1] <60)]for b in sub[::3].cpu(): axes[1].add_patch(plt.Rectangle((b[0], b[1]), b[2], b[3], fill=False, edgecolor="steelblue", alpha=0.35, linewidth=0.6))axes[1].set_title("densite : 1 anchor sur 3, zone centrale")plt.tight_layout()plt.show()
anchors: (5184, 4)
4. L’IoU vectorisée
L’intersection de deux rectangles axis-aligned se coupe sur chaque axe : \(iw = \min(x_1 + w_1, x_2 + w_2) - \max(x_1, x_2)\), nulle si négative. L’IoU est \(\text{inter} / \text{union}\). La version tensorielle confronte tous les anchors (5 184) à toutes les GT d’une image d’un seul broadcast — c’est elle qui rend l’assignation praticable.
IoU : garde-fous OK (identique=1, disjoint=0, moitie=0.3333)
5. Assignation et échantillonnage 1:3
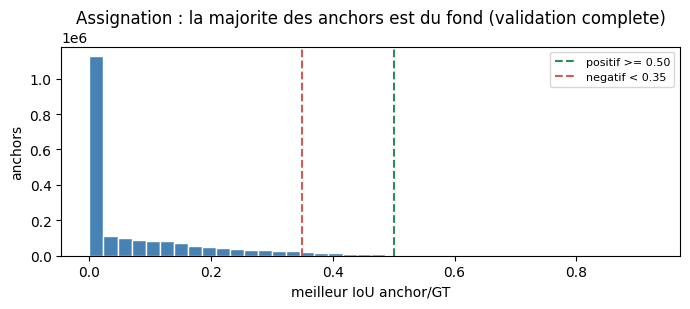
Chaque anchor reçoit un rôle selon son IoU avec la meilleure GT :
positif si IoU ≥ 0,5 — il porte la cible de localisation de cette GT ;
négatif si IoU < 0,35 — c’est du fond sûr ;
zone d’ombre entre les deux — ignoré : ni positif ni négatif (la frontière est bruyante).
Deux garde-fous classiques : le meilleur anchor de chaque GT est forcé positif (sinon un petit objet mal couvert n’aurait jamais de positif), et l’échantillonnage équilibre à 1:3 positifs:négatifs — sur 5 184 anchors, quelques dizaines sont positifs ; sans sous-échantillonnage, la loss noyerait la localisation sous le bruit du fond.
image demo : 26 positifs, 5059 negatifs, 99 en zone d'ombre
aller-retour encode->decode : erreur max 7.63e-06 px
# distribution des meilleurs IoU sur le jeu de validation (avant tout apprentissage)best_ious = torch.cat([iou_t(ANCH, b).max(dim=1).values for b in Bva]).cpu()fig, ax = plt.subplots(figsize=(7, 3.2))ax.hist(best_ious.numpy(), bins=40, color="steelblue", edgecolor="white")for thr, name, col in [(POS_THR, "positif >= 0.50", "seagreen"), (NEG_THR, "negatif < 0.35", "indianred")]: ax.axvline(thr, color=col, linestyle="--", label=name)ax.set_xlabel("meilleur IoU anchor/GT"); ax.set_ylabel("anchors")ax.set_title("Assignation : la majorite des anchors est du fond (validation complete)")ax.legend(loc="upper right", fontsize=8)plt.tight_layout(); plt.show()cov = (best_ious >= POS_THR).float().mean().item()print(f"{100*cov:.1f} % des anchors seulement au-dessus de 0.5 : le desequilibre que l'echantillonnage 1:3 compense")
1.2 % des anchors seulement au-dessus de 0.5 : le desequilibre que l'echantillonnage 1:3 compense
6. Le modèle : un backbone léger, deux têtes 1×1
Le backbone (deux pools, canaux 16→32→64) amène l’image 96×96 sur une feature map 24×24 — exactement la résolution de la grille. Deux convolutions 1×1 lisent chaque position : une tête objectness (9 logits, un par anchor) et une tête de localisation (36 sorties, les 4 deltas de chaque anchor). C’est la morphology SSD/RetinaNet en miniature : la prédiction est dense — chaque position vote sur ses 9 priors.
class AnchorNet(nn.Module):def__init__(self, n_anc):super().__init__()self.back = nn.Sequential( nn.Conv2d(1, 16, 3, padding=1), nn.ReLU(), nn.Conv2d(16, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), # 48x48 nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.Conv2d(32, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), # 24x24 = la grille nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.Conv2d(64, 64, 3, padding=1), nn.ReLU(), )self.obj = nn.Conv2d(64, n_anc, 1) # objectness par anchorself.box = nn.Conv2d(64, n_anc *4, 1) # deltas (dx,dy,dw,dh)def forward(self, x): f =self.back(x) o =self.obj(f).permute(0, 2, 3, 1).reshape(x.size(0), -1) b =self.box(f).permute(0, 2, 3, 1).reshape(x.size(0), -1, 4)return o, bmodel = AnchorNet(N_ANC).to(DEVICE)n_par =sum(p.numel() for p in model.parameters())print(f"AnchorNet : {n_par:,} parametres, sortie objectness {FM*FM*N_ANC}")
La BCE ne voit que les anchors échantillonnés (positifs + négatifs plafonnés à 3× le nombre de positifs, minimum 32 pour les images pauvres). La SmoothL1 ne voit que les positifs — un anchor de fond n’a pas de boîte à régresser. \(\lambda = 2\) équilibre les deux régimes d’échelle (la BCE est O(1), la L1 est en unités d’anchor).
LAMBDA_LOC =2.0def image_loss(o, b, boxes):"""Loss d'UNE image : BCE sur l'echantillon 1:3 + SmoothL1 sur les positifs.""" pos, tgt, neg = assign(ANCH, boxes)if pos isNoneor pos.sum() ==0:returnNone pn = pos.nonzero(as_tuple=True)[0] nn_ = neg.nonzero(as_tuple=True)[0] npos =len(pn) nneg =min(len(nn_), max(3* npos, 32)) total =Noneif nneg >0: sel = nn_[torch.randperm(len(nn_), device=DEVICE)[:nneg]] lab = torch.cat([torch.ones(npos, device=DEVICE), torch.zeros(nneg, device=DEVICE)]) logit = torch.cat([o[pn], o[sel]]) total = F.binary_cross_entropy_with_logits(logit, lab) loc = LAMBDA_LOC * F.smooth_l1_loss(b[pn], tgt[pn])return total + loc if total isnotNoneelse locdef train_epoch(model, opt, X, B): model.train() tot, n =0.0, 0 perm = torch.randperm(len(X)) BS =32for k inrange(0, len(perm), BS): idx = perm[k:k + BS] x = X[idx].to(DEVICE) opt.zero_grad() o, b = model(x) loss =sum(l for j, gi inenumerate(idx)if (l := image_loss(o[j], b[j], B[gi])) isnotNone)ifnot torch.is_tensor(loss):continue loss.backward() opt.step() tot +=float(loss.detach()); n +=1return tot /max(n, 1)
8. Entraînement
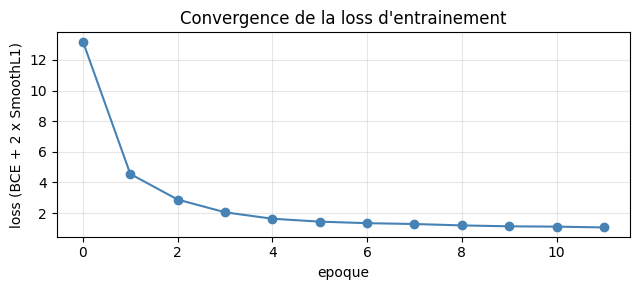
Douze époques, Adam à 1e-3, batch 32 — le budget est calibré pour la démonstration (terrain synthétique, ~150 s sur GPU, quelques minutes sur CPU). La loss agrégée mélange les deux termes ; on surveillera surtout le mAP en validation.
EPOCHS =12opt = torch.optim.Adam(model.parameters(), lr=1e-3)hist = []t0 = time.time()for ep inrange(EPOCHS): l = train_epoch(model, opt, Xtr, Btr) hist.append(l)print(f"epoque {ep:2d} : loss {l:7.3f} ({time.time() - t0:5.0f} s)")plt.figure(figsize=(6.5, 3))plt.plot(hist, marker="o", color="steelblue")plt.xlabel("epoque"); plt.ylabel("loss (BCE + 2 x SmoothL1)")plt.title("Convergence de la loss d'entrainement")plt.grid(alpha=0.3); plt.tight_layout(); plt.show()
epoque  0 : loss  13.191  (    8 s)
epoque  1 : loss   4.549  (   16 s)
epoque  2 : loss   2.879  (   22 s)
epoque  3 : loss   2.048  (   30 s)
epoque  4 : loss   1.627  (   38 s)
epoque  5 : loss   1.438  (   45 s)
epoque  6 : loss   1.338  (   53 s)
epoque  7 : loss   1.283  (   60 s)
epoque  8 : loss   1.191  (   68 s)
epoque  9 : loss   1.132  (   76 s)
epoque 10 : loss   1.111  (   85 s)
epoque 11 : loss   1.059  (   93 s)
9. Décodage et NMS gloutonne
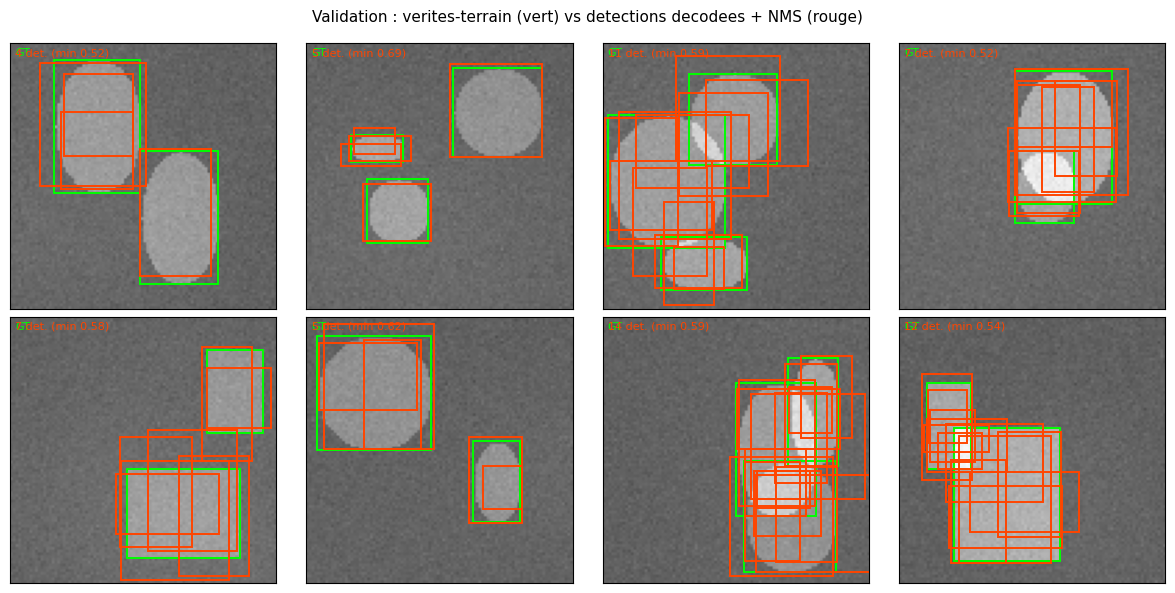
À l’inférence, chaque anchor propose une boîte décodée et un score. Autour d’un même objet, plusieurs anchors voisins dépassent le seuil de confiance : la non-maximum suppression gloutonne conserve la meilleure détection et supprime celles qui la recouvrent (IoU > 0,45) — une boucle, un tri par score, rien d’autre.
def nms(boxes, scores, thr=0.45):"""NMS gloutonne : indices conserves, tri par score decroissant.""" keep, suppressed = [], torch.zeros(len(boxes), dtype=torch.bool, device=DEVICE)for i in scores.argsort(descending=True).tolist():if suppressed[i]:continue keep.append(i) ious = iou_t(boxes[i:i +1], boxes)[0] suppressed |= ious > thr suppressed[i] =False# ne pas se supprimer soi-memereturn keepdef detect(model, img_t, conf=0.5, nms_thr=0.45): model.eval()with torch.no_grad(): o, b = model(img_t.to(DEVICE)) prob = torch.sigmoid(o[0]) sel = (prob > conf).nonzero(as_tuple=True)[0]iflen(sel) ==0:return torch.zeros(0, 4), torch.zeros(0) boxes = decode(ANCH[sel], b[0][sel]) keep = nms(boxes, prob[sel], nms_thr)return boxes[keep].cpu(), prob[sel][keep].cpu()fig, axes = plt.subplots(2, 4, figsize=(12, 6))for ax in axes.flat: ax.set_xticks([]); ax.set_yticks([])for i, ax inenumerate(axes.flat): img = Xva[i][0].numpy() ax.imshow(img, cmap="gray", vmin=-1.5, vmax=2.5) draw_boxes(ax, [tuple(x) for x in Bva[i].tolist()], "lime", "GT") dets, sc = detect(model, Xva[i:i +1]) draw_boxes(ax, [tuple(x) for x in dets.tolist()], "orangered",f"{len(dets)} det. (min {float(sc.min()):.2f})"iflen(sc) else"0 det.")fig.suptitle("Validation : verites-terrain (vert) vs detections decodees + NMS (rouge)", fontsize=11)plt.tight_layout(); plt.show()
10. Le mAP à la main : VOC07 11-point et VOC10 all-point
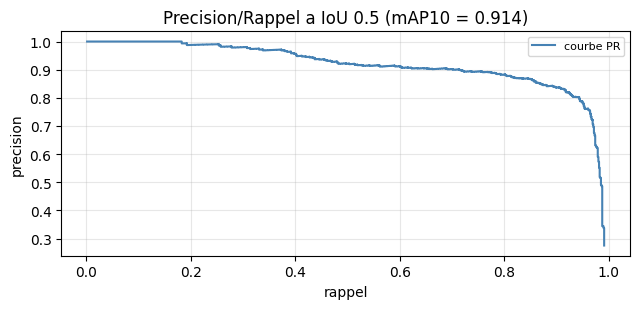
On collecte toutes les détections du jeu de validation, triées par score décroissant ; en descendant la liste, chaque détection est un TP si elle matche (IoU ≥ 0,5) une GT pas encore attribuée, sinon un FP. Les cumuls donnent la courbe précision/rappel :
VOC07, 11 points : \(\text{AP} = \frac{1}{11} \sum_{r \in \{0, 0{,}1, \dots, 1\}} p_{\text{interp}}(r)\) — la précision interpolée au plus grand rappel ≥ r ;
VOC10, all-point : l’aire sous la courbe PR en escalier (précision monotonisée de droite à gauche).
La convention 11-point, historique, optimiste sur les petits jeux — les deux chiffres sont reportés parce que la littérature cite les deux.
11. Ablation : la diversité des ratios sert-elle sur ce terrain ?
Intuition première : le terrain contient des objets allongés (ratios jusqu’à 2,9) ; une grille de priors carrés uniquement (ratio 1:1, 3 anchors/cellule) devrait donc souffrir. On ré-entraîne le même modèle sur la grille carrée et on compare — et la mesure désapprend l’intuition. Deux mécanismes expliquent le résultat :
le forçage du meilleur anchor par GT (§5) garantit à chaque objet au moins un positif, quelle que soit la forme des priors ;
la plage de régression log ±3 laisse à la tête de localisation un facteur \(e^3 \approx 20\) en largeur et en hauteur : n’importe quel prior carré peut se déformer en rectangle allongé.
L’écart mesuré est de l’ordre du point, du même ordre que les fluctuations entre deux exécutions de ce notebook (la grille complète seule bouge de ±0,4 pt de mAP entre deux runs) ; la tendance, carrée légèrement devant, est réelle mais marginale. Ce n’est pas un échec d’expérience, c’est le résultat : sur ce terrain contrôlé et avec cette plage de régression, la diversité des ratios est absorbée par l’assignation et la régression. Elle redevient déterminante quand ces garde-fous disparaissent (deltas plus contraints, objets plus fins, classification multi-classe). La métrique qui aurait pu trancher côté priors est le rappel vue GT — c’est l’objet de l’exercice 2.
ANCH_SQ = build_anchors(SIZES, [1.0], DEVICE)def train_with(anchors, n_anc, epochs):"""Re-entraine un AnchorNet vierge sur un autre jeu d'anchors. image_loss lit le ANCH global : on substitue le jeu courant le temps de l'entrainement, puis on restaure. """ m = AnchorNet(n_anc).to(DEVICE) o_ = torch.optim.Adam(m.parameters(), lr=1e-3)global ANCH saved = ANCH ANCH = anchorstry:for _ inrange(epochs): train_epoch(m, o_, Xtr, Btr)finally: ANCH = savedreturn mdef map_with(anchors, m):global ANCH saved = ANCH ANCH = anchorstry: tp, fp, ng = collect_pr(m, Xva, Bva)finally: ANCH = savedreturn ap_voc(tp, fp, ng)[:2]model_sq = train_with(ANCH_SQ, 3, EPOCHS)sq07, sq10 = map_with(ANCH_SQ, model_sq)print(f"grille carree ({len(ANCH_SQ)} anchors) : mAP07 {sq07:.3f} mAP10 {sq10:.3f}")print(f"grille complete ({len(ANCH)} anchors) : mAP07 {ap07:.3f} mAP10 {ap10:.3f}")print(f"ecart (complete - carree) : {100*(ap07-sq07):+.1f} pts de mAP07, "f"{100*(ap10-sq10):+.1f} pts de mAP10")
Ce que ce notebook ne fait pas — et que les notebooks suivants de l’issue construisent :
une seule échelle de feature map : les vrais SSD/FPN pyramident (stride 4, 8, 16) pour couvrir les grandes échelles — l’exercice 3 en pose le squelette ;
une classification binaire objet/fond : les objets synthétiques n’ont qu’une classe ; multi-classifier demande une tête softmax par anchor ;
pas de Focal Loss : l’échantillonnage 1:3 gère le déséquilibre à la dure ; la focalisation (γ, α) est une autre réponse, mesurée dans son propre notebook ;
l’anchor-free (CenterNet, FCOS) remplace les priors par une heatmap de centres — également un notebook dédié ;
la parité industrielle (torchvision.models.detection, ultralytics) sur le même terrain réduit : les notebooks SOTA du bloc B.
Exercices
Exercice 1 — Soft-NMS
La NMS gloutonne supprime brutalement tout recouvrement > seuil : deux objets réellement proches se marchent dessus. La soft-NMS (Bodla et al., 2017) dégrade le score au lieu de supprimer : \(s_i \leftarrow s_i \cdot (1 - \text{IoU}_i)\) pour les boîtes recouvrantes. Implémentez-la et comparez le mAP obtenu sur la validation avec la NMS dure (le terrain contient des objets proches mais non recouvrants — l’effet attendu est faible mais mesurable).
Indice : la seule boucle qui change est celle de la suppression ; on trie toujours par score et on re-trie après dégradation.
def soft_nms(boxes, scores, thr=0.45, sigma=0.5):"""Exercice 1 : soft-NMS. Retourne (indices conserves, scores degrades). Etapes proposees : 1. trier par score decroissant ; 2. prendre la meilleure boite restante ; 3. DEGRADER (pas supprimer) les scores des boites avec IoU > thr ; 4. re-iterer jusqu'a epuisement, en fixant un seuil de score minimal. """# TODO etudiantpass# Exercice a completer : remplacer nms() par soft_nms() dans detect()# et comparer ap_voc(...) sur la validation.print("Exercice 1 a completer")
Exercice 1 a completer
Exercice 2 — Couverture à priori de la grille
Avant tout apprentissage, la grille elle-même a une capacité plafond : un GT dont le meilleur anchor est sous 0,5 d’IoU ne peut pas être assigné positif (hors forçage du meilleur). Mesurez le rappel maximal théorique de la grille complète sur la validation : pour chaque GT, son meilleur IoU contre les 5 184 anchors ; quelle fraction des GT dépasse 0,5 ? Et contre la grille carrée ?
Indice : c’est un iou_t par image suivi d’un max sur le bon axe — attention à l’orientation du maximum (anchor→GT ou GT→anchor).
def recall_at_anchors(anchors, B):"""Exercice 2 : fraction des GT dont le meilleur anchor atteint POS_THR. Retourne (fraction >= 0.5, IoU moyen du meilleur anchor). """# TODO etudiant# Etape 1 : pour chaque image, iou_t(anchors, gt) puis max sur les ANCHORS# Etape 2 : agregre les meilleurs IoU de chaque GT sur tout le jeu# Etape 3 : fraction >= POS_THR et moyennereturnNone# TODO etudiantprint("Exercice 2 a completer")
Exercice 2 a completer
Exercice 3 — Une deuxième échelle (mini-pyramide)
La grille actuelle vit sur une seule feature map (stride 4, tailles 16-36 px). Un objet de 60 px n’a aucun prior à sa taille. Construisez build_anchors_pyramid() qui ajoute une deuxième grille sur une feature map stride 8 (12×12, tailles 48 et 64, ratio 1:1), concatène les deux jeux, et mesurez le gain de couverture à priori sur les mêmes GT.
Indice : le modèle doit prédire sur les DEUX feature maps (deux têtes 1×1) ; pour l’exercice, seul le calcul de couverture est demandé, pas le ré-entraînement.
def build_anchors_pyramid():"""Exercice 3 : grille a deux echelles (stride 4 + stride 8). Etapes proposees : 1. copier build_anchors avec STRIDE=8, SIZES=[48.0, 64.0], RATIOS=[1.0] ; 2. concatener avec la grille stride-4 existante ; 3. retourner (anchors, nombre d'anchors par position de chaque niveau). """# TODO etudiantpassprint("Exercice 3 a completer")
Exercice 3 a completer
Conclusion
La détection anchor-based réduit la localisation à une régression de petits décalages\((dx, dy, dw, dh)\) contre des priors géométriques posés en grille — le réseau ne devine pas des boîtes, il corrige des hypothèses.
L’assignation (0,5 / 0,35 / zone d’ombre) et l’échantillonnage 1:3 rendent le problème entraînable malgré ~1 % d’anchors positifs.
Le mAP se calcule en trente lignes : cumuls TP/FP sur les détections triées par score, aire sous la courbe PR — les conventions VOC07 et VOC10 diffèrent de quelques points sur ce terrain.
Mesuré, pas décrété : l’ablation §11 met à terre l’intuition « des ratios variés font mieux » — sur ce terrain, la grille carrée (moins d’anchors, optimisation plus facile) fait jeu égal — voire un point mieux — que la grille complète, parce que le forçage du meilleur anchor et la plage log ±3 absorbent les ratios. La bonne métrique côté priors est le rappel vue GT (exercice 2), pas la fraction du pool d’anchors.
Références : Everingham et al., The PASCAL Visual Object Classes (VOC) Challenge, IJCV 2010 (protocole mAP) · Liu et al., SSD: Single Shot MultiBox Detector, ECCV 2016 (grille d’anchors multi-échelle) · Ren et al., Faster R-CNN, NIPS 2015 (RPN, l’origine des anchors) · Bodla et al., Soft-NMS, ICCV 2017.
Notebook suivant dans l’issue : anchor-free from scratch (CenterNet-like), puis Focal Loss, puis la parité SOTA torchvision / ultralytics sur ce même terrain.