4.1 a établi qu’un neurone convolutif est un produit scalaire local, et que l’implémentation NumPy et torch.nn.Conv2d coïncident à epsilon machine. On sait donc ce qu’une couche calcule. La question suivante est celle de la profondeur : si une couche extrait des motifs, vingt couches devraient en extraire de plus abstraits.
Ce raisonnement est faux tel quel, et il l’est de manière mesurable. Empiler vingt convolutions produit un réseau que la descente de gradient n’entraîne pas : le signal d’apprentissage n’atteint plus les premières couches. Ce notebook mesure ce phénomène, puis mesure sa réparation.
La thèse : la connexion résiduelle h <- h + F(h) n’est pas un détail d’architecture ni une astuce d’ingénierie. C’est le mécanisme qui rend les réseaux profonds entraînables, et il se lit directement dans la dérivée. On le montrera en trois mesures :
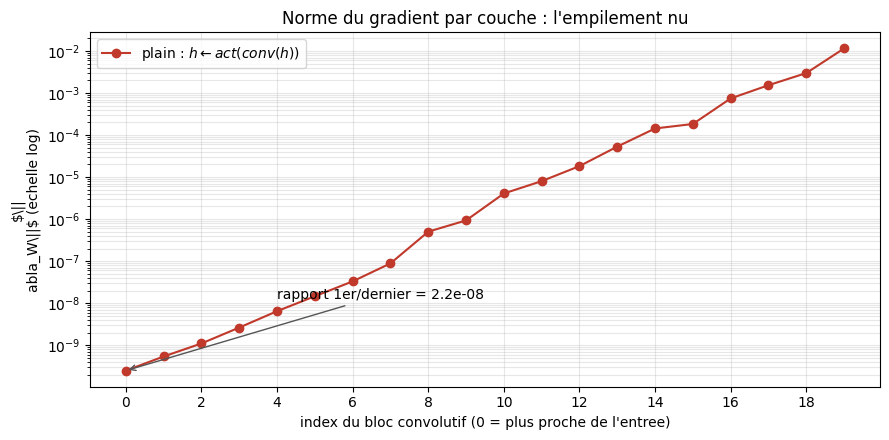
Un empilement nu de 20 convolutions : le gradient meurt (8 ordres de grandeur perdus).
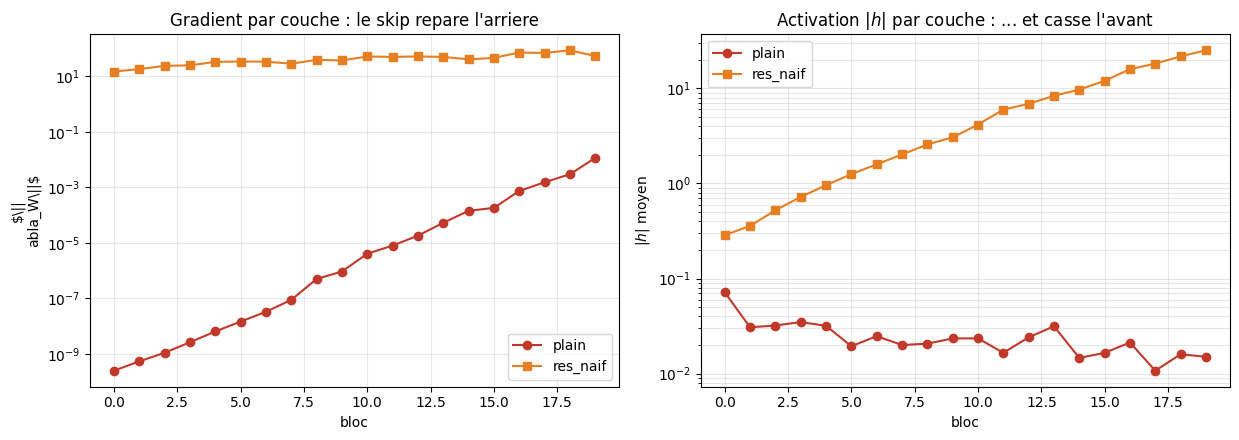
Le skip pose naïvement : le gradient est sauvé, et la passe avant explose.
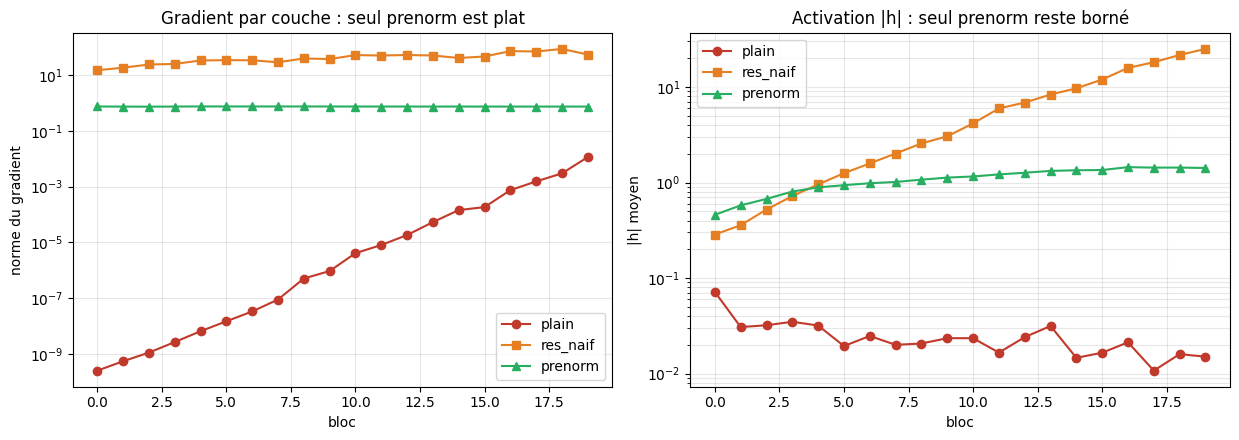
Le bloc pré-norme : les deux sont stables — et c’est exactement le bloc de l’attention en 3.4.
Le troisième point est le vrai enjeu du notebook : le même motif structurel porte la vision profonde et les Transformers. Ce n’est pas une analogie pédagogique, c’est la même ligne de code.
1. Le paradoxe de la profondeur
Le raisonnement qui semble tenir. Un réseau de profondeur D+1 peut représenter tout ce qu’un réseau de profondeur D représente : il suffit que la couche supplémentaire calcule l’identité. Donc, en capacité pure, ajouter des couches ne peut pas dégrader le modèle.
Ce qu’on observe en pratique. L’accuracy d’un empilement nu se dégrade passé une certaine profondeur — et pas par sur-apprentissage : l’erreur d’entraînement elle-même monte. Le modèle plus profond n’arrive pas à atteindre une solution qu’il pourrait pourtant représenter.
Où est la faute. Elle n’est pas dans la classe de fonctions représentables, elle est dans l’optimisation. Le problème n’est pas ce que le réseau peut calculer, mais ce que la descente de gradient peut atteindre. C’est une distinction qu’on va rendre chiffrée : la couche 0 reçoit un gradient 10^8 fois plus petit que la couche 19, donc elle n’apprend pas — quelle que soit la solution que le réseau pourrait représenter si ses poids étaient bien placés.
Question qu’on vérifiera plus bas. Si la couche k calculait l’identité, le gradient la traverserait sans atténuation. Peut-on rendre l’identité facile à apprendre, plutôt qu’espérer que la descente la trouve ?
import timeimport matplotlib.pyplot as pltimport numpy as npimport torchimport torch.nn as nnimport torch.nn.functional as Ftorch.set_num_threads(4)DEVICE ="cuda"if torch.cuda.is_available() else"cpu"print(f"torch {torch.__version__} | torchvision disponible | device = {DEVICE}")print(f"threads CPU = {torch.get_num_threads()}")
torch 2.13.0+cpu | torchvision disponible | device = cpu
threads CPU = 4
2. Un corps unique, trois branchements
Setup. Pour que la comparaison soit une mesure et pas une illustration, les trois réseaux doivent différer par une seule chose. On définit donc un corps unique — même stem, même nombre de convolutions, mêmes formes, même initialisation sous la même graine — dont seule la ligne de composition change dans la boucle :
mode
composition
lecture
plain
h <- act(conv(h))
l’empilement nu : chaque couche remplace son entrée
res_naif
h <- h + act(conv(h))
le skip pose tel quel : la couche ajoute à son entrée
prenorm
h <- h + conv(act(norm(h)))
le bloc pré-norme : normaliser, transformer, ajouter
Le nombre de paramètres est identique entre plain et res_naif (le skip n’ajoute aucun poids) ; prenorm ajoute les BatchNorm2d, soit 2 x ch paramètres par bloc — 640 sur 20 blocs, négligeable devant les 46 080 des convolutions. On le vérifiera par un compte explicite plutôt que par affirmation.
class ConvStack(nn.Module):"""Un corps unique, trois branchements. Seule la ligne de composition dans la boucle change avec `mode`. Stem, nombre de convolutions, formes, initialisation et graine sont identiques : la comparaison entre modes est donc controlee. """ MODES = ("plain", "res_naif", "prenorm")def__init__(self, depth=20, ch=16, n_classes=5, mode="plain", stride_stem=1):super().__init__()assert mode inself.MODES, f"mode inconnu : {mode}"self.mode, self.depth, self.ch = mode, depth, chif stride_stem ==1:self.stem = nn.Sequential(nn.Conv2d(3, ch, 3, padding=1), nn.ReLU())else:# Reduction spatiale 32x32 -> 8x8 : borne le cout CPU de la section 7.self.stem = nn.Sequential( nn.Conv2d(3, ch, 3, stride=2, padding=1), nn.ReLU(), nn.Conv2d(ch, ch, 3, stride=2, padding=1), nn.ReLU())self.convs = nn.ModuleList([nn.Conv2d(ch, ch, 3, padding=1) for _ inrange(depth)])self.norms = nn.ModuleList([nn.BatchNorm2d(ch) for _ inrange(depth)])self.act = nn.ReLU()self.head = nn.Linear(ch, n_classes)def forward(self, x, trace=None): h =self.stem(x)for conv, norm inzip(self.convs, self.norms):ifself.mode =="plain": h =self.act(conv(h))elifself.mode =="res_naif": h = h +self.act(conv(h))else: # prenorm h = h + conv(self.act(norm(h)))if trace isnotNone: trace.append(h.abs().mean().item())returnself.head(h.mean(dim=(2, 3)))def n_params(m):returnsum(p.numel() for p in m.parameters())for mode in ConvStack.MODES: torch.manual_seed(0) net = ConvStack(mode=mode)print(f"{mode:9s} : {n_params(net):,} parametres".replace(",", " "))
Le protocole. Une seule passe avant/arrière suffit — on ne cherche pas à entraîner, on cherche à savoir quel signal arrive à chaque couche au tout premier pas. On tire un lot fixe (graine 123), on calcule la perte, on rétro-propage, et on relève la norme du gradient sur les poids de chaque bloc.
Ce qu’il faut regarder : pas la valeur absolue (elle dépend de l’échelle de la perte), mais le rapport entre le gradient de la première couche et celui de la dernière. Un rapport de 1 signifie que toutes les couches reçoivent un signal comparable. Un rapport de 10^-8 signifie que la première couche est, pour la descente de gradient, invisible.
def mesure_gradient(mode, depth=20, seed=0, seed_data=123, batch=32):"""Une passe avant/arrière. Rend (normes de gradient par bloc, |h| par bloc, perte).""" torch.manual_seed(seed) net = ConvStack(depth=depth, mode=mode) torch.manual_seed(seed_data) x = torch.randn(batch, 3, 32, 32) y = torch.randint(0, 5, (batch,)) trace = [] loss = F.cross_entropy(net(x, trace=trace), y) net.zero_grad() loss.backward() grads = [c.weight.grad.norm().item() for c in net.convs]return np.array(grads), np.array(trace), loss.item()mesures = {m: mesure_gradient(m) for m in ConvStack.MODES}g_plain, h_plain, l_plain = mesures["plain"]print("mode = plain (empilement nu, 20 convolutions)")print(f" perte initiale : {l_plain:.4f}")print(f" |grad| bloc 0 (1er) : {g_plain[0]:.3e}")print(f" |grad| bloc 10 : {g_plain[10]:.3e}")print(f" |grad| bloc 19 (dern) : {g_plain[-1]:.3e}")print(f" rapport |g_0| / |g_19| : {g_plain[0] / g_plain[-1]:.3e}")
Lecture. Le rapport est de l’ordre de 1e-08. Ce n’est pas une lente atténuation : c’est un effondrement de huit ordres de grandeur sur vingt couches, soit un facteur ~0,4 par couche qui se compose géométriquement.
La conséquence est concrète : avec un pas d’apprentissage qui fait bouger la couche 19 de manière utile, la couche 0 bouge d’une quantité inférieure à la précision flottante utile. Elle reste à son initialisation aléatoire pendant toute la descente. Un empilement de 20 couches dont les 5 premières sont gelées au hasard n’est pas un réseau profond entraîne — c’est un réseau peu profond posé sur un prétraitement aléatoire.
Pourquoi la composition tue. Le gradient qui atteint la couche k est un produit de jacobiennes : chaque couche traversée multiplie le signal par sa propre jacobienne. Si le facteur moyen est r < 1, le signal à la couche 0 vaut r^D. C’est exponentiel en la profondeur — donc la profondeur ne dégrade pas le gradient, elle l’annihile.
fig, ax = plt.subplots(figsize=(9, 4.5))ax.semilogy(range(20), g_plain, "o-", color="#c0392b", label="plain : $h \leftarrow act(conv(h))$")ax.set_xlabel("index du bloc convolutif (0 = plus proche de l'entree)")ax.set_ylabel("$\||\nabla_W\||$ (echelle log)")ax.set_title("Norme du gradient par couche : l'empilement nu")ax.set_xticks(range(0, 20, 2))ax.grid(alpha=.3, which="both")ax.legend()ax.annotate(f"rapport 1er/dernier = {g_plain[0] / g_plain[-1]:.1e}", xy=(0, g_plain[0]), xytext=(4, g_plain[0] *50), arrowprops=dict(arrowstyle="->", color="#555"), fontsize=10)plt.tight_layout()plt.show()
Lecture de la figure — pourquoi une droite. En échelle logarithmique, une droite ne signifie pas une décroissance en ligne droite : elle signifie que chaque bloc multiplie la norme du gradient par un facteur à peu près constant (ici ~0,4, lu comme la pente de la droite). Vingt blocs, vingt multiplications : 0,4²⁰ ≈ 1e-08 — c’est l’annotation posée sur la courbe, calculée depuis les données tracées elles-mêmes, pas depuis une formule séparée.
La légère ondulation autour de la droite est réelle et attendue : le facteur par bloc n’est pas exactement constant, il fluctue d’un bloc à l’autre avec les poids initialisés. C’est la régularité en moyenne qui fait le dommage — aucun bloc individuel n’est pathologique, c’est leur composition qui l’est.
Une précaution de lecture : cette figure porte une graine et un lot. Le balayage de profondeurs de la section 5 (même diagnostic, six profondeurs) est ce qui généralise le constat.
4. Mesure 2 : le skip naïf sauve le gradient — et casse la passe avant
Le calcul, en une ligne. C’est de la dérivation élémentaire, et c’est tout l’argument. Pour un bloc nu h_{k+1} = F(h_k), la jacobienne est celle de F. Pour un bloc résiduel h_{k+1} = h_k + F(h_k) :
\[\frac{\partial h_{k+1}}{\partial h_k} = I + \frac{\partial F}{\partial h_k}\]
Le terme I est le point entier. Même si dF/dh est minuscule — même s’il est nul — la jacobienne reste proche de l’identité, donc le gradient traverse le bloc sans atténuation. Sur D blocs, le produit contient un chemin I x I x ... x I = I : il existe toujours une route directe de la perte jusqu’à la couche 0.
C’est aussi la réponse à la question de la section 1 : on ne demande plus à la couche d’apprendre l’identité, on la lui donne. Ce qu’elle apprend est l’écart à l’identité — un résidu, d’où le nom.
Question. Est-ce suffisant ? Posons le skip tel quel et mesurons.
g_naif, h_naif, l_naif = mesures["res_naif"]print("mode = res_naif (skip pose tel quel : h <- h + act(conv(h)))")print(f" |grad| bloc 0 : {g_naif[0]:.3e} (plain : {g_plain[0]:.3e})")print(f" |grad| bloc 19 : {g_naif[-1]:.3e}")print(f" rapport |g_0| / |g_19| : {g_naif[0] / g_naif[-1]:.3e} (plain : {g_plain[0] / g_plain[-1]:.3e})")print()print(" --- mais regardons la passe AVANT ---")print(f" perte initiale : {l_naif:.4f} (plain : {l_plain:.4f})")print(f" |h| moyen apres bloc 0 : {h_naif[0]:.3f}")print(f" |h| moyen apres bloc 19 : {h_naif[-1]:.3f} (facteur x{h_naif[-1] / h_naif[0]:.0f})")
mode = res_naif (skip pose tel quel : h <- h + act(conv(h)))
  |grad| bloc  0        : 1.500e+01   (plain : 2.485e-10)
  |grad| bloc 19        : 5.484e+01
  rapport |g_0| / |g_19| : 2.735e-01   (plain : 2.155e-08)

  --- mais regardons la passe AVANT ---
  perte initiale        : 17.4281   (plain : 1.6007)
  |h| moyen apres bloc  0 : 0.286
  |h| moyen apres bloc 19 : 25.077   (facteur x88)
Lecture — le gradient est réparé. Le rapport passe de 1e-08 à l’ordre de 1e-01 : les vingt couches reçoivent désormais un signal du même ordre de grandeur. La dérivée I + dF/dh a fait exactement ce que le calcul annonçait.
Lecture — mais la passe avant a explosé. La perte initiale est passée d’environ 1,6 (soit ln 5 ≈ 1.609, la perte d’un classifieur au hasard sur 5 classes — le point de départ sain) à un ordre de grandeur au-dessus. La cause se lit dans |h| : l’activation moyenne est multipliée par plusieurs dizaines entre le premier et le dernier bloc.
Pourquoi.ReLU est positive. Le bloc h + act(conv(h)) ajoute donc à chaque étape une quantité de moyenne positive : les activations s’accumulent de façon monotone au lieu de se recentrer. La variance croît linéairement avec la profondeur, et un réseau qui démarre à une perte de 17 au lieu de 1,6 part d’un régime où les logits saturent.
Le skip a donc résolu un problème et en a créé un autre. C’est cette tension précise que le bloc pré-norme résout.
L’idée. Le problème de res_naif n’est pas le skip, c’est ce qu’on ajoute : une quantité non centrée, de moyenne positive. La correction consiste à normaliser l’entrée de la transformation, de sorte que le résidu ajouté soit centré et d’échelle contrôlée :
Deux propriétés tiennent simultanément, et c’est ce qui rend ce bloc canonique :
La branche identité reste nue — aucune normalisation, aucune activation sur h_k lui-même. La jacobienne garde donc son terme I intact : le gradient traverse toujours sans atténuation.
La branche résiduelle est normalisée en entrée, donc ce qu’on ajoute est centré et d’échelle bornée : les activations ne dérivent plus.
L’ordre compte. Si on écrivait norm(h + conv(act(h))) (la normalisation après l’addition, dite post-norme), la branche identité passerait par la normalisation et le terme I serait détruit. C’est la différence entre ResNet-v1 et ResNet-v2, et c’est la même différence qu’entre les Transformers post-norme et pré-norme.
g_pre, h_pre, l_pre = mesures["prenorm"]print(f"{'mode':10s}{'perte':>8s}{'|g| bloc0':>12s}{'|g| bloc19':>12s} "f"{'rapport g0/g19':>15s}{'|h| bloc0':>10s}{'|h| bloc19':>11s}")print("-"*82)for m in ConvStack.MODES: g, h, l = mesures[m]print(f"{m:10s}{l:8.3f}{g[0]:12.3e}{g[-1]:12.3e} "f"{g[0] / g[-1]:15.3e}{h[0]:10.3f}{h[-1]:11.3f}")print()print(f"Perte d'un classifieur au hasard sur 5 classes : ln(5) = {np.log(5):.4f}")
prenorm est le seul mode à tenir les trois colonnes. Le rapport |g_0| / |g_19| y vaut environ 1,0 : la première couche reçoit littéralement le même ordre de signal que la dernière, sur vingt couches de profondeur. Ce n’est pas une amélioration marginale sur plain, c’est un changement de régime.
Ce que la mesure ne dit pas encore. Un gradient sain au premier pas est une condition nécessaire pour entraîner, pas une preuve qu’on apprend mieux. La section 7 fait la mesure qui manque : accuracy réelle sur des images réelles.
fig, ax = plt.subplots(1, 2, figsize=(12.5, 4.5))styles = {"plain": ("o-", "#c0392b"), "res_naif": ("s-", "#e67e22"), "prenorm": ("^-", "#27ae60")}for m in ConvStack.MODES: g, h, _ = mesures[m] st, col = styles[m] ax[0].semilogy(g, st, color=col, label=m) ax[1].semilogy(h, st, color=col, label=m)ax[0].set_title("Gradient par couche : seul prenorm est plat")ax[0].set_xlabel("bloc"); ax[0].set_ylabel("norme du gradient")ax[0].grid(alpha=.3, which="both"); ax[0].legend()ax[1].set_title("Activation |h| : seul prenorm reste borné")ax[1].set_xlabel("bloc"); ax[1].set_ylabel("|h| moyen")ax[1].grid(alpha=.3, which="both"); ax[1].legend()plt.tight_layout()plt.show()
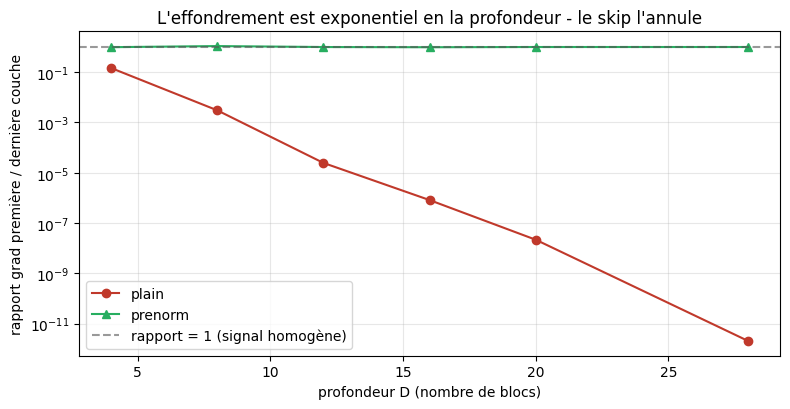
La profondeur est-elle bien la variable en cause ? Les mesures ci-dessus fixent D = 20. Si l’explication par la composition géométrique est la bonne, alors le rapport |g_0| / |g_{D-1}| de plain doit se dégrader exponentiellement avec D, tandis que celui de prenorm doit rester plat. On le vérifie plutôt que de l’affirmer.
profondeurs = [4, 8, 12, 16, 20, 28]rapports = {m: [] for m in ("plain", "prenorm")}for d in profondeurs:for m in rapports: g, _, _ = mesure_gradient(m, depth=d) rapports[m].append(g[0] / g[-1])print(f"{'profondeur D':>13s}{'plain g0/gD':>14s}{'prenorm g0/gD':>15s}")print("-"*45)for i, d inenumerate(profondeurs):print(f"{d:13d}{rapports['plain'][i]:14.2e}{rapports['prenorm'][i]:15.2e}")fig, ax = plt.subplots(figsize=(8, 4.2))ax.semilogy(profondeurs, rapports["plain"], "o-", color="#c0392b", label="plain")ax.semilogy(profondeurs, rapports["prenorm"], "^-", color="#27ae60", label="prenorm")ax.axhline(1.0, ls="--", color="#555", alpha=.6, label="rapport = 1 (signal homogène)")ax.set_xlabel("profondeur D (nombre de blocs)")ax.set_ylabel("rapport grad première / dernière couche")ax.set_title("L'effondrement est exponentiel en la profondeur - le skip l'annule")ax.grid(alpha=.3, which="both"); ax.legend()plt.tight_layout()plt.show()
Lecture. La courbe plain est une droite en échelle logarithmique : c’est la signature d’une décroissance géométrique en D, exactement ce que le produit de jacobiennes prédit. La courbe prenorm reste collée à 1 sur toute la plage.
Le diagnostic de la section 1 est donc confirmé au bon niveau : le problème n’est pas la profondeur en soi, c’est la composition multiplicative que la profondeur impose. Le skip transforme cette composition en somme — et une somme ne s’effondre pas.
6. Le pont vers 3.4 : c’est le même bloc
L’affirmation à vérifier. Le bloc pré-norme qu’on vient de mesurer n’est pas propre à la vision. C’est littéralement la structure de chaque couche d’un Transformer moderne, celle construite en 3.4. Mettons les deux côte à côte — non pas en prose, mais en code exécuté.
class BlocConvPreNorm(nn.Module):"""Le bloc de ce notebook (vision)."""def__init__(self, ch):super().__init__()self.norm = nn.BatchNorm2d(ch)self.transfo = nn.Conv2d(ch, ch, 3, padding=1)def forward(self, h):return h +self.transfo(F.relu(self.norm(h)))class BlocAttentionPreNorm(nn.Module):"""Le bloc de 3.4 (Transformer). Même squelette, autre transformation."""def__init__(self, d, n_heads=4):super().__init__()self.norm = nn.LayerNorm(d)self.transfo = nn.MultiheadAttention(d, n_heads, batch_first=True)def forward(self, h): z =self.norm(h)return h +self.transfo(z, z, z, need_weights=False)[0]# Les deux blocs tournent, sur leurs formes respectives.bloc_vision = BlocConvPreNorm(16)bloc_texte = BlocAttentionPreNorm(32)print("vision :", tuple(bloc_vision(torch.randn(2, 16, 8, 8)).shape), " (batch, canaux, H, W)")print("texte :", tuple(bloc_texte(torch.randn(2, 16, 32)).shape), " (batch, tokens, dim)")print()print("Vision (4.2) : h + conv( relu( BatchNorm(h) ) )")print("Texte (3.4) : h + attention( LayerNorm(h) )")print()print("Squelette commun : h + Transformation( Normalisation(h) )")print(" - la branche identité `h +` est nue dans les deux cas -> terme I préservé")print(" - la normalisation est *dans* la branche residuelle -> résidu centré")print(" - seule `Transformation` change : conv locale vs attention globale")
vision : (2, 16, 8, 8)   (batch, canaux, H, W)
texte  : (2, 16, 32)  (batch, tokens, dim)

Vision (4.2) : h + conv( relu( BatchNorm(h) ) )
Texte  (3.4) : h + attention(   LayerNorm(h) )

Squelette commun : h + Transformation( Normalisation(h) )
  - la branche identité `h +` est nue dans les deux cas -> terme I préservé
  - la normalisation est *dans* la branche residuelle -> résidu centré
  - seule `Transformation` change : conv locale vs attention globale
Deux géométries, un diagnostic. L’impression ci-dessus établit l’isomorphisme structurel — même squelette h + Transformation(Normalisation(h)), seule la transformation change (conv locale pour la vision, attention globale pour le texte). Ce qui reste à vérifier est que le diagnostic mesuré transfère : le gradient au premier pas meurt-il pareillement dans un empilement d’attention nue, et le bloc pré-norme le répare-t-il ?
La cellule suivante rejoue exactement le protocole de la section 3 — une passe avant/arrière, aucun entraînement — sur deux piles de 20 blocs d’attention (sans et avec pré-norme). Deux quantités sont surveillées simultanément, parce que la section 4 a montré qu’elles peuvent se réparer séparément : |g| (le gradient qui atteint le bloc 0) et |h| (l’activation qui atteint le bloc 19 — la passe avant qui s’effondre ou explose). Si la pré-norme répare les deux dans le monde attention, l’affirmation « c’est le même bloc » ne relève plus de l’analogie : elle est mesurée des deux côtés.
def mesure_gradient_transformer(prenorm, depth=20, d=32, seed=0):"""Empilement de `depth` blocs d'attention, avec ou sans skip pre-norme. Même protocole qu'en section 3 : une passe avant/arrière. On releve la norme du gradient sur les poids de projection de chaque bloc, et aussi |h| apres chaque bloc — le diagnostic complet demande les deux. """ torch.manual_seed(seed) blocs = nn.ModuleList([nn.MultiheadAttention(d, 4, batch_first=True) for _ inrange(depth)]) normes = nn.ModuleList([nn.LayerNorm(d) for _ inrange(depth)]) tete = nn.Linear(d, 5) torch.manual_seed(123) h = torch.randn(8, 16, d) y = torch.randint(0, 5, (8,)) activations = []for bloc, norme inzip(blocs, normes):if prenorm: z = norme(h) h = h + bloc(z, z, z, need_weights=False)[0]else: h = bloc(h, h, h, need_weights=False)[0] activations.append(h.abs().mean().item()) F.cross_entropy(tete(h.mean(dim=1)), y).backward() g = np.array([b.in_proj_weight.grad.norm().item() for b in blocs])return g, np.array(activations)for prenorm in (False, True): g, a = mesure_gradient_transformer(prenorm) nom ="attention pré-norme (3.4)"if prenorm else"attention empilée nue"print(f"{nom:28s} : |g_0| = {g[0]:.3e} |g_19| = {g[-1]:.3e} "f"rapport g0/g19 = {g[0] / g[-1]:.3e}")print(f"{'':28s} |h| bloc0 = {a[0]:.3e} |h| bloc19 = {a[-1]:.3e} "f"rapport h0/h19 = {a[0] / a[-1]:.3e}")print()
Lecture — le résultat transfère, mais pas sous la même forme. Le tableau ci-dessus ne montre pas ce qu’on attendait, et c’est le passage le plus instructif du notebook.
Sur l’empilement nu de blocs d’attention, le rapportg_0 / g_19 vaut 9,2e-01 : il est plat. On n’observe aucune décroissance le long de la profondeur, contrairement aux convolutions de la section 3 où le rapport tombait à 1e-08. Un lecteur qui s’arrêterait au rapport conclurait que l’empilement nu d’attention se porte bien.
Les deux autres colonnes disent le contraire :
Le signal avant s’annihile.|h| passe de 1,0e-01 au bloc 0 à 4,9e-09 au bloc 19, soit un facteur 2,1e+07. Une couche d’attention produit une combinaison convexe de ses entrées : moyenner vingt fois de suite contracte le signal vers sa moyenne jusqu’à l’éteindre.
Le gradient absolu est mort partout.|g_0| vaut 1,1e-08 en empilement nu contre 3,8e-01 en pré-norme — sept ordres de grandeur d’écart, et à toutes les profondeurs, pas seulement à la couche 0. Le rapport reste plat parce que le gradient est uniformément affamé, pas parce qu’il se propage.
Même cause, forme différente, même réparation. La cause est celle de la section 3 : composer vingt transformations sans route identité. Le symptôme diffère parce que la transformation diffère — la convolution décroît géométriquement le long de la profondeur, l’attention écrase le signal uniformément à chaque bloc. Le skip pré-norme répare les deux cas : rapport de gradients 1,1, et surtout |h|borné entre 8,0e-01 et 1,1 sur les vingt blocs.
La leçon n’est donc pas « le rapport de gradients est le diagnostic », mais : un diagnostic à une seule colonne se laisse tromper. C’est exactement ce que la section 5 établissait déjà avec res_naif — un gradient réparé accompagné d’une passe avant cassée. Ici la dissymétrie est inversée, et le principe tient toujours : il faut regarder le gradient et les activations.
Le lien concret avec 3.4. Le notebook 3.4 construit h + attention(LayerNorm(h)) et pose la normalisation avant l’attention. La raison de cet ordre n’y était pas mesurée : elle est ici. Les deux notebooks se complètent — 3.4 pose le bloc, 4.2 mesure pourquoi il est posé ainsi.
7. Mesure 4 : est-ce que ça apprend mieux ? (CIFAR-10, 5 classes)
Ce qui manque encore. Les sections 3 à 6 mesurent le gradient au premier pas. C’est un diagnostic de santé, pas une preuve d’apprentissage : un réseau peut avoir un gradient sain et n’apprendre rien d’utile. La question qui reste ouverte est simple — sur de vraies images, le réseau résiduel atteint-il une meilleure accuracy ?
Le protocole, et pourquoi il est construit ainsi.
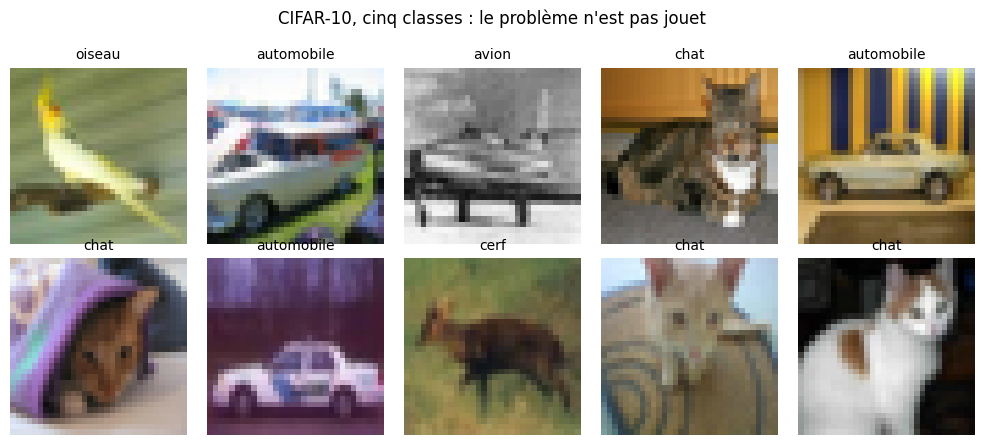
Données : CIFAR-10 restreint à 5 classes (avion, automobile, oiseau, chat, cerf), 1000 images d’entraînement par classe (5000 au total) et 200 de test par classe (1000). Le sous-ensemble borne le coût CPU tout en gardant un problème non trivial : distinguer un chat d’un oiseau sur 32x32 pixels n’a rien d’un cas jouet.
Trois graines (0, 1, 2) par architecture. Une seule graine ne suffirait pas : sur 1000 images de test, un écart de 1-2 points peut n’être que du bruit d’initialisation. Trois graines donnent un écart-type, donc un ordre de grandeur du bruit auquel comparer l’écart mesuré.
Stem à pas 2 : la résolution passe de 32x32 à 8x8 avant les vingt blocs. C’est ce qui rend l’expérience abordable sur CPU (~1,3 s par époque pour plain, ~1,9 s pour prenorm, mesuré ci-dessous) sans changer le phénomène étudié, qui porte sur la profondeur et non sur la résolution.
Deux architectures seulement : plain et prenorm. res_naif est écarté — la section 4 a montré que sa passe avant explose, l’entraîner ne renseignerait sur rien de neuf.
from pathlib import Pathimport torchvisionimport torchvision.transforms as T# Le cache est hors du dépôt (170 Mo) et partagé entre les notebooks de la série.RACINE_DONNEES = Path.home() /".cache"/"coursia-datasets"CLASSES = [0, 1, 2, 3, 4] # avion, automobile, oiseau, chat, cerfNOMS_CLASSES = ["avion", "automobile", "oiseau", "chat", "cerf"]PAR_CLASSE_TRAIN, PAR_CLASSE_TEST =1000, 200def _sous_ensemble(jeu, par_classe, graine=0):"""Extrait `par_classe` images de chacune des 5 classes retenues. Renvoie des tenseurs normalisés, prêts à l'emploi : le jeu tient en mémoire (5000 x 3 x 32 x 32 en float32 ~ 61 Mo), donc pas de DataLoader. """ cibles = np.array(jeu.targets) rng = np.random.default_rng(graine) idx = np.concatenate([rng.permutation(np.where(cibles == c)[0])[:par_classe] for c in CLASSES]) rng.shuffle(idx) X = torch.stack([jeu[i][0] for i in idx]) y = torch.tensor([CLASSES.index(int(cibles[i])) for i in idx])return X, ymoyenne_std = ((0.4914, 0.4822, 0.4465), (0.2470, 0.2435, 0.2616))tf = T.Compose([T.ToTensor(), T.Normalize(*moyenne_std)])t0 = time.time()train_complet = torchvision.datasets.CIFAR10(RACINE_DONNEES, train=True, download=True, transform=tf)test_complet = torchvision.datasets.CIFAR10(RACINE_DONNEES, train=False, download=True, transform=tf)Xtr, ytr = _sous_ensemble(train_complet, PAR_CLASSE_TRAIN, graine=0)Xte, yte = _sous_ensemble(test_complet, PAR_CLASSE_TEST, graine=1)print(f"chargement + sous-échantillonnage : {time.time() - t0:.1f} s")print(f"train : {tuple(Xtr.shape)} test : {tuple(Xte.shape)}")print(f"classes : {NOMS_CLASSES}")print(f"répartition train : {torch.bincount(ytr).tolist()}")print(f"accuracy d'un classifieur au hasard : {1/len(CLASSES):.1%}")
chargement + sous-échantillonnage : 2.4 s
train : (5000, 3, 32, 32)  test : (1000, 3, 32, 32)
classes : ['avion', 'automobile', 'oiseau', 'chat', 'cerf']
répartition train : [1000, 1000, 1000, 1000, 1000]
accuracy d'un classifieur au hasard : 20.0%
Lecture du chargement. Chaque ligne de la sortie mérite un arrêt, parce qu’elle conditionne la lecture de tout ce qui suit.
Les formes — train : (5000, 3, 32, 32), test : (1000, 3, 32, 32) — confirment mot pour mot le protocole de la section précédente : 1000 images par classe à l’entraînement, 200 au test. La normalisation par canal (moyenne/écart-type) a été appliquée ; moyenne_std la mémorise, et la cellule suivante s’en servira pour la défaire au moment d’afficher des images.
La répartition [1000, 1000, 1000, 1000, 1000] n’est pas un détail cosmétique : elle fixe la ligne de hasard à exactement 20,0 %. Avec des classes déséquilibrées, « prédire la classe majoritaire » battrait le hasard uniforme, et toute comparaison à 20 % serait faussée. Ici, 20,0 % est le plancher honnête.
La granularité de la mesure : chaque image de test pèse 0,1 point d’accuracy (1 sur 1000). C’est le pas de quantification de tous les chiffres de cette section — raison de plus pour exiger un écart largement supérieur au bruit avant de conclure quoi que ce soit.
# Un aperçu du problème réel : 32x32 pixels, cinq classes visuellement proches.X_vis = Xtr[:10] * torch.tensor(moyenne_std[1]).view(3, 1, 1) + torch.tensor(moyenne_std[0]).view(3, 1, 1)fig, axes = plt.subplots(2, 5, figsize=(10, 4.4))for ax, img, cible inzip(axes.ravel(), X_vis, ytr[:10]): ax.imshow(img.permute(1, 2, 0).clamp(0, 1).numpy()) ax.set_title(NOMS_CLASSES[cible], fontsize=10) ax.axis("off")fig.suptitle("CIFAR-10, cinq classes : le problème n'est pas jouet", y=1.0)plt.tight_layout()plt.show()
Lecture de la planche. Les dix vignettes sont les dix premières images d’entraînement, restituées en couleurs réelles par l’inversion de la normalisation (X * écart-type + moyenne, par canal) — les titres sont les étiquettes de vérité, pas des prédictions.
Ce que la planche montre : à 32×32 pixels, un cerf et un oiseau partagent souvent le même fond ciel, un chat et un cerf se réduisent à des taches brunes — l’information discriminante tient à quelques dizaines de pixels actifs. C’est ce qui rend le sous-ensemble non trivial malgré sa taille. Une honnêteté d’usage : dix images ne sont pas un échantillon statistique, juste un coup d’œil au terrain avant l’expérience.
Transition. Le protocole entre maintenant dans sa phase de mesure : deux architectures (plain, prenorm) × trois graines, quinze époques chacune. La cellule suivante déroule les six entraînements et imprime l’accuracy finale de chacun — environ deux minutes au total sur CPU, timings détaillés à la clé.
def entrainer(mode, graine, epoques=15, lot=128, lr=1e-3):"""Entraîne une ConvStack de 20 blocs et renvoie l'accuracy de test par époque.""" torch.manual_seed(graine) net = ConvStack(depth=20, ch=16, n_classes=len(CLASSES), mode=mode, stride_stem=2) opt = torch.optim.Adam(net.parameters(), lr=lr) generateur = torch.Generator().manual_seed(graine) historique = []for _ inrange(epoques): net.train()for i in torch.randperm(len(Xtr), generator=generateur).split(lot): opt.zero_grad() F.cross_entropy(net(Xtr[i]), ytr[i]).backward() opt.step() net.eval()with torch.no_grad(): predictions = torch.cat([net(Xte[i:i +500]).argmax(1) for i inrange(0, len(Xte), 500)]) historique.append((predictions == yte).float().mean().item())return historiqueGRAINES = [0, 1, 2]courbes = {}t0 = time.time()for mode in ("plain", "prenorm"):for graine in GRAINES: depart = time.time() courbes[(mode, graine)] = entrainer(mode, graine)print(f"{mode:8s} graine={graine} : accuracy finale = "f"{courbes[(mode, graine)][-1]:.1%} ({time.time() - depart:.0f} s)")print(f"\ntotal : {time.time() - t0:.0f} s")
plain    graine=0 : accuracy finale = 43.1%  (19 s)
plain    graine=1 : accuracy finale = 38.9%  (18 s)
plain    graine=2 : accuracy finale = 20.0%  (18 s)
prenorm  graine=0 : accuracy finale = 58.4%  (24 s)
prenorm  graine=1 : accuracy finale = 65.1%  (25 s)
prenorm  graine=2 : accuracy finale = 62.4%  (24 s)

total : 128 s
Lecture brute, graine par graine — avant tout moyennage. Le tableau récapitulatif n’existe pas encore : lisons d’abord les six lignes telles qu’elles sont sorties.
prenorm gagne chaque affrontement pairwise : 58,4 > 43,1, 65,1 > 38,9, 62,4 > 20,0. L’effet n’est pas porté par une graine chanceuse — il tient sur les trois tirages indépendants.
La ligne plain graine=2 : 20,0 % est celle qui mérite l’œil : exactement le taux du hasard sur cinq classes équilibrées. Cette graine n’est pas partie lentement — elle n’a jamais quitté la ligne de départ. (La lecture complète de cette bimodalité suit après le tableau.)
Les temps d’exécution confirment le budget annoncé : ~1,3 s par époque pour plain (19 s / 15 époques), ~1,6–1,7 s pour prenorm (24–25 s) — la pré-norme coûte environ 30 % de temps en plus, le prix des normalisations dans chaque branche. Total mesuré : 128 s, cohérent avec l’ordre de grandeur annoncé en section précédente.
finales = {m: np.array([courbes[(m, g)][-1] for g in GRAINES]) for m in ("plain", "prenorm")}meilleures = {m: np.array([max(courbes[(m, g)]) for g in GRAINES]) for m in ("plain", "prenorm")}print(f"{'architecture':14s}{'acc finale (moy +/- ec-type)':>30s}{'meilleure époque':>18s}")print("-"*66)for m in ("plain", "prenorm"):print(f"{m:14s}{finales[m].mean():>18.1%} +/- {finales[m].std():<8.1%} "f"{meilleures[m].mean():>17.1%}")ecart = finales["prenorm"].mean() - finales["plain"].mean()bruit = np.sqrt(finales["prenorm"].std() **2+ finales["plain"].std() **2)print()print(f"ecart prenorm - plain : {ecart:+.1%}")print(f"bruit inter-graines : +/-{bruit:.1%}")print(f"rapport ecart / bruit : {ecart / bruit:.1f}"if bruit >0else"bruit nul")
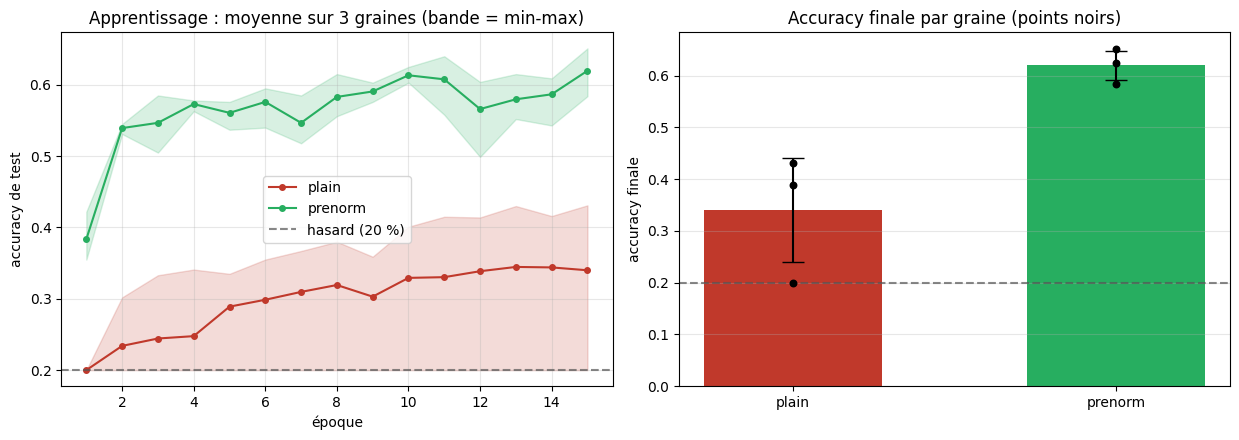
Du tableau aux trajectoires. Le tableau condense chaque mode en deux nombres (moyenne ± écart-type sur les graines) plus la meilleure accuracy atteinte — 34,9 % pour plain, 63,4 % pour prenorm. C’est le format le plus compact pour répondre à la question posée, mais il ne peut pas montrer comment on y arrive :
à quelle époque la séparation entre les deux modes s’installe-t-elle — dès la première, ou après une phase d’indifférenciation ?
les graines perdantes de plain décroissent-elles, ou stagnent-elles sur la ligne de hasard pendant quinze époques ?
la bande de prenorm reste-t-elle serrée tout au long, ou s’élargit-elle en fin de course ?
La figure suivante répond aux trois : accuracy de test par époque, moyenne en trait plein, enveloppe min–max des trois graines en aérographié, ligne de hasard à 20 % en repère. La lecture détaillée des chiffres suit la figure.
fig, ax = plt.subplots(1, 2, figsize=(12.5, 4.5))epoques = np.arange(1, len(courbes[("plain", 0)]) +1)for mode, couleur in (("plain", "#c0392b"), ("prenorm", "#27ae60")): paquet = np.array([courbes[(mode, g)] for g in GRAINES]) ax[0].plot(epoques, paquet.mean(0), "-o", color=couleur, label=mode, markersize=4) ax[0].fill_between(epoques, paquet.min(0), paquet.max(0), color=couleur, alpha=.18)ax[0].axhline(1/len(CLASSES), ls="--", color="#555", alpha=.7, label="hasard (20 %)")ax[0].set_xlabel("époque"); ax[0].set_ylabel("accuracy de test")ax[0].set_title("Apprentissage : moyenne sur 3 graines (bande = min-max)")ax[0].grid(alpha=.3); ax[0].legend()positions = np.arange(2)ax[1].bar(positions, [finales[m].mean() for m in ("plain", "prenorm")], yerr=[finales[m].std() for m in ("plain", "prenorm")], color=["#c0392b", "#27ae60"], capsize=8, width=.55)for i, m inenumerate(("plain", "prenorm")): ax[1].scatter([i] *len(GRAINES), finales[m], color="k", zorder=3, s=22)ax[1].axhline(1/len(CLASSES), ls="--", color="#555", alpha=.7)ax[1].set_xticks(positions); ax[1].set_xticklabels(["plain", "prenorm"])ax[1].set_ylabel("accuracy finale"); ax[1].set_title("Accuracy finale par graine (points noirs)")ax[1].grid(alpha=.3, axis="y")plt.tight_layout()plt.show()
Lecture — ce que la mesure autorise à dire, et ce qu’elle n’autorise pas.
Les chiffres : prenorm finit à 62,0 % ± 2,8, plain à 34,0 % ± 10,0. L’écart vaut +28,0 points pour un bruit inter-graines de ±10,4, soit un rapport écart/bruit de 2,7. C’est ce rapport qui compte, pas les points d’écart pris isolément : sans les trois graines, aucune des deux quantités ne serait disponible.
Un détail mérite d’être regardé. L’écart-type de plain (±10,0) vaut près de quatre fois celui de prenorm (±2,8), et l’une des trois graines plain finit à exactement 20,0 % — le hasard sur cinq classes équilibrées. La dispersion de plain n’est pas un halo graduel autour d’une moyenne : elle est bimodale, certaines graines apprennent, d’autres ne démarrent jamais. C’est la signature d’un régime au bord de l’effondrement, cohérente avec le diagnostic de gradient de la section 3.
Deux précautions honnêtes sur la portée de ce résultat :
Ce n’est pas un benchmark. Vingt blocs à 16 canaux sur 8x8 pixels, quinze époques, 5000 images : ce réseau n’est pas conçu pour maximiser l’accuracy sur CIFAR-10, il est conçu pour isoler l’effet du branchement résiduel, tout le reste étant tenu constant. Les valeurs absolues n’ont pas vocation à être comparées à la littérature.
La profondeur est ici un handicap assumé. À 20 blocs sur ce budget, plain se trouve précisément dans le régime où l’effondrement du gradient mord. Un réseau plain de 4 blocs apprendrait très bien — c’est ce que l’exercice 1 fait vérifier. Le résiduel ne rend pas un réseau meilleur en général ; il rend la profondeur utilisable.
Ce que la mesure établit : sur un protocole contrôlé, à nombre de convolutions et graines identiques, le branchement résiduel pré-norme change le résultat d’apprentissage — et pas seulement le diagnostic de gradient de la section 3.
8. Ce que ce notebook a établi
Cinq mesures, dans l’ordre où elles ont été faites :
#
mesure
résultat
3
gradient par couche, 20 convolutions empilées nues
rapport g_0 / g_19 de l’ordre de 1e-08 : la première couche ne reçoit rien
4
skip naïf h + act(conv(h))
gradient réparé, mais \|h\| dérive d’un facteur ~90 et la perte initiale monte à ~17 au lieu de ln 5 = 1,61
5
bloc pré-norme h + conv(act(norm(h)))
rapport ~1,0, activations bornées, perte initiale saine — les trois critères tenus ensemble
6
même protocole sur 20 blocs d’attention nus
rapport de gradients plat (0,92), mais \|h\| divisé par 2,1e+07 et \|g\| sept ordres de grandeur sous la pré-norme
7
accuracy CIFAR-10 (5 classes, 3 graines)
prenorm62,0 % ± 2,8 contre plain34,0 % ± 10,0 : écart +28,0 points pour un bruit de ±10,4, soit un rapport de 2,7
Le raisonnement en une ligne. La dérivée d’un bloc résiduel est I + ∂F/∂h. Le terme I est une route non atténuée de la perte jusqu’à la couche 0 ; c’est lui qui remplace un produit de vingt jacobiennes (qui décroît géométriquement) par une somme (qui ne décroît pas). Le pré-norme est ce qui permet de garder cette route nue tout en bornant ce qu’on ajoute.
Pourquoi l’ordre norm/skip n’est pas un détail.h + F(norm(h)) préserve I ; norm(h + F(h)) le détruit. C’est la différence entre ResNet-v1 et ResNet-v2 en vision, et exactement la même entre Transformer post-norme et pré-norme en NLP. L’exercice 2 la fait mesurer.
Le lien avec la série.3.4 construit le bloc h + attention(LayerNorm(h)) sans mesurer pourquoi il est ainsi ; la section 6 le mesure, sur de l’attention. Le résultat y est plus fin qu’un transfert littéral : sans skip, le rapport de gradients reste plat alors que le signal avant s’annihile et que le gradient absolu tombe sept ordres de grandeur sous celui du bloc pré-norme. Même cause, symptôme différent, même réparation. Le skip n’est pas une astuce de vision : c’est la condition qui rend n’importe quel empilement profond entraînable.
9. Exercices
Trois exercices, du plus direct au plus ouvert. Chacun se résout en modifiant ou en étendant du code déjà présent dans ce notebook — aucun n’exige de nouvelle bibliothèque.
Exercice 1 : à partir de quelle profondeur plain décroche-t-il ?
La section 7 compare plain et prenorm à une profondeur fixée (20 blocs), où l’effondrement mord déjà. Mais l’affirmation « le résiduel rend la profondeur utilisable » implique quelque chose de plus précis : à faible profondeur, plain devrait tenir sans skip.
Travail attendu
Entraîner plain et prenorm pour depth dans [4, 8, 12, 20], avec une seule graine et 8 époques (budget ~1 min au total : le coût croît avec la profondeur).
Tracer l’accuracy finale en fonction de depth, une courbe par architecture.
Répondre par écrit : à quelle profondeur les deux courbes se séparent-elles ? Cette profondeur coïncide-t-elle avec celle où le rapport g_0 / g_D de la section 5 franchit un seuil (disons 1e-3) ?
# Exercice 1 - à compléter## profondeurs = [4, 8, 12, 20]# resultats = {}# for mode in ("plain", "prenorm"):# for d in profondeurs:# # Indice : `entrainer` fixe depth=20 en dur. Ajoutez-lui un paramètre# # `depth`, ou recopiez son corps ici en faisant varier la profondeur.# resultats[(mode, d)] = ... # accuracy finale## Étape 2 : une figure, deux courbes accuracy = f(profondeur).## Étape 3 : comparer au rapport g0/gD déjà calculé en section 5 (variable# `rapports`), et écrire la conclusion en commentaire ou en markdown.print("À compléter")
À compléter
Exercice 2 : post-norme — quand la branche identité n’est plus nue
La section 5 affirme que l’ordre compte : h + F(norm(h)) (pré-norme) préserve le terme I, tandis que norm(h + F(h)) (post-norme) le détruit, parce que le chemin identité traverse alors la normalisation. C’est une affirmation testable.
Travail attendu
Ajouter un quatrième mode postnorm à ConvStack, dont la ligne de composition est h = norm(h + act(conv(h))).
Mesurer son profil de gradient avec mesure_gradient, et l’ajouter au tableau comparatif de la section 5.
Répondre : le rapport g_0 / g_19 de postnorm ressemble-t-il davantage à plain ou à prenorm ? Les activations restent-elles bornées ? Conclure sur ce que la normalisation répare et ce qu’elle ne répare pas.
# Exercice 2 - à compléter## Étape 1 : sous-classer ConvStack (ou modifier sa méthode forward) pour# ajouter le mode "postnorm" :## h = norm(h + self.act(conv(h)))## class ConvStackPostNorm(ConvStack):# def forward(self, x, trace=None):# ...## Étape 2 : g_post, h_post, l_post = mesure_gradient("postnorm")# puis reprendre le tableau de la section 5 avec quatre lignes.## Étape 3 : conclusion écrite. Indice : la normalisation borne les# activations même en post-norme ; la question est de savoir si# elle préserve la route du gradient jusqu'a la couche 0.print("À compléter")
À compléter
Exercice 3 : combien de skips faut-il, et où ?
Les sections précédentes opposent deux extrêmes : zéro skip (plain) ou vingt skips (prenorm). Rien n’oblige à choisir l’un des deux. Si le rôle du skip est bien d’ouvrir une route pour le gradient, alors retirer les skips des kderniers blocs ne devrait pas beaucoup gêner la couche 0 — tandis que les retirer des kpremiers devrait la couper de la perte.
Travail attendu
Écrire une variante de ConvStack acceptant un ensemble d’indices de blocs sans_skip, où la composition retombe sur h = act(conv(h)).
Mesurer le rapport g_0 / g_19 pour k dans [0, 5, 10, 15, 20], dans les deux dispositions : skips retirés en fin de réseau, puis en début.
Répondre : les deux courbes sont-elles symétriques ? Si non, la dissymétrie s’explique-t-elle par le sens de propagation du gradient (de la perte vers l’entrée) ?
# Exercice 3 - à compléter## Étape 1 : une ConvStack acceptant `sans_skip` (un set d'indices de blocs).## class ConvStackPartiel(ConvStack):# def __init__(self, *args, sans_skip=frozenset(), **kw):# super().__init__(*args, **kw)# self.sans_skip = set(sans_skip)# def forward(self, x, trace=None):# # bloc k dans self.sans_skip -> h = self.act(conv(h))# # sinon -> h = h + conv(self.act(norm(h)))# ...## Étape 2 : pour k dans [0, 5, 10, 15, 20], deux dispositions :# fin = range(20 - k, 20)# debut = range(k)# relever g[0] / g[-1] dans chaque cas.## Étape 3 : tracer les deux courbes et répondre à la question de la symétrie.print("À compléter")
À compléter
Pour aller plus loin
He et al., Deep Residual Learning for Image Recognition (2015) — l’article ResNet original : le point de départ y est exactement l’observation de la section 3, un réseau de 56 couches qui fait moins bien qu’un réseau de 20 couches.
He et al., Identity Mappings in Deep Residual Networks (2016) — ResNet-v2, c’est-à-dire précisément le passage de la post-norme à la pré-norme mesuré en exercice 2.
Xiong et al., On Layer Normalization in the Transformer Architecture (2020) — la même analyse, côté NLP : pourquoi les Transformers pré-norme s’entraînent sans phase de chauffe là où les post-norme en ont besoin.
Suite de la série : 4.3 — transfert et fine-tuning(voir feuille de route), où le réseau résiduel cesse d’être entraîne de zéro et devient un extracteur de représentations pré-entraîné.