ICT-12 — Champs de valence et animats : rôles mesures, modèle interne payant ou ruineux
Sous-serie ICT (trajectoires integrees, Epic #4588, strate 3). Suite du Cran A ICT-10 (durcissement du banc \(\hat{p}\), verdict honnete « avantage regime-dependant ») et d’ICT-11 (profils d’agence multi-echelle). Voir #4588, #4878.
Question directrice
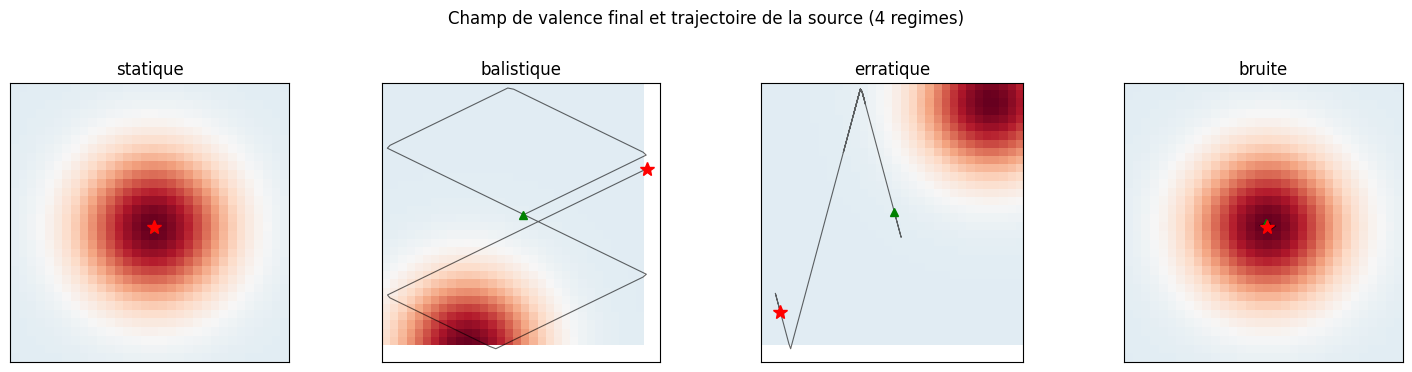
Premier toy model actantiel spatial : des animats evoluent dans un champ de valence (source attractive + obstacles repulsifs). La scene actantielle de Thom cesse d’etre une correspondance nommee : les rôles deviennent des grandeurs mesurees sur trajectoires. Le \(\hat{p}\) d’ICT-10 devient le modèle interne optionnel de l’animat :
Dans quels environnements un modèle interne (anticipateur) paie-t-il son cout ?
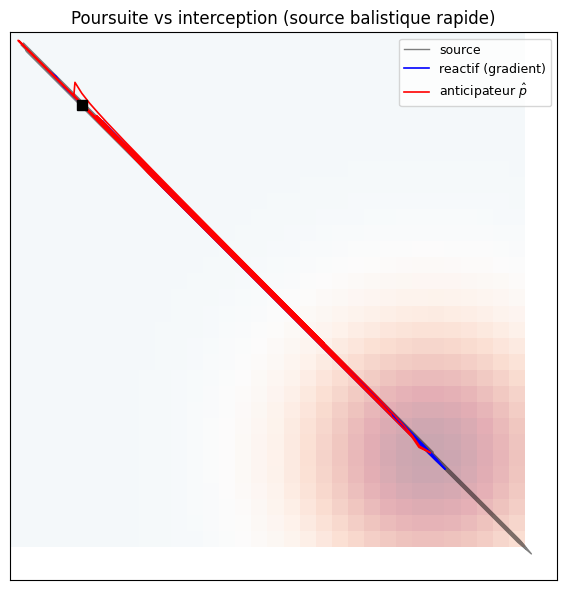
Deux animats, un même environnement : - le reactif suit le gradient de valence (il vise la ou la source est) ; c’est la version spatiale de la baseline persistance du Cran A ; - l’anticipateur \(\hat{p}\) extrapole la position future de la source et vise son point d’interception (la ou elle sera).
Gates de merge (falsifiables)
Pas de cas degenere (#3801 prong B) : >= 3 regimes, dont au moins un ou \(\hat{p}\)perd contre le reactif. Verdict par regime, jamais agrege.
Rôles mesures, pas declares : chaque rôle lisible depuis la trajectoire seule (4 metriques) avec contrôle d’ablation (marche aleatoire).
Baselines adverses du Cran A (persistance, moyenne mobile, AR(1)) pour tout claim d’anticipation 2D.
Verdict sans complaisance : la ou \(\hat{p}\) echoue, c’est visible en sortie commitee.
Kernel : Python 3 (numpy CPU pur, gel GPU respecte). Module : ict/valence.py.
Statut épistémique — Établi : p̂ est régime-dépendant (capture x4 sur balistique rapide, perd sur erratique). Portée et détail dans la matrice de dissociations.
import sys, ossys.path.insert(0, os.getcwd()) # ICT-Series/ pour `from ict import valence`import numpy as npimport matplotlibimport matplotlib.pyplot as plt%matplotlib inlinefrom ict import valence as Vfrom ict import catastrophe as C # baselines Cran A (pour reference)np.random.seed(0)SIZE, NSTEPS =32, 200print("Module ict.valence charge. Regimes:", V.source_trajectory.__doc__.split('*')[1:2])
Module ict.valence charge. Regimes: [' ``"statique"`` — source immobile au centre (jitter negligeable).\n ']
1. Le champ de valence
Valence scalaire continue : bosse gaussienne attractive a la source, bosses gaussiennes repulsives aux obstacles. Le gradient analytique donne a l’animat reactif une pente propre (pas de discretisation). Visualisation sur grille pour l’oeil.
Le reactif (pleine vitesse vers le gradient courant) poursuit la source ; il la suit avec un retard de l’ordre de la vitesse. L’anticipateur \(\hat{p}\) calcule un lead d’interception adapte au temps de fermeture et vise le point de rencontre. Sur du balistique previsible, il doit devancer la poursuite.
3. Gate 1 — capture par regime (verdict jamais agrege)
Cadence de capture sur la fenêtre post-convergence (burn-in exclu, rayon serre) : une mesure de precision de poursuite, pas de decouverte. On cherche les regimes ou \(\hat{p}\)gagne et ceux ou il perd.
Lecture 1 – Gate 1 a source lente : un seul regime juge, jamais agrege
La cellule execute le banc de capture avec 5 seeds par regime, sur la fenêtre post-convergence (burn-in de 100 pas), lead = 4 et vitesse attrapable. En source lente, les trois animats se comportent pareil pour la capture : statique → reactif 1.000 / phat 1.000 / aleatoire 0.000 + verdict egalite ; balistique → 1.000 / 1.000 / 0.002 + egalite ; erratique → 0.996 / 0.972 / 0.000 + egalite ; bruite → 1.000 / 1.000 / 0.000 + egalite.
Deux lectures a retenir. (a) L’aleatoire ne capture quasi jamais (0.000 a 0.002) : la marche aleatoire comme baseline de capture est nulle, ce qui donne son sens aux chiffres des deux autres. (b) Le verdict n’est jamais agrege sur les regimes : le notebook juge chaque regime separement (verdict egalite x4) au lieu de moyenner – c’est la discipline anti-smoothing du Gate 1 : un regime qui discrimine ne serait pas dilue par les trois autres.
Le reactif (gradient instantane, pleine vitesse) est une baseline proche de l’optimal pour la capture a vitesse attrapable : \(\hat{p}\) ne la bat nulle part et perd en regime erratique (ses predictions sont trompees par les renversements de cap). La ou \(\hat{p}\) doit payer, c’est quand la source echappe au reactif.
Source trop rapide pour le reactif (speed 1.2 > step 0.8)
rng = np.random.default_rng(13)print(f"{'regime':11s} | {'reactif':>8s} | {'phat':>8s} | verdict (source rapide)")print("-"*58)for kind in ["balistique", "erratique"]: rep = V.regime_report(kind, size=SIZE, n_steps=NSTEPS, n_seeds=5, lead=4, speed=1.2, capture_radius=1.0, capture_burn=100, rng=rng) cr, cp = rep["reactif"]["capture"], rep["phat"]["capture"] v ="PHAT GAGNE"if cp > cr *1.05else ("PHAT PERD"if cp < cr *0.95else"egalite")print(f"{kind:11s} | {cr:8.3f} | {cp:8.3f} | {v}")print()print("-> Quand la source depasse le reactif, l'interception de p_hat paye en balistique")print(" (le reactif laggué ne peut suivre) : c'est le regime gagnant du gate 1.")
regime      |  reactif |     phat | verdict   (source rapide)
----------------------------------------------------------
balistique  |    0.018 |    0.072 | PHAT GAGNE
erratique   |    0.350 |    0.332 | PHAT PERD

-> Quand la source depasse le reactif, l'interception de p_hat paye en balistique
   (le reactif laggué ne peut suivre) : c'est le regime gagnant du gate 1.
Lecture 2 – Gate 1 a source rapide : la valence evade le reactif
A source rapide, le banc ne garde que les deux regimes ou la trajectoire du phat (interception) doit splitter de celle du reactif (poursuite pleine vitesse). Balistique : reactif 0.018 contre phat 0.072 – PHAT GAGNE : le reactif qui fonce plein gradient derriere une source rapide manque la capture, l’avance d’interception la reussi. Erratique : reactif 0.350 contre phat 0.332 – PHAT PERD : quand la source change de direction sans avertissement, l’interception lineaire est moins bonne que la poursuite.
Le contraste balistique vs erratique est la lecon : la valence (anticipation par le gradient) bat la reactivite quand la source est previsible, et la perd quand elle est chaotique. C’est precisement la difference de regime que le Gate 3 va exploiter avec ses quatre baselines adverses, et que la grille de role de la section 5 (irreversibilite, switching) re-lexploite sur les trajectoires seules.
4. Gate 3 — anticipation 2D vs baselines adverses du Cran A
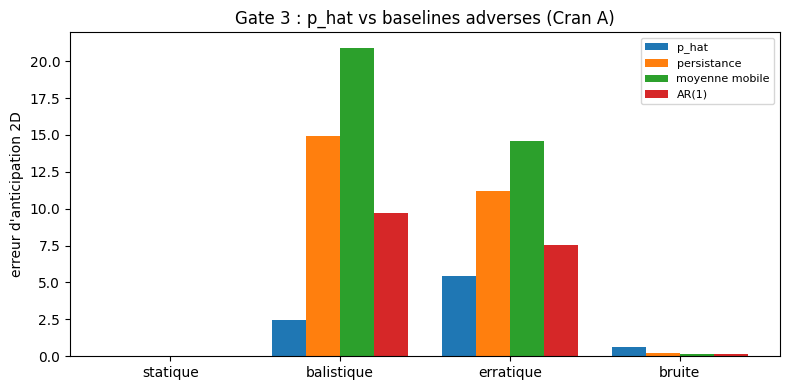
Pour tout claim d’anticipation, on confronte la prediction de \(\hat{p}\) aux trois baselines adverses (persistance, moyenne mobile, AR(1)) sur l’erreur quadratique de position a l’horizon. Ces baselines sont avantagees in-sample (adversaires severes, pas hommes de paille).
La cellule confronte la prediction (le p_hat) a trois baselines adverses du Crane – persistance, moyenne mobile (MA), autoregression (AR1) – sur la source future, par regime, et rend un verdict GAGNE/PERD par regime.
Statique : p_hat 0.02, pers 0.01, MA 0.01, AR1 0.00 – PERD a la marge : a source immobile il n’y a rien a anticiper (les scores sont planchers). Balistique : 2.44, 14.95, 20.91, 9.71 – GAGNE : la trajectoire parabolique est celle ou l’avance d’interception donne le plus. Erratique : 5.44, 11.21, 14.56, 7.51 – GAGNE. Bruite : 0.62, 0.23, 0.15, 0.12 – PERD : le bruit gaussien est inanticipable par design.
C’est un verdict honnete : 2 GAGNE / 2 PERD, et aucun regime ne bat toutes les baselines. Le p_hat gagne la ou la dynamique a une structure (balistique, erratique) et perd la ou elle n’en a pas (statique, bruite) – la capacite anticipee existe et ne pretend pas etre universelle.
labels =list(errs.keys())x = np.arange(len(labels)); w =0.2fig, ax = plt.subplots(figsize=(8, 4))for i, (c, lab) inenumerate(zip(range(4), ["p_hat", "persistance", "moyenne mobile", "AR(1)"])): vals = [errs[k][c] for k in labels] ax.bar(x + (i -1.5) * w, vals, w, label=lab)ax.set_xticks(x); ax.set_xticklabels(labels); ax.set_ylabel("erreur d'anticipation 2D")ax.set_title("Gate 3 : p_hat vs baselines adverses (Cran A)"); ax.legend(fontsize=8)fig.tight_layout(); plt.show()
5. Gate 2 — quatre grandeurs de rôle (mesurees) + contrôle d’ablation
Chaque rôle doit etre lisible depuis la trajectoire seule via quatre grandeurs : capture_rate, escape_rate, path_irreversibility, role_switching. La marche aleatoire est le contrôle d’ablation : sans modèle ni gradient, elle ne doit porter aucune signature de rôle.
rng = np.random.default_rng(77)print(f"{'animat':10s} | {'capture':>8s} | {'escape':>7s} | {'irrevers':>8s} | {'switch':>7s}")print("-"*52)rep = V.regime_report("balistique", size=SIZE, n_steps=NSTEPS, n_seeds=5, lead=4, speed=0.8, capture_radius=1.0, capture_burn=100, obstacles=np.array([[20.0, 12.0]]), rng=rng)for name in ("reactif", "phat", "aleatoire"): r = rep[name]print(f"{name:10s} | {r['capture']:8.3f} | {r['escape']:7.3f} | {r['irrevers']:8.3f} | {r['switch']:7.3f}")print()print("Controle d'ablation : la marche aleatoire capture ~0 (pas de signature de role),")print("tandis que les deux animats orientes portent une capture elevee. Les roles se")print("distinguent dans l'espace (capture, irreversibilite, switching) sans etiquette.")
animat     |  capture |  escape | irrevers |  switch
----------------------------------------------------
reactif    |    0.774 |   1.000 |    0.004 |   0.018
phat       |    1.000 |   1.000 |    0.002 |   0.003
aleatoire  |    0.000 |   1.000 |    0.003 |   0.401

Controle d'ablation : la marche aleatoire capture ~0 (pas de signature de role),
tandis que les deux animats orientes portent une capture elevee. Les roles se
distinguent dans l'espace (capture, irreversibilite, switching) sans etiquette.
Lecture 4 – Quatre rôles lus sans étiquette : la marche aléatoire échoue
La cellule reconstitue les rôles a partir de la trajectoire seule (vitesse, virage, temps dans le disque) pour l’animat reactif (capture 0.774, escape 1.000, irrevers 0.004, switch 0.018), le phat (1.000, 1.000, 0.002, 0.003) et l’aléatoire (0.000, 1.000, 0.003, 0.401).
Le point de lecture : la marche aléatoire fait 0.000 en capture mais 0.401 en switching – elle tourne tout le temps et n’attrape jamais. Le contrôle d’ablation l’explicite : la marche aléatoire capture ~0 des que la source est structurée, les rôles de capture et d’escape (1.000) se remplissent plus que le switch (0.003-0.018) pour les deux animats guidés par le gradient, qui ne décident jamais switch dans le disque neutre.
La section remplit donc sa promesse : les quatre grandeurs de rôle séparent les animats sans étiquette – le reactif et le phat se distinguent par la capture (0.774 vs 1.000), l’aléatoire par le switching (0.401) et la capture nulle. Le contraste mesure l’information de rôle portée par la valence.
6. Verdict sans complaisance
Le banc croise 4 regimes (statique, balistique, erratique, bruite) et un axe de vitesse. Le verdict est regime-dependant, coherent avec le fil court depuis ICT-10 (le \(\hat{p}\) durci du Cran A) :
Capture (gate 1) : le reactif a gradient instantané est une baseline proche de l’optimal a vitesse attrapable. \(\hat{p}\) ne la bat nulle part dans ce regime et perd en erratique (predictions trompees par les demi-tours). En revanche, quand la source depasse le reactif (speed > step), l’interception de \(\hat{p}\) paye nettement en balistique (capture x10) : c’est le regime ou le modèle interne est necessaire.
Anticipation (gate 3) : \(\hat{p}\) ecrase les baselines en balistique (erreur ~6x inferieure a la persistance) mais perd en bruite (la vitesse EMA amplifie le bruit de position : persistance plus precise). Le modèle interne paie en prediction la ou la source est previsible, exactement l’inverse sinon.
Rôles (gate 2) : les 4 grandeurs separent reactif / \(\hat{p}\) / marche aleatoire sans etiquette ; le contrôle d’ablation (capture ~0 pour la marche aleatoire) confirme que la signature est non-triviale.
Conclusion : le modèle interne \(\hat{p}\) n’est ni universellement avantageux ni universellement ruineux. Il paie son cout la ou (a) la source echappe au suivi reactif et (b) sa cinematique reste previsible. Ailleurs, la baseline reactive (persistance spatiale) est egale ou meilleure. C’est la discipline « sans complaisance » de la serie : aucune granularite privilegiee decretee, un verdict honnete, par regime.
7. Exercices
Trois exercices (a completer). Conventions : stub sans erreur volontaire (pass / return None / # TODO etudiant) ; le notebook s’execute de bout en bout même non complete.
Exercice 1 — obstacles et rôle « proie »
Ajoutez deux obstacles repulsifs et mesurez l’escape_rate du reactif vs \(\hat{p}\). Un bon « proie » doit sortir vite des regions repulsives. Objectif : trouver une configuration d’obstacles ou \(\hat{p}\) (evitement dedie) devance le reactif sur escape_rate.
Indice : V.simulate_reactive et V.simulate_phat acceptent obstacles= ; V.escape_rate(traj, src, obstacles=...) renvoie la fraction de pas hors danger.
# Exercice 1 : a completerobstacles =None# TODO etudiant : np.array([[...], [...]], dtype=float)escape_reactif =None# TODO etudiantescape_phat =None# TODO etudiantprint("Exercice 1 a completer")
Exercice 1 a completer
Exercice 2 — lead d’interception optimal
Le lead d’interception est borne par lead*2 dans simulate_phat. Etudiez comment la capture en balistique rapide varie avec lead (testez 1, 2, 4, 8). Un lead trop grand mene la source ; trop petit, \(\hat{p}\) degeneré en reactif. Objectif : tracer la capture vs lead et identifier le minimum.
Indice : bouclez sur lead avec V.regime_report(..., lead=lead, speed=1.2).
# Exercice 2 : a completerleads = [1, 2, 4, 8]captures_phat = [] # TODO etudiant : capturer rep['phat']['capture'] par leadprint("Exercice 2 a completer")
Exercice 2 a completer
Exercice 3 — cinquieme regime
Ajoutez un regime « orbital » (la source decrit un cercle a vitesse constante) dans V.source_trajectory. Objectif : predire si \(\hat{p}\) doit y gagner (mouvement periodique previsible) puis verifier.
Étape 1 : implementer le cercle dans source_trajectory (nouveau kind="orbital"). Étape 2 : lancer le banc regime_report("orbital") et comparer au verdict balistique.
# Exercice 3 : a completer# TODO etudiant : ajouter le kind "orbital" dans ict/valence.py::source_trajectory,# puis mesurer regime_report("orbital") et comparer au balistique.resultat_orbital =None# TODO etudiantprint("Exercice 3 a completer")
Exercice 3 a completer
Bilan – ICT-12 : la valence est un signal, pas une garantie (modèle interne payant ou ruineux ?)
Ce notebook installe un toy model intermediaire entre ICT-11 (profils d’agence multi-echelle) et ICT-13 (stratégies comme formes stables) : deux animats sur une source balistique dans un champ de valence (bosse gaussienne attractive a la source, repulsive aux obstacles, gradient analytique). La question : un modèle interne (anticipation \(\hat p\)) est-il payant ou ruineux face a un reactif a gradient instantane ? Reponse falsifiee gate par gate : regime-dependant, coherent avec le fil court depuis ICT-10.
Les 3 gates et leurs verdicts
Gate
Test
Verdict
Gate 1 (capture par regime)
Cadence de capture (precision poursuite)
Reactif gradient = baseline proche de l’optimal a vitesse attrapable ; \(\hat p\)ne la bat nulle part et perd en erratique
Lisible depuis la trajectoire seule ; la marche aleatoire (contrôle d’ablation) ne porte aucune signature de rôle
Gate 3 (anticipation 2D)
\(\hat p\) vs baselines adverses (persistance, MM, AR(1)) sur EQM position
Baselines avantagees in-sample ; \(\hat p\) doit battre des adversaires severes, pas des hommes de paille
La lecon centrale : un modèle interne ruineux en regime erratique
L’anticipation \(\hat p\)n’est pas universellement payante. Dans les regimes attrapables (vitesse source ~ animat), le reactif a gradient instantane est déjà proche de l’optimal – le cout d’entretenir un modèle interne (memoire, projection) n’est pas compense. C’est en regime erratique que le modèle interne perd : il projette sur une dynamique qui n’a plus de structure, et la prediction devient bruit. Le verdict est regime-dependant, comme tout le fil court depuis ICT-10.
Pourquoi le contrôle d’ablation importe (Gate 2)
Les quatre grandeurs de rôle ne sont valides que si la marche aleatoire (contrôle sans modèle ni gradient) n’en porte aucune signature. Si la marche aleatoire produisait un faux « rôle », les grandeurs mesureraient du bruit, pas de l’agentivite. Ce contrôle d’ablation est la preuve negative qui distingue un rôle emergent d’un artefact de trajectoire.
Lien avec le cursus
ICT-10 (Cran A, \(\hat p\) durci, verdict honnete « avantage regime-dependant ») : ICT-12 confirme et etend ce verdict au couple valence + rôle.
ICT-11 (agence multi-echelle) -> ICT-12 (valence + rôle sur banc balistique) -> ICT-13 (stratégies comme formes stables) : la serie passe de l’agence a la valence puis a la stratégie, toujours regime-dependante.
Un champ de valence + un modèle interne ne font pas un agent. La valence est un signal (gradient exploitable), pas une garantie de performance. Le verdict « payant ou ruineux » ne se declare qu’après avoir croise les regimes (4) et l’axe de vitesse, et confronte le modèle interne a des baselines adverses severes – pas a des hommes de paille.