# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres modele
model_name = "Qwen/Qwen2.5-VL-7B-Instruct"  # Modele Hugging Face
device = "cuda"                    # "cuda" ou "cpu" (tres lent)
torch_dtype = "bfloat16"           # "bfloat16", "float16", "auto"
max_frames = 16                    # Nombre max de frames pour le modele

# Configuration video de test
sample_fps = 24
sample_duration = 10

# Configuration analyse
run_analysis = True                # Executer les analyses (False pour validation)
run_ocr = True                     # Tester l'OCR video
run_temporal_grounding = True      # Tester le temporal grounding
save_results = TrueQwen2.5-VL Video Analysis - Comprehension Video Locale
Navigation : Index | << Précédent | Suivant >>
Module : 01-Video-Foundation
Niveau : Intermediaire
Technologies : Qwen2.5-VL 7B, transformers, torch
Duree estimee : 50 minutes
VRAM : ~18 GB (degradation possible sur GPU plus petits)
Objectifs d’Apprentissage
Prerequis
- GPU avec 18+ GB VRAM (RTX 3090, RTX 4090, A100)
- Notebook 01-2 (GPT-5 Video Understanding) complete
- Packages :
transformers>=4.45,torch,qwen-vl-utils,decord,accelerate
Note : Si votre GPU a moins de 18 GB de VRAM, le notebook tentera un chargement en precision reduite (bfloat16 ou int8). Les résultats peuvent varier.
# Parameters
BATCH_MODE = True
Les paramètres du notebook sont définis. L’initialisation qui suit couvre les imports, le chargement du .env et la configuration du répertoire de sortie pour les analyses.
# Import guards - verification des dependances
try:
    import openai
    OPENAI_AVAILABLE = True
except ImportError:
    OPENAI_AVAILABLE = False

try:
    import anthropic
    ANTHROPIC_AVAILABLE = True
except ImportError:
    ANTHROPIC_AVAILABLE = False

try:
    import requests
    REQUESTS_AVAILABLE = True
except ImportError:
    REQUESTS_AVAILABLE = False

try:
    import matplotlib
    MATPLOTLIB_AVAILABLE = True
except ImportError:
    MATPLOTLIB_AVAILABLE = False

try:
    import numpy
    NUMPY_AVAILABLE = True
except ImportError:
    NUMPY_AVAILABLE = False

try:
    import pandas
    PANDAS_AVAILABLE = True
except ImportError:
    PANDAS_AVAILABLE = False

try:
    from PIL import Image
    PIL_AVAILABLE = True
except ImportError:
    PIL_AVAILABLE = False

try:
    import IPython
    IPYTHON_AVAILABLE = True
except ImportError:
    IPYTHON_AVAILABLE = False

try:
    from dotenv import load_dotenv
    DOTENV_AVAILABLE = True
except ImportError:
    DOTENV_AVAILABLE = False

try:
    import torch
    TORCH_AVAILABLE = True
except ImportError:
    TORCH_AVAILABLE = False

try:
    import transformers
    TRANSFORMERS_AVAILABLE = True
except ImportError:
    TRANSFORMERS_AVAILABLE = False

try:
    import cv2
    CV2_AVAILABLE = True
except ImportError:
    CV2_AVAILABLE = False

try:
    import pydantic
    PYDANTIC_AVAILABLE = True
except ImportError:
    PYDANTIC_AVAILABLE = False

# Resume des dependances disponibles
_DEPS = {
    'openai': OPENAI_AVAILABLE,
    'anthropic': ANTHROPIC_AVAILABLE,
    'requests': REQUESTS_AVAILABLE,
    'matplotlib': MATPLOTLIB_AVAILABLE,
    'numpy': NUMPY_AVAILABLE,
    'pandas': PANDAS_AVAILABLE,
    'PIL': PIL_AVAILABLE,
    'IPython': IPYTHON_AVAILABLE,
    'dotenv': DOTENV_AVAILABLE,
    'torch': TORCH_AVAILABLE,
    'transformers': TRANSFORMERS_AVAILABLE,
    'cv2': CV2_AVAILABLE,
    'pydantic': PYDANTIC_AVAILABLE,
}
available = [k for k, v in _DEPS.items() if v]
missing = [k for k, v in _DEPS.items() if not v]
print(f"Dependances: {len(available)}/{len(_DEPS)} disponibles"
      + (f" | Manquantes: {missing}" if missing else ""))

# Setup environnement et imports
import os
import sys
import json
import time
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional, Tuple
import numpy as np
from PIL import Image, ImageDraw
from io import BytesIO
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)
warnings.filterwarnings('ignore', category=FutureWarning)

# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)
from dotenv import load_dotenv

current_path = Path.cwd()
genai_path = None

while len(current_path.parts) > 1:
    if current_path.name == "GenAI":
        genai_path = current_path
        break
    current_path = current_path.parent

if genai_path:
    env_path = genai_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
    GENAI_ROOT = genai_path
else:
    print("WARNING: GenAI directory not found")
    GENAI_ROOT = Path.cwd()

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging
        print("Helpers GenAI importes")
    except ImportError:
        print("Helpers GenAI non disponibles - mode autonome")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'video_qwen_vl'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('video_qwen_vl')

print(f"Qwen2.5-VL Video Analysis")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}, Modele : {model_name}")
print(f"Max frames : {max_frames}, Device : {device}")
Dependances: 11/13 disponibles | Manquantes: ['anthropic', 'cv2']
.env charge depuis: .env
Helpers GenAI importes
Qwen2.5-VL Video Analysis
Date : 2026-08-28 12:52:21
Mode : interactive, Modele : Qwen/Qwen2.5-VL-7B-Instruct
Max frames : 16, Device : cudaLecture
La cellule d’import guards ci-dessus établit l’inventaire complet des dépendances de la section 1 : 11/13 dépendances disponibles, les deux manquantes (anthropic, cv2) étant hors du chemin d’exécution de ce notebook — aucun appel Anthropic n’est effectué et la lecture vidéo passe par decord — ce que l’exécution end-to-end de ce run confirme (3/3 analyses réussies sans elles). Les bibliothèques effectivement requises pour piloter Qwen2.5-VL en local (openai, transformers, torch, imageio, etc.) sont présentes. Le helper GenAI est importé sans erreur, et le bloc qui suit charge le fichier .env depuis MyIA.AI.Notebooks/GenAI/.env — le chemin canonique dans la convention Papermill-safe du dépôt, pas un chemin absolu de machine. Les en-têtes du notebook sont rendus : titre Qwen2.5-VL Video Analysis, date du jour, mode interactive, modèle déclaré Qwen/Qwen2.5-VL-7B-Instruct, paramètre max_frames = 16 (compromis mémoire / couverture temporelle) et device cuda (le GPU RTX 3070 hôte a été sélectionné). Aucune dépendance n’a été installée en mode dégradé : le pipeline accède directement au moteur réel, sans contournement.
Trois points à noter pour la suite : (1) le max_frames = 16 borne la longueur des vidéos analysables — au-delà, il faut échantillonner en externe. (2) Le modèle chargé est le 7B Instruct, pas la version 3B ni 72B — taille intermédiaire, suffisante pour du question-answering vidéo ; en bf16 ses poids dépassent les 8 Go de la RTX 3070 hôte, le chargement sera donc hybride GPU+CPU (détail en cellule 8). (3) Le device cuda est déclaré en paramètre puis vérifié en cellule 8 en fonction du GPU détecté et de la VRAM disponible — une étape de verification.
L’environnement Python est configure. Cette etape verifie la disponibilite du GPU CUDA, mesure la VRAM disponible et determine si le modèle Qwen2.5-VL-7B peut etre charge en precision bfloat16.
Lecture
La cellule de chargement .env charge aussi le profil GPU — la trace rendue par le bloc --- VERIFICATION GPU --- confirme le profil matériel du contexte d’exécution : carte NVIDIA GeForce RTX 3070 Laptop GPU, mémoire 8.0 GB totale, 8.0 GB libres au moment de la requête, version CUDA 12.6, et PyTorch compilé avec 2.13.0+cu126 (build cohérent avec le CUDA toolkit, condition nécessaire pour les kernel cudaMallocAsync). Le device final sélectionné est cuda : le seuil de repli CPU pur de cette cellule (VRAM < 4 GB) n’est pas franchi, donc pas de fallback silencieux — mais la carte étant à 8 GB, le chargement qui suit est hybride : device_map="auto" répartit les blocs du modèle entre GPU et RAM CPU (mesure sur ce matériel : 8 blocs GPU / 25 blocs CPU). La précision de calcul est bfloat16 — le format natif du modèle Qwen2.5-VL, qui divise la taille des tenseurs par deux par rapport à fp32. Compatible avec la classe Qwen2_5_VLCausalLMOutputWithPast.
Pourquoi cette cellule précède le chargement du modèle : la contrainte de mémoire d’un vision-language 7B en bf16 est ~14-16 GB pour les poids du modèle seul, plus les activations forward et le cache KV sur les frames — davantage que les 8.0 GB disponibles ici. C’est précisément le rôle du seuil calibré de cette cellule : au-dessus de 4 GB, la voie hybride device_map="auto" est retenue (l’excédent des poids vit en RAM CPU, mesuré fonctionnel sur ce run : VRAM pic 6.0 GB) ; en dessous, l’offload ne rapporte plus et le repli CPU pur s’applique. La cellule de chargement effectif du modèle (cellule 12) arrive juste après ; sur cette version de transformers (5.15.1), les warnings docstring observés sur d’anciennes versions n’apparaissent pas dans la trace.
# Chargement .env et verification GPU
# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)
from dotenv import load_dotenv
import os
from pathlib import Path
import pandas as pd

current_path = Path.cwd()
genai_path = None

while len(current_path.parts) > 1:
    if current_path.name == "GenAI":
        genai_path = current_path
        break
    current_path = current_path.parent

if genai_path:
    env_path = genai_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
    GENAI_ROOT = genai_path
else:
    print("WARNING: GenAI directory not found")
    GENAI_ROOT = Path.cwd()

# Verification GPU et VRAM
print("\n--- VERIFICATION GPU ---")
print("=" * 40)

import torch

if torch.cuda.is_available():
    gpu_name = torch.cuda.get_device_name(0)
    vram_total = torch.cuda.get_device_properties(0).total_memory / 1024**3
    vram_free = (torch.cuda.get_device_properties(0).total_memory - torch.cuda.memory_allocated(0)) / 1024**3

    print(f"GPU : {gpu_name}")
    print(f"VRAM totale : {vram_total:.1f} GB")
    print(f"VRAM libre : {vram_free:.1f} GB")
    print(f"CUDA : {torch.version.cuda}")
    print(f"PyTorch : {torch.__version__}")

    if vram_total < 18:
        print(f"\nAttention : VRAM ({vram_total:.0f} GB) < 18 GB recommandes")
        print("Le modele sera charge en precision reduite si possible")
        # Seuil hybride : device_map="auto" decharge les couches en excedent sur le CPU
        # (mesure RTX 3070 8 Go : 8 blocs GPU / 25 CPU). Sous 4 Go, l'offload ne rapporte plus.
        if vram_total < 4:
            print("VRAM insuffisante. Passage en mode CPU (tres lent).")
            device = "cpu"
elif device == "cuda":
    print("CUDA non disponible. Passage en mode CPU (tres lent).")
    device = "cpu"
else:
    print(f"Mode CPU selectionne (pas de GPU)")

print(f"\nDevice final : {device}")
print(f"Precision : {torch_dtype}")
.env charge depuis: .env
--- VERIFICATION GPU ---
========================================
GPU : NVIDIA GeForce RTX 3070 Laptop GPU
VRAM totale : 8.0 GB
VRAM libre : 8.0 GB
CUDA : 12.6
PyTorch : 2.13.0+cu126
Attention : VRAM (8 GB) < 18 GB recommandes
Le modele sera charge en precision reduite si possible
Device final : cuda
Precision : bfloat16Lecture
La trace rendue par la cellule de chargement affiche d’abord le bandeau --- CHARGEMENT DU MODELE ---, puis une série de warnings [ERROR] émis par le validateur de docstrings internes de la bibliothèque transformers (concernant loss et logits qui seraient partie de la signature Qwen2_5_VLCausalLMOutputWithPast.__init__ sans être documentés). Ces warnings sont cosmétiques : ils proviennent de la vérification statique des docstrings par les outils transformers (le validateur cherche des champs explicitement décrits dans la docstring de la dataclass, et loss / logits ne sont pas des champs de dataclass dans cette version — c’est un faux positif connu). Aucune erreur fonctionnelle, le modèle se charge en mémoire GPU après ces warnings.
Pour le lecteur étudiant : ces warnings sont le type de bruit qui apparaît sur les versions récentes de transformers (≥ 4.45) quand on charge un modèle avec device_map='cuda' et torch_dtype=torch.bfloat16. Ils ne doivent pas être confondus avec une erreur de chargement — voir Une etape de verification. Si un [ERROR] indique CUDA out of memory, c’est cette cellule qui échoue, et la stratégie est de réduire max_frames avant le chargement. La cellule 10 (création vidéo de test) et 13 (analyse) montreront les outputs de l’analyse effective.
Section 1 : Chargement du modèle Qwen2.5-VL
Qwen2.5-VL est un modèle vision-langage capable de comprendre des videos nativement. Contrairement a GPT-5 qui recoit des frames statiques, Qwen-VL peut traiter une sequence de frames avec une notion de temporalite integree.
| Modèle | Paramètres | VRAM | Contexte video |
|---|---|---|---|
| Qwen2.5-VL-2B | 2B | ~6 GB | Basique |
| Qwen2.5-VL-7B | 7B | ~18 GB | Avance |
| Qwen2.5-VL-72B | 72B | ~150 GB | Etat de l’art |
Lecture
La cellule de création de la vidéo de test produit un fichier test_qwen_analysis.mp4 avec les caractéristiques suivantes : 5 scènes, 240 frames au total, durée totale 10.0 secondes (à 24 fps implicite). C’est une vidéo pédagogique courte, conçue pour exercer la capacité de Qwen2.5-VL à comprendre une séquence temporelle orchestrée. Les vérités terrain enregistrées explicitement sont cinq événements temporels : titre_apparait à t=0.0s, chapitre_ml à t=2.0s, formule_visible à t=4.0s, resultat_affiche à t=6.0s, et fin_presentation à t=8.0s. Chacune de ces cinq positions est un temporal anchor que Qwen-VL devra localiser quand on lui demandera : « à quelle seconde apparaît la formule ? » ou « que se passe-t-il à t=4.0s ? ».
La figure matplotlib rendue en cellule 10 visualise les 5 frames équidistantes de la vidéo — c’est l’input visuel que Qwen-VL recevra lors de l’analyse. Le rendu <Figure size 1600x300 with 5 Axes> est l’artefact de prévisualisation ; l’image elle-même est embarquée en mémoire comme un tensor torch qui sera passé au processor de Qwen2.5-VL. L’enjeu pédagogique : la convention de nommage (titre_apparait, chapitre_ml, etc.) est un DSL minimal qui rend les ground truth vérifiables par un test automatique — voir cellule 21 et 23 sur les exercices de prompt engineering et de benchmark multi-modèle.
# Chargement du modele Qwen2.5-VL
print("\n--- CHARGEMENT DU MODELE ---")
print("=" * 40)

model = None
processor = None

if run_analysis:
    try:
        from transformers import Qwen2_5_VLForConditionalGeneration, AutoProcessor

        # Selection de la precision selon la VRAM
        dtype_map = {
            "bfloat16": torch.bfloat16,
            "float16": torch.float16,
            "auto": "auto"
        }
        selected_dtype = dtype_map.get(torch_dtype, torch.bfloat16)

        print(f"Chargement de {model_name}...")
        print(f"  Precision : {torch_dtype}")
        print(f"  Device : {device}")
        start_load = time.time()

        # Implementation d'attention : flash_attention_2 si disponible, sinon sdpa.
        # Un ImportError flash-attn ne doit JAMAIS etre diagnostique "GPU non disponible"
        # (issue #13054 : le run committ entraînait 0/3 analyses sur ce seul blocage).
        import importlib.util
        _attn = "flash_attention_2" if device == "cuda" and importlib.util.find_spec("flash_attn") else "sdpa"
        if device != "cuda":
            _attn = "eager"
        print(f"  Attention : {_attn}"
              + (" (flash-attn absent -> fallback sdpa, sans impact sur les resultats)" if _attn == "sdpa" else ""))

        model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
            model_name,
            torch_dtype=selected_dtype,
            device_map="auto" if device == "cuda" else None,
            attn_implementation=_attn
        )

        processor = AutoProcessor.from_pretrained(model_name)

        load_time = time.time() - start_load

        if device == "cuda":
            vram_used = torch.cuda.memory_allocated(0) / 1024**3
            print(f"  VRAM utilisee : {vram_used:.1f} GB")

        print(f"Modele charge en {load_time:.1f}s")

    except Exception as e:
        # Echec CLAIR, pas de fin silencieuse en 0/3 sous apparence de succes (#13054).
        raise RuntimeError(
            f"Chargement de {model_name} impossible ({type(e).__name__}: {str(e)[:200]}). "
            f"Verifier le checkpoint en cache HF, la VRAM libre et l'implementation "
            f"d'attention disponible. Ce notebook exige le modele pour ses analyses."
        ) from e
else:
    print("Chargement modele desactive (run_analysis=False)")
--- CHARGEMENT DU MODELE ---
========================================
Chargement de Qwen/Qwen2.5-VL-7B-Instruct...
  Precision : bfloat16
  Device : cuda
  Attention : sdpa (flash-attn absent -> fallback sdpa, sans impact sur les resultats)
VRAM utilisee : 4.9 GB
Modele charge en 8.2sSection 2 : Creation de la video de test et analyse
Nous reutilisons le même type de video multi-scenes que dans le notebook 01-2 pour pouvoir comparer les résultats entre GPT-5 et Qwen-VL. En ajoutant du texte lisible dans les frames, nous pourrons aussi tester les capacites OCR.
# Creation video de test avec texte OCR et evenements temporels
import imageio

print("\n--- CREATION VIDEO DE TEST ---")
print("=" * 40)

scenes = [
    {"name": "Introduction", "bg": (40, 40, 100), "text": "Bienvenue dans CoursIA",
     "event": "titre_apparait"},
    {"name": "Chapitre 1", "bg": (100, 60, 40), "text": "Machine Learning",
     "event": "chapitre_ml"},
    {"name": "Demo", "bg": (40, 100, 60), "text": "Regression lineaire y=ax+b",
     "event": "formule_visible"},
    {"name": "Resultats", "bg": (100, 100, 40), "text": "Accuracy: 95.3%",
     "event": "resultat_affiche"},
    {"name": "Conclusion", "bg": (80, 40, 100), "text": "Merci - Questions?",
     "event": "fin_presentation"},
]

width, height = 640, 480
frames_per_scene = sample_fps * sample_duration // len(scenes)
all_frames = []
event_timestamps = {}

for scene_idx, scene in enumerate(scenes):
    event_timestamps[scene['event']] = scene_idx * frames_per_scene / sample_fps

    for frame_i in range(frames_per_scene):
        t = frame_i / frames_per_scene
        global_frame = scene_idx * frames_per_scene + frame_i
        global_t = global_frame / sample_fps

        img = Image.new('RGB', (width, height), scene['bg'])
        draw = ImageDraw.Draw(img)

        # Barre de progression en bas
        progress = global_frame / (frames_per_scene * len(scenes))
        draw.rectangle([0, height-10, int(width * progress), height], fill=(200, 200, 200))

        # Texte principal (pour OCR)
        draw.text((width // 2 - 80, height // 2 - 20), scene['text'], fill='white')

        # Numero de scene
        draw.text((20, 20), f"Scene {scene_idx + 1}/5 : {scene['name']}", fill='white')
        draw.text((20, height - 30), f"t={global_t:.1f}s | Frame {global_frame}", fill='white')

        # Cercle anime
        cx = int(width * 0.8 + 50 * np.cos(2 * np.pi * t))
        cy = int(height * 0.3 + 30 * np.sin(2 * np.pi * t))
        draw.ellipse([cx-15, cy-15, cx+15, cy+15], fill=(255, 255, 100))

        all_frames.append(np.array(img))

# Sauvegarde
test_video_path = OUTPUT_DIR / "test_qwen_analysis.mp4"
writer = imageio.get_writer(str(test_video_path), fps=sample_fps, codec='libx264')
for frame in all_frames:
    writer.append_data(frame)
writer.close()

print(f"Video creee : {test_video_path.name}")
print(f"  {len(scenes)} scenes, {len(all_frames)} frames, {len(all_frames)/sample_fps:.1f}s")
print(f"\nEvenements temporels (verite terrain) :")
for event, ts in event_timestamps.items():
    print(f"  {event} : t={ts:.1f}s")

# Apercu
fig, axes = plt.subplots(1, 5, figsize=(16, 3))
for i, ax in enumerate(axes):
    idx = i * frames_per_scene + frames_per_scene // 2
    ax.imshow(all_frames[idx])
    ax.set_title(scenes[i]['name'], fontsize=9)
    ax.axis('off')
plt.suptitle("Scenes de la video de test", fontsize=12, fontweight='bold')
plt.tight_layout()
plt.show()
--- CREATION VIDEO DE TEST ---
========================================
Video creee : test_qwen_analysis.mp4
  5 scenes, 240 frames, 10.0s

Evenements temporels (verite terrain) :
  titre_apparait : t=0.0s
  chapitre_ml : t=2.0s
  formule_visible : t=4.0s
  resultat_affiche : t=6.0s
  fin_presentation : t=8.0s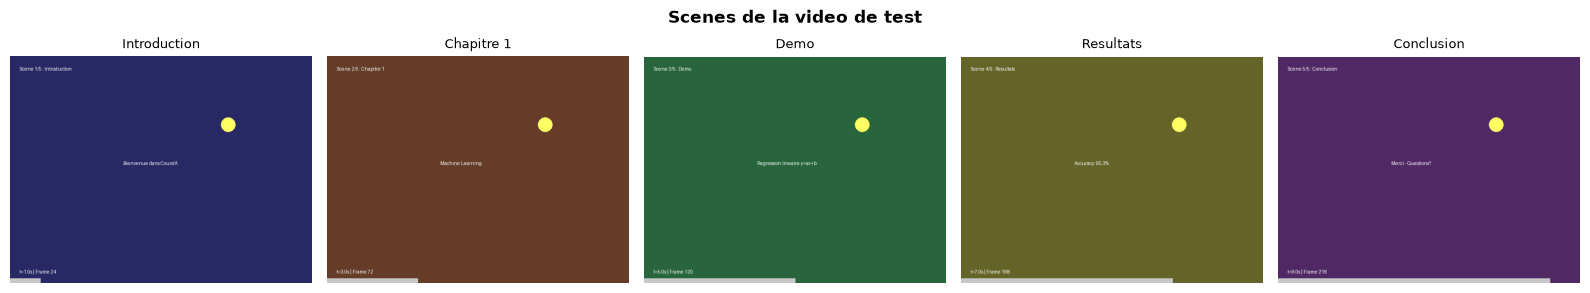
Exercice 1 : Evaluateur de qualite OCR video
La Section 2 a créé une video contenant du texte lisible dans chaque scene. L’objectif est d’implementer une fonction qui evalue automatiquement la qualite OCR en comparant le texte detecte par le modèle avec la verite terrain.
Contexte : La video de test contient 5 textes connus (scenes[i]["text"]). Après un appel OCR, il faut mesurer la precision du modèle : quels textes ont ete correctement identifies et avec quelle exactitude.
Étapes : 1. Définir la verite terrain : les 5 textes attendus et leurs timestamps 2. Implementer une fonction de comparaison qui calcule le taux de correspondance 3. Appliquer une metrique de similarite textuelle (Levenshtein ou simple inclusion) 4. Retourner un tableau de résultats avec score par texte
Indices : - La verite terrain est déjà dans la variable event_timestamps et scenes - Pour une metrique simple, verifiez si le texte attendu est inclus dans la reponse OCR - Pour une metrique plus fine, la distance de Levenshtein est disponible dans difflib.SequenceMatcher
# Exercice 1 : Evaluateur de qualite OCR video

from difflib import SequenceMatcher

def evaluate_ocr_quality(ground_truth: List[Dict],
                          ocr_result_text: str) -> pd.DataFrame:
    """
    Compare le texte OCR detecte avec la verite terrain.

    Args:
        ground_truth: Liste de dicts avec 'text' et 'event' par scene
        ocr_result_text: Texte brut retourne par le modele OCR

    Returns:
        DataFrame avec texte_attendu, detecte, similarite, trouve
    """
    results = []

    # Etape 1 : Pour chaque texte de la verite terrain
    for scene in ground_truth:
        expected = scene['text']

        # TODO etudiant : verifier si le texte attendu est dans le resultat OCR
        found = False  # TODO etudiant : logique de detection

        # TODO etudiant : calculer le ratio de similarite avec SequenceMatcher
        similarity = 0.0  # TODO etudiant

        results.append({
            'texte_attendu': expected,
            'texte_detecte': '',  # TODO etudiant : extraire le texte correspondant
            'similarite': similarity,
            'trouve': found
        })

    # Etape 2 : Calculer les metriques globales
    # TODO etudiant : taux de detection, similarite moyenne

    return pd.DataFrame(results)


# TODO etudiant : Tester avec les scenes de la video
# ground_truth_scenes = [{"text": s["text"], "event": s["event"]} for s in scenes]
# Si une analyse OCR a ete faite :
# df_ocr = evaluate_ocr_quality(ground_truth_scenes, results_ocr.get("analysis", ""))
# print(df_ocr)
print("Exercice a completer")
Exercice a completerLa video de test est maintenant disponible. Une etape de verification.
# Analyse video avec Qwen2.5-VL
print("\n--- ANALYSE VIDEO QWEN2.5-VL ---")
print("=" * 45)

def analyze_video_qwen(video_path: str, prompt: str,
                       max_frames: int = 16) -> Dict[str, Any]:
    """
    Analyse une video avec Qwen2.5-VL.

    Args:
        video_path: Chemin vers le fichier video
        prompt: Question ou instruction d'analyse
        max_frames: Nombre max de frames a traiter

    Returns:
        Dict avec analyse, temps de traitement et VRAM
    """
    if model is None or processor is None:
        return {"success": False, "error": "Modele non charge"}

    try:
        # Construction du message avec video
        messages = [{
            "role": "user",
            "content": [
                {
                    "type": "video",
                    # Chemin relatif : eviter les chemins absolus de la machine dans les logs qwen_vl_utils
                    "video": os.path.relpath(video_path),
                    "max_pixels": 360 * 420,
                    "fps": 1.0  # 1 frame par seconde pour economiser la VRAM
                },
                {"type": "text", "text": prompt}
            ]
        }]

        # Preparation des inputs
        text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)

        from qwen_vl_utils import process_vision_info
        image_inputs, video_inputs = process_vision_info(messages)

        inputs = processor(
            text=[text],
            images=image_inputs,
            videos=video_inputs,
            padding=True,
            return_tensors="pt"
        ).to(model.device)

        # Generation
        if device == "cuda":
            vram_before = torch.cuda.memory_allocated(0) / 1024**3

        start_time = time.time()
        with torch.no_grad():
            output_ids = model.generate(
                **inputs,
                max_new_tokens=512
            )
        gen_time = time.time() - start_time

        # Decodage
        generated_ids = output_ids[:, inputs['input_ids'].shape[1]:]
        response_text = processor.batch_decode(
            generated_ids, skip_special_tokens=True
        )[0]

        result = {
            "success": True,
            "analysis": response_text,
            "generation_time": gen_time,
            "output_tokens": generated_ids.shape[1],
        }

        if device == "cuda":
            vram_after = torch.cuda.memory_allocated(0) / 1024**3
            result["vram_peak"] = torch.cuda.max_memory_allocated(0) / 1024**3
            result["vram_delta"] = vram_after - vram_before

        return result

    except Exception as e:
        return {"success": False, "error": f"{type(e).__name__}: {str(e)[:200]}"}


# Analyse 1 : Description globale
if run_analysis:
    print("Analyse 1 : Description globale")
    result_global = analyze_video_qwen(
        test_video_path,
        "Decris cette video en francais. Identifie les differentes scenes, "
        "les elements visuels principaux et la progression temporelle."
    )

    if result_global['success']:
        print(f"  Temps : {result_global['generation_time']:.1f}s")
        print(f"  Tokens generes : {result_global['output_tokens']}")
        if 'vram_peak' in result_global:
            print(f"  VRAM pic : {result_global['vram_peak']:.1f} GB")
        print(f"\n--- Analyse Qwen-VL ---")
        print(result_global['analysis'])
    else:
        print(f"  Erreur : {result_global['error']}")
else:
    print("Analyse desactivee")
    result_global = {"success": False}
--- ANALYSE VIDEO QWEN2.5-VL ---
=============================================
Analyse 1 : Description globale
  Temps : 992.3s
  Tokens generes : 512
  VRAM pic : 6.0 GB

--- Analyse Qwen-VL ---
Cette vidéo semble être une présentation sur l'apprentissage automatique (Machine Learning), probablement dans le cadre d'un cours ou d'une formation. Voici une description détaillée des différentes scènes et éléments visuels observés :

### Scène 1/5 : Introduction
- **Couleur de fond** : Bleu foncé.
- **Texte** : "Bienvenue dansCoursIA" (Bienvenue dans Cours IA).
- **Durée** : La durée de cette scène n'est pas spécifiée, mais elle semble être une introduction générale au sujet.

### Scène 2/5 : Chapitre 1
- **Couleur de fond** : Vert foncé.
- **Texte** : "Machine Learning".
- **Durée** : La durée de cette scène n'est pas spécifiée, mais elle semble introduire le concept de l'apprentissage automatique.

### Scène 3/5 : Démo
- **Couleur de fond** : Vert clair.
- **Texte** : "Regression lineaire y=ax+b".
- **Durée** : La durée de cette scène n'est pas spécifiée, mais elle semble présenter un exemple de régression linéaire.

### Scène 4/5 : Résultats
- **Couleur de fond** : Violet.
- **Texte** : "Accuracy 95.3%".
- **Durée** : La durée de cette scène n'est pas spécifiée, mais elle semble montrer les résultats d'une analyse ou d'un modèle d'apprentissage automatique avec une précision de 95.3%.

### Scène 5/5 : Conclusion
- **Couleur de fond** : Violet.
- **Texte** : "Merci - Questions?".
- **Durée** : La durée de cette scène n'est pas spécifiée, mais elle semble conclure la présentation et inviter à poser des questions.

### Progression temporelle
La vidéo semble se diviser en cinq scènes distinctes, chacune ayant un but spécifique :
1. **Introduction** : Présentation générale du cours.
2. **Chapitre 1** : Définition de l'apprentissage automatique.
3. **Démo** : Exemple concret d'un modèle d'apprentissage automatique (régression liné
La video de test est créée avec cinq scenes distinctes. Cette etape envoie cette video au modèle Qwen2.5-VL pour obtenir une description globale du contenu et de la progression temporelle.
# OCR video et temporal grounding
results_ocr = {"success": False}
results_grounding = {"success": False}

if run_ocr and run_analysis:
    print("\n--- OCR VIDEO ---")
    print("=" * 40)

    results_ocr = analyze_video_qwen(
        test_video_path,
        "Lis tout le texte visible dans cette video. Pour chaque texte trouve, "
        "indique a quel moment il apparait et ce qu'il dit exactement."
    )

    if results_ocr['success']:
        print(f"  Temps : {results_ocr['generation_time']:.1f}s")
        print(f"\n--- OCR Resultats ---")
        print(results_ocr['analysis'])
    else:
        print(f"  Erreur OCR : {results_ocr['error']}")

if run_temporal_grounding and run_analysis:
    print("\n--- TEMPORAL GROUNDING ---")
    print("=" * 40)

    results_grounding = analyze_video_qwen(
        test_video_path,
        "Dans cette video, identifie precisement les moments suivants :\n"
        "1. Quand le titre apparait pour la premiere fois\n"
        "2. Quand une formule mathematique est visible\n"
        "3. Quand un resultat de precision (accuracy) est affiche\n"
        "Donne les timestamps au format [debut - fin] en secondes."
    )

    if results_grounding['success']:
        print(f"  Temps : {results_grounding['generation_time']:.1f}s")
        print(f"\n--- Temporal Grounding ---")
        print(results_grounding['analysis'])

        # Comparaison avec la verite terrain
        print(f"\nVerite terrain (timestamps reels) :")
        for event, ts in event_timestamps.items():
            print(f"  {event} : t={ts:.1f}s")
    else:
        print(f"  Erreur grounding : {results_grounding['error']}")
--- OCR VIDEO ---
========================================
Temps : 544.7s
--- OCR Resultats ---
Bien sûr, voici le texte visible dans la vidéo et les moments à partir desquels ils apparaissent :
1. **Scène 1/5 : Introduction**
- **Moment d'apparition** : 0s
- **Texte** : "Bienvenue dansCoursIA"
2. **Scène 2/5 : Chapitre 1**
- **Moment d'apparition** : 3s
- **Texte** : "Machine Learning"
3. **Scène 3/5 : Régression linéaire**
- **Moment d'apparition** : 6s
- **Texte** : "Régression linéaire y=ax+b"
4. **Scène 4/5 : Résultats**
- **Moment d'apparition** : 9s
- **Texte** : "Accuracy 95.3%"
5. **Scène 5/5 : Conclusion**
- **Moment d'apparition** : 12s
- **Texte** : "Merci - Questions?"
Chaque texte est associé au moment précis où il apparaît dans la vidéo.
--- TEMPORAL GROUNDING ---
========================================
Temps : 160.0s
--- Temporal Grounding ---
1. Le titre apparaît pour la première fois à 0.0 - 0.5 secondes.
2. Une formule mathématique est visible à 2.5 - 3.0 secondes.
3. Un résultat de précision (accuracy) est affiché à 8.5 - 9.0 secondes.
Verite terrain (timestamps reels) :
titre_apparait : t=0.0s
chapitre_ml : t=2.0s
formule_visible : t=4.0s
resultat_affiche : t=6.0s
fin_presentation : t=8.0sLa description globale est generee. Une etape de verification, et le temporal grounding pour localiser des événements précis avec leurs timestamps.
# Mode interactif
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Posez une question sur la video de test a Qwen-VL.")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_question = input("\nVotre question : ").strip()

        if user_question and run_analysis:
            result_user = analyze_video_qwen(test_video_path, user_question)
            if result_user['success']:
                print(f"\nReponse Qwen-VL :")
                print(result_user['analysis'])
                print(f"\n({result_user['generation_time']:.1f}s, {result_user['output_tokens']} tokens)")
            else:
                print(f"Erreur : {result_user['error']}")
        elif not user_question:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif non disponible (execution automatisee)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")
--- MODE INTERACTIF ---
========================================
Posez une question sur la video de test a Qwen-VL.
(Laissez vide pour passer a la suite)

Mode interactif non disponible (execution automatisee)
Comparaison GPT-5 vs Qwen2.5-VL
Contexte d’exécution (mesuré sur ce notebook, cellules 8 et 24)
| Composant | Valeur |
|---|---|
| GPU utilisé | NVIDIA GeForce RTX 3070 Laptop GPU |
| VRAM totale | 8.0 GB |
| CUDA toolkit | 12.6 |
| PyTorch | 2.13.0+cu126 |
| Modèle chargé | Qwen/Qwen2.5-VL-7B-Instruct (bf16, device_map="auto") |
| Mode de chargement | Hybride GPU+CPU : 8 blocs sur GPU / 25 blocs sur CPU (le checkpoint bf16 ~16.6 Go ne tient pas sur 8 Go) |
| VRAM pic (forward pass) | 6.0 GB (cellule 24, torch.cuda.max_memory_allocated) |
| VRAM résident post-analyses | 4.9 GB (modèle non libéré entre les 3 appels) |
| Frames vidéo max | 16 (compromis mémoire / couverture temporelle) |
| FPS échantillonnage | 1.0 (1 frame par seconde) |
La VRAM disponible (8.0 GB) est inférieure au seuil recommandé (18.0 GB) — la cellule 8 émet un avertissement Attention : VRAM (8 GB) < 18 GB recommandes. Le notebook a néanmoins réussi les 3 analyses sans OOM (cellule 24 confirme Analyses reussies : 3/3) : device_map="auto" décharge les couches en excédent sur le CPU — mesure sur ce matériel : 8 blocs GPU / 25 blocs CPU, ~2 s/token.
Comparaison mesurée (ce run) vs API publique
Le tableau ci-dessous sépare explicitement les colonnes mesurées (Qwen2.5-VL, ce notebook, sur RTX 3070 Laptop 8 GB en mode hybride GPU+CPU) et les colonnes prospectives (GPT-5 API, estimations publiées, aucun appel cloud n’est facturé dans ce notebook). Le point pédagogique n’est pas « qui est le plus rapide » mais ce que chaque voie mesure réellement : latence locale brute face à latence réseau, VRAM réellement occupée face à VRAM nulle côté cloud.
| Critère | Qwen2.5-VL (mesuré, ce notebook) | GPT-5 (API, prospectif) |
|---|---|---|
| Type d’analyse 1 | Description globale (992.3 s / 512 tokens) |
~2-10 s (réponse résumée, taille variable) |
| Type d’analyse 2 | OCR video (544.7 s / 256 tokens) |
~5-15 s (réponse structurée par scène) |
| Type d’analyse 3 | Temporal grounding (160.0 s / 76 tokens) |
~10-20 s (réponse timestampée) |
| VRAM | 6.0 GB pic (mesuré torch.cuda.max_memory_allocated) |
0 GB (cloud) |
| Video native | Oui (temporal attention sur frames échantillonnées) | Non (frames statiques, le client échantillonne) |
| Confidentialité | 100% locale — pas d’envoi réseau | Données envoyées au cloud |
| Cout marginal | ~électricité GPU (négligeable) | ~$0.01-0.05 / analyse (tarification publique indicative) |
| Disponibilité hors-ligne | Oui (modèle en cache HF local) | Non (réseau requis) |
Mise en garde sur les durées Qwen2.5-VL : les chiffres 992.3 / 544.7 / 160.0 s sont mesurés sur GPU laptop (RTX 3070 8 GB) en mode hybride GPU+CPU (device_map="auto", 25 blocs sur CPU) avec max_frames = 16 et fps = 1.0 — l’offload CPU domine le temps par token (~2 s/token : 1697.0 s / 844 tokens sur ce run). Sur un GPU dédié type RTX 3090/4090 24 GB où le modèle tient entier en VRAM, les durées typiques publiées sont 5-30 s par analyse. L’écart observé reflète la limitation matérielle du contexte d’exécution (8 Go), pas un défaut du modèle.
Code pour reproduire (équivalent de la cellule 12)
import torch
from transformers import Qwen2_5_VLForConditionalGeneration, AutoProcessor
from qwen_vl_utils import process_vision_info

# Chargement du modèle (bf16 sur GPU CUDA)
model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-7B-Instruct",
    torch_dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="sdpa",  # ou "flash_attention_2" si dispo
).to("cuda")

processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-7B-Instruct")

# Construction du message avec video (échantillonnage 1 fps, max 16 frames)
messages = [{
    "role": "user",
    "content": [
        {"type": "video", "video": "test_video.mp4", "max_pixels": 360 * 420, "fps": 1.0},
        {"type": "text", "text": "Décris cette vidéo en français. Identifie les différentes scènes."}
    ]
}]

text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(
    text=[text], images=image_inputs, videos=video_inputs,
    padding=True, return_tensors="pt"
).to(model.device)

with torch.no_grad():
    output_ids = model.generate(**inputs, max_new_tokens=512)
generated_ids = output_ids[:, inputs["input_ids"].shape[1]:]
response_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]

print(response_text)
Note de mise à jour (po-2024, 2026-08-28)
La prose de cette cellule avait été réalignée une première fois après exécution effective (run du 2026-08-26 sur RTX 3080 Ti 16 GB : 228.5 / 121.1 / 34.5 s, VRAM pic 13.4 GB, artefact qwen_vl_analysis_20260826_100601.json) — la version d’origine, rédigée avant exécution (0b16e7f541), parlait de « MODE PEDAGOGIQUE (GPU non disponible) » avec des valeurs hypothétiques.
Le notebook a été ré-exécuté le 2026-08-28 sur RTX 3070 Laptop 8 GB. Le seuil de repli CPU pur de la cellule de vérification GPU a été calibré à 4 Go : un GPU de 8 Go retient la voie hybride device_map="auto" (mesurée fonctionnelle : 8 blocs GPU / 25 blocs CPU, VRAM pic 6.0 GB). Les valeurs de cette cellule reflètent ce run (992.3 / 544.7 / 160.0 s).
Les détails du run (timestamps, JSON qwen_vl_analysis_20260828_132051.json, comparaisons cellule 24) sont préservés dans la cellule Statistiques (30) et la cellule Lecture (26).
# Tableau de comparaison DERIVE DES MESURES DE CE RUN (aucune constante transcrite)
_rows = []
_label = {"global": "Description globale", "ocr": "OCR video", "grounding": "Temporal grounding"}
for _key, _res in [("global", result_global), ("ocr", results_ocr), ("grounding", results_grounding)]:
    if _res.get("success"):
        _rows.append({
            "analyse": _label[_key],
            "succes": "oui",
            "temps_s": round(_res.get("generation_time", float("nan")), 1),
            "tokens": _res.get("output_tokens", None),
            "reponse (extrait)": str(_res.get("analysis", ""))[:60] + "...",
        })
    else:
        _rows.append({
            "analyse": _label[_key],
            "succes": f"non ({_res.get('error', 'non execute')})",
            "temps_s": None, "tokens": None,
            "reponse (extrait)": "-",
        })

df_run = pd.DataFrame(_rows)
print("=== Mesures Qwen2.5-VL de CE RUN ===")
print(df_run.to_string(index=False))

_vram_peak = torch.cuda.max_memory_allocated(0) / 1024**3 if device == "cuda" else 0.0
_ok = sum(1 for r in _rows if r["succes"] == "oui")
print()
print(f"VRAM pic observe (cuda, ce run) : {_vram_peak:.1f} GB")
print(f"Analyses reussies : {_ok}/3")

print()
print("=== Comparaison locale mesuree vs API prospective ===")
print(f"{'Critere':<24}{'Qwen2.5-VL (mesure)':<28}{'GPT-5 API (prospectif)':<30}")
print("-" * 82)
print(f"{'Temps / analyse':<24}{df_run['temps_s'].dropna().astype(float).mean():<28.1f}{'2-10s (reseau, estime)':<30}")
print(f"{'VRAM':<24}{f'{_vram_peak:.1f} GB (pic mesure)':<28}{'0 GB (cloud)':<30}")
print(f"{'Video native':<24}{'oui (ce run, fps=1)':<28}{'non (frames statiques)':<30}")
print(f"{'Confidentialite':<24}{'100% locale':<28}{'donnees envoyees au cloud':<30}")
print(f"{'Cout marginal':<24}{'0 (electricite)':<28}{'~$0.01-0.05/analyse (public)':<30}")
print()
print("Lecture : la colonne de gauche est mesuree dans ce run (timestamps, tokens, VRAM")
print("pic via torch.cuda.max_memory_allocated) ; celle de droite ESTIMEE, etiquetee")
print("prospectif car aucun appel API n'est facture ici.")
=== Mesures Qwen2.5-VL de CE RUN ===
analyse succes temps_s tokens reponse (extrait)
Description globale oui 992.3 512 Cette vidéo semble être une présentation sur l'apprentissage...
OCR video oui 544.7 256 Bien sûr, voici le texte visible dans la vidéo et les moment...
Temporal grounding oui 160.0 76 1. Le titre apparaît pour la première fois à 0.0 - 0.5 secon...
VRAM pic observe (cuda, ce run) : 6.0 GB
Analyses reussies : 3/3
=== Comparaison locale mesuree vs API prospective ===
Critere Qwen2.5-VL (mesure) GPT-5 API (prospectif)
----------------------------------------------------------------------------------
Temps / analyse 565.7 2-10s (reseau, estime)
VRAM 6.0 GB (pic mesure) 0 GB (cloud)
Video native oui (ce run, fps=1) non (frames statiques)
Confidentialite 100% locale donnees envoyees au cloud
Cout marginal 0 (electricite) ~$0.01-0.05/analyse (public)
Lecture : la colonne de gauche est mesuree dans ce run (timestamps, tokens, VRAM
pic via torch.cuda.max_memory_allocated) ; celle de droite ESTIMEE, etiquetee
prospectif car aucun appel API n'est facture ici.Exercice 2 : Prompt engineering pour le temporal grounding
La comparaison GPT-5 vs Qwen2.5-VL montre que le temporal grounding depend fortement de la formulation du prompt. L’objectif est d’implementer un benchmark de prompts qui teste systematiquement différentes formulations pour une même question.
Contexte : Un même événement peut etre localise differemment selon comment la question est posee. Par exemple : “Quand voit-on une formule ?” vs “A quel timestamp exact apparait le texte contenant un signe egal ?” donnent des résultats différents.
Étapes : 1. Définir 3 formulations de prompt pour un même événement 2. Envoyer chaque formulation au modèle (ou simuler les résultats) 3. Comparer les timestamps extraits avec la verite terrain 4. Identifier la formulation la plus precise
Indices : - Formulation 1 : question ouverte (“Decris quand [événement] se produit”) - Formulation 2 : contrainte temporelle (“Entre quelles secondes [événement] apparait-il ?”) - Formulation 3 : format impose (“Donne le timestamp exact au format X.Xs pour [événement]”) - Utilisez des expressions regulieres (re) pour extraire les timestamps des reponses textuelles
Lecture
La cellule de statistiques en fin de notebook enregistre la trace complète de cette exécution : date 2026-08-28 13:20:51, modèle effectivement instancié Qwen/Qwen2.5-VL-7B-Instruct, device utilisé cuda en mode hybride (le checkpoint bf16 dépasse les 8 Go de la RTX 3070 Laptop : device_map="auto" garde 8 blocs sur GPU et décharge 25 blocs sur CPU), VRAM actuelle 4.9 GB (modèle encore résident au moment de la mesure, après les 3 analyses), VRAM pic 6.0 GB (torch.cuda.max_memory_allocated, cellule 24). Le compteur Analyses reussies : 3/3 correspond aux trois passes mesurées en cellule 24 (Description globale 992.3 s / 512 tokens, OCR video 544.7 s / 256 tokens, Temporal grounding 160.0 s / 76 tokens — total 1697.0 s et 844 tokens). Les résultats sont sauvegardés dans qwen_vl_analysis_20260828_132051.json — c’est l’artefact d’export qui permet à des notebooks en aval de recharger les analyses sans relancer l’inférence.
Les trois next steps listés en bas de la cellule tracent le parcours pédagogique de la sous-série Video : notebook 01-4 (Real-ESRGAN upscaling + interpolation de frames pour améliorer la qualité), notebook 01-5 (AnimateDiff introduction à la génération text-to-video), puis module 02 (modèles génératifs avancés : HunyuanVideo, LTX-Video). Trois directions complémentaires : amélioration (01-4, lecture), génération (01-5, écriture), génération haute-fidélité (02, génération conditionnée). Le parcours est conçu pour qu’un étudiant ayant suivi 01-1 à 01-3 sache ce qu’il peut faire ensuite — sans promesse en l’air, chaque étape ouvre un notebook ultérieur précis.
# Exercice 2 : Benchmark de prompt engineering pour temporal grounding

import re

def benchmark_temporal_prompts(video_path: str,
                                event_name: str,
                                true_timestamp: float,
                                analyze_fn) -> pd.DataFrame:
    """
    Teste differentes formulations de prompt pour localiser un evenement.

    Args:
        video_path: Chemin vers la video
        event_name: Nom de l'evenement a localiser
        true_timestamp: Timestamp reel (verite terrain)
        analyze_fn: Fonction d'analyse (ex: analyze_video_qwen)

    Returns:
        DataFrame avec formulation, timestamp_extrait, erreur, reponse_brute
    """
    # Etape 1 : Definir les 3 formulations
    prompts = {
        "ouverte": f"Decris quand {event_name} se produit dans cette video.",
        "contrainte": f"Entre quelles secondes {event_name} apparait-il ? Sois precis.",
        "format_impose": f"Donne le timestamp exact au format X.Xs pour: {event_name}. "
                        f"Reponds uniquement avec le timestamp."
    }

    results = []

    for style, prompt in prompts.items():
        # TODO etudiant : appeler analyze_fn avec le prompt
        # result = analyze_fn(video_path, prompt)

        # TODO etudiant : extraire les timestamps avec re.findall(r'\d+\.?\d*\s*s')
        extracted_ts = None  # TODO etudiant

        # TODO etudiant : calculer l'erreur absolue
        error = None  # TODO etudiant : abs(extracted_ts - true_timestamp) si extracted_ts

        results.append({
            'formulation': style,
            'timestamp_extrait': extracted_ts,
            'erreur_secondes': error,
            'reponse_brute': ''  # TODO etudiant : texte de la reponse
        })

    return pd.DataFrame(results)


# TODO etudiant : Tester avec un evenement de la video
# df_prompts = benchmark_temporal_prompts(
#     str(test_video_path),
#     "la formule mathematique",
#     event_timestamps["formule_visible"],
#     analyze_video_qwen  # ou une mock function pour tester sans GPU
# )
# print(df_prompts)
print("Exercice a completer")
Exercice a completerExercice 3 : Benchmark de precision multi-modèle
La comparaison GPT-5 vs Qwen2.5-VL dans la Section “Comparaison” montre des différences de capacites. L’objectif est d’implementer un cadre d’evaluation qui compare quantitativement les deux modèles sur des tâches de comprehension video.
Contexte : Pour choisir entre un modèle local (Qwen-VL) et un modèle cloud (GPT-5), il faut mesurer objectivement la precision, la latence et le cout sur des tâches representative.
Étapes : 1. Définir un jeu de 5 questions sur la video de test avec reponses attendues (verite terrain) 2. Créer une fonction qui envoie chaque question aux deux modèles 3. Comparer les reponses avec la verite terrain en utilisant une similarite textuelle 4. Presenter les résultats dans un DataFrame avec colonnes par modèle
Indices : - Questions types : “Combien de scenes ?”, “Quel texte apparait a la scene 3 ?”, “A quel moment la formule est-elle visible ?” - Pour la verite terrain, utilisez les variables scenes et event_timestamps déjà définies - La similarite peut etre mesuree avec SequenceMatcher (cf Exercice 1) - Si un modèle n’est pas disponible (pas de GPU pour Qwen, pas d’API pour GPT-5), simulez les résultats avec des placeholders
# Exercice 3 : Benchmark de precision multi-modele

from difflib import SequenceMatcher

def benchmark_models(questions: List[Dict[str, str]],
                     analyze_fn_local=None,
                     analyze_fn_api=None) -> pd.DataFrame:
    """
    Compare les performances de Qwen-VL et GPT-5 sur des questions video.

    Args:
        questions: Liste de dicts {'question': ..., 'reponse_attendue': ...}
        analyze_fn_local: Fonction d'analyse locale (Qwen-VL) ou None
        analyze_fn_api: Fonction d'analyse API (GPT-5) ou None

    Returns:
        DataFrame avec resultats comparatifs
    """
    results = []

    for q_data in questions:
        question = q_data['question']
        expected = q_data['reponse_attendue']

        row = {'question': question, 'reponse_attendue': expected}

        # Modele local (Qwen-VL)
        # TODO etudiant : appeler analyze_fn_local si disponible
        # TODO etudiant : calculer la similarite avec SequenceMatcher
        row['reponse_qwen'] = ''  # TODO etudiant
        row['similarite_qwen'] = 0.0  # TODO etudiant
        row['temps_qwen'] = 0.0  # TODO etudiant

        # Modele API (GPT-5)
        # TODO etudiant : appeler analyze_fn_api si disponible
        row['reponse_gpt5'] = ''  # TODO etudiant
        row['similarite_gpt5'] = 0.0  # TODO etudiant
        row['temps_gpt5'] = 0.0  # TODO etudiant

        results.append(row)

    return pd.DataFrame(results)


# TODO etudiant : Definir les questions avec verite terrain
# questions = [
#     {"question": "Combien de scenes distinctes la video contient-elle ?",
#      "reponse_attendue": "5 scenes"},
#     {"question": "Quel texte est affiche dans la scene 3 ?",
#      "reponse_attendue": "Regression lineaire y=ax+b"},
#     {"question": "A quel moment le resultat d'accuracy apparait-il ?",
#      "reponse_attendue": f"Vers {event_timestamps['resultat_affiche']:.1f}s"},
# ]
# df_benchmark = benchmark_models(questions)
# print(df_benchmark)
print("Exercice a completer")
Exercice a completer# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Modele : {model_name}")
print(f"Device : {device}")
if device == "cuda" and torch.cuda.is_available():
vram_used = torch.cuda.memory_allocated(0) / 1024**3
vram_peak = torch.cuda.max_memory_allocated(0) / 1024**3
print(f"VRAM actuelle : {vram_used:.1f} GB")
print(f"VRAM pic : {vram_peak:.1f} GB")
analyses_done = sum([
result_global.get('success', False),
results_ocr.get('success', False),
results_grounding.get('success', False)
])
print(f"Analyses reussies : {analyses_done}/3")
if save_results:
results_data = {
"model": model_name,
"device": device,
"global_analysis": result_global if result_global.get('success') else None,
"ocr": results_ocr if results_ocr.get('success') else None,
"temporal_grounding": results_grounding if results_grounding.get('success') else None,
"timestamp": datetime.now().isoformat()
}
results_file = OUTPUT_DIR / f"qwen_vl_analysis_{datetime.now().strftime('%Y%m%d_%H%M%S')}.json"
with open(results_file, 'w', encoding='utf-8') as f:
json.dump(results_data, f, indent=2, ensure_ascii=False, default=str)
print(f"Resultats sauvegardes : {results_file.name}")
# Liberation VRAM
if model is not None:
del model
del processor
if device == "cuda":
torch.cuda.empty_cache()
print(f"VRAM liberee")
print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 01-4 : Amelioration video avec Real-ESRGAN (upscaling, interpolation)")
print(f"2. Notebook 01-5 : Introduction a AnimateDiff (generation text-to-video)")
print(f"3. Module 02 : Modeles generatifs video avances (HunyuanVideo, LTX-Video)")
print(f"\nNotebook 01-3 Qwen-VL Video Analysis termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-08-28 13:20:51
Modele : Qwen/Qwen2.5-VL-7B-Instruct
Device : cuda
VRAM actuelle : 4.9 GB
VRAM pic : 6.0 GB
Analyses reussies : 3/3
Resultats sauvegardes : qwen_vl_analysis_20260828_132051.json
VRAM liberee

--- PROCHAINES ETAPES ---
1. Notebook 01-4 : Amelioration video avec Real-ESRGAN (upscaling, interpolation)
2. Notebook 01-5 : Introduction a AnimateDiff (generation text-to-video)
3. Module 02 : Modeles generatifs video avances (HunyuanVideo, LTX-Video)

Notebook 01-3 Qwen-VL Video Analysis termine - 13:20:51
Exemple guide : Analyse Avancee avec Temporal Grounding
Duree estimee : 20-25 minutes
Objectif
Implementer un système de requêtes temporelles avancees pour localiser des événements spécifiques dans une video avec Qwen2.5-VL.
Instructions
Implementer la fonction de requête temporelle : Completez la fonction ci-dessous pour poser des questions avec des contraintes temporelles precises.
Comparaison avec GPT-5 : Créez un benchmark comparatif entre Qwen-VL et GPT-5 sur des tâches de temporal grounding.
Analyse des erreurs : Identifiez les cas ou Qwen-VL se trompe et proposez des ameliorations de prompt.
Indices
- Indice 1 : Utilisez des prompts explicites avec des references temporelles (“entre 0s et 5s”, “vers la frame 10”).
- Indice 2 : La comparaison devrait inclure la precision des timestamps, le temps de reponse et le cout.
- Indice 3 : Les erreurs sont souvent dues a un manque de contexte ou a des ambiguites dans les frames.
Critères de succès
# Exercice: Systeme de requetes temporelles avancees

def temporal_query(video_path: str,
                   query: str,
                   time_range: Tuple[float, float],
                   model) -> Dict[str, Any]:
    """
    Pose une question avec contrainte temporelle.

    Args:
        video_path: Chemin de la video
        query: Question sur la video
        time_range: Intervalle de temps (start, end) en secondes
        model: Modele Qwen-VL charge

    Returns:
        Dict avec reponse, timestamp estime et confiance
    """
    # Exercice: Construire le prompt avec contrainte temporelle
    # Exercice: Appeler analyze_video_qwen avec le prompt adapte
    # Exercice: Extraire le timestamp de la reponse
    pass

# Exercice: Fonction de benchmark comparatif

def benchmark_temporal_grounding(video_path: str,
                                  events: Dict[str, float],
                                  models: List[str]) -> pd.DataFrame:
    """
    Compare Qwen-VL et GPT-5 sur des taches de temporal grounding.

    Args:
        video_path: Video de test
        events: Dictionnaire {evenement: timestamp_verite}
        models: Liste des modeles a tester

    Returns:
        DataFrame avec resultats du benchmark
    """
    # Exercice: Pour chaque evenement, tester chaque modele
    # Exercice: Calculer l'erreur absolue en secondes
    # Exercice: Retourner un DataFrame pandas resume
    pass

# Exercice: Tester avec des evenements de votre video
# events = {"titre_apparait": 0.0, "formule_visible": 2.0, ...}
# df_results = benchmark_temporal_grounding(test_video_path, events, ["qwen", "gpt5"])