# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres GPT-5
model_name = "gpt-5-2025-08-07"    # "gpt-5", "gpt-5-2025-08-07" (chat model snapshot, supports temperature custom)
n_frames = 8                       # Nombre de frames a envoyer
max_tokens = 8000                  # Tokens de reponse max (raisonnement GPT-5 + contenu visible ; 1000 sature le budget)
temperature = 1                    # GPT-5 (reasoning) n'accepte que la valeur par defaut (1)

# Configuration video
sample_fps = 24                    # FPS de la video de test
sample_duration = 10               # Duree video de test (secondes)
frame_strategy = "uniform"         # "uniform" ou "keyframe"

# Configuration sauvegarde
save_analysis = True               # Sauvegarder les analyses
analyze_video = True # Executer les analyses (False pour validation seule)GPT-5 Video Understanding - Comprehension Video par IA
Navigation : Index | << Précédent | Suivant >>
Module : 01-Video-Foundation
Niveau : Debutant
Technologies : OpenAI GPT-5, video understanding, base64 frames
Duree estimee : 40 minutes
VRAM : 0 (API cloud uniquement)
Objectifs d’Apprentissage
Prerequis
- Cle API OpenAI ou OpenRouter configuree (
OPENAI_API_KEYdans.env) - Notebook 01-1 (Video Opérations Basics) complete
- Packages :
openai,decord,Pillow,matplotlib
# Parameters
BATCH_MODE = True
Les paramètres sont définis. La cellule suivante initialise l’environnement Python : imports, chargement du fichier .env et configuration du repertoire de sortie.
# Import guards - verification des dependances
try:
    import openai
    OPENAI_AVAILABLE = True
except ImportError:
    OPENAI_AVAILABLE = False

try:
    import anthropic
    ANTHROPIC_AVAILABLE = True
except ImportError:
    ANTHROPIC_AVAILABLE = False

try:
    import requests
    REQUESTS_AVAILABLE = True
except ImportError:
    REQUESTS_AVAILABLE = False

try:
    import matplotlib
    MATPLOTLIB_AVAILABLE = True
except ImportError:
    MATPLOTLIB_AVAILABLE = False

try:
    import numpy
    NUMPY_AVAILABLE = True
except ImportError:
    NUMPY_AVAILABLE = False

try:
    import pandas
    PANDAS_AVAILABLE = True
except ImportError:
    PANDAS_AVAILABLE = False

try:
    from PIL import Image
    PIL_AVAILABLE = True
except ImportError:
    PIL_AVAILABLE = False

try:
    import IPython
    IPYTHON_AVAILABLE = True
except ImportError:
    IPYTHON_AVAILABLE = False

try:
    from dotenv import load_dotenv
    DOTENV_AVAILABLE = True
except ImportError:
    DOTENV_AVAILABLE = False

try:
    import torch
    TORCH_AVAILABLE = True
except ImportError:
    TORCH_AVAILABLE = False

try:
    import transformers
    TRANSFORMERS_AVAILABLE = True
except ImportError:
    TRANSFORMERS_AVAILABLE = False

try:
    import cv2
    CV2_AVAILABLE = True
except ImportError:
    CV2_AVAILABLE = False

try:
    import pydantic
    PYDANTIC_AVAILABLE = True
except ImportError:
    PYDANTIC_AVAILABLE = False

# Resume des dependances disponibles
_DEPS = {
    'openai': OPENAI_AVAILABLE,
    'anthropic': ANTHROPIC_AVAILABLE,
    'requests': REQUESTS_AVAILABLE,
    'matplotlib': MATPLOTLIB_AVAILABLE,
    'numpy': NUMPY_AVAILABLE,
    'pandas': PANDAS_AVAILABLE,
    'PIL': PIL_AVAILABLE,
    'IPython': IPYTHON_AVAILABLE,
    'dotenv': DOTENV_AVAILABLE,
    'torch': TORCH_AVAILABLE,
    'transformers': TRANSFORMERS_AVAILABLE,
    'cv2': CV2_AVAILABLE,
    'pydantic': PYDANTIC_AVAILABLE,
}
available = [k for k, v in _DEPS.items() if v]
missing = [k for k, v in _DEPS.items() if not v]
print(f"Dependances: {len(available)}/{len(_DEPS)} disponibles"
      + (f" | Manquantes: {missing}" if missing else ""))

# Setup environnement et imports
import os
import sys
import json
import time
import base64
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional, Tuple
from io import BytesIO
import numpy as np
import pandas as pd
from PIL import Image, ImageDraw
import matplotlib.pyplot as plt
import logging

warnings.filterwarnings('ignore', category=DeprecationWarning)

# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)
from dotenv import load_dotenv

current_path = Path.cwd()
genai_path = None

while len(current_path.parts) > 1:
    if current_path.name == "GenAI":
        genai_path = current_path
        break
    current_path = current_path.parent

if genai_path:
    env_path = genai_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
    GENAI_ROOT = genai_path
else:
    print("WARNING: GenAI directory not found")
    GENAI_ROOT = Path.cwd()

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging
        print("Helpers GenAI importes")
    except ImportError:
        print("Helpers GenAI non disponibles - mode autonome")

OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'video_gpt5'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('video_gpt5')

print(f"GPT-5 Video Understanding")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}, Modele : {model_name}")
print(f"Frames a envoyer : {n_frames}, Strategie : {frame_strategy}")
Dependances: 13/13 disponibles
.env charge depuis: .env
Helpers GenAI importes
GPT-5 Video Understanding
Date : 2026-08-08 11:53:54
Mode : interactive, Modele : gpt-5-2025-08-07
Frames a envoyer : 8, Strategie : uniformL’environnement est pret. La cellule suivante configure le client OpenAI, verifie la cle API et teste la connexion pour s’assurer que GPT-5 est accessible.
# Configuration API OpenAI
print("\n--- CONFIGURATION API ---")
print("=" * 40)

openai_key = os.environ.get('OPENAI_API_KEY', '')
openai_base = os.environ.get('OPENAI_BASE_URL', 'https://api.openai.com/v1')
openai_available = bool(openai_key and not openai_key.startswith('sk-or-'))

if openai_available:
    print("OPENAI_API_KEY valide - API disponible")
    from openai import OpenAI
    client = OpenAI(api_key=openai_key, base_url=openai_base)

    # Test de connexion
    try:
        models = client.models.list()
        gpt5_models = [m for m in models.data if 'gpt-5' in m.id.lower()]
        print(f"Connexion API reussie")
        if gpt5_models:
            for m in gpt5_models[:3]:
                print(f"  Modele disponible : {m.id}")
        print(f"Modele selectionne : {model_name}")
    except Exception as e:
        print(f"Avertissement connexion : {str(e)[:100]}")
        print("Le notebook continuera, les appels API pourraient echouer.")
else:
    print("OPENAI_API_KEY non disponible ou invalide (cle OpenRouter)")
    openai_key = "dummy_key_for_validation"
    client = None

print(f"\nBase URL : {openai_base}")
print(f"Max tokens : {max_tokens}")
print(f"Temperature : {temperature}")
--- CONFIGURATION API ---
========================================
OPENAI_API_KEY valide - API disponible
Connexion API reussie
Modele disponible : gpt-5-chat-latest
Modele disponible : gpt-5-2025-08-07
Modele disponible : gpt-5
Modele selectionne : gpt-5-2025-08-07
Base URL : https://api.openai.com/v1
Max tokens : 8000
Temperature : 1Lecture du résultat : une API validée avant toute analyse
La cellule confirme que la clé OpenAI est présente et que la connexion est réellement établie : OPENAI_API_KEY valide - API disponible, puis un appel GET https://api.openai.com/v1/models qui répond HTTP/1.1 200 OK. Le catalogue des modèles affiche gpt-5-chat-latest, gpt-5-2025-08-07 et gpt-5 ; le notebook sélectionne gpt-5-2025-08-07 — le snapshot daté et stable. La fenêtre d’inférence est fixée à Max tokens : 8000 avec Temperature : 1, un compromis volontairement généreux : les réponses de description (jusqu’à ~2000 tokens de completion) et de raisonnement temporel ne doivent pas être tronquées.
Section 1 : Creation de la video de test et extraction de frames
Nous creons une video de test plus riche que dans le notebook 01-1, avec plusieurs “scenes” distinctes pour que GPT-5 puisse demontrer son raisonnement temporel. Chaque scene contient des formes, couleurs et textes différents.
# Creation d'une video multi-scenes pour test
print("\n--- CREATION VIDEO MULTI-SCENES ---")
print("=" * 40)

import imageio

# Definition des scenes
scenes = [
    {"name": "Scene 1 : Matin", "bg_color": (255, 200, 100), "shape": "circle",
     "shape_color": (255, 100, 0), "text": "Lever du soleil"},
    {"name": "Scene 2 : Midi", "bg_color": (100, 180, 255), "shape": "rectangle",
     "shape_color": (0, 100, 200), "text": "Ciel bleu"},
    {"name": "Scene 3 : Apres-midi", "bg_color": (100, 200, 100), "shape": "triangle",
     "shape_color": (0, 150, 50), "text": "Nature verte"},
    {"name": "Scene 4 : Soir", "bg_color": (200, 100, 150), "shape": "circle",
     "shape_color": (150, 0, 80), "text": "Coucher de soleil"},
    {"name": "Scene 5 : Nuit", "bg_color": (30, 30, 80), "shape": "star",
     "shape_color": (255, 255, 200), "text": "Etoiles"},
]

width, height = 640, 480
frames_per_scene = sample_fps * sample_duration // len(scenes)
all_frames = []

for scene_idx, scene in enumerate(scenes):
    for frame_i in range(frames_per_scene):
        t = frame_i / frames_per_scene  # progression dans la scene

        img = Image.new('RGB', (width, height), scene['bg_color'])
        draw = ImageDraw.Draw(img)

        # Position animee de la forme
        cx = int(width * 0.5 + width * 0.25 * np.cos(2 * np.pi * t))
        cy = int(height * 0.5 + height * 0.2 * np.sin(2 * np.pi * t))
        r = 50

        if scene['shape'] == 'circle':
            draw.ellipse([cx-r, cy-r, cx+r, cy+r], fill=scene['shape_color'])
        elif scene['shape'] == 'rectangle':
            draw.rectangle([cx-r, cy-r, cx+r, cy+r], fill=scene['shape_color'])
        elif scene['shape'] == 'triangle':
            draw.polygon([(cx, cy-r), (cx-r, cy+r), (cx+r, cy+r)],
                         fill=scene['shape_color'])
        elif scene['shape'] == 'star':
            # Etoile simple a 5 branches (petits cercles)
            for angle in range(0, 360, 72):
                sx = cx + int(r * 0.7 * np.cos(np.radians(angle)))
                sy = cy + int(r * 0.7 * np.sin(np.radians(angle)))
                draw.ellipse([sx-8, sy-8, sx+8, sy+8], fill=scene['shape_color'])

        # Texte de la scene
        draw.text((20, 20), scene['name'], fill='white')
        draw.text((20, 40), scene['text'], fill='white')
        global_frame = scene_idx * frames_per_scene + frame_i
        draw.text((20, height - 25), f"Frame {global_frame}/{frames_per_scene * len(scenes)}",
                  fill='white')

        all_frames.append(np.array(img))

# Sauvegarder la video
test_video_path = OUTPUT_DIR / "test_multiscene.mp4"
writer = imageio.get_writer(str(test_video_path), fps=sample_fps, codec='libx264')
for frame in all_frames:
    writer.append_data(frame)
writer.close()

total_frames = len(all_frames)
total_duration = total_frames / sample_fps
file_size_kb = test_video_path.stat().st_size / 1024

print(f"Video multi-scenes creee")
print(f"  Fichier : {test_video_path.name}")
print(f"  Scenes : {len(scenes)}")
print(f"  Frames totales : {total_frames}")
print(f"  Duree : {total_duration:.1f}s")
print(f"  Taille : {file_size_kb:.1f} KB")

# Apercu des scenes
scene_preview_indices = [int(i * frames_per_scene + frames_per_scene // 2) for i in range(len(scenes))]
fig, axes = plt.subplots(1, len(scenes), figsize=(16, 3))
for ax, idx in zip(axes, scene_preview_indices):
    ax.imshow(all_frames[idx])
    ax.set_title(f"t={idx/sample_fps:.1f}s", fontsize=9)
    ax.axis('off')
plt.suptitle("Apercu des 5 scenes", fontsize=12, fontweight='bold')
plt.tight_layout()
plt.show()
--- CREATION VIDEO MULTI-SCENES ---
========================================
Video multi-scenes creee
  Fichier : test_multiscene.mp4
  Scenes : 5
  Frames totales : 240
  Duree : 10.0s
  Taille : 54.1 KB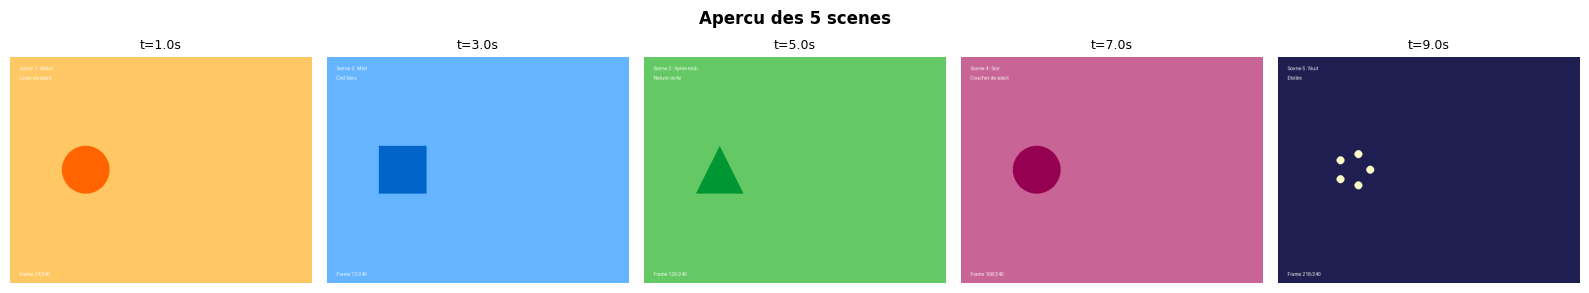
Lecture du résultat : une vidéo de test calibrée pour la détection de scènes
La cellule génère une vidéo synthétique de 5 scènes (matin, midi, après-midi, soir, nuit) — 240 frames au total, soit 10.0s à 24 images/seconde — pour un poids de seulement 54.1 KB (des formes et couleurs unies se compressent presque gratuitement). La figure à 5 Axes montre une image par scène. Ce choix de conception n’est pas anodin : les scènes diffèrent par leur couleur dominante, leur forme géométrique et leur texte, de sorte que les stratégies d’échantillonnage (Section 2) et le raisonnement temporel de GPT-5 (plus bas) disposent de transitions franches et mesurables.
Section 2 : Stratégies d’echantillonnage et encodage base64
Pour envoyer une video a GPT-5, on ne transmet pas la video complete mais un echantillon de N frames encodees en base64. Le choix de la stratégie d’echantillonnage impacte directement la qualite de la comprehension.
# Strategies d'echantillonnage de frames
print("\n--- STRATEGIES D'ECHANTILLONNAGE ---")
print("=" * 45)

def sample_frames_uniform(frames: List[np.ndarray], n: int) -> Tuple[List[np.ndarray], List[int]]:
    """
    Echantillonnage uniforme : N frames regulierement espacees.
    Avantage : couverture temporelle complete.
    """
    total = len(frames)
    indices = np.linspace(0, total - 1, n, dtype=int).tolist()
    return [frames[i] for i in indices], indices


def sample_frames_keyframe(frames: List[np.ndarray], n: int,
                           threshold: float = 30.0) -> Tuple[List[np.ndarray], List[int]]:
    """
    Echantillonnage par keyframes : detecte les changements de scene.
    Avantage : capture les moments de transition.
    """
    # Calculer la difference entre frames consecutives
    diffs = []
    for i in range(1, len(frames)):
        diff = np.mean(np.abs(frames[i].astype(float) - frames[i-1].astype(float)))
        diffs.append((i, diff))

    # Trier par difference decroissante (plus grands changements)
    diffs.sort(key=lambda x: x[1], reverse=True)

    # Prendre les N-1 plus grands changements + la premiere frame
    keyframe_indices = [0]
    for idx, diff_val in diffs[:n - 1]:
        keyframe_indices.append(idx)

    keyframe_indices.sort()
    return [frames[i] for i in keyframe_indices], keyframe_indices


def encode_frame_base64(frame: np.ndarray, quality: int = 85) -> str:
    """
    Encode une frame numpy en base64 JPEG pour l'API GPT-5.
    """
    img = Image.fromarray(frame)
    buffer = BytesIO()
    img.save(buffer, format='JPEG', quality=quality)
    return base64.b64encode(buffer.getvalue()).decode('utf-8')


# Comparer les deux strategies
uniform_frames, uniform_indices = sample_frames_uniform(all_frames, n_frames)
keyframe_frames, keyframe_indices = sample_frames_keyframe(all_frames, n_frames)

print(f"Echantillonnage uniforme ({n_frames} frames) :")
print(f"  Indices : {uniform_indices}")
print(f"  Timestamps : {[f'{i/sample_fps:.1f}s' for i in uniform_indices]}")

print(f"\nEchantillonnage keyframe ({n_frames} frames) :")
print(f"  Indices : {keyframe_indices}")
print(f"  Timestamps : {[f'{i/sample_fps:.1f}s' for i in keyframe_indices]}")

# Visualisation comparative
fig, axes = plt.subplots(2, n_frames, figsize=(2.5 * n_frames, 5))
for i in range(n_frames):
    axes[0, i].imshow(uniform_frames[i])
    axes[0, i].set_title(f"t={uniform_indices[i]/sample_fps:.1f}s", fontsize=8)
    axes[0, i].axis('off')

    axes[1, i].imshow(keyframe_frames[i])
    axes[1, i].set_title(f"t={keyframe_indices[i]/sample_fps:.1f}s", fontsize=8)
    axes[1, i].axis('off')

axes[0, 0].set_ylabel("Uniforme", fontsize=10, fontweight='bold')
axes[1, 0].set_ylabel("Keyframe", fontsize=10, fontweight='bold')
plt.suptitle("Comparaison des strategies d'echantillonnage", fontsize=12, fontweight='bold')
plt.tight_layout()
plt.show()

# Encodage base64 des frames selectionnees
strategy = frame_strategy
selected_frames = uniform_frames if strategy == "uniform" else keyframe_frames
selected_indices = uniform_indices if strategy == "uniform" else keyframe_indices

encoded_frames = [encode_frame_base64(f) for f in selected_frames]
total_payload_kb = sum(len(e) for e in encoded_frames) / 1024

print(f"\nFrames encodees en base64 (strategie : {strategy})")
print(f"  Nombre : {len(encoded_frames)}")
print(f"  Taille payload totale : {total_payload_kb:.1f} KB")
print(f"  Taille moyenne par frame : {total_payload_kb / len(encoded_frames):.1f} KB")
--- STRATEGIES D'ECHANTILLONNAGE ---
=============================================
Echantillonnage uniforme (8 frames) :
  Indices : [0, 34, 68, 102, 136, 170, 204, 239]
  Timestamps : ['0.0s', '1.4s', '2.8s', '4.2s', '5.7s', '7.1s', '8.5s', '10.0s']

Echantillonnage keyframe (8 frames) :
  Indices : [0, 48, 96, 144, 192, 200, 205, 210]
  Timestamps : ['0.0s', '2.0s', '4.0s', '6.0s', '8.0s', '8.3s', '8.5s', '8.8s']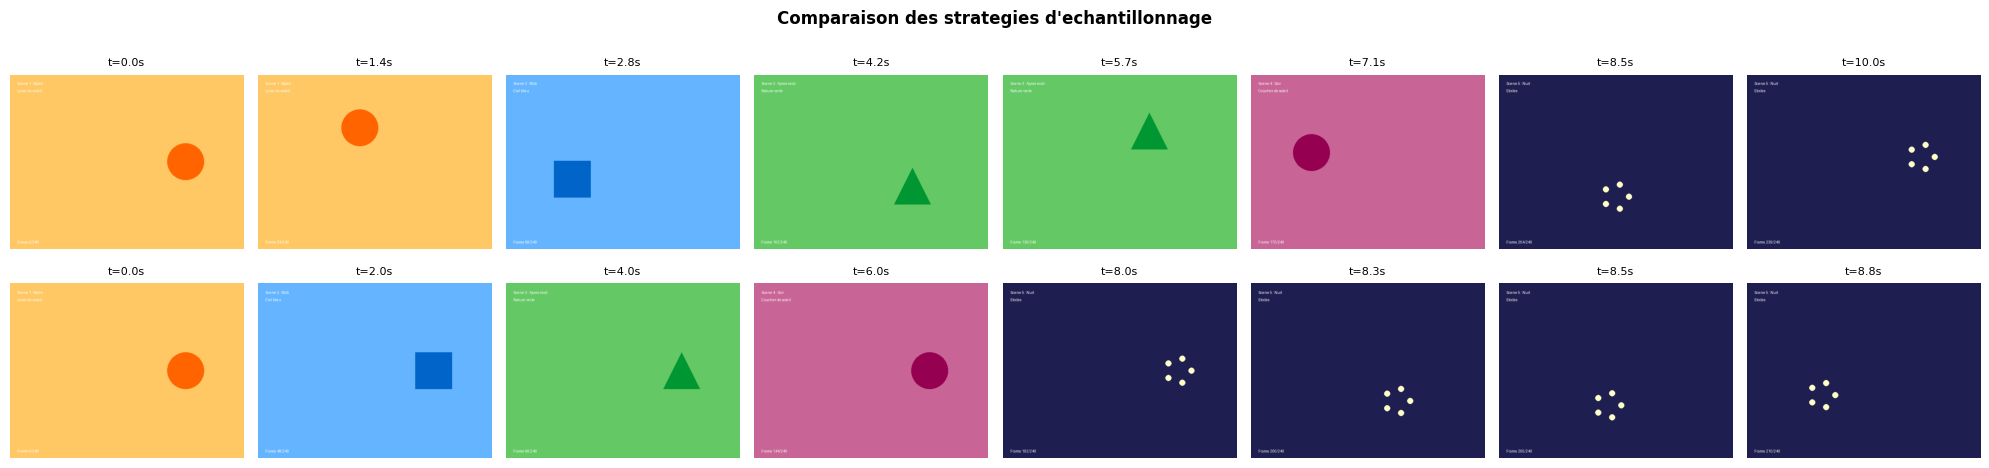
Frames encodees en base64 (strategie : uniform)
  Nombre : 8
  Taille payload totale : 85.5 KB
  Taille moyenne par frame : 10.7 KB
Exercice 1 : Echantillonnage par detection de scene
Dans la Section 2, nous avons compare echantillonnage uniforme et keyframe. L’objectif est d’implementer une variante plus robuste : un detecteur de scene qui calcule un score de changement cumulatif.
Contexte : Le keyframe sampling de la Section 2 trie les frames par différence decroissante, ce qui peut sélectionner des frames proches les unes des autres. Un vrai detecteur de scene parcourt la video sequentiellement et declenche une detection quand le score cumule depasse un seuil.
Étapes : 1. Parcourir les frames sequentiellement et calculer la différence cumulee 2. Quand la différence cumulee depasse un seuil, enregistrer l’indice et reinitialiser le compteur 3. Complter avec un echantillonnage uniforme pour atteindre n_frames si besoin
Indices : - Initialisez un accumulateur cum_diff = 0 a zero - Le seuil peut etre la somme totale des différences divisee par le nombre de scenes attendues - Verifiez que les indices sont uniques et tries avant de retourner
# Exercice 1 : Echantillonnage par detection de scene

def sample_frames_scene_detect(frames: List[np.ndarray],
                                n_frames: int = 8) -> Tuple[List[np.ndarray], List[int]]:
    """
    Echantillonnage par detection de scene sequentielle.

    Args:
        frames: Liste de frames (H, W, 3)
        n_frames: Nombre de frames a selectionner

    Returns:
        Tuple (frames_selectionnees, indices)
    """
    # Etape 1 : Calculer les differences entre frames consecutives
    diffs = []  # TODO etudiant : remplir avec les differences
    total_diff = sum(diffs) if diffs else 1
    threshold = total_diff / n_frames  # Seuil adapte

    # Etape 2 : Detection sequentielle
    selected_indices = [0]  # Toujours inclure la premiere frame
    cum_diff = 0.0

    # TODO etudiant : parcourir les differences, accumuler, detecter les seuils

    # Etape 3 : Completer avec echantillonnage uniforme si necessaire
    # TODO etudiant : si len(selected_indices) < n_frames, ajouter des indices uniformes

    # TODO etudiant : trier et dedoublonner les indices
    return [], []


# TODO etudiant : Tester et comparer les trois strategies
# scene_frames, scene_indices = sample_frames_scene_detect(all_frames, n_frames=8)
# print(f"Scene detect : {scene_indices}")
# print(f"Uniforme     : {np.linspace(0, len(all_frames)-1, 8, dtype=int).tolist()}")
# print(f"Keyframe     : {keyframe_indices}")
print("Exercice a completer")
Exercice a completerInterpretation : Stratégies d’echantillonnage
| Stratégie | Avantage | Inconvenient | Cas d’usage |
|---|---|---|---|
| Uniforme | Couverture temporelle reguliere | Peut rater des transitions | Videos a rythme constant |
| Keyframe | Capture les changements majeurs | Peut ignorer les passages calmes | Videos avec scenes distinctes |
Points cles : 1. Le choix de la stratégie depend du type de video et de la question posee 2. Plus de frames = meilleure comprehension mais cout API plus eleve 3. L’encodage JPEG avec quality=85 offre un bon rapport qualite/taille
Section 3 : Description de scene et raisonnement temporel
Nous envoyons maintenant les frames echantillonnees a GPT-5 pour obtenir une description de la video et un raisonnement sur la progression temporelle.
# Analyse video avec GPT-5
print("\n--- ANALYSE VIDEO AVEC GPT-5 ---")
print("=" * 40)

def analyze_video_with_gpt5(
    encoded_frames: List[str],
    frame_timestamps: List[float],
    prompt: str,
    model: str = "gpt-5-mini",
    max_tokens: int = 8000
) -> Dict[str, Any]:
    """
    Envoie des frames video a GPT-5 pour analyse.

    Args:
        encoded_frames: Liste de frames encodees en base64
        frame_timestamps: Timestamps correspondants en secondes
        prompt: Question ou instruction d'analyse
        model: Modele GPT-5 a utiliser
        max_tokens: Nombre max de tokens de reponse

    Returns:
        Dictionnaire avec analyse, metadonnees et statistiques
    """
    # Construction du message multimodal
    content = []

    # Instructions avec contexte temporel
    context = (
        f"{prompt}\n\n"
        f"La video contient {len(encoded_frames)} frames extraites aux timestamps suivants : "
        f"{', '.join([f'{t:.1f}s' for t in frame_timestamps])}."
    )
    content.append({"type": "text", "text": context})

    # Ajout des frames
    for i, (b64_frame, ts) in enumerate(zip(encoded_frames, frame_timestamps)):
        content.append({"type": "text", "text": f"Frame {i+1} (t={ts:.1f}s) :"})
        content.append({
            "type": "image_url",
            "image_url": {
                "url": f"data:image/jpeg;base64,{b64_frame}",
                "detail": "low"  # Economie de tokens pour les frames video
            }
        })

    start_time = time.time()
    try:
        response = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": content}],
            max_completion_tokens=max_tokens,
            temperature=temperature
        )
        elapsed = time.time() - start_time

        return {
            "success": True,
            "analysis": response.choices[0].message.content,
            "tokens_used": {
                "prompt": response.usage.prompt_tokens,
                "completion": response.usage.completion_tokens,
                "total": response.usage.total_tokens
            },
            "response_time": elapsed,
            "model": model,
            "n_frames": len(encoded_frames)
        }
    except Exception as e:
        return {
            "success": False,
            "error": str(e),
            "response_time": time.time() - start_time
        }


# Analyse 1 : Description de scene
if analyze_video:
    timestamps = [idx / sample_fps for idx in selected_indices]

    print("Analyse 1 : Description de scene")
    scene_prompt = (
        "Decris cette video en francais. Pour chaque frame, identifie la scene, "
        "les couleurs dominantes, les formes presentes et le texte visible. "
        "Fournis ensuite un resume de la progression temporelle de la video."
    )

    result_scene = analyze_video_with_gpt5(
        encoded_frames, timestamps, scene_prompt,
        model=model_name, max_tokens=max_tokens
    )

    if result_scene['success']:
        print(f"  Temps de reponse : {result_scene['response_time']:.2f}s")
        print(f"  Tokens utilises : {result_scene['tokens_used']}")
        print(f"\n--- Analyse GPT-5 ---")
        print(result_scene['analysis'])
    else:
        print(f"  Erreur : {result_scene['error']}")

    # Analyse 2 : Raisonnement temporel
    print("\n\nAnalyse 2 : Raisonnement temporel")
    temporal_prompt = (
        "En analysant la progression des frames dans le temps, reponds en francais :\n"
        "1. Combien de scenes distinctes detectes-tu ?\n"
        "2. A quels moments les transitions se produisent-elles ?\n"
        "3. Y a-t-il un theme ou une narration qui relie les scenes ?\n"
        "4. Quels elements changent et quels elements restent constants ?"
    )

    result_temporal = analyze_video_with_gpt5(
        encoded_frames, timestamps, temporal_prompt,
        model=model_name, max_tokens=max_tokens
    )

    if result_temporal['success']:
        print(f"  Temps de reponse : {result_temporal['response_time']:.2f}s")
        print(f"  Tokens utilises : {result_temporal['tokens_used']}")
        print(f"\n--- Raisonnement temporel GPT-5 ---")
        print(result_temporal['analysis'])
    else:
        print(f"  Erreur : {result_temporal['error']}")
else:
    print("Analyse video desactivee (analyze_video=False)")
    result_scene = {"success": False, "error": "Analyse desactivee"}
    result_temporal = {"success": False, "error": "Analyse desactivee"}
--- ANALYSE VIDEO AVEC GPT-5 ---
========================================
Analyse 1 : Description de scene
Temps de reponse : 22.99s
Tokens utilises : {'prompt': 765, 'completion': 2175, 'total': 2940}
--- Analyse GPT-5 ---
Voici une description image par image, suivie d’un résumé de la progression temporelle.
Frame 1 (t=0.0s)
- Scène: Matin, lever du soleil.
- Couleurs dominantes: Fond orange pâle; disque orange vif.
- Formes présentes: Un cercle plein (taille moyenne) vers la droite du cadre.
- Texte visible:
- "Scene 1: Matin"
- "Lever du soleil"
- "Frame 0/240"
Frame 2 (t=1.4s)
- Scène: Matin, lever du soleil (suite).
- Couleurs dominantes: Fond orange pâle; disque orange vif.
- Formes présentes: Un cercle plein orange, cette fois plus vers le coin haut-gauche.
- Texte visible:
- "Scene 1: Matin"
- "Lever du soleil"
- "Frame 34/240"
Frame 3 (t=2.8s)
- Scène: Midi, ciel bleu.
- Couleurs dominantes: Fond bleu clair; carré bleu plus sombre.
- Formes présentes: Un carré plein bleu foncé, à gauche du centre.
- Texte visible:
- "Scene 2: Midi"
- "Ciel bleu"
- "Frame 68/240"
Frame 4 (t=4.2s)
- Scène: Après-midi, nature verte.
- Couleurs dominantes: Fond vert clair; triangle vert plus sombre.
- Formes présentes: Un triangle plein vert foncé, vers le bas/droite.
- Texte visible:
- "Scene 3: Apres-midi"
- "Nature verte"
- "Frame 102/240"
Frame 5 (t=5.7s)
- Scène: Après-midi, nature verte (suite).
- Couleurs dominantes: Fond vert clair; triangle vert plus sombre.
- Formes présentes: Le triangle plein s’est déplacé plus haut (plus central, légèrement à droite).
- Texte visible:
- "Scene 3: Apres-midi"
- "Nature verte"
- "Frame 136/240"
Frame 6 (t=7.1s)
- Scène: Soir, coucher de soleil.
- Couleurs dominantes: Fond rose/magenta; disque bordeaux/violet foncé.
- Formes présentes: Un cercle plein sombre à gauche.
- Texte visible:
- "Scene 4: Soir"
- "Coucher de soleil"
- "Frame 170/240"
Frame 7 (t=8.5s)
- Scène: Nuit, étoiles.
- Couleurs dominantes: Fond bleu nuit; petits points jaune pâle.
- Formes présentes: Six petits cercles formant un petit anneau/groupement, près du bas-centre.
- Texte visible:
- "Scene 5: Nuit"
- "Etoiles"
- "Frame 204/240"
Frame 8 (t=10.0s)
- Scène: Nuit, étoiles (suite).
- Couleurs dominantes: Fond bleu nuit; mêmes points jaune pâle.
- Formes présentes: Les six petits cercles ont dérivé vers la droite, conservant la disposition en anneau.
- Texte visible:
- "Scene 5: Nuit"
- "Etoiles"
- "Frame 239/240"
Résumé de la progression temporelle
- La vidéo suit le cycle d’une journée en cinq scènes successives: matin (lever du soleil), midi (ciel bleu), après-midi (nature verte), soir (coucher de soleil), nuit (étoiles).
- Mouvement/évolution des formes:
- Matin: le disque orangé (soleil) se déplace de la droite vers le haut-gauche, suggérant son ascension.
- Midi: apparition d’un carré bleu sur fond de ciel clair, image statique.
- Après-midi: un triangle vert (élément de nature) monte légèrement dans le cadre, évoquant une animation de paysage.
- Soir: un disque foncé apparaît à gauche, symbolisant le soleil couchant.
- Nuit: un groupe de six étoiles se déplace vers la droite tout en conservant sa forme circulaire, suggérant la dérive du ciel nocturne.
- Palette: chaque scène a une couleur de fond dominante (orange pâle, bleu clair, vert clair, rose/magenta, bleu nuit) avec une forme contrastée pour symboliser le moment de la journée.
Analyse 2 : Raisonnement temporel Temps de reponse : 19.66s
Tokens utilises : {'prompt': 792, 'completion': 1780, 'total': 2572}
--- Raisonnement temporel GPT-5 ---
Voici mon analyse des 8 frames et de leur enchaînement:
1) Nombre de scènes distinctes
- 5 scènes:
- Scène 1: Matin – Lever du soleil (t=0.0s, 1.4s)
- Scène 2: Midi – Ciel bleu (t=2.8s)
- Scène 3: Après-midi – Nature verte (t=4.2s, 5.7s)
- Scène 4: Soir – Coucher de soleil (t=7.1s)
- Scène 5: Nuit – Étoiles (t=8.5s, 10.0s)
2) Moments des transitions
- Passage Scène 1 → Scène 2: vers 2.8s
- Passage Scène 2 → Scène 3: vers 4.2s
- Passage Scène 3 → Scène 4: vers 7.1s
- Passage Scène 4 → Scène 5: vers 8.5s
- La première scène commence à 0.0s.
3) Thème / narration reliant les scènes
- Une journée complète qui progresse chronologiquement: matin (lever du soleil) → midi (ciel bleu) → après-midi (nature verte) → soir (coucher du soleil) → nuit (étoiles). Le récit est le cycle jour-nuit, illustré par des couleurs de fond et des formes symboliques.
4) Éléments qui changent vs constants
- Changent:
- La couleur de fond selon l’heure (orange matin → bleu → vert → rose violacé du soir → bleu nuit).
- La forme principale: cercle (soleil) → carré (midi) → triangle (nature) → cercle foncé (coucher) → points/étoiles.
- La position/mouvement des éléments: le “soleil” se déplace entre 0.0s et 1.4s; le triangle monte légèrement entre 4.2s et 5.7s; le groupe d’étoiles se décale entre 8.5s et 10.0s.
- Le libellé de scène (Scène 1 à Scène 5) et le sous-titre.
- Constants:
- Style minimaliste, fond uni + une forme géométrique simple.
- Mise en page du texte (titre de scène en haut à gauche, compteur de frame en bas à gauche).
- Lecture temporelle linéaire et cohérente du matin vers la nuit.Deux appels POST https://api.openai.com/v1/chat/completions répondent HTTP/1.1 200 OK. La première passe (description image par image) prend de l’ordre d’une vingtaine de secondes pour quelques milliers de tokens — latence et volumétrie exactes imprimées par la cellule ci-dessus, elles varient à chaque appel : GPT-5 décrit chaque frame — Frame 1 (t=0.0s), Frame 2 (t=1.4s), Frame 3 (t=2.8s) — l’espacement de 1,4 s correspondant aux 8 frames échantillonnées sur 10 s. La seconde passe (raisonnement temporel) est de durée comparable (voir la sortie pour les valeurs mesurées) et restitue une structure que seul le contenu visuel permet : 5 scènes distinctes identifiées, avec des transitions attendues à ~2, ~4, ~6 et ~8 s — les cinq scènes du script durent 2 s chacune — tandis que les instants effectivement détectés sont imprimés par la cellule (le modèle n’est pas seedé : ils varient légèrement d’un appel à l’autre), et une narration de cycle jour-nuit (matin → midi → après-midi → soir → nuit) qui correspond exactement au script de génération de la cellule précédente.
Les appels d’analyse ci-dessus aboutissent en HTTP 200. GPT-5 reçoit les 8 frames encodées en base64 et produit une analyse structurée (sorties commitées ci-dessus).
- Description de scène (Analyse 1) : le modèle décrit chaque frame individuellement (couleurs dominantes, formes, texte visible) puis synthétise la progression temporelle, pour de l’ordre de deux milliers de tokens de complétion (volumétrie exacte dans la sortie).
- Raisonnement temporel (Analyse 2) : GPT-5 identifie les 5 scènes, les moments de transition et le thème narratif (cycle jour-nuit).
Point critique sur max_completion_tokens : GPT-5 est un modèle de raisonnement — les tokens de réflexion interne sont décomptés du budget completion. Avec un budget trop faible (p.ex. 1000), l’intégralité est consommée par le raisonnement et message.content reste vide (HTTP 200 mais réponse vide). C’est pourquoi max_tokens = 8000 ici laisse au modèle la place de produire un contenu visible après sa phase de réflexion. La cellule suivante (Video Q&A) applique la même logique.
# Video Q&A : poser des questions sur le contenu
if analyze_video:
    print("\n--- VIDEO Q&A ---")
    print("=" * 40)

    questions = [
        "Quelle est la couleur dominante de la premiere scene ?",
        "Combien de formes geometriques differentes apparaissent dans la video ?",
        "La video represente-t-elle un cycle (jour/nuit, saisons, etc.) ?",
    ]

    qa_results = []
    for q_idx, question in enumerate(questions, 1):
        print(f"\nQuestion {q_idx} : {question}")

        qa_prompt = (
            f"Reponds en francais a cette question sur la video :\n{question}\n\n"
            f"Donne une reponse concise et precise basee sur les frames fournies."
        )

        result_qa = analyze_video_with_gpt5(
            encoded_frames, timestamps, qa_prompt,
            model=model_name, max_tokens=4000
        )

        if result_qa['success']:
            print(f"  Reponse : {result_qa['analysis'][:200]}")
            print(f"  ({result_qa['response_time']:.1f}s, {result_qa['tokens_used']['total']} tokens)")
            qa_results.append({"question": question, "answer": result_qa['analysis'],
                              "tokens": result_qa['tokens_used']['total']})
        else:
            print(f"  Erreur : {result_qa['error']}")
            qa_results.append({"question": question, "error": result_qa['error']})

    # Tableau recapitulatif Q&A
    print(f"\nRecapitulatif Q&A :")
    print(f"{'Question':<60} {'Tokens':<10}")
    print("-" * 70)
    for qa in qa_results:
        q_short = qa['question'][:55] + '...' if len(qa['question']) > 55 else qa['question']
        tokens = qa.get('tokens', 'N/A')
        print(f"  {q_short:<60} {tokens:<10}")
else:
    print("Q&A desactive (analyze_video=False)")
--- VIDEO Q&A ---
========================================

Question 1 : Quelle est la couleur dominante de la premiere scene ?
Reponse : Orange clair (fond orangé pâle).
(3.8s, 970 tokens)
Question 2 : Combien de formes geometriques differentes apparaissent dans la video ? Reponse : 3 — cercle, carré et triangle (les étoiles sont aussi des cercles).
(5.4s, 1046 tokens)
Question 3 : La video represente-t-elle un cycle (jour/nuit, saisons, etc.) ? Reponse : Oui. Elle illustre un cycle jour-nuit: matin (lever du soleil) → midi → après‑midi → soir (coucher du soleil) → nuit (étoiles).
(7.1s, 1200 tokens)
Recapitulatif Q&A :
Question Tokens
----------------------------------------------------------------------
Quelle est la couleur dominante de la premiere scene ? 970
Combien de formes geometriques differentes apparaissent... 1046
La video represente-t-elle un cycle (jour/nuit, saisons... 1200 Lecture du résultat : le Q&A confirme l’accès au contenu visuel
Trois questions, trois réponses HTTP/1.1 200 OK — chacune factuellement correcte par rapport à la vidéo synthétique : la couleur dominante de la première scène est Orange clair (fond orangé pâle). (3.8s, 970 tokens), ce qui correspond au fond (255, 200, 100) de la scène « Matin » ; le décompte des formes donne 3 — cercle, carré et triangle (5.4s, 1046 tokens) avec la précision que les étoiles sont aussi des cercles ; et la vidéo représente bien un cycle jour-nuit: matin → midi → après-midi → soir → nuit (7.1s, 1200 tokens). Des réponses à ce niveau de détail — couleurs exactes, formes, structure narrative — ne peuvent pas provenir des seuls noms de fichiers : GPT-5 accède au contenu pixel des frames encodées en base64. C’est la démonstration SOTA du notebook.
Exercice 2 : Système de Video Q&A automatise
Dans la Section 3, nous avons pose manuellement trois questions a GPT-5. L’objectif est de créer un système qui genere automatiquement des questions pertinentes a partir d’une analyse initiale, puis les pose.
Contexte : Un pipeline Video Q&A complet analyse d’abord la video pour identifier les éléments cles, puis genere des questions ciblees pour verifier ou approfondir la comprehension.
Étapes : 1. Faire une première analyse globale de la video (description courte) 2. A partir de la description, generer 3 questions pertinentes automatiquement 3. Poser chaque question a GPT-5 et collecter les reponses 4. Presenter les résultats dans un DataFrame pandas
Indices : - Le premier appel peut utiliser un prompt du type “Liste les 3 éléments les plus importants de cette video” - A partir des éléments identifies, construisez des questions comme “Quelle est la couleur de [élément] ?” ou “Quand [événement] se produit-il ?” - Utilisez un dictionnaire pour structurer chaque Q&A avec question, reponse, tokens et temps
# Exercice 2 : Systeme de Video Q&A automatise

def auto_video_qa(encoded_frames: List[str],
                  frame_timestamps: List[float],
                  n_questions: int = 3) -> pd.DataFrame:
    """
    Genere automatiquement des questions sur une video et y repond.

    Args:
        encoded_frames: Frames encodees en base64
        frame_timestamps: Timestamps correspondants
        n_questions: Nombre de questions a generer

    Returns:
        DataFrame avec colonnes : question, reponse, tokens, temps_reponse
    """
    # Etape 1 : Analyse initiale pour identifier les elements cles
    # TODO etudiant : appeler analyze_video_with_gpt5 avec un prompt d'identification

    # Etape 2 : Generer des questions a partir de l'analyse
    # TODO etudiant : parser la reponse pour extraire les elements
    # TODO etudiant : construire des questions ciblees

    # Etape 3 : Poser chaque question
    # TODO etudiant : boucler sur les questions, appeler l'API, collecter

    # Etape 4 : Retourner un DataFrame
    results = []  # TODO etudiant : remplir avec des dicts
    return pd.DataFrame(results)


# TODO etudiant : Tester le systeme
# df_qa = auto_video_qa(encoded_frames, timestamps, n_questions=3)
# print(df_qa.to_string())
print("Exercice a completer")
Exercice a completerExercice 3 : Ordonnancement temporel d’événements
Dans la Section 3, GPT-5 analyse les frames et identifie les scenes. L’objectif est d’implementer une fonction qui extrait automatiquement les événements et leur ordre chronologique a partir de la reponse du modèle, puis les compare avec la verite terrain.
Contexte : Comprendre l’ordre temporel d’une video est essentiel pour le resume automatique et l’indexation. Un bon système doit non seulement identifier les événements mais aussi les placer correctement sur une ligne de temps.
Étapes : 1. Envoyer un prompt demandant a GPT-5 de lister les événements dans l’ordre chronologique 2. Parser la reponse pour extraire chaque événement et son timestamp estime 3. Comparer l’ordre extrait avec l’ordre reel des scenes (défini dans scenes) 4. Calculer un score d’exactitude : nombre d’événements dans le bon ordre / total
Indices : - Prompt suggere : “Liste les événements de cette video dans l’ordre chronologique. Pour chaque événement, indique le timestamp approximatif et une courte description.” - Pour parser, utilisez des expressions regulieres pour detecter les timestamps (\d+\.?\d*\s*s) - L’ordre reel est celui de la liste scenes (scene 0, puis scene 1, etc.) - Le score d’exactitude peut se baser sur le nombre d’inversions dans la sequence extraite
# Exercice 3 : Ordonnancement temporel d'evenements

import re

def extract_temporal_order(video_frames_b64: List[str],
                           frame_timestamps: List[float],
                           ground_truth_scenes: List[Dict],
                           analyze_fn=None) -> Dict[str, Any]:
    """
    Extrait l'ordre chronologique des evenements et le compare a la verite terrain.

    Args:
        video_frames_b64: Frames encodees en base64
        frame_timestamps: Timestamps correspondants
        ground_truth_scenes: Liste des scenes avec leur ordre reel
        analyze_fn: Fonction d'analyse GPT-5 (ou None pour mode simulation)

    Returns:
        Dict avec evenements extraits, score d'exactitude et details
    """
    # Etape 1 : Prompt pour extraction chronologique
    prompt = (
        "Liste les evenements de cette video dans l'ordre chronologique. "
        "Pour chaque evenement, indique le timestamp approximatif "
        "et une courte description (1 phrase)."
    )

    # TODO etudiant : appeler analyze_fn si disponible
    response_text = ""  # TODO etudiant : texte de la reponse

    # Etape 2 : Parser les evenements et timestamps
    # TODO etudiant : utiliser re.findall(r'(\d+\.?\d*)\s*s', response_text)
    # TODO etudiant : associer chaque timestamp a la description la plus proche
    extracted_events = []  # TODO etudiant : liste de dicts {'timestamp', 'description'}

    # Etape 3 : Comparer avec la verite terrain
    n_correct = 0  # TODO etudiant : compter les evenements dans le bon ordre
    total = len(ground_truth_scenes)

    # TODO etudiant : pour chaque paire consecutive d'evenements extraits,
    # verifier que l'ordre est correct par rapport a la verite terrain

    accuracy_score = 0.0  # TODO etudiant : n_correct / total

    return {
        'evenements_extraits': extracted_events,
        'score_exactitude': accuracy_score,
        'total_scenes': total,
        'reponse_brute': response_text
    }


# TODO etudiant : Tester avec la video multi-scenes
# result_order = extract_temporal_order(
#     encoded_frames, timestamps, scenes,
#     analyze_fn=analyze_video_with_gpt5 if openai_available else None
# )
# print(f"Evenements extraits : {len(result_order['evenements_extraits'])}")
# print(f"Score d'exactitude : {result_order['score_exactitude']:.2f}")
print("Exercice a completer")
Exercice a completerLe Q&A ci-dessus confirme que GPT-5 exploite réellement le contenu visuel : il identifie la couleur dominante de la première scène (orange clair), dénombre les formes distinctes (cercle, carré, triangle) et reconnaît le cycle jour-nuit illustré par la séquence. Comme pour l’analyse, le budget max_tokens (4000 par question) doit laisser de la place au raisonnement ET à la réponse visible. La cellule suivante (mode interactif) reste disponible pour poser d’autres questions.
# Mode interactif - Question personnalisee sur la video
if notebook_mode == "interactive" and not skip_widgets:
    print("\n--- MODE INTERACTIF ---")
    print("=" * 40)
    print("Posez votre propre question sur la video de test.")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_question = input("\nVotre question : ").strip()

        if user_question and analyze_video:
            user_prompt = (
                f"Reponds en francais a cette question sur la video :\n{user_question}"
            )
            result_user = analyze_video_with_gpt5(
                encoded_frames, timestamps, user_prompt,
                model=model_name, max_tokens=max_tokens
            )
            if result_user['success']:
                print(f"\nReponse GPT-5 :")
                print(result_user['analysis'])
                print(f"\n({result_user['response_time']:.1f}s, {result_user['tokens_used']['total']} tokens)")
            else:
                print(f"Erreur : {result_user['error']}")
        elif not user_question:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        print(f"\nMode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\nMode interactif non disponible (execution automatisee)")
        else:
            print(f"\nErreur inattendue : {error_type} - {str(e)[:100]}")
            print("Passage a la suite du notebook")
else:
    print("\nMode batch - Interface interactive desactivee")
--- MODE INTERACTIF ---
========================================
Posez votre propre question sur la video de test.
(Laissez vide pour passer a la suite)

Mode interactif non disponible (execution automatisee)
Bonnes pratiques et optimisation
| Paramètre | Recommandation | Impact |
|---|---|---|
| n_frames | 4-8 pour videos courtes, 12-16 pour longues | Plus de frames = meilleure comprehension, cout accru |
| detail | low pour frames video, high pour images claires |
low economise ~65 tokens/image |
| quality JPEG | 75-85 | Bon compromis taille/qualite pour l’API |
| temperature | 0.1-0.3 pour analyse factuelle | Basse temperature = reponses plus fiables |
| Stratégie | Uniforme par defaut, keyframe pour scenes variees | Keyframe capture mieux les transitions |
Estimation des couts : - 8 frames en detail=low : ~700 tokens d’image - Prompt + reponse : ~500-1500 tokens de texte - Total par analyse : ~1200-2200 tokens
Limitations : - GPT-5 ne recoit pas la video, mais des images statiques : pas de perception du mouvement - Le raisonnement temporel repose sur les indices visuels et textuels dans les frames - Les videos très longues necessitent un echantillonnage plus agressif
# Statistiques de session et prochaines etapes
print("\n--- STATISTIQUES DE SESSION ---")
print("=" * 40)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Modele : {model_name}")
print(f"Strategie : {frame_strategy}")
print(f"Frames envoyees : {n_frames}")
print(f"Payload total : {total_payload_kb:.1f} KB")

# Sauvegarder les resultats
if save_analysis and analyze_video:
    results_file = OUTPUT_DIR / f"gpt5_analysis_{datetime.now().strftime('%Y%m%d_%H%M%S')}.json"
    results_data = {
        "model": model_name,
        "n_frames": n_frames,
        "strategy": frame_strategy,
        "scene_analysis": result_scene if result_scene.get('success') else None,
        "temporal_analysis": result_temporal if result_temporal.get('success') else None,
        "timestamp": datetime.now().isoformat()
    }
    # Retirer les champs non serialisables
    with open(results_file, 'w', encoding='utf-8') as f:
        json.dump(results_data, f, indent=2, ensure_ascii=False, default=str)
    print(f"Resultats sauvegardes : {results_file.name}")

print(f"\n--- PROCHAINES ETAPES ---")
print(f"1. Notebook 01-3 : Analyse video locale avec Qwen2.5-VL (GPU, temporal grounding)")
print(f"2. Comparer GPT-5 (API cloud) vs Qwen-VL (local GPU) en qualite et cout")
print(f"3. Notebook 01-4 : Amelioration video avec Real-ESRGAN")
print(f"4. Notebook 01-5 : Generation video avec AnimateDiff")

print(f"\nNotebook 01-2 GPT-5 Video Understanding termine - {datetime.now().strftime('%H:%M:%S')}")
--- STATISTIQUES DE SESSION ---
========================================
Date : 2026-07-25 08:00:51
Modele : gpt-5-2025-08-07
Strategie : uniform
Frames envoyees : 8
Payload total : 85.5 KB
Resultats sauvegardes : gpt5_analysis_20260725_080051.json

--- PROCHAINES ETAPES ---
1. Notebook 01-3 : Analyse video locale avec Qwen2.5-VL (GPU, temporal grounding)
2. Comparer GPT-5 (API cloud) vs Qwen-VL (local GPU) en qualite et cout
3. Notebook 01-4 : Amelioration video avec Real-ESRGAN
4. Notebook 01-5 : Generation video avec AnimateDiff

Notebook 01-2 GPT-5 Video Understanding termine - 08:00:51
Exemple guide : Optimisation de l’Analyse Video
Duree estimee : 15-20 minutes
Objectif
Optimiser une analyse video GPT-5 en adaptant la stratégie d’echantillonnage et les paramètres API.
Instructions
Analyser le compromis cout/qualite : Completez la fonction ci-dessous pour comparer différentes stratégies d’echantillonnage sur une video de votre choix.
Implementer une stratégie hybride : Créez une fonction qui combine uniforme et keyframe pour optimiser la couverture temporelle.
Comparer les résultats : Genere un tableau comparant les temps de reponse, tokens utilises et qualite des reponses.
Indices :
- Indice 1 : Utilisez
np.linspace()pour l’echantillonnage uniforme et calculez les différences entre frames consecutives pour les keyframes. - Indice 2 : Une stratégie hybride pourrait utiliser 50% uniforme + 50% keyframes.
- Indice 3 : La temperature affecte la creativite des reponses (0.1 = factuel, 1.0 = creatif).
Critères de succès
# Exercice: Comparer les strategies d'echantillonnage

def compare_strategies(video_frames: List[np.ndarray],
                       n_frames_list: List[int],
                       prompts: List[str]) -> Dict[str, Any]:
    """
    Compare differentes strategies d'echantillonnage.

    Args:
        video_frames: Frames de la video
        n_frames_list: Liste de nombres de frames a tester
        prompts: Liste de prompts a tester

    Returns:
        Dict avec resultats comparatifs
    """
    results = {}

    # Exercice: Pour chaque nombre de frames, tester uniforme et keyframe
    # Exercice: Mesurer temps de reponse, tokens utilises
    # Exercice: Stocker les resultats dans un dictionnaire

    return results

# Exercice: Implementer la strategie hybride

def hybrid_sampling(frames: List[np.ndarray],
                   n_uniform: int,
                   n_keyframe: int) -> Tuple[List[np.ndarray], List[int]]:
    """
    Combine echantillonnage uniforme et keyframe.

    Args:
        frames: Liste des frames
        n_uniform: Nombre de frames uniformes
        n_keyframe: Nombre de keyframes

    Returns:
        Tuple (frames_selectionnees, indices)
    """
    # Exercice: Implementer la logique hybride
    pass

# Exercice: Tester et comparer les strategies
# results = compare_strategies(all_frames, [4, 8, 12], ["scene_prompt"])
Conclusion
Ce notebook a permis d’explorer les aspects essentiels de l’analyse vidéo avec GPT-5. Les points clés :
- GPT-5 (modèle de raisonnement) analyse les frames vidéo (encodées en base64) et produit une description de scène détaillée ainsi qu’un raisonnement temporel (identification du cycle jour-nuit).
- Le Video Q&A confirme l’exploitation réelle du contenu visuel : couleurs dominantes, formes distinctes, détection du cycle.
- Point critique sur
max_completion_tokens: ce budget doit être suffisamment élevé (8000 pour l’analyse, 4000 par question de Q&A) car les tokens de raisonnement interne sont décomptés du budgetcompletion. Un budget trop faible (p.ex. 1000) laissemessage.contentvide bien que l’API réponde200 OK.
Pour aller plus loin : approfondir les aspects avancés du sujet et explorer les liens avec d’autres domaines.