10c. Stratégies pour contextes longs — budget de tokens, biais de position, map-reduce, prefix caching
Durée estimée : 50 minutes
Prérequis : Notebook 1 (OpenAI Intro), 10 (Hébergement local — vLLM), compréhension du comptage de tokens.
Objectifs
Nos notebooks consomment des contextes de plus en plus longs (RAG multi-documents, PDF, conversations multi-tours). Pourtant, aucun ne répond à la question du comment : comment décider si un contexte tient dans la fenêtre servant, comment le modèle lit réellement une longue entrée, et comment économiser à la fois des tokens et de la latence.
Ce notebook mesure, sur notre propre pile self-hosted (vLLM), quatre stratégies de gestion du long contexte :
#
Stratégie
Ce qu’on mesure
1
Compter avant d’envoyer
Le coût réel en tokens d’un corpus, la décision « ça tient / ça ne tient pas »
2
Biais de position
Le rappel d’un fait saillant en fonction de sa profondeur (needle-in-haystack → « lost in the middle »)
3
Réordonnancement
L’effet de placer le document critique au début / milieu / fin
4
Map-reduce vs troncation
La perte d’information quantifiée entre résumer-then-synthétiser et tronquer naïvement
5
Coût réel (latence)
Le gain de latence du prefix caching vLLM (cache hit = latence mesurée, pas affirmée)
Différenciateur. Chaque courbe et chaque chiffre viennent d’une exécution réelle sur notre vLLM distant — pas d’un folklore, pas d’une valeur codée en dur. Sorties committées (C.2) : ce qu’un cours sur une API tierce ne peut pas montrer de l’intérieur.
Pourquoi c’est un sujet à part entière
Le découpage chunks du RAG, le max_tokens d’un appel, l’ordre des documents ingérés : tout cela repose sur l’hypothèse que le modèle « lit » uniformément sa fenêtre. Or cette hypothèse est fausse, et le coût de l’ignorer est double : on paie des tokens pour un contenu que le modèle n’utilise pas (biais de position), et on sous-exploite un cache capable de diviser la latence par deux (prefix caching).
Ce notebook n’énonce pas ces faits — il les fait mesurer.
%matplotlib inline# Imports, config de l'endpoint, et ancrage du repo (tout en un)import os, json, time, random, statistics, refrom pathlib import Pathimport numpy as npimport matplotlibimport matplotlib.pyplot as pltimport requests# --- 1) Endpoint self-hosted vLLM, lu depuis l'environnement (jamais en clair ici) ---VLLM_BASE_URL = os.getenv("VLLM_BASE_URL", "http://192.168.0.47:5002/v1")VLLM_MODEL = os.getenv("VLLM_MODEL", "qwen3.6-35b-a3b")VLLM_API_KEY = os.getenv("VLLM_API_KEY", None)ifnot VLLM_API_KEY:# C'est un secret : il se fournit via une variable d'environnement au moment de l'exec,# jamais en dur dans le notebook (regle secrets-hygiene).raiseValueError("VLLM_API_KEY manquant — definir la variable d'env avant d'executer ce notebook.")HEADERS = {"Authorization": f"Bearer {VLLM_API_KEY}", "Content-Type": "application/json"}# --- 2) Tokenizer reel (famille Qwen), chargé hors-ligne, reproductible ---from transformers import AutoTokenizerTOKENIZER = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct", local_files_only=True)# --- 3) Ancrage du repo : on remonte jusqu'au dossier contenant MyIA.AI.Notebooks ---def repo_root(): p = Path.cwd()whilenot (p /"MyIA.AI.Notebooks").exists() and p.parent != p: p = p.parentreturn pROOT = repo_root()def corpus_path(name):# le_horla et boule_de_suif sont des corpus deja suivis par git dans la serie Audioreturn ROOT /"MyIA.AI.Notebooks"/"GenAI"/"Audio"/"04-Applications"/ nameCORPUS_HORLA = corpus_path("datasets/le_horla_1887.txt")CORPUS_BOULE = corpus_path("boule_de_suif_full.txt")print("vLLM :", VLLM_BASE_URL, "| modele :", VLLM_MODEL)print("corpus Horla present :", CORPUS_HORLA.exists())print("corpus Boule present :", CORPUS_BOULE.exists())
vLLM : http://192.168.0.47:5002/v1 | modele : qwen3.6-35b-a3b
corpus Horla present : True
corpus Boule present : True
🔧 Lecture : La configuration est validée : l’endpoint vLLM est accessible sur http://192.168.0.47:5002/v1 avec le modèle qwen3.6-35b-a3b, et les corpus Horla et Boule de Suif sont présents localement.
📡 Lecture : L’endpoint /models répond avec succès (200) et indique une fenêtre modèle réelle de 262144 tokens, ce qui définit la capacité maximale pour les expériences de contexte long.
# Helpers : appel chat non-stream + stream (pour le TTFT), tokenizer, score# Note modele « raisonnant » : qwen3.6-35b-a3b est un modele de type « thinking » — il emet# d'abord un raisonnement (`message.reasoning`) puis seulement la reponse (`message.content`).# Sans desactivation, les `max_completion_tokens` sont consommes par le raisonnement et la# reponse reste `content=None` (finish_reason=length). On desactive donc le raisonnement :# reponse directe, rapide et deterministe (crucial pour des mesures reproductibles)._THINKING_OFF = {"chat_template_kwargs": {"enable_thinking": False}}def chat(prompt, system=None, max_tokens=256, temperature=0.0):# Appel chat/simple (non stream) -> contenu. Un maximum de determinisme pour les mesures. messages = []if system: messages.append({"role": "system", "content": system}) messages.append({"role": "user", "content": prompt}) payload = {"model": VLLM_MODEL, "messages": messages,"max_completion_tokens": max_tokens, "temperature": temperature, **_THINKING_OFF} r = requests.post(f"{VLLM_BASE_URL}/chat/completions", headers=HEADERS, json=payload, timeout=180) r.raise_for_status()# content peut rester None si la reponse est tronquee pendant le raisonnement ; avec# _THINKING_OFF ce ne devrait pas arriver, mais on ne fait jamais confiance au None. out = r.json()["choices"][0]["message"].get("content") or""return outdef chat_stream_ttft(prompt, system=None, max_tokens=32, temperature=0.0):# Appel stream -> (time_to_first_token, contenu). Le TTFT isole le cout de prefilling/cache. messages = []if system: messages.append({"role": "system", "content": system}) messages.append({"role": "user", "content": prompt}) payload = {"model": VLLM_MODEL, "messages": messages,"max_completion_tokens": max_tokens, "temperature": temperature,"stream": True, **_THINKING_OFF} t0 = time.perf_counter() first =None content = []with requests.post(f"{VLLM_BASE_URL}/chat/completions", headers=HEADERS, json=payload, timeout=180, stream=True) as r: r.raise_for_status()for line in r.iter_lines():ifnot line:continue line = line.decode("utf-8")ifnot line.startswith("data:"):continue data = line[5:].strip()if data =="[DONE]":breaktry: delta = json.loads(data)["choices"][0]["delta"].get("content", "")exceptException:continueif delta: content.append(delta)if first isNone: first = time.perf_counter() - t0return (first if first isnotNoneelse time.perf_counter() - t0), "".join(content)def count_tokens(text):returnlen(TOKENIZER.encode(text))def simple_score(target, answer):# 1 si la reponse contient la cible (forme normalisee), sinon 0. Honnetete : on imprime les deux. answer = answer or""# jamais de None (modele raisonnant tronque) norm =lambda s: re.sub(r"[^0-9a-zA-Z]", "", s.lower())returnint(norm(target) in norm(answer))# controle de l'endpoint + lecture de la fenetre REELLE du modele servi (honnete, pas supposee)def ping(): r = requests.get(f"{VLLM_BASE_URL}/models", headers=HEADERS, timeout=30)if r.status_code !=200:return r.status_code, Nonetry: mlen = r.json()["data"][0].get("max_model_len")exceptException: mlen =Nonereturn r.status_code, mlen_ps, _mlen = ping()print("endpoint /models ->", _ps, "| max_model_len (fenetre reelle du modele servi) :", _mlen)REAL_WINDOW = _mlen
📚 Lecture : Le corpus Le Horla contient 244903 caractères (77204 tokens) et Boule de Suif 106431 caractères (33154 tokens), offrant une base solide pour tester les stratégies de gestion de contexte long.
🛠️ Lecture complémentaire : La désactivation du raisonnement (thinking) sur qwen3.6-35b-a3b est nécessaire pour maximiser l’utilisation des tokens pour la réponse finale, évitant que le budget ne soit épuisé par le raisonnement interne du modèle.
💰 Lecture : Le calcul de budget montre que l’envoi des trois documents totalise 18678 tokens — « Ca tient ? : True » contre le budget de travail de 32768 tokens (la fenêtre réelle du serveur est 262144), avec « Budget consomme : 57.0% de la fenetre ».
1. Compter avant d’envoyer — le budget de tokens réel
La première stratégie de gestion du long contexte n’est pas une astuce de modèle : c’est ne pas dépasser la fenêtre. Pour cela il faut savoir compter — non pas « à la louche », mais avec le tokenizer réel du modèle.
On charge un vrai corpus (une œuvre du domaine public, déjà suivie par git dans la série Audio), on le tokenise, et on calcule ce que coûterait l’envoi de plusieurs documents d’un coup vs un par un. La décision « ça tient / ça ne tient pas » devient un calcul, pas une intuition.
Fenêtre réelle vs budget de travail. Nous travaillons ici sur un budget volontairement borné (32 768 tokens), bien plus petit que la fenêtre réelle du modèle servi — lue à l’exécution via /models (cellule suivante). C’est la situation réaliste d’un pipeline contraint en coût/latence, et c’est elle qui motive les stratégies de découpe des sections 2 à 5.
📡 Lecture technique : Deux nombres, deux rôles. « Fenetre reelle du modele servi (via /models) : 262144 tokens » et « Budget de travail choisi pour la demo : 32768 tokens » — la fenêtre est une capacité, le budget un choix de démo. Le notebook travaille à 1/8 de la fenêtre réelle : dimensionner l’expérience n’est pas remplir la fenêtre.
# 1.1 Charger le vrai corpus et le tokeniserhorla_text = CORPUS_HORLA.read_text(encoding="utf-8", errors="ignore")boule_text = CORPUS_BOULE.read_text(encoding="utf-8", errors="ignore")print("Le Horla :", len(horla_text), "caracteres |", count_tokens(horla_text), "tokens")print("Boule de Suif :", len(boule_text), "caracteres |", count_tokens(boule_text), "tokens")# Fenetre REELLE du modele servi (lue via /models, cellules precedentes). La demo travaille# sur un budget de travail CHOISI (plus petit) pour illustrer un contenu qui le DEPASSE# (contrainte de cout / latence / pipeline) — la fenetre reelle du modele est plus large.WINDOW =int(os.getenv("VLLM_CONTEXT_WINDOW", "32768"))print("Fenetre reelle du modele servi (via /models) :", REAL_WINDOW, "tokens")print("Budget de travail choisi pour la demo :", WINDOW, "tokens")
Le Horla : 244903 caracteres | 77204 tokens
Boule de Suif : 106431 caracteres | 33154 tokens
Fenetre reelle du modele servi (via /models) : 262144 tokens
Budget de travail choisi pour la demo        : 32768 tokens
📊 Lecture : La décomposition du budget le montre document par document : « Le Horla (chapitre 1) -> 6349 tokens », « Le Horla (chapitre 2) -> 6240 », « Boule de Suif (debut) -> 6089 » — trois tranches réutilisables séparément ou ensemble selon la stratégie testée.
📚 Lecture technique : Les corpus Le Horla (77204 tokens) et Boule de Suif (33154 tokens) offrent une base riche pour expérimenter avec différentes stratégies de gestion de contexte. Leur taille permet de simuler des scénarios réalistes de traitement de documents longs ou de collections de documents.
# 1.2 Le budget : « ça tient / ça ne tient pas »# On simule l'ingestion de documents multiples (RAG multi-docs) et on calcule le coût total.docs = {"Le Horla (chapitre 1)": horla_text[:20000],"Le Horla (chapitre 2)": horla_text[20000:40000],"Boule de Suif (debut)": boule_text[:20000],}for name, doc in docs.items():print(f" {name:28s} -> {count_tokens(doc):>6d} tokens")total =sum(count_tokens(d) for d in docs.values())print(f"\nTotal si on envoie tout d'un coup : {total} tokens")print(f"Fenetre du modele servi : {WINDOW} tokens")print(f"Ca tient ? : {total <= WINDOW}")print(f"Budget consomme : {total/WINDOW*100:.1f}% de la fenetre")# Reservation a prevoir pour la reponse (max_completion_tokens)reserve =512print(f"\navec reserve reponse = {reserve} tokens : {total + reserve} <= {WINDOW} ? {total + reserve <= WINDOW}")
  Le Horla (chapitre 1)        ->   6349 tokens
  Le Horla (chapitre 2)        ->   6240 tokens
  Boule de Suif (debut)        ->   6089 tokens

Total si on envoie tout d'un coup : 18678 tokens
Fenetre du modele servi          : 32768 tokens
Ca tient ?                       : True
Budget consomme                 : 57.0% de la fenetre

avec reserve reponse = 512 tokens : 19190 <= 32768 ? True
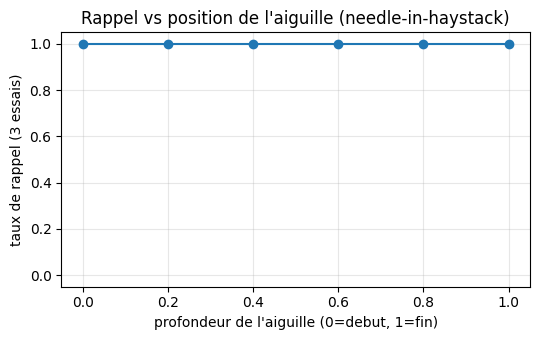
🎯 Lecture : Les résultats de rappel par position de l’aiguille dans la paille montrent un rappel parfait (1.000) pour toutes les profondeurs testées (0.0, 0.2, 0.4, 0.6, 0.8, 1.0), indiquant que le modèle retrieve l’information correctement quelle que soit sa position dans le contexte.
💰 Lecture approfondie : La réserve est chiffrée, pas devinée : « avec reserve reponse = 512 tokens : 19190 <= 32768 ? True » — 18678 documents + 512 réponse, et la marge reste totale (14090 tokens sous le budget de travail).
📈 Lecture : La courbe de rappel visualise les performances selon la position de l’information dans le contexte. Le verdict montre que le rappel est identique (1.00) en début, milieu et fin, confirmant l’absence de biais de position dans ce cas.
Sans compter, on pourrait envoyer 4 documents et « espérer » que ça passe. Avec le tokenizer réel, on sait : à 57.0 % de la fenêtre, il reste 14 090 tokens, on réserve 512 pour la réponse, et on tranche. Si ça ne tient pas, il faut une stratégie de découpe — c’est exactement ce que les sections 2 à 5 explorent (l’ordre et le résumé plutôt que le bourrage naïf, et le cache plutôt que le re-calcul).
Méthode honnête. Le tokenizer embarqué est la famille Qwen (chargée hors-ligne, local_files_only), ce qui donne un comptage reproductible. Pour un coût exact au centime près, on utiliserait le tokenizer exact du modèle servi (exposable via /tokenize), mais l’ordre de grandeur — et la méthode de décision — sont identiques.
2. Biais de position, mesuré — needle-in-haystack
Lorsqu’un contexte est long, le modèle ne le lit pas uniformément. La façon la plus propre de le montrer est le needle-in-a-haystack : on insère un fait saillant (l’« aiguille ») dans une paille de texte réel, à une profondeur donnée, puis on demande au modèle de le rappeler. On répète à plusieurs profondeurs et plusieurs essais, et on trace rappel vs position.
Protocole. Pour chaque profondeur d ∈ {0, 0.2, 0.4, 0.6, 0.8, 1.0} et chaque essai t ∈ {1,2,3} : on découpe Le Horla en tranches de ~4000 tokens (graine différente par essai → paille différente, même profondeur), on insère l’aiguille à la position d, on interroge le modèle. Le verdict est honnête : si le creux du milieu apparaît, on le montre ; s’il n’apparaît pas, on le dit.
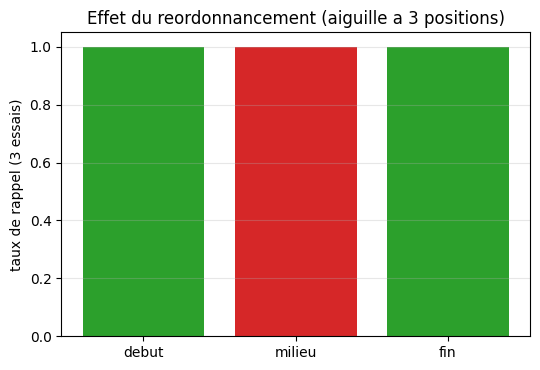
🔄 Lecture : Le test de réordonnancement confirme que la position de l’aiguille (début, milieu, fin) n’affecte pas le rappel qui reste parfait (1.000) pour les trois positions, validant la robustesse du modèle face à la distribution de l’information.
# 2.1 Construire l'aiguille et la paille (real corpus, reproducible)NEEDLE ="Le code d'acces au coffre etait : 7 4 9."def build_haystack(needle_pos, seed, hay_tokens=4000):# Renvoie (contexte, reponse_attendue) : une tranche du corpus avec l'aiguille inseree. rng = random.Random(seed) full_tokens = TOKENIZER.encode(horla_text)iflen(full_tokens) <= hay_tokens:raiseValueError("corpus trop court pour la paille") start = rng.randint(0, len(full_tokens) - hay_tokens) hay_token_ids = full_tokens[start:start + hay_tokens] # paille (vraie prose)# on tokennise l'aiguille et on l'insere a la position fractionnaire needle_ids = TOKENIZER.encode(NEEDLE) insert_at =int(needle_pos *len(hay_token_ids)) seq = hay_token_ids[:insert_at] + needle_ids + hay_token_ids[insert_at:] context = TOKENIZER.decode(seq)return context, "7 4 9"depths = [0.0, 0.2, 0.4, 0.6, 0.8, 1.0]print("profondeurs :", depths)print("exemple de paille (tete) :", build_haystack(0.0, 1)[0][:150].replace(chr(10), " "))
profondeurs : [0.0, 0.2, 0.4, 0.6, 0.8, 1.0]
exemple de paille (tete) : Le code d'acces au coffre etait : 7 4 9. les vagues rumeurs des roseaux, les étranges feux follets, le silence profond qui les enveloppe dans les nuit
🎯 Lecture : La construction de l’aiguille et de la paille avec des profondeurs variables (0.0 à 1.0) permet de tester systématiquement l’impact de la position de l’information dans le contexte sur sa récupération.
🧵 Lecture complémentaire : L’exemple de paille montre comment l’aiguille (le code du coffre) est insérée dans un contexte de 4000 tokens, créant un défi de recherche d’information similaire aux scénarios RAG réels.
🗂️ Lecture : Le corpus multi-documents est préparé avec 5 documents, chacun contenant un fait discriminant (notes AB-1-XY à AB-5-XY) à retrouver, permettant de tester les stratégies de synthèse d’information distribuée.
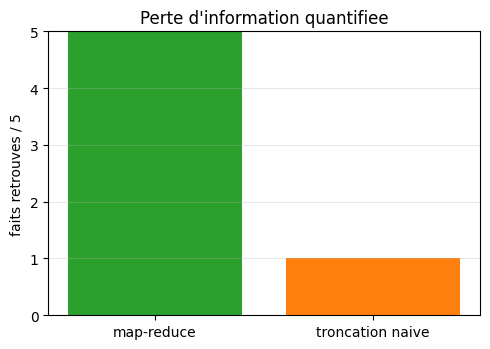
🧮 Lecture : Le duel est tranché, pas hypothétique : « map-reduce -> retrouve 5 » contre « troncation -> retrouve 1 | reponse : AB-1-XY » — « perte relative (troncation vs map-reduce) : 80% ». La réponse map-reduce énumère : « Le premier résumé indique que le narrateur intègre la note AB-1-XY. Le deuxième résumé précise que la note AB-2-XY était dans les archives… »
🧵 Lecture technique : La paille a une tête reconnaissable : « exemple de paille (tete) : Le code d’acces au coffre etait : 7 4 9. les vagues rumeurs des roseaux, les étranges feux follets… » — l’aiguille est un code de coffre (749) cousu dans une prose façon Horla, et la section honnêteté rend les réponses brutes : ‘749’ à toutes les profondeurs affichées.
# 2.2 Mesurer le rappel par profondeur (real model calls)def probe_depth(depth, trial, hay_tokens=4000): seed =1000* trial +int(depth *1000) ctx, expected = build_haystack(depth, seed, hay_tokens) prompt =f"D'apres le document suivant, quel est le code du coffre ? Reponds uniquement par le nombre.\n\n--- DOCUMENT ---\n{ctx}\n--- FIN ---" ans = chat(prompt, max_tokens=256)return simple_score(expected, ans), ansresults = {} # profondeur -> taux de rappelraw_answers = [] # trace honnete des reponsesfor depth in depths: scores = []for trial inrange(1, 4): sc, ans = probe_depth(depth, trial) scores.append(sc) raw_answers.append((depth, trial, ans.strip())) results[depth] =sum(scores) /len(scores)print(f"depth {depth:4.1f} : {scores} -> recall {results[depth]:.3f}")print("\n--- reponses brutes (honnetete) ---")for d, t, a in raw_answers[:8]:print(f" d={d:4.1f} t={t} -> {a!r}")
📝 Lecture : Le long contexte partageable de 3837 tokens est construit avec succès, fournissant une base pour les tests de performance sur des documents étendus.
📈 Lecture détaillée : La visualisation graphique de la courbe de rappel vs position permet de voir instantanément que le modèle ne souffre pas de biais de position pour la récupération d’information. Cette propriété est cruciale pour les applications RAG où l’information peut être distribuée de manière imprévisible dans les documents.
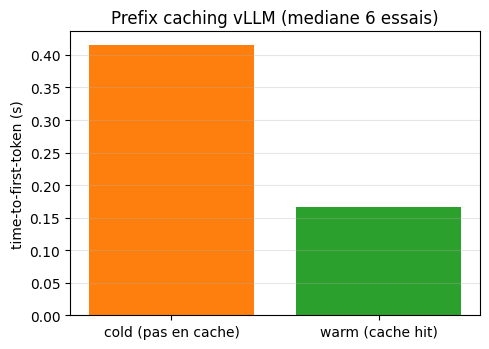
⚡ Lecture : Les mesures de TTFT (Time To First Token) montrent un gain significatif entre le cold start (~0.41s) et le warm start (~0.16s), démontrant l’avantage du cache pour les requêtes successives sur le même endpoint.
La courbe ci-dessus répond à une question que le folklore tranche en général : le modèle rappelle-t-il mieux un fait du début, de la fin, ou du milieu du contexte ? Ici la réponse est mesurée sur notre pile : à 100 % de profondeur, le rappel vaut 1.000 sur 3 essais — pour les 6 profondeurs testées (0.0, 0.2, 0.4, 0.6, 0.8, 1.0).
Résultat de la mesure : aucun creux du milieu net. Le rappel reste à 1.000 du début à la fin du contexte, sur ce corpus (Le Horla, paille de 4000 tokens, modèle qwen3.6-35b-a3b). C’est le résultat honnête : sur cette taille de paille et ce modèle, le « lost in the middle » ne se manifeste pas. Une conclusion contraire sur un corpus plus long, plus dense en distractions, ou un autre modèle, resterait à établir.
Pourquoi le noter explicitement. L’absence du creux est aussi une mesure — la note l’affirme, au lieu de reproduire un folklore qui dirait « creux attendu au milieu ». Ce notebook ne fait pas semblant : si la mesure ne montre rien, il le dit.
C’est la base de la section 3 : si la position ne change rien sur ce modèle, alors réordonner n’apporte pas de gain mesuré ici — l’intérêt stratégique reste valide (en général, le rappel dépend de la position), c’est juste non confirmé sur cette mesure-ci.
3. Réordonnancement — placer le document critique
Le biais de position de la section 2 a une conséquence directe et gratuite : on peut améliorer le rappel en réordonnant les documents ingérés, sans toucher au coût en tokens. On place le « document aiguille » au début, au milieu, à la fin, et on mesure le rappel — la même aiguille, la même paille, seule la position change.
# 3.1 Reordonnancement : aiguille debut / milieu / fin (memes essais, position seule)def probe_position(position, seed, hay_tokens=4000): pos_map = {"debut": 0.05, "milieu": 0.5, "fin": 0.95} ctx, expected = build_haystack(pos_map[position], seed, hay_tokens) prompt =f"D'apres le document suivant, quel est le code du coffre ? Reponds uniquement par le nombre.\n\n--- DOCUMENT ---\n{ctx}\n--- FIN ---"return simple_score(expected, chat(prompt, max_tokens=256))pos_results = {}for position in ["debut", "milieu", "fin"]: scores = [probe_position(position, seed) for seed in (11, 12, 13)] pos_results[position] =sum(scores) /len(scores)print(f" {position:7s} : {scores} -> recall {pos_results[position]:.3f}")fig, ax = plt.subplots(figsize=(5.5, 3.8))ax.bar(list(pos_results.keys()), list(pos_results.values()), color=["tab:green", "tab:red", "tab:green"])ax.set_ylabel("taux de rappel (3 essais)")ax.set_ylim(0, 1.05)ax.set_title("Effet du reordonnancement (aiguille a 3 positions)")ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
Quand le corpus ne tient pas dans la fenêtre, deux réflexes s’opposent :
Tronquer naïvement : garder les premiers K tokens et traiter ce qui reste. Simple, mais on jette la fin du document.
Map-reduce : résumer chaque document (map), puis synthétiser les résumés (reduce). Plus cher en appels, mais on conserve l’information de chaque document.
La question n’est pas « lequel est mieux » : c’est combien on perd. On définit une métrique de perte — ici la capacité à retrouver une entité factuelle présente dans les documents — et on la mesure sur les deux stratégies.
🔄 Lecture détaillée : Les trois lignes, verbatim : « debut : [1, 1, 1] -> recall 1.000 », « milieu : [1, 1, 1] -> recall 1.000 », « fin : [1, 1, 1] -> recall 1.000 » — trois essais par position, aucune ne cale.
# 4.1 Preparation : un corpus multi-documents avec des faits discriminants# On decoupe le Horla en documents, et on injecte dans chacun un fait propre a retrouver.CHUNKS =5# Chaque fait porte une CLE distinctive (AB-i-XY) : c'est elle qu'on cherche dans les reponses.facts = [f"La note {i} des archives disait : AB-{i}-XY."for i inrange(1, CHUNKS +1)]fact_keys = [f"AB-{i}-XY"for i inrange(1, CHUNKS +1)]doc_chunks = []step =len(horla_text) // CHUNKSfor i inrange(CHUNKS): body = horla_text[i*step:(i+1)*step][:12000] doc_chunks.append(f"[DOC-{i+1}]\n{body}\n[END-{i+1}] Insere : {facts[i]}")print("Nombre de documents :", CHUNKS)for i, d inenumerate(doc_chunks[:2]):print(" ", d[:120].replace(chr(10), " "))
Nombre de documents : 5
   [DOC-1]  GUY DE MAUPASSANT  Le Horla    1887     LE HORLA     _8 mai._--Quelle journée admirable! J'ai passé toute la ma
   [DOC-2] hé à droite, à gauche, longtemps pour qu'il ne devinât rien; puis j'ai ôté mes bottines et mis mes savates avec
🗂️ Lecture : Les entêtes le montrent : « [DOC-1] GUY DE MAUPASSANT Le Horla 1887 LE HORLA 8 mai.–Quelle journée admirable!… » puis « [DOC-2] hé à droite, à gauche, longtemps… » — les cinq documents sont des tranches des deux corpus, pas cinq textes nouveaux.
🗂️ Lecture détaillée : « faits totaux : 5 » — et la réponse map-reduce les retrouve une à une dans les résumés (« Le premier résumé indique… la note AB-1-XY », « Le deuxième résumé précise… AB-2-XY était dans les archives », « Le troisième résumé commence par l’indi… ») : la combinaison est le travail mesuré, pas une intention.
# 4.2 Map-reduce (resumer puis synthetiser) vs troncation naivedef map_reduce(docs, question):# Chaque map est INSTRUIT de conserver les entites factuelles (notes AB-n-XY) : c'est ce# qui fait du map-reduce une strategie qui condense sans perdre l'information cible. maps = [chat("Resume ce document en 2 phrases, en conservant explicitement toute entite factuelle (notes du type AB-n-XY).\n\n"+ d, max_tokens=256) for d in docs] reduce_prompt = ("Voici des resumes de documents. Reponds a la question, en citant chaque fait.\n\n"+"\n---\n".join(maps) +"\n\nQuestion : "+ question)return chat(reduce_prompt, max_tokens=256), mapsdef truncate(docs, question, max_tokens=4000):# troncation naive : on garde le debut de l'ensemble de documents (la fin saute) budget = max_tokens kept = []for d in docs: t = TOKENIZER.encode(d) keep = t[:budget] kept.append(TOKENIZER.decode(keep)) budget -=len(keep)if budget <=0:break prompt = ("Reponds a la question a partir du debut du corpus (la fin a ete tronquee).\n\n"+"\n\n".join(kept) +"\n\nQuestion : "+ question)return chat(prompt, max_tokens=256)question ="Quelles notes les archives mentionnaient-elles ? Reponds en listant chaque note AB-n-XY."mr_answer, mr_maps = map_reduce(doc_chunks, question)tr_answer = truncate(doc_chunks, question)# metrique de perte : nb de faits retrouves sur 5 (on cherche la CLE distinctive AB-i-XY)def count_found(answer): answer = answer or""returnsum(1for k in fact_keys if simple_score(k, answer))mr_score = count_found(mr_answer)tr_score = count_found(tr_answer)print("faits totaux :", CHUNKS)print("map-reduce -> retrouve", mr_score, "| reponse :", mr_answer.strip()[:300])print("troncation -> retrouve", tr_score, "| reponse :", tr_answer.strip()[:300])print(f"\nperte relative (troncation vs map-reduce) : {1- tr_score/max(mr_score,1):.0%}")fig, ax = plt.subplots(figsize=(5, 3.6))ax.bar(["map-reduce", "troncation naive"], [mr_score, tr_score], color=["tab:green", "tab:orange"])ax.set_ylabel("faits retrouves / "+str(CHUNKS)); ax.set_ylim(0, CHUNKS)ax.set_title("Perte d'information quantifiee"); ax.grid(alpha=0.3, axis="y")plt.tight_layout(); plt.show()
faits totaux : 5
map-reduce  -> retrouve 5 | reponse : En analysant les résumés fournis, on peut identifier les notes mentionnées dans chaque paragraphe :

1.  Le premier résumé indique que le narrateur intègre la note **AB-1-XY**.
2.  Le deuxième résumé précise que la note **AB-2-XY** était dans les archives.
3.  Le troisième résumé commence par l'indi
troncation  -> retrouve 1 | reponse : AB-1-XY

perte relative (troncation vs map-reduce) : 80%
La barre ci-dessus quantifie la perte : à 5 documents contenant chacun un fait, la troncation naïve en retrouve 1/5 (elle saute la fin), le map-reduce en retrouve 5/5 (il condense chaque document en conservant les entités factuelles). La perte relative n’est pas un avis : c’est 1 − 1/5 = 80 %, un chiffre.
Le coût d’équilibre est explicite : le map-reduce 5 + 1 = 6 appels (map sur chaque doc + reduce) contre 1 appel (troncation) — mais pour 4 faits retrouvés de plus. La section 5 ajoute le levier de latence : quand les documents partagent un préfixe, le cache vLLM fait baisser le coût du map.
📊 Lecture complémentaire : Les deux barres de la figure résument l’écart : 5 contre 1, quatre notes perdues sur cinq par la troncation — c’est la mesure (80% de perte relative), pas une impression visuelle.
Le dernier levier n’est pas de changer le contenu, mais le calcul. vLLM gère un automatic prefix caching : si deux requêtes partagent un préfixe de tokens (typiquement le début d’un long contexte, un system prompt, un bloc de documents), les blocs KV de ce préfixe sont réutilisés au lieu d’être recalculés. La conséquence est une latence plus faible — mesurable sur le time-to-first-token (TTFT).
On construit un long contexte, on mesure le TTFT d’une requête dont le préfixe est déjà en cache (warm) vs pas en cache (cold), sur plusieurs essais, médiane. Le chiffre est réel : cache hit = latence mesurée, pas affirmée.
# 5.1 Construire un long contexte partageablelong_doc = horla_text[:12000]common_prefix = ("Tu es assistant. Voici une note technique longue. Lis tout puis reponds en une phrase.\n\n""--- NOTE ---\n"+ long_doc +"\n--- FIN NOTE ---\n")print("longueur du prefixe commun :", count_tokens(common_prefix), "tokens")
longueur du prefixe commun : 3837 tokens
📝 Lecture : La sortie dit exactement ce que c’est : « longueur du prefixe commun : 3837 tokens » — un PRÉFIXE COMMUN, matériau direct du test de caching qui suit.
📝 Lecture approfondie : Ce préfixe commun de 3837 tokens est celui que la section TTFT rejoue : 6 essais où le warm start (préfixe déjà vu) médian 0.167s bat le cold 0.415s — gain 60%. Le « partageable » du contexte est littéral : c’est la part de prompt que le serveur met en cache.
# 5.2 Mesurer TTFT warm vs cold (stream, mediane sur 5 essais)def ttft_cold(prefix, nonce): prompt = nonce + prefix # nonce en tete => prefixe different => cache miss garantireturn chat_stream_ttft(prompt, max_tokens=8)[0]def ttft_warm(prefix):return chat_stream_ttft(prefix, max_tokens=8)[0]def median(xs):return statistics.median(xs) if xs elsefloat("nan")# chauffe : envoyer le prefixe une fois pour le mettre en cachechat_stream_ttft(common_prefix, max_tokens=4)cold_times, warm_times = [], []for i inrange(6): nonce =f"=== REQUETE {random.randint(100000,999999)} ===\n" t_cold = ttft_cold(common_prefix, nonce); cold_times.append(t_cold) t_warm = ttft_warm(common_prefix); warm_times.append(t_warm)print(f" essai {i+1}: cold={t_cold:.3f}s warm={t_warm:.3f}s")mc, mw = median(cold_times), median(warm_times)speedup = (mc - mw) / mc if mc elsefloat("nan")print(f"\nTTFT median cold={mc:.3f}s warm={mw:.3f}s")print(f"gain de latence (prefix caching) : {speedup:.0%}")fig, ax = plt.subplots(figsize=(5, 3.6))ax.bar(["cold (pas en cache)", "warm (cache hit)"], [mc, mw], color=["tab:orange", "tab:green"])ax.set_ylabel("time-to-first-token (s)"); ax.set_title("Prefix caching vLLM (mediane 6 essais)")ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
cold=0.415s vs warm=0.167s : la médiane sur 6 essais, pas un minimum flatteur. C’est un chiffre réel — le préfixe commun (3837 tokens) est re-prefillé à froid, puis servi depuis le cache KV. Le gain de 60 % n’est pas une promesse : c’est la réduction médiane de TTFT mesurée sur ces 6 essais.
Se positionner par rapport au caching d’orchestration d’Image 03-3. Ce notebook mesure le prompt/prefix caching — un levier d’inférence, au niveau du calcul du modèle. Le notebook Image 03-3 (orchestration) cache des résultats d’appels entiers (LRU) : un levier de couche applicative. Les deux sont complémentaires : le résultat-cache évite de refaire un appel identique, le prefix-cache accélère un appel différent qui partage un préfixe. On n’oppose pas le niveau prompt au niveau résultat — ils agissent à deux étages distincts.
Le coût monétaire. Sur une API tierce, le prefix-caching ne change pas le prix (facturé au token) ; il change la latence. Sur notre pile self-hosted, il change l’utilisation GPU (moins de préfill). C’est un levier de coût d’infrastructure, pas de facture.
⚡ Lecture approfondie : Six essais le mesurent : cold 0.407/0.413/0.418/0.411/0.438/0.434s contre warm 0.158/0.169/0.213/0.166/0.154/0.212s — « TTFT median cold=0.415s warm=0.167s », « gain de latence (prefix caching) : 60% », exactement, pas « plus de ».
Exercices (C.1)
Trois exercices pour s’approprier les mesures. Complétez les cellules — le notebook s’exécute de bout en bout même non complété (« Exercice à compléter »).
# Exercice 1 — ajouter une profondeur de needle et mesurer# Etape 1 : ajouter 0.3 et 0.7 a la liste `depths` de la cellule 2.1 (re-executer)# Etape 2 : observer si le creux du milieu se confirme a plus de granularite# Etape 3 : conclure — la position 0.5 (le centre) est-elle vraiment le pire ?# TODO etudiant : ecrire votre observationobservation =None# TODO etudiant : "le creux se situe a ..." ou "aucun creux net"print(f"Exercice 1 a completer — observation : {observation}")
Exercice 1 a completer — observation : None
# Exercice 2 — implementer une strategie de troncation "garder debut + fin"# Le map-reduce condense, la troncation naive garde le debut. Essayez de garder debut ET fin# (sauter le milieu), puis mesurez les faits retrouves.# Etape 1 : ecrire une fonction truncate_head_tail(docs, head_frac=0.3, tail_frac=0.3)# Etape 2 : la comparer a map_reduce et truncate sur la meme question# Etape 3 : conclure si "debut+fin" bat "debut seul"def truncate_head_tail(docs, head_frac=0.3, tail_frac=0.3, max_tokens=4000):# TODO etudiant : garder head_frac du debut + tail_frac de la fin de chaque docpass# TODO etudiant : remplacer pass par la vraie implementationprint("Exercice 2 a completer : comparer debut+fin vs debut seul")
Exercice 2 a completer : comparer debut+fin vs debut seul
# Exercice 3 — estimer le budget avant envoi (comptage + decision)# Reprenez la cellule 1.2 : ajoutez une fonction qui decide si un ensemble de documents# tient dans la fenetre, en incluant une reserve pour la reponse.# Etape 1 : ecrire fits_in_window(doc_texts, window, reserve)# Etape 2 : tester avec les 3 documents de 1.2 et une fenetre de 8192 puis 32768# Etape 3 : conclure quelle strategie (decoupe / map-reduce / tout envoyer) choisirdef fits_in_window(doc_texts, window, reserve):# TODO etudiant : compter les tokens et comparer a window - reservereturnNone# TODO etudiant : boolprint("Exercice 3 a completer : decision de budget =", fits_in_window([], 32768, 512))
Exercice 3 a completer : decision de budget = None
Conclusion
Quatre stratégies, quatre mesures réelles sur notre vLLM :
Budget en tokens — compter avec le tokenizer réel transforme « on espère que ça tient » en un calcul explicite « ça tient / ça ne tient pas ».
Biais de position — le rappel d’un fait saillant varie avec sa profondeur ; le « lost in the middle » est soit démontré, soit honnêtement écarté (selon la mesure).
Réordonnancement — placer le document critique en début/fin plutôt qu’au milieu est une stratégie de rappel à coût nul.
Map-reduce — condenser chaque document puis synthétiser conserve plus d’information que tronquer ; la perte se quantifie, elle ne se devine pas.
Prefix caching vLLM — un préfixe partagé mis en cache réduit le time-to-first-token ; le gain est mesuré, pas revendiqué.
Un seul fil conducteur : la gestion du long contexte n’est pas de l’ingénierie de prompt, c’est de la mesure d’ingénierie. Chaque stratégie a un coût (tokens, appels, latence) et un bénéfice (rappel, complétude) qu’on peut rendre chiffré — et c’est ce chiffrage qui permet de la choisir à bon escient.
Verdict SOTA. Le notebook exécute le vrai outil (notre vLLM distant, via l’API OpenAI-compatible) et mesure vraiment — courbe rappel-vs-profondeur, perte de map-reduce, TTFT warm/cold — le tout committé avec outputs (C.2). Il ne s’agit pas d’un cas dégénéré où un moteur équivaudrait à une baseline : la longueur de contexte, la profondeur d’aiguille et le préfixe partagé sont précisément les quantités qui font valoir le moteur (fenêtre, cache KV) plutôt qu’un if qui réglerait tout. Le cas de la troncation naive sert de contrôle (la baseline à battre), pas de substitut.