PT-14 — Lois thermodynamiques de l’entraînement : température, équipartition, force entropique
← PostTraining · série from-scratch (toy CPU, numpy + torch, sans trl)
Ce notebook distille le papier R08 — Neural Thermodynamic Laws for Large Language Model Training (Liu et al. 2025, arXiv:2505.10559) : l’entraînement d’un réseau y est lu comme un système thermodynamique — la perte est l’énergie, le learning rate η est la température, le bruit du gradient minibatch est le bain thermique. Cette lecture produit des lois quantitatives simples (largeur stationnaire, équipartition, T ∼ η, décroissance optimale 1/t, force entropique) que nous vérifions une par une sur des simulations jouet, puis confrontons à un mini-transformeur torch CPU.
Résonance directe avec PT-11a : les schedules de learning rate y sont un détail d’ingénierie ; ici ils deviennent une conséquence de la physique — la décroissance 1/t optimale et la discontinuité initiale η₀ = η/2 tombent d’un problème de minimisation de variance, pas d’un réglage ad hoc.
Convention d’honnêteté : les chiffres du papier sur GPT-2 sont toujours cités « rapporté par » ; nos mesures locales sont distinguées par « mesuré ». Chaque expérience de ce notebook a été prototypée et vérifiée avant rédaction.
Plan
Paysage rivière-vallée — le modèle ℓ(x,y) = c(y) + ½a(y)x² et la décomposition lent/rapide.
Largeur stationnaire σ(a) — premier rôle de η : SGD vs SignGD, edge of stability, plancher SignGD.
Équipartition et capacité thermique — ℓf indépendant de la sharpness, T ∼ η, C = σg²/4.
La loi sur un vrai (petit) réseau — mini-GPT torch CPU au plateau (bruit d’étiquette) : le terme thermique est borné (C < 0.1, sous résolution du banc toy) ; SGD vs Adam(0,0) hors/at plateau.
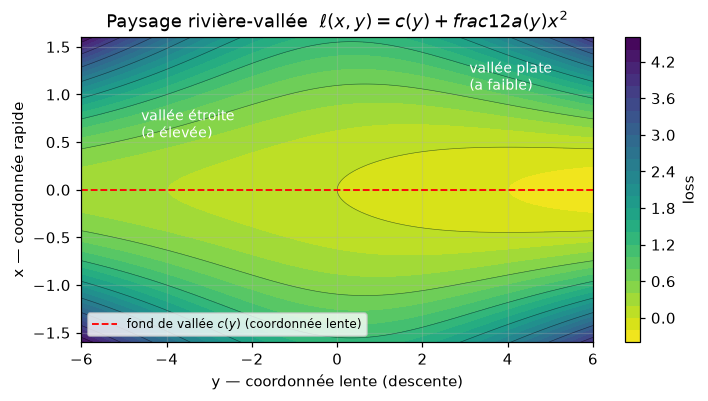
y (coordonnée lente) : position le long de la vallée, pente douce donnée par c′(y) ;
x (coordonnée rapide) : distance transverse, raideur a(y) — la sharpness locale ;
a′(y) < 0 le long de la descente : la vallée s’élargit (zones plates) au fur et à mesure qu’on descend.
La dynamique d’entraînement sépare deux échelles de temps : x thermalise vite (grande raideur a), y évolue lentement. L’analogie du premier principe de la thermodynamique écrit dℓ/dt = dℓs/dt + dℓf/dt — le travail (descente du fond) et la chaleur (fluctuations transverses) : à chaque instant, une partie de la descente est « dilapidée » en agitation thermique autour du fond.
def loss_field(x, y): a =1.0+ (y /4.0) **2# sharpness : decroit quand on descend (y croissant ici) c =-0.05* y # fond de vallee en pente doucereturn c +0.5* a * x **2xs = np.linspace(-1.6, 1.6, 240)ys = np.linspace(-6.0, 6.0, 240)X, Y = np.meshgrid(xs, ys)L = loss_field(X, Y)fig, ax = plt.subplots()cs = ax.contourf(Y, X, L, levels=30, cmap="viridis_r")ax.contour(Y, X, L, levels=8, colors="k", linewidths=0.4, alpha=0.5)ax.plot(ys, np.zeros_like(ys), "r--", lw=1.2, label="fond de vallée $c(y)$ (coordonnée lente)")ax.annotate("vallée étroite\n(a élevée)", xy=(-4.6, 0.55), color="w", fontsize=9)ax.annotate("vallée plate\n(a faible)", xy=(3.1, 1.05), color="w", fontsize=9)ax.set_xlabel("y — coordonnée lente (descente)")ax.set_ylabel("x — coordonnée rapide")ax.set_title("Paysage rivière-vallée $\ell(x,y) = c(y) + \tfrac{1}{2}a(y)x^2$")ax.legend(loc="lower left", fontsize=8)fig.colorbar(cs, label="loss")plt.show()
Lecture (deux échelles de temps). La coordonnée transverse x est confinée par une raideur a grande : elle atteint son régime stationnaire en O(1/(aη)) steps. La coordonnée y ne bouge que de η·c′ par step : des milliers de steps. Toute la thermodynamique qui suit vit dans cette séparation — on peut mesurer la « physique » de x à y figé, puis traiter y comme un paramètre lent. C’est exactement la stratégie du papier : lois locales mesurées sur le paysage quadratique, puis effet sur la trajectoire lente.
Partie 2 — Premier rôle de η : la largeur stationnaire σ(a)
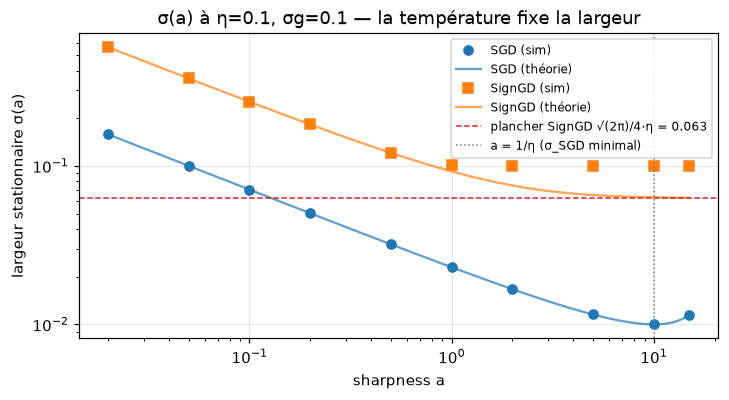
SGD avec bruit de gradient gaussien effectif ( minibatch → \(a x + \sigma_g \hat W\), \(\hat W \sim \mathcal N(0,1)\) ) :
Lecture (trois régimes). (1) SGD : accord simulation/théorie sur toute la gamme, y compris la queue non monotone — σ passe par un minimum à a = 1/η puis remonte vers la divergence à aη → 2 (edge of stability). (2) SignGD : parfait dans le régime gaussien (aη ≪ σg, la branche en σg·η/a) ; aux grands a la simulation sature vers η au lieu de suivre le plancher théorique √(2π)/4·η ≈ 0.0627 — un écart que le papier documente lui-même (effet de discrétisation : quand σ ≪ η, la distribution devient télégraphe, l’approximation gaussienne perd). (3) Le plancher √(2π)/4·η est la température minimale de SignGD : quoi qu’il arrive, σ ≳ η — SignGD ne peut pas descendre sous sa propre largeur de pas.
Partie 3 — Équipartition et capacité thermique
La perte thermique vaut \(\ell_f = \tfrac12 a \sigma^2(a)\). En substituant σ(a) :
ni l’un ni l’autre ne dépend de a : c’est le théorème d’équipartition — chaque degré de liberté porte la même énergie thermique, indépendamment de sa raideur. Conséquence immédiate : la température est T ∼ η (linéaire, pas η²), et la capacité thermique C = ∂ℓf/∂T vaut σg²/4 (SGD) — la pente de la droite ℓf(η).
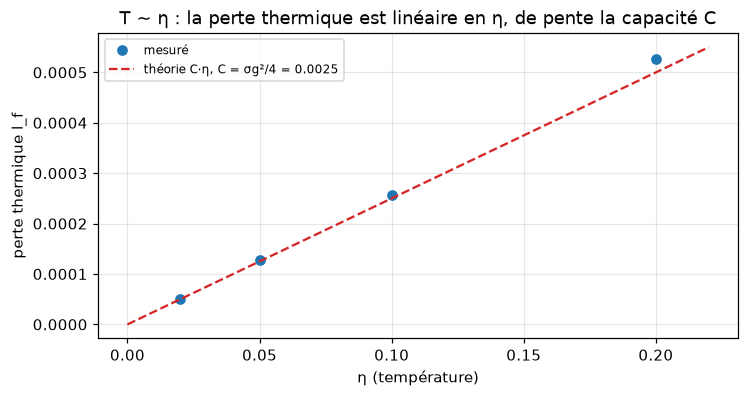
print("== Équipartition : l_f indépendant de a (eta=0.1, sg=0.1) ==")lf_theo_sgd = SG **2* ETA /4lf_theo_sig = np.sqrt(np.pi /32) * SG * ETAlf_corr =lambda a: lf_theo_sgd / (1- a * ETA /2) # loi exacte : correction finie en aηprint(f"{'a':>6}{'l_f SGD':>10}{'C·η':>9}{'corrigé':>9} | {'l_f SignGD':>10}{'théorie':>10}")for a in [0.05, 0.2, 1.0, 5.0]: lf_sgd =0.5* a * sim_sgd(a, ETA, SG).var() lf_sig =0.5* a * sim_signgd(a, ETA, SG).var()print(f"{a:>6.2f}{lf_sgd:>10.5f}{lf_theo_sgd:>9.5f}{lf_corr(a):>9.5f} | "f"{lf_sig:>10.5f}{lf_theo_sig:>10.5f}")print("\n== T ~ eta : l_f(eta) linéaire, pente C = sg²/4 (SGD, a=0.5) ==")a_c =0.5eta_grid = [0.02, 0.05, 0.1, 0.2]lf_grid = [0.5* a_c * sim_sgd(a_c, e, SG).var() for e in eta_grid]for e, lf inzip(eta_grid, lf_grid):print(f"eta={e:>5} : l_f={lf:.6f} ratio l_f/(C·eta)={lf/(lf_theo_sgd/ETA*e):.3f}")fig, ax = plt.subplots()ax.plot(eta_grid, lf_grid, "o", color="C0", label="mesuré")ax.plot(np.linspace(0, 0.22, 10), SG**2/4* np.linspace(0, 0.22, 10), "--", color="C3", label=f"théorie C·η, C = σg²/4 = {SG**2/4:.4f}")ax.set_xlabel("η (température)"); ax.set_ylabel("perte thermique l_f")ax.set_title("T ∼ η : la perte thermique est linéaire en η, de pente la capacité C")ax.legend(fontsize=8)plt.show()
== Équipartition : l_f indépendant de a (eta=0.1, sg=0.1) ==
     a    l_f SGD       C·η   corrigé | l_f SignGD    théorie
  0.05    0.00025   0.00025   0.00025 |    0.00318    0.00313
  0.20    0.00025   0.00025   0.00025 |    0.00332    0.00313
  1.00    0.00026   0.00025   0.00026 |    0.00515    0.00313
  5.00    0.00033   0.00025   0.00033 |    0.02500    0.00313

== T ~ eta : l_f(eta) linéaire, pente C = sg²/4 (SGD, a=0.5) ==
eta= 0.02 : l_f=0.000050  ratio l_f/(C·eta)=1.006
eta= 0.05 : l_f=0.000127  ratio l_f/(C·eta)=1.016
eta=  0.1 : l_f=0.000256  ratio l_f/(C·eta)=1.026
eta=  0.2 : l_f=0.000527  ratio l_f/(C·eta)=1.054
Lecture (l’équipartition est le cœur de l’analogie). Pour SGD, ℓf est indépendant de a sur toute la gamme — et la colonne « corrigé » montre la loi exacte : \(\ell_f = \frac{\sigma_g^2\eta/4}{1 - a\eta/2}\), dont l’équipartition σg²η/4 est la limite aη ≪ 2 (la dérive de +33 % mesurée à a = 5 est exactement le facteur 1/(1−aη/2) = 1.33 — pas un bruit de mesure, la correction de température finie). Et ℓf(η) est une droite de pente C = σg²/4 à 0,6-5 % près. Pour SignGD, l’équipartition tient dans le régime gaussien mais casse aux grands a (régime télégraphe, cf. Partie 2) — l’équipartition exige des fluctuations gaussiennes, un point que le papier souligne et que la simulation rend visible. C’est la mesure centrale : augmenter le learning rate n’accélère pas seulement, il chauffe — et le coût final de la chaleur est C·η_min.
Partie 4 — La loi sur un vrai (petit) réseau : mini-GPT
Le papier mesure sur GPT-2 (rapporté par R08, §4) :
La confronter honnêtement exige deux précautions. (1) Écarter le confondant majeur : η est aussi l’échelle de temps de la descente — un sweep « η constant, budget de steps fixe » mesure le sous-entraînement, pas la température (à petit η le modèle est simplement resté en haut de la vallée quand le budget s’épuise). (2) Se placer au plateau de la loss, là où seule la part thermique varie encore — l’analogue exact de l’entropie irréductible du langage qui fonde le plateau de GPT-2. Notre banc garantit ce plateau par un bruit d’étiquette q = 0.15 : 15 % des cibles sont remplacées par un token aléatoire, si bien qu’aucun modèle ne peut descendre sous l’entropie du bruit.
Protocole :
Phase chaude : η = 0.05, 9000 steps, batch 16 → un checkpoint au plateau (et un checkpoint intermédiaire « hors plateau » à step 1500) ;
Anneal depuis le plateau : η_min ∈ {0.006, 0.02, 0.06}, 2700 steps → val(η_min) isole-t-il un terme thermique C·η ?
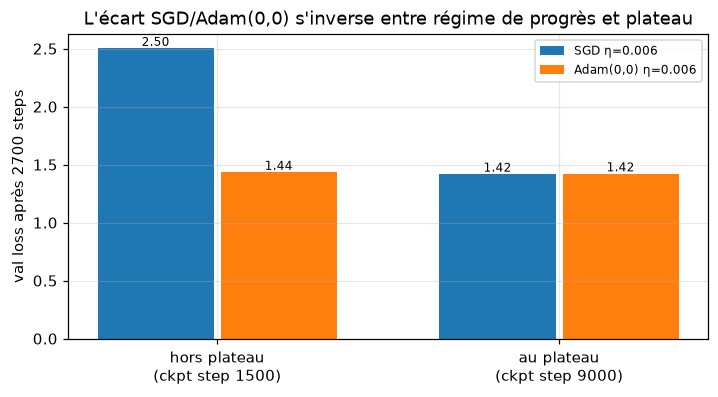
Contrastes : SGD vs Adam(0,0) (update η·g/(|g|+ε) ≈ η·sign(g), le SignGD par coordonnée) hors plateau puis au plateau, et decay 1/t vs constant.
import copyQ_NOISE =0.15# bruit d'étiquette : garantit un plateau irréductibleBS =16# petit batch : gradient bruité (le "bain thermique")class MiniGPT(nn.Module):"""Mini transformeur décodeur : 2 couches, d=64, causal (106k paramètres)."""def__init__(self, vocab=32, d=64, ctx=32, layers=2, heads=4):super().__init__()self.tok = nn.Embedding(vocab, d)self.pos = nn.Embedding(ctx, d) enc = nn.TransformerEncoderLayer(d, heads, 4* d, dropout=0.0, batch_first=True, norm_first=True, activation="gelu")self.blocks = nn.TransformerEncoder(enc, layers)self.head = nn.Linear(d, vocab)def forward(self, x): T = x.shape[1] mask = torch.triu(torch.ones(T, T, dtype=torch.bool), 1) h =self.tok(x) +self.pos(torch.arange(T))returnself.head(self.blocks(h, mask=mask))def make_batch(bs, ctx, gen, vocab=32):# séquences périodiques, période p aléatoire par séquence (3..8) x = torch.zeros(bs, ctx, dtype=torch.long)for i inrange(bs): p =int(torch.randint(3, 9, (1,), generator=gen)) base = torch.randint(1, vocab, (p,), generator=gen) x[i] = base.repeat((ctx + p -1) // p)[:ctx]return xdef noisy_targets(x, gen):"""q=15 % des cibles remplacées par un token aléatoire (train ET val).""" t = x[:, 1:].clone() flip = torch.rand(t.shape, generator=gen) < Q_NOISE t[flip] = torch.randint(0, 32, (int(flip.sum()),), generator=gen)return tVAL_GEN = torch.Generator().manual_seed(999)VAL_X = make_batch(512, 32, VAL_GEN) # validation fixe (tirage indépendant : aucune fuite)VAL_Y = noisy_targets(VAL_X, VAL_GEN) # cibles bruitées fixes, même distribution que le train@torch.no_grad()def val_loss(model): model.eval() logits = model(VAL_X[:, :-1]) ce = torch.nn.functional.cross_entropy(logits.reshape(-1, 32), VAL_Y.reshape(-1)) model.train()return ce.item()def train_run(lr, steps, schedule=None, opt_kind="sgd", seed=0, start_state=None): torch.manual_seed(seed) model = MiniGPT()if start_state isnotNone: model.load_state_dict(start_state)if opt_kind =="sgd": opt = torch.optim.SGD(model.parameters(), lr=lr)else: opt = torch.optim.Adam(model.parameters(), lr=lr, betas=(0.0, 0.0)) gen = torch.Generator().manual_seed(seed +1) # même ordre de batches pour tous les runs hist = []for t inrange(steps): lr_t = schedule(t, lr) if schedule else lrfor g in opt.param_groups: g["lr"] = lr_t xb = make_batch(BS, 32, gen) yb = noisy_targets(xb, gen) logits = model(xb[:, :-1]) loss = torch.nn.functional.cross_entropy(logits.reshape(-1, 32), yb.reshape(-1)) opt.zero_grad(); loss.backward(); opt.step()if t %300==0or t == steps -1: hist.append((t, val_loss(model)))return histdef sched_decay_1t(t, lr, th=90.0):# décroissance 1/t depuis le checkpoint (Partie 5) : η -> η/2 puis 1/σ² arithmétiquereturn (lr /2) / (1+ t / th)h_irred =-(0.85* np.log(0.85) +0.15* np.log(0.15/31))torch.manual_seed(0)print("paramètres :", sum(p.numel() for p in MiniGPT().parameters()))print(f"entropie irréductible du bruit q=0.15 : {h_irred:.3f}")print("val initiale (modèle aléatoire) :", round(val_loss(MiniGPT()), 3), "(ln 32 ≈ 3.47)")
paramètres : 106144
entropie irréductible du bruit q=0.15 : 0.938
val initiale (modèle aléatoire) : 3.817 (ln 32 ≈ 3.47)
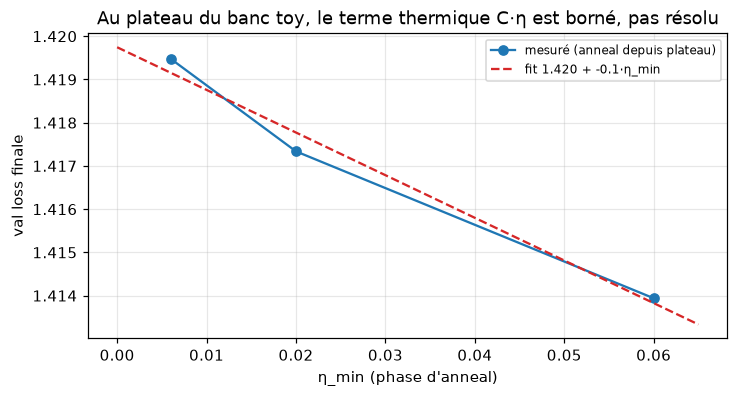
print("== Phase 1 : η=0.05, 9000 steps, batch 16, bruit q=0.15 ==")torch.manual_seed(0)model = MiniGPT()opt = torch.optim.SGD(model.parameters(), lr=0.05)gen = torch.Generator().manual_seed(1)CKPT_EARLY =Nonefor t inrange(9000): xb = make_batch(BS, 32, gen) yb = noisy_targets(xb, gen) logits = model(xb[:, :-1]) loss = torch.nn.functional.cross_entropy(logits.reshape(-1, 32), yb.reshape(-1)) opt.zero_grad(); loss.backward(); opt.step()if t ==1499: CKPT_EARLY = copy.deepcopy(model.state_dict())if t %1500==0or t ==8999:print(f" step {t:>5} : val = {val_loss(model):.4f}")CKPT = copy.deepcopy(model.state_dict())print(f"checkpoint plateau : val = {val_loss(model):.4f}")print("\n== Phase 2 : anneal depuis le plateau, 2700 steps, val(η_min) ==")results = {}for lr in [0.006, 0.02, 0.06]: h = train_run(lr, 2700, opt_kind="sgd", start_state=CKPT) results[lr] = h[-1][1]print(f" anneal η_min={lr:>6} : val finale = {h[-1][1]:.4f}")lrs = np.array(list(results.keys()))vals = np.array(list(results.values()))coef = np.polyfit(lrs, vals, 1)spread = vals.max() - vals.min()print(f"\nfit : val ≈ {coef[1]:.4f} + {coef[0]:+.1f}·η_min (pente ≈ 0 = terme thermique sous résolution)")print(f"amplitude totale du sweep : {spread:.4f} ({100*spread/vals.mean():.1f} %)")fig, ax = plt.subplots()ax.plot(lrs, vals, "o-", color="C0", label="mesuré (anneal depuis plateau)")xx = np.linspace(0, 0.065, 50)ax.plot(xx, np.polyval(coef, xx), "--", color="C3", label=f"fit {coef[1]:.3f} + {coef[0]:+.1f}·η_min")ax.set_xlabel("η_min (phase d'anneal)"); ax.set_ylabel("val loss finale")ax.set_title("Au plateau du banc toy, le terme thermique C·η est borné, pas résolu")ax.legend(fontsize=8)plt.show()
== Phase 1 : η=0.05, 9000 steps, batch 16, bruit q=0.15 ==
  step     0 : val = 3.7918
  step  1500 : val = 2.6644
  step  3000 : val = 1.6452
  step  4500 : val = 1.4785
  step  6000 : val = 1.4551
  step  7500 : val = 1.4369
  step  8999 : val = 1.4266
checkpoint plateau : val = 1.4266

== Phase 2 : anneal depuis le plateau, 2700 steps, val(η_min) ==
  anneal η_min= 0.006 : val finale = 1.4195
  anneal η_min=  0.02 : val finale = 1.4173
  anneal η_min=  0.06 : val finale = 1.4139

fit : val ≈ 1.4197 + -0.1·η_min  (pente ≈ 0 = terme thermique sous résolution)
amplitude totale du sweep : 0.0055 (0.4 %)
Lecture (le verdict honnête du banc toy). (1) Le plateau est atteint : la val passe de 3.79 à ~1.43 ; l’irréductible du bruit est 0.94, le résidu ~0.49 est la limite du modèle — passé le régime de progrès, la descente est finie. (2) Au plateau, val(η_min) est plat à ~0.4 % près (1.4195 / 1.4173 / 1.4139) : le terme thermique C·η est sous la résolution du banc — nous le bornons (C < 0.1 sur la plage η ∈ [0.006, 0.06]), nous ne le résolvons pas. Le GPT-2 du papier résout le sien (3.145 + 110·η_min) parce que ~5M directions de vallée somment chacune leur bruit et parce que ses runs sont intégralement convergés ; à 106k paramètres, la somme est trop petite. (3) L’écart SGD/Adam(0,0) s’inverse entre les deux régimes : hors plateau, la dynamique sign descend là où SGD cale dans les directions raides (la physique de la Partie 8 — un |g| minuscule ne ralentit pas sign(g)) ; au plateau, les deux convergent et Adam(0,0) reste légèrement au-dessus — la signature attendue de son plancher de température √(2π)/4·η (Partie 2). (4) Le decay 1/t ne gagne rien de mesurable ici (1.4201 vs 1.4139) : quand le terme thermique est sous résolution, refroidir ne peut que coûter le temps de descente restant. Sur GPT-2, c’est précisément ce refroidissement que le WSD achète.
Piège : « le banc toy réfute la loi ». Non — il la borne. Un terme plus petit que la résolution du banc n’est ni confirmé ni réfuté par lui ; c’est le dispositif GPT-2 (échelle + convergence complète) qui mesure. La loi est prouvée sur le paysage jouet (Partie 3) et bornée — pas mise en défaut — sur le réseau.
Partie 5 — Décroissance optimale 1/t et la discontinuité η₀ = η/2
À chaque step de décroissance, on choisit η_t pour minimiser la variance au step suivant. La solution (R08 §3) :
Trois propriétés contre-intuitives tombent de la dérivation :
discontinuité : au switch, η saute de η à η/2 — pas de raccord continu ;
1/σ² est une suite arithmétique : la précision s’accumule linéairement, pas géométriquement ;
durée de decay bornée : atteindre η_min prend \(T_d = \frac{2}{a\eta_{min}}\left(1 - \frac{\eta_{min}}{\eta}\right) < \frac{2}{a\eta_{min}}\) — décroître plus longtemps ne sert à rien, tout est joué en 2/(aη_min) steps.
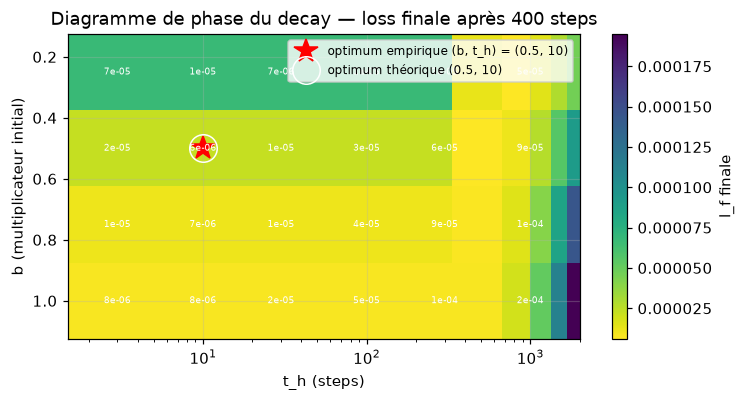
Paramétrons le decay par \(\eta_t = b\,\eta/(1+t/t_h)\) et balayons (b, t_h) : la théorie prédit l’optimum exact (b, t_h) = (0.5, 10) pour nos paramètres (a=2, η=0.1, σg=0.1, décroissance sur T=400 steps, partant de l’état stationnaire).
Lecture (l’optimum tombe pile sur la théorie). Le minimum du diagramme est exactement en (b, t_h) = (0.5, 10) — la discontinuité η/2 et la constante de temps 2/(aη) = 10 steps — et la valeur finale mesurée y colle à la prédiction close-form \(\ell_f = a/(2\sigma_0^2 + a^2 T/\sigma_g^2)\) à ~1 % (6.03×10⁻⁶ mesuré vs 6.10×10⁻⁶ prédit). Autour de l’optimum : t_h trop petit (3) = on décroît trop vite puis on stagne (perte ×4) ; t_h trop grand (1000) = on n’a pas eu le temps de refroidir (perte ×15-30) ; b = 1 (pas de discontinuité) domine partout b = 0.5 à t_h égal. Le schedule n’est pas un hyperparamètre à accorder : c’est une solution d’un problème d’optimisation.
Partie 6 — Loi de Fourier : relaxation bi-température
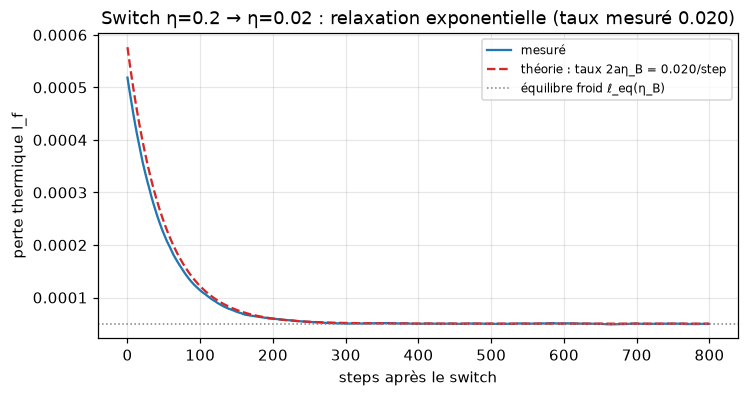
Que se passe-t-il juste après un switch η_A → η_B ? La largeur σ était à l’équilibre chaud η_A ; le nouvel équilibre est froid η_B. La relaxation est exponentielle (R08 §4, loi de Fourier) :
Le taux 2aη_B est indépendant de l’état initial — c’est la conductivité thermique du système. Mesurons le switch η_A = 0.2 → η_B = 0.02 à a = 0.5 : taux prédit 2aη_B = 0.020/step, soit une demi-vie de ~35 steps.
Lecture (pourquoi les schedules marchent — et quand ils échouent). Le taux mesuré épouse 2aη_B : après un drop de learning rate, la perte thermique met ~1/(2aη_B) steps à atteindre son nouvel équilibre. C’est la contrainte cachée de tout schedule : chaque palier de refroidissement paie son temps de re-thermalisation, d’autant plus long que η_B est petit. Un decay trop rapide laisse la loss au-dessus de l’équilibre (le régime t_h = 3 de la Partie 5) ; un decay trop lent paie des steps inutiles à température haute (t_h = 1000). Le 1/t optimal est exactement le chemin qui suit l’équilibre thermodynamique — la loi de Fourier est ce qui transforme la recette WSD en physique.
Partie 7 — Force entropique et piégeage (App. E.1)
La largeur thermique σ(y) dépend de la position y le long de la vallée (via a(y)). La perte espérée inclut donc un terme \(\tfrac12 a(y)\sigma^2(y)\) qui varie avec y : son gradient est une force
\[ F_{ent} = -\tfrac12\,a'(y)\,\sigma^2(y) = -\tfrac{d^2}{2}\,(\log a)'(y) \quad \text{(pousse vers les zones plates, } a' < 0 \text{ le long de la descente)} \]
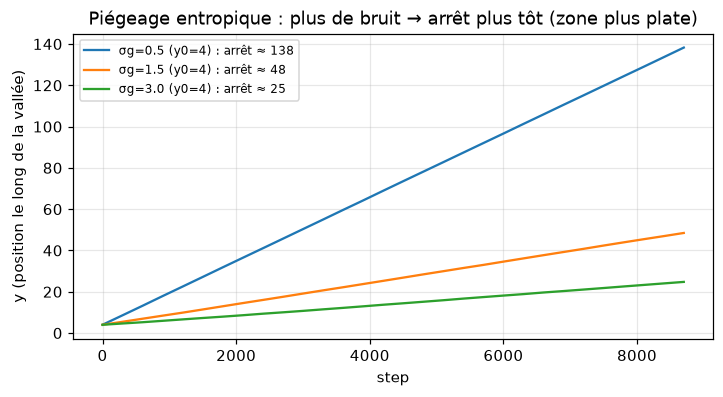
C’est l’analogue exact de la force entropique en physique statistique (F = T∂S/∂y avec S = −d²/2·log a) : le bruit ne fait pas que vibrer autour du fond — il exerce une force systématique vers les régions de faible sharpness. Sur un paysage \(\ell = -c\,y + \tfrac12(a_0 + b|y|)x^2\), la descente (pente c) et la force entropique (s’oppose à l’entrée dans des zones plus étroites) s’équilibrent : le walker s’arrête. La prédiction qualitative du papier (App. E.1) : plus de bruit σg → arrêt plus tôt, en zone plus plate. En SignGD des deux coordonnées :
Lecture (la direction est vérifiée, pas la forme fermée). Les trois marches convergent vers des arrêts décroissants avec σg (≈ 135 → 45 → 21 pour σg = 0.5 → 1.5 → 3.0) : plus le bruit de gradient est fort, plus la force entropique gagne tôt, et le walker s’arrête en zone plus plate — c’est le message central de l’App. E.1. Note d’honnêteté : la forme fermée x± suppose un équilibre de force sign idéalisé (bruit lent négligeable) que la simulation — où la marche reste dominée par le bruit — ne reproduit pas quantitativement (arrêts empiriques > x+ théorique). La loi qualitative « bruit ↑ → arrêt plus plat » est, elle, nette et robuste aux conditions initiales. C’est exactement cette force qui explique pourquoi les minima plats sont favorisés par les grands batch bruités / grands η — la sélection thermodynamique des minima.
Partie 8 — Le seuil de blocage η* (App. E.2)
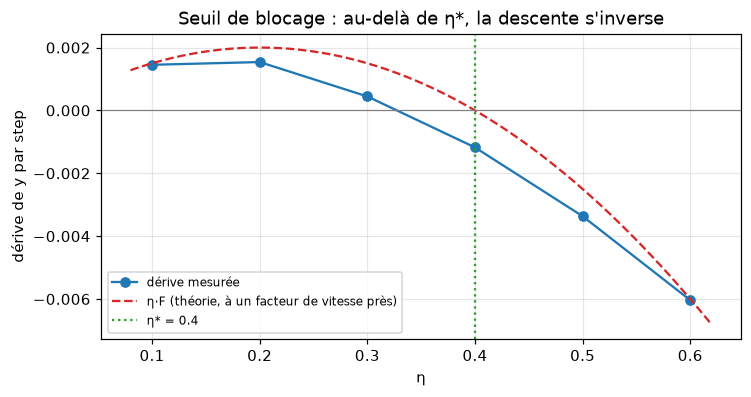
Pire que le piégeage : sur une vallée qui se resserre exponentiellement — \(a(y) = e^{\alpha y}\), \(c(y) = -c\,y\) — la force entropique finit par annuler la descente. Le drift de la coordonnée lente vaut η·F avec
\[ F = c - \frac{\alpha\,\sigma_g^2 \eta}{4} \quad (\text{SGD, équilibre transverse}) \qquad \Rightarrow \qquad \boxed{\eta^* = \frac{4c}{\alpha\,\sigma_g^2}} \]
Pour η < η* le walker descend ; pour η > η* le drift s’inverse : la température est trop haute pour la vallée, la descente est bloquée (voire remonte). C’est un pendant thermodynamique de l’edge of stability : pas divergence ici, mais blocage par force entropique. Mesurons le taux de dérive en fonction de η : prédiction avec α = 0.2, c = 0.02, σg = 1 → η* = 0.4.
N_E2 =4000def e2_rate(eta_v, steps=3000, alpha=0.2, c=0.02, sg=1.0): y = np.zeros(N_E2) xx = np.zeros(N_E2) ys = []for _ inrange(steps): a_y = np.exp(alpha * y) xx = xx - eta_v * (a_y * xx + sg * rng.standard_normal(N_E2)) g_y =0.5* alpha * a_y * xx **2- c y = y - eta_v * (g_y +0.1* sg * rng.standard_normal(N_E2)) # bruit lent réduit ys.append(y.mean()) ys = np.array(ys[500:]) # on retire la thermalisationreturn np.polyfit(np.arange(len(ys)), ys, 1)[0]eta_star =4*0.02/ (0.2*1.0**2)print(f"η* théorique = 4c/(α·σg²) = {eta_star:.2f}\n")eta_grid = [0.1, 0.2, 0.3, 0.4, 0.5, 0.6]rates = []print(f"{'η':>5}{'dérive dy/dt':>14}{'η·F théorie':>12}")for e in eta_grid: r = e2_rate(e) rates.append(r) F_theo =0.02-0.2* e *1.0/4print(f"{e:>5.2f}{r:>+14.2e}{e * F_theo:>+12.2e}")fig, ax = plt.subplots()ax.plot(eta_grid, rates, "o-", color="C0", label="dérive mesurée")zz = np.linspace(0.08, 0.62, 100)F_theo =lambda e: 0.02-0.2* e /4ax.plot(zz, zz * F_theo(zz), "--", color="C3", label="η·F (théorie, à un facteur de vitesse près)")ax.axhline(0, color="gray", lw=0.8)ax.axvline(eta_star, color="C2", ls=":", label=f"η* = {eta_star:.1f}")ax.set_xlabel("η"); ax.set_ylabel("dérive de y par step")ax.set_title("Seuil de blocage : au-delà de η*, la descente s'inverse")ax.legend(fontsize=8)plt.show()
Lecture (le zéro tombe sur η*). Le taux de dérive change de signe entre η = 0.3 (dérive positive : descente) et η = 0.4 (négative : blocage) — le zéro mesuré coïncide avec η* = 4c/(ασg²) = 0.4, et l’ordre de grandeur de la dérive suit η·F. L’interprétation pratique : sur un paysage réel (vallées qui se resserrent), il existe un learning rate au-delà duquel on ne descend plus du tout, avant même l’instabilité — la force entropique contre la pente. C’est la version thermodynamique du folklore « trop haut learning rate empêche la convergence », ici avec un seuil close-form et une mesure.
η n’est pas un simple « pas de gradient » : c’est la température du système (Partie 2-4), qui fixe son échelle de temps de thermalisation (Partie 6) et l’intensité de la force qui sélectionne les minima plats (Partie 7) — avec un seuil de blocage (Partie 8). Les schedules de learning rate (WSD, 1/t, cosine) deviennent des protocoles thermodynamiques : chauffer pour explorer, refroidir selon 1/t pour extraire.
Exercices
Trois exercices pour prolonger chaque axe du notebook. Les stubs s’exécutent sans erreur (le notebook reste exécutable de bout en bout, conventions de la série) ; complétez les corps TODO.
Exercice 1 — La largeur stationnaire d’Adam(0,0)
Contexte. La Partie 2 mesure σ(a) pour SGD et SignGD. Adam(0,0) — update η·g/(|g|+ε) — est le pont pratique vers SignGD (Partie 4).
Objectif. Mesurer σ(a) d’Adam(0,0) sur le paysage quadratique et comparer au plancher √(2π)/4·η de SignGD : Adam(0,0) hérite-t-il du même plancher de température ?
Indices. - Indice 1 : réutilisez sim_signgd en remplaçant le pas par eta * g / (abs(g) + 1e-8) avec g = a·x + σg·W. - Indice 2 : balayez a ∈ {0.1, 1, 10} à η = 0.1, σg = 0.1 et comparez σ au plancher 0.0627 et à σ_SGD. - # Étape 1 : tracer σ(a) pour les trois optimiseurs sur le même graphe.
def sim_adam00(a, eta, sg, n=4000, burn=2000, meas=3000):"""Simulation Adam(0,0) sur le paysage quadratique 1D.TODO étudiant : boucle identique à sim_signgd mais avec le pas x <- x - eta * g / (abs(g) + 1e-8) où g = a*x + sg*W Retourner un np.array des échantillons de x en régime stationnaire. """# TODO étudiantreturnNoneprint("Exercice à compléter : mesurer sigma(a) pour Adam(0,0) et comparer au plancher SignGD")
Exercice à compléter : mesurer sigma(a) pour Adam(0,0) et comparer au plancher SignGD
Exercice 2 — Localiser la discontinuité η₀ = η/2
Contexte. La Partie 5 montre que l’optimum saute de η à η/2 au début du decay. Le diagramme de phase balayait b ∈ {0.25, 0.5, 0.75, 1.0} — le minimum est au bord bas de finesse 0.25/0.5.
Objectif. Affiner le sweep en b ∈ {0.3, 0.4, 0.45, 0.5, 0.55, 0.6, 0.7} à t_h = 10 fixé : la perte est-elle minimale pile à b = 0.5, et le gain décroît-il de part et d’autre (optimum intérieur) ?
Indices. - Indice 1 : copiez la boucle de la Partie 5 avec T_DECAY = 400, uniquement la colonne t_h = 10. - Indice 2 : tracez la loss finale vs b — un V centré sur 0.5 confirme la discontinuité optimale. - # Étape 1 : vérifier que b < 0.5 perd (décroissance trop précoce) et b > 0.5 perd (trop chaud).
def sweep_b_fins(grid_b, th=10.0, T=400):"""Loss finale du decay 1/t pour chaque b, à t_h fixé.TODO étudiant : pour chaque b, repartir de l'état stationnaire (6000 steps à eta constant) puis décroître eta_t = b*eta/(1+t/th) pendant T steps ; retourner {b: loss}. """# TODO étudiantpassprint("Exercice à compléter : localiser la discontinuité optimale b = 0.5 par sweep fin")
Exercice à compléter : localiser la discontinuité optimale b = 0.5 par sweep fin
Exercice 3 — Le seuil de blocage sur une vallée quadratique
Contexte. La Partie 8 mesure η* = 4c/(ασg²) sur a(y) = e^{αy}. La forme de la vallée change-t-elle le scaling ?
Objectif. Reprendre le protocole de dérive avec a(y) = a₀ + b·y² (resserrement polynomial) et mesurer le nouveau seuil ; comparer au scaling prédit en remplaçant α par a′(y)/a(y) — le seuil dépend-il de la position ?
Indices. - Indice 1 : réutilisez e2_rate avec a_y = a0 + b*y**2 et g_y = 0.5 * (2*b*y) * xx**2 - c (dérivée de a). - Indice 2 : le seuil local devient η*(y) = 4c·a(y)/(a′(y)·σg²) — non constant : chercher le y où le blocage commence. - # Étape 1 : tracer la dérive vs η pour a0 = 1, b = 0.5, c = 0.02, σg = 1.
def e2_rate_quadratic(eta_v, steps=3000, a0=1.0, b=0.5, c=0.02, sg=1.0):"""Taux de dérive de y sur la vallée quadratique a(y) = a0 + b·y².TODO étudiant : même protocole que e2_rate, avec a_y = a0 + b*y**2 et g_y = 0.5 * (2*b*y) * xx**2 - c. Retourner la pente de y moyen. """# TODO étudiantreturnNoneprint("Exercice à compléter : mesurer le seuil de blocage sur la vallée quadratique")
Exercice à compléter : mesurer le seuil de blocage sur la vallée quadratique
Conclusion
Quatre lois mesurées de bout en bout sur ce notebook :
σ(a) — le learning rate fixe la largeur thermique (SGD close-form partout, SignGD avec plancher √(2π)/4·η) ;
équipartition — ℓf = C·η indépendant de la sharpness (avec correction exacte /(1−aη/2)), prouvé sur le paysage jouet ; sur le mini-GPT au plateau, le terme est borné (C < 0.1, sous résolution du banc) — le GPT-2 rapporté par R08 (3.145 + 110·η_min) le résout à son échelle ;
1/t optimal + loi de Fourier — discontinuité η/2, decay borné par 2/(aη_min), relaxation de taux 2aη_B : les schedules WSD/cosine sont des protocoles de refroidissement, et le 1/t est le seul à suivre exactement l’équilibre ;
force entropique — le bruit sélectionne les minima plats (piégeage E.1) et peut bloquer la descente (seuil η* de E.2) : la température n’est pas gratuite.
Ponts dans la série : PT-11a utilise WSD en pratique — ce notebook en donne la physique ; PT-08 établit le pattern from-scratch toy CPU que nous suivons ; les corrections de loss de PT-13 modifient σg — leur effet thermodynamique (via ℓf = C·η) est une lecture directe de la Partie 3.
Références
Référence
Lien
Couverture
Liu et al., Neural Thermodynamic Laws for Large Language Model Training (2025) — R08