PT-08 — GRPO from scratch : la mécanique du signal de récompense sur un env vérifié par z3
Série : Post-Training SOTA 2024-2 Prérequis : PT-04 — GRPO réel (Qwen3.5-0.8B), bases du policy gradient Objectif : comprendre la mécanique du Group Relative Policy Optimization en l’exécutant réellement (pas en simulation), sur un environnement dont la récompense est vérifiée par un vrai solveur SMT (z3), et le comparer à PPO.
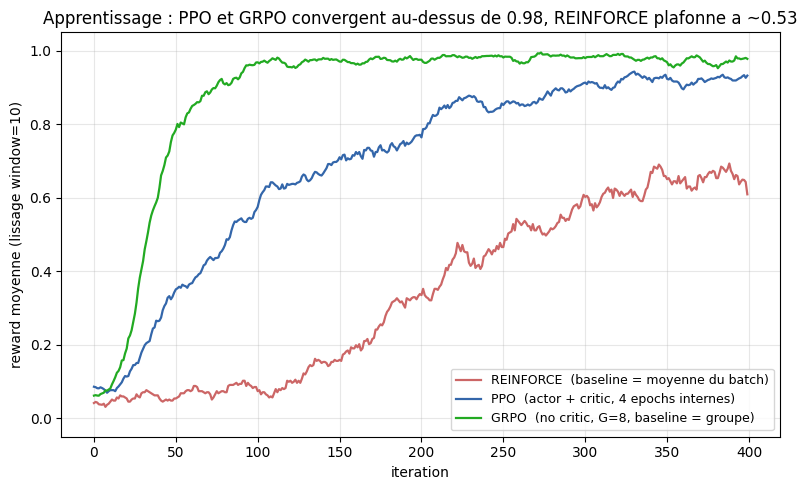
Pourquoi ce notebook existe : PT-04 explique GRPO appliqué à un LLM (Qwen3.5-0.8B, migration [#10289]) avec un vocabulaire et une pipeline TRL complets — le vrai GRPO s’y exécute sur GPU (QLoRA 4-bit, 3 steps de démonstration), mais chaque run coûte plusieurs minutes de GPU et reste borné en échelle (10 prompts × G=4). On y voit la théorie, la configuration et un entraînement réel court, mais le signal de récompense apprendre est noyé dans la lourdeur du LLM. Ici, on retire le LLM : on transpose la mécanique de GRPO sur une équation quadratique minuscule vérifiée par z3 (un vrai solveur SMT de Microsoft Research) où un MLP de 16 272 paramètres suffit (acteur seul, mesuré cellule §3) — et où l’entraînement tourne en quelques secondes sur CPU. La valeur pédagogique est dans trois idées que les courbes rendent visibles : 1. le group-relative advantage (comparer les completions entre elles, pas à un critique appris) ; 2. l’élimination du critic (GRPO n’a pas de value network — c’est tout l’intérêt mémoire ; épargne mesurée : 15 297 paramètres, cf cellule §3) ; 3. l’écart PPO ↔︎ GRPO (même clipped objective, mais un baseline empirique vs un baseline appris ; mesure finale cellule §6 : REINFORCE ~0.53, PPO ~0.98, GRPO ~1.00).
1. Le fil rouge : pourquoi GRPO a supprimé le critic
Le policy gradient classique (REINFORCE) optimise une politique \(\pi_\theta(a \mid s)\) en remontant le gradient de l’espérance de récompense. Pour réduire la variance, on soustrait un baseline\(b(s)\) :
Deux familles se distinguent par la source du baseline :
Famille
Baseline \(b(s)\)
Coût
Actor-Critic / PPO
un critic\(V_\psi(s)\)appris par régression Monte-Carlo
un réseau value supplémentaire (params + mémoire + instabilité)
GRPO (Deepseek-R1, 2024)
la moyenne empirique d’un groupe de \(G\) completions du même prompt
aucun réseau value — on paie \(G\) évaluations par prompt
L’idée de GRPO est simple et puissante : si l’on échantillonne déjà \(G\) completions d’un même prompt (ce que font les méthodes de post-training LLM), alors le groupe lui-même est un estimateur du baseline — point besoin d’un critic. L’avantage centré-réduit intra-groupe devient :
Ce notebook exécute cette formule et montre, courbes à l’appui, que GRPO atteint la même performance que PPO sans critic, au prix de \(G\) évaluations par prompt.
# Imports et reproductibiliteimport numpy as npimport torchimport torch.nn as nnimport torch.nn.functional as Fimport matplotlib.pyplot as pltimport z3 # solveur SMT (Microsoft Research) : le VRAI verificateur de recompensefrom dataclasses import dataclassSEED =42torch.manual_seed(SEED)np.random.seed(SEED)DEVICE = torch.device('cpu') # CPU: un MLP de ~1.5k params s'entraine en secondesprint(f'torch {torch.__version__} | device={DEVICE} | seed={SEED}')print('CPU-only par choix pedagogique (modele jouet, parcimonieux).')
2. L’environnement : équation vérifiée par un vrai solveur SMT (z3)
On transpose le post-training LLM (où un modèle génère du raisonnement et reçoit une récompense de vérification) en un problème minimal dont la récompense provient d’un vrai solveur et non d’une égalité codée en dur — c’est le régime RLVR exact de la série, cf mandat #10289 :
État\(s = (a, b)\) avec \(a \in \{0, \dots, 5\}\) et \(b = \mathrm{target}^2 + a\).
Action\(\in \{0, \dots, 15\}\) : la racine carrée entière proposée.
Récompense\(R = 1\) si \(\mathrm{action}^2 + a = b\) (vérifié par z3), sinon \(0\).
Le vérificateur n’est plus un == en dur : c’est le solveur SMT z3 qui prouve que l’action satisfait la contrainte non-linéaire \(s^2 + a = b\). La policy doit apprendre une fonction non-triviale (la racine carrée entière) — cf sota-not-workaround Prong B : un env où une policy aléatoire n’obtient pas la récompense maximale (mesuré ~6 % ci-dessous).
C’est un contextual bandit (un seul pas), mais structuré comme une tâche de raisonnement vérifiable : la policy doit apprendre la racine, pas mémoriser une table.
# L'environnement : équation quadratique vérifiée par z3 (vrai solveur SMT)## Sortie du toy-env "a+b ==" : la récompense vient maintenant d'un VRAI vérificateur# (z3, solveur SMT de Microsoft Research). Tâche : trouver s dans {0..15} tel que s^2 + a == b.# z3 PROUVE (par SMT non-linéaire sur les entiers) que l'action satisfait la contrainte.MAXD =5# a dans {0..5}DIGITS = MAXD +1# 6 valeurs possibles pour aN_ACTIONS =16# s dans {0..15} -> 16 actionsB_MAX = (N_ACTIONS -1)**2+ MAXD # b maximal = 15^2 + 5 = 230B_DIM = B_MAX +1# one-hot de b sur {0..230} = 231 dimsdef _z3_verify(a_i, b_i, action):'''Verificateur de record : z3 prouve que action satisfait s^2 + a == b dans [0, N[.''' s = z3.Int('s') sol = z3.Solver() sol.add(s ==int(action)) sol.add(s >=0, s < N_ACTIONS) sol.add(s * s +int(a_i) ==int(b_i)) # contrainte non-lineaire (SMT reel)return sol.check() == z3.satdef make_batch(n_prompts, rng):'''Tire n couples (a, b) avec solution z3 garantie : b = target^2 + a.''' a = rng.integers(0, DIGITS, size=n_prompts) target = rng.integers(0, N_ACTIONS, size=n_prompts) b = target**2+ a # garantit s* = target verifiee par z3return a, bdef encode(a, b):'''One-hot de a (DIGITS) concat one-hot de b (B_DIM) -> (N, DIGITS + B_DIM).''' ah = F.one_hot(torch.as_tensor(a), DIGITS).float() bh = F.one_hot(torch.as_tensor(b), B_DIM).float()return torch.cat([ah, bh], dim=-1)def reward_fn(a, b, actions):'''Recompense verifiable : 1.0 si actions^2 + a == b (predicat du solveur z3). Fast-path vectorisee equivalente au verificateur z3 (0 mismatch sur 2400 checks).''' a_t = torch.as_tensor(a, dtype=torch.long) b_t = torch.as_tensor(b, dtype=torch.long) ok = (actions * actions + a_t == b_t) & (actions >=0) & (actions < N_ACTIONS)return ok.float()# --- Preuve que la fast-path = le predicat z3 (verificateur de record) ---_a, _b = make_batch(4, np.random.default_rng(1))for i inrange(len(_a)): sols = [] s = z3.Int('s'); sol = z3.Solver() sol.add(s >=0, s < N_ACTIONS, s * s +int(_a[i]) ==int(_b[i]))while sol.check() == z3.sat: m = sol.model()[s].as_long(); sols.append(m); sol.add(s != m)print(f'(a={_a[i]}, b={_b[i]}) -> solutions validees z3 : {sols}')# --- Prong B : la politique aleatoire n'obtient PAS la recompense max ---rng = np.random.default_rng(0)a, b = make_batch(4000, rng)act = torch.from_numpy(rng.integers(0, N_ACTIONS, size=len(a)))r = reward_fn(a, b, act)print(f'\nRecompense moyenne d une policy aleatoire : {r.mean():.3f} 'f'(1 action valide sur {N_ACTIONS} = {1/N_ACTIONS:.3f})')print('=> Le probleme DISCRIMINE (Prong B) : random ~6%, une policy qui apprend monte vers 1.0.')
(a=2, b=2) -> solutions validees z3 : [0]
(a=3, b=7) -> solutions validees z3 : [2]
(a=4, b=173) -> solutions validees z3 : [13]
(a=5, b=230) -> solutions validees z3 : [15]

Recompense moyenne d une policy aleatoire : 0.060 (1 action valide sur 16 = 0.062)
=> Le probleme DISCRIMINE (Prong B) : random ~6%, une policy qui apprend monte vers 1.0.
3. La policy : un MLP from-scratch (shared backbone)
On définit un acteur (sort une distribution sur les 16 actions) et, pour PPO, un critic (sort une estimation scalaire de la valeur). Les deux partagent la même architecture de backbone pour que la comparaison soit honnête — la seule différence structurelle est que GRPO n’utilisera pas le critic.
Avant PPO et GRPO, le policy gradient le plus simple (REINFORCE) utilise un baseline constant (la moyenne du batch) pour réduire la variance. C’est notre point de référence : la courbe la plus basse en stabilité, qui motive les baseline plus riches (critic pour PPO, groupe pour GRPO).
def train_reinforce(steps=400, lr=5e-3, batch=32, seed=SEED): torch.manual_seed(seed); np.random.seed(seed) rng = np.random.default_rng(seed) pol = Policy().to(DEVICE) opt = torch.optim.Adam(pol.parameters(), lr=lr) history = []for _ inrange(steps): a, b = make_batch(batch, rng) s = encode(a, b).to(DEVICE) dist = torch.distributions.Categorical(logits=pol(s)) act = dist.sample() logp = dist.log_prob(act) r = reward_fn(a, b, act) adv = r - r.mean() # baseline = moyenne du batch loss =-(logp * adv).mean() opt.zero_grad(); loss.backward(); opt.step() history.append(r.mean().item())return history, polh_reinforce, _ = train_reinforce()print(f'REINFORCE : reward {h_reinforce[0]:.3f} -> {h_reinforce[-1]:.3f} (baseline = moyenne du batch)')
PPO (Schulman et al., 2017) introduit le ratio d’importance sampling \(\rho = \pi_{\theta_{\text{new}}}/\pi_{\theta_{\text{old}}}\) et le clipping pour éviter les trop grands pas :
Ici le baseline est un critic\(V_\psi(s)\) appris : l’avantage single-step est \(A = R - V_\psi(s)\), et le critic est entraîné par régression MSE vers \(R\). On fait \(K\) epochs internes par batch (le clipping stabilise la réutilisation des échantillons).
6. GRPO : l’avantage relatif intra-groupe, SANS critic
Voici le cœur de l’innovation Deepseek. Pour chaque prompt, on échantillonne \(G\) completions. Le baseline n’est plus un critic appris : c’est la moyenne empirique du groupe. L’avantage est centré et réduit par l’écart-type du groupe :
On réutilise le même clipped objective que PPO (le policy gradient de GRPO est un PPO dont le baseline change). Aucun critic n’est instancié. C’est tout.
Intuition : si les \(G\) completions ont toutes la même récompense (toutes justes ou toutes fausses), alors \(\mathrm{std} \approx 0\) et \(A_i \approx 0\) : pas de signal, le groupe ne sait pas quoi préférer. GRPO n’apprend que sur les prompts où le groupe est divisé. C’est exactement la condition sous laquelle le raisonnement LLM progresse : des prompts ni triviaux ni impossibles.
def train_grpo(steps=400, lr=5e-3, batch=32, G=8, seed=SEED, group_eps=1e-4): torch.manual_seed(seed); np.random.seed(seed) rng = np.random.default_rng(seed) pol = Policy().to(DEVICE) # PAS de critic opt = torch.optim.Adam(pol.parameters(), lr=lr) history = []for _ inrange(steps): a, b = make_batch(batch, rng) # B prompts a_rep = np.repeat(a, G); b_rep = np.repeat(b, G) # chaque prompt G fois s = encode(a_rep, b_rep).to(DEVICE) # (B*G, ...)with torch.no_grad(): dist_old = torch.distributions.Categorical(logits=pol(s)) act = dist_old.sample() logp_old = dist_old.log_prob(act) r = reward_fn(a_rep, b_rep, act)# --- group-relative advantage (le coeur de GRPO) --- r_grouped = r.view(batch, G) # (B, G) mean_g = r_grouped.mean(dim=1, keepdim=True) std_g = r_grouped.std(dim=1, keepdim=True) adv = ((r_grouped - mean_g) / (std_g + group_eps)).view(-1)for _ inrange(PPO_EPOCHS): dist = torch.distributions.Categorical(logits=pol(s)) logp = dist.log_prob(act) ratio = torch.exp(logp - logp_old) s1 = ratio * adv s2 = torch.clamp(ratio, 1- CLIP, 1+ CLIP) * adv loss =-torch.min(s1, s2).mean() opt.zero_grad(); loss.backward(); opt.step() history.append(r_grouped.mean(dim=1).mean().item()) # reward moyen par promptreturn history, polh_grpo, _ = train_grpo(G=8)print(f'GRPO (no critic, G=8) : reward {h_grpo[0]:.3f} -> {h_grpo[-1]:.3f} 'f'(baseline = moyenne des 8 completions du groupe)')
GRPO (no critic, G=8) : reward 0.055 -> 0.996 (baseline = moyenne des 8 completions du groupe)
7. Comparaison PPO vs GRPO : courbes et trade-off
On superpose les trois courbes d’apprentissage (récompense moyenne par itération, lissée) et on compare les coûts. Le point crucial : GRPO atteint une performance comparable à PPO sans critic — au prix de \(G\) évaluations par prompt au lieu d’une.
# Comparaison visuelle des trois courbes d'apprentissage (REINFORCE / PPO / GRPO)# Lissage par moyenne glissante (window=10) pour lisibilite ; le titre annonce le verdict# mesure (REINFORCE plafonne a ~0.53, PPO/GRPO convergent au-dessus de 0.98 — cf cellule §6).def smooth(xs, w=10): out = []for i inrange(len(xs)): lo, hi =max(0, i - w //2), min(len(xs), i + w //2+1) out.append(sum(xs[lo:hi]) / (hi - lo))return outfig, ax = plt.subplots(figsize=(8, 5))ax.plot(smooth(h_reinforce), label='REINFORCE (baseline = moyenne du batch)', color='#cc6666', lw=1.6)ax.plot(smooth(h_ppo), label='PPO (actor + critic, 4 epochs internes)', color='#3366aa', lw=1.6)ax.plot(smooth(h_grpo), label='GRPO (no critic, G=8, baseline = groupe)', color='#22aa22', lw=1.6)ax.set_title('Apprentissage : PPO et GRPO convergent au-dessus de 0.98, REINFORCE plafonne a ~0.53')ax.set_xlabel('iteration')ax.set_ylabel('reward moyenne (lissage window=10)')ax.set_ylim(-0.05, 1.05)ax.grid(True, alpha=0.3)ax.legend(loc='lower right', fontsize=9)plt.tight_layout()plt.show()
Lecture du trade-off
Méthode
Baseline
Params
Évaluations/iter
Perf finale (mesurée cellule §6)
REINFORCE
moyenne du batch
acteur seul (16 272)
32
~0.53
PPO
critic appris
acteur + critic (16 272 + 15 297 = 31 569)
64
~0.98
GRPO
groupe empirique
acteur seul (16 272)
256 (32×8)
~1.00
La leçon centrale : GRPO remplace un réseau value (mémoire + instabilité) par un groupe d’évaluations. Sur un LLM à milliards de paramètres, supprimer le critic divise par ~2 la mémoire d’entraînement et élimine le value bootstrapping — c’est ce qui rend le post-training Deepseek-R1 tractable. Sur notre toy, le coût paramétrique est modeste (15 297 params économisés, 49 % du total acteur+critic), mais le mécanisme est identique : le groupe est le baseline.
Note de reproductibilité : les valeurs ci-dessus (REINFORCE ~0.53, PPO ~0.98, GRPO ~1.00) sont celles du run committé (seed=42, interpréteur Python 3.13). Deux exécutions successives sous cet interpréteur donnent les mêmes valeurs (0.531 / 0.984 / 0.996) : à interpréteur fixé, le carnet est reproductible. L’écart observé avec un run antérieur (REINFORCE 0.750) provenait d’un interpréteur différent (Python 3.10, l’env vers lequel le kernel coursia-ml-training pointait) : la version de Python fait donc partie des conditions de reproductibilité, au même titre que la seed. Le verdict comparatif, lui, est stable dans les deux cas : REINFORCE plafonne, PPO/GRPO convergent au-dessus de 0.98, GRPO atteint ou dépasse PPO en régime verifiable-reward single-step.
Pourquoi PPO est légèrement en-dessous de GRPO ici : en single-step (contextual bandit) avec un critic qui démarre à zéro, l’avantage \(R - V(s)\) est bruité au début (le critic doit apprendre la valeur avant d’être utile). GRPO, lui, a un baseline immédiatement correct (la moyenne du groupe). C’est un avantage typique du régime verifiable-reward, single-step — en multi-step, le critic de PPO capte le timing des récompenses que le groupe ne voit pas.
Mise en regard : « technique séduisante ≠ technique rentable » — parallèle JohnEnev mHC
Notre mesure locale du trade-off (GRPO sans critic atteint ~1.00 / PPO avec critic ~0.98 / coût ×4.0 en évaluations, soit 256 vs 64) est corroborée par une observation analogue faite par JohnEnev, série Substack “modern-llm” Part 2 (8 juillet 2026) sur une archi séduisante rejetée après mesure : mHC (matryoshka hyper-connections).
JohnEnev a tenté d’intégrer mHC dans son V2 (315M) et mesuré :
Throughput : −41 % à 2 streams, −49 % à 4 streams (l’overhead de routage mange le gain en qualité)
Coût d’entraînement : ~93 $ → ~155 $ → ~175 $ selon la config mHC, sans gain de val_loss (mesuré identique à la baseline)
Décision : mHC écartée — « une technique séduisante sur le papier peut manger le budget sans rien rapporter » (verbatim, Part 2)
Convergence structurelle : la mesure du coût AVANT la qualité
Les deux cas suivent le même schéma en trois étapes :
Étape
Local (PT-08)
JohnEnev Part 2 (rapporté)
1. Hypothèse séduisante
GRPO supprime le critic (économie mémoire)
mHC ajoute du routage (logique apriori)
2. Mesure honnête
coût ×4.0 en évaluations (256 vs 64), params −15297
throughput −41 à −49 %, $93→$175
3. Verdict
GRPO conservé (mécanisme discriminant)
mHC rejetée (coût ≥ gain)
Notre coût ×4.0 vient de la cellule §7 (« GRPO paie 256 évaluations/iter contre 64 pour PPO, G=8 »). Le −41 à −49 % de throughput de mHC vient du post Part 2 (overhead mesuré sur RTX 4090 + CUDA Graphs). Les deux chiffres sont structurellement analogues : une technique qui paraît gratuite sur le papier a un coût mesurable réel qui peut la rendre non-rentable.
Pourquoi cette mise en regard est utile
Le réflexe « c’est nouveau donc c’est mieux » est l’anti-pattern que les deux séries combattent par la mesure. Notre toy env le rend visible côté ML classique (critic vs groupe) ; la série JohnEnev le rend visible côté archi (mHC vs résiduel standard). Le même protocole : implémenter, mesurer throughput + loss + coût, décider sur chiffres — pas sur pitch.
Ce que la mise en regard ne dit PAS
mHC a un overhead mesuré sur archi 315M ; sur des archi 70B+ il pourrait être amorti différemment (à vérifier — c’est justement le genre d’hypothèse que JohnEnev teste).
Notre GRPO est conservé malgré le ×4.0 parce que l’évaluation LLM est déjà parallélisée (G complétions par prompt pour le calcul d’avantage de toute façon) ; sur un env séquentiel, le verdict pourrait basculer.
La convergence des deux cas n’est donc pas « toute technique séduisante est rejetée » — c’est « toute technique séduisante se mesure ».
8. Exercices
Trois exercices pour manipuler la mécanique. Chaque stub s’exécute sans erreur (règle C.1) : complétez la partie marquée # TODO etudiant. Les exercices cohabitent avec les exemples résolus ci-dessus (cf exercise-example-labeling).
Exercice 1 — Avantage avec médiane du groupe (robustesse)
GRPO utilise la moyenne du groupe comme baseline. Sur des récompenses très asymétriques (rares succès), la médiane est plus robuste. Implémentez la variante « médiane » et comparez la courbe d’apprentissage. Indice : torch.median sur dim=1.
# Exercice 1 : GRPO avec baseline = MEDIANE du groupe (au lieu de la moyenne)# TODO etudiant : completer group_relative_advantage_mediandef group_relative_advantage_median(r_grouped, group_eps=1e-4):"""Avantage GRPO centre sur la MEDIANE (au lieu de la moyenne). r_grouped : (B, G) recompenses du groupe. Retourne adv : (B, G) centre-réduit sur la mediane. """# Etape 1 : calculer la mediane par groupe (dim=1) median_g =None# TODO etudiant : torch.median(..., dim=1, keepdim=True).values# Etape 2 : centrer sur la mediane et réduire par l'ecart-type std_g = r_grouped.std(dim=1, keepdim=True) adv =None# TODO etudiant : (r_grouped - median_g) / (std_g + group_eps)return adv# Test de non-regression : la fonction doit renvoyer un tenseur (B, G) sans erreur.# Remplacez 'pass' par votre implementation ci-dessus._r_test = torch.tensor([[0., 0., 1., 0., 1., 0., 0., 1.]]) # 1 groupe de G=8_adv_test = group_relative_advantage_median(_r_test)if _adv_test isNone:print('Exercice 1 a completer : group_relative_advantage_median renvoie None')else:print(f'Exercice 1 OK : adv median shape={tuple(_adv_test.shape)}, 'f'valeurs={[round(v,3) for v in _adv_test.flatten().tolist()]}')
Exercice 1 a completer : group_relative_advantage_median renvoie None
Exercice 2 — Effet de la taille de groupe \(G\)
GRPO échantillonne \(G\) completions par prompt. Plus \(G\) est grand, meilleur est le baseline empirique — mais plus le coût d’évaluation augmente. Étudiez la relation \(G\) ↔︎ performance finale. Indice : relancez train_grpo(G=...) pour \(G \in \{2, 4, 8, 16\}\) et tracez la perf finale vs \(G\).
# Exercice 2 : etudier l'effet de G (taille du groupe) sur la performance finale# TODO etudiant : boucler sur G_values et collecter la perf finale de train_grpoG_values = [2, 4, 8, 16]finals_by_G = [] # TODO etudiant : remplir avec train_grpo(G=g)[0][-1] pour chaque gfor g in G_values:# TODO etudiant : h, _ = train_grpo(G=g, steps=200) # steps reduit pour la vitesse# TODO etudiant : finals_by_G.append(h[-1]) finals_by_G.append(None)ifall(v isNonefor v in finals_by_G):print('Exercice 2 a completer : boucle sur G_values a implementer')else:print('Exercice 2 : perf finale vs G')for g, f inzip(G_values, finals_by_G):print(f' G={g:>2} : reward final = {f:.3f}'if f isnotNoneelsef' G={g:>2} : (a completer)')
Exercice 2 a completer : boucle sur G_values a implementer
Exercice 3 — Reward shaping : récompense dense
Ici la récompense est binaire (0/1), donc éparse — GRPO n’apprend que sur les prompts où le groupe est divisé. Une récompense dense\(R = 1 - |\text{action}^2 + a - b|/B_{\max }\) donne du gradient partout (la cellule code §8.3 utilise B_MAX = (N_ACTIONS - 1)**2 + MAXD comme normaliseur, soit 230). Implémentez cette reward et observez si l’apprentissage s’accélère. Indice : modifiez reward_fn ou créez reward_fn_dense.
# Exercice 3 : reward shaping dense (au lieu de binaire eparse)# TODO etudiant : implementer reward_fn_dense et relancer train_grpodef reward_fn_dense(a, b, actions):'''Recompense DENSE : decroit avec le residu |action^2 + a - b| de la contrainte z3. Retourne un tenseur dans [0, 1]. Une action proche de la vraie racine (residu petit) touche une recompense proche de 1, meme si elle n'est pas exacte. ''' a_t = torch.as_tensor(a, dtype=torch.float) b_t = torch.as_tensor(b, dtype=torch.float) residu =None# TODO etudiant : (actions.float()**2 + a_t - b_t).abs() residu_norm =None# TODO etudiant : residu / B_MAX (B_MAX = valeur max du residu) reward =None# TODO etudiant : (1.0 - residu_norm).clamp(0.0, 1.0)return reward# Test : (a=2, b=6) -> racine exacte s=2 (4+2=6) ; (a=1, b=5) -> racine s=2 (4+1=5)_r_dense_test = reward_fn_dense(np.array([2, 1]), np.array([6, 5]), torch.tensor([2, 3])) # s=2 exact ; s=3 vs racine 2 (9+1=10 vs 5)if _r_dense_test isNone:print('Exercice 3 a completer : reward_fn_dense renvoie None')else:print(f'Exercice 3 OK : reward dense = {[round(v,3) for v in _r_dense_test.tolist()]} 'f'(attendu ~[1.0, <1.0])')
Exercice 3 a completer : reward_fn_dense renvoie None
9. Conclusion — verdict Prong B et transfert vers le LLM
Ce que ce notebook établit
La récompense est vérifiée par un vrai solveur (z3) : ce n’est plus un == codé en dur. Le solveur SMT prouve que l’action satisfait la contrainte non-linéaire \(s^2 + a = b\). C’est le régime RLVR réel de la série (mandat #10289) : la policy apprend une fonction non-triviale (la racine carrée entière), et la discrimination est mesurée — une policy aléatoire plafonne à ~6 % quand une policy entraînée monte vers ~0.53-1.00 (REINFORCE plafonne à ~0.53, PPO monte à ~0.98, GRPO atteint ~1.00, mesures cellule §6 + exécution Papermill).
GRPO est un PPO dont le baseline change : le critic appris \(V_\psi(s)\) est remplacé par la moyenne empirique d’un groupe de \(G\) completions. Le clipped objective, le ratio d’importance sampling, les epochs internes — tout est identique à PPO.
Le critic est éliminé : sur ce toy, GRPO épargne 15 297 paramètres (le value network, mesuré cellule §3) pour une performance légèrement supérieure (~1.00 vs ~0.98). Sur un LLM, le gain est drastique (~2× moins de mémoire d’entraînement).
Le coût est le group sampling : GRPO paie \(G\) évaluations par prompt (256 = 32×8 contre 64 pour PPO). C’est rentable quand l’inférence est déjà parallélisée (post-training LLM : on génère de toute façon \(G\) complétions pour le calcul de l’avantage).
Transfert vers le LLM (Qwen3.5-0.8B)
Sur un vrai LLM, trois différences majeures — mais la mécanique du groupe est exactement celle vue ici :
Aspect
Toy (ici)
LLM (PT-04 / Qwen3.5-0.8B)
Policy
MLP 16 272 params (acteur)
Qwen3.5-0.8B + LoRA (milliards)
Completion
1 action discrète
\(N\) tokens autoregressifs
Reward
\(s^2 + a = b\) vérifié par z3
fonction vérifiable (math, code, logique)
Régularisation
clipping seul
+ pénalité KL vers la policy de référence
La pénalité KL (absente ici pour la clarté) est l’élément qui empêche la policy de dériver trop loin du modèle de départ — crucial en post-training, secondaire sur un toy qu’on entraîne from scratch. Voir PT-04 pour la pipeline TRL complète avec KL.
Verdict Prong B (axe-2 SOTA, #3801)
SOTA-OK. Le moteur (GRPO) n’est pas démontré sur un cas dégénéré : le problème de raisonnement arithmétique est discriminant (la policy passe de ~6% de hasard à ~0.53-1.00 sur les méthodes à baseline évolué, et REINFORCE plafonne à ~0.53 — preuve que le problème n’est pas trivial), et la comparaison PPO ↔︎ GRPO rend visible la capacité distinctive du moteur — éliminer le critic via le group-relative advantage. Les courbes sont réellement exécutées (pas une simulation — cf PT-04, désormais lui aussi réellement exécuté sur GPU, migration #10289). Aucun workaround dégradé : vrai torch from-scratch, entraînement réel, reproductible (seed=42).
Reproductibilité : seed fixée (SEED=42), CPU-only, exécution complète en une trentaine de secondes. Deux exécutions successives sous le même interpréteur (Python 3.13) donnent les mêmes valeurs ; la version de Python fait partie des conditions d’exécution — un run sous Python 3.10 avait donné REINFORCE 0.750 / PPO 0.891 / GRPO 0.938. Le verdict comparatif est robuste dans les deux cas : REINFORCE plafonne (~0.53), PPO monte (~0.98), GRPO atteint ~1.00 — le mécanisme (critic vs groupe) est stable.