Jeux sous Forme Extensive : Arbres de Jeu et Ensembles d’Information
Ce notebook introduit les jeux sous forme extensive, qui modelisent les situations stratégiques dynamiques ou les joueurs agissent sequentiellement.
Objectifs d’apprentissage
Comprendre la representation en arbre des jeux dynamiques
Distinguer information parfaite et imparfaite
Manipuler les ensembles d’information (infosets)
Convertir entre formes normale et extensive
Utiliser OpenSpiel pour les jeux extensifs
Prerequis
Notebooks 1-6 : Fondations, equilibres de Nash, jeux a somme nulle, evolution de la cooperation
Notions de base sur les arbres et graphes
Familiarite avec les jeux en forme normale (matrices de gains)
Duree estimee : 60 minutes
# Configuration et importsimport numpy as npimport matplotlib.pyplot as pltfrom dataclasses import dataclass, fieldfrom typing import List, Dict, Optional, Tuple, Any, Setfrom collections import defaultdictimport networkx as nx# OpenSpiel (optionnel)try:import pyspiel HAS_OPENSPIEL =Trueprint(f"OpenSpiel disponible, version: {pyspiel.__version__ ifhasattr(pyspiel, '__version__') else'N/A'}")exceptImportError: HAS_OPENSPIEL =Falseprint("OpenSpiel non disponible - exemples avec implementation locale")# Style matplotlibplt.style.use('seaborn-v0_8-whitegrid')plt.rcParams['figure.figsize'] = (10, 6)
OpenSpiel disponible, version: 1.6.15
1. De la Forme Normale a la Forme Extensive
1.1 Limitations de la forme normale
La forme normale (matrice de gains) ne capture pas : - L’ordre des coups : qui joue quand ? - L’information disponible : que sait chaque joueur au moment de jouer ? - L’historique du jeu : les actions précédentes
1.2 Éléments d’un jeu extensif
Un jeu sous forme extensive comprend :
Élément
Description
Noeuds
Points de decision ou le jeu peut se trouver
Racine
Noeud de depart du jeu
Terminaux
Noeuds finaux avec gains
Actions
Transitions entre noeuds
Joueurs
Incluant potentiellement “Nature” (hasard)
Information sets
Ensembles de noeuds indistinguables pour un joueur
# Classes de base pour les jeux extensifs@dataclassclass GameNode:"""Noeud dans un arbre de jeu.""" node_id: str player: int# -1 pour terminal, 0 pour nature actions: List[str] = field(default_factory=list) children: Dict[str, 'GameNode'] = field(default_factory=dict) payoffs: Optional[Tuple[float, ...]] =None# Pour noeuds terminaux infoset: Optional[str] =None# Identifiant de l'ensemble d'information chance_probs: Optional[Dict[str, float]] =None# Pour noeuds de naturedef is_terminal(self) ->bool:returnself.player ==-1def is_chance(self) ->bool:returnself.player ==0class ExtensiveFormGame:"""Jeu sous forme extensive."""def__init__(self, name: str, num_players: int):self.name = nameself.num_players = num_playersself.root: Optional[GameNode] =Noneself.nodes: Dict[str, GameNode] = {}self.infosets: Dict[str, List[str]] = defaultdict(list) # infoset_id -> [node_ids]def add_node(self, node: GameNode):"""Ajoute un noeud au jeu."""self.nodes[node.node_id] = nodeif node.infoset:self.infosets[node.infoset].append(node.node_id)def set_root(self, node: GameNode):"""Definit le noeud racine."""self.root = nodeself.add_node(node)def get_terminal_nodes(self) -> List[GameNode]:"""Retourne tous les noeuds terminaux."""return [n for n inself.nodes.values() if n.is_terminal()]def get_infoset_nodes(self, infoset_id: str) -> List[GameNode]:"""Retourne les noeuds d'un ensemble d'information."""return [self.nodes[nid] for nid inself.infosets[infoset_id]]print("Classe definie : ExtensiveFormGame (jeu sous forme extensive)")
Classe definie : ExtensiveFormGame (jeu sous forme extensive)
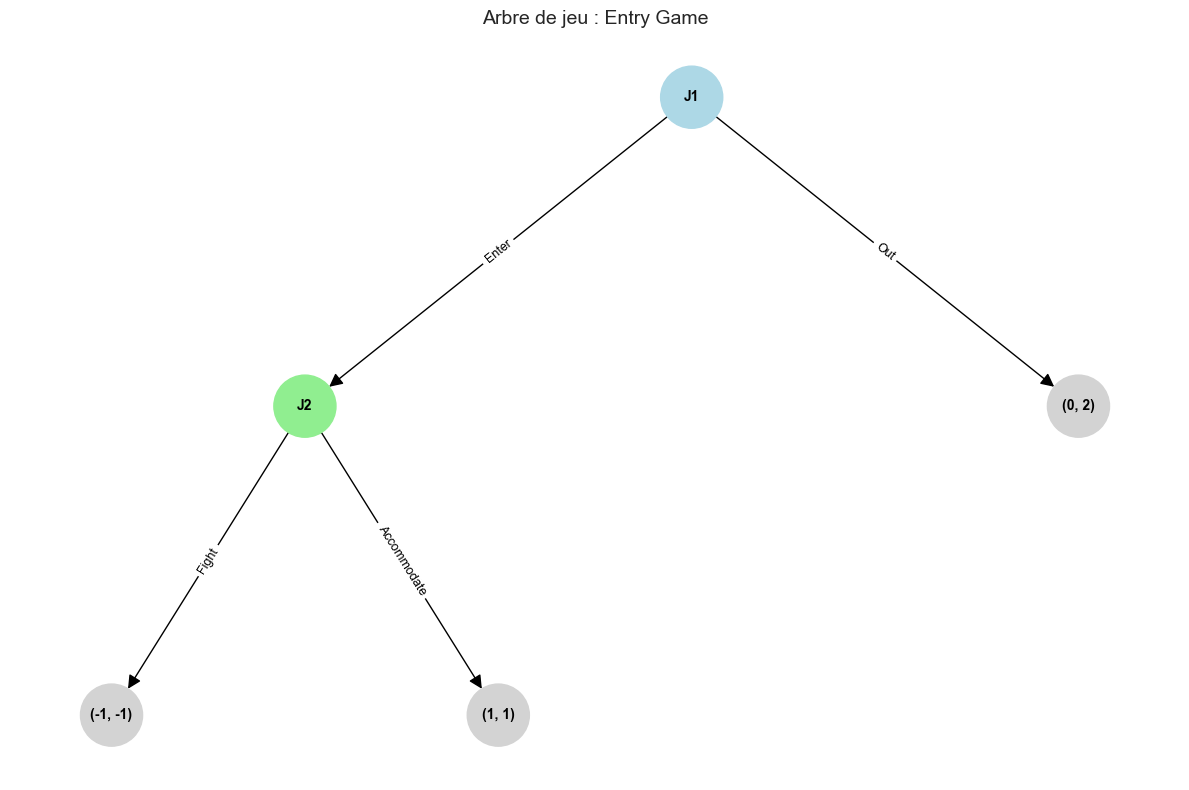
2. Exemple : Jeu d’Entree sur le Marche
Un exemple classique de jeu séquentiel :
Entrant decide : Entrer (E) ou Rester dehors (O)
Si Entrer, Incumbant decide : Combattre (F) ou Accommoder (A)
                    Entrant
                   /       \
               E  /         \  O
                 /           \
           Incumbant        (0, 2)
            /     \
        F  /       \  A
          /         \
      (-1, -1)     (1, 1)
Gains : (Entrant, Incumbant)
def create_entry_game() -> ExtensiveFormGame:"""Cree le jeu d'entree sur le marche.""" game = ExtensiveFormGame("Entry Game", num_players=2)# Noeuds terminaux out_terminal = GameNode("out", player=-1, payoffs=(0, 2)) fight_terminal = GameNode("fight", player=-1, payoffs=(-1, -1)) accommodate_terminal = GameNode("accommodate", player=-1, payoffs=(1, 1))# Noeud de l'incumbant (joueur 2) incumbent_node = GameNode("incumbent_choice", player=2, actions=["Fight", "Accommodate"], infoset="I2_1" ) incumbent_node.children = {"Fight": fight_terminal,"Accommodate": accommodate_terminal }# Noeud racine (entrant, joueur 1) entrant_node = GameNode("root", player=1, actions=["Enter", "Out"], infoset="I1_1" ) entrant_node.children = {"Enter": incumbent_node,"Out": out_terminal }# Construire le jeu game.set_root(entrant_node)for node in [incumbent_node, out_terminal, fight_terminal, accommodate_terminal]: game.add_node(node)return gameentry_game = create_entry_game()print(f"Jeu: {entry_game.name}")print(f"Nombre de joueurs: {entry_game.num_players}")print(f"Noeuds terminaux: {len(entry_game.get_terminal_nodes())}")
Jeu: Entry Game
Nombre de joueurs: 2
Noeuds terminaux: 3
Interpretation : Structure du jeu d’entree
Le code ci-dessus construit l’arbre de jeu avec ses différents composants.
Anatomie de l’arbre créé :
Noeud
Joueur
Infoset
Actions
Description
root
1 (Entrant)
I1_1
Enter, Out
Decision initiale
incumbent_choice
2 (Incumbant)
I2_1
Fight, Accommodate
Reponse a l’entree
out, fight, accommodate
-1 (Terminal)
-
-
Fins de partie
Structure des gains : - Out : (0, 2) - L’entrant renonce, l’incumbant garde son monopole - Enter + Fight : (-1, -1) - Guerre de prix destructrice pour les deux - Enter + Accommodate : (1, 1) - Partage du marche, tous gagnent
Observation : Ce jeu illustre une menace non credible - l’incumbant menace de combattre, mais s’il est rationnel, il devrait toujours accommoder (1 > -1). Nous verrons dans le notebook sur l’induction arriere comment formaliser cette intuition.
def visualize_game_tree(game: ExtensiveFormGame, figsize=(12, 8)):"""Visualise l'arbre de jeu avec NetworkX.""" G = nx.DiGraph() pos = {} labels = {} edge_labels = {} colors = []# Couleurs par joueur player_colors = {-1: 'lightgray', 0: 'lightyellow', 1: 'lightblue', 2: 'lightgreen'}def add_node_recursive(node, x=0, y=0, dx=2): G.add_node(node.node_id) pos[node.node_id] = (x, y)if node.is_terminal(): labels[node.node_id] =f"{node.payoffs}"elif node.is_chance(): labels[node.node_id] ="Nature"else: labels[node.node_id] =f"J{node.player}" colors.append(player_colors.get(node.player, 'white'))if node.children: n_children =len(node.children) x_start = x - (n_children -1) * dx /2for i, (action, child) inenumerate(node.children.items()): child_x = x_start + i * dx G.add_edge(node.node_id, child.node_id) edge_labels[(node.node_id, child.node_id)] = action add_node_recursive(child, child_x, y -1, dx /2) add_node_recursive(game.root)# Tracer fig, ax = plt.subplots(figsize=figsize) nx.draw(G, pos, ax=ax, labels=labels, node_color=colors, node_size=2000, font_size=10, font_weight='bold', arrows=True, arrowsize=20) nx.draw_networkx_edge_labels(G, pos, edge_labels, font_size=9) ax.set_title(f"Arbre de jeu : {game.name}", fontsize=14) plt.tight_layout() plt.show()visualize_game_tree(entry_game)
3. Stratégies dans les Jeux Extensifs
3.1 Stratégie Pure
Une stratégie pure est un plan d’action complet : elle specifie une action pour chaque ensemble d’information du joueur.
Pour l’Entrant : 2 stratégies (Enter ou Out)
Pour l’Incumbant : 2 stratégies (Fight ou Accommodate)
3.2 Stratégie Comportementale
Une stratégie comportementale associe une distribution de probabilite sur les actions a chaque ensemble d’information.
3.3 Equivalence (Theoreme de Kuhn)
Dans les jeux avec rappel parfait (chaque joueur se souvient de toutes ses actions passees), stratégies mixtes et comportementales sont equivalentes.
@dataclassclass PureStrategy:"""Strategie pure pour un joueur.""" player: int actions: Dict[str, str] # infoset_id -> actiondef get_action(self, infoset: str) ->str:returnself.actions.get(infoset, None)@dataclassclass BehavioralStrategy:"""Strategie comportementale pour un joueur.""" player: int probabilities: Dict[str, Dict[str, float]] # infoset -> {action -> prob}def get_action_prob(self, infoset: str, action: str) ->float:if infoset notinself.probabilities:return0.0returnself.probabilities[infoset].get(action, 0.0)def sample_action(self, infoset: str) ->str:"""Echantillonne une action selon la distribution.""" probs =self.probabilities[infoset] actions =list(probs.keys()) weights = [probs[a] for a in actions]return np.random.choice(actions, p=weights)# Strategies pour le jeu d'entreeprint("Strategies pures pour l'Entrant:")entrant_enter = PureStrategy(1, {"I1_1": "Enter"})entrant_out = PureStrategy(1, {"I1_1": "Out"})print(f" - S1: {entrant_enter.actions}")print(f" - S2: {entrant_out.actions}")print("\nStrategies pures pour l'Incumbant:")incumbent_fight = PureStrategy(2, {"I2_1": "Fight"})incumbent_acc = PureStrategy(2, {"I2_1": "Accommodate"})print(f" - S1: {incumbent_fight.actions}")print(f" - S2: {incumbent_acc.actions}")
Interpretation : Stratégies et ensembles d’information
Ce code définit les deux types fondamentaux de stratégies dans les jeux extensifs.
Stratégie pure vs comportementale :
Type
Specification
Exemple (Entrant)
Pure
Une action déterministe par infoset
I1_1 -> “Enter”
Comportementale
Distribution de probabilite par infoset
I1_1 -> {Enter: 0.7, Out: 0.3}
Observation sur les stratégies de l’Entrant : - L’Entrant n’a qu’un seul infoset (I1_1) = un seul point de decision - Ses 2 stratégies pures correspondent a ses 2 actions possibles
Observation sur les stratégies de l’Incumbant : - L’Incumbant a aussi un seul infoset (I2_1) - Ses stratégies sont Fight ou Accommodate - Important : Ces stratégies sont des plans complets, pas des actions conditionnelles
Point cle : Dans un jeu a information parfaite, le nombre de stratégies pures d’un joueur est le produit du nombre d’actions a chaque noeud de decision. Ici : 2 x 2 = 4 profils de stratégies pures au total.
def evaluate_strategy_profile(game: ExtensiveFormGame, strategies: Dict[int, PureStrategy]) -> Tuple[float, ...]:""" Evalue un profil de strategies pures. Args: game: Le jeu extensif strategies: Dict {player -> PureStrategy} Returns: Tuple des gains pour chaque joueur """def traverse(node: GameNode) -> Tuple[float, ...]:if node.is_terminal():return node.payoffsif node.is_chance():# Moyenne ponderee pour les noeuds de nature expected = np.zeros(game.num_players)for action, prob in node.chance_probs.items(): child_payoffs = traverse(node.children[action]) expected += prob * np.array(child_payoffs)returntuple(expected)# Noeud de decision strategy = strategies[node.player] action = strategy.get_action(node.infoset)return traverse(node.children[action])return traverse(game.root)# Tester tous les profils de strategiesprint("Matrice de gains du jeu d'entree:")print("\n Fight Accommodate")for e_strat, e_name in [(entrant_enter, "Enter"), (entrant_out, "Out")]: row =f"{e_name:8} "for i_strat in [incumbent_fight, incumbent_acc]: payoffs = evaluate_strategy_profile(entry_game, {1: e_strat, 2: i_strat}) row +=f" {payoffs} "print(row)
Matrice de gains du jeu d'entree:

              Fight    Accommodate
Enter       (-1, -1)      (1, 1)
Out         (0, 2)      (0, 2)
Forme normale du jeu d’entree : analyse
La matrice ci-dessus revele la structure stratégique du jeu :
Observations cles : - La stratégie “Out” de l’entrant donne (0, 2) quelle que soit la stratégie de l’incumbant - Cela signifie que la “menace” de Fight n’affecte pas le gain si l’entrant reste dehors - Pourtant, cette menace peut influencer la decision d’entrer !
Le problème : Le deuxieme equilibre repose sur une menace non credible. L’incumbant ne combattrait jamais reellement (car -1 < 1).
C’est exactement pourquoi la forme extensive est importante : elle nous permet de detecter ces menaces vides en analysant les sous-jeux (voir notebook 9).
4. Information Parfaite vs Imparfaite
4.1 Information Parfaite
Un jeu a information parfaite si chaque ensemble d’information contient exactement un noeud. Chaque joueur connait l’historique complet du jeu.
Exemples : Echecs, Morpion, Go, Jeu d’entree
4.2 Information Imparfaite
Un jeu a information imparfaite si certains ensembles d’information contiennent plusieurs noeuds. Le joueur ne peut pas distinguer ces noeuds.
Exemples : Poker, Bataille navale, jeux avec coups simultanes
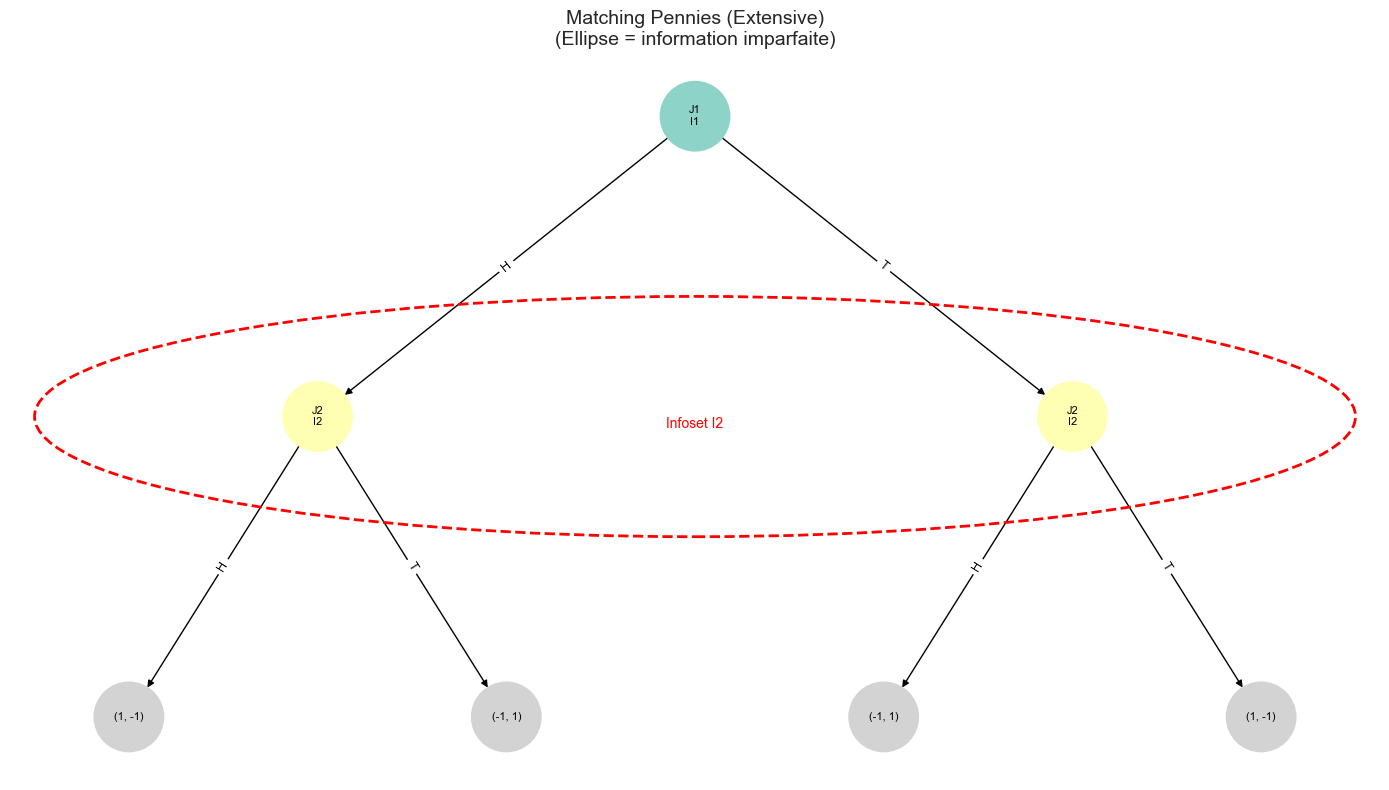
def create_simultaneous_move_game() -> ExtensiveFormGame:""" Cree un jeu de coups simultanes (Matching Pennies) represente sous forme extensive avec information imparfaite. J1 choisit H ou T J2 choisit H ou T sans voir le choix de J1 -> Les noeuds de decision de J2 sont dans le meme infoset """ game = ExtensiveFormGame("Matching Pennies (Extensive)", num_players=2)# Noeuds terminaux hh = GameNode("HH", player=-1, payoffs=(1, -1)) # Match: J1 gagne ht = GameNode("HT", player=-1, payoffs=(-1, 1)) # No match: J2 gagne th = GameNode("TH", player=-1, payoffs=(-1, 1)) # No match: J2 gagne tt = GameNode("TT", player=-1, payoffs=(1, -1)) # Match: J1 gagne# Noeuds de J2 - MEME INFOSET (information imparfaite) j2_after_h = GameNode("J2_afterH", player=2, actions=["H", "T"], infoset="I2") j2_after_h.children = {"H": hh, "T": ht} j2_after_t = GameNode("J2_afterT", player=2, actions=["H", "T"], infoset="I2") # MEME infoset! j2_after_t.children = {"H": th, "T": tt}# Noeud de J1 (racine) j1_node = GameNode("root", player=1, actions=["H", "T"], infoset="I1") j1_node.children = {"H": j2_after_h, "T": j2_after_t} game.set_root(j1_node)for node in [j2_after_h, j2_after_t, hh, ht, th, tt]: game.add_node(node)return gamemp_game = create_simultaneous_move_game()print("Jeu des Pennies (Matching Pennies) - Information Imparfaite")print("="*60)print(f"\nInfoset de J2: {mp_game.infosets['I2']}")print("-> J2 ne sait pas si J1 a joue H ou T!")# Verification: l'information parfaite implique singletonsdef has_perfect_information(game: ExtensiveFormGame) ->bool:"""Verifie si le jeu a information parfaite."""for infoset_id, nodes in game.infosets.items():iflen(nodes) >1:returnFalsereturnTrueprint(f"\nJeu d'entree - Information parfaite: {has_perfect_information(entry_game)}")print(f"Matching Pennies - Information parfaite: {has_perfect_information(mp_game)}")
Jeu des Pennies (Matching Pennies) - Information Imparfaite
============================================================

Infoset de J2: ['J2_afterH', 'J2_afterT']
-> J2 ne sait pas si J1 a joue H ou T!

Jeu d'entree - Information parfaite: True
Matching Pennies - Information parfaite: False
L’importance des infosets
La visualisation ci-dessus montre pourquoi les ensembles d’information sont centraux en théorie des jeux :
Matching Pennies comme jeu simultane : - Même si J1 “joue en premier” dans l’arbre, J2 ne sait pas ce que J1 a joue - Les deux noeuds de J2 sont dans le même infoset (ellipse rouge) - Cela rend le jeu strategiquement equivalent a un jeu simultane
Consequences pratiques : 1. J2 ne peut pas conditionner sa stratégie sur l’action de J1 2. La seule stratégie possible pour J2 est “jouer H” ou “jouer T” (pas “si J1 joue H alors…”) 3. C’est exactement comme si les deux joueurs choisissaient en même temps
Le lien avec le poker : - Au poker, vous ne voyez pas les cartes des autres - Vous ne savez pas s’ils ont une bonne ou mauvaise main - Tous les etats ou ils ont une bonne main sont dans le même infoset depuis votre perspective - Votre stratégie doit etre la même pour tous ces etats !
def visualize_with_infosets(game: ExtensiveFormGame, figsize=(14, 8)):"""Visualise l'arbre avec les infosets en surbrillance.""" G = nx.DiGraph() pos = {} labels = {} edge_labels = {}# Couleurs pour infosets (cycling) infoset_colors = plt.cm.Set3(np.linspace(0, 1, 12)) infoset_to_color = {} color_idx =0def get_node_color(node):nonlocal color_idxif node.is_terminal():return'lightgray'if node.infoset:if node.infoset notin infoset_to_color: infoset_to_color[node.infoset] = infoset_colors[color_idx %12] color_idx +=1return infoset_to_color[node.infoset]return'white' colors = []def add_nodes(node, x=0, y=0, dx=2): G.add_node(node.node_id) pos[node.node_id] = (x, y) colors.append(get_node_color(node))if node.is_terminal(): labels[node.node_id] =f"{node.payoffs}"else: labels[node.node_id] =f"J{node.player}\n{node.infoset}"if node.children: n =len(node.children) x_start = x - (n-1) * dx /2for i, (action, child) inenumerate(node.children.items()): G.add_edge(node.node_id, child.node_id) edge_labels[(node.node_id, child.node_id)] = action add_nodes(child, x_start + i*dx, y-1, dx/2) add_nodes(game.root) fig, ax = plt.subplots(figsize=figsize) nx.draw(G, pos, ax=ax, labels=labels, node_color=colors, node_size=2500, font_size=8, arrows=True) nx.draw_networkx_edge_labels(G, pos, edge_labels, font_size=9)# Dessiner les ellipses autour des infosets multiplesfor infoset_id, node_ids in game.infosets.items():iflen(node_ids) >1: positions = [pos[nid] for nid in node_ids] xs, ys =zip(*positions) center = (np.mean(xs), np.mean(ys)) width =max(xs) -min(xs) +1.5 height =max(ys) -min(ys) +0.8 ellipse = plt.matplotlib.patches.Ellipse( center, width, height, fill=False, linestyle='--', linewidth=2, edgecolor='red' ) ax.add_patch(ellipse) ax.annotate(f"Infoset {infoset_id}", center, fontsize=10, color='red', ha='center', va='top') ax.set_title(f"{game.name}\n(Ellipse = information imparfaite)", fontsize=14) plt.tight_layout() plt.show()visualize_with_infosets(mp_game)
5. Jeux avec Hasard : Noeuds de Nature
Certains jeux incluent des éléments aleatoires : tirage de cartes, lancers de des, etc.
On modelise cela par un joueur special appele Nature (joueur 0) qui “choisit” selon des probabilites connues.
def create_simple_card_game() -> ExtensiveFormGame:""" Jeu de carte simple: 1. Nature tire une carte (H=high avec p=0.5, L=low avec p=0.5) 2. J1 voit la carte et decide: Bet ou Check 3. Si Bet, J2 decide: Call ou Fold (sans voir la carte) Gains (simplifies): - Check: (1,1) si H, (-1,-1) si L - Bet+Fold: (1, -1) - Bet+Call: (2, -2) si H, (-2, 2) si L """ game = ExtensiveFormGame("Simple Card Game", num_players=2)# Terminaux pour H (high card) h_check = GameNode("H_check", -1, payoffs=(1, 1)) h_fold = GameNode("H_fold", -1, payoffs=(1, -1)) h_call = GameNode("H_call", -1, payoffs=(2, -2))# Terminaux pour L (low card) l_check = GameNode("L_check", -1, payoffs=(-1, -1)) l_fold = GameNode("L_fold", -1, payoffs=(1, -1)) l_call = GameNode("L_call", -1, payoffs=(-2, 2))# J2 apres Bet (ne sait pas si H ou L) - MEME INFOSET j2_after_h_bet = GameNode("J2_H_bet", 2, ["Call", "Fold"], infoset="I2_bet") j2_after_h_bet.children = {"Call": h_call, "Fold": h_fold} j2_after_l_bet = GameNode("J2_L_bet", 2, ["Call", "Fold"], infoset="I2_bet") # MEME infoset j2_after_l_bet.children = {"Call": l_call, "Fold": l_fold}# J1 avec carte H - infoset separe car il voit la carte j1_with_h = GameNode("J1_H", 1, ["Bet", "Check"], infoset="I1_H") j1_with_h.children = {"Bet": j2_after_h_bet, "Check": h_check}# J1 avec carte L - infoset separe j1_with_l = GameNode("J1_L", 1, ["Bet", "Check"], infoset="I1_L") j1_with_l.children = {"Bet": j2_after_l_bet, "Check": l_check}# Noeud de Nature (racine) nature = GameNode("nature", 0, ["H", "L"]) nature.children = {"H": j1_with_h, "L": j1_with_l} nature.chance_probs = {"H": 0.5, "L": 0.5} game.set_root(nature)for node in [j1_with_h, j1_with_l, j2_after_h_bet, j2_after_l_bet, h_check, h_fold, h_call, l_check, l_fold, l_call]: game.add_node(node)return gamecard_game = create_simple_card_game()print("Jeu de cartes simple")print("="*50)print(f"Infosets de J1: I1_H (carte haute), I1_L (carte basse)")print(f"Infosets de J2: {card_game.infosets['I2_bet']} (ne connait pas la carte)")
Jeu de cartes simple
==================================================
Infosets de J1: I1_H (carte haute), I1_L (carte basse)
Infosets de J2: ['J2_H_bet', 'J2_L_bet'] (ne connait pas la carte)
6. OpenSpiel : Jeux Extensifs Avances
OpenSpiel fournit de nombreux jeux déjà implementes avec une API standardisee.
if HAS_OPENSPIEL:# Kuhn Poker - jeu classique a information imparfaite kuhn = pyspiel.load_game("kuhn_poker")print("Kuhn Poker (OpenSpiel)")print("="*50)print(f"Nombre de joueurs: {kuhn.num_players()}")print(f"Type de jeu: {kuhn.get_type().dynamics}")print(f"Information: {kuhn.get_type().information}")print(f"Utilite: {kuhn.get_type().utility}")# Simuler une partie state = kuhn.new_initial_state()print(f"\nEtat initial: {state}")# Historique d'une partie exempleprint("\nSimulation d'une partie:")whilenot state.is_terminal():if state.is_chance_node(): outcomes = state.chance_outcomes() action, prob = outcomes[np.random.choice(len(outcomes))]print(f" Nature tire: action {action} (p={prob:.2f})")else: player = state.current_player() actions = state.legal_actions() action = np.random.choice(actions)print(f" Joueur {player} joue: {state.action_to_string(player, action)}") state.apply_action(action)print(f"\nResultat: {state.returns()}")else:print("OpenSpiel non disponible")print("Pour installer: pip install open_spiel")
Kuhn Poker (OpenSpiel)
==================================================
Nombre de joueurs: 2
Type de jeu: Dynamics.SEQUENTIAL
Information: Information.IMPERFECT_INFORMATION
Utilite: Utility.ZERO_SUM

Etat initial:

Simulation d'une partie:
  Nature tire: action 2 (p=0.33)
  Nature tire: action 1 (p=0.50)
  Joueur 0 joue: Bet
  Joueur 1 joue: Bet

Resultat: [2.0, -2.0]
Interpretation : Kuhn Poker et structure d’information
L’exemple du Kuhn Poker illustre parfaitement les concepts cles des jeux extensifs a information imparfaite.
Structure du jeu observee : - Joueurs séquentiels : Nature distribue d’abord (3 cartes possibles), puis J0 joue, puis J1 repond - Information asymetrique : Chaque joueur voit sa propre carte mais pas celle de l’adversaire - Infosets distincts : Les chaînes comme "0", "0pb" encodent l’historique observable par J0
Analyse de la partie simulee :
Action
Interpretation
Nature tire action 0/2
Distribution des cartes (J, Q, K encodes)
J0 joue Bet/Pass
Decision basee uniquement sur sa carte
J1 joue Bet/Pass
Decision sans connaitre la carte de J0
Pourquoi ce jeu est fondamental : - C’est le plus petit jeu de poker non trivial - Il admet une solution analytique connue (equilibre de Nash en stratégies mixtes) - Il demontre le bluff comme stratégie optimale : miser avec une mauvaise carte peut etre profitable
Note technique : Les infosets comme "1p" signifient “J1 avec carte 1 après Pass de J0” - le joueur connait sa carte mais pas celle de l’adversaire.
if HAS_OPENSPIEL:def explore_game_tree(game, max_nodes=20):"""Explore l'arbre de jeu d'OpenSpiel.""" state = game.new_initial_state() nodes_visited =0def dfs(state, depth=0):nonlocal nodes_visitedif nodes_visited >= max_nodes:return indent =" "* depth nodes_visited +=1if state.is_terminal():print(f"{indent}[Terminal] Gains: {state.returns()}")returnif state.is_chance_node():print(f"{indent}[Nature] Outcomes: {len(state.chance_outcomes())}")for action, prob in state.chance_outcomes()[:2]: # Limiter child = state.child(action)print(f"{indent} -> action {action} (p={prob:.2f})") dfs(child, depth +1)else: player = state.current_player() infoset = state.information_state_string(player)print(f"{indent}[J{player}] Infoset: {infoset[:30]}...")for action in state.legal_actions()[:2]: # Limiter child = state.child(action)print(f"{indent} -> {state.action_to_string(player, action)}") dfs(child, depth +1)print(f"\nExploration de l'arbre de {game.get_type().short_name}:")print("="*50) dfs(state) explore_game_tree(kuhn)
Tout jeu extensif peut etre converti en forme normale en enumerant toutes les stratégies pures.
Attention : La taille de la matrice peut exploser exponentiellement!
from itertools import productdef extensive_to_normal(game: ExtensiveFormGame):""" Convertit un jeu extensif en forme normale. Returns: Dict avec matrices de gains et labels de strategies """# Collecter les infosets par joueur player_infosets = defaultdict(list) infoset_actions = {}for node in game.nodes.values():if node.infoset andnot node.is_terminal() andnot node.is_chance():if node.infoset notin infoset_actions: player_infosets[node.player].append(node.infoset) infoset_actions[node.infoset] = node.actions# Generer toutes les strategies puresdef generate_strategies(player): infosets = player_infosets[player]ifnot infosets:return [PureStrategy(player, {})] action_combinations = product(*[infoset_actions[i] for i in infosets] ) strategies = []for combo in action_combinations: actions =dict(zip(infosets, combo)) strategies.append(PureStrategy(player, actions))return strategies strategies_p1 = generate_strategies(1) strategies_p2 = generate_strategies(2) m, n =len(strategies_p1), len(strategies_p2) A = np.zeros((m, n)) B = np.zeros((m, n))for i, s1 inenumerate(strategies_p1):for j, s2 inenumerate(strategies_p2): payoffs = evaluate_strategy_profile(game, {1: s1, 2: s2}) A[i, j] = payoffs[0] B[i, j] = payoffs[1]return {'A': A,'B': B,'row_strategies': strategies_p1,'col_strategies': strategies_p2 }# Convertir le jeu d'entreenormal_form = extensive_to_normal(entry_game)print("Jeu d'entree - Forme Normale")print("="*50)print(f"\nStrategies du joueur 1:")for i, s inenumerate(normal_form['row_strategies']):print(f" S{i+1}: {s.actions}")print(f"\nStrategies du joueur 2:")for j, s inenumerate(normal_form['col_strategies']):print(f" S{j+1}: {s.actions}")print(f"\nMatrice des gains (Joueur 1):")print(normal_form['A'])print(f"\nMatrice des gains (Joueur 2):")print(normal_form['B'])
Jeu d'entree - Forme Normale
==================================================

Strategies du joueur 1:
  S1: {'I1_1': 'Enter'}
  S2: {'I1_1': 'Out'}

Strategies du joueur 2:
  S1: {'I2_1': 'Fight'}
  S2: {'I2_1': 'Accommodate'}

Matrice des gains (Joueur 1):
[[-1.  1.]
 [ 0.  0.]]

Matrice des gains (Joueur 2):
[[-1.  1.]
 [ 2.  2.]]
8. Exercices
Les exercices suivants mettent en pratique les concepts cles des jeux sous forme extensive etudies dans les sections précédentes : arbres de jeu, stratégies comportementales, equilibres de Nash, ensembles d’information, et equilibres parfaits en sous-jeux (SPE). Chaque exercice mobilise le moteur de representation arborescente et les algorithmes d’induction arriere définis dans ce notebook (sections 1-7).
L’objectif pedagogique est de transformer la comprehension conceptuelle en capacite operationnelle : construire un arbre, calculer un SPE, verifier la stabilite d’un profil de stratégies.
8.1. Exercice 1 : Solveur du jeu de l’Ultimatum
Dans le jeu de l’ultimatum : 1. J1 propose un partage x (sur 10 euros) 2. J2 accepte (gains : 10-x, x) ou refuse (gains : 0, 0)
Implementer un solveur backward-induction pour le jeu de l’ultimatum avec x dans {2, 4, 5, 6, 8}.
Indices gradues :
Indice 1 : Pour chaque offre x, J2 rationnel accepte si et seulement si son gain x >= 0 (refuser rapporte toujours 0). Le seuil d’acceptation minimal de J2 est donc 0 euro.
Indice 2 : Par anticipation backward-induction, J1 sait que J2 acceptera toute offre positive. J1 maximise donc son propre gain 10 - x en choisissant le plus petit x acceptable, c’est-a-dire x = 2 (le minimum de la liste {2,4,5,6,8} – 0 n’est pas une offre admissible).
Indice 3 : En consequence, le SPE predit une offre de 2 euros (le minimum de la liste, soit gains (8, 2)). Le résultat solve_ultimatum([2,4,5,6,8]) doit retourner {'spe_offer': 2, 'j1_payoff': 8, 'j2_payoff': 2, 'j2_accepts': [2,4,5,6,8]} (J2 rationnel accepte tout, J1 choisit le minimum de la liste).
8.2. Exercice 2 : Construction d’un arbre de jeu a 3 firmes
Contexte : Trois firmes (A, B, C) choisissent sequentiellement d’entrer ou non sur un marche. La firme A decide en premier (Entree ou Reste_dehors), puis B observe le choix de A et decide a son tour, puis C observe les choix de A et de B et decide enfin.
Questions :
Construire l’arbre de jeu complet avec gains specifies pour chaque firme
Identifier les ensembles d’information (combien B en a-t-il ? combien C en a-t-il ?)
Trouver l’equilibre de Nash en stratégies comportementales par induction arriere
Indices gradues :
Indice 1 : Structure arborescente : A (1 racine) -> B (2 branches) -> C (4 feuilles par branche de B) = 1 + 2 + 8 = 11 noeuds au total, dont 8 terminaux. Chaque firme occupe un niveau.
Indice 2 : Ensembles d’information : A observe l’historique vide (1 infoset), B observe le choix de A (2 infosets distincts I_B_in / I_B_out), C observe les choix de A et B (4 infosets distincts I_C_AinBin / I_C_AinBout / I_C_AoutBin / I_C_AoutBout). En information PARFAITE, chaque infoset contient exactement 1 noeud.
Indice 3 : Pour l’induction arriere, demarrer par C (niveau le plus bas) : pour chaque infoset de C, calculer son best response (Entree ou Reste_dehors) en fonction des gains specifies. Propager ensuite les choix optimaux de C vers le niveau de B, puis B choisit en anticipant la reaction de C. Enfin A choisit en anticipant la reaction de B qui anticipe C.
8.3. Exercice 3 : Verification de SPE (Subgame Perfect Equilibrium)
Contexte : Etant donne un jeu extensif a information parfaite et un profil de stratégies pures pour chaque firme, verifier que ce profil constitue bien un equilibre PARFAIT en sous-jeux (SPE), pas seulement un equilibre de Nash du jeu global.
Questions :
Enumerer tous les sous-jeux du jeu extensif (chaque noeud de decision et ses descendants définit un sous-jeu)
Pour chaque sous-jeu, verifier que le profil de stratégies restreint a ce sous-jeu constitue un equilibre de Nash
Conclure sur le statut SPE : le profil est-il un SPE, ou identifie-t-on des violations ?
Indices gradues :
Indice 1 : Un sous-jeu est identifie par sa racine (un noeud de decision) ; il inclut tous les descendants de cette racine. Le jeu entier est lui-même un sous-jeu (racine = noeud racine du jeu). Pour le jeu a 3 firmes de l’exercice 8.2, il y a donc 1 + 2 + 4 = 7 sous-jeux (le jeu global + 2 sous-jeux de B + 4 sous-jeux de C).
Indice 2 : Pour verifier le SPE dans un sous-jeu, restreindre les stratégies au sous-jeu et calculer les gains de chaque firme sous ces stratégies restreintes. Verifier ensuite qu’aucune firme n’a de deviation unilaterale profitable DANS CE SOUS-JEU (pas seulement dans le jeu global).
Indice 3 : La différence avec un Nash equilibrium global : un NE peut etre un SPE-violating profile si une firme menace de jouer une action non-credible dans un sous-jeu plus profond. Le SPE elimine ces menaces non-credibles en exigeant la Nash property a chaque sous-jeu.
Note C.1 : Conformement aux conventions du notebook (règle C.1), les cellules code ci-dessous contiennent des stubs (pass, return ..., # TODO etudiant) sans raise NotImplementedError ni assert False. Le notebook doit s’executer de bout en bout même si les solutions ne sont pas completees.
Exercice 1 — SPE du jeu de l’ultimatum par induction arrière
Contexte. Le jeu de l’ultimatum (§ formes extensives séquentielles) oppose un proposeur J1 à un récepteur J2 : J1 offre un partage \(x \in \{2,4,5,6,8\}\) d’un total de 10, puis J2 accepte ou refuse (refus \(\to\) gains \((0,0)\)). C’est le cas d’école de l’induction arrière : la solution repose sur ce que J2 fera rationnellement, et J1 anticipe cette réaction.
Objectif. Implémenter solve_ultimatum(offers, total) qui, par backward induction, détermine l’offre SPE de J1. Le raisonnement : J2 rationnel accepte toute offre positive (un gain \(x>0\) vaut mieux que \(0\) du refus) ; J1 le sait et choisit donc l’offre acceptée qui maximise son propre gain \((total - x)\), soit la plus petite offre de la liste.
Les étapes détaillées et un indice sur le résultat attendu figurent dans la docstring du stub ci-dessous (# Etape N, # Indice).
# === Exercices : Jeux extensifs et SPE ===# Stubs pour les 3 exos definis en section 8 (8.1, 8.2, 8.3).# Conformement a la regle C.1 du depot (pas d'erreur volontaire en cellule notebook),# ces stubs utilisent uniquement pass / return / commentaires TODO etudiant ;# le notebook s'execute de bout en bout meme si les solutions ne sont pas completees.def solve_ultimatum(offers=None, total: int=10) -> Dict[str, Any]:"""Solveur backward-induction pour le jeu de l'ultimatum. J1 propose un partage x dans `offers`, J2 accepte ou refuse : - J2 accepte -> gains (total - x, x) - J2 refuse -> gains (0, 0) Le SPE backward-induction determine l'offre optimale de J1 en anticipant la reaction rationnelle de J2. Args: offers: liste des offres discretes possibles pour J1 (defaut [2,4,5,6,8]). total: montant total a partager (defaut 10 euros). Returns: Dict avec : - 'spe_offer' (int) : offre choisie par J1 dans le SPE - 'j1_payoff' (int) : gain de J1 dans le SPE - 'j2_payoff' (int) : gain de J2 dans le SPE - 'j2_accepts' (List[int]) : liste des offres acceptees par J2 """if offers isNone: offers = [2, 4, 5, 6, 8]# TODO etudiant : implementer le solveur backward-induction# Etape 1 : calculer l'ensemble des offres acceptees par J2 (J2 rationnel# accepte ssi x >= 0, soit toutes les offres positives de la liste)# Etape 2 : J1 anticipe que J2 accepte toutes les offres -> il choisit# l'offre qui MAXIMISE son propre gain (total - x), donc le plus# petit x parmi les offres acceptees# Etape 3 : retourner le dict avec spe_offer, j1_payoff=total-spe_offer,# j2_payoff=spe_offer, et j2_accepts# Indice : avec offers=[2,4,5,6,8] et total=10, le SPE est spe_offer=2,# j1_payoff=8, j2_payoff=2, j2_accepts=[2,4,5,6,8]return {'spe_offer': 0,'j1_payoff': 0,'j2_payoff': 0,'j2_accepts': [], } # TODO etudiant : remplacer par le vrai calcul SPE
Exercice 2 — Construire l’arbre d’un jeu séquentiel à 3 joueurs
Contexte. Les exemples précédents (§1–§6) portaient sur des arbres à 2 joueurs. Un jeu d’entrée séquentiel à 3 firmes (A \(\to\) B \(\to\) C, chacune observant les choix précédents) généralise la structure : il faut composer plusieurs ensembles d’information et relier correctement les nœuds internes aux feuilles.
Objectif. Compléter build_three_player_entry_game() pour construire l’arbre complet : 1 racine (A), 2 nœuds intermédiaires (B, un par choix de A), 8 feuilles (C : \(2\times2\times2\)), et 7 ensembles d’information (1 pour A + 2 pour B + 4 pour C). Les gains reflètent le partage du marché selon le nombre d’entrants.
La structure attendue (nœuds, infosets, gains) est détaillée dans la docstring du stub ci-dessous.
def build_three_player_entry_game() -> ExtensiveFormGame:"""Construit l'arbre de jeu a 3 firmes sequentielles (A -> B -> C). Structure : - Firme A (joueur 1, racine) decide Entree ou Reste_dehors - Firme B (joueur 2) observe A et decide Entree ou Reste_dehors - Firme C (joueur 3) observe A et B et decide Entree ou Reste_dehors Returns: ExtensiveFormGame avec 3 firmes, 11 noeuds (1 racine + 2 B + 8 terminaux) et 7 ensembles d'information (1 pour A + 2 pour B + 4 pour C). """# TODO etudiant : implementer l'arbre complet# Etape 1 : creer le jeu avec num_players=3# Etape 2 : creer les 8 noeuds terminaux (C: 2x2x2 = 8 feuilles)# Etape 3 : creer les 2 noeuds intermediaires de B (un par choix de A)# avec infoset distinct I_B_in / I_B_out# Etape 4 : creer le noeud racine de A avec infoset I_A# Etape 5 : relier les enfants (A.Entree -> B_in -> C_in/B_in/B_out)# Etape 6 : set_root + add_node pour chaque noeud# Indice : gains possibles (A, B, C) :# - (0, 0, 0) si toutes restent dehors# - gains varies selon le nombre d'entrants (marche partage / concurrence) game = ExtensiveFormGame("3-Player Entry Game", num_players=3)# TODO etudiant : completer l'arbre ci-dessusreturn game
Exercice 3 — Vérifier un équilibre de Nash parfait en sous-jeux (SPE)
Contexte. Un équilibre de Nash du jeu global peut reposer sur une menace non crédible — une stratégie qui ne serait pas rationnelle si le sous-jeu correspondant était réellement atteint. Le SPE (Subgame Perfect Equilibrium) élimine ces menaces en exigeant un équilibre de Nash dans chaque sous-jeu. C’est précisément ce que la backward induction garantit (Exercice 1) et que la simple vérification de Nash global rate.
Objectif. Implémenter verify_spe(game, strategies) : pour chaque sous-jeu (identifié par sa racine), vérifier qu’aucun joueur ne peut améliorer son gain par déviation unilatérale dans ce sous-jeu. Retourner is_spe et la liste des violations (sous-jeu + joueur + déviation profitable).
La cellule suivante contient un test rapide des trois stubs (avec signatures non implémentées) pour vérifier que tout s’exécute de bout en bout. Les étapes détaillées figurent dans la docstring du stub.
def verify_spe(game: ExtensiveFormGame, strategies: Dict[int, PureStrategy]) -> Dict[str, Any]:"""Verifie qu'un profil de strategies pures est un SPE. Le SPE exige que le profil soit un equilibre de Nash dans CHAQUE sous-jeu du jeu extensif, pas seulement dans le jeu global. Cette difference est ce qui elimine les menaces non-credibles. Args: game: jeu extensif a information parfaite. strategies: dict {joueur -> PureStrategy} specifiant une action par infoset. Returns: Dict avec : - 'is_spe' (bool) : True si tous les sous-jeux verifient la Nash property - 'subgames_checked' (int) : nombre de sous-jeux examines - 'violations' (List[str]) : liste des sous-jeux ou la Nash property fail """# TODO etudiant : implementer la verification SPE# Etape 1 : enumerer tous les sous-jeux = tous les noeuds de decision# (racine + chaque noeud interne = sous-jeu identifie par sa racine)# Etape 2 : pour chaque sous-jeu, calculer les gains de chaque firme# sous les strategies RESTREINTES au sous-jeu# (on utilise les strategies globales mais on tronque au sous-arbre)# Etape 3 : pour chaque firme, tester si elle a une deviation unilaterale# profitable DANS CE SOUS-JEU (comparer son gain actuel au gain# maximal parmi les deviations possibles)# Etape 4 : si une firme peut ameliorer son gain par deviation dans# au moins un sous-jeu, ajouter "subgame=<root_id>: player=<p># can deviate to gain <delta>" a violations# Indice : pour le jeu a 3 firmes, on attend 7 sous-jeux (1+2+4)return {'is_spe': False,'subgames_checked': 0,'violations': ['TODO etudiant : implementer la verification SPE'], }# Test rapide (avec stubs non implementes, on verifie juste la signature)print("3 exos a completer : solve_ultimatum, build_three_player_entry_game, verify_spe")print("\nResultats stubs (non implementes) :")print(f" solve_ultimatum([2,4,5,6,8]) -> {solve_ultimatum([2,4,5,6,8])}")print(f" build_three_player_entry_game() -> {build_three_player_entry_game().name}")print(f" verify_spe(entry_game, ...) -> {verify_spe(entry_game, {1: entrant_enter, 2: incumbent_acc})['is_spe']}")
La conversion extensive -> normale est exponentielle
OpenSpiel fournit de nombreux jeux pre-implementes
Prochaine étape
Notebook 8 : Jeux Combinatoires - Théorie de Conway, jeux de Nim et theoreme de Sprague-Grundy.
Lien avec la formalisation Lean : La conversion entre forme extensive et forme normale (section 7) s’appuie sur les structures de jeux définies dans lean_game_defs/Basic.lean, qui formalise NormalFormGame et Game2x2. Les equilibres de Nash en stratégies pures et mixtes, calcules ici sur la matrice issue de la conversion, correspondent aux definitions formelles de lean_game_defs/Nash.lean (isPureNashEquilibrium, isNashEquilibrium). La théorie des ensembles d’information et de l’equilibre parfait en sous-jeux (SPE) sera approfondie dans les notebooks 9 et 10 avec l’induction arriere.
Resume et perspectives
Ce notebook a permis de construire les fondements de la representation extensive des jeux, en passant de la matrice de gains statique a l’arbre de jeu dynamique. Les concepts centraux exploites – noeuds de decision, ensembles d’information (infosets), stratégies pures et comportementales – constituent le vocabulaire de base pour analyser toute interaction stratégique séquentielle. La distinction entre information parfaite (chaque joueur connait l’historique complet) et information imparfaite (certains etats sont indistinguables) s’est revelee fondamentale : elle determine les stratégies disponibles pour chaque joueur et la complexite de l’analyse. L’integration avec OpenSpiel a illustre comment ces concepts s’appliquent a des jeux reels comme le Kuhn Poker, ou le bluff emerge naturellement de la structure d’information asymetrique.
La conversion entre forme extensive et forme normale a mis en evidence un phenomene important : la representation extensive est plus parcimonieuse, car la forme normale peut exploser exponentiellement en fonction du nombre de noeuds de decision. Le jeu d’entree sur le marche a également souleve la question des menaces non credibles, que la forme extensive detecte mais ne resout pas formellement.
Papiers fondateurs de la théorie des jeux sous forme extensive :
Kuhn, H. W. (1953). Extensive Games and the Problem of Information. In Kuhn & Tucker (eds.), Contributions to the Theory of Games, Volume II, Annals of Mathematics Studies 28, Princeton University Press, pp. 193–216. — La formalisation moderne des jeux sous forme extensive (ensembles d’information, stratégies comportementales, théorème d’équivalence §3.3).
Nash, J. F. (1950). Equilibrium Points in N-Person Games. Proceedings of the National Academy of Sciences, 36(1):48–49. — L’existence d’équilibre (le concept résolu ici sur l’arbre de jeu).
Nash, J. F. (1951). Non-Cooperative Games. Annals of Mathematics, 54(2):286–295. — La démonstration d’existence via point fixe (prix Nobel d’économie 1994).
Note : la backward induction (solution des jeux à information parfaite) remonte à Zermelo (1913) sur le jeu d’échecs, et la sélection d’équilibres parfaits en sous-jeux à Selten (1965) — non reproduites ici faute de vérification bibliographique firsthand ce cycle.