Evolution de la Confiance et Dilemme du Prisonnier Itere
Ce notebook explore le Dilemme du Prisonnier Itere (IPD) et l’evolution de la cooperation, inspire par le travail d’Axelrod et la simulation interactive “The Evolution of Trust” de Nicky Case.
Objectifs d’apprentissage
Comprendre le Dilemme du Prisonnier Itere
Implementer les stratégies classiques (Tit-for-Tat, Hawks, Doves…)
Reproduire le tournoi d’Axelrod (1984)
Simuler l’evolution des populations (replicator dynamics)
Identifier les conditions pour l’emergence de la cooperation
Prerequis
Notebooks 1-5 : Fondations, equilibres de Nash, jeux a somme nulle
Notion de stratégie dominante et de dilemme du prisonnier
Dans le Dilemme du Prisonnier unique, la stratégie dominante est de trahir.
Mais quand le jeu est repete (potentiellement indefiniment), la cooperation peut emerger !
Matrice des gains (convention Axelrod)
Cooperer
Trahir
Cooperer
(R, R) = (3, 3)
(S, T) = (0, 5)
Trahir
(T, S) = (5, 0)
(P, P) = (1, 1)
T (Temptation) = 5 : Trahir quand l’autre coopere
R (Reward) = 3 : Cooperation mutuelle
P (Punishment) = 1 : Trahison mutuelle
S (Sucker) = 0 : Cooperer quand l’autre trahit
Condition du dilemme : T > R > P > S et 2R > T + S
# ActionsCOOPERATE ='C'DEFECT ='D'# Matrice des gains (convention Axelrod)T, R, P, S =5, 3, 1, 0# Temptation, Reward, Punishment, Suckerdef payoff(action1: str, action2: str) -> Tuple[int, int]:""" Retourne les gains (joueur1, joueur2) pour une paire d'actions. """if action1 == COOPERATE and action2 == COOPERATE:return (R, R)elif action1 == COOPERATE and action2 == DEFECT:return (S, T)elif action1 == DEFECT and action2 == COOPERATE:return (T, S)else: # DEFECT, DEFECTreturn (P, P)# Verification de la condition du dilemmeprint(f"Gains: T={T}, R={R}, P={P}, S={S}")print(f"Condition T > R > P > S: {T > R > P > S}")print(f"Condition 2R > T + S: {2*R > T + S} ({2*R} > {T+S})")
Gains: T=5, R=3, P=1, S=0
Condition T > R > P > S: True
Condition 2R > T + S: True (6 > 5)
Lecture chiffree — les deux conditions passees au banc. La sortie ne redefinit pas la matrice, elle la verifie : Condition T > R > P > S: True puis Condition 2R > T + S: True (6 > 5). Les deux nombres de la parenthese se decodent en une ligne : 2R = 6 et T + S = 5, l’ecart vaut 1. Pourquoi ce second test alors que le premier suffit a ordonner les gains ? Parce qu’il verrouille la porte de l’alternance : deux joueurs qui se repartiraient trahison et duperie tour a tour engrangeraient (T + S) / 2 = 2,5 points par coup en moyenne — moins que les R = 3 de la cooperation mutuelle. Avec 2R > T + S, cooperer a chaque coup domine toute strategie d’alternance : le dilemme reste entier, sans issue par la rotation des roles.
2. Stratégies classiques
Implementons les stratégies les plus connues du tournoi d’Axelrod.
class Strategy(ABC):""" Classe de base pour les strategies IPD. """def__init__(self, name: str="Strategy"):self.name = nameself.reset()def reset(self):"""Reinitialise l'etat interne."""self.my_history: List[str] = []self.opponent_history: List[str] = []@abstractmethoddef choose(self) ->str:"""Choisit une action basee sur l'historique."""passdef update(self, my_action: str, opponent_action: str):"""Met a jour l'historique apres un tour."""self.my_history.append(my_action)self.opponent_history.append(opponent_action)def__repr__(self):returnself.nameclass AlwaysCooperate(Strategy):"""Coopere toujours (Dove / Colombe)."""def__init__(self):super().__init__("AlwaysCooperate")def choose(self) ->str:return COOPERATEclass AlwaysDefect(Strategy):"""Trahit toujours (Hawk / Faucon)."""def__init__(self):super().__init__("AlwaysDefect")def choose(self) ->str:return DEFECTclass TitForTat(Strategy):""" Tit-for-Tat (Copycat / Donnant-donnant). - Coopere au premier tour - Ensuite, copie le dernier coup de l'adversaire Gagnant du tournoi d'Axelrod (1980). """def__init__(self):super().__init__("TitForTat")def choose(self) ->str:ifnotself.opponent_history:return COOPERATEreturnself.opponent_history[-1]class TitForTwoTats(Strategy):""" Tit-for-Two-Tats (Copykitten / Rancunier indulgent). - Coopere jusqu'a ce que l'adversaire trahisse DEUX fois de suite - Plus indulgent que TFT face aux erreurs """def__init__(self):super().__init__("TitForTwoTats")def choose(self) ->str:iflen(self.opponent_history) <2:return COOPERATE# Trahit seulement si l'adversaire a trahi les 2 derniers toursifself.opponent_history[-1] == DEFECT andself.opponent_history[-2] == DEFECT:return DEFECTreturn COOPERATEclass Grudger(Strategy):""" Grudger (Rancunier / Grim Trigger). - Coopere jusqu'a la premiere trahison - Apres une trahison, ne pardonne JAMAIS """def__init__(self):super().__init__("Grudger")self.betrayed =Falsedef reset(self):super().reset()self.betrayed =Falsedef choose(self) ->str:ifself.betrayed:return DEFECTreturn COOPERATEdef update(self, my_action: str, opponent_action: str):super().update(my_action, opponent_action)if opponent_action == DEFECT:self.betrayed =Trueclass Random(Strategy):"""Joue aleatoirement avec probabilite p de cooperer."""def__init__(self, p: float=0.5):super().__init__(f"Random(p={p})")self.p = pdef choose(self) ->str:return COOPERATE if random.random() <self.p else DEFECTclass Pavlov(Strategy):""" Pavlov (Win-Stay, Lose-Shift). - Repete l'action si elle a rapporte un bon gain (R ou T) - Change sinon """def__init__(self):super().__init__("Pavlov")def choose(self) ->str:ifnotself.my_history:return COOPERATE last_mine =self.my_history[-1] last_opp =self.opponent_history[-1]# Bon resultat (R ou T) -> repeterif (last_mine == COOPERATE and last_opp == COOPERATE) or\ (last_mine == DEFECT and last_opp == COOPERATE):return last_mine# Mauvais resultat -> changerreturn DEFECT if last_mine == COOPERATE else COOPERATEclass SuspiciousTitForTat(Strategy):"""TFT mais commence par trahir."""def__init__(self):super().__init__("SuspiciousTFT")def choose(self) ->str:ifnotself.opponent_history:return DEFECT # Mefiant au debutreturnself.opponent_history[-1]# Liste des strategiesSTRATEGIES = [ AlwaysCooperate, AlwaysDefect, TitForTat, TitForTwoTats, Grudger, Random, Pavlov, SuspiciousTitForTat,]print("Strategies implementees:")for StratCls in STRATEGIES: strat = StratCls()print(f" - {strat.name}")
Lecture chiffree — le plateau de depart se lit en quatre familles. Le print final enumere les huit strategies qui disputeront tous les matchs du notebook : les gentils d’entree (AlwaysCooperate, TitForTat, TitForTwoTats, Grudger — aucun ne trahit en premier), le defecteur pur (AlwaysDefect), le bruit (Random(p=0.5), une trahison sur deux en esperance), et deux profils atypiques : Pavlov, qui ne change de comportement qu’apres un coup mal paye, et SuspiciousTFT, le seul du plateau a ouvrir par la trahison. Cette grammaire — nice, retaliating, forgiving — est exactement celle que le tableau final de la section 8 resumera ; le tournoi la mettra a l’epreuve en croisant chaque famille avec les sept autres.
3. Simulation d’un match
Simulons des rencontres entre stratégies.
def play_match(strategy1: Strategy, strategy2: Strategy, rounds: int=200, noise: float=0.0) -> Tuple[int, int]:""" Simule un match entre deux strategies. Args: strategy1, strategy2: Les deux strategies rounds: Nombre de tours noise: Probabilite d'erreur (action inversee) Returns: (score1, score2) """ strategy1.reset() strategy2.reset() score1, score2 =0, 0for _ inrange(rounds):# Choisir les actions action1 = strategy1.choose() action2 = strategy2.choose()# Appliquer le bruit (erreurs de transmission)if noise >0:if random.random() < noise: action1 = DEFECT if action1 == COOPERATE else COOPERATEif random.random() < noise: action2 = DEFECT if action2 == COOPERATE else COOPERATE# Calculer les gains p1, p2 = payoff(action1, action2) score1 += p1 score2 += p2# Mettre a jour les historiques strategy1.update(action1, action2) strategy2.update(action2, action1)return score1, score2# Test: TitForTat vs AlwaysDefecttft = TitForTat()defector = AlwaysDefect()s1, s2 = play_match(tft, defector, rounds=100)print(f"TitForTat vs AlwaysDefect (100 tours):")print(f" TFT: {s1}, Defector: {s2}")# TitForTat vs TitForTattft1 = TitForTat()tft2 = TitForTat()s1, s2 = play_match(tft1, tft2, rounds=100)print(f"\nTitForTat vs TitForTat (100 tours):")print(f" TFT1: {s1}, TFT2: {s2}")
TitForTat vs AlwaysDefect (100 tours):
  TFT: 99, Defector: 104

TitForTat vs TitForTat (100 tours):
  TFT1: 300, TFT2: 300
Interpretation : résultats des matchs
Les deux matchs tests illustrent la dynamique fondamentale du dilemme du prisonnier itere :
Match 1 : TFT vs AlwaysDefect (100 tours)
Tour
TFT
Defector
Gains TFT
Gains Defector
1
C
D
S=0
T=5
2-100
D
D
P=1
P=1
Total
-
-
99
104
TitForTat “perd” le match direct car il subit le coup S=0 au premier tour avant de riposter.
Match 2 : TFT vs TFT (100 tours)
Chaque tour
TFT1
TFT2
Gains
Tous
C
C
R=3 chacun
Total
-
-
300 chacun
Deux TFT cooperent parfaitement et obtiennent le gain maximal possible.
Point cle : Un defecteur bat un cooperateur en match direct, mais deux cooperateurs obtiennent ensemble bien plus qu’un defecteur seul.
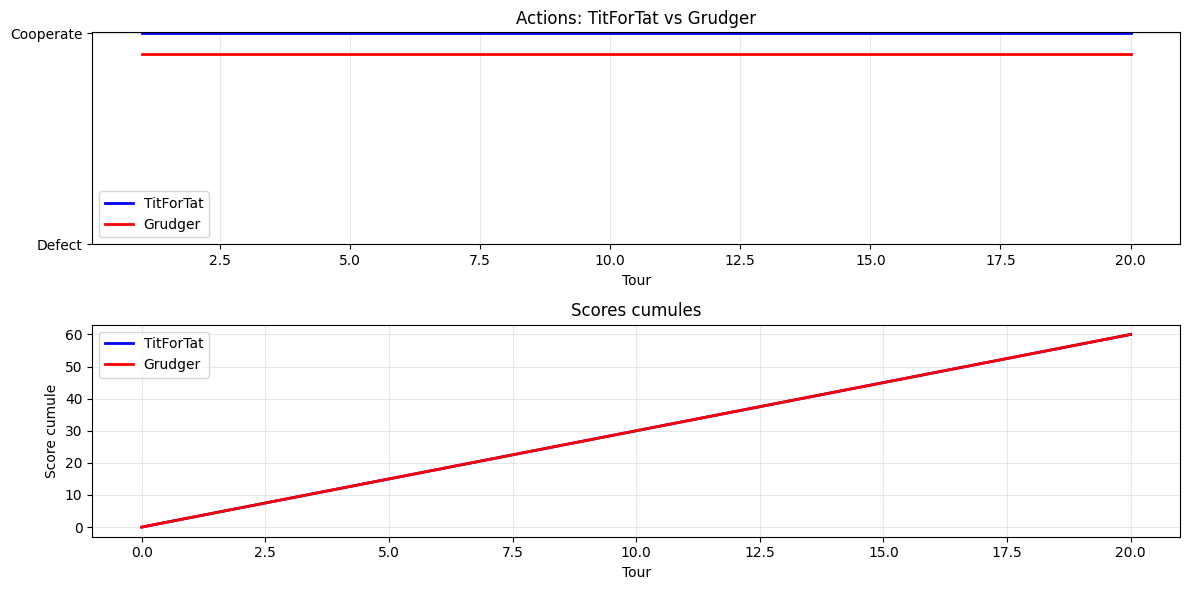
La visualisation TFT vs Grudger illustre deux stratégies “nice” qui cooperent parfaitement :
Graphique des actions : - Les deux lignes restent a “Cooperate” pendant tout le match - Aucune trahison n’est declenchee car aucun des deux ne commence
Graphique des scores cumules : - Les scores evoluent de maniere identique (pente = R = 3 par tour) - Score final egal : 60 points chacun sur 20 tours
Principe : Deux stratégies “nice” (qui ne trahissent jamais en premier) cooperent toujours et obtiennent le gain maximal mutuel.
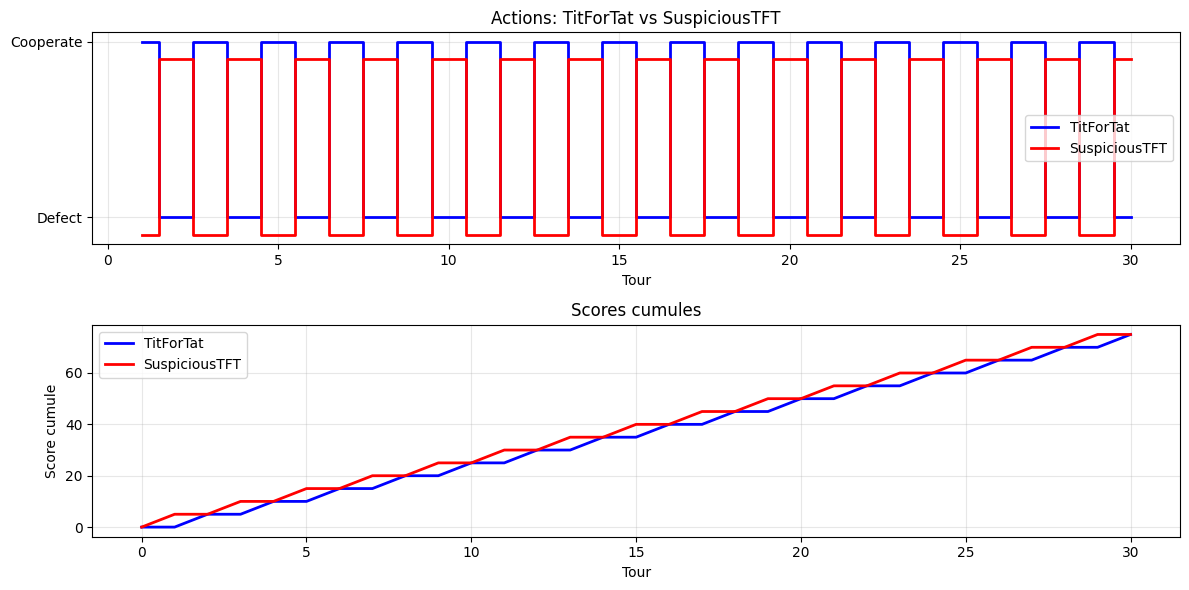
La cellule suivante montre un cas plus interessant : TFT vs SuspiciousTFT.
# Visualiser TFT vs SuspiciousTFTvisualize_match(TitForTat(), SuspiciousTitForTat(), rounds=30)
Score final: TitForTat=75, SuspiciousTFT=75
Lecture chiffree — 75 partout : l’alternance verrouillee. Le score final TitForTat=75, SuspiciousTFT=75 sur 30 coups se decode exactement. Un seul coup les separe a l’ouverture : TitForTat coopere, SuspiciousTFT trahit — gains 0 contre 5. Ensuite les deux reflexes se renvoient la defection et la cooperation en quinconce : chacun joue D quand l’autre vient de jouer C, et C quand l’autre vient de jouer D. Trente coups d’alternance stricte donnent a chaque joueur quinze trahisons recompensees et quinze duperies : 15 x 5 + 15 x 0 = 75. La figure au-dessus raconte la meme histoire en barres croisees. Ce score egale et mediant porte la lecon du regime : une seule defaite d’ouverture entre deux strategies miroirs verrouille l’alternance pour toujours — ni la cooperation mutuelle (3 x 30 = 90) ni la defection generale (1 x 30 = 30) ne seront atteintes, et le total commun 75 + 75 = 150 reste sous les 180 que la cooperation mutuelle aurait payes.
4. Tournoi d’Axelrod
Reproduisons le celebre tournoi d’Axelrod (1980) ou chaque stratégie affronte toutes les autres.
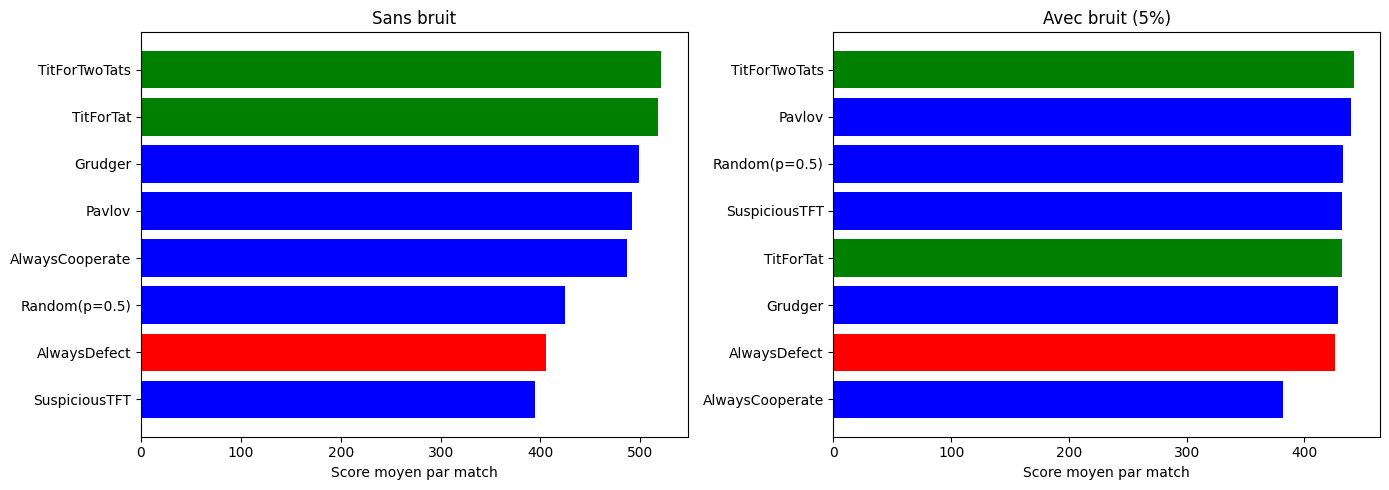
Protocole de lecture — ce que mesure la colonne Score moyen. Chaque strategie joue 200 coups contre chacune des sept autres : le score affiche est le gain moyen par rencontre — un total de points, pas un bilan de victoires et de defaites. Une strategie peut perdre plusieurs duels et finir premiere : le classement recompense qui collecte le plus sur l’ensemble des rencontres, adversaires gentils compris. Le bas du tableau le confirme : SuspiciousTFT ferme la marche a 394,81 — sa trahison d’ouverture lui coute chaque rencontre contre les cinq gentils du champ ; AlwaysDefect ne le precede qu’a 405,50 ; et AlwaysCooperate (486,75) devance Random (424,62) : subir la duperie coute moins cher que la distribuer au hasard dans un tournoi ou la majorite du champ est gentil.
def run_tournament(strategies: List[Strategy], rounds: int=200, noise: float=0.0, repetitions: int=1) -> Dict[str, float]:""" Execute un tournoi round-robin. Args: strategies: Liste des strategies participantes rounds: Nombre de tours par match noise: Probabilite d'erreur repetitions: Nombre de repetitions pour moyenner (utile avec bruit) Returns: Dictionnaire {nom_strategie: score_moyen_par_match} """ n =len(strategies) scores = defaultdict(float) match_count = defaultdict(int)for _ inrange(repetitions):for i inrange(n):for j inrange(n):# Creer des instances fraiches s1 =type(strategies[i])() s2 =type(strategies[j])() score1, score2 = play_match(s1, s2, rounds, noise) scores[strategies[i].name] += score1 scores[strategies[j].name] += score2 match_count[strategies[i].name] +=1 match_count[strategies[j].name] +=1# Calculer la moyenne par match avg_scores = {name: scores[name] / match_count[name] for name in scores}return avg_scoresdef display_tournament_results(results: Dict[str, float], title: str="Tournoi"):"""Affiche les resultats du tournoi.""" sorted_results =sorted(results.items(), key=lambda x: -x[1])print(f"\n{title}")print("="*50)print(f"{'Rang':<5}{'Strategie':<20}{'Score moyen':<12}")print("-"*50)for rank, (name, score) inenumerate(sorted_results, 1):print(f"{rank:<5}{name:<20}{score:<12.2f}")# Creer les instancestournament_strategies = [StratCls() for StratCls in STRATEGIES]# Tournoi sans bruitresults = run_tournament(tournament_strategies, rounds=200, noise=0.0)display_tournament_results(results, "Tournoi d'Axelrod (sans bruit)")
Ces résultats reproduisent les decouvertes historiques d’Axelrod (1980). Les stratégies gagnantes partagent des caractéristiques communes :
Rang
Stratégie
Score
Caractéristiques
1
TitForTwoTats
~520
Nice, Forgiving++, Retaliating
2
TitForTat
~519
Nice, Forgiving, Retaliating
3
Grudger
~500
Nice, Retaliating, NOT Forgiving
Pourquoi TitForTat gagne ?
“Nice” : Ne jamais trahir en premier permet d’etablir la cooperation
“Retaliating” : Punir les trahisons dissuade l’exploitation
“Forgiving” : Revenir a la cooperation après punition permet de sortir des spirales
Le paradoxe : AlwaysDefect bat TitForTat en match direct (104 vs 99), mais perd le tournoi car il ne peut pas etablir de cooperation rentable avec les autres stratégies “nice”.
# Tournoi avec bruit (5% d'erreurs)results_noisy = run_tournament(tournament_strategies, rounds=200, noise=0.05, repetitions=10)display_tournament_results(results_noisy, "Tournoi avec bruit (5% d'erreurs)")
L’introduction de 5% de bruit (erreurs de transmission) bouleverse le classement :
Sans bruit
Avec bruit (5%)
Evolution
1. TitForTwoTats
1. TitForTwoTats
Stable (leader #1)
2. TitForTat
2. Pavlov
Forte hausse (#4 -> #2)
3. Grudger
3. TitForTat
Recule (#2 -> #3)
4. Pavlov
4. Random(p=0.5)
Hausse (#6 -> #4)
5. AlwaysCooperate
5. Grudger
Recule (#3 -> #5)
Mécanismes observes :
TitForTat souffre : Une erreur de l’adversaire est interpretee comme une trahison, declenchant une riposte qui peut mener a une spirale de represailles
TitForTwoTats resiste : Requiert deux trahisons consecutives pour riposter, absorbant les erreurs isolees
Grudger s’effondre : Une seule erreur = fin definitive de la cooperation
AlwaysCooperate chute : Sans reciprocite, les erreurs s’accumulent contre lui
# Visualisation comparativefig, axes = plt.subplots(1, 2, figsize=(14, 5))for ax, res, title in [(axes[0], results, 'Sans bruit'), (axes[1], results_noisy, 'Avec bruit (5%)')]: names =list(res.keys()) scores =list(res.values()) sorted_idx = np.argsort(scores)[::-1] names = [names[i] for i in sorted_idx] scores = [scores[i] for i in sorted_idx] colors = ['green'if'TitFor'in n else'red'if'Defect'in n else'blue'for n in names] ax.barh(range(len(names)), scores, color=colors) ax.set_yticks(range(len(names))) ax.set_yticklabels(names) ax.set_xlabel('Score moyen par match') ax.set_title(title) ax.invert_yaxis()plt.tight_layout()plt.show()
Observations d’Axelrod
Les stratégies gagnantes partagent plusieurs proprietes :
Nice (Gentilles) : Ne jamais trahir en premier
Retaliating (Retorsion) : Punir les trahisons
Forgiving (Pardonner) : Revenir a la cooperation après punition
Clear (Claire) : Comportement previsible
Exercice 2 : Exploitabilite d’une stratégie
Dans un tournoi, une stratégie est d’autant plus robuste qu’elle est difficile a exploiter. L’exploitabilite mesure l’ecart entre le gain contre le pire adversaire et le gain contre le meilleur adversaire. Une stratégie très exploitable (comme AlwaysCooperate) perd beaucoup contre les defecteurs mais gagne beaucoup contre les cooperateurs. Une stratégie peu exploitable (comme TitForTat) a des gains plus homogenes.
Objectif : Implementer compute_exploitability qui evalue la vulnerabilite d’une stratégie face a un ensemble d’adversaires.
def compute_exploitability(strategy: Strategy, opponents: list, rounds: int=200) ->dict:""" Calcule l'exploitabilite d'une strategie face a un ensemble d'adversaires. L'exploitabilite mesure la vulnerabilite : l'ecart entre le pire et le meilleur gain obtenu contre les differents adversaires. Args: strategy: La strategie a evaluer opponents: Liste de strategies adversaires rounds: Nombre de tours par match Returns: Dictionnaire avec worst_opponent, worst_score, best_score, exploitability """# TODO etudiant : implementer le calcul d'exploitabilite# Etape 1 : faire jouer la strategie contre chaque adversaire avec play_match# Etape 2 : calculer le gain de la strategie contre chaque adversaire# Etape 3 : identifier le pire adversaire (gain minimum) et le meilleur (gain maximum)# Etape 4 : calculer l'exploitabilite = best_score - worst_score# Indice : creer des instances fraiches avec type(strategy)() pour chaque matchreturn {"worst_opponent": None, "worst_score": 0.0, "best_score": 0.0, "exploitability": 0.0} # TODO etudiant : remplacer# Test rapide (decommentez apres implementation)# result = compute_exploitability(TitForTat(), [AlwaysDefect(), AlwaysCooperate(), TitForTat()])# print(f"Exploitabilite de TFT: {result}")print("Exercice a completer")
Exercice a completer
Lire la sortie d’un exercice non rempli. La cellule n’affiche que « Exercice a completer » : compute_exploitability est un squelette, et son contrat est pose par l’enonce ci-dessus. Quand la solution existera, la sortie presentera pour chaque strategie du panel l’ecart entre son gain contre le pire adversaire et son gain contre le meilleur — AlwaysCooperate devrait crever l’ecart (elle nourrit les defecteurs et encaisse face aux gentils), TitForTat le resserrer (ses gains varient peu selon l’adversaire). L’attendu n’est donc pas un classement mais un tableau de dispersions : la lecture dira quelle strategie exposait ses flancs, pas laquelle marque le plus de points. L’indice de l’enonce donne la marche a suivre, pas la reponse.
5. Dynamique des populations (Replicator Dynamics)
Comment evoluent les populations de stratégies au fil du temps ?
def compute_payoff_matrix(strategies: List[Strategy], rounds: int=200) -> np.ndarray:""" Calcule la matrice des gains moyens entre strategies. M[i,j] = gain moyen de strategie i contre strategie j """ n =len(strategies) M = np.zeros((n, n))for i inrange(n):for j inrange(n): s1 =type(strategies[i])() s2 =type(strategies[j])() score1, _ = play_match(s1, s2, rounds) M[i, j] = score1 / rounds # Gain moyen par tourreturn Mdef replicator_dynamics(M: np.ndarray, x0: np.ndarray, T: int=100, dt: float=0.1) -> np.ndarray:""" Simule la dynamique du replicateur. dx_i/dt = x_i * (fitness_i - fitness_moyenne) Args: M: Matrice des gains x0: Distribution initiale des strategies T: Nombre d'iterations dt: Pas de temps Returns: Trajectoire des proportions (T x n) """ n =len(x0) trajectory = np.zeros((T, n)) x = x0.copy()for t inrange(T): trajectory[t] = x# Fitness de chaque strategie fitness = M @ x# Fitness moyenne avg_fitness = x @ fitness# Equation du replicateur dx = x * (fitness - avg_fitness) * dt x = x + dx# Normaliser (pour stabilite numerique) x = np.maximum(x, 0) x = x / np.sum(x)return trajectory# Calculer la matrice des gainssimple_strategies = [TitForTat(), AlwaysCooperate(), AlwaysDefect()]M = compute_payoff_matrix(simple_strategies, rounds=200)print("Matrice des gains moyens par tour:")print(f"{'':15}", end="")for s in simple_strategies:print(f"{s.name:>15}", end="")print()for i, s inenumerate(simple_strategies):print(f"{s.name:15}", end="")for j inrange(len(simple_strategies)):print(f"{M[i,j]:>15.2f}", end="")print()
Matrice des gains moyens par tour:
                     TitForTatAlwaysCooperate   AlwaysDefect
TitForTat                 3.00           3.00           0.99
AlwaysCooperate           3.00           3.00           0.00
AlwaysDefect              1.02           5.00           1.00
Interpretation : matrice des gains
La matrice des gains moyens par tour revele les interactions entre stratégies :
Confrontation
Gain moyen/tour
Explication
TFT vs TFT
3.00
Cooperation mutuelle parfaite (R=3)
TFT vs Cooperate
3.00
Cooperation mutuelle
TFT vs Defect
0.99
TFT coopere au tour 1 (S=0), puis trahit (P=1)
Cooperate vs Defect
0.00
Exploitation totale (S=0 a chaque tour)
Defect vs Cooperate
5.00
Exploitation totale (T=5 a chaque tour)
Defect vs Defect
1.00
Trahison mutuelle (P=1)
Observation cle : AlwaysDefect gagne le match direct contre tout le monde, mais TitForTat maximise le gain total dans un tournoi car il obtient des gains eleves contre les cooperateurs tout en limitant les pertes contre les defecteurs.
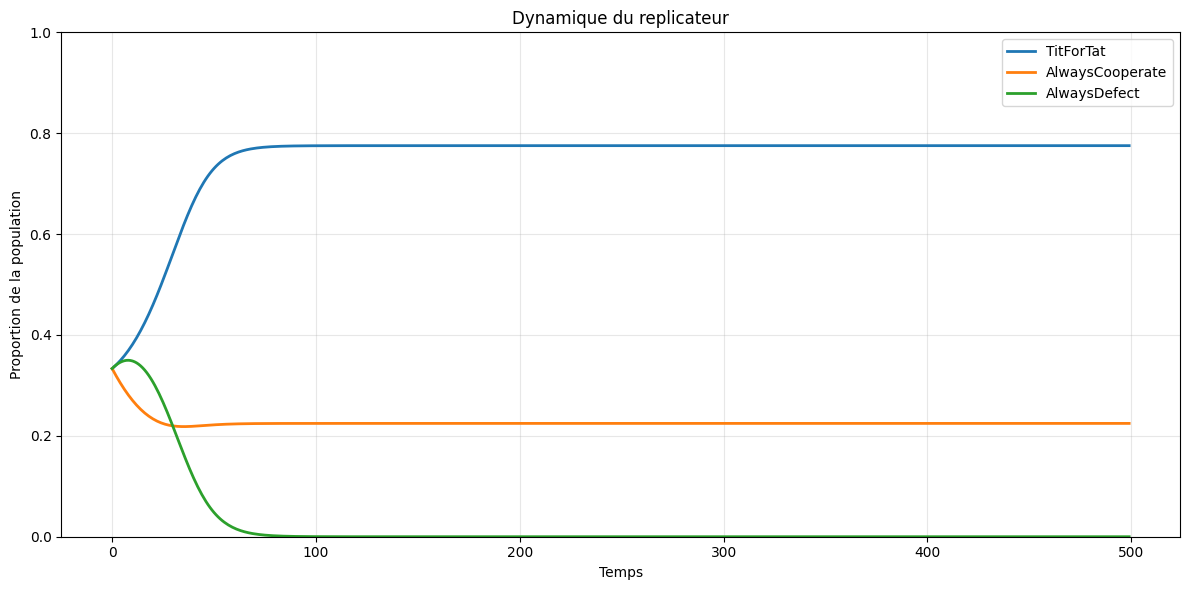
def plot_replicator_dynamics(strategies: List[Strategy], x0: np.ndarray =None, T: int=500):""" Visualise l'evolution des populations. """ n =len(strategies) M = compute_payoff_matrix(strategies, rounds=200)if x0 isNone: x0 = np.ones(n) / n # Distribution uniforme trajectory = replicator_dynamics(M, x0, T=T, dt=0.1)# Visualisation fig, ax = plt.subplots(figsize=(12, 6))for i, s inenumerate(strategies): ax.plot(trajectory[:, i], label=s.name, linewidth=2) ax.set_xlabel('Temps') ax.set_ylabel('Proportion de la population') ax.set_title('Dynamique du replicateur') ax.legend(loc='best') ax.set_ylim(0, 1) ax.grid(True, alpha=0.3) plt.tight_layout() plt.show()# Etat finalprint("\nEtat final:")for i, s inenumerate(strategies):print(f" {s.name}: {trajectory[-1, i]*100:.1f}%")# Evolution: TFT vs Cooperators vs Defectorsplot_replicator_dynamics(simple_strategies)
La simulation montre l’evolution des proportions de stratégies dans une population selon l’equation du replicateur :
\[\frac{dx_i}{dt} = x_i \cdot (f_i - \bar{f})\]
ou \(x_i\) est la proportion de la stratégie \(i\), \(f_i\) sa fitness, et \(\bar{f}\) la fitness moyenne.
Résultats observes : - TitForTat devient majoritaire (77.5% de la population) - AlwaysCooperate persiste de facon residuelle (22.5%) - AlwaysDefect est eliminee (0.0%)
Mécanisme d’elimination : 1. Les defecteurs exploitent les cooperateurs purs (gain 5 vs 0) 2. Mais les TFT se protegent mutuellement (gain 3 vs 3 entre eux) 3. Contre les defecteurs, TFT ne perd que le premier tour puis obtient 1-1 4. Le leger avantage des TFT s’accumule et domine a long terme
Note : Ce résultat est souvent décrit comme une illustration du concept de stratégie évolutivement stable (ESS) de Maynard Smith. Ce n’est pas le cas ici : TitForTat n’est pas une ESS — le mutant AlwaysCooperate lui est neutre (u(TFT,TFT) = u(AC,TFT) = 3.00), il est donc une stratégie neutrement stable (NSS), et le point d’arrêt 77,5 % / 22,5 % est un point de repos du réplicateur dépendant de la condition initiale. Le critère complet est appliqué au § 5bis.
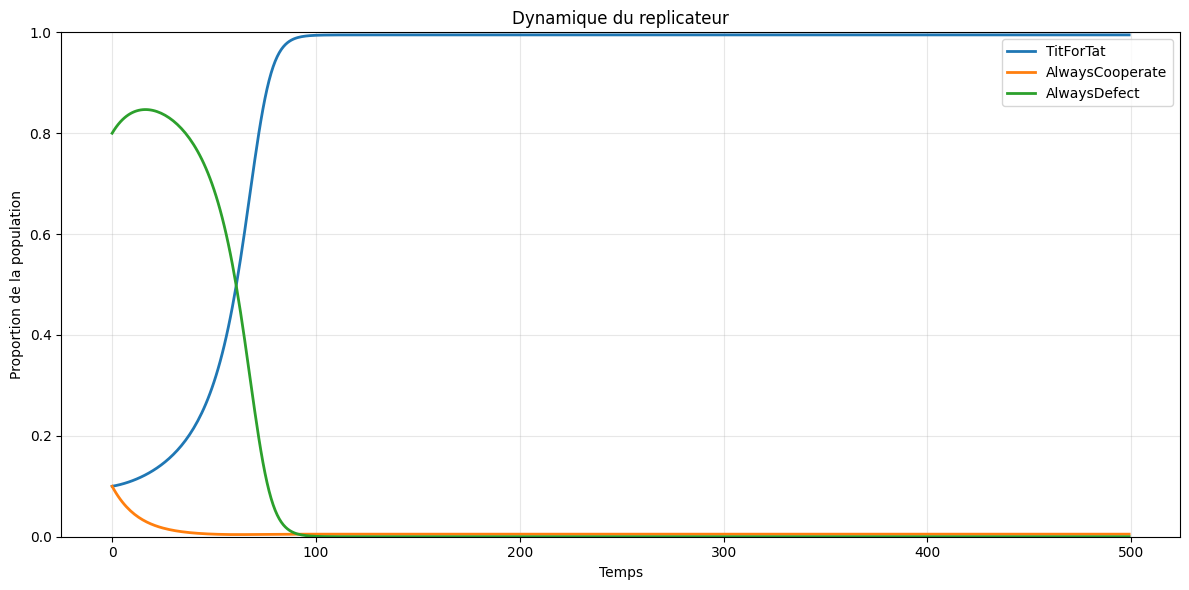
# Avec conditions initiales differentes# Beaucoup de defecteurs au debutplot_replicator_dynamics(simple_strategies, x0=np.array([0.1, 0.1, 0.8]))
Ce résultat illustre un concept fondamental en théorie des jeux evolutionnaire : la dépendance aux conditions initiales.
Condition initiale
TFT
Cooperate
Defect
Convergence
Uniforme (33% chacun)
~77%
~23%
~0%
TFT majoritaire
Pro-defection (80% D)
~100%
~0%
~0%
TFT domine encore
Observation cle : Même avec seulement 10% de TitForTat au depart, cette stratégie finit par dominer. Cela s’explique par :
Exploitation des cooperateurs : Les defecteurs exploitent les cooperateurs purs, les eliminant
Resistance mutuelle : Les TFT se protegent entre eux par la reciprocite
Punition des defecteurs : Les TFT punissent les defecteurs, reduisant leur avantage
Theoreme du folk : Dans un IPD suffisamment repete, la cooperation peut etre un equilibre de Nash si les joueurs sont assez “patients” (valorisent le futur).
5bis. Stratégie évolutivement stable (ESS) : le critère d’équilibre que la dynamique seule ne pose pas
La dynamique du réplicateur montre où la population s’arrête, mais pas pourquoi elle y résiste. Le concept qui répond à cette question est la stratégie évolutivement stable (ESS) de Maynard Smith — l’analogue évolutionnaire de l’équilibre de Nash : une population qui, une fois à cette composition, ne peut pas être envahie par un petit nombre de mutants.
Trois notions à distinguer, que la seule dynamique ne sépare pas :
ESS (stricte) : la stratégie i est une ESS si, pour tout mutant j != i :
u(i,i) > u(j,i) (elle gagne contre la population qu’elle domine), ou
u(i,i) = u(j,i)etu(i,j) > u(j,j) (à égalité, elle l’emporte dans le tête-à-tête avec le mutant).
NSS (neutrement stable) : le cas d’égalité u(i,i) = u(j,i) sans que u(i,j) > u(j,j) ne tienne — la stratégie résiste à l’invasion, mais tout mélange de la résidente et du mutant est lui aussi un point de repos.
Point de repos du réplicateur : une composition x où dx_i = 0 pour tout i. Un continuum de compositions peut être des points de repos sans qu’aucune ne soit une ESS ni un attracteur.
La section 5 a conclu « illustration du concept d’ESS ». Appliquons le critère ; il montre que ce n’est pas ce qui se passe ici.
def is_ess(M: np.ndarray, i: int, eps: float=1e-9) -> Tuple[bool, List[int]]:""" Teste si la strategie i est une strategie evolutivement stable (ESS) au sens de Maynard Smith sur la matrice M. M[a,b] = gain moyen de a contre b. i est une ESS ssi pour tout mutant j != i : (1) M[i,i] > M[j,i] (i gagne contre le mutant), ou (2) M[i,i] == M[j,i] ET M[i,j] > M[j,j] (egalite, puis i l'emporte en tete-a-tete) Renvoie (est_ess, mutants_faillite) ; mutants_faillite liste les j != i qui font echouer le test (mutant neutre ou envahissant). eps absorbe le bruit flottant des moyennes arithmetiques. """ n = M.shape[0] failing: List[int] = []for j inrange(n):if j == i:continue u_ii, u_ji = M[i, i], M[j, i] u_ij, u_jj = M[i, j], M[j, j]if u_ii > u_ji + eps:continue# condition (1) stricte remplieifabs(u_ii - u_ji) <= eps and u_ij > u_jj + eps:continue# condition (2) remplie (cas d'egalite) failing.append(j)returnlen(failing) ==0, failing
Un verdict ESS est réfutable par un seul mutant
is_ess ne renvoie pas un booléen nu : il renvoie aussi la liste des mutants qui font échouer le test. Ce choix n’est pas cosmétique ; un verdict privé de son réfutateur est indistinguable d’un verdict déclaré. Ici, chaque « NON » de la cellule suivante s’accompagne du mutant précis qui l’a produit, et ce mutant se revérifie à la main contre la matrice.
# Appliquer le critere ESS aux trois strategies de la matrice commiteeprint("Verdicts ESS sur la matrice du replicateur (cellule 22):\n")for i, s inenumerate(simple_strategies): ok, fail = is_ess(M, i) mut = [simple_strategies[j].name for j in fail] if fail else []print(f" {s.name:16}{'OUI'if ok else'NON':4}{', '.join(mut) if mut else'-'}")print("\nTitForTat n'est PAS une ESS : le mutant AlwaysCooperate lui est neutre")print("(u(TFT,TFT) = u(AC,TFT) = 3.00, et u(TFT,AC) = u(AC,AC) = 3.00).")print("TitForTat est donc une strategie *neutrement stable* (NSS), pas une ESS.")print("Tout melange TFT/AC (avec x_AlwaysDefect = 0) est un point de repos du replicateur.")print(" -> les 77.5% / 22.5% commites ne sont pas un attracteur : ils dependent de x_0.")
Verdicts ESS sur la matrice du replicateur (cellule 22):

  TitForTat        NON   AlwaysCooperate
  AlwaysCooperate  NON   TitForTat, AlwaysDefect
  AlwaysDefect     OUI   -

TitForTat n'est PAS une ESS : le mutant AlwaysCooperate lui est neutre
(u(TFT,TFT) = u(AC,TFT) = 3.00, et u(TFT,AC) = u(AC,AC) = 3.00).
TitForTat est donc une strategie *neutrement stable* (NSS), pas une ESS.
Tout melange TFT/AC (avec x_AlwaysDefect = 0) est un point de repos du replicateur.
  -> les 77.5% / 22.5% commites ne sont pas un attracteur : ils dependent de x_0.
Le contrôle positif : distinguer une absence réelle d’un instrument cassé
Le tableau ci-dessus rend surtout des « NON ». Pris seul, il reste ambigu : il ne dit pas si la matrice committée n’admet pas d’ESS, ou si is_ess refuse tout ce qu’on lui donne.
La cellule suivante lève l’ambiguïté en appliquant le même test à un jeu où une ESS stricte existe et est effectivement atteinte par la dynamique (Faucon-Colombe, V > C). Un instrument qui répond correctement sur ce contrôle, puis négativement sur la matrice committée, se distingue alors d’un instrument qui répond toujours non.
# Controle positif : un jeu ou une ESS STRICTE existe ET est atteinte par la dynamique# Faucon-Colombe avec V > C : la ressource vaut plus que le cout du combat.# Matrice (gain de la ligne contre la colonne) : H/H=(V-C)/2, H/D=V, D/H=0, D/D=V/2def hawk_dove_matrix(V: float, C: float) -> np.ndarray:return np.array([[(V - C) /2.0, V], [0.0, V /2.0]])def replicator_converge(M: np.ndarray, x0: np.ndarray, T: int=2000, dt: float=0.05) -> np.ndarray: x = x0.astype(float).copy()for _ inrange(T): x = x + x * (M @ x - x @ (M @ x)) * dt x = np.clip(x, 0, 1) x = x / x.sum()return xprint("Faucon-Colombe, ressource abondante (V=4, cout du combat C=2) : V > C")M_hd = hawk_dove_matrix(V=4.0, C=2.0)for i, nm inenumerate(["Faucon", "Colombe"]): ok, fail = is_ess(M_hd, i)print(f" is_ess({nm}) -> {'OUI (ESS stricte)'if ok else'NON'}"f"{' (mutants: '+', '.join(['Faucon','Colombe'][j] for j in fail) +')'if fail else''}")xf = replicator_converge(M_hd, np.array([0.5, 0.5]))print(f" replicator depuis 50/50 -> [Faucon {xf[0]*100:.1f}%, Colombe {xf[1]*100:.1f}%]")print(" (la dynamique converge vers l'ESS que le critere a detectee : ils s'accordent)")print("\nFaucon-Colombe, ressource rare (V=2, cout C=3) : V < C (aucune pure ESS stricte)")M_hd2 = hawk_dove_matrix(V=2.0, C=3.0)for i, nm inenumerate(["Faucon", "Colombe"]): ok, fail = is_ess(M_hd2, i)print(f" is_ess({nm}) -> {'OUI'if ok else'NON'}"f"{' (mutants: '+', '.join(['Faucon','Colombe'][j] for j in fail) +')'if fail else''}")print(" (ici l'ESS est mixte p_faucon = V/C = 2/3 : is_ess dit honnetement qu'aucune PURE n'est stricte)")
Faucon-Colombe, ressource abondante (V=4, cout du combat C=2) : V > C
  is_ess(Faucon) -> OUI (ESS stricte)
  is_ess(Colombe) -> NON  (mutants: Faucon)
  replicator depuis 50/50 -> [Faucon 100.0%, Colombe 0.0%]
  (la dynamique converge vers l'ESS que le critere a detectee : ils s'accordent)

Faucon-Colombe, ressource rare (V=2, cout C=3) : V < C (aucune pure ESS stricte)
  is_ess(Faucon) -> NON  (mutants: Colombe)
  is_ess(Colombe) -> NON  (mutants: Faucon)
  (ici l'ESS est mixte p_faucon = V/C = 2/3 : is_ess dit honnetement qu'aucune PURE n'est stricte)
Interprétation : ESS, NSS et la subtilité que la note initiale masquait
Appliqué à la matrice committée, le critère rend un verdict inattendu et honnête :
Stratégie
ESS ?
Pourquoi
TitForTat
NON
Mutant neutre AlwaysCooperate : u(TFT,TFT) = u(AC,TFT) = 3.00 et u(TFT,AC) = u(AC,AC) = 3.00. C’est une NSS, pas une ESS.
AlwaysCooperate
NON
Neutre contre TitForTat, et exploitable par AlwaysDefect (u(AC,AD) = 0.00).
AlwaysDefect
OUI (au sens pair-à-pair)
u(AD,AD) = 1.00 > u(TFT,AD) = 0.99 et u(AD,AD) = 1.00 > u(AC,AD) = 0.00 : il gagne le face-à-face contre les deux.
Le point délicat : AlwaysDefect est une ESS stricte au sens de Maynard Smith, pourtant la dynamique du réplicateur l’élimine (0,0 % à l’état final). Ce n’est pas une contradiction de la théorie, c’en est la portée exacte : une ESS garantit la stabilité locale (une population presque toute-AD résiste à une petite invasion), pas la convergence globale depuis n’importe quelle composition. Ici AD ne prospère qu’en présence de sa « proie » (AlwaysCooperate, qui lui rapporte 5.00) ; dès qu’il l’élimine, sa propre fitness s’effondre et TitForTat reprend l’avantage. La dynamique emmène donc la population vers la face neutre TFT-AC — un continuum de points de repos — et non vers l’ESS locale AD.
Ce que cela enseigne — et corrige — la note de la section 5 : « TitForTat est une ESS » était faux, et la version « la coopération évolue » mérite d’être nuancée. TitForTat est neutrement stable, et l’équilibre observé (77,5 % / 22,5 %) est un point de repos choisi par la condition initiale, pas un attracteur que la dynamique aurait imposé. Une autre x_0 (cellule 26) donne un autre couple tout aussi « final » : l’ESS est le bon outil pour poser la question, et le seul moyen de ne pas attribuer au hasard de la condition initiale une vertu stabilisatrice qu’il n’a pas.
Miroir avec le jumeau C#. Le jumeau C# de cette paire conclut AlwaysDefect = NSS — pas ESS — sur son pool de 7 stratégies : là-bas, SuspiciousTFT fait exactement 1.00 contre elle (\(u(STFT,AD) = 1.00 = u(AD,AD)\), égalité parfaite sur les deux axes du critère), et le verdict d’AlwaysDefect tombe d’ESS stricte à NSS. Ici, sur 3 stratégies, AlwaysDefectest une ESS stricte (\(u(AD,AD) = 1.00 > u(TFT,AD) = 0.99\)). Les deux verdicts sont vrais simultanément : le statut ESS est relatif à l’ensemble des mutants disponibles, pas une propriété intrinsèque de la stratégie. Un étudiant qui compare les deux notebooks voit le même objet recevoir deux verdicts — c’est la leçon, pas une incohérence.
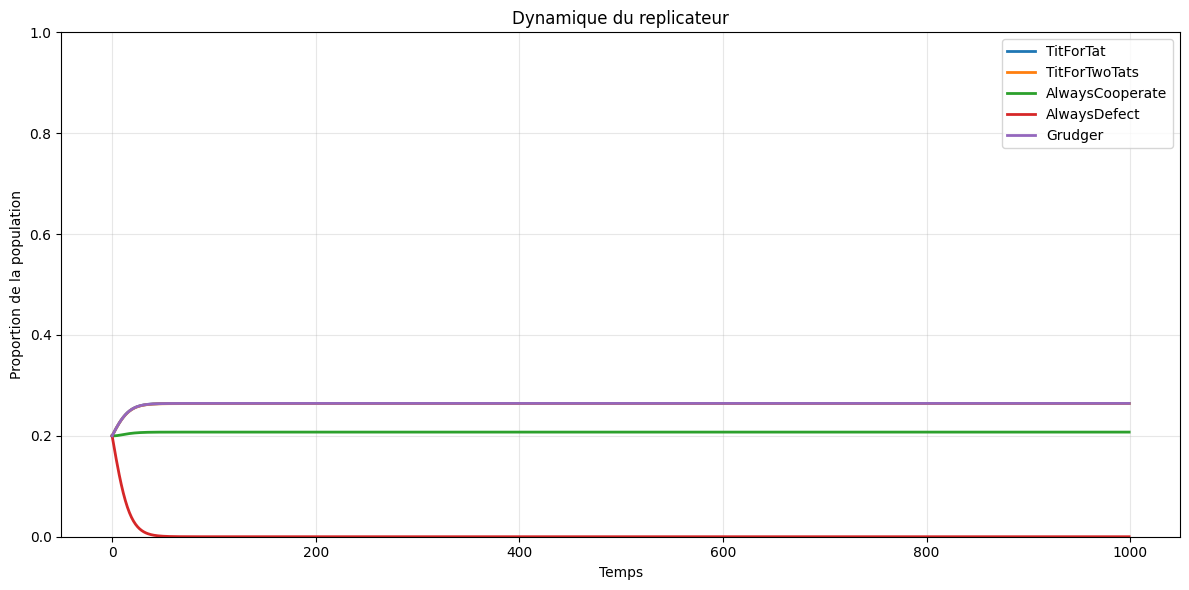
# Evolution plus complexe avec plus de strategiescomplex_strategies = [ TitForTat(), TitForTwoTats(), AlwaysCooperate(), AlwaysDefect(), Grudger(),]plot_replicator_dynamics(complex_strategies, T=1000)
Lecture chiffree — l’elimination nette d’AlwaysDefect. L’etat final de la simulation complexe se lit en une colonne : AlwaysDefect: 0.0% — disparu — tandis que les trois retaliateurs (TitForTat, TitForTwoTats, Grudger) finissent ex aequo a 26.4% chacun, et qu’AlwaysCooperate subsiste a 20.7%. Le mecanisme d’elimination compte plus que le verdict : le defecteur prospere d’abord en exploitant les cooperateurs purs, mais chaque trahison nourrit les retaliateurs qui l’etalonnent, et son vivier de proie s’epuise plus vite que sa propre base. Les trois retaliateurs finissent a egalite parce qu’entre eux ils jouent pareil — cooperation integrale, aucune trahison — et qu’ils punissent le defecteur de la meme facon : contre ce champ, rien ne les separe. AlwaysCooperate survit a 20.7% parce que les retaliateurs ne la punissent pas : sa part d’equilibre reflete l’absence de predation au sein du camp gentil.
Exercice 3 : Seuil de cooperation
La dynamique du replicateur montre que TitForTat peut dominer même depuis une faible proportion initiale. Mais quel est le seuil minimal en dessous duquel la cooperation ne peut plus emerger ? Ce seuil depend de la composition de la population (proportion de cooperateurs, defecteurs, et retaliateurs).
Objectif : Implementer find_cooperation_threshold qui recherche systematiquement la proportion minimale de TitForTat necessaire pour que la cooperation envahisse une population majoritairement defectrice.
def find_cooperation_threshold(defector_prop: float=0.7, cooperators: list=None, precision: float=0.01) ->float:""" Trouve la proportion minimale initiale de TitForTat pour que la cooperation emerge dans une population. Args: defector_prop: Proportion de defecteurs dans la population cooperators: Liste des strategies cooperatrices en competion avec TFT precision: Precision de la recherche binaire Returns: Proportion minimale de TFT pour que TFT atteigne > 50% a l'equilibre, ou -1.0 si la cooperation ne peut pas emerger """# TODO etudiant : implementer la recherche du seuil de cooperation# Etape 1 : preparer la liste des strategies [TitForTat] + cooperators (defaut: [AlwaysCooperate, AlwaysDefect])# Etape 2 : boucler sur tft_prop de precision a (1 - defector_prop) par pas de precision# Etape 3 : pour chaque tft_prop, calculer la repartition : [tft_prop, reste, defector_prop]# ou "reste" = 1 - tft_prop - defector_prop reparti parmi les cooperateurs# Etape 4 : simuler replicator_dynamics avec T=500# Etape 5 : si la proportion finale de TFT > 0.5, retourner tft_prop (seuil trouve)# Etape 6 : si aucun seuil trouve, retourner -1.0# Indice : utiliser compute_payoff_matrix puis replicator_dynamicsreturn-1.0# TODO etudiant : remplacer# Test rapide (decommentez apres implementation)# threshold = find_cooperation_threshold(defector_prop=0.7)# print(f"Seuil minimal de TFT pour cooperation: {threshold:.2f}")print("Exercice a completer")
Exercice a completer
Lire la sortie d’un exercice non rempli. Meme ligne unique — « Exercice a completer » — et le squelette find_cooperation_threshold(defector_prop=0.7, precision=0.01) attend sa solution. Le contrat : balayer la proportion initiale de TitForTat, par pas d’au plus 0,01, dans une population a 70% de defecteurs ; simuler pour chaque valeur la dynamique du replicateur ; retourner la plus petite proportion d’ou la cooperation emerge. La sortie remplie sera un seul nombre — un seuil, pas une trajectoire. Sa valeur dira si le point de bascule est brutal ou progressif : un seuil haut signifiera que la cooperation exige un noyau initial massif pour survivre au champ defecteur. L’exercice prolonge la question de la cellule precedente en sens inverse : la simulation montrait un champ gentil eliminer AlwaysDefect ; ici on demande d’ou part la limite basse de ce renversement.
6. Conditions pour la cooperation
Quand la cooperation peut-elle emerger et persister ?
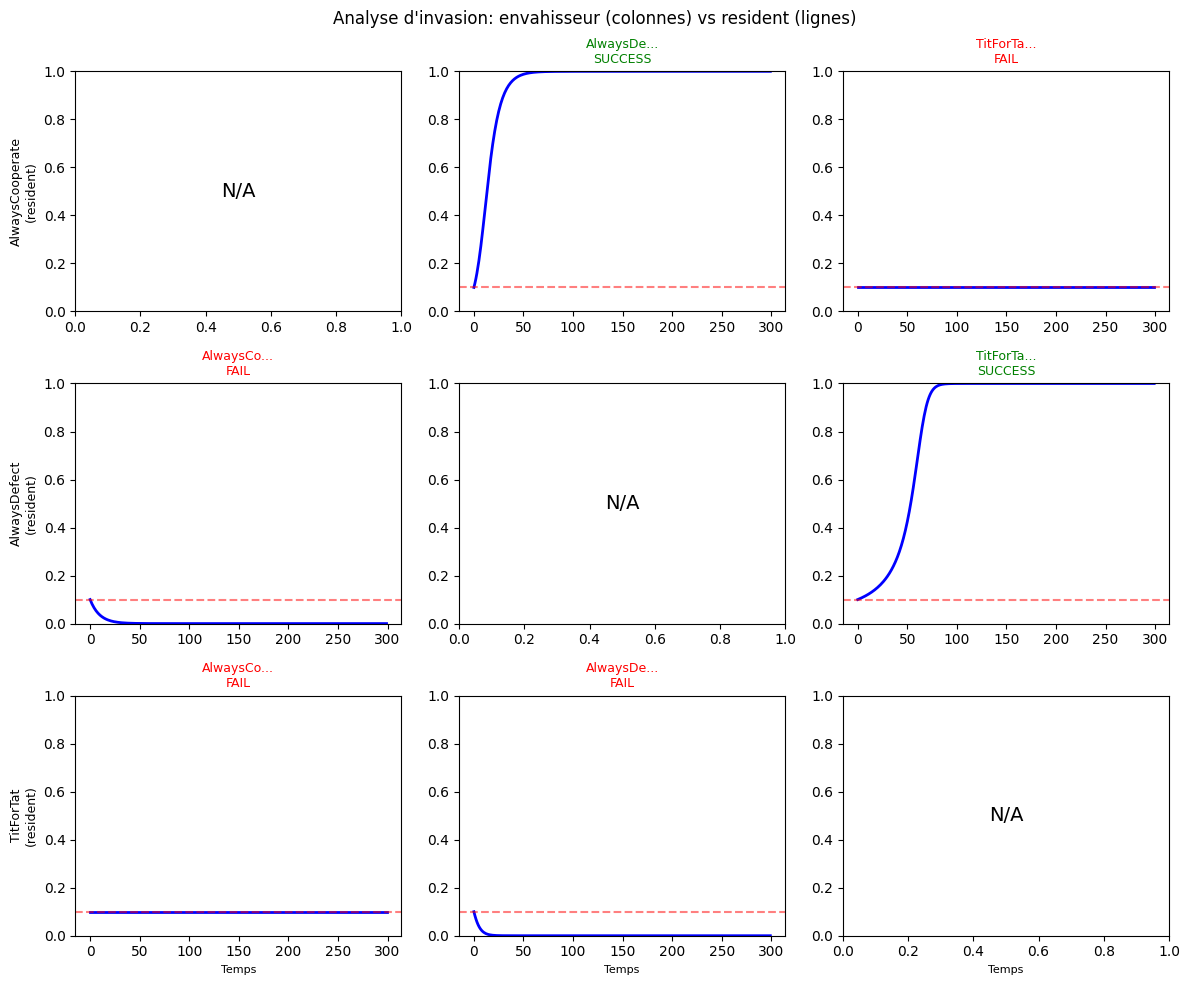
def analyze_invasion(resident: Strategy, invader: Strategy, invasion_rate: float=0.1, T: int=500) -> Tuple[np.ndarray, bool]:""" Analyse si un envahisseur peut envahir une population residente. Args: resident: Strategie residente invader: Strategie envahissante invasion_rate: Proportion initiale d'envahisseurs Returns: (trajectory, invasion_successful) """ M = compute_payoff_matrix([resident, invader], rounds=200) x0 = np.array([1- invasion_rate, invasion_rate]) trajectory = replicator_dynamics(M, x0, T=T, dt=0.1)# Invasion reussie si la proportion d'envahisseurs augmente success = trajectory[-1, 1] > invasion_rate *2return trajectory, successdef plot_invasion_analysis():""" Analyse les possibilites d'invasion entre strategies. """ strategies = [AlwaysCooperate(), AlwaysDefect(), TitForTat()] n =len(strategies) fig, axes = plt.subplots(n, n, figsize=(12, 10))for i, resident inenumerate(strategies):for j, invader inenumerate(strategies): ax = axes[i, j]if i == j: ax.text(0.5, 0.5, 'N/A', ha='center', va='center', fontsize=14) ax.set_xlim(0, 1) ax.set_ylim(0, 1)else: traj, success = analyze_invasion(type(resident)(), type(invader)(), T=300) ax.plot(traj[:, 1], 'b-', linewidth=2) ax.axhline(y=0.1, color='r', linestyle='--', alpha=0.5) ax.set_ylim(0, 1) result ="SUCCESS"if success else"FAIL" color ='green'if success else'red' ax.set_title(f'{invader.name[:8]}...\n{result}', fontsize=9, color=color)if i == n-1: ax.set_xlabel('Temps', fontsize=8)if j ==0: ax.set_ylabel(f'{resident.name}\n(resident)', fontsize=9) fig.suptitle('Analyse d\'invasion: envahisseur (colonnes) vs resident (lignes)', fontsize=12) plt.tight_layout() plt.show()plot_invasion_analysis()
Observations
AlwaysDefect peut envahir AlwaysCooperate facilement
TitForTat resiste a l’invasion par AlwaysDefect
TitForTat peut envahir AlwaysDefect s’il y a suffisamment de TFT
La cooperation peut emerger si les cooperateurs peuvent se reconnaitre et interagir preferentiellement entre eux.
7. Impact du bruit
Comment le bruit (erreurs) affecte-t-il les stratégies ?
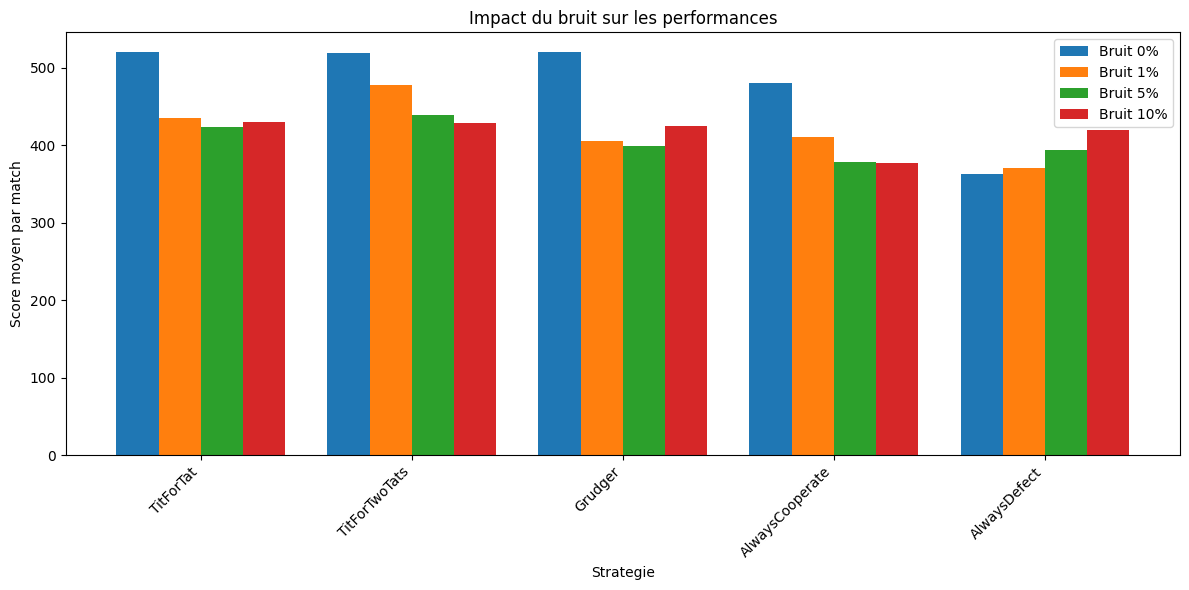
def compare_noise_impact(strategies: List[Strategy], noise_levels: List[float] = [0, 0.01, 0.05, 0.1]):""" Compare les performances des strategies a differents niveaux de bruit. """ results = {}for noise in noise_levels: tournament_results = run_tournament(strategies, rounds=200, noise=noise, repetitions=20) results[noise] = tournament_results# Visualisation fig, ax = plt.subplots(figsize=(12, 6)) x = np.arange(len(strategies)) width =0.2for i, noise inenumerate(noise_levels): scores = [results[noise][s.name] for s in strategies] ax.bar(x + i*width, scores, width, label=f'Bruit {noise*100:.0f}%') ax.set_xlabel('Strategie') ax.set_ylabel('Score moyen par match') ax.set_title('Impact du bruit sur les performances') ax.set_xticks(x + width *1.5) ax.set_xticklabels([s.name for s in strategies], rotation=45, ha='right') ax.legend() plt.tight_layout() plt.show()# Comparer l'impact du bruittest_strategies = [TitForTat(), TitForTwoTats(), Grudger(), AlwaysCooperate(), AlwaysDefect()]compare_noise_impact([type(s)() for s in test_strategies])
Observations sur le bruit
TitForTat souffre du bruit : une erreur peut declencher une spirale de represailles
TitForTwoTats (Copykitten) est plus robuste au bruit car il pardonne une erreur
Grudger est devastateur avec le bruit : une seule erreur = fin de la cooperation
7bis. Comparaison avec la librairie Axelrod (référence SOTA)
Le tournoi implémenté de zéro ci-dessus montre la mécanique d’un tournoi IPD (matrice de gains, matchs round-robin, classement par score cumulé). Pour la recherche réelle, la communauté utilise la librairie axelrod (Knight et al., J. Open Res. Software 2016) : 243 stratégies standardisées, tournois round-robin et écologiques (processus de Moran), bruit paramétrable, reproductibilité bit-à-bit. C’est l’outil canonique pour répliquer les tournois historiques d’Axelrod (1980, 1980b) et tester de nouvelles stratégies à grande échelle.
Nous confrontons ci-dessous nos 6 stratégies pédagogiques aux stratégies équivalentes de la librairie, afin de (a) valider que notre implémentation jouet reproduit les phénomènes qualitatifs et (b) situer notre classement par rapport à la référence SOTA.
# --- Comparaison avec la librairie Axelrod (référence SOTA, 243 stratégies) ---import axelrod as axl# 6 stratégies canoniques de la librairie, correspondant à celles implémentées plus hautaxl_players = [ axl.Cooperator(), # Cooperator axl.Defector(), # Defector / Always Defect axl.TitForTat(), # Tit For Tat (gagnant des tournois historiques d'Axelrod) axl.Grudger(), # Grudger (une trahison -> trahir toujours) axl.WinStayLoseShift(), # Pavlov axl.Random(p=0.5), # Random]print(f"Librairie Axelrod : {len(axl.strategies)} stratégies disponibles (référence SOTA)")# Tournoi round-robin standard Axelrod : turns=200, repetitions=10# Convention Axelrod : le score = années de prison, donc MOINS = mieuxtournament = axl.Tournament(axl_players, turns=200, repetitions=10)results = tournament.play(progress_bar=False)print("--- Classement round-robin (librairie Axelrod, 200 tours x 10 répétitions) ---")print("(convention : moins d'années de prison = mieux)")for rank, name inenumerate(results.ranked_names, start=1):print(f" {rank}. {name}")
Librairie Axelrod : 243 stratégies disponibles (référence SOTA)
--- Classement round-robin (librairie Axelrod, 200 tours x 10 répétitions) ---
(convention : moins d'années de prison = mieux)
  1. Defector
  2. Grudger
  3. Tit For Tat
  4. Win-Stay Lose-Shift
  5. Cooperator
  6. Random: 0.5
Interprétation : notre jouet vs la référence SOTA
Lecture du classement : le tournoi round-robin de la librairie Axelrod (convention : le score = années de prison, donc moins = mieux) place Defector en tête (#1), devant Grudger (#2) et TitForTat (#3). Ce verdict surprend par rapport au récit classique « nice guys finish first », mais il est cohérent avec le dilemme du prisonnier en round-robin statique sur ce petit pool : il contient un Cooperator naïf, donc la défection unilatérale l’exploite et procure à Defector très peu d’années de prison. Le récit s’inverse en dynamique écologique (processus de Moran) : l’exploiteur épuise ses cibles coopératives au fil des générations et décline — c’est pourquoi les stratégies « nice » dominent les tournois historiques d’Axelrod (1980). TitForTat n’arrive ici que 3e en round-robin statique ; sa domination s’exprime dans les formats évolutifs à élimination, déjà illustrés par la section replicator-dynamics ci-dessus.
Ce qu’apporte la librairie : (a) 243 stratégies standardisées vs nos 6 pédagogiques, (b) tournois reproductibles bit-à-bit (graine fixée), (c) gestion du bruit, des tournois à élimination et du processus de Moran, (d) interaction avec axelrod-stratégies (le zoo communautaire). Ce qu’apporte notre implémentation : la compréhension intime de la mécanique — comment se calcule un score de tournoi, comment se propage une population, pourquoi telle stratégie gagne. Les deux sont complémentaires : l’implémentation manuelle enseigne le comment, la librairie permet la recherche à l’échelle.
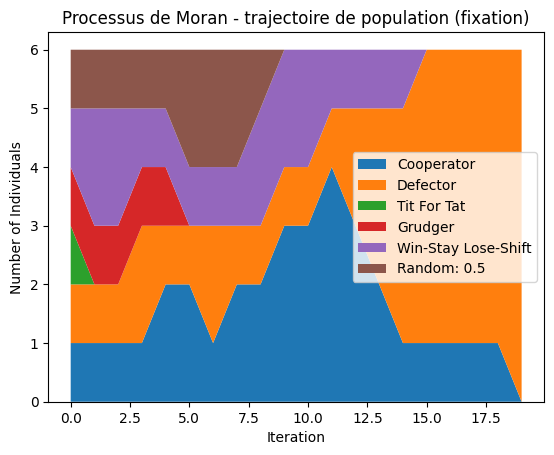
# --- Processus de Moran (dynamique ecologique stochastique, librairie Axelrod) ---# La cellule precedente n'a execute que le tournoi round-robin. Le processus de Moran# (elimination ecologique en population FINIE) est la dynamique nommee en reference SOTA# ci-dessus. Executons-la reellement sur le meme ensemble de 6 strategies.import matplotlib.pyplot as pltfrom collections import Counter# (1) Une seule trajectoire : visualisation de la fixationmp = axl.MoranProcess(axl_players, turns=200, seed=42)mp.play()print(f"Trajectoire unique (graine=42) -> survivant fixe : {mp.winning_strategy_name}")ax = mp.populations_plot()ax.set_title("Processus de Moran - trajectoire de population (fixation)")plt.show()# (2) Distribution sur 25 graines : la fixation est STOCHASTIQUE en population finiewinners = Counter()for seed inrange(25): mp_i = axl.MoranProcess(axl_players, turns=200, seed=seed) mp_i.play() winners[mp_i.winning_strategy_name] +=1print() # ligne vide avant la distributionprint("Distribution des fixations sur 25 runs (graines 0-24) :")total =sum(winners.values())for strat, count in winners.most_common(): pct =100* count / totalprint(f" {strat:25s}: {count:3d}/{total} ({pct:2.0f}%)")
Distribution des fixations sur 25 runs (graines 0-24) :
  Defector                 :   7/25 (28%)
  Grudger                  :   6/25 (24%)
  Win-Stay Lose-Shift      :   4/25 (16%)
  Random: 0.5              :   3/25 (12%)
  Tit For Tat              :   3/25 (12%)
  Cooperator               :   2/25 ( 8%)
Interprétation : le processus de Moran réel vs la dynamique replicator
L’exécution du processus de Moran révèle un tableau plus nuancé que l’affirmation « TitForTat domine surtout dans les formats écologiques ». Sur cet ensemble de 6 stratégies, TitForTat ne se fixe que dans une minorité des trajectoires — souvent derrière Defector et Grudger. Deux raisons structurelles :
Population finie ≠ champ moyen. Le processus de Moran est une dynamique stochastique en population finie : la dérive génétique (drift) peut faire fixer n’importe quelle stratégie, y compris des stratégies sous-optimales en score moyen. La section replicator-dynamics (§5) résolvait au contraire une ODE déterministe en champ moyen (population infinie) — les deux dynamiques donnent des prédictions différentes, et ce n’est pas une contradiction mais deux modèles distincts de la même idée de « sélection écologique ».
Composition du sous-ensemble. La domination historique de TitForTat (Axelrod 1980) s’observe sur le tournoi complet des 63 stratégies soumises, pas sur un sous-ensemble pédagogique de 6 incluant une stratégie Random. Grudger, qui punit définitivement, tire ici parti de la présence de Defector.
Leçon méthodologique : la librairie axelrod permet de tester empiriquement de telles affirmations en exécutant réellement la dynamique nommée — c’est précisément la valeur ajoutée d’un outil SOTA sur une implémentation jouet.
8. Resume
Stratégies et leurs proprietes
Stratégie
Nice
Retaliating
Forgiving
Robuste au bruit
TitForTat
Oui
Oui
Oui
Non
TitForTwoTats
Oui
Oui
Très
Oui
Grudger
Oui
Oui
Non
Non
AlwaysCooperate
Oui
Non
N/A
Non
AlwaysDefect
Non
N/A
N/A
Oui
Pavlov
Oui
Variable
Variable
Moyen
Lecons d’Axelrod
Soyez gentil : Ne trahissez pas en premier
Soyez provoquable : Punissez les trahisons
Soyez indulgent : Pardonnez après punition
Soyez clair : Comportement previsible
Conditions pour la cooperation
Repetition : Le jeu doit etre repete (ombre du futur)
Reconnaissance : Les cooperateurs doivent pouvoir se reconnaitre
Clustering : Les cooperateurs beneficient d’interactions preferentielles
Robustesse : La stratégie doit resister au bruit
9. Exercices supplementaires
Les exercices précédents (GenerousTitForTat en section 9, exploitabilite en section 4, seuil de cooperation en section 5) sont distribues dans le notebook.
Exercice 4 (bonus)
Simulez un tournoi avec 20% de “bruit structurel” (certains joueurs font toujours des erreurs) et comparez les résultats avec le tournoi sans bruit.
Exercice 5 (bonus)
Explorez l’effet de la taille de la population sur l’evolution des stratégies : que se passe-t-il avec seulement 3 stratégies vs 8 ?
# Espace pour les exercices# Exercice 1: Generous TitForTatclass GenerousTitForTat(Strategy):"""TFT avec pardon aleatoire."""def__init__(self, forgiveness: float=0.1):super().__init__(f"GenTFT(p={forgiveness})")self.forgiveness = forgivenessdef choose(self) ->str:# TODO: Implementer la strategie Generous TitForTat# 1. Premier coup: toujours cooperer# 2. Si l'adversaire a defait au coup precedent:# - Pardonner avec probabilite self.forgiveness (cooperer)# - Sinon, riposter (defaire)# 3. Si l'adversaire a coopere: cooperer## Indice: self.opponent_history contient l'historique de l'adversaire# COOPERATE et DEFECT sont les constantes a utiliserpass# Tester votre implementation# ...print("Exercice a completer : strategies evolutives avancees")
Exercice a completer : strategies evolutives avancees
Lire la sortie d’un exercice non rempli. La ligne « Exercice a completer : strategies evolutives avancees » marque l’espace de travail laisse pour GenerousTitForTat et ses proches — l’exercice 1 annonce en debut de notebook. Le terrain est deja prepare : les classes de la section 2 s’heritent (il suffit de redefinir le premier coup ou la reaction a une trahison), la matrice de gains et le moteur de tournoi de la section 4 se reutilisent tels quels. Une solution remplie affichera au minimum le classement rejoue avec la nouvelle venue — et la question interessante sera sa place face aux retaliateurs purs : GenerousTitForTat pardonne aussi les trahisons accidentelles, exactement le regime que la section 7 (bruit) examine plus loin.
Resume et perspectives
Ce notebook a explore l’emergence de la cooperation a travers le Dilemme du Prisonnier Itere et la théorie des jeux evolutionnaire. Nous avons implemente les stratégies classiques du tournoi d’Axelrod – Tit-for-Tat, Grudger, Pavlov, AlwaysCooperate, AlwaysDefect – et reproduit le résultat historique : les stratégies “gentilles, retorsives et pardonnantes” dominent les stratégies agressives dans un tournoi round-robin. La dynamique du replicateur a montre comment Tit-for-Tat peut envahir une population majoritairement defectrice, illustrant le concept de stratégie evolutivement stable (ESS) de Maynard Smith. L’analyse de l’impact du bruit a revele que Tit-for-Two-Tats est plus robuste aux erreurs que Tit-for-Tat, car sa tolerance a deux trahisons consecutives absorbe les accidents de transmission.
Les lecons d’Axelrod – etre gentil, provoquable, indulgent et clair – transcendent la théorie des jeux pour s’appliquer a la conception de systèmes multi-agents, aux mécanismes de reputation en ligne et aux protocoles de cooperation internationale. La condition fondamentale pour la cooperation reste l’“ombre du futur” : la repetition indefinie des interactions rend la punition credible et la cooperation rationnelle.
Le notebook suivant, GameTheory-07-ExtensiveForm-Python, elargit notre analyse aux jeux sous forme extensive, ou les joueurs jouent sequentiellement et ou l’information imparfaite introduit de nouvelles subtilites stratégiques.
Lien avec la formalisation Lean
Le dilemme du prisonnier itere et les tournois d’Axelrod utilisent la matrice de gains du dilemme comme instance de Game2x2, définie dans lean_game_defs/Basic.lean. La dominance de la defection dans le jeu statique se formalise via strictlyDominates1 dans lean_game_defs/Nash.lean. La dynamique des repetitions et les stratégies evolutionnaires (Tit-for-Tat, Pavlov) restent a formaliser.