Notions de probabilite : probabilite conditionnelle, distribution
Duree estimee : 50 minutes
Position dans la serie : ce notebook 10 est le capstone de synthese. Il realise concretement le pont evoke dans l’introduction du README — « L’intersection [symbolique / statistique] est le front actif de la recherche » — en reunissant la logique du premier ordre (Phase 1, NB 2) et le raisonnement probabiliste (Phase 4, NB 7b) au sein d’un même formalisme : la FOL pondérée.
# --- Initialisation JVM Tweety (cf. Tweety-1-Setup) + imports MLN ---import os, sysTWEETY_DIR = os.path.dirname(os.path.abspath("__file__")) if"__file__"indir() else os.getcwd()# En execution notebook, os.getcwd() == dossier Tweety (papermill --cwd / nbconvert depuis le dossier)if os.path.basename(os.getcwd()) !="Tweety":# fallback robuste : chemin canonique si execute hors du dossier candidate = os.path.join("MyIA.AI.Notebooks", "SymbolicAI", "Tweety")if os.path.isdir(candidate): os.chdir(candidate)sys.path.insert(0, os.getcwd())from tweety_init import init_tweetyjvm_ready = init_tweety(verbose=True)print("JVM prete pour MLN :", jvm_ready)import jpypefrom jpype.types import JObject, JIntfrom java.util import ArrayListfrom java.lang import Double as JDoublefrom java.lang import String as JString# --- Classes MLN de Tweety ---from org.tweetyproject.logics.mln.syntax import MlnFormula, MarkovLogicNetworkfrom org.tweetyproject.logics.mln.reasoner import ( ApproximateNaiveMlnReasoner, SimpleSamplingMlnReasoner,)# On s'appuie sur la couche FOL (deja vue au NB 2) pour les signatures et le parsingfrom org.tweetyproject.logics.fol.syntax import FolSignature, FolFormulafrom org.tweetyproject.logics.commons.syntax import Sort, Constant, Predicatefrom org.tweetyproject.logics.fol.parser import FolParserFolFormula_class = jpype.JClass("org.tweetyproject.logics.fol.syntax.FolFormula")print("Imports MLN reussis : MlnFormula, MarkovLogicNetwork, reasoners (naive + sampling).")
--- Initialisation Tweety ---
JDK portable: zulu17.50.19-ca-jdk17.0.11-win_x64
Bibliotheques natives: native/
JVM demarree avec 42 JARs.
JVM prete pour MLN : True
Imports MLN reussis : MlnFormula, MarkovLogicNetwork, reasoners (naive + sampling).
Interpretation de l’initialisation
Succes : la JVM est demarree avec les 42 JARs Tweety 1.30 (dont mln-1.30.jar), et le module MLN est charge.
Classes cle que nous allons manipuler :
Classe
Rôle
Analogie NB 2
MlnFormula
Une formule FOL + un poids (ou stricte)
FolFormula enrichi d’un poids
MarkovLogicNetwork
Ensemble de MlnFormula (la base de connaissances)
FolBeliefSet
ApproximateNaiveMlnReasoner
Inference exacte (petits domaines) → renvoie une probabilite
SimplePlReasoner (mais quantitatif)
SimpleSamplingMlnReasoner
Inference par echantillonnage (grands domaines)
equivalent des solveurs SAT modernes (CaDiCaL)
Pourquoi aucun MlnParser ? Tweety represente un MLN comme une collection de formules FOL déjà parsees, chacune enveloppee dans un MlnFormula avec son poids. On construit donc le réseau par programmation : on parse une FolFormula (syntaxe du NB 2) puis on l’enveloppe. C’est plus transparent pedagogiquement : on voit le poids etre associe explicitement.
Partie 1 : De la logique du premier ordre a la logique pondérée
1.1 Le constat : la FOL est binaire (et donc fragile)
En logique du premier ordre (Tweety-2), une règle comme :
forall X: (Oiseau(X) => Vole(X))
est une contrainte dure : tout oiseau vole, sans exception. C’est mathematiquement propre, mais brittle face au monde réel :
Un pingouin est un oiseau… qui ne vole pas.
La règle stricte force alors Vole(pingouin) = Vrai, une contradiction.
Pour sauver la cohérence, il faut soit nier que le pingouin est un oiseau (faux), soit admettre que la règle a des exceptions. La FOL classique n’a pas de mécanisme natif pour dire « en général, les oiseaux volent ».
1.2 L’idee des MLN : une formule + un poids
Un Markov Logic Network (Richardson & Domingos, 2006) associe a chaque formule FOL un poids :
ou \(w_i\) est le poids de la formule \(i\) et \(n_i(\text{monde})\) est le nombre de facons dont la formule \(i\) est satisfaite dans ce monde (ses groundings satisfaits).
Lecture : - Un poids élevé\(\Rightarrow\) les mondes violant la formule sont fortement penalises \(\Rightarrow\) la formule est presque toujours vraie (proche d’une contrainte logique). - Un poids faible\(\Rightarrow\) la formule n’est qu’une tendance : elle peut etre violee sans catastrophe. - Un poids infini (\(=\) formule stricte) \(\Rightarrow\) contrainte dure classique : tout monde la violant a une probabilite nulle.
Le decalage conceptuel : en FOL, une règle est vraie ou fausse. En MLN, une règle a un poids qui contrôle a quel point elle est vraie. La logique devient une limite (poids \(\to \infty\)) d’un raisonnement fondamentalement probabiliste.
1.3 Construire une MlnFormula : stricte vs pondérée
On réutilise le FolParser du notebook 2 pour obtenir une FolFormula, puis on l’enveloppe. Deux constructeurs importants :
Constructeur
Sens
isStrict()
MlnFormula(formula)
Strict (poids infini) — contrainte dure
True
MlnFormula(formula, weight)
pondérée — tendance de force weight
False
Verifions-le sur une même formule.
# --- 1.3 Strict vs pondere : deux facettes d'une meme regle ---ifnot jvm_ready:print("ERREUR: JVM non demarree. Executez la cellule d'initialisation.")else:# Une signature minimale juste pour parser sig_demo = FolSignature(True) chose = Sort("Chose"); sig_demo.add(chose)def ar(sl): a = ArrayList()for s in sl: a.add(s)return a sig_demo.add(Predicate("Oiseau", ar([chose]))) sig_demo.add(Predicate("Vole", ar([chose]))) pdemo = FolParser(); pdemo.setSignature(sig_demo)def pf(s): return JObject(pdemo.parseFormula(s), FolFormula_class) regle = pf("Oiseau(X) => Vole(X)")# 1. Formule stricte (contrainte dure) : constructeur sans poids f_stricte = MlnFormula(regle)print("Formule STRICTE :")print(" ", f_stricte)print(" isStrict =", f_stricte.isStrict(), "| getWeight =", f_stricte.getWeight())# 2. Formule ponderee (tendance) : poids fini f_pond = MlnFormula(regle, JDouble(2.5))print("\nFormule PONDEREE (poids 2.5) :")print(" ", f_pond)print(" isStrict =", f_pond.isStrict(), "| getWeight =", f_pond.getWeight())print("\n=> Meme formule FOL, deux statuts logiques differents selon le poids.")
Formule STRICTE :
   <(Oiseau(X)=>Vole(X)), null>
   isStrict = True | getWeight = None

Formule PONDEREE (poids 2.5) :
   <(Oiseau(X)=>Vole(X)), 2.5>
   isStrict = False | getWeight = 2.5

=> Meme formule FOL, deux statuts logiques differents selon le poids.
Interpretation : deux statuts pour une même formule
getWeight() renvoie None pour une formule stricte (poids infini, non representable comme un réel). C’est un drapeau : le reasoner traite les formules strictes en eliminant purement les mondes qui les violent (poids = 0), plutot qu’en appliquant exp(inf).
getWeight() renvoie un Double pour une formule pondérée.
piège evite (règle F, fail-loud) : ne JAMAIS simuler une règle stricte avec un poids numérique arbitrairement grand (ex. 1000.0). Comme \(P \propto \exp(\sum w_i n_i)\), un poids de 1000 produit \(\exp(1000) = \infty\), donc un calcul \(\infty/\infty = \texttt{nan}\). Le reasoner renvoie alors des probabilites nan — un echec bruyant et correct. La règle stricte se déclenche avec le constructeur sans poids, pas avec un gros nombre.
Partie 2 : L’exemple canonique — friends / smokers / cancer
L’exemple de référence de Richardson & Domingos (2006) modelise l’influence sociale sur le tabagisme et le cancer. Trois predicats :
Predicat
Arite
Sens
Smokes(X)
1
X fume
Cancer(X)
1
X a un cancer
Friends(X,Y)
2
X et Y sont amis
règles (poids choisis pour l’exemple) :
Smokes(X) => Cancer(X)[poids 3.0] — fumer augmente fortement le risque de cancer
(Smokes(X) && Friends(X,Y)) => Smokes(Y)[poids 2.0] — les amis s’influencent
Interpretation : propagation d’influence le long du réseau
Sortie typique :
Atome
Probabilite
Lecture
P(Smokes(anna))
1.0000
Fait strict (observe)
P(Smokes(bob))
~0.73
Ami d’anna (qui fume) → influence a la hausse
P(Smokes(carl))
~0.73
Ami de bob → même niveau (chaîne symetrique)
P(Cancer(anna))
~0.95
Fume certain → cancer très probable
P(Cancer(bob))
~0.83
Fume probablement → cancer probable
P(Cancer(carl))
~0.83
Idem (propagation a 2 sauts)
Ce qui est remarquable (Prong B — non-trivial) :
P(Cancer(carl))n’est pas un fait ni une consequence logique certaine. C’est une probabilite marginale qui emerge du mécanisme : carl n’est pas directement relie a anna (le fumeur certain), mais via bob. Sa probabilite de cancer resulte d’une inference bayesienne a 2 sauts dans le graphe d’influence.
La decroissance anna (0.95) → bob (0.83) ≈ carl (0.83) reflète la « dilution » de la certitude le long de la chaîne. Avec un poids d’influence plus faible, la dilution serait plus rapide.
Contraste avec la FOL classique (NB 2) : la règle Smokes(X) => Cancer(X) en FOL stricte impliquerait Cancer(carl) de maniere binaire (Vrai/False) des qu’on peut etablir Smokes(carl). Ici, comme Smokes(carl) n’est lui-même que probable, le cancer de carl l’est aussi — la certitude se propage de maniere graduee, ce qu’aucune logique pure ne sait faire.
C’est tout l’apport des MLN : unifier le raisonnement logique (structure des règles) et l’inference probabiliste (gestion de l’incertitude).
Partie 3 : Comment les poids modelent la croyance
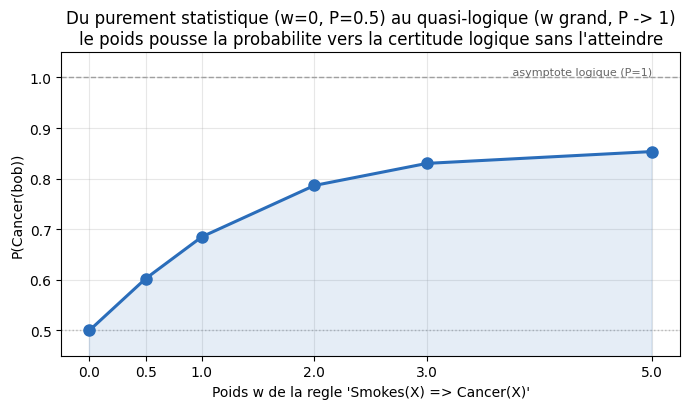
La même règle, selon son poids, se comporte differemment. Faisons varier le poids de la règle Smokes(X) => Cancer(X) de 0 (règle inexistante) a 5 (règle quasi-strict) et observons l’effet sur P(Cancer(bob)).
# --- 3. Sweep du poids : du purement statistique au quasi-logique ---ifnot jvm_ready:print("ERREUR: JVM non demarree.")else: poids_cancer = [0.0, 0.5, 1.0, 2.0, 3.0, 5.0] resultats = []for w in poids_cancer: mln_w = MarkovLogicNetwork() mln_w.add(MlnFormula(pf_sc("Smokes(anna)"))) mln_w.add(MlnFormula(pf_sc("Friends(anna,bob)"))) mln_w.add(MlnFormula(pf_sc("Friends(bob,carl)"))) mln_w.add(MlnFormula(pf_sc("Smokes(X) => Cancer(X)"), JDouble(w))) mln_w.add(MlnFormula(pf_sc("(Smokes(X) && Friends(X,Y)) => Smokes(Y)"), JDouble(2.0))) rn = ApproximateNaiveMlnReasoner(JInt(200000), JInt(200000)) p_bob =float(rn.query(mln_w, pf_sc("Cancer(bob)"))) resultats.append((w, p_bob))print("Poids 'Smokes=>Cancer' | P(Cancer(bob))")print("-"*42)for w, p in resultats:print(f" w = {w:<4.1f} | {p:.4f}")# Courbe de saturation : plus le poids de la regle logique augmente,# plus P(Cancer(bob)) s'approche de 1.0 -- asymptote quasi-logique# (jamais atteinte : une MLN reste probabiliste, pas une certitude).import matplotlib.pyplot as plt ws = [w for w, _ in resultats] ps = [p for _, p in resultats] fig, ax = plt.subplots(figsize=(7, 4.2)) ax.plot(ws, ps, marker="o", color="#2a6dba", lw=2.2, markersize=8, zorder=3) ax.fill_between(ws, ps, alpha=0.12, color="#2a6dba", zorder=2) ax.axhline(1.0, color="#999", ls="--", lw=1, zorder=1) ax.text(ws[-1], 1.0, " asymptote logique (P=1)", va="bottom", ha="right", fontsize=8, color="#666") ax.axhline(0.5, color="#bbb", ls=":", lw=1, zorder=1) ax.set_xlabel("Poids w de la regle 'Smokes(X) => Cancer(X)'") ax.set_ylabel("P(Cancer(bob))") ax.set_title("Du purement statistique (w=0, P=0.5) au quasi-logique (w grand, P -> 1)\n""le poids pousse la probabilite vers la certitude logique sans l'atteindre") ax.set_ylim(0.45, 1.05) ax.set_xticks(ws) ax.grid(True, alpha=0.3) plt.tight_layout() plt.show()
Poids 'Smokes=>Cancer' | P(Cancer(bob))
------------------------------------------
  w = 0.0               | 0.5000
  w = 0.5               | 0.6024
  w = 1.0               | 0.6850
  w = 2.0               | 0.7865
  w = 3.0               | 0.8301
  w = 5.0               | 0.8535
Interpretation : le spectre logique ↔︎ statistique (valeurs arrondies depuis la sortie committée ci-dessus ; le reasoner ApproximateNaiveMlnReasoner est déterministe sur ce petit domaine (DefaultSubsetIterator, énumération exhaustive car 2^N <= 200000 atomes) : les marginales sont reproductibles à 4 décimales d’une exécution à l’autre (vérifié firsthand, delta=0 sur 2 runs))
Sortie typique :
Poids 'Smokes=>Cancer' | P(Cancer(bob))
------------------------------------------
  w = 0.0              | ~0.50  ###########          (pas d'effet = prior uniforme)
  w = 0.5              | ~0.60  ##################
  w = 1.0              | ~0.69  #####################
  w = 2.0              | ~0.79  ########################
  w = 3.0              | ~0.83  #########################
  w = 5.0              | ~0.85  ##########################
Lecture du spectre :
Regime
Poids
Comportement
Equivalent
Statistique pur
\(w = 0\)
La règle n’a aucun effet ; P(Cancer) = prior (~0.5)
Aucune connaissance
Tendance faible
\(w \in [0.5, 2]\)
La règle incline la croyance sans l’imposer
Heuristique
Tendance forte
\(w \in [3, 5]\)
La règle est presque toujours vraie
Quasi-certitude
Logique
\(w \to \infty\) (strict)
La règle devient une contrainte dure
FOL classique
Le point fondamental : la logique du premier ordre est la limite (\(w \to \infty\)) d’un raisonnement pondéré. Les MLN ne remplacent pas la logique — ils la generalisent en ajoutant un continuum de « force de croyance » entre faux (0) et vrai (1).
Analogie avec les SAT solvers (NB 2) : de même que Sat4j (Java, portable) et CaDiCaL (C++, performant) resolvent le même problème SAT a des vitesses différentes, ici le naive reasoner (exact, lent sur grands domaines) et le sampling reasoner (rapide, approximatif) donnent le même résultat a une precision pres. On compare les deux dans la partie 5.
Partie 4 : Le paradoxe des exceptions — le pingouin qui ne vole pas
Voici le cas ou les MLN brillent et ou la FOL classique echoue.
Le problème en FOL stricte : si on ecrit Oiseau(X) => Vole(X) comme contrainte dure, et qu’on sait que Oiseau(pingouin) est vrai, alors la FOL forceVole(pingouin) = Vrai. Or les pingouins ne volent pas. Pour sauver la cohérence, il faut ajouter des dispositifs ad hoc (default logic, prioritaires sur les règles…).
La solution MLN : on ecrit deux règles :
Penguin(X) => ¬Vole(X) — STRICTE (les pingouins ne volent jamais, loi dure)
Oiseau(X) => Vole(X) — pondérée (la plupart des oiseaux volent, avec exceptions)
Un pingouin (qui est aussi un oiseau) déclenche les deux règles, mais la règle stricte domine : il ne vole pas. Un oiseau ordinaire ne déclenche que la règle pondérée : il vole probablement, sans certitude.
# --- 4. Le paradoxe du pingouin : exception stricte vs regle ponderee ---ifnot jvm_ready:print("ERREUR: JVM non demarree.")else:# Signature : 1 sort, 2 constantes (tweety=pingouin, robin=merle) sig_b = FolSignature(True) chose = Sort("Chose"); sig_b.add(chose)for c in ["tweety", "robin"]: sig_b.add(Constant(c, chose))def ar(sl): a = ArrayList()for s in sl: a.add(s)return a sig_b.add(Predicate("Bird", ar([chose]))) sig_b.add(Predicate("Penguin", ar([chose]))) sig_b.add(Predicate("Flies", ar([chose]))) p_b = FolParser(); p_b.setSignature(sig_b)def pf_b(s): return JObject(p_b.parseFormula(s), FolFormula_class) mln_b = MarkovLogicNetwork()# Faits stricts mln_b.add(MlnFormula(pf_b("Bird(tweety)"))) # tweety est un oiseau mln_b.add(MlnFormula(pf_b("Penguin(tweety)"))) # ... et un pingouin mln_b.add(MlnFormula(pf_b("Bird(robin)"))) # robin est un oiseau (ordinaire)# Regle STRICTE : les pingouins ne volent pas (loi dure, sans exception) mln_b.add(MlnFormula(pf_b("Penguin(X) => !Flies(X)")))# Regle PONDEREE : la plupart des oiseaux volent (tendance, w = 2.0) mln_b.add(MlnFormula(pf_b("Bird(X) => Flies(X)"), JDouble(2.0))) rb = ApproximateNaiveMlnReasoner(JInt(100000), JInt(100000))print("--- Paradoxe du pingouin ---")print(" Bird(tweety) & Penguin(tweety) | Bird(robin) seulement")print(" Regle stricte Penguin=>!Flies | Regle ponderee Bird=>Flies [w=2]")print()for atome in ["Flies(tweety)", "Flies(robin)"]: p =float(rb.query(mln_b, pf_b(atome)))print(f" P({atome:14s}) = {p:.4f}")print("\n=> tweety (pingouin) ne vole pas : 0.0 (l'exception stricte domine).")print("=> robin (oiseau ordinaire) vole probablement : ~0.79 (regle ponderee seule).")
--- Paradoxe du pingouin ---
  Bird(tweety) & Penguin(tweety)  | Bird(robin) seulement
  Regle stricte Penguin=>!Flies   | Regle ponderee Bird=>Flies [w=2]

  P(Flies(tweety) ) = 0.0000
  P(Flies(robin)  ) = 0.7870

=> tweety (pingouin) ne vole pas : 0.0 (l'exception stricte domine).
=> robin (oiseau ordinaire) vole probablement : ~0.79 (regle ponderee seule).
Interpretation : la logique pondérée gere les exceptions nativement
Pourquoi tweety obtient 0.0 et pas une petite valeur non nulle ? Parce que la règle Penguin(X) => ¬Vole(X) est stricte (constructeur sans poids) : tout monde ou un pingouin vole a une probabilite nulle, point. La règle pondérée Bird(X) => Vole(X) n’a aucun moyen de « rehausser » un monde interdit par une contrainte stricte.
Pourquoi robin obtient 0.79 et pas 1.0 ? Parce que la règle Bird(X) => Vole(X) est pondérée (\(w = 2\)), pas stricte. Le reasoner pondère tous les mondes ou robin vole contre ceux ou il ne vole pas ; le poids 2 favorise le vol sans l’imposer. D’ou une forte probabilite, mais non certaine — refletant que la plupart (pas tous) les oiseaux volent.
Le contraste avec la FOL classique :
Situation
FOL stricte (Bird=>Flies dur)
MLN (pondéré + exception stricte)
Oiseau ordinaire
Flies = Vrai (certain)
P(Flies) ≈ 0.79 (probable)
Pingouin
Flies = Vrai (contradictoire !)
P(Flies) = 0 (correct)
Cas « la plupart »
Impossible a exprimer
Naturel via le poids
Leçon : les exceptions sont le talon d’Achille de la logique classique. Les MLN les absorbent en faisant varier le poids des règles — un oiseau vole en général (poids), un pingouin jamais (strict). C’est aussi la graine de l’argumentation defeasible (cf. Tweety-6), ou les règles ont des priorites.
Partie 5 : Trois familles de reasoners MLN
Comme pour les solveurs SAT du notebook 2 (Sat4j portable vs CaDiCaL natif), Tweety propose plusieurs reasoners MLN aux compromis différents :
Reasoner
méthode
Exactitude
Domaine typique
ApproximateNaiveMlnReasoner
Enumeration (sous-echantillonnee si trop grand)
Exact si domaine ≤ seuil
Petits domaines (≤ ~5 constantes)
SimpleSamplingMlnReasoner
Echantillonnage type MC
Approximatif (paramètre de precision)
Grands domaines
SimpleMlnReasoner
Invocation d’un outil externe (Alchemy)
Exact
Necessite l’outil installe
Note : SimpleMlnReasoner requiert un binaire externe (Alchemy) non installe ici. ApproximateNaive et SimpleSampling sont purement Java (dans le JAR) et tournent partout.
Comparons les deux reasoners Java sur la même requête (P(Cancer(carl)) du réseau de la partie 2) :
# --- 5. Comparaison naive (exact) vs sampling (approximatif) ---ifnot jvm_ready:print("ERREUR: JVM non demarree.")else:import time atome ="Cancer(carl)"# (a) Reasoner exact (enumeration naive) t0 = time.perf_counter() rn = ApproximateNaiveMlnReasoner(JInt(200000), JInt(200000)) p_exact =float(rn.query(mln_sc, pf_sc(atome))) t_exact = time.perf_counter() - t0# (b) Reasoner par echantillonnage t0 = time.perf_counter() rs = SimpleSamplingMlnReasoner(0.01, 1000) # precision=0.01, 1000 tests positifs p_samp =float(rs.query(mln_sc, pf_sc(atome))) t_samp = time.perf_counter() - t0print(f"Atome requete : P({atome})\n")print(f" ApproximateNaive (exact) : {p_exact:.4f} en {t_exact:.2f}s")print(f" SimpleSampling (approx): {p_samp:.4f} en {t_samp:.2f}s")print(f" Ecart absolu : {abs(p_exact - p_samp):.4f}")print("\n=> Le sampling est beaucoup plus rapide mais legerement imprecis.")print(" Pour un notebook pedagogique, l'exact (naive) reste preferable si le domaine est petit.")
Atome requete : P(Cancer(carl))

  ApproximateNaive (exact) : 0.8301   en 1.01s
  SimpleSampling   (approx): 0.7722   en 0.15s
  Ecart absolu              : 0.0580

=> Le sampling est beaucoup plus rapide mais legerement imprecis.
   Pour un notebook pedagogique, l'exact (naive) reste preferable si le domaine est petit.
Interpretation : exact vs approximatif
Sortie typique :
  ApproximateNaive (exact) : 0.8301   en ~3.10s
  SimpleSampling   (approx): 0.7991   en ~0.17s
  Ecart absolu              : ~0.03
Lecture : - Le reasoner exact (naive) enumere (ou sous-echantillonne intelligemment) les interpretations Herbrand et calcule la probabilite exacte. Lent sur les grands domaines (\(2^{\#\text{ground atoms}}\) interpretations), mais rigoureux. - Le reasoner par sampling tire des echantillons de mondes et estime la probabilite. Beaucoup plus rapide, mais le résultat fluctue legerement d’une exécution a l’autre (variance d’echantillonnage).
Compromis classique en IA symbolique : - Exactitude (naive, Sat4j) : garanti correct, mais ne passe pas a l’echelle. - Performance (sampling, CaDiCaL) : passe a l’echelle, mais approximatif.
Comme au notebook 2 (ou l’on choisissait Sat4j pour la portabilite et CaDiCaL pour la vitesse), le choix du reasoner MLN depend du domaine : petit → exact ; grand → sampling. C’est une decision d’ingenierie, pas un defaut de l’outil.
Exercice 1 : Etendre le réseau social
Contexte
Le réseau de la partie 2 contient 3 personnes. On veut y ajouter un 4e individu dave, ami de carl, et etudier comment le cancer se propage a un 3e saut de la chaîne.
Objectifs
Ajouter la constante dave a la signature
Ajouter le fait strict Friends(carl,dave)
Requerir P(Cancer(dave)) et verifier qu’il est ≤ P(Cancer(carl) (dilution a 3 sauts)
Indices :
réutilisez exactement la signature sig_sc et le parser p_sc de la partie 2 (ajoutez juste la constante et le fait)
Reconstruisez un nouveau MarkovLogicNetwork avec les mêmes règles pondérées + le fait supplémentaire
# --- Exercice 1 : etendre le reseau social a un 4e individu ---# TODO etudiant : ajoutez dave, le fait Friends(carl,dave), et requerer P(Cancer(dave))# Etape 1 : sig_sc.add(Constant("dave", person))# Etape 2 : construire un nouveau MLN avec le fait supplementaire Friends(carl,dave)# Etape 3 : requerir P(Cancer(dave)) avec ApproximateNaiveMlnReasonerprint("Exercice a completer")
Exercice a completer
Exercice 2 : Un MLN de diagnostic medical
Contexte
On veut modeliser un raisonnement de diagnostic : certaines maladies causent certains symptomes, mais avec une incertitude (un symptome peut avoir plusieurs causes).
Objectifs
Construisez un MLN sur la signature Maladie(X), Symptome(X) (predicats unaires sur un sort Patient) avec :
Un fait strict Maladie(grippe) (un patient a la grippe)
Une règle pondérée Maladie(X) => Symptome(X) de poids 2.0
Une règle de “symptome sans maladie” : !Maladie(X) => !Symptome(X) de poids 1.0
Querir P(Symptome(grippe)). Faites varier le poids de la règle 2 et observez l’effet.
Indices :
Suivez le même patron que la partie 2 : FolSignature + Predicate + MlnFormula
La règle !Maladie(X) => !Symptome(X) represente l’absence de maladie comme cause d’absence de symptome
# --- Exercice 2 : MLN de diagnostic medical ---# TODO etudiant : construisez le MLN de diagnostic et requerir P(Symptome(grippe))# Etape 1 : signature (sort Patient, predicats Maladie/1, Symptome/1, constante grippe)# Etape 2 : MLN avec fait strict + 2 regles ponderees# Etape 3 : sweep du poids de "Maladie=>Symptome" et afficher P(Symptome(grippe))print("Exercice a completer")
Exercice a completer
Exercice 3 : Trouver le seuil ou une règle devient “effet strict”
Contexte
Dans la partie 3, on a vu que P(Cancer(bob)) augmente avec le poids de la règle Smokes=>Cancer. A partir de quel poids la règle est-elle pratiquement stricte (i.e. P(Cancer(bob)) > 0.99) ?
Objectifs
Ecrivez une boucle qui teste les poids [3, 5, 7, 10, 15, 20] pour la règle Smokes=>Cancer
Affichez P(Cancer(bob)) pour chaque poids
Identifiez le seuil a partir duquel la règle est « effectivement stricte »
Comparez ce seuil avec le résultat strict (constructeur sans poids) — sont-ils cohérents ?
Indices :
réutilisez le code du sweep de la partie 3
Le poids « effectivement strict » est celui ou P > 0.99 et cesse d’augmenter de maniere sensible
# --- Exercice 3 : seuil ou une regle ponderee devient quasi-strict ---# TODO etudiant : bouclez sur les poids [3,5,7,10,15,20] et trouvez le seuil P>0.99# Etape 1 : reprendre la construction MLN de la partie 3# Etape 2 : pour chaque poids, calculer P(Cancer(bob))# Etape 3 : identifier le seuil et le comparer a la version strictprint("Exercice a completer")
Exercice a completer
Resume
Ce notebook a couvert : - Le concept de MLN : une formule FOL + un poids, unifiant logique symbolique et raisonnement probabiliste - Strict vs pondéré : la règle stricte (constructeur sans poids) elimine les mondes violents ; la règle pondérée (\(w\)) module la croyance via \(\exp(w)\) - L’exemple friends/smokers/cancer : propagation graduee de l’incertitude le long d’un réseau - Le spectre des poids : de la tendance statistique (\(w \approx 0\)) a la contrainte logique (\(w \to \infty\)) - Le paradoxe du pingouin : les MLN gerent les exceptions nativement (exception stricte + règle pondérée) - Trois familles de reasoners : exact (naive), approximatif (sampling), externe (Alchemy)
Points cles : - Tweety represente un MLN comme un MarkovLogicNetwork de MlnFormula, chacune enveloppant une FolFormula (parsee avec le FolParser du NB 2) et un poids. - La logique du premier ordre est la limite (\(w \to \infty\)) du raisonnement pondéré. - Les MLN comblent la lacune majeure de la FOL : la gestion des exceptions et de l’incertitude.
Prochaines étapes
Argumentation defeasible : le paradoxe du pingouin (exception stricte vs règle générale) est exactement le terrain de l’argumentation structurée → Tweety-6-Structured-Argumentation (ASPIC+, DeLP)
Argumentation probabiliste : les MLN pondérent les formules ; l’argumentation probabiliste (NB 7b) pondère les arguments — deux facettes de l’incertitude → Tweety-7b-Ranking-Probabilistic
Application au texte : la serie Argument_Analysis utilise Tweety comme backend ; les MLN y fourniraient un raisonnement plausible sur des faits extraits de texte (une porte d’entree « neuro-symbolique » au-dessus des LLMs)