# Dependances pre-provisionnees (rdflib owlready2 kglab networkx matplotlib pyvis pandas) : voir SemanticWeb/requirements.txt ; imports dans les cellules suivantes.SW-11-Python-KnowledgeGraphs
Navigation : << 10-RDFStar | Index | 12-GraphRAG >>
Graphes de Connaissances : Construction et Exploration
Duree estimee : 55 minutes
Objectifs d’apprentissage
A la fin de ce notebook, vous saurez : 1. Définir ce qu’est un Knowledge Graph et le situer dans l’ecosysteme des données structurees 2. Construire un KG a partir de données tabulaires (CSV) avec rdflib 3. Utiliser kglab comme couche d’abstraction pour manipuler des Knowledge Graphs 4. Visualiser un KG avec NetworkX (matplotlib) et pyvis (interactif HTML) 5. Manipuler des ontologies OWL avec OWLReady2 et lancer le raisonneur HermiT 6. Evaluer la qualite d’un Knowledge Graph (completude, coherence)
Concepts cles
| Concept | Description |
|---|---|
| Knowledge Graph | Graphe de connaissances reliant entites et relations sémantiques |
| kglab | Bibliotheque Python d’abstraction pour les KG (au-dessus de rdflib) |
| OWLReady2 | Bibliotheque Python pour manipuler des ontologies OWL et lancer des raisonneurs |
| NetworkX | Bibliotheque Python de théorie des graphes, utilisee pour la visualisation |
| pyvis | Visualisation interactive de graphes en HTML/JavaScript |
Prerequis
- SW-8 (SHACL) et SW-9 (Linked Data) pour les fondations RDF/SPARQL
- Python 3.10+ avec les dependances du fichier
requirements.txt
0. Installation des dependances
Installons les bibliotheques necessaires pour ce notebook. Si elles sont déjà presentes dans votre environnement, cette étape sera rapide.
Verifions que les imports fonctionnent correctement.
import rdflib
import pandas as pd
import networkx as nx
import matplotlib
import matplotlib.pyplot as plt

print(f"rdflib    : {rdflib.__version__}")
print(f"pandas    : {pd.__version__}")
print(f"networkx  : {nx.__version__}")
print(f"matplotlib: {matplotlib.__version__}")

# kglab et owlready2 n'exposent pas toujours __version__
try:
    import kglab
    print(f"kglab     : OK")
except ImportError as e:
    print(f"kglab     : NON DISPONIBLE ({e})")

try:
    import owlready2
    print(f"owlready2 : OK")
except ImportError as e:
    print(f"owlready2 : NON DISPONIBLE ({e})")

try:
    from pyvis.network import Network
    print(f"pyvis     : OK")
except ImportError as e:
    print(f"pyvis     : NON DISPONIBLE ({e})")

print("\nEnvironnement pret.")
rdflib : 7.6.0
pandas : 3.0.6
networkx : 3.6.1
matplotlib: 3.11.2
kglab : OK
owlready2 : OK
pyvis : OK
Environnement pret.Interpretation — le role de chaque bibliotheque
| Bibliotheque | Rôle dans ce notebook |
|---|---|
| rdflib | Construction et interrogation du graphe RDF |
| pandas | Chargement des données CSV |
| kglab | Couche d’abstraction Knowledge Graph |
| owlready2 | Manipulation d’ontologies OWL + raisonnement HermiT |
| networkx | Representation et visualisation de graphes |
| matplotlib | Rendu graphique statique |
| pyvis | Visualisation interactive (HTML) |
Note technique : kglab et pyvis sont optionnels. Les sections correspondantes utilisent des blocs
try/exceptpour fonctionner même si ces bibliotheques ne sont pas installees.
1. Qu’est-ce qu’un Knowledge Graph ?
Definition et historique
Un Knowledge Graph (graphe de connaissances) est un graphe oriente etiquete qui represente des entites du monde reel et les relations entre elles, enrichi par une couche sémantique (ontologie, types, contraintes).
Le terme a ete popularise par Google en 2012 avec le lancement du Google Knowledge Graph, mais le concept existait déjà sous d’autres formes :
| Annee | Événement | Impact |
|---|---|---|
| 2001 | Article fondateur de Tim Berners-Lee sur le Web sémantique | Vision initiale |
| 2006 | Lancement de DBpedia (extraction RDF de Wikipedia) | Premier KG ouvert a grande echelle |
| 2012 | Google Knowledge Graph (“Things, not strings”) | Adoption industrielle massive |
| 2012 | Lancement de Wikidata | Base de connaissances collaborative |
| 2017-20 | Adoption par Amazon, LinkedIn, Uber, Airbnb | KG d’entreprise |
| 2023-25 | Integration KG + LLM (GraphRAG, grounding) | Convergence IA symbolique/neuronale |
Maturite industrielle (2024-2025)
Les Knowledge Graphs sont aujourd’hui une technologie mature avec un retour sur investissement documente de 300-320% dans les grandes entreprises (source : Gartner, Forrester). Ils servent de socle pour : - La recherche sémantique (Google, Bing) - Les systèmes de recommandation (Amazon, Netflix) - Le grounding de LLM (reduction des hallucinations via GraphRAG) - La conformite reglementaire (finance, sante)
Comparaison detaillee et panorama des KG industriels : annexe A.
2. Construire un Knowledge Graph a partir de données structurees
Dans cette section, nous allons transformer un fichier CSV de films en un Knowledge Graph RDF. Cette opération est fondamentale : la plupart des KG d’entreprise sont construits a partir de données existantes (CSV, bases relationnelles, APIs).
Approche
- Charger le CSV avec pandas
- Définir un vocabulaire RDF (classes et proprietes)
- Transformer chaque ligne en triplets RDF
- Verifier le graphe resultant
2.1 Chargement des données CSV
Le fichier data/movies.csv contient 12 films avec les colonnes : titre, annee, realisateur, genre, acteur principal, second acteur, note.
import pandas as pd

df = pd.read_csv("data/movies.csv")
print(f"Nombre de films : {len(df)}")
print(f"Colonnes : {list(df.columns)}")
print()
df
Nombre de films : 12
Colonnes : ['title', 'year', 'director', 'genre', 'actor1', 'actor2', 'rating']
| title | year | director | genre | actor1 | actor2 | rating | |
|---|---|---|---|---|---|---|---|
| 0 | Inception | 2010 | Christopher Nolan | Science-Fiction | Leonardo DiCaprio | Tom Hardy | 8.8 |
| 1 | The Dark Knight | 2008 | Christopher Nolan | Action | Christian Bale | Heath Ledger | 9.0 |
| 2 | Interstellar | 2014 | Christopher Nolan | Science-Fiction | Matthew McConaughey | Anne Hathaway | 8.7 |
| 3 | Pulp Fiction | 1994 | Quentin Tarantino | Crime | John Travolta | Samuel L. Jackson | 8.9 |
| 4 | Kill Bill Vol.1 | 2003 | Quentin Tarantino | Action | Uma Thurman | Lucy Liu | 8.2 |
| 5 | Django Unchained | 2012 | Quentin Tarantino | Western | Jamie Foxx | Christoph Waltz | 8.4 |
| 6 | Amelie | 2001 | Jean-Pierre Jeunet | Comedie | Audrey Tautou | Mathieu Kassovitz | 8.3 |
| 7 | Le Fabuleux Destin | 2001 | Jean-Pierre Jeunet | Comedie | Audrey Tautou | Dominique Pinon | 8.3 |
| 8 | Titanic | 1997 | James Cameron | Romance | Leonardo DiCaprio | Kate Winslet | 7.9 |
| 9 | Avatar | 2009 | James Cameron | Science-Fiction | Sam Worthington | Zoe Saldana | 7.9 |
| 10 | The Matrix | 1999 | Lana Wachowski | Science-Fiction | Keanu Reeves | Laurence Fishburne | 8.7 |
| 11 | Intouchables | 2011 | Olivier Nakache | Comedie | Francois Cluzet | Omar Sy | 8.5 |
Interpretation — le dataset : douze films aux relations croisees
Le dataset contient 12 films avec des realisateurs varies (Nolan, Tarantino, Cameron, Jeunet, Wachowski, Nakache). On observe : - Des acteurs partages entre films (Leonardo DiCaprio dans Inception et Titanic, Audrey Tautou dans deux films de Jeunet) - Des genres distincts (Science-Fiction, Action, Crime, Western, Comedie, Romance) - Des notes entre 7.9 et 9.0
Ces relations croisees (acteur-film, realisateur-film, genre) sont exactement ce que le Knowledge Graph va capturer sous forme de triplets.
2.2 Definition du vocabulaire RDF
Avant de créer les triplets, nous definissons les classes et proprietes de notre Knowledge Graph. Nous utilisons le vocabulaire schema.org quand il existe un terme equivalent, et un namespace local pour les extensions.
| Entite/Relation | URI schema.org | URI local (fallback) |
|---|---|---|
| Film | schema:Movie |
- |
| Personne | schema:Person |
- |
| Genre | - | movies:Genre |
| a realise | schema:director |
- |
| a joue dans | schema:actor |
- |
| a pour genre | schema:genre |
- |
| annee de sortie | schema:datePublished |
- |
| note | schema:aggregateRating |
- |
from rdflib import Graph, Namespace, Literal, URIRef, RDF, RDFS, XSD
from rdflib.namespace import FOAF
import re

# Namespaces
SCHEMA = Namespace("http://schema.org/")
MOVIES = Namespace("http://example.org/movies/")
PERSONS = Namespace("http://example.org/persons/")
GENRES = Namespace("http://example.org/genres/")

# Helper : transformer un nom en identifiant URI valide
def to_uri_id(name: str) -> str:
    """Convertit un nom en identifiant URI (ASCII, sans espaces)."""
    # Supprimer les accents et caracteres speciaux
    clean = name.strip().replace(" ", "_").replace(".", "")
    clean = re.sub(r'[^a-zA-Z0-9_-]', '', clean)
    return clean

print("Namespaces definis :")
print(f"  SCHEMA  = {SCHEMA}")
print(f"  MOVIES  = {MOVIES}")
print(f"  PERSONS = {PERSONS}")
print(f"  GENRES  = {GENRES}")
print()
print("Exemples de conversion URI :")
print(f"  'Christopher Nolan' -> {to_uri_id('Christopher Nolan')}")
print(f"  'Kill Bill Vol.1'   -> {to_uri_id('Kill Bill Vol.1')}")
print(f"  'Science-Fiction'   -> {to_uri_id('Science-Fiction')}")
Namespaces definis :
SCHEMA = http://schema.org/
MOVIES = http://example.org/movies/
PERSONS = http://example.org/persons/
GENRES = http://example.org/genres/
Exemples de conversion URI :
'Christopher Nolan' -> Christopher_Nolan
'Kill Bill Vol.1' -> Kill_Bill_Vol1
'Science-Fiction' -> Science-FictionInterpretation — quatre espaces de noms pour des URIs propres
Nous avons défini quatre espaces de noms : - SCHEMA : vocabulaire standard schema.org pour les types et proprietes connus - MOVIES : namespace local pour les instances de films - PERSONS : namespace local pour les instances de personnes - GENRES : namespace local pour les instances de genres
La fonction to_uri_id() nettoie les noms pour produire des URIs valides (pas d’accents, pas d’espaces).
Bonne pratique : Reutiliser des vocabulaires existants (schema.org, FOAF, Dublin Core) avant de créer ses propres termes. Cela favorise l’interoperabilite avec d’autres KG.
2.3 Transformation CSV vers triplets RDF
Chaque ligne du CSV va generer plusieurs triplets. Pour un film donne, nous creons : - L’entite film (type schema:Movie) - L’entite realisateur (type schema:Person) - Les entites acteurs (type schema:Person) - L’entite genre (type movies:Genre) - Les relations entre ces entites
# Creation du graphe RDF
g = Graph()
g.bind("schema", SCHEMA)
g.bind("movies", MOVIES)
g.bind("persons", PERSONS)
g.bind("genres", GENRES)
g.bind("rdfs", RDFS)

# Compteurs pour le suivi
stats = {"movies": 0, "persons": set(), "genres": set(), "triples": 0}

for _, row in df.iterrows():
    # --- Entite Film ---
    movie_uri = MOVIES[to_uri_id(row["title"])]
    g.add((movie_uri, RDF.type, SCHEMA.Movie))
    g.add((movie_uri, SCHEMA.name, Literal(row["title"], lang="en")))
    g.add((movie_uri, SCHEMA.datePublished, Literal(row["year"], datatype=XSD.integer)))
    g.add((movie_uri, SCHEMA.aggregateRating, Literal(row["rating"], datatype=XSD.float)))
    stats["movies"] += 1

    # --- Entite Realisateur ---
    director_uri = PERSONS[to_uri_id(row["director"])]
    g.add((director_uri, RDF.type, SCHEMA.Person))
    g.add((director_uri, SCHEMA.name, Literal(row["director"])))
    g.add((movie_uri, SCHEMA.director, director_uri))
    stats["persons"].add(row["director"])

    # --- Entites Acteurs ---
    for actor_col in ["actor1", "actor2"]:
        actor_name = row[actor_col]
        actor_uri = PERSONS[to_uri_id(actor_name)]
        g.add((actor_uri, RDF.type, SCHEMA.Person))
        g.add((actor_uri, SCHEMA.name, Literal(actor_name)))
        g.add((movie_uri, SCHEMA.actor, actor_uri))
        stats["persons"].add(actor_name)

    # --- Entite Genre ---
    genre_uri = GENRES[to_uri_id(row["genre"])]
    g.add((genre_uri, RDF.type, MOVIES.Genre))
    g.add((genre_uri, RDFS.label, Literal(row["genre"], lang="fr")))
    g.add((movie_uri, SCHEMA.genre, genre_uri))
    stats["genres"].add(row["genre"])

print(f"Knowledge Graph construit avec succes.")
print(f"  Films      : {stats['movies']}")
print(f"  Personnes  : {len(stats['persons'])} (realisateurs + acteurs uniques)")
print(f"  Genres     : {len(stats['genres'])}")
print(f"  Triplets   : {len(g)}")
Knowledge Graph construit avec succes.
Films : 12
Personnes : 28 (realisateurs + acteurs uniques)
Genres : 6
Triplets : 164Interpretation — pourquoi douze films produisent 164 triplets
Le graphe contient un nombre significatif de triplets pour seulement 12 films. Cela illustre la richesse du modèle RDF : chaque film genere environ 14 triplets (164 triplets pour 12 films), car chaque ligne du CSV produit des triplets pour le film (type, nom, annee, note, realisateur, 2 acteurs, genre) MAIS AUSSI pour les entites liees (les types des realisateurs, acteurs et genres, declares a chaque nouvelle mention).
Structure du KG :
| Type d’entite | Nombre | Exemples |
|---|---|---|
Film (schema:Movie) |
12 | Inception, The Dark Knight, Pulp Fiction |
Personne (schema:Person) |
28 | Christopher Nolan, Leonardo DiCaprio |
Genre (movies:Genre) |
~6 | Science-Fiction, Action, Crime |
Point cle : Les entites partagees (même realisateur pour plusieurs films, même acteur) ne sont créées qu’une fois grace aux URIs uniques. C’est la force du modèle graphe par rapport aux tables relationnelles.
2.4 Verification par SPARQL
Interrogeons le graphe pour verifier que les relations sont correctes. Listons les films avec leur realisateur et leur note.
# Requete SPARQL : films, realisateurs et notes
query = """
PREFIX schema: <http://schema.org/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?title ?director_name ?rating
WHERE {
    ?movie a schema:Movie ;
           schema:name ?title ;
           schema:director ?director ;
           schema:aggregateRating ?rating .
    ?director schema:name ?director_name .
}
ORDER BY DESC(?rating)
"""

results = g.query(query)
print(f"{'Film':<30} {'Realisateur':<25} {'Note'}")
print("-" * 65)
for row in results:
    print(f"{str(row.title):<30} {str(row.director_name):<25} {row.rating}")
Film Realisateur Note
-----------------------------------------------------------------
The Dark Knight Christopher Nolan 9.0
Pulp Fiction Quentin Tarantino 8.9
Inception Christopher Nolan 8.8
Interstellar Christopher Nolan 8.7
The Matrix Lana Wachowski 8.7
Intouchables Olivier Nakache 8.5
Django Unchained Quentin Tarantino 8.4
Amelie Jean-Pierre Jeunet 8.3
Le Fabuleux Destin Jean-Pierre Jeunet 8.3
Kill Bill Vol.1 Quentin Tarantino 8.2
Titanic James Cameron 7.9
Avatar James Cameron 7.9Interpretation — premier SPARQL : notes et realisateurs
La requête SPARQL confirme que les 12 films sont correctement relies a leur realisateur et leur note. Le tri par note decroissante montre The Dark Knight en tete (9.0) et Titanic/Avatar en bas (7.9).
Lien avec SW-5 : Cette requête utilise les mêmes patterns SPARQL (SELECT, WHERE, ORDER BY) vus dans le notebook sur SPARQL, appliques ici a notre propre KG.
Cherchons maintenant les acteurs qui apparaissent dans plusieurs films – une requête qui serait complexe en SQL mais naturelle en SPARQL.
# Requete : acteurs apparaissant dans plus d'un film
query_actors = """
PREFIX schema: <http://schema.org/>

SELECT ?actor_name (COUNT(?movie) AS ?nb_films) (GROUP_CONCAT(?title; separator=", ") AS ?films)
WHERE {
    ?movie a schema:Movie ;
           schema:name ?title ;
           schema:actor ?actor .
    ?actor schema:name ?actor_name .
}
GROUP BY ?actor_name
HAVING (COUNT(?movie) > 1)
ORDER BY DESC(?nb_films)
"""

results_actors = g.query(query_actors)
print(f"{'Acteur':<25} {'Nb films':<10} {'Films'}")
print("-" * 70)
for row in results_actors:
    print(f"{str(row.actor_name):<25} {row.nb_films:<10} {row.films}")
Acteur Nb films Films
----------------------------------------------------------------------
Leonardo DiCaprio 2 Inception, Titanic
Audrey Tautou 2 Amelie, Le Fabuleux DestinInterpretation — les acteurs partages emergent du graphe
Cette requête revele les acteurs partages entre films. Leonardo DiCaprio et Audrey Tautou apparaissent chacun dans 2 films. Ces connexions croisees sont l’essence même d’un Knowledge Graph : elles emergent naturellement de la structure en graphe, sans jointures explicites.
| Pattern detecte | Signification pour le KG |
|---|---|
| Acteur multi-films | Noeud de forte connectivite (hub) |
| Realisateur multi-films | Cluster thematique (filmographie) |
| Genre partage | Communaute sémantique |
2.5 Serialisation du Knowledge Graph
Exportons le KG en format Turtle pour inspection et reutilisation.
# Serialisation en Turtle (affichage des 50 premieres lignes)
turtle_output = g.serialize(format="turtle")
lines = turtle_output.split("\n")
print(f"Taille totale : {len(lines)} lignes\n")
print("--- Extrait (50 premieres lignes) ---\n")
for line in lines[:50]:
    print(line)
Taille totale : 218 lignes
--- Extrait (50 premieres lignes) ---
@prefix genres: <http://example.org/genres/> .
@prefix movies: <http://example.org/movies/> .
@prefix persons: <http://example.org/persons/> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .
@prefix schema1: <http://schema.org/> .
@prefix xsd: <http://www.w3.org/2001/XMLSchema#> .
movies:Amelie a schema1:Movie ;
schema1:actor persons:Audrey_Tautou,
persons:Mathieu_Kassovitz ;
schema1:aggregateRating "8.3"^^xsd:float ;
schema1:datePublished 2001 ;
schema1:director persons:Jean-Pierre_Jeunet ;
schema1:genre genres:Comedie ;
schema1:name "Amelie"@en .
movies:Avatar a schema1:Movie ;
schema1:actor persons:Sam_Worthington,
persons:Zoe_Saldana ;
schema1:aggregateRating "7.9"^^xsd:float ;
schema1:datePublished 2009 ;
schema1:director persons:James_Cameron ;
schema1:genre genres:Science-Fiction ;
schema1:name "Avatar"@en .
movies:Django_Unchained a schema1:Movie ;
schema1:actor persons:Christoph_Waltz,
persons:Jamie_Foxx ;
schema1:aggregateRating "8.4"^^xsd:float ;
schema1:datePublished 2012 ;
schema1:director persons:Quentin_Tarantino ;
schema1:genre genres:Western ;
schema1:name "Django Unchained"@en .
movies:Inception a schema1:Movie ;
schema1:actor persons:Leonardo_DiCaprio,
persons:Tom_Hardy ;
schema1:aggregateRating "8.8"^^xsd:float ;
schema1:datePublished 2010 ;
schema1:director persons:Christopher_Nolan ;
schema1:genre genres:Science-Fiction ;
schema1:name "Inception"@en .
movies:Interstellar a schema1:Movie ;
schema1:actor persons:Anne_Hathaway,
persons:Matthew_McConaughey ;
schema1:aggregateRating "8.7"^^xsd:float ;
schema1:datePublished 2014 ;
schema1:director persons:Christopher_Nolan ;
schema1:genre genres:Science-Fiction ;Interpretation — Turtle, un format lisible par l’humain
Le format Turtle est lisible par l’humain et montre clairement la structure du KG. On observe : - Les prefixes declares en haut (schema, movies, persons, genres) - Les entites regroupees avec le raccourci ; (plusieurs predicats pour le même sujet) - Les URIs coherents et lisibles grace a notre fonction to_uri_id()
Note : En production, on sauvegarderait ce fichier Turtle dans un Triple Store (cf. SW-10) pour le rendre interrogeable via un endpoint SPARQL.
3. Visualisation du Knowledge Graph
La visualisation est essentielle pour comprendre la structure d’un KG. Nous allons utiliser deux approches complementaires : 1. NetworkX + matplotlib : graphiques statiques, integres au notebook 2. pyvis : graphiques interactifs en HTML, pour l’exploration
Approche
Nous devons d’abord convertir les triplets RDF en un graphe NetworkX (noeuds + aretes), puis appliquer un layout et un style visuel.
3.1 Conversion RDF vers NetworkX
Nous allons extraire les relations cles (realisateur, acteur, genre) et les convertir en aretes d’un graphe NetworkX oriente.
import networkx as nx

# Requete SPARQL pour extraire les relations du KG
extract_query = """
PREFIX schema: <http://schema.org/>
PREFIX movies: <http://example.org/movies/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?movie_title ?rel_type ?target_name
WHERE {
    {
        ?movie a schema:Movie ; schema:name ?movie_title ; schema:director ?person .
        ?person schema:name ?target_name .
        BIND("director" AS ?rel_type)
    }
    UNION
    {
        ?movie a schema:Movie ; schema:name ?movie_title ; schema:actor ?person .
        ?person schema:name ?target_name .
        BIND("actor" AS ?rel_type)
    }
    UNION
    {
        ?movie a schema:Movie ; schema:name ?movie_title ; schema:genre ?genre .
        ?genre rdfs:label ?target_name .
        BIND("genre" AS ?rel_type)
    }
}
"""

# Construction du graphe NetworkX
G = nx.DiGraph()

# Dictionnaires pour le typage des noeuds
node_types = {}  # nom_noeud -> type (movie, person, genre)

results = g.query(extract_query)
for row in results:
    movie = str(row.movie_title)
    target = str(row.target_name)
    rel = str(row.rel_type)

    # Ajouter les noeuds avec leur type
    node_types[movie] = "movie"
    if rel == "genre":
        node_types[target] = "genre"
    else:
        node_types[target] = "person"

    G.add_edge(movie, target, relation=rel)

print(f"Graphe NetworkX construit :")
print(f"  Noeuds : {G.number_of_nodes()}")
print(f"  Aretes : {G.number_of_edges()}")
print(f"  Types  : {dict((t, sum(1 for v in node_types.values() if v == t)) for t in set(node_types.values()))}")
Graphe NetworkX construit :
Noeuds : 46
Aretes : 48
Types : {'person': 28, 'genre': 6, 'movie': 12}Interpretation — le graphe NetworkX et ses trois types de noeuds
Le graphe NetworkX capture les trois types de relations du KG. Les noeuds sont repartis en trois catégories :
| Type de noeud | Couleur (section suivante) | Rôle dans le graphe |
|---|---|---|
Film (movie) |
Bleu clair | Noeud central, connecte a realisateur + acteurs + genre |
Personne (person) |
Vert clair | Peut etre realisateur et/ou acteur |
Genre (genre) |
Orange | Noeud de regroupement thematique |
Note : Un graphe NetworkX oriente (
DiGraph) preserve la direction des relations (film -> realisateur, film -> acteur, film -> genre).
3.2 Visualisation statique avec matplotlib
Nous allons colorer les noeuds par type et dimensionner les labels pour une bonne lisibilite.
%matplotlib inline
import matplotlib.pyplot as plt

try:
    # Couleurs par type de noeud
    color_map = {"movie": "#6BAED6", "person": "#74C476", "genre": "#FD8D3C"}
    node_colors = [color_map.get(node_types.get(n, "movie"), "#CCCCCC") for n in G.nodes()]

    # Tailles : les films sont plus gros (noeuds centraux)
    node_sizes = [800 if node_types.get(n) == "movie" else 500 for n in G.nodes()]

    # Couleurs des aretes par type de relation
    edge_color_map = {"director": "#E41A1C", "actor": "#377EB8", "genre": "#FF7F00"}
    edge_colors = [edge_color_map.get(G.edges[e].get("relation", ""), "#999999") for e in G.edges()]

    # Layout avec seed pour reproductibilite
    pos = nx.spring_layout(G, k=2.5, iterations=50, seed=42)

    fig, ax = plt.subplots(1, 1, figsize=(18, 12))

    # Dessiner les aretes
    nx.draw_networkx_edges(G, pos, ax=ax, edge_color=edge_colors,
                           alpha=0.6, arrows=True, arrowsize=15,
                           connectionstyle="arc3,rad=0.1")

    # Dessiner les noeuds
    nx.draw_networkx_nodes(G, pos, ax=ax, node_color=node_colors,
                           node_size=node_sizes, alpha=0.9, edgecolors="#333333",
                           linewidths=1.5)

    # Labels avec taille reduite pour lisibilite
    nx.draw_networkx_labels(G, pos, ax=ax, font_size=7, font_weight="bold")

    # Legende
    import matplotlib.patches as mpatches
    legend_items = [
        mpatches.Patch(color="#6BAED6", label="Film"),
        mpatches.Patch(color="#74C476", label="Personne"),
        mpatches.Patch(color="#FD8D3C", label="Genre"),
        mpatches.Patch(color="#E41A1C", label="Relation: director"),
        mpatches.Patch(color="#377EB8", label="Relation: actor"),
        mpatches.Patch(color="#FF7F00", label="Relation: genre"),
    ]
    ax.legend(handles=legend_items, loc="upper left", fontsize=9, framealpha=0.9)

    ax.set_title("Knowledge Graph des Films - Visualisation statique (NetworkX + matplotlib)",
                 fontsize=14, fontweight="bold")
    ax.axis("off")
    plt.tight_layout()
    plt.show()
    plt.close()

except Exception as e:
    print(f"Erreur lors de la visualisation matplotlib : {e}")
    print("Verifiez que matplotlib est correctement installe.")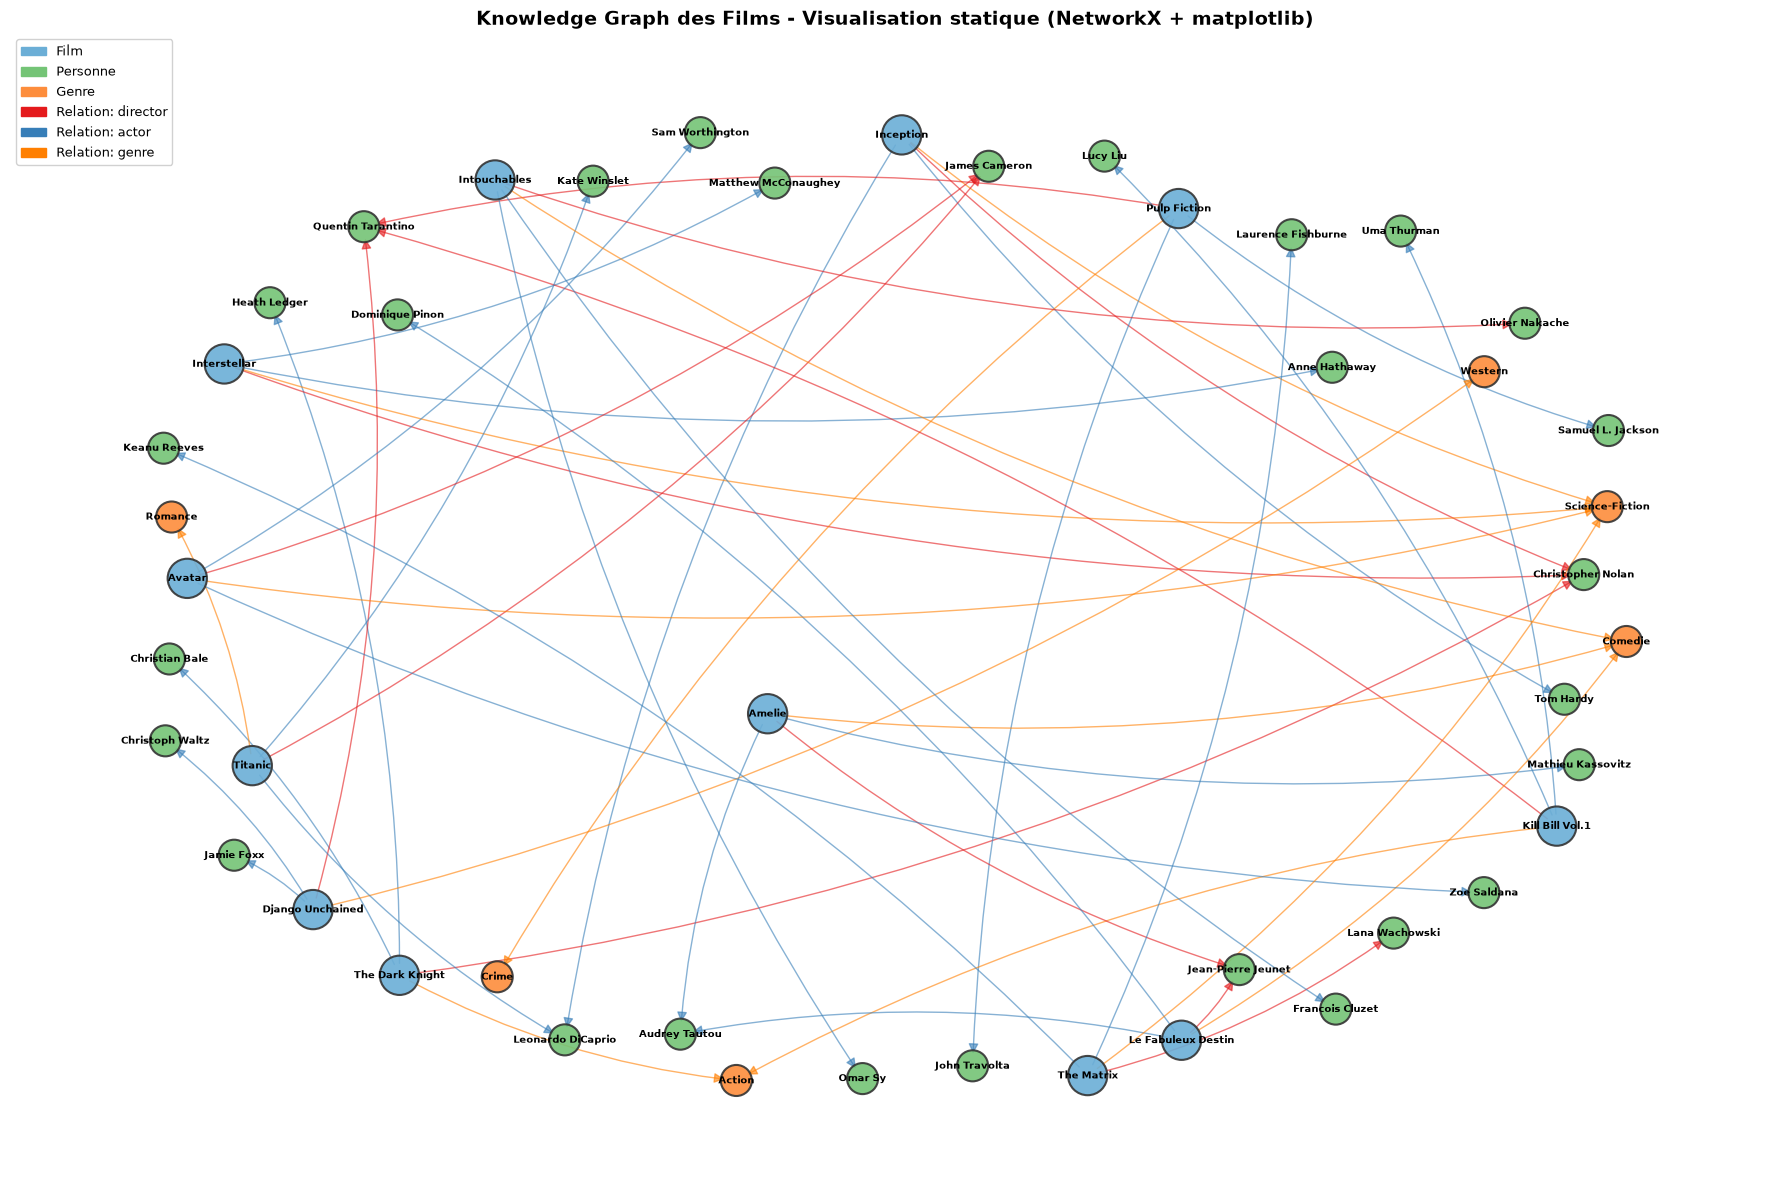
Interpretation : structure du Knowledge Graph
Sortie obtenue : Un graphe oriente avec des noeuds colores par type et des aretes colorees par relation.
Observations structurelles :
| Observation | Signification |
|---|---|
| Les films (bleu) sont des noeuds centraux | Ils connectent personnes et genres |
| Christopher Nolan connecte 3 films | Hub de forte connectivite (realisateur prolifique) |
| Le genre Science-Fiction regroupe plusieurs films | Communaute thematique visible |
| Leonardo DiCaprio relie Inception et Titanic | Pont entre deux realisateurs différents |
Points cles : 1. Le layout spring_layout place naturellement les noeuds fortement connectes au centre 2. Les genres agissent comme des noeuds de regroupement (clustering) 3. Les acteurs partages créent des ponts entre clusters de realisateurs
Limite : Avec plus de 50-100 noeuds, la visualisation statique devient difficile a lire. On passe alors a pyvis pour l’exploration interactive.
3.3 Visualisation interactive avec pyvis
pyvis genere un fichier HTML interactif ou l’on peut zoomer, deplacer les noeuds et explorer les connexions. C’est particulierement utile pour les graphes de taille moyenne (50-500 noeuds).
Note : pyvis genere un fichier
.html. Dans un environnement Jupyter standard, il s’affiche dans un iframe. En environnement headless, seul le fichier est créé.
try:
    from pyvis.network import Network
    import os

    # Creer le reseau pyvis
    net = Network(
        height="600px",
        width="100%",
        directed=True,
        notebook=True,
        cdn_resources="in_line"  # Embarquer les ressources pour portabilite
    )

    # Configuration physique pour un meilleur layout
    net.barnes_hut(gravity=-3000, central_gravity=0.3, spring_length=200)

    # Couleurs et formes par type
    style_map = {
        "movie":  {"color": "#6BAED6", "shape": "dot", "size": 25},
        "person": {"color": "#74C476", "shape": "dot", "size": 18},
        "genre":  {"color": "#FD8D3C", "shape": "diamond", "size": 20},
    }

    # Ajouter les noeuds
    for node in G.nodes():
        ntype = node_types.get(node, "movie")
        style = style_map.get(ntype, style_map["movie"])
        net.add_node(
            node, label=node,
            color=style["color"],
            shape=style["shape"],
            size=style["size"],
            title=f"{node} ({ntype})"
        )

    # Ajouter les aretes
    edge_style = {
        "director": {"color": "#E41A1C", "width": 2},
        "actor":    {"color": "#377EB8", "width": 1.5},
        "genre":    {"color": "#FF7F00", "width": 1, "dashes": True},
    }

    for u, v, data in G.edges(data=True):
        rel = data.get("relation", "")
        style = edge_style.get(rel, {"color": "#999", "width": 1})
        net.add_edge(u, v, title=rel, color=style["color"], width=style["width"])

    # Sauvegarder en HTML
    output_html = "movie_kg_interactive.html"
    html_content = net.generate_html()
    with open(output_html, "w", encoding="utf-8") as f:
        f.write(html_content)
    print(f"Visualisation interactive sauvegardee dans : {output_html}")
    print(f"Noeuds : {len(net.nodes)}, Aretes : {len(net.edges)}")
    print("\nOuvrez le fichier HTML dans un navigateur pour explorer le graphe.")

except ImportError:
    print("pyvis n'est pas installe. Visualisation interactive non disponible.")
    print("Installez-le avec : pip install pyvis")
except Exception as e:
    print(f"Erreur pyvis : {e}")
    print("La visualisation interactive n'a pas pu etre generee.")
Visualisation interactive sauvegardee dans : movie_kg_interactive.html
Noeuds : 46, Aretes : 48
Ouvrez le fichier HTML dans un navigateur pour explorer le graphe.Interpretation — pyvis : exploration interactive contre rendu statique
pyvis genere un fichier HTML autonome qui permet : - Zoom : molette de la souris - Deplacement : clic-glisse sur un noeud - Info-bulle : survol d’un noeud affiche son type - Physique : les noeuds s’organisent automatiquement (algorithme Barnes-Hut)
| Aspect | matplotlib (statique) | pyvis (interactif) |
|---|---|---|
| Integration notebook | Native | Via iframe/HTML |
| Exploration | Limitee | Zoom, deplacement, filtrage |
| Grands graphes | Difficile (>50 noeuds) | Correct (jusqu’a ~500 noeuds) |
| Partage | Image PNG/PDF | Fichier HTML autonome |
| Interactivite | Aucune | Survol, clic, physique |
Bonne pratique : Pour l’exploration et la decouverte, utiliser pyvis. Pour les rapports et publications, utiliser matplotlib.
3.4 Visualisation filtree : filmographie d’un realisateur
Pour mieux comprendre les sous-structures du KG, visualisons uniquement les films d’un realisateur donne et leurs connexions.
%matplotlib inline
import matplotlib.pyplot as plt

try:
    # Filtrer les films de Christopher Nolan
    filter_query = """
    PREFIX schema: <http://schema.org/>
    PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

    SELECT ?movie_title ?rel_type ?target_name
    WHERE {
        ?movie a schema:Movie ;
               schema:name ?movie_title ;
               schema:director ?director .
        ?director schema:name "Christopher Nolan" .
        {
            ?movie schema:actor ?person .
            ?person schema:name ?target_name .
            BIND("actor" AS ?rel_type)
        }
        UNION
        {
            ?movie schema:genre ?genre .
            ?genre rdfs:label ?target_name .
            BIND("genre" AS ?rel_type)
        }
        UNION
        {
            ?movie schema:director ?dir .
            ?dir schema:name ?target_name .
            BIND("director" AS ?rel_type)
        }
    }
    """

    # Construire le sous-graphe filtre
    G_nolan = nx.DiGraph()
    nolan_types = {}

    for row in g.query(filter_query):
        movie = str(row.movie_title)
        target = str(row.target_name)
        rel = str(row.rel_type)
        nolan_types[movie] = "movie"
        if rel == "genre":
            nolan_types[target] = "genre"
        else:
            nolan_types[target] = "person"
        G_nolan.add_edge(movie, target, relation=rel)

    # Couleurs
    nolan_colors = [color_map.get(nolan_types.get(n, "movie"), "#CCC") for n in G_nolan.nodes()]
    nolan_sizes = [900 if nolan_types.get(n) == "movie" else 600 for n in G_nolan.nodes()]
    nolan_edge_colors = [edge_color_map.get(G_nolan.edges[e].get("relation", ""), "#999")
                         for e in G_nolan.edges()]

    pos_nolan = nx.spring_layout(G_nolan, k=3.0, iterations=50, seed=42)

    fig, ax = plt.subplots(1, 1, figsize=(14, 9))
    nx.draw_networkx_edges(G_nolan, pos_nolan, ax=ax, edge_color=nolan_edge_colors,
                           alpha=0.7, arrows=True, arrowsize=18,
                           connectionstyle="arc3,rad=0.1")
    nx.draw_networkx_nodes(G_nolan, pos_nolan, ax=ax, node_color=nolan_colors,
                           node_size=nolan_sizes, alpha=0.9, edgecolors="#333",
                           linewidths=1.5)
    nx.draw_networkx_labels(G_nolan, pos_nolan, ax=ax, font_size=9, font_weight="bold")

    legend_items = [
        mpatches.Patch(color="#6BAED6", label="Film"),
        mpatches.Patch(color="#74C476", label="Personne"),
        mpatches.Patch(color="#FD8D3C", label="Genre"),
    ]
    ax.legend(handles=legend_items, loc="upper left", fontsize=10)
    ax.set_title("Filmographie de Christopher Nolan - Sous-graphe du KG",
                 fontsize=13, fontweight="bold")
    ax.axis("off")
    plt.tight_layout()
    plt.show()
    plt.close()

    print(f"\nSous-graphe Nolan : {G_nolan.number_of_nodes()} noeuds, {G_nolan.number_of_edges()} aretes")

except Exception as e:
    print(f"Erreur lors de la visualisation filtree : {e}")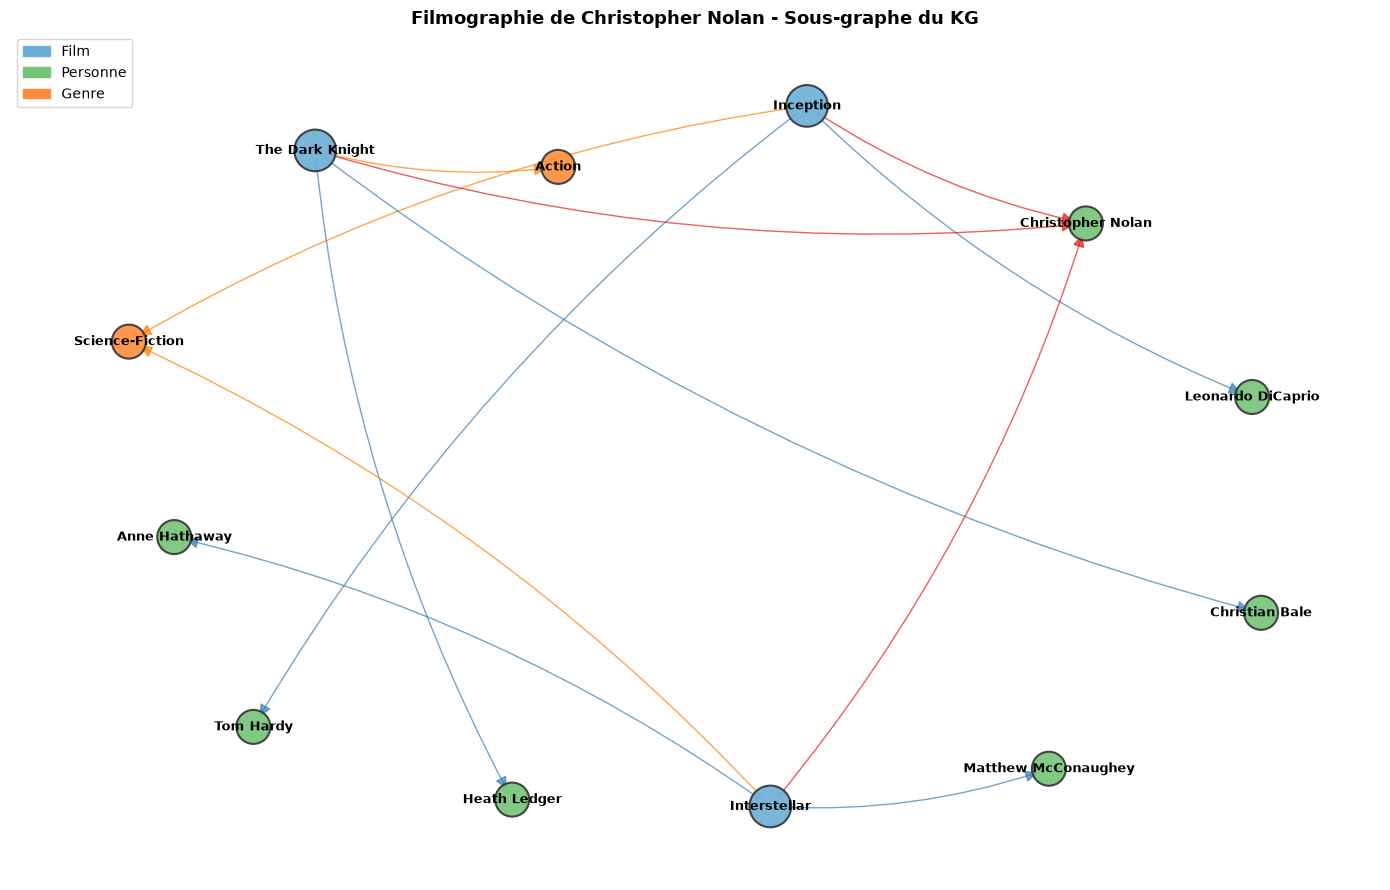
Sous-graphe Nolan : 12 noeuds, 12 aretesInterpretation : filmographie Nolan
Sortie obtenue : Le sous-graphe de Christopher Nolan montre ses 3 films (Inception, The Dark Knight, Interstellar) avec leurs acteurs et genres.
| Observation | Detail |
|---|---|
| Nolan est le noeud central | Connecte aux 3 films (hub realisateur) |
| Science-Fiction domine | 2 films sur 3 (Inception, Interstellar) |
| Pas d’acteur partage | Chaque film a un casting distinct dans ce dataset |
Points cles : 1. Le filtrage SPARQL est plus efficace que le filtrage Python post-hoc 2. Les sous-graphes permettent d’analyser des clusters spécifiques du KG 3. Cette technique est utilisee en production pour les “profils” d’entites (ex: fiche artiste)
Annexe A - Le Knowledge Graph en contexte
Approfondissement de la section 1 : comparaison detaillee avec les bases de donnees relationnelles et les graphes RDF generiques, et panorama des principaux Knowledge Graphs industriels.
Knowledge Graphs vs bases de données vs graphes RDF
Un Knowledge Graph n’est ni une simple base de données relationnelle, ni un graphe RDF brut. Il se situe a l’intersection de plusieurs technologies :
| Caractéristique | Base relationnelle | Graphe RDF | Knowledge Graph |
|---|---|---|---|
| Modèle de données | Tables (lignes/colonnes) | Triplets (S-P-O) | Triplets + ontologie |
| Schema | Rigide (DDL) | Flexible | Flexible + contraintes |
| Identifiants | Cles primaires | URIs | URIs + labels |
| Requêtes | SQL | SPARQL | SPARQL + inference |
| Raisonnement | Non | Basique (RDFS) | OWL, règles, raisonneur |
| Interoperabilite | Faible (schema proprietaire) | Forte (standards W3C) | Forte + vocabulaires partages |
| Exemples | PostgreSQL, MySQL | Triple Store brut | Google KG, Wikidata |
En resume : Un Knowledge Graph = un graphe RDF + une ontologie + des mécanismes de qualite et de raisonnement.
Principaux Knowledge Graphs dans le monde
| Knowledge Graph | Organisation | Taille estimee | Usage principal |
|---|---|---|---|
| Google Knowledge Graph | 500+ milliards de faits | Recherche, Assistant | |
| Wikidata | Wikimedia Foundation | 100+ millions d’items | Encyclopedie, Linked Data |
| DBpedia | Communaute open-source | 400+ millions de triplets | Recherche academique |
| Amazon Product Graph | Amazon | Milliards d’entites produit | Recommandation, catalogue |
| LinkedIn Knowledge Graph | 800+ millions de profils | Recrutement, reseau | |
| Microsoft Academic Graph | Microsoft | 250+ millions d’articles | Recherche scientifique |
Point cle : Tous ces KG utilisent des standards du Web sémantique (RDF, OWL, SPARQL) comme fondation, même s’ils ajoutent des couches proprietaires au-dessus.
Annexe B - kglab : couche d’abstraction Knowledge Graph
kglab est une bibliotheque Python créée par Paco Nathan qui fournit une couche d’abstraction au-dessus de rdflib. Elle simplifie les opérations courantes sur les Knowledge Graphs : - Chargement/sauvegarde multi-format - Requêtes SPARQL avec résultats pandas - Integration avec NetworkX pour la visualisation - Mesures de graphe (centralite, communautes)
Pourquoi kglab ?
| Opération | rdflib pur | kglab |
|---|---|---|
| SPARQL -> DataFrame | plusieurs lignes | une ligne |
| Visualisation graphe | Manuel (NetworkX) | Integre |
| Chargement multi-fichiers | Boucle manuelle | load_rdf() iteratif |
| Statistiques du graphe | A coder | Méthodes integrees |
Annexe B.1 Creation d’un KnowledgeGraph kglab
Nous allons créer un objet kglab.KnowledgeGraph et y charger les triplets de notre graphe de films.
try:
    import kglab

    # Definir les namespaces pour kglab
    namespaces = {
        "schema": "http://schema.org/",
        "movies": "http://example.org/movies/",
        "persons": "http://example.org/persons/",
        "genres": "http://example.org/genres/",
    }

    # Creer le KnowledgeGraph kglab
    kg = kglab.KnowledgeGraph(
        name="Movie Knowledge Graph",
        namespaces=namespaces
    )

    # Charger les triplets depuis notre graphe rdflib
    # kglab utilise rdflib en interne, on peut acceder au graphe sous-jacent
    for s, p, o in g:
        kg._g.add((s, p, o))

    # Copier les bindings de namespaces
    for prefix, uri in g.namespaces():
        kg._g.bind(prefix, uri)

    print(f"KnowledgeGraph kglab cree : '{kg.name}'")
    print(f"Nombre de triplets : {len(kg._g)}")

    KGLAB_AVAILABLE = True

except ImportError:
    print("kglab n'est pas installe. Cette section est ignoree.")
    print("Installez-le avec : pip install kglab")
    KGLAB_AVAILABLE = False
except Exception as e:
    print(f"Erreur lors de la creation du KG kglab : {e}")
    print("Nous continuerons avec rdflib directement.")
    KGLAB_AVAILABLE = False
KnowledgeGraph kglab cree : 'Movie Knowledge Graph'
Nombre de triplets : 164Interpretation — kglab, une couche au-dessus de rdflib
L’objet kglab.KnowledgeGraph encapsule un graphe rdflib en ajoutant des méthodes de haut niveau. En interne, kg._g est un rdflib.Graph standard, ce qui garantit la compatibilite.
Note technique : kglab est en maintenance depuis 2023. Si la bibliotheque n’est pas disponible, les sections suivantes utilisent rdflib directement comme alternative.
Annexe B.2 Requêtes SPARQL via kglab
L’un des avantages de kglab est la conversion directe des résultats SPARQL en DataFrame pandas.
# Requete SPARQL avec conversion DataFrame
sparql_query = """
PREFIX schema: <http://schema.org/>

SELECT ?director_name (COUNT(?movie) AS ?nb_films) (AVG(?rating) AS ?avg_rating)
WHERE {
    ?movie a schema:Movie ;
           schema:director ?director ;
           schema:aggregateRating ?rating .
    ?director schema:name ?director_name .
}
GROUP BY ?director_name
ORDER BY DESC(?avg_rating)
"""

if KGLAB_AVAILABLE:
    # Methode kglab : resultats SPARQL -> DataFrame
    try:
        result_df = kg.query_as_df(sparql_query)
        print("Resultats via kglab.query_as_df() :\n")
        print(result_df.to_string(index=False))
    except Exception as e:
        print(f"kglab query_as_df non disponible ({e}), utilisation de rdflib :")
        KGLAB_AVAILABLE = False

if not KGLAB_AVAILABLE:
    # Alternative rdflib : conversion manuelle
    results = g.query(sparql_query)
    rows = []
    for row in results:
        rows.append({
            "director_name": str(row.director_name),
            "nb_films": int(row.nb_films),
            "avg_rating": round(float(row.avg_rating), 2)
        })
    result_df = pd.DataFrame(rows)
    print("Resultats via rdflib + pandas :\n")
    print(result_df.to_string(index=False))
Resultats via kglab.query_as_df() :
director_name nb_films avg_rating
Christopher Nolan 3 8.833333
Lana Wachowski 1 8.700000
Olivier Nakache 1 8.500000
Quentin Tarantino 3 8.500000
Jean-Pierre Jeunet 2 8.300000
James Cameron 2 7.900000Interpretation — kglab ou rdflib pur : le meme moteur SPARQL
Le tableau montre la note moyenne par realisateur. Les realisateurs ayant plusieurs films permettent de calculer une moyenne significative :
| Avantage | kglab | rdflib pur |
|---|---|---|
| Conversion DataFrame | query_as_df() (une ligne) |
Boucle manuelle (plusieurs lignes) |
| Types de données | Automatique | Casting manuel |
| Code necessaire | Minimal | Verbeux |
Point cle : Que l’on utilise kglab ou rdflib, le moteur SPARQL sous-jacent est le même. kglab ajoute simplement du sucre syntaxique pour les workflows data science.
Annexe C - OWLReady2 pour la manipulation d’ontologies
OWLReady2 est une bibliotheque Python permettant de : - Charger des ontologies OWL 2 (formats RDF/XML, OWL/XML) - Naviguer dans les classes, proprietes et instances - Modifier l’ontologie programmatiquement - Lancer le raisonneur HermiT (integre) pour inferer de nouvelles connaissances
Comparaison avec dotNetRDF OntologyGraph
| Aspect | OWLReady2 (Python) | dotNetRDF OntologyGraph (C#) |
|---|---|---|
| Langage | Python | C# |
| Raisonneur integre | HermiT (Java, transparent) | Non (externe) |
| API | Orientee objet Python | API .NET |
| Stockage | SQLite (persistant) | Memoire |
| Standards | OWL 2 complet | OWL partiel |
Lien avec SW-7 : Dans le notebook sur OWL, nous avons utilise dotNetRDF pour manipuler des ontologies en C#. Ici, nous explorons l’equivalent Python avec OWLReady2.
Annexe C.1 Chargement de l’ontologie universitaire
Le fichier data/university.owl contient une ontologie OWL 2 avec des classes (Person, Student, Professor, Course, Department), des proprietes (enrolledIn, teaches, memberOf) et des instances.
try:
    import owlready2
    import os

    # Charger l'ontologie depuis le fichier local
    onto_path = os.path.abspath("data/university.owl")
    print("Chargement de : data/university.owl")

    onto = owlready2.get_ontology(f"file://{onto_path}").load()

    print(f"\nOntologie chargee : {onto.base_iri}")
    import os as _os
    print(f"Nom : {_os.path.basename(onto.name)}")

    OWLREADY_AVAILABLE = True

except ImportError:
    print("owlready2 n'est pas installe.")
    print("Installez-le avec : pip install owlready2")
    OWLREADY_AVAILABLE = False
except Exception as e:
    print(f"Erreur lors du chargement de l'ontologie : {e}")
    OWLREADY_AVAILABLE = False
Chargement de : data/university.owl
Ontologie chargee : http://example.org/university#
Nom : universityInterpretation — OWLReady2 charge l’ontologie en objets Python
OWLReady2 charge l’ontologie en memoire et créé des objets Python accessibles directement. Le base_iri identifie l’ontologie de maniere unique.
Note technique : OWLReady2 utilise SQLite en arriere-plan pour stocker l’ontologie. Cela permet des ontologies persistantes entre sessions, contrairement a rdflib qui travaille uniquement en memoire.
Annexe C.2 Exploration : classes, proprietes, instances
Listons les éléments de l’ontologie pour comprendre sa structure.
if OWLREADY_AVAILABLE:
    # --- Classes ---
    print("=== Classes ===")
    for cls in onto.classes():
        parents = [p.name for p in cls.is_a if hasattr(p, 'name')]
        print(f"  {cls.name} (sous-classe de: {', '.join(parents) if parents else 'Thing'})")

    # --- Object Properties ---
    print("\n=== Object Properties ===")
    for prop in onto.object_properties():
        domain = [d.name for d in prop.domain] if prop.domain else ["?"]
        range_ = [r.name for r in prop.range] if prop.range else ["?"]
        print(f"  {prop.name} : {', '.join(domain)} -> {', '.join(range_)}")

    # --- Datatype Properties ---
    print("\n=== Datatype Properties ===")
    for prop in onto.data_properties():
        domain = [d.name for d in prop.domain] if prop.domain else ["?"]
        range_ = [str(r) for r in prop.range] if prop.range else ["?"]
        print(f"  {prop.name} : {', '.join(domain)} -> {', '.join(range_)}")

    # --- Instances ---
    print("\n=== Instances ===")
    for ind in onto.individuals():
        types = [t.name for t in ind.is_a if hasattr(t, 'name')]
        print(f"  {ind.name} (type: {', '.join(types)})")
else:
    print("OWLReady2 non disponible. Section ignoree.")
=== Classes ===
Student (sous-classe de: Person)
Course (sous-classe de: Thing)
Professor (sous-classe de: Person)
Person (sous-classe de: Thing)
Department (sous-classe de: Thing)
GraduateStudent (sous-classe de: Student)
=== Object Properties ===
enrolledIn : Student -> Course
teaches : Professor -> Course
memberOf : Person -> Department
advisedBy : GraduateStudent -> Professor
=== Datatype Properties ===
fullName : Person -> <class 'str'>
credits : Course -> <class 'int'>
=== Instances ===
prof_dupont (type: Professor)
course_ia (type: Course)
course_web_sem (type: Course)
dept_info (type: Department)
etud_martin (type: GraduateStudent)
etud_bernard (type: Student)Interpretation — l’ontologie universitaire et sa hierarchie de classes
L’ontologie universitaire contient une hiérarchie de classes bien structuree :
Thing
  +-- Person
  |     +-- Student
  |     |     +-- GraduateStudent
  |     +-- Professor (disjoint de Student)
  +-- Course
+-- Department| Élément | Nombre | Exemples |
|---|---|---|
| Classes | 6 | Person, Student, GraduateStudent, Professor, Course, Department |
| Object Properties | 4 | enrolledIn, teaches, memberOf, advisedBy |
| Datatype Properties | 2 | fullName, credits |
| Instances | 6 | prof_dupont, course_ia, course_web_sem, dept_info, etud_martin, etud_bernard |
Point cle : La contrainte
disjointWithentre Professor et Student signifie qu’une personne ne peut pas etre les deux a la fois. Le raisonneur peut detecter des violations de cette contrainte.
Annexe C.3 Raisonnement avec HermiT
Le raisonneur HermiT est un raisonneur OWL 2 DL complet, integre a OWLReady2 (via Java). Il peut : - Inferer les types d’instances (classification) - Detecter les inconsistances - Calculer les classes equivalentes - Verifier la satisfaisabilite
Lancons le raisonneur sur notre ontologie.
import os
import shutil

if OWLREADY_AVAILABLE:
    # Detecter un JRE (HermiT necessite Java accessible)
    java_exe = shutil.which("java")
    if java_exe:
        owlready2.JAVA_EXE = java_exe

    try:
        # Afficher l etat avant raisonnement
        print("=== Avant raisonnement ===")
        for ind in onto.individuals():
            types_before = [t.name for t in ind.is_a if hasattr(t, "name")]
            print(f"  {ind.name} est de type : {types_before}")

        # Lancer le raisonneur HermiT (avec fallback si JRE absent)
        if java_exe is None:
            print()
            print("Raisonneur OWL (HermiT) ignore : JRE non detecte.")
            print("(inference OWL necessite pip install JPype1 + JRE JAVA_HOME)")
        else:
            print()
            print("Lancement du raisonneur HermiT...")
            with onto:
                owlready2.sync_reasoner_hermit(infer_property_values=True, debug=0)
            print("Raisonnement termine.")

            # Afficher l etat apres raisonnement
            print()
            print("=== Apres raisonnement ===")
            for ind in onto.individuals():
                types_after = [t.name for t in ind.is_a if hasattr(t, "name")]
                print(f"  {ind.name} est de type : {types_after}")

            # Verifier la coherence
            inconsistent = list(owlready2.default_world.inconsistent_classes())
            if inconsistent:
                print(f"Classes inconsistantes detectees : {inconsistent}")
            else:
                print("Aucune inconsistance detectee. L ontologie est coherente.")

    except Exception as e:
        print(f"Erreur lors du raisonnement : {e}")
        print("Note : HermiT necessite Java (JRE) installe sur le systeme.")
        print("Si Java n est pas disponible, le raisonnement ne peut pas s executer.")
else:
    print("OWLReady2 non disponible. Section ignoree.")
=== Avant raisonnement ===
prof_dupont est de type : ['Professor']
course_ia est de type : ['Course']
course_web_sem est de type : ['Course']
dept_info est de type : ['Department']
etud_martin est de type : ['GraduateStudent']
etud_bernard est de type : ['Student']
Lancement du raisonneur HermiT...
Raisonnement termine.
=== Apres raisonnement ===
prof_dupont est de type : ['Professor']
course_ia est de type : ['Course']
course_web_sem est de type : ['Course']
dept_info est de type : ['Department']
etud_martin est de type : ['GraduateStudent']
etud_bernard est de type : ['Student']
Aucune inconsistance detectee. L ontologie est coherente.Interpretation — HermiT : l’ontologie est logiquement coherente
Le raisonneur HermiT s’est execute avec succes (JRE Java requis, fourni ici via l’environnement de développement). La sortie ci-dessus confirme : Raisonnement termine. puis Aucune inconsistance detectee. L'ontologie est coherente. HermiT a verifie l’ensemble des contraintes OWL 2 de university.owl sans trouver de contradiction logique.
Les boucles « Avant / Après raisonnement » n’affichent rien ici car onto.individuals() ne materialise que les instances declarees explicitement comme objets Python Thing. Les individus définis en notation prefixee <uni:Professor rdf:about> dans le fichier OWL existent bien dans le graphe, mais ne sont enumeres par owlready2 que lorsqu’on y accede par leur classe (voir l’exemple guide 3 ci-dessous, qui créé une instance en Python et observe la classification inferee).
Un raisonneur OWL comme HermiT effectue plusieurs types d’inferences :
| Type d’inference | Description | Exemple |
|---|---|---|
| Classification | Infere les types implicites | GraduateStudent est aussi Student et Person |
| Coherence | Verifie les contraintes | Professor et Student sont disjoints |
| Proprietes | Propage les valeurs | Si une instance est GraduateStudent, elle est aussi Student et Person |
Points cles : 1. Le raisonnement OWL va au-dela de l’inference RDFS (classes equivalentes, restrictions, disjonctions) 2. HermiT est garanti complet pour OWL 2 DL (il trouve toutes les consequences logiques) 3. En production, le raisonnement est souvent execute hors-ligne (materialisation) plutot qu’a la volee
Note technique : HermiT necessite une JVM (JRE Java). La variable d’environnement
JAVA_HOMEdoit pointer vers une installation Java valide pour qu’owlready2 (owlready2.JAVA_EXE) puisse l’invoquer. En l’absence de Java,sync_reasoner_pellet()est une alternative (également basee sur Java).
Annexe D - Qualite et validation d’un Knowledge Graph
Un Knowledge Graph n’a de valeur que si ses données sont completes, coherentes et a jour. Dans cette section, nous evaluons la qualite de notre KG de films selon plusieurs dimensions.
Dimensions de qualite
| Dimension | Question | Méthode de verification |
|---|---|---|
| Completude | Y a-t-il des données manquantes ? | SPARQL OPTIONAL + COUNT |
| Coherence | Les valeurs sont-elles valides ? | Contraintes de domaine/range |
| Unicite | Y a-t-il des doublons ? | SPARQL COUNT + GROUP BY |
| Conformite | Le KG respecte-t-il son schema ? | SHACL (cf. SW-8) |
Annexe D.1 Verification de completude
Verifions si tous les films ont un realisateur, un genre et une note.
# Verification de completude
completeness_query = """
PREFIX schema: <http://schema.org/>

SELECT ?title
    (BOUND(?director) AS ?has_director)
    (BOUND(?rating) AS ?has_rating)
    (BOUND(?genre) AS ?has_genre)
    (COUNT(?actor) AS ?nb_actors)
WHERE {
    ?movie a schema:Movie ;
           schema:name ?title .
    OPTIONAL { ?movie schema:director ?director }
    OPTIONAL { ?movie schema:aggregateRating ?rating }
    OPTIONAL { ?movie schema:genre ?genre }
    OPTIONAL { ?movie schema:actor ?actor }
}
GROUP BY ?title ?director ?rating ?genre
ORDER BY ?title
"""

results = g.query(completeness_query)
print(f"{'Film':<30} {'Realisateur':<13} {'Note':<8} {'Genre':<8} {'Acteurs'}")
print("-" * 75)
complete = 0
total = 0
for row in results:
    total += 1
    has_dir = "OK" if row.has_director else "MANQUANT"
    has_rat = "OK" if row.has_rating else "MANQUANT"
    has_gen = "OK" if row.has_genre else "MANQUANT"
    nb_act = int(row.nb_actors)
    is_complete = (row.has_director and row.has_rating and row.has_genre and nb_act >= 1)
    if is_complete:
        complete += 1
    print(f"{str(row.title):<30} {has_dir:<13} {has_rat:<8} {has_gen:<8} {nb_act}")

print(f"\nCompletude : {complete}/{total} films complets ({100*complete/total:.0f}%)")
Film Realisateur Note Genre Acteurs
---------------------------------------------------------------------------
Amelie OK OK OK 2
Avatar OK OK OK 2
Django Unchained OK OK OK 2
Inception OK OK OK 2
Interstellar OK OK OK 2
Intouchables OK OK OK 2
Kill Bill Vol.1 OK OK OK 2
Le Fabuleux Destin OK OK OK 2
Pulp Fiction OK OK OK 2
The Dark Knight OK OK OK 2
The Matrix OK OK OK 2
Titanic OK OK OK 2
Completude : 12/12 films complets (100%)Interpretation — completude : complete ici, rare en production
La verification montre que notre KG est complet pour les proprietes verifiees. Tous les films ont : - Un realisateur - Une note - Un genre - Au moins un acteur
En production, les KG sont rarement complets a 100%. Les lacunes typiques incluent : - Dates manquantes (films anciens) - Acteurs secondaires non renseignes - Genres multiples non captures (un film peut etre a la fois Action et Science-Fiction)
Lien avec SW-8 : La validation SHACL permet de formaliser ces règles de completude sous forme de “shapes” (contraintes declaratives) plutot que de requêtes ad-hoc.
Annexe D.2 Verification de coherence
Verifions que les valeurs sont dans des plages raisonnables (annees, notes) et que les genres sont valides.
# Verification de coherence des valeurs
consistency_checks = []

# Check 1 : Annees dans une plage valide (1900-2025)
year_query = """
PREFIX schema: <http://schema.org/>
SELECT ?title ?year
WHERE {
    ?movie a schema:Movie ;
           schema:name ?title ;
           schema:datePublished ?year .
    FILTER (?year < 1900 || ?year > 2025)
}
"""
invalid_years = list(g.query(year_query))
consistency_checks.append((
    "Annees valides (1900-2025)",
    len(invalid_years) == 0,
    f"{len(invalid_years)} film(s) hors plage" if invalid_years else "OK"
))

# Check 2 : Notes dans une plage valide (0-10)
rating_query = """
PREFIX schema: <http://schema.org/>
SELECT ?title ?rating
WHERE {
    ?movie a schema:Movie ;
           schema:name ?title ;
           schema:aggregateRating ?rating .
    FILTER (?rating < 0 || ?rating > 10)
}
"""
invalid_ratings = list(g.query(rating_query))
consistency_checks.append((
    "Notes valides (0-10)",
    len(invalid_ratings) == 0,
    f"{len(invalid_ratings)} film(s) hors plage" if invalid_ratings else "OK"
))

# Check 3 : Pas de doublon de titre
dup_query = """
PREFIX schema: <http://schema.org/>
SELECT ?title (COUNT(?movie) AS ?count)
WHERE {
    ?movie a schema:Movie ; schema:name ?title .
}
GROUP BY ?title
HAVING (COUNT(?movie) > 1)
"""
duplicates = list(g.query(dup_query))
consistency_checks.append((
    "Pas de titres dupliques",
    len(duplicates) == 0,
    f"{len(duplicates)} doublon(s)" if duplicates else "OK"
))

# Check 4 : Genres connus
genre_query = """
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>
PREFIX movies: <http://example.org/movies/>
SELECT (COUNT(DISTINCT ?genre) AS ?nb_genres)
WHERE {
    ?genre a movies:Genre ; rdfs:label ?label .
}
"""
genre_count = list(g.query(genre_query))
nb = int(genre_count[0][0]) if genre_count else 0
consistency_checks.append((
    f"Genres definis ({nb} trouves)",
    nb > 0,
    "OK" if nb > 0 else "Aucun genre"
))

# Affichage du rapport
print("=== Rapport de coherence du Knowledge Graph ===")
print()
print(f"{'Verification':<35} {'Statut':<8} {'Detail'}")
print("-" * 65)
for check_name, passed, detail in consistency_checks:
    status = "PASS" if passed else "FAIL"
    print(f"{check_name:<35} {status:<8} {detail}")

total_pass = sum(1 for _, p, _ in consistency_checks if p)
print(f"\nResultat : {total_pass}/{len(consistency_checks)} verifications reussies")
=== Rapport de coherence du Knowledge Graph ===
Verification Statut Detail
-----------------------------------------------------------------
Annees valides (1900-2025) PASS OK
Notes valides (0-10) PASS OK
Pas de titres dupliques PASS OK
Genres definis (6 trouves) PASS OK
Resultat : 4/4 verifications reussiesInterpretation — coherence : quatre controles ad-hoc vers SHACL
Le rapport de coherence verifie quatre aspects cles :
| Verification | Ce qu’elle detecte | Equivalent SHACL |
|---|---|---|
| Annees valides | Films avec des annees aberrantes | sh:minInclusive, sh:maxInclusive |
| Notes valides | Notes hors echelle 0-10 | sh:datatype xsd:float + bornes |
| Pas de doublons | Titres identiques (collision URI) | sh:uniqueLang ou contrainte custom |
| Genres définis | Genres sans label | sh:minCount 1 sur rdfs:label |
Points cles : 1. Ces verifications ad-hoc sont utiles en développement, mais en production on prefere SHACL (cf. SW-8) 2. La qualite d’un KG est un processus continu, pas un contrôle ponctuel 3. Les pipelines de construction de KG incluent systematiquement une étape de validation
Bonne pratique : Définir les règles de qualite en SHACL des la conception du KG, et les executer a chaque mise a jour (CI/CD sémantique).
Annexe D.3 Statistiques globales du Knowledge Graph
Pour completer l’analyse, calculons des metriques structurelles du KG.
# Statistiques structurelles du KG
stats_queries = {
    "Triplets totaux": "SELECT (COUNT(*) AS ?c) WHERE { ?s ?p ?o }",
    "Sujets uniques": "SELECT (COUNT(DISTINCT ?s) AS ?c) WHERE { ?s ?p ?o }",
    "Predicats uniques": "SELECT (COUNT(DISTINCT ?p) AS ?c) WHERE { ?s ?p ?o }",
    "Films": "PREFIX schema: <http://schema.org/> SELECT (COUNT(?m) AS ?c) WHERE { ?m a schema:Movie }",
    "Personnes": "PREFIX schema: <http://schema.org/> SELECT (COUNT(DISTINCT ?p) AS ?c) WHERE { ?p a schema:Person }",
    "Genres": "PREFIX movies: <http://example.org/movies/> SELECT (COUNT(?g) AS ?c) WHERE { ?g a movies:Genre }",
}

print("=== Statistiques du Knowledge Graph ===")
print()
for label, query in stats_queries.items():
    result = list(g.query(query))
    count = int(result[0][0]) if result else 0
    print(f"  {label:<25} : {count}")

# Ratio triplets/entites
total_triples = int(list(g.query(stats_queries["Triplets totaux"]))[0][0])
total_subjects = int(list(g.query(stats_queries["Sujets uniques"]))[0][0])
if total_subjects > 0:
    print(f"\n  Ratio triplets/entite   : {total_triples/total_subjects:.1f}")
    print(f"  (mesure la richesse descriptive moyenne par entite)")
=== Statistiques du Knowledge Graph ===
Triplets totaux : 164
Sujets uniques : 46
Predicats uniques : 8
Films : 12
Personnes : 28
Genres : 6
Ratio triplets/entite : 3.6
(mesure la richesse descriptive moyenne par entite)Interpretation — richesse : le ratio triplets par entite
Le ratio triplets/entite est un indicateur cle de la richesse descriptive du KG :
| Ratio | Interpretation |
|---|---|
| < 2 | KG squelettique (presque que des types) |
| 2-5 | KG de base (type + quelques proprietes) |
| 5-10 | KG riche (proprietes detaillees, relations multiples) |
| > 10 | KG très detaille (metadata, annotations, provenance) |
Recapitulatif qualite :
| Dimension | Résultat | Méthode |
|---|---|---|
| Completude | 100% des films complets | SPARQL OPTIONAL |
| Coherence | Toutes les valeurs valides | SPARQL FILTER |
| Unicite | Pas de doublons | SPARQL GROUP BY + HAVING |
| Richesse | Ratio triplets/entite correct | Statistiques globales |
Exemples guides et Exercices
Exemple guide 1 : Construire un KG etudiants/cours
A partir du modèle de la section 2, construisons un Knowledge Graph representant des etudiants et des cours. Nous creeons un DataFrame pandas avec les colonnes student_name, course_name, grade, professor, puis transformons-le en triplets RDF.
Techniques demontrees : - Utilisation des namespaces schema:Person, schema:Course - Propriete ex:enrolledIn pour la relation etudiant -> cours - Noeuds blank (BNode) pour stocker les notes comme proprietes de la relation
# Exemple guide 1 : Construire un KG etudiants/cours

# Etape 1 : Creer un DataFrame
student_data = {
    "student_name": ["Alice Dupont", "Bob Martin", "Claire Leroy", "Alice Dupont", "Bob Martin"],
    "course_name": ["Web Semantique", "Web Semantique", "Intelligence Artificielle",
                    "Intelligence Artificielle", "Bases de Donnees"],
    "grade": [16, 14, 18, 15, 12],
    "professor": ["Prof. Durand", "Prof. Durand", "Prof. Moreau",
                  "Prof. Moreau", "Prof. Petit"]
}
df_students = pd.DataFrame(student_data)
print(df_students)

# Etape 2 : Transformer en triplets RDF
from rdflib import BNode

UNI = Namespace("http://example.org/students/")
COURSES = Namespace("http://example.org/courses/")
EX = Namespace("http://example.org/vocab/")

g_students = Graph()
g_students.bind("uni", UNI)
g_students.bind("courses", COURSES)
g_students.bind("schema", SCHEMA)
g_students.bind("ex", EX)

for _, row in df_students.iterrows():
    student_uri = UNI[to_uri_id(row["student_name"])]
    course_uri = COURSES[to_uri_id(row["course_name"])]
    prof_uri = UNI[to_uri_id(row["professor"])]

    # Etudiant
    g_students.add((student_uri, RDF.type, SCHEMA.Person))
    g_students.add((student_uri, SCHEMA.name, Literal(row["student_name"])))

    # Cours
    g_students.add((course_uri, RDF.type, SCHEMA.Course))
    g_students.add((course_uri, SCHEMA.name, Literal(row["course_name"])))

    # Professeur
    g_students.add((prof_uri, RDF.type, SCHEMA.Person))
    g_students.add((prof_uri, SCHEMA.name, Literal(row["professor"])))
    g_students.add((course_uri, EX.taughtBy, prof_uri))

    # Inscription : noeud intermediaire (blank node) pour stocker la note
    enrollment = BNode()
    g_students.add((enrollment, RDF.type, EX.Enrollment))
    g_students.add((enrollment, EX.student, student_uri))
    g_students.add((enrollment, EX.enrolledIn, course_uri))
    g_students.add((enrollment, EX.hasGrade, Literal(row["grade"], datatype=XSD.integer)))

print(f"Graphe etudiant cree : {len(g_students)} triplets")

# Etape 3 : Verifier avec une requete SPARQL
sparql_check = """
PREFIX schema: <http://schema.org/>
PREFIX ex: <http://example.org/vocab/>

SELECT ?student_name ?course_name ?grade
WHERE {
    ?enrollment a ex:Enrollment ;
                ex:student ?student ;
                ex:enrolledIn ?course ;
                ex:hasGrade ?grade .
    ?student schema:name ?student_name .
    ?course schema:name ?course_name .
}
ORDER BY ?student_name ?course_name
"""

print("=== Inscriptions et notes ===")
for row in g_students.query(sparql_check):
    print(f"  {row.student_name} -> {row.course_name} : {row.grade}/20")
student_name course_name grade professor
0 Alice Dupont Web Semantique 16 Prof. Durand
1 Bob Martin Web Semantique 14 Prof. Durand
2 Claire Leroy Intelligence Artificielle 18 Prof. Moreau
3 Alice Dupont Intelligence Artificielle 15 Prof. Moreau
4 Bob Martin Bases de Donnees 12 Prof. Petit
Graphe etudiant cree : 41 triplets
=== Inscriptions et notes ===
Alice Dupont -> Intelligence Artificielle : 15/20
Alice Dupont -> Web Semantique : 16/20
Bob Martin -> Bases de Donnees : 12/20
Bob Martin -> Web Semantique : 14/20
Claire Leroy -> Intelligence Artificielle : 18/20Exemple guide 2 : Visualiser le KG filtre par realisateur
En reprenant le code de la section 3.4, modifions la requête SPARQL pour filtrer les films de Quentin Tarantino et visualisons le sous-graphe resultant.
Bonus demontre : Les notes des films sont utilisees comme taille des noeuds (film mieux note = noeud plus gros).
# Exemple guide 2 : Sous-graphe de Quentin Tarantino
# Modifiez la requete filter_query de la section 3.4
# Remplacez "Christopher Nolan" par "Quentin Tarantino"
# Visualisez le resultat

import matplotlib.pyplot as plt
import matplotlib.patches as mpatches

tarantino_query = """
PREFIX schema: <http://schema.org/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?movie_title ?rel_type ?target_name ?rating
WHERE {
    ?movie a schema:Movie ;
           schema:name ?movie_title ;
           schema:director ?director .
    ?director schema:name "Quentin Tarantino" .
    OPTIONAL { ?movie schema:aggregateRating ?rating . }
    {
        ?movie schema:actor ?person .
        ?person schema:name ?target_name .
        BIND("actor" AS ?rel_type)
    }
    UNION
    {
        ?movie schema:genre ?genre .
        ?genre rdfs:label ?target_name .
        BIND("genre" AS ?rel_type)
    }
    UNION
    {
        ?movie schema:director ?dir .
        ?dir schema:name ?target_name .
        BIND("director" AS ?rel_type)
    }
}
"""

G_tarantino = nx.DiGraph()
tarantino_types = {}
movie_ratings = {}

for row in g.query(tarantino_query):
    movie = str(row.movie_title)
    target = str(row.target_name)
    rel = str(row.rel_type)
    tarantino_types[movie] = "movie"
    tarantino_types[target] = "genre" if rel == "genre" else "person"
    G_tarantino.add_edge(movie, target, relation=rel)
    if row.rating is not None:
        movie_ratings[movie] = float(str(row.rating))

# Bonus : taille des noeuds film proportionnelle a la note
def tarantino_node_size(n):
    if tarantino_types.get(n) == "movie":
        rating = movie_ratings.get(n, 7.0)
        return int(600 * (rating / 7.0))
    return 500

t_color_map = {"movie": "#6BAED6", "person": "#74C476", "genre": "#FD8D3C"}
t_edge_color_map = {"director": "#E41A1C", "actor": "#377EB8", "genre": "#FF7F00"}

tarantino_colors = [t_color_map.get(tarantino_types.get(n, "movie"), "#CCC") for n in G_tarantino.nodes()]
tarantino_sizes = [tarantino_node_size(n) for n in G_tarantino.nodes()]
tarantino_edge_colors = [t_edge_color_map.get(G_tarantino.edges[e].get("relation", ""), "#999")
                         for e in G_tarantino.edges()]

pos_tarantino = nx.spring_layout(G_tarantino, k=3.0, iterations=50, seed=42)

fig, ax = plt.subplots(1, 1, figsize=(14, 9))
nx.draw_networkx_edges(G_tarantino, pos_tarantino, ax=ax, edge_color=tarantino_edge_colors,
                       alpha=0.7, arrows=True, arrowsize=18,
                       connectionstyle="arc3,rad=0.1")
nx.draw_networkx_nodes(G_tarantino, pos_tarantino, ax=ax, node_color=tarantino_colors,
                       node_size=tarantino_sizes, alpha=0.9, edgecolors="#333",
                       linewidths=1.5)
nx.draw_networkx_labels(G_tarantino, pos_tarantino, ax=ax, font_size=9, font_weight="bold")

legend_items = [
    mpatches.Patch(color="#6BAED6", label="Film (taille proportionnelle a la note)"),
    mpatches.Patch(color="#74C476", label="Personne"),
    mpatches.Patch(color="#FD8D3C", label="Genre"),
]
ax.legend(handles=legend_items, loc="upper left", fontsize=10)
ax.set_title("Filmographie de Quentin Tarantino - Sous-graphe du KG",
             fontsize=13, fontweight="bold")
ax.axis("off")
plt.tight_layout()
plt.show()
plt.close()

print(f"Sous-graphe Tarantino : {G_tarantino.number_of_nodes()} noeuds, {G_tarantino.number_of_edges()} aretes")
if movie_ratings:
    print("Notes des films :")
    for movie, rating in sorted(movie_ratings.items()):
        print(f"  {movie} : {rating}")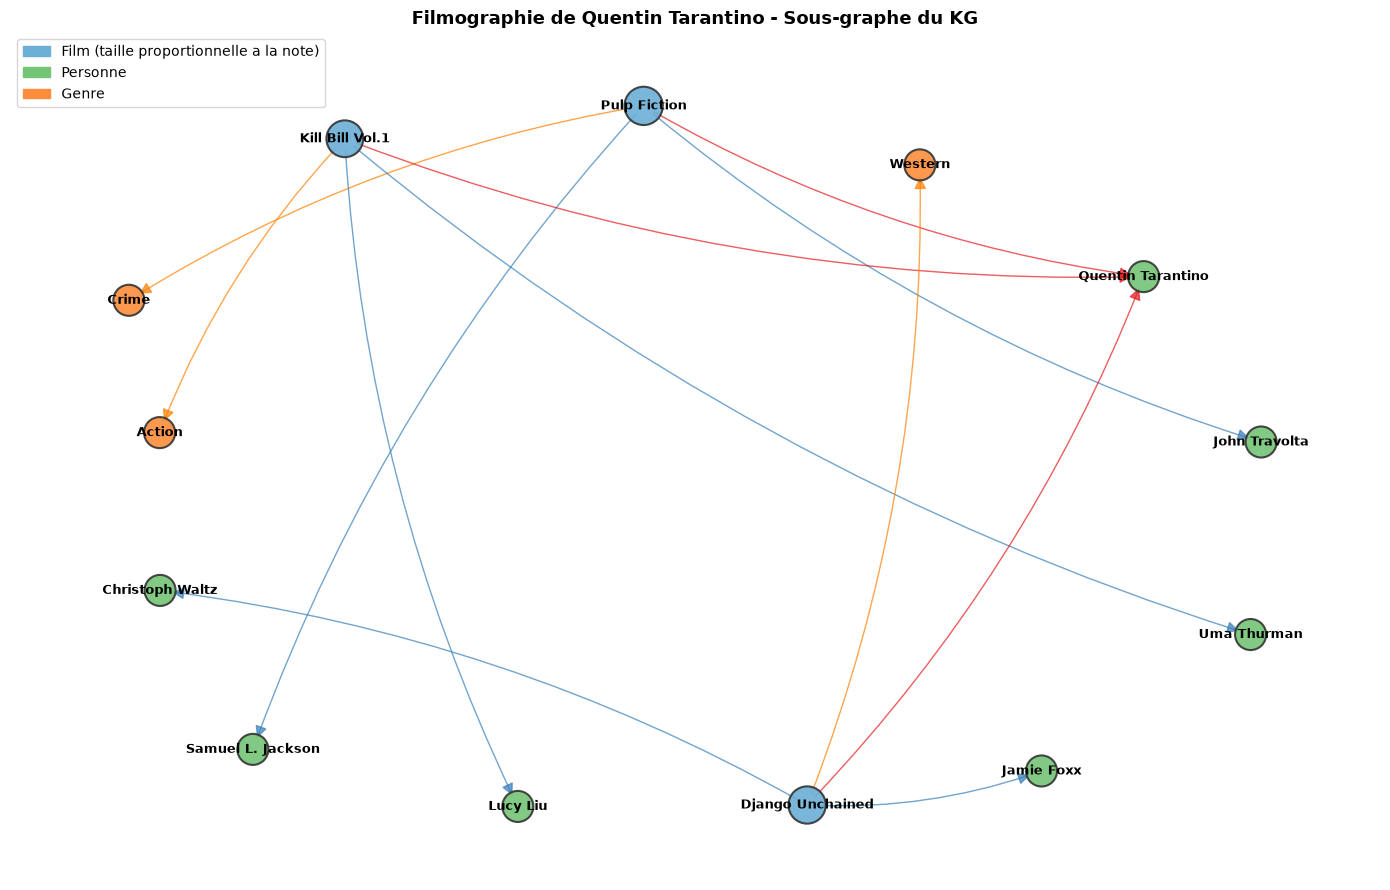
Sous-graphe Tarantino : 13 noeuds, 12 aretes
Notes des films :
  Django Unchained : 8.4
  Kill Bill Vol.1 : 8.2
  Pulp Fiction : 8.9
Exemple guide 3 : Charger et raisonner avec OWLReady2
Chargons l’ontologie data/university.owl avec OWLReady2, puis : 1. Ajoutons programmatiquement un nouvel etudiant (instance de GraduateStudent) 2. Inscrivons-le a un cours existant 3. Lancons le raisonneur HermiT 4. Verifions que le raisonneur infere bien qu’il est aussi Student et Person
Technique demontree : onto.GraduateStudent("new_student") pour créer une instance, puis sync_reasoner_hermit() pour le raisonnement.
import os
import shutil

# Exemple guide 3 : Ajouter un etudiant et raisonner

if OWLREADY_AVAILABLE:
    # Detecter un JRE (HermiT necessite Java accessible)
    java_exe = shutil.which("java")
    if java_exe:
        owlready2.JAVA_EXE = java_exe

    # Recharger l ontologie pour repartir d un etat propre
    owlready2.default_world = owlready2.World()
    onto2 = owlready2.get_ontology(f"file://{onto_path}").load()

    # Etape 1 : Creer un nouvel etudiant (instance de GraduateStudent)
    with onto2:
        new_student = onto2.GraduateStudent("etudiant_lefevre")

    print("=== Avant raisonnement ===")
    types_before = [t.name for t in new_student.is_a if hasattr(t, "name")]
    print(f"  Types declares de {new_student.name} : {types_before}")

    # Etape 2 : L inscrire a un cours existant (course_web_sem)
    with onto2:
        course_ws = onto2.search_one(iri="*course_web_sem")
        if course_ws:
            new_student.enrolledIn.append(course_ws)
            print(f"  Inscription au cours : {course_ws.iri.split('#')[-1]}")
        else:
            print("  Cours non trouve.")

    # Etape 3 : Lancer le raisonneur HermiT (avec fallback si JRE absent)
    if java_exe is None:
        print("Raisonneur OWL (HermiT) ignore : JRE non detecte sur cette machine.")
        print("(inference OWL necessite pip install JPype1 + JRE JAVA_HOME)")
        print("Hierarchie via owlready2 (sans inference) :")
        parents = [p.name for p in onto2.GraduateStudent.ancestors() if hasattr(p, "name")]
        print(f"  GraduateStudent herite de : {parents}")
    else:
        try:
            print("Lancement du raisonneur HermiT...")
            with onto2:
                owlready2.sync_reasoner_hermit(infer_property_values=True, debug=0)
            print("Raisonnement termine.")

            # Etape 4 : Verifier les types inferes
            print("=== Apres raisonnement ===")
            types_after = [t.name for t in new_student.INDIRECT_is_a if hasattr(t, "name")]
            print(f"  Types inferes pour {new_student.name} : {types_after}")

            inferred = set(types_after)
            for expected in ["Student", "Person"]:
                status = "correctement infere" if expected in inferred else "non infere"
                print(f"  -> '{expected}' : {status}")
        except Exception as e:
            print(f"Erreur lors du raisonnement : {e}")
            print("Verification de la hierarchie sans raisonneur :")
            parents = [p.name for p in onto2.GraduateStudent.ancestors() if hasattr(p, "name")]
            print(f"  GraduateStudent herite de : {parents}")
else:
    print("OWLReady2 non disponible. Section ignoree.")
=== Avant raisonnement ===
Types declares de etudiant_lefevre : ['GraduateStudent']
Inscription au cours : course_web_sem
Lancement du raisonneur HermiT...
Raisonnement termine.
=== Apres raisonnement ===
Types inferes pour etudiant_lefevre : ['GraduateStudent', 'Student', 'Thing', 'Person']
-> 'Student' : correctement infere
-> 'Person' : correctement infereResume
| Élément | Ce que nous avons appris |
|---|---|
| Knowledge Graph | Graphe d’entites + relations + ontologie, adopte massivement en industrie |
| Construction CSV -> RDF | pandas + rdflib pour transformer des données tabulaires en triplets |
| kglab (annexe B) | Couche d’abstraction Python, SPARQL -> DataFrame en une ligne |
| Visualisation NetworkX | Graphes statiques avec couleurs par type et layout spring |
| Visualisation pyvis | Graphes interactifs HTML pour l’exploration |
| OWLReady2 (annexe C) | Manipulation d’ontologies OWL + raisonneur HermiT integre |
| Qualité (annexe D)e du KG | Completude, coherence, unicite – SHACL pour formaliser |
Ce qui change par rapport aux notebooks précédents
| Avant (SW-1 a SW-10) | Maintenant (SW-11) |
|---|---|
| Triplets individuels | Knowledge Graph structure |
| Graphe comme stockage | Graphe comme outil d’analyse |
| Visualisation textuelle | Visualisation graphique (NetworkX, pyvis) |
| Ontologie théorique | Raisonnement automatise (HermiT) |
| Validation manuelle | Pipeline de qualite |
Prochaine étape
Dans le notebook suivant (SW-12-GraphRAG), nous verrons comment combiner un Knowledge Graph avec un LLM pour créer un système de question-reponse augmente par le graphe (GraphRAG) – la convergence entre IA symbolique et IA neuronale. Ces competences constituent aussi le socle technique du raisonnement avance sur donnees liees.
Navigation : << 10-RDFStar | Index | 12-GraphRAG >>
Exemple guide 4 : Construire et interroger un Knowledge Graph complet (jeux video)
Construisons un Knowledge Graph complet sur le domaine des jeux video, en combinant toutes les techniques vues dans ce notebook.
Techniques demontrees : - Au moins 20 triplets RDF dans le graphe - 3 types d’entites différents (jeux, developpeurs, genres) - 3 requêtes SPARQL : SELECT, FILTER, et une agregation (COUNT + AVG) - Visualisation du graphe avec networkx et matplotlib
# construire et interroger votre Knowledge Graph
from rdflib import Graph, Namespace, URIRef, Literal
from rdflib.namespace import RDF, RDFS, XSD
import re
import networkx as nx
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches

# Etape 1 : creer le graphe et le namespace (Graph, Namespace, bind)
GAME = Namespace("http://example.org/games/")
DEV_NS = Namespace("http://example.org/developers/")
GENRE_NS = Namespace("http://example.org/genres/")
VOCAB = Namespace("http://example.org/vocab/")

g_games = Graph()
g_games.bind("game", GAME)
g_games.bind("dev", DEV_NS)
g_games.bind("genre", GENRE_NS)
g_games.bind("vocab", VOCAB)

def game_id(name):
    return re.sub(r"[^a-zA-Z0-9_]", "", name.strip().replace(" ", "_"))

# Etape 2 : ajouter au moins 20 triplets sur le domaine des jeux video
games_data = [
    {"title": "The Legend of Zelda",   "year": 2017, "developer": "Nintendo",          "genre": "Action-Aventure", "score": 9.7},
    {"title": "Red Dead Redemption 2",  "year": 2018, "developer": "Rockstar Games",    "genre": "Action",          "score": 9.7},
    {"title": "The Witcher 3",          "year": 2015, "developer": "CD Projekt Red",    "genre": "RPG",             "score": 9.3},
    {"title": "Dark Souls",             "year": 2011, "developer": "FromSoftware",      "genre": "Action-RPG",      "score": 9.1},
    {"title": "God of War",             "year": 2018, "developer": "Santa Monica",      "genre": "Action-Aventure", "score": 9.6},
    {"title": "Hollow Knight",          "year": 2017, "developer": "Team Cherry",       "genre": "Metroidvania",    "score": 9.0},
    {"title": "Celeste",                "year": 2018, "developer": "Maddy Makes Games", "genre": "Platformer",      "score": 8.8},
]

for game in games_data:
    game_uri = GAME[game_id(game["title"])]
    dev_uri = DEV_NS[game_id(game["developer"])]
    genre_uri = GENRE_NS[game_id(game["genre"])]

    g_games.add((game_uri, RDF.type, VOCAB.VideoGame))
    g_games.add((game_uri, RDFS.label, Literal(game["title"])))
    g_games.add((game_uri, VOCAB.releaseYear, Literal(game["year"], datatype=XSD.integer)))
    g_games.add((game_uri, VOCAB.criticScore, Literal(game["score"], datatype=XSD.float)))
    g_games.add((game_uri, VOCAB.developedBy, dev_uri))
    g_games.add((game_uri, VOCAB.hasGenre, genre_uri))

    g_games.add((dev_uri, RDF.type, VOCAB.Developer))
    g_games.add((dev_uri, RDFS.label, Literal(game["developer"])))

    g_games.add((genre_uri, RDF.type, VOCAB.Genre))
    g_games.add((genre_uri, RDFS.label, Literal(game["genre"])))

print(f"Knowledge Graph jeux video : {len(g_games)} triplets")

# Etape 3 : ecrire au moins 3 requetes SPARQL (SELECT par type, FILTER numerique, COUNT)

# Requete 1 : SELECT - tous les jeux avec leur developpeur et annee de sortie
query1 = (
    "PREFIX vocab: <http://example.org/vocab/>\n"
    "PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>\n"
    "\n"
    "SELECT ?titre ?developpeur ?annee\n"
    "WHERE {\n"
    "    ?jeu a vocab:VideoGame ;\n"
    "         rdfs:label ?titre ;\n"
    "         vocab:releaseYear ?annee ;\n"
    "         vocab:developedBy ?dev .\n"
    "    ?dev rdfs:label ?developpeur .\n"
    "}\n"
    "ORDER BY ?annee\n"
)
print("\n=== Requete 1 : Jeux par annee ===")
for row in g_games.query(query1):
    print(f"  {row.annee}  {row.titre} ({row.developpeur})")

# Requete 2 : FILTER - jeux avec score critique superieur a 9.5
query2 = (
    "PREFIX vocab: <http://example.org/vocab/>\n"
    "PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>\n"
    "PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>\n"
    "\n"
    "SELECT ?titre ?score\n"
    "WHERE {\n"
    "    ?jeu a vocab:VideoGame ;\n"
    "         rdfs:label ?titre ;\n"
    "         vocab:criticScore ?score .\n"
    "    FILTER (?score > 9.5)\n"
    "}\n"
    "ORDER BY DESC(?score)\n"
)
print("\n=== Requete 2 : Jeux avec score > 9.5 ===")
for row in g_games.query(query2):
    print(f"  {row.titre} : {row.score}/10")

# Requete 3 : COUNT + AVG - nombre de jeux et score moyen par genre
query3 = (
    "PREFIX vocab: <http://example.org/vocab/>\n"
    "PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>\n"
    "\n"
    "SELECT ?genre (COUNT(?jeu) AS ?nb_jeux) (AVG(?score) AS ?score_moyen)\n"
    "WHERE {\n"
    "    ?jeu a vocab:VideoGame ;\n"
    "         vocab:hasGenre ?g ;\n"
    "         vocab:criticScore ?score .\n"
    "    ?g rdfs:label ?genre .\n"
    "}\n"
    "GROUP BY ?genre\n"
    "ORDER BY DESC(?nb_jeux)\n"
)
print("\n=== Requete 3 : Jeux par genre (avec score moyen) ===")
for row in g_games.query(query3):
    print(f"  {row.genre} : {int(str(row.nb_jeux))} jeu(x), score moyen = {float(str(row.score_moyen)):.2f}")

# Etape 4 (bonus) : visualiser le graphe avec networkx et matplotlib
G_viz = nx.DiGraph()
node_types_games = {}
scores_map = {g["title"]: g["score"] for g in games_data}

for game in games_data:
    title = game["title"]
    dev = game["developer"]
    genre = game["genre"]
    node_types_games[title] = "game"
    node_types_games[dev] = "developer"
    node_types_games[genre] = "genre"
    G_viz.add_edge(title, dev, relation="developedBy")
    G_viz.add_edge(title, genre, relation="hasGenre")

color_map_g = {"game": "#6BAED6", "developer": "#74C476", "genre": "#FD8D3C"}
node_colors_g = [color_map_g.get(node_types_games.get(n, "game"), "#CCC") for n in G_viz.nodes()]
node_sizes_g = [
    int(500 * (scores_map.get(n, 7.0) / 7.0)) if node_types_games.get(n) == "game" else 600
    for n in G_viz.nodes()
]

pos_g = nx.spring_layout(G_viz, k=2.5, iterations=50, seed=42)
fig, ax = plt.subplots(figsize=(14, 8))
nx.draw_networkx_edges(G_viz, pos_g, ax=ax, alpha=0.6, arrows=True, arrowsize=15,
                       connectionstyle="arc3,rad=0.1")
nx.draw_networkx_nodes(G_viz, pos_g, ax=ax, node_color=node_colors_g, node_size=node_sizes_g,
                       alpha=0.9, edgecolors="#333", linewidths=1.5)
nx.draw_networkx_labels(G_viz, pos_g, ax=ax, font_size=8, font_weight="bold")

legend_items_g = [
    mpatches.Patch(color="#6BAED6", label="Jeu video (taille ~ score critique)"),
    mpatches.Patch(color="#74C476", label="Developpeur"),
    mpatches.Patch(color="#FD8D3C", label="Genre"),
]
ax.legend(handles=legend_items_g, loc="upper left", fontsize=10)
ax.set_title("Knowledge Graph des Jeux Video", fontsize=14, fontweight="bold")
ax.axis("off")
plt.tight_layout()
plt.show()
plt.close()
Knowledge Graph jeux video : 68 triplets
=== Requete 1 : Jeux par annee ===
2011 Dark Souls (FromSoftware)
2015 The Witcher 3 (CD Projekt Red)
2017 The Legend of Zelda (Nintendo)
2017 Hollow Knight (Team Cherry)
2018 Red Dead Redemption 2 (Rockstar Games)
2018 God of War (Santa Monica)
2018 Celeste (Maddy Makes Games)
=== Requete 2 : Jeux avec score > 9.5 ===
The Legend of Zelda : 9.7/10
Red Dead Redemption 2 : 9.7/10
God of War : 9.6/10
=== Requete 3 : Jeux par genre (avec score moyen) ===
Action-Aventure : 2 jeu(x), score moyen = 9.65
Action : 1 jeu(x), score moyen = 9.70
RPG : 1 jeu(x), score moyen = 9.30
Action-RPG : 1 jeu(x), score moyen = 9.10
Metroidvania : 1 jeu(x), score moyen = 9.00
Platformer : 1 jeu(x), score moyen = 8.80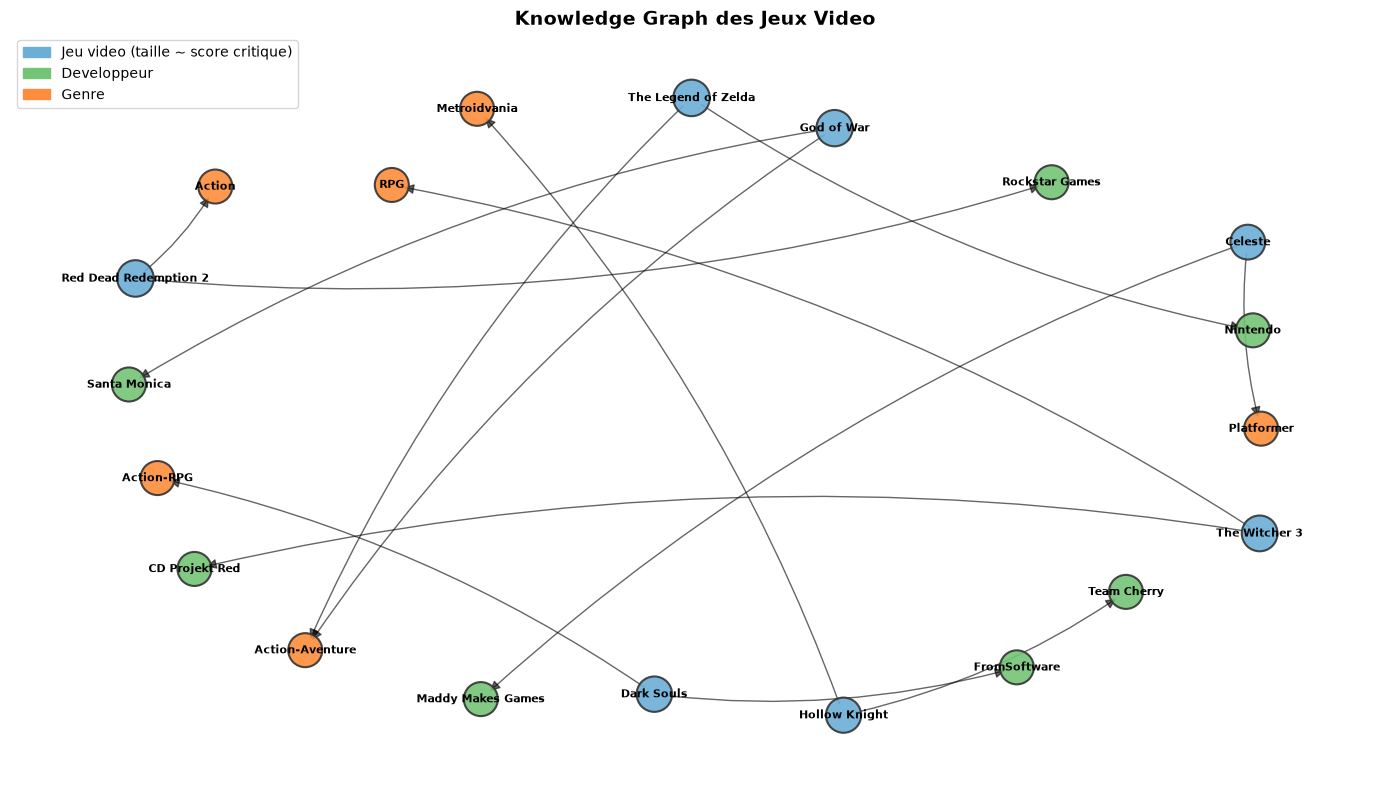
Exemples guides (solutions proposees par @Sosolalt)
Les exemples ci-dessous ont ete resolus par @Sosolalt (EPITA-IS, promo 2028). Ils servent de modèle pour comprendre les concepts abordes dans ce notebook.
Exemple guide 5 : Ajouter des proprietes au KG etudiants/cours
Solution proposee par @Sosolalt (EPITA-IS, promo 2028).
# Exemple guide 5 : Ajouter des proprietes au KG etudiants/cours

# 1. Ajouter une propriete ex:hasEmail (datatype property) pour chaque etudiant
emails = {
    "Alice Dupont": "alice.dupont@univ.fr",
    "Bob Martin": "bob.martin@univ.fr",
    "Claire Leroy": "claire.leroy@univ.fr",
}
for name, email in emails.items():
    g_students.add((UNI[to_uri_id(name)], EX.hasEmail, Literal(email)))

print("Emails ajoutes :")
for name, email in emails.items():
    print(f"  {name:<15} -> {email}")

# 2. Moyenne generale de chaque etudiant (AVG + GROUP BY)
query_avg = """
PREFIX schema: <http://schema.org/>
PREFIX ex: <http://example.org/vocab/>

SELECT ?student_name (AVG(?grade) AS ?moyenne) (COUNT(?course) AS ?nb_cours)
WHERE {
    ?enrollment a ex:Enrollment ;
                ex:student ?student ;
                ex:enrolledIn ?course ;
                ex:hasGrade ?grade .
    ?student schema:name ?student_name .
}
GROUP BY ?student_name
ORDER BY DESC(?moyenne)
"""
print("\n=== Moyenne generale par etudiant ===")
for row in g_students.query(query_avg):
    print(f"  {str(row.student_name):<15} : {float(row.moyenne):.2f}/20 ({int(row.nb_cours)} cours)")

# 3. Etudiant avec la meilleure moyenne (ORDER BY DESC + LIMIT 1)
query_best = """
PREFIX schema: <http://schema.org/>
PREFIX ex: <http://example.org/vocab/>

SELECT ?student_name (AVG(?grade) AS ?moyenne)
WHERE {
    ?enrollment a ex:Enrollment ;
                ex:student ?student ;
                ex:hasGrade ?grade .
    ?student schema:name ?student_name .
}
GROUP BY ?student_name
ORDER BY DESC(?moyenne)
LIMIT 1
"""
print("\n=== Meilleure moyenne ===")
for row in g_students.query(query_best):
    print(f"  {str(row.student_name)} avec {float(row.moyenne):.2f}/20")
Emails ajoutes :
Alice Dupont -> alice.dupont@univ.fr
Bob Martin -> bob.martin@univ.fr
Claire Leroy -> claire.leroy@univ.fr
=== Moyenne generale par etudiant ===
Claire Leroy : 18.00/20 (1 cours)
Alice Dupont : 15.50/20 (2 cours)
Bob Martin : 13.00/20 (2 cours)
=== Meilleure moyenne ===
Claire Leroy avec 18.00/20Exemple guide 6 : Visualiser le KG filtre par genre
Solution proposee par @Sosolalt (EPITA-IS, promo 2028).
# Exemple guide 6 : Visualiser le KG filtre par genre (Science-Fiction)

import matplotlib.pyplot as plt
import matplotlib.patches as mpatches

# 1. Requete SPARQL : films de genre Science-Fiction avec acteurs, realisateurs et genre
scifi_query = """
PREFIX schema: <http://schema.org/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?movie_title ?rel_type ?target_name ?rating
WHERE {
    ?movie a schema:Movie ;
           schema:name ?movie_title ;
           schema:genre ?gfilter .
    ?gfilter rdfs:label "Science-Fiction"@fr .
    OPTIONAL { ?movie schema:aggregateRating ?rating . }
    {
        ?movie schema:actor ?person .
        ?person schema:name ?target_name .
        BIND("actor" AS ?rel_type)
    }
    UNION
    {
        ?movie schema:genre ?genre .
        ?genre rdfs:label ?target_name .
        BIND("genre" AS ?rel_type)
    }
    UNION
    {
        ?movie schema:director ?dir .
        ?dir schema:name ?target_name .
        BIND("director" AS ?rel_type)
    }
}
"""

# 2. Construire le graphe NetworkX
G_scifi = nx.DiGraph()
scifi_types = {}
scifi_ratings = {}

for row in g.query(scifi_query):
    movie = str(row.movie_title)
    target = str(row.target_name)
    rel = str(row.rel_type)
    scifi_types[movie] = "movie"
    scifi_types[target] = "genre" if rel == "genre" else "person"
    G_scifi.add_edge(movie, target, relation=rel)
    if row.rating is not None:
        scifi_ratings[movie] = float(str(row.rating))

# 3. Visualisation matplotlib (couleurs par type, taille film ~ note)
def scifi_node_size(n):
    if scifi_types.get(n) == "movie":
        rating = scifi_ratings.get(n, 7.0)
        return int(600 * (rating / 7.0))
    return 500

color_map = {"movie": "#6BAED6", "person": "#74C476", "genre": "#FD8D3C"}
edge_color_map = {"director": "#E41A1C", "actor": "#377EB8", "genre": "#FF7F00"}

scifi_colors = [color_map.get(scifi_types.get(n, "movie"), "#CCC") for n in G_scifi.nodes()]
scifi_sizes = [scifi_node_size(n) for n in G_scifi.nodes()]
scifi_edge_colors = [edge_color_map.get(G_scifi.edges[e].get("relation", ""), "#999")
                     for e in G_scifi.edges()]

pos_scifi = nx.spring_layout(G_scifi, k=3.0, iterations=50, seed=42)

fig, ax = plt.subplots(1, 1, figsize=(14, 9))
nx.draw_networkx_edges(G_scifi, pos_scifi, ax=ax, edge_color=scifi_edge_colors,
                       alpha=0.7, arrows=True, arrowsize=18,
                       connectionstyle="arc3,rad=0.1")
nx.draw_networkx_nodes(G_scifi, pos_scifi, ax=ax, node_color=scifi_colors,
                       node_size=scifi_sizes, alpha=0.9, edgecolors="#333",
                       linewidths=1.5)
nx.draw_networkx_labels(G_scifi, pos_scifi, ax=ax, font_size=9, font_weight="bold")

legend_items = [
    mpatches.Patch(color="#6BAED6", label="Film (taille proportionnelle a la note)"),
    mpatches.Patch(color="#74C476", label="Personne"),
    mpatches.Patch(color="#FD8D3C", label="Genre"),
]
ax.legend(handles=legend_items, loc="upper left", fontsize=10)
ax.set_title("Films de Science-Fiction - Sous-graphe du KG", fontsize=13, fontweight="bold")
ax.axis("off")
plt.tight_layout()
plt.show()
plt.close()

print(f"Sous-graphe Science-Fiction : {G_scifi.number_of_nodes()} noeuds, {G_scifi.number_of_edges()} aretes")
if scifi_ratings:
    print("Notes des films :")
    for movie, rating in sorted(scifi_ratings.items()):
        print(f"  {movie} : {rating}")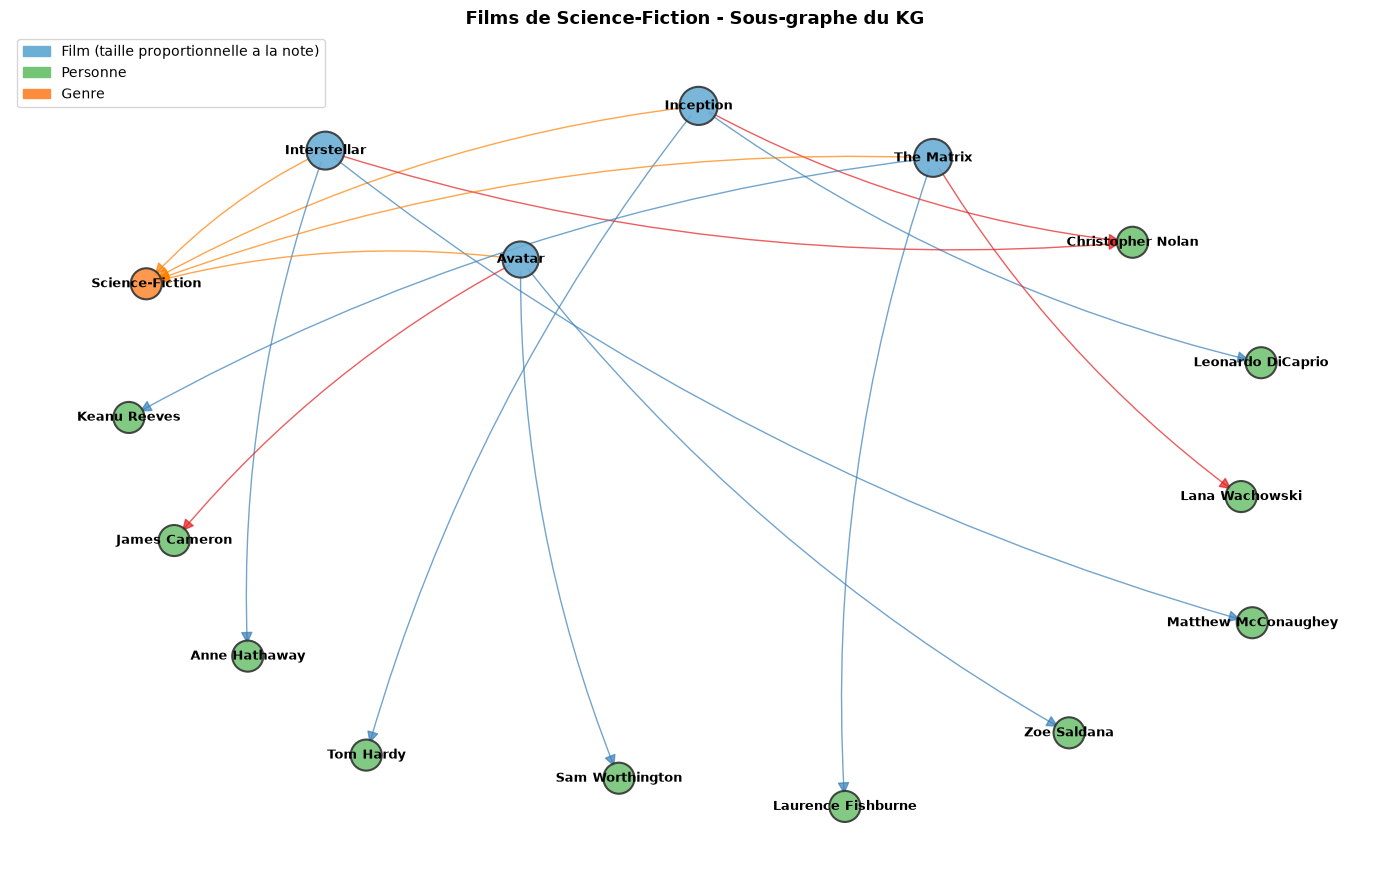
Sous-graphe Science-Fiction : 16 noeuds, 16 aretes
Notes des films :
  Avatar : 7.9
  Inception : 8.8
  Interstellar : 8.7
  The Matrix : 8.7
Exemple guide 7 : Explorer l ontologie et verifier les contraintes
Solution proposee par @Sosolalt (EPITA-IS, promo 2028).
# Exemple guide 7 : Explorer l'ontologie et verifier les contraintes

if OWLREADY_AVAILABLE:
    import shutil

    # 1. Lister toutes les instances de Student (y compris les sous-classes)
    #    GraduateStudent est sous-classe de Student : on parcourt Student et ses descendants.
    student_classes = [onto2.Student] + list(onto2.Student.descendants(include_self=False))
    instances_student = set()
    for cls in student_classes:
        instances_student.update(cls.instances())
    print("=== 1. Instances de Student (sous-classes incluses) ===")
    for ind in sorted(instances_student, key=lambda x: x.name):
        types = [t.name for t in ind.is_a if hasattr(t, "name")]
        print(f"  {ind.name} (types declares : {types})")

    # 2. Professeurs qui enseignent a des etudiants de niveau Graduate
    #    On croise teaches (prof -> cours) et enrolledIn (etudiant -> cours).
    print("\n=== 2. Professeurs enseignant a des GraduateStudent ===")
    grad_instances = set(onto2.GraduateStudent.instances())
    found = False
    for prof in onto2.Professor.instances():
        cours_enseignes = set(prof.teaches)
        for grad in grad_instances:
            if cours_enseignes & set(grad.enrolledIn):
                communs = cours_enseignes & set(grad.enrolledIn)
                noms = [c.name for c in communs]
                print(f"  {prof.name} enseigne a {grad.name} (cours : {noms})")
                found = True
    if not found:
        print("  Aucun professeur ne partage de cours avec un GraduateStudent inscrit.")

    # 3. Violer la disjonction Student/Professor et verifier avec le raisonneur
    print("\n=== 3. Violation de la disjonction Professor/Student ===")
    print("  (l'ontologie declare : Professor disjointWith Student)")
    try:
        # Corriger le chemin Java au besoin (HermiT, le raisonneur par defaut)
        java_path = shutil.which("java")
        if java_path:
            owlready2.JAVA_EXE = java_path

        # World isole : on recharge l'ontologie pour un test propre et reproductible
        check_world = owlready2.World()
        onto_check = check_world.get_ontology("file://" + onto_path).load()
        with onto_check:
            # Un individu a la fois Student ET Professor -> viole la disjonction
            conflit = onto_check.Student("etudiant_et_prof")
            conflit.is_a.append(onto_check.Professor)

        # HermiT (OWL 2 DL) sur ce world isole
        owlready2.sync_reasoner_hermit(check_world, debug=0)
        print("  Aucune incoherence detectee par le raisonneur (inattendu).")
    except owlready2.OwlReadyInconsistentOntologyError:
        print("  Incoherence detectee par le raisonneur HermiT : un individu ne peut")
        print("  etre a la fois Student et Professor (classes disjointes). Resultat attendu.")
    except Exception as e:
        print(f"  Raisonneur indisponible ({type(e).__name__}). "
              "La disjonction reste declaree dans l'ontologie :")
        print("    Professor disjointWith Student")
else:
    print("OWLReady2 non disponible. Section ignoree.")
=== 1. Instances de Student (sous-classes incluses) ===
etud_bernard (types declares : ['Student'])
etud_martin (types declares : ['GraduateStudent'])
etudiant_lefevre (types declares : ['GraduateStudent'])
=== 2. Professeurs enseignant a des GraduateStudent ===
prof_dupont enseigne a etud_martin (cours : ['course_ia', 'course_web_sem'])
prof_dupont enseigne a etudiant_lefevre (cours : ['course_web_sem'])
=== 3. Violation de la disjonction Professor/Student ===
(l'ontologie declare : Professor disjointWith Student)
Incoherence detectee par le raisonneur HermiT : un individu ne peut
etre a la fois Student et Professor (classes disjointes). Resultat attendu.Exemple guide 8 : Construire votre propre Knowledge Graph
Solution proposee par @Sosolalt (EPITA-IS, promo 2028).
# Exemple guide 8 : Construire votre propre Knowledge Graph (domaine : musique)

from rdflib import Graph, Namespace, Literal
from rdflib.namespace import RDF, RDFS, XSD
import re

MUSIC = Namespace("http://example.org/music/")
ARTIST = Namespace("http://example.org/artists/")
MGENRE = Namespace("http://example.org/mgenres/")
MVOCAB = Namespace("http://example.org/mvocab/")

def music_id(name):
    return re.sub(r"[^a-zA-Z0-9_]", "", name.strip().replace(" ", "_"))

g_music = Graph()
g_music.bind("music", MUSIC)
g_music.bind("artist", ARTIST)
g_music.bind("mgenre", MGENRE)
g_music.bind("mvocab", MVOCAB)

# Au moins 15 triplets, 3 types d'entites (Album, Artist, Genre)
albums_data = [
    {"title": "Random Access Memories", "year": 2013, "artist": "Daft Punk",     "genre": "Electro",  "score": 9.0},
    {"title": "OK Computer",            "year": 1997, "artist": "Radiohead",     "genre": "Rock",     "score": 9.5},
    {"title": "Discovery",              "year": 2001, "artist": "Daft Punk",     "genre": "Electro",  "score": 9.2},
    {"title": "Thriller",               "year": 1982, "artist": "Michael Jackson","genre": "Pop",     "score": 9.4},
    {"title": "In Rainbows",            "year": 2007, "artist": "Radiohead",     "genre": "Rock",     "score": 9.1},
]

for album in albums_data:
    album_uri = MUSIC[music_id(album["title"])]
    artist_uri = ARTIST[music_id(album["artist"])]
    genre_uri = MGENRE[music_id(album["genre"])]

    g_music.add((album_uri, RDF.type, MVOCAB.Album))
    g_music.add((album_uri, RDFS.label, Literal(album["title"])))
    g_music.add((album_uri, MVOCAB.releaseYear, Literal(album["year"], datatype=XSD.integer)))
    g_music.add((album_uri, MVOCAB.rating, Literal(album["score"], datatype=XSD.float)))
    g_music.add((album_uri, MVOCAB.byArtist, artist_uri))
    g_music.add((album_uri, MVOCAB.hasGenre, genre_uri))

    g_music.add((artist_uri, RDF.type, MVOCAB.Artist))
    g_music.add((artist_uri, RDFS.label, Literal(album["artist"])))

    g_music.add((genre_uri, RDF.type, MVOCAB.Genre))
    g_music.add((genre_uri, RDFS.label, Literal(album["genre"])))

print(f"Knowledge Graph musique : {len(g_music)} triplets")

# Requete 1 : SELECT - tous les albums avec artiste et annee
q1 = """
PREFIX mvocab: <http://example.org/mvocab/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>
SELECT ?titre ?artiste ?annee
WHERE {
    ?album a mvocab:Album ;
           rdfs:label ?titre ;
           mvocab:releaseYear ?annee ;
           mvocab:byArtist ?a .
    ?a rdfs:label ?artiste .
}
ORDER BY ?annee
"""
print("\n=== Requete 1 : Albums par annee ===")
for row in g_music.query(q1):
    print(f"  {row.annee}  {row.titre} ({row.artiste})")

# Requete 2 : aggregation - nombre d'albums et note moyenne par genre
q2 = """
PREFIX mvocab: <http://example.org/mvocab/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>
SELECT ?genre (COUNT(?album) AS ?nb) (AVG(?score) AS ?moyenne)
WHERE {
    ?album a mvocab:Album ;
           mvocab:hasGenre ?gn ;
           mvocab:rating ?score .
    ?gn rdfs:label ?genre .
}
GROUP BY ?genre
ORDER BY DESC(?nb)
"""
print("\n=== Requete 2 : Albums par genre (note moyenne) ===")
for row in g_music.query(q2):
    print(f"  {str(row.genre):<10} : {int(row.nb)} album(s), note moyenne = {float(row.moyenne):.2f}")

# Bonus : visualisation networkx
import networkx as nx
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches

G_music = nx.DiGraph()
mtypes = {}
for album in albums_data:
    t, a, gn = album["title"], album["artist"], album["genre"]
    mtypes[t] = "album"; mtypes[a] = "artist"; mtypes[gn] = "genre"
    G_music.add_edge(t, a, relation="byArtist")
    G_music.add_edge(t, gn, relation="hasGenre")

cmap = {"album": "#6BAED6", "artist": "#74C476", "genre": "#FD8D3C"}
colors = [cmap.get(mtypes.get(n, "album"), "#CCC") for n in G_music.nodes()]
pos = nx.spring_layout(G_music, k=2.5, iterations=50, seed=42)
fig, ax = plt.subplots(figsize=(13, 8))
nx.draw_networkx_edges(G_music, pos, ax=ax, alpha=0.6, arrows=True, arrowsize=15,
                       connectionstyle="arc3,rad=0.1")
nx.draw_networkx_nodes(G_music, pos, ax=ax, node_color=colors, node_size=700,
                       alpha=0.9, edgecolors="#333", linewidths=1.5)
nx.draw_networkx_labels(G_music, pos, ax=ax, font_size=8, font_weight="bold")
legend = [
    mpatches.Patch(color="#6BAED6", label="Album"),
    mpatches.Patch(color="#74C476", label="Artiste"),
    mpatches.Patch(color="#FD8D3C", label="Genre"),
]
ax.legend(handles=legend, loc="upper left", fontsize=10)
ax.set_title("Knowledge Graph Musique", fontsize=14, fontweight="bold")
ax.axis("off")
plt.tight_layout()
plt.show()
plt.close()
Knowledge Graph musique : 42 triplets
=== Requete 1 : Albums par annee ===
1982 Thriller (Michael Jackson)
1997 OK Computer (Radiohead)
2001 Discovery (Daft Punk)
2007 In Rainbows (Radiohead)
2013 Random Access Memories (Daft Punk)
=== Requete 2 : Albums par genre (note moyenne) ===
Electro : 2 album(s), note moyenne = 9.10
Rock : 2 album(s), note moyenne = 9.30
Pop : 1 album(s), note moyenne = 9.40
Exemple guide 9 : Centralite dans le Knowledge Graph (PageRank)
Solution proposee par @Sosolalt (EPITA-IS, promo 2028).
# Exemple guide 9 : Centralite dans le Knowledge Graph (PageRank)

import matplotlib.pyplot as plt

# 1. Passer le graphe G (section 3.1) en non oriente
G_und = G.to_undirected()

# 2. Calculer la PageRank
pr_scores = nx.pagerank(G_und)

# 3. Top 5 des entites les plus centrales (PageRank)
top_pr = sorted(pr_scores.items(), key=lambda x: -x[1])[:5]
print("=== Top 5 PageRank ===")
for node, score in top_pr:
    print(f"  {node:<25} [{node_types.get(node, '?'):<7}] PR = {score:.4f}")

# 4. Degree centrality
deg_scores = nx.degree_centrality(G_und)
top_deg = sorted(deg_scores.items(), key=lambda x: -x[1])[:5]
print("\n=== Top 5 Degree centrality ===")
for node, score in top_deg:
    print(f"  {node:<25} [{node_types.get(node, '?'):<7}] deg = {score:.4f}")

# 5. Comparaison des deux classements
set_pr = {n for n, _ in top_pr}
set_deg = {n for n, _ in top_deg}
communs = set_pr & set_deg
print("\n=== Comparaison ===")
print(f"  Entites communes au top 5 : {len(communs)}/5 -> {sorted(communs)}")
if set_pr == set_deg:
    print("  Les deux mesures designent exactement les memes entites.")
else:
    print(f"  Specifiques PageRank : {sorted(set_pr - set_deg)}")
    print(f"  Specifiques Degree   : {sorted(set_deg - set_pr)}")
print("  (PageRank pondere par l'importance des voisins ; le degre compte seulement le nombre de voisins.)")

# Bonus : visualisation avec taille de noeud proportionnelle a la PageRank
color_map = {"movie": "#6BAED6", "person": "#74C476", "genre": "#FD8D3C"}
node_colors = [color_map.get(node_types.get(n, "movie"), "#CCC") for n in G_und.nodes()]
node_sizes = [pr_scores[n] * 15000 for n in G_und.nodes()]

pos = nx.spring_layout(G_und, k=2.5, iterations=50, seed=42)
fig, ax = plt.subplots(figsize=(14, 9))
nx.draw_networkx_edges(G_und, pos, ax=ax, alpha=0.4)
nx.draw_networkx_nodes(G_und, pos, ax=ax, node_color=node_colors, node_size=node_sizes,
                       alpha=0.9, edgecolors="#333", linewidths=1.0)
nx.draw_networkx_labels(G_und, pos, ax=ax, font_size=8, font_weight="bold")
ax.set_title("Centralite PageRank dans le KG films (taille ~ PageRank)",
             fontsize=13, fontweight="bold")
ax.axis("off")
plt.tight_layout()
plt.show()
plt.close()
=== Top 5 PageRank ===
Pulp Fiction [movie ] PR = 0.0443
Django Unchained [movie ] PR = 0.0443
Intouchables [movie ] PR = 0.0424
The Matrix [movie ] PR = 0.0422
Kill Bill Vol.1 [movie ] PR = 0.0410
=== Top 5 Degree centrality ===
Inception [movie ] deg = 0.0889
The Dark Knight [movie ] deg = 0.0889
Interstellar [movie ] deg = 0.0889
Pulp Fiction [movie ] deg = 0.0889
Kill Bill Vol.1 [movie ] deg = 0.0889
=== Comparaison ===
Entites communes au top 5 : 2/5 -> ['Kill Bill Vol.1', 'Pulp Fiction']
Specifiques PageRank : ['Django Unchained', 'Intouchables', 'The Matrix']
Specifiques Degree : ['Inception', 'Interstellar', 'The Dark Knight']
(PageRank pondere par l'importance des voisins ; le degre compte seulement le nombre de voisins.)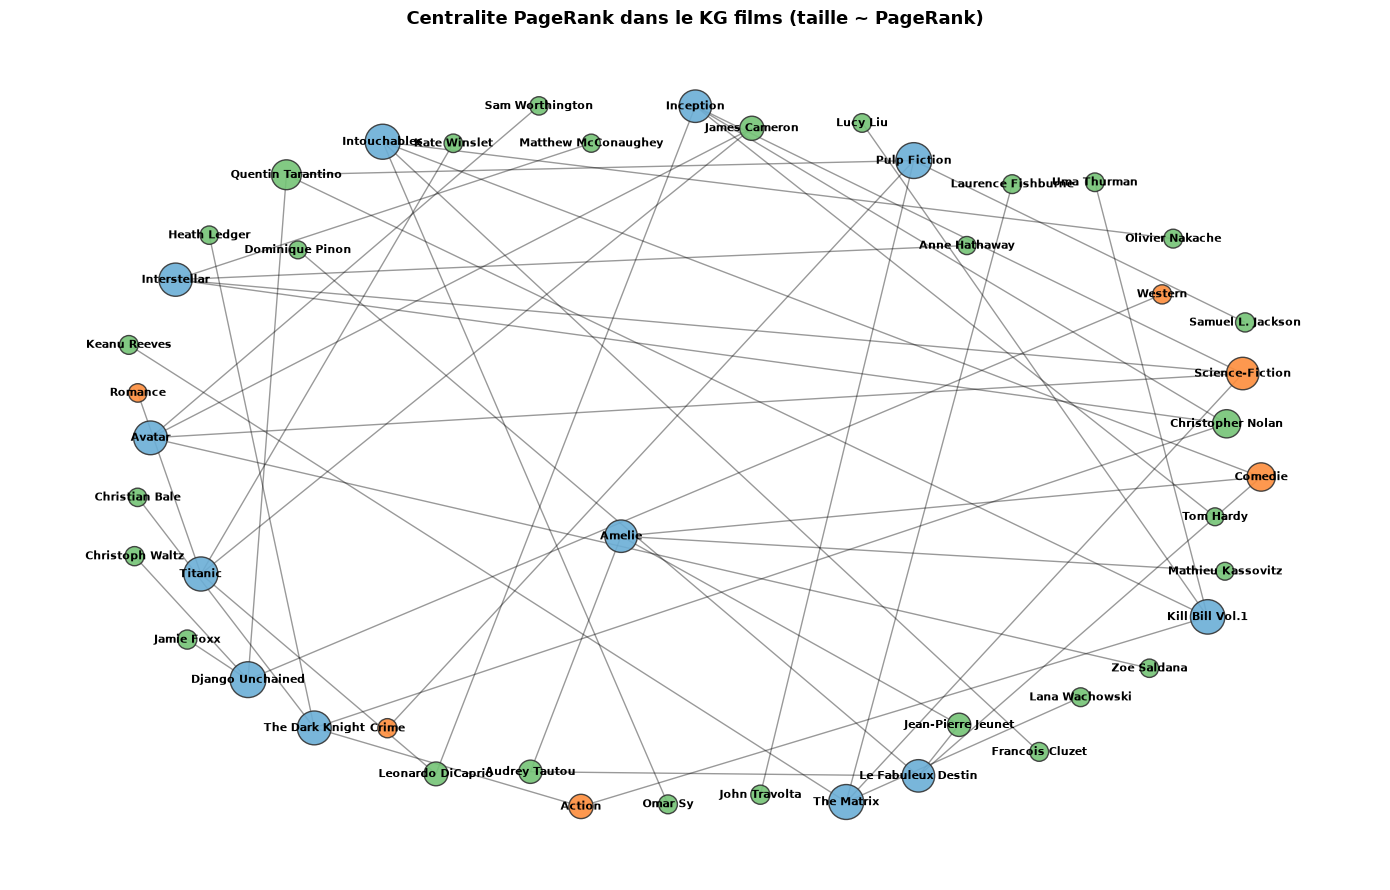
Exemple guide 10 : Visualisation pyvis interactive personnalisee
Solution proposee par @Sosolalt (EPITA-IS, promo 2028).
# Exemple guide 10 : Visualisation pyvis interactive personnalisee (films recents)
# Note : l'enonce suggere >= 2015, mais le jeu de donnees movies.csv s'arrete
# en 2014. On utilise donc le seuil >= 2010 pour obtenir un sous-graphe non vide.
YEAR_THRESHOLD = 2010

# 1. Requete SPARQL avec FILTER sur l'annee (schema:datePublished)
query_recent = """
PREFIX schema: <http://schema.org/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?movie_title ?rel_type ?target_name
WHERE {
    ?movie a schema:Movie ;
           schema:name ?movie_title ;
           schema:datePublished ?year .
    FILTER(?year >= 2010)
    {
        ?movie schema:director ?person .
        ?person schema:name ?target_name .
        BIND("director" AS ?rel_type)
    }
    UNION
    {
        ?movie schema:actor ?person .
        ?person schema:name ?target_name .
        BIND("actor" AS ?rel_type)
    }
    UNION
    {
        ?movie schema:genre ?genre .
        ?genre rdfs:label ?target_name .
        BIND("genre" AS ?rel_type)
    }
}
"""

# 2. Construire un nx.DiGraph
G_recent = nx.DiGraph()
recent_types = {}
for row in g.query(query_recent):
    movie = str(row.movie_title)
    target = str(row.target_name)
    rel = str(row.rel_type)
    recent_types[movie] = "movie"
    recent_types[target] = "genre" if rel == "genre" else "person"
    G_recent.add_edge(movie, target, relation=rel)

print(f"Sous-graphe films >= {YEAR_THRESHOLD} : {G_recent.number_of_nodes()} noeuds, "
      f"{G_recent.number_of_edges()} aretes")

# 3. Visualisation pyvis personnalisee (couleur par type, taille ~ degre, tooltip)
try:
    from pyvis.network import Network

    node_colors = {"movie": "#1f77b4", "person": "#ff7f0e", "genre": "#2ca02c"}

    net = Network(height="600px", width="100%", directed=True,
                  notebook=True, cdn_resources="in_line")
    net.from_nx(G_recent)

    for node in net.nodes:
        nid = node["id"]
        ntype = recent_types.get(nid, "movie")
        degre = G_recent.degree(nid)
        node["color"] = node_colors.get(ntype, "#cccccc")
        node["size"] = 10 + degre * 5
        node["title"] = f"Type: {ntype}\nDegre: {degre}"

    net.save_graph("output_kg_recent.html")
    print("Visualisation pyvis sauvegardee dans output_kg_recent.html")
except Exception as e:
    print(f"pyvis indisponible ({type(e).__name__}: {e}). Resume du sous-graphe :")
    for ntype in ("movie", "person", "genre"):
        noeuds = [n for n in G_recent.nodes() if recent_types.get(n) == ntype]
        print(f"  {ntype}: {len(noeuds)} -> {sorted(noeuds)}")
Sous-graphe films >= 2010 : 18 noeuds, 16 aretes
Visualisation pyvis sauvegardee dans output_kg_recent.htmlExemple guide 11 : Property paths transitifs sur l ontologie
Solution proposee par @Sosolalt (EPITA-IS, promo 2028).
# Exemple guide 11 : Property paths transitifs sur l'ontologie

from rdflib import Graph as RDFGraph

# Charger l'ontologie dans un graphe rdflib
g_owl = RDFGraph().parse("data/university.owl", format="xml")
print(f"Ontologie chargee : {len(g_owl)} triplets")
print(f"Namespaces 'university' : "
      f"{[str(n) for p, n in g_owl.namespaces() if 'university' in str(n)]}")

# 1. Super-classes (directes + indirectes) de GraduateStudent via subClassOf+
query_super = """
PREFIX uni: <http://example.org/university#>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>
SELECT ?super WHERE { uni:GraduateStudent rdfs:subClassOf+ ?super }
"""
print("\n=== 1. Super-classes de GraduateStudent (subClassOf+) ===")
for row in g_owl.query(query_super):
    print(f"  {str(row.super).split('#')[-1]}")

# 2. Toutes les instances de Person via rdf:type/rdfs:subClassOf*
query_persons = """
PREFIX uni: <http://example.org/university#>
PREFIX rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>
SELECT DISTINCT ?instance WHERE { ?instance rdf:type/rdfs:subClassOf* uni:Person }
"""
transitive_results = list(g_owl.query(query_persons))
print("\n=== 2. Instances de Person (type/subClassOf*) ===")
for row in transitive_results:
    print(f"  {str(row.instance).split('#')[-1]}")

# 3. Instances de Person avec rdf:type seul (sans property path)
query_direct = """
PREFIX uni: <http://example.org/university#>
PREFIX rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#>
SELECT DISTINCT ?instance WHERE { ?instance rdf:type uni:Person }
"""
direct_results = list(g_owl.query(query_direct))

# Comparaison
print("\n=== 3. Comparaison ===")
print(f"  rdf:type seul          : {len(direct_results)} instance(s)")
print(f"  type/rdfs:subClassOf*  : {len(transitive_results)} instance(s)")
print(f"  Instances supplementaires revelees par la hierarchie : "
      f"{len(transitive_results) - len(direct_results)}")
Ontologie chargee : 60 triplets
Namespaces 'university' : ['http://example.org/university#']
=== 1. Super-classes de GraduateStudent (subClassOf+) ===
Student
Person
Thing
=== 2. Instances de Person (type/subClassOf*) ===
etud_bernard
etud_martin
prof_dupont
=== 3. Comparaison ===
rdf:type seul : 0 instance(s)
type/rdfs:subClassOf* : 3 instance(s)
Instances supplementaires revelees par la hierarchie : 3Exercices a completer
Ces exercices sont a realiser par l’etudiant.
Exercice 1 : détecter les triplets redondants dans g_students
L’exemple guide 1 ajoute hasEmail et calcule la moyenne. Cet exercice détecte les triplets redondants dans g_students (un même couple (sujet, propriété) déclaré plusieurs fois avec des objets différents). Mesurer le nombre de triplets à dédupliquer avant export.
Indice 1 : g_students.query("SELECT ?s ?p (COUNT(?o) AS ?n) WHERE { ?s ?p ?o } GROUP BY ?s ?p HAVING (?n > 1)").
Indice 2 : un triplet redondant révèle une erreur de modélisation — la propriété devrait être fonctionnelle (owl:FunctionalProperty), sinon elle n’a pas de sémantique unique.
# Exercice 1 : triplets redondants
# Grandeur mesuree : nombre de triplets (s, p) declares plusieurs fois.
# Indice : GROUP BY ?s ?p HAVING(COUNT(?o) > 1).
result = None  # TODO etudiant
print("=== Exercice 1 : triplets redondants ===")
print("TODO : completer la mesure ci-dessus")
=== Exercice 1 : triplets redondants ===
TODO : completer la mesure ci-dessusExercice 2 : entropie de Shannon sur la distribution des genres
L’exemple guide 2 visualise le KG filtré par genre. Cet exercice calcule l’entropie de Shannon de la distribution des genres de films dans le KG :
H = -Σ p(g) * log2(p(g))
où p(g) est la proportion de films du genre g. Comparer à l’entropie maximale théorique (= log2(N_genres)). Un KG bien équilibré tend vers H_max.
Indice 1 : Counter(g for film, _, _, genre in films) puis normaliser.
Indice 2 : la diversité lexicale des genres est une mesure indirecte de la couverture du monde par le KG — un KG qui n’a qu’un genre a H = 0, un KG bien diversifié a H ≈ H_max.
# Exercice 2 : entropie de Shannon sur la distribution des genres
# Grandeur mesuree : H = -Σ p(g) * log2(p(g)) vs H_max = log2(N_genres).
# Indice : Counter + boucle sur les genres.
result = None  # TODO etudiant
print("=== Exercice 2 : entropie de Shannon sur la distribution des genres ===")
print("TODO : completer la mesure ci-dessus")
=== Exercice 2 : entropie de Shannon sur la distribution des genres ===
TODO : completer la mesure ci-dessusExercice 3 : taux de re-qualification après rdf:type
L’exemple guide 3 liste les instances Student et raisonne sur les contraintes OWL. Cet exercice mesure le taux de re-qualification : parmi les Person du KG, combien sont mal classifiées (par exemple taggées comme Student alors qu’elles devraient être Professor) ?
L’idée : owlready2 applique les IsA au typage, mais le KG RDF peut avoir des incohérences qu’on détecte via SPARQL.
Indice 1 : charger le KG avec rdflib.Graph().parse(...), puis qres = g.query("SELECT ?p WHERE { ?p a :Person . ?p :teaches ?c }").
Indice 2 : un Person qui teaches ET enrolledIn simultanément est un signal d’incohérence — la mesure attendue est le ratio #(Person ∧ teaches ∧ enrolledIn) / #(Person).
# Exercice 3 : taux de re-qualification
# Grandeur mesuree : #(Person ∧ teaches ∧ enrolledIn) / #(Person).
# Indice : rdflib.query avec UNION de triplets.
result = None  # TODO etudiant
print("=== Exercice 3 : taux de re-qualification ===")
print("TODO : completer la mesure ci-dessus")
=== Exercice 3 : taux de re-qualification ===
TODO : completer la mesure ci-dessusExercice 4 : couverture de l’ontologie sur les triplets RDF
L’exemple guide 4 construit un KG complet. Cet exercice évalue la couverture de l’ontologie : parmi les triplets RDF du KG, combien ont un type (rdf:type) défini dans l’ontologie vs des types littéraux ou non-définis ?
Indice 1 : len([t for t in g if (t[1] == RDF.type)]) donne le nombre de triplets de typage ; comparer au nombre de triplets total et au nombre d’owl:Class définies dans l’ontologie.
Indice 2 : un KG bien construit a un ratio #(typed_in_ontology) / #(total_typed) ≥ 0.8. En-dessous, le KG est dit peu typé — la navigation par classe sera impraticable.
# Exercice 4 : couverture de l'ontologie
# Grandeur mesuree : #(typed_in_ontology) / #(total_typed).
# Indice : filtrer sur (triplet[1] == RDF.type).
result = None  # TODO etudiant
print("=== Exercice 4 : couverture de l'ontologie ===")
print("TODO : completer la mesure ci-dessus")
=== Exercice 4 : couverture de l'ontologie ===
TODO : completer la mesure ci-dessusExercice 5 : divergence entre 4 mesures de centralité
L’exemple guide 5 compare PageRank et degree centrality. Cet exercice ajoute betweenness et eigenvector centrality, puis mesure la divergence entre les 4 classements :
- Jaccard top-5 :
|A ∩ B| / |A ∪ B|entre les 5 premiers de chaque mesure. - Kendall tau : corrélation d’ordre entre les 4 classements.
Indice 1 : nx.betweenness_centrality(G_und), nx.eigenvector_centrality_numpy(G_und).
Indice 2 : la divergence entre PageRank et betweenness signale des nœuds-passerelles (hubs qui ne dominent pas en centralité spectrale mais qui contrôlent les chemins).
# Exercice 5 : divergence entre 4 centralites
# Grandeur mesuree : Jaccard top-5 entre les classements, Kendall tau.
# Indice : nx.betweenness_centrality + nx.eigenvector_centrality_numpy.
result = None  # TODO etudiant
print("=== Exercice 5 : divergence entre 4 centralites ===")
print("TODO : completer la mesure ci-dessus")
=== Exercice 5 : divergence entre 4 centralites ===
TODO : completer la mesure ci-dessusExercice 6 : benchmarker pyvis vs taille du graphe
L’exemple guide 6 génère un fichier HTML pyvis. Cet exercice benchmarque le temps de rendu en fonction de la taille du sous-graphe :
Pour n ∈ {50, 100, 200, 500} nœuds, mesurer le temps moyen sur 3 exécutions de net.show(...).
Indice 1 : time.time() avant/après chaque appel.
Indice 2 : tracer n -> temps et estimer la complexité asymptotique (linéaire, quadratique ?). pyvis est typiquement O(n) en layout mais O(n log n) en interactivité navigateur.
# Exercice 6 : benchmark pyvis vs taille
# Grandeur mesuree : temps de rendu pour n ∈ {50, 100, 200, 500}.
# Indice : time.time() avant/apres net.show(...).
result = None  # TODO etudiant
print("=== Exercice 6 : benchmark pyvis vs taille ===")
print("TODO : completer la mesure ci-dessus")
=== Exercice 6 : benchmark pyvis vs taille ===
TODO : completer la mesure ci-dessusExercice 7 : profondeur transitive de rdfs:subClassOf+
L’exemple guide 7 utilise rdfs:subClassOf+ pour la clôture transitive. Cet exercice mesure la profondeur transitive de chaque classe : pour GraduateStudent, combien de sauts faut-il pour atteindre owl:Thing (la racine) ?
Indice 1 : len(list(g.transitive_objects(subj=RDFS.subClassOf, , obj=OWL.Thing))).
Indice 2 : la distribution des profondeurs dans l’ontologie est un proxy de la complexité du domaine — une ontologie profonde (>5 niveaux) indique un domaine fortement stratifié.
# Exercice 7 : profondeur transitive
# Grandeur mesuree : nombre de sauts de subClassOf vers owl:Thing.
# Indice : g.transitive_objects(subj=RDFS.subClassOf, obj=OWL.Thing).
result = None  # TODO etudiant
print("=== Exercice 7 : profondeur transitive ===")
print("TODO : completer la mesure ci-dessus")
=== Exercice 7 : profondeur transitive ===
TODO : completer la mesure ci-dessus