Le job-shop scheduling est un problème canonique d’optimisation combinatoire : on dispose de \(m\) machines et de \(n\) jobs, chaque job etant une sequence d’opérations (une par machine) de durees données. On veut trouver un ordonnancement (date de debut de chaque opération) qui :
respecte l’ordre des opérations de chaque job (precedence),
n’utilise chaque machine qu’une fois a la fois (exclusion disjonctive),
minimise le makespan\(C_{\max}\) (la date de fin de la dernière opération).
Ce problème est NP-difficile : il n’existe pas d’algorithme polynomial connu, et une approche gloutonne (heuristique) rate souvent l’optimum. C’est typiquement la ou un solveur SMT comme Z3 brille : on decrit les contraintes (precedence + exclusion) et l’objectif (minimiser \(C_{\max}\)), et Optimize trouve l’ordonnancement optimal.
Ce notebook montre : (a) une heuristique gloutonne FIFO sous-optimale, (b) la modelisation Z3 avec la contrainte disjonctive Or(... , ...), (c) l’optimum trouve par Optimize.minimize, et (d) un diagramme de Gantt comparant les deux. Il porte en Python l’exemple C# 11_Job_Shop_Scheduling de la serie sœur Z3.Linq.
# Imports : z3 (solveur SMT) + matplotlib (diagramme de Gantt).import osimport z3import matplotlibimport matplotlib.pyplot as plt# En mode batch (Papermill/nbconvert headless), on desactive le mode interactif.# On garde le backend inline par defaut (capture les figures au plt.show()).BATCH_MODE = os.getenv("BATCH_MODE", "false").lower() in ("true", "1", "yes")if BATCH_MODE: plt.ioff()print("z3 version :", z3.get_version_string())
z3 version : 4.16.0
Instance de reference : 3 jobs x 2 machines
On encode l’instance comme un dictionnaire : chaque job est la liste ordonnee de ses opérations, chaque opération etant un couple (machine, duree).
Job
Opération 1
Opération 2
J0
M0 (3h)
M1 (3h)
J1
M1 (2h)
M0 (2h)
J2
M0 (2h)
M1 (2h)
Notez que J0 et J2 commencent par M0, mais J1 commence par M1 : les jobs n’ont pas tous le même parcours.
# Instance : 3 jobs x 2 machines (M0, M1).# Format : jobs[j] = [(machine, duree), (machine, duree)] dans l'ordre des operations.MACHINES = ["M0", "M1"]jobs = {"J0": [("M0", 3), ("M1", 3)], # 3h sur M0 puis 3h sur M1"J1": [("M1", 2), ("M0", 2)], # 2h sur M1 puis 2h sur M0"J2": [("M0", 2), ("M1", 2)], # 2h sur M0 puis 2h sur M1}JOB_NAMES =list(jobs.keys())print(f"Instance : {len(JOB_NAMES)} jobs x {len(MACHINES)} machines")for j in JOB_NAMES: parcours =" puis ".join(f"{m}({d}h)"for m, d in jobs[j])print(f" {j} : {parcours}")
Instance : 3 jobs x 2 machines
  J0 : M0(3h) puis M1(3h)
  J1 : M1(2h) puis M0(2h)
  J2 : M0(2h) puis M1(2h)
Pourquoi ce problème est-il difficile ?
Le job-shop scheduling est NP-difficile (Garey & Johnson, 1976) : dès que le nombre de jobs et de machines croît, l’espace des ordonnancements possibles explose, car il faut choisir un ordre des opérations sur chaque machine parmi tous les ordres compatibles. Notre instance 3 jobs x 2 machines reste complètement lisible — c’est le but pédagogique — mais la même structure à 10 jobs x 10 machines défie les approches exactes depuis les années 1960 (l’instance canonique FT10 de Fisher & Thompson n’a été close qu’en 1989).
Deux bornes encadrent déjà l’espace des solutions :
Borne inférieure de charge : chaque machine doit absorber la somme des durées des opérations qui la traversent, soit 7 h pour M0 (3 + 2 + 2) et 7 h pour M1 (3 + 2 + 2). Aucun ordonnancement ne peut finir avant t = 7.
Horizon séquentiel : si tout était exécuté à la suite, la date de fin serait la somme de toutes les durées : 6 + 4 + 4 = 14 h. C’est exactement la valeur que donnera le glouton ci-dessous — et la borne supérieure que nous fournirons à Z3.
La question devient : peut-on descendre sous 14 h en entrelaçant les jobs ? C’est précisément ce que la contrainte disjonctive va exprimer.
Approche gloutonne : ordonnancement FIFO
Avant Z3, essayons une heuristique simple : on schedule les jobs dans l’ordre (J0, puis J1, puis J2), et pour chaque job on place chaque opération le plus tot possible (des que la machine est libre et que l’opération précédente du job est terminee).
Cette stratégie FIFO est rapide mais myope : elle ne regarde pas plus loin que le job courant, et peut laisser une machine inutilisee la ou un autre ordre aurait mieux equilibre la charge.
def greedy_fifo(jobs, machine_names):"""Ordonnancement glouton : schedule chaque job dans l'ordre, chaque operation ASAP.""" machine_free = {m: 0for m in machine_names} # disponibilite de chaque machine schedule = {}for j in jobs: schedule[j] = []for (m, d) in jobs[j]: job_ready = schedule[j][-1][1] + schedule[j][-1][2] if schedule[j] else0 start =max(machine_free[m], job_ready) schedule[j].append((m, start, d)) machine_free[m] = start + d cmax =max(s[1] + s[2] for j in schedule for s in schedule[j])return schedule, cmaxgreedy_schedule, greedy_cmax = greedy_fifo(jobs, MACHINES)print(f"Glouton FIFO : Cmax = {greedy_cmax}h")for j in JOB_NAMES: ops =", ".join(f"{m}[{s},{s+d}]"for m, s, d in greedy_schedule[j])print(f" {j} : {ops}")
Le passage au declaratif. On introduit une variable entiere \(s_{j,k}\) = date de debut de l’opération \(k\) du job \(j\), plus une variable \(C_{\max}\) pour le makespan. Les contraintes se traduisent directement :
Precedence intra-job : l’opération \(k\) commence après la fin de l’opération \(k{-}1\) : \(s_{j,k} \ge s_{j,k-1} + d_{j,k-1}\).
Exclusion disjonctive (le coeur du modèle) : pour deux opérations \(a\) et \(b\) sur la même machine, l’une doit finir avant que l’autre commence : \(s_a + d_a \le s_b\)OU\(s_b + d_b \le s_a\). C’est cette disjonction Or(...) (non-lineaire, difficile pour un simple parcours) qui fait toute la valeur du solveur.
Objectif : minimiser \(C_{\max} = \max_{j,k}(s_{j,k} + d_{j,k})\), via Optimize.minimize.
La borne superieure sure \(C_{\max} \le\) somme de toutes les durees (cas ou tout serait sequentialise) garantit un domaine fini au solveur.
def solve_jobshop(jobs, machine_names):"""Modelise le job-shop en Z3 et minimise le makespan (Cmax).""" opt = z3.Optimize() job_names =list(jobs.keys()) horizon =sum(d for j in jobs for (_, d) in jobs[j]) # borne sup sure# Variables de debut : start[j][k] start = {j: [z3.Int(f"s_{j}_{k}") for k inrange(len(jobs[j]))] for j in job_names} cmax = z3.Int("cmax")# (1) Domaine + precedence intra-job + borne makespanfor j in job_names:for k, (m, d) inenumerate(jobs[j]): opt.add(start[j][k] >=0) opt.add(start[j][k] + d <= cmax)if k >0: _, pd = jobs[j][k -1] opt.add(start[j][k] >= start[j][k -1] + pd)# (2) Exclusion disjonctive : deux operations sur la MEME machine ne se chevauchent pasfor m in machine_names: ops_on_m = [(j, k, jobs[j][k][1])for j in job_names for k inrange(len(jobs[j]))if jobs[j][k][0] == m]for a inrange(len(ops_on_m)):for b inrange(a +1, len(ops_on_m)): ja, ka, da = ops_on_m[a] jb, kb, db = ops_on_m[b] opt.add(z3.Or(start[ja][ka] + da <= start[jb][kb], start[jb][kb] + db <= start[ja][ka]))# (3) Objectif : minimiser le makespan opt.add(cmax <= horizon) opt.minimize(cmax)assert opt.check() == z3.sat, "Instance insatisfiable" model = opt.model() schedule = {j: [(jobs[j][k][0], model[start[j][k]].as_long(), jobs[j][k][1])for k inrange(len(jobs[j]))] for j in job_names}return schedule, model[cmax].as_long()opt_schedule, opt_cmax = solve_jobshop(jobs, MACHINES)print(f"Z3 optimal : Cmax = {opt_cmax}h (glouton = {greedy_cmax}h, gain = {greedy_cmax - opt_cmax}h)")
Z3 optimal : Cmax = 8h (glouton = 14h, gain = 6h)
Anatomie du modèle généré
Avant de lire le résultat, comptons ce que Z3 manipule réellement pour cette instance :
Élément
Quantité
Détail
Variables entières
7
\(s_{j,k}\) pour 6 opérations + \(C_{\max}\)
Précédences intra-job
3
une par job (l’opération 2 suit l’opération 1)
Bornes de domaine
6
\(s_{j,k} \ge 0\), plus \(s_{j,k} + d_{j,k} \le C_{\max}\)
Contraintes disjonctives
6
3 paires sur M0, 3 paires sur M1
Les paires disjonctives se répartissent ainsi : M0 porte les opérations J0-1, J1-2 et J2-1, soit \(\binom{3}{2} = 3\) paires ; M1 porte J0-2, J1-1 et J2-2, soit 3 paires également. Chaque paire produit un Or(...) : l’une des deux opérations finit avant que l’autre commence. Ces 6 disjonctions sont le cœur combinatoire du modèle — c’est elles qui codent le choix de l’ordre sur chaque machine, sans jamais l’énumérer.
Notez enfin le rôle d’Optimize (et non Solver) : là où un Solver renverrait le premier ordonnancement faisable trouvé, Optimize.minimize(cmax) exige le makespan minimal, avec garantie d’optimalité — le solveur prouve qu’aucune valeur inférieure n’est satisfiable. C’est une preuve, pas une heuristique.
Résultat optimal
Le solveur trouve l’ordonnancement de makespan minimal. Comparons le detail op par op : la ou le glouton sequentialisait trop, Z3 entrelace les jobs (une opération d’un job pendant le creux d’un autre) pour reduire le temps total.
print("Comparaison glouton vs Z3 optimal :\n")for j in JOB_NAMES: g =", ".join(f"{m}[{s},{s+d}]"for m, s, d in greedy_schedule[j]) o =", ".join(f"{m}[{s},{s+d}]"for m, s, d in opt_schedule[j])print(f" {j}")print(f" glouton : {g}")print(f" optimal : {o}")print(f"\nMakespan : glouton {greedy_cmax}h -> optimal {opt_cmax}h (gain de {greedy_cmax - opt_cmax}h, {100*(greedy_cmax-opt_cmax)/greedy_cmax:.0f}%)")
Lecture de la comparaison : d’où vient l’écart 14 h -> 8 h ?
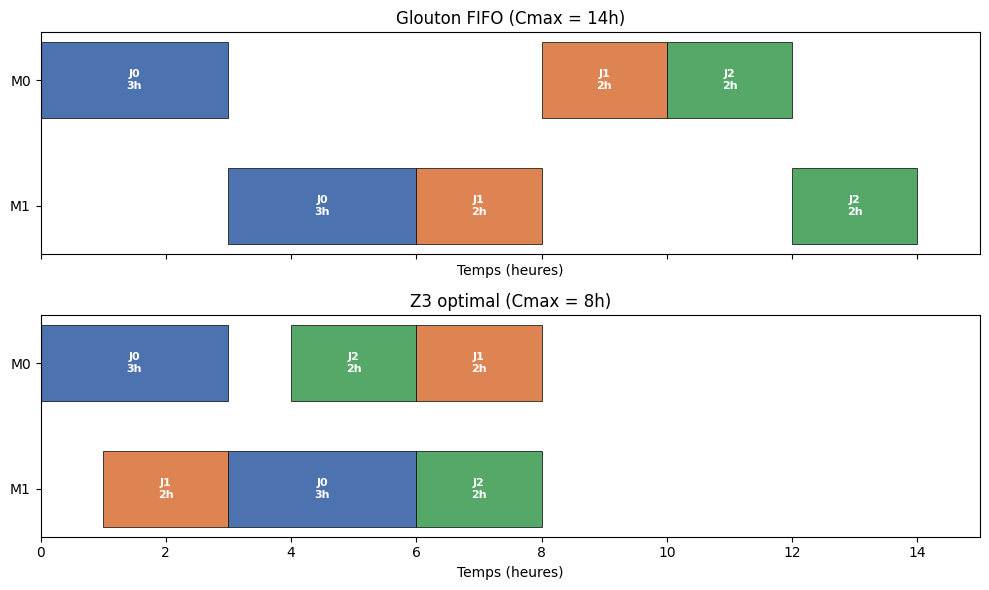
La sortie ci-dessus se lit ligne par ligne, et tout se joue sur J1. J0 est identique dans les deux ordonnancements (M0[0,3] puis M1[3,6]) : c’est le premier job traité, le glouton ne peut pas se tromper. Mais observez J1 :
Glouton : M1[6,8] puis M0[8,10]. Pourquoi attendre t = 6 pour sa première opération ? Parce que le glouton traite les jobs les uns après les autres : quand vient le tour de J1, la plage M1[3,6] est déjà réservée par J0, et le glouton ne place jamais une opération dans un trou laissé avant un placement précédent. La fenêtre M1[0,3] — parfaitement libre à ce moment-là — reste inutilisée.
Optimal : M1[1,3] puis M0[6,8]. Z3 n’a aucune notion d’ordre de traitement : il place les 6 opérations simultanément dans le temps, et remplit la fenêtre M1[1,3] que le glouton a laissée vide.
J2 subit le même effet en cascade : reculé à M0[10,12]/M1[12,14] par le glouton, il est avancé à M0[4,6]/M1[6,8] par l’optimal. Le glouton aboutit à 14 h — exactement l’horizon séquentiel, la pire borne possible — tandis que l’optimal gagne 6 h (43 %), une heure seulement au-dessus de la borne de charge (7 h).
Visualisation : diagramme de Gantt
Le diagramme de Gantt rend visible la différence : chaque ligne est une machine, chaque barre coloree une opération. Le glouton (haut) laisse des trous ; l’optimal Z3 (bas) tasse les opérations pour finir plus tot.
Diagramme de Gantt : glouton (haut) vs optimal (bas).
Lecture du diagramme
Les deux Gantt ci-dessus rendent visibles les défauts du glouton. Sur le Gantt optimal (bas), chaque machine ne reste inoccupée qu’une seule heure : M0 sur [3,4] et M1 sur [0,1]. Les trois jobs s’entrelacent — la barre J1 sur M1 occupe [1,3] pendant que J0 travaille sur M0, puis les rôles s’échangent. Le makespan de 8 h correspond à la fin simultanée des deux dernières opérations (J1 sur M0 et J2 sur M1).
Un point mérite réflexion : la borne inférieure de charge (7 h) n’est pas atteinte. Un ordonnancement à 7 h remplirait chaque machine sans aucune interruption — le solveur a exploré cette possibilité et prouvé qu’elle viole nécessairement une précédence ou une disjonction. C’est l’apport décisif d’Optimize : la valeur 8 h est certifiée minimale. Un métaheuristique (recuit simulé, colonies de fourmis) pourrait trouver 8 h aussi, mais ne pourrait jamais certifier qu’il n’existe pas de solution à 7 h.
Les exercices suivants prolongent exactement ce geste : ajouter un job (l’espace de recherche grandit), une deadline (contrainte dure), une machine (nouvelles disjonctions).
Exercices
Les trois exercices suivants vous font manipuler le modèle : etendre l’instance (1), ajouter une contrainte metier de deadline (2), et monter en dimension avec une troisieme machine (3). Chaque stub reutilise solve_jobshop défini plus haut.
Exercice 1 – Ajout d’un quatrieme job
Objectif : ajouter un job J3 = [("M1", 1), ("M0", 3)] (1h sur M1 puis 3h sur M0) et re-resoudre. Observez comment le makespan optimal augmente (ou non) et comment Z3 re-entrelace les opérations.
Indices : copiez le dict jobs dans jobs_4 avec l’entree J3 supplementaire ; appelez solve_jobshop(jobs_4, MACHINES).
# Exercice 1 : ajoutez un quatrieme job J3 et re-resolvez.# Etape 1 : definissez jobs_4 = dict(jobs) puis jobs_4["J3"] = [("M1", 1), ("M0", 3)].# Etape 2 : resolvez via solve_jobshop(jobs_4, MACHINES).# Etape 3 : comparez le nouveau Cmax a l'optimum 3-jobs (opt_cmax).def resoudre_4_jobs():"""Retourne (schedule, cmax) pour l'instance 3 jobs + J3."""# TODO etudiant : construire jobs_4 et appeler solve_jobshopreturnNoneprint("Exercice 1 a completer : ajouter un 4eme job et mesurer le nouveau Cmax optimal.")
Exercice 1 a completer : ajouter un 4eme job et mesurer le nouveau Cmax optimal.
Exercice 2 – Contrainte d’urgence (deadline)
Objectif : le job J1 vient de passer urgent : imposez qu’il termine avant \(t = 6\) (dans l’ordonnancement optimal exhibé plus haut, J1 termine à \(t = 8\)). Ajoutez cette contrainte au modèle et verifyez que le makespan optimal augmente — mesuré au solveur, Cmax passe de 8 à 9 : la deadline force un ordonnancement moins efficace.
Indices : la fin de J1 est start["J1"][-1] + duree_derniere_op ; ajoutez opt.add(... <= 6) avant opt.minimize. Modifiez solve_jobshop ou créez une variante.
# Exercice 2 : ajoutez une deadline (J1 doit terminer avant t=6).# Indice : opt.add(start["J1"][-1] + jobs["J1"][-1][1] <= 6) avant opt.minimize.# Etape 1 : copiez solve_jobshop en solve_jobshop_deadline(jobs, machines, deadline_j1=6).# Etape 2 : resolvez et comparez le Cmax a opt_cmax (sans deadline).def solve_jobshop_deadline(jobs, machine_names, deadline_j1=6):"""Job-shop avec une deadline sur J1."""# TODO etudiant : modeliser + ajouter la deadline + minimiserreturnNoneprint("Exercice 2 a completer : mesurer le surcout d'une deadline sur J1.")
Exercice 2 a completer : mesurer le surcout d'une deadline sur J1.
Exercice 3 – Extension a 3 machines
Objectif : etendre l’instance a 3 machines (M0, M1, M2) avec des jobs a 3 opérations chacun, et verifyez que solve_jobshop generalize sans modification de code (le modèle est paramètre par les données).
Indices : definissez MACHINES_3 = ["M0", "M1", "M2"] et des jobs_3 ou chaque job a 3 opérations sur des machines distinctes ; la fonction solve_jobshop gere déjà le cas general.
# Exercice 3 : etendez l'instance a 3 machines, 3 operations par job.# Indice : MACHINES_3 = ["M0", "M1", "M2"], jobs_3 = {j: [(m1,d1),(m2,d2),(m3,d3)], ...}.# Etape 1 : definissez jobs_3 (3 jobs, chacun 3 operations sur des machines distinctes).# Etape 2 : resolvez via solve_jobshop(jobs_3, MACHINES_3).# Question : le temps de resolution grimpe-t-il avec 3 machines ? Mesurez-le.def resoudre_3_machines():"""Retourne (schedule, cmax) pour une instance 3 machines."""# TODO etudiant : definir jobs_3 + MACHINES_3 et appeler solve_jobshopreturnNoneprint("Exercice 3 a completer : generaliser a 3 machines et observer le temps de resolution.")
Exercice 3 a completer : generaliser a 3 machines et observer le temps de resolution.
Conclusion
Le job-shop scheduling illustre le gain du declaratif sur une classe de problemes ou l’heuristique gloutonne est structurellement sous-optimale :
La contrainte disjonctiveOr(s_a + d_a <= s_b, s_b + d_b <= s_a) (exclusion mutuelle sur une machine) est difficile a coder en imperatif sans enumerer tous les ordres possibles ; Z3 la traite nativement.
Optimize.minimize trouve le makespan optimal (prouvablement minimal), la ou FIFO se contente d’un ordonnancement realisable mais myope.
Le modèle est paramètre par les données : ajouter un job, une machine ou une deadline se fait en modifiant l’instance ou en ajoutant une contrainte, sans re-ecrire l’algorithme de resolution.
Limites : sur de très grandes instances (dizaines de jobs x dizaines de machines), le solveur peut devenir lent — c’est le prix de l’optimalite garantie. Dans ce cas, on combine souvent Z3 avec des heuristiques (fournir un ordonnancement glouton comme borne superieure aide le solveur a pruner).
Suite logique : retour a la serie Z3-Python, ou explorez la version C# Z3.Linq qui aborde le même problème via une couche declarative LINQ.