Planners-3-State-Space - Recherche dans l’Espace d’Etats

Navigation : Index | << PDDL Basics | Fast Downward >>


Objectifs d’apprentissage

A la fin de ce notebook, vous saurez :

  1. Representer un problème de planification comme un graphe d’etats
  2. Implementer les algorithmes de recherche non informee (BFS, DFS)
  3. Comprendre les algorithmes informes (Greedy, A*) et leur optimalite
  4. Designer des heuristiques admissibles et coherentes
  5. Visualiser les espaces d’etats avec networkx

Prerequis

  • Python 3.9+ installe
  • Notebooks Planners-1 et Planners-2 compris
  • Connaissances basiques en théorie des graphes

Duree estimee : 35 minutes


1. Introduction a la Recherche dans l’Espace d’Etats

La planification automatique peut etre formulee comme un problème de recherche dans un graphe :

  • Les noeuds representent les etats du monde
  • Les aretes representent les actions (transitions)
  • Le but est de trouver un chemin de l’etat initial vers un etat but

1.1 Definition formelle

Un problème de recherche d’etat est un tuple \(\langle S, A, T, I, G \rangle\) ou :

Composante Description
\(S\) Ensemble fini d’etats
\(A\) Ensemble d’actions
\(T \subseteq S \times A \times S\) Fonction de transition
\(I \in S\) Etat initial
\(G \subseteq S\) Ensemble d’etats but

1.2 Le defi de l’explosion combinatoire

Le nombre d’etats possibles croit de maniere exponentielle avec le nombre de predicats :

\[|S| = O(2^n)\]

C’est pourquoi les heuristiques sont essentielles pour guider la recherche vers les etats prometteurs.


2. Representation d’un Espace d’Etats

Commencons par définir un espace d’etats simple et le visualiser avec networkx.

# Imports necessaires
import networkx as nx
import matplotlib.pyplot as plt
from collections import deque
import heapq
from typing import Dict, List, Set, Tuple, Optional, Callable
from dataclasses import dataclass, field

print("Imports reussis")
print(f"networkx version: {nx.__version__}")
Imports reussis
networkx version: 3.6.1

2.1 Exemple simple : Navigation dans une grille

Considerons un problème de navigation dans une grille 3x3. Le robot doit aller de la position (0,0) a la position (2,2).

# Definition de l'espace d'etats pour la navigation
@dataclass(frozen=True)
class GridState:
    """Etat representant une position dans la grille."""
    x: int
    y: int
    
    def __repr__(self):
        return f"({self.x},{self.y})"

@dataclass
class Action:
    """Action de deplacement."""
    name: str
    dx: int
    dy: int
    cost: int = 1

# Actions disponibles
ACTIONS = {
    'up': Action('up', 0, 1),
    'down': Action('down', 0, -1),
    'left': Action('left', -1, 0),
    'right': Action('right', 1, 0)
}

class GridWorld:
    """Monde de grille pour la navigation."""
    
    def __init__(self, width: int, height: int, obstacles: Set[Tuple[int, int]] = None):
        self.width = width
        self.height = height
        self.obstacles = obstacles or set()
    
    def is_valid(self, state: GridState) -> bool:
        """Verifie si un etat est valide."""
        return (0 <= state.x < self.width and 
                0 <= state.y < self.height and
                (state.x, state.y) not in self.obstacles)
    
    def get_successors(self, state: GridState) -> List[Tuple[GridState, Action, int]]:
        """Retourne les successeurs d'un etat."""
        successors = []
        for action in ACTIONS.values():
            new_state = GridState(state.x + action.dx, state.y + action.dy)
            if self.is_valid(new_state):
                successors.append((new_state, action, action.cost))
        return successors

# Creation du monde
grid = GridWorld(3, 3)
initial_state = GridState(0, 0)
goal_state = GridState(2, 2)

print(f"Monde grille: {grid.width}x{grid.height}")
print(f"Etat initial: {initial_state}")
print(f"Etat but: {goal_state}")
print(f"\nSuccesseurs de l'etat initial: {grid.get_successors(initial_state)}")
Monde grille: 3x3
Etat initial: (0,0)
Etat but: (2,2)

Successeurs de l'etat initial: [((0,1), Action(name='up', dx=0, dy=1, cost=1), 1), ((1,0), Action(name='right', dx=1, dy=0, cost=1), 1)]

2.2 Visualisation du graphe d’etats

Construisons le graphe complet des etats accessibles et visualisons-le.

# Construction du graphe d'etats
def build_state_graph(grid: GridWorld) -> nx.DiGraph:
    """Construit le graphe d'etats complet."""
    G = nx.DiGraph()
    
    # Ajouter tous les etats valides
    for x in range(grid.width):
        for y in range(grid.height):
            state = GridState(x, y)
            if grid.is_valid(state):
                G.add_node(state)
    
    # Ajouter les transitions
    for node in list(G.nodes()):
        for successor, action, cost in grid.get_successors(node):
            G.add_edge(node, successor, action=action.name, cost=cost)
    
    return G

# Construction du graphe
state_graph = build_state_graph(grid)

print(f"Graphe d'etats construit:")
print(f"  - Nombre de noeuds (etats): {state_graph.number_of_nodes()}")
print(f"  - Nombre d'aretes (transitions): {state_graph.number_of_edges()}")
Graphe d'etats construit:
  - Nombre de noeuds (etats): 9
  - Nombre d'aretes (transitions): 24

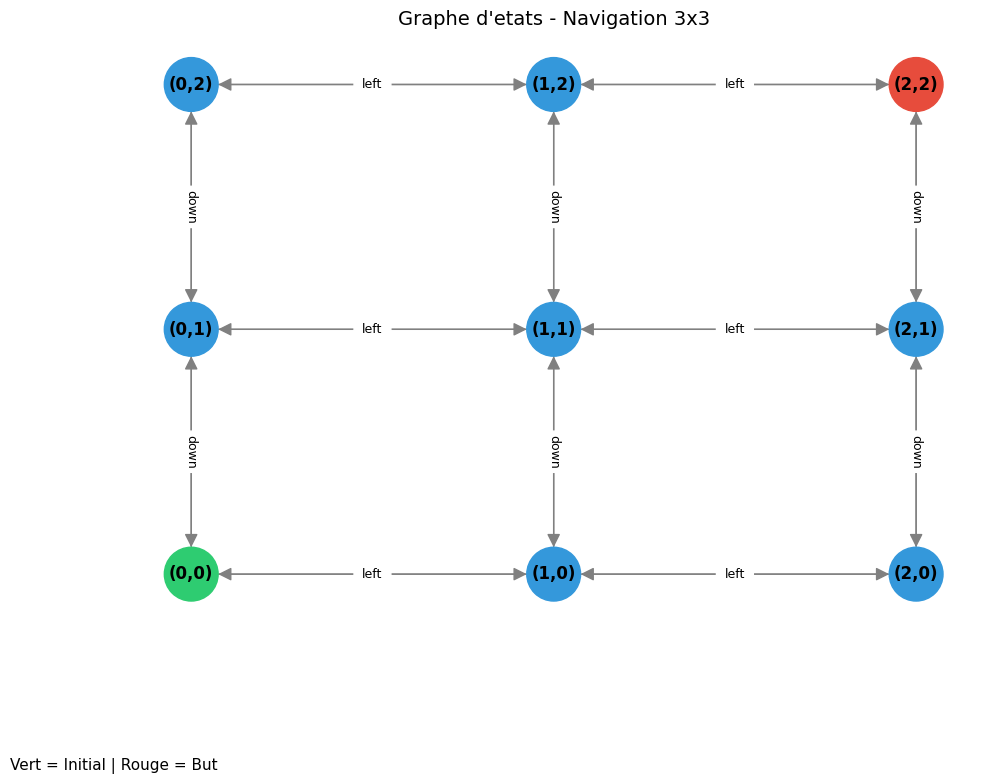
Visualisation du graphe d’etats construit pour la grille de navigation, representant chaque etat accessible comme un noeud et chaque action possible comme une arete.

# Visualisation du graphe d'etats
fig, ax = plt.subplots(figsize=(10, 8))

# Positions des noeuds basees sur les coordonnees de la grille
pos = {node: (node.x, node.y) for node in state_graph.nodes()}

# Couleurs des noeuds
node_colors = []
for node in state_graph.nodes():
    if node == initial_state:
        node_colors.append('#2ecc71')  # Vert pour l'etat initial
    elif node == goal_state:
        node_colors.append('#e74c3c')  # Rouge pour l'etat but
    else:
        node_colors.append('#3498db')  # Bleu pour les autres etats

# Dessiner le graphe
nx.draw(state_graph, pos, ax=ax, with_labels=True, 
        node_color=node_colors, node_size=1500,
        font_size=12, font_weight='bold',
        arrows=True, arrowsize=20,
        edge_color='gray')

# Ajouter les etiquettes d'action sur les aretes
edge_labels = {(u, v): d['action'] for u, v, d in state_graph.edges(data=True)}
nx.draw_networkx_edge_labels(state_graph, pos, edge_labels, font_size=9)

# Legende
ax.set_title("Graphe d'etats - Navigation 3x3", fontsize=14)
ax.text(-0.5, -0.8, "Vert = Initial | Rouge = But", fontsize=11)

plt.tight_layout()
plt.show()

Interpretation de la visualisation

Élément Representation
Noeuds Etats (positions dans la grille)
Aretes Actions (deplacements)
Noeud vert Etat initial (0,0)
Noeud rouge Etat but (2,2)

Observations : - Le graphe contient 9 etats (3x3 = 9 positions) - Chaque etat a au maximum 4 successeurs (haut, bas, gauche, droite) - Le plus court chemin de (0,0) a (2,2) a une longueur de 4


3. Recherche Non Informee

Les algorithmes de recherche non informee n’utilisent aucune information sur le but pour guider la recherche.

3.1 Breadth-First Search (BFS)

BFS explore les noeuds par ordre de profondeur croissante. Il garantit de trouver la solution la plus courte en nombre d’actions.

def bfs(initial_state, goal_state, get_successors) -> Tuple[List, int, int]:
    """
    Recherche en largeur (Breadth-First Search).
    
    Retourne: (chemin, cout, noeuds_explores)
    """
    # File FIFO pour BFS
    frontier = deque([(initial_state, [initial_state], 0)])
    explored = set()
    nodes_explored = 0
    
    while frontier:
        current_state, path, cost = frontier.popleft()
        nodes_explored += 1
        
        # Test du but
        if current_state == goal_state:
            return path, cost, nodes_explored
        
        # Marquer comme explore
        explored.add(current_state)
        
        # Explorer les successeurs
        for next_state, action, action_cost in get_successors(current_state):
            if next_state not in explored and next_state not in [s for s, _, _ in frontier]:
                new_path = path + [next_state]
                new_cost = cost + action_cost
                frontier.append((next_state, new_path, new_cost))
    
    return None, 0, nodes_explored  # Pas de solution

# Test de BFS
bfs_path, bfs_cost, bfs_nodes = bfs(initial_state, goal_state, grid.get_successors)

print("=== Breadth-First Search (BFS) ===")
print(f"Chemin trouve: {' -> '.join(str(s) for s in bfs_path)}")
print(f"Cout total: {bfs_cost}")
print(f"Noeuds explores: {bfs_nodes}")
print(f"Longueur du chemin: {len(bfs_path) - 1} actions")
=== Breadth-First Search (BFS) ===
Chemin trouve: (0,0) -> (0,1) -> (0,2) -> (1,2) -> (2,2)
Cout total: 4
Noeuds explores: 9
Longueur du chemin: 4 actions

3.2 Depth-First Search (DFS)

DFS explore en profondeur d’abord. Il ne garantit pas l’optimalite mais utilise moins de memoire.

def dfs(initial_state, goal_state, get_successors, max_depth: int = 100) -> Tuple[List, int, int]:
    """
    Recherche en profondeur (Depth-First Search) avec limite de profondeur.
    
    Retourne: (chemin, cout, noeuds_explores)
    """
    # Pile LIFO pour DFS
    frontier = [(initial_state, [initial_state], 0)]
    explored = set()
    nodes_explored = 0
    
    while frontier:
        current_state, path, cost = frontier.pop()  # pop() pour LIFO
        nodes_explored += 1
        
        # Test du but
        if current_state == goal_state:
            return path, cost, nodes_explored
        
        # Limite de profondeur
        if len(path) > max_depth:
            continue
        
        # Marquer comme explore
        explored.add(current_state)
        
        # Explorer les successeurs (en inverse pour ordre naturel)
        successors = list(get_successors(current_state))
        for next_state, action, action_cost in reversed(successors):
            if next_state not in explored:
                new_path = path + [next_state]
                new_cost = cost + action_cost
                frontier.append((next_state, new_path, new_cost))
    
    return None, 0, nodes_explored

# Test de DFS
dfs_path, dfs_cost, dfs_nodes = dfs(initial_state, goal_state, grid.get_successors)

print("=== Depth-First Search (DFS) ===")
print(f"Chemin trouve: {' -> '.join(str(s) for s in dfs_path)}")
print(f"Cout total: {dfs_cost}")
print(f"Noeuds explores: {dfs_nodes}")
print(f"Longueur du chemin: {len(dfs_path) - 1} actions")
=== Depth-First Search (DFS) ===
Chemin trouve: (0,0) -> (0,1) -> (0,2) -> (1,2) -> (1,1) -> (1,0) -> (2,0) -> (2,1) -> (2,2)
Cout total: 8
Noeuds explores: 9
Longueur du chemin: 8 actions

3.3 Comparaison BFS vs DFS

Critere BFS DFS
Structure File (FIFO) Pile (LIFO)
Optimalite Oui (cout uniforme) Non
Completude Oui Oui (profondeur limitee)
Memoire O(b^d) O(b*d)
Temps O(b^d) O(b^m)

Ou : - \(b\) = facteur de branchement moyen - \(d\) = profondeur de la solution optimale - \(m\) = profondeur maximale

# Comparaison cote a cote
print("=== Comparaison BFS vs DFS ===")
print(f"{'Algorithme':<10} {'Cout':<10} {'Noeuds explores':<20} {'Longueur chemin'}")
print("-" * 55)
print(f"{'BFS':<10} {bfs_cost:<10} {bfs_nodes:<20} {len(bfs_path) - 1}")
print(f"{'DFS':<10} {dfs_cost:<10} {dfs_nodes:<20} {len(dfs_path) - 1}")

# Verifier si DFS est optimal
if dfs_cost > bfs_cost:
    print(f"\nDFS a trouve une solution SOUS-OPTIMALE ({dfs_cost} > {bfs_cost})")
else:
    print(f"\nDFS a trouve une solution optimale")
=== Comparaison BFS vs DFS ===
Algorithme Cout       Noeuds explores      Longueur chemin
-------------------------------------------------------
BFS        4          9                    4
DFS        8          9                    8

DFS a trouve une solution SOUS-OPTIMALE (8 > 4)

Interpretation : BFS garantit l’optimalite, DFS non

Résultat obtenu : sur le même problème, BFS trouve un chemin de cout 4 tandis que DFS en trouve un de cout 8.

Metrique BFS DFS
Chemin (0,0)-(0,1)-(0,2)-(1,2)-(2,2) (0,0)-(0,1)-(0,2)-(1,2)-(1,1)-(1,0)-(2,0)-(2,1)-(2,2)
Cout 4 8
Noeuds explores 9 9

Points cles : - BFS explore par couches de profondeur : la première solution trouvee est toujours la plus courte en nombre d’actions (cout uniforme) - DFS plonge dans une direction sans considérer la distance au but : il a visite tout le perimetre avant d’atteindre (2,2) - Les 9 noeuds explores sont identiques : sur cette grille 3x3, les deux algorithmes visitent l’integralite de l’espace, mais l’ordre de visite differe fondamentalement

3.4 Recherche en arrière — la régression

Toutes les recherches de la section 3 vont en avant : elles partent d’un état initial et appliquent les actions jusqu’à atteindre le but. La planification admet une direction duale, la recherche en arrière (ou régression), qui part du but et inverse les actions pour retrouver les états qui mènent à lui.

En STRIPS, l’inverse d’une action \(a = (pre, add, del)\) se lit directement dans ses trois composantes :

\[\text{regress}(g, a) = (g \setminus add(a)) \cup pre(a)\]

Autrement dit : pour que \(g\) soit vrai après \(a\), il faut que \(g\) soit vrai avant \(a\) sauf ce que \(a\) ajoute (qui devient vrai grâce à \(a\)), plus ce que \(a\) exige. Cette formule n’a de sens que si l’action peut réellement produire \(g\) — c’est la condition de pertinence, la duale exacte de l’applicabilité :

Applicabilité (en avant) Pertinence (en arrière)
Condition \(pre(a) \subseteq s\) \(add(a) \cap g \neq \varnothing\)
Interdiction — \(del(a) \cap g = \varnothing\)
Lecture « dans cet état, l’action s’applique » « pour ce but, l’action peut aider »

Une action applicable peut servir n’importe quel but ; une action pertinente est celle dont l’effet produit au moins un littéral du but sans en détruire aucun.

But partiel. Les algorithmes de la section 3 comparaient l’état courant à un état but unique. La régression lève cette restriction : le but \(G\) est un ensemble de littéraux (une description partielle de l’état visé). C’est là que la duale devient réellement utile — on n’a pas besoin de matérialiser un état complet.

Note de modélisation. Dans le Monde des Blocs, l’action move(X,Y) exige que X repose sur un support \(Z\) (X est posé sur quelque chose). En régression ce support est inconnu : on le note on(X, ?) (porteur libre). Le littéral on(X, ?) est vrai dans un état dès que X est posé sur un support réel.

# Monde des Blocs STRIPS minimal, porteur libre (on(X, ?))
# On construit le dual exact de la recherche avant : la regression (recherche arriere).
import collections

BLOCKS = ['A', 'B', 'C']
TAB = 'Table'
TARGETS = BLOCKS + [TAB]            # ce sur quoi un bloc peut etre pose

def on(x, y): return ('on', x, y)
def clr(x):   return ('clear', x)
def on_free(x): return ('on', x, None)   # "x est pose sur un support inconnu"

def is_free(l): return l[0] == 'on' and l[2] is None

def fmt(l):
    if is_free(l): return f"on({l[1]}, ?)"
    if l[0] == 'clear': return f"clear({l[1]})"
    return f"on({l[1]}, {l[2]})"
def fmt_set(s):
    if not s: return "∅"
    return "{" + ", ".join(fmt(l) for l in sorted(s, key=lambda l: (l[0], str(l[1:])))) + "}"

def subkey(s):
    return (len(s), tuple(sorted((l[0], str(l[1:])) for l in s)))

# Actions schematiques move(X,Y) : X est pose sur Y (Y != X). Le support de X est libre.
def build_strips_actions():
    acts = {}
    for X in BLOCKS:
        for Y in TARGETS:
            if Y == X: continue
            pre = {clr(X), on_free(X)}
            if Y != TAB: pre.add(clr(Y))
            add = {on(X, Y)}
            dele = {on_free(X)}
            if Y != TAB: dele.add(clr(Y))
            acts[f"move({X},{Y})"] = {'name': f"move({X},{Y})", 'pre': pre, 'add': add, 'del': dele}
    return acts
S_ACTIONS = build_strips_actions()

def lit_true(l, state):
    if is_free(l):
        return any(('on', l[1], z) in state for z in TARGETS if z != l[1])
    return l in state
def sub_ok(sub, state):
    return all(lit_true(l, state) for l in sub)

# --- cote avant ---
def applicable(a, state): return sub_ok(a['pre'], state)
def apply(a, state):
    ns = set(state)
    for l in a['del']:
        if is_free(l): ns = {s for s in ns if not (s[0] == 'on' and s[1] == l[1])}
        else: ns.discard(l)
    ns |= a['add']
    return frozenset(ns)

# --- cote arriere : la duale ---
def pertinente(a, but):
    if not (a['add'] & but): return False
    for d in a['del']:
        if d in but: return False
    return True
def regress(but, a):
    if not pertinente(a, but): return None
    r = set(but - a['add'])
    for p in a['pre']: r.add(p)
    return frozenset(r)
def get_predecessors(but):
    return [(a['name'], regress(but, a)) for a in S_ACTIONS.values() if regress(but, a) is not None]

# Etat initial : les trois blocs poses sur la table
INIT = frozenset({on('A', TAB), on('B', TAB), on('C', TAB), clr('A'), clr('B'), clr('C')})

def bfs_forward(init, goal, maxn=5000):
    vis = {frozenset(init)}
    q = collections.deque([(init, [])]); nodes = 1
    while q and nodes < maxn:
        st, pl = q.popleft()
        if goal <= st: return pl, nodes
        for a in S_ACTIONS.values():
            if applicable(a, st):
                ns = apply(a, st)
                if ns not in vis: vis.add(ns); q.append((ns, pl + [a['name']])); nodes += 1
    return None, nodes

def bfs_backward(goal, init, maxn=5000):
    # BFS en arriere : chaque sous-but de la file est un ensemble de litteraux a rendre vrais.
    vis = {frozenset(goal)}
    q = collections.deque([(goal, [])]); nodes = 1
    while q and nodes < maxn:
        sub, pl = q.popleft()
        if sub_ok(sub, init): return pl, nodes, list(vis)   # vis = tous les sous-buts rencontres
        for name, r in get_predecessors(sub):
            if r is None: continue
            if r not in vis: vis.add(r); q.append((r, pl + [name])); nodes += 1
    return None, nodes, list(vis)

# ---- Demo 1 : but a UN SEUL litteral (les autres blocs non contraints) ----
GOAL1 = frozenset({on('A', 'B')})
print("Demo 1 : but PARTIEL", fmt_set(GOAL1), "- les blocs B et C ne sont pas contraints")
print("  Initial :", fmt_set(INIT))
print("  Sous-buts rencontres :")
fwd_plan, fwd_nodes = bfs_forward(INIT, GOAL1)
bwd_plan, bwd_nodes, frontier = bfs_backward(GOAL1, INIT)
for i, s in enumerate(sorted(frontier, key=subkey)):
    print("    sous-but", i+1, ":", fmt_set(s))
print("  Avant  :", fwd_nodes, "noeuds, plan", fwd_plan)
print("  Arr    :", bwd_nodes, "noeuds, sous-buts (plan inverse)", [a for a in bwd_plan])

# ---- Demo 2 : tour A/B/C - le plan arriere sort inverse du plan avant ----
GOAL2 = frozenset({on('A', 'B'), on('B', 'C')})
fwd2, nf2 = bfs_forward(INIT, GOAL2)
bwd2, nb2, fr2 = bfs_backward(GOAL2, INIT)
print("\nDemo 2 : but", fmt_set(GOAL2))
print("  Avant  :", nf2, "noeuds, plan", fwd2)
print("  Arr    :", nb2, "noeuds, plan", bwd2)
print("  Sous-buts de la demo 2 :")
for s in sorted(fr2, key=subkey):
    print("    ", fmt_set(s))
print("\nBranchement depuis INIT (actions applicables) :", len([a for a in S_ACTIONS.values() if applicable(a, INIT)]))
print("Branchement depuis le but 1 (actions pertinentes) :", len(get_predecessors(GOAL1)))
Demo 1 : but PARTIEL {on(A, B)} - les blocs B et C ne sont pas contraints
  Initial : {clear(A), clear(B), clear(C), on(A, Table), on(B, Table), on(C, Table)}
  Sous-buts rencontres :
    sous-but 1 : {on(A, B)}
    sous-but 2 : {clear(A), clear(B), on(A, ?)}
  Avant  : 7 noeuds, plan ['move(A,B)']
  Arr    : 2 noeuds, sous-buts (plan inverse) ['move(A,B)']

Demo 2 : but {on(A, B), on(B, C)}
  Avant  : 27 noeuds, plan ['move(B,C)', 'move(A,B)']
  Arr    : 4 noeuds, plan ['move(A,B)', 'move(B,C)']
  Sous-buts de la demo 2 :
     {on(A, B), on(B, C)}
     {clear(A), clear(B), on(A, ?), on(B, C)}
     {clear(B), clear(C), on(A, B), on(B, ?)}
     {clear(A), clear(B), clear(C), on(A, ?), on(B, ?)}

Branchement depuis INIT (actions applicables) : 9
Branchement depuis le but 1 (actions pertinentes) : 1

Interprétation : la régression exploite le but partiel

Les deux démos mesurent le nombre de nœuds explorés — états complets pour la recherche avant, ensembles de sous-buts pour la recherche arrière — sur la même instance :

Instance Avant (nœuds) Arrière (nœuds) Branchement avant Branchement arrière
but {on(A, B)} 7 2 9 actions applicables 1 action pertinente
but {on(A, B), on(B, C)} 27 4 9 applicables 2 pertinentes

Pourquoi l’arrière explore moins. Le facteur de branchement n’est pas le même dans les deux sens. En avant, depuis un état donné, toutes les actions applicables sont essayées — ici 9 (chaque bloc peut se poser sur deux de ses congénères ou la table). En arrière, depuis un but, seules les actions pertinentes importent — celles dont l’effet produit un littéral du but (1 ou 2 ici). La condition de pertinence (add ∩ but ≠ ∅ et del ∩ but = ∅) filtre l’essentiel du branchement avant.

Le but partiel est la clé. Dans la démo 1, le but {on(A, B)} ne contraint ni B ni C. La recherche avant doit quand même construire un état complet des trois blocs (7 états explorés). La recherche arrière, elle, ne manipule qu’un seul littéral à la fois : son chemin est {on(A,B)} → {clear(A), clear(B), on(A, ?)}, ensemble déjà vrai dans l’état initial. Elle n’a jamais besoin de décider où vont B et C pendant qu’elle cherche — c’est ce qui rend la régression naturelle pour les buts partiels, et c’est précisément le point que l’énoncé de §1.1 (le but est un ensemble) anticipait mais que les algorithmes en avant n’exploitent pas.

Le plan arrière est inversé. La démo 2 le montre explicitement : la recherche avant produit [move(B,C), move(A,B)] (on construit la tour du bas vers le haut), la recherche arrière produit le même plan lu en sens inverse [move(A,B), move(B,C)] (on part du but et on remonte vers l’état initial). C’est un plan valide — les deux directions se lisent l’une l’autre.

La limite à retenir. La régression n’est pas magiquement « meilleure » : son branchement est faible quand la pertinence filtre bien (but partiel, actions à effets dissociés), mais il peut exploser sur des domaines où beaucoup d’actions produisent chacun des littéraux du but. La leçon est la dualité elle-même : applicabilité en avant, pertinence en arrière, et la régression comme lecture inverse du modèle STRIPS que §2 a payé sans jamais l’utiliser.


4. Recherche Informee

Les algorithmes de recherche informee utilisent une heuristique pour estimer le cout restant jusqu’au but.

4.1 Heuristique pour la navigation

Pour la navigation en grille, une heuristique naturelle est la distance de Manhattan :

\[h(n) = |x_n - x_{but}| + |y_n - y_{but}|\]

def manhattan_distance(state: GridState, goal: GridState) -> int:
    """Heuristique de distance de Manhattan."""
    return abs(state.x - goal.x) + abs(state.y - goal.y)

# Test de l'heuristique sur differents etats
print("=== Heuristique de Distance Manhattan ===")
test_states = [GridState(0,0), GridState(1,1), GridState(2,2), GridState(0,2)]

print(f"{'Etat':<10} {'h(n)':<10} {'Interpretation'}")
print("-" * 40)
for s in test_states:
    h = manhattan_distance(s, goal_state)
    interp = "(etat but)" if s == goal_state else f"{h} deplacements min"
    print(f"{str(s):<10} {h:<10} {interp}")
=== Heuristique de Distance Manhattan ===
Etat       h(n)       Interpretation
----------------------------------------
(0,0)      4          4 deplacements min
(1,1)      2          2 deplacements min
(2,2)      0          (etat but)
(0,2)      2          2 deplacements min

Interpretation : Efficacite de Greedy Best-First

Résultat obtenu : Greedy explore 5 noeuds seulement (contre 9 pour BFS) tout en trouvant le chemin optimal.

Algorithme Noeuds explores Cout Optimal ?
BFS 9 4 Oui (garanti)
DFS 9 8 Non
Greedy 5 4 Oui (chanceux)

Points cles : - Greedy suit directement la direction du but (h decroissante), ignorant le cout accumule - Sur cette grille sans obstacles, l’heuristique guide parfaitement vers le but - En presence d’obstacles, Greedy peut s’enliser dans un cul-de-sac ou trouver un chemin sous-optimal

4.3 Algorithme A*

A* combine le cout accumule \(g(n)\) et l’heuristique \(h(n)\) :

\[f(n) = g(n) + h(n)\]

Avec une heuristique admissible (\(h(n) \leq h^*(n)\)), A* garantit l’optimalite.

def a_star(initial_state, goal_state, get_successors, heuristic) -> Tuple[List, int, int]:
    """
    A* Search Algorithm.
    Utilise f(n) = g(n) + h(n) ou g(n) est le cout accumule.
    
    Avec une heuristique admissible, garantit l'optimalite.
    
    Retourne: (chemin, cout, noeuds_explores)
    """
    # File de priorite basee sur f(n) = g(n) + h(n)
    counter = 0
    h0 = heuristic(initial_state, goal_state)
    frontier = [(h0, counter, initial_state, [initial_state], 0)]  # (f, _, state, path, g)
    explored = {}  # Etat -> meilleur g(n) connu
    nodes_explored = 0
    
    while frontier:
        f, _, current_state, path, g = heapq.heappop(frontier)
        nodes_explored += 1
        
        # Test du but
        if current_state == goal_state:
            return path, g, nodes_explored
        
        # Si deja explore avec un meilleur g, ignorer
        if current_state in explored and explored[current_state] <= g:
            continue
        
        explored[current_state] = g
        
        # Explorer les successeurs
        for next_state, action, action_cost in get_successors(current_state):
            new_g = g + action_cost
            
            if next_state not in explored or explored[next_state] > new_g:
                h = heuristic(next_state, goal_state)
                f = new_g + h
                new_path = path + [next_state]
                counter += 1
                heapq.heappush(frontier, (f, counter, next_state, new_path, new_g))
    
    return None, 0, nodes_explored

# Test de A*
astar_path, astar_cost, astar_nodes = a_star(
    initial_state, goal_state, grid.get_successors, manhattan_distance
)

print("=== A* Search ===")
print(f"Chemin trouve: {' -> '.join(str(s) for s in astar_path)}")
print(f"Cout total: {astar_cost}")
print(f"Noeuds explores: {astar_nodes}")
print(f"Longueur du chemin: {len(astar_path) - 1} actions")
=== A* Search ===
Chemin trouve: (0,0) -> (0,1) -> (0,2) -> (1,2) -> (2,2)
Cout total: 4
Noeuds explores: 12
Longueur du chemin: 4 actions

Interpretation des résultats A*

Pour cet exemple simple, tous les algorithmes trouvent le chemin optimal (cout = 4). Cependant :

Algorithme f(n) Optimalite Efficacite
BFS profondeur Oui (cout uniforme) Explore tous les noeuds <= d
Greedy h(n) Non Rapide mais peut sous-optimiser
A* g(n) + h(n) Oui (h admissible) Guide vers le but efficacement

L’avantage d’A* devient evident sur des problemes plus grands.


5. Proprietes des Heuristiques

La qualite d’une heuristique determine l’efficacite d’A*. Deux proprietes sont importantes.

5.1 Admissibilite

Une heuristique \(h\) est admissible si elle ne surestime jamais le cout restant :

\[h(n) \leq h^*(n) \quad \forall n\]

ou \(h^*(n)\) est le cout optimal reel de \(n\) au but.

Exemple : La distance de Manhattan est admissible car c’est le chemin le plus court possible sans obstacles.

# Demonstration de l'admissibilite de Manhattan
print("=== Verification de l'admissibilite ===")
print("\nLa distance de Manhattan est ADMISSIBLE car:")
print("- Elle represente le chemin le plus court sans contraintes")
print("- En presence d'obstacles, le chemin reel >= h_manhattan")
print("- Elle ne surestime jamais le cout reel")

# Exemple avec obstacle
grid_with_obstacle = GridWorld(3, 3, obstacles={(1, 1)})
_h_val = manhattan_distance(GridState(0,0), goal_state)
# h* via BFS sur la grille a obstacle. NB: l'obstacle (1,1) est hors de tous les
# plus courts chemins (0,0)->(2,2) (ex. (0,0)->(0,1)->(0,2)->(1,2)->(2,2)), donc le
# chemin optimal reste de cout 4 : ici h = h* (Manhattan exacte, donc admissible).
_h_star = bfs(GridState(0,0), goal_state, grid_with_obstacle.get_successors)[1]
print("\n--- Grille avec obstacle en (1,1) ---")
print(f"h((0,0), (2,2)) = {_h_val}")
print(f"h*((0,0), (2,2)) = {_h_star} (chemin reel optimal, via BFS)")
print(f"h <= h* ? {_h_val <= _h_star}, l'heuristique est admissible (ici h = h* : l'obstacle (1,1) est hors des plus courts chemins, il n'allonge pas le trajet)")
=== Verification de l'admissibilite ===

La distance de Manhattan est ADMISSIBLE car:
- Elle represente le chemin le plus court sans contraintes
- En presence d'obstacles, le chemin reel >= h_manhattan
- Elle ne surestime jamais le cout reel

--- Grille avec obstacle en (1,1) ---
h((0,0), (2,2)) = 4
h*((0,0), (2,2)) = 4 (chemin reel optimal, via BFS)
h <= h* ? True, l'heuristique est admissible (ici h = h* : l'obstacle (1,1) est hors des plus courts chemins, il n'allonge pas le trajet)

5.2 Coherence (Consistance)

Une heuristique \(h\) est coherente (ou consistante) si pour tout noeud \(n\) et successeur \(n'\) :

\[h(n) \leq c(n, n') + h(n')\]

C’est l’inegalite triangulaire : l’heuristique ne peut pas decroitre plus vite que le cout reel.

def check_consistency(grid, goal, heuristic):
    """Verifie la coherence d'une heuristique sur tous les etats."""
    inconsistencies = []
    
    for x in range(grid.width):
        for y in range(grid.height):
            state = GridState(x, y)
            if not grid.is_valid(state):
                continue
                
            h_n = heuristic(state, goal)
            
            for next_state, action, cost in grid.get_successors(state):
                h_next = heuristic(next_state, goal)
                
                # h(n) <= c(n,n') + h(n')
                if h_n > cost + h_next:
                    inconsistencies.append((state, next_state, h_n, cost, h_next))
    
    return inconsistencies

# Verification de la coherence de Manhattan
inconsistencies = check_consistency(grid, goal_state, manhattan_distance)

print("=== Verification de la coherence ===")
print("Condition: h(n) <= c(n,n') + h(n') pour tout n et successeur n'")

if not inconsistencies:
    print("\nResultat: La distance de Manhattan est COHERENTE")
    print("Aucune violation de l'inegalite triangulaire detectee.")
else:
    print(f"\nResultat: {len(inconsistencies)} violations detectees")
    for state, next_state, h_n, cost, h_next in inconsistencies[:3]:
        print(f"  {state}->{next_state}: h(n)={h_n} > c+ h(n')={cost}+{h_next}={cost+h_next}")
=== Verification de la coherence ===
Condition: h(n) <= c(n,n') + h(n') pour tout n et successeur n'

Resultat: La distance de Manhattan est COHERENTE
Aucune violation de l'inegalite triangulaire detectee.

Interpretation : Verification de la coherence (inegalite triangulaire)

Résultat obtenu : la distance de Manhattan ne viole jamais la condition \(h(n) \leq c(n, n') + h(n')\) sur la grille 3x3.

Propriete Condition Consequence pour A*
Admissibilite \(h(n) \leq h^*(n)\) Optimalite garantie
Coherence \(h(n) \leq c(n,n') + h(n')\) Pas de re-expansion de noeuds

Points cles : - La coherence implique l’admissibilite (mais pas la reciproque) - Avec une heuristique coherente, A* ne re-explore jamais un noeud déjà visite, ce qui garantit une complexite en temps polynomiale par rapport au nombre d’etats - Manhattan est coherente en 4-connectivite car chaque pas unitaire ne change la distance que de 1 au maximum

5.3 Heuristiques admissibles vs non admissibles

Heuristique Admissible Résultat A*
Manhattan Oui Optimal
Euclidean Oui Optimal (distance vol d’oiseau)
Zero Oui Optimal (equivalent a Dijkstra)
Double Manhattan Non Sous-optimal possible
Carre de Manhattan Non Sous-optimal certain
# Comparaison d'heuristiques admissibles et non admissibles

# Heuristique non admissible: double de Manhattan
def double_manhattan(state: GridState, goal: GridState) -> int:
    """Heuristique NON ADMISSIBLE."""
    return 2 * manhattan_distance(state, goal)

# Heuristique triviale admissible
def zero_heuristic(state: GridState, goal: GridState) -> int:
    """Heuristique admissible triviale."""
    return 0

print("=== Comparaison d'heuristiques ===")
print(f"{'Heuristique':<20} {'Admissible':<12} {'Cout':<8} {'Noeuds explores'}")
print("-" * 55)

# Test avec differentes heuristiques
heuristics = [
    ("Manhattan", manhattan_distance, True),
    ("Zero", zero_heuristic, True),
    ("Double Manhattan", double_manhattan, False)
]

for name, h_func, is_adm in heuristics:
    path, cost, nodes = a_star(initial_state, goal_state, grid.get_successors, h_func)
    adm_str = "Oui" if is_adm else "Non"
    print(f"{name:<20} {adm_str:<12} {cost:<8} {nodes}")

print("\nObservation: Double Manhattan peut trouver une solution sous-optimale.")
=== Comparaison d'heuristiques ===
Heuristique          Admissible   Cout     Noeuds explores
-------------------------------------------------------
Manhattan            Oui          4        12
Zero                 Oui          4        12
Double Manhattan     Non          4        5

Observation: Double Manhattan peut trouver une solution sous-optimale.

Interpretation : Impact de l’heuristique sur l’efficacite d’A*

Résultat obtenu : trois heuristiques testees sur le même problème donnent des résultats contrastes.

Heuristique Admissible Noeuds explores Cout trouve Optimal ?
Manhattan Oui 12 4 Oui
Zero (Dijkstra) Oui 12 4 Oui
Double Manhattan Non 5 4 Oui (chanceux)

Points cles : - Manhattan et Zero explorent le même nombre de noeuds (12) ici car la grille est petite ; l’ecart grandit sur des problemes plus grands - Double Manhattan est plus rapide (5 noeuds) mais non optimal en general : sur cette instance simple, le hasard a produit le chemin optimal - Une heuristique non admissible peut etre utilisee quand la vitesse prime sur l’optimalite (planning temps reel)


6. Exemple Pratique : Problème du 8-Puzzle

Le 8-puzzle est un problème classique de planification. Il consiste a deplacer des tuiles numerotees pour atteindre une configuration cible.

from typing import Tuple
import copy

@dataclass(frozen=True)
class PuzzleState:
    """Etat du 8-puzzle."""
    tiles: Tuple[Tuple[int, ...], ...]  # 3x3 grid
    
    @classmethod
    def from_list(cls, grid: List[List[int]]) -> 'PuzzleState':
        return cls(tuple(tuple(row) for row in grid))
    
    def find_blank(self) -> Tuple[int, int]:
        """Trouve la position du trou (0)."""
        for i in range(3):
            for j in range(3):
                if self.tiles[i][j] == 0:
                    return (i, j)
        raise ValueError("Pas de trou trouve")
    
    def __repr__(self):
        s = "\n".join(" ".join(str(x) if x != 0 else " " for x in row) for row in self.tiles)
        return s

class EightPuzzle:
    """Probleme du 8-puzzle."""
    
    MOVES = {'up': (-1, 0), 'down': (1, 0), 'left': (0, -1), 'right': (0, 1)}
    
    def __init__(self, goal_state: PuzzleState):
        self.goal = goal_state
    
    def get_successors(self, state: PuzzleState) -> List[Tuple[PuzzleState, str, int]]:
        """Retourne les etats successeurs."""
        successors = []
        blank_i, blank_j = state.find_blank()
        
        for move_name, (di, dj) in self.MOVES.items():
            new_i, new_j = blank_i + di, blank_j + dj
            
            if 0 <= new_i < 3 and 0 <= new_j < 3:
                # Creer un nouvel etat avec les tuiles echangees
                new_tiles = [list(row) for row in state.tiles]
                new_tiles[blank_i][blank_j] = new_tiles[new_i][new_j]
                new_tiles[new_i][new_j] = 0
                new_state = PuzzleState.from_list(new_tiles)
                successors.append((new_state, move_name, 1))
        
        return successors
    
    def manhattan_heuristic(self, state: PuzzleState) -> int:
        """Heuristique de distance Manhattan pour le 8-puzzle."""
        distance = 0
        
        # Position cible de chaque tuile dans l'etat but
        goal_positions = {}
        for i in range(3):
            for j in range(3):
                tile = self.goal.tiles[i][j]
                goal_positions[tile] = (i, j)
        
        # Calculer la distance Manhattan de chaque tuile
        for i in range(3):
            for j in range(3):
                tile = state.tiles[i][j]
                if tile != 0:  # Ignorer le trou
                    goal_i, goal_j = goal_positions[tile]
                    distance += abs(i - goal_i) + abs(j - goal_j)
        
        return distance

# Configuration du 8-puzzle
goal_puzzle = PuzzleState.from_list([[1, 2, 3], [4, 5, 6], [7, 8, 0]])
initial_puzzle = PuzzleState.from_list([[1, 2, 3], [4, 0, 6], [7, 5, 8]])

puzzle = EightPuzzle(goal_puzzle)

print("=== 8-Puzzle ===")
print("\nEtat initial:")
print(initial_puzzle)
print("\nEtat but:")
print(goal_puzzle)
print(f"\nHeuristique h(initial) = {puzzle.manhattan_heuristic(initial_puzzle)}")
=== 8-Puzzle ===

Etat initial:
1 2 3
4   6
7 5 8

Etat but:
1 2 3
4 5 6
7 8  

Heuristique h(initial) = 2

Resolution du 8-puzzle avec l’algorithme A* en utilisant la distance de Manhattan comme heuristique admissible, puis affichage de la sequence de mouvements trouvee.

# Resolution du 8-puzzle avec A*
print("=== Resolution du 8-Puzzle avec A* ===")

# Adapter l'heuristique pour l'interface A*
def puzzle_heuristic(state, goal):
    return puzzle.manhattan_heuristic(state)

path, cost, nodes = a_star(
    initial_puzzle, 
    goal_puzzle, 
    puzzle.get_successors, 
    puzzle_heuristic
)

print(f"Solution trouvee en {cost} mouvements")
print(f"Noeuds explores: {nodes}")
print(f"\nSequence de mouvements: {' -> '.join(str(s) for s in path)}")
print(f"\nLongueur du chemin: {len(path)} etats")
=== Resolution du 8-Puzzle avec A* ===
Solution trouvee en 2 mouvements
Noeuds explores: 3

Sequence de mouvements: 1 2 3
4   6
7 5 8 -> 1 2 3
4 5 6
7   8 -> 1 2 3
4 5 6
7 8  

Longueur du chemin: 3 etats

Interpretation de la solution 8-Puzzle

Metrique Valeur
Mouvements Variable selon la configuration initiale
Noeuds explores A* explore moins que BFS grace a l’heuristique
Optimalite Garantie par l’heuristique de Manhattan (admissible)

Note : Le 8-puzzle a \(9!/2 = 181,440\) etats accessibles. L’heuristique est cruciale pour resoudre efficacement les instances difficiles.


7. Resume et Comparaison des Algorithmes

7.1 Tableau comparatif final

# Recapitulatif de tous les algorithmes testes
print("=== Resume des Algorithmes de Recherche ===")
print(f"{'Algorithme':<25} {'Type':<15} {'Optimal':<10} {'Heuristique'}")
print("-" * 65)
print(f"{'BFS':<25} {'Non informe':<15} {'Oui*':<10} {'Non'}")
print(f"{'DFS':<25} {'Non informe':<15} {'Non':<10} {'Non'}")
print(f"{'Greedy Best-First':<25} {'Informe':<15} {'Non':<10} {'Oui (h seulement)'}")
print(f"{'A*':<25} {'Informe':<15} {'Oui':<10} {'Oui (g + h)'}")
print("-" * 65)
print("* BFS est optimal uniquement si tous les pas ont le meme cout. Sur un terrain")
print("  pondere (couts variables), seul A* (ou Dijkstra) garantit le cout minimal :")
print("  voir l'exemple guide ci-dessous.")
=== Resume des Algorithmes de Recherche ===
Algorithme                Type            Optimal    Heuristique
-----------------------------------------------------------------
BFS                       Non informe     Oui*       Non
DFS                       Non informe     Non        Non
Greedy Best-First         Informe         Non        Oui (h seulement)
A*                        Informe         Oui        Oui (g + h)
-----------------------------------------------------------------
* BFS est optimal uniquement si tous les pas ont le meme cout. Sur un terrain
  pondere (couts variables), seul A* (ou Dijkstra) garantit le cout minimal :
  voir l'exemple guide ci-dessous.

7.2 Points cles a retenir

Concept Definition
Etat Configuration du monde a un instant donne
Espace d’etats Graphe des etats accessibles
Heuristique Fonction estimant le cout restant vers le but
Admissibilite \(h(n) \leq h^*(n)\) (ne surestime jamais)
Coherence \(h(n) \leq c(n,n') + h(n')\) (inegalite triangulaire)
A* Algorithme optimal avec heuristique admissible

7.3 Lien avec la planification PDDL

Dans le contexte de la planification : - Les etats sont des ensembles de predicats (faits vrais) - Les actions sont les transitions entre etats - Les heuristiques sont souvent calculees a partir du relaxation du problème

Les planificateurs modernes comme Fast Downward utilisent des variantes sophistiquees d’A* avec des heuristiques comme : - \(h^{add}\) : Heuristique additive - \(h^{max}\) : Heuristique maximum - \(h^{FF}\) : Heuristique Fast Forward - \(h^{LM-cut}\) : Heuristique bas sur les landmarks


7.4 Exemple guide : Terrain pondere – pourquoi A* se distingue de BFS

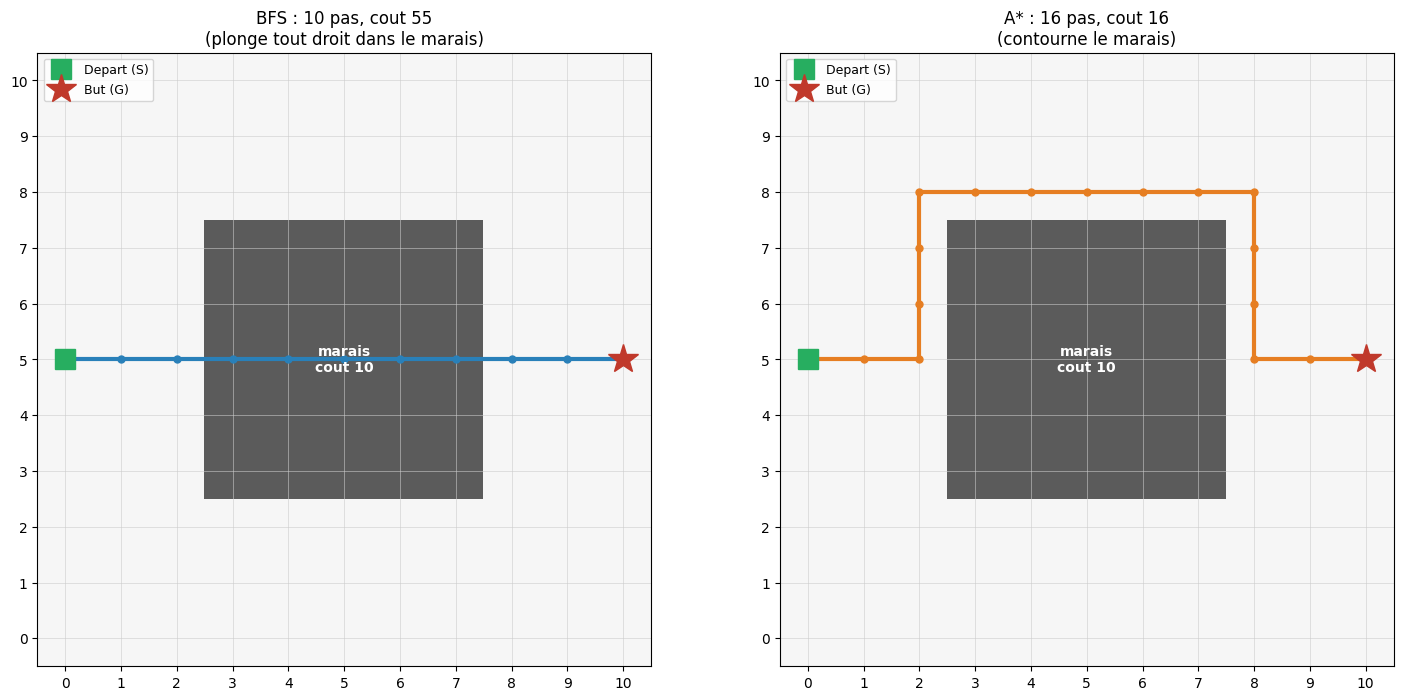
Sur une grille a cout uniforme (chaque pas coute 1), BFS est deja optimal : le chemin avec le moins de pas est aussi le moins couteux, et A* ne peut pas faire mieux – le differenciateur entre les algorithmes n’apparait pas. Pour le reveler, nous passons a un terrain pondere : une grille 11x11 dotee d’un marais central (cout 10 par case de marais, 1 sinon), avec le depart et le but alignes de part et d’autre du marais. C’est exactement la situation ou raisonner sur le cout cumule (A*, Dijkstra) plutot que sur le seul nombre de pas (BFS, Greedy) change le resultat.

Ce que nous allons faire : 1. Definir une grille 11x11 avec un marais central 5x5 (25 cases a cout 10, les autres a cout 1) 2. Lancer BFS, Greedy Best-First et A* sur ce meme terrain pondere 3. Visualiser les chemins : BFS plonge tout droit dans le marais, A* le contourne 4. Comparer le nombre de pas et le cout – c’est la que l’optimalite d’A* se distingue

# Exemple guide : terrain pondere -- BFS/Greedy minimisent les PAS, A* le COUT
# C'est LE differenciateur d'optimalite : BFS trouve un chemin court en etapes,
# mais ce n'est PAS le chemin le moins couteux. Seul A* (cout cumule g + h) le trouve.

import numpy as np

# 1. Grille 11x11 avec un marais central : chaque case du marais coute 10 (sinon 1)
W = H = 11
marais = {(x, y) for x in range(3, 8) for y in range(3, 8)}  # bloc central 5x5
COUT_MARAIS = 10
start_w = GridState(0, 5)
goal_w = GridState(10, 5)

def cout_case(x, y):
    """Cout pour entrer dans la case (x, y) : terrain pondere."""
    return COUT_MARAIS if (x, y) in marais else 1

# Successeurs ponderes : le cout d'un pas depend du terrain de la case d'arrivee.
# (GridWorld.get_successors renvoie un cout uniforme de 1 ; ici on le pondere.)
ACTIONS = [(0, 1), (0, -1), (-1, 0), (1, 0)]
def successeurs_ponderes(state):
    voisins = []
    for dx, dy in ACTIONS:
        nx_, ny_ = state.x + dx, state.y + dy
        if 0 <= nx_ < W and 0 <= ny_ < H:
            voisins.append((GridState(nx_, ny_), None, cout_case(nx_, ny_)))
    return voisins

print(f"Grille {W}x{H} | marais central de {len(marais)} cases (cout {COUT_MARAIS}) "
      f"| depart {start_w} -> but {goal_w}")

# 2. Resolution par les trois algorithmes (memes fonctions que precedemment)
bfs_path_w, bfs_cost_w, bfs_nodes_w = bfs(start_w, goal_w, successeurs_ponderes)
greedy_path_w, greedy_cost_w, greedy_nodes_w = greedy_best_first(
    start_w, goal_w, successeurs_ponderes, manhattan_distance)
astar_path_w, astar_cost_w, astar_nodes_w = a_star(
    start_w, goal_w, successeurs_ponderes, manhattan_distance)

# 3. Visualisation : terrain pondere + chemin BFS (bleu) et chemin A* (orange)
terrain = np.array([[cout_case(x, y) for x in range(W)] for y in range(H)])
fig, axes = plt.subplots(1, 2, figsize=(15, 7))
panneaux = [
    (f'BFS : {len(bfs_path_w) - 1} pas, cout {bfs_cost_w}\n(plonge tout droit dans le marais)',
     bfs_path_w, '#2980b9'),
    (f'A* : {len(astar_path_w) - 1} pas, cout {astar_cost_w}\n(contourne le marais)',
     astar_path_w, '#e67e22'),
]
for ax, (titre, path, couleur) in zip(axes, panneaux):
    ax.imshow(terrain, origin='lower', cmap='Greys', vmin=0, vmax=14)
    if path:
        ax.plot([s.x for s in path], [s.y for s in path], '-o',
                color=couleur, lw=3, ms=5)
    ax.plot(start_w.x, start_w.y, 's', color='#27ae60', ms=15, label='Depart (S)')
    ax.plot(goal_w.x, goal_w.y, '*', color='#c0392b', ms=22, label='But (G)')
    ax.text(5, 5, 'marais\ncout 10', ha='center', va='center',
            color='white', fontsize=10, weight='bold')
    ax.set_title(titre, fontsize=12)
    ax.set_xticks(range(W)); ax.set_yticks(range(H))
    ax.grid(True, color='#cccccc', lw=0.4)
    ax.legend(loc='upper left', fontsize=9)
plt.tight_layout()
plt.show()

# 4. Comparaison detaillee
print("=== Terrain pondere : BFS / Greedy / A* ===")
print(f"{'Algorithme':<20} {'Pas':<6} {'Cout':<6} {'Noeuds':<8} {'Traverse le marais ?'}")
print("-" * 64)
for nom, path, cost, nodes in [
        ('BFS', bfs_path_w, bfs_cost_w, bfs_nodes_w),
        ('Greedy Best-First', greedy_path_w, greedy_cost_w, greedy_nodes_w),
        ('A*', astar_path_w, astar_cost_w, astar_nodes_w)]:
    n_marais = sum(1 for s in path if (s.x, s.y) in marais)
    etat = f'oui ({n_marais} cases)' if n_marais else 'non'
    print(f"{nom:<20} {len(path) - 1:<6} {cost:<6} {nodes:<8} {etat}")

print(f"\nBFS et Greedy minimisent le nombre de PAS ({len(bfs_path_w) - 1}) : un chemin court")
print(f"en etapes, mais cher (cout {bfs_cost_w}) car il traverse le marais tout droit.")
print(f"A* minimise le COUT reel : {len(astar_path_w) - 1} pas (plus long en etapes) mais cout {astar_cost_w},")
print("car il contourne le marais. Seul A* trouve le chemin le moins couteux.")
Grille 11x11 | marais central de 25 cases (cout 10) | depart (0,5) -> but (10,5)

=== Terrain pondere : BFS / Greedy / A* ===
Algorithme           Pas    Cout   Noeuds   Traverse le marais ?
----------------------------------------------------------------
BFS                  10     55     91       oui (5 cases)
Greedy Best-First    10     55     11       oui (5 cases)
A*                   16     16     75       non

BFS et Greedy minimisent le nombre de PAS (10) : un chemin court
en etapes, mais cher (cout 55) car il traverse le marais tout droit.
A* minimise le COUT reel : 16 pas (plus long en etapes) mais cout 16,
car il contourne le marais. Seul A* trouve le chemin le moins couteux.

Interpretation : le terrain pondere revele l’optimalite (BFS != A*)

Sur une grille a cout uniforme (chaque pas coute 1), BFS est déjà optimal : le chemin avec le moins de pas est aussi le moins couteux, et A* ne peut pas faire mieux. Le differenciateur entre les algorithmes n’apparait pas. C’est pourquoi on introduit ici un terrain pondere : un marais central ou chaque case coute 10 au lieu de 1.

Algorithme Critere minimise Pas Cout Traverse le marais
BFS nombre de pas 10 55 oui (tout droit)
Greedy heuristique h seule 10 55 oui (tout droit)
A* cout reel g + h 16 16 non (contourne)

La lecon centrale – l’optimalite :

  • BFS minimise le nombre de pas, pas le cout. Il trouve un chemin court en étapes (10 pas) mais cher (cout 55), parce qu’il fonce tout droit dans le marais. BFS ne trouve pas le chemin le moins couteux – c’est exactement ce qui le distingue d’A*.
  • Greedy se laisse berner de la même facon. Guide par la seule distance a vol d’oiseau (h), il vise le but en ligne droite et traverse le marais lui aussi (cout 55). Ignorer le cout déjà parcouru (g) le rend sous-optimal.
  • A* minimise le cout reel (f = g + h). Il accepte un chemin plus long en étapes (16 pas) pour contourner le marais et atteindre le cout minimal (16). Avec une heuristique de Manhattan admissible (elle ne surestime jamais le cout reel, car chaque pas coute au moins 1), A* garantit le chemin optimal.

Pourquoi c’est le bon exemple. Tant que tous les pas coutent pareil, « le plus court chemin » et « le moins de pas » sont la même chose : on ne voit jamais la différence entre les algorithmes. Des qu’un terrain a des couts variables – distances reelles, temps, energie – seul un algorithme qui raisonne sur le cout cumule (A*, Dijkstra) trouve l’optimum. C’est précisément la situation des heuristiques PDDL du notebook Planners-5, ou chaque action a son propre cout.


8. Exercices

Exercice 1 : Grille avec obstacles

Modifiez le monde de la grille pour inclure des obstacles et comparez les performances de BFS et A*.

Questions : 1. Combien de noeuds A* explore-t-il en moins que BFS ? 2. L’heuristique de Manhattan reste-t-elle admissible avec des obstacles ?

# Exercice 1 : Grille avec obstacles
# Creez une grille 5x5 avec des obstacles et comparez BFS vs A*

print("Exercice a completer : grille 5x5 avec obstacles, BFS vs A*")
Exercice a completer : grille 5x5 avec obstacles, BFS vs A*

Exercice 2 : Heuristique personnalisee

Implementez l’heuristique Euclidienne pour la navigation et verifiez si elle est admissible.

\[h_{eucl}(n) = \sqrt{(x_n - x_{but})^2 + (y_n - y_{but})^2}\]

Question : Est-elle coherente pour des mouvements en 4-connectivite ?

# Exercice 2 : Heuristique Euclidienne
import math

def euclidean_distance(state: GridState, goal: GridState) -> float:
    # Votre implementation ici
    pass  # TODO etudiant : calculer sqrt((x-x_goal)^2 + (y-y_goal)^2)

# Testez l'admissibilite et la coherence
print("Exercice a completer : heuristique euclidienne, admissibilite et coherence")
Exercice a completer : heuristique euclidienne, admissibilite et coherence

Exercice 3 : 8-Puzzle avec unified-planning

Utilisez unified-planning pour modeliser et resoudre le problème du 8-puzzle.

Indice : Definissez des predicats pour la position des tuiles et des actions pour les mouvements.

# Exercice 3 : 8-Puzzle avec unified-planning
try:
    from unified_planning.shortcuts import *
    print("unified-planning disponible")
    # Votre implementation ici...
except ImportError:
    print("unified-planning non installe. Voir Planners-0-Setup.ipynb")
unified-planning disponible

Exercice 4 : Heuristique Manhattan pour BlocksWorld

Implementer une heuristique Manhattan pour le problème BlocksWorld.

Indice : Comptez le nombre de blocs mal places par rapport au but.

# Exercice 4 : Heuristique Manhattan pour BlocksWorld
# TODO etudiant : Implementer une heuristique Manhattan pour le probleme BlocksWorld
# Indice : Comptez le nombre de blocs mal places par rapport au but
result = None  # TODO etudiant : remplacer par votre implementation
print("Exercice a completer : Heuristique Manhattan pour BlocksWorld")
Exercice a completer : Heuristique Manhattan pour BlocksWorld

Exercice 5 : Pertinence d’une action pour un but (régression)

Dans le Monde des Blocs du §3.4, une action move(A, B) est un dictionnaire {'name', 'pre', 'add', 'del'}. La dualité applicabilité / pertinence relie la recherche avant à la recherche arrière :

  • Applicabilité (en avant) : pre(a) ⊆ s — l’action s’applique à l’état courant.
  • Pertinence (en arrière) : add(a) ∩ g ≠ ∅ et del(a) ∩ g = ∅ — l’action peut produire au moins un littéral du but g sans en détruire aucun.

Complétez la fonction est_pertinente de la cellule suivante : elle doit dire si une action peut servir à établir un but donné.

# Exercice 5 : Pertinence d'une action pour un but (regression)
# TODO etudiant : implementer est_pertinente(action, but) qui retourne True ssi
#   add(action) & but != vide  ET  del(action) & but == vide   (condition de pertinence, §3.4)
# Indice 1 : add et del sont les ensembles 'add'/'del' du dictionnaire de l'action.
# Etape 1 : verifier add(action) & but != vide ; sinon retourner False sans aller plus loin.
# Etape 2 : verifier del(action) & but == vide ; sinon retourner False.
# Etape 3 : retourner True si les deux conditions sont remplies.

def est_pertinente(action, but):
    # TODO etudiant : implementer ici
    return None  # TODO etudiant : remplacer par votre implementation

# Test de reference : l'action move(A,B) du §3.4, et un but qui la demande.
ex_action = {
    'name': 'move(A,B)',
    'pre':  {('clear', 'A'), ('on', 'A', None), ('clear', 'B')},
    'add':  {('on', 'A', 'B')},
    'del':  {('on', 'A', None), ('clear', 'B')},
}
but = {('on', 'A', 'B')}
result = est_pertinente(ex_action, but)
print("Exercice a completer : Pertinence d'une action pour un but")
Exercice a completer : Pertinence d'une action pour un but

9. Conclusion

Resume des apprentissages

Dans ce notebook, vous avez appris :

  1. Representer un problème comme un graphe d’etats avec networkx
  2. Implementer BFS (optimal en cout uniforme) et DFS (economique en memoire)
  3. Utiliser A* avec des heuristiques admissibles pour une recherche optimale guidee
  4. Verifier l’admissibilite et la coherence des heuristiques
  5. Appliquer ces concepts au problème du 8-puzzle

Connexion avec Fast Downward

Dans le prochain notebook Planners-4-Fast-Downward, nous explorerons : - Le planificateur Fast Downward et ses heuristiques puissantes - L’heuristique LM-cut pour la planification optimale - L’integration avec PDDL et unified-planning


Ressources


Notebook suivant : Planners-4-Fast-Downward

Retour au sommet