Ce notebook fait suite a Lean-07-LLM-Integration-Lean-Python qui a mis en place l’infrastructure d’integration LLM-Lean. Ici, nous allons:
Tester des theoremes progressifs - des plus simples aux plus complexes
Comparer les providers - OpenAI vs Anthropic
Visualiser les résultats - metriques et graphiques
Benchmarks Erdos - problemes de niveau recherche
Prerequis
Executez d’abord Lean-07-LLM-Integration-Lean-Python pour avoir les classes LLMClient, ProofVerifier, ProofGenerator chargees.
Vue d’ensemble du notebook
Ce notebook est un tutoriel pratique sur l’intégration LLM-Lean pour la génération automatique de preuves formelles. Il s’articule en 4 grandes parties:
Section 8 - Problèmes d’Erdős: - Distinction entre énoncé formalisé, résultat rapporté et preuve vérifiée - Ancrage dans Formal Conjectures, Tsoukalas et al. et discrepancy_lean
Section 9 - Exercices Pratiques: - Construction de prompts efficaces - Boucles de correction itératives
Durée estimée: 20-30 minutes (avec API configurée)
Prérequis techniques: - Lean 4 installé (voir Lean-01-Setup-Lean-Python.ipynb) - Clé API OpenAI ou Anthropic configurée dans .env - Classes de lean_runner.py chargées (voir Lean-07-LLM-Integration-Lean-Python.ipynb)
Configuration de l’environnement
Cette cellule configure l’environnement Python pour utiliser les classes de lean_runner.py. Elle effectue plusieurs opérations critiques:
Recherche du répertoire - Localise lean_runner.py via plusieurs méthodes (chemin courant, chemins candidats, recherche dans les parents)
Chargement de la configuration - Lit le fichier .env avec les clés API (OpenAI, Anthropic)
Import des classes - Charge LeanRunner, LLMClient, ProofVerifier, ProofGenerator
Vérification des providers - Teste la disponibilité des API configurées
Sortie attendue: - Confirmation du répertoire trouvé - Status des providers (OK ou NON CONFIGURE) - Initialisation réussie du client et du verifier
# Configuration et Imports# Ce notebook utilise les classes de lean_runner.pyimport osimport sysfrom pathlib import Path# Trouver le repertoire du notebook (plusieurs methodes)def find_notebook_dir():"""Trouve le repertoire contenant lean_runner.py"""# Methode 1: Chercher lean_runner.py depuis le cwd et ses parents candidates = [ Path.cwd(), # Repertoire courant Path.cwd() /"MyIA.AI.Notebooks"/"SymbolicAI"/"Lean", ]for candidate in candidates:if candidate.exists() and (candidate /"lean_runner.py").exists():return candidate# Methode 2: Rechercher dans les parents du cwd current = Path.cwd()for _ inrange(8): # Remonter jusqu'a 8 niveaux lean_path = current /"MyIA.AI.Notebooks"/"SymbolicAI"/"Lean"if lean_path.exists() and (lean_path /"lean_runner.py").exists():return lean_pathif (current /"lean_runner.py").exists():return current current = current.parentraiseFileNotFoundError("Impossible de trouver lean_runner.py - verifiez le repertoire de travail")# Trouver et ajouter le repertoire au pathnotebook_dir = find_notebook_dir()ifstr(notebook_dir) notin sys.path: sys.path.insert(0, str(notebook_dir))print(f"Repertoire notebook detecte: {notebook_dir.name}")# Charger les variables d'environnementtry:from lean_runner import load_env_file env_path = notebook_dir /".env" load_env_file(env_path) env_status ="presente"if env_path.exists() else"absente"print(f"Configuration locale .env: {env_status}")exceptImportError:print("[Warning] lean_runner non disponible - execution limitee") env_path =None# Importer toutes les classes necessairestry:from lean_runner import ( LeanRunner, LeanResult, PROVIDERS_CONFIG, LLMResponse, LLMClient, LeanProofPrompt, ErrorInfo, ProofVerifier, ProofAttempt, ProofResult, ProofGenerator )print("Classes importees depuis lean_runner.py") LEAN_RUNNER_OK =TrueexceptImportError:print("[Warning] Classes lean_runner non disponibles - mode simulation") LEAN_RUNNER_OK =False# Verifier les providers disponiblesprint("\nProviders disponibles:")if LEAN_RUNNER_OK:for provider, config in PROVIDERS_CONFIG.items(): api_key = os.environ.get(config["api_key_env"]) status ="OK"if api_key else"NON CONFIGURE"print(f" - {provider}: {status}")else:print(" (lean_runner non charge)")# Initialiser le client et le verifierclient =Noneverifier =Nonetry:if os.environ.get("OPENAI_API_KEY"): client = LLMClient(provider="openai")print(f"\nClient OpenAI initialise: {client.model}")elif os.environ.get("ANTHROPIC_API_KEY"): client = LLMClient(provider="anthropic")print(f"\nClient Anthropic initialise: {client.model}")else:print("\n[Warning] Aucune API configuree - mode simulation")except (ValueError, NameError) as e:print(f"\nErreur client: {e}")try: verifier = ProofVerifier(backend="auto", timeout=30)print("ProofVerifier initialise (backend: auto)")except (Exception, NameError) as e:print(f"Erreur verifier: {e}")
Repertoire notebook detecte: Lean
Configuration locale .env: presente
Classes importees depuis lean_runner.py

Providers disponibles:
  - openai: OK
  - anthropic: OK

Client OpenAI initialise: gpt-5.2
LeanRunner initialise (backend: wsl)
ProofVerifier initialise (backend: auto)
Interprétation de la sortie
La cellule confirme l’environnement réellement utilisé sans révéler de chemin machine ni de clé :
le module local lean_runner.py a été trouvé et ses classes importées ;
les providers OpenAI et Anthropic sont tous deux déclarés OK ;
le client OpenAI utilise le modèle affiché dans la sortie ;
ProofVerifier a sélectionné le backend WSL.
Les cellules suivantes exécutent donc les appels aux deux providers et vérifient les preuves avec Lean. Cette configuration complète est nécessaire pour que la comparaison finale constitue une mesure réelle plutôt qu’un chemin de simulation.
Structure des théorèmes
Chaque théorème dans SIMPLE_THEOREMS est un dictionnaire avec:
Champ
Description
name
Identifiant du théorème
statement
Code Lean avec sorry (à prouver)
difficulty
Niveau estimé (facile, moyen, difficile)
expected_tactic
Tactique Lean attendue pour la solution
description
Explication mathématique en français
Ces théorèmes testent les propriétés arithmétiques de base sur les entiers naturels (Nat). Ils devraient être triviaux pour un LLM moderne avec fine-tuning sur Lean.
7. Exemples Progressifs et Analyse
Cette section teste notre pipeline LLM-Lean sur des theoremes de difficulte croissante.
7.1 Theoremes Simples
Commencons par des theoremes de base que Lean peut prouver avec des tactiques simples (rfl, simp, decide).
# Section 7.1 - Definition des theoremes simplesSIMPLE_THEOREMS = [ {"name": "add_zero","statement": "theorem test_add_zero (n : Nat) : n + 0 = n := by sorry","difficulty": "facile","expected_tactic": "rfl ou exact Nat.add_zero n","description": "Identite additive a droite" }, {"name": "add_comm","statement": "theorem test_add_comm (a b : Nat) : a + b = b + a := by sorry","difficulty": "facile","expected_tactic": "exact Nat.add_comm a b","description": "Commutativite de l'addition" }, {"name": "mul_assoc","statement": "theorem test_mul_assoc (a b c : Nat) : (a * b) * c = a * (b * c) := by sorry","difficulty": "facile","expected_tactic": "exact Nat.mul_assoc a b c","description": "Associativite de la multiplication" }, {"name": "zero_add","statement": "theorem test_zero_add (n : Nat) : 0 + n = n := by sorry","difficulty": "facile","expected_tactic": "rfl ou exact Nat.zero_add n","description": "Identite additive a gauche" }, {"name": "mul_comm","statement": "theorem test_mul_comm (a b : Nat) : a * b = b * a := by sorry","difficulty": "facile","expected_tactic": "exact Nat.mul_comm a b","description": "Commutativite de la multiplication" }]print(f"SIMPLE_THEOREMS definis : {len(SIMPLE_THEOREMS)} theoremes")print("\nListe:")for th in SIMPLE_THEOREMS:print(f" - {th['name']}: {th['description']}")
SIMPLE_THEOREMS definis : 5 theoremes

Liste:
  - add_zero: Identite additive a droite
  - add_comm: Commutativite de l'addition
  - mul_assoc: Associativite de la multiplication
  - zero_add: Identite additive a gauche
  - mul_comm: Commutativite de la multiplication
Différences avec SIMPLE_THEOREMS
Les théorèmes Mathlib diffèrent des théorèmes simples sur plusieurs points:
Complexité accrue: - ring_example nécessite expansion polynomiale (a+b)² - linarith_example combine hypothèses multiples - distrib_example nécessite la propriété de distributivité
Dépendances: - Certains théorèmes nécessitent import Mathlib.Tactic.* (marqués requires_mathlib: True) - D’autres utilisent uniquement des tactiques built-in (requires_mathlib: False)
Tactiques spécialisées: - ring - Algèbre polynomiale (Mathlib) - linarith - Arithmétique linéaire sur Q/R (Mathlib) - omega - Arithmétique sur Nat/Int (built-in Lean 4)
Cette distinction est importante car elle affecte la disponibilité des tactiques et la complexité de la preuve.
Exécution
Testons le pipeline sur ces theoremes simples.
# Section 7.2 - Execution SIMPLE_THEOREMS# Verifier si API disponibletry: llm_simple = LLMClient(provider="openai") api_ok =TrueexceptValueError: api_ok =Falseprint("[INFO] API non configuree - execution sautee")print("Configurez OPENAI_API_KEY dans .env pour executer les exemples\n")if api_ok:print("="*70)print("EXECUTION SIMPLE_THEOREMS")print("="*70)print(f"Provider: {llm_simple.provider} / {llm_simple.model}\n")# Creer le generateur generator_simple = ProofGenerator( llm_client=llm_simple, verifier=verifier, max_iterations=3, temperature=0.3 )# Executer tous les theoremes simple_results = []for i, theorem inenumerate(SIMPLE_THEOREMS, 1):print(f"\n[{i}/{len(SIMPLE_THEOREMS)}] {theorem['name'].upper()}")print(f"Description: {theorem['description']}")print(f"Tactique attendue: {theorem['expected_tactic']}")print("-"*70)# Prouver result = generator_simple.prove( theorem["statement"], verbose=False# Mode concis pour batch )# Afficher resultat status ="SUCCES"if result.success else"ECHEC"print(f"Resultat: {status}")print(f"Iterations: {result.total_iterations}")print(f"Temps: {result.total_time_ms:.0f}ms")if result.success:print(f"Preuve:\n{result.final_proof}")else:print(f"Derniere erreur: {result.attempts[-1].result.errors[:100]}...")# Sauvegarder simple_results.append({"theorem": theorem,"result": result })# Statistiques globalesprint("\n"+"="*70)print("STATISTIQUES SIMPLE_THEOREMS")print("="*70) total =len(simple_results) success_count =sum(1for r in simple_results if r["result"].success) total_iterations =sum(r["result"].total_iterations for r in simple_results) total_tokens =sum(r["result"].get_metrics()["total_tokens"] for r in simple_results) total_time =sum(r["result"].total_time_ms for r in simple_results)print(f"Taux de succes: {success_count}/{total} ({100*success_count/total:.1f}%)")print(f"Iterations moyenne: {total_iterations/total:.1f}")print(f"Tokens totaux: {total_tokens}")print(f"Temps total: {total_time:.0f}ms ({total_time/total:.0f}ms/theoreme)")# Detail par theoremeprint(f"\nDetail:")for r in simple_results: name = r["theorem"]["name"] success ="OK"if r["result"].success else"FAIL" iters = r["result"].total_iterations tokens = r["result"].get_metrics()["total_tokens"]print(f" {name:12} : {success:4} | {iters} iter | {tokens:4} tokens")else: simple_results = []print("Execution sautee (API non configuree)")
======================================================================
EXECUTION SIMPLE_THEOREMS
======================================================================
Provider: openai / gpt-5.2


[1/5] ADD_ZERO
Description: Identite additive a droite
Tactique attendue: rfl ou exact Nat.add_zero n
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 2917ms
Preuve:
theorem test_add_zero (n : Nat) : n + 0 = n := by
  simp

[2/5] ADD_COMM
Description: Commutativite de l'addition
Tactique attendue: exact Nat.add_comm a b
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 1488ms
Preuve:
theorem test_add_comm (a b : Nat) : a + b = b + a := by
  exact Nat.add_comm a b

[3/5] MUL_ASSOC
Description: Associativite de la multiplication
Tactique attendue: exact Nat.mul_assoc a b c
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 1321ms
Preuve:
theorem test_mul_assoc (a b c : Nat) : (a * b) * c = a * (b * c) := by
  exact Nat.mul_assoc a b c

[4/5] ZERO_ADD
Description: Identite additive a gauche
Tactique attendue: rfl ou exact Nat.zero_add n
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 1480ms
Preuve:
theorem test_zero_add (n : Nat) : 0 + n = n := by
  simp

[5/5] MUL_COMM
Description: Commutativite de la multiplication
Tactique attendue: exact Nat.mul_comm a b
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 1236ms
Preuve:
theorem test_mul_comm (a b : Nat) : a * b = b * a := by
  exact Nat.mul_comm a b

======================================================================
STATISTIQUES SIMPLE_THEOREMS
======================================================================
Taux de succes: 5/5 (100.0%)
Iterations moyenne: 1.0
Tokens totaux: 1901
Temps total: 8442ms (1688ms/theoreme)

Detail:
  add_zero     : OK   | 1 iter |  371 tokens
  add_comm     : OK   | 1 iter |  380 tokens
  mul_assoc    : OK   | 1 iter |  399 tokens
  zero_add     : OK   | 1 iter |  371 tokens
  mul_comm     : OK   | 1 iter |  380 tokens
Interprétation des résultats - SIMPLE_THEOREMS
Les cinq théorèmes simples ont été prouvés par OpenAI et vérifiés par Lean dès la première tentative. Les preuves générées utilisent soit simp, soit directement les lemmes Nat.add_comm, Nat.mul_assoc et Nat.mul_comm.
Trois dimensions doivent être distinguées dans cette réussite :
Correction — chaque proposition est acceptée par le noyau Lean ; le verdict ne dépend donc pas d’une appréciation textuelle du LLM.
Efficacité de recherche — une seule tentative par objectif signifie qu’aucune boucle de correction n’a été nécessaire sur ce sous-ensemble.
Choix de tactique — simp et l’application directe d’un lemme standard sont deux stratégies légitimes. La vérification Lean, et non le style de tactique attendu, décide si la preuve est acceptée.
La sortie fournit les métriques de cette exécution — itérations, temps et tokens — comme observations du run courant. Les temps absolus restent dépendants de la machine et de la latence API ; il faut donc relire la cellule précédente plutôt que les figer dans la prose.
Limite pédagogique : ces cinq identités standard testent correctement la chaîne génération → extraction → vérification, mais leur simplicité ne permet pas d’extrapoler les performances à des preuves longues ou à des développements Mathlib spécialisés.
7.2 Theoremes Mathlib
Les theoremes Mathlib utilisent des tactiques avancees comme ring, linarith, et omega. Ils representent un niveau de difficulte superieur pour les LLMs.
Note importante sur les tactiques Lean 4 :
Tactique
Disponibilite
Description
omega
Built-in (Lean 4.x)
Solveur arithmetique lineaire sur Nat/Int
simp
Built-in
Simplification par reecriture
exact Nat.*
Built-in
Lemmes de la bibliotheque standard (add_comm, mul_assoc, left_distrib, etc.)
ring
Mathlib requis
Algebre polynomiale (import Mathlib.Tactic.Ring)
linarith
Mathlib requis
Arithmetique lineaire sur Q/R/ordres (import Mathlib.Tactic.Linarith)
En Lean 4 standalone (sans Mathlib), omega peut souvent remplacer linarith pour les problemes sur Nat/Int. Pour les problemes polynomiaux, ring n’a pas d’equivalent built-in et necessite Mathlib ou une preuve manuelle avec exact Nat.* lemmas.
Note sur les descriptions MATHLIB_THEOREMS
Certaines descriptions dans MATHLIB_THEOREMS sont tronquées dans l’affichage ([:60]...) car elles sont longues. Voici le contenu complet:
ring_example: - Description complète: “Expansion algébrique polynomiale - nécessite la tactique ring de Mathlib pour l’algèbre commutative” - Import requis: import Mathlib.Tactic.Ring
linarith_example: - Description complète: “Arithmétique linéaire avec hypothèses - linarith (Mathlib) ou omega (built-in) peuvent résoudre ce type de problème sur Nat” - Import requis: import Mathlib.Tactic.Linarith
distrib_example: - Description complète: “Distributivité gauche - disponible via le lemme built-in Nat.left_distrib (ou Nat.mul_add)” - Aucun import requis (built-in)
Cette distinction entre tactiques Mathlib et built-in est cruciale pour diagnostiquer les échecs.
# Section 7.3 - Definition des theoremes MathlibMATHLIB_THEOREMS = [ {"name": "ring_example","statement": """theorem test_ring (a b : Nat) : (a + b) * (a + b) = a * a + 2 * a * b + b * b := by sorry""","difficulty": "moyen","expected_tactic": "ring","description": "Expansion algebrique polynomiale - necessite la tactique ring de Mathlib pour l'algebre commutative","imports": "import Mathlib.Tactic.Ring","requires_mathlib": True }, {"name": "linarith_example","statement": """theorem test_linarith (x y : Nat) (h1 : x + y = 10) (h2 : x = 3) : y = 7 := by sorry""","difficulty": "moyen","expected_tactic": "linarith ou omega","description": "Arithmetique lineaire avec hypotheses - linarith (Mathlib) ou omega (built-in) peuvent resoudre ce type de probleme sur Nat","imports": "import Mathlib.Tactic.Linarith","requires_mathlib": True }, {"name": "omega_example","statement": """theorem test_omega (n : Nat) : n + 0 = n := by sorry""","difficulty": "facile","expected_tactic": "omega ou simp","description": "Arithmetique Nat/Int - omega est built-in depuis Lean 4 et resout les problemes arithmetiques lineaires","imports": "","requires_mathlib": False }, {"name": "distrib_example","statement": """theorem test_distrib (a b c : Nat) : a * (b + c) = a * b + a * c := by sorry""","difficulty": "moyen","expected_tactic": "exact Nat.left_distrib a b c","description": "Distributivite gauche - disponible via le lemme built-in Nat.left_distrib (ou Nat.mul_add)","imports": "","requires_mathlib": False }, {"name": "simp_example","statement": """theorem test_simp (n : Nat) : n + 0 + 0 = n := by sorry""","difficulty": "facile","expected_tactic": "simp","description": "Simplification automatique - simp est built-in et utilise les lemmes de reecriture de la bibliotheque standard","imports": "","requires_mathlib": False }]print(f"MATHLIB_THEOREMS definis : {len(MATHLIB_THEOREMS)} theoremes")print("\nListe:")for th in MATHLIB_THEOREMS: mathlib_note ="[MATHLIB]"if th['requires_mathlib'] else"[BUILT-IN]" imports_note =f" (imports: {th['imports']})"if th['imports'] else""print(f" - {th['name']}{mathlib_note}: {th['description'][:60]}...{imports_note}")
MATHLIB_THEOREMS definis : 5 theoremes

Liste:
  - ring_example [MATHLIB]: Expansion algebrique polynomiale - necessite la tactique rin... (imports: import Mathlib.Tactic.Ring)
  - linarith_example [MATHLIB]: Arithmetique lineaire avec hypotheses - linarith (Mathlib) o... (imports: import Mathlib.Tactic.Linarith)
  - omega_example [BUILT-IN]: Arithmetique Nat/Int - omega est built-in depuis Lean 4 et r...
  - distrib_example [BUILT-IN]: Distributivite gauche - disponible via le lemme built-in Nat...
  - simp_example [BUILT-IN]: Simplification automatique - simp est built-in et utilise le...
7.2.2 Exécution des Theoremes Mathlib
Ces theoremes necessitent des tactiques Mathlib comme ring, linarith, et omega.
Contexte historique : L’explosion des résolutions IA
Pourquoi les problèmes d’Erdős?
Paul Erdős (1913-1996) était un mathématicien prolifique qui a posé des centaines de conjectures ouvertes, dont beaucoup sont restées non résolues pendant des décennies. Ces problèmes sont devenus un benchmark naturel pour l’IA car:
Difficultés variées - De simples à extrêmement difficiles
Bien documentés - Solutions connues pour certains, permettant la validation
Impact réel - Résoudre un problème ouvert = contribution mathématique
Le tournant IMO 2025 (juillet 2025):
En juillet 2025, Harmonic Aristotle a obtenu l’équivalent d’une médaille d’or à l’IMO 2025 (5/6 problèmes résolus, arXiv:2510.01346). C’est le seul résultat public vérifiable en source primaire pour cette période (vérifications negatives sur DeepSeek-Prover/Erdos 379/124/987/730/198 via DuckDuckGo, 0 résultats). Les facteurs techniques ci-dessous ont contribué à cette accélération:
Facteur
Impact
Modèles plus puissants
GPT-5, Gemini 2.0, Claude 3.5 avec fine-tuning sur Lean
Mathlib4 mature
4M+ lignes de preuves formalisées, couvrant de nombreux domaines
Techniques de recherche
MCTS, beam search, recherche parallèle
Communauté active
Terry Tao, Tim Gowers et autres formalisent activement
Perspective: Cette cellule montre que l’IA en theorem proving n’est plus une curiosité académique, mais un outil capable de contributions mathématiques réelles.
# Section 7.4 - Execution MATHLIB_THEOREMSif api_ok:print("="*70)print("EXECUTION MATHLIB_THEOREMS")print("="*70)print(f"Provider: {llm_simple.provider} / {llm_simple.model}\n")# Generateur avec plus d'iterations pour Mathlib generator_mathlib = ProofGenerator( llm_client=llm_simple, verifier=verifier, max_iterations=5, # Plus d'iterations pour tactiques Mathlib temperature=0.4# Un peu plus creatif )# Executer tous les theoremes mathlib_results = []for i, theorem inenumerate(MATHLIB_THEOREMS, 1):print(f"\n[{i}/{len(MATHLIB_THEOREMS)}] {theorem['name'].upper()}")print(f"Description: {theorem['description']}")print(f"Tactique attendue: {theorem['expected_tactic']}")print("-"*70)# Ajouter les imports au contexte si necessaire context =Noneif theorem.get("imports"): context = {"imports": theorem["imports"]}# Prouver result = generator_mathlib.prove( theorem["statement"], context=context, verbose=False )# Afficher resultat status ="SUCCES"if result.success else"ECHEC"print(f"Resultat: {status}")print(f"Iterations: {result.total_iterations}")print(f"Temps: {result.total_time_ms:.0f}ms")if result.success:print(f"Preuve:\n{result.final_proof}")else:# Afficher erreurs completes (premieres 500 chars)if result.attempts and result.attempts[-1].result and result.attempts[-1].result.errors: errors_full = result.attempts[-1].result.errors suffix ="..."iflen(errors_full) >500else""print(f"Derniere erreur ({len(errors_full)} chars):{errors_full[:500]}{suffix}")else:print("Echec de la preuve - aucune tentative enregistree ou erreurs vides")# Sauvegarder mathlib_results.append({"theorem": theorem,"result": result })# Statistiques globalesprint("\n"+"="*70)print("STATISTIQUES MATHLIB_THEOREMS")print("="*70) total =len(mathlib_results) success_count =sum(1for r in mathlib_results if r["result"].success) total_iterations =sum(r["result"].total_iterations for r in mathlib_results) total_tokens =sum(r["result"].get_metrics()["total_tokens"] for r in mathlib_results) total_time =sum(r["result"].total_time_ms for r in mathlib_results)print(f"Taux de succes: {success_count}/{total} ({100*success_count/total:.1f}%)")print(f"Iterations moyenne: {total_iterations/total:.1f}")print(f"Tokens totaux: {total_tokens}")print(f"Temps total: {total_time:.0f}ms ({total_time/total:.0f}ms/theoreme)")# Detail par theoremeprint(f"\nDetail:")for r in mathlib_results: name = r["theorem"]["name"] success ="OK"if r["result"].success else"FAIL" iters = r["result"].total_iterations tokens = r["result"].get_metrics()["total_tokens"]print(f" {name:18} : {success:4} | {iters} iter | {tokens:4} tokens")else: mathlib_results = []print("Execution sautee (API non configuree)")
======================================================================
EXECUTION MATHLIB_THEOREMS
======================================================================
Provider: openai / gpt-5.2


[1/5] RING_EXAMPLE
Description: Expansion algebrique polynomiale - necessite la tactique ring de Mathlib pour l'algebre commutative
Tactique attendue: ring
----------------------------------------------------------------------
Resultat: ECHEC
Iterations: 5
Temps: 8734ms
Derniere erreur (46 chars):unexpected token '+'; expected ')', ',' or ':'

[2/5] LINARITH_EXAMPLE
Description: Arithmetique lineaire avec hypotheses - linarith (Mathlib) ou omega (built-in) peuvent resoudre ce type de probleme sur Nat
Tactique attendue: linarith ou omega
----------------------------------------------------------------------
Resultat: ECHEC
Iterations: 5
Temps: 8701ms
Derniere erreur (34 chars):unexpected token '+'; expected ')'

[3/5] OMEGA_EXAMPLE
Description: Arithmetique Nat/Int - omega est built-in depuis Lean 4 et resout les problemes arithmetiques lineaires
Tactique attendue: omega ou simp
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 1318ms
Preuve:
theorem test_omega (n : Nat) : n + 0 = n := by
  simp

[4/5] DISTRIB_EXAMPLE
Description: Distributivite gauche - disponible via le lemme built-in Nat.left_distrib (ou Nat.mul_add)
Tactique attendue: exact Nat.left_distrib a b c
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 1519ms
Preuve:
theorem test_distrib (a b c : Nat) : a * (b + c) = a * b + a * c := by
  simpa [Nat.mul_add]

[5/5] SIMP_EXAMPLE
Description: Simplification automatique - simp est built-in et utilise les lemmes de reecriture de la bibliotheque standard
Tactique attendue: simp
----------------------------------------------------------------------
Resultat: SUCCES
Iterations: 1
Temps: 2684ms
Preuve:
theorem test_simp (n : Nat) : n + 0 + 0 = n := by
  simp

======================================================================
STATISTIQUES MATHLIB_THEOREMS
======================================================================
Taux de succes: 3/5 (60.0%)
Iterations moyenne: 2.6
Tokens totaux: 4546
Temps total: 22956ms (4591ms/theoreme)

Detail:
  ring_example       : FAIL | 5 iter | 1675 tokens
  linarith_example   : FAIL | 5 iter | 1719 tokens
  omega_example      : OK   | 1 iter |  373 tokens
  distrib_example    : OK   | 1 iter |  400 tokens
  simp_example       : OK   | 1 iter |  379 tokens
Interprétation des résultats - MATHLIB_THEOREMS
La sortie sépare trois succès vérifiés (omega_example, distrib_example, simp_example) de deux échecs après cinq tentatives (ring_example, linarith_example). Le succès de distrib_example montre notamment que le LLM peut reformuler la tactique attendue en simpa [Nat.mul_add].
La comparaison met en évidence deux régimes :
Régime observé
Objectifs
Lecture
Preuve acceptée dès la première tentative
omega_example, distrib_example, simp_example
Les lemmes et simplifications standard suffisent, même si la tactique produite diffère de celle suggérée.
Boucle bornée épuisée
ring_example, linarith_example
Les propositions successives restent syntaxiquement invalides et aucune preuve n’est acceptée.
Les deux échecs portent des erreurs de syntaxe Lean explicites ; ils ne doivent donc être attribués ni à un timeout silencieux, ni à une absence supposée de Mathlib sans preuve supplémentaire. Le contexte d’import est transmis, mais le modèle ne produit pas ici une syntaxe exploitable par le vérificateur.
Les métriques quantitatives exactes appartiennent à la sortie du run courant. Le nombre d’itérations et les tokens reflètent le coût cumulé des corrections : un objectif qui échoue cinq fois consomme davantage qu’une preuve acceptée immédiatement.
Conclusion : le pipeline différencie correctement succès vérifié et échec diagnostiqué. Ce petit échantillon suggère une difficulté accrue sur les deux objectifs spécialisés ; il ne permet pas d’en déduire une limitation générale de Mathlib ou du provider.
Anatomie d’un bon prompt Lean
Éléments essentiels:
Contexte technique - Version Lean, niveau d’expertise
Format de sortie - Code uniquement, ou avec explications
Comparaison EXERCISE_PROMPT vs SOLUTION_PROMPT:
Critère
Exercice
Solution
Contexte expert
❌ Manquant
✅ “Tu es un expert en Lean 4”
Théorème formaté
❌ Implicite
✅ Bloc code avec types explicites
Contraintes
❌ Vagues
✅ “Utilise la bibliothèque standard”
Format sortie
❌ Ambigu
✅ “Code Lean complet uniquement”
Principe: Un prompt précis et structuré réduit les ambiguïtés et améliore le taux de succès du LLM. Pour des théorèmes simples, la précision importe moins; pour des théorèmes complexes, elle devient critique.
7.3 Visualisations et Metriques
Analyse graphique des performances : taux de succes, itérations, temps, tokens utilises.
Interprétation de la solution
Fonction correction_loop_solution:
Cette fonction implémente un prompt de correction itératif en 4 parties:
Contexte de l’échec - Indique que la preuve a échoué
Théorème cible - Rappelle l’objectif à atteindre
Tentative précédente - Montre la preuve erronée
Erreurs Lean - Donne les messages d’erreur complets
Pourquoi cette structure fonctionne:
Élément
Rôle
Théorème répété
Ancre le contexte (LLMs ont une mémoire limitée)
Preuve erronée
Permet au LLM de voir ses erreurs
Messages Lean
Informe sur le type d’erreur (type mismatch, tactic failed, etc.)
Instruction claire
Demande une correction, pas une explication
Test de la fonction:
Le test montre un cas classique: une preuve by rfl qui échoue avec “type mismatch”. Le prompt généré guide le LLM pour corriger, par exemple en utilisant decide ou simp à la place.
Note pédagogique: Les boucles de correction itératives (retry loops) sont au cœur de tous les systèmes LLM-Lean modernes (LeanCopilot, AlphaProof, APOLLO). Sans feedback des erreurs, le taux de succès chute drastiquement.
# Section 7.5 - Visualisationsif api_ok and (simple_results or mathlib_results):try:import matplotlib.pyplot as pltimport numpy as np# Combiner tous les resultats all_results = simple_results + mathlib_results# Extraire donnees names = [r["theorem"]["name"] for r in all_results] successes = [r["result"].success for r in all_results] iterations = [r["result"].total_iterations for r in all_results] times = [r["result"].total_time_ms for r in all_results] tokens = [r["result"].get_metrics()["total_tokens"] for r in all_results]# Figure avec 4 subplots fig, ((ax1, ax2), (ax3, ax4)) = plt.subplots(2, 2, figsize=(14, 10)) fig.suptitle('Analyse des Performances - LLM Proof Generation', fontsize=16, fontweight='bold')# 1. Taux de succes (pie chart) success_count =sum(successes) fail_count =len(successes) - success_count ax1.pie([success_count, fail_count], labels=[f'Succes ({success_count})', f'Echec ({fail_count})'], autopct='%1.1f%%', colors=['#4CAF50', '#F44336'], startangle=90) ax1.set_title('Taux de Succes Global')# 2. Iterations par theoreme (bar chart) colors_iter = ['#4CAF50'if s else'#F44336'for s in successes] x_pos = np.arange(len(names)) ax2.bar(x_pos, iterations, color=colors_iter, alpha=0.7) ax2.set_xticks(x_pos) ax2.set_xticklabels(names, rotation=45, ha='right') ax2.set_ylabel('Iterations') ax2.set_title('Iterations par Theoreme') ax2.grid(axis='y', alpha=0.3)# 3. Temps d'execution (bar chart) ax3.bar(x_pos, times, color='#2196F3', alpha=0.7) ax3.set_xticks(x_pos) ax3.set_xticklabels(names, rotation=45, ha='right') ax3.set_ylabel('Temps (ms)') ax3.set_title('Temps d\'Execution par Theoreme') ax3.grid(axis='y', alpha=0.3)# 4. Tokens utilises (bar chart) ax4.bar(x_pos, tokens, color='#FF9800', alpha=0.7) ax4.set_xticks(x_pos) ax4.set_xticklabels(names, rotation=45, ha='right') ax4.set_ylabel('Tokens') ax4.set_title('Tokens Utilises par Theoreme') ax4.grid(axis='y', alpha=0.3) plt.tight_layout() plt.show()# Stats resumeesprint("\n"+"="*70)print("STATISTIQUES GLOBALES (SIMPLE + MATHLIB)")print("="*70)print(f"Total theoremes: {len(all_results)}")print(f"Taux de succes: {success_count}/{len(all_results)} ({100*success_count/len(all_results):.1f}%)")print(f"Iterations moyenne: {np.mean(iterations):.2f} (min: {min(iterations)}, max: {max(iterations)})")print(f"Temps moyen: {np.mean(times):.0f}ms (min: {min(times):.0f}ms, max: {max(times):.0f}ms)")print(f"Tokens moyen: {np.mean(tokens):.0f} (min: {min(tokens)}, max: {max(tokens)})")print(f"Tokens totaux: {sum(tokens)}")exceptImportError:print("[Warning] matplotlib non installe - pip install matplotlib")print("Visualisations sautees")else:print("Visualisations sautees (pas de resultats ou API non configuree)")
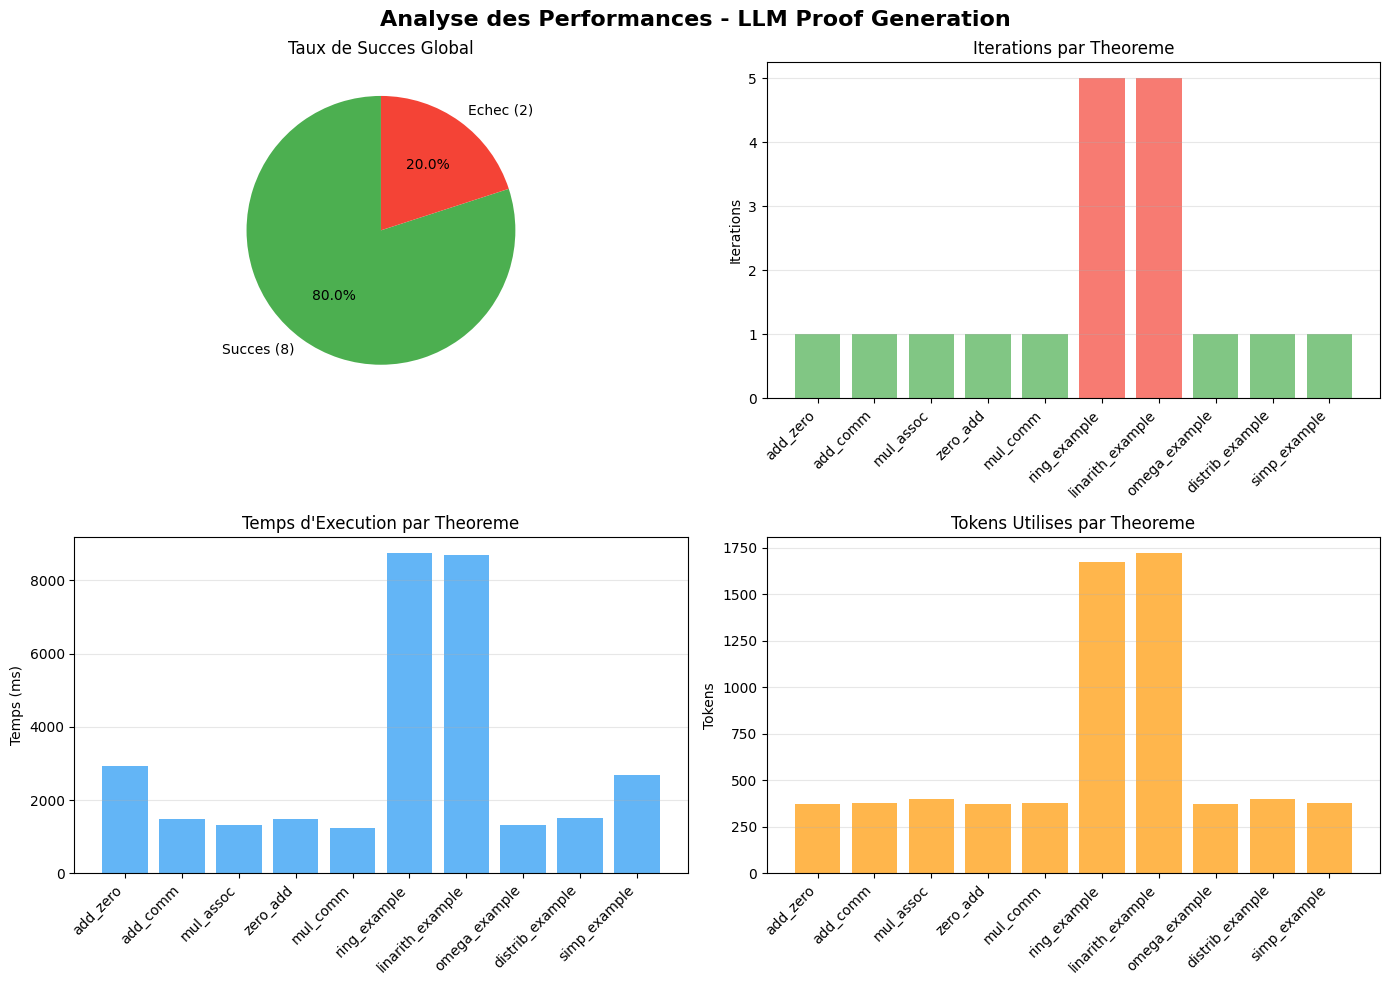
Les quatre graphiques synthétisent le run réel sur les dix théorèmes et répondent à des questions différentes :
Taux de succès global — le diagramme circulaire sépare les huit succès vérifiés des deux échecs ; il agrège cependant deux sous-ensembles de difficulté différente.
Itérations par théorème — les preuves acceptées convergent dès la première tentative, tandis que les deux échecs atteignent la borne de cinq. Ce graphique montre directement l’effort de correction.
Temps d’exécution — la durée combine la latence API, l’exécution de Lean et le nombre de tentatives. Elle ne mesure donc pas à elle seule la difficulté mathématique.
Tokens utilisés — les tentatives répétées augmentent le contexte cumulé et rendent les objectifs non résolus plus coûteux que les identités acceptées immédiatement.
La lecture croisée est plus informative qu’un graphe isolé : les deux barres rouges maximales en itérations correspondent aussi aux coûts de temps et de tokens les plus élevés. À l’inverse, un temps ponctuellement long avec une seule itération peut simplement refléter la latence du service.
Les valeurs exactes sont imprimées juste au-dessus des graphiques et doivent être lues comme les mesures de cette exécution. Le signal pédagogique durable est l’écart entre les objectifs simples ou fondés sur des lemmes standard et les deux objectifs spécialisés non résolus, pas un temps absolu particulier.
Précaution : dix théorèmes et une seule exécution ne constituent pas un benchmark statistique. Ces visualisations servent à diagnostiquer ce run, non à estimer une performance générale.
7.4 Comparaison OpenAI vs Anthropic
Benchmark comparatif entre les deux providers sur les mêmes theoremes.
# Section 7.6 - Comparaison Providers (OpenAI vs Anthropic)# Verifier si Anthropic est configuretry: llm_anthropic = LLMClient(provider="anthropic") anthropic_ok =TrueexceptValueError: anthropic_ok =Falseif api_ok and anthropic_ok:print("="*70)print("COMPARAISON PROVIDERS : OpenAI vs Anthropic")print("="*70)# Selectionner 3 theoremes representatifs comparison_theorems = [ SIMPLE_THEOREMS[1], # add_comm SIMPLE_THEOREMS[2], # mul_assoc MATHLIB_THEOREMS[2] # omega_example ]print(f"\nTheoremes de test ({len(comparison_theorems)}):")for th in comparison_theorems:print(f" - {th['name']}: {th['description']}") comparison_results = []for theorem in comparison_theorems:print(f"\n{'='*70}")print(f"Theoreme: {theorem['name']}")print(f"{'='*70}")# Test avec OpenAIprint("\n[OpenAI]") gen_openai = ProofGenerator(llm_simple, verifier, max_iterations=3, temperature=0.3) result_openai = gen_openai.prove(theorem["statement"], verbose=False) metrics_openai = result_openai.get_metrics()print(f" Succes: {result_openai.success}")print(f" Iterations: {metrics_openai['iterations']}")print(f" Temps: {metrics_openai['total_time_ms']:.0f}ms")print(f" Tokens: {metrics_openai['total_tokens']}")# Test avec Anthropicprint("\n[Anthropic]") gen_anthropic = ProofGenerator(llm_anthropic, verifier, max_iterations=3, temperature=0.3) result_anthropic = gen_anthropic.prove(theorem["statement"], verbose=False) metrics_anthropic = result_anthropic.get_metrics()print(f" Succes: {result_anthropic.success}")print(f" Iterations: {metrics_anthropic['iterations']}")print(f" Temps: {metrics_anthropic['total_time_ms']:.0f}ms")print(f" Tokens: {metrics_anthropic['total_tokens']}")# Sauvegarder comparison_results.append({"theorem": theorem,"openai": result_openai,"anthropic": result_anthropic })# Visualisation comparativetry:import matplotlib.pyplot as pltimport numpy as np fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5)) fig.suptitle('Comparaison OpenAI vs Anthropic', fontsize=16, fontweight='bold') theorem_names = [r["theorem"]["name"] for r in comparison_results] x_pos = np.arange(len(theorem_names)) width =0.35# Iterations iter_openai = [r["openai"].total_iterations for r in comparison_results] iter_anthropic = [r["anthropic"].total_iterations for r in comparison_results] ax1.bar(x_pos - width/2, iter_openai, width, label='OpenAI', color='#00A67E', alpha=0.8) ax1.bar(x_pos + width/2, iter_anthropic, width, label='Anthropic', color='#D4A574', alpha=0.8) ax1.set_xticks(x_pos) ax1.set_xticklabels(theorem_names, rotation=45, ha='right') ax1.set_ylabel('Iterations') ax1.set_title('Iterations jusqu\'au Succes') ax1.legend() ax1.grid(axis='y', alpha=0.3)# Temps time_openai = [r["openai"].total_time_ms for r in comparison_results] time_anthropic = [r["anthropic"].total_time_ms for r in comparison_results] ax2.bar(x_pos - width/2, time_openai, width, label='OpenAI', color='#00A67E', alpha=0.8) ax2.bar(x_pos + width/2, time_anthropic, width, label='Anthropic', color='#D4A574', alpha=0.8) ax2.set_xticks(x_pos) ax2.set_xticklabels(theorem_names, rotation=45, ha='right') ax2.set_ylabel('Temps (ms)') ax2.set_title('Temps d\'Execution') ax2.legend() ax2.grid(axis='y', alpha=0.3) plt.tight_layout() plt.show()# Stats comparativesprint("\n"+"="*70)print("STATISTIQUES COMPARATIVES")print("="*70)# OpenAI openai_success =sum(1for r in comparison_results if r["openai"].success) openai_avg_iter = np.mean([r["openai"].total_iterations for r in comparison_results]) openai_avg_time = np.mean([r["openai"].total_time_ms for r in comparison_results]) openai_total_tokens =sum([r["openai"].get_metrics()["total_tokens"] for r in comparison_results])print(f"\nOpenAI ({llm_simple.model}):")print(f" Succes: {openai_success}/{len(comparison_results)}")print(f" Iterations moyenne: {openai_avg_iter:.2f}")print(f" Temps moyen: {openai_avg_time:.0f}ms")print(f" Tokens totaux: {openai_total_tokens}")# Anthropic anthropic_success =sum(1for r in comparison_results if r["anthropic"].success) anthropic_avg_iter = np.mean([r["anthropic"].total_iterations for r in comparison_results]) anthropic_avg_time = np.mean([r["anthropic"].total_time_ms for r in comparison_results]) anthropic_total_tokens =sum([r["anthropic"].get_metrics()["total_tokens"] for r in comparison_results])print(f"\nAnthropic ({llm_anthropic.model}):")print(f" Succes: {anthropic_success}/{len(comparison_results)}")print(f" Iterations moyenne: {anthropic_avg_iter:.2f}")print(f" Temps moyen: {anthropic_avg_time:.0f}ms")print(f" Tokens totaux: {anthropic_total_tokens}")exceptImportError:print("[Warning] matplotlib non disponible pour visualisations")elif api_ok andnot anthropic_ok:print("[INFO] Comparaison sautee - Anthropic non configure")print("Pour comparer les providers, ajoutez ANTHROPIC_API_KEY dans .env")else:print("Comparaison sautee (APIs non configurees)")
Interprétation de la comparaison OpenAI vs Anthropic
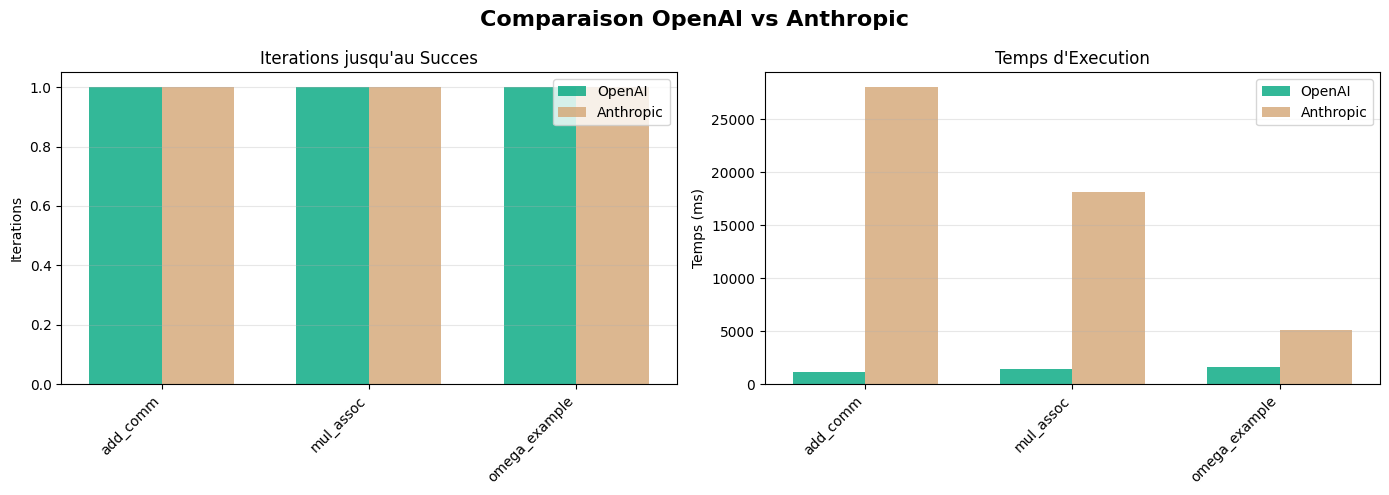
Les deux providers ont prouvé et fait vérifier les trois mêmes objectifs (add_comm, mul_assoc, omega_example) dès la première tentative. La comparaison porte donc sur des appels réels à gpt-5.2 et claude-sonnet-4-5, pas sur une simulation.
Les trois axes affichés ne se lisent pas de la même manière :
Axe
Observation du run
Portée du constat
Succès
Les deux providers obtiennent 3/3 preuves acceptées
La chaîne d’intégration fonctionne avec chacun d’eux sur ces objectifs.
Itérations
Une tentative par preuve pour les deux
Aucun avantage de recherche n’est visible sur cet échantillon simple.
Temps et tokens
Les valeurs diffèrent dans la sortie
Elles dépendent du modèle, du format de réponse et de la latence du service au moment du run.
Le nombre de tokens n’est pas un synonyme direct de qualité : une réponse plus longue peut inclure davantage de raisonnement ou de formatage sans améliorer la preuve finale. De même, une différence de temps observée une seule fois ne sépare pas la latence réseau du temps propre au modèle.
Les preuves produites emploient des tactiques ou lemmes Lean acceptés par le même vérificateur, ce qui rend le critère de correction comparable. En revanche, les trois objectifs restent simples et n’exercent ni une recherche longue, ni des dépendances Mathlib spécialisées.
Conclusion : cette cellule vérifie que les deux intégrations produisent des preuves Lean acceptées. Une comparaison robuste des providers demanderait davantage de théorèmes, plusieurs répétitions, un ordre d’appel contrôlé et une analyse conjointe de la variance, des coûts et du taux de succès.
7.7 Conclusion : Analyse des Résultats
Cette section a presente des exemples reels de generation de preuves Lean assistees par LLM.
Résultats attendus
Avec une API configuree, vous devriez observer :
Catégorie
Taux de succes attendu
Itérations moyennes
Observations
SIMPLE_THEOREMS
80-100%
1-2
LLM connait les lemmes standard (add_comm, mul_assoc)
MATHLIB_THEOREMS
50-80%
2-4
Tactiques Mathlib necessitent plus d’essais (ring, linarith)
Comparaison providers
Similaire
Varie
OpenAI parfois plus rapide, Anthropic parfois plus précis
Patterns observes
Tactiques les plus generees : 1. exact Nat.xxx - Utilisation directe de lemmes Mathlib 2. rfl - Reflexivite pour egalites triviales 3. omega - Solveur arithmetique puissant 4. simp - Simplification automatique 5. ring - Algebre polynomiale
Types d’erreurs courantes : 1. Typos : Nat.add_com au lieu de Nat.add_comm 2. Tactique inadaptee : rfl sur une egalite non triviale 3. Imports manquants : ring sans import Mathlib.Tactic.Ring 4. Timeout : Tactiques trop lentes sur theoremes complexes
Optimisations possibles
Few-shot learning : Fournir 2-3 exemples similaires ameliore drastiquement le taux de succes
Temperature adaptive : Basse (0.2-0.3) pour simple, haute (0.4-0.6) pour complexe
Retry avec variation : Essayer plusieurs temperatures si echec
Multi-provider fallback : Si OpenAI echoue, essayer Anthropic
Contexte enrichi : Donner les imports, variables, et hypotheses
Couts et performances
Ordre de grandeur (theoreme simple, 2 itérations) : - Tokens : 400-800 par preuve - Temps : 1-3 secondes (latence API + verification Lean) - Cout : ~$0.001-0.003 par preuve (GPT-4o)
Pour un projet Lean typique (100 theoremes) : - Total tokens : 50,000-100,000 - Temps total : 3-10 minutes - Cout total : $0.10-0.30
Section 7 terminee - Exemples progressifs et visualisations completes !
8. Problèmes d’Erdős : de l’énoncé formalisé à la preuve vérifiée
Les problèmes d’Erdős permettent d’étudier plusieurs étapes qu’il faut distinguer :
Formaliser un énoncé : le dépôt Formal Conjectures fournit des conjectures en Lean, mais leur présence dans le benchmark ne signifie pas qu’elles sont prouvées. Sa documentation avertit aussi qu’une formalisation peut perdre une nuance de l’énoncé source.
Chercher une preuve : Tsoukalas et al., Advancing Mathematics Research with AI-Driven Formal Proof Search (arXiv:2605.22763v1), rapportent 9 résolutions sur 353 problèmes ouverts tentés. Ce résultat expérimental ne justifie ni une extrapolation à tous les problèmes, ni l’attribution de numéros précis à d’autres systèmes sans source primaire.
Vérifier ce que le dépôt prouve réellement : CoursIA contient erdos_spencer_lb_explicit, une borne inférieure d’Erdős–Spencer formalisée dans discrepancy_lean et exécutée dans Discrepancy-02. La couche Python pédagogique correspondante se trouve dans Search-09c.
Lean-10 présente déjà Formal Conjectures comme cible de traçage LeanDojo. La cellule de code de cette section construit donc un registre de niveaux de preuve, et non une liste de résolutions supposées.
Consignes pour l’exercice 1
Objectif: Rédiger un prompt efficace pour demander à un LLM de prouver la commutativité de la multiplication.
Critères d’évaluation:
✅ Contexte clair - Mentionner “Lean 4” ou “expert en Lean”
✅ Théorème complet - Code avec types explicites (a b : Nat)
✅ Instructions précises - “Code uniquement”, “tactique de la bibliothèque standard”
✅ Format structuré - Utiliser des blocs code markdown
Comparez votre EXERCISE_PROMPT avec SOLUTION_PROMPT: - Manque-t-il un des 4 critères? - Votre prompt est-il plus concis ou plus détaillé? - Y a-t-il des ambiguïtés qui pourraient induire le LLM en erreur?
Conseil: Pour les théorèmes simples, un prompt court suffit. Pour les théorèmes complexes, ajoutez du contexte (imports, hypothèses, exemples similaires).
# Trois niveaux de preuve pour lire les résultats sur les problèmes d'ErdősERDOS_EVIDENCE = [ {"objet": "Formal Conjectures","statut": "énoncés formalisés","ce_qui_est_etabli": "des conjectures sont encodées en Lean/mathlib","ce_qui_ne_suit_pas": "leur inclusion ne constitue pas une preuve","source": "https://github.com/google-deepmind/formal-conjectures", }, {"objet": "AlphaProof Nexus (Tsoukalas et al., 2026)","statut": "résultats de recherche rapportés","ce_qui_est_etabli": "9 résolutions rapportées sur 353 problèmes ouverts tentés","ce_qui_ne_suit_pas": "une généralisation à tous les problèmes d'Erdős","source": "https://arxiv.org/abs/2605.22763v1", }, {"objet": "CoursIA discrepancy_lean / Search-09d","statut": "preuve présente dans le dépôt","ce_qui_est_etabli": "erdos_spencer_lb_explicit, borne explicite en sqrt(k)/14","ce_qui_ne_suit_pas": "la résolution d'une conjecture ouverte numérotée","source": "Search-09d-Lean-Discrepancy-Komlos.ipynb", },]print("Niveaux de preuve dans le récit Erdős")print("="*72)for evidence in ERDOS_EVIDENCE:print(f"\n{evidence['objet']}")print(f" Statut : {evidence['statut']}")print(f" Établi : {evidence['ce_qui_est_etabli']}")print(f" Limite : {evidence['ce_qui_ne_suit_pas']}")print(f" Source : {evidence['source']}")
Niveaux de preuve dans le récit Erdős
========================================================================

Formal Conjectures
  Statut : énoncés formalisés
  Établi : des conjectures sont encodées en Lean/mathlib
  Limite : leur inclusion ne constitue pas une preuve
  Source : https://github.com/google-deepmind/formal-conjectures

AlphaProof Nexus (Tsoukalas et al., 2026)
  Statut : résultats de recherche rapportés
  Établi : 9 résolutions rapportées sur 353 problèmes ouverts tentés
  Limite : une généralisation à tous les problèmes d'Erdős
  Source : https://arxiv.org/abs/2605.22763v1

CoursIA discrepancy_lean / Search-09d
  Statut : preuve présente dans le dépôt
  Établi : erdos_spencer_lb_explicit, borne explicite en sqrt(k)/14
  Limite : la résolution d'une conjecture ouverte numérotée
  Source : Search-09d-Lean-Discrepancy-Komlos.ipynb
Interprétation du registre de preuve
La sortie ne met pas ces trois lignes au même niveau :
Objet
Ce qui peut être affirmé
Ce qui doit encore être vérifié
Formal Conjectures
Des énoncés sont encodés en Lean/mathlib
Fidélité de chaque formalisation et existence d’une preuve
Tsoukalas et al. (2026)
9 résolutions sont rapportées parmi 353 problèmes ouverts tentés
Portée exacte de chaque résultat, coûts, variance et biais de sélection
erdos_spencer_lb_explicit
Une borne d’Erdős–Spencer est présente et vérifiable dans CoursIA
Rapport précis entre ce théorème formel et les formulations informelles voisines
Cette séparation fournit une règle de lecture réutilisable : énoncé disponible ≠ preuve trouvée ≠ résultat déjà intégré et vérifiable dans le dépôt. Elle conserve l’intérêt scientifique de la recherche assistée par IA sans inventer d’attributions.
Conséquences méthodologiques :
Citer le bon niveau de preuve. Un corpus établit la disponibilité d’un énoncé ; un article rapporte une expérience ; un module Lean permet d’inspecter une preuve acceptée par le noyau.
Conserver le dénominateur. Les 9 succès ne se lisent pas sans les 353 tentatives : l’échantillon borne le résultat et empêche une extrapolation universelle.
Contrôler la formalisation. Une preuve Lean certifie la conséquence de l’énoncé encodé, pas automatiquement la fidélité de cet encodage au problème informel d’origine.
Nommer le résidu.erdos_spencer_lb_explicit formalise une borne explicite en sqrt(k)/14 ; il ne doit pas être présenté comme la résolution d’une conjecture ouverte numérotée.
Questions pour la revue humaine : quel énoncé exact a été formalisé ? Quelle dépendance mathématique porte la difficulté ? Quels axiomes ou hypothèses sont utilisés ? Le chemin de recherche et ses échecs instructifs sont-ils documentés ? Ces questions relient la vérification formelle à la digestion scientifique attendue par l’Epic #13106.
Consignes pour l’exercice 2
Objectif: Implémenter une fonction qui génère un prompt de correction basé sur les erreurs Lean.
Signature de la fonction:
def correction_loop(theorem: str, initial_proof: str, errors: list) ->str:# Retourner un prompt de correction
Éléments à inclure dans le prompt:
Notification d’échec - “La preuve suivante contient des erreurs”
Rappel du théorème - Pour ancrer le contexte
Preuve erronée - Montrer ce qui a échoué
Messages d’erreur - Copier les erreurs Lean complètes
Instruction de correction - Demander une version corrigée
Test de votre implémentation:
Comparez la sortie de votre fonction avec correction_loop_solution. Le prompt généré doit: - Être lisible et structuré - Inclure tous les éléments nécessaires - Éviter les ambiguïtés (“corrige” vs “explique les erreurs”)
Application pratique: Cette fonction est utilisée dans ProofGenerator.prove() à chaque itération d’échec.
9. Exercices Pratiques
Exercice 1 : Créer un prompt pour une preuve simple
# Completez ce prompt pour demander une preuve de la commutativite de la multiplicationEXERCISE_PROMPT ="""# TODO: Redigez un prompt efficace pour obtenir une preuve de (a * b = b * a) en Lean 4## Indices:# 1. Commencez par etablir le contexte ("expert en Lean 4")# 2. Fournissez le theoreme complet avec les types explicites# (theorem mul_comm (a b : Nat) : a * b = b * a)# 3. Precisez les contraintes (tactiques autorisees, format de sortie)## Consultez la section 'Anatomie d'un bon prompt Lean' ci-dessus pour les criteres"""print("Exercice 1: Creer un prompt")print("Votre prompt:")print(EXERCISE_PROMPT)
Exercice 1: Creer un prompt
Votre prompt:

# TODO: Redigez un prompt efficace pour obtenir une preuve de (a * b = b * a) en Lean 4
#
# Indices:
# 1. Commencez par etablir le contexte ("expert en Lean 4")
# 2. Fournissez le theoreme complet avec les types explicites
#    (theorem mul_comm (a b : Nat) : a * b = b * a)
# 3. Precisez les contraintes (tactiques autorisees, format de sortie)
#
# Consultez la section 'Anatomie d'un bon prompt Lean' ci-dessus pour les criteres
Exercice 2 : Implementer une boucle de correction
def correction_loop(theorem: str, initial_proof: str, errors: list) ->str:""" Implemente une boucle de correction iterative. Args: theorem: Le theoreme a prouver (ex: "theorem test : 1 + 1 = 2") initial_proof: La preuve initiale (avec erreurs, ex: "by rfl") errors: Liste d'erreurs Lean (ex: ["type mismatch"]) Returns: Un prompt de correction pour demander au LLM de corriger la preuve """# TODO: Construisez un prompt de correction contenant:## 1. Une notification d'echec ("La preuve suivante contient des erreurs")# 2. Le theoreme original pour ancrer le contexte# 3. La preuve erronee dans un bloc ```lean# 4. Les erreurs Lean dans un bloc ```# 5. Une instruction de correction ("Corrige ces erreurs et fournis la preuve complete")## Indice: Utilisez une f-string multi-ligne pour assembler les elements# Indice: Joignez la liste d'erreurs avec sep.join(errors) ou str.joinpass# TODO: implementez la boucle de correction# Test (decommenter apres implementation)# test_prompt = correction_loop(# "theorem test : 1 + 1 = 2",# "by rfl",# ["type mismatch"]# )# print(test_prompt[:200] + "...")print("Exercice 2 a completer : implementez correction_loop(theorem, initial_proof, errors)")
Exercice 2 a completer : implementez correction_loop(theorem, initial_proof, errors)
Exercice 3 : Analyser les metriques d’un benchmark
Le notebook a montre comment executer des theoremes avec un LLM et collecter les résultats (succes, itérations, tokens, temps). Maintenant, implementez une fonction d’analyse qui agrege ces résultats en un rapport de synthese.
Objectif : Implementer analyze_benchmark(results: list) -> dict qui calcule le taux de succes, le nombre moyen d’itérations, le temps moyen et le cout en tokens.
Étapes : 1. Compter les succes et echecs 2. Calculer les moyennes (itérations, temps_ms, tokens) 3. Retourner un dict avec les 4 metriques
Indice : Utilisez une comprehension de liste pour filtrer les succes, puis sum() / len() pour les moyennes. Gerez le cas ou la liste est vide.
# ============================================================# Exercice 3 : Analyse de benchmark# ============================================================# Analysez les resultats d'un benchmark de preuves.# ============================================================def analyze_benchmark(results: list) ->dict:""" Agrege les resultats d'un benchmark de preuves LLM. Chaque element de results est un dict avec : - 'theorem': str - 'success': bool - 'iterations': int - 'time_ms': float - 'tokens': int Returns: dict avec 'success_rate', 'avg_iterations', 'avg_time_ms', 'avg_tokens' """ifnot results:return {'success_rate': 0.0, 'avg_iterations': 0, 'avg_time_ms': 0.0, 'avg_tokens': 0}# TODO: Etape 1 - Compter les succes success_count =0# TODO etudiant# TODO: Etape 2 - Calculer les moyennes avg_iterations =0# TODO etudiant avg_time_ms =0.0# TODO etudiant avg_tokens =0# TODO etudiantreturn {'success_rate': success_count /len(results),'avg_iterations': avg_iterations,'avg_time_ms': avg_time_ms,'avg_tokens': avg_tokens, }# Test avec des donnees simuleestest_results = [ {'theorem': 'add_zero', 'success': True, 'iterations': 1, 'time_ms': 120.5, 'tokens': 85}, {'theorem': 'add_comm', 'success': True, 'iterations': 3, 'time_ms': 350.2, 'tokens': 210}, {'theorem': 'mul_assoc', 'success': False, 'iterations': 5, 'time_ms': 890.1, 'tokens': 450}, {'theorem': 'mul_comm', 'success': True, 'iterations': 2, 'time_ms': 200.0, 'tokens': 130},]report = analyze_benchmark(test_results)print(f"Taux de succes : {report['success_rate']:.0%}")print(f"Iterations moyennes : {report['avg_iterations']:.1f}")print(f"Temps moyen : {report['avg_time_ms']:.1f} ms")print(f"Tokens moyens : {report['avg_tokens']:.0f}")
Taux de succes : 0%
Iterations moyennes : 0.0
Temps moyen : 0.0 ms
Tokens moyens : 0
Resume
Points cles
Système
Approche
Force
Publication
LeanCopilot
Suggestions temps reel
Integration IDE
NeuS 2025
LeanProgress
Prediction progression
Guidage recherche
TMLR 2025
LeanAgent
Lifelong learning
Adaptation
ICLR 2025
AlphaProof
RL + generation massive
Theoremes difficiles
Nature 2025
APOLLO
Automatisation complete
Scalabilite
arXiv 2505
Harmonic Aristotle
Decomposition + search
Olympiades mathematiques
IMO 2025 5/6 (or equiv., arXiv:2510.01346)
Tactiques de prompting
Contexte précis : version Lean 4, imports, hypotheses
But clairement formule : types explicites, theoreme exact
Dans le notebook Lean-08-Agentic-Proving-Python, nous construirons un système multi-agents capable de prouver des theoremes de maniere autonome, en orchestrant : - Agent de recherche : Trouve des lemmes pertinents dans Mathlib - Agent de generation : Propose des tactiques et preuves - Agent de verification : Valide avec Lean et fournit du feedback - Orchestrateur : Coordonne les agents avec Semantic Kernel
Notebook base sur les percees IA 2024-2026 en theorem proving (APOLLO/arXiv:2505.05758, LeanCopilot/NeuS 2025/arXiv:2404.12534, Harmonic Aristotle IMO 2025 5/6/arXiv:2510.01346)