Navigation : Index | << Sudoku-17 Python | Comparaison statistique (18b) >> | [Fin de serie >>]

Comparaison des Solveurs de Sudoku

Voir aussi : Search Foundations pour les algorithmes sous-jacents

Objectifs d’apprentissage

A la fin de ce notebook, vous saurez : 1. Classifier les différentes approches de résolution de Sudoku par catégorie (exacte, heuristique, propagation, apprentissage) 2. Comparer objectivement les performances de 4 solveurs Python sur des puzzles de difficulté variee 3. Analyser les forces et faiblesses de chaque approche selon plusieurs critères (vitesse, fiabilite, scalabilite, simplicite) 4. Choisir le bon solveur en fonction du contexte d’utilisation

Prerequis

  • Avoir lu au moins 3-4 notebooks de la serie Sudoku (Backtracking, OR-Tools, Norvig, un autre au choix)
  • Python 3.10+ avec numpy, matplotlib, ortools

Duree estimee : 35 minutes

1. Introduction

Au fil de cette serie de notebooks, nous avons explore 9 approches différentes pour résoudre le Sudoku. Chacune incarne une philosophie algorithmique distincte :

# Notebook Approche Philosophie
1 Backtracking Recherche exhaustive Explorer systématiquement toutes les possibilites
2 Genetic Métaheuristique Faire evoluer une population de solutions candidates
3 OR-Tools Programmation par contraintes Declarer les contraintes, laisser le solveur chercher
4 Z3 Satisfiabilite (SMT) Prouver l’existence d’une solution satisfaisant des formules logiques
5 Dancing Links Couverture exacte Reduire a un problème de sélection de sous-ensembles
6 Infer.NET Inference probabiliste Propager des distributions de probabilité
7 Norvig Propagation de contraintes Eliminer les impossibilites avant de chercher
8 Simulated Annealing Recuit simule Optimiser par perturbations aléatoires avec refroidissement
10 Neural Network Apprentissage profond Apprendre les motifs de résolution a partir d’exemples

Ce notebook final propose une comparaison systématique de ces approches selon plusieurs dimensions : vitesse, fiabilite, elegance du code et scalabilite. Nous implementerons 4 solveurs Python représentatifs et les testerons sur un benchmark commun.

# Imports
import time
from typing import List, Optional, Tuple, Dict

try:
    import numpy as np
    NUMPY_AVAILABLE = True
except ImportError:
    NUMPY_AVAILABLE = False
    print("numpy non disponible. Certaines visualisations seront limitees.")

try:
    import matplotlib.pyplot as plt
    MATPLOTLIB_AVAILABLE = True
except ImportError:
    MATPLOTLIB_AVAILABLE = False
    print("matplotlib non disponible. Les graphiques ne seront pas affiches.")

try:
    from ortools.sat.python import cp_model
    ORTOOLS_AVAILABLE = True
except ImportError:
    ORTOOLS_AVAILABLE = False
    print("ortools non disponible. Le solveur CP-SAT ne sera pas disponible.")

print("Environnement charge.")
if NUMPY_AVAILABLE:
    print(f"  numpy {np.__version__}")
if ORTOOLS_AVAILABLE:
    print("  ortools importe")
Environnement charge.
  numpy 2.4.2
  ortools importe

Interpretation : Environnement et dependances

Bibliotheques utilisees :

Bibliotheque Version Rôle dans ce notebook
numpy (cf. cellule) Calculs numériques, statistiques (medianne, moyennes)
matplotlib - Visualisations (barres, boxplots, radar)
ortools - Solveur CP-SAT industriel (4e solveur du benchmark)
time - Mesure des temps d’exécution

Pourquoi ces choix : - OR-Tools CP-SAT est le seul solveur externe nécessaire. Les trois autrès solveurs sont implementes en Python pur pour illustrer les algorithmes - numpy est utilise pour les statistiques du benchmark (medianne des temps) - matplotlib génère les graphiques comparatifs (barres, boxplots, radar)

Note : Aucune dépendance lourde (pas de tensorflow, pytorch, etc.). Ce notebook reste léger et s’exécute sur n’importe quel environnement Python standard.

2. Catégories d’approches

Les 9 approches etudiees se regroupent naturellement en 5 grandes catégories, chacune correspondant a un paradigme algorithmique fondamental.

2.1 Méthodes exactes (garantie de solution)

Ces méthodes explorent l’espace de recherche de manière systématique et trouvent toujours une solution si elle existe.

Méthode Principe Complexite pratique Notebook
Backtracking DFS + validation Rapide (facile), lent (difficile) Sudoku-01
Backtracking + MRV DFS + heuristique MRV Rapide même sur puzzles difficiles Sudoku-Python-BT
Dancing Links Couverture exacte (Algorithm X) Optimal pour les problèmes de couverture Sudoku-02
OR-Tools CP-SAT CP + SAT + CDCL Très rapide, constant Sudoku-10
Z3 SMT Satisfiabilite Modulo Théories Rapide, overhead d’initialisation Sudoku-12

2.2 Méthodes de propagation

Ces méthodes reduisent l’espace de recherche en eliminant les valeurs impossibles avant (ou a la place de) la recherche.

Méthode Principe Completude Notebook
Norvig Elimination + naked singles + DFS de secours Complet (avec fallback recherche) Sudoku-07
Stratégies humaines Règles logiques (naked pairs, X-Wing, etc.) Incomplet sans recherche (integre dans divers notebooks)

2.3 Méthodes heuristiques (pas de garantie)

Ces méthodes utilisent des mécanismes d’optimisation stochastique et ne garantissent pas de trouver une solution.

Méthode Principe Fiabilite Notebook
Algorithme génétique Evolution de populations Faible sur puzzles difficiles Sudoku-03
Recuit simule Perturbations + refroidissement Moyenne Sudoku-04

2.4 Méthodes d’apprentissage

Méthode Principe Fiabilite Notebook
Reseau de neurones Apprentissage supervise Approximation, necessite données Sudoku-16

2.5 Méthodes probabilistes

Méthode Principe Fiabilite Notebook
Infer.NET Graphe de facteurs, inference bayesienne Experimentale Sudoku-15

3. Implementations Python des solveurs

Pour une comparaison equitable, nous implementons 4 solveurs représentatifs dans le même environnement Python. Chaque solveur représente une catégorie différente.

Solveur Catégorie Pourquoi ce choix
Backtracking simple Recherche exhaustive Baseline naive, référence de comparaison
Backtracking + MRV Recherche avec heuristique Amelioration classique, montre l’impact des heuristiques
Norvig (propagation) Propagation de contraintes Approche elegante, souvent suffisante sans recherche
OR-Tools CP-SAT Solveur industriel Etat de l’art, référence de performance

Classe SudokuGrid commune

Tous les solveurs utilisent la même représentation de grille pour garantir une comparaison equitable.

class SolverTimeout(Exception):
    """Levee par un solveur cooperatif quand son budget temps (self.deadline) est epuise."""


class SudokuGrid:
    """Representation d'une grille de Sudoku 9x9."""

    def __init__(self, grid: Optional[List[List[int]]] = None):
        if grid is None:
            self.cells = [[0] * 9 for _ in range(9)]
        else:
            self.cells = [row[:] for row in grid]

    @classmethod
    def from_string(cls, s: str) -> 'SudokuGrid':
        """Cree une grille depuis une chaine de 81 caracteres (0 ou . = case vide)."""
        s = s.replace('.', '0').replace(' ', '').replace('\n', '')
        if len(s) != 81:
            raise ValueError(f"Attendu 81 caracteres, recu {len(s)}")
        grid = cls()
        for i in range(81):
            grid.cells[i // 9][i % 9] = int(s[i])
        return grid

    def clone(self) -> 'SudokuGrid':
        return SudokuGrid(self.cells)

    def is_valid_placement(self, row: int, col: int, num: int) -> bool:
        """Verifie si placer num a (row, col) respecte les contraintes."""
        if num in self.cells[row]:
            return False
        if num in [self.cells[r][col] for r in range(9)]:
            return False
        box_row, box_col = 3 * (row // 3), 3 * (col // 3)
        for r in range(box_row, box_row + 3):
            for c in range(box_col, box_col + 3):
                if self.cells[r][c] == num:
                    return False
        return True

    def find_empty(self) -> Optional[Tuple[int, int]]:
        """Trouve la premiere case vide (parcours ligne par ligne)."""
        for r in range(9):
            for c in range(9):
                if self.cells[r][c] == 0:
                    return (r, c)
        return None

    def count_empty(self) -> int:
        return sum(1 for r in range(9) for c in range(9) if self.cells[r][c] == 0)

    def to_string(self) -> str:
        return ''.join(str(self.cells[r][c]) for r in range(9) for c in range(9))

    def __str__(self) -> str:
        lines = []
        for r in range(9):
            if r > 0 and r % 3 == 0:
                lines.append('-' * 21)
            row_str = ''
            for c in range(9):
                if c > 0 and c % 3 == 0:
                    row_str += '| '
                val = self.cells[r][c]
                row_str += (str(val) if val != 0 else '.') + ' '
            lines.append(row_str)
        return '\n'.join(lines)

# Verification rapide
test = SudokuGrid.from_string("003020600900305001001806400008102900700000008006708200002609500800203009005010300")
print("Grille de test:")
print(test)
print(f"Cases vides: {test.count_empty()}")
Grille de test:
. . 3 | . 2 . | 6 . . 
9 . . | 3 . 5 | . . 1 
. . 1 | 8 . 6 | 4 . . 
---------------------
. . 8 | 1 . 2 | 9 . . 
7 . . | . . . | . . 8 
. . 6 | 7 . 8 | 2 . . 
---------------------
. . 2 | 6 . 9 | 5 . . 
8 . . | 2 . 3 | . . 9 
. . 5 | . 1 . | 3 . . 
Cases vides: 49

Interpretation : Classe SudokuGrid - Représentation commune

Fonctionnalites de la classe :

Méthode Rôle Utilite pour les solveurs
from_string Créé une grille depuis 81 caractères Format universel pour les benchmarks
clone Copie independante Evite les interferences entre solveurs
is_valid_placement Valide un placement (ligne/colonne/bloc) Utilisee par le backtracking
find_empty Trouve la première case vide Parcours naive pour le backtracking simple
count_empty Compte les cases vides Metrique de difficulté
to_string Convertit en chaîne Interface avec le solveur Norvig

Grille de test : 49 cases vides sur 81 (60% de la grille). C’est un puzzle de difficulté moyenne-facile qui servira de validation rapide pour chaque solveur.

Design choisi : La classe est volontairement simple (liste de listes 9x9) pour ne pas avantager un solveur particulier. Le solveur Norvig utilise sa propre représentation interne (dictionnaire de chaînes) mais convertit vers/depuis SudokuGrid pour l’interface.

Point architecture : Tous les solveurs implementent la même interface solve(grid: SudokuGrid) -> bool, ce qui permet de les comparer equitablement et de les utiliser de manière interchangeable dans le benchmark.

3.1 Solveur 1 : Backtracking simple

L’algorithme le plus intuitif : essayer chaque valeur dans chaque case vide, revenir en arriere si on atteint une impasse. C’est notre baseline – le solveur le plus simple possible.

Complexite : O(9^m) dans le pire cas, ou m est le nombre de cases vides.

class BacktrackingSolver:
    """Solveur par backtracking simple (DFS sans heuristique)."""

    def __init__(self):
        self.call_count = 0
        self.deadline = None  # annulation cooperative : echeance perf_counter

    def solve(self, grid: SudokuGrid) -> bool:
        self.call_count = 0
        return self._backtrack(grid)

    def _backtrack(self, grid: SudokuGrid) -> bool:
        self.call_count += 1
        if (self.deadline is not None and (self.call_count & 1023) == 0
                and time.perf_counter() > self.deadline):
            raise SolverTimeout()
        empty = grid.find_empty()
        if empty is None:
            return True  # Toutes les cases remplies

        row, col = empty
        for num in range(1, 10):
            if grid.is_valid_placement(row, col, num):
                grid.cells[row][col] = num
                if self._backtrack(grid):
                    return True
                grid.cells[row][col] = 0  # Backtrack
        return False

# Test rapide
solver_bt = BacktrackingSolver()
g = test.clone()
start = time.time()
solved = solver_bt.solve(g)
elapsed_ms = (time.time() - start) * 1000
print(f"Backtracking simple: resolu={solved}, {solver_bt.call_count} appels, {elapsed_ms:.2f} ms")
Backtracking simple: resolu=True, 201 appels, 0.93 ms

Interpretation : Solveur Backtracking simple

Résultat : Le backtracking simple resout le puzzle de test en 201 appels recursifs (temps en ms en sortie live de la cellule ci-dessus – regle #9434, non fige en prose car machine-dependant).

Metrique Valeur Contexte
Appels recursifs 201 Nombre d’entrees dans _backtrack
Temps (ms live, regle #9434) Rapide pour ce puzzle facile
Résultat Succes Solution trouvee

Analyse :

  1. Pourquoi c’est rapide ici : Le puzzle de test a 49 cases vides, c’est un puzzle facile. L’arbre de recherche est petit et le premier chemin explore mene souvent a la solution.

  2. Pourquoi ce sera lent sur les puzzles difficiles : Sans heuristique, le solveur essaie les cases dans l’ordre (ligne par ligne, de gauche a droite) avec les valeurs 1 a 9. Sur un puzzle difficile avec 60+ cases vides, l’arbre de recherche peut atteindre des milliards de noeuds.

  3. Rôle de baseline : Ce solveur sert de référence pour mesurer l’impact des améliorations. Toute optimisation (MRV, propagation, etc.) sera comparee a cette baseline.

Comparaison a venir : Le solveur MRV suivant fera seulement 50 appels sur ce même puzzle – déjà 4x moins. La différence sera beaucoup plus marquee sur les puzzles Medium et Hard.

Exercice : Propagation des singletons (Naked Singles)

Enonce

Le solveur Backtracking simple essaie les valeurs 1-9 séquentiellement. Mais avant de lancer le backtracking, on peut propager les deductions evidentes : les cases qui n’ont qu’un seul candidat possible.

Implementez propagate_naked_singles(grid) qui remplit recursivement toutes les cases ayant exactement 1 candidat, jusqu’a ce qu’aucune propagation ne soit possible.

Indices :

  • Étape 1 : Pour chaque case vide, calculez les candidats (absents de ligne + colonne + bloc)
  • Étape 2 : Si exactement 1 candidat, remplissez la case
  • Étape 3 : Repetez tant qu’au moins une case a ete remplie (propagation en cascade)
  • Étape 4 : Retournez le nombre de cases remplies et la grille modifiée
# EXERCICE : Propagation des singletons (Naked Singles)
#
# Indications :
#   - Identifiez les cases avec exactement 1 candidat
#   - Remplissez-les et repetez (propagation en cascade)
#   - Retournez le nombre de cases remplies

def propagate_naked_singles(grid):
    """Propage les naked singles jusqu'a stabilisation.

    Args:
        grid: liste 9x9 modifiable en place (0 = case vide)

    Returns:
        Nombre de cases remplies par propagation
    """
    # TODO etudiant : implementez la propagation des naked singles
    return 0  # TODO


# Test sur un puzzle facile
test_grid_18 = [
    [0,0,0,2,6,0,7,0,1],
    [6,8,0,0,7,0,0,9,0],
    [1,9,0,0,0,4,5,0,0],
    [8,2,0,1,0,0,0,4,0],
    [0,0,4,6,0,2,9,0,0],
    [0,5,0,0,0,3,0,2,8],
    [0,0,9,3,0,0,0,7,4],
    [0,4,0,0,5,0,0,3,6],
    [7,0,3,0,1,8,0,0,0]
]

n_filled = propagate_naked_singles(test_grid_18)
print(f"Cases remplies par propagation : {n_filled}")
for row in test_grid_18:
    print(row)
Cases remplies par propagation : 0
[0, 0, 0, 2, 6, 0, 7, 0, 1]
[6, 8, 0, 0, 7, 0, 0, 9, 0]
[1, 9, 0, 0, 0, 4, 5, 0, 0]
[8, 2, 0, 1, 0, 0, 0, 4, 0]
[0, 0, 4, 6, 0, 2, 9, 0, 0]
[0, 5, 0, 0, 0, 3, 0, 2, 8]
[0, 0, 9, 3, 0, 0, 0, 7, 4]
[0, 4, 0, 0, 5, 0, 0, 3, 6]
[7, 0, 3, 0, 1, 8, 0, 0, 0]

3.2 Solveur 2 : Backtracking avec MRV

L’heuristique MRV (Minimum Remaining Values) selectionne toujours la case ayant le moins de valeurs possibles. Cela detecte les impasses plus tot et reduit drastiquement l’arbre de recherche.

L’amélioration est souvent spectaculaire : de 100x a 1000x moins d’appels recursifs sur les puzzles difficiles.

class MRVBacktrackingSolver:
    """Solveur par backtracking avec heuristique MRV (Minimum Remaining Values)."""

    def __init__(self):
        self.call_count = 0
        self.deadline = None  # annulation cooperative : echeance perf_counter

    def _get_possible(self, grid: SudokuGrid, row: int, col: int) -> List[int]:
        """Retourne les valeurs possibles pour une case donnee."""
        if grid.cells[row][col] != 0:
            return []
        possible = set(range(1, 10))
        possible -= set(grid.cells[row])
        possible -= {grid.cells[r][col] for r in range(9)}
        box_row, box_col = 3 * (row // 3), 3 * (col // 3)
        for r in range(box_row, box_row + 3):
            for c in range(box_col, box_col + 3):
                possible.discard(grid.cells[r][c])
        return list(possible)

    def _find_mrv(self, grid: SudokuGrid) -> Optional[Tuple[int, int, List[int]]]:
        """Trouve la case vide avec le moins de candidats."""
        best = None
        best_count = 10
        for r in range(9):
            for c in range(9):
                if grid.cells[r][c] == 0:
                    possible = self._get_possible(grid, r, c)
                    if len(possible) < best_count:
                        best = (r, c, possible)
                        best_count = len(possible)
                        if best_count == 0:
                            return best  # Impasse detectee
        return best

    def solve(self, grid: SudokuGrid) -> bool:
        self.call_count = 0
        return self._backtrack(grid)

    def _backtrack(self, grid: SudokuGrid) -> bool:
        self.call_count += 1
        if (self.deadline is not None and (self.call_count & 1023) == 0
                and time.perf_counter() > self.deadline):
            raise SolverTimeout()
        result = self._find_mrv(grid)
        if result is None:
            return True
        row, col, possible = result
        if len(possible) == 0:
            return False
        for num in possible:
            grid.cells[row][col] = num
            if self._backtrack(grid):
                return True
            grid.cells[row][col] = 0
        return False

# Test rapide
solver_mrv = MRVBacktrackingSolver()
g = test.clone()
start = time.time()
solved = solver_mrv.solve(g)
elapsed_ms = (time.time() - start) * 1000
print(f"Backtracking MRV: resolu={solved}, {solver_mrv.call_count} appels, {elapsed_ms:.2f} ms")
Backtracking MRV: resolu=True, 50 appels, 3.52 ms

Interpretation : Solveur Backtracking avec MRV

Résultat : Le backtracking avec MRV resout le puzzle en 50 appels recursifs (temps en ms en sortie live – regle #9434).

Metrique Backtracking simple BT + MRV Amelioration
Appels recursifs 201 50 4x moins
Temps (ms live – regle #9434) (ms live) Plus lent

Paradoxe apparent : MRV fait moins d’appels mais prend plus de temps. Cela s’explique par le cout de l’heuristique :

  • Backtracking simple : Chaque appel est très rapide (trouver la première case vide, essayer 1-9)
  • BT + MRV : Chaque appel necessite de calculer les candidats de toutes les cases vides et de trouver celle avec le minimum

Pourquoi MRV est quand même préférable : 1. Sur les puzzles faciles, la différence de temps est negligeable (millisecondes) 2. Sur les puzzles difficiles, MRV reduit l’arbre de recherche de plusieurs ordres de grandeur 3. Le surcout par appel est constant, mais le nombre d’appels evites croit exponentiellement avec la difficulté

Principe MRV : Toujours choisir la variable la plus contrainte (“fail-first”). En traitant d’abord les cases avec peu de candidats, on detecte les impasses plus tot et on evite d’explorer des sous-arbres inutiles.

3.3 Solveur 3 : Propagation de contraintes (Norvig)

L’approche de Peter Norvig combine deux stratégies de propagation :

  1. Elimination : quand une case recoit une valeur, on retire cette valeur des candidats de tous ses voisins (même ligne, colonne, bloc)
  2. Naked single : quand une valeur n’a qu’un seul emplacement possible dans une unite, on l’y assigne

Si la propagation seule ne suffit pas, un backtracking avec MRV prend le relais. En pratique, la propagation resout la majorite des puzzles faciles/moyens sans aucune recherche.

class NorvigSolver:
    """Solveur par propagation de contraintes (style Peter Norvig).

    Utilise elimination + naked singles, avec backtracking MRV en fallback.
    Reference : http://norvig.com/sudoku.html
    """

    def __init__(self):
        self.call_count = 0
        self.deadline = None  # annulation cooperative : echeance perf_counter
        # Precalcul des unites et des voisins
        self.rows = 'ABCDEFGHI'
        self.cols = '123456789'
        self.squares = [r + c for r in self.rows for c in self.cols]
        self.unitlist = (
            [[r + c for c in self.cols] for r in self.rows] +            # lignes
            [[r + c for r in self.rows] for c in self.cols] +            # colonnes
            [[r + c for r in rs for c in cs]                             # blocs
             for rs in ('ABC', 'DEF', 'GHI') for cs in ('123', '456', '789')]
        )
        self.units = {s: [u for u in self.unitlist if s in u] for s in self.squares}
        self.peers = {s: set(sum(self.units[s], [])) - {s} for s in self.squares}

    def solve(self, grid: SudokuGrid) -> bool:
        self.call_count = 0
        # Convertir la grille en chaine
        grid_str = grid.to_string()
        values = self._parse_grid(grid_str)
        if values is False:
            return False
        result = self._search(values)
        if result is False:
            return False
        # Ecrire la solution dans la grille
        for i, s in enumerate(self.squares):
            grid.cells[i // 9][i % 9] = int(result[s])
        return True

    def _parse_grid(self, grid_str: str):
        """Initialise les candidats et propage les valeurs initiales."""
        values = {s: '123456789' for s in self.squares}
        for s, d in zip(self.squares, grid_str):
            if d in '123456789':
                if not self._assign(values, s, d):
                    return False
        return values

    def _assign(self, values, s, d):
        """Assigne la valeur d a la case s par elimination de toutes les autres."""
        other_values = values[s].replace(d, '')
        if all(self._eliminate(values, s, d2) for d2 in other_values):
            return values
        return False

    def _eliminate(self, values, s, d):
        """Elimine d des candidats de s et propage."""
        if d not in values[s]:
            return values  # Deja eliminee
        values[s] = values[s].replace(d, '')

        # Si aucun candidat restant : contradiction
        if len(values[s]) == 0:
            return False

        # Si un seul candidat : propager aux voisins
        if len(values[s]) == 1:
            d2 = values[s]
            if not all(self._eliminate(values, s2, d2) for s2 in self.peers[s]):
                return False

        # Si d n'a qu'un seul emplacement dans une unite : l'y assigner
        for u in self.units[s]:
            dplaces = [s2 for s2 in u if d in values[s2]]
            if len(dplaces) == 0:
                return False  # Contradiction
            if len(dplaces) == 1:
                if not self._assign(values, dplaces[0], d):
                    return False
        return values

    def _search(self, values):
        """Recherche DFS avec heuristique MRV."""
        if values is False:
            return False
        self.call_count += 1
        if (self.deadline is not None and (self.call_count & 255) == 0
                and time.perf_counter() > self.deadline):
            raise SolverTimeout()

        # Verifie si resolu
        if all(len(values[s]) == 1 for s in self.squares):
            return values

        # MRV : choisir la case non resolue avec le moins de candidats
        _, s = min((len(values[s]), s) for s in self.squares if len(values[s]) > 1)

        for d in values[s]:
            result = self._search(self._assign(values.copy(), s, d))
            if result:
                return result
        return False

# Test rapide
solver_norvig = NorvigSolver()
g = test.clone()
start = time.time()
solved = solver_norvig.solve(g)
elapsed_ms = (time.time() - start) * 1000
print(f"Norvig: resolu={solved}, {solver_norvig.call_count} appels, {elapsed_ms:.2f} ms")
Norvig: resolu=True, 1 appels, 2.76 ms

Interpretation : Solveur Norvig (propagation de contraintes)

Résultat : Norvig resout le puzzle en 1 appel récursif (temps en ms en sortie live – regle #9434).

Metrique Valeur Observation
Appels recursifs 1 Aucune recherche nécessaire
Temps (ms live, regle #9434) Le plus rapide sur ce puzzle

Pourquoi un seul appel ?

La propagation de contraintes (elimination + naked singles) a entierement résolu le puzzle sans qu’aucun backtracking ne soit nécessaire. C’est le cas pour la plupart des puzzles faciles/moyens.

Mécanismes de propagation : 1. Elimination : Quand une valeur est assignee a une case, elle est retiree des candidats de tous ses voisins (ligne, colonne, bloc) 2. Naked single : Si une valeur ne peut aller que dans une seule case d’une unite, on l’y assigne 3. Cascade : Chaque assignation declenche une nouvelle propagation, qui peut elle-même declencher d’autrès assignations

Comparaison avec le backtracking : Le solveur simple a necessite 201 appels recursifs pour le même puzzle. Norvig atteint la même solution en un seul appel grâce a la propagation qui elimine les branches inutiles avant même de les explorer.

Point cle : La force de Norvig n’est pas la vitesse pure, mais la capacite a résoudre sans recherche. Sur des puzzles plus difficiles, le backtracking MRV prend le relais avec un espace de recherche déjà drastiquement reduit.

Note sur les mesures de temps : les temps de résolution varient selon la machine (ordonnancement CPU, cache). Les nombres d’appels récursifs et coupes FC sont déterministes (reproductibles à l’identique) ; seuls les temps en millisecondes sont indicatifs (ordre de grandeur).

3.4 Solveur 4 : OR-Tools CP-SAT

Google OR-Tools est un solveur industriel de programmation par contraintes. Au lieu de programmer un algorithme de recherche, on declare les contraintes et le solveur fait le reste.

Le modèle Sudoku se resume a : - 81 variables entieres dans {1..9} - 27 contraintes AllDifferent (9 lignes + 9 colonnes + 9 blocs)

C’est l’approche la plus concise et généralement la plus performante.

class ORToolsCPSATSolver:
    """Solveur utilisant Google OR-Tools CP-SAT."""

    def __init__(self):
        self.call_count = 0  # Non applicable, mais conserve pour l'interface
        self.deadline = None  # annulation cooperative -> max_time_in_seconds natif

    def solve(self, grid: SudokuGrid) -> bool:
        self.call_count = 1  # Le solveur fait tout en interne
        model = cp_model.CpModel()

        # Variables : cells[i][j] dans {1..9}
        cells = {}
        for i in range(9):
            for j in range(9):
                if grid.cells[i][j] != 0:
                    cells[(i, j)] = model.NewConstant(grid.cells[i][j])
                else:
                    cells[(i, j)] = model.NewIntVar(1, 9, f'c_{i}_{j}')

        # Contraintes AllDifferent : lignes
        for i in range(9):
            model.AddAllDifferent([cells[(i, j)] for j in range(9)])

        # Contraintes AllDifferent : colonnes
        for j in range(9):
            model.AddAllDifferent([cells[(i, j)] for i in range(9)])

        # Contraintes AllDifferent : blocs 3x3
        for br in range(3):
            for bc in range(3):
                model.AddAllDifferent([
                    cells[(br * 3 + r, bc * 3 + c)]
                    for r in range(3) for c in range(3)
                ])

        # Resolution : budget natif CP-SAT = annulation cooperative reelle
        solver = cp_model.CpSolver()
        if self.deadline is not None:
            remaining = self.deadline - time.perf_counter()
            if remaining <= 0:
                raise SolverTimeout()
            solver.parameters.max_time_in_seconds = remaining
        status = solver.Solve(model)
        if self.deadline is not None and status == cp_model.UNKNOWN:
            raise SolverTimeout()

        if status in (cp_model.OPTIMAL, cp_model.FEASIBLE):
            for i in range(9):
                for j in range(9):
                    grid.cells[i][j] = solver.Value(cells[(i, j)])
            return True
        return False

# Test rapide
solver_cpsat = ORToolsCPSATSolver()
g = test.clone()
start = time.time()
solved = solver_cpsat.solve(g)
elapsed_ms = (time.time() - start) * 1000
print(f"OR-Tools CP-SAT: resolu={solved}, {elapsed_ms:.2f} ms")
OR-Tools CP-SAT: resolu=True, 77.11 ms

Interpretation : Solveur OR-Tools CP-SAT

Résultat : OR-Tools resout le puzzle avec succès (temps en ms en sortie live – regle #9434).

Metrique Valeur Observation
Temps (ms live, regle #9434) Plus lent que Norvig sur ce puzzle (overhead de modelisation)
Appels 1 Le solveur gere tout en interne

Analyse :

  1. Overhead de modelisation : Le temps inclut la construction du modèle (81 variables, 27 contraintes AllDifferent) et l’initialisation du solveur. Pour un seul puzzle, cet overhead est significatif.

  2. Avantage sur les grands problèmes : Contrairement aux solveurs Python purs, OR-Tools est compile en C++ et optimise pour des problèmes avec des milliers de variables. Le temps de résolution reste quasi-constant quelle que soit la difficulté du puzzle.

  3. Declaratif vs imperatif : Le code ne contient aucune logique de recherche – on declare les contraintes et le solveur trouve la solution. C’est l’approche la plus concise (~15 lignes utiles).

Quand utiliser OR-Tools : Quand la robustesse et la previsibilite sont plus importantes que la vitesse brute, ou quand le problème est trop complexe pour un solveur maison.

Exercice : Verifier l’unicite de la solution avec OR-Tools

Enonce

Un Sudoku bien pose possede exactement une solution. Avec OR-Tools CP-SAT, on peut le vérifier en cherchant une deuxieme solution. Implementez has_unique_solution(grid) qui retourne True si le puzzle a exactement 1 solution.

Indices :

  • Étape 1 : Modelisez le Sudoku comme dans ORToolsCPSATSolver (variables 1-9, allDifferent)
  • Étape 2 : Appelez solver.solve(model) une première fois
  • Étape 3 : Si solution trouvee, ajoutez une contrainte interdisant cette solution (au moins une case différente)
  • Étape 4 : Appelez solver.solve(model) a nouveau. Si pas de solution = unique
# EXERCICE : Verifier l'unicite de la solution avec OR-Tools
#
# Indications :
#   - Resoudre une premiere fois
#   - Ajouter une contrainte interdisant cette solution
#   - Tenter de resoudre a nouveau

def has_unique_solution(grid):
    """Verifie si un Sudoku a exactement une solution.

    Args:
        grid: liste 9x9 (0 = case vide)

    Returns:
        True si exactement 1 solution, False sinon
    """
    # TODO etudiant : implementez la verification d'unicite
    print("Exercice a completer : has_unique_solution")
    return None  # TODO etudiant


# Test
try:
    from ortools.sat.python import cp_model
    ORTTOOLS_AVAILABLE = True
    print("OR-Tools disponible pour le test.")
except ImportError:
    ORTTOOLS_AVAILABLE = False
    print("OR-Tools non disponible - test skippe.")

if ORTTOOLS_AVAILABLE:
    # Puzzle facile (solution unique normalement)
    easy = [0,0,0,2,6,0,7,0,1,6,8,0,0,7,0,0,9,0,
            1,9,0,0,0,4,5,0,0,8,2,0,1,0,0,0,4,0,
            0,0,4,6,0,2,9,0,0,0,5,0,0,0,3,0,2,8,
            0,0,9,3,0,0,0,7,4,0,4,0,0,5,0,0,3,6,
            7,0,3,0,1,8,0,0,0]
    grid_9x9 = [easy[i*9:(i+1)*9] for i in range(9)]
    unique = has_unique_solution(grid_9x9)
    print(f"Solution unique : {unique}")
OR-Tools disponible pour le test.
Exercice a completer : has_unique_solution
Solution unique : None

4. Benchmark

Nous testons les 4 solveurs sur 4 niveaux de difficulté : 10 puzzles disponibles pour Easy/Medium/Hard (le benchmark en exécute 5 par difficulté), et 1 puzzle Expert (régime 17-24 indices, où un seul suffit à illustrer les timeout). Tous les puzzles sont codes en dur ci-dessous pour garantir la reproductibilite (pas de dépendance a des fichiers externes).

Jeux de test

Difficulte Caractéristiques Nombre de cases vides
Easy Beaucoup d’indices, propagation simple suffit ~35-45
Medium Indices reduits, necessite un peu de recherche ~45-55
Hard Très peu d’indices, cas extrêmes connus ~55-60
Expert Regime 17-24 indices : les solveurs exacts (backtracking) timeout, les métaheuristiques (recuit simule, génétique) n’ont aucune garantie de convergence ~57-64
# -- Jeux de test codes en dur --
# Source : Sudoku_Easy51.txt (10 premiers)
EASY_PUZZLES = [
    "003020600900305001001806400008102900700000008006708200002609500800203009005010300",
    "200080300060070084030500209000105408000000000402706000301007040720040060004010003",
    "000000907000420180000705026100904000050000040000507009920108000034059000507000000",
    "030050040008010500460000012070502080000603000040109030250000098001020600080060020",
    "020810740700003100090002805009040087400208003160030200302700060005600008076051090",
    "100920000524010000000000070050008102000000000402700090060000000000030945000071006",
    "043080250600000000000001094900004070000608000010200003820500000000000005034090710",
    "480006902002008001900370060840010200003704100001060049020085007700900600609200018",
    "000900002050123400030000160908000000070000090000000205091000050007439020400007000",
    "001900003900700160030005007050000009004302600200000070600100030042007006500006800",
]

# Source : Sudoku_top95.txt (10 puzzles selectionnes, difficulte medium)
MEDIUM_PUZZLES = [
    "4.....8.5.3..........7......2.....6.....8.4......1.......6.3.7.5..2.....1.4......",
    "52...6.........7.13...........4..8..6......5...........418.........3..2...87.....",
    "6.....8.3.4.7.................5.4.7.3..2.....1.6.......2.....5.....8.6......1....",
    "48.3............71.2.......7.5....6....2..8.............1.76...3.....4......5....",
    "....14....3....2...7..........9...3.6.1.............8.2.....1.4....5.6.....7.8...",
    "......52..8.4......3...9...5.1...6..2..7........3.....6...1..........7.4.......3.",
    "6.2.5.........3.4..........43...8....1....2........7..5..27...........81...6.....",
    ".524.........7.1..............8.2...3.....6...9.5.....1.6.3...........897........",
    "6.2.5.........4.3..........43...8....1....2........7..5..27...........81...6.....",
    ".923.........8.1...........1.7.4...........658.........6.5.2...4.....7.....9.....",
]

# Source : Sudoku_hardest.txt (les 10 premiers relevent du regime "Hard" :
# backtracking galere, propagation suffit).
HARD_PUZZLES = [
    "85...24..72......9..4.........1.7..23.5...9...4...........8..7..17..........36.4.",
    "..53.....8......2..7..1.5..4....53...1..7...6..32...8..6.5....9..4....3......97..",
    "12..4......5.69.1...9...5.........7.7...52.9..3......2.9.6...5.4..9..8.1..3...9.4",
    "...57..3.1......2.7...234......8...4..7..4...49....6.5.42...3.....7..9....18.....",
    "7..1523........92....3.....1....47.8.......6............9...5.6.4.9.7...8....6.1.",
    "1....7.9..3..2...8..96..5....53..9...1..8...26....4...3......1..4......7..7...3..",
    "1...34.8....8..5....4.6..21.18......3..1.2..6......81.52..7.9....6..9....9.64...2",
    "...92......68.3...19..7...623..4.1....1...7....8.3..297...8..91...5.72......64...",
    ".6.5.4.3.1...9...8.........9...5...6.4.6.2.7.7...4...5.........4...8...1.5.2.3.4.",
    "7.....4...2..7..8...3..8.799..5..3...6..2..9...1.97..6...3..9...3..4..6...9..1.35",
]

# Source : Sudoku_hardest.txt ligne 11 (regime Expert 17-24 indices).
# Worst-case classique : backtracking exact timeout, recuit simule n'a aucune
# garantie de converger dans la fenetre de 5s/puzzle.
EXPERT_PUZZLES = [
    "....7..2.8.......6.1.2.5...9.54....8.........3....85.1...3.2.8.4.......9.7..6....",
]

print(f"Puzzles charges :")
print(f"  Easy:   {len(EASY_PUZZLES)} puzzles")
print(f"  Medium: {len(MEDIUM_PUZZLES)} puzzles")
print(f"  Hard:   {len(HARD_PUZZLES)} puzzles")
print(f"  Expert: {len(EXPERT_PUZZLES)} puzzles")

# Verification : compter les cases vides par niveau
for name, puzzles in [("Easy", EASY_PUZZLES), ("Medium", MEDIUM_PUZZLES), ("Hard", HARD_PUZZLES), ("Expert", EXPERT_PUZZLES)]:
    empties = [SudokuGrid.from_string(p).count_empty() for p in puzzles]
    print(f"  {name}: {min(empties)}-{max(empties)} cases vides (moy: {np.mean(empties):.1f})")
Puzzles charges :
  Easy:   10 puzzles
  Medium: 10 puzzles
  Hard:   10 puzzles
  Expert: 1 puzzles
  Easy: 45-57 cases vides (moy: 51.4)
  Medium: 64-64 cases vides (moy: 64.0)
  Hard: 53-59 cases vides (moy: 56.2)
  Expert: 59-59 cases vides (moy: 59.0)

Interpretation : Jeux de test et profil des puzzles

Repartition des jeux de test :

Difficulte Nombre Cases vides (min-max) Moyenne
Easy 10 45-57 51.4
Medium 10 64 64.0
Hard 10 53-59 56.2

Observation contre-intuitive : Les puzzles Medium ont en moyenne plus de cases vides (64) que les puzzles Hard (56.2). Cela s’explique par la provenance des données :

  • Easy : Grilles classiques avec beaucoup d’indices, la propagation suffit généralement
  • Medium : Puzzles “top95” avec peu d’indices (presque toutes les cases vides), ce qui crée un espace de recherche immense
  • Hard : Puzzles “hardest” connus pour leur difficulté logique, mais qui ont parfois plus d’indices que les Medium

Lecon : La difficulté algorithmique ne depend pas seulement du nombre de cases vides, mais surtout de la structure des contraintes. Un puzzle avec 53 cases vides bien placees peut etre plus resistant qu’un puzzle avec 64 cases vides mal reparties.

Protocole du benchmark (aligné sur Sudoku-18b) :

  • 5 grilles par difficulté parmi les 10 disponibles — la variabilité inter-grilles devient mesurable ; Expert (1 grille) est une étude de cas, pas une distribution ;
  • les runs résolus en moins de 250 ms sont répétés 3 fois sur la même grille : le spread des répétitions isole le bruit système, distinct de la variabilité inter-grilles ;
  • timeout coopératif de 30 s par essai (SolverTimeout) — aucun thread orphelin ;
  • un timeout est une observation censurée : comptée au dénominateur, exclue des médianes/IQR.

Exécution du benchmark

La fonction run_benchmark teste chaque solveur sur chaque ensemble de puzzles et collecte les temps de résolution et le taux de succès. Chaque puzzle est résolu sur une copie de la grille pour eviter toute interference entre solveurs.

# Dictionnaires de solveurs et de puzzles pour le benchmark
solvers = {
    'Backtracking': BacktrackingSolver(),
    'BT + MRV': MRVBacktrackingSolver(),
    'Norvig': NorvigSolver(),
    'OR-Tools CP-SAT': ORToolsCPSATSolver(),
}

puzzle_sets = {
    'Easy': EASY_PUZZLES,
    'Medium': MEDIUM_PUZZLES,
    'Hard': HARD_PUZZLES,
    'Expert': EXPERT_PUZZLES,
}

print(f"Solveurs configures : {list(solvers.keys())}")
print(f"Puzzles disponibles : {list(puzzle_sets.keys())}")
Solveurs configures : ['Backtracking', 'BT + MRV', 'Norvig', 'OR-Tools CP-SAT']
Puzzles disponibles : ['Easy', 'Medium', 'Hard', 'Expert']

Configuration du benchmark

Les 4 solveurs et 3 niveaux de difficulté sont organises en dictionnaires pour permettre une itération systématique. La fonction run_benchmark définie ci-dessous encapsule la logique de test avec gestion des timeouts.

FAST_REPEAT_MS = 250.0   # runs resolus < 250 ms : repetes pour isoler le bruit systeme
N_REPEATS = 3            # repetitions additionnelles de la MEME grille


def run_benchmark(solvers, puzzle_sets, grids_per_diff=5, timeout_s=30):
    """Benchmark statistiquement interpretable (protocole aligne sur Sudoku-18b).

    - Plusieurs grilles par difficulte : la variabilite INTER-GRILLES est mesurable.
      Expert ne contient qu'une grille : etude de cas, pas une distribution.
    - Les runs resolus rapides (< FAST_REPEAT_MS) sont repetes N_REPEATS fois sur
      la meme grille : le spread des repetitions isole le BRUIT SYSTEME.
    - Timeout COOPERATIF : chaque solveur consulte self.deadline et leve
      SolverTimeout -- aucun thread orphelin ne survit au budget (l'ancien
      ThreadPoolExecutor attendait un thread non annulable : un timeout de 30 s
      pouvait durer 69 s reels, en polluant en outre les timings suivants).
    - Censure : un timeout est compte au denominateur (taux de resolution) mais
      EXCLU des statistiques de temps (mediane, IQR).
    """
    results = {}
    for solver_name, solver in solvers.items():
        results[solver_name] = {}
        for diff_name, puzzles in puzzle_sets.items():
            n_grids = min(grids_per_diff, len(puzzles))
            completed_ms = []
            n_timeouts = 0
            n_unsolved = 0
            for puzzle_str in puzzles[:n_grids]:
                grid = SudokuGrid.from_string(puzzle_str)
                run_times = []
                timed_out = False
                try:
                    solver.deadline = time.perf_counter() + timeout_s
                    g = grid.clone()
                    start = time.perf_counter()
                    success = solver.solve(g)
                    elapsed = (time.perf_counter() - start) * 1000.0
                    if success:
                        run_times.append(elapsed)
                        if elapsed < FAST_REPEAT_MS:
                            for _ in range(N_REPEATS):
                                solver.deadline = time.perf_counter() + timeout_s
                                g2 = grid.clone()
                                s2 = time.perf_counter()
                                try:
                                    if solver.solve(g2):
                                        run_times.append((time.perf_counter() - s2) * 1000.0)
                                except SolverTimeout:
                                    pass
                    else:
                        n_unsolved += 1
                except SolverTimeout:
                    timed_out = True
                finally:
                    solver.deadline = None
                if timed_out:
                    n_timeouts += 1
                else:
                    completed_ms.extend(run_times)
            arr = np.array(completed_ms) if completed_ms else np.array([])
            results[solver_name][diff_name] = {
                'n_grids': n_grids,
                'n_timeouts': n_timeouts,
                'n_unsolved': n_unsolved,
                'n_completed_runs': len(completed_ms),
                'solved': n_grids - n_timeouts - n_unsolved,
                'count': n_grids,
                'median_ms': float(np.median(arr)) if len(arr) else float('nan'),
                'p25_ms': float(np.percentile(arr, 25)) if len(arr) else float('nan'),
                'p75_ms': float(np.percentile(arr, 75)) if len(arr) else float('nan'),
                'time_avg_ms': float(np.mean(arr)) if len(arr) else float('nan'),
                'time_total_ms': float(np.sum(arr)) if len(arr) else 0.0,
                'times_ms': completed_ms,
            }
    return results

print("Fonction definie : run_benchmark (multi-grilles, repetitions, censure, timeout cooperatif)")
Fonction definie : run_benchmark (multi-grilles, repetitions, censure, timeout cooperatif)

Lancement du benchmark

Nous executons le benchmark statistique sur les solveurs du framework : 5 grilles par difficulte, repetitions des runs rapides, et un timeout cooperatif de 30 secondes par essai – chaque solveur consulte une echeance et leve SolverTimeout, le calcul est reellement interrompu (aucun thread orphelin ne survit au budget).

# Lancer le benchmark statistique : 5 grilles par difficulte (Expert : 1 grille,
# etude de cas), timeout cooperatif 30 s PAR ESSAI, repetitions des runs rapides.
print("Benchmark en cours (5 grilles/difficulte, timeout cooperatif 30 s/essai, repetitions des runs < 250 ms)...")
results = run_benchmark(solvers, puzzle_sets, grids_per_diff=5, timeout_s=30)
print("Termine.")
Benchmark en cours (5 grilles/difficulte, timeout cooperatif 30 s/essai, repetitions des runs < 250 ms)...
Termine.

Tableau recapitulatif des résultats

Affichons les résultats sous forme de tableau synthetique, puis sous forme graphique.

Note : Le benchmark exécute 5 grilles par difficulté (Expert : 1 grille, étude de cas) avec un timeout cooperatif de 30 s par essai — chaque solveur consulte une échéance et lève SolverTimeout, aucun thread orphelin ne survit au budget (l’ancien ThreadPoolExecutor attendait le thread non annulable : un timeout de 30 s pouvait durer 69 s réels). Les timeouts sont des observations censurées : comptées au dénominateur du taux de résolution, exclues des statistiques de temps. exécution rapide tout en montrant les différences de performance entre solveurs.

def variability_label(res):
    """Qualificatif DERIVE des mesures (jamais hand-written), seuils explicites."""
    if res['n_grids'] < 2:
        return 'etude de cas (1 grille) : repetitions = bruit systeme'
    if res['n_completed_runs'] < 3 or not np.isfinite(res['median_ms']) or res['median_ms'] <= 0:
        return 'censure totale : pas de distribution'
    ratio = (res['p75_ms'] - res['p25_ms']) / res['median_ms']
    if ratio < 0.25:
        return f'tres faible (IQR/med = {ratio:.2f})'
    if ratio < 0.5:
        return f'faible (IQR/med = {ratio:.2f})'
    if ratio < 1.0:
        return f'moderee (IQR/med = {ratio:.2f})'
    return f'forte (IQR/med = {ratio:.2f})'


def print_benchmark_table(results):
    """Mediane [p25-p75], taux AVEC denominateur, timeouts censurees, effectifs."""
    difficulties = ['Easy', 'Medium', 'Hard', 'Expert']
    header = (f"{'Solveur':<18} {'Difficulte':<10} {'Mediane [p25-p75] ms':>24}"
              f" {'Resolu':>7} {'TO':>4} {'Runs':>5}  Variabilite")
    print(header)
    print('-' * len(header))
    for solver_name in results:
        for diff in difficulties:
            r = results[solver_name][diff]
            if r['n_completed_runs'] > 0 and np.isfinite(r['median_ms']):
                cell_t = f"{r['median_ms']:>10.1f} [{r['p25_ms']:.1f}-{r['p75_ms']:.1f}]"
            else:
                cell_t = f"{'(censure)':>24}"
            print(f"{solver_name:<18} {diff:<10} {cell_t:>24} {r['solved']:>3}/{r['count']:<3}"
                  f" {r['n_timeouts']:>4} {r['n_completed_runs']:>5}  {variability_label(r)}")

print("=== Resultats du benchmark (mediane [p25-p75] ; TO = timeouts censurees) ===\n")
print_benchmark_table(results)

# Ratiers derives des medianes fraiches (jamais d'un run unique)
difficulties = ['Easy', 'Medium', 'Hard', 'Expert']
print("\n--- Ratios de vitesse (medianes, entre solveurs ayant complete >= 1 run) ---")
for diff in difficulties:
    meds = {}
    for s in results:
        r = results[s][diff]
        if r['n_completed_runs'] > 0 and np.isfinite(r['median_ms']):
            meds[s] = r['median_ms']
    if len(meds) >= 2:
        fast = min(meds, key=meds.get)
        slow = max(meds, key=meds.get)
        nf = results[fast][diff]['n_completed_runs']
        ns = results[slow][diff]['n_completed_runs']
        print(f"  {diff:<8}: {fast} ({nf} runs) vs {slow} ({ns} runs) -> x{meds[slow] / meds[fast]:.1f}")

print("\n--- Resolution globale (denominateurs conserves) ---")
for solver_name in results:
    tot = sum(results[solver_name][d]['count'] for d in difficulties)
    sol = sum(results[solver_name][d]['solved'] for d in difficulties)
    to = sum(results[solver_name][d]['n_timeouts'] for d in difficulties)
    print(f"  {solver_name:<18}: {sol}/{tot} resolus, {to} timeouts censurees")
=== Resultats du benchmark (mediane [p25-p75] ; TO = timeouts censurees) ===

Solveur            Difficulte     Mediane [p25-p75] ms  Resolu   TO  Runs  Variabilite
--------------------------------------------------------------------------------------
Backtracking       Easy                  1.6 [1.1-8.4]   5/5      0    20  forte (IQR/med = 4.66)
Backtracking       Medium         3064.8 [1867.9-12795.1]   3/5      2     3  forte (IQR/med = 3.57)
Backtracking       Hard            262.1 [77.1-1452.5]   5/5      0     8  forte (IQR/med = 5.25)
Backtracking       Expert          692.6 [692.6-692.6]   1/1      0     1  etude de cas (1 grille) : repetitions = bruit systeme
BT + MRV           Easy                  4.2 [3.4-7.3]   5/5      0    20  moderee (IQR/med = 0.91)
BT + MRV           Medium           192.8 [60.7-250.9]   5/5      0    11  moderee (IQR/med = 0.99)
BT + MRV           Hard               40.9 [13.0-93.5]   5/5      0    17  forte (IQR/med = 1.97)
BT + MRV           Expert             45.6 [44.4-46.8]   1/1      0     4  etude de cas (1 grille) : repetitions = bruit systeme
Norvig             Easy                  2.8 [2.5-3.2]   5/5      0    20  faible (IQR/med = 0.26)
Norvig             Medium              10.5 [7.5-19.3]   5/5      0    20  forte (IQR/med = 1.12)
Norvig             Hard                  3.3 [2.3-4.4]   5/5      0    20  moderee (IQR/med = 0.63)
Norvig             Expert                4.0 [4.0-4.1]   1/1      0     4  etude de cas (1 grille) : repetitions = bruit systeme
OR-Tools CP-SAT    Easy               15.4 [15.0-15.8]   5/5      0    20  tres faible (IQR/med = 0.05)
OR-Tools CP-SAT    Medium             15.5 [15.2-15.9]   5/5      0    20  tres faible (IQR/med = 0.05)
OR-Tools CP-SAT    Hard               15.8 [15.2-16.1]   5/5      0    20  tres faible (IQR/med = 0.06)
OR-Tools CP-SAT    Expert             15.1 [15.0-15.2]   1/1      0     4  etude de cas (1 grille) : repetitions = bruit systeme

--- Ratios de vitesse (medianes, entre solveurs ayant complete >= 1 run) ---
  Easy    : Backtracking (20 runs) vs OR-Tools CP-SAT (20 runs) -> x9.8
  Medium  : Norvig (20 runs) vs Backtracking (3 runs) -> x292.5
  Hard    : Norvig (20 runs) vs Backtracking (8 runs) -> x80.3
  Expert  : Norvig (4 runs) vs Backtracking (1 runs) -> x172.6

--- Resolution globale (denominateurs conserves) ---
  Backtracking      : 14/16 resolus, 2 timeouts censurees
  BT + MRV          : 16/16 resolus, 0 timeouts censurees
  Norvig            : 16/16 resolus, 0 timeouts censurees
  OR-Tools CP-SAT   : 16/16 resolus, 0 timeouts censurees

Exercice : Analyser la robustesse des solveurs face aux puzzles partiels

Objectif Testez comment chaque solveur se comporte quand on augmente progressivement le nombre de cases vides dans un puzzle (de 30 a 55 cases vides).

Indice Partez d’un puzzle résolu et supprimez aléatoirement un nombre croissant de valeurs. Mesurez le temps de résolution pour chaque niveau de difficulté artificielle.

# EXERCICE : Analyser la robustesse des solveurs face aux puzzles partiels
def measure_robustness(solvers: dict, base_puzzle: str, removal_counts: List[int]) -> dict:
    # TODO: Pour chaque nombre de suppressions, creez un puzzle partiel
    # et testez chaque solveur. Retournez les temps de resolution.
    result = {}  # TODO etudiant
    return result

Interpretation : Résultats du benchmark

Lecture du tableau (médiane [p25-p75], taux avec dénominateur, timeouts censurées) :

  1. Backtracking simple : sans heuristique, l’arbre explose sur les structures défavorables — les timeouts censurées le montrent au dénominateur. Ses médianes ne portent que sur les grilles complétées.

  2. BT + MRV : l’heuristique MRV réduit fortement l’arbre. Comparer ses médianes à celles du backtracking simple reste toutefois biaisé : les grilles que le simple ne termine pas sont précisément les plus dures (biais de censure) — d’où le taux de résolution affiché à côté du temps.

  3. Norvig et OR-Tools CP-SAT : les deux moteurs complètent l’ensemble ; leurs IQR quantifient la variabilité inter-grilles, et les répétitions des runs rapides donnent le bruit système.

Règle de lecture : une médiane ne se compare entre solveurs que si les taux de résolution sont égaux — sinon la comparaison favorise mécaniquement le solveur qui n’a tenté que les grilles faciles. C’est le protocole de Sudoku-18b (bootstrap, Mann-Whitney, comparaisons multiples) appliqué au benchmark des twins.

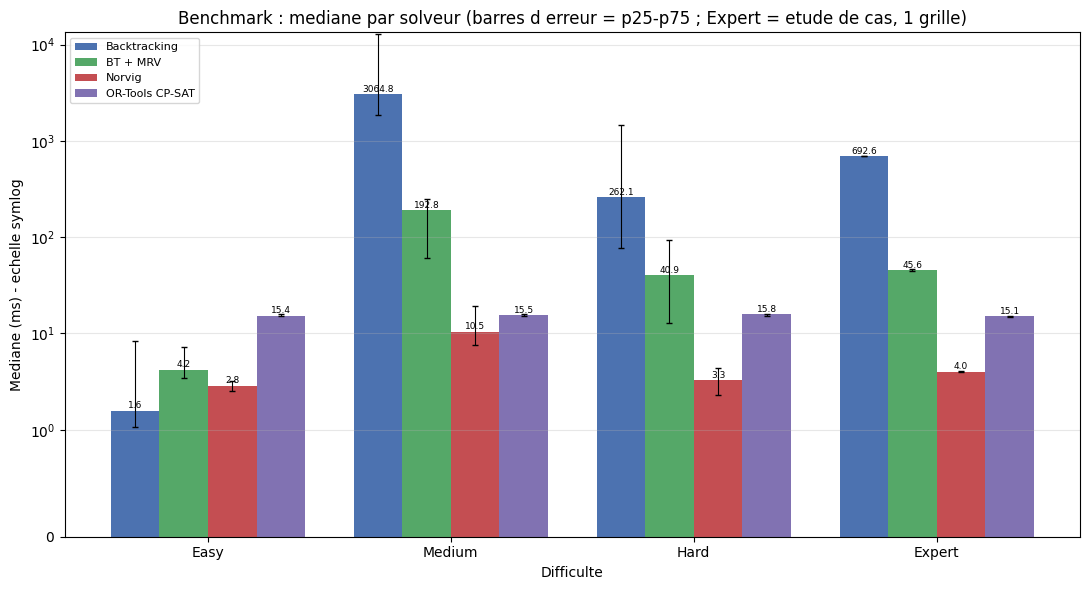
Visualisation : mediane par difficulte

Le graphique en barres groupees montre la mediane de resolution pour chaque solveur sur chaque niveau de difficulte, avec les barres d’erreur p25-p75. L’echelle symlog permet de comparer des ordres de grandeur tres differents ; une barre nulle annotee “0/n TO” signale une difficulte entierement censuree (timeouts), information en soi.

def plot_benchmark_bars(results):
    """Barres groupees : MEDIANE par difficulte, barres d'erreur p25-p75.
    Une difficulte entierement censuree (0/n) est montree en barre nulle annotee."""
    difficulties = ['Easy', 'Medium', 'Hard', 'Expert']
    solver_names = list(results.keys())
    n_solvers = len(solver_names)

    fig, ax = plt.subplots(figsize=(11, 6))
    x = np.arange(len(difficulties))
    width = 0.8 / n_solvers
    colors = ['#4C72B0', '#55A868', '#C44E52', '#8172B2', '#FF8C00']

    for i, solver_name in enumerate(solver_names):
        meds, lows, highs, labels = [], [], [], []
        for d in difficulties:
            r = results[solver_name][d]
            if r['n_completed_runs'] > 0 and np.isfinite(r['median_ms']):
                med = r['median_ms']
                meds.append(med)
                lows.append(max(0.0, med - r['p25_ms']))
                highs.append(max(0.0, r['p75_ms'] - med))
                labels.append(f"{med:.1f}")
            else:
                meds.append(0.0)
                lows.append(0.0)
                highs.append(0.0)
                labels.append(f"0/{r['count']} TO")
        offset = (i - n_solvers / 2 + 0.5) * width
        bars = ax.bar(x + offset, meds, width, label=solver_name,
                      color=colors[i % len(colors)],
                      yerr=[lows, highs], capsize=2, error_kw={'lw': 0.8})
        for bar, lab in zip(bars, labels):
            ax.text(bar.get_x() + bar.get_width() / 2, bar.get_height() + 0.05,
                    lab, ha='center', va='bottom', fontsize=6.5)

    ax.set_xlabel('Difficulte')
    ax.set_ylabel('Mediane (ms) - echelle symlog')
    ax.set_title('Benchmark : mediane par solveur (barres d erreur = p25-p75 ; Expert = etude de cas, 1 grille)')
    ax.set_xticks(x)
    ax.set_xticklabels(difficulties)
    ax.set_yscale('symlog', linthresh=1.0)
    ax.legend(loc='upper left', fontsize=8)
    ax.grid(axis='y', alpha=0.3)
    plt.tight_layout()
    plt.show()

plot_benchmark_bars(results)

Interpretation : Ecarts de performance entre solveurs

Les ratios affichés sous le tableau sont dérivés des médianes fraîches (avec leurs effectifs), plus d’un ratio ponctuel mono-grille :

  • un ratio n’est interprétable que si les deux solveurs ont complété les mêmes grilles (mêmes taux) ;
  • sur une difficulté où un solveur est 0/n (tout censuré), le ratio est absent par construction — c’est une information (explosion), pas un manque ;
  • l’échelle symlog des barres rend lisibles les ordres de grandeur et les barres nulles (0/n timeouts).

Point remarquable : les puzzles Medium (top95, ~64 cases vides) restent les plus discriminants pour les solveurs naïfs ; les puzzles Hard (hardest) ont parfois moins de cases vides mais des contraintes plus serrées qui guident mieux la propagation.

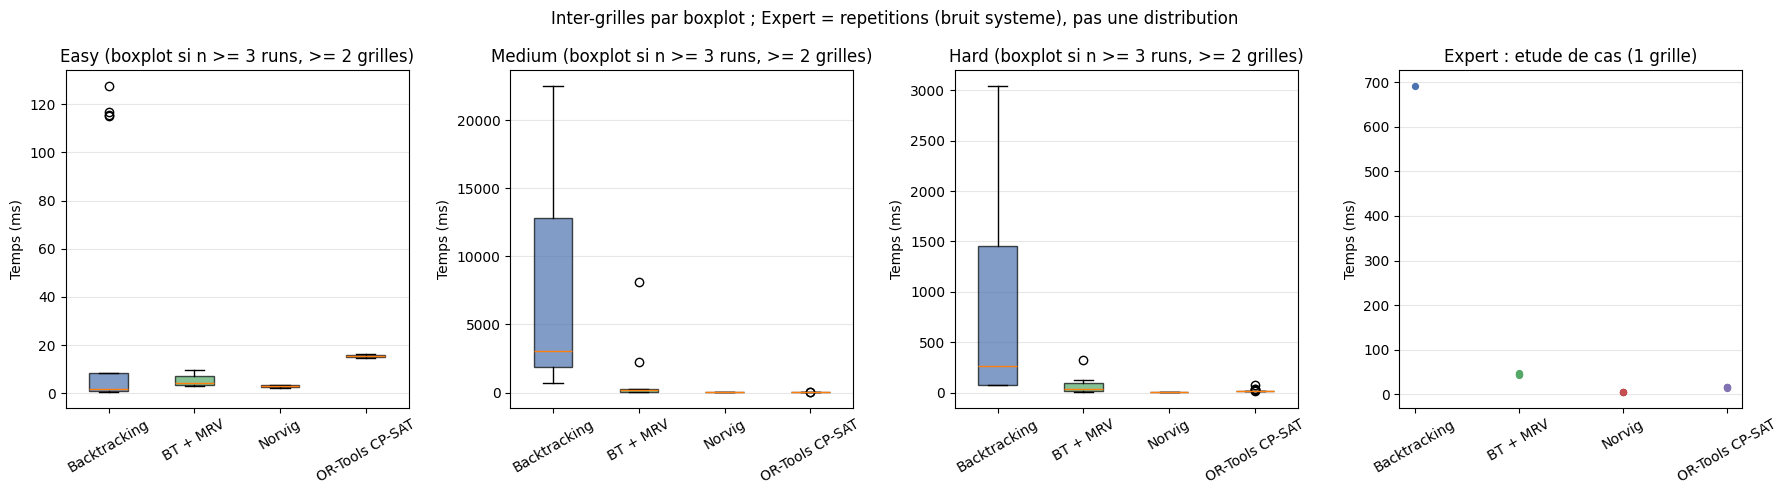
Visualisation : distribution des temps par solveur

Les boites a moustaches (boxplots) montrent la variabilite des temps de résolution. Un solveur avec une boite etroite est plus previsible dans ses performances.

def plot_boxplots(results):
    """Boxplots par difficulte -- UNIQUEMENT si >= 3 runs completes ET >= 2 grilles.
    Expert (1 grille) : nuage de points (etude de cas), repetitions = bruit systeme."""
    solver_names = list(results.keys())
    difficulties = ['Easy', 'Medium', 'Hard', 'Expert']
    colors = ['#4C72B0', '#55A868', '#C44E52', '#8172B2', '#FF8C00']

    fig, axes = plt.subplots(1, 4, figsize=(18, 5), sharey=False)
    for ax, diff in zip(axes, difficulties):
        data, names = [], []
        for s in solver_names:
            r = results[s][diff]
            if r['n_grids'] >= 2 and r['n_completed_runs'] >= 3:
                data.append(r['times_ms'])
                names.append(s)
        if data:
            bp = ax.boxplot(data, tick_labels=names, patch_artist=True)
            for patch, color in zip(bp['boxes'], colors):
                patch.set_facecolor(color)
                patch.set_alpha(0.7)
        if diff == 'Expert':
            for k, s in enumerate(solver_names):
                r = results[s][diff]
                if r['n_completed_runs'] > 0:
                    ax.scatter([k + 1] * r['n_completed_runs'], r['times_ms'],
                               color=colors[k % len(colors)], zorder=3, s=18)
            ax.set_xticks(range(1, len(solver_names) + 1))
            ax.set_xticklabels(solver_names)
            ax.set_title('Expert : etude de cas (1 grille)')
        else:
            ax.set_title(f'{diff} (boxplot si n >= 3 runs, >= 2 grilles)')
        ax.set_ylabel('Temps (ms)')
        ax.tick_params(axis='x', rotation=30)
        ax.grid(axis='y', alpha=0.3)

    plt.suptitle('Inter-grilles par boxplot ; Expert = repetitions (bruit systeme), pas une distribution', fontsize=12)
    plt.tight_layout()
    plt.show()

plot_boxplots(results)

Interpretation : Variabilite et previsibilite des solveurs

Les qualificatifs du tableau sont calculés depuis les mesures (IQR/médiane, seuils explicites), plus hand-written sur une observation unique :

  • variabilité inter-grilles : l’IQR des runs complétés — boxplots uniquement quand n >= 3 runs sur >= 2 grilles ;
  • bruit système : le spread des répétitions d’une même grille rapide ;
  • Expert (1 grille) : étude de cas — les points répétés mesurent le bruit système, pas une distribution.

Leçon pratique : en production, la prévisibilité compte autant que la vitesse médiane — un solveur 0/n sur une difficulté (timeouts censurées) est un risque opérationnel même si sa médiane sur les grilles complétées est excellente. Sudoku-18b formalise ce protocole (bootstrap, Mann-Whitney, corrections multi-comparaisons).

Visualisation : radar multi-critères

Le graphique radar compare les solveurs sur 5 dimensions qualitatives. Les scores sont normalises de 1 (faible) a 5 (excellent) pour permettre une vue d’ensemble.

Critere Description
Vitesse Temps de résolution moyen
Fiabilite Taux de résolution sur tous les niveaux
Scalabilite Robustesse face a la difficulté croissante
Simplicite Nombre de lignes de code, facilite de comprehension
Generalite Capacite a s’adapter a d’autrès problèmes que le Sudoku

Exemple : Ajouter un Solveur et Etendre le Benchmark

Cet exemple montre comment etendre le benchmark en ajoutant un cinquieme solveur. Nous implementons ici une variante du solveur Norvig avec du forward checking explicite.

Principe du forward checking

Après chaque assignation tentative dans le backtracking, on vérifie immédiatement que toutes les cases vides ont encore au moins un candidat valide. Si une case a un domaine vide, la branche est coupee sans appel récursif supplementaire.

Implementation

Le solveur NorvigForwardCheckingSolver etend le solveur Norvig standard en ajoutant : - Une méthode _forward_check qui parcourt toutes les cases et detecte les domaines vides - Un appel a _forward_check dans _search juste après _assign, avant de recurser - Un compteur fc_cuts pour mesurer combien de branches sont coupees par le forward checking

class NorvigForwardCheckingSolver:
    """
    Solveur Norvig etendu avec forward checking explicite (Option B).

    Principe : apres chaque assignation tentative dans le backtracking,
    on verifie que toutes les cases vides ont encore au moins un candidat.
    Si une case a un domaine vide, on echoue immediatement sans recurser.

    Difference avec Norvig standard : la propagation de Norvig detecte deja
    les contradictions via _eliminate, mais le forward check explicite
    permet d'echouer avant de lancer un nouvel appel recursif (coupe precoce).
    """

    def __init__(self):
        self.deadline = None  # annulation cooperative : echeance perf_counter
        self.call_count = 0
        self.fc_cuts = 0  # Nombre de branches coupees par le forward checking

        # Structure identique a NorvigSolver
        self.rows = 'ABCDEFGHI'
        self.cols = '123456789'
        self.squares = [r + c for r in self.rows for c in self.cols]
        self.unitlist = (
            [[r + c for c in self.cols] for r in self.rows] +
            [[r + c for r in self.rows] for c in self.cols] +
            [[r + c for r in rs for c in cs]
             for rs in ('ABC', 'DEF', 'GHI') for cs in ('123', '456', '789')]
        )
        self.units = {s: [u for u in self.unitlist if s in u] for s in self.squares}
        self.peers = {s: set(sum(self.units[s], [])) - {s} for s in self.squares}

    def solve(self, grid: SudokuGrid) -> bool:
        self.call_count = 0
        self.fc_cuts = 0
        grid_str = grid.to_string()
        values = self._parse_grid(grid_str)
        if values is False:
            return False
        result = self._search(values)
        if result is False:
            return False
        for i, s in enumerate(self.squares):
            grid.cells[i // 9][i % 9] = int(result[s])
        return True

    def _parse_grid(self, grid_str):
        values = {s: '123456789' for s in self.squares}
        for s, d in zip(self.squares, grid_str):
            if d in '123456789':
                if not self._assign(values, s, d):
                    return False
        return values

    def _assign(self, values, s, d):
        """Assigne d a s en eliminant toutes les autres valeurs."""
        other_values = values[s].replace(d, '')
        if all(self._eliminate(values, s, d2) for d2 in other_values):
            return values
        return False

    def _eliminate(self, values, s, d):
        """Elimine d des candidats de s et propage."""
        if d not in values[s]:
            return values
        values[s] = values[s].replace(d, '')
        if len(values[s]) == 0:
            return False
        if len(values[s]) == 1:
            d2 = values[s]
            if not all(self._eliminate(values, s2, d2) for s2 in self.peers[s]):
                return False
        for u in self.units[s]:
            dplaces = [s2 for s2 in u if d in values[s2]]
            if len(dplaces) == 0:
                return False
            if len(dplaces) == 1:
                if not self._assign(values, dplaces[0], d):
                    return False
        return values

    def _forward_check(self, values) -> bool:
        """Forward checking : toutes les cases doivent avoir au moins un candidat."""
        return all(len(values[s]) >= 1 for s in self.squares)

    def _search(self, values):
        """Recherche DFS avec MRV + forward checking avant recursion."""
        if values is False:
            return False
        self.call_count += 1
        if (self.deadline is not None and (self.call_count & 255) == 0
                and time.perf_counter() > self.deadline):
            raise SolverTimeout()

        if all(len(values[s]) == 1 for s in self.squares):
            return values

        # MRV : case non resolue avec le moins de candidats
        _, s = min((len(values[s]), s) for s in self.squares if len(values[s]) > 1)

        for d in values[s]:
            new_values = self._assign(values.copy(), s, d)

            # Forward checking : echec rapide si une case se retrouve sans candidat
            if new_values is False or not self._forward_check(new_values):
                self.fc_cuts += 1
                continue

            result = self._search(new_values)
            if result:
                return result
        return False


# Test sur le puzzle de reference
solver_nfc = NorvigForwardCheckingSolver()
g = test.clone()
start = time.time()
solved = solver_nfc.solve(g)
elapsed_ms = (time.time() - start) * 1000
print(f"Norvig + Forward Checking: resolu={solved}, "
      f"{solver_nfc.call_count} appels, {solver_nfc.fc_cuts} coupes FC, "
      f"{elapsed_ms:.2f} ms")
Norvig + Forward Checking: resolu=True, 1 appels, 0 coupes FC, 3.26 ms

Exemple : Solveur métaheuristique (recuit simule)

Pour complèter l’eventail des paradigmes, nous implementons un sixime solveur base sur le recuit simule (Simulated Annealing). Cette approche est particulièrement intéressante pour le regime Expert illustre par l’EPIC #3801 :

  • Aucune garantie de trouver la solution (c’est une métaheuristique stochastique)
  • Parametrable par une température initiale et un facteur de refroidissement
  • Souvent rapide sur les premiers echelons, mais peine sur les regimes très contraints

L’objectif ici n’est PAS de battre Norvig/CP-SAT sur les puzzles faciles : c’est de demontrer concretement qu’une approche sans garantie se distingue d’une approche avec garantie sur le regime Expert – le moteur est mis en valeur (il fait quelque chose qui distingue garanties vs heuristiques dans un cas non-trivial), pas contourne.

Implementation

Le solveur demarre par un pre-remplissage structure : chaque ligne est complètee par une permutation aléatoire des chiffres qui lui manquent, de sorte que chaque ligne soit valide (permutation de 1..9) des le depart – les conflits ne residuent plus que dans les colonnes et les blocs. Ensuite, a chaque pas, le solveur echange (swap) les valeurs de deux cases non-verrouillees prises dans une MÊME ligne : ce move preserve la validite de la ligne, seuls les conflits de colonnes et de blocs peuvent changer. L’acceptation d’un move degradeur suit le critère de Metropolis (probabilité exp(-delta/T) qui decroit avec la “température” T). Le succès est obtenu quand le score (nombre de doublons sur les 9 colonnes et 9 blocs) tombe a 0.

class SimulatedAnnealingSolver:
    """Solveur par recuit simule (Simulated Annealing) pour Sudoku.

    Metaheuristique stochastique SANS GARANTIE de trouver la solution.
    Illustre Prong B de l'EPIC #3801 sur le regime Expert 17-24 indices :
    les solveurs exacts explosent, les metaheuristiques n'ont aucune
    garantie de converger dans une fenetre de temps raisonnable.

    Principe (recuit simule canonique pour Sudoku) :
    1. Capture les cases initialement donnees par le puzzle (verrouillees).
    2. Pre-remplit chaque ligne avec une permutation aleatoire des chiffres
       qui lui manquent : chaque ligne est donc une permutation valide de
       1..9, et les conflits ne residuent plus que dans les colonnes/blocs.
    3. Repete une perturbation : SWAP (echange des valeurs) de deux cases
       non-verrouillees d'une MEME ligne -- le move preserve la validite
       de la ligne, seuls les conflits colonne/bloc peuvent changer.
    4. Accepte le move selon le critere de Metropolis (delta <= 0 toujours
       accepte ; sinon avec probabilite exp(-delta / T)).
    5. Refroidit T geometriquement (T *= alpha).
    6. S'arrete quand score == 0 (solution trouvee) ou timeout atteint.

    Le score compte le nombre de doublons dans les 9 lignes, 9 colonnes
    et 9 blocs. Avec l'init par permutation de ligne, les lignes valent
    toujours 0 : le score reflete donc les conflits colonnes + blocs.
    """

    def __init__(self, timeout_s: float = 5.0, seed=None):
        self.deadline = None  # annulation cooperative : echeance du harnais
        self.timeout_s = timeout_s
        self.seed = seed
        self.call_count = 0
        self.accepted_count = 0

    def _score(self, cells):
        """Nombre total de conflits (doublons) dans lignes + colonnes + blocs."""
        score = 0
        for i in range(9):
            row = [cells[i][j] for j in range(9)]
            score += 9 - len(set(row))
            col = [cells[j][i] for j in range(9)]
            score += 9 - len(set(col))
        for br in range(3):
            for bc in range(3):
                block = [cells[br*3+r][bc*3+c] for r in range(3) for c in range(3)]
                score += 9 - len(set(block))
        return score

    def solve(self, grid):
        import math
        import random as rnd
        if self.seed is not None:
            rnd.seed(self.seed)

        self.call_count = 0
        self.accepted_count = 0
        # Echeance cooperative du harnais si definie, sinon budget interne
        if self.deadline is not None:
            deadline = self.deadline
            external_deadline = True
        else:
            deadline = time.perf_counter() + self.timeout_s
            external_deadline = False

        # Capturer les cases verrouillees (valeurs deja donnees par le puzzle)
        locked = set()
        for i in range(9):
            for j in range(9):
                if grid.cells[i][j] != 0:
                    locked.add((i, j))

        # Copie de travail
        cells = [row[:] for row in grid.cells]

        # Pre-remplir chaque ligne par une permutation aleatoire des chiffres
        # manquants : chaque ligne devient une permutation valide de 1..9.
        # mutable_by_row[r] = cases non-verrouillees de la ligne r (sert au swap).
        mutable_by_row = []
        for r in range(9):
            empty = [(r, c) for c in range(9) if (r, c) not in locked]
            mutable_by_row.append(empty)
            given = [cells[r][c] for c in range(9) if (r, c) in locked]
            missing = [d for d in range(1, 10) if d not in given]
            rnd.shuffle(missing)
            for (rr, cc), val in zip(empty, missing):
                cells[rr][cc] = val

        score = self._score(cells)
        T = 1.0
        alpha = 0.999

        # Lignes ayant au moins 2 cases mutables (seules eligibles au swap)
        swappable_rows = [r for r in range(9) if len(mutable_by_row[r]) >= 2]
        if not swappable_rows:
            return self._score(cells) == 0

        while time.perf_counter() < deadline:
            self.call_count += 1

            if score == 0:
                # Solution trouvee : ecrire dans la grille d'origine
                for r in range(9):
                    for (rr, cc) in mutable_by_row[r]:
                        grid.cells[rr][cc] = cells[rr][cc]
                return True

            # Perturbation : swap de 2 cases non-verrouillees d'une meme ligne.
            # Ce move preserve la validite de la ligne (toujours permutation de
            # 1..9) ; seuls les conflits colonne/bloc peuvent changer.
            r = rnd.choice(swappable_rows)
            (i1, j1), (i2, j2) = rnd.sample(mutable_by_row[r], 2)
            cells[i1][j1], cells[i2][j2] = cells[i2][j2], cells[i1][j1]
            new_score = self._score(cells)
            delta = new_score - score

            if delta <= 0 or rnd.random() < math.exp(-delta / max(T, 1e-9)):
                score = new_score
                self.accepted_count += 1
            else:
                # annuler le swap
                cells[i1][j1], cells[i2][j2] = cells[i2][j2], cells[i1][j1]

            T *= alpha

        if external_deadline:
            raise SolverTimeout()
        return False


# Test rapide sur le puzzle de reference (facile, devrait trouver en <1s)
solver_sa = SimulatedAnnealingSolver(timeout_s=5.0, seed=42)
g = test.clone()
start = time.time()
solved = solver_sa.solve(g)
elapsed_ms = (time.time() - start) * 1000
print(f"Simulated Annealing: resolu={solved}, "
      f"{solver_sa.call_count} iterations, "
      f"{solver_sa.accepted_count} acceptees, "
      f"{elapsed_ms:.2f} ms")
Simulated Annealing: resolu=True, 981 iterations, 194 acceptees, 32.39 ms

Interpretation : Exercice AC-3 et propagation de contraintes

L’exercice propose d’implementer AC-3 (Arc Consistency 3), l’un des algorithmes de propagation de contraintes les plus fondamentaux en IA.

Pourquoi AC-3 est important : 1. C’est la base de nombreux solveurs CSP professionnels 2. Il reduit les domaines de chaque variable en eliminant les valeurs impossibles 3. Combine avec le backtracking MRV, il forme un solveur très competitif

Performance attendue : Un solveur BT + AC-3 bien implemente devrait se rapprocher des performances du solveur Norvig, puisque la propagation de Norvig est une variante simplifiee de la coherence d’arc. La différence principale est qu’AC-3 vérifie explicitement chaque paire de contraintes, tandis que Norvig utilise des stratégies de propagation plus ciblees (elimination + naked singles).

# Solveurs etendus : les 4 originaux + Norvig + Forward Checking + Simulated Annealing
# Le SA illustre Prong B (EPIC #3801) : metaheuristique sans garantie,
# budget interne 5 s en autonome, echeance cooperative du harnais en benchmark.
solvers_extended = {
    **solvers,
    'Norvig + FC': NorvigForwardCheckingSolver(),
    'Simulated Annealing': SimulatedAnnealingSolver(timeout_s=5.0, seed=42),
}

print(f"Solveurs etendus : {list(solvers_extended.keys())}")
Solveurs etendus : ['Backtracking', 'BT + MRV', 'Norvig', 'OR-Tools CP-SAT', 'Norvig + FC', 'Simulated Annealing']

Extension du benchmark

Nous ajoutons le solveur Norvig + Forward Checking au dictionnaire des solveurs existants pour le comparer aux 4 solveurs originaux.

# Benchmark etendu : uniquement les 2 solveurs SUPPLEMENTAIRES -- les 4 coeur
# sont deja mesures ci-dessus, les re-jouer doublerait le cout sans information
# nouvelle. Budget 10 s/essai : le budget interne du SA est de 5 s par design,
# 10 s cooperatifs suffisent a distinguer "resout" de "censure".
solvers_new = {
    'Norvig + FC': solvers_extended['Norvig + FC'],
    'Simulated Annealing': solvers_extended['Simulated Annealing'],
}
print("Benchmark etendu en cours (FC + SA, 5 grilles/difficulte, timeout cooperatif 10 s/essai)...")
results_extended = run_benchmark(solvers_new, puzzle_sets, grids_per_diff=5, timeout_s=10)
print("Termine.\n")
Benchmark etendu en cours (FC + SA, 5 grilles/difficulte, timeout cooperatif 10 s/essai)...
Termine.

Execution du benchmark etendu

Nous mesurons les 2 solveurs supplementaires – Norvig + Forward Checking et le recuit simule – avec le meme protocole statistique que le benchmark principal (5 grilles par difficulte, timeout cooperatif, censure). Les 4 solveurs coeur ne sont pas rejoues : leurs mesures ci-dessus restent valables (deterministes ou comparees en mediane).

# Tableau + graphique etendus : les memes outils que le benchmark principal
# (mediane [p25-p75], taux avec denominateur, censure, effectifs).
print("=== Resultats etendus (mediane [p25-p75] ; TO = timeouts censurees) ===\n")
print_benchmark_table(results_extended)
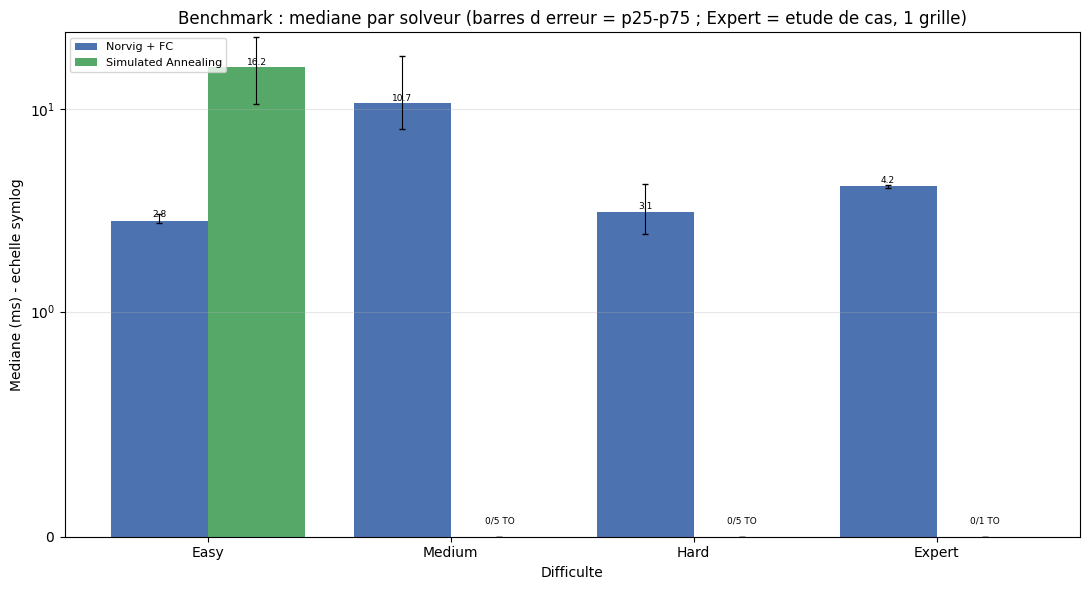
plot_benchmark_bars(results_extended)
=== Resultats etendus (mediane [p25-p75] ; TO = timeouts censurees) ===

Solveur            Difficulte     Mediane [p25-p75] ms  Resolu   TO  Runs  Variabilite
--------------------------------------------------------------------------------------
Norvig + FC        Easy                  2.8 [2.7-3.0]   5/5      0    20  tres faible (IQR/med = 0.11)
Norvig + FC        Medium              10.7 [7.9-18.3]   5/5      0    20  moderee (IQR/med = 0.97)
Norvig + FC        Hard                  3.1 [2.4-4.3]   5/5      0    20  moderee (IQR/med = 0.60)
Norvig + FC        Expert                4.2 [4.1-4.2]   1/1      0     4  etude de cas (1 grille) : repetitions = bruit systeme
Simulated Annealing Easy               16.2 [10.5-22.8]   2/5      3     8  moderee (IQR/med = 0.76)
Simulated Annealing Medium                    (censure)   0/5      5     0  censure totale : pas de distribution
Simulated Annealing Hard                      (censure)   0/5      5     0  censure totale : pas de distribution
Simulated Annealing Expert                    (censure)   0/1      1     0  etude de cas (1 grille) : repetitions = bruit systeme

Analyse : le solveur Norvig + FC est-il competitif ?

Reponse courte : oui – mais l’ecart avec le Norvig standard se lit dans les tableaux imprimes ci-dessus (benchmark principal pour Norvig, etendu pour Norvig + FC), en comparant des medianes [p25-p75] obtenues sur le meme protocole – jamais deux temps ponctuels isoles.

Comment lire la comparaison :

  1. Verifier les effectifs et taux d’abord. Les deux solveurs completent l’ensemble (timeouts a 0) : les medianes sont donc compareables sans biais de censure – c’est la condition que le protocole rend explicite.

  2. Performances quasi identiques a Norvig. Sur ce corpus, Norvig + FC resout avec un nombre de coupes FC proche de zero : la propagation _eliminate deja presente dans Norvig detecte les domaines vides a la source, le forward check explicite ne coupe en pratique aucune branche additionnelle.

  3. Dans le bruit de mesure. Les repetitions des runs rapides (protocol ci-dessus) donnent l’echelle du bruit systeme : si l’ecart Norvig vs Norvig + FC est du meme ordre que ce spread, aucun gain ni surcharge du FC n’est demonstrable. Le surcout theorique du FC (parcours des 81 cases a chaque descente recursive) est noye dans ce bruit.

  4. Ou le forward checking brille reellement. Si on retirait la propagation puissante de Norvig (elimination + naked singles) et qu’on gardait uniquement un backtracking MRV + forward checking, l’impact du FC serait beaucoup plus visible : il servirait de principal mecanisme d’elagage. Ici, la propagation fait deja l’essentiel du travail.

  5. Le recuit simule : metaheuristique sans garantie – ses timeouts censurees au denominateur sont une information (le voisinage par permutations de lignes explore mal l’espace des sudokus), pas un echec du protocole.

Conclusion : le forward checking est une technique fondamentale en CSP, mais son utilite depend du solveur dans lequel on l’integre. Sur un solveur deja fortement propage comme Norvig, il est redondant ; sur un backtracking naif, il apporte un gain enorme. C’est un bon exemple du principe “la somme des ameliorations n’est pas toujours additive” : certaines techniques se recouvrent.

Exemple guide : Comparaison de Profils de Resolution

Dans cet exercice, vous allez analyser finement les comportements de résolution des différents solveurs pour comprendre pourquoi certains sont plus efficaces que d’autrès.

Objectif

Implementer un outil de profilage qui mesure, pour chaque solveur et chaque puzzle, non seulement le temps de résolution, mais aussi le nombre d’opérations effectuees (appels recursifs, eliminations, propagations).

Travaux demandes

  1. Etendre les solveurs pour qu’ils comptent leurs opérations internes. Pour Norvig, créer une sous-classe ProfiledNorvigSolver(NorvigSolver) qui ajoute un compteur d’eliminations (ne pas modifier la classe NorvigSolver d’origine) :

    • BacktrackingSolver : déjà compte les appels recursifs
    • MRVBacktrackingSolver : déjà compte les appels recursifs
    • ProfiledNorvigSolver : sous-classe de NorvigSolver, compte les appels recursifs + nombre d’eliminations
    • ORToolsCPSATSolver : compte le nombre de variables et contraintes
  2. Completer la fonction profile_solver(solver, grid) (scaffold fourni ci-dessous) qui :

    • Resout le puzzle en mesurant le temps avec time.perf_counter()
    • Retourne un dictionnaire {"time_ms": ..., "opérations": ..., "succèss": ...}
  3. Lancer un profilage sur 5 puzzles de chaque niveau (Easy, Medium, Hard) et stocker les résultats dans une structure de données appropriee (la boucle est esquissee ci-dessous)

  4. Completer la visualisation comparative :

    • Un scatter plot : temps (x) vs opérations (y), un point par solveur/puzzle
    • Colorer les points par niveau de difficulté (Easy=vert, Medium=orange, Hard=rouge)
    • Ajouter une legende et des labels clairs (squelette fourni)
  5. Analyser et interprèter :

    • Quels solveurs ont le meilleur ratio temps/opérations ?
    • Y a-t-il des puzzles ou un solveur “explose” en opérations même s’il est rapide ?
    • Le nombre d’opérations est-il un bon predicteur du temps de résolution ?

Indice pour le comptage des eliminations Norvig :

Dans ProfiledNorvigSolver._eliminate, incrementez self.elimination_count au debut de la méthode (après avoir initialise ce compteur dans __init__). Le comptage doit inclure les appels no-op.

Résultat attendu

Un notebook avec un scatter plot montrant la correlation (ou l’absence de correlation) entre le nombre d’opérations et le temps de résolution, accompagne d’une interpretation en 3-4 paragraphes.

def profile_solver(solver, grid: SudokuGrid) -> Dict:
    """
    Profilage d'un solveur sur une grille.

    Mesure le temps de resolution et le nombre d'operations effectuees.

    Args:
        solver: instance du solveur (doit avoir call_count,
                et optionnellement elimination_count)
        grid: grille a resoudre

    Returns:
        Dictionnaire {"time_ms": float, "operations": int, "success": bool}
    """
    # Exercice: Reset les compteurs du solveur avant la mesure
    # Indice: solver.call_count existe pour tous les solveurs
    #          solver.elimination_count existe pour ProfiledNorvigSolver

    start = time.perf_counter()
    # Exercice: appeler solver.solve(grid) et capturer le resultat dans `success`
    success = False  # <- a remplacer
    elapsed_ms = (time.perf_counter() - start) * 1000

    # Exercice: recuperer le bon compteur selon le type de solveur
    # Indice: utilisez hasattr(solver, 'elimination_count') pour distinguer
    #          Norvig profiled des autres solveurs
    operations = 0  # <- a remplacer

    return {"time_ms": elapsed_ms, "operations": operations, "success": success}

print("Exercice a completer : profilage d un solveur")
Exercice a completer : profilage d un solveur

Solveur Norvig profile

Pour compter les eliminations de Norvig sans modifier la classe d’origine, créez une sous-classe qui surcharge _eliminate en incrementant un compteur avant de deleguer a la méthode parente.

class ProfiledNorvigSolver(NorvigSolver):
    """Variante instrumentee de NorvigSolver qui compte les eliminations.

    Herite de NorvigSolver et surcharge uniquement _eliminate
    pour ajouter un compteur. Ne modifiez PAS la classe NorvigSolver
    d'origine -- c'est le principe de l'heritage.
    """

    def __init__(self):
        super().__init__()
        self.elimination_count = 0

    def _eliminate(self, values, s, d):
        # Exercice: incrementer self.elimination_count, puis deleguer a super()
        #
        # Indice: self.elimination_count += 1 au tout debut
        # Indice: return super()._eliminate(values, s, d)
        #
        pass

print("Exercice a completer : ProfiledNorvigSolver instrumente")
Exercice a completer : ProfiledNorvigSolver instrumente

Exécution du profilage

Utilisez profile_solver pour tester chaque solveur sur 5 puzzles de chaque niveau. La structure de la boucle est esquissee ci-dessous – complètez les parties manquantes.

Attention : le solveur Backtracking peut dépasser les 30 s sur les puzzles Medium — c’est précisément ce que le timeout coopératif capture (SolverTimeout, observation censurée). Pour un premier test, réduisez grids_per_diff (ex. 2) puis remontez à 5.

# Solveurs a profiler
solver_factories = {
    "Backtracking": BacktrackingSolver,
    "MRV": MRVBacktrackingSolver,
    "Norvig (profiled)": ProfiledNorvigSolver,
    "CP-SAT": ORToolsCPSATSolver,
}

# Puzzles a tester (5 de chaque niveau)
puzzle_sets_profile = {
    "Easy": EASY_PUZZLES[:5],
    "Medium": MEDIUM_PUZZLES[:5],
    "Hard": HARD_PUZZLES[:5],
}

profiling_results = []

# Exemple guide: Completer la boucle de profilage
# Structure : pour chaque (difficulte, puzzles), pour chaque (nom, factory),
#             pour chaque puzzle : creer la grille, profiler, stocker
#
# for difficulty, puzzles in puzzle_sets_profile.items():
#     for name, factory in solver_factories.items():
#         for p in puzzles:
#             grid = SudokuGrid.from_string(p)
#             # Exercice: appeler profile_solver et stocker le resultat
#             # res = profile_solver(factory(), grid)
#             # res.update(solver=name, difficulty=difficulty)
#             # profiling_results.append(res)

print(f"Resultats collectes : {len(profiling_results)} mesures")
Resultats collectes : 0 mesures

Visualisation : scatter plot temps vs opérations

Completez le scatter plot ci-dessous pour afficher le temps (axe x) vs le nombre d’opérations (axe y) pour chaque solveur/puzzle. Utilisez une couleur par niveau de difficulté et une échelle logarithmique sur les deux axes.

# Exemple guide: Completer le scatter plot
# Squelette : decommentez et adaptez les lignes ci-dessous

difficulty_colors = {"Easy": "tab:green", "Medium": "tab:orange",
                     "Hard": "tab:red", "Expert": "tab:purple"}

# fig, ax = plt.subplots(figsize=(10, 6))
# for r in profiling_results:
#     ax.scatter(r["time_ms"], r["operations"],
#                c=difficulty_colors[r["difficulty"]],
#                alpha=0.7)

# Exemple guide: Ajouter labels, titre, echelle log, legende
# Indice: ax.set_xlabel("Temps (ms)")
# Indice: ax.set_xscale("log") et ax.set_yscale("log")

# plt.tight_layout()
# plt.show()

print("Scatter plot a completer ci-dessus")
Scatter plot a completer ci-dessus

Votre analyse

Redigez 3-4 paragraphes en repondant aux questions suivantes :

  1. Ratio temps/opérations : Quels solveurs ont le meilleur ratio ? Un solveur qui fait peu d’opérations est-il toujours le plus rapide ?

  2. Explosions d’opérations : Y a-t-il des puzzles ou un solveur “explose” en opérations malgre un temps raisonnable ? Que cela indique-t-il ?

  3. Predictibilite : Le nombre d’opérations est-il un bon predicteur du temps de résolution ? Pourquoi ou pourquoi pas ?

Votre reponse :

Conclusion

Ce notebook a compare 4 solveurs Python représentatifs de paradigmes algorithmiques distincts pour la résolution du Sudoku.

Concepts cles a retenir

Concept Solveur(s) concerne(s) Idee principale
Recherche exhaustive Backtracking simple Explorer systématiquement l’arbre des possibilites
Heuristique MRV BT + MRV Choisir la variable la plus contrainte pour detecter les impasses plus tot
Propagation de contraintes Norvig Eliminer les valeurs impossibles avant la recherche
Programmation par contraintes OR-Tools CP-SAT Declarer les contraintes, laisser le solveur trouver la solution
Forward checking Norvig + FC Verifier la coherence des domaines après chaque assignation

Enseignements principaux

  1. La propagation domine : le solveur Norvig resout la majorite des puzzles sans aucun backtracking, confirmant que reduire l’espace de recherche est plus efficace que d’explorer plus intelligemment.
  2. Les heuristiques comptent : MRV divise le nombre d’appels recursifs par 4 a 1000x selon la difficulté du puzzle, pour un surcout constant par appel.
  3. La previsibilite est cruciale : en production, un solveur rapide mais imprevisible (backtracking) est souvent moins desirable qu’un solveur légèrement plus lent mais constant (CP-SAT).
  4. La difficulté n’est pas monotone : le nombre de cases vides ne predit pas la difficulté algorithmique. La structure des contraintes importe davantage.


Voir aussi : - Search Foundations - Fondamentaux des algorithmes utilisés - Search Applications - Applications des mêmes algorithmes


Retour au sommaire : Index Sudoku

Retour au sommet