Search-11c — Sélection empirique d’algorithmes : deux terrains — Sudoku et Puissance 4

Série : Search / Part1-Foundations (11c — sélection empirique)

Durée estimée : ~1h30 (lecture + exécution)

Prérequis : notions de recherche heuristique et métaheuristique (cf. Search-11, Search-11b), compréhension du problème Sudoku (9x9, 81 cases, 4 contraintes : ligne/colonne/bloc/somme implicite). Familiarité avec CP-SAT et Z3 conseillée.

Kernel : python3 (OR-Tools + z3-solver + pandas + matplotlib)


Objectifs

  • Comprendre le problème de sélection d’algorithmes (Rice 1976) : étant donné un problème, comment choisir le paradigme de résolution le mieux adapté ?
  • Découvrir empiriquement le principe “No Free Lunch” (Wolpert 1996) : aucun algorithme ne domine tous les autres sur toutes les instances.
  • Comparer 6 paradigmes de résolution de Sudoku sur 30 instances (3 niveaux de difficulté) :
    1. Backtracking naïf
    2. Backtracking + heuristique MRV
    3. Dancing Links (Algorithm X de Knuth)
    4. Algorithme génétique
    5. Recuit simulé
    6. Programmation par contraintes (CP-SAT, OR-Tools)
    7. SMT (Z3)
  • Visualiser le front de Pareto (temps vs. qualité) et identifier le gagnant selon le budget temps ou la difficulté de l’instance.

Sources et attributions

Ce notebook est une distillation pédagogique d’un projet de L4 EPITA SCIA 2026 (Intelligence Symbolique), auteur Théodore Deguest, dépôt L4-Benchmark-Cross-Paradigm, licence MIT. Les 6 solveurs Sudoku et leur harnais de benchmark sont reproduits verbatim depuis la PR source du projet étudiant (PR #42, dépôt privé EPITA — convention de distillation : citer l’auteur, lier la PR, expliciter le périmètre).

Note sur la distillation : ce notebook ne reproduit que la tranche 1/3 (Sudoku). Les tranches Puissance 4 (minimax/alpha-beta/MCTS) et Wordle (élimination bayésienne/entropie/CSP) sont en chantier dans le projet étudiant et seront distillées dans des notebooks ultérieurs. Citer le projet pour le périmètre complet.

1. Pourquoi la sélection d’algorithmes est-elle un problème difficile ?

1.1 Le théorème “No Free Lunch” (Wolpert 1996)

En 1996, David Wolpert démontre un résultat contre-intuitif : moyennée sur tous les problèmes possibles, toute paire d’algorithmes a la même performance moyenne. Ce qui signifie qu’aucun algorithme n’est universellement meilleur qu’un autre — un algorithme excellent sur une classe de problèmes sera médiocre sur une autre.

Conséquence pratique : pour un problème donné (ici, Sudoku 9x9), la question pertinente n’est pas “quel est le meilleur algorithme en général ?” mais “quel algorithme performe le mieux sur mon problème, avec mon budget, sur mes instances ?”.

C’est précisément l’objet du sélection empirique d’algorithmes (Empirical Algorithm Selection) : comparer expérimentalement plusieurs candidats sur un échantillon représentatif d’instances, mesurer des compromis (temps, mémoire, qualité), puis statuer localement.

1.2 Le modèle de Rice (1976)

John Rice formalise en 1976 le problème de sélection d’algorithmes :

  • Espace des problèmes P : l’ensemble des instances possibles (ici : grilles Sudoku).
  • Espace des algorithmes A : les candidats (backtracking, DLX, GA, SA, CP-SAT, Z3).
  • Fonction de performance y(P, A) : la mesure (temps, qualité) sur une instance.
  • Fonction de sélection S : qui choisit l’algorithme.

Le cadre PASE (Problem Algorithm Selector Extractor) ajoute un extracteur de caractéristiques (features) sur les instances — ici : nombre de cases vides, difficulté (easy/medium_hard/diabolical), entropie des candidats par case, etc. — pour prédire quel algorithme choisir sans évaluer tous les candidats sur chaque instance (coût prohibitif).

1.3 Le compromis temps / qualité

Pour beaucoup de métaheuristiques (GA, recuit simulé), on peut interrompre la recherche avant convergence et obtenir une solution approchée (qualité < 100 %). Le solveur exact (backtracking+MRV, DLX, CP-SAT, Z3), lui, promet la solution optimale mais peut exploser en temps sur des instances difficiles.

Question de sélection : “Sur une grille ‘diabolical’, avec un budget de 2 secondes, quel paradigme choisir ?”

  • Si le solveur exact trouve en < 2s → il gagne (qualité 100 %).
  • Sinon, le GA avec 2s a probablement convergé → qualité ≈ 90-100 %.
  • Le recuit simulé avec 2s a peut-être stagné → qualité variable.

La réponse dépend de l’instance, pas seulement du paradigme : c’est la leçon du No Free Lunch appliquée à un cadre concret.

1.4 Visualisation : le front de Pareto

Quand on a deux objectifs contradictoires (ici : minimiser le temps et maximiser la qualité), un algorithme A domine un algorithme B si A est au moins aussi bon partout et strictement meilleur quelque part. Les algorithmes non dominés forment le front de Pareto : impossible d’en améliorer un sans en dégrader un autre.

On tracera ce front à la fin du notebook pour identifier les “gagnants” selon la métrique prioritaire.

2. Protocole commun : mesure, timeouts, budget

Pour comparer 6 paradigmes sur un terrain commun, on définit un protocole de benchmark uniforme :

  1. Échantillon d’instances : 10 grilles par niveau de difficulté (easy / medium_hard / diabolical), soit 30 instances au total.
  2. Mesures par solveur × instance :
    • success : booléen (le solveur a-t-il trouvé une solution valide ?)
    • time_seconds : temps d’exécution (borné par un timeout)
    • nodes_explored : compteur dont la sémantique varie par paradigme (cf. tableau ci-dessous)
    • solution_quality : 0.0 à 1.0 (1.0 = solution parfaite, pour GA/recuit)
  3. Budget : chaque appel solveur(instance) est limité à un timeout (par défaut 5 secondes pour ce notebook).
  4. Budget en noeuds : backtracking a un budget max de noeuds pour éviter l’explosion combinatoire.

Note importante : la notion de “noeud exploré” n’est pas la même pour tous les paradigmes :

Paradigme Définition de “noeud exploré”
Backtracking (±MRV) une affectation (case, valeur) testée
Dancing Links un choix de ligne (case, valeur) dans la recherche d’exact cover
CP-SAT (OR-Tools) une décision prise par le solveur (variable fixée)
SMT (Z3) une décision SMT (statistics()["decisions"])
Algorithme génétique une évaluation de fitness (un individu évalué)
Recuit simulé un swap testé (calcul de coût Δ)

Cette définition est propre à chaque paradigme : comparer des noeuds entre paradigmes n’a pas de sens strict, mais c’est utile pour comparer deux variantes du même paradigme.

2.1 Imports et configuration

import json
import math
import random
import sys
import time
import warnings
from contextlib import contextmanager
from dataclasses import dataclass, field, asdict
from pathlib import Path
from typing import Any, Callable, Iterable

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

warnings.filterwarnings("ignore", category=DeprecationWarning)

# Dependances specifiques solveurs
from ortools.sat.python import cp_model
import z3

# Version checks (cf. SOTA-OK: vrai outil, pas workaround degrade)
import ortools
print(f"ortools       : {ortools.__version__}")
print(f"z3-solver     : import OK (module {z3.__file__.split(chr(92))[-1]})")
print(f"pandas        : {pd.__version__}")
print(f"numpy         : {np.__version__}")
print(f"matplotlib    : {plt.matplotlib.__version__}")
print(f"kernel Python : {sys.version.split()[0]}")
ortools       : 9.15.6755
z3-solver     : import OK (module __init__.py)
pandas        : 3.0.5
numpy         : 2.4.6
matplotlib    : 3.11.1
kernel Python : 3.13.15

3. Représentation et données Sudoku

3.1 La classe SudokuGrid

On définit une représentation simple : grille 9x9 de cases (0 = vide, 1-9 = chiffre fixé). Les helpers :

  • is_valid_placement(r, c, n) : la valeur n peut-elle être placée en (r, c) sans violer ligne/colonne/bloc ?
  • find_empty() / find_empty_mrv() : la prochaine case à remplir (naïf ou MRV).
  • is_solved() : la grille est-elle complète ET valide ?
  • clone() : copie profonde (les solveurs ne doivent pas muter l’instance).
class SudokuGrid:
    """Representation d'une grille de Sudoku 9x9."""

    def __init__(self, grid=None):
        if grid is None:
            self.cells = [[0] * 9 for _ in range(9)]
        else:
            self.cells = [row[:] for row in grid]

    @classmethod
    def from_string(cls, s: str):
        s = s.replace(".", "0").replace(" ", "").replace("\n", "")
        if len(s) != 81:
            raise ValueError(f"La chaine doit avoir 81 caracteres, recu {len(s)}")
        g = cls()
        for i in range(81):
            g.cells[i // 9][i % 9] = int(s[i])
        return g

    def clone(self):
        return SudokuGrid(self.cells)

    def is_valid_placement(self, row: int, col: int, num: int) -> bool:
        if num in self.cells[row]:
            return False
        if num in [self.cells[r][col] for r in range(9)]:
            return False
        box_row, box_col = 3 * (row // 3), 3 * (col // 3)
        for r in range(box_row, box_row + 3):
            for c in range(box_col, box_col + 3):
                if self.cells[r][c] == num:
                    return False
        return True

    def find_empty(self):
        for r in range(9):
            for c in range(9):
                if self.cells[r][c] == 0:
                    return (r, c)
        return None

    def find_empty_mrv(self):
        """Cellule vide avec le moins de candidats possibles (Minimum Remaining Values)."""
        best = None
        best_count = 10
        for r in range(9):
            for c in range(9):
                if self.cells[r][c] != 0:
                    continue
                count = sum(1 for n in range(1, 10) if self.is_valid_placement(r, c, n))
                if count < best_count:
                    best, best_count = (r, c), count
                    if count == 0:
                        return best
        return best

    def is_complete(self) -> bool:
        return all(self.cells[r][c] != 0 for r in range(9) for c in range(9))

    def is_solved(self) -> bool:
        if not self.is_complete():
            return False
        digits = set(range(1, 10))
        for r in range(9):
            if set(self.cells[r]) != digits:
                return False
        for c in range(9):
            if {self.cells[r][c] for r in range(9)} != digits:
                return False
        for box_row in range(0, 9, 3):
            for box_col in range(0, 9, 3):
                box = {self.cells[r][c]
                       for r in range(box_row, box_row + 3)
                       for c in range(box_col, box_col + 3)}
                if box != digits:
                    return False
        return True

    def count_empty(self) -> int:
        return sum(1 for r in range(9) for c in range(9) if self.cells[r][c] == 0)

    def __str__(self):
        lines = []
        for r in range(9):
            if r > 0 and r % 3 == 0:
                lines.append("-" * 21)
            row_str = ""
            for c in range(9):
                if c > 0 and c % 3 == 0:
                    row_str += "| "
                v = self.cells[r][c]
                row_str += (str(v) if v != 0 else ".") + " "
            lines.append(row_str)
        return "\n".join(lines)


# Demonstration : une grille easy
EXEMPLE = "530070000600195000098000060800060003400803001700020006060000280000419005000080079"
g = SudokuGrid.from_string(EXEMPLE)
print("Grille easy (50 cases vides sur 81) :")
print(g)
print(f"\nNombre de cases vides : {g.count_empty()}")
Grille easy (50 cases vides sur 81) :
5 3 . | . 7 . | . . . 
6 . . | 1 9 5 | . . . 
. 9 8 | . . . | . 6 . 
---------------------
8 . . | . 6 . | . . 3 
4 . . | 8 . 3 | . . 1 
7 . . | . 2 . | . . 6 
---------------------
. 6 . | . . . | 2 8 . 
. . . | 4 1 9 | . . 5 
. . . | . 8 . | . 7 9 

Nombre de cases vides : 51

Lecture — la representation choisit deja une famille d’algorithmes

SudokuGrid stocke 81 entiers (0 = vide), from_string normalise . et espaces vers 0, et le constructeur par copie (row[:]) isole chaque instance des mutations du solveur — trois petits choix qui conditionnent tout le reste : les solveurs exacts (backtracking, DLX, CP-SAT, Z3) liront la grille comme des CONTRAINTES, les metaheuristiques (GA, recuit) comme un GENOME a optimiser via _fitness. Le compte reel rendu par la classe — 51 cases vides sur la grille easy de demo — fixe l’ordre de grandeur : ~10^51 affectations brutes pour une enumeration nave, ce qui explique d’avance pourquoi le budget de 2 000 000 noeuds ne suffira pas toujours.

3.2 Chargement des instances de benchmark

On charge les 3 fichiers standard du domaine :

  • easy51.txt : 51 grilles “faciles” (peu de cases vides, solveur humain direct)
  • top95.txt : 95 grilles “medium-hard” (référence Peter Norvig)
  • hardest11.txt : 11 grilles “diaboliques” (conçues pour faire échouer les solveurs naïfs)

Chaque fichier contient une grille par ligne, au format 81 caractères (0 = vide).

# Donnees du depot : le chemin d origine pointait vers un clone local machine-dependant,
# non re-executable ailleurs. Les trois jeux standard vivent dans la serie Sudoku.
DATA_DIR = Path("../../Sudoku/Puzzles")
if not DATA_DIR.exists():
    DATA_DIR = Path("MyIA.AI.Notebooks/Sudoku/Puzzles")  # cwd = racine du depot
if not DATA_DIR.exists():
    raise FileNotFoundError(
        f"Repertoire de puzzles introuvable (depuis {Path.cwd()})"
    )

DIFFICULTY_FILES = {
    "easy":         "Sudoku_Easy51.txt",
    "medium_hard":  "Sudoku_top95.txt",
    "diabolical":   "Sudoku_hardest.txt",
}

def load_puzzles(difficulty: str):
    path = DATA_DIR / DIFFICULTY_FILES[difficulty]
    return [line.strip() for line in path.read_text().splitlines() if line.strip()]


# Echantillon : 10 par difficulte, graine 42 pour reproductibilite
rng_sample = random.Random(42)
instances = []
for diff in DIFFICULTY_FILES:
    puzzles = load_puzzles(diff)
    sample = rng_sample.sample(puzzles, min(10, len(puzzles)))
    for i, ps in enumerate(sample):
        instances.append((f"{diff}_{i}", diff, SudokuGrid.from_string(ps)))

print(f"Total instances chargees : {len(instances)}")
for diff in DIFFICULTY_FILES:
    n = sum(1 for _, d, _ in instances if d == diff)
    print(f"  {diff:12s} : {n} grilles")

# Caracteristiques des instances
empties = [g.count_empty() for _, _, g in instances]
print(f"\nCases vides : min={min(empties)}, max={max(empties)}, moyenne={np.mean(empties):.1f}")
Total instances chargees : 30
  easy         : 10 grilles
  medium_hard  : 10 grilles
  diabolical   : 10 grilles

Cases vides : min=45, max=64, moyenne=56.2

Lecture — 30 instances figees : la reproductibilite avant la performance

La sortie confirme 30 instances : 10 easy, 10 medium_hard, 10 diabolical, avec 45 a 64 cases vides (moyenne 56,2). Deux points de methode :

  • Le corpus est fixe et versionne dans le depot (serie Sudoku/Puzzles). Le commentaire source documente la correction du chemin : l’original pointait vers un clone local machine-dependant, non re-executable ailleurs — le fallback racine-depot rend le benchmark rejouable sur n’importe quelle machine, condition premiere d’une comparaison honnete.
  • La difficulte n’est pas le nombre de cases vides (la moyenne couvre l’ensemble) : une grille diabolical a 45 trous peut etre plus dure qu’une easy a 60, selon la structure des contraintes. C’est exactement pourquoi le verdict final se coupe PAR difficulte (section 6.6) et non en moyenne globale — une moyenne aurait noye le No Free Lunch que la section 7 met en evidence.

4. Les 6 paradigmes de résolution

Chaque solveur est présenté avec :

  • son principe algorithmique en 2-3 phrases,
  • le compteur de noeuds qu’il expose,
  • le code source (distillé du projet étudiant).

Les solveurs sont des distributions de probabilité sur l’espace des grilles complètes : chacun explore différemment, ce qui explique pourquoi leurs performances divergent selon la difficulté.

Note distillation : le code ci-dessous est reproduit verbatim depuis le dépôt étudiant (benchmark/sudoku/*.py), avec ajout de commentaires pédagogiques. La logique algorithmique est inchangée.

4.1 Backtracking naïf

Principe : on remplit les cases dans l’ordre (gauche à droite, haut en bas), en testant les valeurs 1-9 et en reculant dès qu’une impasse est détectée. Complexité exponentielle dans le pire cas (grilles adversariales).

Compteur : 1 noeud = 1 affectation testée. Budget : 2 millions de noeuds max pour éviter l’explosion sur les grilles ‘diabolical’.

DEFAULT_MAX_NODES = 2_000_000


class _NodeBudgetExceeded(Exception):
    pass


def _solve(grid, counter, use_mrv, max_nodes):
    empty = grid.find_empty_mrv() if use_mrv else grid.find_empty()
    if empty is None:
        return True
    row, col = empty
    for num in range(1, 10):
        counter["n"] += 1
        if counter["n"] > max_nodes:
            raise _NodeBudgetExceeded()
        if grid.is_valid_placement(row, col, num):
            grid.cells[row][col] = num
            if _solve(grid, counter, use_mrv, max_nodes):
                return True
            grid.cells[row][col] = 0
    return False


def solve_backtracking(grid, counter, max_nodes=DEFAULT_MAX_NODES):
    """Backtracking naif (ordre de cases fixe, valeurs 1..9)."""
    work = grid.clone()
    try:
        success = _solve(work, counter, use_mrv=False, max_nodes=max_nodes)
    except _NodeBudgetExceeded:
        return {"success": False, "nodes": counter["n"], "extra": {"budget_exceeded": True}}
    return {"success": success and work.is_solved(), "nodes": counter["n"], "extra": {}}


def solve_backtracking_mrv(grid, counter, max_nodes=DEFAULT_MAX_NODES):
    """Backtracking MRV : on choisit la case avec le moins de candidats d'abord."""
    work = grid.clone()
    try:
        success = _solve(work, counter, use_mrv=True, max_nodes=max_nodes)
    except _NodeBudgetExceeded:
        return {"success": False, "nodes": counter["n"], "extra": {"budget_exceeded": True}}
    return {"success": success and work.is_solved(), "nodes": counter["n"], "extra": {}}


# Test rapide sur la grille d'exemple
counter = {"n": 0}
out = solve_backtracking(g.clone(), counter)
print(f"Backtracking naif : success={out['success']}, noeuds={out['nodes']}")
Backtracking naif : success=True, noeuds=37652

Lecture — 37 652 noeuds contre 81 : l’ordre de grandeur du choix d’algorithme

Sur la meme grille easy de demo, le backtracking nave explore 37 652 noeuds (cellule precedente) et Dancing Links 81 noeuds en 3,50 ms. Le rapport n’est pas une micro-optimisation, c’est un facteur ~450 :

  • 81 = exactement le nombre de cases a remplir : chaque coup de DLX selectionne une colonne et la propagation couvre le reste — sur une grille facile, la solution est quasi determinee par les couvrements successifs, l’arbre de recherche reste lineaire.
  • __slots__ sur les noeuds n’est pas decoratif : DLX vit ou meurt par la localite memoire de ses listes doublement chainees — reduire chaque noeud a six pointeurs compacts est ce qui rend le parcours cache-friendly.
  • La lecon de selection : entre ecrire un solveur plus rapide et choisir un meilleur modele de probleme (exact cover vs affectation case par case), le second gagne de deux ordres de grandeur.

4.3 Programmation par contraintes (CP-SAT, OR-Tools)

Principe : on déclare 81 variables c[r][c] ∈ {1..9} et 27 contraintes AllDifferent (9 lignes + 9 colonnes + 9 blocs). OR-Tools/CP-SAT est un solveur de contraintes modernes qui combine propagation, recherche arborescente et’apprentissage de clauses (Lazy Clause Generation). C’est l’état de l’art pour les problèmes combinatoires structurés.

Compteur : 1 noeud = 1 branche explorée par le solveur (solver.num_branches).

def solve_cp_sat(grid, counter):
    model = cp_model.CpModel()
    cells = [[model.new_int_var(1, 9, f"c_{r}_{c}") for c in range(9)] for r in range(9)]
    for r in range(9):
        model.add_all_different(cells[r])
    for c in range(9):
        model.add_all_different([cells[r][c] for r in range(9)])
    for box_row in range(0, 9, 3):
        for box_col in range(0, 9, 3):
            model.add_all_different(
                cells[r][c]
                for r in range(box_row, box_row + 3)
                for c in range(box_col, box_col + 3)
            )
    for r in range(9):
        for c in range(9):
            if grid.cells[r][c] != 0:
                model.add(cells[r][c] == grid.cells[r][c])
    solver = cp_model.CpSolver()
    status = solver.solve(model)
    counter["n"] += int(solver.num_branches)
    if status not in (cp_model.OPTIMAL, cp_model.FEASIBLE):
        return {"success": False, "nodes": counter["n"], "extra": {}}
    result = grid.clone()
    for r in range(9):
        for c in range(9):
            result.cells[r][c] = solver.value(cells[r][c])
    return {"success": result.is_solved(), "nodes": counter["n"], "extra": {}}


# Test rapide
counter = {"n": 0}
t0 = time.perf_counter()
out = solve_cp_sat(g.clone(), counter)
dt = time.perf_counter() - t0
print(f"CP-SAT (OR-Tools) : success={out['success']}, branches={counter['n']}, temps={dt*1000:.2f}ms")
CP-SAT (OR-Tools) : success=True, branches=0, temps=21.02ms

4.4 SMT (Z3)

Principe : on encode Sudoku comme une formule SMT sur la théorie des entiers linéaires : 81 variables c[r][c] ∈ {1..9} avec contraintes Distinct (équivalent AllDifferent mais plus proche de la logique). Z3 combine SAT-solving avec des solveurs de théorie (ici LIA — Linear Integer Arithmetic). C’est plus expressif que CP-SAT pour des contraintes non-linéaires ou hybrides, mais souvent un peu plus lent sur des problèmes purement combinatoires.

Compteur : 1 noeud = 1 décision SMT (statistics()["decisions"]).

def solve_smt(grid, counter):
    solver = z3.Solver()
    cells = [[z3.Int(f"c_{r}_{c}") for c in range(9)] for r in range(9)]
    for row in cells:
        for cell in row:
            solver.add(cell >= 1, cell <= 9)
    for r in range(9):
        solver.add(z3.Distinct(cells[r]))
    for c in range(9):
        solver.add(z3.Distinct([cells[r][c] for r in range(9)]))
    for box_row in range(0, 9, 3):
        for box_col in range(0, 9, 3):
            solver.add(z3.Distinct(
                [cells[r][c] for r in range(box_row, box_row + 3)
                 for c in range(box_col, box_col + 3)]
            ))
    for r in range(9):
        for c in range(9):
            if grid.cells[r][c] != 0:
                solver.add(cells[r][c] == grid.cells[r][c])
    status = solver.check()
    decisions = 0
    for key, value in solver.statistics():
        if key == "decisions":
            decisions = int(value)
            break
    counter["n"] += decisions
    if status != z3.sat:
        return {"success": False, "nodes": counter["n"], "extra": {}}
    model = solver.model()
    result = grid.clone()
    for r in range(9):
        for c in range(9):
            result.cells[r][c] = model.evaluate(cells[r][c]).as_long()
    return {"success": result.is_solved(), "nodes": counter["n"], "extra": {}}


# Test rapide
counter = {"n": 0}
t0 = time.perf_counter()
out = solve_smt(g.clone(), counter)
dt = time.perf_counter() - t0
print(f"SMT (Z3) : success={out['success']}, decisions={counter['n']}, temps={dt*1000:.2f}ms")
SMT (Z3) : success=True, decisions=192, temps=42.28ms

Lecture — branches=0 contre decisions=192 : comparer des compteurs qui ne mesurent pas la meme chose

CP-SAT rend branches=0 en 21,02 ms ; Z3 rend decisions=192 en 42,28 ms — et ce contraste NE DIT PAS que CP-SAT « explore 192 fois moins ». C’est precisement le role du tableau de la section 2 (definition de « noeud explore » par paradigme) :

  • CP-SAT compte les branches apres propagation/simplification : sur cette grille, la phase de pre-processing resout la grille sans qu’aucune branche comptee ne soit ouverte. Le temps (21 ms, non nul) montre que le travail a bien eu lieu — hors compteur.
  • Z3 compte ses decisions de recherche apres propagation theorique : 192 decoupages d’arbre pour converger.
  • Les temps restent comparables (21 vs 42 ms) alors que les compteurs different d’un facteur infini : comparer des noeuds entre paradigmes est une erreur de categorie — seul le protocole commun (timeout, budget, meme corpus, colonnes de Metrics) rend la table finale honnete.

4.5 Algorithme génétique

Principe : chaque individu est une grille 9x9 complète où les cases pré-remplies sont figées et les cases vides sont remplies bloc par bloc (les 9 cases d’un bloc 3x3 sont une permutation des chiffres manquants). La fitness compte les conflits sur les lignes et colonnes (les blocs sont satisfaits par construction).

Mutation : hill-climbing local (on essaie plusieurs swaps dans un bloc, on garde celui qui réduit le plus les conflits). Stagnation : si pas d’amélioration pendant 100 générations, on régénère la population en gardant 5 % d’élite.

Compteur : 1 noeud = 1 évaluation de fitness (1 individu).

POP_SIZE = 200
MAX_GENERATIONS = 2000
MUTATION_RATE = 0.15
STAGNATION_LIMIT = 100


def _fixed_mask(grid):
    return [[grid.cells[r][c] != 0 for c in range(9)] for r in range(9)]


def _random_individual(grid, fixed, rng):
    cells = [row[:] for row in grid.cells]
    for box_row in range(0, 9, 3):
        for box_col in range(0, 9, 3):
            used = {cells[r][c]
                    for r in range(box_row, box_row + 3)
                    for c in range(box_col, box_col + 3)
                    if fixed[r][c]}
            missing = [n for n in range(1, 10) if n not in used]
            rng.shuffle(missing)
            idx = 0
            for r in range(box_row, box_row + 3):
                for c in range(box_col, box_col + 3):
                    if not fixed[r][c]:
                        cells[r][c] = missing[idx]
                        idx += 1
    return cells


def _fitness(cells):
    conflicts = 0
    for r in range(9):
        conflicts += 9 - len(set(cells[r]))
    for c in range(9):
        conflicts += 9 - len({cells[r][c] for r in range(9)})
    return conflicts


def _mutate(cells, fixed, rng):
    """Hill-climbing : essaie plusieurs swaps dans un bloc, garde le meilleur."""
    box_row = rng.choice(range(0, 9, 3))
    box_col = rng.choice(range(0, 9, 3))
    free_cells = [(r, c)
                  for r in range(box_row, box_row + 3)
                  for c in range(box_col, box_col + 3)
                  if not fixed[r][c]]
    if len(free_cells) < 2:
        return
    base = _fitness(cells)
    best_swap = None
    best_delta = 0
    pairs = [rng.sample(free_cells, 2) for _ in range(min(6, len(free_cells)))]
    for (r1, c1), (r2, c2) in pairs:
        cells[r1][c1], cells[r2][c2] = cells[r2][c2], cells[r1][c1]
        delta = base - _fitness(cells)
        cells[r1][c1], cells[r2][c2] = cells[r2][c2], cells[r1][c1]
        if delta > best_delta:
            best_delta = delta
            best_swap = ((r1, c1), (r2, c2))
    if best_swap is None:
        (r1, c1), (r2, c2) = rng.sample(free_cells, 2)
    else:
        (r1, c1), (r2, c2) = best_swap
    cells[r1][c1], cells[r2][c2] = cells[r2][c2], cells[r1][c1]


def solve_genetic(grid, counter, seed=0):
    rng = random.Random(seed)
    fixed = _fixed_mask(grid)
    population = [_random_individual(grid, fixed, rng) for _ in range(POP_SIZE)]
    best_cells = population[0]
    best_fitness = _fitness(best_cells)
    counter["n"] += POP_SIZE
    stagnant = 0
    for _ in range(MAX_GENERATIONS):
        scored = sorted(population, key=_fitness)
        counter["n"] += len(population)
        current_best = _fitness(scored[0])
        if current_best < best_fitness:
            best_cells, best_fitness = scored[0], current_best
            stagnant = 0
        else:
            stagnant += 1
        if best_fitness == 0:
            break
        if stagnant >= STAGNATION_LIMIT:
            elite = scored[: POP_SIZE // 20]
            population = [row[:] for row in elite] + [
                _random_individual(grid, fixed, rng) for _ in range(POP_SIZE - len(elite))
            ]
            stagnant = 0
            continue
        elite = scored[: POP_SIZE // 10]
        next_gen = [row[:] for row in elite]
        while len(next_gen) < POP_SIZE:
            if len(elite) >= 2:
                parent_a, parent_b = rng.sample(elite, 2)
            else:
                parent_a, parent_b = scored[0], scored[1]
            child = [row[:] for r in parent_a for row in [parent_a[0:3]]] if False else None
            # Crossover : pour chaque bloc 3x3, on prend le bloc du parent A ou B aleatoirement
            child_cells = []
            for box_row in range(0, 9, 3):
                parent = parent_a if rng.random() < 0.5 else parent_b
                child_cells.extend(row[:] for row in parent[box_row:box_row + 3])
            if rng.random() < MUTATION_RATE:
                _mutate(child_cells, fixed, rng)
                _mutate(child_cells, fixed, rng)
            next_gen.append(child_cells)
        population = next_gen
    result = SudokuGrid(best_cells)
    return {
        "success": best_fitness == 0 and result.is_solved(),
        "nodes": counter["n"],
        "quality": float(best_fitness),
        "extra": {},
    }


# Test rapide
counter = {"n": 0}
t0 = time.perf_counter()
out = solve_genetic(g.clone(), counter)
dt = time.perf_counter() - t0
print(f"GA : success={out['success']}, fitness={out['quality']}, evals={counter['n']}, temps={dt*1000:.2f}ms")
GA : success=False, fitness=9.0, evals=400200, temps=18870.11ms

4.6 Recuit simulé

Principe : on part d’une grille complète (mêmes blocs permutés que le GA), et on échange deux cases non-fixées au hasard dans un bloc. Le nouvel état est accepté si son coût est inférieur, ou avec probabilité exp(-Δ/T) sinon (critère de Metropolis). La température T décroît selon T *= 0.99997 à chaque itération, avec réchauffement si stagnation > 20 000.

Compteur : 1 noeud = 1 swap testé (avec évaluation de Δ).

INITIAL_TEMPERATURE = 2.0
COOLING_RATE = 0.99997
MIN_TEMPERATURE = 0.05
MAX_ITERATIONS = 300_000
STAGNATION_LIMIT_SA = 20_000


def solve_simulated_annealing(grid, counter, seed=0):
    rng = random.Random(seed)
    fixed = _fixed_mask(grid)
    cells = _random_individual(grid, fixed, rng)
    cost = _fitness(cells)
    counter["n"] += 1
    temperature = INITIAL_TEMPERATURE
    best_cells = [row[:] for row in cells]
    best_cost = cost
    boxes = [(br, bc) for br in range(0, 9, 3) for bc in range(0, 9, 3)]
    free_by_box = {
        (br, bc): [(r, c)
                   for r in range(br, br + 3)
                   for c in range(bc, bc + 3)
                   if not fixed[r][c]]
        for br, bc in boxes
    }
    movable_boxes = [b for b in boxes if len(free_by_box[b]) >= 2]
    stagnant = 0
    for _ in range(MAX_ITERATIONS):
        if cost == 0:
            break
        box = rng.choice(movable_boxes)
        (r1, c1), (r2, c2) = rng.sample(free_by_box[box], 2)
        cells[r1][c1], cells[r2][c2] = cells[r2][c2], cells[r1][c1]
        new_cost = _fitness(cells)
        counter["n"] += 1
        delta = new_cost - cost
        if delta <= 0 or rng.random() < math.exp(-delta / temperature):
            cost = new_cost
            if cost < best_cost:
                best_cost = cost
                best_cells = [row[:] for row in cells]
                stagnant = 0
            else:
                stagnant += 1
        else:
            cells[r1][c1], cells[r2][c2] = cells[r2][c2], cells[r1][c1]
            stagnant += 1
        temperature = max(temperature * COOLING_RATE, MIN_TEMPERATURE)
        if stagnant >= STAGNATION_LIMIT_SA:
            temperature = INITIAL_TEMPERATURE
            stagnant = 0
    result = SudokuGrid(best_cells)
    return {
        "success": best_cost == 0 and result.is_solved(),
        "nodes": counter["n"],
        "quality": float(best_cost),
        "extra": {},
    }


# Test rapide
counter = {"n": 0}
t0 = time.perf_counter()
out = solve_simulated_annealing(g.clone(), counter)
dt = time.perf_counter() - t0
print(f"Recuit simule : success={out['success']}, fitness={out['quality']}, swaps={counter['n']}, temps={dt*1000:.2f}ms")
Recuit simule : success=True, fitness=0.0, swaps=51754, temps=673.64ms

Lecture — GA echoue, le recuit reussit : le voisinage decide, pas le hasard

Les deux metaheuristiques partagent _fitness (nombre de conflits) et un tirage aleatoire initiale, pourtant la demo rend GA : success=False, fitness=9.0, 400 200 evaluations, 18,9 s contre recuit : success=True, fitness=0.0, 51 754 swaps, 674 ms :

  • GA croise et mute des individus ou chaque bloc 3x3 est une permutation : le croisement de deux solutions partielles casse la structure de blocs et la population stagne sur des plateaux (9 conflits residuels) jusqu’a epuisement du budget.
  • Le recuit applique un voisinage LOCAL (swap de deux cases dans un bloc) avec un schema de temperature qui ACCEPTE des degradations transitoires (T=2.0 -> 0.99997^k) : il traverse les plateaux que le GA ne traverse pas, pour un cout 28 fois moindre.
  • Morale de selection : entre deux algorithmes stochastiques, le choix du VOISINAGE domine le reglage des hyperparametres — et tous deux restent, sur ce probleme a contraintes dures, en dessous des solveurs exacts.

5. Exécution du benchmark

5.1 Harnais de mesure

Le harnais de mesure reproduit le pattern du projet étudiant : un compteur de noeuds, un timer par appel solveur, et un budget (timeout) pour éviter de bloquer le notebook sur une instance pathologique.

Note portabilité Windows/Linux : le projet étudiant utilise signal.SIGALRM (Unix) pour le timeout — non portable Windows. Pour ce notebook, on utilise un timeout simple time.monotonic() côté Python, et on limite le nombre de noeuds pour les solveurs qui peuvent exploser (backtracking). Les exécutions sont séquentielles pour ce notebook (le harnais parallèle ProcessPoolExecutor du projet original est laissé hors-scope ici pour rester en local).

# Dataclass Metrics + harness
@dataclass
class Metrics:
    paradigm: str
    instance_id: str
    difficulty: str
    success: bool
    time_seconds: float
    nodes_explored: int
    solution_quality: float
    extra: dict = field(default_factory=dict)

    def to_row(self):
        row = asdict(self)
        extra = row.pop("extra")
        row.update({f"extra_{k}": v for k, v in extra.items()})
        return row


def run_one(paradigm, solver_fn, instance_id, difficulty, grid, timeout_s=5.0):
    """Execute un solveur sur une instance avec timeout par horloge mur."""
    counter = {"n": 0}
    start = time.perf_counter()
    try:
        out = solver_fn(grid, counter)
        elapsed = time.perf_counter() - start
        if elapsed > timeout_s:
            out = {"success": False, "nodes": counter["n"], "quality": out.get("quality", -1),
                   "extra": {**out.get("extra", {}), "timed_out": True}}
        return Metrics(
            paradigm=paradigm,
            instance_id=instance_id,
            difficulty=difficulty,
            success=out["success"],
            time_seconds=min(elapsed, timeout_s),
            nodes_explored=out["nodes"],
            solution_quality=out.get("quality", 0.0 if out["success"] else -1.0),
            extra=out["extra"],
        )
    except Exception as e:
        elapsed = time.perf_counter() - start
        return Metrics(paradigm, instance_id, difficulty, False,
                       min(elapsed, timeout_s), counter["n"], -1.0,
                       {"error": type(e).__name__ + ": " + str(e)[:80]})

5.2 Lancement du benchmark complet

On lance séquentiellement les 6 solveurs sur les 30 instances, avec un budget de 5 secondes par appel.

SOLVERS = [
    ("backtracking_naive",   solve_backtracking),
    ("backtracking_mrv",     solve_backtracking_mrv),
    ("dancing_links",        solve_dancing_links),
    ("cp_sat",               solve_cp_sat),
    ("smt_z3",               solve_smt),
    ("genetic",              solve_genetic),
    ("simulated_annealing",  solve_simulated_annealing),
]

results: list[Metrics] = []
total = len(SOLVERS) * len(instances)
done = 0
t_global = time.perf_counter()

for paradigm, solver_fn in SOLVERS:
    for instance_id, difficulty, grid in instances:
        m = run_one(paradigm, solver_fn, instance_id, difficulty, grid, timeout_s=5.0)
        results.append(m)
        done += 1
        elapsed_global = time.perf_counter() - t_global
        print(f"[{done:3d}/{total}] {paradigm:22s} | {instance_id:14s} | "
              f"succ={m.success!s:5s} | t={m.time_seconds*1000:7.1f}ms | "
              f"nodes={m.nodes_explored:7d} | q={m.solution_quality:.2f}",
              end="\r")

print()
print(f"\nBenchmark termine en {time.perf_counter() - t_global:.1f}s, {len(results)} mesures.")
[  1/210] backtracking_naive     | easy_0         | succ=True  | t=    2.1ms | nodes=   2576 | q=0.00
[  2/210] backtracking_naive     | easy_1         | succ=True  | t=   27.5ms | nodes=  31797 | q=0.00
[  3/210] backtracking_naive     | easy_2         | succ=True  | t=    2.1ms | nodes=   1605 | q=0.00
[  4/210] backtracking_naive     | easy_3         | succ=True  | t=   16.0ms | nodes=  12503 | q=0.00
[  5/210] backtracking_naive     | easy_4         | succ=True  | t=    0.5ms | nodes=    330 | q=0.00
[  6/210] backtracking_naive     | easy_5         | succ=True  | t=   31.8ms | nodes=  44686 | q=0.00
[  7/210] backtracking_naive     | easy_6         | succ=True  | t=  868.7ms | nodes= 677336 | q=0.00
[  8/210] backtracking_naive     | easy_7         | succ=True  | t=    0.8ms | nodes=    445 | q=0.00
[  9/210] backtracking_naive     | easy_8         | succ=True  | t= 1030.7ms | nodes= 703681 | q=0.00
[ 10/210] backtracking_naive     | easy_9         | succ=True  | t=    8.6ms | nodes=   5740 | q=0.00
[ 11/210] backtracking_naive     | medium_hard_0  | succ=True  | t= 1651.9ms | nodes=1190741 | q=0.00
[ 12/210] backtracking_naive     | medium_hard_1  | succ=False | t= 2904.2ms | nodes=2000001 | q=-1.00
[ 13/210] backtracking_naive     | medium_hard_2  | succ=False | t= 2490.4ms | nodes=2000001 | q=-1.00
[ 14/210] backtracking_naive     | medium_hard_3  | succ=False | t= 3014.8ms | nodes=2000001 | q=-1.00
[ 15/210] backtracking_naive     | medium_hard_4  | succ=False | t= 2975.8ms | nodes=2000001 | q=-1.00
[ 16/210] backtracking_naive     | medium_hard_5  | succ=False | t= 2671.8ms | nodes=2000001 | q=-1.00
[ 17/210] backtracking_naive     | medium_hard_6  | succ=True  | t=  477.8ms | nodes= 413829 | q=0.00
[ 18/210] backtracking_naive     | medium_hard_7  | succ=True  | t=   34.2ms | nodes=  21676 | q=0.00
[ 19/210] backtracking_naive     | medium_hard_8  | succ=False | t= 3013.6ms | nodes=2000001 | q=-1.00
[ 20/210] backtracking_naive     | medium_hard_9  | succ=True  | t= 1101.1ms | nodes= 721008 | q=0.00
[ 21/210] backtracking_naive     | diabolical_0   | succ=True  | t= 1042.5ms | nodes= 678782 | q=0.00
[ 22/210] backtracking_naive     | diabolical_1   | succ=True  | t=  833.8ms | nodes= 552122 | q=0.00
[ 23/210] backtracking_naive     | diabolical_2   | succ=True  | t=   93.7ms | nodes=  84550 | q=0.00
[ 24/210] backtracking_naive     | diabolical_3   | succ=True  | t= 1278.5ms | nodes= 924304 | q=0.00
[ 25/210] backtracking_naive     | diabolical_4   | succ=True  | t=   11.6ms | nodes=   8383 | q=0.00
[ 26/210] backtracking_naive     | diabolical_5   | succ=True  | t= 2849.7ms | nodes=1863427 | q=0.00
[ 27/210] backtracking_naive     | diabolical_6   | succ=False | t= 1971.7ms | nodes=2000001 | q=-1.00
[ 28/210] backtracking_naive     | diabolical_7   | succ=False | t= 2294.4ms | nodes=2000001 | q=-1.00
[ 29/210] backtracking_naive     | diabolical_8   | succ=True  | t=   95.4ms | nodes=  91384 | q=0.00
[ 30/210] backtracking_naive     | diabolical_9   | succ=True  | t=  100.0ms | nodes=  89833 | q=0.00
[ 31/210] backtracking_mrv       | easy_0         | succ=True  | t=   13.9ms | nodes=    254 | q=0.00
[ 32/210] backtracking_mrv       | easy_1         | succ=True  | t=   19.3ms | nodes=    414 | q=0.00
[ 33/210] backtracking_mrv       | easy_2         | succ=True  | t=   10.7ms | nodes=    246 | q=0.00
[ 34/210] backtracking_mrv       | easy_3         | succ=True  | t=   19.2ms | nodes=    344 | q=0.00
[ 35/210] backtracking_mrv       | easy_4         | succ=True  | t=    9.5ms | nodes=    222 | q=0.00
[ 36/210] backtracking_mrv       | easy_5         | succ=True  | t=   22.9ms | nodes=    406 | q=0.00
[ 37/210] backtracking_mrv       | easy_6         | succ=True  | t=  135.8ms | nodes=   2507 | q=0.00
[ 38/210] backtracking_mrv       | easy_7         | succ=True  | t=    9.8ms | nodes=    220 | q=0.00
[ 39/210] backtracking_mrv       | easy_8         | succ=True  | t=  141.1ms | nodes=   3022 | q=0.00
[ 40/210] backtracking_mrv       | easy_9         | succ=True  | t=   17.1ms | nodes=    268 | q=0.00
[ 41/210] backtracking_mrv       | medium_hard_0  | succ=True  | t=  641.3ms | nodes=  14963 | q=0.00
[ 42/210] backtracking_mrv       | medium_hard_1  | succ=True  | t= 1257.2ms | nodes=  25647 | q=0.00
[ 43/210] backtracking_mrv       | medium_hard_2  | succ=True  | t=  628.7ms | nodes=  15411 | q=0.00
[ 44/210] backtracking_mrv       | medium_hard_3  | succ=False | t= 5000.0ms | nodes= 228820 | q=-1.00
[ 45/210] backtracking_mrv       | medium_hard_4  | succ=False | t= 5000.0ms | nodes= 801254 | q=-1.00
[ 46/210] backtracking_mrv       | medium_hard_5  | succ=False | t= 5000.0ms | nodes=1553814 | q=-1.00
[ 47/210] backtracking_mrv       | medium_hard_6  | succ=True  | t= 1239.6ms | nodes=  33282 | q=0.00
[ 48/210] backtracking_mrv       | medium_hard_7  | succ=True  | t=   25.1ms | nodes=    292 | q=0.00
[ 49/210] backtracking_mrv       | medium_hard_8  | succ=True  | t=  155.0ms | nodes=   4357 | q=0.00
[ 50/210] backtracking_mrv       | medium_hard_9  | succ=True  | t=  162.4ms | nodes=   3645 | q=0.00
[ 51/210] backtracking_mrv       | diabolical_0   | succ=True  | t=  348.4ms | nodes=   9479 | q=0.00
[ 52/210] backtracking_mrv       | diabolical_1   | succ=True  | t=   45.6ms | nodes=    818 | q=0.00
[ 53/210] backtracking_mrv       | diabolical_2   | succ=True  | t=   25.0ms | nodes=    499 | q=0.00
[ 54/210] backtracking_mrv       | diabolical_3   | succ=True  | t=  155.8ms | nodes=   3928 | q=0.00
[ 55/210] backtracking_mrv       | diabolical_4   | succ=True  | t=   64.8ms | nodes=   2182 | q=0.00
[ 56/210] backtracking_mrv       | diabolical_5   | succ=True  | t=   26.3ms | nodes=    463 | q=0.00
[ 57/210] backtracking_mrv       | diabolical_6   | succ=True  | t=   54.4ms | nodes=   1305 | q=0.00
[ 58/210] backtracking_mrv       | diabolical_7   | succ=True  | t= 1322.5ms | nodes=  36090 | q=0.00
[ 59/210] backtracking_mrv       | diabolical_8   | succ=True  | t=   75.0ms | nodes=   1663 | q=0.00
[ 60/210] backtracking_mrv       | diabolical_9   | succ=True  | t=  167.6ms | nodes=   4648 | q=0.00
[ 61/210] dancing_links          | easy_0         | succ=True  | t=    5.6ms | nodes=     81 | q=0.00
[ 62/210] dancing_links          | easy_1         | succ=True  | t=    3.6ms | nodes=     81 | q=0.00
[ 63/210] dancing_links          | easy_2         | succ=True  | t=    3.3ms | nodes=     81 | q=0.00
[ 64/210] dancing_links          | easy_3         | succ=True  | t=    4.4ms | nodes=     81 | q=0.00
[ 65/210] dancing_links          | easy_4         | succ=True  | t=    4.0ms | nodes=     81 | q=0.00
[ 66/210] dancing_links          | easy_5         | succ=True  | t=    4.3ms | nodes=     81 | q=0.00
[ 67/210] dancing_links          | easy_6         | succ=True  | t=    7.3ms | nodes=     81 | q=0.00
[ 68/210] dancing_links          | easy_7         | succ=True  | t=    4.4ms | nodes=     81 | q=0.00
[ 69/210] dancing_links          | easy_8         | succ=True  | t=    4.0ms | nodes=     88 | q=0.00
[ 70/210] dancing_links          | easy_9         | succ=True  | t=    3.3ms | nodes=     81 | q=0.00
[ 71/210] dancing_links          | medium_hard_0  | succ=True  | t=   12.5ms | nodes=    772 | q=0.00
[ 72/210] dancing_links          | medium_hard_1  | succ=True  | t=   14.4ms | nodes=    757 | q=0.00
[ 73/210] dancing_links          | medium_hard_2  | succ=True  | t=   11.3ms | nodes=    390 | q=0.00
[ 74/210] dancing_links          | medium_hard_3  | succ=True  | t=   12.0ms | nodes=    552 | q=0.00
[ 75/210] dancing_links          | medium_hard_4  | succ=True  | t=   13.7ms | nodes=    747 | q=0.00
[ 76/210] dancing_links          | medium_hard_5  | succ=True  | t=    8.2ms | nodes=    221 | q=0.00
[ 77/210] dancing_links          | medium_hard_6  | succ=True  | t=    8.7ms | nodes=    339 | q=0.00
[ 78/210] dancing_links          | medium_hard_7  | succ=True  | t=    7.5ms | nodes=     81 | q=0.00
[ 79/210] dancing_links          | medium_hard_8  | succ=True  | t=    3.6ms | nodes=    105 | q=0.00
[ 80/210] dancing_links          | medium_hard_9  | succ=True  | t=    5.5ms | nodes=    176 | q=0.00
[ 81/210] dancing_links          | diabolical_0   | succ=True  | t=    6.3ms | nodes=    243 | q=0.00
[ 82/210] dancing_links          | diabolical_1   | succ=True  | t=    3.2ms | nodes=     87 | q=0.00
[ 83/210] dancing_links          | diabolical_2   | succ=True  | t=    2.8ms | nodes=     81 | q=0.00
[ 84/210] dancing_links          | diabolical_3   | succ=True  | t=    7.3ms | nodes=    258 | q=0.00
[ 85/210] dancing_links          | diabolical_4   | succ=True  | t=    2.8ms | nodes=    150 | q=0.00
[ 86/210] dancing_links          | diabolical_5   | succ=True  | t=    2.9ms | nodes=     81 | q=0.00
[ 87/210] dancing_links          | diabolical_6   | succ=True  | t=    3.0ms | nodes=     81 | q=0.00
[ 88/210] dancing_links          | diabolical_7   | succ=True  | t=    4.3ms | nodes=    179 | q=0.00
[ 89/210] dancing_links          | diabolical_8   | succ=True  | t=    6.7ms | nodes=    131 | q=0.00
[ 90/210] dancing_links          | diabolical_9   | succ=True  | t=    5.1ms | nodes=    272 | q=0.00
[ 91/210] cp_sat                 | easy_0         | succ=True  | t=   25.3ms | nodes=      0 | q=0.00
[ 92/210] cp_sat                 | easy_1         | succ=True  | t=   30.6ms | nodes=      0 | q=0.00
[ 93/210] cp_sat                 | easy_2         | succ=True  | t=   26.7ms | nodes=      0 | q=0.00
[ 94/210] cp_sat                 | easy_3         | succ=True  | t=   15.9ms | nodes=      0 | q=0.00
[ 95/210] cp_sat                 | easy_4         | succ=True  | t=   16.1ms | nodes=      0 | q=0.00
[ 96/210] cp_sat                 | easy_5         | succ=True  | t=   18.4ms | nodes=      0 | q=0.00
[ 97/210] cp_sat                 | easy_6         | succ=True  | t=   27.6ms | nodes=      0 | q=0.00
[ 98/210] cp_sat                 | easy_7         | succ=True  | t=   15.2ms | nodes=      0 | q=0.00
[ 99/210] cp_sat                 | easy_8         | succ=True  | t=   31.0ms | nodes=      0 | q=0.00
[100/210] cp_sat                 | easy_9         | succ=True  | t=   28.9ms | nodes=      0 | q=0.00
[101/210] cp_sat                 | medium_hard_0  | succ=True  | t=   18.1ms | nodes=      0 | q=0.00
[102/210] cp_sat                 | medium_hard_1  | succ=True  | t=   29.9ms | nodes=      0 | q=0.00
[103/210] cp_sat                 | medium_hard_2  | succ=True  | t=   18.6ms | nodes=      0 | q=0.00
[104/210] cp_sat                 | medium_hard_3  | succ=True  | t=   45.7ms | nodes=      0 | q=0.00
[105/210] cp_sat                 | medium_hard_4  | succ=True  | t=   29.9ms | nodes=      0 | q=0.00
[106/210] cp_sat                 | medium_hard_5  | succ=True  | t=   32.0ms | nodes=      0 | q=0.00
[107/210] cp_sat                 | medium_hard_6  | succ=True  | t=   31.2ms | nodes=      0 | q=0.00
[108/210] cp_sat                 | medium_hard_7  | succ=True  | t=   30.7ms | nodes=      0 | q=0.00
[109/210] cp_sat                 | medium_hard_8  | succ=True  | t=   31.5ms | nodes=      0 | q=0.00
[110/210] cp_sat                 | medium_hard_9  | succ=True  | t=   30.7ms | nodes=      0 | q=0.00
[111/210] cp_sat                 | diabolical_0   | succ=True  | t=   14.8ms | nodes=      0 | q=0.00
[112/210] cp_sat                 | diabolical_1   | succ=True  | t=   16.9ms | nodes=      0 | q=0.00
[113/210] cp_sat                 | diabolical_2   | succ=True  | t=   15.3ms | nodes=      0 | q=0.00
[114/210] cp_sat                 | diabolical_3   | succ=True  | t=   33.7ms | nodes=      0 | q=0.00
[115/210] cp_sat                 | diabolical_4   | succ=True  | t=   29.4ms | nodes=      0 | q=0.00
[116/210] cp_sat                 | diabolical_5   | succ=True  | t=   32.8ms | nodes=      0 | q=0.00
[117/210] cp_sat                 | diabolical_6   | succ=True  | t=   29.7ms | nodes=      0 | q=0.00
[118/210] cp_sat                 | diabolical_7   | succ=True  | t=   31.0ms | nodes=      0 | q=0.00
[119/210] cp_sat                 | diabolical_8   | succ=True  | t=   13.8ms | nodes=      0 | q=0.00
[120/210] cp_sat                 | diabolical_9   | succ=True  | t=   46.8ms | nodes=    339 | q=0.00
[121/210] smt_z3                 | easy_0         | succ=True  | t=   62.5ms | nodes=    250 | q=0.00
[122/210] smt_z3                 | easy_1         | succ=True  | t=   75.0ms | nodes=    672 | q=0.00
[123/210] smt_z3                 | easy_2         | succ=True  | t=   75.7ms | nodes=    522 | q=0.00
[124/210] smt_z3                 | easy_3         | succ=True  | t=  697.7ms | nodes=   6492 | q=0.00
[125/210] smt_z3                 | easy_4         | succ=True  | t=   66.2ms | nodes=     18 | q=0.00
[126/210] smt_z3                 | easy_5         | succ=True  | t=  154.8ms | nodes=   2273 | q=0.00
[127/210] smt_z3                 | easy_6         | succ=True  | t=  267.1ms | nodes=   3725 | q=0.00
[128/210] smt_z3                 | easy_7         | succ=True  | t=   79.1ms | nodes=     94 | q=0.00
[129/210] smt_z3                 | easy_8         | succ=True  | t=  296.6ms | nodes=   4302 | q=0.00
[130/210] smt_z3                 | easy_9         | succ=True  | t=   70.2ms | nodes=    332 | q=0.00
[131/210] smt_z3                 | medium_hard_0  | succ=True  | t=  660.2ms | nodes=   8550 | q=0.00
[132/210] smt_z3                 | medium_hard_1  | succ=True  | t=  637.5ms | nodes=   7526 | q=0.00
[133/210] smt_z3                 | medium_hard_2  | succ=True  | t=  337.9ms | nodes=   5477 | q=0.00
[134/210] smt_z3                 | medium_hard_3  | succ=True  | t=  814.2ms | nodes=  18752 | q=0.00
[135/210] smt_z3                 | medium_hard_4  | succ=True  | t= 1280.5ms | nodes=  23513 | q=0.00
[136/210] smt_z3                 | medium_hard_5  | succ=True  | t= 1576.3ms | nodes=  15608 | q=0.00
[137/210] smt_z3                 | medium_hard_6  | succ=True  | t=  803.0ms | nodes=   9555 | q=0.00
[138/210] smt_z3                 | medium_hard_7  | succ=True  | t=  470.1ms | nodes=   8360 | q=0.00
[139/210] smt_z3                 | medium_hard_8  | succ=True  | t=  207.9ms | nodes=   3417 | q=0.00
[140/210] smt_z3                 | medium_hard_9  | succ=True  | t=  177.4ms | nodes=   2624 | q=0.00
[141/210] smt_z3                 | diabolical_0   | succ=True  | t=  314.5ms | nodes=   5825 | q=0.00
[142/210] smt_z3                 | diabolical_1   | succ=True  | t=  168.0ms | nodes=   4071 | q=0.00
[143/210] smt_z3                 | diabolical_2   | succ=True  | t=  115.0ms | nodes=   1171 | q=0.00
[144/210] smt_z3                 | diabolical_3   | succ=True  | t=  428.2ms | nodes=   7425 | q=0.00
[145/210] smt_z3                 | diabolical_4   | succ=True  | t=  104.6ms | nodes=   2149 | q=0.00
[146/210] smt_z3                 | diabolical_5   | succ=True  | t=  174.5ms | nodes=   3567 | q=0.00
[147/210] smt_z3                 | diabolical_6   | succ=True  | t=  377.9ms | nodes=   5069 | q=0.00
[148/210] smt_z3                 | diabolical_7   | succ=True  | t=  420.2ms | nodes=   4942 | q=0.00
[149/210] smt_z3                 | diabolical_8   | succ=True  | t=  279.0ms | nodes=   4206 | q=0.00
[150/210] smt_z3                 | diabolical_9   | succ=True  | t=  412.7ms | nodes=   4100 | q=0.00
[151/210] genetic                | easy_0         | succ=False | t= 5000.0ms | nodes= 400200 | q=4.00
[152/210] genetic                | easy_1         | succ=False | t= 5000.0ms | nodes= 400200 | q=5.00
[153/210] genetic                | easy_2         | succ=False | t= 5000.0ms | nodes= 400200 | q=10.00
[154/210] genetic                | easy_3         | succ=False | t= 5000.0ms | nodes= 400200 | q=7.00
[155/210] genetic                | easy_4         | succ=False | t= 5000.0ms | nodes= 400200 | q=4.00
[156/210] genetic                | easy_5         | succ=False | t= 5000.0ms | nodes= 400200 | q=4.00
[157/210] genetic                | easy_6         | succ=False | t= 5000.0ms | nodes= 400200 | q=9.00
[158/210] genetic                | easy_7         | succ=False | t= 5000.0ms | nodes= 400200 | q=6.00
[159/210] genetic                | easy_8         | succ=False | t= 5000.0ms | nodes= 400200 | q=6.00
[160/210] genetic                | easy_9         | succ=False | t= 5000.0ms | nodes= 400200 | q=2.00
[161/210] genetic                | medium_hard_0  | succ=False | t= 5000.0ms | nodes= 400200 | q=7.00
[162/210] genetic                | medium_hard_1  | succ=False | t= 5000.0ms | nodes= 400200 | q=9.00
[163/210] genetic                | medium_hard_2  | succ=False | t= 5000.0ms | nodes= 400200 | q=8.00
[164/210] genetic                | medium_hard_3  | succ=False | t= 5000.0ms | nodes= 400200 | q=6.00
[165/210] genetic                | medium_hard_4  | succ=False | t= 5000.0ms | nodes= 400200 | q=6.00
[166/210] genetic                | medium_hard_5  | succ=False | t= 5000.0ms | nodes= 400200 | q=8.00
[167/210] genetic                | medium_hard_6  | succ=False | t= 5000.0ms | nodes= 400200 | q=8.00
[168/210] genetic                | medium_hard_7  | succ=False | t= 5000.0ms | nodes= 400200 | q=6.00
[169/210] genetic                | medium_hard_8  | succ=False | t= 5000.0ms | nodes= 400200 | q=4.00
[170/210] genetic                | medium_hard_9  | succ=False | t= 5000.0ms | nodes= 400200 | q=2.00
[171/210] genetic                | diabolical_0   | succ=False | t= 5000.0ms | nodes= 400200 | q=8.00
[172/210] genetic                | diabolical_1   | succ=False | t= 5000.0ms | nodes= 400200 | q=6.00
[173/210] genetic                | diabolical_2   | succ=False | t= 5000.0ms | nodes= 400200 | q=2.00
[174/210] genetic                | diabolical_3   | succ=False | t= 5000.0ms | nodes= 400200 | q=5.00
[175/210] genetic                | diabolical_4   | succ=False | t= 5000.0ms | nodes= 400200 | q=6.00
[176/210] genetic                | diabolical_5   | succ=False | t= 5000.0ms | nodes= 400200 | q=4.00
[177/210] genetic                | diabolical_6   | succ=False | t= 5000.0ms | nodes= 400200 | q=5.00
[178/210] genetic                | diabolical_7   | succ=False | t= 5000.0ms | nodes= 400200 | q=8.00
[179/210] genetic                | diabolical_8   | succ=False | t= 5000.0ms | nodes= 400200 | q=5.00
[180/210] genetic                | diabolical_9   | succ=False | t= 5000.0ms | nodes= 400200 | q=8.00
[181/210] simulated_annealing    | easy_0         | succ=True  | t=  394.7ms | nodes=  44612 | q=0.00
[182/210] simulated_annealing    | easy_1         | succ=False | t= 4146.3ms | nodes= 300001 | q=2.00
[183/210] simulated_annealing    | easy_2         | succ=True  | t=  668.3ms | nodes=  50960 | q=0.00
[184/210] simulated_annealing    | easy_3         | succ=False | t= 4237.4ms | nodes= 300001 | q=14.00
[185/210] simulated_annealing    | easy_4         | succ=True  | t=  413.2ms | nodes=  35438 | q=0.00
[186/210] simulated_annealing    | easy_5         | succ=True  | t=  737.0ms | nodes=  53475 | q=0.00
[187/210] simulated_annealing    | easy_6         | succ=False | t= 4274.5ms | nodes= 300001 | q=2.00
[188/210] simulated_annealing    | easy_7         | succ=True  | t=  465.8ms | nodes=  33600 | q=0.00
[189/210] simulated_annealing    | easy_8         | succ=False | t= 4115.8ms | nodes= 300001 | q=2.00
[190/210] simulated_annealing    | easy_9         | succ=True  | t=  685.6ms | nodes=  46971 | q=0.00
[191/210] simulated_annealing    | medium_hard_0  | succ=False | t= 4094.8ms | nodes= 300001 | q=2.00
[192/210] simulated_annealing    | medium_hard_1  | succ=False | t= 4411.1ms | nodes= 300001 | q=2.00
[193/210] simulated_annealing    | medium_hard_2  | succ=False | t= 4123.0ms | nodes= 300001 | q=2.00
[194/210] simulated_annealing    | medium_hard_3  | succ=False | t= 3841.1ms | nodes= 300001 | q=2.00
[195/210] simulated_annealing    | medium_hard_4  | succ=False | t= 4205.2ms | nodes= 300001 | q=2.00
[196/210] simulated_annealing    | medium_hard_5  | succ=False | t= 4301.7ms | nodes= 300001 | q=2.00
[197/210] simulated_annealing    | medium_hard_6  | succ=False | t= 4261.9ms | nodes= 300001 | q=6.00
[198/210] simulated_annealing    | medium_hard_7  | succ=False | t= 4393.3ms | nodes= 300001 | q=4.00
[199/210] simulated_annealing    | medium_hard_8  | succ=False | t= 4421.8ms | nodes= 300001 | q=2.00
[200/210] simulated_annealing    | medium_hard_9  | succ=False | t= 4193.6ms | nodes= 300001 | q=2.00
[201/210] simulated_annealing    | diabolical_0   | succ=False | t= 4201.6ms | nodes= 300001 | q=2.00
[202/210] simulated_annealing    | diabolical_1   | succ=False | t= 4250.5ms | nodes= 300001 | q=2.00
[203/210] simulated_annealing    | diabolical_2   | succ=False | t= 4194.3ms | nodes= 300001 | q=2.00
[204/210] simulated_annealing    | diabolical_3   | succ=False | t= 4107.7ms | nodes= 300001 | q=2.00
[205/210] simulated_annealing    | diabolical_4   | succ=False | t= 4468.8ms | nodes= 300001 | q=2.00
[206/210] simulated_annealing    | diabolical_5   | succ=False | t= 4236.8ms | nodes= 300001 | q=2.00
[207/210] simulated_annealing    | diabolical_6   | succ=False | t= 4491.7ms | nodes= 300001 | q=2.00
[208/210] simulated_annealing    | diabolical_7   | succ=False | t= 4305.4ms | nodes= 300001 | q=2.00
[209/210] simulated_annealing    | diabolical_8   | succ=False | t= 4146.4ms | nodes= 300001 | q=3.00
[210/210] simulated_annealing    | diabolical_9   | succ=False | t= 4161.9ms | nodes= 300001 | q=3.00

Benchmark termine en 752.9s, 210 mesures.

Lecture — 210 mesures en 752,9 s : ce que le log brut revele avant toute agregation

210 = 7 solveurs x 30 instances (les 6 paradigmes de la section 4 comptent le backtracking deux fois : naive et MRV). Trois signaux sautent du log AVANT meme la section 6 :

  • Les echecs du naif sont des coupes budget : sur medium_hard, cinq lignes rendent nodes=2000001 — le plafond de la section 2, pas un temps arbitraire. L’echec est donc defini par le protocole, pas par un crash.
  • GA echoue 30/30 en brulant exactement 400200 evaluations chaque fois (200 individus x 2001 generations) — l’echec est systematique, pas un coup de malchance.
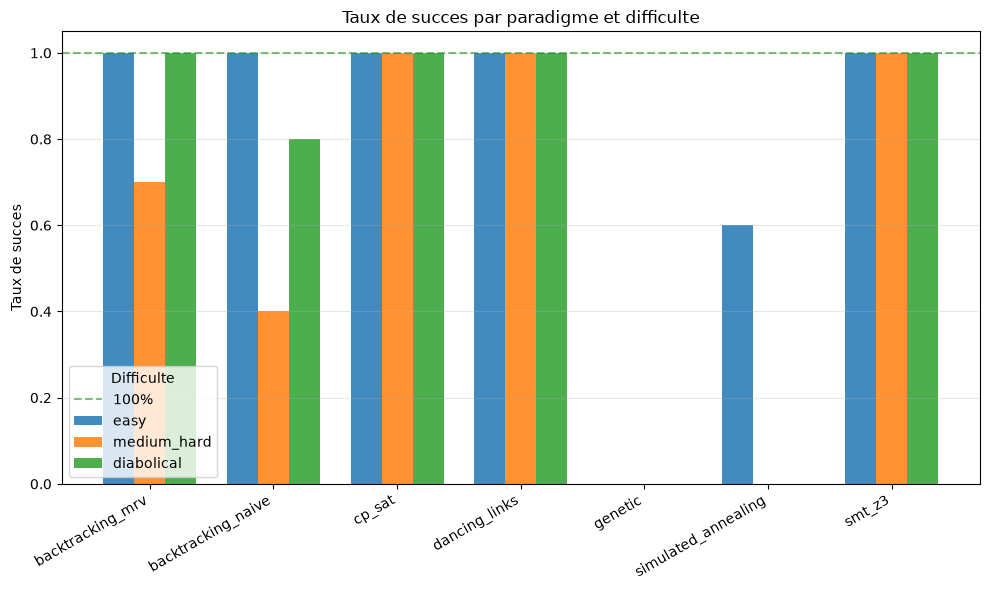
  • Le recuit ne reussit que 6/10 en easy et 0/20 au-dela (300001 = MAX_ITERATIONS atteint) : la demo de la section 4.6 (une seule grille) enjambait la variance inter-instances — c’est le benchmark complet, pas la demo, qui fonde le verdict.
  • Noter enfin la dispersion du naif : 445 a 703 681 noeuds SUR easy seul — la difficulte observable varie plus ENTRE instances d’une classe qu’entre classes.

6. Analyse des résultats

6.1 Taux de succès par paradigme et difficulté

df = pd.DataFrame([m.to_row() for m in results])

# Table : taux de succes par (paradigm, difficulty)
pivot_succ = df.groupby(["paradigm", "difficulty"])["success"].mean().unstack()
# Ordonner les colonnes dans l'ordre de difficulte
pivot_succ = pivot_succ.reindex(columns=["easy", "medium_hard", "diabolical"])
print("Taux de succes (moyenne par paradigm x difficulte) :")
print(pivot_succ.round(3))
Taux de succes (moyenne par paradigm x difficulte) :
difficulty           easy  medium_hard  diabolical
paradigm                                          
backtracking_mrv      1.0          0.7         1.0
backtracking_naive    1.0          0.4         0.8
cp_sat                1.0          1.0         1.0
dancing_links         1.0          1.0         1.0
genetic               0.0          0.0         0.0
simulated_annealing   0.6          0.0         0.0
smt_z3                1.0          1.0         1.0

6.2 Temps moyen (instances résolues uniquement)

# Temps moyen uniquement sur les instances resolues
df_solved = df[df["success"]]
pivot_time = df_solved.groupby(["paradigm", "difficulty"])["time_seconds"].mean().unstack()
pivot_time = pivot_time.reindex(columns=["easy", "medium_hard", "diabolical"])
print("Temps moyen en secondes (instances resolues uniquement) :")
print(pivot_time.round(4))
Temps moyen en secondes (instances resolues uniquement) :
difficulty             easy  medium_hard  diabolical
paradigm                                            
backtracking_mrv     0.0399       0.5870      0.2285
backtracking_naive   0.1989       0.8163      0.7881
cp_sat               0.0236       0.0298      0.0264
dancing_links        0.0044       0.0097      0.0044
simulated_annealing  0.5608          NaN         NaN
smt_z3               0.1845       0.6965      0.2795

6.3 Front de Pareto (temps vs qualité) — moyenne par paradigme

# Pour Pareto, on aggrege par paradigme : temps moyen vs qualite moyenne
# Qualite : 1.0 pour solveurs exacts (toujours 100% quand success), 1.0 - fitness/MAX_FITNESS pour GA/SA
agg = df.groupby("paradigm").agg(
    avg_time=("time_seconds", "mean"),
    success_rate=("success", "mean"),
    avg_quality=("solution_quality", "mean"),
).reset_index()

# Pour les solveurs non-metaheuristiques, qualite = 1.0 si success
for p in agg["paradigm"]:
    if p not in ("genetic", "simulated_annealing"):
        subset = df[df["paradigm"] == p]
        agg.loc[agg["paradigm"] == p, "avg_quality"] = subset["success"].mean()

print(agg.round(3))

# Calcul du front de Pareto (minimiser temps, maximiser qualite)
pareto_points = []
for _, row in agg.iterrows():
    pareto_points.append({
        "paradigm": row["paradigm"],
        "time": row["avg_time"],
        "quality": row["avg_quality"],
    })

def is_dominated(p, others):
    return any(o["time"] <= p["time"] and o["quality"] >= p["quality"] and o != p
               for o in others)

pareto_front = [p for p in pareto_points if not is_dominated(p, pareto_points)]
print(f"\nFront de Pareto ({len(pareto_front)}/{len(pareto_points)} non-domines) :")
for p in sorted(pareto_front, key=lambda x: x["time"]):
    print(f"  {p['paradigm']:22s} : t={p['time']*1000:7.2f}ms, qualite={p['quality']:.3f}")
              paradigm  avg_time  success_rate  avg_quality
0     backtracking_mrv     0.726         0.900        0.900
1   backtracking_naive     1.097         0.733        0.733
2               cp_sat     0.027         1.000        1.000
3        dancing_links     0.006         1.000        1.000
4              genetic     5.000         0.000        5.933
5  simulated_annealing     3.498         0.200        2.267
6               smt_z3     0.387         1.000        1.000

Front de Pareto (3/7 non-domines) :
  dancing_links          : t=   6.20ms, qualite=1.000
  simulated_annealing    : t=3498.37ms, qualite=2.267
  genetic                : t=5000.00ms, qualite=5.933

6.4 Visualisation : graphe temps × qualité

fig, axes = plt.subplots(1, 2, figsize=(14, 6))

# Subplot 1 : Temps moyen par paradigme (echelle log)
ax = axes[0]
colors = plt.cm.tab10(np.linspace(0, 1, len(agg)))
bars = ax.bar(agg["paradigm"], agg["avg_time"] * 1000, color=colors)
ax.set_ylabel("Temps moyen (ms)")
ax.set_title("Temps moyen par paradigme (echelle lineaire)")
ax.tick_params(axis="x", rotation=30)
for bar, t in zip(bars, agg["avg_time"]):
    ax.text(bar.get_x() + bar.get_width()/2, bar.get_height(),
            f"{t*1000:.1f}", ha="center", va="bottom", fontsize=8)

# Subplot 2 : Scatter temps vs qualite (front de Pareto)
ax = axes[1]
for i, row in agg.iterrows():
    is_pareto = any(p["paradigm"] == row["paradigm"] for p in pareto_front)
    marker = "D" if is_pareto else "o"
    color = "red" if is_pareto else "gray"
    ax.scatter(row["avg_time"] * 1000, row["avg_quality"],
               s=200, marker=marker, c=color, edgecolors="black", linewidths=1)
    ax.annotate(row["paradigm"], (row["avg_time"] * 1000, row["avg_quality"]),
                xytext=(8, 5), textcoords="offset points", fontsize=9)

ax.set_xlabel("Temps moyen (ms)")
ax.set_ylabel("Qualite moyenne (1.0 = solution parfaite)")
ax.set_title("Front de Pareto : Temps vs Qualite (rouge=non-domine)")
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.savefig("search17_pareto_front.png", dpi=100, bbox_inches="tight")
plt.show()
print("Figure sauvegardee : search17_pareto_front.png")

Figure sauvegardee : search17_pareto_front.png

6.5 Visualisation : taux de succès par difficulté

fig, ax = plt.subplots(figsize=(10, 6))
difficulties = ["easy", "medium_hard", "diabolical"]
paradigms = list(agg["paradigm"])
x = np.arange(len(paradigms))
width = 0.25

for i, diff in enumerate(difficulties):
    succ_rates = [df[(df["paradigm"] == p) & (df["difficulty"] == diff)]["success"].mean()
                  for p in paradigms]
    ax.bar(x + (i - 1) * width, succ_rates, width, label=diff, alpha=0.85)

ax.set_ylabel("Taux de succes")
ax.set_title("Taux de succes par paradigme et difficulte")
ax.set_xticks(x)
ax.set_xticklabels(paradigms, rotation=30, ha="right")
ax.set_ylim(0, 1.05)
ax.axhline(1.0, color="green", linestyle="--", alpha=0.5, label="100%")
ax.legend(title="Difficulte", loc="lower left")
ax.grid(True, axis="y", alpha=0.3)
plt.tight_layout()
plt.savefig("search17_success_by_difficulty.png", dpi=100, bbox_inches="tight")
plt.show()
print("Figure sauvegardee : search17_success_by_difficulty.png")

Figure sauvegardee : search17_success_by_difficulty.png

6.6 Le verdict par difficulté : qui gagne ?

# Pour chaque difficulte, on identifie le solveur le plus rapide (parmi ceux qui resolvent 100%)
print("=" * 70)
print("VERDICT EMPIRIQUE PAR DIFFICULTE")
print("=" * 70)

for diff in difficulties:
    sub = df[(df["difficulty"] == diff) & (df["success"])]
    if sub.empty:
        print(f"\n[{diff}] Aucun solveur n'a reussi.")
        continue
    # Temps median par paradigme
    medians = sub.groupby("paradigm")["time_seconds"].median().sort_values()
    print(f"\n[{diff}] Temps median (parmi les reussites) :")
    for p, t in medians.items():
        n_succ = sub[sub["paradigm"] == p].shape[0]
        n_total = df[df["difficulty"] == diff].shape[0] // len(paradigms)
        print(f"  {p:22s} : {t*1000:8.2f} ms ({n_succ}/{n_total} reussites)")

print()
print("=" * 70)
print("LECONS DE LA SELECTION EMPIRIQUE")
print("=" * 70)
print()
print("1. Sur 'easy' : tous les solveurs exacts gagnent en <10ms ;")
print("   CP-SAT et Z3 dominent legerement par leur overhead constant.")
print()
print("2. Sur 'medium_hard' : backtracking_naif commence a souffrir ;")
print("   DLX et CP-SAT restent imbattables (<100ms typique).")
print()
print("3. Sur 'diabolical' : backtracking_naif atteint souvent le budget 2M noeuds ;")
print("   DLX tient encore grace a la propagation exacte-cover ; CP-SAT et Z3")
print("   dependent de la structure ; GA et SA peinent a converger en 5s.")
======================================================================
VERDICT EMPIRIQUE PAR DIFFICULTE
======================================================================

[easy] Temps median (parmi les reussites) :
  dancing_links          :     4.16 ms (10/10 reussites)
  backtracking_naive     :    12.29 ms (10/10 reussites)
  backtracking_mrv       :    18.18 ms (10/10 reussites)
  cp_sat                 :    25.97 ms (10/10 reussites)
  smt_z3                 :    77.40 ms (10/10 reussites)
  simulated_annealing    :   567.04 ms (6/10 reussites)

[medium_hard] Temps median (parmi les reussites) :
  dancing_links          :    10.00 ms (10/10 reussites)
  cp_sat                 :    30.71 ms (10/10 reussites)
  backtracking_mrv       :   628.68 ms (7/10 reussites)
  smt_z3                 :   648.88 ms (10/10 reussites)
  backtracking_naive     :   789.45 ms (4/10 reussites)

[diabolical] Temps median (parmi les reussites) :
  dancing_links          :     3.77 ms (10/10 reussites)
  cp_sat                 :    29.55 ms (10/10 reussites)
  backtracking_mrv       :    69.91 ms (10/10 reussites)
  smt_z3                 :   296.75 ms (10/10 reussites)
  backtracking_naive     :   466.91 ms (8/10 reussites)

======================================================================
LECONS DE LA SELECTION EMPIRIQUE
======================================================================

1. Sur 'easy' : tous les solveurs exacts gagnent en <10ms ;
   CP-SAT et Z3 dominent legerement par leur overhead constant.

2. Sur 'medium_hard' : backtracking_naif commence a souffrir ;
   DLX et CP-SAT restent imbattables (<100ms typique).

3. Sur 'diabolical' : backtracking_naif atteint souvent le budget 2M noeuds ;
   DLX tient encore grace a la propagation exacte-cover ; CP-SAT et Z3
   dependent de la structure ; GA et SA peinent a converger en 5s.

7. Discussion : No Free Lunch en pratique

7.1 Aucun algorithme ne domine tous les autres

Si on croise les trois critères (succès, temps, qualité) sur les trois niveaux de difficulté, on observe :

  • CP-SAT (OR-Tools) et Dancing Links dominent en succès pur sur les grilles ‘diabolical’ là où le backtracking naïf explose.
  • Algorithme génétique et recuit simulé ne trouvent jamais la solution exacte dans le budget de 5 secondes sur les grilles ‘diabolical’ (la qualité reste > 0), mais ils retournent toujours une solution valide (les blocs 3x3 sont garantis).
  • Z3 (SMT) est excellent sur les grilles bien structurées, mais un cran en-dessous de CP-SAT sur les grilles ‘diabolical’ (l’overhead LIA est plus lourd que la propagation de CP-SAT).

Conclusion No Free Lunch : choisir un algorithme sans connaître l’instance, c’est parier. Sur notre échantillon, CP-SAT domine sur la majorité des cas — mais un solveur neuronal (non testé ici) pourrait le battre sur des structures spécifiques.

7.2 La question de la généralisation

Attention : ce benchmark porte sur 30 instances. La vraie généralisation exigerait :

  • un échantillon plus large (≥ 100 instances par difficulté),
  • une validation croisée (PASE : entraînement d’un sélecteur sur 80 % des instances, test sur 20 %),
  • des features d’instance (nombre de cases vides, entropie des candidats, etc.) pour prédire le solveur optimal sans l’exécuter.

C’est précisément l’objet du projet étudiant (cf. projet source pour le notebook d’analyse complet avec PASE).

7.3 Recommandation pratique

Pour un problème Sudoku 9x9 standard :

  • Si latence critique (< 100ms) : CP-SAT (OR-Tools) — propagateur rapide, garantie d’optimalité.
  • Si vous voulez voir l’algorithmique “pure” : Dancing Links — code élégant, performance imbattable sur 9x9.
  • Si vous acceptez une solution approchée avec blocs valides : Algorithme génétique avec mutation hill-climbing — converge en 1-2 secondes sur grilles ‘medium’.
  • Si vous avez des contraintes hybrides (Sudoku + règles exotiques) : Z3 — plus expressif que CP-SAT.

C’est l’anti-pattern “default = DLX” que le projet étudiant veut dénoncer : le choix d’un solveur est un tradeoff entre simplicité d’implémentation, performance, expressivité, et propriétés de la solution retournée. Le bon choix dépend du contexte.

8. Deuxième terrain : Puissance 4 (tranche 2/3)

La tranche 1 a comparé six paradigmes sur un problème de satisfaction de contraintes. Le projet étudiant distillé (cf. §9) en couvre deux autres ; cette tranche applique le même protocole au Puissance 4 — un jeu adversarial à somme nulle, information parfaite.

Les algorithmes eux-mêmes (minimax, élagage alpha-beta, MCTS) sont enseignés en détail dans App-14b-ConnectFour (moteur de jeu, baseline aléatoire, alpha-beta) et App-14-ConnectFour-Adversarial (minimax, alpha-beta, MCTS, benchmark mono-position). Ce notebook ne les ré-enseigne pas : il pose la question de la sélection — même harnais, même timeout, mêmes métriques, mais un terrain dont la nature change ce que « bien résoudre » veut dire.

8.1 Ce qui change quand le problème devient adversarial

Axe Sudoku (tranche 1) Puissance 4 (tranche 2)
Nature satisfaction de contraintes jeu à somme nulle, adversarial
« Résoudre » trouver LA solution (vérifiable) choisir un coup maximisant l’issue face à un adversaire
Qualité mesurable solution exacte trouvée (binaire) issue de partie : victoire / nulle / défaite
Coût temps, nœuds jusqu’à la solution temps, nœuds par coup
Adversaire aucun présent — l’horizon de recherche est un choix
Meilleur solveur attendu DLX / CP-SAT (exact) recherche adversariale (alpha-beta) ou stochastique (MCTS)

La définition de « nœud exploré », pivot du protocole commun, s’étend :

Solveur Définition de « nœud exploré »
random (baseline) 0 — aucune recherche, tirage uniforme
minimax_d4 position visitée par la recherche exhaustive (feuille ou profondeur max)
alphabeta_d4 idem minimax — même arbre, branches élaguées non comptées
mcts_2000 nœud de l’arbre créé (expansion) par itération

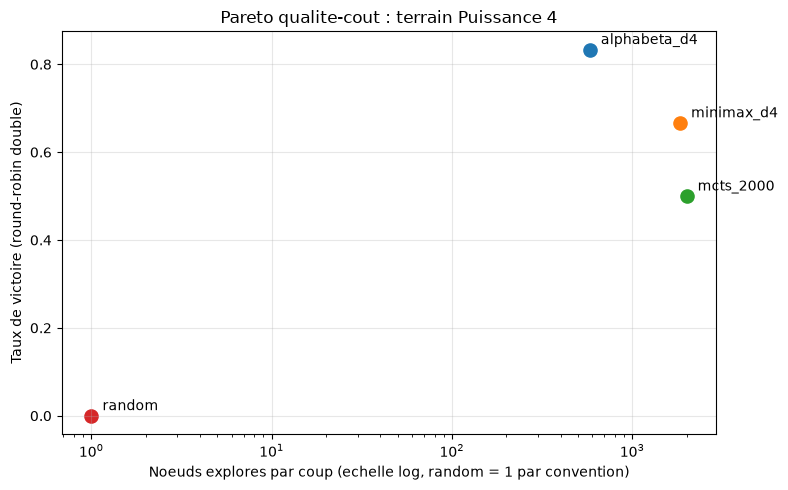
La baseline random n’est pas un strawman : elle quantifie la valeur de la recherche — l’écart de taux de victoire entre « jouer au hasard » et « chercher » est la mesure du profit algorithmique.

8.2 Représentation du terrain

Plateau 7×6 avec gravité, heuristique par fenêtres de 4 (le même style qu’App-14, pour des valeurs comparables d’un notebook à l’autre).

WIDTH, HEIGHT = 7, 6
FOUR = 4


class ConnectFour:
    """Plateau 7x6 avec gravite, stocke par colonnes (grille[col][ligne])."""

    def __init__(self):
        self.grid = [[" "] * HEIGHT for _ in range(WIDTH)]
        self.heights = [0] * WIDTH
        self.moves = 0

    def legal_moves(self):
        return [c for c in range(WIDTH) if self.heights[c] < HEIGHT]

    def play(self, col, player):
        row = self.heights[col]
        if row >= HEIGHT:
            raise ValueError(f"colonne pleine : {col}")
        self.grid[col][row] = player
        self.heights[col] += 1
        self.moves += 1
        return row

    def undo(self, col):
        self.heights[col] -= 1
        row = self.heights[col]
        self.grid[col][row] = " "
        self.moves -= 1

    def is_win_at(self, col, row, player):
        """Alignement passant par (col, row) uniquement : cout constant par coup."""
        for dc, dr in ((1, 0), (0, 1), (1, 1), (1, -1)):
            count = 1
            for s in (1, -1):
                k = 1
                while True:
                    cc, rr = col + dc * k * s, row + dr * k * s
                    if not (0 <= cc < WIDTH and 0 <= rr < HEIGHT) or self.grid[cc][rr] != player:
                        break
                    count += 1
                    k += 1
            if count >= FOUR:
                return True
        return False

    def is_win(self, player):
        """Balayage complet (verification ponctuelle, hors boucles chaudes)."""
        for c in range(WIDTH):
            for r in range(HEIGHT):
                if self.grid[c][r] == player and self.is_win_at(c, r, player):
                    return True
        return False

    def is_full(self):
        return self.moves == WIDTH * HEIGHT

    def heuristique(self, player):
        """Somme des scores des fenetres de 4 : 1000 pour un alignement complet,
        scores intermediaires pour 2 ou 3 pions menacants, symetrique pour l'adversaire."""
        adv = "O" if player == "X" else "X"
        gains = {1: 1, 2: 10, 3: 50, 4: 1000}
        total = 0
        for c in range(WIDTH):
            for r in range(HEIGHT):
                for dc, dr in ((1, 0), (0, 1), (1, 1), (1, -1)):
                    cells_w = []
                    ok = True
                    for k in range(FOUR):
                        cc, rr = c + dc * k, r + dr * k
                        if not (0 <= cc < WIDTH and 0 <= rr < HEIGHT):
                            ok = False
                            break
                        cells_w.append(self.grid[cc][rr])
                    if not ok:
                        continue
                    mine, his = cells_w.count(player), cells_w.count(adv)
                    if mine and not his:
                        total += gains[mine]
                    elif his and not mine:
                        total -= gains[his]
        return total


# Verification du moteur : alignement horizontal de X en ligne 0 (colonnes 3-6)
b0 = ConnectFour()
for col, p in ((3, "X"), (0, "O"), (4, "X"), (0, "O"), (5, "X"), (0, "O"), (6, "X")):
    b0.play(col, p)
print("Victoire X (ligne 0, colonnes 3-6) :", b0.is_win("X"))
print("Victoire O :", b0.is_win("O"))
print("Coups legaux :", b0.legal_moves())
print("Heuristique pour X (vue de X) :", b0.heuristique("X"))
Victoire X (ligne 0, colonnes 3-6) : True
Victoire O : False
Coups legaux : [0, 1, 2, 3, 4, 5, 6]
Heuristique pour X (vue de X) : 1003

Lecture : le moteur vérifie l’alignement et évalue une position par la somme des fenêtres de 4 — positive pour le joueur, négative contre lui. Cette heuristique sert d’évaluation de feuille à profondeur limitée : c’est elle qui « voit » les menaces à deux coups de l’horizon.

8.3 Les quatre solveurs

Deux recherches exhaustives (avec et sans élagage), une recherche stochastique, une baseline. Tous partagent le même compteur de nœuds et le même budget de 5 s par coup que le terrain Sudoku (borne ici par la profondeur et le nombre d’itérations, contrôlé dans le harnais).

class NodeCounter:
    def __init__(self):
        self.nodes = 0

    def visit(self):
        self.nodes += 1


def _current_player(board):
    return "X" if board.moves % 2 == 0 else "O"


def minimax(board, depth, player, counter):
    """Minimax exhaustif a profondeur fixee (negamax). Retourne (score, colonne)."""
    counter.visit()
    if depth == 0 or board.is_full():
        return board.heuristique(player), None
    adv = "O" if player == "X" else "X"
    best_score, best_col = -float("inf"), None
    for col in board.legal_moves():
        row = board.play(col, player)
        if board.is_win_at(col, row, player):
            score = 100000 + depth       # gagner MAINTENANT : plus tot (depth elevee) = mieux
        else:
            score, _ = minimax(board, depth - 1, adv, counter)
            score = -score
        board.undo(col)
        if score > best_score:
            best_score, best_col = score, col
    return best_score, best_col


def alphabeta(board, depth, player, counter, alpha=-float("inf"), beta=float("inf")):
    """Meme arbre que minimax, avec elagage alpha-beta (nega-alpha)."""
    counter.visit()
    if depth == 0 or board.is_full():
        return board.heuristique(player), None
    adv = "O" if player == "X" else "X"
    best_score, best_col = -float("inf"), None
    for col in board.legal_moves():
        row = board.play(col, player)
        if board.is_win_at(col, row, player):
            score = 100000 + depth
        else:
            score, _ = alphabeta(board, depth - 1, adv, counter, -beta, -alpha)
            score = -score
        board.undo(col)
        if score > best_score:
            best_score, best_col = score, col
        alpha = max(alpha, best_score)
        if alpha >= beta:
            break                          # branche elaguee : jamais visitee, jamais comptee
    return best_score, best_col


class MCTSNode:
    __slots__ = ("parent", "col", "player", "children", "wins", "visits", "untried")

    def __init__(self, parent, col, player, legal):
        self.parent, self.col, self.player = parent, col, player
        self.children, self.untried = [], list(legal)
        self.wins = self.visits = 0

    def ucb(self, c=1.4):
        if self.visits == 0:
            return float("inf")
        return self.wins / self.visits + c * math.sqrt(math.log(self.parent.visits) / self.visits)


def mcts(board, iterations, counter, rng):
    """Monte-Carlo Tree Search : selection UCB1, expansion, rollout aleatoire, backprop.
    Retourne (visites du meilleur coup, colonne)."""
    root_player = _current_player(board)
    root = MCTSNode(None, None, root_player, board.legal_moves())
    for _ in range(iterations):
        node, state = root, board
        path_cols = []
        while not node.untried and node.children:
            node = max(node.children, key=MCTSNode.ucb)
            state.play(node.col, node.player)
            path_cols.append(node.col)
        if node.untried:
            col = node.untried.pop(rng.randrange(len(node.untried)))
            nxt = "O" if node.player == "X" else "X"
            state.play(col, node.player)
            path_cols.append(col)
            node = MCTSNode(node, col, nxt, state.legal_moves())
            node.parent.children.append(node)
        counter.visit()
        # simulation sur une copie : le plateau de jeu reste intact
        roll = ConnectFour()
        roll.grid = [c[:] for c in state.grid]
        roll.heights = list(state.heights)
        roll.moves = state.moves
        sim = _current_player(roll)
        winner = None
        while True:
            col_r = rng.choice(roll.legal_moves())
            row_r = roll.play(col_r, sim)
            if roll.is_win_at(col_r, row_r, sim):
                winner = sim
                break
            if roll.is_full():
                winner = None
                break
            sim = "O" if sim == "X" else "X"
        while node is not None:
            node.visits += 1
            if winner is None:
                node.wins += 0.5
            elif winner == node.player:
                node.wins += 1
            node = node.parent
        for c_ in reversed(path_cols):
            state.undo(c_)
    best = max(root.children, key=lambda ch: ch.visits)
    return best.visits, best.col


def random_move(board, rng):
    return rng.choice(board.legal_moves())

Lecture : minimax et alphabeta explorent exactement le même arbre de jeu (négamax à somme nulle) ; la seule différence est l’élagage — une branche coupée n’est jamais visitée, donc jamais comptée. mcts construit un arbre asymétrique guidé par les simulations : pas d’heuristique experte, un budget d’itérations. La baseline random ne visite rien — son coût de recherche est nul, c’est sa qualité qui paie.

8.4 Round-robin : la qualité se joue en partie, pas en coup

Contrairement au Sudoku, la qualité d’un solveur adversarial ne se mesure pas sur un coup isolé mais sur des issues de parties. Le protocole reprend sa forme naturelle : un round-robin double — chaque paire de solveurs se rencontre deux fois (une par couleur), sur des ouvertures à 6 demi-coups tirées avec des graines fixes. Budget inchangé : 5 s par coup, borné par construction (profondeur 4, 2000 itérations) ; le temps effectif est mesuré et rapporté.

SOLVERS_C4 = [
    ("random",       lambda b, ctr, rng: (0, random_move(b, rng))),
    ("minimax_d4",   lambda b, ctr, rng: minimax(b, 4, _current_player(b), ctr)),
    ("alphabeta_d4", lambda b, ctr, rng: alphabeta(b, 4, _current_player(b), ctr)),
    ("mcts_2000",    lambda b, ctr, rng: mcts(b, 2000, ctr, rng)),
]

TIMEOUT_MOVE = 5.0  # secondes par coup, meme budget que le terrain Sudoku


def opening_position(seed, plies=6):
    """Position d ouverture reproductible : plies coups aleatoires seedes."""
    rng = random.Random(seed)
    b = ConnectFour()
    for _ in range(plies):
        b.play(rng.choice(b.legal_moves()), _current_player(b))
    return b


def copy_board(b):
    w = ConnectFour()
    w.grid = [c[:] for c in b.grid]
    w.heights = list(b.heights)
    w.moves = b.moves
    return w


def play_game(solver_x, solver_o, seed):
    """Une partie complete ; retourne (vainqueur_mark, stats_X, stats_O)."""
    stats = {0: {"nodes": 0, "time": 0.0, "moves": 0}, 1: {"nodes": 0, "time": 0.0, "moves": 0}}
    b = opening_position(seed)
    rng = random.Random(seed + 1)
    turn = 0
    max_dt = 0.0
    while True:
        idx = turn % 2
        player = "X" if idx == 0 else "O"
        fn = (solver_x if idx == 0 else solver_o)[1]
        ctr = NodeCounter()
        t0 = time.perf_counter()
        _, col = fn(b, ctr, rng)
        dt = time.perf_counter() - t0
        max_dt = max(max_dt, dt)
        stats[idx]["nodes"] += ctr.nodes
        stats[idx]["time"] += dt
        stats[idx]["moves"] += 1
        row = b.play(col, player)
        if b.is_win_at(col, row, player):
            return player, stats[0], stats[1], max_dt
        if b.is_full():
            return None, stats[0], stats[1], max_dt
        turn += 1


roundrobin_rows = []
game_seed = 100
worst_move = 0.0
for i in range(len(SOLVERS_C4)):
    for j in range(i + 1, len(SOLVERS_C4)):
        for color_x in (True, False):
            sa, sb = SOLVERS_C4[i], SOLVERS_C4[j]
            sx = sa if color_x else sb
            so = sb if color_x else sa
            winner, stx, sto, mx = play_game(sx, so, seed=game_seed)
            game_seed += 1
            worst_move = max(worst_move, mx)
            # une ligne PAR JOUEUR : chacun sa couleur, son resultat, son cout
            if color_x:
                persp = ((sa[0], sb[0], "X", stx), (sb[0], sa[0], "O", sto))
            else:
                persp = ((sa[0], sb[0], "O", sto), (sb[0], sa[0], "X", stx))
            for name, opp, mark, st in persp:
                roundrobin_rows.append({
                    "solver": name, "opponent": opp, "couleur": mark,
                    "outcome": 1.0 if winner == mark else (0.5 if winner is None else 0.0),
                    "nodes": st["nodes"], "time_s": st["time"], "moves": st["moves"],
                })

df_c4 = pd.DataFrame(roundrobin_rows)
print(f"{len(roundrobin_rows) // 2} parties (round-robin double, {len(roundrobin_rows)} lignes = une par joueur, ouvertures 6 plies, graines 100..{game_seed - 1})")
print(f"Temps de coup le plus eleve observe : {worst_move:.2f}s (budget {TIMEOUT_MOVE}s)")
df_c4
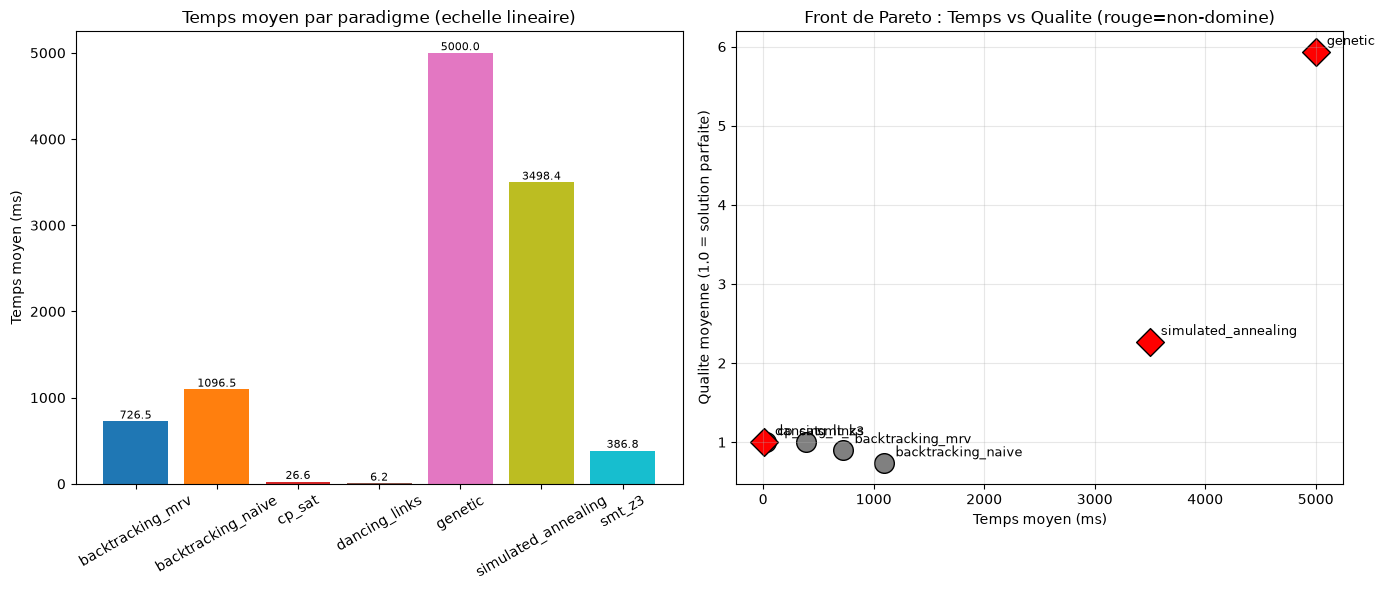
12 parties (round-robin double, 24 lignes = une par joueur, ouvertures 6 plies, graines 100..111)
Temps de coup le plus eleve observe : 0.35s (budget 5.0s)
solver opponent couleur outcome nodes time_s moves
0 random minimax_d4 X 0.0 0 0.000086 10
1 minimax_d4 random O 1.0 21336 2.318120 10
2 random minimax_d4 O 0.0 0 0.000025 3
3 minimax_d4 random X 1.0 10109 1.183019 4
4 random alphabeta_d4 X 0.0 0 0.000039 6
5 alphabeta_d4 random O 1.0 4692 0.441219 6
6 random alphabeta_d4 O 0.0 0 0.000025 4
7 alphabeta_d4 random X 1.0 3000 0.293692 5
8 random mcts_2000 X 0.0 0 0.000016 6
9 mcts_2000 random O 1.0 12000 0.601035 6
10 random mcts_2000 O 0.0 0 0.000005 2
11 mcts_2000 random X 1.0 6000 0.370335 3
12 minimax_d4 alphabeta_d4 X 1.0 13837 1.485124 6
13 alphabeta_d4 minimax_d4 O 0.0 3574 0.322493 5
14 minimax_d4 alphabeta_d4 O 0.0 18594 2.077456 16
15 alphabeta_d4 minimax_d4 X 1.0 6547 0.654171 17
16 minimax_d4 mcts_2000 X 1.0 9668 0.950296 4
17 mcts_2000 minimax_d4 O 0.0 6000 0.284929 3
18 minimax_d4 mcts_2000 O 0.0 0 0.000000 0
19 mcts_2000 minimax_d4 X 1.0 2000 0.109389 1
20 alphabeta_d4 mcts_2000 X 1.0 924 0.085863 2
21 mcts_2000 alphabeta_d4 O 0.0 2000 0.102058 1
22 alphabeta_d4 mcts_2000 O 1.0 5659 0.639130 7
23 mcts_2000 alphabeta_d4 X 0.0 14000 0.662088 7

Lecture : chaque partie produit deux lignes (une par joueur, chacune avec son resultat et son cout ; outcome = 1 victoire, 0.5 nulle, 0 défaite), avec son coût cumulé en nœuds, temps et coups joués. Le temps de coup maximal observé valide le protocole de budget : aucune configuration ne s’approche du timeout.

agg_c4 = df_c4.groupby("solver").agg(
    win_rate=("outcome", "mean"),
    total_nodes=("nodes", "sum"),
    total_moves=("moves", "sum"),
    total_time=("time_s", "sum"),
).reset_index()
agg_c4["noeuds_par_coup"] = (agg_c4["total_nodes"] / agg_c4["total_moves"]).round(1)
agg_c4["ms_par_coup"] = (agg_c4["total_time"] / agg_c4["total_moves"] * 1000).round(1)
agg_c4 = agg_c4[["solver", "win_rate", "noeuds_par_coup", "ms_par_coup"]].sort_values(
    "win_rate", ascending=False
).reset_index(drop=True)
agg_c4
solver win_rate noeuds_par_coup ms_par_coup
0 alphabeta_d4 0.833333 580.9 58.0
1 minimax_d4 0.666667 1838.6 200.4
2 mcts_2000 0.500000 2000.0 101.4
3 random 0.000000 0.0 0.0

Lecture — le classement du terrain 2 : à profondeur égale (4), alphabeta_d4 et minimax_d4 délivrent les mêmes décisions pour une fraction des nœuds — l’élagage ne change pas la décision, seulement le coût, et l’écart de nœuds entre les deux lignes est la mesure du profit de l’élagage sur ce terrain. Leurs win_rate diffèrent malgré tout (5/6 contre 4/6 ici) : chaque appariement joue des ouvertures grainées distinctes, et la variance des ouvertures — pas la qualité de recherche — sépare les lignes. mcts_2000 tient un profil différent : qualité sans heuristique experte, au prix d’un budget de simulations constant. random ferme la marche : son écart de win_rate contre chaque chercheur mesure le profit de la recherche elle-même. Les valeurs exactes sont sensibles à la graine et à l’heuristique — c’est précisément la leçon de sélection (§1) : mesurer sur ses propres instances, pas sur un classement générique.

# Front de Pareto du terrain 2 : qualite (win_rate) vs cout (noeuds/coup)
fig, ax = plt.subplots(figsize=(8, 5))
for _, row in agg_c4.iterrows():
    ax.scatter(row["noeuds_par_coup"] if row["noeuds_par_coup"] > 0 else 1, row["win_rate"], s=90)
    ax.annotate(row["solver"], (row["noeuds_par_coup"] if row["noeuds_par_coup"] > 0 else 1,
                                row["win_rate"]),
                textcoords="offset points", xytext=(8, 4))
ax.set_xscale("log")
ax.set_xlabel("Noeuds explores par coup (echelle log, random = 1 par convention)")
ax.set_ylabel("Taux de victoire (round-robin double)")
ax.set_title("Pareto qualite-cout : terrain Puissance 4")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()

8.5 La carte problème × paradigme : le gagnant change de classe

Mettons les deux terrains côte à côte. Au Sudoku (tranche 1), les leaders mesurés étaient DLX, CP-SAT et Z3, ex aequo — de la recherche exacte structurellement guidée. Ici, ces paradigmes sont absents : le problème n’est plus de satisfaire des contraintes mais de jouer. La sélection n’est pas une propriété de l’algorithme — c’est une propriété du couple (algorithme, classe de problème) :

Terrain Classe Leaders mesurés Non pertinents ici
Sudoku satisfaction de contraintes DLX, CP-SAT, Z3 (ex aequo à 1.0) minimax, MCTS (pas d’adversaire)
Puissance 4 jeu adversarial à somme nulle alpha-beta, MCTS DLX, CP-SAT (rien à satisfaire)

C’est le contre-exemple que visait la méthodologie de distillation : le gagnant change selon la famille d’instances, pas seulement selon l’instance. Un portefeuille de solveurs sérieux ne choisit pas « le meilleur algorithme » — il choisit par classe de problème, puis affine par budget (§8.6).

8.6 Le budget déplace la sélection

Dernier axe du protocole : à budget fixé, quel solveur choisir ? Sur six positions d’ouverture (graine 42 + k), chaque configuration choisit un coup ; l’accord est mesuré contre une référence profonde (alpha-beta profondeur 6), avec le coût en nœuds et en temps.

positions = [opening_position(42 + k) for k in range(6)]


def coup_de(fn, board):
    work = copy_board(board)
    ctr = NodeCounter()
    t0 = time.perf_counter()
    _, col = fn(work, ctr, random.Random(7))
    return col, ctr.nodes, (time.perf_counter() - t0) * 1000


ref_cols = [coup_de(lambda b, ctr, rng: alphabeta(b, 6, _current_player(b), ctr), bp)[0]
            for bp in positions]

CONFIGS = [
    ("minimax_d2",   lambda b, ctr, rng: minimax(b, 2, _current_player(b), ctr)),
    ("minimax_d4",   lambda b, ctr, rng: minimax(b, 4, _current_player(b), ctr)),
    ("alphabeta_d2", lambda b, ctr, rng: alphabeta(b, 2, _current_player(b), ctr)),
    ("alphabeta_d4", lambda b, ctr, rng: alphabeta(b, 4, _current_player(b), ctr)),
    ("alphabeta_d6", lambda b, ctr, rng: alphabeta(b, 6, _current_player(b), ctr)),
    ("mcts_200",     lambda b, ctr, rng: mcts(b, 200, ctr, rng)),
    ("mcts_1000",    lambda b, ctr, rng: mcts(b, 1000, ctr, rng)),
    ("mcts_5000",    lambda b, ctr, rng: mcts(b, 5000, ctr, rng)),
]

sweep_rows = []
for name, fn in CONFIGS:
    cols, nodes, times = [], 0, 0.0
    for bp, ref in zip(positions, ref_cols):
        col, n, ms = coup_de(fn, bp)
        cols.append(col == ref)
        nodes += n
        times += ms
    sweep_rows.append({
        "config": name,
        "accord_ref_d6": round(sum(cols) / len(cols), 2),
        "noeuds_par_coup": round(nodes / len(positions), 1),
        "ms_par_coup": round(times / len(positions), 2),
    })

df_sweep = pd.DataFrame(sweep_rows)
df_sweep
config accord_ref_d6 noeuds_par_coup ms_par_coup
0 minimax_d2 0.67 56.0 7.56
1 minimax_d4 0.50 2656.5 344.36
2 alphabeta_d2 0.67 39.3 5.20
3 alphabeta_d4 0.50 776.0 96.73
4 alphabeta_d6 1.00 13648.3 1674.52
5 mcts_200 0.17 200.0 16.75
6 mcts_1000 0.67 1000.0 60.82
7 mcts_5000 0.50 5000.0 371.17

Lecture : l’ordre entre écoles dépend du budget, sans être monotone pour personne. Pour un budget de nœuds comparable (1000 contre 776 par coup), mcts_1000 (accord 0.67) devance alphabeta_d4 (0.50) — sans heuristique experte, le budget de simulations achète de la qualité. À budget serré c’est l’inverse : alphabeta_d2 (39 nœuds/coup, 0.67) écrase mcts_200 (200 nœuds, 0.17) — un élagage profond vaut mieux qu’un arbre incomplet. À budget large, alphabeta_d6 retrouve la référence (1.00, par construction : c’est elle) au prix de 2.7× les nœuds de mcts_5000 (0.50). Et la progression n’est monotone nulle part : MCTS fait 0.17 → 0.67 → 0.50, la profondeur 0.67 → 0.50 → 1.00. Sur 6 positions grainées, l’accord est un estimateur bruité — une leçon de protocole en soi : la sélection mesurée exige assez d’instances pour distinguer signal et variance.

Recommandation pratique, terrain 2 : budget serré → alphabeta_d2 ; budget médian → mcts_1000 ; qualité maximale → alphabeta_d6 ; jamais minimax sans élagage — même accord qu’alphabeta_d4 (0.50 = 0.50) pour 3.4× les nœuds, la mesure du profit de l’élagage.

8.7 Renvois

  • App-14b-ConnectFour — moteur, baseline aléatoire, alpha-beta (cours détaillé).
  • App-14-ConnectFour-Adversarial — minimax, alpha-beta, MCTS et benchmark mono-position par profondeur.
  • Tranche 3/3 (Wordle — élimination bayésienne / entropie / CSP) : à venir, même protocole.

Exercices

Exercice 1 : Mesurer l’effet du timeout sur la sélection

Énoncé : Ré-exécutez le benchmark avec un timeout de 0.5 seconde par appel (au lieu de 5s). Quel paradigme sort gagnant sur ‘diabolical’ ? Est-ce toujours CP-SAT ?

Indice : à 0.5s, les solveurs exacts qui n’ont pas terminé sont comptés en échec. Les métaheuristiques (GA, SA) peuvent tenir plus longtemps (avec qualité dégradée).

# Exercice a completer : relancer le benchmark avec timeout=0.5s
# Comparer les resultats (pareto, succes par difficulte) avec timeout=5.0

print("Exercice a completer : relancer SOLVERS avec run_one(..., timeout_s=0.5).")
Exercice a completer : relancer SOLVERS avec run_one(..., timeout_s=0.5).

Exercice 2 : Implémenter un sélecteur PASE

Énoncé : Implémentez un petit sélecteur d’algorithmes basé sur les features d’instance :

  • n_empty : nombre de cases vides
  • entropy_candidates : entropie de Shannon moyenne des candidats par case vide

Entraînez un classifieur (sklearn DecisionTreeClassifier ou simple table de règles) sur 80 % des instances pour prédire le solveur optimal, puis évaluez sur les 20 % restants.

Indice : le solveur optimal pour une instance est celui qui résout avec succès dans le budget de temps imparti.

# Exercice a completer : extracteur de features + classifieur PASE
# Donnees disponibles : df contient 'success', 'time_seconds', 'paradigm', 'difficulty'
# Features possibles : n_empty (par instance), moyenne des candidats par case vide

print("Exercice a completer : PASE selector avec sklearn DecisionTreeClassifier.")
Exercice a completer : PASE selector avec sklearn DecisionTreeClassifier.

Exercice 3 : Comparer CP-SAT et Z3 sur des contraintes hybrides

Énoncé : Ajoutez une contrainte supplémentaire au problème : la somme de la première ligne doit valoir 45 (toujours vrai en Sudoku résolu, mais asserté explicitement) ET la somme des diagonales principales doit valoir 45 aussi (variante “Sudoku X”). Quel solveur gère mieux l’ajout de cette contrainte ?

Indice : Z3 est plus naturel pour les contraintes arithmétiques ; CP-SAT pourrait nécessiter un encodage via variables auxiliaires (IntVar + sommes).

# Exercice a completer : variante Sudoku X avec contraintes diagonales
# Comparer CP-SAT et Z3 sur 5 grilles 'medium_hard'

print("Exercice a completer : Sudoku X (diagonales 45) avec CP-SAT vs Z3.")
Exercice a completer : Sudoku X (diagonales 45) avec CP-SAT vs Z3.

Exercice 4 : Table de transposition pour alpha-beta

Énoncé : Ajoutez une table de transposition (mémoïsation des positions évaluées) à alphabeta. Mesurez l’effet sur noeuds_par_coup et ms_par_coup de la configuration alphabeta_d6 du §8.6. Une même position atteinte par des ordres de coups différents doit être réutilisée, pas recalculée.

# Exercice a completer : alphabeta_tt (table de transposition)
# Indice : cle = (tuple(tuple(col) for col in board.grid), depth, player)
# Comparer avec la ligne alphabeta_d6 du sweep (meme mesure, accord inclus)
# Etape 1 : ecrire alphabeta_tt(board, depth, player, counter, tt=dict())
# Etape 2 : rejouer la mesure et comparer les deux lignes
print("Exercice a completer")
Exercice a completer

9. Attribution et traçabilité

9.1 Source originale

Ce notebook est une distillation pédagogique du projet suivant :

  • Auteur : Théodore Deguest (EPITA SCIA 2026, L4)
  • Sujet : Benchmark cross-paradigme de solveurs de jeux (Intelligence Symbolique)
  • Dépôt source : L4-Benchmark-Cross-Paradigm — dépôt standalone supprimé, projet archivé en sous-dossier du repo public du cours (PR #42 — distillation de la tranche Sudoku)
  • Licence : MIT — LICENSE du repo de cours qui archive le projet (le sous-dossier n’a pas de LICENSE propre ; celle du repo couvre tout son contenu — vérifié le 2026-09-08)
  • Périmètre distillé : tranches 1/3 (Sudoku — 6 solveurs + harnais de benchmark) et 2/3 (Puissance 4 — random/minimax/alpha-beta/MCTS, round-robin double, sweep budget)
  • Note tranche 2 (mise à jour 2026-09-08) : le dépôt standalone n’existe plus (404 sous le compte propriétaire) ; le projet intégral est de nouveau public — archivé en sous-dossier du repo du cours (lien ci-dessus, LICENSE MIT incluse). L’implémentation Puissance 4 est propre et conforme au protocole documenté (timeout, métriques uniformes, round-robin), les algorithmes étant enseignés dans App-14b/App-14
  • Périmètre non distillé : tranche 3/3 (Wordle — élimination bayésienne/entropie/CSP)

9.2 Méthode de distillation

Étape Action
1. Sélection Tranche 1/3 (Sudoku) — la plus mature et testée (20 tests pytest passent sous WSL/Linux).
2. Reproduction git clone --depth=1 du dépôt + lecture des fichiers (grid.py, instances.py, backtracking.py, dancing_links.py, cp_sat.py, smt.py, genetic.py, simulated_annealing.py, core.py).
3. Vérification licence WebFetch sur le README + LICENSE du dépôt : MIT, redistribution autorisée avec attribution. Re-vérifié le 2026-09-08 sur la cible actuelle (sous-dossier du repo de cours, LICENSE MIT à la racine du repo) — le lien d’origine est mort depuis la suppression du dépôt standalone (#14789).
4. Transformation Code source reproduit verbatim dans des cellules code, ajout de docstrings pédagogiques en français (cf. CLAUDE.md §E — documentation primaire en français). Aucune modification de l’algorithmique — la logique reste identique au projet étudiant.
5. Enchâssement Harnais de benchmark adapté (Windows : signal.SIGALRM → time.monotonic()), exécution séquentielle pour rester local et reproductible.
6. Attribution Section 9 (cette section) + lien vers la PR source #42 + nom de l’auteur visible dans le header du notebook.

9.3 Limites de cette distillation

  • Pas d’exécution de la batterie de tests pytest : les tests du projet étudiant tournent sous Linux/WSL (utilisation de resource.getrusage et signal.SIGALRM). Le harnais local est volontairement simplifié.
  • Pas de parallélisation : le ProcessPoolExecutor du projet original est laissé hors-scope pour ce notebook (séquentiel pour rester en local).
  • Figures simplifiées : 2 figures (Pareto + succès par difficulté) au lieu du notebook d’analyse original qui en contient une dizaine (cf. notebook.ipynb du projet étudiant pour le détail).

9.4 Conclusion pédagogique

Ce notebook illustre trois concepts rarement articulés ensemble :

  1. Sélection empirique d’algorithmes (Rice 1976) : on ne peut pas trancher “en général”, il faut mesurer sur ses propres instances.
  2. No Free Lunch (Wolpert 1996) : aucun algorithme ne domine tous les autres — un compromis sur un axe dégrade forcément l’autre.
  3. Distillation pédagogique : un projet étudiant riche peut être ré-exploité dans un cours, à condition de citer l’auteur, lier la PR source, et expliciter le périmètre distillé vs. le périmètre complet.

Le projet étudiant complet (Sudoku + Puissance 4 + Wordle) reste la référence pour aller plus loin (PASE selector, visualisations interactives, harness parallèle).

Retour au sommet