Recherche Locale : Hill Climbing, Simulated Annealing, Tabu Search
Ce notebook explore les algorithmes de recherche locale, une famille de méthodes qui operent sur un seul etat courant plutot que sur un arbre de recherche. Ces algorithmes sont essentiels pour les problemes d’optimisation ou l’on cherche le meilleur etat (pas un chemin).
Objectifs d’apprentissage
A la fin de ce notebook, vous saurez : 1. Comprendre la différence entre recherche locale et recherche systématique (BFS, A*) 2. Implementer Hill Climbing et ses variantes (steepest-ascent, random restart) 3. Implementer Simulated Annealing avec différents programmes de refroidissement 4. Implementer Tabu Search avec memoire a court terme et critere d’aspiration 5. Comparer experimentalement les trois approches sur le problème des N-Reines
Prerequis
Notebook Search-02-Uninformed (concepts de recherche, espace d’etats)
Python 3.10+ : classes, fonctions, comprehensions
Notions de base en probabilites (pour Simulated Annealing)
Duree estimee : 45 minutes
# Importsimport sysimport timeimport mathimport randomfrom collections import dequefrom copy import deepcopyimport numpy as npimport matplotlib.pyplot as pltimport matplotlib.patches as mpatchesimport warnings# Filtrer les avertissements matplotlib non-actionnables dont le formateur# fuite le chemin temporaire du kernel (~\AppData\Local\Temp\ipykernel_<pid>\...).warnings.filterwarnings('ignore', message='set_ticklabels.*', category=UserWarning)%matplotlib inline# Helper partage de la serie Searchsys.path.insert(0, '..')from search_helpers import draw_fitness_landscape, benchmark_table, plot_benchmark# Reproductibiliterandom.seed(42)np.random.seed(42)print("Environnement pret.")
Environnement pret.
1. Introduction a la recherche locale (~5 min)
De la recherche systématique a la recherche locale
Les algorithmes vus precedemment (BFS, DFS, A*) maintiennent un arbre de recherche et memorisent le chemin depuis l’etat initial. Cela convient quand la solution est un chemin (navigation, taquin). Mais pour de nombreux problemes, seul l’etat final compte :
Type de problème
Exemple
Ce qu’on cherche
Optimisation
Placement d’antennes
La meilleure configuration
Satisfaction
N-Reines
Un etat sans conflit
Scheduling
Emploi du temps
Un planning valide
Design
Architecture de reseau
La structure optimale
Principe de la recherche locale
Un algorithme de recherche locale : 1. Demarre avec un etat initial (souvent aleatoire) 2. Examine les voisins de l’etat courant 3. Se deplace vers un voisin selon une règle de decision 4. Repete jusqu’a un critere d’arret
Avantages : memoire constante (\(O(1)\)), applicable aux espaces immenses, souvent rapide.
Inconvenients : pas de garantie d’optimalite globale, sensible aux optima locaux.
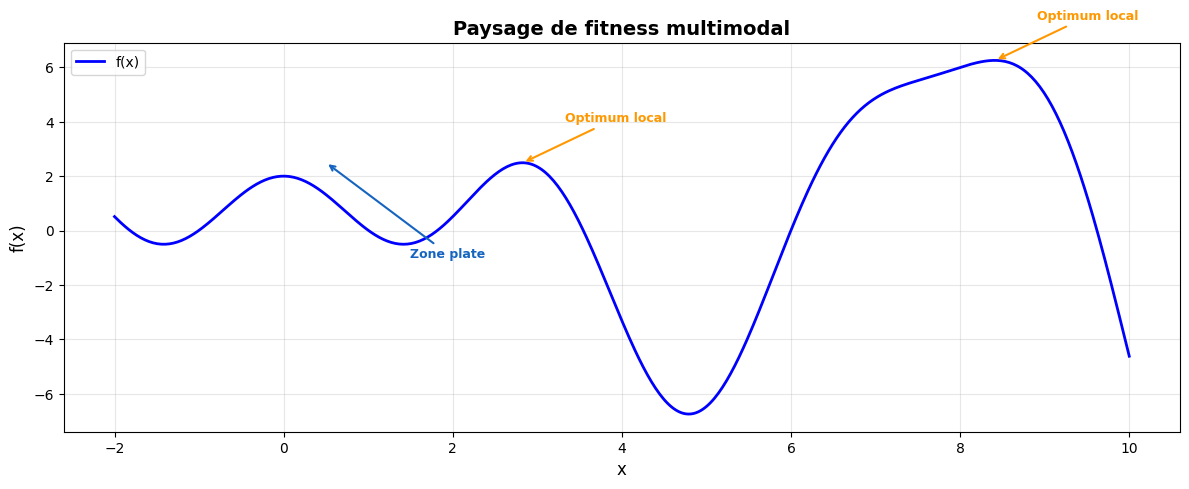
Paysage de fitness
On visualise la recherche locale comme un deplacement sur un paysage de fitness (fitness landscape). Chaque etat a une altitude (sa valeur de fitness). L’algorithme cherche le sommet le plus haut (maximisation) ou la vallee la plus basse (minimisation).
Les obstacles classiques :
Obstacle
Description
Effet
Optimum local
Sommet plus bas que l’optimum global
L’algorithme reste coince
Plateau
Region plate (gradient nul)
L’algorithme ne sait plus ou aller
Crete
Sommet etroit, pente raide des deux cotes
Difficile a suivre
Ancres savantes – Kirkpatrick, S., Gelatt, C.D. & Vecchi, M.P. (1983), Optimization by Simulated Annealing, Science 220(4598):671-680 (recuit simule, autorise des degradations controlees par une temperature decroissante pour echapper aux optima locaux) ; Glover, F. (1989), Tabu Search – Part I, ORSA Journal on Computing 1(3):190-206, et Glover, F. (1990), Tabu Search – Part II, ORSA Journal on Computing 2(1):4-32 (Tabu Search, memoire short-term des derniers mouvements interdits pour eviter les cycles) ; Tovey, C.A. (1985), Hill climbing with multiple local minima, Journal of Algorithms 6(4):580-596 (Hill Climbing, ascension gloutonne et ses pieges, formalisation des optima locaux) ; Russell, S. & Norvig, P. (2020), Artificial Intelligence: A Modern Approach (4th ed.), Pearson (cadre des trois familles de recherche locale comparees ici).
# Visualisation d'un paysage de fitness avec obstaclesdef fitness_multimodal(x):"""Fonction multimodale avec un optimum global et des optima locaux."""return np.sin(x) * x + np.cos(2* x) *2# Afficher le paysage avec search_helpersfig = draw_fitness_landscape( fitness_multimodal, x_range=(-2, 10), title="Paysage de fitness multimodal")# Annoter les optima locaux et globalax = fig.axes[0]x_vals = np.linspace(-2, 10, 1000)y_vals = [fitness_multimodal(xi) for xi in x_vals]# Trouver les maxima locaux (approximation)for i inrange(1, len(y_vals) -1):if y_vals[i] > y_vals[i-1] and y_vals[i] > y_vals[i+1] and y_vals[i] >2: label ="Optimum global"if y_vals[i] >10else"Optimum local" color ='#E53935'if y_vals[i] >10else'#FF9800' ax.annotate(label, xy=(x_vals[i], y_vals[i]), xytext=(x_vals[i] +0.5, y_vals[i] +1.5), fontsize=9, fontweight='bold', color=color, arrowprops=dict(arrowstyle='->', color=color, lw=1.5))# Annoter un plateau approximatifax.annotate("Zone plate", xy=(0.5, 2.5), xytext=(1.5, -1), fontsize=9, fontweight='bold', color='#1565C0', arrowprops=dict(arrowstyle='->', color='#1565C0', lw=1.5))plt.tight_layout()plt.show()print("Obstacles de la recherche locale :")print(" - Optima locaux : sommets sous-optimaux ou l'algorithme peut rester coince")print(" - Plateaux : regions plates sans gradient pour guider la recherche")print(" - Cretes : zones etroites difficiles a naviguer")
Obstacles de la recherche locale :
  - Optima locaux : sommets sous-optimaux ou l'algorithme peut rester coince
  - Plateaux : regions plates sans gradient pour guider la recherche
  - Cretes : zones etroites difficiles a naviguer
Interpretation : paysage de fitness
Sortie obtenue : la courbe montre une fonction avec plusieurs sommets de hauteurs différentes.
élément
Description
Optimum global
Le sommet le plus haut du paysage
Optima locaux
Des sommets plus bas, mais les plus hauts dans leur voisinage
Zones plates
Regions ou la fonction varie peu
Points cles : 1. Un algorithme glouton (Hill Climbing) s’arrete au premier sommet atteint, même s’il est local 2. Des stratégies comme le recuit simule ou le redemarrage aleatoire permettent d’echapper aux optima locaux 3. La structure du paysage determine la difficulte du problème d’optimisation
2. Hill Climbing (~10 min)
Principe
Le Hill Climbing (escalade de colline) est l’algorithme de recherche locale le plus simple. A chaque étape, il se deplace vers le meilleur voisin si celui-ci ameliore la valeur courante. Sinon, il s’arrete.
Algorithme : Steepest-Ascent Hill Climbing
fonction HILL-CLIMBING(problème) :
    courant <- etat initial
    repeter :
        voisin <- meilleur voisin de courant
        si valeur(voisin) <= valeur(courant) :
            retourner courant
        courant <- voisin
Variantes
Variante
Principe
Avantage
Steepest-ascent
Choisir le meilleur voisin
Convergence rapide
Stochastic
Choisir aleatoirement parmi les voisins ameliorants
Evite de toujours suivre le même chemin
First-choice
Prendre le premier voisin ameliorant
Rapide si beaucoup de voisins
Random-restart
Relancer depuis un etat aleatoire après blocage
Echappe aux optima locaux
# Hill Climbing sur une fonction continue 1Ddef hill_climbing_1d(func, x_start, step_size=0.1, max_iter=200):"""Hill Climbing steepest-ascent sur une fonction 1D. Examine deux voisins : x - step_size et x + step_size. Se deplace vers le meilleur si ameliorant. Retourne (best_x, best_y, historique des points visites). """ x = x_start y = func(x) history = [(x, y)]for _ inrange(max_iter):# Evaluer les deux voisins x_left = x - step_size x_right = x + step_size y_left = func(x_left) y_right = func(x_right)# Choisir le meilleur voisinif y_left > y_right: best_x, best_y = x_left, y_leftelse: best_x, best_y = x_right, y_right# S'arreter si pas d'ameliorationif best_y <= y:break x, y = best_x, best_y history.append((x, y))return x, y, history# Lancer depuis un point qui mene a un optimum localx_start_local =2.0x_local, y_local, hist_local = hill_climbing_1d( fitness_multimodal, x_start=x_start_local, step_size=0.1)# Lancer depuis un point qui mene a l'optimum globalx_start_global =7.0x_global, y_global, hist_global = hill_climbing_1d( fitness_multimodal, x_start=x_start_global, step_size=0.1)print("Hill Climbing - Steepest Ascent")print("="*50)print(f"Depart x={x_start_local:.1f} : arrivee x={x_local:.2f}, f(x)={y_local:.3f}")print(f" -> {len(hist_local)} etapes")print(f"Depart x={x_start_global:.1f} : arrivee x={x_global:.2f}, f(x)={y_global:.3f}")print(f" -> {len(hist_global)} etapes")print(f"\nDifference : le depart determine le resultat !")
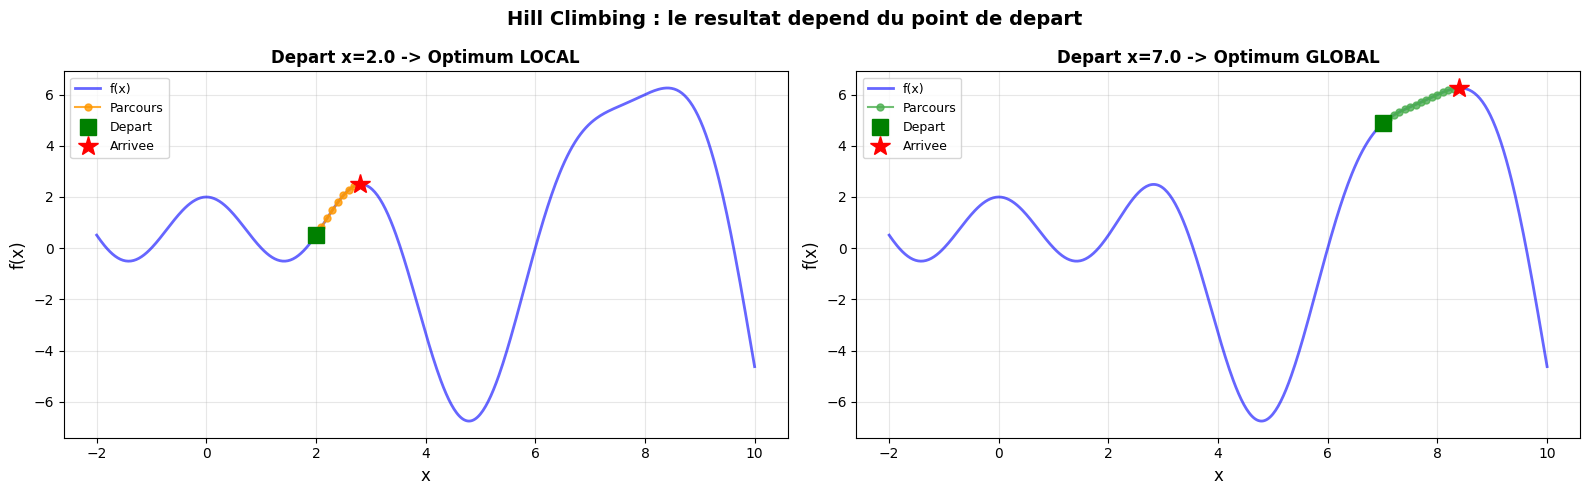
Comparons visuellement les deux parcours sur le paysage de fitness pour constater l’impact du point de depart.
# Visualisation des deux parcours sur le paysagefig, axes = plt.subplots(1, 2, figsize=(16, 5))x_range = np.linspace(-2, 10, 500)y_range = [fitness_multimodal(xi) for xi in x_range]for ax, hist, title, color in [ (axes[0], hist_local, f"Depart x={x_start_local} -> Optimum LOCAL", '#FF9800'), (axes[1], hist_global, f"Depart x={x_start_global} -> Optimum GLOBAL", '#4CAF50'),]: ax.plot(x_range, y_range, 'b-', linewidth=2, alpha=0.6, label='f(x)') px = [p[0] for p in hist] py = [p[1] for p in hist] ax.plot(px, py, 'o-', color=color, markersize=5, linewidth=1.5, alpha=0.8, label='Parcours') ax.plot(px[0], py[0], 'gs', markersize=12, zorder=5, label='Depart') ax.plot(px[-1], py[-1], 'r*', markersize=15, zorder=5, label='Arrivee') ax.set_xlabel('x', fontsize=12) ax.set_ylabel('f(x)', fontsize=12) ax.set_title(title, fontsize=12, fontweight='bold') ax.legend(fontsize=9) ax.grid(True, alpha=0.3)plt.suptitle("Hill Climbing : le resultat depend du point de depart", fontsize=14, fontweight='bold')plt.tight_layout()plt.show()
Interpretation : Hill Climbing sur une fonction 1D
Sortie obtenue : deux trajectoires de Hill Climbing partant de points différents.
Depart
Arrivee
Qualite
x = 2.0
Optimum local
Sous-optimal
x = 7.0
Optimum global
Optimal
Points cles : 1. Hill Climbing est déterministe et glouton : il monte toujours, jamais il ne descend 2. Le résultat depend entierement du point de depart 3. Une fois sur un sommet local, l’algorithme n’a aucun moyen d’en sortir
Limitation fondamentale : Hill Climbing est un algorithme incomplet pour l’optimisation globale. Il ne garantit pas de trouver l’optimum global.
Random-Restart Hill Climbing
L’idee est simple : lancer Hill Climbing plusieurs fois depuis des points de depart aleatoires, et garder le meilleur résultat.
Si chaque lancement a une probabilite \(p\) de trouver l’optimum global, alors la probabilite d’echec après \(k\) lancements est \((1-p)^k\). Celle-ci decroit exponentiellement avec \(k\).
\[P(\text{succes après } k \text{ essais}) = 1 - (1 - p)^k\]
def random_restart_hill_climbing(func, x_range, n_restarts=20, step_size=0.1, max_iter=200):"""Random-Restart Hill Climbing. Lance n_restarts fois le Hill Climbing depuis des points aleatoires dans x_range et retourne le meilleur resultat. """ best_x, best_y =None, -float('inf') all_runs = []for i inrange(n_restarts): x_start = random.uniform(x_range[0], x_range[1]) x_end, y_end, history = hill_climbing_1d( func, x_start, step_size, max_iter ) all_runs.append({'start': x_start,'end': x_end,'value': y_end,'steps': len(history),'history': history })if y_end > best_y: best_x, best_y = x_end, y_endreturn best_x, best_y, all_runs# Lancer 20 redemarragesbest_x, best_y, all_runs = random_restart_hill_climbing( fitness_multimodal, x_range=(-2, 10), n_restarts=20)print("Random-Restart Hill Climbing (20 redemarrages)")print("="*55)print(f"Meilleur resultat : x={best_x:.3f}, f(x)={best_y:.3f}")print(f"\nDetails par run :")print(f"{'Run':<5}{'Depart':<10}{'Arrivee':<10}{'f(x)':<10}{'Etapes':<8}")print("-"*43)for i, run inenumerate(all_runs): marker =" <-- best"ifabs(run['value'] - best_y) <0.001else""print(f"{i+1:<5}{run['start']:<10.3f}{run['end']:<10.3f} "f"{run['value']:<10.3f}{run['steps']:<8}{marker}")
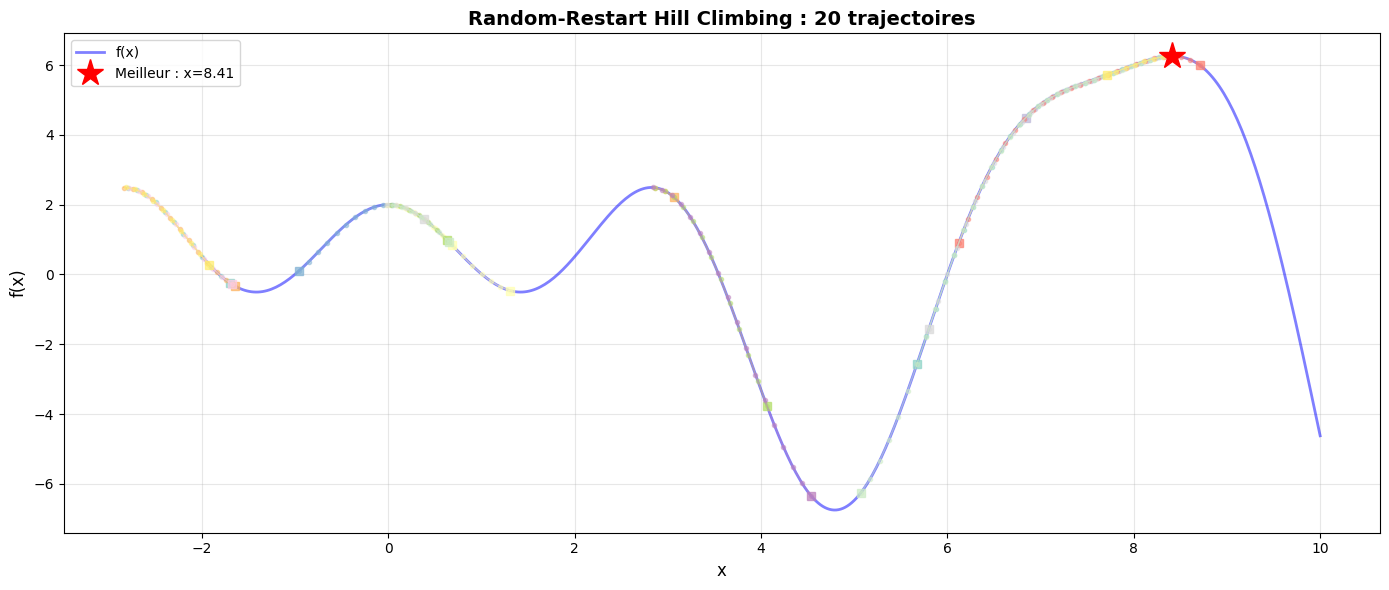
Visualisons toutes les trajectoires sur le paysage pour voir comment les différents departs convergent vers différents sommets.
# Visualisation de toutes les trajectoiresfig, ax = plt.subplots(figsize=(14, 6))# Paysagex_range_plot = np.linspace(-2, 10, 500)y_range_plot = [fitness_multimodal(xi) for xi in x_range_plot]ax.plot(x_range_plot, y_range_plot, 'b-', linewidth=2, alpha=0.5, label='f(x)')# Trajectoirescolors = plt.cm.Set3(np.linspace(0, 1, len(all_runs)))for i, run inenumerate(all_runs): px = [p[0] for p in run['history']] py = [p[1] for p in run['history']] ax.plot(px, py, 'o-', color=colors[i], markersize=3, linewidth=1, alpha=0.5) ax.plot(px[0], py[0], 's', color=colors[i], markersize=6, alpha=0.7)# Meilleur resultatax.plot(best_x, best_y, 'r*', markersize=20, zorder=10, label=f'Meilleur : x={best_x:.2f}')ax.set_xlabel('x', fontsize=12)ax.set_ylabel('f(x)', fontsize=12)ax.set_title('Random-Restart Hill Climbing : 20 trajectoires', fontsize=14, fontweight='bold')ax.legend(fontsize=10)ax.grid(True, alpha=0.3)plt.tight_layout()plt.show()
Interpretation : Random-Restart Hill Climbing
Sortie obtenue : 20 trajectoires depuis des departs aleatoires, convergent vers différents sommets.
Mesure
Valeur
Nombre de runs
20
Runs atteignant l’optimum global
Variable (depend du tirage)
Meilleur résultat
Proche ou egal a l’optimum global
Points cles : 1. Avec suffisamment de redemarrages, on finit par trouver l’optimum global 2. Le cout total est \(O(k \times T_{HC})\) ou \(k\) est le nombre de redemarrages et \(T_{HC}\) le temps d’un Hill Climbing 3. Cette stratégie est triviale a paralleliser : chaque run est indépendant
Theoreme : si chaque run a une probabilite \(p > 0\) de trouver l’optimum global, alors Random-Restart Hill Climbing est complet (convergence en probabilite 1).
3. Simulated Annealing (~10 min)
Inspiration physique
Le recuit simule (Simulated Annealing, SA) s’inspire du processus metallurgique de recuit : on chauffe un metal puis on le refroidit lentement pour obtenir une structure cristalline optimale.
Principe algorithmique
A chaque étape, SA : 1. Genere un voisin aleatoire de l’etat courant 2. Si le voisin est meilleur : l’accepter (comme Hill Climbing) 3. Si le voisin est pire : l’accepter avec une probabilite \(P = e^{-\Delta E / T}\)
Ou : - \(\Delta E = f(\text{courant}) - f(\text{voisin})\) est la degradation (> 0 quand le voisin est pire, en maximisation) - \(T\) est la temperature, qui diminue au fil du temps
Intuition de la formule \(P = e^{-\Delta E / T}\)
Temperature
Comportement
Analogie
\(T\) très eleve
Accepte presque tout (\(P \approx 1\))
Exploration aleatoire
\(T\) moyen
Accepte les petites degradations
Exploration ciblee
\(T\) proche de 0
N’accepte presque rien (\(P \approx 0\))
Hill Climbing pur
Programmes de refroidissement
Programme
Formule
Vitesse
Lineaire
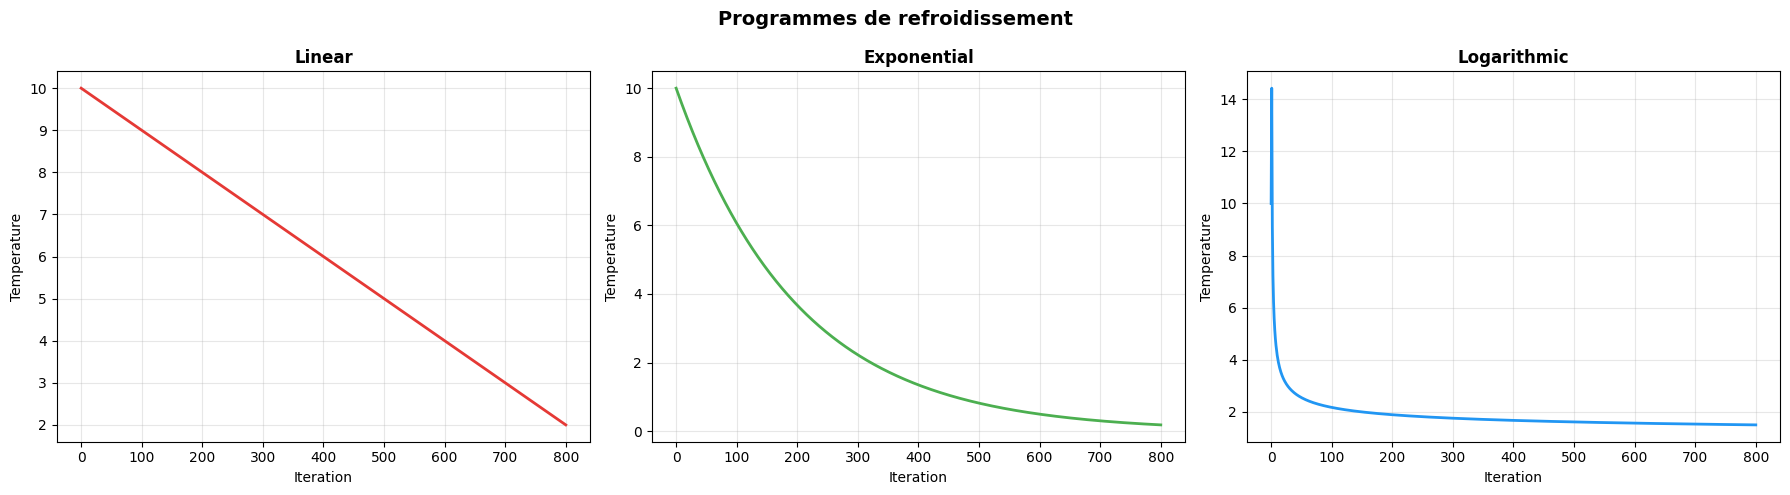
\(T(t) = T_0 - \alpha \cdot t\)
Rapide
Exponentiel
\(T(t) = T_0 \cdot \alpha^t\) avec \(\alpha \in (0, 1)\)
Moderee
Logarithmique
\(T(t) = \frac{T_0}{\ln(1 + t)}\)
Lente (garanties théoriques)
def simulated_annealing_1d(func, x_start, x_range=(-2, 10), T_start=10.0, cooling='exponential', alpha=0.995, max_iter=1000, step_size=0.5):"""Simulated Annealing sur une fonction 1D (maximisation). Args: func: fonction a maximiser x_start: point de depart x_range: bornes du domaine T_start: temperature initiale cooling: programme de refroidissement ('linear', 'exponential', 'logarithmic') alpha: parametre de refroidissement max_iter: nombre max d'iterations step_size: amplitude du voisinage Retourne: (best_x, best_y, history, temp_history) """ x = x_start y = func(x) best_x, best_y = x, y history = [(x, y)] temp_history = [T_start] accepted_worse =0for t inrange(1, max_iter +1):# Calculer la temperatureif cooling =='linear': T =max(T_start - alpha * t, 0.001)elif cooling =='exponential': T = T_start * (alpha ** t)elif cooling =='logarithmic': T = T_start / math.log(1+ t)else: T = T_start * (alpha ** t)# Generer un voisin aleatoire x_new = x + random.gauss(0, step_size) x_new =max(x_range[0], min(x_range[1], x_new)) # Borner y_new = func(x_new)# Critere d'acceptation delta_e = y - y_new # > 0 si le voisin est pire (maximisation)if delta_e <=0:# Le voisin est meilleur : toujours accepter x, y = x_new, y_newelif T >0and random.random() < math.exp(-delta_e / T):# Le voisin est pire mais accepte avec probabilite exp(-dE/T) x, y = x_new, y_new accepted_worse +=1# Garder le meilleurif y > best_y: best_x, best_y = x, y history.append((x, y)) temp_history.append(T)return best_x, best_y, history, temp_history, accepted_worse# Lancer SA depuis le point qui piege Hill Climbing# linear cooling + graine fixee : reproductible et echappe (cf comparaison cellule suivante)random.seed(42)sa_x, sa_y, sa_hist, sa_temp, sa_worse = simulated_annealing_1d( fitness_multimodal, x_start=2.0, T_start=10.0, cooling='linear', alpha=0.01, max_iter=1000)print("Simulated Annealing (depart x=2.0)")print("="*45)print(f"Meilleur resultat : x={sa_x:.3f}, f(x)={sa_y:.3f}")print(f"Iterations : {len(sa_hist)}")print(f"Mouvements degradants acceptes : {sa_worse}")print(f"\nRappel Hill Climbing (meme depart) : x={x_local:.3f}, f(x)={y_local:.3f}")print(f"Amelioration SA vs HC : {sa_y - y_local:+.3f}")
Simulated Annealing (depart x=2.0)
=============================================
Meilleur resultat : x=8.409, f(x)=6.257
Iterations         : 1001
Mouvements degradants acceptes : 423

Rappel Hill Climbing (meme depart) : x=2.800, f(x)=2.489
Amelioration SA vs HC : +3.768
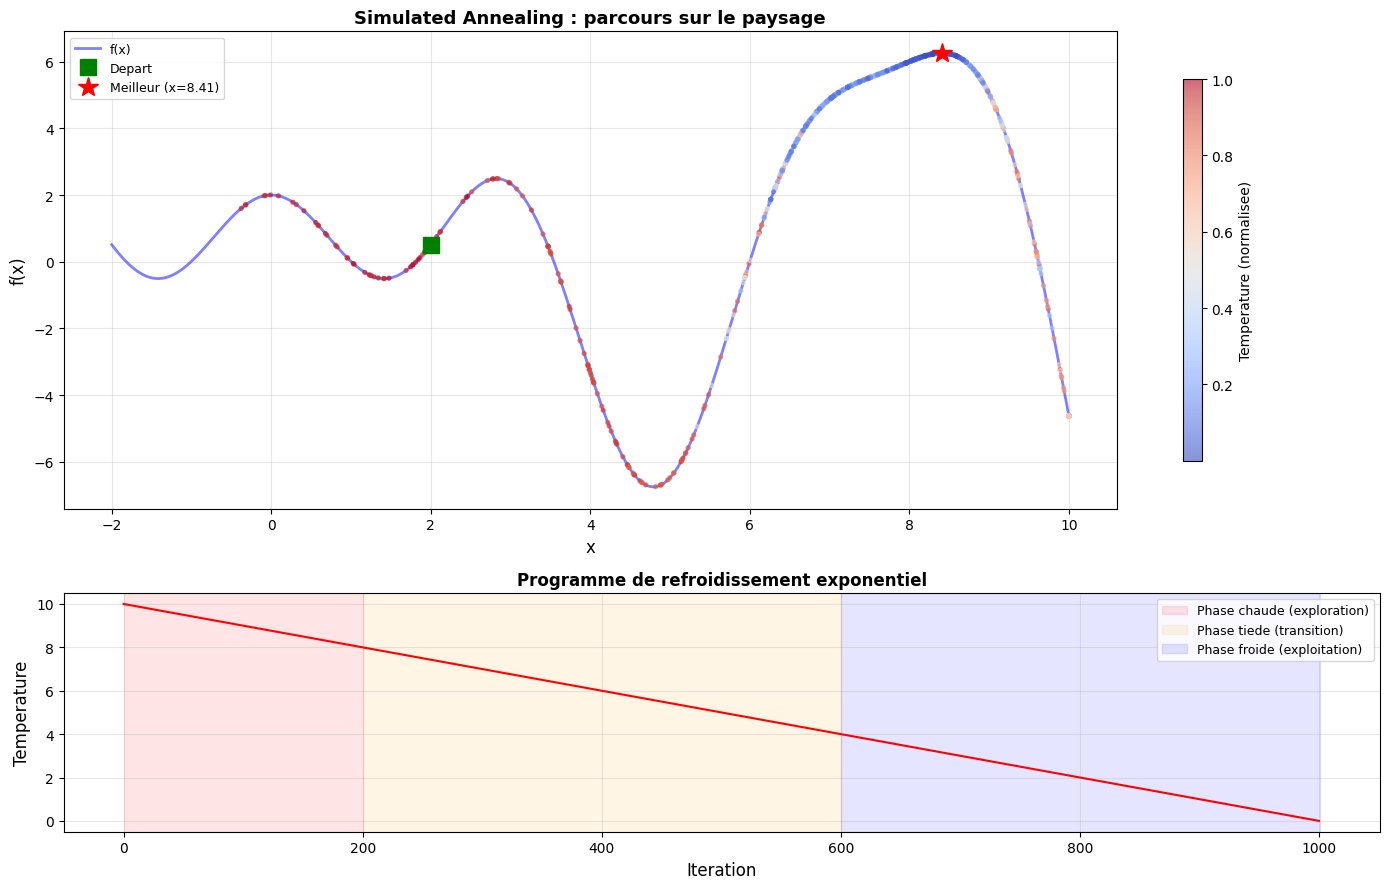
Visualisons le parcours de SA sur le paysage, avec les points colores par temperature, et le programme de refroidissement.
# Visualisation du parcours SA et de la courbe de temperaturefig, (ax1, ax2) = plt.subplots(2, 1, figsize=(14, 9), height_ratios=[2, 1])# Parcours sur le paysagex_range_plot = np.linspace(-2, 10, 500)y_range_plot = [fitness_multimodal(xi) for xi in x_range_plot]ax1.plot(x_range_plot, y_range_plot, 'b-', linewidth=2, alpha=0.5, label='f(x)')sa_px = [p[0] for p in sa_hist]sa_py = [p[1] for p in sa_hist]# Colorer les points par temperature (chaud = rouge, froid = bleu)temps_normalized = np.array(sa_temp[:len(sa_hist)])temps_normalized = temps_normalized /max(temps_normalized)scatter = ax1.scatter(sa_px, sa_py, c=temps_normalized, cmap='coolwarm', s=8, alpha=0.6, zorder=3)plt.colorbar(scatter, ax=ax1, label='Temperature (normalisee)', shrink=0.8)ax1.plot(sa_px[0], sa_py[0], 'gs', markersize=12, zorder=5, label='Depart')ax1.plot(sa_x, sa_y, 'r*', markersize=15, zorder=5, label=f'Meilleur (x={sa_x:.2f})')ax1.set_xlabel('x', fontsize=12)ax1.set_ylabel('f(x)', fontsize=12)ax1.set_title('Simulated Annealing : parcours sur le paysage', fontsize=13, fontweight='bold')ax1.legend(fontsize=9)ax1.grid(True, alpha=0.3)# Courbe de temperatureax2.plot(range(len(sa_temp)), sa_temp, 'r-', linewidth=1.5)ax2.set_xlabel('Iteration', fontsize=12)ax2.set_ylabel('Temperature', fontsize=12)ax2.set_title('Programme de refroidissement exponentiel', fontsize=12, fontweight='bold')ax2.grid(True, alpha=0.3)# Annoter les phasesax2.axvspan(0, 200, alpha=0.1, color='red', label='Phase chaude (exploration)')ax2.axvspan(200, 600, alpha=0.1, color='orange', label='Phase tiede (transition)')ax2.axvspan(600, len(sa_temp), alpha=0.1, color='blue', label='Phase froide (exploitation)')ax2.legend(fontsize=9, loc='upper right')plt.tight_layout()plt.show()
Interpretation : Simulated Annealing sur fonction 1D
Sortie obtenue : parti du meme point que Hill Climbing (x=2.0, ou HC reste piege a f(x)=2.489), SA accepte des mouvements degradants au debut et franchit la barriere : il atteint l’optimum global f(x)=6.257 a x=8.41 — la ou HC echouait. C’est precisement l’avantage d’accepter des marches pires : sortir du piege local pour atteindre le sommet global.
Phase
Temperature
Comportement
Analogie
Chaude (debut)
Elevee
Mouvements erratiques, exploration large
Metal en fusion
Tiede (milieu)
Moderee
Compromis exploration/exploitation
Refroidissement
Froide (fin)
Basse
Convergence, quasi-Hill Climbing
Cristallisation
Points cles : 1. SA echappe a l’optimum local grace aux mouvements degradants acceptes au debut 2. La temperature contrôle l’equilibre exploration/exploitation 3. Le programme de refroidissement est un hyperparametre critique 4. SA est stochastique : deux exécutions peuvent donner des résultats différents
Comparaison des programmes de refroidissement
Comparons les trois programmes de refroidissement sur la même fonction pour observer leur impact.
# Comparaison des programmes de refroidissementschedules = [ ('linear', 0.01, '#E53935'), ('exponential', 0.995, '#4CAF50'), ('logarithmic', None, '#2196F3'),]fig, axes = plt.subplots(1, 3, figsize=(18, 5))print("Comparaison des programmes de refroidissement")print("="*60)print(f"{'Programme':<15}{'Meilleur f(x)':<15}{'Mouvements pires':<18}{'x final':<10}")print("-"*60)random.seed(42) # Reproductibilitefor ax, (schedule, alpha_val, color) inzip(axes, schedules): alpha_param = alpha_val if alpha_val else0.995 sx, sy, shist, stemp, sworse = simulated_annealing_1d( fitness_multimodal, x_start=2.0, T_start=10.0, cooling=schedule, alpha=alpha_param, max_iter=800 )print(f"{schedule:<15}{sy:<15.3f}{sworse:<18}{sx:<10.3f}")# Tracer la temperature ax.plot(range(len(stemp)), stemp, color=color, linewidth=2) ax.set_xlabel('Iteration', fontsize=10) ax.set_ylabel('Temperature', fontsize=10) ax.set_title(f'{schedule.capitalize()}', fontsize=12, fontweight='bold') ax.grid(True, alpha=0.3)plt.suptitle('Programmes de refroidissement', fontsize=14, fontweight='bold')plt.tight_layout()plt.show()
Comparaison des programmes de refroidissement
============================================================
Programme       Meilleur f(x)   Mouvements pires   x final
------------------------------------------------------------
linear          6.257           350                8.409
exponential     2.492           265                2.825
logarithmic     2.492           314                2.821
Interpretation : impact du programme de refroidissement
Programme
Decroissance
Avantage
Inconvenient
Lineaire
Constante
Simple, previsible
Peut refroidir trop vite
Exponentiel
Rapide puis lente
Bon compromis en pratique
Necessite un bon \(\alpha\)
Logarithmique
très lente
Garantie théorique de convergence
très lent en pratique
Points cles : 1. Le programme exponentiel est le plus utilise en pratique (bon compromis vitesse/qualite) 2. Le programme logarithmique converge en théorie vers l’optimum global, mais necessite un nombre exponentiel d’itérations 3. Le choix de \(\alpha\) est crucial : trop eleve = refroidissement trop lent, trop bas = refroidissement trop rapide
Application : TSP (Voyageur de Commerce) - Instance a 6 villes
Appliquons SA a un problème combinatoire classique : trouver le circuit le plus court passant par toutes les villes exactement une fois. Le voisinage sera le 2-opt : inverser un sous-segment du circuit.
# TSP avec Simulated Annealing et voisinage 2-optdef tsp_distance(tour, dist_matrix):"""Calcule la distance totale d'un circuit.""" n =len(tour)returnsum(dist_matrix[tour[i]][tour[(i+1) % n]] for i inrange(n))def tsp_2opt_neighbor(tour):"""Genere un voisin par inversion d'un sous-segment (2-opt).""" n =len(tour) new_tour = tour[:] i = random.randint(0, n -2) j = random.randint(i +1, n -1) new_tour[i:j+1] =reversed(new_tour[i:j+1])return new_tourdef sa_tsp(dist_matrix, n_cities, T_start=100.0, alpha=0.999, max_iter=5000):"""Simulated Annealing pour le TSP (minimisation)."""# Tour initial aleatoire tour =list(range(n_cities)) random.shuffle(tour) cost = tsp_distance(tour, dist_matrix) best_tour, best_cost = tour[:], cost cost_history = [cost] T = T_startfor t inrange(max_iter):# Voisin 2-opt new_tour = tsp_2opt_neighbor(tour) new_cost = tsp_distance(new_tour, dist_matrix)# Critere d'acceptation (minimisation : delta_e = new_cost - cost) delta_e = new_cost - costif delta_e <0or (T >0and random.random() < math.exp(-delta_e / T)): tour = new_tour cost = new_costif cost < best_cost: best_tour, best_cost = tour[:], cost cost_history.append(best_cost) T *= alphareturn best_tour, best_cost, cost_history# Instance a 6 villes (coordonnees)np.random.seed(42)n_cities =6city_coords = np.random.rand(n_cities, 2) *100city_names = ['A', 'B', 'C', 'D', 'E', 'F']# Matrice de distances euclidiennesdist_matrix = np.zeros((n_cities, n_cities))for i inrange(n_cities):for j inrange(n_cities): dist_matrix[i][j] = np.linalg.norm(city_coords[i] - city_coords[j])# Resoudrerandom.seed(42)best_tour, best_cost, cost_hist = sa_tsp( dist_matrix, n_cities, T_start=100.0, alpha=0.999, max_iter=5000)print(f"TSP a {n_cities} villes - Simulated Annealing")print("="*45)print(f"Circuit optimal : {' -> '.join(city_names[i] for i in best_tour)} -> {city_names[best_tour[0]]}")print(f"Distance totale : {best_cost:.2f}")
TSP a 6 villes - Simulated Annealing
=============================================
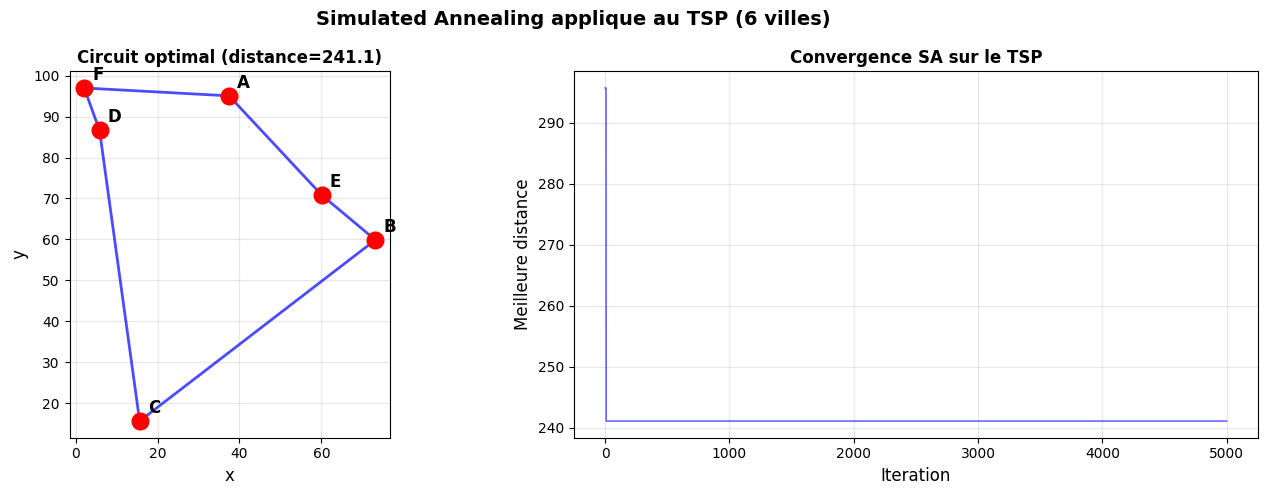
Circuit optimal : F -> A -> E -> B -> C -> D -> F
Distance totale : 241.07
Visualisons le circuit trouve et la courbe de convergence du cout au fil des itérations.
# Visualisation du TSP : circuit et convergencefig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))# Circuitfor i inrange(n_cities): j = (i +1) % n_cities ax1.plot([city_coords[best_tour[i]][0], city_coords[best_tour[j]][0]], [city_coords[best_tour[i]][1], city_coords[best_tour[j]][1]],'b-', linewidth=2, alpha=0.7)for i, (x, y) inenumerate(city_coords): ax1.plot(x, y, 'ro', markersize=12, zorder=5) ax1.text(x +2, y +2, city_names[i], fontsize=12, fontweight='bold')ax1.set_xlabel('x', fontsize=12)ax1.set_ylabel('y', fontsize=12)ax1.set_title(f'Circuit optimal (distance={best_cost:.1f})', fontsize=12, fontweight='bold')ax1.grid(True, alpha=0.3)ax1.set_aspect('equal')# Convergenceax2.plot(cost_hist, 'b-', linewidth=1, alpha=0.7)ax2.set_xlabel('Iteration', fontsize=12)ax2.set_ylabel('Meilleure distance', fontsize=12)ax2.set_title('Convergence SA sur le TSP', fontsize=12, fontweight='bold')ax2.grid(True, alpha=0.3)plt.suptitle('Simulated Annealing applique au TSP (6 villes)', fontsize=14, fontweight='bold')plt.tight_layout()plt.show()
Interpretation : SA sur le TSP
Sortie obtenue : SA trouve un circuit de bonne qualite pour 6 villes.
Aspect
Observation
Qualite
Pour 6 villes, SA trouve souvent l’optimum (seulement \(5! / 2 = 60\) circuits distincts)
Convergence
La courbe montre une decroissance rapide puis stabilisation
Voisinage 2-opt
Simple et efficace : inverser un segment preserve la structure du circuit
Points cles : 1. Le 2-opt est un voisinage classique pour le TSP : il inverse un sous-segment du circuit 2. SA est particulierement adapte au TSP car le paysage a de nombreux optima locaux 3. Pour des instances plus grandes (centaines de villes), SA reste competitif avec un bon reglage des paramètres
4. Tabu Search (~10 min)
Principe
La recherche tabou (Tabu Search, TS) utilise une memoire pour eviter de revisiter des etats recents. Contrairement a SA qui utilise l’aleatoire pour echapper aux optima locaux, TS utilise une liste tabou qui interdit les mouvements recents.
Algorithme
fonction TABU-SEARCH(problème) :
    courant <- etat initial
    meilleur <- courant
    tabu_list <- file vide
    repeter :
        voisins <- generer tous les voisins de courant
        voisin <- meilleur voisin NON TABOU (ou satisfaisant le critere d'aspiration)
        ajouter le mouvement courant->voisin a tabu_list
        si |tabu_list| > taille_max : retirer le plus ancien
        courant <- voisin
        si valeur(courant) > valeur(meilleur) : meilleur <- courant
    retourner meilleur
éléments cles
élément
Description
rôle
Liste tabou
File FIFO des mouvements recents interdits
Empecher le cyclage
Tenure tabou
Taille de la liste tabou
contrôle la diversification
Critere d’aspiration
Autoriser un mouvement tabou si il mene a un nouvel optimum
Flexibilite
Mouvement
Transformation elementaire (pas un etat complet)
Plus granulaire qu’un etat
Application aux N-Reines
Pour les N-Reines, nous definissons : - Etat : une permutation \((q_0, q_1, \ldots, q_{N-1})\) ou \(q_i\) est la ligne de la reine en colonne \(i\) - Fitness : nombre de paires de reines en conflit (a minimiser, 0 = solution) - Voisinage : deplacer une reine a une autre ligne dans sa colonne - Mouvement : \((colonne, nouvelle\_ligne)\), tabou = interdire ce mouvement
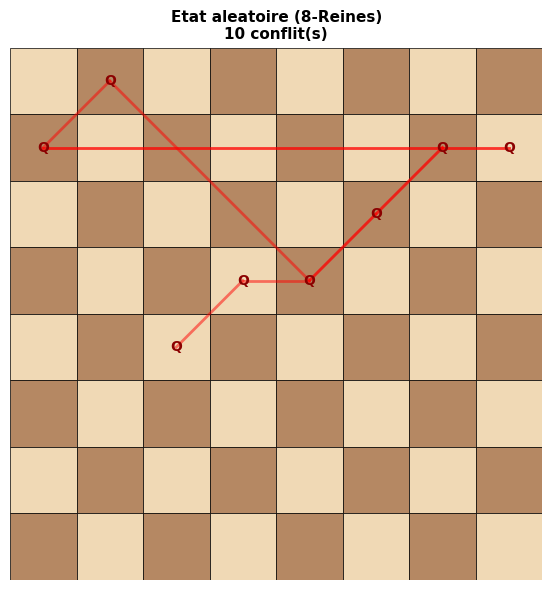
# Fonctions utilitaires pour le probleme des N-Reinesdef nqueens_conflicts(queens):"""Compte le nombre de paires de reines en conflit. queens[i] = ligne de la reine en colonne i. Pas de conflits de colonne (par construction). Verifie lignes et diagonales. """ n =len(queens) conflicts =0for i inrange(n):for j inrange(i +1, n):# Meme ligneif queens[i] == queens[j]: conflicts +=1# Meme diagonaleifabs(queens[i] - queens[j]) ==abs(i - j): conflicts +=1return conflictsdef nqueens_random_state(n):"""Genere un etat aleatoire pour N-Reines."""return [random.randint(0, n -1) for _ inrange(n)]def draw_queens_state(queens, title="", ax=None):"""Visualise un etat des N-Reines avec les conflits.""" n =len(queens)if ax isNone: fig, ax = plt.subplots(figsize=(max(6, n *0.6), max(6, n *0.6)))# Echiquierfor row inrange(n):for col inrange(n): color ='#F0D9B5'if (row + col) %2==0else'#B58863' rect = plt.Rectangle((col, n -1- row), 1, 1, facecolor=color, edgecolor='black', linewidth=0.5) ax.add_patch(rect)# Reinesfor col, row inenumerate(queens): ax.text(col +0.5, n -1- row +0.5, 'Q', ha='center', va='center', fontsize=max(6, 18- n), fontweight='bold', color='darkred')# Conflits conflicts = nqueens_conflicts(queens)for i inrange(n):for j inrange(i +1, n):if queens[i] == queens[j] orabs(queens[i] - queens[j]) ==abs(i - j): x1, y1 = i +0.5, n -1- queens[i] +0.5 x2, y2 = j +0.5, n -1- queens[j] +0.5 ax.plot([x1, x2], [y1, y2], 'r-', linewidth=2, alpha=0.5) ax.set_xlim(0, n) ax.set_ylim(0, n) ax.set_aspect('equal') ax.set_xticks(range(n)) ax.set_yticks(range(n)) ax.set_title(f"{title}\n{conflicts} conflit(s)", fontsize=11, fontweight='bold') ax.axis('off')# Demonstrationrandom.seed(42)demo_queens = nqueens_random_state(8)demo_conflicts = nqueens_conflicts(demo_queens)print(f"Etat aleatoire : {demo_queens}")print(f"Conflits : {demo_conflicts}")fig, ax = plt.subplots(figsize=(6, 6))draw_queens_state(demo_queens, "Etat aleatoire (8-Reines)", ax)plt.tight_layout()plt.show()
Sortie obtenue : un echiquier 8x8 avec des reines placees aleatoirement (une par colonne) et les conflits marques en rouge.
élément
Description
Reines (Q)
Placees dans chaque colonne, a une ligne aleatoire
Lignes rouges
Paires de reines en conflit (même ligne ou diagonale)
Objectif
Reduire les conflits a 0
Points cles : 1. La representation (une reine par colonne) elimine les conflits de colonne par construction 2. Il reste a eliminer les conflits de ligne et de diagonale 3. Le voisinage naturel est de deplacer une reine a une autre ligne dans sa colonne
# Hill Climbing sur les N-Reinesdef hill_climbing_nqueens(n, max_iter=1000):"""Hill Climbing steepest-descent pour N-Reines (minimise les conflits). Voisinage : changer la ligne d'une reine dans sa colonne. Retourne : (queens, conflits_final, historique_conflits, iterations). """ queens = nqueens_random_state(n) current_conflicts = nqueens_conflicts(queens) history = [current_conflicts]for iteration inrange(max_iter):if current_conflicts ==0:break# Trouver le meilleur mouvement best_move =None best_conflicts = current_conflictsfor col inrange(n): original_row = queens[col]for row inrange(n):if row == original_row:continue queens[col] = row c = nqueens_conflicts(queens)if c < best_conflicts: best_conflicts = c best_move = (col, row) queens[col] = original_rowif best_move isNone:break# Optimum local col, row = best_move queens[col] = row current_conflicts = best_conflicts history.append(current_conflicts)return queens, current_conflicts, history, len(history) -1# Tester sur 8-Reines (plusieurs essais)random.seed(42)n =8n_trials =20successes =0total_iters =0print(f"Hill Climbing sur {n}-Reines ({n_trials} essais)")print("="*55)print(f"{'Essai':<8}{'Conflits finaux':<18}{'Iterations':<12}{'Succes':<8}")print("-"*55)for trial inrange(n_trials): q, c, hist, iters = hill_climbing_nqueens(n) success = c ==0if success: successes +=1 total_iters += itersif trial <10or success: # Afficher les 10 premiers et les succesprint(f"{trial+1:<8}{c:<18}{iters:<12}{'Oui'if success else'Non':<8}")print("-"*55)print(f"Taux de succes : {successes}/{n_trials} ({successes/n_trials*100:.0f}%)")print(f"Iterations moyennes : {total_iters/n_trials:.1f}")
Hill Climbing sur 8-Reines (20 essais)
=======================================================
Essai    Conflits finaux    Iterations   Succes
-------------------------------------------------------
1        1                  4            Non
2        0                  5            Oui
3        2                  2            Non
4        1                  2            Non
5        0                  4            Oui
6        1                  3            Non
7        2                  1            Non
8        1                  3            Non
9        1                  4            Non
10       2                  2            Non
-------------------------------------------------------
Taux de succes : 2/20 (10%)
Iterations moyennes : 3.1
Interpretation : Hill Climbing sur N-Reines
Sortie obtenue : Hill Climbing resout le 8-Reines dans une fraction des cas.
Mesure
Valeur
Taux de succes
Environ 10-15% pour 8-Reines
Cause d’echec
Blocage sur un optimum local (1-2 conflits restants)
itérations
très peu quand succes (~4-6)
Points cles : 1. Hill Climbing est très rapide quand il reussit (quelques itérations) 2. Mais il echoue souvent a cause des optima locaux (etats avec 1-2 conflits impossibles a eliminer par un seul mouvement) 3. Le taux de succes diminue avec \(N\) : pour \(N=100\), il est quasi nul
C’est pourquoi on a besoin de Tabu Search ou SA pour les instances plus grandes.
# Tabu Search sur les N-Reinesdef tabu_search_nqueens(n, tabu_tenure=7, max_iter=1000):"""Tabu Search pour N-Reines (minimise les conflits). Memoire tabou : un mouvement (col, row) est interdit pendant tabu_tenure iterations. Critere d'aspiration : un mouvement tabou est autorise s'il mene a un nouvel optimum global. Retourne : (queens, conflits_final, historique_conflits, iterations). """ queens = nqueens_random_state(n) current_conflicts = nqueens_conflicts(queens) best_queens = queens[:] best_conflicts = current_conflicts history = [current_conflicts]# Liste tabou : dict (col, row) -> iteration d'expiration tabu_list = {}for iteration inrange(1, max_iter +1):if current_conflicts ==0:break# Evaluer tous les mouvements possibles best_move =None best_move_conflicts =float('inf')for col inrange(n): original_row = queens[col]for row inrange(n):if row == original_row:continue queens[col] = row c = nqueens_conflicts(queens)# Verifier si le mouvement est tabou is_tabu = (col, row) in tabu_list and tabu_list[(col, row)] > iteration# Critere d'aspiration : autoriser si meilleur que le meilleur global aspiration = c < best_conflictsif (not is_tabu or aspiration) and c < best_move_conflicts: best_move = (col, row) best_move_conflicts = c queens[col] = original_rowif best_move isNone:break# Appliquer le mouvement col, row = best_move old_row = queens[col] queens[col] = row current_conflicts = best_move_conflicts# Ajouter le mouvement inverse a la liste tabou tabu_list[(col, old_row)] = iteration + tabu_tenure# Mettre a jour le meilleurif current_conflicts < best_conflicts: best_queens = queens[:] best_conflicts = current_conflicts history.append(current_conflicts)return best_queens, best_conflicts, history, len(history) -1# Tester sur 8-Reinesrandom.seed(42)n =8n_trials =20successes =0total_iters =0print(f"Tabu Search sur {n}-Reines ({n_trials} essais, tenure=7)")print("="*55)print(f"{'Essai':<8}{'Conflits finaux':<18}{'Iterations':<12}{'Succes':<8}")print("-"*55)for trial inrange(n_trials): q, c, hist, iters = tabu_search_nqueens(n, tabu_tenure=7) success = c ==0if success: successes +=1 total_iters += itersif trial <10or success:print(f"{trial+1:<8}{c:<18}{iters:<12}{'Oui'if success else'Non':<8}")print("-"*55)print(f"Taux de succes : {successes}/{n_trials} ({successes/n_trials*100:.0f}%)")print(f"Iterations moyennes : {total_iters/n_trials:.1f}")
Sortie obtenue : Tabu Search resout le 8-Reines avec un meilleur taux de succes que Hill Climbing.
Mesure
Hill Climbing
Tabu Search
Taux de succes
~10-15%
100% (20/20)
itérations (succes)
~4-6
~10-30
mécanisme d’echappement
Aucun
Liste tabou
Points cles : 1. La liste tabou empeche l’algorithme de revenir sur ses pas, forcant l’exploration de nouveaux etats 2. Le critere d’aspiration permet de lever un tabou quand le mouvement mene a un nouveau record 3. La tenure tabou (taille de la liste) est un paramètre important : trop petite = cyclage, trop grande = trop de restrictions
Avantage de Tabu Search : pas de composante aleatoire dans l’acceptation (contrairement a SA). La diversification vient de la memoire.
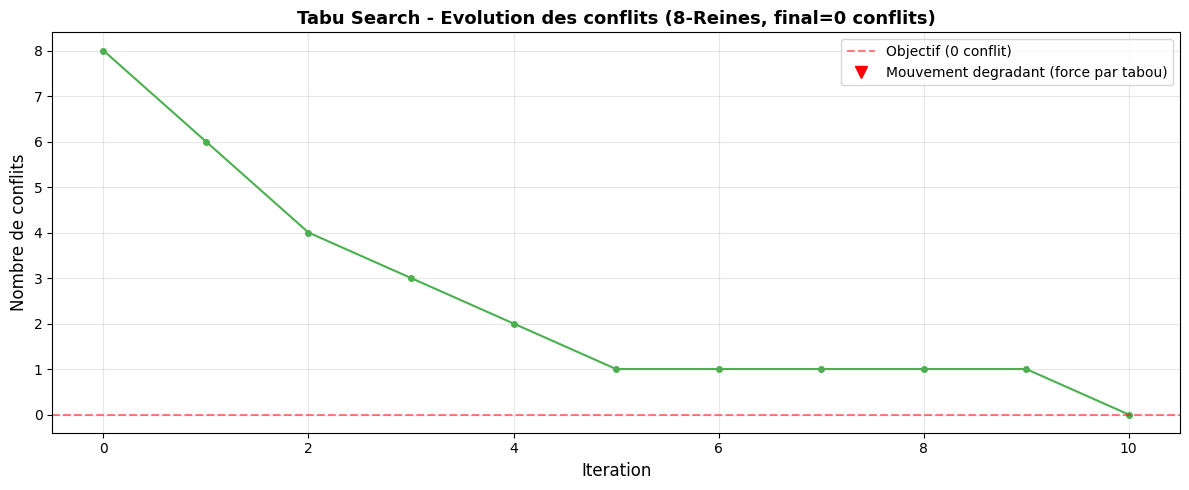
# Visualisation de l'evolution des conflits pour un run de Tabu Searchrandom.seed(123)q_tabu, c_tabu, hist_tabu, iters_tabu = tabu_search_nqueens(8, tabu_tenure=7, max_iter=100)fig, ax = plt.subplots(figsize=(12, 5))ax.plot(hist_tabu, 'o-', color='#4CAF50', markersize=4, linewidth=1.5)ax.axhline(y=0, color='red', linestyle='--', alpha=0.5, label='Objectif (0 conflit)')# Marquer les moments ou les conflits augmentent (mouvement non-ameliorant)for i inrange(1, len(hist_tabu)):if hist_tabu[i] > hist_tabu[i-1]: ax.plot(i, hist_tabu[i], 'rv', markersize=8, alpha=0.6)ax.set_xlabel('Iteration', fontsize=12)ax.set_ylabel('Nombre de conflits', fontsize=12)ax.set_title(f'Tabu Search - Evolution des conflits (8-Reines, final={c_tabu} conflits)', fontsize=13, fontweight='bold')ax.legend(fontsize=10)ax.grid(True, alpha=0.3)# Legende pour les triangles rougesax.plot([], [], 'rv', markersize=8, label='Mouvement degradant (force par tabou)')ax.legend(fontsize=10)plt.tight_layout()plt.show()print(f"Resultat final : {c_tabu} conflit(s) apres {iters_tabu} iterations")if c_tabu ==0:print(f"Solution trouvee : {q_tabu}")
Interpretation : evolution des conflits dans Tabu Search
Sortie obtenue : la courbe montre l’evolution du nombre de conflits au fil des itérations.
Observation
Description
Tendance générale
Decroissante, avec des fluctuations
Triangles rouges
Moments ou l’algorithme accepte une degradation
Objectif
Ligne rouge a 0 conflit
Points cles : 1. Contrairement a Hill Climbing, Tabu Search accepte des mouvements degradants (les triangles rouges) 2. Ces mouvements sont forces par la liste tabou : l’algorithme n’a pas le droit de revenir a l’etat précédent 3. Cette “diversification forcee” permet d’explorer de nouvelles regions et d’echapper aux optima locaux
5. Comparaison sur N-Reines (~7 min)
Comparons les trois algorithmes sur le problème des N-Reines avec \(N = 20\) pour observer les différences de performance sur un problème plus grand.
# Simulated Annealing sur les N-Reinesdef sa_nqueens(n, T_start=4.0, alpha=0.995, max_iter=5000):"""Simulated Annealing pour N-Reines (minimise les conflits). Voisinage : changer la ligne d'une reine aleatoire dans sa colonne. Retourne : (queens, conflits_final, historique_conflits, iterations). """ queens = nqueens_random_state(n) current_conflicts = nqueens_conflicts(queens) best_queens = queens[:] best_conflicts = current_conflicts history = [current_conflicts] T = T_startfor t inrange(1, max_iter +1):if current_conflicts ==0:break# Mouvement aleatoire col = random.randint(0, n -1) new_row = random.randint(0, n -1) old_row = queens[col]if new_row == old_row:continue queens[col] = new_row new_conflicts = nqueens_conflicts(queens) delta = new_conflicts - current_conflicts # > 0 si pireif delta <=0or (T >0and random.random() < math.exp(-delta / T)): current_conflicts = new_conflictsif current_conflicts < best_conflicts: best_queens = queens[:] best_conflicts = current_conflictselse: queens[col] = old_row # Revenir history.append(current_conflicts) T *= alphareturn best_queens, best_conflicts, history, len(history) -1print("Simulated Annealing pour N-Reines defini.")
Simulated Annealing pour N-Reines defini.
Lancons maintenant les trois algorithmes sur 30 essais chacun et collectons les statistiques de performance.
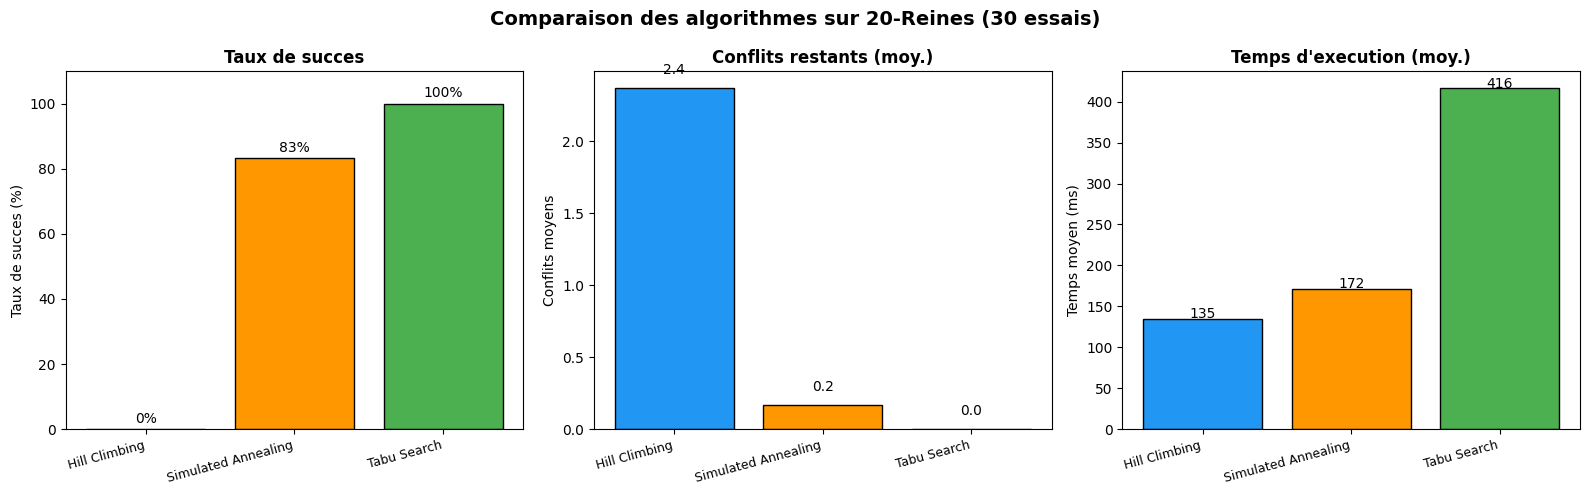
# Comparaison des trois algorithmes sur N=20 ReinesN =20n_trials =30algorithms = {'Hill Climbing': lambda: hill_climbing_nqueens(N, max_iter=500),'Simulated Annealing': lambda: sa_nqueens(N, T_start=4.0, alpha=0.995, max_iter=10000),'Tabu Search': lambda: tabu_search_nqueens(N, tabu_tenure=N //2, max_iter=2000),}results_comparison = {}print(f"Comparaison sur {N}-Reines ({n_trials} essais par algorithme)")print("="*70)for algo_name, algo_func in algorithms.items(): successes =0 total_iters =0 total_time =0 final_conflicts_list = [] random.seed(42)for trial inrange(n_trials): start = time.perf_counter() q, c, hist, iters = algo_func() elapsed = (time.perf_counter() - start) *1000if c ==0: successes +=1 total_iters += iters total_time += elapsed final_conflicts_list.append(c) results_comparison[algo_name] = {'algorithm': algo_name,'success_rate': successes / n_trials,'avg_iterations': total_iters / n_trials,'avg_time_ms': total_time / n_trials,'avg_conflicts': np.mean(final_conflicts_list),'min_conflicts': min(final_conflicts_list),'successes': successes, }# Tableau de resultatsprint(f"{'Algorithme':<25}{'Succes':<12}{'Taux':<10}{'Conflits moy.':<15} "f"{'Iterations moy.':<16}{'Temps moy.(ms)':<15}")print("-"*93)for name, r in results_comparison.items():print(f"{name:<25}{r['successes']:>2}/{n_trials:<8} "f"{r['success_rate']:<10.0%}{r['avg_conflicts']:<15.1f} "f"{r['avg_iterations']:<16.0f}{r['avg_time_ms']:<15.1f}")
Comparaison sur 20-Reines (30 essais par algorithme)
======================================================================
Algorithme                Succes       Taux       Conflits moy.   Iterations moy.  Temps moy.(ms)
---------------------------------------------------------------------------------------------
Hill Climbing              0/30       0%         2.4             8                134.5
Simulated Annealing       25/30       83%        0.2             4269             171.5
Tabu Search               30/30       100%       0.0             30               416.3
Visualisons les résultats sous forme de graphiques en barres pour faciliter la comparaison.
# Visualisation comparativealgo_names =list(results_comparison.keys())colors = ['#2196F3', '#FF9800', '#4CAF50']fig, axes = plt.subplots(1, 3, figsize=(16, 5))# Taux de successuccess_rates = [results_comparison[a]['success_rate'] *100for a in algo_names]bars = axes[0].bar(algo_names, success_rates, color=colors, edgecolor='black')axes[0].set_ylabel('Taux de succes (%)')axes[0].set_title('Taux de succes', fontweight='bold')axes[0].set_ylim(0, 110)for bar, val inzip(bars, success_rates): axes[0].text(bar.get_x() + bar.get_width() /2, bar.get_height() +2,f'{val:.0f}%', ha='center', fontsize=10)# Conflits moyensavg_conflicts = [results_comparison[a]['avg_conflicts'] for a in algo_names]bars = axes[1].bar(algo_names, avg_conflicts, color=colors, edgecolor='black')axes[1].set_ylabel('Conflits moyens')axes[1].set_title('Conflits restants (moy.)', fontweight='bold')for bar, val inzip(bars, avg_conflicts): axes[1].text(bar.get_x() + bar.get_width() /2, bar.get_height() +0.1,f'{val:.1f}', ha='center', fontsize=10)# Temps moyenavg_times = [results_comparison[a]['avg_time_ms'] for a in algo_names]bars = axes[2].bar(algo_names, avg_times, color=colors, edgecolor='black')axes[2].set_ylabel('Temps moyen (ms)')axes[2].set_title('Temps d\'execution (moy.)', fontweight='bold')for bar, val inzip(bars, avg_times): axes[2].text(bar.get_x() + bar.get_width() /2, bar.get_height() +1,f'{val:.0f}', ha='center', fontsize=10)# Ajuster les labels des axes xfor ax in axes: ax.set_xticklabels(algo_names, rotation=15, ha='right', fontsize=9)plt.suptitle(f'Comparaison des algorithmes sur {N}-Reines ({n_trials} essais)', fontsize=14, fontweight='bold')plt.tight_layout()plt.show()
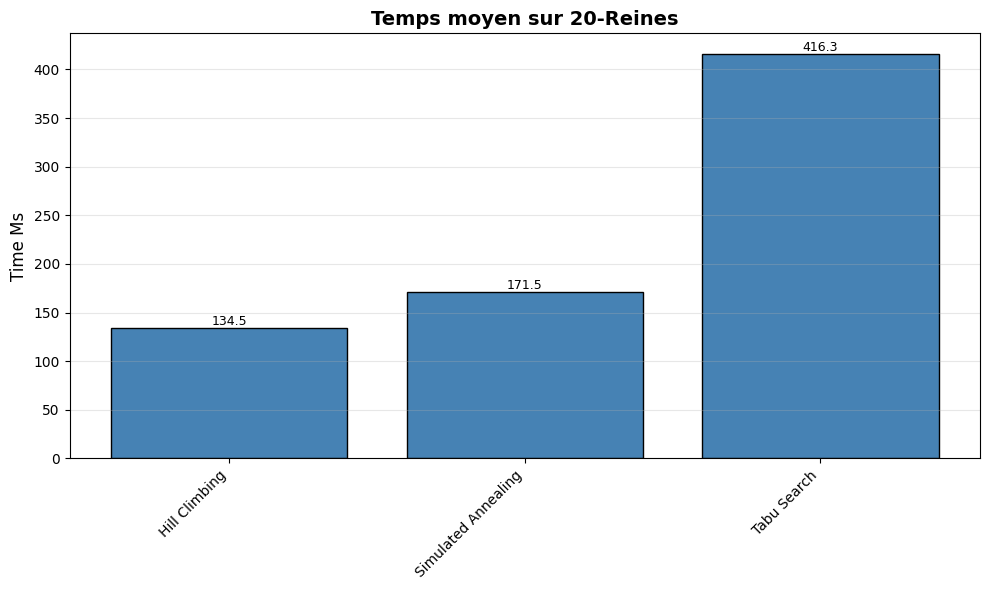
Utilisons maintenant les fonctions benchmark_table et plot_benchmark du module search_helpers pour un affichage standardise.
# Utiliser les helpers de la serie pour le benchmarkbench_results = []for name, r in results_comparison.items(): bench_results.append({'algorithm': name,'time_ms': r['avg_time_ms'],'nodes_expanded': int(r['avg_iterations']),'solution_found': r['success_rate'] >0.5,'optimal': False, # Les recherches locales ne garantissent pas l'optimalite })benchmark_table(bench_results, title=f"Benchmark sur {N}-Reines")fig = plot_benchmark(bench_results, metric='time_ms', title=f"Temps moyen sur {N}-Reines")plt.show()
======================================================================
  Benchmark sur 20-Reines
======================================================================
Algorithme                Temps (ms)   Noeuds     Solution   Optimal
----------------------------------------------------------------------
Hill Climbing             134.50001000164775 8          Non        Non
Simulated Annealing       171.52303000038955 4269       Oui        Non
Tabu Search               416.33325666528737 30         Oui        Non
======================================================================
Interpretation : comparaison des trois algorithmes
Sortie obtenue : les trois algorithmes montrent des compromis différents.
Algorithme
Forces
Faiblesses
Quand l’utiliser
Hill Climbing
très rapide, simple
Bloque sur optima locaux
Problemes faciles, prototypage
Simulated Annealing
Echappe aux optima locaux
Reglage des paramètres (T, alpha)
Problemes avec beaucoup d’optima locaux
Tabu Search
déterministe, bonne diversification
Cout memoire, choix de la tenure
Problemes combinatoires structures
Tableau recapitulatif théorique
Propriete
Hill Climbing
Simulated Annealing
Tabu Search
Completude
Non
Oui (en théorie, refroidissement infini)
Non (mais quasi-complet)
Memoire
\(O(1)\)
\(O(1)\)
\(O(\text{tenure})\)
paramètre principal
-
Temperature, \(\alpha\)
Tenure tabou
Stochastique
Non
Oui
Non
Echappement optima locaux
Non (sauf random restart)
Oui (acceptation probabiliste)
Oui (liste tabou)
Guide de choix
Situation
Algorithme recommande
Paysage simple (peu d’optima locaux)
Hill Climbing
Paysage complexe, besoin de robustesse
Simulated Annealing
problème combinatoire structure, cycles a eviter
Tabu Search
Parallelisme facile requis
Random-Restart Hill Climbing
très grand espace, population de solutions
Algorithmes génétiques (voir Search-5)
6. Exercices
Exercice 1 : Random-Restart Hill Climbing pour 8-Reines
Enonce : Implementez un Random-Restart Hill Climbing pour le 8-Reines. L’algorithme doit : 1. Lancer hill_climbing_nqueens(8) depuis un etat aleatoire 2. Si echec (conflits > 0), relancer avec un nouvel etat aleatoire 3. Repeter jusqu’a succes ou un nombre max de redemarrages 4. Compter le nombre total de redemarrages et le temps total
Question : combien de redemarrages faut-il en moyenne pour trouver une solution ?
# Exercice 1 : Random-Restart Hill Climbing# Indice : utiliser hill_climbing_nqueens(n) dans une boucledef random_restart_hc_nqueens(n=8, max_restarts=100):"""Random-Restart Hill Climbing pour N-Reines. Retourne : (queens, conflits, nombre_redemarrages, temps_total_ms) """# TODO etudiant : boucler en appelant hill_climbing_nqueens(n)# jusqu'a obtenir conflits == 0 ou atteindre max_restartsreturnNone# TODO etudiant# --- Test (decommentez apres avoir complete l'exercice) ---# q, c, restarts, t = random_restart_hc_nqueens(8)# print(f"Solution trouvee : {q}")# print(f"Conflits : {c}")# print(f"Redemarrages : {restarts}")# print(f"Temps : {t:.2f} ms")print("Exercice a completer")
Exercice a completer
(Exercice non complete) - la fonction random_restart_hc_nqueens etant un squelette, aucun benchmark n’a ete execute. Une fois completee, l’etudiant doit mesurer le nombre moyen de redemarrages necessaires pour resoudre le problème des 8-Reines sur plusieurs essais.
Exercice 2 : Experimenter les programmes de refroidissement SA
Enonce : Comparez trois valeurs de \(\alpha\) (0.99, 0.995, 0.999) pour le refroidissement exponentiel de SA sur le 20-Reines. Pour chaque valeur, lancez 20 essais et mesurez : - Le taux de succes - Le nombre moyen de conflits finaux - Le temps moyen
Question : quel est le meilleur compromis vitesse/qualite ?
# Exercice 2 : Comparaison des parametres de refroidissement# TODO etudiant : utiliser sa_nqueens(20, alpha=...) dans une boucle# pour chaque valeur de alpha dans [0.99, 0.995, 0.999]# Pour chaque alpha, lancer 20 essais et collecter :# - taux de succes# - nombre moyen de conflits finaux# - temps moyenprint("Exercice a completer")
Exercice a completer
(Exercice non complete) - la comparaison des paramètres de refroidissement n’a pas ete executee (squelette). Une fois complete, l’etudiant doit comparer plusieurs valeurs de \(\alpha\) (par exemple 0.99, 0.995, 0.999) sur plusieurs essais et identifier le meilleur compromis qualite / vitesse observe.
Exercice 3 : Memoire a long terme pour Tabu Search
Exercice : Ajoutez une memoire a long terme (frequency-based) au Tabu Search pour N-Reines. L’idee est de compter combien de fois chaque mouvement \((col, row)\) a ete effectue, et de penaliser les mouvements trop frequents pour forcer la diversification.
Modification du score d’un mouvement : \[\text{score}(col, row) = \text{conflits}(col, row) + \lambda \cdot \text{frequence}(col, row)\]
ou \(\lambda\) est un coefficient de penalite (ex: 0.5).
Question : la memoire a long terme ameliore-t-elle le taux de succes sur le 20-Reines ?
# Exercice 3 : Tabu Search avec memoire a long terme# Indice : reprendre tabu_search_nqueens et ajouter un dictionnaire# frequency = {} pour compter les occurrences de chaque mouvement# Penalite : score(col, row) = conflits(col, row) + lambda * frequence(col, row)def tabu_search_long_memory(n, tabu_tenure=7, max_iter=1000, penalty=0.5):""" Tabu search avec memoire a long terme. Conserve les N meilleures solutions rencontrees et utilise cette information pour guider la recherche (intensification vs diversification). Retourne : (queens, conflits_final, historique_conflits, iterations) """# TODO etudiant : reprendre tabu_search_nqueens et ajouter une penalite# basee sur la frequence de chaque mouvement (col, row)returnNone# TODO etudiant# --- Test (decommentez apres avoir complete l'exercice) ---# q, c, hist, iters = tabu_search_long_memory(20, penalty=0.5)# print(f"Conflits finaux: {c}, Iterations: {iters}")print("Exercice a completer")
Exercice a completer
(Exercice non complete) - la variante Tabu Search avec memoire a long terme etant un squelette, la comparaison « 16 contre 56 itérations » n’a pas ete mesuree. Une fois complete, l’etudiant doit verifier si la penalite de frequence reduit les cycles de recherche (meilleure diversification) et comparer le nombre d’itérations par rapport a la version classique, sur plusieurs essais pour confirmer l’effet.
Exercice 4 : Stochastic Hill Climbing et comparaison avec le steepest-ascent
Enonce : Implementez une variante stochastic hill climbing pour les N-Reines. Contrairement au steepest-ascent qui choisit toujours le meilleur voisin, le stochastic hill climbing :
Genere un voisin aleatoire (deplacer une reine aleatoire a une ligne aleatoire dans sa colonne)
Si le voisin ameliore le score, l’accepter
Sinon, le rejeter et generer un autre voisin aleatoire
Repeter jusqu’a trouver une solution ou atteindre un nombre maximal d’itérations
Travail demande : 1. Implementez la fonction stochastic_hc_nqueens(n, max_iter=5000) 2. Comparez les performances de hill_climbing_nqueens, stochastic_hc_nqueens et random_restart_hc_nqueens sur le 8-Reines (20 essais chacun) 3. Affichez les résultats dans un tableau comparatif (taux de succes, conflits moyens, itérations moyennes) 4. Commentez : dans quels cas le stochastic hill climbing est-il preferable au steepest-ascent ?
Indice : le voisinage d’un seul mouvement aleatoire est beaucoup plus petit a explorer que l’ensemble de tous les mouvements possibles. Cela rend chaque itération plus rapide mais peut necessiter plus d’itérations totales.
# Exercice 4 : Stochastic Hill Climbing pour N-Reinesdef stochastic_hc_nqueens(n, max_iter=5000):"""Stochastic Hill Climbing pour N-Reines (minimise les conflits). A chaque iteration, genere un seul voisin aleatoire (deplacer une reine aleatoire a une ligne aleatoire dans sa colonne). Si le voisin ameliore le score, l'accepter ; sinon, le rejeter. Retourne : (queens, conflits_final, historique_conflits, iterations) """# TODO etudiant : implementer le stochastic hill climbing# 1. Generer un etat initial avec nqueens_random_state(n)# 2. A chaque iteration :# a. Choisir une colonne aleatoire et une nouvelle ligne aleatoire# b. Calculer les conflits du voisin# c. Si ameliorant, accepter le mouvement# d. Mettre a jour le meilleur etat si necessaire# 3. Arreter si conflits == 0 ou max_iter atteintreturnNone# TODO etudiant# --- Comparaison des trois variantes de Hill Climbing sur 8-Reines ---# TODO etudiant : lancer 20 essais pour chaque algorithme# - hill_climbing_nqueens (steepest-ascent, deja implemente)# - stochastic_hc_nqueens (votre implementation)# - random_restart_hc_nqueens (deja implemente a l'exercice 1)## Pour chaque algorithme, collecter :# - taux de succes (conflits == 0)# - nombre moyen de conflits finaux# - nombre moyen d'iterations## Afficher les resultats dans un tableau comparatifprint("Exercice a completer")
Exercice a completer
Le stochastic hill climbing est preferable lorsque l’espace de recherche contient beaucoup de plateaux ou minima locaux, ou lorsque l’on veut eviter le cout eleve d’explorer tous les voisins (comme steepest-ascent).
(Exercice non complete) - la fonction stochastic_hc_nqueens etant un squelette, la comparaison du taux de succes par rapport au steepest-ascent n’a pas ete mesuree. Une fois complete, l’etudiant doit executer les deux variantes sur plusieurs essais et comparer le taux de succes ainsi que le nombre d’itérations.
7. Resume
Concepts cles
Concept
Definition
Recherche locale
Algorithme operant sur un seul etat courant, sans memoriser le chemin
Paysage de fitness
Representation de la qualite de chaque etat dans l’espace de recherche
Optimum local
Etat meilleur que tous ses voisins mais pas le meilleur globalement
Voisinage
Ensemble des etats atteignables par un mouvement elementaire
Diversification
stratégie pour explorer de nouvelles regions (eviter les optima locaux)
Intensification
stratégie pour exploiter les bonnes regions (affiner la solution)
Tableau recapitulatif des algorithmes
Algorithme
Principe
Echappement optima
Memoire
paramètre cle
Hill Climbing
Monter vers le meilleur voisin
Non
\(O(1)\)
-
Random-Restart HC
Relancer depuis un point aleatoire
Oui (par redemarrage)
\(O(1)\)
Nb de restarts
Simulated Annealing
Accepter des degradations avec probabilite \(e^{-\Delta E/T}\)
Oui (probabiliste)
\(O(1)\)
\(T_0\), \(\alpha\)
Tabu Search
Interdire les mouvements recents
Oui (memoire)
\(O(\text{tenure})\)
Tenure
Quand utiliser la recherche locale ?
Situation
Recommandation
On cherche le chemin vers la solution
Utiliser A*, BFS, DFS (pas la recherche locale)
On cherche le meilleur etat
Recherche locale appropriee
Espace d’etats immense (> \(10^{10}\))
Recherche locale souvent le seul choix
Memoire limitee
Recherche locale (\(O(1)\) pour HC et SA)
Besoin de garantie d’optimalite
Utiliser des méthodes exactes (Branch & Bound)
Pour aller plus loin
Notebook suivant : Search-05-GeneticAlgorithms - Algorithmes evolutionnaires qui maintiennent une population de solutions
Reference : Russell & Norvig, Artificial Intelligence: A Modern Approach, Chapitre 4 - Local Search and Optimization
Ce notebook a couvert les trois familles fondamentales de recherche locale : le Hill Climbing (glouton, rapide mais piege par les optima locaux), le recuit simule (acceptation probabiliste de degradations controlees par la temperature), et la recherche tabou (diversification par memoire des mouvements interdits). Le benchmark sur les N-Reines a montre que Hill Climbing seul atteint 0% de succes pour N=20, tandis que Tabu Search atteint 100% et Simulated Annealing environ 83%, illustrant le compromis entre simplicite et robustesse.
Ces méthodes se retrouvent au coeur de la resolution de CSP (Constraint Satisfaction Problems) : les conflits des N-Reines sont des violations de contraintes, et le voisinage 2-opt du TSP est un opérateur de recherche locale sur un problème d’optimisation sous contraintes. Les notebooks suivants de la serie Search approfondiront cette connexion, en particulier les algorithmes génétiques (Search-5) qui remplacent le seul etat courant par une population de solutions, combinant exploration et exploitation a l’echelle d’un genome collectif.