Le notebook App-2 compare trois stratégies de coloration — glouton séquentiel, DSATUR (degré de saturation) et CP-SAT (programmation par contraintes via OR-Tools) — sur un graphe aléatoire et conclut, par exemple, que « CP-SAT utilise 18 couleurs, DSATUR 19, le glouton 22 ». Mais cette conclusion repose sur une seule instance. Or le graphe tiré au hasard n’est qu’un tirage parmi une infinité de graphes de même taille et même densité : un autre tirage pourrait rapprocher les stratégies, voire les inverser sur certaines métriques.
Ce notebook pose la question méthodologique qui manque à App-2 : quand peut-on affirmer qu’une stratégie est significativement meilleure qu’une autre, plutôt que d’avoir observé un écart dû au hasard de l’échantillonnage des graphes ?
Plan
Le piège de l’instance unique — pourquoi une comparaison ponctuelle n’est pas une preuve.
Distribution cross-instance — échantillonner \(N\) graphes d’Erdős-Rényi \(G(n,p)\) et regarder la distribution du nombre de couleurs de chaque stratégie.
Intervalle de confiance bootstrap à 95 % — encadrer l’écart moyen sans hypothèse de normalité.
Test apparié par paires (Wilcoxon signé) — l’écart est-il statistiquement significatif ? (+ correction de Bonferroni pour les comparaisons multiples).
Effet de la densité — le gap glouton/DSATUR dépend-il de \(p\) ?
Famille conceptuelle. Ce notebook est le troisième d’une veine « validité statistique d’une comparaison » : Sudoku-18b étudie la variance du temps de solveurs déterministes ; ML-4b (série ML) étudie la variance des métriques d’un modèle en cross-validation. Ici, la stochasticité est d’une autre nature : elle vient de la génération aléatoire des instances (le graphe lui-même), pas du temps système ni de l’initialisation. Les stratégies sont déterministes, mais la question posée — « sur quels graphes cette stratégie gagne-t-elle ? » — est aléatoire.
Pré-requis : avoir parcouru App-2-GraphColoring (définitions de coloration, nombre chromatique \(\chi\), principe du glouton / DSATUR / CP-SAT).
1. Mise en place — trois stratégies de coloration
Nous réimplémentons les trois stratégies de App-2 sous une forme minimale et commentée, afin de pouvoir les lancer sur \(N\) graphes sans dépendre d’artefacts extérieurs. La stack est la même que App-2 : networkx (graphes), ortools.sat.python.cp_model (CP-SAT), plus numpy / scipy / matplotlib pour la statistique et les figures.
Reproductibilité. Toute la génération aléatoire est contrôlée par une graine fixée (SEED = 42). Les stratégies elles-mêmes sont déterministes : relancer ce notebook donne byte-à-byte les mêmes nombres. La seule source de variabilité que nous étudions est donc bien celle des instances (les graphes), pas celle du matériel ou de l’initialisation.
import numpy as npimport matplotlib.pyplot as pltimport networkx as nxfrom scipy import statsfrom ortools.sat.python import cp_modelSEED =42rng = np.random.default_rng(SEED)# Style des figuresplt.rcParams.update({"figure.dpi": 110, "font.size": 10})def greedy_color(G, order=None):"""Glouton séquentiel : couleur la plus basse non utilisée par les voisins. `order` = ordre des sommets (par défaut, l'ordre networkx).""" nodes =list(G.nodes()) if order isNoneelse order color = {}for u in nodes: used = {color[v] for v in G[u] if v in color} c =0while c in used: c +=1 color[u] = creturnmax(color.values()) +1if color else0def dsatur_color(G):"""DSATUR : à chaque pas, colorer le sommet de saturation maximale (nombre de couleurs distinctes parmi les voisins déjà colorés), départage les égalités par le degré décroissant.""" color = {} saturation = {u: 0for u in G} degree =dict(G.degree())whilelen(color) <len(G): u =max((v for v in G if v notin color), key=lambda v: (saturation[v], degree[v])) used = {color[v] for v in G[u] if v in color} c =0while c in used: c +=1 color[u] = cfor w in G[u]:if w notin color: saturation[w] =len({color[v] for v in G[w] if v in color})returnmax(color.values()) +1def cpsat_color(G, time_limit=2.0):"""Coloration par CP-SAT (OR-Tools), bornée supérieurement par le glouton. Renvoie (k, statut) : k = nombre de couleurs de la meilleure solution trouvée dans la limite de temps ; statut = "OPTIMAL" si k est le nombre chromatique chi prouvé (optimalité démontrée par le solveur), "FEASIBLE" si k n'est qu'une borne supérieure de chi (solution valide trouvée sans preuve d'optimalité dans la limite de temps).""" n =len(G)if n ==0:return0, "OPTIMAL"# graphe vide : chi = 0, trivialement optimal nodes =list(G.nodes()) idx = {u: i for i, u inenumerate(nodes)} ub = greedy_color(G) # borne supérieure = résultat glouton model = cp_model.CpModel() x = {(v, c): model.NewBoolVar(f"x_{v}_{c}")for v inrange(n) for c inrange(ub)}for v inrange(n): model.Add(sum(x[(v, c)] for c inrange(ub)) ==1)for u, w in G.edges(): iu, iw = idx[u], idx[w]for c inrange(ub): model.Add(x[(iu, c)] + x[(iw, c)] <=1) used = []for c inrange(ub): uc = model.NewBoolVar(f"used_{c}") model.AddMaxEquality(uc, [x[(v, c)] for v inrange(n)]) used.append(uc) model.Minimize(sum(used)) solver = cp_model.CpSolver() solver.parameters.max_time_in_seconds = time_limit solver.parameters.num_search_workers =4 status = solver.Solve(model)if status in (cp_model.OPTIMAL, cp_model.FEASIBLE):returnint(round(solver.ObjectiveValue())), solver.StatusName(status)return ub, "AUCUNE_SOLUTION"# pas de solution trouvée : borne gloutonprint("Stratégies chargées : glouton, DSATUR, CP-SAT.")
Stratégies chargées : glouton, DSATUR, CP-SAT.
2. Le piège de l’instance unique
Comparons les trois stratégies sur un seul graphe \(G(50, 0{,}4)\), comme le ferait une conclusion ponctuelle :
Faut-il en conclure que DSATUR est « meilleure » que le glouton de 3 couleurs, et CP-SAT de 1 de plus ? Non, pour une raison simple : un autre tirage du même graphe aurait pu donner des écarts différents. La conclusion ci-dessus mélange deux effets indissociables — la différence réelle entre stratégies et la particularité de cette instance. Pour les séparer, il faut répéter.
Notons aussi le statut du solveur CP-SAT : FEASIBLE. La valeur 8 est une borne supérieure du nombre chromatique \(\chi\) — une coloration valide trouvée en 2 secondes — pas un \(\chi\)prouvé (ce serait le statut OPTIMAL, optimalité démontrée par le solveur). Cette distinction entre optimum démontré et simple solution trouvée accompagnera tout le notebook.
3. Distribution cross-instance — échantillonner \(N\) graphes
Nous générons \(N = 20\) graphes indépendants \(G(50, 0{,}4)\) et reportons le nombre de couleurs de chaque stratégie. La distribution empirique (et non la seule moyenne) révèle la variabilité due à l’échantillonnage des graphes.
N_INSTANCES =20N_NODES =50P_DENSE =0.4# Graines déterministes dérivées du RNG maître (reproductible)seeds = [int(s) for s in rng.integers(1, 10**9, size=N_INSTANCES)]graphs = [nx.gnp_random_graph(N_NODES, P_DENSE, seed=s) for s in seeds]greedy_res = np.array([greedy_color(G) for G in graphs])dsatur_res = np.array([dsatur_color(G) for G in graphs])cpsat_solutions = [cpsat_color(G, time_limit=2.0) for G in graphs]cpsat_res = np.array([k for k, _ in cpsat_solutions])n_optimal =sum(1for _, s in cpsat_solutions if s =="OPTIMAL")n_feasible =sum(1for _, s in cpsat_solutions if s =="FEASIBLE")print(f"Sur N={N_INSTANCES} graphes G({N_NODES}, {P_DENSE}) :")print(f" glouton : moyenne={greedy_res.mean():.2f} médiane={np.median(greedy_res):.0f} écart-type={greedy_res.std():.2f} min/max={greedy_res.min()}/{greedy_res.max()}")print(f" DSATUR : moyenne={dsatur_res.mean():.2f} médiane={np.median(dsatur_res):.0f} écart-type={dsatur_res.std():.2f} min/max={dsatur_res.min()}/{dsatur_res.max()}")print(f" CP-SAT : moyenne={cpsat_res.mean():.2f} médiane={np.median(cpsat_res):.0f} écart-type={cpsat_res.std():.2f} min/max={cpsat_res.min()}/{cpsat_res.max()}")print(f" statuts CP-SAT : {n_optimal} OPTIMAL (chi prouvé) / {n_feasible} FEASIBLE (borne supérieure de chi)")
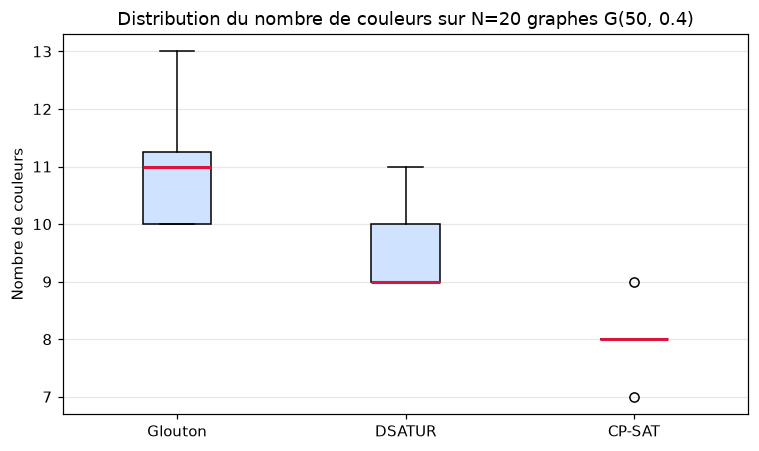
La hiérarchie glouton > DSATUR > CP-SAT tient en moyenne, mais la variabilité n’est pas nulle (l’écart-type vaut de l’ordre de \(0{,}3\) à \(0{,}9\) couleur selon la stratégie). Nuance apportée par les statuts : CP-SAT ne prouve l’optimalité (OPTIMAL) que sur 1 instance sur 20 — sa colonne est donc majoritairement une collection de bornes supérieures de \(\chi\), suffisantes pour situer la hiérarchie, mais qui ne sont pas des nombres chromatiques démontrés. Visualisons ces distributions :
fig, ax = plt.subplots(figsize=(7, 4.2))data = [greedy_res, dsatur_res, cpsat_res]labels = ["Glouton", "DSATUR", "CP-SAT"]ax.boxplot(data, tick_labels=labels, patch_artist=True, boxprops=dict(facecolor="#cfe2ff"), medianprops=dict(color="crimson", linewidth=2))ax.set_ylabel("Nombre de couleurs")ax.set_title(f"Distribution du nombre de couleurs sur N={N_INSTANCES} graphes G({N_NODES}, {P_DENSE})")ax.grid(axis="y", alpha=0.3)plt.tight_layout()plt.show()
Les boîtes à moustache montrent que les trois distributions ne se chevauchent quasiment pas : la médiane CP-SAT est sous le minimum du glouton. C’est un premier indice fort — mais « visuellement séparées » n’est pas « statistiquement prouvé ». Formalisons.
4. Intervalle de confiance bootstrap à 95 %
La moyenne empirique \(\bar{x}\) n’est qu’une estimation de la moyenne « vraie » \(\mu\) sur la population (infinie) des graphes \(G(50, 0{,}4)\). Le bootstrap non paramétrique estime l’incertitude sur \(\bar{x}\) en rééchantillonnant avec remise les \(N\) observations, sans supposer de loi (Gaussienne ou autre) sur les données.
On tire \(B\) échantillons bootstrap (de même taille \(N\), avec remise), on calcule la moyenne de chacun, et on prend les quantiles à 2,5 % et 97,5 % comme borne de l’IC à 95 %.
def bootstrap_ic(echantillon, B=2000, confiance=0.95, seed=SEED):"""IC bootstrap non paramétrique sur la moyenne.""" rng_b = np.random.default_rng(seed) n =len(echantillon) boot_means = np.array([ np.mean(rng_b.choice(echantillon, size=n, replace=True))for _ inrange(B) ]) alpha = (1- confiance) /2 lo = np.percentile(boot_means, 100* alpha) hi = np.percentile(boot_means, 100* (1- alpha))returnfloat(lo), float(hi)print(f"IC 95% bootstrap (B=2000) sur le nombre de couleurs moyen :")for nom, res in [("Glouton", greedy_res), ("DSATUR", dsatur_res), ("CP-SAT", cpsat_res)]: lo, hi = bootstrap_ic(res)print(f" {nom:8} : {res.mean():5.2f} IC95% = [{lo:.2f}, {hi:.2f}] (largeur {hi-lo:.2f})")
IC 95% bootstrap (B=2000) sur le nombre de couleurs moyen :
  Glouton  : 10.95  IC95% = [10.55, 11.35]  (largeur 0.80)
  DSATUR   :  9.40  IC95% = [9.15, 9.70]  (largeur 0.55)
  CP-SAT   :  8.00  IC95% = [7.85, 8.15]  (largeur 0.30)
Les IC à 95 % sont étroits (largeur \(\approx 0{,}3\)–\(0{,}8\) couleur) et disjoints entre stratégies : même la borne basse du glouton reste au-dessus de la borne haute de DSATUR, elle-même au-dessus de celle de CP-SAT. C’est la preuve quantitative qui manquait au constat visuel.
5. Test apparié par paires (Wilcoxon signé) + correction de Bonferroni
« Les IC sont disjoints » suggère une différence, mais ne répond pas formellement à la question de la signification. Le protocole est apparié : à chaque indice \(i\), les trois valeurs (glouton, DSATUR, CP-SAT) proviennent du même graphe \(G_i\). Le test adapté est donc le test de Wilcoxon sur rangs signés (non paramétrique, apparié) : sur les différences \(d_i = A(G_i) - B(G_i)\), il teste \(H_0\) : « les \(d_i\) sont symétriquement répartis autour de zéro » contre \(H_1\) : « la stratégie A utilise strictement plus de couleurs que B ». Un test pour échantillons indépendants (Mann-Whitney) ne serait pas adapté ici : en ignorant l’appariement par graphe, il fausserait la force de la preuve.
Convention pour les différences nulles (zero_method="wilcox" de SciPy) : les ex aequo (\(d_i = 0\)) sont exclus avant le classement des rangs. Cette même convention servira de base à la taille d’effet de la section 6 — test et effet sont ainsi calculés sur les mêmes différences non nulles.
Comme nous faisons trois comparaisons par paires (glouton/DSATUR, DSATUR/CP-SAT, glouton/CP-SAT), le risque de faux positif gonfle. La correction de Bonferroni divise le seuil \(\alpha\) par le nombre de comparaisons (\(\alpha/3\)) pour contrôler le risque global — elle corrige la multiplicité des tests ; elle ne remplace pas le choix d’un test adapté au protocole.
paires = [ ("Glouton", greedy_res, "DSATUR", dsatur_res), ("DSATUR", dsatur_res, "CP-SAT", cpsat_res), ("Glouton", greedy_res, "CP-SAT", cpsat_res),]m =len(paires) # nombre de comparaisonsalpha_brut =0.05alpha_bonf = alpha_brut / mprint(f"3 comparaisons appariées par paires — seuil alpha = {alpha_brut}, corrigé Bonferroni = {alpha_bonf:.4f}\n")print(f"{'Comparaison':<20}{'W':>8}{'p (brut)':>14}{'p < bonf?':>11}")for (na, va, nb, vb) in paires: W, pval = stats.wilcoxon(va, vb, alternative="greater", zero_method="wilcox") verdict ="OUI"if pval < alpha_bonf else"non"print(f"{na+' > '+nb:<20}{W:>8.0f}{pval:>14.2e}{verdict:>11}")# Le meme contraste en test NON apparie (Mann-Whitney) : la lecture de la# section 5 explique pourquoi ces p-valeurs, plus petites, suraffirment.print()print(f"{'Comparaison':<20}{'p (Mann-Whitney)':>18}")for (na, va, nb, vb) in paires: U, p_mw = stats.mannwhitneyu(va, vb, alternative="greater")print(f"{na+' > '+nb:<20}{p_mw:>18.2e}")
Les trois \(p\)-valeurs appariées (\(7{,}4 \times 10^{-5}\), \(2{,}4 \times 10^{-5}\) et \(3{,}3 \times 10^{-5}\)) sont toutes très en-dessous du seuil corrigé (\(1{,}7 \times 10^{-2}\)) : les trois hiérarchies sont statistiquement significatives, et ce n’est pas un artefact des comparaisons multiples.
À titre de comparaison, le test indépendant Mann-Whitney donne bien des \(p\)-valeurs plus petites encore (mesurées ci-dessus : \(1{,}2 imes 10^{-6}\), \(9{,}6 imes 10^{-9}\) et \(5{,}9 imes 10^{-9}\)) — apparemment « plus fort », mais inadapté ici : en ignorant l’appariement par graphe, il suraffirme la force de la preuve. La force d’un test ne se choisit pas d’après son résultat, elle se déduit du protocole expérimental.
6. Taille d’effet rank-bisérial apparié — significatif \(\neq\) important
Un \(p\)-value minuscule avec \(N = 20\) peut simplement traduire « l’effet existe et \(N\) suffit à le détecter », sans dire s’il est grand. La taille d’effet rank-bisérial appariée\(r\) quantifie la magnitude, indépendamment de \(N\), en restant sur les différences non nulles \(d_i = A(G_i) - B(G_i)\) (convention de la section 5) :
\[r = \frac{R_+ - R_-}{R_+ + R_-} \in [-1, +1]\]
où \(R_+\) (respectivement \(R_-\)) est la somme des rangs de \(|d_i|\) — rangs calculés sur l’ensemble des différences non nulles — pour les \(d_i > 0\) (respectivement \(d_i < 0\)). Ici \(r = +1\) signifie « A utilise plus de couleurs que B sur toutes les instances non ex aequo », \(r = 0\) « équilibre parfait des rangs », \(r = -1\) « B utilise plus de couleurs que A partout ». C’est l’équivalent non paramétrique du « combien ça compte, pas seulement est-ce que ça existe ».
def rank_biserial_apparie(va, vb):"""Rank-bisérial apparié : (R+ - R-)/(R+ + R-) sur les différences non nulles (convention zero_method='wilcox', cohérente avec la section 5).""" d = np.asarray(va) - np.asarray(vb) d = d[d !=0]iflen(d) ==0:return0.0 rangs = stats.rankdata(np.abs(d)) r_plus = rangs[d >0].sum() r_moins = rangs[d <0].sum()returnfloat((r_plus - r_moins) / (r_plus + r_moins))print(f"{'Comparaison':<20}{'r':>6} bilan par paire (N=20) [interpretation]")for (na, va, nb, vb) in paires: r = rank_biserial_apparie(va, vb) interp = ("quasi-systématique"if r >0.9else"marquée"if r >0.5else"modérée"if r >0.3else"faible") d = np.asarray(va) - np.asarray(vb) # d > 0 : nb l'emporte (moins de couleurs) vict =int((d >0).sum()) egal =int((d ==0).sum()) defa =int((d <0).sum())print(f"{na+' > '+nb:<20}{r:>6.3f}{nb} gagne {vict}/{len(d)}, egalites {egal}, defaites {defa} [{interp}]")
Ici \(r = 1{,}000\) pour les trois paires : chaque stratégie domine la précédente sur toutes les instances non ex aequo. DSATUR ne « concède » que 2 égalités sur 20 face au glouton (18 victoires, 0 défaite), et CP-SAT l’emporte 20 fois sur 20 dans ses deux confrontations — mais rappelons que ses valeurs ne sont des nombres chromatiques prouvés que pour l’unique instance OPTIMAL : l’effet massif se mesure ici sur des bornes supérieures. L’effet n’est pas seulement détectable, il est massif. Pour coloration de graphes denses d’Erdős-Rényi, DSATUR n’est pas « un peu meilleur » que le glouton — il l’emporte sur la quasi-totalité des instances testées.
Pourquoi pas les graphes de Mycielski ? Une intuition répandue voudrait que les graphes de Mycielski (construction sans triangle avec nombre chromatique arbitraire) soient le cas où le glouton échoue. En pratique, avec l’ordre par défaut de networkx, le glouton et DSATUR y trouvent le \(\chi\) exact : l’écart n’apparaît pas. Les graphes d’Erdős-Rényi denses (\(p \geq 0{,}3\)) sont le bon cas discriminant — c’est aussi ce que montre App-2 sur son instance unique, et ce que ce notebook confirme statistiquement sur \(N\) instances.
7. Effet de la densité — le gap dépend-il de \(p\) ?
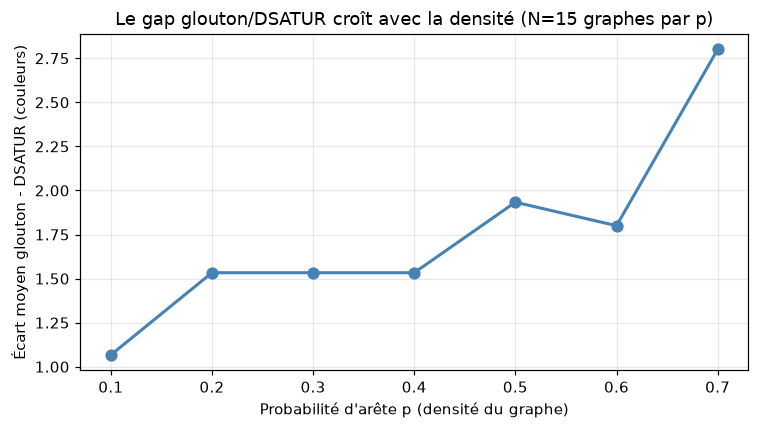
La conclusion précédente vaut pour \(p = 0{,}4\). Le gap glouton/DSATUR est-il sensible à la densité du graphe ? Balayons \(p \in [0{,}1, 0{,}7]\) (CP-SAT est délibérément omis du balayage : il est trop coûteux pour \(7 \times N_{\text{sweep}}\) résolutions supplémentaires ; le cas principal ci-dessus a déjà montré qu’il ferme encore le gap à \(p = 0{,}4\)).
SWEEP_PS = [0.10, 0.20, 0.30, 0.40, 0.50, 0.60, 0.70]N_SWEEP =15gap_mean = [] # écart moyen glouton - DSATUR selon pwins_dsatur = [] # instances où DSATUR fait strictement mieuxegalites = [] # instances où les deux stratégies coïncidentfor p in SWEEP_PS: sub_seeds = [int(s) for s in rng.integers(1, 10**9, size=N_SWEEP)] gaps = []for s in sub_seeds: G = nx.gnp_random_graph(N_NODES, p, seed=s) gaps.append(greedy_color(G) - dsatur_color(G)) gap_mean.append(np.mean(gaps)) wins_dsatur.append(sum(1for d in gaps if d >0)) egalites.append(sum(1for d in gaps if d ==0))print("Sweep densité — écart glouton - DSATUR (N=15 graphes par p) :")print(f"{'p':>5} | {'gap moyen':>9} | DSATUR gagne | égalités")for p, g, w, e inzip(SWEEP_PS, gap_mean, wins_dsatur, egalites):print(f"{p:5.2f} | {g:9.3f} | {w:2d}/{N_SWEEP} | {e}")fig, ax = plt.subplots(figsize=(7, 4))ax.plot(SWEEP_PS, gap_mean, "o-", color="steelblue", linewidth=2, markersize=7)ax.set_xlabel("Probabilité d'arête p (densité du graphe)")ax.set_ylabel("Écart moyen glouton - DSATUR (couleurs)")ax.set_title(f"Le gap glouton/DSATUR croît avec la densité (N={N_SWEEP} graphes par p)")ax.grid(alpha=0.3)plt.tight_layout()plt.show()
Le gap s’accroît avec \(p\) : sur des graphes creux (\(p = 0{,}1\)), l’écart moyen entre glouton et DSATUR reste d’environ 1 couleur (DSATUR gagne sur 13 des 15 graphes, égalité sur 2) — ils ne coïncident donc quasi-jamais ; sur des graphes denses (\(p \geq 0{,}4\)), DSATUR tire profit de l’ordre dynamique des sommets et l’écart moyen grimpe de 1,5 à 3 couleurs. Le verdict « DSATUR est meilleure » dépend donc de la densité — un angle que la conclusion ponctuelle de App-2 ne pouvait pas révéler.
8. Synthèse — relire App-2 à la lumière des intervalles
Question
Réponse ponctuelle (App-2)
Réponse statistique (ce notebook)
DSATUR < glouton ?
« oui, sur cette instance »
oui, significativement (\(p = 7{,}4 \times 10^{-5}\), test apparié), effet massif (\(r = 1{,}000\)), IC disjoints
CP-SAT < DSATUR ?
« oui, sur cette instance »
oui, significativement (\(p = 2{,}4 \times 10^{-5}\)), effet massif — en gardant à l’esprit que CP-SAT ne prouve l’optimalité que sur 1 instance sur 20 (OPTIMAL) ; sur les 19 autres, ses valeurs sont des bornes supérieures de \(\chi\)
Conclusion générale ?
« CP-SAT est le meilleur »
sur graphes denses, oui, en bornes obtenues en ≤ 2 s — mais sur graphes creux l’écart glouton/DSATUR se réduit à environ 1 couleur (DSATUR n’y l’emporte que de peu)
Leçon méthodologique. Une comparaison ponctuelle de solveurs sur une instance confond l’effet propre des stratégies et la particularité du graphe tiré. Échantillonner \(N\) instances, encadrer les moyennes par des IC bootstrap, tester la signification avec un test adapté au protocole (ici apparié : Wilcoxon signé + Bonferroni) et mesurer la taille d’effet transforme une intuition en conclusion défendable — et révèle les dépendances (ici, en la densité) que masque l’instance unique.
C’est exactement la démarche de Sudoku-18b pour le temps d’exécution et de ML-4b pour les métriques de modèle. Trois domaines, même discipline : un écart observé n’est une conclusion que si sa variabilité est mesurée.
Exercices
Les trois exercices suivants sont à compléter. L’objectif est d’expérimenter vous-même la méthodologie sur des variantes du problème.
Exercice 1 — Une quatrième stratégie : Welsh-Powell
Implémentez la coloration Welsh-Powell : comme le glouton séquentiel, mais en traitant les sommets par degré décroissant. Ajoutez-la au benchmark ci-dessus et testez (Wilcoxon signé apparié + taille d’effet, en réutilisant la convention des différences nulles de la section 5) si elle est significativement meilleure que le glouton séquentiel par ordre networkx sur les mêmes \(N\) graphes.
Indice :order = sorted(G.nodes(), key=lambda v: G.degree(v), reverse=True) puis passez order à greedy_color.
# Exercice 1 — à compléter# 1. Définissez welsh_powell_color(G) en réutilisant greedy_color(G, order=...).# 2. Calculez son résultat sur les N=20 graphes `graphs` déjà générés.# 3. Comparez-la au glouton séquentiel (greedy_res) par Wilcoxon signé apparié# (stats.wilcoxon, zero_method="wilcox") + rank-bisérial apparié.# 4. Affichez l'IC 95% bootstrap de la moyenne.def welsh_powell_color(G):# TODO étudiant : trier les sommets par degré décroissant, appeler greedy_color result =None# TODOreturn result# TODO : benchmark + tests statistiques sur `graphs`print("Exercice à compléter")
Exercice à compléter
Exercice 2 — Vers des graphes encore plus denses
Reproduisez le balayage de densité de la section 7, mais en rajoutant CP-SAT sur un sous-ensemble plus petit (par exemple \(N_{\text{CP-SAT}} = 5\) instances par valeur de \(p\)). Le gap DSATUR/CP-SAT s’annule-t-il à forte densité (\(p \geq 0{,}6\)) ?
Indice : attention au temps de calcul — augmentez time_limit de CP-SAT si certaines instances n’atteignent pas l’optimum prouvé.
# Exercice 2 — à compléter# Reproduisez le sweep densité avec CP-SAT sur N_CP_SAT = 5 instances par p.# Pour chaque p, comparez DSATUR vs CP-SAT (gap moyen) et observez la tendance.print("Exercice à compléter")
Exercice à compléter
Exercice 3 — Tail-effect : médiane vs moyenne
Pour CP-SAT (le plus régulier), comparez la moyenne et la médiane du nombre de couleurs sur les \(N = 20\) instances. Si elles diffèrent, que dit cela de la forme de la distribution (symétrique ou asymétrique) ? Calculez un IC bootstrap sur la médiane et comparez sa largeur à celui de la moyenne.
Indice : une moyenne supérieure à la médiane signe une distribution étirée vers la droite (quelques instances « coûteuses » tirent la moyenne vers le haut).
# Exercice 3 — à compléter# 1. Comparez moyenne et médiane de cpsat_res.# 2. Adaptez bootstrap_ic pour renvoyer l'IC sur la médiane (remplacez np.mean par np.median).# 3. Comparez les largeurs d'IC moyenne vs médiane.print("Exercice à compléter")