App-19 — Génération procédurale de niveaux via WFC + CP-SAT
Application CSP : Wave Function Collapse (effondrement de fonction d’onde) modélisé avec OR-Tools CP-SAT. Adapté du projet étudiant EPITA Programmation par Contraintes 2026 (groupe H2).
Objectifs du sujet
#
Objectif
Statut
1
Implémenter WFC comme CSP avec CP-SAT (variables=tuiles, contraintes=adjacence)
Ce notebook prolonge le projet Timothe-Le-Bronec-H2_WFC_CPSAT du cours EPITA SCIA Programmation par Contraintes 2026, realise en solo par Timothe Le Bronec (Timothe Le Bronec) : repertoire source, commit de livraison 08dfe96 (login thorgal27 verifie firsthand), cherry-pick 621f1cc (par jsboigeEpita), licence MIT (LICENSE globale du depot parent jsboigeEpita/2026-Epita-Programmation-par-Contraintes, verifiee 2026-09-17 ; pas de LICENSE locale dans le sous-projet, statut herite du parent).
Le projet etudiant couvre deja l’essentiel de ce que ce notebook pedagogique reprend :
la modelisation WFC comme CSP : variables = tuile placee en (i, j), domaine = tileset donne, contraintes = regles d’adjacence issues de tileset.json ;
le solveur CP-SAT qui enumere les configurations globales (par opposition au PureWFC qui collapse une cellule a la fois) ;
la generation aleatoire de niveau (generate_random) pour evaluation ;
l’evaluation sur les tuiles donjon et cave (tileset.json, tileset_cave.json).
Ce qui est ajoute dans ce notebook par rapport au projet source :
la couche metriques : adjacency_violations (compte les adjacences illegales), bfs_reachable_floor (test de connectivite du joueur), tile_variety (diversity de tuiles) qui rendent la comparaison WFC pur / CP-SAT / aleatoire quantitative ;
la comparaison systematique des trois solveurs sur les memes instances (Section 8), absente du notebook source ;
les contraintes globales : ajout de la connectivite, du chemin joueur, et du placement d’objets qui rendent les niveaux jouables (le projet source optimise la coherence d’adjacence, pas la jouabilite) ;
les contraintes de difficulte (densite ennemis, variete) qui ramenent WFC du domaine graphique vers un usage pedagogique.
L’enrichissement preserve le solveur et les tilesets du projet etudiant ; les ajouts sont concentres sur la couche d’evaluation et de contraintes de jouabilite, qui manquaient pour transformer une generation graphique en un sujet de cours.
0. Imports
import sys, ossys.path.insert(0, os.path.dirname(os.path.abspath('__file__')))import numpy as npimport matplotlib.pyplot as pltimport matplotlib.patches as mpatchesimport matplotlib.colors as mcolorsfrom matplotlib.gridspec import GridSpecimport ipywidgets as widgetsfrom IPython.display import display, clear_outputimport math, time, randomfrom wfc_cpsat import ( load_tileset, generate_random, PureWFC, solve_cpsat, run_all, adjacency_violations, bfs_reachable_floor, tile_variety)print('Imports OK')
Imports OK
1. Inspection du tileset
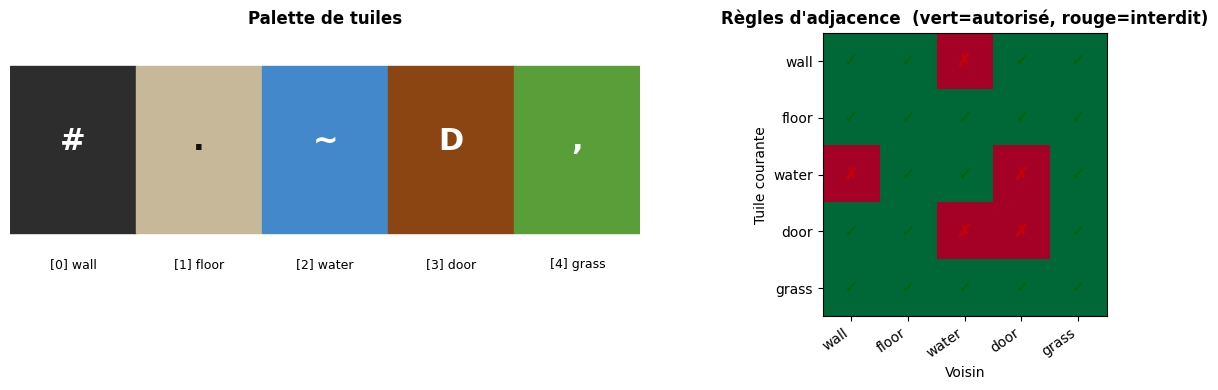
Le tileset définit les tuiles et les règles d’adjacence : quelle tuile peut être placée à côté de quelle autre.
tileset = load_tileset()tiles = tileset['tiles']rules = {int(k): v for k, v in tileset['adjacency']['rules'].items()}n =len(tiles)fig, axes = plt.subplots(1, 2, figsize=(13, 4))# Palette de tuilesax = axes[0]for i, t inenumerate(tiles): rect = plt.Rectangle((i, 0), 1, 1, color=t['color']) ax.add_patch(rect) lum =int(t['color'][1:3], 16) *0.299+int(t['color'][3:5], 16) *0.587+int(t['color'][5:7], 16) *0.114 txt_color ='white'if lum <128else'#111' ax.text(i +0.5, 0.55, t['char'], ha='center', va='center', fontsize=22, fontweight='bold', color=txt_color) ax.text(i +0.5, -0.15, f"[{i}] {t['name']}", ha='center', va='top', fontsize=9)ax.set_xlim(0, n); ax.set_ylim(-0.5, 1.2); ax.axis('off')ax.set_title('Palette de tuiles', fontweight='bold')# Matrice d'adjacenceax2 = axes[1]matrix = np.array([rules[i] for i inrange(n)], dtype=float)ax2.imshow(matrix, cmap='RdYlGn', vmin=0, vmax=1, interpolation='nearest')ax2.set_xticks(range(n)); ax2.set_yticks(range(n))ax2.set_xticklabels([t['name'] for t in tiles], rotation=35, ha='right')ax2.set_yticklabels([t['name'] for t in tiles])ax2.set_title('Règles d\'adjacence (vert=autorisé, rouge=interdit)', fontweight='bold')for i inrange(n):for j inrange(n): ax2.text(j, i, '✓'if rules[i][j] else'✗', ha='center', va='center', color='darkgreen'if rules[i][j] else'#c00', fontsize=13)ax2.set_xlabel('Voisin'); ax2.set_ylabel('Tuile courante')plt.tight_layout()plt.show()print(f"\n{n} tuiles, {sum(rules[a][b] for a inrange(n) for b inrange(n))}/{n*n} paires autorisées")
5 tuiles, 20/25 paires autorisées
Lecture — la structure du tileset porte toute la difficulté
La sortie texte résume l’essentiel : 5 tuiles, 20 paires autorisées sur 25. Autrement dit, seules 5 paires de tuiles sont interdites — mais ce sont elles qui font exister le problème : si les 25 paires étaient autorisées, n’importe quel remplissage aléatoire produirait un niveau valide, et ni WFC ni CP-SAT n’auraient de raison d’être. La difficulté de génération est entièrement portée par la densité de ces interdictions.
Deux repères de lecture de la figure :
La matrice se lit ligne = tuile courante, colonne = voisin (cf. les labels d’axes posés par la cellule). Une case verte en (i, j) dit « la tuile i accepte la tuile j comme voisine ».
Le dictionnaire tileset['weights'], visible dans la palette mais pas dans la matrice, servira dès la cellule suivante : le tirage WFC est pondéré, toutes les tuiles n’ont pas la même probabilité d’être choisies à l’effondrement.
C’est aussi ici que se joue la généricité annoncée en §7 : le tileset donjon (5 tuiles) et le tileset cave (4 tuiles) alimentent exactement le même code — seules les données JSON changent.
2. Animation WFC pas à pas
Visualisation de l’effondrement des domaines : chaque cellule part avec toutes les tuiles possibles (entropie maximale), puis se réduit progressivement.
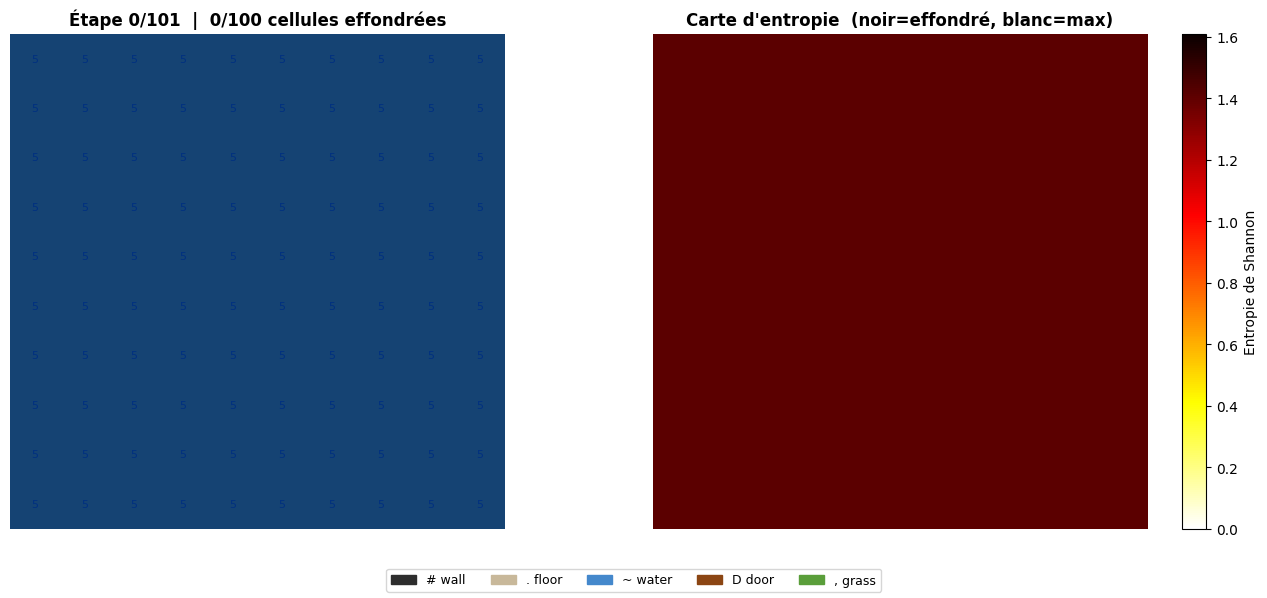
Cellules bleues = domaine encore non réduit (nombre de tuiles restantes affiché)
Carte de droite = entropie de Shannon par cellule (plus sombre = plus contraint)
ROWS, COLS, SEED =10, 10, 42class WFCRecorder(PureWFC):"""PureWFC with domain snapshots recorded after each collapse step."""def__init__(self, *args, **kwargs):super().__init__(*args, **kwargs)self.snapshots = []self._record(None)def _record(self, cell): snap = [[set(self.domains[r][c]) for c inrange(self.cols)] for r inrange(self.rows)]self.snapshots.append((snap, cell))def solve(self): stack = []whileTrue: cell =self._pick_cell()if cell isNone: grid = np.zeros((self.rows, self.cols), dtype=int)for r inrange(self.rows):for c inrange(self.cols): grid[r][c] =next(iter(self.domains[r][c]))self._record(None)return grid r, c = cell d =list(self.domains[r][c]) w = [self.weights[t] for t in d] chosen =self.rng.choices(d, weights=w)[0] snap = [[set(self.domains[r2][c2]) for c2 inrange(self.cols)] for r2 inrange(self.rows)] stack.append((snap, r, c, chosen))self.domains[r][c] = {chosen} ok =self._propagate(r, c)self._record((r, c))whilenot ok:self.backtracks +=1ifnot stack:returnNone snap, br, bc, bad_tile = stack.pop()self.domains = [[set(snap[r2][c2]) for c2 inrange(self.cols)] for r2 inrange(self.rows)]self.domains[br][bc].discard(bad_tile)ifnotself.domains[br][bc]:continue ok =self._propagate(br, bc)self._record((br, bc))recorder = WFCRecorder(ROWS, COLS, tileset, SEED)final_wfc = recorder.solve()print(f"WFC terminé — {len(recorder.snapshots)} étapes, {recorder.backtracks} retours arrière")
WFC terminé — 102 étapes, 0 retours arrière
Lecture — anatomie des 102 étapes
Le décompte se vérifie sur la source de WFCRecorder : 102 = 1 instantané initial + 100 effondrements + 1 instantané final. Le __init__ enregistre l’état « tous les domaines pleins » ; la grille 10×10 compte 100 cellules, chacune effondrée exactement une fois (un _record par effondrement) ; la sortie de solve() ajoute l’instantané terminal.
Le second nombre est le plus instructif : 0 retours arrière. À chaque effondrement, la propagation AC-3 (_propagate) a suffi à maintenir la cohérence des domaines voisins — la pile stack du backtracking n’a jamais été consultée. Ce n’est pas une propriété générale du WFC : c’est un fait de ce couple instance/graine (20/25 paires autorisées, seed 42). Sur un tileset plus contraint ou une autre graine, le même code peut dérouler des dizaines de retours arrière.
Enfin, l’effondrement n’est pas uniforme : rng.choices(d, weights=w) tire la tuile selon tileset['weights'] — le seed 42 rend la séquence reproductible, mais la distribution des tuiles du niveau final reflète ces poids.
Rendu pas à pas de l’effondrement WFC
L’enregistreur WFCRecorder a capturé chaque étape de l’effondrement. La cellule suivante définit render_step, qui dessine pour chaque instantané la grille (tuiles effondrées + domaines restants) et la carte d’entropie de Shannon correspondante. Un slider interactif permet de naviguer dans les 102 étapes.
tile_colors = [t['color'] for t in tiles]cmap_tiles = mcolors.ListedColormap(tile_colors)norm_tiles = mcolors.BoundaryNorm(range(len(tiles) +1), cmap_tiles.N)def render_step(step_idx): snap, collapsed_cell = recorder.snapshots[step_idx] fig, axes = plt.subplots(1, 2, figsize=(14, 6)) tile_img = np.full((ROWS, COLS), -1.0) entropy_grid = np.zeros((ROWS, COLS))for r inrange(ROWS):for c inrange(COLS): d = snap[r][c]iflen(d) ==1: tile_img[r][c] =next(iter(d))eliflen(d) >1: w = [tileset['weights'][t] for t in d] s =sum(w) entropy_grid[r][c] =-sum((wi/s)*math.log(wi/s) for wi in w if wi >0) ax = axes[0] collapsed_mask = tile_img >=0 disp = np.where(collapsed_mask, tile_img, 0) ax.imshow(disp, cmap=cmap_tiles, norm=norm_tiles, interpolation='nearest') ent_overlay = np.ma.masked_where(collapsed_mask, entropy_grid) ax.imshow(ent_overlay, cmap='Blues', alpha=0.65, interpolation='nearest', vmin=0, vmax=math.log(len(tiles)))if collapsed_cell: ax.add_patch(plt.Rectangle((collapsed_cell[1]-.5, collapsed_cell[0]-.5), 1, 1, fill=False, edgecolor='red', linewidth=2.5))for r inrange(ROWS):for c inrange(COLS): d = snap[r][c]iflen(d) ==1: t =next(iter(d)) lum =int(tiles[t]['color'][1:3],16)*.299+int(tiles[t]['color'][3:5],16)*.587+int(tiles[t]['color'][5:7],16)*.114 ax.text(c, r, tiles[t]['char'], ha='center', va='center', fontsize=9, color='white'if lum <128else'#111')eliflen(d) >1: ax.text(c, r, str(len(d)), ha='center', va='center', fontsize=8, color='#003080') collapsed_count = collapsed_mask.sum() ax.set_title(f'Étape {step_idx}/{len(recorder.snapshots)-1} | {collapsed_count}/{ROWS*COLS} cellules effondrées', fontweight='bold') ax.axis('off') ax2 = axes[1] im2 = ax2.imshow(entropy_grid, cmap='hot_r', interpolation='nearest', vmin=0, vmax=math.log(len(tiles))) plt.colorbar(im2, ax=ax2, label='Entropie de Shannon') ax2.set_title('Carte d\'entropie (noir=effondré, blanc=max)', fontweight='bold') ax2.axis('off') legend = [mpatches.Patch(color=t['color'], label=f"{t['char']}{t['name']}") for t in tiles] fig.legend(handles=legend, loc='lower center', ncol=len(tiles), fontsize=9) plt.tight_layout(rect=[0, 0.07, 1, 1]) plt.show()slider = widgets.IntSlider(min=0, max=len(recorder.snapshots)-1, value=0, description='Étape:', continuous_update=False, layout=widgets.Layout(width='85%'))out = widgets.Output()def on_change(change):with out: clear_output(wait=True) render_step(change['new'])slider.observe(on_change, names='value')display(widgets.VBox([slider, out]))render_step(0)
Lecture — l’entropie de Shannon comme guide de l’effondrement
Le module wfc_cpsat révèle la politique cachée derrière l’animation : _pick_cell balaie toutes les cellules non effondrées et choisit celle d’entropie minimale. On effondre donc d’abord là où l’incertitude résiduelle est la plus faible — les cellules déjà très contraintes par leurs voisines — et on laisse la propagation faire le reste. C’est l’heuristique classique « most constrained variable » du CSP, réexprimée en vocabulaire quantique.
L’entropie affichée à droite vaut −Σ (wi/s)·log(wi/s) sur le domaine restant (mêmes poids weights que le tirage). Son maximum, atteint pour un domaine plein de 5 tuiles équiprobables, est log(5) ≈ 1,61 — c’est le vmax fixé par la cellule, ce qui garantit une échelle comparable d’une étape à l’autre.
À l’étape 0 (celle rendue par l’exécution committée) : aucune cellule effondrée, la grille de gauche est intégralement bleue avec un « 5 » par case, la carte d’entropie est uniforme au maximum. Faites glisser le slider vers les dernières étapes : les taches sombres gagnent, l’encadré rouge suit la dernière cellule effondrée.
3. Modèle CP-SAT — Contraintes globales
CP-SAT permet d’exprimer des contraintes globales impossibles à modéliser avec WFC pur :
Contrainte
Type CP-SAT
Description
Adjacence
AddAllowedAssignments
Table de paires (tuile_a, tuile_b) autorisées
Ratio de sol
Add(sum >= k)
Proportion de cases floor bornée
Placement d’objets
Add(sum == k)
Exactement N clés, M coffres
Densité ennemis
Add(enemies*100 >= ratio*floor)
Difficulté proportionnelle à la surface
Connectivité
AddImplication + arc vars
Chaque case floor a au moins un arc entrant depuis un voisin floor
Connectivité : modélisée par des variables d’arc arc[u→v] — si une case floor est non-source, au moins un arc entrant doit être actif depuis un voisin floor. C’est une condition nécessaire de connectivité (relaxation flow), sans variables de chemin exponentielles.
Lecture — chaque contrainte globale se lit dans la solution
La sortie porte les quatre nombres qui font la valeur de CP-SAT sur ce problème :
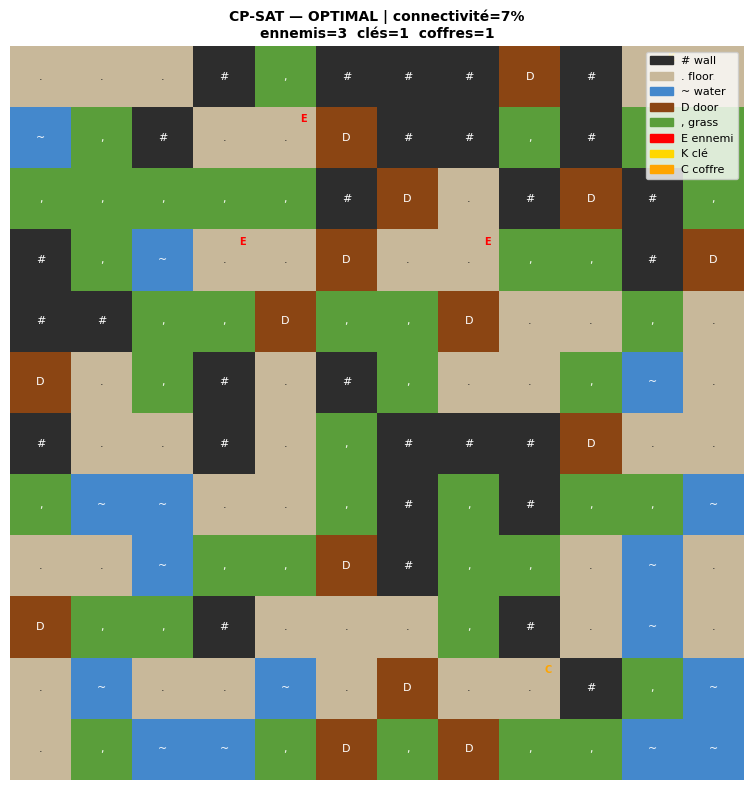
43 cases de sol sur 144 (≈ 30 %) : la solution s’est collée à la borne min_floor_ratio = 0.30. Le solveur n’a aucune incitation à maximiser le sol — il satisfait la fenêtre demandée et consacre le reste de son effort à l’objectif déclaré.
3 ennemis pour 43 cases = 7,0 % du sol, dans la fenêtre [0.05, 0.20] — et pas à une borne : une inégalité est satisfaite, pas nécessairement saturée.
Clés = 1, coffres = 1 : les contraintes d’égalité (Add(sum == k)) sont tenues exactement — c’est précisément ce qu’un processus local comme WFC ne sait pas exprimer (« exactement N occurrences d’un type de tuile »).
Le statut OPTIMAL : le solveur ne rend pas seulement une solution, il atteste qu’aucune meilleure n’existe pour l’objectif. WFC, lui, ne produit jamais une telle preuve — il n’a même pas de notion d’optimalité.
Visualisation du niveau généré par CP-SAT
Le solveur a trouvé une solution optimale en respectant toutes les contraintes globales. La cellule suivante définit plot_level, une fonction de rendu réutilisée dans tout le notebook, puis affiche le niveau avec ses objets (ennemis, clés, coffres) et vérifie la connectivité BFS.
def plot_level(ax, grid, obj_grid, title, tileset, show_objects=True): tiles_l = tileset['tiles'] cmap_l = mcolors.ListedColormap([t['color'] for t in tiles_l]) norm_l = mcolors.BoundaryNorm(range(len(tiles_l) +1), cmap_l.N) ax.imshow(grid, cmap=cmap_l, norm=norm_l, interpolation='nearest') obj_chars = {1: ('E', 'red'), 2: ('K', 'gold'), 3: ('C', 'orange')}for r inrange(grid.shape[0]):for c inrange(grid.shape[1]): t = grid[r, c] lum =int(tiles_l[t]['color'][1:3],16)*.299+int(tiles_l[t]['color'][3:5],16)*.587+int(tiles_l[t]['color'][5:7],16)*.114 ax.text(c, r, tiles_l[t]['char'], ha='center', va='center', fontsize=8, color='white'if lum <128else'#222')if show_objects and obj_grid isnotNoneand obj_grid[r, c] >0: oc, col = obj_chars.get(obj_grid[r, c], ('?', 'white')) ax.text(c +0.3, r -0.3, oc, ha='center', va='center', fontsize=7, color=col, fontweight='bold') ax.set_title(title, fontsize=10, fontweight='bold') ax.axis('off')if cpsat_result.grid isnotNone: fig, ax = plt.subplots(1, 1, figsize=(8, 8)) floor_id =next(t['id'] for t in tileset['tiles'] if t['name'] =='floor') conn = bfs_reachable_floor(cpsat_result.grid, floor_id) plot_level(ax, cpsat_result.grid, cpsat_result.stats['obj_grid'],f"CP-SAT — {cpsat_result.status} | connectivité={conn:.0%}\n"f"ennemis={cpsat_result.stats['enemy_count']} clés={cpsat_result.stats['key_count']} coffres={cpsat_result.stats['chest_count']}", tileset) legend = [mpatches.Patch(color=t['color'], label=f"{t['char']}{t['name']}") for t in tileset['tiles']] legend += [mpatches.Patch(color='red', label='E ennemi'), mpatches.Patch(color='gold', label='K clé'), mpatches.Patch(color='orange', label='C coffre')] ax.legend(handles=legend, loc='upper right', fontsize=8, framealpha=0.8) plt.tight_layout() plt.show()
Exercice : Valider un niveau genere
Ecrivez une fonction validate_level qui prend une grille generee et verifie tous les critères de qualite : violations d’adjacence, connectivite BFS, et comptage d’objets. La fonction retourne un dict avec les metriques et un booléen valid (True si 0 violations + connectivite > 50%).
Indices : - Utilisez adjacency_violations(grid, rules) du module wfc_cpsat pour les violations - Utilisez bfs_reachable_floor(grid, floor_id) pour la connectivite - Pour les objets : np.sum(obj_grid == k) pour chaque type (1=ennemi, 2=cle, 3=coffre) - Un niveau est “valide” si violations == 0 ET connectivite >= 0.5
def validate_level(grid: np.ndarray, rules: dict, floor_id: int, obj_grid: np.ndarray =None) ->dict:"""Valide un niveau genere en verifiant adjacence, connectivite et objets. Args: grid: Grille 2D d'IDs de tuiles rules: Dictionnaire d'adjacence {tile_id: [bool, ...]} floor_id: ID de la tuile 'floor' (ou 'cave') obj_grid: Grille optionnelle d'objets (0=rien, 1=ennemi, 2=cle, 3=coffre) Returns: Dict avec 'violations', 'connectivity', 'objects', 'valid' """# TODO etudiant : implementer la validation complete d'un niveau# Etape 1 : compter les violations d'adjacence avec adjacency_violations# Etape 2 : calculer la connectivite avec bfs_reachable_floor# Etape 3 : si obj_grid est fourni, compter les objets par type# Etape 4 : determiner valid = (violations == 0) and (connectivity >= 0.5)return {"violations": -1, "connectivity": 0.0, "objects": {}, "valid": False} # TODO etudiantprint("Exercice a completer : validation de niveau")
Exercice a completer : validation de niveau
4. Comparaison côte à côte : Random vs WFC vs CP-SAT
Même taille de grille (12×12), même seed.
GRID_SZ =12SEED_CMP =42print(f"Lancement des 3 méthodes ({GRID_SZ}×{GRID_SZ}, seed={SEED_CMP})...")results, tileset = run_all(GRID_SZ, GRID_SZ, SEED_CMP, cpsat_connectivity=True)floor_id =next(t['id'] for t in tileset['tiles'] if t['name'] =='floor')rules_cmp = {int(k): v for k, v in tileset['adjacency']['rules'].items()}n_tiles_cmp =len(tileset['tiles'])for name, res in results.items(): g = res['grid']if g isNone:print(f" {name:8s}: FAILED");continue viol = adjacency_violations(g, rules_cmp) conn = bfs_reachable_floor(g, floor_id) var = tile_variety(g, n_tiles_cmp) bt = res['backtracks']print(f" {name:8s}: {res['time']:.2f}s viol={viol} conn={conn:.0%} var={var}/{n_tiles_cmp} bt={bt}")
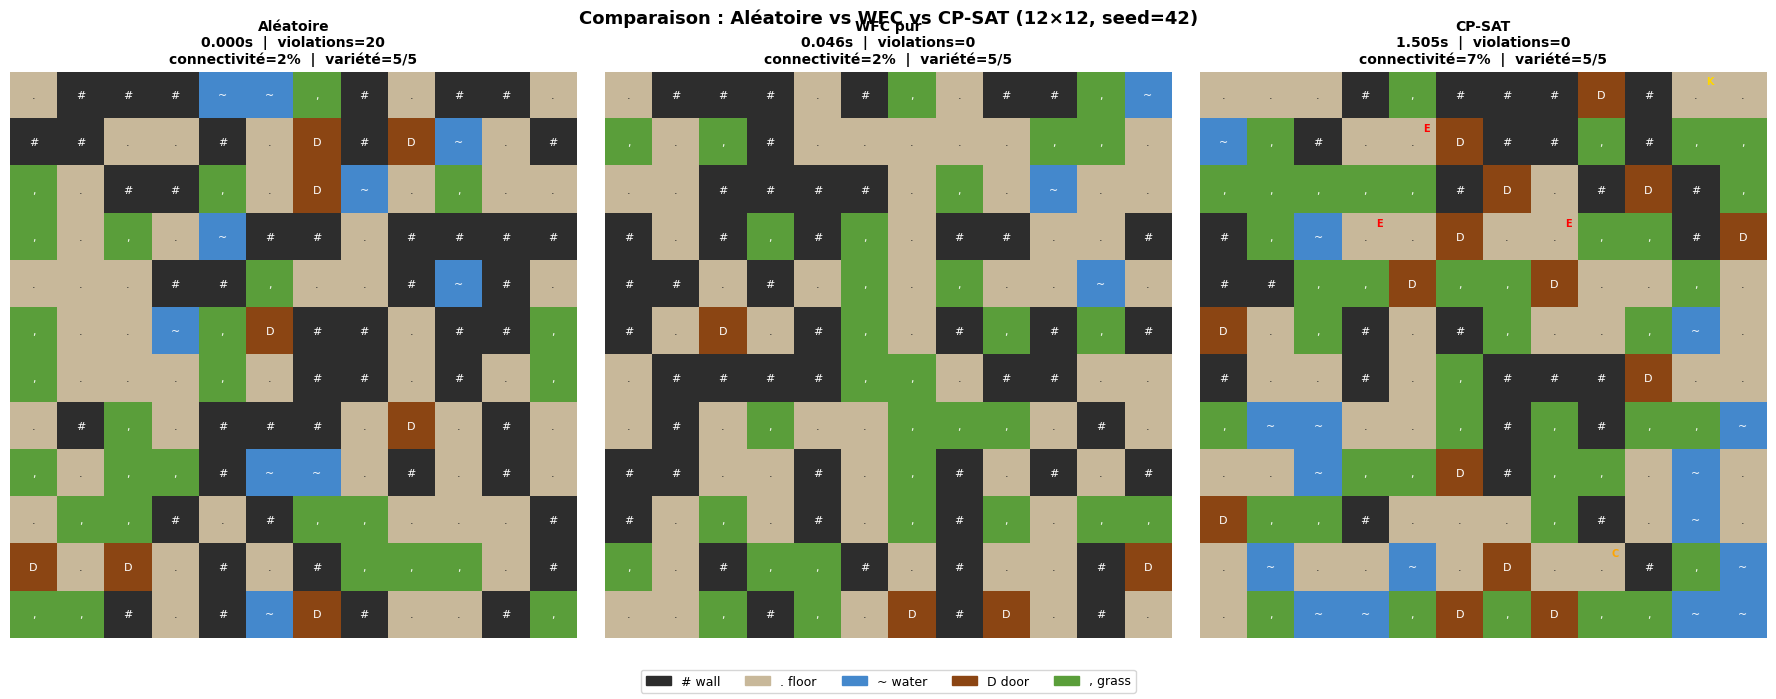
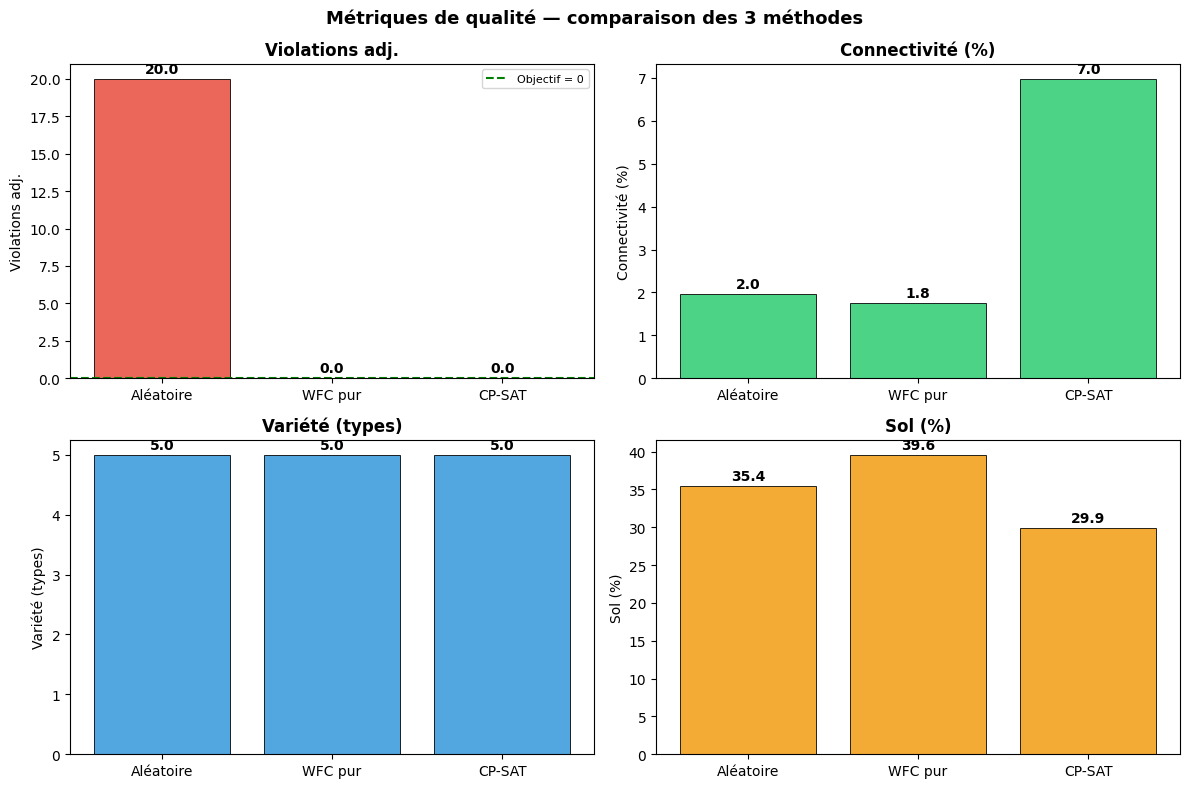
Les trois lignes de la sortie se lisent comme un argument en trois temps :
Aléatoire : 20 violations d’adjacence, connectivité 2 %. C’est l’aveu d’une méthode sans modèle — elle remplit la grille et constate.
WFC pur : 0 violations, mais connectivité inchangée à 2 %. C’est le point pédagogique central : la propagation locale élimine parfaitement les conflits de voisinage, et pourtant le niveau n’est pas plus traversable. Une contrainte globale (« le joueur peut aller partout ») n’est pas la somme des contraintes locales.
CP-SAT : 0 violations et connectivité portée à 7 % par la relaxation flow — un triplement, obtenu sans garantie (condition nécessaire, pas suffisante ; la synthèse y revient).
Deux détails de lecture : bt=None pour CP-SAT n’est pas un zéro — la colonne n’a pas de sens pour un solveur SAT, qui ne fait pas de backtracking au sens WFC ; et la variété 5/5 pour les trois méthodes montre que cette métrique ne discrimine rien sur ce tileset.
Visualisation comparative des trois méthodes
Les résultats textuels confirment les tendances : Random produit des violations, WFC élimine les violations locales mais ne garantit pas la connectivité, CP-SAT optimise simultanément adjacence + connectivité. La cellule suivante trace les trois grilles côte à côte avec leurs métriques.
labels_cmp = {'random': 'Aléatoire', 'wfc': 'WFC pur', 'cpsat': 'CP-SAT'}fig, axes = plt.subplots(1, 3, figsize=(18, 7))for ax, (name, res) inzip(axes, results.items()): g = res['grid']if g isNone: ax.text(0.5, 0.5, 'FAILED', ha='center', va='center', transform=ax.transAxes, fontsize=16, color='red') ax.axis('off');continue viol = adjacency_violations(g, rules_cmp) conn = bfs_reachable_floor(g, floor_id) var = tile_variety(g, n_tiles_cmp) obj_g = res.get('obj_grid') title = (f"{labels_cmp[name]}\n"f"{res['time']:.3f}s | violations={viol}\n"f"connectivité={conn:.0%} | variété={var}/{n_tiles_cmp}") plot_level(ax, g, obj_g, title, tileset, show_objects=(obj_g isnotNone))legend = [mpatches.Patch(color=t['color'], label=f"{t['char']}{t['name']}") for t in tileset['tiles']]fig.legend(handles=legend, loc='lower center', ncol=n_tiles_cmp, fontsize=9)plt.suptitle('Comparaison : Aléatoire vs WFC vs CP-SAT (12×12, seed=42)', fontsize=13, fontweight='bold')plt.tight_layout(rect=[0, 0.06, 1, 0.96])plt.show()
5. Métriques de qualité
metrics = {}for name, res in results.items(): g = res['grid']if g isNone: metrics[name] =None;continue metrics[name] = {'violations': adjacency_violations(g, rules_cmp),'connectivity': bfs_reachable_floor(g, floor_id) *100,'variety': tile_variety(g, n_tiles_cmp),'floor_pct': (g == floor_id).sum() / g.size *100,'time_ms': res['time'] *1000,'backtracks': res['backtracks'] or0, }method_names =list(labels_cmp.values())metric_keys = ['violations', 'connectivity', 'variety', 'floor_pct']metric_labels= ['Violations adj.', 'Connectivité (%)', 'Variété (types)', 'Sol (%)']colors_bar = ['#e74c3c', '#2ecc71', '#3498db', '#f39c12']fig, axes = plt.subplots(2, 2, figsize=(12, 8))for ax, key, label, col inzip(axes.flat, metric_keys, metric_labels, colors_bar): vals = [metrics[m][key] if metrics[m] else0for m in results] bars = ax.bar(method_names, vals, color=col, alpha=0.85, edgecolor='black', linewidth=0.7)for b, v inzip(bars, vals): ax.text(b.get_x() + b.get_width()/2, b.get_height() +max(vals)*0.01,f'{v:.1f}', ha='center', va='bottom', fontsize=10, fontweight='bold') ax.set_title(label, fontweight='bold') ax.set_ylabel(label)if key =='violations': ax.axhline(0, color='green', linestyle='--', linewidth=1.5, label='Objectif = 0') ax.legend(fontsize=8)plt.suptitle('Métriques de qualité — comparaison des 3 méthodes', fontsize=13, fontweight='bold')plt.tight_layout()plt.show()# Tableau récapprint(f"{'Méthode':<12}{'Violations':>12}{'Connectivité':>14}{'Variété':>9}{'Sol%':>7}{'Temps(ms)':>12}{'Backtracks':>12}")print("-"*80)for name, label in labels_cmp.items(): m = metrics[name]if m isNone:print(f"{label:<12} FAILED")else:print(f"{label:<12}{m['violations']:>12}{m['connectivity']:>13.0f}% "f"{m['variety']:>9}{m['floor_pct']:>6.0f}% {m['time_ms']:>11.1f}{m['backtracks']:>12}")
Lecture — le trade-off expressivité/performance, chiffré
Le tableau texte complète la figure en portant les six métriques collectées (la figure n’en trace que quatre) :
Temps : 0,4 ms → 46 ms → 1 505 ms sur cette exécution — trois ordres de grandeur entre aléatoire et CP-SAT, un facteur ~30 entre WFC et CP-SAT. L’ordre de grandeur qualitatif est structurel ; les valeurs exactes sont machine-dep (la note de la section 6 pose la convention, valable ici aussi).
Sol % : 35 / 40 / 30. CP-SAT se colle à sa borne inférieure (30 %), quand WFC produit la grille la plus ouverte (40 %) sans qu’aucune contrainte ne le lui demande — deux philosophies : satisfaire un cahier des charges vs suivre des poids de tirage.
Backtracks : 0 partout sur cette graine. La comparaison WFC vs CP-SAT se joue donc ici sur l’expressivité, pas sur la difficulté de recherche — l’écart de temps achète des contraintes que WFC ne sait pas énoncer, pas une victoire sur un problème commun plus dur.
Exercice : Generation par batch et statistiques
Pour evaluer la robustesse d’une méthode, il faut generer plusieurs niveaux (seeds différents) et calculer les statistiques aggregatees. Implementez une fonction batch_evaluate qui genere N niveaux avec WFC et retourne les metriques moyennes (violations, connectivite, temps).
Indices : - Bouclez sur range(n_seeds) en utilisant chaque itération comme seed - Pour chaque seed, appelez PureWFC(rows, cols, tileset, seed=i).solve() - Collectez violations et connectivite dans des listes - Retournez les moyennes avec np.mean() et ecarts-types avec np.std()
def batch_evaluate(n_seeds: int, rows: int, cols: int, tileset: dict) ->dict:"""Genere n_seeds niveaux WFC et calcule les metriques aggregatees. Args: n_seeds: Nombre de niveaux a generer (seeds 0..n_seeds-1) rows: Nombre de lignes de la grille cols: Nombre de colonnes de la grille tileset: Tileset charge via load_tileset() Returns: Dict avec 'mean_violations', 'std_violations', 'mean_connectivity', 'std_connectivity', 'success_rate', 'total_time' """# TODO etudiant : implementer l'evaluation par batch# Etape 1 : extraire rules et floor_id du tileset# Etape 2 : boucler sur n_seeds seeds, generer avec PureWFC# Etape 3 : pour chaque grille, calculer violations et connectivite# Etape 4 : calculer moyennes et ecarts-types# Etape 5 : calculer success_rate = grilles_valides / n_seedsreturn {"mean_violations": 0.0, "std_violations": 0.0,"mean_connectivity": 0.0, "std_connectivity": 0.0,"success_rate": 0.0, "total_time": 0.0} # TODO etudiantprint("Exercice a completer : evaluation par batch")
Exercice a completer : evaluation par batch
6. Contraintes de difficulté — expérimentation
CP-SAT permet de modifier la difficulté du niveau en changeant les ratios : - min_enemy_ratio / max_enemy_ratio : densité d’ennemis - min_floor_ratio / max_floor_ratio : surface jouable - n_keys, n_chests : objets requis
Cela est impossible avec WFC pur : WFC ne peut exprimer que des contraintes locales d’adjacence.
Lecture — l’inversion contre-intuitive du coût de résolution
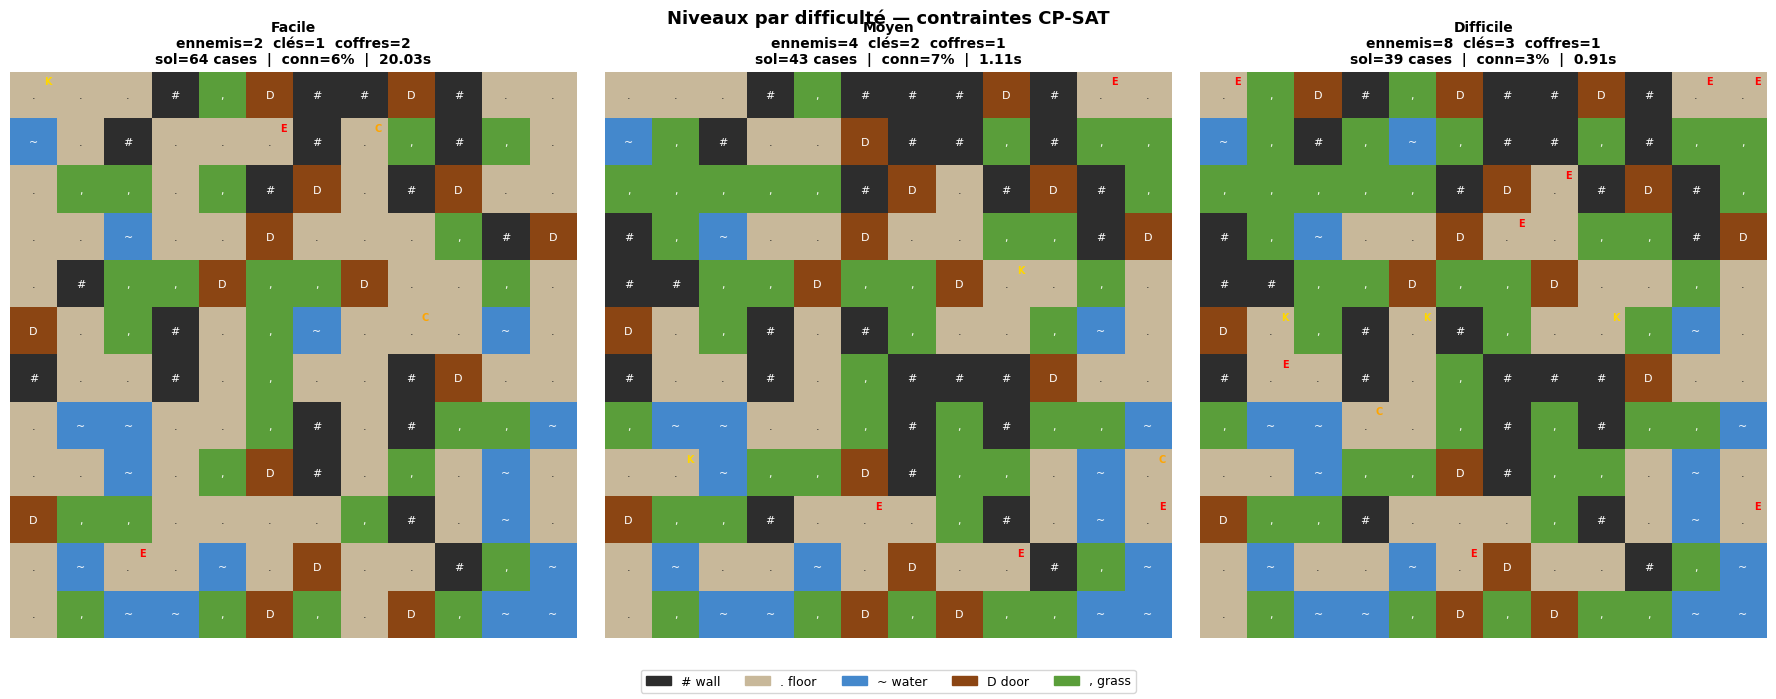
Le résultat le plus surprenant de la section : c’est Facile, le preset aux ratios les plus permissifs, qui coûte le plus — statut FEASIBLE au terme du timeout de 20 s, optimalité non prouvée — quand Moyen et Difficile, aux contraintes plus serrées, prouvent leur optimalité en environ une seconde.
La lecture est structurelle : élargir les fenêtres de ratios élargit l’espace des solutions candidates. Le solveur trouve vite une solution, mais doit explorer bien davantage pour prouver qu’aucune meilleure n’existe dans un espace aussi ouvert. Serrer les contraintes élague l’arbre de recherche — la difficulté perçue du niveau généré est l’inverse de la difficulté de le générer prouvablement bien. (La sémantique exacte des statuts est détaillée dans la note de la cellule suivante ; seuls les statuts et comptes sont structurels, les temps sont machine-dep.)
Les fenêtres demandées sont tenues sur les trois presets : Facile porte 2 ennemis pour 64 cases de sol (3,1 %, fenêtre [0.02, 0.08]), Moyen 4 ennemis pour 43 cases (9,3 %, fenêtre [0.08, 0.18]), Difficile 8 ennemis pour 39 cases (20,5 %, fenêtre [0.18, 0.35]).
Visualisation des niveaux par difficulte
Les trois configurations (Facile, Moyen, Difficile) sont resolues. La cellule suivante affiche les grilles obtenues cote a cote, avec le compteur d’ennemis, de cles et de coffres, ainsi que le taux de connectivite et le temps de resolution.
Note sur le statut du solveur : Moyen et Difficile atteignent le statut OPTIMAL (solution optimale prouvee en runtime machine-dep). Facile, dont l’espace de recherche est plus large (ratios de sol 45-65 %, peu d’ennemis), s’arrete au statut FEASIBLE : le solveur trouve une solution valide mais ne prouve pas son optimalite dans le delai imparti (timeout_s = 20.0, runtime machine-dep), et le decompte exact d’ennemis/cles peut donc varier d’une execution a l’autre (le seed fixe ne rend deterministe que le statut OPTIMAL, pas les solutions FEASIBLE). C’est un comportement attendu de CP-SAT, et l’une des raisons pour lesquelles on utilise un timeout en production.
Note methodologique – separation structurel / machine-dep : le statut (OPTIMAL / FEASIBLE) et les statistiques (nombre de cases sol / ennemis / cles / coffres / taux de connectivite) sont des invariants structurels (resultats solveur sur instance specifique, deterministes sur la graine fixee). En revanche, le temps de resolution et le timeout_s sont machine-dep (CPU, charge systeme, version Python, OR-Tools, taille de l’instance) et ne survivent pas a une re-execution sur une autre machine. Pour observer vos propres timings, executez la cellule de benchmark ci-dessous (la cellule solve_cpsat utilise time.time() pour mesurer le solve_time).
En vous basant sur les 3 presets (Facile/Moyen/Difficile) définis ci-dessus, créez un nouveau preset “Hardcore” avec vos propres paramètres de contraintes. L’objectif est un niveau avec peu de sol, beaucoup d’ennemis, et plusieurs cles/coffres obligeant le joueur a explorer.
Indices : - Inspirez-vous du dictionnaire difficulty_configs ci-dessus - Paramètres disponibles : min_enemy_ratio, max_enemy_ratio, min_floor_ratio, max_floor_ratio, n_keys, n_chests - Un niveau hardcore typique : sol < 30%, ennemis > 25%, 3+ cles, 2+ coffres - Appelez solve_cpsat(12, 12, tileset, seed=42, add_connectivity=True, timeout_s=20.0, **votre_config) pour tester
# TODO etudiant : definir et tester votre preset "Hardcore"hardcore_config = {'min_enemy_ratio': 0.0, # TODO etudiant : choisir un ratio minimum d'ennemis'max_enemy_ratio': 0.0, # TODO etudiant : choisir un ratio maximum d'ennemis'min_floor_ratio': 0.0, # TODO etudiant : choisir un ratio minimum de sol'max_floor_ratio': 0.0, # TODO etudiant : choisir un ratio maximum de sol'n_keys': 0, # TODO etudiant : nombre de cles'n_chests': 0, # TODO etudiant : nombre de coffres}# TODO etudiant : decommenter et ajuster les parametres ci-dessus, puis tester# result_hardcore = solve_cpsat(12, 12, tileset, seed=42, add_connectivity=True, # timeout_s=20.0, **hardcore_config)# if result_hardcore.grid is not None:# s = result_hardcore.stats# print(f"Hardcore: {result_hardcore.status} {result_hardcore.solve_time:.2f}s")# print(f" ennemis={s['enemy_count']} sol={s['floor_cells']} cles={s['key_count']} coffres={s['chest_count']}")# else:# print(f"Hardcore: FAILED ({result_hardcore.status}) — ajustez les parametres")print("Exercice a completer : preset de difficulte Hardcore")
Exercice a completer : preset de difficulte Hardcore
7. Évaluation sur un second tileset (cave)
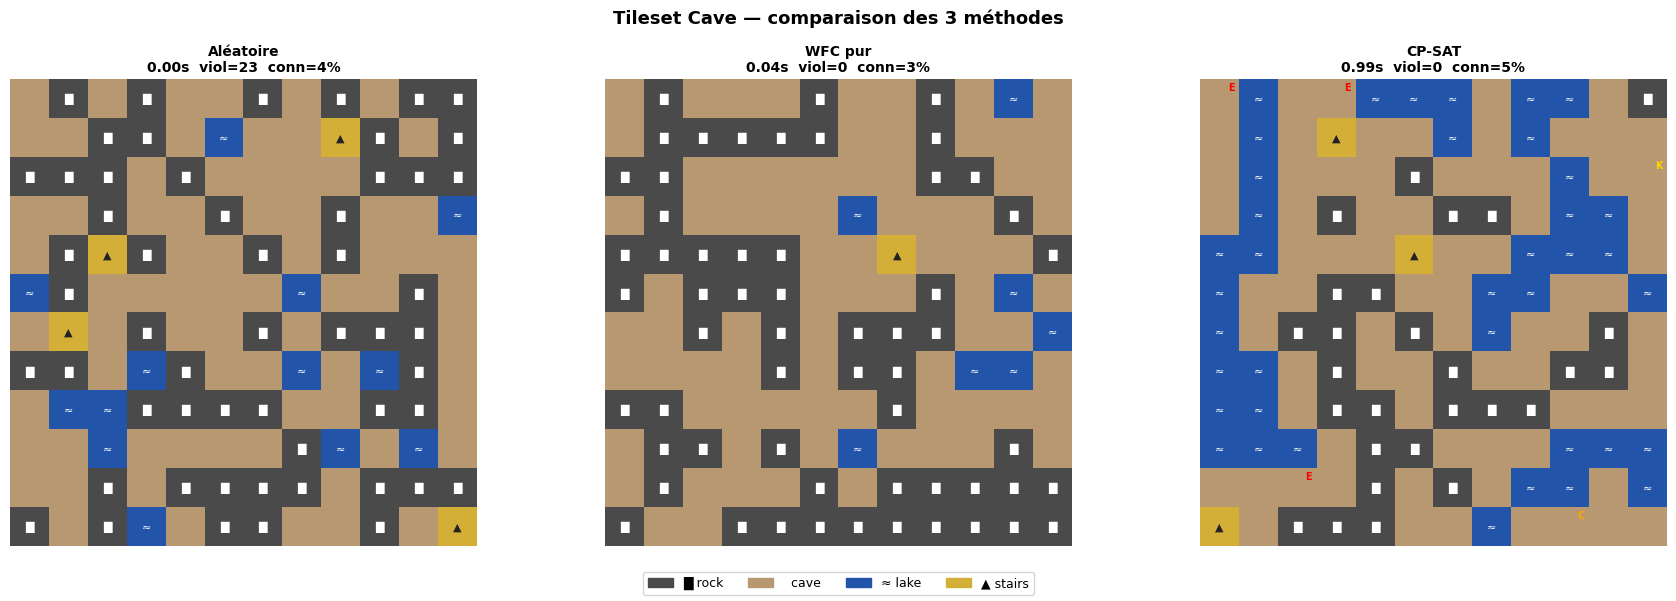
Vérification que l’approche est générique : le modèle CP-SAT s’adapte automatiquement à tout tileset JSON.
Tileset cave : 4 tuiles (roche, caverne, lac, escalier) avec des règles d’adjacence différentes.
tileset_cave = load_tileset('tileset_cave.json')tiles_cave = tileset_cave['tiles']rules_cave = {int(k): v for k, v in tileset_cave['adjacency']['rules'].items()}floor_cave_id =next(t['id'] for t in tiles_cave if t['name'] =='cave')print("Tileset cave chargé:", [t['name'] for t in tiles_cave])fig, axes = plt.subplots(1, 3, figsize=(18, 6))method_fns = [ ('Aléatoire', lambda: (generate_random(12, 12, tileset_cave, seed=7), None)), ('WFC pur', lambda: (PureWFC(12, 12, tileset_cave, seed=7).solve(), None)), ('CP-SAT', lambda: (r2 := solve_cpsat(12, 12, tileset_cave, seed=7, min_floor_ratio=0.25, max_floor_ratio=0.65, min_enemy_ratio=0.03, max_enemy_ratio=0.15, n_keys=1, n_chests=1, add_connectivity=True, timeout_s=20.0), (r2.grid, r2.stats.get('obj_grid') if r2.stats elseNone))[1]),]for ax, (name, fn) inzip(axes, method_fns): t0 = time.time() result = fn() elapsed = time.time() - t0 g, og = resultif g isNone: ax.text(0.5, 0.5, 'FAILED', ha='center', va='center', transform=ax.transAxes, fontsize=16, color='red') ax.axis('off');continue viol = adjacency_violations(g, rules_cave) conn = bfs_reachable_floor(g, floor_cave_id) plot_level(ax, g, og, f"{name}\n{elapsed:.2f}s viol={viol} conn={conn:.0%}", tileset_cave)legend_c = [mpatches.Patch(color=t['color'], label=f"{t['char']}{t['name']}") for t in tiles_cave]fig.legend(handles=legend_c, loc='lower center', ncol=len(tiles_cave), fontsize=9)plt.suptitle('Tileset Cave — comparaison des 3 méthodes', fontsize=13, fontweight='bold')plt.tight_layout(rect=[0, 0.06, 1, 0.96])plt.show()
Lecture — la généricité du modèle mise à l’épreuve
Le changement de tileset est un changement de données, pas de code : les trois méthodes sont appelées avec la même API (generate_random, PureWFC, solve_cpsat), et la sortie confirme le chargement des 4 tuiles cave (rock, cave, lake, stairs) contre 5 au donjon. Toute l’adaptation vit dans les deux JSON — c’est la propriété qui rend l’approche réutilisable au-delà du cas d’école.
Deux repères de lecture :
Le rôle de « sol » est une convention de nommage : c’est floor_cave_id = ... name == 'cave' qui désigne la tuile jouable ici. Les ratios de la section sont recalibrés pour la morphologie cave (sol 25–65 %, ennemis 3–15 %) — à comparer aux fenêtres du donjon en section 3.
Le seed est 7 ici (et non 42) : les trois méthodes restent comparées à graine égale entre elles — la comparaison reste appariée — mais l’instance diffère de celle du donjon, donc on ne compare pas les niveaux inter-tilesets.
Chaque clic sur « Générer » rejoue l’intégralité du pipeline des sections 3 à 5 : run_all relance aléatoire + WFC + CP-SAT avec les paramètres du panneau — seed, taille 6–18, tileset donjon ou cave, connectivité on/off — et les trois grilles sont rendues avec leurs métriques recalculées. Le panneau suit le même patron que le slider d’étape de la section 2 : un widget Output vidé à chaque interaction (clear_output(wait=True)) pour ne retenir que le dernier rendu.
Une observation honnête sur la version committée : les curseurs « Sol [min,max] » et « Ennemis » sont affichés dans le panneau, mais le rappel generate ne les lit pas — la signature de run_all (rows, cols, seed, tileset_path, cpsat_connectivity) n’expose pas de ratios, et le CP-SAT appelé en dessous garde donc ses valeurs par défaut. Les brancher est le prolongement naturel de cette section : étendre run_all avec deux paramètres optionnels, ou appeler solve_cpsat directement dans generate avec les bornes extraites des deux curseurs.
Synthese – WFC vs CP-SAT pour la generation procedurale
Critere
Aleatoire
WFC pur
CP-SAT
Violations d’adjacence
Elevees (ex: 20/12x12)
0
0
Connectivite garantie
Non (~2%)
Non (~2%)
Partiellement (relaxation flow, ~7% observe)
Contraintes globales (objets, difficulte)
Impossible
Impossible
Possible (sommes, ratios)
Variete de tuiles
Maximale
Maximale
Maximale
Temps de calcul
runtime machine-dep
runtime machine-dep
runtime machine-dep (entre OPTIMAL ~1 s et timeout 20 s)
Expressivite
Aucune
Locale uniquement
Globale + objectives
Note methodologique – separation structurel / machine-dep : toutes les colonnes sauf Temps de calcul sont des invariants structurels (resultats solveur sur instance specifique ou proprietes algorithmiques, deterministes sur la graine fixee). En revanche, la colonne Temps de calcul est machine-dep (CPU, charge systeme, version Python, OR-Tools, taille de l’instance) et ne survit pas a une re-execution sur une autre machine. L’ordre de grandeur qualitatif (Aleatoire et WFC tres rapides vs CP-SAT beaucoup plus lent) reste structurel, mais le ratio exact 30-500x mentionne dans les Points cles est lui aussi machine-dep (le ratio varie significativement d’une machine a l’autre). Pour observer vos propres timings et ratios, executez la cellule de benchmark ci-dessous.
Points cles a retenir
WFC modelise un probleme de propagation locale : chaque tuile contraint ses voisines immediates. C’est rapide, mais ne peut exprimer que des contraintes d’adjacence.
CP-SAT formule le meme probleme comme un CSP global : toutes les contraintes (adjacence + objets + difficulte + connectivite) sont satisfaites simultanement par un solveur SAT.
Trade-off expressivite/perf : CP-SAT est beaucoup plus lent que WFC (l’ordre de grandeur du ratio depend de la machine), mais permet d’exprimer des contraintes impossibles en WFC pur (nb exact d’objets, ratios globaux, connectivite).
Hybride possible : utiliser WFC pour generer un niveau rapidement, puis CP-SAT pour reparer/critiquer (verifier connectivite, compter objets). C’est l’approche pratique des game studios.
Pour aller plus loin
Optimizer la connectivite : remplacer la relaxation flow par une contrainte de chemin explicite (variables path[u] = rang dans le BFS), plus couteuse mais complete.
Multi-objectif : optimiser la variete (Maximize(sum(different))) tout en saturant les contraintes globales.
Generation de tilesets : apprendre les regles d’adjacence depuis une image de reference (WFC observationnel).
Parallelisation : CP-SAT supporte num_search_workers=N pour exploiter les CPU multi-coeurs.
Ce notebook a montre comment formuler un probleme de generation procedurale (typiquement traite par des heuristiques ad-hoc) comme un CSP canonique resolu par un solveur industriel (OR-Tools). C’est un pattern transferrable a de nombreux domaines : placement de composants en VLSI, allocation de frequences, planification de taches.