Utiliser PyTorch pour de vrais gradients (fin du prototype numpy de RL-02)
Comparer les 4 reward functions via entrainement PPO + evaluation multi-seed
Verdict honnete : la reward shaping ameliore-t-elle le Sharpe OOS vs B&H ?
1. Pourquoi le Reward Shape ?
Dans RL-01 et RL-02, la recompense etait simplement le P&L de la position :
\[r_t = a_t \cdot R_{t+1}\]
Problemes connus : - Myopie : l’agent maximise le gain immediate, ignore le risque a long terme - Volatilite excessive : pas de penalite pour les gros drawdowns - Transaction costs ignores : l’agent flip trop souvent
L’environnement encapsule les 4 fonctions de reward dans un seul step(). Le paramètre reward_type determine quelle fonction est utilisee pendant l’entrainement.
Contrairement a RL-02 (numpy + finite différences), ici on utilise torch.nn pour un backpropagation exact. L’actor produit une distribution softmax sur les 3 actions, le critic estime la valeur de l’etat.
PPO avec minibatch updates, clipping, et entropy bonus. La boucle collecte des trajectoires sur un episode complet, puis met a jour le reseau sur plusieurs epochs.
PPO: 200 episodes x 252 steps, LR=0.0003, CLIP=0.2
Ready to train with 4 reward types x 4 seeds = 16 runs
5. Entrainement comparatif : 4 reward functions x 1 seed
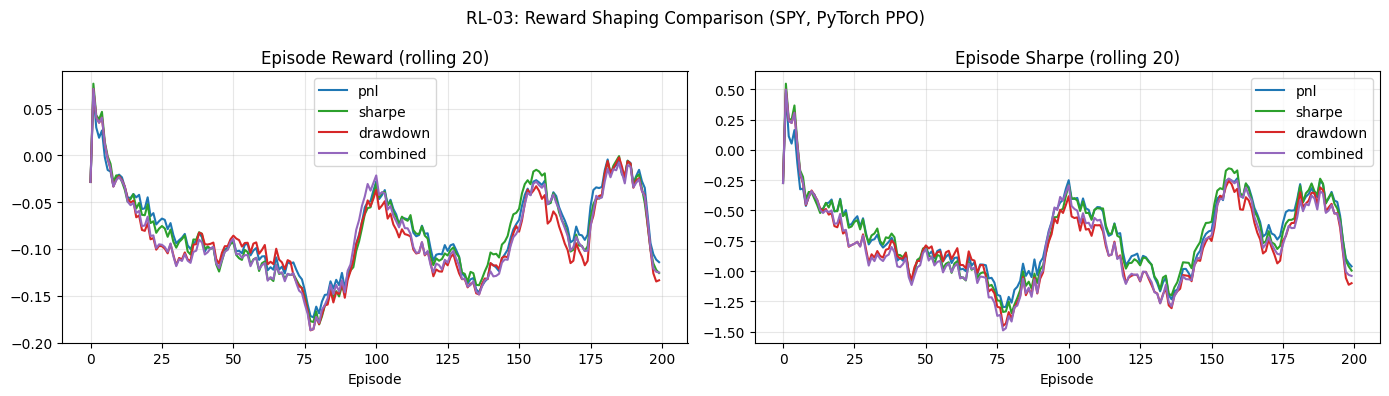
On entraine un agent par reward function (seed=0) et on compare les courbes d’apprentissage.
reward_types = ["pnl", "sharpe", "drawdown", "combined"]train_results = {}for rt in reward_types: env = TradingEnvWithReward(returns, reward_type=rt) model, ep_rewards, ep_sharpes = train_ppo(env, seed=0, verbose=False) train_results[rt] = {"rewards": ep_rewards, "sharpes": ep_sharpes} final_sharpe = np.mean(ep_sharpes[-20:])print(f"Reward={rt:10s} | Final Sharpe (last 20 ep mean): {final_sharpe:+.3f}")# Plot learning curvesfig, axes = plt.subplots(1, 2, figsize=(14, 4))colors = {"pnl": "#1f77b4", "sharpe": "#2ca02c", "drawdown": "#d62728", "combined": "#9467bd"}for rt in reward_types:# Smooth with rolling mean rw = pd.Series(train_results[rt]["rewards"]).rolling(20, min_periods=1).mean() sh = pd.Series(train_results[rt]["sharpes"]).rolling(20, min_periods=1).mean() axes[0].plot(rw, label=rt, color=colors[rt]) axes[1].plot(sh, label=rt, color=colors[rt])axes[0].set_title("Episode Reward (rolling 20)")axes[0].set_xlabel("Episode")axes[0].legend()axes[0].grid(True, alpha=0.3)axes[1].set_title("Episode Sharpe (rolling 20)")axes[1].set_xlabel("Episode")axes[1].legend()axes[1].grid(True, alpha=0.3)plt.suptitle(f"RL-03: Reward Shaping Comparison (SPY, PyTorch PPO)", fontsize=12)plt.tight_layout()plt.savefig("rl_reward_shaping_curves.png", dpi=100, bbox_inches="tight")plt.show()print(f"\nLearning curves saved. Best reward type by final Sharpe: "f"{max(reward_types, key=lambda rt: np.mean(train_results[rt]['sharpes'][-20:]))}")
Reward=pnl        | Final Sharpe (last 20 ep mean): -0.962
Reward=sharpe     | Final Sharpe (last 20 ep mean): -0.996
Reward=drawdown   | Final Sharpe (last 20 ep mean): -1.101
Reward=combined   | Final Sharpe (last 20 ep mean): -1.040
Learning curves saved. Best reward type by final Sharpe: pnl
6. Evaluation out-of-sample
On utilise les 70% premiers jours pour l’entrainement, les 30% suivants pour le test (evaluation OOS). La politique est gloutonne (déterministe).
Le verdict est honnete : la reward shaping ameliore-t-elle significativement le Sharpe OOS par rapport au B&H ? Edge >= 2 sigma cross-seed necessaire pour “BEATS”.
print("="*70)print("VERDICT -- QC-Py-RL-03: Reward Shaping with PyTorch PPO")print("="*70)# Best reward type by mean deltabest_rt =max(reward_types, key=lambda rt: multi_seed_results[rt]["mean_delta"])best = multi_seed_results[best_rt]# Overall verdict: best reward type's multi-seed resultif best["n_positive"] >=3and (np.isnan(best["sigma_edge"]) or best["sigma_edge"] >=2.0): verdict ="BEATS"elif best["mean_delta"] <0or best["n_positive"] <2: verdict ="NO BEATS"else: verdict ="INCONCLUSIVE"print(f"Best reward type: {best_rt}")print(f"Mean delta Sharpe: {best['mean_delta']:+.3f}")print(f"Sigma edge: {best['sigma_edge']:+.2f}")print(f"Seeds positive: {best['n_positive']}/4")print(f"\n>>> VERDICT: {verdict} <<<")if verdict =="NO BEATS":print(f"\nNote: Meme avec PyTorch + reward shaping, le B&H SPY reste dur a battre.")print(f"RL-04 explorera GRPO (Group Relative Policy Optimization) pour une")print(f"approche differente d'optimisation de politique.")print(f"\n{'='*70}")print(f"RL Series Progress (#1461)")print(f"{'='*70}")print(f" RL-1. Q-Learning Tabulaire | NO BEATS | PR #1581")print(f" RL-2. PPO (numpy) | NO BEATS | PR #1583")print(f" RL-3. Reward Shaping (PyTorch) | {verdict:15s} | This PR <<<")print(f" RL-4. GRPO | Pending | -")print(f" RL-5. Portfolio RL | Pending | -")
======================================================================
VERDICT -- QC-Py-RL-03: Reward Shaping with PyTorch PPO
======================================================================
Best reward type: sharpe
Mean delta Sharpe: -1.519
Sigma edge:        -0.76
Seeds positive:    1/4

>>> VERDICT: NO BEATS <<<

Note: Meme avec PyTorch + reward shaping, le B&H SPY reste dur a battre.
RL-04 explorera GRPO (Group Relative Policy Optimization) pour une
approche differente d'optimisation de politique.

======================================================================
RL Series Progress (#1461)
======================================================================
  RL-1. Q-Learning Tabulaire           | NO BEATS        | PR #1581
  RL-2. PPO (numpy)                    | NO BEATS        | PR #1583
  RL-3. Reward Shaping (PyTorch)       | NO BEATS        | This PR <<<
  RL-4. GRPO                           | Pending         | -
  RL-5. Portfolio RL                   | Pending         | -