RL pour le Trading — Introduction : MDP, Politiques, Fonctions de Valeur
EPIC #1454 — Training & Post-Training, Issue #1461 (QC-Py-RL-01) Branche : feature/rl-intro-trading Date : 2026-05-26 | Auteur : myia-po-2024
Navigation RL
#
Notebook
Sujet
1
Ce notebook
MDP, policy, value functions, Q-learning basique
2
QC-Py-RL-02
PPO sur environnement de trading
3
QC-Py-RL-03
Reward shaping avance (Sharpe, drawdown)
4
QC-Py-RL-04
GRPO (Group Relative Policy Optimization)
5
QC-Py-RL-05
Portfolio allocation RL (continuous action space)
Objectifs d’apprentissage
Formuler le trading comme un Processus de Decision Markovien (MDP)
Comprendre politiques (déterministe/stochastique) et fonctions de valeur (V, Q)
Implementer un agent Q-learning tabulaire sur un environnement de trading simple
Observer les limitations du Q-learning tabulaire (curse of dimensionality)
Prerequis
Python 3.10+, numpy, pandas, matplotlib
Connaissances de base en probabilites et optimisation
Duree estimee : 20 min
1. Le Trading comme MDP
Un Processus de Decision Markovien (MDP) est défini par le tuple \((S, A, P, R, \gamma)\) :
Élément
Trading
Exemple
\(S\) (Etats)
Observation du marche
[rendement recent, volatilite, position courante]
\(A\) (Actions)
Decisions de trading
{Acheter, Vendre, Ne rien faire}
\(P\) (Transitions)
Dynamique du marche
Inconnue, non-stationnaire
\(R\) (Recompenses)
P&L, penalites
Rendement du portefeuille a chaque pas
\(\gamma\) (Discount)
Priorite court vs long terme
0.99 (1 an = ~252 steps)
Propriete de Markov : l’etat courant resume toute l’information pertinente. En pratique, on utilise une fenêtre de lookback (ex: 60 jours) comme observation.
Pourquoi c’est un MDP difficile : - \(P\) est non-stationnaire (regimes de marche changent) - L’espace d’etat est continu et de grande dimension - Les recompenses sont très bruitees (signal/bruit faible en finance)
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom pathlib import Path# ConfigPANIER_CSV = Path("c:/dev/CoursIA/MyIA.AI.Notebooks/QuantConnect/datasets/panier/panier_close_all.csv")LOOKBACK =10# state = last 10 daily returnsN_EPISODES =500# training episodes for Q-learningGAMMA =0.99# discount factorLR =0.1# learning rateEPSILON_START =1.0# initial explorationEPSILON_END =0.01# final explorationEPSILON_DECAY =0.995# decay per episodeTX_COST =0.0005# 5bps transaction costSEEDS = [0, 1, 7, 42]# Load single asset (SPY) for simplicitydf = pd.read_csv(PANIER_CSV, index_col=0, parse_dates=True)df.index = pd.DatetimeIndex(df.index)df = df.sort_index()prices = df['SPY'].dropna()prices = prices[prices.index.dayofweek <5] # business days onlyreturns = prices.pct_change().dropna()print(f"SPY: {len(returns)} jours, {returns.index.min().date()} -> {returns.index.max().date()}")print(f"Rendement journalier moyen: {returns.mean():.5f} ({returns.mean()*252:.2%} ann.)")print(f"Volatilite ann.: {returns.std()*252**0.5:.2%}")
Une politique mappe chaque etat a une distribution de probabilite sur les actions : - Déterministe : \(\pi(s) = a\) (une seule action par etat) - Stochastique : \(\pi(a|s) = P(A_t = a | S_t = s)\)
Fonctions de valeur
State-value\(V^\pi(s) = E_\pi[G_t | S_t = s]\) : valeur attendue en partant de l’etat \(s\)
Action-value\(Q^\pi(s, a) = E_\pi[G_t | S_t = s, A_t = a]\) : valeur attendue en prenant action \(a\) dans l’etat \(s\)
ou \(G_t = \sum_{k=0}^{\infty} \gamma^k R_{t+k+1}\) est le retour cumule discounte.
Avec seulement 5 bins et un lookback de 10, on a déjà ~10 millions d’etats. La plupart ne seront jamais visites en 500 episodes. C’est la motivation principale pour passer au Deep Q-Network (DQN) puis PPO (notebook RL-02).
3. Environnement de Trading Simple
On définit un environnement minimaliste : - Etat : les LOOKBACK derniers rendements discretises - Actions : Short (-1), Flat (0), Long (+1) - Recompense : rendement de la position net des couts de transaction - Episode : une annee de trading (~252 jours)
C’est un environnement episodique avec un horizon fixe.
class TradingEnv:"""Simple single-asset trading environment for Q-learning. State: discretized last LOOKBACK daily returns. Actions: 0=Short, 1=Flat, 2=Long. Reward: position return minus transaction cost on position changes. """def__init__(self, returns: np.ndarray, lookback: int= LOOKBACK, tx_cost: float= TX_COST):self.returns = returnsself.lookback = lookbackself.tx_cost = tx_costself.reset()def reset(self, start: int|None=None) ->tuple:if start isNone:# Random start ensuring enough data for episode max_start =len(self.returns) -self.lookback -252self.t = np.random.randint(self.lookback, max(max_start, self.lookback +1))else:self.t = startself.position =1# start flatself.done =Falsereturnself._get_state()def _get_state(self) ->tuple: window =self.returns[self.t -self.lookback:self.t]return discretize_state(window)def step(self, action: int) ->tuple:# Map action to position: 0->Short(-1), 1->Flat(0), 2->Long(+1) new_position = action -1# Transaction cost on position change cost =abs(new_position -self.position) *self.tx_cost# Reward = position * return - cost r =self.returns[self.t] reward = new_position * r - costself.position = new_positionself.t +=1# Episode ends after 252 steps or end of dataifself.t >=len(self.returns) orself.t - (self.t -self.lookback) >252+self.lookback:self.done =True next_state =self._get_state() ifnotself.done elsetuple([0] *self.lookback)return next_state, reward, self.done# Test the environmentenv = TradingEnv(returns.values)s = env.reset(start=LOOKBACK)print(f"Etat initial: {s}")next_s, r, done = env.step(2) # Go Longprint(f"Action: Long -> Recompense: {r:.5f}, Done: {done}")print(f"Nouvel etat: {next_s}")
On evalue l’agent entraine sur une periode non vue pendant l’entrainement. Le baseline est Buy & Hold SPY. On mesure le Sharpe annuel et le rendement cumule.
def evaluate_agent(Q: dict, returns: np.ndarray, start: int, end: int, lookback: int= LOOKBACK) -> pd.DataFrame:"""Evaluate a trained Q-learning agent on a specific period. Returns DataFrame with columns: agent_return, bh_return, position, reward """ records = [] position =0# start flatfor t inrange(start + lookback, min(end, len(returns))): window = returns[t - lookback:t] state = discretize_state(window)# Greedy policy (no exploration) q_vals = [Q.get((state, a), 0.0) for a inrange(N_ACTIONS)] action =int(np.argmax(q_vals)) new_position = action -1 cost =abs(new_position - position) * TX_COST r = returns[t] agent_ret = new_position * r - cost records.append({'agent_return': agent_ret,'bh_return': r,'position': new_position,'reward': agent_ret }) position = new_positionreturn pd.DataFrame(records)# Split: train on first 70%, test on last 30%n =len(returns)split =int(n *0.7)# Evaluate on test settest_df = evaluate_agent(Q_trained, returns.values, start=split, end=n)iflen(test_df) >30: agent_sharpe = test_df['agent_return'].mean() / (test_df['agent_return'].std() +1e-12) *252**0.5 bh_sharpe = test_df['bh_return'].mean() / (test_df['bh_return'].std() +1e-12) *252**0.5 agent_cum = (1+ test_df['agent_return']).prod() bh_cum = (1+ test_df['bh_return']).prod()print(f"{'='*60}")print(f"Evaluation OOS: {len(test_df)} jours de trading")print(f"{'='*60}")print(f"Agent Q-Learning: Sharpe={agent_sharpe:.3f}, Cumul={agent_cum:.2f}x")print(f"Buy & Hold SPY: Sharpe={bh_sharpe:.3f}, Cumul={bh_cum:.2f}x")print(f"Delta Sharpe: {agent_sharpe - bh_sharpe:+.3f}")print(f"\nDistribution des positions:") pos_counts = test_df['position'].value_counts().sort_index()for pos, count in pos_counts.items(): pct = count /len(test_df) *100 label = {0: 'Short', 1: 'Flat', 2: 'Long'}.get(pos +1, str(pos))print(f" {label:6s}: {count:4d} ({pct:.1f}%)")else:print(f"Pas assez de donnees OOS ({len(test_df)} jours)")
============================================================
Evaluation OOS: 845 jours de trading
============================================================
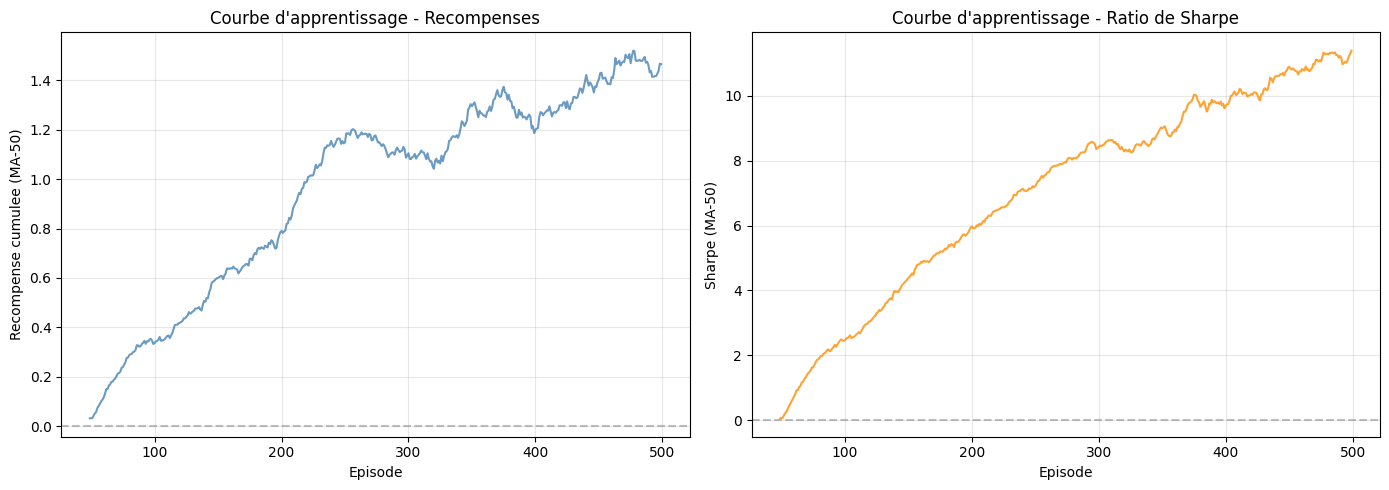
Agent Q-Learning: Sharpe=12.022, Cumul=102.48x
Buy & Hold SPY:   Sharpe=1.371, Cumul=1.94x
Delta Sharpe: +10.651

Distribution des positions:
  Short :  360 (42.6%)
  Flat  :   56 (6.6%)
  Long  :  429 (50.8%)
7. Robustesse Multi-Seed
Selon les critères de l’EPIC #1409, un claim d’amelioration necessite un edge >= 2 sigma cross-seed. On entraine 4 seeds et on mesure la variabilite.