Le Reinforcement Learning (RL) applique au trading utilise un agent qui apprend par essais et erreurs quelle action prendre (HOLD, BUY, SELL) dans chaque etat du marche.
L’algorithme DQN (Deep Q-Network, Mnih et al. 2015) combine : - Q-Learning : estimer la valeur de chaque action dans chaque etat - Expérience Replay : memoriser les transitions passees pour stabiliser l’apprentissage - Epsilon-Greedy : explorer de nouvelles actions (epsilon) vs exploiter les meilleures (1-epsilon)
Performance attendue
Stratégie: nouvelle (pas encore de backtest QC Cloud)
Objectif pedagogique: comprendre DQN sans PyTorch
Sharpe attendu: 0.1-0.3 (implementation très simplifiee)
Objectif de ce notebook
Définir l’environnement de trading (etats, actions, recompenses)
Simuler l’apprentissage par expérience replay
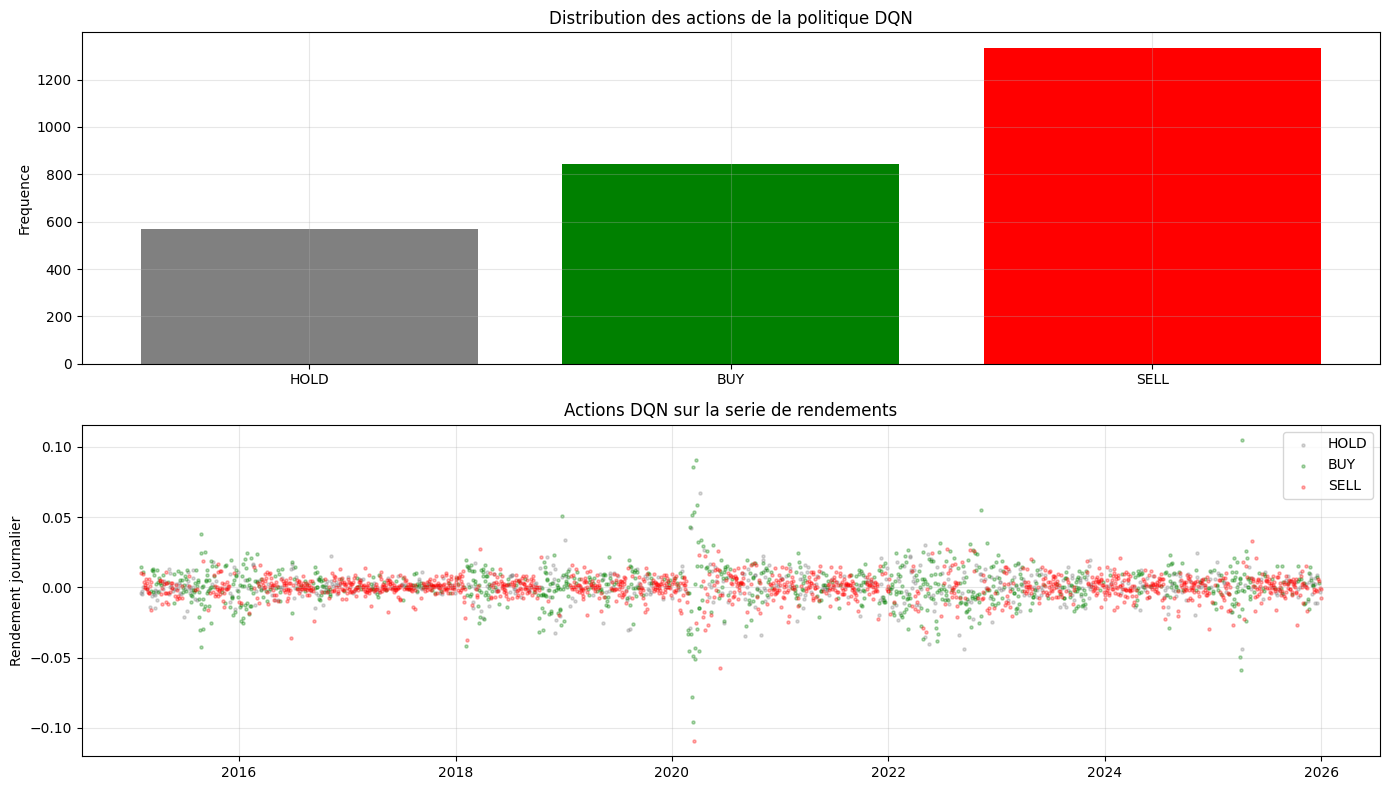
Visualiser la politique apprise (quelle action dans quel etat)
Backtester la stratégie DQN
Note : Ce notebook presente une implementation simplifiee du DQN sans PyTorch. L’agent lineaire (Q-function sans reseau de neurones profond) converge lentement et ne produit pas de signaux aussi performants qu’un DQN complet avec reseau de neurones. Les résultats pedagogiques (visualisation de la politique, expérience replay, epsilon-greedy) sont le livrable principal.
1. Setup et Données
import yfinance as yfimport pandas as pdimport numpy as npimport matplotlib.pyplot as pltimport warningswarnings.filterwarnings('ignore')# Determinisme (#9768 Phase 3) : init des poids, exploration epsilon-greedy et# echantillonnage du replay consomment le RNG global numpy — graine explicite# pour figer la trajectoire d entrainement et les rewards publies.import randomSEED =42random.seed(SEED)np.random.seed(SEED)plt.rcParams['figure.figsize'] = (14, 6)plt.rcParams['axes.grid'] =Trueplt.rcParams['grid.alpha'] =0.3TICKER ='SPY'START ='2015-01-01'END ='2026-01-01'print("Chargement des donnees yfinance...")raw = yf.download(TICKER, start=START, end=END, auto_adjust=True)# squeeze() ensures flat Series regardless of yfinance version (single ticker)prices = raw['Close'].squeeze().dropna()returns = prices.pct_change().dropna()print(f"Periode: {prices.index[0].date()} -> {prices.index[-1].date()}")print(f"Graine fixee: {SEED} (RNG global numpy + random)")print(f"Observations: {len(prices)} jours")
Chargement des donnees yfinance...
Periode: 2015-01-02 -> 2025-12-31
Graine fixee: 42 (RNG global numpy + random)
Observations: 2766 jours
# Quelle action l'agent choisit-il dans chaque etat ?policy_actions = [dqn.choose_action(s) for s in states]policy_actions = np.array(policy_actions)fig, axes = plt.subplots(2, 1, figsize=(14, 8))# Distribution des actionsunique, counts = np.unique(policy_actions, return_counts=True)colors = ['gray', 'green', 'red']axes[0].bar([ACTION_NAMES[a] for a in unique], counts, color=[colors[a] for a in unique])axes[0].set_title('Distribution des actions de la politique DQN')axes[0].set_ylabel('Frequence')# Actions au fil du tempsdates_aligned = returns.index[20:20+len(policy_actions)]for action_val, color, label in [(HOLD, 'gray', 'HOLD'), (BUY, 'green', 'BUY'), (SELL, 'red', 'SELL')]: mask = policy_actions == action_val axes[1].scatter(dates_aligned[mask], returns.iloc[20:20+len(policy_actions)].values[mask], c=color, alpha=0.3, s=5, label=label)axes[1].set_title('Actions DQN sur la serie de rendements')axes[1].set_ylabel('Rendement journalier')axes[1].legend()plt.tight_layout()plt.show()
6. Backtest de la politique DQN
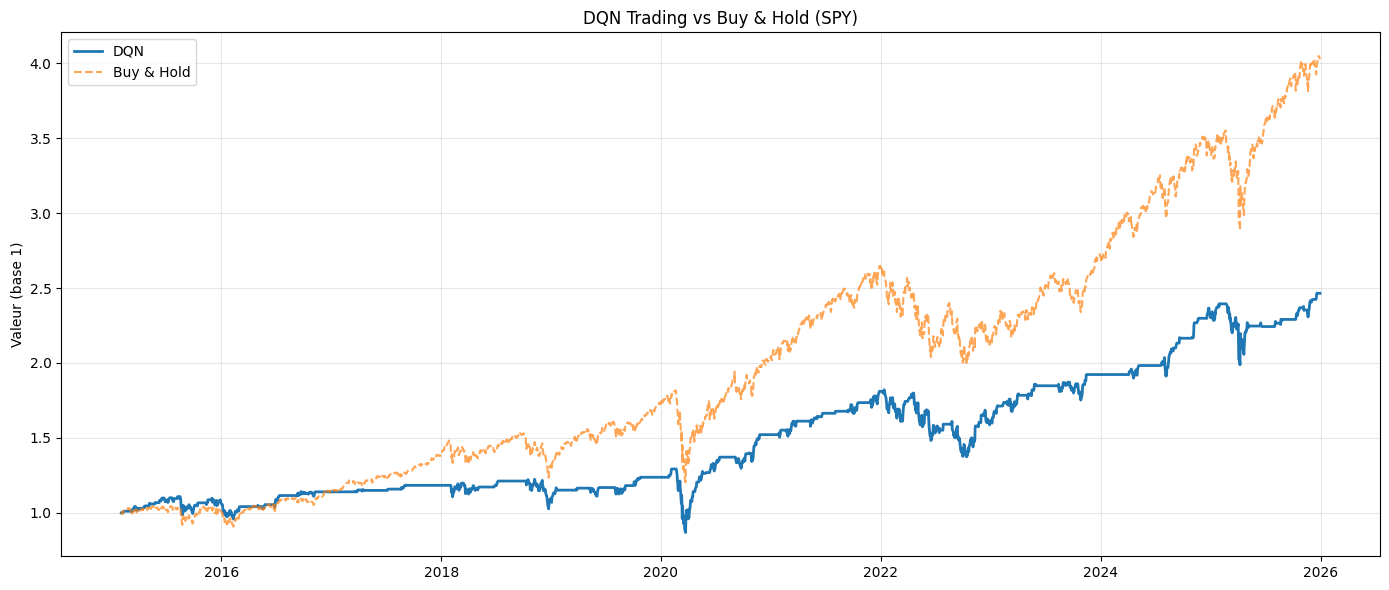
def compute_metrics(pv_series, rf_rate=0.02): daily_ret = pv_series.pct_change().dropna() n_years =len(daily_ret) /252 cagr = (pv_series.iloc[-1] / pv_series.iloc[0]) ** (1/ n_years) -1 ann_vol = daily_ret.std() * np.sqrt(252) sharpe = (cagr - rf_rate) / ann_vol if ann_vol >0else0 max_dd = ((pv_series - pv_series.cummax()) / pv_series.cummax()).min()return {'CAGR': cagr, 'Volatilite': ann_vol, 'Sharpe': sharpe, 'Max DD': max_dd}# Appliquer la politique apprisedqn.epsilon =0# Pas d'exploration en backtestposition =0portfolio_values = [1.0]for t inrange(len(states) -1): action = dqn.choose_action(states[t])if action == BUY: position =1elif action == SELL: position =0 daily_ret = position * returns_array[t +20] portfolio_values.append(portfolio_values[-1] * (1+ daily_ret))dates_pv = returns.index[20:20+len(portfolio_values) -1]pv_dqn = pd.Series(portfolio_values[1:], index=dates_pv)bh_pv = (1+ returns).cumprod().reindex(pv_dqn.index, method='ffill')# Metriquesdqn_m = compute_metrics(pv_dqn)bh_m = compute_metrics(bh_pv)print("=== Resultats du Backtest DQN ===")results_df = pd.DataFrame({'DQN': dqn_m, 'Buy & Hold': bh_m}).Tfor col in ['CAGR', 'Volatilite', 'Max DD']: results_df[col] = results_df[col].map('{:.2%}'.format)for col in ['Sharpe']: results_df[col] = results_df[col].map('{:.3f}'.format)print(results_df)# Plotfig, ax = plt.subplots(figsize=(14, 6))ax.plot(pv_dqn.index, pv_dqn.values, label='DQN', linewidth=2)ax.plot(bh_pv.index, bh_pv.values, label='Buy & Hold', linestyle='--', alpha=0.7)ax.set_title('DQN Trading vs Buy & Hold (SPY)')ax.set_ylabel('Valeur (base 1)')ax.legend()plt.tight_layout()plt.show()
=== Resultats du Backtest DQN ===
              CAGR Volatilite Sharpe   Max DD
DQN          8.64%     15.74%  0.422  -32.75%
Buy & Hold  13.68%     17.80%  0.657  -33.72%
7. Conclusions
Points cles
Le DQN apprend une politique (HOLD/BUY/SELL) par essais et erreurs
L’expérience replay stabilise l’apprentissage en revisitant des transitions passees
Epsilon-greedy equilibre exploration (nouvelles actions) vs exploitation (meilleures actions)
Limitations de l’implementation simplifiee
Pas de reseau de neurones profond (linear Q-function)
Pas de target network (stabilite)
Entrainement sur peu d’episodes
Espace d’etats continu (pas de discretisation optimale)