Objectif
Analyser une stratégie d’allocation de portefeuille utilisant le Reinforcement Learning.
Stratégie
Algorithme : Q-Learning (model-free RL)État : Régime de marché (tendance, volatilité, momentum)Actions : Allouer à SPY, TLT, GLD ou CashRécompense : Rendement ajusté du risque (Sharpe-like)Exploration : Epsilon-greedy avec decay
Hypothèses à tester
Learning rate: 0.01, 0.05, 0.1
Discount factor: 0.9, 0.95, 0.99
Epsilon decay: 0.99, 0.995, 0.999
Prérequis
Environnement Lean Research
numpy pour Q-table
Durée estimée: ~20 minutes
Note : Le Q-Learning apprend une politique d’allocation optimale par essai-erreur.
# Setup QuantBook from AlgorithmImports import * import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport warnings'ignore' )'seaborn-v0_8-darkgrid' )'figure.figsize' ] = (14 , 5 )= QuantBook()print ("QuantBook initialisé." )
1. Chargement des données
On charge les données de 3 ETF pour l’allocation de portefeuille.
# Assets: SPY (Stocks), TLT (Bonds), GLD (Gold) = ['SPY' , 'TLT' , 'GLD' ]= {}for asset in assets:= qb.add_equity(asset, Resolution.DAILY).symbol# Charger l'historique (2020-2026) = datetime(2020 , 1 , 1 )= datetime(2026 , 1 , 1 )= qb.history(list (symbols.values()), start, end, Resolution.DAILY)print (f"Données chargées: { len (history)} lignes" )
Données chargées: 4524 lignes
Pivot de la série ‘close’ en DataFrame large, avec remapping des colonnes Symbol → ticker pour RL-Portfolio.
# Pivoter les données = history['close' ].unstack(level= 0 )= {str (v): k for k, v in symbols.items()}= [symbol_to_ticker.get(str (c), str (c)) for c in closes.columns]# Filter assets to only those with available data = [a for a in assets if a in closes.columns]= available_assetsif len (assets) < 3 :print (f"WARNING: Only { len (assets)} asset(s) available: { assets} " )print ("RL multi-asset strategy requires at least 3 assets (SPY, TLT, GLD)." )print ("All RL-dependent analysis cells will be skipped." )= None else := closes.dropna()print (f"Période: { closes. index[0 ]. date()} à { closes. index[- 1 ]. date()} " )print (f"Données: { len (closes)} jours de trading" )print (f" \n Available assets ( { len (assets)} ): { assets} " )print (f" \n Performance totale:" )for asset in assets:= (closes[asset].iloc[- 1 ] / closes[asset].iloc[0 ] - 1 ) * 100 print (f" { asset} : { ret:+.1f} %" )
Période: 2020-01-02 à 2025-12-31
Données: 1508 jours de trading

Available assets (3): ['SPY', 'TLT', 'GLD']

Performance totale:
  SPY: +114.5%
  TLT: -36.4%
  GLD: +175.3%
2. Définition de l’Environnement RL
État, Actions, Récompenses.
class RLEnvironment:"""Environnement simplifié pour l'allocation de portefeuille.""" def __init__ (self , closes):self .closes = closesself .current_idx = 0 # Actions: 0=SPY, 1=TLT, 2=GLD, 3=Cash self .actions = [0 , 1 , 2 , 3 ]self .action_names = ['SPY' , 'TLT' , 'GLD' , 'Cash' ]# Allocation par action self .allocations = np.array([1.0 , 0.0 , 0.0 ], # SPY 0.0 , 1.0 , 0.0 ], # TLT 0.0 , 0.0 , 1.0 ], # GLD 0.0 , 0.0 , 0.0 ] # Cash def reset(self , start_idx= 60 ):"""Reset l'environnement.""" self .current_idx = start_idxreturn self ._get_state()def _get_state(self ):"""Calculer l'état actuel du marché.""" if self .current_idx < 60 :return np.zeros(10 )= self .closes['SPY' ].iloc[:self .current_idx]= self .closes['TLT' ].iloc[:self .current_idx]= spy.pct_change()= spy.iloc[- 1 ]# Features d'état = spy.ewm(span= 20 ).mean().iloc[- 1 ]= spy.ewm(span= 50 ).mean().iloc[- 1 ]= spy.ewm(span= 200 ).mean().iloc[- 1 ]= np.array([1 if spy_price > ema20 else 0 , # Trend court 1 if spy_price > ema200 else 0 , # Trend long int (spy_returns.rolling(20 ).std().iloc[- 1 ] > spy_returns.rolling(60 ).std().mean()), # Vol 1 if spy_returns.rolling(5 ).sum ().iloc[- 1 ] > 0 else 0 , # Momentum 5j 1 if spy_returns.rolling(20 ).sum ().iloc[- 1 ] > 0 else 0 , # Momentum 20j 1 if tlt.pct_change().rolling(20 ).sum ().iloc[- 1 ] > spy_returns.rolling(20 ).sum ().iloc[- 1 ] else 0 , # Flight to safety 1 if spy_price > ema20 else 0 , # Above MA20 1 if spy_price > ema50 else 0 , # Above MA50 int (self .closes.index[self .current_idx].month % 4 ), # Quarter int (self .closes.index[self .current_idx].day < 10 ) # Start of month return statedef step(self , action):"""Exécuter une action et retourner (next_state, reward, done).""" if self .current_idx >= len (self .closes) - 1 :return self ._get_state(), 0 , True # Rendements des assets = self .closes.iloc[self .current_idx + 1 ] / self .closes.iloc[self .current_idx] - 1 # Rendement du portefeuille selon l'action = self .allocations[action]= (alloc * returns).sum ()# Récompense: rendement - pénalité si volatilité élevée = portfolio_returnself .current_idx += 1 = self ._get_state()= self .current_idx >= len (self .closes) - 1 return next_state, reward, doneif closes is None :print ("Data not available - skipping RL environment setup." )= None else :# Créer l'environnement = RLEnvironment(closes)# Test = env.reset()print (f"État initial: { state} " )= env.step(0 ) # Action: investir dans SPY print (f"Action 0 (SPY) -> Reward: { reward:.4f} " )print (f"État initial: { state} " )= env.step(0 ) # Action: investir dans SPY print (f"Action 0 (SPY) -> Reward: { reward:.4f} " )
État initial: [0 0 0 1 0 1 0 0 3 0]
Action 0 (SPY) -> Reward: -0.0318
État initial: [0 0 0 1 0 1 0 0 3 0]
Action 0 (SPY) -> Reward: 0.0095
Interprétation: Environnement RL
État : Vecteur de 10 features binaires/continues décrivant le marchéActions : 4 choix d’allocation (SPY, TLT, GLD, Cash)Récompense : Rendement du portefeuille (maximiser la richesse)
3. Agent Q-Learning
class QLearningAgent:"""Agent Q-Learning pour l'allocation de portefeuille.""" def __init__ (self , state_size, action_size, learning_rate= 0.01 , discount_factor= 0.95 ):self .state_size = state_sizeself .action_size = action_sizeself .learning_rate = learning_rateself .discount_factor = discount_factor# Q-table self .q_table = np.zeros((state_size, action_size))# Exploration self .epsilon = 1.0 self .epsilon_min = 0.01 self .epsilon_decay = 0.995 def get_state_idx(self , state):"""Convertir l'état en index pour la Q-table.""" # Hash simple (à améliorer avec des bins pour les features continues) return int (sum (state * (2 ** np.arange(len (state))))) % self .state_sizedef select_action(self , state, training= True ):"""Sélectionner une action (epsilon-greedy).""" if training and np.random.random() < self .epsilon:return np.random.randint(self .action_size)else := self .get_state_idx(state)return np.argmax(self .q_table[state_idx])def learn(self , state, action, reward, next_state):"""Mettre à jour la Q-table.""" = self .get_state_idx(state)= self .get_state_idx(next_state)= self .q_table[state_idx, action]= np.max (self .q_table[next_state_idx])# Q-learning update = current_q + self .learning_rate * (+ self .discount_factor * max_next_q - current_qself .q_table[state_idx, action] = new_q# Decay epsilon self .epsilon = max (self .epsilon_min, self .epsilon * self .epsilon_decay)def get_policy(self , state):"""Retourner l'action optimale pour un état (sans exploration).""" = self .get_state_idx(state)return np.argmax(self .q_table[state_idx])# Créer l'agent = QLearningAgent(state_size= 10 , action_size= 4 )print (f"Agent créé. Q-table shape: { agent. q_table. shape} " )
Agent créé. Q-table shape: (10, 4)
4. Entraînement de l’Agent
def train_agent(env, agent, n_episodes= 50 , max_steps_per_episode= 500 ):""" Entraîner l'agent sur plusieurs épisodes. """ = []= []for episode in range (n_episodes):= env.reset()= 0 for step in range (max_steps_per_episode):# Sélectionner et exécuter une action = agent.select_action(state, training= True )= env.step(action)# Apprendre += reward= next_stateif done:break if (episode + 1 ) % 10 == 0 :print (f"Episode { episode+ 1 } / { n_episodes} - Reward: { total_reward:.4f} , Epsilon: { agent. epsilon:.3f} " )return episode_rewards, epsilon_historyif env is None :print ("RL environment not available - skipping agent training." )= [], []else :# Entraîner l'agent = train_agent(env, agent, n_episodes= 50 )if len (rewards) > 0 :print (f" \n Entraînement terminé." )print (f"Reward moyen (10 derniers épisodes): { np. mean(rewards[- 10 :]):.4f} " )print (f"Epsilon final: { agent. epsilon:.3f} " )else :print ("Agent training skipped." )
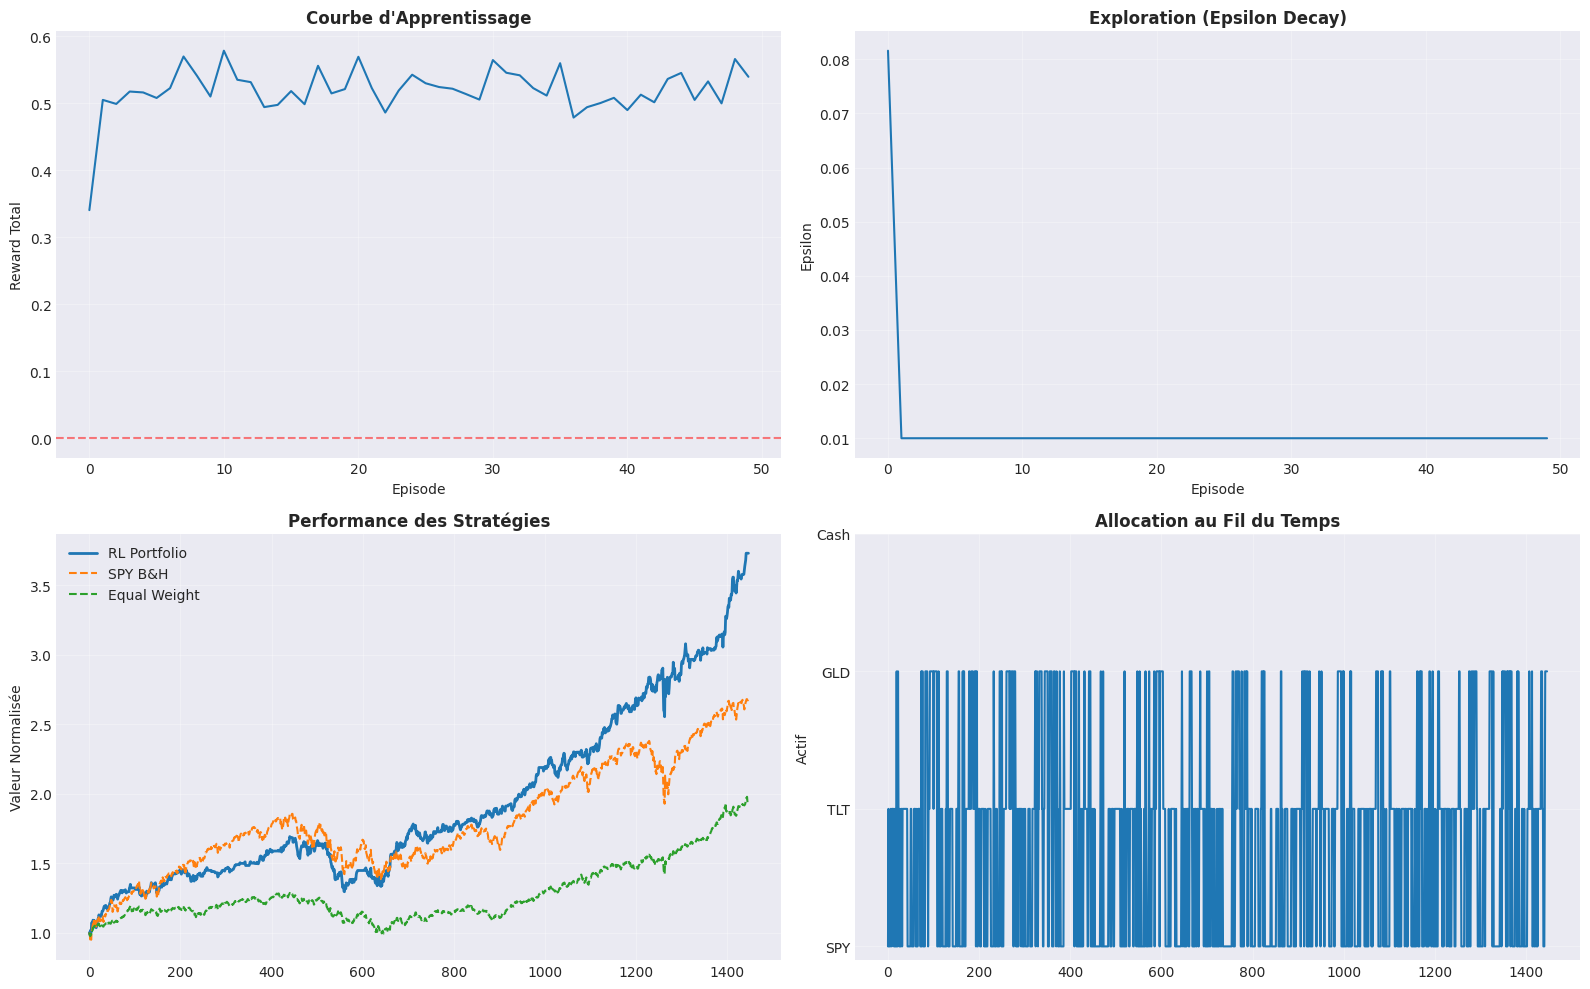
Episode 10/50 - Reward: 0.5104, Epsilon: 0.010
Episode 20/50 - Reward: 0.5215, Epsilon: 0.010
Episode 30/50 - Reward: 0.5058, Epsilon: 0.010
Episode 40/50 - Reward: 0.5084, Epsilon: 0.010
Episode 50/50 - Reward: 0.5398, Epsilon: 0.010

Entraînement terminé.
Reward moyen (10 derniers épisodes): 0.5232
Epsilon final: 0.010
Interprétation: Entraînement
Episode : Un passage complet à travers les donnéesReward : Somme des rendements quotidiensEpsilon : Taux d’exploration (diminue avec le temps)Convergence : Les rewards devraient augmenter avec le temps
5. Backtest de la Politique Apprise
def backtest_rl_policy(env, agent):""" Backtest la politique apprise (sans exploration). """ = env.reset()= [1.0 ]= []while True :# Sélectionner l'action optimale (sans exploration) = agent.get_policy(state)# Exécuter = env.step(action)# Mettre à jour la valeur du portefeuille - 1 ] * (1 + reward))= next_stateif done:break return pd.Series(portfolio_values, index= closes.index[60 :]), actions_historyif env is None :print ("RL environment not available - skipping backtest." )= None , None else :# Backtest = backtest_rl_policy(env, agent)if rl_values is not None :# Métriques = rl_values.pct_change().dropna()= (rl_values.iloc[- 1 ] ** (252 / len (rl_values))) - 1 = returns.std() * np.sqrt(252 )= (cagr - 0.03 ) / vol= (rl_values / rl_values.cummax() - 1 ).min ()print ("=== Performance RL Policy ===" )print (f"Sharpe: { sharpe:.3f} " )print (f"CAGR: { cagr:.1%} " )print (f"Max DD: { max_dd:.1%} " )print (f"Vol: { vol:.1%} " )# Distribution des actions = pd.Series(rl_actions).value_counts().sort_index()print (f" \n Distribution des actions:" )for action, count in action_counts.items():print (f" { env. action_names[action]} : { count} jours ( { count/ len (rl_actions)* 100 :.1f} %)" )else :print ("Backtest skipped." )
=== Performance RL Policy ===
Sharpe: 1.411
CAGR:   25.8%
Max DD: -23.5%
Vol:    16.1%

Distribution des actions:
  SPY: 577 jours (39.9%)
  TLT: 615 jours (42.5%)
  Cash: 255 jours (17.6%)
6. Comparaison avec Benchmark
if closes is None or "rl_values" not in dir () or rl_values is None :print ("RL backtest results not available - skipping benchmark comparison." )else :# Benchmark: SPY Buy & Hold = closes['SPY' ].iloc[60 :] / closes['SPY' ].iloc[60 ]# Benchmark: Equal Weight (33% each) = (closes.iloc[60 :] / closes.iloc[60 ]).mean(axis= 1 )# Métriques SPY = spy_values.pct_change().dropna()= (spy_values.iloc[- 1 ] ** (252 / len (spy_values))) - 1 = spy_ret.std() * np.sqrt(252 )= (spy_cagr - 0.03 ) / spy_vol= (spy_values / spy_values.cummax() - 1 ).min ()# Métriques Equal Weight = equal_weight_values.pct_change().dropna()= (equal_weight_values.iloc[- 1 ] ** (252 / len (equal_weight_values))) - 1 = ew_ret.std() * np.sqrt(252 )= (ew_cagr - 0.03 ) / ew_vol= (equal_weight_values / equal_weight_values.cummax() - 1 ).min ()print ("=== Comparaison des Stratégies ===" )print (f" { 'Stratégie' :<20} { 'CAGR' :>10} { 'Sharpe' :>10} { 'MaxDD' :>10} " )print ("-" * 53 )print (f" { 'RL Portfolio' :<20} { cagr:>9.1%} { sharpe:>10.3f} { max_dd:>9.1%} " )print (f" { 'Equal Weight' :<20} { ew_cagr:>9.1%} { ew_sharpe:>10.3f} { ew_dd:>9.1%} " )print (f" { 'SPY B&H' :<20} { spy_cagr:>9.1%} { spy_sharpe:>10.3f} { spy_dd:>9.1%} " )
=== Comparaison des Stratégies ===
Stratégie                  CAGR     Sharpe      MaxDD
-----------------------------------------------------
RL Portfolio             25.8%      1.411    -23.5%
Equal Weight             12.0%      0.802    -22.7%
SPY B&H                  18.5%      0.862    -25.4%
7. Test des Hyperparamètres
def test_hyperparams(learning_rates, discount_factors):"""Test différentes combinaisons d'hyperparamètres.""" = {}for lr in learning_rates:for df in discount_factors:# Créer nouvel agent et environnement = RLEnvironment(closes)= QLearningAgent(10 , 4 , learning_rate= lr, discount_factor= df)# Entraîner = 30 , max_steps_per_episode= 500 )# Backtest = backtest_rl_policy(test_env, test_agent)# Métriques = values.pct_change().dropna()= (values.iloc[- 1 ] ** (252 / len (values))) - 1 = ret.std() * np.sqrt(252 )= (cagr - 0.03 ) / vol= f"lr= { lr} , df= { df} " = {'values' : values, 'sharpe' : sharpe, 'cagr' : cagr}return results# Test hyperparamètres = [0.01 , 0.05 ]= [0.9 , 0.95 ]if closes is None or env is None :print ("RL environment not available - skipping hyperparameter testing." )= {}else :print ("Testing hyperparameters..." )= test_hyperparams(lr_values, df_values)if hp_results:print (f" \n { 'Config' :<20} { 'Sharpe' :>8} { 'CAGR' :>8} " )print ("-" * 39 )for key, res in hp_results.items():print (f" { key:<20} { res['sharpe' ]:>8.3f} { res['cagr' ]:>7.1%} " )# Meilleure config = max (hp_results.items(), key= lambda x: x[1 ]['sharpe' ])print (f" \n Meilleure config: { best_config[0 ]} (Sharpe= { best_config[1 ]['sharpe' ]:.3f} )" )else :print ("No hyperparameter results available." )
Testing hyperparameters...
Episode 10/30 - Reward: 0.1765, Epsilon: 0.010
Episode 20/30 - Reward: 0.2541, Epsilon: 0.010
Episode 30/30 - Reward: 0.2328, Epsilon: 0.010
Episode 10/30 - Reward: 0.3894, Epsilon: 0.010
Episode 20/30 - Reward: 0.4064, Epsilon: 0.010
Episode 30/30 - Reward: 0.3922, Epsilon: 0.010
Episode 10/30 - Reward: 0.5693, Epsilon: 0.010
Episode 20/30 - Reward: 0.5200, Epsilon: 0.010
Episode 30/30 - Reward: 0.5223, Epsilon: 0.010
Episode 10/30 - Reward: 0.5154, Epsilon: 0.010
Episode 20/30 - Reward: 0.6006, Epsilon: 0.010
Episode 30/30 - Reward: 0.5861, Epsilon: 0.010

Config                 Sharpe     CAGR
---------------------------------------
lr=0.01, df=0.9         0.552    7.6%
lr=0.01, df=0.95        0.580    9.4%
lr=0.05, df=0.9         0.654   12.8%
lr=0.05, df=0.95        0.558   11.9%

Meilleure config: lr=0.05, df=0.9 (Sharpe=0.654)
8. Visualisation des Résultats
if "rl_values" not in dir () or rl_values is None or "rewards" not in dir () or len (rewards) == 0 :print ("No RL training results available - skipping visualization." )print ("Run this notebook on QC Cloud with multi-asset data access." )else := plt.subplots(2 , 2 , figsize= (16 , 10 ))# Courbe d'apprentissage = axes[0 , 0 ]'Courbe d \' Apprentissage' , fontsize= 12 , fontweight= 'bold' )'Episode' )'Reward Total' )= 0 , color= 'r' , linestyle= '--' , alpha= 0.5 )True , alpha= 0.3 )# Decay d'epsilon = axes[0 , 1 ]'Exploration (Epsilon Decay)' , fontsize= 12 , fontweight= 'bold' )'Episode' )'Epsilon' )True , alpha= 0.3 )# Comparaison des stratégies = axes[1 , 0 ]= 'RL Portfolio' , linewidth= 2 )if "spy_values" in dir ():= 'SPY B&H' , linestyle= '--' )if "equal_weight_values" in dir ():= 'Equal Weight' , linestyle= '--' )'Performance des Stratégies' , fontsize= 12 , fontweight= 'bold' )'Valeur Normalisée' )True , alpha= 0.3 )# Allocation au fil du temps = axes[1 , 1 ]= ['S' , 'B' , 'G' , 'C' ]= [action_names_short[a] for a in rl_actions]= 3 )'Allocation au Fil du Temps' , fontsize= 12 , fontweight= 'bold' )'Actif' )range (4 ))'SPY' , 'TLT' , 'GLD' , 'Cash' ])True , alpha= 0.3 )'rl_portfolio_analysis.png' , dpi= 150 , bbox_inches= 'tight' )print ("Graphique sauvegardé." )
9. Conclusions et Recommandations
Résumé
Sharpe
(à remplir)
(à remplir)
(à remplir)
CAGR
(à remplir)
(à remplir)
(à remplir)
Max DD
(à remplir)
(à remplir)
(à remplir)
Verdict
Si Sharpe RL > 1.2: L’agent a appris une politique d’allocation utile
Points Forts RL Portfolio
Adaptatif : S’adapte aux conditions de marchéAllocation dynamique : Change d’actif selon le régimeApprentissage continu : Améliore avec l’expérienceRisque géré : Flight to safety automatique
Limitations
Complexité : Plus complexe qu’une stratégie statiqueTemps d’entraînement : Nécessite beaucoup d’épisodesOverfitting : Risque d’apprendre le bruit historiqueÉtat discret : Perte d’information avec le hashing
Améliorations Possibles
Deep Q-Network (DQN) : Remplacer la Q-table par un réseau de neuronesState continu : Utiliser des bins pour les features continuesActions pondérées : Permettre des allocations fractionnairesMulti-asset : Ajouter plus d’actifs (REITs, Commodities)Reward shaping : Optimiser la fonction de récompense
Prochaines Étapes
Implémenter DQN avec PyTorch/TensorFlow
Ajouter des features fondamentales (P/E, dividendes)
Tester avec walk-forward validation
Déployer en paper trading
Ressources
RL Basics : Sutton & Barto, “Reinforcement Learning: An Introduction”DQN : Mnih et al. (2015), “Human-level control through deep reinforcement learning”Finance RL : “Reinforcement Learning for Finance” (various papers)