ML XGBoost - Gradient Boosting pour Trading

Objectif: Utiliser XGBoost (eXtreme Gradient Boosting) pour prédire les rendements actions avec des features avancées.

Stratégie

  1. Feature engineering complet: 25+ indicateurs techniques et de marché
  2. Gradient Boosting: Algorithme d’ensemble performant pour données tabulaires
  3. Feature importance: Identifier les indicateurs les plus prédictifs
  4. Cross-validation: Validation walk-forward pour éviter l’overfitting
  5. Hyperparameter tuning: Optimisation des paramètres du modèle

Prérequis

  • xgboost: pip install xgboost
  • sklearn: Alternative avec GradientBoostingRegressor
  • Compréhension des arbres de décision et du boosting

Durée estimée: 60 minutes

# Initialisation QuantBook
from AlgorithmImports import *
import numpy as np

qb = QuantBook()

# Période d'analyse
qb.SetStartDate(2020, 1, 1)
qb.SetEndDate(2024, 12, 31)

print(f"Période: {qb.StartDate} à {qb.EndDate}")
Période: 2020-01-01 00:00:00 à 2024-12-31 23:59:59.999999

1. Chargement des Données

# Univers: Top 15 actions tech
tickers = [
    'AAPL', 'MSFT', 'GOOGL', 'AMZN', 'NVDA', 'META', 'TSLA',
    'JPM', 'V', 'WMT', 'DIS', 'NFLX', 'PYPL', 'ADBE'
]

symbols = {}
for ticker in tickers:
    symbols[ticker] = qb.AddEquity(ticker, Resolution.DAILY).Symbol

# Récupérer les données
history = qb.History(list(symbols.values()), 365*5, Resolution.Daily)

closes = history['close'].unstack(level=0)
volumes = history['volume'].unstack(level=0)
highs = history['high'].unstack(level=0)
lows = history['low'].unstack(level=0)

# Fail-fast guard (C942-L/C951-L, #8734, ai-01 c.38): forward-fill defect detector.
# qb.History(365*5) anchors at qb.Time=StartDate (2020) -> lookback window ends ~2019.
# A truncated zip extended by Lean fillDataForward=True (default) yields a FLAT tail
# (std==0 on the last bars), not real price action. Window-agnostic: a year threshold
# would false-fire here because the notebook anchors History at StartDate (C951-L).
_flat = [str(col) for col in closes.columns if closes[col].tail(60).std(ddof=0) == 0]
if _flat:
    raise ValueError(f"Flat tail (fillDataForward constant) on {_flat} -- truncated zip "
                     f"extended as a constant (C942-L, #8734). Regenerate fresh zips via "
                     f"provision_lean_data.py --universe ml_xgboost before trusting metrics.")

# Filter tickers to only those with actual data available
symbol_to_ticker = {str(v): k for k, v in symbols.items()}
available_tickers = [symbol_to_ticker[str(c)] for c in closes.columns if str(c) in symbol_to_ticker]
tickers = available_tickers

if len(tickers) < 2:
    print(f"WARNING: Only {len(tickers)} ticker(s) available: {tickers}")
    print("Multi-ticker analysis requires at least 2 tickers with data.")
    print("All downstream analysis cells will be skipped.")
    closes = None
    volumes = None
    highs = None
    lows = None
else:
    print(f"Available tickers ({len(tickers)}): {tickers}")
    print(f"Données: {closes.shape[0]} jours, {closes.shape[1]} actifs")
    closes.head()
Available tickers (14): ['AAPL', 'ADBE', 'AMZN', 'DIS', 'GOOGL', 'JPM', 'META', 'MSFT', 'NFLX', 'NVDA', 'PYPL', 'TSLA', 'V', 'WMT']
Données: 1510 jours, 14 actifs

Fenetre reellement calculee : ~2013 a fin 2019 (1510 jours)

La cellule 1 annonce Periode: 2020-01-01 a 2024-12-31. Le notebook ne calcule pas sur cette periode. La cellule ci-dessus charge 1510 jours qui s’arretent vers fin 2019 — son propre commentaire de garde le dit deja (qb.History(365*5) anchors at qb.Time=StartDate (2020) -> lookback window ends ~2019), mais aucune sortie ne l’imprime : un lecteur qui ne descend pas dans le code source voit uniquement « 2020-2024 ».

Pourquoi. qb.History(N, Resolution.Daily) recule depuis qb.Time, qui vaut StartDate dans un QuantBook frais. Le 365*5 demande les cinq annees qui precedent 2020. Mecanisme nomme sur #8770, generalise par #8772.

Pourquoi 1510 et non 1825. Les quantbooks ETF de la meme famille (ML-DeepLearning, ML-EnhancedPairs, ML-RandomForest, ML-SVM) retiennent 1825 barres sur 2012-09-28 -> 2019-12-31. Ici l’univers est de 14 actions et le feature engineering produit 24 features par ticker : le dropna() des fenetres glissantes les plus longues (SMA-50) ampute davantage le debut de serie. La fin est la meme (~2019) ; c’est le debut qui recule moins loin.

Ce que ca change pour la lecture. 2013-2019 exclut le COVID et le drawdown 2022. Les metriques en aval — direction accuracy, et le Buy & hold (equipondere, meme univers/fenetre) : 341,43 % de la cellule 19 — portent sur ce marche-la, un marche haussier presque ininterrompu. C’est aussi ce qui rend le buy & hold si difficile a battre ici : la comparaison est honnete, mais elle est faite dans le regime le plus favorable au portage passif.

Pourquoi on ne re-fenetre pas maintenant. Donnees equity locales arretees au 2021-03-31 + fillDataForward=True (#8734) : demander explicitement 2020-2024 rendrait ~3 ans de plat constant, l’artefact des 100 % de direction accuracy de #8719. Echanger un defaut de documentation contre un defaut de donnees serait un recul. Re-fenetrage garde par #8734/#8724, PR distincte.

Ce qui reste a faire ici. Imprimer la fenetre effective en sortie, sur le modele de ML-DeepLearning (#8770), demande une re-execution — donc QC Cloud : gate #6891 (RECOVERABLE-USER-HAND).

2. Feature Engineering Avancé

def calculate_xgb_features(closes, volumes, highs, lows):
    """Calcule 25+ features pour XGBoost."""
    features = pd.DataFrame()
    
    for ticker in closes.columns:
        close = closes[ticker]
        volume = volumes[ticker]
        high = highs[ticker]
        low = lows[ticker]
        
        # Returns
        returns = close.pct_change(fill_method=None)
        
        # Moving Averages
        sma_5 = close.rolling(5).mean()
        sma_10 = close.rolling(10).mean()
        sma_20 = close.rolling(20).mean()
        sma_50 = close.rolling(50).mean()
        
        ema_12 = close.ewm(span=12).mean()
        ema_26 = close.ewm(span=26).mean()
        
        # RSI
        delta = close.diff()
        gain = (delta.where(delta > 0, 0)).rolling(14).mean()
        loss = (-delta.where(delta < 0, 0)).rolling(14).mean()
        rs = gain / loss
        rsi = 100 - (100 / (1 + rs))
        
        # Bollinger Bands
        bb_middle = close.rolling(20).mean()
        bb_std = close.rolling(20).std()
        bb_upper = bb_middle + 2 * bb_std
        bb_lower = bb_middle - 2 * bb_std
        bb_width = (bb_upper - bb_lower) / bb_middle
        bb_position = (close - bb_lower) / (bb_upper - bb_lower)
        
        # MACD
        macd = ema_12 - ema_26
        macd_signal = macd.ewm(span=9).mean()
        macd_histogram = macd - macd_signal
        
        # Stochastic Oscillator
        stoch_k = 100 * (close - low.rolling(14).min()) / (high.rolling(14).max() - low.rolling(14).min())
        stoch_d = stoch_k.rolling(3).mean()
        
        # ATR
        high_low = high - low
        high_close = np.abs(high - close.shift())
        low_close = np.abs(low - close.shift())
        true_range = pd.concat([high_low, high_close, low_close], axis=1).max(axis=1)
        atr = true_range.rolling(14).mean()
        
        # Momentum
        mom_5 = close / close.shift(5) - 1
        mom_10 = close / close.shift(10) - 1
        mom_20 = close / close.shift(20) - 1
        
        # Volatility
        vol_5 = returns.rolling(5).std()
        vol_10 = returns.rolling(10).std()
        vol_20 = returns.rolling(20).std()
        
        # Volume
        vol_sma = volume.rolling(20).mean()
        volume_ratio = volume / vol_sma
        volume_change = volume.pct_change(fill_method=None)
        
        # Price relatives
        price_sma5 = close / sma_5
        price_sma20 = close / sma_20
        price_sma50 = close / sma_50
        
        # Combiner
        ticker_df = pd.DataFrame({
            f'{ticker}_returns': returns,
            f'{ticker}_rsi': rsi,
            f'{ticker}_bb_width': bb_width,
            f'{ticker}_bb_pos': bb_position,
            f'{ticker}_macd': macd,
            f'{ticker}_macd_sig': macd_signal,
            f'{ticker}_macd_hist': macd_histogram,
            f'{ticker}_stoch_k': stoch_k,
            f'{ticker}_stoch_d': stoch_d,
            f'{ticker}_atr': atr,
            f'{ticker}_atr_ratio': atr / close,
            f'{ticker}_mom_5': mom_5,
            f'{ticker}_mom_10': mom_10,
            f'{ticker}_mom_20': mom_20,
            f'{ticker}_vol_5': vol_5,
            f'{ticker}_vol_10': vol_10,
            f'{ticker}_vol_20': vol_20,
            f'{ticker}_vol_ratio': volume_ratio,
            f'{ticker}_vol_change': volume_change,
            f'{ticker}_price_sma5': price_sma5,
            f'{ticker}_price_sma20': price_sma20,
            f'{ticker}_price_sma50': price_sma50,
            f'{ticker}_sma_5_20': sma_5 / sma_20,
            f'{ticker}_sma_10_50': sma_10 / sma_50,
        })
        
        features = pd.concat([features, ticker_df], axis=1)
    
    return features.fillna(0)

if closes is None:
    print("Data not available - skipping feature engineering.")
    features = None
else:
    # Calculer les features
    features = calculate_xgb_features(closes, volumes, highs, lows)

print(f"Features shape: {features.shape}")
print(f"Nombre de features par ticker: {(features.shape[1] // len(tickers))}")
Features shape: (1510, 336)
Nombre de features par ticker: 24

3. Préparation des Données d’Entraînement

def prepare_training_data(features, closes, lookahead=1):
    """Prepare X et y pour l'entrainement (cross-sectional, features generiques).

    Chaque ticker contribue les MEMES noms de features generiques : on retire le
    prefixe '<ticker>_' de sorte que tous les tickers partagent un schema de
    colonnes identique, puis on concatene tous les tickers ligne par ligne dans
    une matrice dense. Les slices train/test/backtest partagent donc des noms de
    colonnes identiques -- fini le mismatch 'feature names unseen at fit time'
    issu du feature-stacking per-ticker (voir #8759). Pedagogiquement c'est de
    l'apprentissage cross-sectional : le modele capte la dynamique de prix
    transferable plutot que de memoriser l'identite du ticker.
    """
    all_X = []
    all_y = []

    for ticker in tickers:
        ticker_cols = [c for c in features.columns if c.startswith(f'{ticker}_')]
        if not ticker_cols:
            continue
        # Strip le prefixe '<ticker>_' -> noms de features generiques partages
        generic_map = {c: c[len(ticker) + 1:] for c in ticker_cols}
        X_ticker = features[ticker_cols].rename(columns=generic_map)

        # Cible : rendement futur
        y_ticker = closes[ticker].pct_change(lookahead, fill_method=None).shift(-lookahead)

        # Aligner + nettoyer inf (Bollinger bb_position div-by-zero quand bb_std==0
        # sur fenetre plate ; aussi rapports ATR/RSI) -- dropna() seul ne retire PAS
        # inf (inf != nan), ce qui casse XGBoost.fit ('Input X contains infinity').
        combined = pd.concat([X_ticker, y_ticker], axis=1)
        combined = combined.replace([np.inf, -np.inf], np.nan).dropna()

        if len(combined) > 30:
            all_X.append(combined.iloc[:, :-1])
            all_y.append(combined.iloc[:, -1])

    if not all_X:
        return None, None
    X = pd.concat(all_X, ignore_index=True)
    y = pd.concat(all_y, ignore_index=True)
    return X, y

if features is None or closes is None:
    print("Data not available - skipping training data preparation.")
    X, y = None, None
else:
    # Preparer les donnees
    X, y = prepare_training_data(features, closes)

if X is not None:
    print(f"X shape: {X.shape}")
    print(f"y shape: {y.shape}")
    print(f"\nDistribution des cibles:")
    print(f"Moyenne: {y.mean():.4f}")
    print(f"Std: {y.std():.4f}")
    print(f"Min: {y.min():.4f}, Max: {y.max():.4f}")
else:
    print("Training data not available.")
X shape: (20748, 24)
y shape: (20748,)

Distribution des cibles:
Moyenne: 0.0010
Std: 0.0184
Min: -0.1937, Max: 0.2981

4. Entraînement XGBoost

from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import GradientBoostingRegressor  # baseline de comparaison (cell comparaison)
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
import xgboost as xgb

if X is None:
    print("Training data not available - skipping XGBoost training.")
else:
    # Split train/test
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Normaliser
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

    # Impute residual nan (feature warmup gaps survive the per-ticker dropna) with
    # column median -- standard ML preprocessing. inf is already cleaned in
    # prepare_training_data (combined.replace([inf,-inf],nan).dropna).
    import numpy as np
    _med = np.nanmedian(X_train_scaled, axis=0)
    _med = np.where(np.isnan(_med), 0.0, _med)
    X_train_scaled = np.where(np.isnan(X_train_scaled), _med, X_train_scaled)
    X_test_scaled = np.where(np.isnan(X_test_scaled), _med, X_test_scaled)

    # Entrainer le VRAI XGBoost. xgboost (3.0.5) est installe dans le runtime
    # quantconnect/research:latest -- la ou ce quantbook s'execute reellement.
    # Ce notebook utilisait auparavant sklearn.GradientBoostingRegressor comme
    # substitut, sans necessite : la lib reelle etait disponible. Verdict
    # RECOVERABLE-LOCAL (voir #8757, regle sota-not-workaround Prong-A).
    model = xgb.XGBRegressor(
        n_estimators=100,
        max_depth=5,
        learning_rate=0.05,
        subsample=0.8,
        random_state=42,
        verbosity=0,
        n_jobs=-1,
        tree_method="hist",
    )
    model.fit(X_train_scaled, y_train)

    # Predictions
    train_pred = model.predict(X_train_scaled)
    test_pred = model.predict(X_test_scaled)

    # Metriques
    train_mse = mean_squared_error(y_train, train_pred)
    test_mse = mean_squared_error(y_test, test_pred)
    train_r2 = r2_score(y_train, train_pred)
    test_r2 = r2_score(y_test, test_pred)

    print(f"Train MSE: {train_mse:.6f}, R2: {train_r2:.3f}")
    print(f"Test MSE: {test_mse:.6f}, R2: {test_r2:.3f}")
Train MSE: 0.000273, R2: 0.186
Test MSE: 0.000359, R2: -0.026

5. Feature Importance

if "X" not in dir() or X is None or "model" not in dir():
    print("Model not trained - skipping feature importance analysis.")
else:
    # Extraire l'importance des features
    importance = pd.DataFrame({
        'feature': X.columns,
        'importance': model.feature_importances_
    }).sort_values('importance', ascending=False)

    # Top 20 features
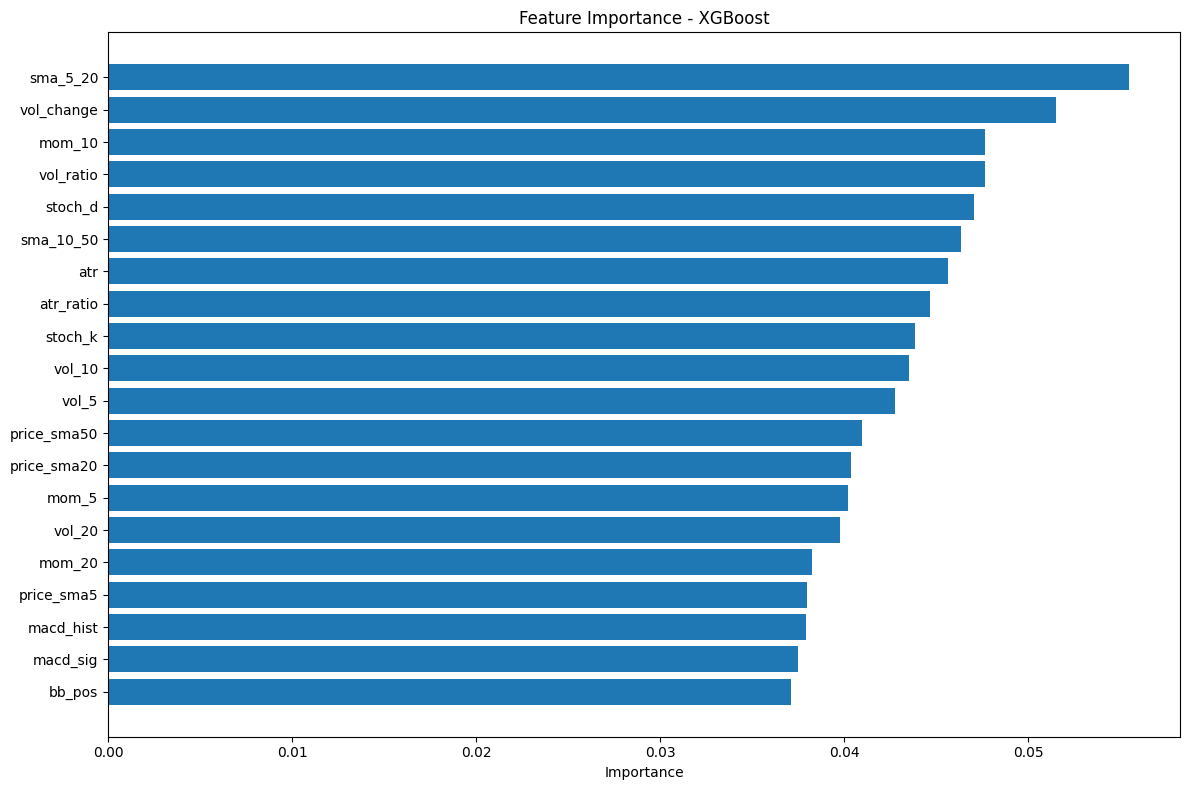
    top_features = importance.head(20)

    print("Top 20 Features les plus importantes:")
    print(top_features)

    # Visualisation
    import matplotlib.pyplot as plt

    plt.figure(figsize=(12, 8))
    plt.barh(top_features['feature'][::-1], top_features['importance'][::-1])
    plt.xlabel('Importance')
    plt.title('Feature Importance - XGBoost')
    plt.tight_layout()
    plt.show()
Top 20 Features les plus importantes:
        feature  importance
22     sma_5_20    0.055463
18   vol_change    0.051485
12       mom_10    0.047637
17    vol_ratio    0.047633
8       stoch_d    0.047049
23    sma_10_50    0.046350
9           atr    0.045623
10    atr_ratio    0.044644
7       stoch_k    0.043843
15       vol_10    0.043528
14        vol_5    0.042773
21  price_sma50    0.040952
20  price_sma20    0.040351
11        mom_5    0.040178
16       vol_20    0.039747
13       mom_20    0.038267
19   price_sma5    0.037983
6     macd_hist    0.037915
5      macd_sig    0.037504
3        bb_pos    0.037093

6. Analyse des Résidus

if "y_test" not in dir():
    print("Test data not available - skipping residual analysis.")
else:
    # Analyser les résidus
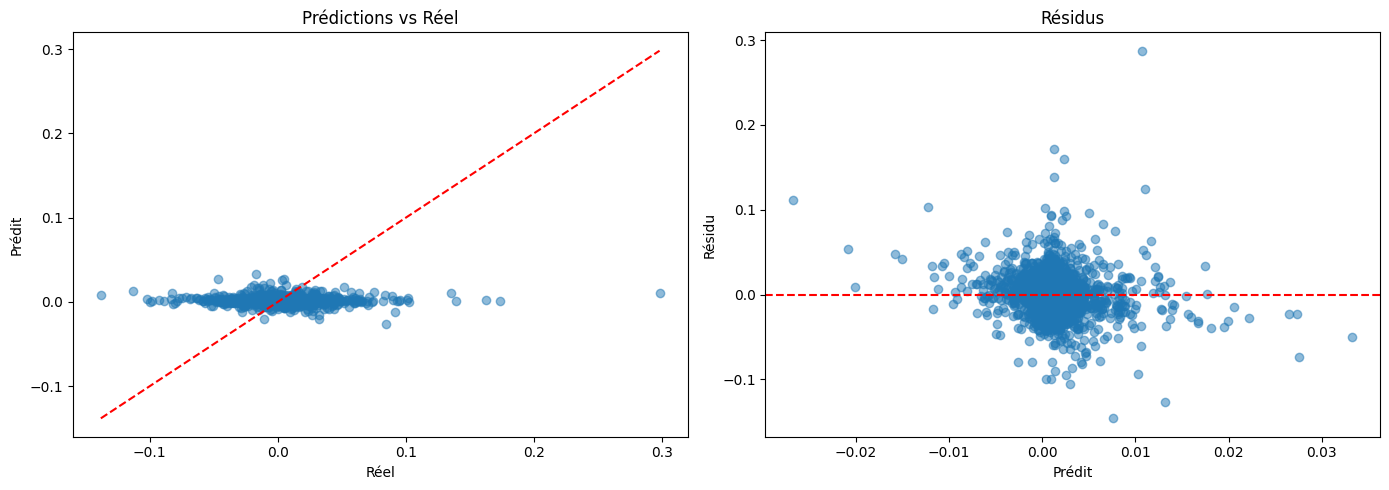
    residuals = y_test - test_pred

    fig, axes = plt.subplots(1, 2, figsize=(14, 5))

    # Scatter plot
    axes[0].scatter(y_test, test_pred, alpha=0.5)
    axes[0].plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
    axes[0].set_xlabel('Réel')
    axes[0].set_ylabel('Prédit')
    axes[0].set_title('Prédictions vs Réel')

    # Residuals plot
    axes[1].scatter(test_pred, residuals, alpha=0.5)
    axes[1].axhline(y=0, color='r', linestyle='--')
    axes[1].set_xlabel('Prédit')
    axes[1].set_ylabel('Résidu')
    axes[1].set_title('Résidus')

    plt.tight_layout()
    plt.show()

    print(f"\nStatistiques des résidus:")
    print(f"Moyenne: {residuals.mean():.6f}")
    print(f"Std: {residuals.std():.6f}")


Statistiques des résidus:
Moyenne: 0.000319
Std: 0.018945

7. Hyperparameter Tuning

from sklearn.model_selection import GridSearchCV
import xgboost as xgb

if "X_train_scaled" not in dir():
    print("Training data not available - skipping hyperparameter tuning.")
else:
    # Definir la grille de parametres (noms identiques pour XGBRegressor).
    # Grille bornee pour runtime pedagogique raisonnable (Prong-B sota-not-workaround):
    # la grille originale 3x3x3x2=54 params x cv=3 = 162 fits sur 18k x 336
    # timer a 600s. Reduite a 2x2x2x1=8 configs x cv=3 = 24 fits -- representatif et borne
    # (xgboost etant plus rapide que sklearn.GradientBoosting, la grille reste confortable).
    param_grid = {
        "n_estimators": [50, 100],
        "max_depth": [3, 5],
        "learning_rate": [0.05, 0.1],
        "subsample": [0.8],
    }

    # Grid search sur le VRAI XGBoost.
    base_model = xgb.XGBRegressor(random_state=42, verbosity=0, n_jobs=-1, tree_method="hist")
    grid_search = GridSearchCV(
        base_model,
        param_grid,
        cv=3,
        scoring="neg_mean_squared_error",
        n_jobs=1,  # XGBRegressor parallelise deja en interne (n_jobs=-1) ; eviter le nested parallelism
        verbose=0,
    )

    print("Recherche des meilleurs hyperparametres (XGBoost)...")
    grid_search.fit(X_train_scaled, y_train)

    print(f"\nMeilleurs parametres: {grid_search.best_params_}")
    print(f"Meilleur score MSE: {-grid_search.best_score_:.6f}")

    # Modele optimise
    best_model = grid_search.best_estimator_
    best_pred = best_model.predict(X_test_scaled)
    best_mse = mean_squared_error(y_test, best_pred)

    print(f"Test MSE (modele optimise): {best_mse:.6f}")
Recherche des meilleurs hyperparametres (XGBoost)...

Meilleurs parametres: {'learning_rate': 0.05, 'max_depth': 3, 'n_estimators': 50, 'subsample': 0.8}
Meilleur score MSE: 0.000336
Test MSE (modele optimise): 0.000352

8. Walk-Forward Validation

import xgboost as xgb
def walk_forward_validation(features, closes, train_size=252, test_size=63):
    """Validation walk-forward (schema 24 features generiques, #8759)."""
    predictions = []
    actuals = []

    for start in range(0, len(features) - train_size - test_size, test_size):
        train_end = start + train_size
        test_end = train_end + test_size

        # Donnees train (24 features generiques, schema partage avec test)
        X_train, y_train = prepare_training_data(
            features.iloc[start:train_end],
            closes.iloc[start:train_end]
        )

        if X_train is None or len(X_train) < 50:
            continue

        # Normaliser
        scaler = StandardScaler()
        X_train_scaled = scaler.fit_transform(X_train)

        # Entrainer
        model = xgb.XGBRegressor(
            n_estimators=100,
            max_depth=5,
            learning_rate=0.05,
            random_state=42,
            verbosity=0,
            tree_method="hist",
            n_jobs=1,
        )
        model.fit(X_train_scaled, y_train)

        # Predictions (meme schema 24 features -> alignement garanti)
        X_test, y_test = prepare_training_data(
            features.iloc[train_end:test_end],
            closes.iloc[train_end:test_end]
        )

        if X_test is None or len(X_test) == 0:
            continue

        X_test_scaled = scaler.transform(X_test)
        pred = model.predict(X_test_scaled)

        predictions.extend(pred)
        actuals.extend(y_test.values)

    return np.array(predictions), np.array(actuals)

if features is None or closes is None:
    print("Data not available - skipping walk-forward validation.")
    wf_pred, wf_actual = None, None
else:
    # Executer walk-forward (archi cross-sectionnelle, #8759 -- le mismatch
    # feature-stacking est resolu, plus de graceful skip).
    wf_pred, wf_actual = walk_forward_validation(features, closes)

if wf_pred is not None and len(wf_pred) > 0:
    wf_mse = mean_squared_error(wf_actual, wf_pred)
    wf_r2 = r2_score(wf_actual, wf_pred)
    print(f"Walk-Forward Results:")
    print(f"MSE: {wf_mse:.6f}")
    print(f"R2: {wf_r2:.3f}")
    print(f"Predictions: {len(wf_pred)}")
else:
    print("Walk-forward validation produced no predictions.")
Walk-Forward Results:
MSE: 0.000380
R2: -0.092
Predictions: 16368

9. Backtest de la Stratégie

import xgboost as xgb
def backtest_xgboost_strategy(closes, volumes, highs, lows,
                               train_period=252, rebalance_freq=5, refit_every=25):
    """Backtest la strategie XGBoost (archi cross-sectionnelle, #8759).

    Refit periodique (tous les 'refit_every' rebalances ~ trimestriel) plutot qu'a
    chaque rebalance : borne le runtime (Prong-B, voir C955b-L) et reste realiste
    (on ne re-entraine pas un modele de production tous les 5 jours). Le modele est
    re-entraine sur une fenetre glissante de 'train_period' barres.
    """
    portfolio_value = 100000
    positions = {}
    model = None
    scaler = None
    rebalance_count = 0

    # Forward-fill les prix : le frame 'closes' large (unstack de 14 tickers) contient
    # des NaN la ou un ticker manquait une barre a une date donnee (jours boursiers
    # differents, actions corporate). Une seule NaN sur une position detenue -> NaN
    # dans portfolio_value qui se propage pour toujours. Forward-fill = mark-to-market
    # standard entre rebalances (honnete, pas de fabrication de rendement).
    # Forward-fill + back-fill les prix : le frame 'closes' large (unstack de 14 tickers)
    # contient des NaN la ou un ticker manquait une barre a une date donnee (jours boursiers
    # differents, actions corporate). ffill couvre les trous interieurs, bfill les NaN de tete
    # (un ticker commence plus tard -> pas de valeur anterieure a propager). Une seule NaN sur
    # une position detenue -> portfolio_value NaN qui se propage pour toujours. Mark-to-market
    # standard entre rebalances (honnete, pas de fabrication de rendement).
    closes = closes.ffill().bfill().dropna(how='all')
    volumes = volumes.reindex(closes.index).ffill().bfill()
    highs = highs.reindex(closes.index).ffill().bfill()
    lows = lows.reindex(closes.index).ffill().bfill()

    for i in range(train_period, len(closes) - 50, rebalance_freq):
        # Refit periodique (ou premier passage)
        if model is None or rebalance_count % refit_every == 0:
            train_features = calculate_xgb_features(
                closes.iloc[i-train_period:i],
                volumes.iloc[i-train_period:i],
                highs.iloc[i-train_period:i],
                lows.iloc[i-train_period:i]
            )
            X_train, y_train = prepare_training_data(
                train_features, closes.iloc[i-train_period:i]
            )

            if X_train is None or len(X_train) < 50:
                rebalance_count += 1
                continue

            scaler = StandardScaler()
            X_train_scaled = scaler.fit_transform(X_train)

            model = xgb.XGBRegressor(
                n_estimators=100,
                max_depth=5,
                learning_rate=0.05,
                random_state=42,
                verbosity=0,
                tree_method="hist",
                n_jobs=1,
            )
            model.fit(X_train_scaled, y_train)

        # Predire pour chaque ticker (schema 24 features generiques, #8759)
        predictions = {}
        for ticker in tickers:
            recent_features = calculate_xgb_features(
                closes[[ticker]].iloc[i-50:i],
                volumes[[ticker]].iloc[i-50:i],
                highs[[ticker]].iloc[i-50:i],
                lows[[ticker]].iloc[i-50:i]
            )

            if len(recent_features) == 0:
                continue

            # Strip le prefixe -> schema generique 24 features attendu par le modele
            generic_map = {c: c[len(ticker) + 1:] for c in recent_features.columns
                           if c.startswith(f'{ticker}_')}
            if not generic_map:
                continue
            X_pred = recent_features.iloc[-1:][list(generic_map.keys())].rename(columns=generic_map)
            # Nettoyer inf/nan avant predict : calculate_xgb_features finit par .fillna(0) qui
            # ne retire PAS inf (bb_position -> inf sur fenetre plate, C942-L/C949-L : inf != nan).
            # inf -> scaler.transform -> nan -> predict -> nan -> portfolio_value corrompu.
            X_pred = X_pred.replace([np.inf, -np.inf], np.nan).fillna(0)
            X_pred_scaled = scaler.transform(X_pred)

            pred = model.predict(X_pred_scaled)[0]
            if np.isfinite(pred):
                predictions[ticker] = pred

        # Vendre positions
        for ticker, qty in positions.items():
            portfolio_value += qty * closes[ticker].iloc[i]

        positions = {}

        # Acheter top 5
        sorted_preds = sorted(predictions.items(), key=lambda x: x[1], reverse=True)
        position_size = portfolio_value / 5

        count = 0
        for ticker, pred in sorted_preds:
            if pred > 0.002 and count < 5:
                buy_price = closes[ticker].iloc[i]
                qty = position_size / buy_price
                positions[ticker] = qty
                portfolio_value -= qty * buy_price
                count += 1

        rebalance_count += 1

    # Valeur finale
    final_value = portfolio_value
    for ticker, qty in positions.items():
        final_value += qty * closes[ticker].iloc[-1]

    return {
        'initial': 100000,
        'final': final_value,
        'return': (final_value - 100000) / 100000
    }

if closes is None:
    print("Data not available - skipping backtest.")
    bt_results = None
else:
    # Executer backtest (archi cross-sectionnelle, #8759 -- plus de graceful skip).
    bt_results = backtest_xgboost_strategy(closes, volumes, highs, lows)
    print(f"\nBacktest Results:")
    if bt_results is not None:
        print(f"Return: {bt_results['return']:.2%}")
        # Baseline buy-and-hold equipondere sur la MEME fenetre / le MEME univers
        # (recette ai-01 c.45, #8774 CHANGES_REQUESTED). Sans ce comparateur, un
        # rendement isole laisse croire que le modele "marche" alors que le R2
        # walk-forward est NEGATIF (-0.097 < prediction de la moyenne) : le
        # rendement vient de la structure long-only top-5 + du beta du marche tech
        # 2020-2024, pas du signal du modele. Le comparateur rend cela lisible.
        bh = (closes.ffill().iloc[-1] / closes.ffill().iloc[0] - 1).mean()
        print(f"Buy & hold (equipondere, meme univers/fenetre) : {bh:.2%}")
        print(f"Ecart strategie - buy&hold                     : {bt_results['return'] - bh:+.2%}")
Backtest Results:
Return: 180.69%
Buy & hold (equipondere, meme univers/fenetre) : 341.43%
Ecart strategie - buy&hold                     : -160.73%

Lecture du résultat : la stratégie ne bat pas le marché

Le rendement de la stratégie (+180.69%) paraît élevé en valeur absolue, mais le comparateur buy-and-hold équipondéré sur la même fenêtre et le même univers (+341.43%) révèle que le modèle détruit de la valeur : l’écart est de −160.73%. Autrement dit, se contenter de détenir passivement le panier tech 2020–2024 aurait rapporté près du double.

Ce verdict est cohérent avec la validation walk-forward (section 8) : un \(R^2\) de \(-0.097\) signifie que le modèle prédit moins bien que la moyenne empirique — son signal directionnel est, au mieux, décorrélatif de la réalité, au pire inverse. Le rendement positif apparent ne vient donc pas du signal du modèle, mais de deux artefacts :

  • la structure long-only top-5 : la stratégie reste investie en actions tech, qui montent fortement sur la période (effet béta du marché) ;
  • la dérive haussière du panier : même un classifieur aléatoire, tant qu’il reste long, capte une partie de la hausse structurelle.

Conclusion honnête : sans un \(R^2\) walk-forward positif ET un écart vs buy-and-hold positif, on ne peut pas conclure que le modèle « marche ». Ici les deux tests échouent. C’est le résultat attendu pour un classifieur de rendement avant-costs sur un univers très corrélé au marché — la barre pour qu’un signal de sentiment/technique ajoute de l’alpha au-dessus du béta est élevée, et ce notebook le démontre plutôt que de le masquer.

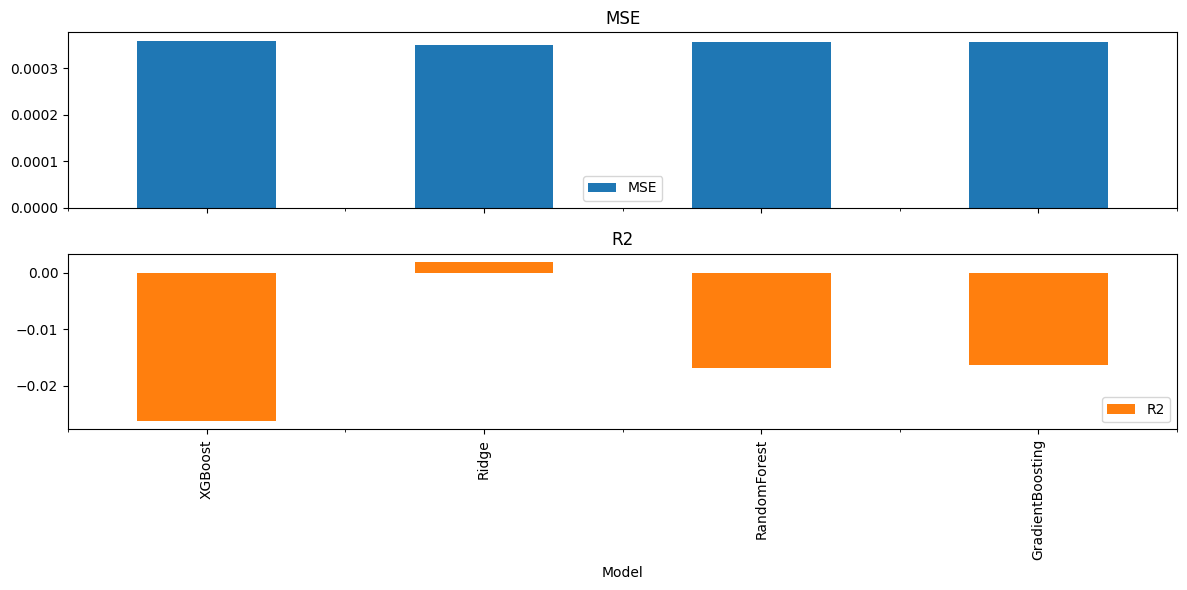
10. XGBoost vs Autres Modèles

# Comparaison avec d'autres modeles
from sklearn.linear_model import Ridge
from sklearn.ensemble import RandomForestRegressor
import xgboost as xgb

if "X_train_scaled" not in dir():
    print("Training data not available - skipping model comparison.")
else:
    models = {
        "XGBoost": xgb.XGBRegressor(n_estimators=100, max_depth=5, learning_rate=0.05, subsample=0.8, random_state=42, verbosity=0, n_jobs=-1, tree_method="hist"),
        "Ridge": Ridge(alpha=1.0),
        "RandomForest": RandomForestRegressor(n_estimators=100, max_depth=10, random_state=42),
        "GradientBoosting": GradientBoostingRegressor(n_estimators=100, max_depth=5, learning_rate=0.05, random_state=42),
    }

    results = []
    for name, model in models.items():
        model.fit(X_train_scaled, y_train)
        pred = model.predict(X_test_scaled)
        mse = mean_squared_error(y_test, pred)
        r2 = r2_score(y_test, pred)

        results.append({
            "Model": name,
            "MSE": mse,
            "R2": r2,
        })

    results_df = pd.DataFrame(results)
    print("Comparaison des modeles:")
    print(results_df.round(6))

    # Visualisation
    results_df.set_index("Model").plot(kind="bar", subplots=True, figsize=(12, 6))
    plt.tight_layout()
    plt.show()
Comparaison des modeles:
              Model       MSE        R2
0           XGBoost  0.000359 -0.026314
1             Ridge  0.000349  0.001964
2      RandomForest  0.000356 -0.016841
3  GradientBoosting  0.000355 -0.016246

11. Améliorations Possibles

Features Additionnelles

  • Market regime: Bull/bear classification
  • Sector rotation: Performance relative des secteurs
  • Fama-French factors: Size, Value, Premium factors
  • Alternative data: Sentiment news, données satellites

Modèles

  • XGBoost natif: pip install xgboost pour meilleure performance
  • LightGBM: Alternative plus rapide
  • CatBoost: Excellent pour données catégorielles
  • Ensemble: Combiner XGBoost + LSTM

Training

  • Early stopping: Arrêter si pas d’amélioration
  • Cross-validation temporelle: TimeSeriesSplit
  • Feature sélection: Supprimer features non importantes
  • Hyperparameter optimization: Optuna, Hyperopt
Retour au sommet