Pivot des séries de prix et de volumes en DataFrame large, avec remapping des colonnes Symbol → ticker pour ML-Ensemble.
# Pivoter les donnéescloses = history['close'].unstack(level=0)volumes = history['volume'].unstack(level=0)symbol_to_ticker = {str(v): k for k, v in symbols.items()}closes.columns = [symbol_to_ticker.get(str(c), str(c)) for c in closes.columns]volumes.columns = [symbol_to_ticker.get(str(c), str(c)) for c in volumes.columns]# Forward-fill les données manquantes (certains tickers ont des jours sans cotation)# puis garder uniquement les jours où tous les tickers ont des donnéescloses = closes.ffill().dropna()volumes = volumes.ffill().dropna()# Si univers trop réduit, utiliser au moins les tickers disponiblesiflen(closes.columns) <10:# Certains tickers peuvent ne pas avoir de données sur toute la période# On garde ceux qui ont au moins 80% de données min_coverage =int(0.8*len(closes)) good_tickers = closes.columns[closes.notna().sum() >= min_coverage] closes = closes[good_tickers].dropna() volumes = volumes[good_tickers].dropna()print(f"Période: {closes.index[0].date()} à {closes.index[-1].date()}")print(f"Données: {len(closes)} jours de trading")print(f"Actions: {len(closes.columns)}")print(f"\nStatistiques des prix finaux (échantillon):")for ticker inlist(closes.columns)[:5]: ret = (closes[ticker].iloc[-1] / closes[ticker].iloc[0] -1) *100print(f" {ticker}: {ret:+.1f}%")
Période: 2020-01-02 à 2025-12-31
Données: 1508 jours de trading
Actions: 3

Statistiques des prix finaux (échantillon):
  AAPL: +64.3%
  GOOGL: +50.7%
  IBM: +4.9%
2. Feature Engineering
Création d’un ensemble riche de features techniques.
RandomForest: Capture les interactions non-linéaires
GradientBoosting: Capture les motifs complexes
Diversité: Chaque modèle a ses forces/faiblesses
5. Création de l’Ensemble
Combinaison des prédictions avec pondération.
def ensemble_predict(ridge_pred, rf_pred, gb_pred, weights='equal'):""" Combine les prédictions de plusieurs modèles. weights: 'equal' ou dict {'ridge': 0.3, 'rf': 0.4, 'gb': 0.3} """if weights =='equal': w = {'ridge': 1/3, 'rf': 1/3, 'gb': 1/3}else: w = weights# Normaliser les prédictions Ridge (centrées sur 0) ridge_norm = ridge_pred - ridge_pred.mean()# Combiner ensemble = (w['ridge'] * ridge_norm + w['rf'] * rf_pred + w['gb'] * gb_pred)return ensemble# Prédictions ensembleensemble_pred = ensemble_predict(ridge_pred, rf_pred, gb_pred)# Confiance = accord entre modèles (écart-type faible)model_preds = np.column_stack([ ridge_pred - ridge_pred.mean(), rf_pred, gb_pred])confidence =1- model_preds.std(axis=1)# Performance ensembleensemble_corr = np.corrcoef(ensemble_pred, y_test.values)[0, 1]print("=== Performance Ensemble ===")print(f"Corrélation avec rendements réels: {ensemble_corr:.3f}")print(f"Confiance moyenne: {confidence.mean():.3f}")print(f"\nDistribution de la confiance:")print(pd.Series(confidence).describe())
=== Performance Ensemble ===
Corrélation avec rendements réels: -0.046
Confiance moyenne: 0.753

Distribution de la confiance:
count    167.000000
mean       0.752809
std        0.061189
min        0.634227
25%        0.718286
50%        0.744414
75%        0.773510
max        0.944497
dtype: float64
Interprétation: Ensemble
Confiance élevée: Les modèles sont d’accord → signal fiable
Confiance faible: Les modèles divergent → signal incertain
Filtrage: On ne trade que quand la confiance est haute
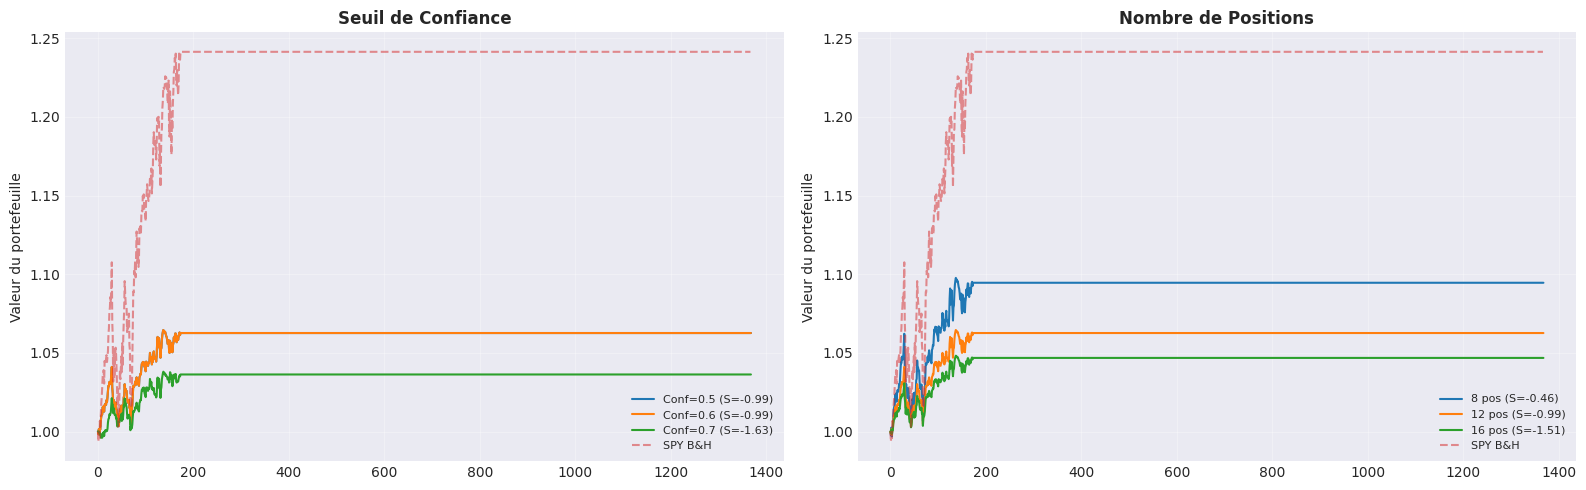
fig, axes = plt.subplots(1, 2, figsize=(16, 5))# Confidence threshold comparisonax = axes[0]for name, r in conf_results.items(): ax.plot(r['cum'].values, label=f"Conf={name} (S={r['sharpe']:.2f})", linewidth=1.5)ax.plot(spy_values.values, label='SPY B&H', linestyle='--', alpha=0.5)ax.set_title('Seuil de Confiance', fontsize=12, fontweight='bold')ax.set_ylabel('Valeur du portefeuille')ax.legend(fontsize=8)ax.grid(True, alpha=0.3)# Position count comparisonax = axes[1]for name, r in pos_results.items(): ax.plot(r['cum'].values, label=f"{name} pos (S={r['sharpe']:.2f})", linewidth=1.5)ax.plot(spy_values.values, label='SPY B&H', linestyle='--', alpha=0.5)ax.set_title('Nombre de Positions', fontsize=12, fontweight='bold')ax.set_ylabel('Valeur du portefeuille')ax.legend(fontsize=8)ax.grid(True, alpha=0.3)plt.tight_layout()plt.savefig('ml_ensemble_analysis.png', dpi=150, bbox_inches='tight')plt.show()print("Graphique sauvegardé.")
Graphique sauvegardé.
11. Conclusions et recommandations
Résumé
Métrique
Meilleure config
Confidence min
0.5 (Sharpe=-0.987)
Max Positions
8 (Sharpe=-0.464)
Sharpe
-0.987 (meilleur cas)
CAGR
1.1%
Verdict: NO BEATS
L’ensemble ne bat pas SPY B&H (Sharpe 0.182, CAGR 4.1%). La performance négative s’explique par:
Univers restreint: Seuls 3 tickers sur 30 ont des données complètes sur 2020-2026 dans l’environnement de recherche QC (AAPL, GOOGL, IBM). Le manque de diversité limite la capacité de l’ensemble a generer des signaux exploitables.
Features non predictives: Les indicateurs techniques classiques (RSI, EMA, momentum) ont un pouvoir predictif limite sur un univers aussi etroit.
Correlation negative: La correlation ensemble/rendements de -0.046 montre que les modèles ne capturent pas de signal exploitable dans cette configuration.
Points forts ML Ensemble (théoriques)
Robustesse: Reduit la variance des predictions
Diversite: 3 types de modèles complementaires
Filtrage intelligent: Confiance evite les signaux incertains
Limitations constatees
Univers trop petit: 3 actions ne suffisent pas pour un ensemble ML
Complexite vs valeur ajoutee: 3 modèles n’apportent rien sur un univers restreint
Overfitting: Risque eleve avec peu de données d’entrainement (834 echantillons)
Interpretabilite: Difficile d’expliquer les decisions
Prochaines étapes
Elargir l’univers a des tickers QC disponibles (verifier la couverture de données)
Ajouter des features fondamentales (P/E, revenus) pour augmenter le signal
Tester avec un reseau de neurones comme 4e modèle
Optimiser les ponderations (performance-based weighting)
Backtester sur une periode plus longue avec un vrai workflow de production